DLCV 12・影像生成:從 GAN 到文字生成影像系統
先備知識:ML 07・生成模型:自編碼器、VAE、GAN 與正規化流、ML 08・擴散模型與流匹配
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 依條件與所需輸出定義生成及編輯任務。
- 區分生成器家族,以及像素、潛在與 token 表示。
- 追蹤文字編碼、條件化、取樣與解碼。
- 比較空間控制、個人化與編輯機制。
- 評估品質、多樣性、對齊、成本與資料相關失敗。
先看全貌
影像生成器把一個需求變成一張新的圖片。這個需求可以什麼都沒有(「隨便一張臉」),可以是一個類別標籤(「一隻金翅雀」),可以是一句話(「草地上的一顆紅球」),也可以是另一張影像加上一道指令(「把它變成冬天」)。結果應該看起來真實、每次嘗試都有變化,而且確實畫出了被要求的內容。
為什麼重要。 影像生成不到十年,就從又小又模糊的臉進步到逼真、能聽懂提示的圖片,現在已經是設計工具、照片編輯器、資料管線與復原系統的一部分(DLCV 09B 就用同樣的模型來修復受損的照片)。作為電腦視覺系統,現代生成器結合了語言模型、影像壓縮器、生成網路、取樣器與評估流程。每個部分都可能單獨出錯,也都有各自的文獻。
本篇的位置。 理論放在 ML 學習路線,本篇不重複。ML 07 以程式推導 VAE、GAN、正規化流與經典指標(Inception Score、FID、精確率與召回率)。ML 08 推導擴散、DDIM、無分類器引導、潛在擴散、擴散 Transformer、流匹配與少步取樣器。ML 09 談像素與 token 上的自迴歸模型,ML 10 談 CLIP 與參數高效微調。這裡採取的是系統觀點:這些元件怎麼組裝成文字生成影像的產品、怎麼操控、怎麼評判,以及可能出什麼問題。兩段程式範例只用 NumPy 與 scikit-image,在 CPU 上幾秒內就能跑完,也不需要網路上的權重。
下一步。 DLCV 12A 把這些系統從影像延伸到影片。
任務:要生成什麼,以及「好」是什麼意思
白話版。 生成在文字、標籤或輸入影像等條件下產生輸出;應分別評估真實感、多樣性與條件遵循。
六種生成任務
下面所有任務,都是從條件分布 取樣,其中 是影像, 是條件;無條件生成使用空條件 。
| 任務 | 條件 | 輸出 | 本篇中的範例方法 |
|---|---|---|---|
| 無條件生成 | 無 | 訓練領域內的一張影像 | 人臉上的 StyleGAN [1] |
| 類別條件生成 | 一個類別標籤 | 該類別的一張影像 | BigGAN [2]、DiT [3] |
| 文字生成影像 | 一段文字提示 | 符合提示的一張影像 | Imagen [4]、潛在擴散 [5] |
| 影像轉影像 | 一張影像(常加上文字) | 保留其結構的新影像 | SDEdit [6]、ControlNet [7] |
| 編輯 | 一張影像加上編輯需求 | 編輯後的影像 | Prompt-to-Prompt [8]、InstructPix2Pix [9] |
| 影像修補/外擴 | 一張影像加上遮罩 | 遮罩區域被填補的影像 | RePaint [10] |
因為形式相同,一個訓練好的文字生成影像模型就能涵蓋表中的大部分列:編輯、遮罩與控制影像,都只是額外的條件,或是取樣器不同的起點。
三個問題:保真度、多樣性、對齊
- 保真度(品質)。 每個樣本看起來像該領域的真實影像嗎?有沒有瑕疵?
- 多樣性(涵蓋度)。 許多樣本合起來,涵蓋了真實影像的變化嗎?還是模型一直重複幾個偏愛的結果(模式崩塌,mode collapse)?
- 對齊。 樣本畫出了條件所要求的內容嗎:正確的物體、數量、顏色、位置與文字?
再加上第四個實務問題:成本,也就是網路的評估次數,以及每張影像要花幾秒。前三個問題彼此拉扯。多數生成器都有一個旋鈕,用多樣性換取保真度與對齊:BigGAN 的截斷技巧(truncation trick)縮小輸入雜訊的範圍 [2],擴散模型中的無分類器引導則把樣本推向條件 [11]。把這種旋鈕調高,影像會更乾淨、更符合提示,但也更相似。每次讀到單一的「品質」數字,都要記得這個取捨。分別量測保真度與多樣性的指標,推導在 ML 07;本篇在後面的評估一節補上對齊這一面。
各模型家族的一張地圖
白話版。 GAN、擴散、流與自迴歸模型學習不同生成程序;另須選擇以像素、連續潛在表示或 token 表達影像。
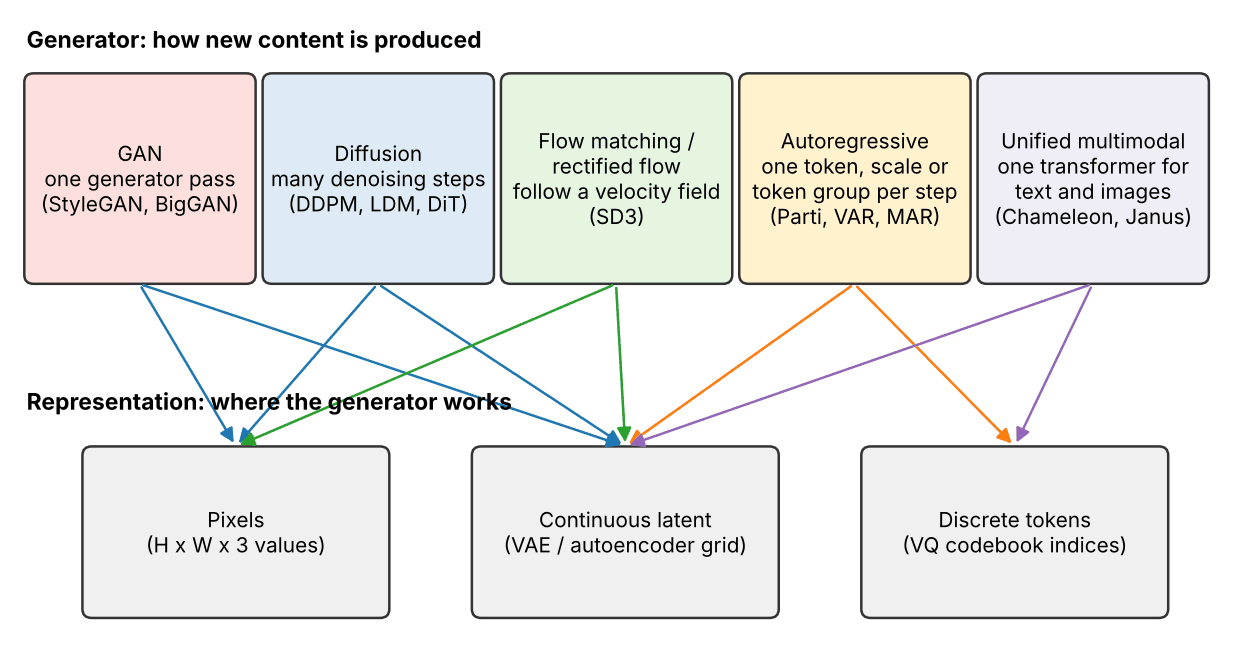
GAN:通過生成器一次。 生成器把隨機雜訊對應成影像,同時訓練的判別器則試著分辨生成影像與真實影像;生成器靠騙過它來進步 [12]。取樣只要一次前向傳遞,所以 GAN 很快。StyleGAN [1] 把雜訊對應成一個中間的「風格」向量,並把它注入生成器的每個解析度,這把粗略的屬性(姿勢、身分)和細緻的屬性(雀斑、頭髮)分開,也讓各尺度可以分別控制。BigGAN [2] 在 ImageNet 上擴大類別條件 GAN 的規模,並提出上面提到的截斷技巧。GAN 的訓練不穩定,也可能漏掉某些模式,這讓它們很難擴展到開放式的提示。理論與程式:ML 07,GAN。
VAE 與 tokenizer:先壓縮。 變分自編碼器(VAE)學習一個編碼器把影像編成緊湊的潛在編碼,一個解碼器把它還原成像素,以及編碼上的一個簡單先驗 [13]。在今天的系統裡,自編碼器的主要工作是為另一個生成器做前置壓縮:潛在擴散在比影像小好幾倍的連續潛在網格上執行去雜訊網路 [5];以 token 為基礎的模型則使用向量量化(vector-quantized)自編碼器(VQ-VAE [14]、VQGAN [15]),把影像變成由學到的碼本(codebook)中整數索引組成的網格,就像字典裡的字。解碼器設下了上限:解碼器重建不出來的細節,沒有任何生成器能產生。細節見 ML 07,VAE 與 ML 09,視覺 token。
擴散:許多小步的去雜訊。 訓練一個網路,從帶雜訊的影像中去掉一點 Gaussian 雜訊;要生成時,從純雜訊出發,反覆套用許多次 [16]。訓練是穩定的迴歸問題,加上更好的架構與分類器引導後,擴散模型在 ImageNet 上超越了 GAN [17]。把同樣的過程放在自編碼器的潛在網格上執行,也就是潛在擴散,讓高解析度的文字生成影像變得負擔得起 [5]。理論與程式:ML 08,以及其中的潛在擴散一節。
流匹配與整流流:沿著速度場前進。 取一個雜訊樣本和一個資料樣本,用直線連起來,訓練網路預測沿著這類直線的行進方向;要生成時,從雜訊出發,沿著預測的方向前進 [18], [19]。它與擴散關係密切(只是雜訊與資料之間走的路徑不同),現在已用在大規模系統:Stable Diffusion 3 以整流流(rectified flow)目標訓練一個大型潛在 Transformer [20]。理論:ML 08,流匹配。
自迴歸與統一模型:一片一片地寫出圖片。 把影像變成 token 序列,在已生成的所有內容的條件下,預測下一個 token(或下一組 token,或整張 token 圖下一個更清晰的版本)。這就是把語言模型的做法用在影像上,最新的形式是用單一個 Transformer 同時讀寫文字與影像。後面有專屬的一節。
| 家族 | 如何取樣 | 循序的網路呼叫次數 | 主要優點 | 主要注意事項 |
|---|---|---|---|---|
| GAN | 通過生成器一次 | 一次 | 速度快、平滑可編輯的潛在空間 | 訓練穩定性、模式涵蓋 |
| 擴散 | 從雜訊反覆去雜訊 | 數十到數百次;蒸餾後更少 | 品質、涵蓋度、訓練穩定 | 取樣成本 |
| 流匹配 | 對學到的速度做積分 | 數十次;蒸餾後更少 | 目標簡單、路徑更直 | 沒蒸餾還是需要好幾步 |
| 自迴歸 | 依某種順序預測 token | 每個 token、每組或每個尺度一次 | 重用語言模型的機制、token 有精確概似 | tokenizer 的上限、誤差累積 |
地圖上有兩點容易忘記。生成器與表示方式是各自獨立的選擇:擴散模型可以在像素上運作(Imagen [4]),也可以在潛在上運作(潛在擴散 [5]),自迴歸模型可以使用離散或連續的 token [21]。而且實際的系統會混合各家族:VQGAN 的 tokenizer 是用對抗損失訓練的 [15],對抗式蒸餾則把擴散模型變成只要一到四步的生成器 [22]。
文字生成影像系統
白話版。 潛在文字生成影像流程先編碼提示、產生條件化潛在表示,再解碼像素;條件介面連接語言與影像特徵。
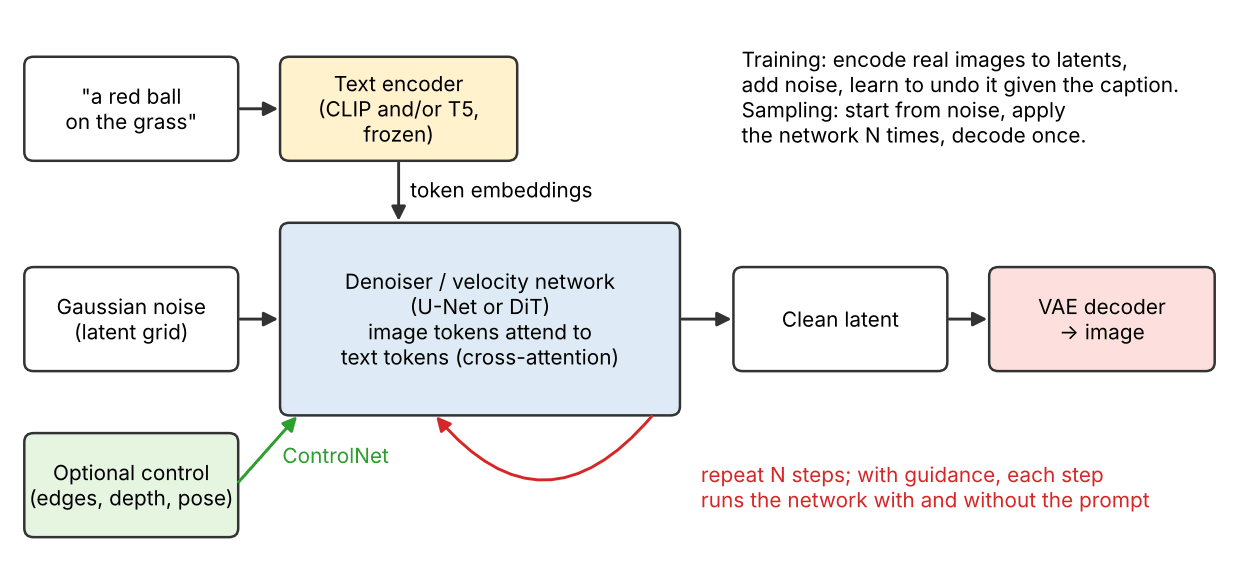
訓練時,影像與標題配對中的每張影像會被編碼成潛在表徵、加上隨機強度的雜訊,去雜訊網路學習在給定標題嵌入的條件下還原雜訊。取樣時,去雜訊網路從純雜訊出發,執行 步,再由解碼器產生像素。這兩句話背後的擴散與取樣公式,在 ML 08;下面我們看與文字有關的部分。
文字編碼器:CLIP 或語言模型
白話版。 文字編碼器決定生成器能「理解」什麼。一個訓練來配對影像與標題的模型,懂得視覺概念;只用文字訓練的大型語言模型,則更懂文法、詞序,以及和拼字有關的結構。許多系統兩種都用。
主要有兩類編碼器:
- CLIP 文字編碼器以對比方式訓練,讓影像與它的標題在共享的嵌入空間中彼此靠近 [23](見 ML 10)。它們的嵌入有視覺上的依據。
- 語言模型編碼器,例如 T5 [24],只用文字訓練。Imagen 的關鍵發現是:一個大型凍結的 T5 編碼器出乎意料地好用,而把文字編碼器加大,對保真度與影像–文字對齊的改善,遠大於把影像擴散模型加大 [4]。
近期的系統會把兩者結合。SDXL 在先前 Stable Diffusion 模型的設計上加了第二個文字編碼器 [25]。Stable Diffusion 3 使用三個凍結的編碼器:兩個 CLIP 模型和 T5-XXL;作者報告指出,推論時拿掉 T5,對大多數提示損失不大,但對含有長篇文字或許多細節的提示明顯有害 [20]。有一個相關的發現與拼字有關:文字編碼器若看到的是整個詞片段而不是字元(「對字元視而不見」,character-blind),就很難一個字母一個字母地畫出一個字,而能辨識字元的編碼器,繪製視覺文字的準確度高得多 [26]。DALL·E 2 走的是另一條路:先由一個「先驗」(prior)網路從標題生成 CLIP 影像嵌入,再由擴散解碼器根據這個嵌入生成影像 [27]。
交叉注意力:文字如何抵達像素
白話版。 在每一層,影像的每個位置都先問一個問題(「這裡該放什麼?」),再掃過提示的所有字,找出能回答的那些字。它收集到的答案,是這些字的加權混合,匹配的字權重大。
潛在擴散為此在 U-Net 去雜訊網路中加入了交叉注意力層 [5]。令 為某一層的影像特徵( 個空間位置,每個是寬度 的向量), 為文字編碼器的輸出( 個寬度 的 token)。學到的矩陣 、 把它們投影到共同的寬度 :
這裡 為每個影像位置存放一個查詢(query), 為每個文字 token 存放一個鍵(key)與一個值(value),softmax 沿著每一列計算,而 是注意力圖:第 列是 個 token 上的機率分布,說明位置 對每個字聽多少。輸出 給每個影像位置一份字的值的混合,並加回影像特徵。查詢來自影像,鍵與值來自文字,這正是它稱為交叉注意力而不是自注意力的原因(比較 NLP 07)。把 的第 行當成影像來看,就得到第 個字被畫在哪裡的熱度圖,Prompt-to-Prompt 就把這個事實變成一種編輯方法 [8]。
Transformer 骨幹提供了另一種做法。Stable Diffusion 3 的 MM-DiT 把影像 token 與文字 token 串成一個序列,讓它們雙向互相注意,兩種模態各有各自的權重 [20]。於是文字也會「讀」影像,而不只是影像讀文字。
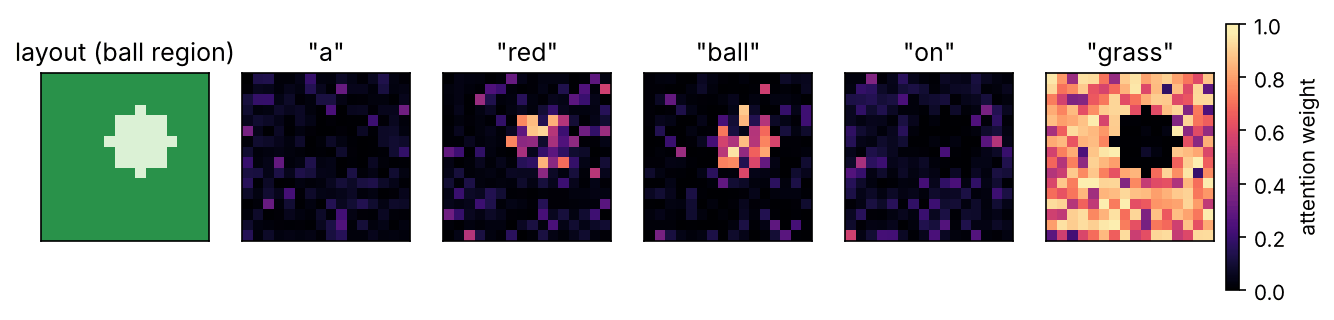
下面的玩具範例建立一個 的影像特徵網格,其中一塊圓盤區域像是「red」和「ball」這兩個字,背景像是「grass」,然後執行一次交叉注意力。為了易讀,投影矩陣用單位矩陣;在訓練好的模型中它們是學出來的。
程式碼 · Python · 26 行
import numpy as np

rng = np.random.default_rng(0)
d = 32                                       # feature width
words = ["a", "red", "ball", "on", "grass"]  # the prompt, one text token per word
E = rng.normal(size=(len(words), d))         # text-encoder outputs, one row per word

# A 16 x 16 grid of image tokens: a disk ("the ball") on a background ("the grass").
yy, xx = np.mgrid[:16, :16]
ball = ((yy - 6) ** 2 + (xx - 9) ** 2 <= 9).ravel()   # 29 of the 256 positions
X = 1.0 * rng.normal(size=(256, d))                   # noisy image features
X[ball] += 0.5 * (E[1] + E[2])                        # ball region looks like "red ball"
X[~ball] += 0.5 * E[4]                                # background looks like "grass"

# Cross-attention: queries from the image, keys and values from the text.
# Real models learn W_q, W_k, W_v; identity matrices keep the toy readable.
Q, K, V = X, E, E
scores = Q @ K.T / np.sqrt(d)                         # 256 image tokens x 5 words
A = np.exp(scores - scores.max(axis=1, keepdims=True))
A /= A.sum(axis=1, keepdims=True)                     # softmax over the words
out = A @ V                                           # each image token gets a mix of word values

print("each row sums to 1:", np.allclose(A.sum(axis=1), 1), "| output shape:", out.shape)
for j, w in enumerate(words):
    print(f"{w:6s} mean weight inside the ball={A[ball, j].mean():.2f}  "
          f"outside={A[~ball, j].mean():.2f}")
輸出如下:
程式碼 · 6 行
each row sums to 1: True | output shape: (256, 32)
a      mean weight inside the ball=0.02  outside=0.06
red    mean weight inside the ball=0.43  outside=0.07
ball   mean weight inside the ball=0.52  outside=0.04
on     mean weight inside the ball=0.02  outside=0.08
grass  mean weight inside the ball=0.01  outside=0.74
(這些數字來自我們的玩具實驗,不是任何訓練好的模型。)在圓盤內,幾乎所有注意力都給了「red」和「ball」;在圓盤外,四分之三給了「grass」。虛詞「a」和「on」在任何地方權重都很小。圖 3 畫出這五張圖。請注意這個機制不保證的事:「red」和「ball」位在同一區,是因為特徵這樣設定;注意力公式裡沒有任何東西,會強迫顏色字附著到正確的物體上。當畫面上有兩個物體時,顏色可能注意到錯的那一個,這是後面要談的屬性綁定失敗的根源之一 [28]。
實務上的引導
無分類器引導(classifier-free guidance,CFG)的推導與測試在 ML 08;這裡只做提醒。訓練時,對隨機一部分的樣本把標題丟掉(換成空提示),讓同一個網路同時學會條件預測與無條件預測 [11]。取樣時把兩者結合:,其中 與 是有提示與沒有提示的預測, 是引導尺度; 會越過條件預測,朝提示的方向再移動。
對系統建構者而言,有四件實務上的事很重要:
- 它是旋鈕,不是量測值。 較高的 通常讓影像更忠於提示、對比更高,但變化更少; 非常高時,影像會過飽和而扭曲。要報告它的數值與慣例(有些程式碼寫成 )。
- 除非把兩個預測合成一個批次,否則每一步的工作量會加倍,所以 30 步的引導取樣器大約要做 60 次網路評估。
- 它也適用於 token 模型。 自迴歸與遮罩 token 生成器,會對下一個 token 的 logits 套用同樣的公式(ML 09)。
- 蒸餾模型可能把它內建進去。 有些蒸餾後的檢查點,被訓練成重現有引導的輸出,所以引導尺度變成輸入或乾脆消失;比較設定之前,要先讀發布文件(ML 08)。
骨幹與幾個代表性系統
去雜訊網路最早是 U-Net [29],一種有跳接的卷積編碼器–解碼器,並在數個解析度上插入交叉注意力層 [5]。擴散 Transformer(DiT)則用作用在潛在小塊上的 Vision Transformer 取代它,並且隨著 Transformer 的運算量增加,表現穩定進步 [3](細節見 ML 08)。近期的大型系統多半使用 Transformer。下表列出幾個設計已有論文記載的系統;它是設計選擇的地圖,不是排名。
| 系統 | 在哪裡生成 | 生成器與骨幹 | 文字條件化 |
|---|---|---|---|
| 潛在擴散/Stable Diffusion [5] | 自編碼器潛在空間 | 擴散,U-Net | 對文字編碼器做交叉注意力 |
| DALL·E 2 [27] | 像素 | 以 CLIP 影像嵌入為條件的擴散解碼器 | 由先驗把標題對應成 CLIP 影像嵌入 |
| Imagen [4] | 像素,64 → 256 → 1024 級聯 | 擴散 | 凍結的 T5-XXL |
| Parti [30] | 離散 token(ViT-VQGAN) | 自迴歸編碼器–解碼器 Transformer | 文字是編碼器的輸入 |
| Muse [31] | 離散 token | 遮罩平行解碼,Transformer | 來自預訓練語言模型的嵌入 |
| SDXL [25] | 自編碼器潛在空間 | 擴散,更大的 U-Net,可選的精修器 | 兩個文字編碼器 |
| Stable Diffusion 3 [20] | 自編碼器潛在空間 | 整流流,MM-DiT Transformer | 兩個 CLIP 編碼器與 T5-XXL |
Imagen 級聯的解析度,來自其參考文獻所列的專案頁面。
選讀:Stable Diffusion 3(見「論文導讀」頁)。一篇論文如何結合整流流目標、文字與影像聯合的 Transformer、三個文字編碼器與精選的標題,以及怎麼讀它的消融實驗。
控制、個人化與編輯
白話版。 提示是很弱的方向盤:文字無法釘死確切的姿勢、某個人的狗,或「只改帽子」。有三類方法提供更強的操控:額外的控制影像(邊緣、深度、姿勢)、教模型新概念的小型個人化更新,以及改動給定影像、同時保留其餘部分的編輯流程。
空間控制:ControlNet
ControlNet 把空間條件(邊緣圖、深度圖、分割圖、人體姿勢)加到大型預訓練的文字生成影像模型上,又不損壞它 [7]。它把原始網路鎖住,為它的編碼層做一份接收條件的可訓練副本,再透過零卷積(zero convolution)把副本接回原始網路:零卷積是權重與偏差都從零開始的 卷積。在第一個訓練步,新加的分支輸出剛好是零,所以模型的行為與原始模型完全相同,學習從一個能運作的生成器出發。論文報告,不論資料集小(少於 5 萬)或大(超過 100 萬),訓練都很穩健 [7]。
選讀:ControlNet 的零卷積(見「補充資料」頁)。一個受控區塊的方程式,以及為什麼梯度仍然能傳到零初始化的層。
個人化:教模型一個新概念
三種方法在儲存量、速度與保真度之間各有取捨:
- Textual inversion 讓整個模型保持凍結,只從某個概念的 3–5 張影像學習一個新的詞嵌入(一個新的「偽詞」),做法是在這些影像上最小化一般的去雜訊損失 [32]。儲存下來的結果只是一個向量,但它的表達能力受限於凍結的模型本來就畫得出來的東西。
- DreamBooth 用某個主體的幾張影像微調整個模型,影像的標題包含一個罕見的識別字加上類別名稱,例如 “a [V] dog”,並加上一項類別專屬的先驗保留損失(prior-preservation loss),讓模型仍然畫得出一般的狗;沒有它,模型會漂移而失去多樣性 [33]。
- LoRA(低秩適配,low-rank adaptation)凍結每個權重矩陣 ,只學習加性更新 ,其中 、,且秩 很小 [34]。它原本是為語言模型提出的;同樣的更新可以接在文字生成影像去雜訊網路的注意力層上,讓個人化的風格或主體變成一個可以開關的小檔案(ML 10,PEFT)。
選讀:個人化目標函數並排比較(見「補充資料」頁)。textual inversion 與 DreamBooth 的精確損失,以及這三種方法各儲存什麼。
編輯與影像修補
- SDEdit 對輸入影像(例如一張粗略的彩色草圖)加雜訊,加到某個中間的雜訊強度,再執行一般的反向過程 [6]。起始雜訊強度低,會保留輸入的版面與顏色(忠實);強度高,則給模型更多自由(真實)。一個數字就決定了這個平衡。
- Prompt-to-Prompt 透過更改提示(“a cat on a bike” → “a dog on a bike”)來編輯生成的影像,同時在取樣時重複使用原本的交叉注意力圖,所以版面維持不變,只有被改動的字的內容會變 [8]。要用這種方式編輯真實照片,必須先找到一個能重現它的雜訊,例如用確定性的 DDIM 反轉(ML 08)。
- InstructPix2Pix 依照書面指令(“make it look like winter”)行動。它的訓練資料是自動產生的:結合語言模型(GPT-3)與文字生成影像模型(Stable Diffusion),做出大量編輯前後的範例;用這些配對訓練的條件擴散模型,只要一次取樣就能完成編輯,不需要對每張影像微調或反轉 [9]。
- RePaint 用無條件擴散模型做影像修補:在每個反向步驟,它把已知區域換成輸入影像加上正確強度雜訊的副本,讓模型只生成被遮住的區域 [10]。
Huang 等人的一篇綜述,依學習策略、輸入條件與任務,整理了許多以擴散為基礎的編輯方法 [35]。
快速取樣簡述
文字生成影像模型是互動使用的,所以網路呼叫的次數很重要。各條路線在 ML 08,少步生成 都談過:DDIM 這類確定性取樣器,用同一個網路就需要較少的步數 [36];漸進式蒸餾(progressive distillation)反覆把步數減半 [37];一致性模型(consistency models)學習從軌跡上任何一點直接跳到終點 [38];對抗式擴散蒸餾(adversarial diffusion distillation,ADD)把擴散教師與對抗損失結合,讓大型模型只用 1–4 步就能取樣 [22]。比較系統時,要算每一次網路評估(包含兩次引導傳遞),再加上解碼器。
自迴歸與統一多模態生成器
白話版。 自迴歸生成器寫影像的方式,就像語言模型寫句子:一次一個 token,或一次一組 token,每次都以前面寫的為條件。最新的一步,是用一個 Transformer 同時處理文字與影像,讓同一個模型既能描述圖片、回答關於圖片的問題,也能畫新的圖。
一段話看自迴歸這條路線
理論在 ML 09;這裡只做摘要。tokenizer(VQ-VAE 或 VQGAN,ML 09)把影像變成整數網格,Transformer 用鏈鎖法則為它們建模,以 teacher forcing 的下一個 token 交叉熵訓練(ML 09)。Parti [30] 與 LlamaGen [39] 這類逐行掃描(raster-order)模型,每步預測一個 token;MaskGIT [40] 與 Muse [31] 這類遮罩模型一次平行預測許多 token,並在幾輪中逐步修正(ML 09);VAR 每步預測整張更清晰的 token 圖,由粗到細 [41](ML 09);MAR 則放棄離散碼本,用一個小型擴散頭為每個連續 token 建模 [21](ML 09)。取樣成本、KV 快取以及與擴散的比較,在 ML 09。
實務上的自迴歸文字生成影像
從系統面來看,有四件事值得知道。
- 文字是以上下文的形式進來,而不是透過對另一個去雜訊網路的交叉注意力。 Parti 把文字生成影像當成翻譯:Transformer 編碼器讀提示,解碼器寫出影像 token;論文把這個編碼器–解碼器模型擴大到 200 億個參數,並提出 PartiPrompts 基準,包含超過 1,600 個英文提示 [30]。Muse 則把預訓練大型語言模型的文字嵌入餵給遮罩 token Transformer,不需微調就支援影像修補、外擴與不用遮罩的編輯 [31]。
- 語言模型的基礎設施可以直接轉用。 LlamaGen 使用單純的 Llama 式解碼器;除了 111M 到 3.1B 參數的類別條件模型,它還訓練了一個 775M 的文字條件模型,並報告 LLM 服務框架讓影像生成加速 326%–414% [39]。
- tokenizer 具有決定性。 MAGVIT-v2 主張 tokenizer 是關鍵元件:配上它新的「免查表」(lookup-free)量化器,詞彙量可以變得很大,在相同訓練資料、相近模型大小與相近訓練預算下,語言模型在 ImageNet 上勝過擴散模型 [42]。文字和細線這類小細節,是粗糙 tokenizer 的典型犧牲品(ML 09)。
- 引導與取樣的旋鈕可以沿用。 在 logits 上做 CFG、temperature 與 top- 取樣,決定保真度與多樣性的平衡,而且每個有引導的步驟要做兩次前向傳遞。
統一多模態模型
白話版。 與其用一個文字模型把提示交給另一個獨立的影像模型,統一模型把文字與影像片段放進同一個序列,用一個 Transformer 訓練。設計上的問題是:影像片段是離散 token 還是連續向量、影像部分用下一個 token 預測還是擴散生成,以及理解與生成是否共用同一個影像編碼器?
下面這些模型都有論文記載,並說明了主要的設計選擇:
- Chameleon 從一開始就把離散的影像 token 與文字 token 放在同一個序列(「早期融合」,early fusion),用一個模型處理圖說生成、問答,以及文字、影像與混合文件的生成 [43]。
- Emu3 從頭訓練一個 Transformer,只用下一個 token 預測,處理影像、文字與影片的離散 token [44]。
- Transfusion 讓影像保持連續,用一個 Transformer 同時訓練文字上的下一個 token 損失與影像小塊上的擴散損失;作者報告這樣的擴展性比把影像量化成 token 更好 [45]。
- Show-o 把文字的自迴歸建模,與影像 token 上的離散(遮罩)擴散結合起來 [46]。
- Janus 共用一個 Transformer,但為理解與生成使用不同的視覺編碼器,因為這兩個任務需要不同程度的影像細節 [47]。
| 模型 | 影像表示 | 影像目標 | 視覺編碼器 |
|---|---|---|---|
| Chameleon [43] | 離散 token | 下一個 token | 一個,共用 |
| Emu3 [44] | 離散 token | 下一個 token | 一個,共用 |
| Transfusion [45] | 連續小塊 | 擴散 | 一個,共用 |
| Show-o [46] | 離散 token | 遮罩(離散)擴散 | 一個,共用 |
| Janus [47] | 生成用離散 token | 下一個 token | 理解與生成各自獨立 |
選讀:統一多模態模型逐一介紹(見「補充資料」頁)。每篇論文在 Transformer、tokenizer 與訓練資料上改了什麼。
目前仍未解決的是:一個模型能否在相同大小下,同時在理解與生成上都達到最先進;共用的視覺 tokenizer 讓每個任務付出多少代價(這是 Janus 的動機);以及評估該如何比較統一模型與專門的擴散系統。這些論文中關於擴展的主張,都是各篇論文在自己資料上的量測,還不是定論。
評估文字生成影像模型
白話版。 你需要四種證據:影像看起來真實又多樣嗎(分布指標)、整體上符合提示嗎(對齊分數)、細節對嗎(組合式檢查),以及人喜歡嗎(人類偏好)。每一種都能抓到其他幾種漏掉的失敗。
分布指標及其陷阱
FID 比較生成影像與真實影像的特徵統計;精確率與召回率把保真度與涵蓋度分開。兩者的定義與實作都在 ML 07,ML 08 則談較新的特徵空間。對文字生成影像模型,常見的協定是零樣本 COCO FID:用沒有在 COCO 上訓練的模型,根據 COCO 標題 [48] 生成影像,再與真實的 COCO 影像比較,Imagen 就是這麼做的 [4]。實務上有五個陷阱:
- 有限樣本偏差。 FID 在有限的樣本集上有偏差,且偏差取決於被評估的模型,所以即使樣本數相同,比較也不完全公平;Chong 與 Forsyth 提議外插到無限樣本數 [49]。
- 前處理。 特徵擷取之前所用的縮放濾波器與 JPEG 壓縮,會大幅改變 FID;Parmar 等人展示了這點,並提供參考實作 [50]。
- 特徵看到什麼。 Inception 特徵與 ImageNet 類別非常接近,因此讓生成影像的類別直方圖吻合,就可以降低 FID,卻不代表影像變好 [51]。
- 與人的一致性。 在一項大型人類研究中,沒有任何常見指標與人類判斷高度相關,且 FID 低估了擴散模型;作者建議使用 DINOv2 這類更豐富的特徵擷取器 [52]。CMMD 則以 CLIP 嵌入和核距離,取代 Inception 特徵與 Gaussian 假設 [53]。
- 沒有對齊。 FID 完全不看提示:一個無視所有提示、卻畫出漂亮的類 COCO 影像的模型,也可能得到好分數。
提示對齊:CLIPScore
CLIPScore 衡量影像與文字在 CLIP 嵌入空間中有多一致 [54]。令 為文字的 CLIP 嵌入, 為影像的 CLIP 嵌入,
其中 是餘弦相似度, 是只用來重新縮放範圍的常數(原論文中 ,該論文是為影像圖說提出這個分數的)。用於文字生成影像的評估時,要對提示–影像配對取平均。它便宜,也不需要參考影像,但它繼承了 CLIP 的盲點:一個概括整張影像的嵌入,不擅長處理數量、空間關係,以及哪個屬性屬於哪個物體。GenEval 的研究發現,在這類組合式任務上,它的物件層級檢查與人類判斷的一致程度遠高於 CLIPScore [55]。
組合式基準
白話版。 與其用一個整體相似度,不如對影像提出具體的是非題:有狗嗎、剛好三隻嗎、狗在貓的左邊嗎、車是紅的嗎?由偵測器或視覺–語言模型來回答。
GenEval 用模板為六種任務(單一物體、兩個物體、計數、顏色、位置與屬性綁定)產生提示,用實例分割模型偵測物體,用 CLIP 分類物體顏色,再把每張影像評為正確或不正確 [55]。T2I-CompBench 提供 6,000 個組合式提示,分三類(屬性綁定、物體關係與複雜組合),並為每類設計專屬的指標 [56]。Imagen 的 DrawBench [4] 與 Parti 的 PartiPrompts [30] 是供人類並排比較的提示集。物件偵測本身是 DLCV 03 的主題;開放詞彙偵測器(DLCV 03)可以檢查固定類別清單以外的物體。
選讀:GenEval(見「論文導讀」頁)。這個基準怎麼建構、分數怎麼計算,以及怎麼讀它的表格。
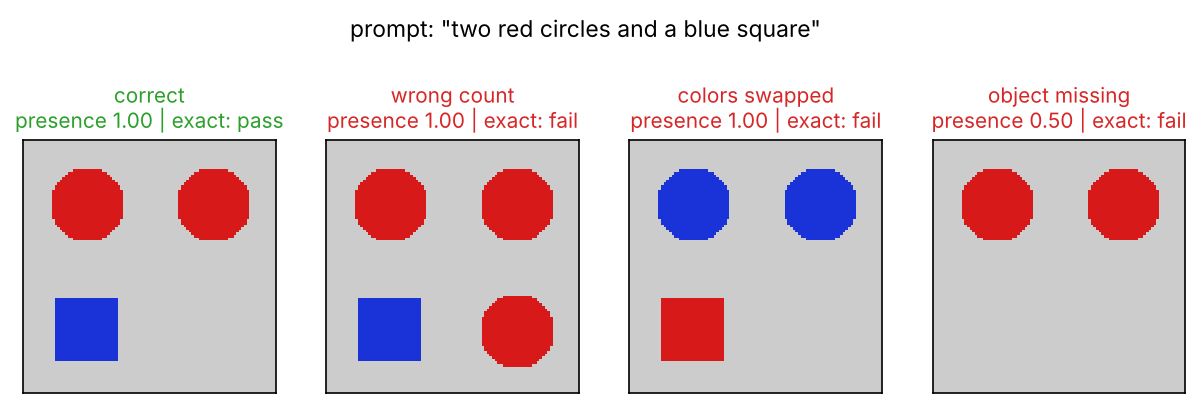
下面的玩具範例說明為什麼物件層級的檢查很重要。它為提示 “two red circles and a blue square” 畫出由彩色圓盤與方塊組成的合成「生成影像」,用連通元件偵測形狀,並比較兩種分數:一個是出現分數(presence score),只問提示裡的哪些字出現在影像的任何地方(刻意設計成整體相似度分數的簡單替身,不是 CLIP 本身);另一個是精確檢查(exact check),要求每個(顏色、形狀)配對都有正確的數量,像 GenEval 那樣。
程式碼 · Python · 49 行
import numpy as np
from skimage.draw import disk, rectangle
from skimage.measure import label, regionprops

COLORS = {"red": (0.85, 0.1, 0.1), "blue": (0.1, 0.2, 0.85)}

def render(objects, size=96):
    """Draw (color, shape) objects at fixed slots on a gray canvas: a stand-in for a generated image."""
    img = np.full((size, size, 3), 0.8)
    for k, (col, shape) in enumerate(objects):
        cy, cx = 24 + 48 * (k // 2), 24 + 48 * (k % 2)
        if shape == "circle":
            rr, cc = disk((cy, cx), 14)
        else:
            rr, cc = rectangle((cy - 12, cx - 12), extent=(24, 24))
        img[rr, cc] = COLORS[col]
    return img

def detect(img):
    """Toy 'detector': connected colored regions -> (color, shape) pairs."""
    found = []
    for region in regionprops(label(np.abs(img - 0.8).sum(-1) > 0.3)):
        r, g, b = img[tuple(region.coords.T)].mean(0)
        col = "red" if r > b else "blue"
        shape = "square" if region.extent > 0.9 else "circle"   # filled bbox fraction
        found.append((col, shape))
    return found

def presence_score(prompt, img):
    """Bag-of-words check: which prompt words appear anywhere (ignores counts and binding)."""
    words = {w for obj in prompt for w in obj}
    seen = {w for obj in detect(img) for w in obj}
    return len(words & seen) / len(words)

def exact_check(prompt, img):
    """GenEval-style check: every (color, shape) pair with the right count."""
    return sorted(detect(img)) == sorted(prompt)

prompt = [("red", "circle"), ("red", "circle"), ("blue", "square")]   # "two red circles and a blue square"
candidates = {
    "correct":          prompt,
    "wrong count":      prompt + [("red", "circle")],
    "colors swapped":   [("blue", "circle"), ("blue", "circle"), ("red", "square")],
    "object missing":   prompt[:2],
}
for name, objs in candidates.items():
    img = render(objs)
    print(f"{name:15s} presence score={presence_score(prompt, img):.2f}  "
          f"exact check={'pass' if exact_check(prompt, img) else 'fail'}")
輸出如下:
程式碼 · 4 行
correct         presence score=1.00  exact check=pass
wrong count     presence score=1.00  exact check=fail
colors swapped  presence score=1.00  exact check=fail
object missing presence score=0.50 exact check=fail出現分數給數量錯誤和顏色互換的影像滿分,因為提示裡的每個字都出現在某個地方;只有精確檢查抓得到它們。真實的基準會用訓練好的偵測器與顏色分類器,取代我們的連通元件「偵測器」,並承襲它們的錯誤:檢查的好壞只取決於偵測器,這也是 GenEval 要報告它與人類標註者一致程度的原因 [55]。圖 4 畫出這四張影像。
人類偏好與整體評估
人仍然是最終的參考標準。因為人類研究很慢,有幾個團隊訓練了偏好模型,預測人們針對某個提示會偏好兩張影像中的哪一張:ImageReward 以 13.7 萬筆專家比較訓練 [57],PickScore 則以 Pick-a-Pic 訓練,這是透過網頁應用程式收集真實使用者選擇的開放資料集 [58]。HEIM 沿著 12 個面向(包括對齊、品質、美感、原創性、推理、知識、偏見、毒性、公平性、穩健性、多語言與效率)評估模型,涵蓋 62 個情境與 26 個模型,並發現沒有單一模型在所有面向都最好 [59]。學習出來的偏好模型本身也是帶有偏見的模型;如果把生成器調整成最大化它,分數可能比真實品質上升得更快。
報告檢查清單。 對文字生成影像模型的任何主張,都要說明:提示(以及如何取樣)、每個提示的影像數與隨機種子、取樣器、步數與引導尺度、解析度、指標的實作與特徵擷取器,並展示未經挑選的樣本。把分布、對齊、組合式與偏好的結果並列報告,並說明哪些數字是自己跑的,哪些是從論文抄來的。
資料
白話版。 生成器只能學到訓練影像和標題所呈現的東西,所以資料集決定了它的知識、風格與許多偏見。大型文字生成影像資料集是從網路上爬取的,這帶來品質、著作權與同意權的問題。
- 類別條件基準使用 ImageNet [60];文字生成影像論文常在 COCO 標題上做零樣本評估 [48];人臉生成器則使用 FFHQ 這類資料集,也就是隨 StyleGAN 一起提出的高品質人臉資料集 [1]。
- LAION-5B 是公開釋出的資料集,包含 58.5 億個經 CLIP 過濾的影像–文字配對,其中 23.2 億個的文字是英文 [61]。它發布的是 URL 與替代文字,而不是影像本身;它的資料集說明(datasheet)寫明,LAION 以 CC-BY-4.0 釋出中介資料,但不擁有影像或文字的著作權,影像中出現的人可能並未同意上傳,且資料集目前的形式應該用於學術研究;它也說明了申請移除連結的方法 [61]。
- 內容稽核。 Birhane 等人檢視了較早的 LAION-400M 資料集,發現其中有露骨且有問題的影像–文字配對,包括色情內容、惡意刻板印象與辱罵字眼 [62]。
- 標題也是資料。 Stable Diffusion 3 以各半的原始標題與視覺–語言模型寫的合成標題混合訓練,並過濾資料中的色情內容、低美感分數與近似重複(以減少訓練影像被原樣吐出)[20]。
風險與負責任的使用
白話版。 能畫出任何東西的模型,也能抄襲、強化刻板印象與欺騙。實務上的對策是量測這些行為,在資料與模型中減少它們,並為生成的影像加上標示,讓觀看的人可以查驗它們從哪裡來。
記憶與抄襲
Carlini 等人顯示,擴散模型會記住個別的訓練影像,並且可能把它們吐出來:他們用「生成後過濾」的流程,取出超過一千個訓練樣本,從個人的照片到有商標的標誌都有,並且在實驗中發現擴散模型的隱私性比 GAN 差 [63]。Somepalli 等人建立影像檢索工具,把生成影像與訓練影像做比較,發現包含 Stable Diffusion 在內的模型,有些案例複製了訓練資料的內容 [64]。對訓練資料去重 [20],以及把生成影像與訓練集比對,是標準的第一道防線。
偏見
Bianchi 等人發現,普通的提示(特質、職業、物件)會產生並放大人口統計上的刻板印象,而且在他們的測試中,反刻板印象的提示與系統的防護措施都無法消除它們 [65]。Luccioni 等人提出一種量測生成人物之社會偏見的方法:比較性別與族群字詞造成的變化,與職業造成的變化,並發現在他們測試的三個系統中,邊緣化身分的代表性不足 [66]。偏見評估需要它自己的提示與分析;整體的品質指標看不出來。另見 ML 10,資料來源、偏誤與隱私。
深偽、出處與浮水印
標示生成影像有兩種互補的工具:
- 簽章式出處證明(C2PA)。 C2PA 規格定義了出處聲明的「清單」(manifest,誰、如何製作了這份素材),它經過密碼學簽章,並綁定到素材上,綁定方式是密碼學雜湊(硬綁定),或指紋、隱形浮水印(軟綁定)[67]。有效的簽章只能證明聲明沒有被竄改;並不證明內容為真,而且存在中介資料裡的清單可以直接被移除。
- 隱形浮水印。 Tree-Ring 浮水印把一個圖樣藏在擴散取樣器初始雜訊的傅立葉轉換中,並透過反轉取樣器來偵測 [68]。Stable Signature 微調潛在解碼器,讓每張生成影像都帶有一組二元簽章,由預訓練的擷取器讀出 [69]。傳統浮水印見 IP 08。
兩者都不是完整的答案。Zhao 等人證明並展示,像素層級的隱形浮水印可以被「再生攻擊」(regeneration attack,先加雜訊,再用生成模型重建)移除 [70];Saberi 等人則指出,低擾動浮水印在「偵測不到有浮水印的影像」與「誤把真實影像標為有浮水印」之間存在根本的取捨,並展示了偽造攻擊,能讓真實影像看起來像有浮水印 [71]。要把出處證明與浮水印當成需要權衡的證據,而不是證明。
選讀:硬綁定、軟綁定與浮水印(見「補充資料」頁)。每種機制在裁切、重新編碼與中介資料被剝除之後,各自還能留下什麼。
失效模式
白話版。 今天的生成器很擅長 “a photo of X”,但在需求中精確的部分仍然不可靠:有幾個、哪個是什麼顏色、東西在哪裡、文字寫了什麼。知道典型的失敗,就知道該測什麼。
- 計數。 “Four apples” 常常得到三個或五個。GenEval 的計數任務(2、3 或 4 個物體)直接量測這點 [55]。
- 空間關係。 “A cup to the left of a laptop” 常被畫成錯誤的排列;在 GenEval 原始的研究中,最好的模型只在 15% 的影像中畫出正確的位置 [55]。
- 屬性綁定與洩漏。 在 “a red car and a blue bench” 中,顏色可能在物體之間互換,或洩漏到背景;當時 GenEval 中最好的模型,只在 35% 的影像中把屬性綁定對 [55]。Attend-and-Excite 也記載了災難性忽略(catastrophic neglect),也就是提示中的某個主體完全沒被畫出來,並在取樣時調整交叉注意力圖,讓每個主體 token 都得到注意力 [28]。
- 文字渲染。 拼錯的招牌與標籤很常見;對字元視而不見的文字編碼器是已有記載的原因之一 [26],而 Stable Diffusion 3 的消融實驗顯示,T5 編碼器對含有書面文字的提示最重要 [20]。
- 手。 生成的手常有錯誤的手指數量或不規則的形狀;HandRefiner 事後用以重建的手部網格為條件的影像修補來修復 [72]。請注意,物件層級的基準檢查不了這點:GenEval 的作者指出,他們的偵測器數得出人,卻數不出手指 [55]。
- 內容與風格的複製。 點出著名影像、產品或藝術家的提示,可能引出近乎複製的訓練內容 [64], [63]。
怎麼測試。 為每種失敗類型建立一小組提示,每個提示用固定的隨機種子生成數張影像,盡量用物件層級的工具檢查,做不到的就用眼睛看,並追蹤各模型版本之間的失敗率。
現代觀點
值得一讀的綜述。
- Zhang 等人 [73](2023)是對文字生成影像擴散模型的完整回顧:簡短介紹擴散、文字條件合成的背景、開創性系統及其改進、影像以外的應用(影片、其他模態、文字引導的編輯),以及開放的挑戰。
- Croitoru 等人 [74](IEEE TPAMI 2023)綜述視覺中的擴散模型,依公式(DDPM、分數網路、SDE)與應用(生成、超解析度、影像修補、編輯、轉換、分割)分組。
- Huang 等人 [35](IEEE TPAMI 2025)依學習策略、使用者輸入條件與編輯任務,為以擴散為基礎的影像編輯分類,特別關注影像修補與外擴,並提出一個基準(EditEval),搭配由大型多模態模型評分的指標。
- Xiong 等人 [75](TMLR 2025)綜述視覺中的自迴歸模型,依表示方式分成以像素、以 token 與以尺度為基礎的模型,並討論它們與其他生成家族的關聯,以及在影像、影片、3-D 與多模態生成上的用途。
2023–2026 年的最新進展。 (1) 採用流目標與多個文字編碼器的潛在 Transformer,成為大規模的標準做法,如 Stable Diffusion 3 [20],建立在 DiT [3] 之上。(2) 自迴歸模型回歸,靠的是更好的 tokenizer [42]、next-scale 預測 [41] 與連續 token [21]。(3) 以一個 Transformer 同時理解與生成的統一多模態模型接連出現 [43], [45], [46], [47], [44]。(4) 少步生成讓互動使用變得實際可行 [22], [38]。(5) 評估超越了 FID,走向組合式檢查 [55], [56]、學習式偏好模型 [57], [58] 與整體性基準 [59]。近期的研究也重新檢視像素空間中的生成,以及在表徵空間中的生成;見 ML 08,像素空間、潛在空間與表徵自編碼器。
尚待解決的問題。 可靠的計數、空間推理與屬性綁定;任何語言中都清晰可讀的文字;在單張影像層級上與人一致、又不能被取巧操弄的評估指標;在不損失品質的前提下防止記憶;量測並減少偏見;能撐過編輯的出處證明;訓練資料的同意與授權;以及高解析度與影片生成的成本。
選讀:Latent Diffusion、SD3(見「論文導讀」頁)。先讀潛在表示,再看 SD3 如何改變訓練路徑與多模態 Transformer。
重點整理
- 選擇生成器前,先定義條件與輸出限制。
- 生成目標與影像表示是不同選擇,系統也能結合多個家族。
- 檢查文字或空間條件如何進入模型,以及引導在推論時改變什麼。
- 注意力圖呈現內部互動,不保證物件與屬性正確綁定。
- 控制、個人化與編輯需要不同資料及計算資源。
- 結合分布、對齊、組合與人類偏好評估,並報告取樣協定與成本。
- 記憶化、偏差與來源追溯須與視覺品質分開檢查。
練習
- 對應任務。 對六種生成任務表中的每個任務,寫出對潛在文字生成影像模型而言,條件 是什麼樣的張量(形狀與型別),以及它由圖 2 流程中的哪個部分接收。
提示
提示會變成 個 token 嵌入,經由交叉注意力進入。類別標籤可以寫成文字提示,或是加到時間嵌入上的嵌入。對於影像轉影像與編輯,輸入影像會被編碼成潛在表徵,然後加雜訊到中間強度(SDEdit),或串接到去雜訊網路的輸入通道(InstructPix2Pix);控制影像經由 ControlNet 的可訓練副本進入;影像修補用的遮罩,決定哪些潛在位置要重新生成。
- 玩具範例中的忽略。 在交叉注意力程式中,加入第六個字 “dog”,它的嵌入是一個新的隨機向量,沒有任何影像區域與它相似。它的注意力圖長什麼樣子?它對其他字的權重有什麼影響?接著讓球區只像 “ball”(不像 “red”)。哪一張圖會改變?
提示
“dog” 那一行在各處都得到小而無結構的權重,因為沒有任何查詢與它的鍵匹配:沒有任何東西告訴生成器狗該放在哪裡,這正是 Attend-and-Excite 修正的情況,它在取樣時加強被忽略 token 的注意力。softmax 在每一列仍然加總為 1,所以其他字的權重會少一點。把 “red” 從球的特徵中拿掉,會讓 “red” 的圖變暗:顏色字只會注意特徵已經暗示它的地方。
- 打破指標。 擴充組合式檢查的程式,加入一個候選影像:物體正確,但藍色方塊與其中一個紅圓重疊。玩具偵測器會回報什麼?真實的偵測器式基準需要什麼才能處理它?
提示
重疊的形狀會合併成一個連通元件,所以玩具偵測器看到的物體變少,形狀也不對;即使人可能接受這張影像,精確檢查仍然會失敗。真實的基準使用實例分割,可以把重疊的物體分開,GenEval 在判斷位置時也加入了處理重疊邊界框的規則。每一種自動檢查都有這樣的盲點,這就是基準要報告與人類標註者一致程度的原因。
- 設計評估。 你必須判斷一個新模型,在「包裝上有簡短品牌名稱的產品照片」上,是否比目前的模型更好。寫出評估計畫:提示、影像數、自動指標、人類研究,以及什麼樣的結果會改變你的決定。
提示
使用固定的提示集,涵蓋不同的產品類型、文字長度與背景;每個提示用多個隨機種子;對渲染出來的文字與要求的字串做 OCR 檢查;對產品類型做物件層級檢查;用 FID 或 CMMD 對照真實產品照片來衡量真實感(固定實作與樣本數);並做盲測的並排人類比較,評估對齊與品質。事先決定你願意為多大的差異採取行動,並且針對品牌標誌,對訓練集做記憶檢查。
- 編輯後的出處證明。 一張影像帶有硬綁定的 C2PA 清單,並由帶有 Stable Signature 浮水印的模型生成。之後它被裁切、重新存成 JPEG,並上傳到一個會剝除中介資料的網站。哪些關於它來源的證據可能留下來?為什麼?
提示
清單會隨中介資料一起消失;即使保留下來,硬綁定的雜湊也不再符合裁切並重新編碼後的像素。軟綁定或穩健的隱形浮水印可以撐過適度的裁切與壓縮(Stable Signature 報告在強烈裁切之後仍能偵測),但再生攻擊可以移除像素層級的浮水印。誠實的答案是「也許浮水印還在,但清單不在」,這就是兩者被設計成配合使用的原因。
參考文獻
- T. Karras, S. Laine and T. Aila, “A Style-Based Generator Architecture for Generative Adversarial Networks,” CVPR, 2019. arXiv
- A. Brock, J. Donahue and K. Simonyan, “Large Scale GAN Training for High Fidelity Natural Image Synthesis,” ICLR, 2019. arXiv
- W. Peebles and S. Xie, “Scalable Diffusion Models with Transformers,” ICCV, 2023. CVF
- C. Saharia, W. Chan, S. Saxena et al., “Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding,” NeurIPS, 2022. arXiv · project page
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser and B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. CVF
- C. Meng, Y. He, Y. Song et al., “SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations,” ICLR, 2022. arXiv
- L. Zhang, A. Rao and M. Agrawala, “Adding Conditional Control to Text-to-Image Diffusion Models,” ICCV, 2023. CVF
- A. Hertz, R. Mokady, J. Tenenbaum et al., “Prompt-to-Prompt Image Editing with Cross-Attention Control,” ICLR, 2023. arXiv
- T. Brooks, A. Holynski and A. A. Efros, “InstructPix2Pix: Learning to Follow Image Editing Instructions,” CVPR, 2023. CVF
- A. Lugmayr, M. Danelljan, A. Romero et al., “RePaint: Inpainting using Denoising Diffusion Probabilistic Models,” CVPR, 2022. CVF
- J. Ho and T. Salimans, “Classifier-Free Diffusion Guidance,” NeurIPS 2021 Workshop on Deep Generative Models and Downstream Applications; arXiv:2207.12598, 2022. arXiv
- I. J. Goodfellow, J. Pouget-Abadie, M. Mirza et al., “Generative Adversarial Nets,” NeurIPS, 2014. arXiv
- D. P. Kingma and M. Welling, “Auto-Encoding Variational Bayes,” ICLR, 2014. arXiv
- A. van den Oord, O. Vinyals and K. Kavukcuoglu, “Neural Discrete Representation Learning,” NeurIPS, 2017. arXiv
- P. Esser, R. Rombach and B. Ommer, “Taming Transformers for High-Resolution Image Synthesis,” CVPR, 2021. CVF
- J. Ho, A. Jain and P. Abbeel, “Denoising Diffusion Probabilistic Models,” NeurIPS, 2020. arXiv
- P. Dhariwal and A. Nichol, “Diffusion Models Beat GANs on Image Synthesis,” NeurIPS, 2021. arXiv
- Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel and M. Le, “Flow Matching for Generative Modeling,” ICLR, 2023. arXiv
- X. Liu, C. Gong and Q. Liu, “Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow,” ICLR, 2023. arXiv
- P. Esser, S. Kulal, A. Blattmann et al., “Scaling Rectified Flow Transformers for High-Resolution Image Synthesis,” ICML, PMLR 235, 2024. arXiv
- T. Li, Y. Tian, H. Li, M. Deng and K. He, “Autoregressive Image Generation without Vector Quantization,” NeurIPS, 2024. arXiv
- A. Sauer, D. Lorenz, A. Blattmann and R. Rombach, “Adversarial Diffusion Distillation,” ECCV, LNCS, pp. 87–103, 2024. doi · arXiv
- A. Radford, J. W. Kim, C. Hallacy et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML, PMLR 139, 2021. arXiv
- C. Raffel, N. Shazeer, A. Roberts et al., “Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer,” Journal of Machine Learning Research, vol. 21, 2020. arXiv
- D. Podell, Z. English, K. Lacey et al., “SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis,” ICLR, 2024. arXiv
- R. Liu, D. Garrette, C. Saharia et al., “Character-Aware Models Improve Visual Text Rendering,” ACL, 2023. ACL Anthology
- A. Ramesh, P. Dhariwal, A. Nichol, C. Chu and M. Chen, “Hierarchical Text-Conditional Image Generation with CLIP Latents,” arXiv:2204.06125, 2022. arXiv
- H. Chefer, Y. Alaluf, Y. Vinker, L. Wolf and D. Cohen-Or, “Attend-and-Excite: Attention-Based Semantic Guidance for Text-to-Image Diffusion Models,” ACM Transactions on Graphics, vol. 42, no. 4 (SIGGRAPH), 2023. doi · arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” MICCAI, 2015. arXiv
- J. Yu, Y. Xu, J. Y. Koh et al., “Scaling Autoregressive Models for Content-Rich Text-to-Image Generation,” Transactions on Machine Learning Research, 2022. arXiv
- H. Chang, H. Zhang, J. Barber et al., “Muse: Text-To-Image Generation via Masked Generative Transformers,” ICML, PMLR 202, 2023. arXiv
- R. Gal, Y. Alaluf, Y. Atzmon et al., “An Image is Worth One Word: Personalizing Text-to-Image Generation using Textual Inversion,” ICLR, 2023. arXiv
- N. Ruiz, Y. Li, V. Jampani, Y. Pritch, M. Rubinstein and K. Aberman, “DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation,” CVPR, 2023. CVF
- E. J. Hu, Y. Shen, P. Wallis et al., “LoRA: Low-Rank Adaptation of Large Language Models,” ICLR, 2022. arXiv
- Y. Huang, J. Huang, Y. Liu et al., “Diffusion Model-Based Image Editing: A Survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2025. doi · arXiv
- J. Song, C. Meng and S. Ermon, “Denoising Diffusion Implicit Models,” ICLR, 2021. arXiv
- T. Salimans and J. Ho, “Progressive Distillation for Fast Sampling of Diffusion Models,” ICLR, 2022. arXiv
- Y. Song, P. Dhariwal, M. Chen and I. Sutskever, “Consistency Models,” ICML, PMLR 202, 2023. arXiv
- P. Sun, Y. Jiang, S. Chen et al., “Autoregressive Model Beats Diffusion: Llama for Scalable Image Generation,” arXiv:2406.06525, 2024. arXiv
- H. Chang, H. Zhang, L. Jiang, C. Liu and W. T. Freeman, “MaskGIT: Masked Generative Image Transformer,” CVPR, 2022. CVF
- K. Tian, Y. Jiang, Z. Yuan, B. Peng and L. Wang, “Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction,” NeurIPS, 2024. arXiv
- L. Yu, J. Lezama, N. B. Gundavarapu et al., “Language Model Beats Diffusion — Tokenizer is Key to Visual Generation,” ICLR, 2024. arXiv
- Chameleon Team, “Chameleon: Mixed-Modal Early-Fusion Foundation Models,” arXiv:2405.09818, 2024. arXiv
- X. Wang, Y. Cui, J. Wang et al., “Multimodal learning with next-token prediction for large multimodal models,” Nature, vol. 650, pp. 327–333, 2026 (preprint “Emu3: Next-Token Prediction is All You Need,” 2024). doi · arXiv
- C. Zhou, L. Yu, A. Babu et al., “Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model,” ICLR, 2025. arXiv
- J. Xie, W. Mao, Z. Bai et al., “Show-o: One Single Transformer to Unify Multimodal Understanding and Generation,” ICLR, 2025. arXiv
- C. Wu, X. Chen, Z. Wu et al., “Janus: Decoupling Visual Encoding for Unified Multimodal Understanding and Generation,” CVPR, 2025. CVF
- T.-Y. Lin, M. Maire, S. Belongie et al., “Microsoft COCO: Common Objects in Context,” ECCV, 2014. arXiv
- M. J. Chong and D. Forsyth, “Effectively Unbiased FID and Inception Score and Where to Find Them,” CVPR, 2020. arXiv
- G. Parmar, R. Zhang and J.-Y. Zhu, “On Aliased Resizing and Surprising Subtleties in GAN Evaluation,” CVPR, 2022. CVF
- T. Kynkäänniemi, T. Karras, M. Aittala, T. Aila and J. Lehtinen, “The Role of ImageNet Classes in Fréchet Inception Distance,” ICLR, 2023. arXiv
- G. Stein, J. C. Cresswell, R. Hosseinzadeh et al., “Exposing Flaws of Generative Model Evaluation Metrics and Their Unfair Treatment of Diffusion Models,” NeurIPS, 2023. arXiv
- S. Jayasumana, S. Ramalingam, A. Veit, D. Glasner, A. Chakrabarti and S. Kumar, “Rethinking FID: Towards a Better Evaluation Metric for Image Generation,” CVPR, 2024. CVF
- J. Hessel, A. Holtzman, M. Forbes, R. Le Bras and Y. Choi, “CLIPScore: A Reference-free Evaluation Metric for Image Captioning,” EMNLP, 2021. ACL Anthology
- D. Ghosh, H. Hajishirzi and L. Schmidt, “GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment,” NeurIPS Datasets and Benchmarks Track, 2023. arXiv
- K. Huang, K. Sun, E. Xie, Z. Li and X. Liu, “T2I-CompBench: A Comprehensive Benchmark for Open-world Compositional Text-to-image Generation,” NeurIPS Datasets and Benchmarks Track, 2023. proceedings
- J. Xu, X. Liu, Y. Wu et al., “ImageReward: Learning and Evaluating Human Preferences for Text-to-Image Generation,” NeurIPS, 2023. arXiv
- Y. Kirstain, A. Polyak, U. Singer et al., “Pick-a-Pic: An Open Dataset of User Preferences for Text-to-Image Generation,” NeurIPS, 2023. arXiv
- T. Lee, M. Yasunaga, C. Meng et al., “Holistic Evaluation of Text-To-Image Models,” NeurIPS Datasets and Benchmarks Track, 2023. arXiv
- J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li and L. Fei-Fei, “ImageNet: A Large-Scale Hierarchical Image Database,” CVPR, 2009. doi
- C. Schuhmann, R. Beaumont, R. Vencu et al., “LAION-5B: An Open Large-Scale Dataset for Training Next Generation Image-Text Models,” NeurIPS Datasets and Benchmarks Track, 2022. arXiv
- A. Birhane, V. U. Prabhu and E. Kahembwe, “Multimodal datasets: misogyny, pornography, and malignant stereotypes,” arXiv:2110.01963, 2021. arXiv
- N. Carlini, J. Hayes, M. Nasr et al., “Extracting Training Data from Diffusion Models,” USENIX Security Symposium, 2023. USENIX · arXiv
- G. Somepalli, V. Singla, M. Goldblum, J. Geiping and T. Goldstein, “Diffusion Art or Digital Forgery? Investigating Data Replication in Diffusion Models,” CVPR, 2023. CVF
- F. Bianchi, P. Kalluri, E. Durmus et al., “Easily Accessible Text-to-Image Generation Amplifies Demographic Stereotypes at Large Scale,” ACM FAccT, 2023. doi
- A. S. Luccioni, C. Akiki, M. Mitchell and Y. Jernite, “Stable Bias: Analyzing Societal Representations in Diffusion Models,” NeurIPS Datasets and Benchmarks Track, 2023. arXiv
- Coalition for Content Provenance and Authenticity (C2PA), “C2PA Technical Specification,” version 2.1, 2024. specification
- Y. Wen, J. Kirchenbauer, J. Geiping and T. Goldstein, “Tree-Ring Watermarks: Fingerprints for Diffusion Images that are Invisible and Robust,” NeurIPS, 2023. arXiv
- P. Fernandez, G. Couairon, H. Jégou, M. Douze and T. Furon, “The Stable Signature: Rooting Watermarks in Latent Diffusion Models,” ICCV, 2023. CVF
- X. Zhao, K. Zhang, Z. Su et al., “Invisible Image Watermarks Are Provably Removable Using Generative AI,” NeurIPS, 2024. arXiv
- M. Saberi, V. S. Sadasivan, K. Rezaei et al., “Robustness of AI-Image Detectors: Fundamental Limits and Practical Attacks,” ICLR, 2024. arXiv
- W. Lu, Y. Xu, J. Zhang, C. Wang and D. Tao, “HandRefiner: Refining Malformed Hands in Generated Images by Diffusion-based Conditional Inpainting,” ACM Multimedia, 2024, pp. 7085–7093. doi
- C. Zhang, C. Zhang, M. Zhang, I. S. Kweon and J. Kim, “Text-to-image Diffusion Models in Generative AI: A Survey,” arXiv:2303.07909, 2023. arXiv
- F.-A. Croitoru, V. Hondru, R. T. Ionescu and M. Shah, “Diffusion Models in Vision: A Survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023. doi
- J. Xiong, G. Liu, L. Huang et al., “Autoregressive Models in Vision: A Survey,” Transactions on Machine Learning Research, 2025. arXiv
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 12A・影片生成 · 38 分鐘