DLCV 09B・生成式影像復原:取樣出一個合理的答案
先備知識:DLCV 09・深度影像復原:低階視覺、ML 07・生成模型:自編碼器、VAE、GAN 與正規化流
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 說明平方誤差復原為何平均不確定細節。
- 區分合理後驗樣本與忠實還原。
- 比較 GAN 先驗、條件擴散與預訓練先驗的反問題求解器。
- 用可執行的簡例追蹤先驗引導與量測一致性。
- 評估隨機性、幻覺與完整推論成本。
先看全貌
DLCV 09 訓練的復原網路,目標是平均而言接近乾淨影像。損傷輕微時這樣做很有效。但損傷若抹掉了大量資訊(寬度只有 16 像素的人臉、壓縮得很重的照片、一大塊缺洞),「平均而言接近」就會給出平滑、像蠟像一樣的猜測。生成式復原換了一種立場:既然有許多乾淨影像都與輸入相符,那就從中挑一張,並確保它看起來像真實的照片。
為什麼重要:近年最讓人信服的真實世界超解析度,以及人臉與老照片復原,都來自生成模型,先是 GAN,約從 2021 年起則是擴散模型。同樣的技術也被用在醫學與科學的逆問題上,在那裡,捏造出來的細節可能造成實際的傷害。所以你需要同時具備兩種能力:知道這些方法怎麼運作,也知道怎麼衡量它們捏造了什麼。
本篇的位置。 本篇建立在 DLCV 09 的退化模型、損失函數與評估指標,以及 ML 07 的生成模型之上;擴散與流匹配在 ML 08 推導,這裡只拿來使用。超解析度有自己的篇章(DLCV 09A 談影像、DLCV 09A.3 談影片),在這裡只當作範例。所有程式碼都用 NumPy 與 SciPy,在 CPU 上幾秒內就能跑完,用的是答案已知的玩具問題,所以每項說法都可以驗證。
為什麼迴歸會模糊:後驗平均
白話版。 平方誤差訓練偏向條件平均;當多種清晰結構都能解釋相同輸入,其平均可能模糊。
一個輸入,許多答案
像 DLCV 09 那樣,把量測寫成 。對於超解析度、去模糊、影像修補或重度壓縮, 都會丟掉資訊,所以有一整組乾淨影像 都幾乎同樣好地解釋同一個 。用貝氏的語言來說,看到 之後仍然剩下的不確定性,就是後驗分布(posterior distribution)
其中 是先驗(prior;在看到 之前一張影像有多可能:自然影像很可能,雜訊不可能), 是概似(likelihood; 對量測的解釋有多好,若是標準差為 的 Gaussian 雜訊,它正比於 ),而 是不依賴 的正規化常數。損傷輕微時,後驗很窄,每個合理的方法都會得到相同的結果。損傷嚴重時,後驗很寬,常常有好幾個分離的眾數(mode),例如「邊緣在這裡」或「邊緣再往右兩個像素」。
數學:平方誤差的最小值就是後驗平均
復原網路 用成對資料 以平方誤差訓練,是在資料分布上最小化期望損失 。對每個固定的 ,最佳輸出 要最小化
其中期望是對後驗 取的, 是後驗平均。第二項不依賴 (它是無法消除的不確定性),所以最小值出現在
這就是最小均方誤差(minimum mean squared error, MMSE)估計量。夠大的網路訓練得夠久,就會逼近它。(L1 損失得到的則是逐像素的後驗中位數:有時比較銳利,但仍是一個像素一個像素地決定,而不是一張連貫的影像;DLCV 09 比較了各種損失。)如果用 MSE 或 PSNR 來打分,後驗平均就是正確答案;如果你要的是看起來真實的影像,它就是錯誤答案:把邊緣位置各不相同的影像平均起來,得到的影像根本沒有銳利的邊緣。
程式:平均很模糊、每個樣本都很銳利的玩具問題
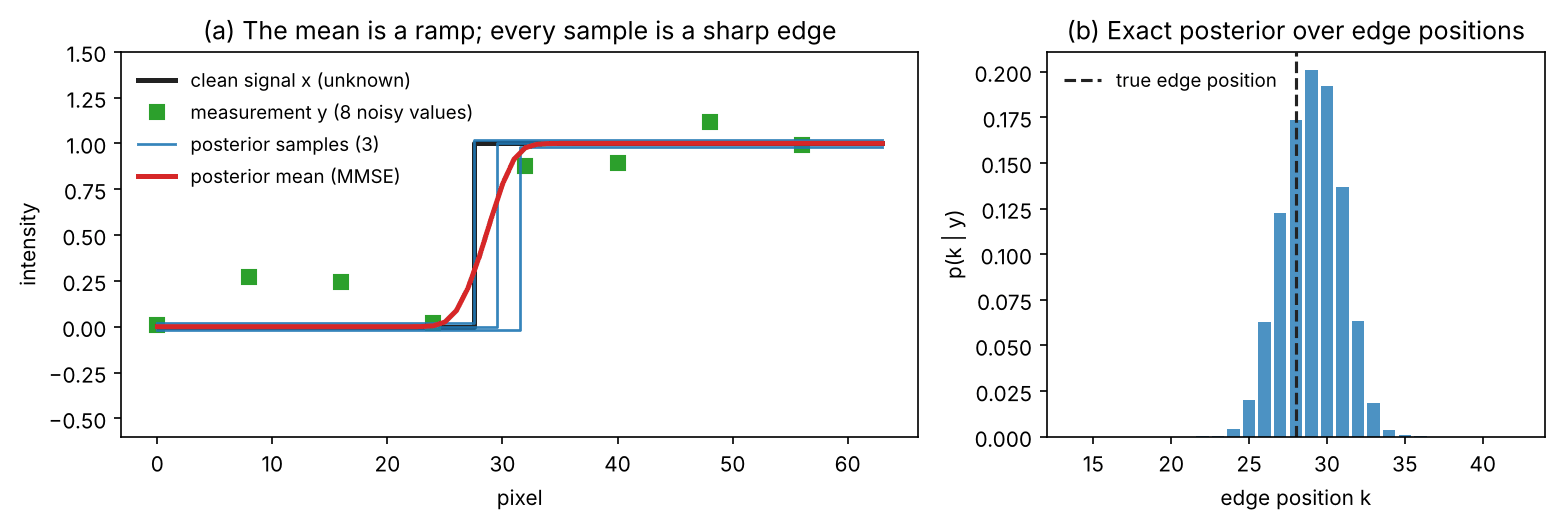
我們需要一個能精確算出後驗的問題。這裡的乾淨「影像」是 64 個像素的一維訊號,帶有一個階梯邊緣(左邊是 0,右邊是 1),邊緣位置在第 8 到第 55 個像素之間、未知,且每個位置的機率相同。退化是:用標準差 3 個像素的 Gaussian 模糊,每 8 個像素只保留 1 個,再加上標準差 0.2 的 Gaussian 雜訊。乾淨訊號只有 48 種可能,所以後驗就是一份精確的 48 個機率的清單。
程式碼 · Python · 37 行
import numpy as np
from scipy.ndimage import gaussian_filter1d
from scipy.stats import wasserstein_distance

rng = np.random.default_rng(0)
n, factor, sigma = 64, 8, 0.2
positions = np.arange(8, 56)                                     # where the edge may be
X = (np.arange(n)[None, :] >= positions[:, None]).astype(float)  # every possible clean signal
A = lambda x: gaussian_filter1d(x, 3.0, axis=-1, mode="nearest")[..., ::factor]  # blur, keep 1 of 8
AX = A(X)                                                        # every candidate, degraded

def posterior(y):
    """Exact p(edge position | y): uniform prior, Gaussian noise of std sigma."""
    logp = -np.sum((y - AX) ** 2, axis=1) / (2 * sigma**2)
    p = np.exp(logp - logp.max())
    return p / p.sum()

truth, mean, post, prior = [], [], [], []
for _ in range(2000):
    x = X[rng.integers(len(positions))]
    y = A(x) + sigma * rng.standard_normal(n // factor)
    p = posterior(y)
    truth.append(x)
    mean.append(p @ X)                                           # posterior mean (MMSE)
    post.append(X[rng.choice(len(positions), p=p)])              # a sample from p(x | y)
    prior.append(X[rng.integers(len(positions))])                # a sample that ignores y
truth = np.array(truth)

for name, est in [("posterior mean", mean), ("posterior sample", post), ("prior sample", prior)]:
    est = np.array(est)
    mse = np.mean((est - truth) ** 2)
    w1 = wasserstein_distance(est.ravel(), truth.ravel())        # pixel values like real ones?
    jump = np.abs(np.diff(est, axis=1)).max(axis=1).mean()       # sharpest step (real: 1.0)
    print(f"{name:16s} MSE {mse:.4f} | W1 {w1:.4f} | largest step {jump:.2f}")
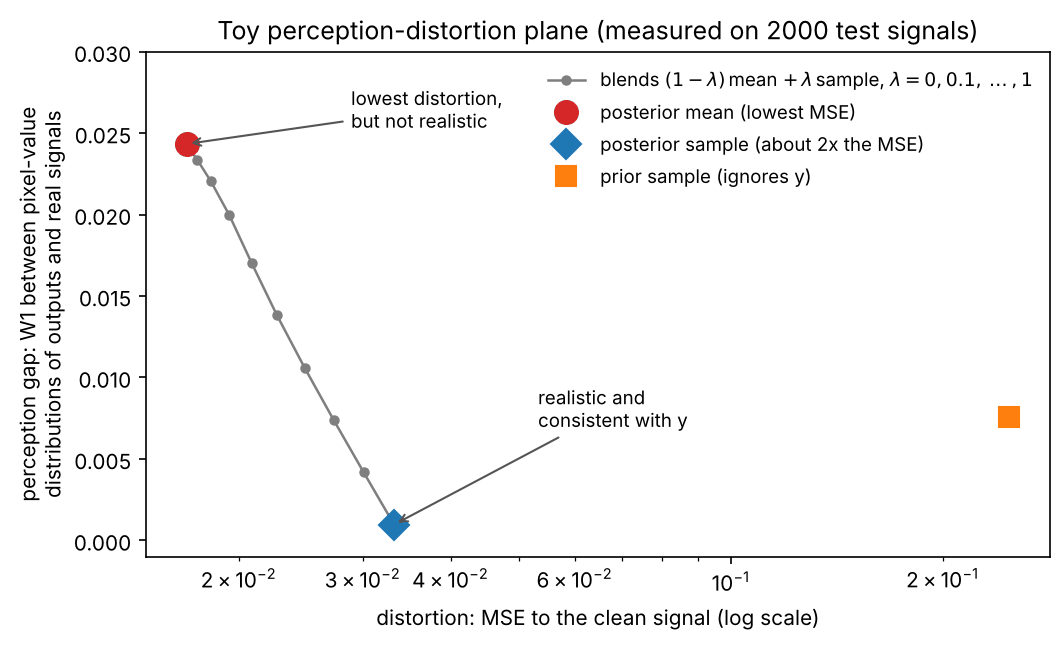
# posterior mean   MSE 0.0169 | W1 0.0243 | largest step 0.22
# posterior sample MSE 0.0333 | W1 0.0010 | largest step 1.00
# prior sample     MSE 0.2485 | W1 0.0076 | largest step 1.00
我們在 2,000 個隨機測試訊號上比較三種估計量。各欄分別是:與乾淨訊號的 MSE;一個粗略的「逼真度」分數,也就是輸出像素值的分布與真實像素值的分布之間的一維 Wasserstein 距離 W1(真實訊號只含 0 與 1,所以介於中間的灰階值是不真實的);以及輸出中最銳利階梯的高度(每個真實訊號都是 1.0)。本篇程式碼區塊裡的所有數字,都來自我們自己的執行結果。
- 後驗平均的 MSE 最低,但它最銳利的階梯平均只有 0.22:它是一條斜坡,不是邊緣,而且它的灰階值使它在統計上不像任何真實訊號。
- 後驗樣本是一個真正的邊緣(階梯 1.00,W1 接近零),放在資料允許的位置上。它的 MSE 是 0.0333,幾乎恰好是後驗平均 0.0169 的兩倍。這個兩倍不是巧合(見下一節)。
- 先驗樣本不理會 。它完全逼真,卻毫無用處:它的 MSE 差了大約 15 倍。光有逼真度不等於復原。(它的 W1 是 0.0076 而不是 0,來自 2,000 個訊號的測試所含的取樣雜訊。)
「生成式」復原是什麼意思
白話版。 生成式復原器選擇一個合理答案;理想後驗取樣器在反覆取樣下,應呈現給定輸入的條件不確定性。
精確版。 生成式(或稱隨機性、後驗取樣)復原模型是一個隨機映射:給定 和一個隨機種子 ,它傳回 ,且在 固定時,其分布應該逼近 。本篇的每個方法都有三個要素:
- 先驗 ,也就是自然影像的分布,由生成模型(GAN、擴散模型、流、碼本)學得。
- 概似或資料一致性項,把輸出與輸入綁在一起,可以是明確的(已知 時用 ),也可以是隱含的(給網路看 ,再用成對資料訓練)。
- 產生樣本的方法:生成器的一次前向傳遞,或取樣器的許多個步驟。
有一個方便的恆等式把這三者連起來。對貝氏定理取對數、再對 取梯度,常數 就消失了:
其中 是先驗的分數(score;一個指向更可能的影像的向量場), 是概似的梯度(指向更能解釋 的影像)。所以每一個「沿著上坡方向走,再加上雜訊」的取樣器,都可以拆成先驗的推力與資料的推力。這個拆法是下面零樣本擴散復原的骨幹。
建構這類復原模型有兩大類做法:
- 直接學習後驗(監督式):像條件式 GAN 與條件式擴散模型那樣,用成對資料 訓練條件式生成器。不必把 寫出來,但遇到新的退化就需要重新訓練。
- 把先驗與已知的概似結合(零樣本):只用乾淨影像訓練一次無條件的生成模型,測試時再用 和 來引導它的取樣器,GAN 反演與 DPS 這類方法就是這樣做的。一個模型可以服務許多任務,但必須知道 ,而且取樣通常比較慢。
感知–失真權衡
白話版。 逼真樣本會對不確定細節作出選擇。在理想精確後驗假設下,取樣的期望 MSE 是最佳平均估計器的兩倍;學得的生成器沒有此保證。
精確版。 Blau 與 Michaeli [1] 對任何由 輸出 的復原方法,定義它的失真(distortion)為 ,其中 是任何逐影像的失真度量,例如平方誤差;並把它的感知品質(perceptual quality)定義為真實影像分布 與復原影像分布 之間的某個散度 (為零表示輸出在統計上與真實影像無法區分,例如連完美的判別器也分不出來)。感知–失真函數為
其中最小值是對所有(可能帶有隨機性的)復原方法 取的, 是失真預算。他們證明 是不遞增的,而且當 對第二個引數為凸函數時,它也是凸的 [1]。因此,在(失真、感知)平面的原點附近有一塊達不到的區域:把失真壓得超過某個點,就會迫使輸出偏離真實影像的分布。他們也證明這對任何失真度量都成立,不只是 MSE。
曲線上有兩個點最重要。令 是最低可能的失真(對平方誤差來說由 MMSE 估計量達成), 是在感知品質完美()時能達到的最低失真。對平方誤差,論文證明了(在其 arXiv 延伸版 [1] 中)
而且這個界可以由後驗取樣 達到。以 PSNR 來說,完美的逼真度所需付出的代價,絕不會超過大約 3 dB,因為 。這正是我們玩具問題中的兩倍(0.0333 對 0.0169)。論文也指出這個界不一定是緊的:有些問題讓完美的逼真度所花的代價低於 MMSE 的兩倍。
選讀:為什麼後驗取樣恰好讓 MSE 變成兩倍(見「補充資料」頁)。用四行證明這個兩倍。
圖 2 把玩具問題中的各個估計量放在這個平面上。在後驗平均與後驗樣本之間,我們也畫出簡單的混合 ,這是在兩者之間做取捨的一個簡單方法。它們的期望 MSE 是 ,因為後驗樣本與平均的偏差,和真值與平均的偏差互不相關,所以 得到兩倍。這些混合只是一條可以達到的路徑;真正的界 可能在它下方。
這在實務上的意義是:
- 方法是一個點,不是一個分數。 要同時報告一個失真指標(PSNR、SSIM)以及一個感知指標,並說明你的方法瞄準哪一個點。只用 PSNR 來比較 GAN 復原模型和 MSE 復原模型,是在比較兩個不同的目標。
- 「PSNR 更好、而且更逼真」只可能出現在離界線很遠的方法上。 一旦方法接近曲線,就只能沿著曲線移動。
- 許多生成式復原模型都提供一個旋鈕,可以沿著曲線滑動:GAN 損失的權重、CodeFormer [10] 的保真度權重、StableSR [24] 的特徵包裝純量、DiffBIR [25] 的引導強度。選擇旋鈕,就是選擇權衡曲線上的一個點。
選讀:Blau 與 Michaeli:The Perception-Distortion Tradeoff(CVPR 2018)(見「論文導讀」頁)。怎麼讀它的定理和超解析度比較。
第一族:以 GAN 為基礎的復原與 GAN 先驗
白話版。 GAN 加進了一位看過大量真實照片的評論者,只要復原影像看起來是假的,它就會抱怨。復原模型學著產生評論者能接受的輸出,這就把它從模糊的平均推向逼真的紋理。第二個想法是重複利用一個本來就是為了生成人臉或場景而訓練好的 GAN:復原就變成「找出這個生成器能畫出、又與受損輸入相符的那張影像」。
對抗損失與感知損失
第一條路線維持監督式訓練,只改變損失(公式見 DLCV 09)。SRGAN [2] 把對抗損失和預訓練 VGG 特徵上的損失結合起來,沿用 Johnson 等人 [3] 的感知損失想法;ESRGAN [4] 改進了生成器與判別器;Real-ESRGAN [5] 用豐富的合成退化流程為真實照片訓練這類模型(DLCV 09A 有詳細介紹)。用本篇的說法,總損失
有一個像素項 (可分離的 L1 以逐座標後驗中位數為目標;平方 L2 以後驗平均為目標)、一個特徵項 (比對深層特徵,能容許小幅位移)、以及一個對抗項 (把輸出分布拉向真實影像),權重為 。Blau 與 Michaeli 指出,對抗項近似的是一個散度 ,所以最小化這個損失,就是感知–失真問題的拉格朗日(Lagrangian)形式,而改變 就是沿著曲線移動 [1]。
有兩點要注意。第一,大多數這類網路是決定性的,所以它們給的是一個合理的答案,而不是機率正確的樣本。第二,GAN 的訓練可能發生模式崩塌(ML 07),而且對抗項會獎勵判別器喜歡的任何紋理,包括場景中從未出現過的紋理。
預訓練 GAN 當作影像先驗
第二條路線把「影像長什麼樣子」和「這個輸入說了什麼」分開。在乾淨影像上訓練好的 GAN 生成器 (例如在人臉上訓練的 StyleGAN [6]),把潛在碼 對應到影像 。它的輸出構成一個學得的影像流形(image manifold):復原就可以在這個流形上搜尋與 相符的影像。
以最佳化進行 GAN 反演。 求解
其中 讓 留在生成器訓練時所見的區域內, 是它的權重。不必為每個任務訓練任何東西,而且 可以是任何可微分的退化。PULSE [7] 用這個做法做人臉超解析度,在 StyleGAN 的潛在空間裡搜尋縮小後會等於輸入的人臉;不同的隨機起點會得到不同的人臉,而且全都吻合,這直接呈現了「許多個答案」。
把生成器放進前向網路裡。 為了避免每張影像都要做一次最佳化,GLEAN [8] 與 GFP-GAN [9] 把一個預訓練並凍結的 GAN 放在編碼器–解碼器之中:編碼器讀取受損影像,生成器提供逼真的特徵,一次前向傳遞就得到結果。CodeFormer [10] 則改用學得的人臉部件離散碼本,取代 GAN 的潛在空間,並且有一個在測試時以保真度換品質的旋鈕。
選讀:以 GAN 為先驗的復原方法詳解(見「補充資料」頁)。PULSE、GLEAN、GFP-GAN 與 CodeFormer 如何使用它們的先驗,並附一個二維反演玩具問題。
長處與限制。 GAN 先驗在生成器很好的窄領域(例如對齊過的人臉)中,一次前向傳遞就能給出銳利而逼真的結果。但它們只能產生生成器所能產生的東西:和訓練用人臉不像的輸入,會被拉向「典型」的人臉,這是保真度與公平性的問題,PULSE 的作者也明確討論了這類偏差 [7]。一篇擴散復原的綜述 [44] 指出,訓練不穩定與紋理看起來假,是以 GAN 為基礎的復原最主要的兩個弱點,這也是接下來擴散先驗的動機之一。Xia 等人的綜述 [47] 回顧了 GAN 反演及其在復原與編輯上的應用。
第二族:以擴散模型為先驗
白話版。 擴散模型是一個在每個雜訊程度上都訓練過的去雜訊器。從純雜訊出發,一次去掉一點雜訊,就能把雜訊變成逼真的影像。用在復原上,我們有兩種做法:要嘛教去雜訊器在去雜訊的同時看著受損的輸入(條件式擴散),要嘛拿一個只認得乾淨影像的去雜訊器,在每一小步去雜訊之後,輕推目前的猜測,讓它與受損輸入相符(零樣本後驗取樣)。
一頁看懂擴散
完整的推導在 ML 08;我們只需要四個事實,採用變異數保持(variance-preserving)的 DDPM 慣例 [11]。
前向加噪。 對乾淨影像 與步數 ,
其中 沿著選定的排程,從約 1(幾乎乾淨)遞減到約 0(純雜訊), 是標準 Gaussian 雜訊。
去雜訊器就是分數估計器。 一個訓練來由 預測 的網路,會給出雜訊分布 的分數:(ML 08)[12]。
Tweedie 公式 [13] 把分數轉成乾淨影像的估計,
其中 是給定雜訊影像時乾淨影像的後驗平均,所以當 很大時它是模糊的,正如第一節所說。
取樣。 從 出發,反覆從一個中心位於 與 之間、變異數小而已知的 Gaussian 抽出 (ML 08)。每一步花一次網路呼叫;經典的取樣器要用到數百步。用分數網路的退火 Langevin 動力學 [48],以及連續時間的 SDE 觀點 [12],則是用別的說法描述同一個想法。
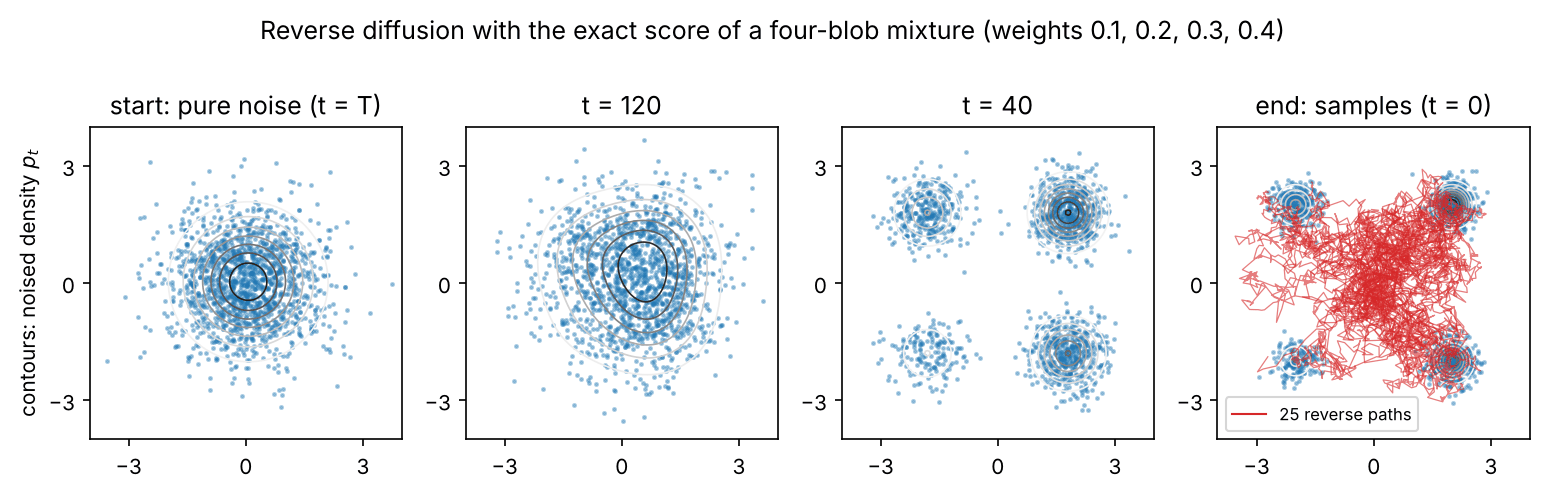
程式:用精確分數做擴散。 影像尺度的擴散需要訓練好的網路。在二維玩具問題上,我們可以略過網路:如果「影像」分布是 Gaussian 的混合,每個加噪後的邊際分布 仍是 Gaussian 的混合,它的分數有封閉形式。下面的先驗有四個團塊,權重為 0.1、0.2、0.3、0.4,標準差為 0.3。
程式碼 · Python · 40 行
import numpy as np

rng = np.random.default_rng(1)
mu = np.array([[-2.0, -2.0], [-2.0, 2.0], [2.0, -2.0], [2.0, 2.0]])  # a 2-D "image" prior:
w = np.array([0.1, 0.2, 0.3, 0.4])                                   # four Gaussian blobs
s2 = 0.3**2                                                          # each with variance s2 * I

T = 200
beta = np.linspace(1e-4, 0.05, T)
alpha = 1 - beta
abar = np.cumprod(alpha)

def score(x, ab):
    """Exact grad log p_t(x) of the noised mixture, plus responsibilities r."""
    m, v = np.sqrt(ab) * mu, ab * s2 + (1 - ab)            # component k at time t: N(m_k, v I)
    d2 = ((x[:, None, :] - m[None]) ** 2).sum(-1)         # (N, K) squared distances
    logr = np.log(w) - d2 / (2 * v)
    r = np.exp(logr - logr.max(1, keepdims=True)); r /= r.sum(1, keepdims=True)
    return (r[:, :, None] * (m[None] - x[:, None, :])).sum(1) / v, r

def x0_hat(x, ab):                                         # Tweedie: E[x_0 | x_t]
    return (x + (1 - ab) * score(x, ab)[0]) / np.sqrt(ab)

def ddpm_step(x, t, x0):
    """Sample x_{t-1} from the Gaussian q(x_{t-1} | x_t, x_0 = x0)."""
    ab_prev = abar[t - 1] if t > 0 else 1.0
    mean = (np.sqrt(ab_prev) * beta[t] * x0 + np.sqrt(alpha[t]) * (1 - ab_prev) * x) / (1 - abar[t])
    var = beta[t] * (1 - ab_prev) / (1 - abar[t])
    return mean + np.sqrt(var) * rng.standard_normal(x.shape)

x = rng.standard_normal((4000, 2))                         # start from pure noise
for t in reversed(range(T)):
    x = ddpm_step(x, t, x0_hat(x, abar[t]))
_, r = score(x, 1.0)
print("signal left at t=T:", round(abar[-1], 5))
print("fraction per blob :", np.bincount(r.argmax(1), minlength=4) / len(x), "(target", w, ")")
print("spread inside blob:", round(float(np.sqrt(((x - mu[r.argmax(1)]) ** 2).mean())), 3), "(target 0.3)")
# signal left at t=T: 0.00612
# fraction per blob : [0.09675 0.2005  0.3075  0.39525] (target [0.1 0.2 0.3 0.4] )
# spread inside blob: 0.283 (target 0.3)
取樣器重現的團塊權重,誤差在取樣誤差之內。每個團塊內部的散布是 0.283,而不是 0.3:只有 200 個粗略的步驟時,反向過程會稍微太窄(用 1,000 個較小的步驟時,我們量到 0.296)。這是關於步數的第一個教訓:步數少比較便宜,但比較不精確。圖 3 顯示粒子雲從雜訊收縮成四個團塊的過程。
路線 A:訓練條件式擴散復原模型
最直接的做法,是讓去雜訊器看到輸入:用成對資料訓練 ,於是取樣器抽出的樣本逼近 。SR3 [14] 把這個做法用在超解析度:把放大後的低解析度影像和雜訊影像一起交給 U-Net,取樣時從純雜訊一步一步精修。在論文針對 人臉超解析度所做的人類研究中,受測者被 SR3 騙過的比例接近 50%,GAN 基準方法則至多是 34% [14]。Palette [15] 把同一套做法用在上色、影像修補、擴圖(uncropping)與 JPEG 復原上,並顯示單一多任務模型可以追上各任務專用的模型。
條件式模型需要成對資料,而且每一類退化都要重新訓練,不過它們能處理雜訊,也能處理難以寫成算子的退化(相機處理流程、壓縮)。從純雜訊開始,會浪費步數去重新製造 本來就有的東西;ResShift [16] 則建立一條在高解析度與低解析度影像之間、靠位移其殘差來移動的鏈,據報告只用 15 個取樣步驟就得到有競爭力的結果。
路線 B:用預訓練模型做零樣本後驗取樣
白話版。 只用乾淨影像訓練一個無條件的擴散模型。要復原時,照常執行它的取樣器,但每走一步,就拿目前的乾淨影像猜測和輸入核對,並稍微修正一下。模型貢獻的是「看起來真實」,修正貢獻的是「與我們量測到的相符」。
精確版。 把上一節的分數恆等式用在雜訊變數 上:
其中第一項是預訓練模型的分數,第二項是雜訊概似(noisy likelihood):雜訊狀態 對 的解釋有多好。第一項我們已經有了。第二項是難處,因為 取決於乾淨影像,而
是把概似對所有可能產生 的乾淨影像取平均,對影像尺度的模型來說這是算不出來的。各種方法的差別主要就在於如何近似這一項,而它們最後都落到同一個迴圈(圖 4):先驗步驟(用預訓練模型做一步反向擴散),以及資料一致性步驟(朝 的方向做梯度步驟、投影或封閉形式的修正)。
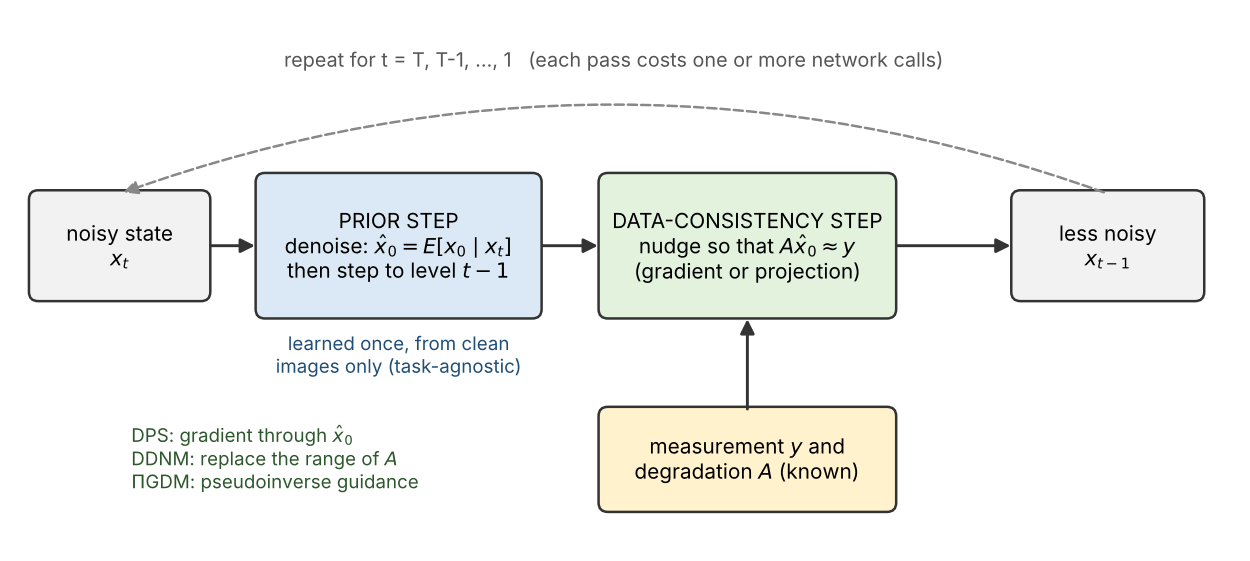
DPS(diffusion posterior sampling)[17] 是最容易說明的。它把對 的平均換成它的平均值,即 。在 Gaussian 雜訊下,這給出資料步驟
其中 是一般先驗步驟的結果, 是步長;論文使用 , 為常數。梯度要穿過 ,所以每一步都需要透過去雜訊器做反向傳播。由於它從不精確地投影到量測上,DPS 也適用於含雜訊與非線性的退化(論文包含 Poisson 雜訊、Fourier 相位還原與非均勻去模糊)。
其他成員主要在資料步驟上有所不同:
- DDRM(denoising diffusion restoration models)[18] 在退化算子奇異值分解的座標下處理線性退化,對有量測到與沒量測到的座標採取不同的處理;不需反向傳播,步數也少。
- DDNM(denoising diffusion null-space model)[19] 把 中由量測決定的部分直接從資料複製過來,即 ( 是線性算子 的偽逆),只在量測看不到的部分保留模型的猜測。
- ΠGDM(pseudoinverse-guided diffusion models)[20] 用退化算子的偽逆,加上對 的明確不確定性來建構引導;它會透過去雜訊器反向傳播,但不透過退化算子反向傳播,所以也涵蓋像 JPEG 這樣不可微分的量測。
- DiffPIR [21] 把即插即用的分裂法(輪流做資料步驟與去雜訊步驟,如 DLCV 09 所述)放進擴散取樣器裡,據報告最多用 100 次網路評估就有不錯的結果。
選讀:零樣本擴散取樣器有何不同(見「補充資料」頁)。各方法的資料步驟、值域–零空間的分解與 SVD 觀點,附一段三行的檢查程式。
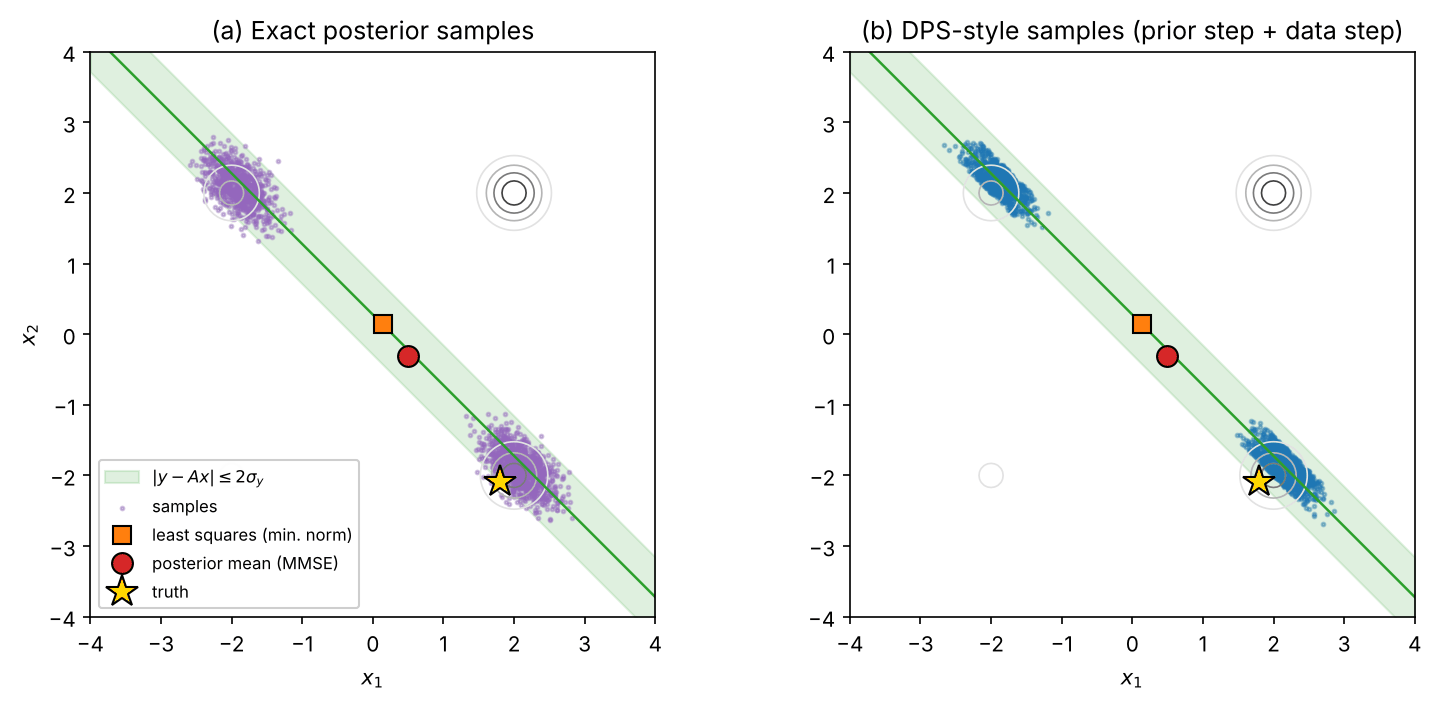
程式:在後驗已知的問題上做 DPS 式取樣器。 我們沿用四團塊先驗,並觀測二維「影像」的一個線性投影 ,其中 ,雜訊標準差 。位於 與 的團塊都有 ,所以接近 0 的量測確實是模稜兩可的。先驗和概似在每個團塊內都是 Gaussian,因此精確後驗仍是四團塊的混合,我們可以拿它來檢驗取樣器。 的 Jacobian 以有限差分計算,這在二維很便宜;在影像尺度上,這一步就是反向傳播。
程式碼 · Python · 43 行
# Continues the previous snippet (same session): mu, w, s2, T, abar, x0_hat, ddpm_step.
rng = np.random.default_rng(3)
A = np.array([[1.0, 1.0]]) / np.sqrt(2)          # we only observe one projection of x
sig_y = 0.2
x_true = np.array([1.8, -2.1])
y = A @ x_true + sig_y * rng.standard_normal(1)

# Reference: the exact posterior of a Gaussian mixture under a linear-Gaussian measurement.
S = (A @ A.T)[0, 0] * s2 + sig_y**2               # variance of y within one blob
logpost = np.log(w) - (y - mu @ A.T)[:, 0] ** 2 / (2 * S)
post_w = np.exp(logpost - logpost.max()); post_w /= post_w.sum()
gain = s2 * A.T / S                               # Kalman gain, shape (2, 1)
post_mu = mu + (y - mu @ A.T) @ gain.T            # posterior mean inside each blob
post_cov = s2 * (np.eye(2) - gain @ A)
k = rng.choice(4, size=2000, p=post_w)
exact = post_mu[k] + rng.multivariate_normal(np.zeros(2), post_cov, size=2000)
mmse = post_w @ post_mu                           # posterior mean
least_sq = (np.linalg.pinv(A) @ y).ravel()        # minimum-norm solution of A x = y

def data_grad(x, ab, h=1e-4):
    """grad_x ||y - A x0_hat(x)||^2 through Tweedie's estimate (finite-difference Jacobian)."""
    J = np.stack([(x0_hat(x + h * e, ab) - x0_hat(x - h * e, ab)) / (2 * h) for e in np.eye(2)], -1)
    resid = y - x0_hat(x, ab) @ A.T                # (N, 1)
    return -2 * np.einsum("nij,ik,nk->nj", J, A.T, resid), np.abs(resid)

x = rng.standard_normal((2000, 2))
for t in reversed(range(T)):
    x_prior = ddpm_step(x, t, x0_hat(x, abar[t]))  # 1) prior step: one reverse-diffusion step
    g, res = data_grad(x, abar[t])
    x = x_prior - 0.1 / (res + 1e-8) * g           # 2) data-consistency step, DPS step size

blob = lambda pts: np.bincount(np.argmin(((pts[:, None] - mu) ** 2).sum(-1), 1), minlength=4) / len(pts)
print("least squares", least_sq.round(2), "| posterior mean", mmse.round(2), "| truth", x_true)
for name, pts in [("exact posterior", exact), ("DPS", x)]:
    print(f"{name:15s} blob shares {blob(pts)} | median |y - Ax| {np.median(np.abs(y - pts @ A.T)):.3f}"
          f" | mean sq. error {np.mean(((pts - x_true) ** 2).sum(1)):.2f}")
for name, est in [("least squares", least_sq), ("posterior mean", mmse)]:
    print(f"{name:15s} sq. error {np.sum((est - x_true) ** 2):.2f}")
# least squares [0.14 0.14] | posterior mean [ 0.5 -0.3] | truth [ 1.8 -2.1]
# exact posterior blob shares [0.    0.409 0.591 0.   ] | median |y - Ax| 0.122 | mean sq. error 12.97
# DPS             blob shares [0.     0.4055 0.5945 0.    ] | median |y - Ax| 0.100 | mean sq. error 13.09
# least squares   sq. error 7.77
# posterior mean  sq. error 4.93
請對照圖 5 來讀輸出:
- 最小平方解 與後驗平均都落在兩個合理團塊的中間,那裡的先驗幾乎是空的:這就是這個玩具問題裡「模糊」的答案。後驗平均的平方誤差最低(4.93),因為它採取了避險的做法。
- DPS 式樣本落在右邊的兩個團塊,占比 0.41 與 0.59,與精確後驗吻合。它們的均方誤差(13.09)高得多,因為約 40% 的樣本落在另一個團塊:一個很有把握、卻是錯的答案。這是後驗取樣照預期運作的結果,也是幻覺細節的二維版本。
- DPS 對量測的擬合比真正的後驗稍微更緊(殘差中位數 0.100 對 0.122):它是一種近似,它的殘差取決於步長 (練習 3)。在高維度中,這類偏差要難發現得多。
選讀:Chung 等人:Diffusion Posterior Sampling for General Noisy Inverse Problems(ICLR 2023)(見「論文導讀」頁)。這篇論文近似了什麼、量測了什麼,以及讀它的表格時要檢查什麼。
條件式與零樣本如何選擇
| 問題 | 條件式(SR3、Palette、ResShift) | 零樣本(DPS、DDRM、DDNM、ΠGDM、DiffPIR) |
|---|---|---|
| 訓練 | 每一類退化一個模型,用成對資料 | 在乾淨影像上訓練一個無條件模型 |
| 測試時的退化 | 隱含;只要訓練時出現過,可以是未知的 | 必須已知(或估計出來),且通常要可微分 |
| 雜訊與真實相機流程 | 訓練時有涵蓋就能處理 | 只能處理到概似模型所允許的程度 |
| 每張影像的成本 | 數十到數百步,不需反向傳播 | 通常數百步;DPS 類方法還要反向傳播 |
| 適合的情境 | 一個任務,且有大量訓練配對 | 物理已知、新的算子、不想重新訓練 |
一個粗略的準則:如果你能針對你的退化收集或合成配對,就訓練條件式模型(或非生成式的模型)。如果算子是已知的物理(模糊核、取樣遮罩、斷層掃描投影器),而且每換一種設定就重新訓練並不實際,零樣本取樣就很有吸引力。
第三族:潛在擴散與基礎模型復原器
白話版。 最強的影像生成器,是用龐大影像集訓練出來的大型文字生圖擴散模型。它們對草地、布料和磚牆長什麼樣子的了解,遠超過任何復原資料集所能教的。近年的真實世界復原模型,會把這樣的模型凍結(或幾乎凍結),加上一個小網路讓它看到受損影像,再讓它把缺少的細節畫進去。結果可以非常驚人,也可能憑空捏造東西。
建立在預訓練的文字生圖模型上
潛在擴散(latent diffusion)[22] 不在像素上,而是在自編碼器壓縮後的潛在空間中執行擴散,這使大型文字生圖模型變得負擔得起(ML 08)。ControlNet [23] 示範了怎麼在這樣的模型上加入新的影像條件,而不破壞它(其作者描述這個模型是用數十億張影像預訓練的):預訓練模型被鎖住,它編碼層的一個可訓練副本接收條件,兩者用零初始化的卷積連接,所以訓練是從未改變的模型開始。復原方法兩個想法都借用了。StableSR [24] 固定生成器,透過一個時間感知的編碼器注入低品質影像,並提供一個使用者設定的純量,在品質與保真度之間取捨。DiffBIR [25] 先用一般的復原網路移除退化,再用 ControlNet 式的轉接器重新生成遺失的細節,同樣有可調的保真度引導。SUPIR [26] 把先驗與資料的規模都放大(論文描述了 2,000 萬張附文字標註的高解析度影像),並讓文字提示來引導復原。
更少的步數:從數百步到一步
多步的潛在復原模型很慢,而且它們隨機的起始雜訊讓每次執行的輸出都不同。蒸餾與重新設計的模型把這兩者都降低了:SinSR [27]、OSEDiff [28] 與 TSD-SR [30] 一步就完成復原,InvSR [29] 則是一到五步,做法主要是從低品質影像而不是純雜訊出發,並蒸餾一個多步的教師模型。一般的蒸餾家族(漸進式、一致性、對抗式)在 ML 08 中有說明。
選讀:潛在擴散與一步復原方法逐一介紹(見「補充資料」頁)。StableSR、DiffBIR、SUPIR、SinSR、OSEDiff、InvSR 與 TSD-SR 各自加入了什麼。
兩個後果。第一,從輸入出發的一步復原模型幾乎是決定性的:它像 GAN 一樣給出一個合理的答案,而不是散布正確的樣本。第二,步數不是成本的全部:一步模型的網路可能更大,而且潛在方法還要在完整解析度上負擔自編碼器的編碼器與解碼器。
幻覺問題
白話版。 強大的先驗用典型的東西填補空缺,而不是用原本在那裡的東西。輸入說得很少的地方,輸出大多是先驗:它看起來很真實,影像裡也沒有任何線索告訴你它是捏造的。它會出現在這些地方:
- 文字與符號。 招牌、車牌和文件上的字母非常具體:一個小錯誤就會改變意思。生成式復原模型可以產生乾淨、清晰可讀、卻是錯的字元。
- 人臉與身分。 人臉先驗產生的是訓練分布中的一張臉;對特定的人來說,鼻子或眼睛稍有不同,就是身分改變。
- 紋理。 磚牆、布料和樹葉可能被另一種不同、但同樣合理的圖案取代。
- 潛在解碼器。 潛在復原模型的自編碼器本身就有重建誤差;把乾淨影像編碼再解碼,就能看出光是它就改變了什麼,正如 ML 08 所建議的。
- 醫學與科學影像。 一個並不存在的合理結構,或被抹平的真實病灶,都是診斷錯誤。Bhadra 等人 [35] 在斷層掃描重建中分析了這件事:他們把一個估計拆成由量測決定的部分,以及由先驗補上的零空間(null-space)部分,並據此定義了幻覺圖。
零空間的觀點用一行就能說明機制,它用的是 DDNM 背後的分解:對線性的 ,任何估計 都滿足 。資料一致性只限制第一個部分。第二個部分的一切都來自先驗,而當 丟掉很多資訊時,這個部分就很大,所以一個完全符合資料一致性的輸出,仍然可能大部分都是捏造的。與 一致是必要條件,永遠不是充分條件。
幻覺的量測本身就是一個研究主題。最近一項針對生成式超解析度的研究主張,幻覺的細節無論用保真度指標或無參考品質模型,都很難捕捉到,並提出了一種「幻覺分數」(Hallucination Score),做法是對多模態大型語言模型下提示,其作者發現這個分數與人類判斷高度吻合 [36]。
第四族:流匹配與整流流復原器
白話版。 流匹配學習一個平滑的「速度場」,沿著幾乎筆直的路徑把雜訊送到影像,所以只需要很少的步數。用在復原上,可以把一個模糊的最佳猜測送到逼真的影像,也可以把預訓練的流接到和擴散相同的「先驗 + 資料」迴圈裡。
流匹配 [31] 與整流流 [32] 訓練網路預測一條路徑的速度,路徑連接一個簡單分布與資料分布;樣本來自對常微分方程的積分,而筆直的路徑只需要很少的積分步數(ML 08)。有兩個經過驗證的復原用法:
- PMRF(posterior-mean rectified flow)[33] 直接瞄準感知–失真一節的 這個點:在輸出分布與真實影像相同的估計量中,MSE 最低的那一個。依據論文引用的一項理論結果,它先預測後驗平均(一個一般的 MMSE 網路),再用一個逼近最佳傳輸映射的整流流模型,把這個模糊的估計傳輸到逼真的影像。這是理解整篇內容的一種乾淨的方式:先得到最佳的平均,再盡可能少地移動它,讓它看起來真實。
- PnP-Flow [34] 由預訓練的流匹配模型定義出隨時間變化的去雜訊器,並交替進行三件事:對資料保真項做梯度步驟、重新投影回學得的流路徑,以及去雜訊:這是圖 4 的迴圈,只是把擴散模型換成流,並避免了透過 ODE 做反向傳播。
評估生成式復原
白話版。 分開問四個問題:輸出與真值接近嗎(有真值時)?它看起來真實嗎?它與輸入相符嗎?再執行一次,它會改變多少?一個數字無法回答這四個問題,而一張漂亮的圖一個也回答不了。
指標的定義在 DLCV 09。對生成式復原模型,請這樣使用它們。
- 有參考影像時的保真度。 PSNR 與 SSIM [39](低失真)、LPIPS [38](與參考影像的感知距離)。在相同資料模型下,給定觀測後與真值條件獨立的精確後驗樣本,其期望平方誤差是 MMSE 估計量的兩倍 [1]。只有用這兩個期望 MSE 計算 PSNR 時,才得到約 3 dB 的差距;逐張 PSNR 再取平均不一定如此。學得的生成器與訓練出的迴歸基準不一定符合這些理想假設。應測量實際權衡,不能只靠較低的 PSNR 證明更逼真。
- 逼真度。 NIQE [41]、MUSIQ [42] 與 CLIP-IQA [43] 這類無參考指標替單張影像打分;FID [40] 則比較輸出與真實影像集合之特徵分布的高斯近似。它是實用的分布比較代理量,不是完整影像分布 與 之間的精確距離,而且需要很多影像。無參考指標可以靠加進紋理來作弊,所以千萬不要只用它們。
- 與輸入的一致性。 重新套用退化再比較: 應該約等於雜訊水準。這不需要參考影像,並且能抓出忽略輸入的輸出。但它抓不到零空間的幻覺(見前面的小節)。
- 隨機性。 取樣器給的是輸出的分布。請把它報告出來。
報告多個樣本。 這段程式碼延續階梯邊緣玩具問題:一個測試輸入、每次執行八個復原結果、三次使用不同隨機種子的執行,就像同一方法的三位使用者會看到的情況。
程式碼 · Python · 31 行
# Recreate the step-edge toy: the intervening DPS example uses a different A.
import numpy as np
from scipy.ndimage import gaussian_filter1d
n, factor, sigma = 64, 8, 0.2
positions = np.arange(8, 56)
X = (np.arange(n)[None, :] >= positions[:, None]).astype(float)
A = lambda x: gaussian_filter1d(x, 3.0, axis=-1, mode="nearest")[..., ::factor]
AX = A(X)

def posterior(y):
    logp = -np.sum((y - AX)**2, axis=1) / (2 * sigma**2)
    p = np.exp(logp - logp.max())
    return p / p.sum()

rng = np.random.default_rng(5)
x = X[20]                                                   # a test signal: edge at pixel 28
y = A(x) + sigma * rng.standard_normal(n // factor)
p = posterior(y)
for seed in range(3):                                       # three "users" with different seeds
    r = np.random.default_rng(seed)
    S = X[r.choice(len(positions), size=8, p=p)]            # 8 restorations of the same input
    err = ((S - x) ** 2).mean(axis=1)
    print(f"seed {seed}: MSE mean {err.mean():.4f} ± {err.std():.4f} | best of 8 {err.min():.4f}"
          f" | edges at {sorted(set(np.argmax(S, axis=1).tolist()))}")
S = X[rng.choice(len(positions), size=200, p=p)]
std = S.std(axis=0)                                         # per-pixel spread across samples
print("pixels with std > 0.1:", np.flatnonzero(std > 0.1), "| true edge at", np.argmax(x))
# seed 0: MSE mean 0.0273 ± 0.0268 | best of 8 0.0000 | edges at [23, 24, 26, 27, 28, 29]
# seed 1: MSE mean 0.0273 ± 0.0103 | best of 8 0.0156 | edges at [25, 26, 27, 29, 30]
# seed 2: MSE mean 0.0293 ± 0.0213 | best of 8 0.0000 | edges at [24, 25, 26, 27, 28]
# pixels with std > 0.1: [22 23 24 25 26 27 28 29 30] | true edge at 28
三個教訓,各附一條報告規則:
- 散布和平均一樣大。 在單一輸入上,每個樣本的 MSE 變動的幅度,和它的平均值差不多。要報告樣本之間(以及不同種子之間)的平均與散布,而不是只報告一個樣本。
- 「K 個中取最佳」是神諭(oracle)。 挑出最接近真值的樣本,在三個種子中有兩個得到零 MSE,這個數字沒有任何使用者能得到,因為使用者沒有真值。如果論文報告 K 取最佳,就必須明說,也不該拿來和單一樣本的結果比較。(例如 DPS 在相位還原上報告四個樣本中的最佳者,這是該問題的通行做法,並且有明說 [17]。)
- 樣本散布是診斷線索,不是經過校準的誤差圖。 在這個精確後驗玩具問題中,200 個樣本的逐像素標準差在邊緣附近很大(第 22 到 30 個像素)。學得的取樣器卻可能反覆產生相同的錯誤細節,讓低散布與高誤差同時出現;額外取樣也有運算成本。Angelopoulos 等人 [37] 用保留資料校準影像值預測集合:以指定的校準信心水準,限制來自相同分布的新影像中,未被區間涵蓋像素比例的期望值。這不保證每張個別影像的每個像素都涵蓋真值,也不保證任意分布偏移下仍然成立。
運算成本。 要報告網路評估次數(NFE,包含引導與任何額外的傳遞)、解析度、硬體與實際耗時,對潛在方法還要報告自編碼器的成本。舉一個具體的參照:DPS 論文報告,在一張 RTX 2080 Ti GPU 上、每次 1,000 次網路評估,每張 的 FFHQ 影像約 95 秒,每張 ImageNet 影像約 600 秒 [17]。蒸餾後的一步復原模型把步數降到一步,但要比較的是完整流程,而不是步數。
一份最起碼誠實的報告:在有參考影像時報告 PSNR/SSIM 與 LPIPS;兩三個來自不同家族的無參考指標,再加上足夠大的集合上的 FID;重新退化後的殘差;樣本與種子之間的平均與散布;NFE 與耗時;重大主張要有使用者研究;以及一個包含失敗案例、而不是只有最好看結果的圖庫。
失效模式,以及何時不該使用生成式復原
白話版。 當目標是一張令人愉快、合理的圖片時,生成式復原是對的工具。當這張圖片要被當作證據時,它就是錯的工具。
典型的失效模式。
- 捏造的具體內容:文字、數字、人臉、小物件、醫學發現(見幻覺一節)。
- 忽略輸入:資料一致性太弱,尤其是在強烈朝向先驗或提示引導時,會給出一個略有不同的場景的逼真影像;色偏是擴散超解析度已知的問題 [46]。
- 假設的退化與真實的退化不符:零樣本方法需要正確的 。錯誤的模糊核或雜訊水準會被資料步驟傳遞下去,而先驗再讓錯誤的答案看起來很有說服力。
- 分布外的輸入:在人臉或自然照片上訓練的先驗,會把顯微鏡、衛星或醫學影像拉向錯誤的「典型」外觀,也會把不像訓練資料的人臉拉向典型的人臉(PULSE 討論過的偏差 [7])。
- 不同次執行與不同尺寸之間的不穩定性:不同種子給出不同的細節,而在固定尺寸上訓練的模型,處理較大的影像需要特殊做法(StableSR 的漸進聚合取樣就是一種解法 [24])。
- 成本:每張影像要數百次網路呼叫,或是一個非常大的一步網路。
何時不該使用它,或只在明確標示並附上不確定性時才使用:
- 證據與量測:鑑識、法律、新聞與監視用途、車牌、要被閱讀的文件,以及任何有人會依據某個細節採取行動的情況。偏好 MMSE 復原模型(平滑,但不會對具體細節下定論),或是顯示一組樣本並附上不確定性圖。
- 醫學與科學:診斷、定量與任何下游量測。使用針對該任務驗證過的方法,並做像 [35] 這樣的幻覺分析,同時讓量測到的資料保持可見。
- 輕微的退化:當後驗很窄(輕微雜訊、乾淨影像的 超解析度)時,迴歸網路本來就能給出銳利的答案,而且更快、風險更小。
- 餵給其他演算法的流程(偵測、OCR、量測):復原應該用下游任務來評判;捏造的細節可能造成誤偵測。
一條簡短的決策規則:如果一個錯誤但逼真的細節,比一塊模糊的區域更糟,那就不要在沒有不確定性報告的情況下使用生成式復原模型。
現代觀點
綜述論文。
- Li 等人,“Diffusion Models for Image Restoration and Enhancement: A Comprehensive Survey”(IJCV 2025) [44]。把擴散式復原分成監督式方法(依取樣器的條件化方式分組)與零樣本方法(投影、分解與後驗估計),另外涵蓋盲復原與真實世界復原,並在數個任務上比較各方法。重點:感知品質最好,而取樣成本、模型大小、真實世界退化和評估是主要的障礙。
- Daras 等人,“A Survey on Diffusion Models for Inverse Problems”(arXiv 2024) [45]。涵蓋不再額外訓練、直接使用預訓練擴散模型的方法,依它們處理量測項的方式分成四個家族:對 的明確近似(DPS、ΠGDM 與 DDRM 一系屬於此類)、變分推論、CSGM 型的潛在最佳化,以及漸近精確的 Monte Carlo 方法;第二套分類則依一致性如何被強制(梯度、投影、取樣、最佳化)來歸類。重點:許多看似不同的方法,其實都是計算一個量測誤差,再以不同方式把它「提升」回影像空間,而這個領域缺乏一個衡量品質對運算量的標準基準。
- Moser 等人,“Diffusion Models, Image Super-Resolution, and Everything: A Survey”(IEEE TNNLS 2025) [46]。專注於超解析度:基礎、輸入域(像素或潛在空間)、條件化、引導、退化空間與零樣本方法。重點:擴散縮小了與人類偏好之間的大部分差距,而運算成本、論文之間的可比性、可解釋性與色偏仍是未解決的問題。
- Xia 等人,“GAN Inversion: A Survey”(IEEE TPAMI 2023) [47]。回顧影像如何被映射回預訓練 GAN 的潛在空間,以及這如何支援復原與編輯。重點:第一族的 GAN 先驗方法都是反演的特例,它們的限制在於生成器的涵蓋範圍與反演的成本。
選讀:Li 等人:Diffusion Models for Image Restoration and Enhancement: A Comprehensive Survey(IJCV 2025)(見「論文導讀」頁)。怎麼使用這篇綜述的分類與比較表。
2023–2026 年的最新進展。
- 預訓練的文字生圖模型成為真實世界復原的預設先驗,透過轉接器連接(StableSR、DiffBIR、SUPIR),並提供明確的保真度旋鈕,因為不受控制的生成會偏離輸入。
- 步數從數百步降到一步,靠的是殘差位移鏈、蒸餾與反演(ResShift、SinSR、OSEDiff、InvSR、TSD-SR)。一步模型用後驗的散布換取速度與可重複性。
- 零樣本後驗取樣成熟為一個家族,有共通的結構(DPS、DDRM、DDNM、ΠGDM、DiffPIR),並延伸到流(PnP-Flow),也有統整這些近似的綜述 [45]。
- 理論重新進入實務:感知–失真的界現在直接指引方法設計,例如 PMRF 的「先取後驗平均,再做傳輸」[33]。
- 幻覺開始被量測,而不只是被提及,例如使用專門的分數 [36]。
尚未解決的問題。
- 量測忠實度:目前沒有被接受的指標能說「既銳利又正確」。保真度指標會懲罰所有細節;無參考指標則獎勵捏造的細節。
- 影像尺度上真正的後驗取樣:零樣本方法是近似的(我們的玩具問題即使在二維也顯示出小小的偏差),而少步模型的多樣性很低。對高解析度影像給出經過校準的不確定性,大致上仍是開放問題。
- 未知的退化:零樣本方法需要 ;監督式方法需要正確的訓練分布。
- 成本:用大型先驗做高解析度與影片復原,仍然很昂貴。
- 負責任的使用:領域偏移、人臉先驗的族群偏差,以及生成內容的標示,在實務上都還沒有解決。
選讀:DDNM、DPS、BlindDPS(見「論文導讀」頁)。比較已知無雜訊線性算子、帶雜訊概似引導,以及聯合估計未知算子。
重點整理
- 最佳平方誤差估計是條件平均,平均多解結構可能造成模糊。
- 合理的生成細節仍可能與原始場景不同。
- 感知—失真界限針對理想分布與估計器 [1],學得的生成器不會自動滿足條件。
- 區分依任務訓練的條件模型,以及搭配量測限制的預訓練先驗。
- 輸入一致性無法偵測未觀測成分中的虛構;減少取樣步數也不會消除多解性。
- 報告忠實度、真實感、一致性、隨機種子與完整成本,不隱藏多次取樣後挑最佳結果的做法。
- 當逼真但錯誤的細節會破壞用途時,選擇保守的復原方式。
練習
- 用手算出那個兩倍。 在階梯邊緣玩具問題中,假設對某個輸入,後驗以機率 0.5 把邊緣放在第 30 個像素,以機率 0.5 放在第 32 個像素,而真值在第 30 個像素。計算後驗平均的 MSE(每像素,64 個像素),以及後驗樣本的期望 MSE。比值是 2 嗎?解釋為什麼定理中的兩倍是對各輸入取的平均,而不是對每個輸入都成立的保證。
提示
兩個候選只在第 30 與第 31 個像素不同。平均在那裡是 0.5,所以它的 MSE 是 ;樣本有 0.5 的機率是對的,否則在兩個像素上各錯 1,所以它的期望 MSE 是 :比值為二。如果後驗改成把 0.9 放在錯誤的位置,這個真值的比值會是 。定理是對 與 聯合取平均,在那裡,真值本身就是依後驗分布的。
- 走一遍權衡。 用第一段程式碼,計算下列各項的 MSE 與 W1:(a) 後驗平均加上標準差 0.1 的 Gaussian 雜訊,(b) 後驗中位數的邊緣位置(選擇後驗累積機率第一次超過 0.5 的位置),以及 (c) 後驗眾數。把它們放在圖 2 的平面上。哪些靠近後驗樣本那個點?
提示
加雜訊並不會產生邊緣:在我們的執行中,最大的階梯只有 0.40,W1 增加到約 0.095(雜訊造成許多不真實的中間值),MSE 增加到 0.0274,所以 (a) 是遠離兩個目標。中位數與眾數都是單一的真實邊緣,所以它們的 W1 和樣本一樣接近零(我們的執行中分別是 0.0009 與 0.0011),而它們的 MSE(0.0245 與 0.0259)低於隨機樣本的(0.0338),因為它們從不挑選不太可能的位置。不過它們是決定性的:它們不會重現後驗的散布,而集合層級的指標可以偵測到這一點(相似輸入的所有輸出都一致)。
- DPS 的步長。 在 DPS 式的程式碼中,把資料步驟裡的常數 0.1 換成 0.02、0.5 與 2.0。對每一個,報告團塊占比、殘差 的中位數與均方誤差,並與精確後驗比較。接著把正規化步驟 換成未正規化的步驟 。你對 DPS 的步長與雜訊水準 之間的關係有什麼結論?
提示
使用正規化的步驟時,不論殘差多大,每個資料步驟的長度大致相同,所以最後殘差中位數會落在那個常數附近(在我們的執行中,0.02、0.1、0.5 與 2.0 分別得到 0.021、0.100、0.496 與 1.994)。太大的值會讓殘差遠高於雜訊水準,並扭曲團塊占比(2.0 時是 0.24 與 0.76,精確值是 0.41 與 0.59);0.02 時約有 1% 的樣本最後落入量測所排除的團塊,因為早期的修正太弱。未正規化的步驟 得到的殘差中位數是 0.007,比雜訊水準所允許的緊得多。兩種選擇都沒有像精確後驗那樣與 綁在一起:步長是調出來的超參數,這是 DPS 只是一種近似的原因之一。
- 步數與精確度。 在擴散的程式碼中,分別用 (並用
beta = np.linspace(1e-4, 0.2, T))和 (並用np.linspace(1e-4, 0.01, T))執行取樣器。記錄每個團塊內部的散布。把結果與成本的討論連起來,並說明為什麼一步的蒸餾復原模型是訓練出來的,而不是單純用更少的步數得到的。
提示
在我們的執行中,50 步的散布約為 0.263,200 步為 0.283,1,000 步為 0.296(目標 0.3):即使用精確的分數,粗略的步驟也會讓反向過程太窄。一步模型不能靠對同一個取樣器跨一大步來達到精確度;它必須經過訓練(蒸餾,或用不同的方式建構),才能跳得正確。
- 零空間的幻覺。 取一個長度 16 的一維訊號,並令 為相鄰兩項取平均(一個 的矩陣)。計算 ,並驗證 是投影()。構造兩個不同的訊號,量測 完全相同,一個平滑,另一個帶有銳利的棋盤格圖案。自然訊號的生成式先驗會挑哪一個?各個訊號的哪個部分是「捏造的」?
提示
兩兩平均的零空間,包含每一對之內符號交替的所有圖案 (每對的振幅 任意);把它加到平滑訊號上, 不變。每一對之內的差,也就是 ,資料完全看不到,全部由先驗提供:平滑訊號的先驗會挑小的,紋理先驗則可能加進一些。這就是 [35] 的幻覺圖想法。
- 設計一個評估。 你必須決定,一步的潛在擴散復原模型能否取代以 MSE 訓練的網路,用來復原掃描的檔案文件。寫出評估方案:資料、指標、樣本與種子的數量、檢查幻覺字元的方法、運算量測,以及決策規則。
提示
盡可能使用有參考影像的真實掃描(用高解析度重新掃描),再加上乾淨文件的合成退化。報告 PSNR/SSIM/LPIPS、一個無參考指標,以及最關鍵的:兩種方法、以及多個種子相對於真實文字的 OCR 字元錯誤率;也報告兩個種子在某個字元上意見不一的頻率(不確定性訊號)。包含 NFE、耗時與記憶體,並計入自編碼器。依任務來決定:如果生成模型提高了字元錯誤率,或在不同種子之間改變了字元,就保留 MSE 網路來閱讀,只把生成式的用於顯示,並清楚標示。
參考文獻
- Y. Blau and T. Michaeli, “The Perception-Distortion Tradeoff,” in Proc. IEEE/CVF CVPR, 2018, pp. 6228–6237 (extended version on arXiv). doi · arXiv
- C. Ledig, L. Theis, F. Huszár, J. Caballero, A. Cunningham, A. Acosta, A. Aitken, A. Tejani, J. Totz, Z. Wang and W. Shi, “Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network,” in Proc. IEEE CVPR, 2017, pp. 105–114. doi · arXiv
- J. Johnson, A. Alahi and L. Fei-Fei, “Perceptual Losses for Real-Time Style Transfer and Super-Resolution,” in Proc. ECCV, 2016, pp. 694–711. doi · arXiv
- X. Wang, K. Yu, S. Wu, J. Gu, Y. Liu, C. Dong, Y. Qiao and C. C. Loy, “ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks,” in Proc. ECCV Workshops, 2018 (LNCS, 2019), pp. 63–79. doi · arXiv
- X. Wang, L. Xie, C. Dong and Y. Shan, “Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data,” in Proc. IEEE/CVF ICCV Workshops, 2021, pp. 1905–1914. doi · arXiv
- T. Karras, S. Laine and T. Aila, “A Style-Based Generator Architecture for Generative Adversarial Networks,” in Proc. IEEE/CVF CVPR, 2019, pp. 4396–4405. doi · arXiv
- S. Menon, A. Damian, S. Hu, N. Ravi and C. Rudin, “PULSE: Self-Supervised Photo Upsampling via Latent Space Exploration of Generative Models,” in Proc. IEEE/CVF CVPR, 2020, pp. 2434–2442. doi · arXiv
- K. C. K. Chan, X. Wang, X. Xu, J. Gu and C. C. Loy, “GLEAN: Generative Latent Bank for Large-Factor Image Super-Resolution,” in Proc. IEEE/CVF CVPR, 2021, pp. 14240–14249. doi · arXiv
- X. Wang, Y. Li, H. Zhang and Y. Shan, “Towards Real-World Blind Face Restoration with Generative Facial Prior,” in Proc. IEEE/CVF CVPR, 2021, pp. 9164–9174. doi · arXiv
- S. Zhou, K. C. K. Chan, C. Li and C. C. Loy, “Towards Robust Blind Face Restoration with Codebook Lookup Transformer,” in Proc. NeurIPS, vol. 35, 2022, pp. 30599–30611. doi · arXiv
- J. Ho, A. Jain and P. Abbeel, “Denoising Diffusion Probabilistic Models,” in Proc. NeurIPS, 2020. proceedings · arXiv
- Y. Song, J. Sohl-Dickstein, D. P. Kingma, A. Kumar, S. Ermon and B. Poole, “Score-Based Generative Modeling through Stochastic Differential Equations,” in Proc. ICLR, 2021. arXiv
- B. Efron, “Tweedie’s Formula and Selection Bias,” Journal of the American Statistical Association, vol. 106, no. 496, pp. 1602–1614, 2011. doi
- C. Saharia, J. Ho, W. Chan, T. Salimans, D. J. Fleet and M. Norouzi, “Image Super-Resolution via Iterative Refinement,” IEEE TPAMI, 2022 (early access). doi · arXiv
- C. Saharia, W. Chan, H. Chang, C. Lee, J. Ho, T. Salimans, D. Fleet and M. Norouzi, “Palette: Image-to-Image Diffusion Models,” in Proc. ACM SIGGRAPH Conference, 2022, pp. 1–10. doi · arXiv
- Z. Yue, J. Wang and C. C. Loy, “ResShift: Efficient Diffusion Model for Image Super-resolution by Residual Shifting,” in Proc. NeurIPS, vol. 36, 2023, pp. 13294–13307. doi · arXiv
- H. Chung, J. Kim, M. T. McCann, M. L. Klasky and J. C. Ye, “Diffusion Posterior Sampling for General Noisy Inverse Problems,” in Proc. ICLR, 2023. arXiv
- B. Kawar, M. Elad, S. Ermon and J. Song, “Denoising Diffusion Restoration Models,” in Proc. NeurIPS, vol. 35, 2022, pp. 23593–23606. doi · arXiv
- Y. Wang, J. Yu and J. Zhang, “Zero-Shot Image Restoration Using Denoising Diffusion Null-Space Model,” in Proc. ICLR, 2023. arXiv
- J. Song, A. Vahdat, M. Mardani and J. Kautz, “Pseudoinverse-Guided Diffusion Models for Inverse Problems,” in Proc. ICLR, 2023. ICLR page
- Y. Zhu, K. Zhang, J. Liang, J. Cao, B. Wen, R. Timofte and L. Van Gool, “Denoising Diffusion Models for Plug-and-Play Image Restoration,” in Proc. IEEE/CVF CVPR Workshops, 2023, pp. 1219–1229. doi · arXiv
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser and B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” in Proc. IEEE/CVF CVPR, 2022, pp. 10674–10685. doi · arXiv
- L. Zhang, A. Rao and M. Agrawala, “Adding Conditional Control to Text-to-Image Diffusion Models,” in Proc. IEEE/CVF ICCV, 2023, pp. 3813–3824. doi · arXiv
- J. Wang, Z. Yue, S. Zhou, K. C. K. Chan and C. C. Loy, “Exploiting Diffusion Prior for Real-World Image Super-Resolution,” International Journal of Computer Vision, vol. 132, no. 12, pp. 5929–5949, 2024. doi · arXiv
- X. Lin, J. He, Z. Chen, Z. Lyu, B. Dai, F. Yu, Y. Qiao, W. Ouyang and C. Dong, “DiffBIR: Toward Blind Image Restoration with Generative Diffusion Prior,” in Proc. ECCV, 2024 (LNCS), pp. 430–448. doi · arXiv
- F. Yu, J. Gu, Z. Li, J. Hu, X. Kong, X. Wang, J. He, Y. Qiao and C. Dong, “Scaling Up to Excellence: Practicing Model Scaling for Photo-Realistic Image Restoration In the Wild,” in Proc. IEEE/CVF CVPR, 2024, pp. 25669–25680. doi · arXiv
- Y. Wang, W. Yang, X. Chen, Y. Wang, L. Guo, L.-P. Chau, Z. Liu, Y. Qiao, A. C. Kot and B. Wen, “SinSR: Diffusion-Based Image Super-Resolution in a Single Step,” in Proc. IEEE/CVF CVPR, 2024, pp. 25796–25805. doi · arXiv
- R. Wu, L. Sun, Z. Ma and L. Zhang, “One-Step Effective Diffusion Network for Real-World Image Super-Resolution,” in Proc. NeurIPS, vol. 37, 2024, pp. 92529–92553. doi · arXiv
- Z. Yue, K. Liao and C. C. Loy, “Arbitrary-steps Image Super-resolution via Diffusion Inversion,” in Proc. IEEE/CVF CVPR, 2025, pp. 23153–23163. doi · arXiv
- L. Dong, Q. Fan, Y. Guo, Z. Wang, Q. Zhang, J. Chen, Y. Luo and C. Zou, “TSD-SR: One-Step Diffusion with Target Score Distillation for Real-World Image Super-Resolution,” in Proc. IEEE/CVF CVPR, 2025, pp. 23174–23184. doi · arXiv
- Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel and M. Le, “Flow Matching for Generative Modeling,” in Proc. ICLR, 2023. arXiv
- X. Liu, C. Gong and Q. Liu, “Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow,” in Proc. ICLR, 2023. arXiv
- G. Ohayon, T. Michaeli and M. Elad, “Posterior-Mean Rectified Flow: Towards Minimum MSE Photo-Realistic Image Restoration,” in Proc. ICLR, 2025. arXiv
- S. Martin, A. Gagneux, P. Hagemann and G. Steidl, “PnP-Flow: Plug-and-Play Image Restoration with Flow Matching,” in Proc. ICLR, 2025. arXiv
- S. Bhadra, V. A. Kelkar, F. J. Brooks and M. A. Anastasio, “On Hallucinations in Tomographic Image Reconstruction,” IEEE Transactions on Medical Imaging, vol. 40, no. 11, pp. 3249–3260, 2021. doi · arXiv
- W. Ren, R. Goyal, Z. Hu, T. T. Aumentado-Armstrong, I. Mohomed and A. Levinshtein, “Hallucination Score: Towards Mitigating Hallucinations in Generative Image Super-Resolution,” arXiv:2507.14367, 2025. arXiv
- A. N. Angelopoulos, A. P. Kohli, S. Bates, M. I. Jordan, J. Malik, T. Alshaabi, S. Upadhyayula and Y. Romano, “Image-to-Image Regression with Distribution-Free Uncertainty Quantification and Applications in Imaging,” in Proc. ICML, PMLR 162, 2022. proceedings · arXiv
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018, pp. 586–595. doi · arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image Quality Assessment: From Error Visibility to Structural Similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- M. Heusel, H. Ramsauer, T. Unterthiner, B. Nessler and S. Hochreiter, “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” in Proc. NeurIPS (NIPS), 2017. arXiv
- A. Mittal, R. Soundararajan and A. C. Bovik, “Making a ‘Completely Blind’ Image Quality Analyzer,” IEEE Signal Processing Letters, vol. 20, no. 3, pp. 209–212, 2013. doi
- J. Ke, Q. Wang, Y. Wang, P. Milanfar and F. Yang, “MUSIQ: Multi-scale Image Quality Transformer,” in Proc. IEEE/CVF ICCV, 2021, pp. 5128–5137. doi · arXiv
- J. Wang, K. C. K. Chan and C. C. Loy, “Exploring CLIP for Assessing the Look and Feel of Images,” in Proc. AAAI, vol. 37, no. 2, 2023, pp. 2555–2563. doi · arXiv
- X. Li, Y. Ren, X. Jin, C. Lan, X. Wang, W. Zeng, X. Wang and Z. Chen, “Diffusion Models for Image Restoration and Enhancement: A Comprehensive Survey,” International Journal of Computer Vision, vol. 133, no. 11, pp. 8078–8108, 2025. doi · arXiv
- G. Daras, H. Chung, C.-H. Lai, Y. Mitsufuji, J. C. Ye, P. Milanfar, A. G. Dimakis and M. Delbracio, “A Survey on Diffusion Models for Inverse Problems,” arXiv:2410.00083, 2024. arXiv
- B. B. Moser, A. S. Shanbhag, F. Raue, S. Frolov, S. Palacio and A. Dengel, “Diffusion Models, Image Super-Resolution, and Everything: A Survey,” IEEE Transactions on Neural Networks and Learning Systems, vol. 36, no. 7, pp. 11793–11813, 2025. doi · arXiv
- W. Xia, Y. Zhang, Y. Yang, J.-H. Xue, B. Zhou and M.-H. Yang, “GAN Inversion: A Survey,” IEEE TPAMI, vol. 45, no. 3, pp. 3121–3138, 2023. doi · arXiv
- Y. Song and S. Ermon, “Generative Modeling by Estimating Gradients of the Data Distribution,” in Proc. NeurIPS, 2019. arXiv
- H. Chung, J. Kim, S. Kim and J. C. Ye, “Parallel Diffusion Models of Operator and Image for Blind Inverse Problems,” in Proc. IEEE/CVF CVPR, 2023, pp. 6059–6069. paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 09C・低光影像增強 · 33 分鐘