DLCV 02A・臉部辨識與度量學習
先備知識:DLCV 02・深度影像分類
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分驗證、封閉集識別與開放集識別。
- 追蹤偵測、特徵點對齊、正規化嵌入與相似度評分。
- 比較成對損失與角度間隔分類損失。
- 為驗證或登錄庫搜尋選擇門檻與指標。
- 評估資料集適用性、人口群體差異、隱私與呈現攻擊。
先看全貌
分類器是從一份固定的答案清單裡挑一個。臉部辨識系統不能這樣運作:它明年會遇到的人,並不在訓練集裡。它學的是一種衡量兩張臉有多像的方法,再用一個門檻做決定。
這個想法叫度量學習(metric learning),應用範圍遠不止人臉。同一套做法(學一個嵌入、用距離比較、用門檻決定)也驅動著行人重識別(DLCV 07)、影像檢索、語者驗證,以及 ML 06 的對比式自監督方法。人臉是把這套做法推得最遠的地方,因為規模極大(數百萬個身分、百萬分之一的錯誤率),賭注也高(手機解鎖、邊境管制、警方搜尋)。
臉部辨識同時也是帶有真實社會成本的技術:錯誤不會平均落在不同群體身上,訓練資料常在未經同意下蒐集,有些用途還受到法律限制。本篇把這些主題當成工程的一部分來談,陳述事實,並附上查證過的來源。
兩份綜述構成這個領域的骨架:Wang 與 Deng 對深度臉部辨識的回顧 [1],以及 NIST 對商用演算法族群效應的報告 [2]。我們會在「現代觀點」回頭談這兩份文獻。
相關章節。 softmax、交叉熵、ROC 與校準的基礎在 DLCV 02。重識別、針對人的三元組損失與 CMC 指標在 DLCV 07。對比式學習與 InfoNCE 在 ML 06,影像–文字嵌入(CLIP)在 ML 10。最近鄰比對與開放集合拒絕的傳統觀點在 PR 04 與 PR 10。
辨識就是比較:開放集合問題
白話版。 驗證判斷兩張臉是否同一人,識別則搜尋已儲存身分;兩者都能比較訓練時未見的人。
驗證、識別、封閉集合與開放集合
令 為一張臉部影像, 為它的嵌入,由參數為 的網路產生。比較兩張影像 會得到一個相似度分數
其中 是歐氏範數。已經儲存參考影像的人稱為已註冊(enrolled);他們儲存的嵌入(每人一個或多個)構成圖庫(gallery),而要被辨識的新影像稱為探測影像(probe)。一個固定的門檻(threshold) 把分數轉成決定。
| 任務 | 問題 | 輸出 | 典型用途 |
|---|---|---|---|
| 驗證(1:1) | 探測影像 是宣稱的那個人 嗎? | 若 就接受,否則拒絕 | 手機解鎖、護照閘門 |
| 封閉集合識別(1:N) | 是 位已註冊者中的哪一位? | 基準測試;已知、封閉的群體 | |
| 開放集合識別(1:N) | 有註冊嗎?如果有,是誰? | 最佳匹配的分數 就回傳它,否則回答「未註冊」 | 監控名單、照片搜尋 |
| 分類(DLCV 02) | 屬於哪個訓練類別? | 訓練時見過的類別之一 | 測試時不用在人臉上 |
這裡 是第 位的圖庫嵌入, 是圖庫大小。圖 1 畫出三種辨識任務。重點在最後一列:臉部分類器的類別是訓練時的身分,而測試時幾乎每張探測影像都屬於別人。NIST 對實際部署系統運作方式的描述也是同一個意思:臉部辨識演算法內建的並不是某個特定的人;它從通常沒見過的人身上抽出特徵向量,比較兩個向量來得到分數 [2]。
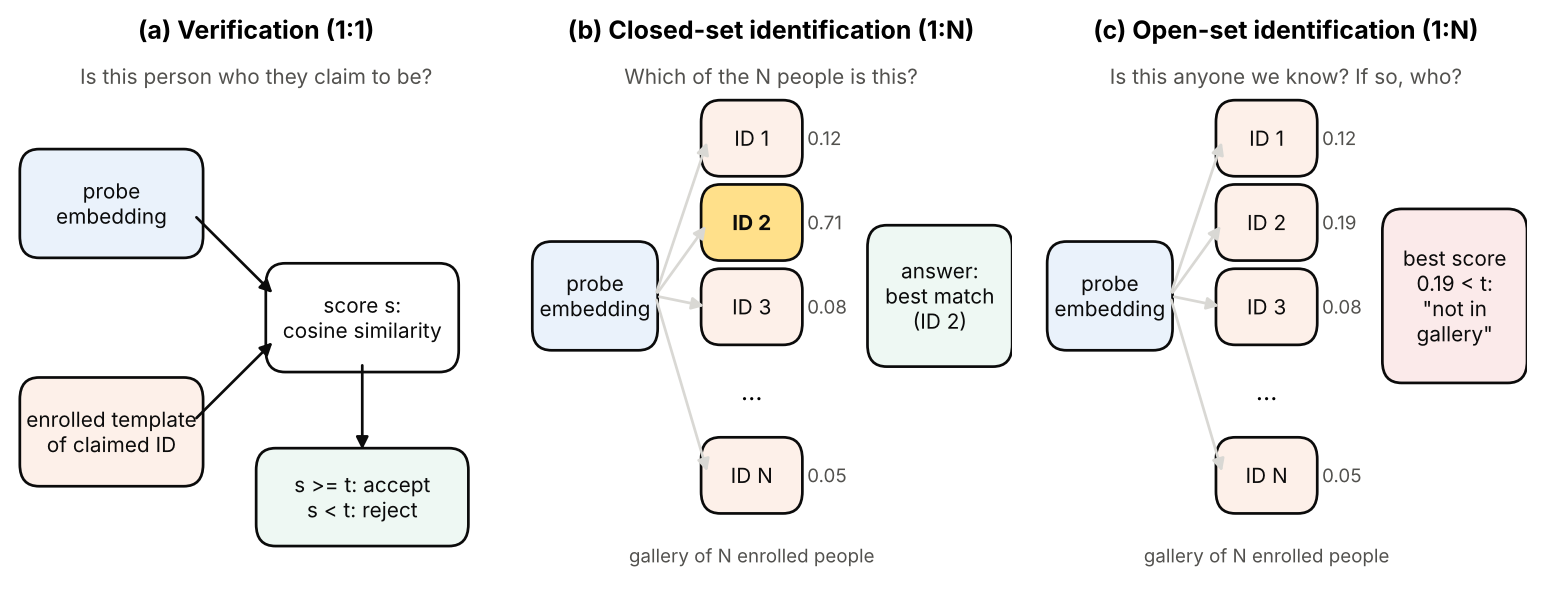
封閉集合與開放集合是評估方式的性質,不是網路的性質。封閉集合識別的測試保證每張探測影像在圖庫中都有對應的人,所以「挑最佳匹配」原則上一定正確。開放集合測試包含未註冊者的探測影像,這時門檻就不可避免。多數真實的搜尋都是開放集合。一般分類器也有同樣的區別,稱為開放集合辨識,見 PR 10;對臉部而言,這是常態,不是邊緣情況。
為什麼不直接訓練一個分類器?
白話版。 分類器只為訓練身分配置輸出;辨識則重用學得的嵌入來比較新身分。
用 softmax 與交叉熵在 個身分上訓練標準分類器,其倒數第二層本來就已經很有用。DeepFace [6] 是最早的深度系統之一,它在一個擁有身分標籤、超過 4,000 人的資料集上訓練網路,並證明所學的表示可以推廣到不受限制的照片中的人臉;輸出層本身不會用在新的人身上。FaceNet [7] 則改為直接用三元組損失訓練嵌入。這兩條路線(分類式訓練與成對訓練)後來在 2017–2019 年匯流成以邊界為基礎的 softmax 損失,也就是我們下面要學的內容。
什麼樣的嵌入適合開放集合使用?SphereFace 把理想準則說成兩個性質:類別內的最大距離應該小於類別間的最小距離 [12]。普通分類器只要求每個訓練樣本落在決策邊界的正確一側,並不在乎類別是否緊密。邊界(margin)就是用來要求緊密度的方法。
臉部辨識流程
白話版。 先偵測臉部、定位特徵點,以旋轉與縮放對齊裁切影像,再計算嵌入。
- 偵測(detection)找出每張臉周圍的框。
- 特徵點定位(landmark localization)找出幾個關鍵點,通常是五個:兩個眼睛中心、鼻尖與兩個嘴角。
- 對齊(alignment)扭轉影像,使特徵點對上固定的模板,並裁切成固定大小的小影像(例如 像素)。
- 嵌入(embedding)把裁切影像映射成向量,通常做 正規化,使長度為 1。
- 比較(comparison)計算與一個模板(驗證)或圖庫(識別)的餘弦相似度,再套用門檻。
偵測與特徵點
臉部偵測是專門針對單一類別的物件偵測,DLCV 03 的一般想法都適用。傳統的里程碑是 Viola–Jones 串接分類器,在 DLCV 03 的傳統偵測器補充說明中有整理。臉部辨識文獻中常見的前端有兩種深度偵測器,兩者都在預測框的同時預測五個特徵點:
- MTCNN [4] 是三個卷積網路組成的串接結構,由粗到細預測臉部框與特徵點位置,訓練時使用線上困難樣本挖掘策略。
- RetinaFace [5] 是具有多工輸出頭的單階段偵測器;它的作者在 WIDER FACE 資料集上手動標註五個特徵點,並證明這項額外的監督有助於偵測困難的臉。
這些不是歷史細節:CosFace 用 MTCNN 的特徵點對齊臉部 [13],ArcFace 的期刊版本則用 RetinaFace 的特徵點 [16]。偵測器與特徵點的誤差會傳遞到後面每一步,所以辨識結果永遠是整條流程的結果。
以相似變換對齊
白話版。 我們希望每張臉都正對鏡頭、大小與位置相同。相似變換(旋轉、等比例縮放、平移)的彈性剛好足以做到這點,又不會扭曲臉的形狀。
相似變換(similarity transform)把點 映射為
其中 是縮放比例, 是旋轉角, 是平移量。它有四個參數 ,而且方程式對這些參數是線性的。給定偵測到的特徵點 與模板位置 ,我們選擇使 最小的參數:十條方程式、四個未知數,一次最小平方解。CosFace 與 SphereFace 都描述它們的裁切影像是由偵測到的特徵點「經相似變換」得到的 [12], [13]。
程式碼 · Python · 28 行
import numpy as np

# A toy 5-point template (left eye, right eye, nose tip, left and right mouth
# corners) in a 112 x 112 crop. The coordinates are our own illustration.
template = np.array([[38., 46], [74, 46], [56, 66], [42, 86], [70, 86]])

def fit_similarity(src, dst):
    """Least-squares a, b, tx, ty with dst ~ [[a, -b], [b, a]] @ src + t."""
    n = len(src)
    A = np.zeros((2 * n, 4))
    A[0::2] = np.c_[src[:, 0], -src[:, 1], np.ones(n), np.zeros(n)]
    A[1::2] = np.c_[src[:, 1],  src[:, 0], np.zeros(n), np.ones(n)]
    a, b, tx, ty = np.linalg.lstsq(A, dst.reshape(-1), rcond=None)[0]
    return np.array([[a, -b, tx], [b, a, ty]])

# "Detected" landmarks: the template rotated by 20 degrees, scaled by 1.8,
# shifted into a large photo, plus 1-pixel detector noise.
rng = np.random.default_rng(0)
ang, sc = np.radians(20), 1.8
R = sc * np.array([[np.cos(ang), -np.sin(ang)], [np.sin(ang), np.cos(ang)]])
detected = template @ R.T + [310, 205] + rng.normal(scale=1.0, size=(5, 2))

M = fit_similarity(detected, template)          # photo -> crop
warped = detected @ M[:, :2].T + M[:, 2]
scale = np.hypot(M[0, 0], M[1, 0])
print(f"scale {scale:.3f} (expect {1 / sc:.3f}), "
      f"rotation {np.degrees(np.arctan2(M[1, 0], M[0, 0])):.1f} deg (expect -20.0)")
print(f"RMS landmark error after alignment: {np.sqrt(((warped - template) ** 2).sum(1).mean()):.2f} px")
輸出
scale 0.559 (expect 0.556), rotation -19.8 deg (expect -20.0)
RMS landmark error after alignment: 0.56 px
這個擬合幾乎完全還原了縮放與旋轉,剩下的誤差(0.56 像素)就是 1 像素的特徵點雜訊經五個點平均後留下的部分。矩陣 M 接著用來把整張影像扭轉成裁切影像。
選讀:對齊臉部:最小平方相似變換(見「補充資料」頁)。正規方程式、為什麼避免使用完整的仿射或投影扭轉,以及特殊情況(鏡射、側臉、錯誤的特徵點)。
嵌入與模板
嵌入網路是 DLCV 02 中的普通影像骨幹(ResNet 或視覺 Transformer),只是最後一層輸出的是 維向量,而不是類別分數。FaceNet 用 [7];ArcFace 的實驗用 與 的裁切影像 [16]。當一個人用多張影像或一段影片註冊時,這些嵌入會合併成一個模板(template);ArcFace 直接取模板中所有影像的特徵中心(平均)[16]。既然網路的輸出在比較前會先正規化,把平均後的向量再正規化一次也就很自然。
超球面上的嵌入
白話版。 如果我們把每個嵌入縮放成長度 1,它們就全都落在一個球面上。於是「兩張臉有多像」變成「兩支箭頭之間的夾角有多小」。長度常常反映影像品質而不是身分,現在它不會再干擾比較。
為什麼要正規化,為什麼用餘弦
對單位向量 (即 ),
其中 是兩者的夾角。所以在球面上,歐氏距離平方與餘弦相似度給出相同的排序,對其中一個設門檻就等於對另一個設門檻。正規化拿掉了一個網路原本可能濫用的自由度:在沒有正規化的 softmax 中,網路只要把容易樣本的特徵拉長,就能降低它們的損失,而不必讓類別變得更緊密。NormFace 分析了這點,並證明直接在正規化後的特徵上訓練,需要額外的縮放因子才能收斂 [11]。
高維度還帶來一個有用的事實:隨機方向幾乎彼此正交。如果 與 在 的單位球面上獨立且均勻分佈,則 ,且 的標準差是 。因此異人分數會緊密聚集在 0 附近,門檻只需要超過這個狹窄分佈的尾端。
程式碼 · Python · 13 行
import numpy as np

rng = np.random.default_rng(0)
e = rng.normal(size=(2000, 512))
e /= np.linalg.norm(e, axis=1, keepdims=True)       # 2,000 random unit vectors
a, b = e[0], e[1]
cos = a @ b
print(f"cos = {cos:.4f}   |a-b|^2 = {np.sum((a - b) ** 2):.4f}   2-2cos = {2 - 2 * cos:.4f}")

S = e @ e.T
off = S[np.triu_indices(len(e), 1)]                 # all distinct pairs
print(f"random pairs: mean cos {off.mean():.4f}, std {off.std():.4f}, "
      f"1/sqrt(512) = {1 / np.sqrt(512):.4f}, max {off.max():.3f}")
輸出
cos = 0.0472   |a-b|^2 = 1.9057   2-2cos = 1.9057
random pairs: mean cos -0.0000, std 0.0442, 1/sqrt(512) = 0.0442, max 0.214
在 512 維的將近兩百萬個隨機配對中,最大的餘弦只有 0.214。訓練好的網路產生的不是隨機嵌入,但這個畫面仍然成立:不同的人落在接近 的夾角上,而訓練的工作就是把每個人的影像拉進圍繞同一方向的一個小球冠。
成對損失:對比損失與三元組損失
白話版。 訓練嵌入最直接的方法,是給網路看成對或三張一組的影像,並告訴它「這兩張應該靠近,那兩張應該遠離」。困難在於這類例子幾乎都已經很容易,除非我們去找困難的例子,否則網路從中學不到什麼。
對比損失
對比損失(contrastive loss)由 Chopra、Hadsell 與 LeCun [8] 為了用孿生網路做臉部驗證而提出,後來由 Hadsell、Chopra 與 LeCun [9] 發展完整,它一次看一對影像:
其中若這對影像是同一個人則 ,否則 ; 是邊界,。同人的配對會被拉近;異人的配對只會被推開,直到相距 為止。除了常數倍數與標籤約定外,這個平方 hinge 形式就是 [9] 中的形式;[8] 則提出了背後的想法:訓練孿生網路,讓學到的距離把同人與異人的配對分開。
三元組損失與困難負樣本挖掘
FaceNet [7] 的三元組損失(triplet loss)不是對距離設門檻,而是比較距離。它的定義,以及在重識別中的用法,見 DLCV 07 與 ML 06;FaceNet 的形式是在單位長度的嵌入上用距離平方:
其中 是錨點影像(anchor), 是正樣本(同一個人), 是負樣本(另一個人), 是嵌入, 是邊界。本章要補充的是挖掘(mining)問題。對一組距離平方為 的錨點–正樣本配對,一個距離平方為 的負樣本屬於:
- 容易(easy),若 (損失為零、梯度為零),
- 半困難(semi-hard),若 (比正樣本遠,但落在邊界之內;這是 FaceNet 的定義 [7]),
- 困難(hard),若 (比正樣本更近)。
FaceNet 在大的小批次內線上挑選半困難負樣本,因為訓練初期最困難的負樣本會導致不好的局部極小值 [7]。後來廣泛使用的另一種做法是批次內最困難(batch-hard)挖掘:在由 個身分 張影像組成的批次中,替每個錨點取最遠的正樣本與最近的負樣本 [10]。
程式碼 · Python · 26 行
import numpy as np

rng = np.random.default_rng(0)
P, Kimg, alpha = 8, 4, 0.2                  # 8 people x 4 images, margin
centres = rng.normal(size=(P, 64))
y = np.repeat(np.arange(P), Kimg)
e = centres[y] + 1.5 * rng.normal(size=(len(y), 64))
e /= np.linalg.norm(e, axis=1, keepdims=True)
d2 = ((e[:, None] - e[None]) ** 2).sum(-1)  # squared distances

easy = semi = hard = 0
for a in range(len(y)):
    for p in np.flatnonzero((y == y[a]) & (np.arange(len(y)) != a)):
        dn = d2[a, y != y[a]]               # distances to all negatives
        hard += (dn < d2[a, p]).sum()
        semi += ((dn >= d2[a, p]) & (dn < d2[a, p] + alpha)).sum()
        easy += (dn >= d2[a, p] + alpha).sum()
tot = easy + semi + hard
print(f"{tot} triplets: easy {easy / tot:.1%}, semi-hard {semi / tot:.1%}, hard {hard / tot:.1%}")

# batch-hard: for each anchor, farthest positive and closest negative
same = y[:, None] == y[None]
hp = np.where(same, d2, -np.inf).max(1)
hn = np.where(~same, d2, np.inf).min(1)
loss = np.maximum(hp - hn + alpha, 0)
print(f"batch-hard loss {loss.mean():.3f}; anchors with non-zero loss: {(loss > 0).sum()} of {len(y)}")
輸出
2688 triplets: easy 92.8%, semi-hard 5.4%, hard 1.9%
batch-hard loss 0.213; anchors with non-zero loss: 28 of 32
在這個合成的批次中,全部 2,688 組有效三元組裡有 92.8% 屬於容易,沒有任何貢獻。對所有三元組取平均會稀釋少數有用的三元組;批次內最困難挖掘則為 32 個錨點中的 28 個找到非零損失。這是人臉規模下成對訓練的核心弱點:可能的三元組數量隨資料集大小的三次方增長,幾乎全都是容易的,結果還取決於取樣策略與批次的組成。
以邊界為基礎的 softmax 損失
白話版。 與其讓影像彼此比較,不如給每個訓練身分一個學出來的「錨定方向」放在球面上,並訓練每張影像以明確的邊界指向自己身分的方向:不只比指向其他方向更近,而是近一個固定的角度。這樣每張影像只有一項損失,就同時與所有身分比較。
從 softmax 到正規化 softmax
從 DLCV 02 的 softmax 交叉熵出發。對影像 的特徵 ,其身分標籤為 ,最後一層的權重行向量為 、偏差為 ,損失為
令 ,並把 logit 寫成 ,其中 是 與 之間的夾角。現在把兩者都正規化:,並把 固定為常數 。這時 logit 是 ,預測只取決於角度 [11], [13], [16]:
尺度 是必要的,因為餘弦落在 :沒有它,即使角度排列得完美,softmax 仍然離有信心很遠,損失就降不下來。NormFace 分析了這種無法收斂的現象 [11],CosFace 則推導出 的一個下界,隨類別數增加而增大 [13];CosFace 與 ArcFace 都使用 [13], [16]。
選讀:尺度 s 要多大?(見「補充資料」頁)。CosFace 的下界與每個符號的定義、一個計算實例,以及 太小或太大會出什麼問題。
現在每一行 都是單位向量:球面上身分 的類別中心(class center),也叫代理點(proxy)。這是與成對損失相比最關鍵的結構改變。每張影像在每一步都與全部 個類別中心比較,所以沒有什麼需要挖掘,而且比較是全域的,不受限於一個批次。類別中心只用於訓練;測試時會丟掉最後一層,只保留嵌入網路 [16]。
加上邊界的三種方式
正規化 softmax 在對所有 都有 時就算滿足:特徵與自己的中心之間的夾角,比與任何其他中心的都小。這會把決策邊界剛好放在兩個中心的正中間,所以靠近邊界的樣本雖然正確,卻只是勉強正確。邊界(margin)把目標 logit 從 改成 ,其中 ,使目標 logit 更難達成,其他 logit 仍是 :
三個經典損失只在 上不同:
| 損失 | 目標 logit | 邊界類型 | 論文中的數值 |
|---|---|---|---|
| SphereFace(A-Softmax)[12] | ,延伸成保持單調(見下) | 乘法式角度邊界 | |
| CosFace(LMCL)[13];也有 AM-Softmax [14] | 加法式餘弦邊界 | 、 | |
| ArcFace [15], [16] | 加法式角度邊界 | 、 |
這裡 是邊界(SphereFace 為整數,CosFace 為餘弦的偏移量,ArcFace 為以弧度表示的角度), 是樣本與自己的類別中心之間的夾角;最後一欄列的是論文中報告的數值。由於 在 上不是單調的,SphereFace 對 、 使用 [12]。最初的 SphereFace 只正規化權重,訓練初期還需要普通 softmax 的幫助 [16]。AM-Softmax [14] 與 CosFace 大約同時發表,用的是同樣的加法式餘弦邊界。
程式碼 · Python · 12 行
import numpy as np

def sphereface_psi(theta, m=4):
    """SphereFace's monotone extension of cos(m*theta) to [0, pi]."""
    k = np.floor(theta * m / np.pi)
    return (-1) ** k * np.cos(m * theta) - 2 * k

print(" angle  softmax  SphereFace  CosFace  ArcFace")
for deg in [10, 30, 45, 60, 90]:
    t = np.radians(deg)
    print(f"{deg:5d}   {np.cos(t):6.3f}   {sphereface_psi(t):8.3f}   "
          f"{np.cos(t) - 0.35:6.3f}   {np.cos(t + 0.5):6.3f}")
輸出
 angle  softmax  SphereFace  CosFace  ArcFace
   10    0.985      0.766    0.635    0.781
   30    0.866     -0.500    0.516    0.520
   45    0.707     -1.000    0.357    0.282
   60    0.500     -1.500    0.150    0.024
   90    0.000     -3.000   -0.350   -0.479
這張表列出五個角度下的目標 logit(除以 )。每種邊界都會降低正確類別的 logit,所以損失要等到角度很小才會變小。懲罰的增長方式各不相同:CosFace 在每個角度都減去同樣的 0.35;ArcFace 的懲罰在 附近很小(在 為 0.204),角度越寬越大; 的 SphereFace 在寬角度時非常嚴格。
圓上的幾何
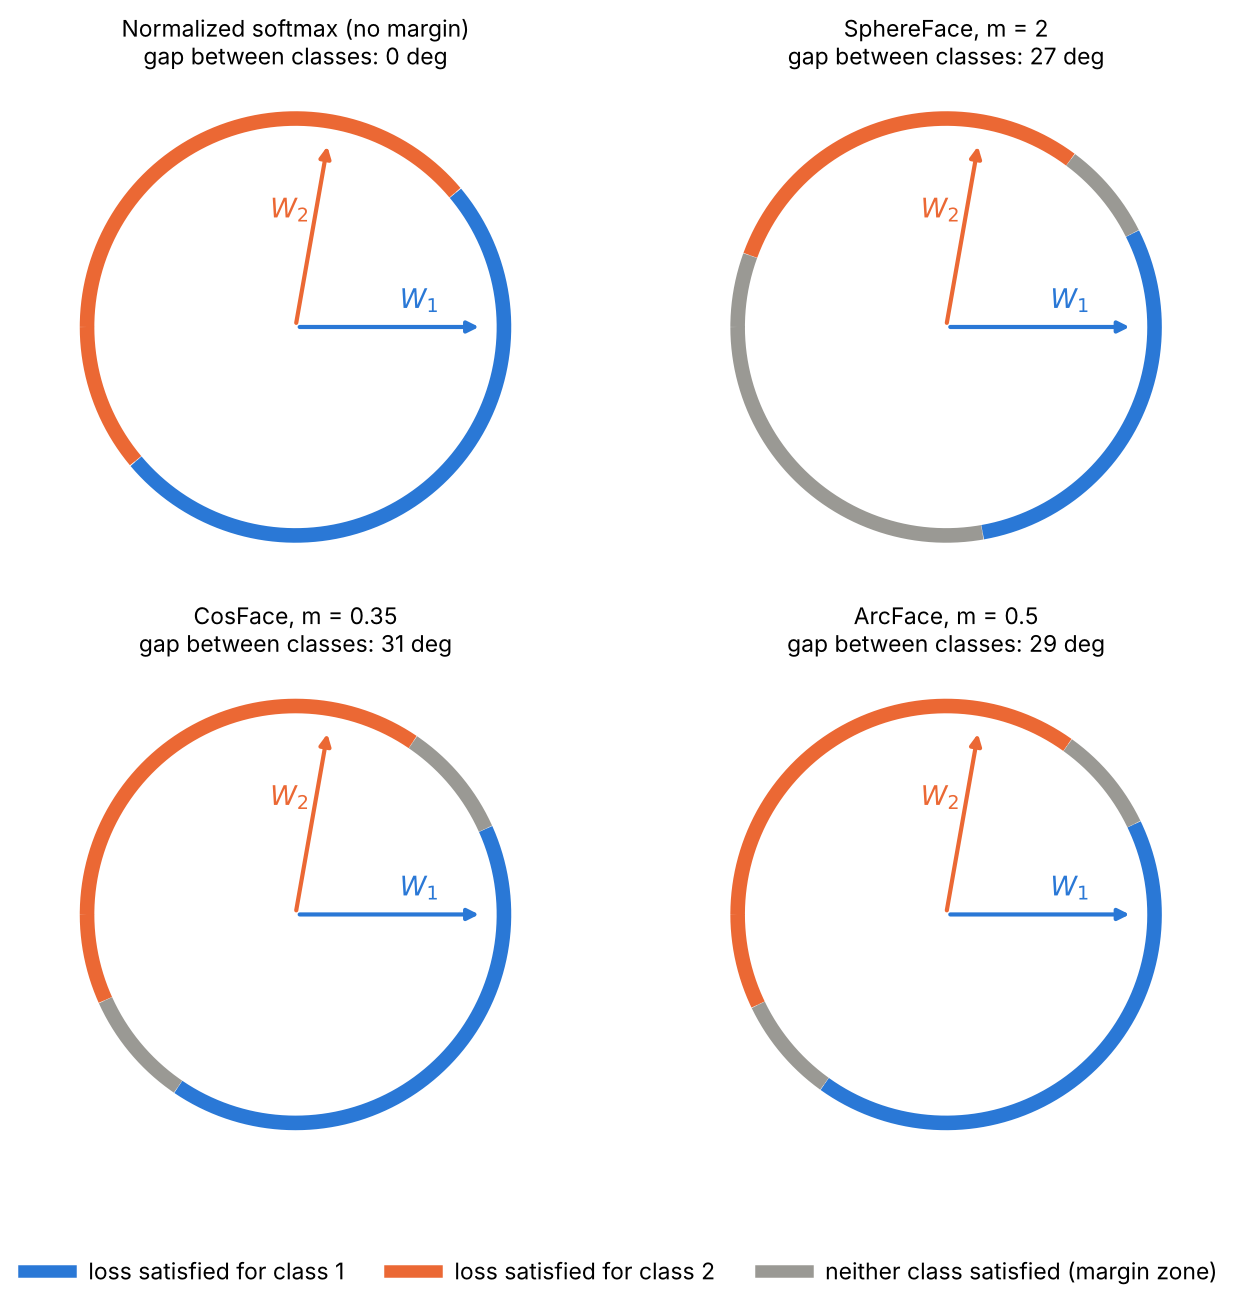
白話版。 想像圓上有兩個類別中心。沒有邊界時,圓恰好被它們平分。有了邊界,每個類別只佔不到一半,中間有一段不屬於任何人的區域:落在那裡的樣本仍然有損失。訓練會把樣本推出這段區域,推向自己的中心。
兩個類別的中心 相距角度 ,一個特徵落在它們之間的弧上,當 (其中 )時,類別 1 的樣本就「滿足」了。解出來就是類別 1 的邊界:
- 正規化 softmax:(沒有間隙);
- SphereFace:,所以 ;兩個類別邊界之間的間隙是 ,它隨 增加;
- CosFace:;間隙在餘弦上是固定量,所以它在角度上的大小取決於 ;
- ArcFace:,所以 ;間隙對任何 都恰好是 弧度。
ArcFace 的作者稱這個邊界等於超球面上的測地距離(geodesic distance),這就是名稱的由來 [15], [16]。圖 2 畫出 時的四種情況;SphereFace 用 ,好讓它的區域能放進同一張圖。
從公式還可以得到一個實務細節: 只有在 時才遞減。對於與自己中心的夾角大於 的樣本(嚴重分類錯誤或標籤錯誤的樣本),ArcFace 的目標 logit 在樣本越離越遠時反而會開始上升。實作必須明確處理這個範圍,例如在那裡改用單調的懲罰。在下面的玩具程式中,所有角度都遠低於這個範圍。
選讀:並排比較邊界損失:一個公式與它的特殊情況(見「補充資料」頁)。組合邊界 、每個邊界的推導、ArcFace logit 的梯度,以及為什麼容易的樣本會停止貢獻。
玩具實驗:softmax 對 ArcFace
白話版。 我們用同一個小網路在合成的「人臉」上訓練兩次:一次用普通 softmax,一次用 ArcFace。然後看訓練集的叢集有多緊密,更重要的是,網路能多好地區分它沒見過的人。
資料模仿人臉問題。每個合成身分是 16 維輸入裡 4 維「身分」子空間中的一個隨機點;每張影像還會在其餘 12 個維度加上很大的隨機「干擾」成分(代表姿勢與光線),並在所有維度加上小雜訊。網路是一個 64 個 ReLU 單元的隱藏層,後面接一個線性映射到 的嵌入。前向傳遞與梯度都用手寫實作,包括通過正規化與通過 的連鎖律,並使用普通的梯度下降。我們在 100 個身分上訓練,並在 50 個訓練時從未出現的身分上測試驗證。固定 FAR = 1% 的 TAR(下一節定義)是:當門檻讓 1% 的異人配對通過時,被接受的同人測試配對的比例。
程式碼 · Python · 61 行
import numpy as np

rng = np.random.default_rng(0)
D, K = 16, 4                                      # input dim, identity dims
U = np.linalg.qr(rng.normal(size=(D, D)))[0]      # random orthonormal basis

def sample(ids, n_per):
    """Identity signal in 4 directions, large 'pose/light' nuisance in 12."""
    y = np.repeat(np.arange(len(ids)), n_per)
    nuis = 1.5 * rng.normal(size=(len(y), D - K))
    x = ids[y] @ U[:, :K].T + nuis @ U[:, K:].T + 0.3 * rng.normal(size=(len(y), D))
    return x, y

unit = lambda v, ax: v / np.linalg.norm(v, axis=ax, keepdims=True)

def train(x, y, C, d=4, margin=None, s=16.0, steps=800, lr=0.2, H=64):
    """One-hidden-layer embedding net + class centres W, plain gradient descent.
    margin=None: ordinary softmax on raw features; otherwise ArcFace logits."""
    r = np.random.default_rng(1)
    W1 = r.normal(size=(D, H)) / 4; b1 = np.zeros(H)
    W2 = r.normal(size=(H, d)) / 8; W = r.normal(size=(d, C))
    Y = np.eye(C)[y]
    for _ in range(steps):
        h = np.maximum(x @ W1 + b1, 0); z = h @ W2          # embeddings
        if margin is None:
            L = z @ W
        else:
            f, w = unit(z, 1), unit(W, 0)
            th = np.arccos(np.clip(f @ w, -1 + 1e-7, 1 - 1e-7))   # angles to centres
            L = s * np.where(Y > 0, np.cos(th + margin), np.cos(th))
        p = np.exp(L - L.max(1, keepdims=True)); p /= p.sum(1, keepdims=True)
        g = (p - Y) / len(y)                                  # dLoss/dlogits
        if margin is None:
            gz, gW = g @ W.T, z.T @ g
        else:                                                 # chain rule through cos(theta+m)
            gc = g * s * np.where(Y > 0, np.sin(th + margin) / np.sin(th), 1.0)
            gf, gw = gc @ w.T, f.T @ gc
            gz = (gf - (gf * f).sum(1, keepdims=True) * f) / np.linalg.norm(z, axis=1, keepdims=True)
            gW = (gw - (gw * w).sum(0, keepdims=True) * w) / np.linalg.norm(W, axis=0, keepdims=True)
        gh = (gz @ W2.T) * (h > 0)
        W1 -= lr * x.T @ gh; b1 -= lr * gh.sum(0); W2 -= lr * h.T @ gz; W -= lr * gW
    return lambda xx: unit(np.maximum(xx @ W1 + b1, 0) @ W2, 1)

def intra_angle(e, y):            # mean angle (degrees) to own class mean direction
    cen = unit(np.stack([e[y == j].mean(0) for j in np.unique(y)]), 1)
    return np.degrees(np.arccos(np.clip((e * cen[y]).sum(1), -1, 1))).mean()

def tar_at_far(e, y, far=0.01):   # verification on all pairs of unseen people
    i, j = np.triu_indices(len(y), 1)
    sc, same = (e[i] * e[j]).sum(1), y[i] == y[j]
    thr = np.quantile(sc[~same], 1 - far)
    return (sc[same] > thr).mean()

ids = rng.normal(size=(150, K))
xtr, ytr = sample(ids[:100], 10)          # 100 training identities
xte, yte = sample(ids[100:], 10)          # 50 identities never seen in training
for name, m in [("softmax", None), ("norm-softmax", 0.0), ("ArcFace m=0.5", 0.5)]:
    emb = train(xtr, ytr, 100, margin=m)
    print(f"{name:14s} train intra {intra_angle(emb(xtr), ytr):5.1f} deg | "
          f"unseen intra {intra_angle(emb(xte), yte):5.1f} deg | "
          f"unseen TAR@FAR=1% {tar_at_far(emb(xte), yte):.3f}")
輸出
softmax        train intra  27.1 deg | unseen intra  43.9 deg | unseen TAR@FAR=1% 0.082
norm-softmax   train intra  16.1 deg | unseen intra  30.1 deg | unseen TAR@FAR=1% 0.098
ArcFace m=0.5  train intra  11.6 deg | unseen intra  24.4 deg | unseen TAR@FAR=1% 0.248
這個腳本在 CPU 上大約跑十秒。在這次玩具實驗中,訓練影像到其類別中心的平均夾角,從 27.1°(softmax)降到 16.1°(只做正規化),再降到 11.6°(ArcFace),而沒見過的人的叢集也縮緊了(43.9° 到 24.4°)。FAR = 1% 時,對未見過的人的驗證率大約變為三倍,從 0.082 到 0.248。有兩點提醒。第一,絕對數字偏低,因為對有雜訊的資料用 4 維嵌入本來就是困難的問題;只有比較才有意義。第二,這些都是單次執行;換另外兩個隨機種子,在我們的執行中 softmax < 正規化 softmax < ArcFace 的順序維持不變,但確切的數值會改變。
圖 3 在有六個身分的二維嵌入中呈現同樣的效果,可以直接看出來:softmax 讓每個類別沿著一條射線散開(它可以靠拉長特徵來降低損失),而 ArcFace 把每個類別擠進一小段弧。
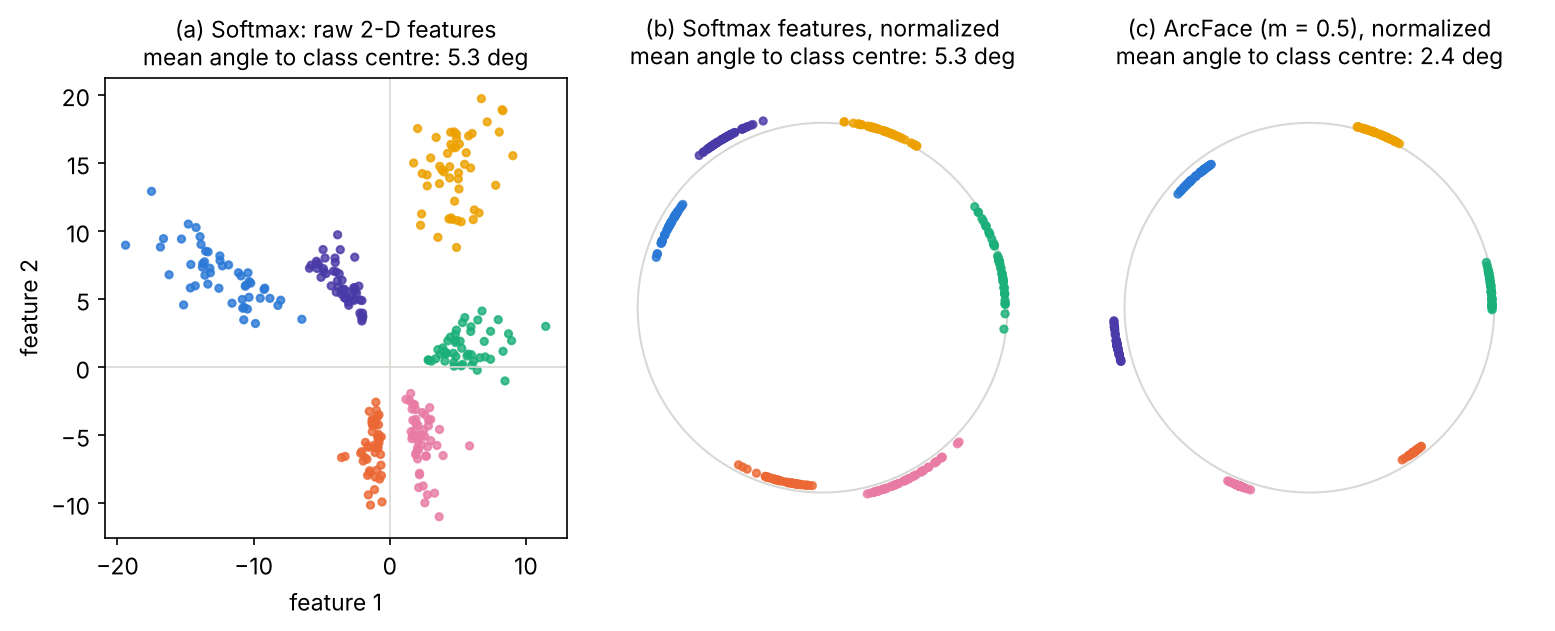
邊界會直接讓訓練身分的叢集變緊。這是否能推廣到新的人,取決於訓練身分有多少、多樣到什麼程度;訓練身分很少時,網路可以把它們完美分開,卻什麼一般性的東西都沒學到。這就是臉部辨識訓練集要包含數十萬到數百萬個身分的原因之一(見資料集一節)。
類別中心、子中心與自適應邊界
白話版。 一旦每個身分有了中心,幾種改良就很自然地出現。它們都保留邊界 softmax,只改變中心或邊界的某一件事。
中心損失(center loss)[17] 比角度損失更早出現,它把每個特徵拉向學出來的類別中心。Sub-center ArcFace [18], [16] 給每個身分多個中心,讓有雜訊或標籤錯誤的影像可以聚集在遠離乾淨影像的地方。MagFace [19] 與 AdaFace [20] 把邊界連到影像品質(利用特徵的大小),讓品質很差的影像不會主導訓練。Partial FC [21] 每一步只更新被取樣的一部分中心,來降低數百萬個中心的成本。要記住的只有一點:類別中心是訓練用的工具,這些方法調整的是影像被拉向它們的嚴格程度與成本。
選讀:一個類別不只一個中心:子中心、品質感知邊界與 Partial FC(見「補充資料」頁)。每種變體如何改變損失、它針對的問題,以及使用時要注意什麼。
評估驗證
白話版。 取很多組同一個人的照片配對(同人配對,genuine pairs),以及很多組不同人的配對(異人配對,impostor pairs)。好的系統會給同人配對高分,給異人配對低分。任何一個門檻都要在兩種錯誤之間取捨:放冒名者進來,以及把真正的使用者擋在門外。
同人與異人分數,FAR 與 TAR
對分數 的門檻 ,
FAR 是誤接受率(false accept rate),FRR 是誤拒絕率(false reject rate),TAR 是真接受率(true accept rate)。NIST 的評估在一對一比較中使用等價的名稱:誤匹配率(false match rate, FMR)與誤不匹配率(false non-match rate, FNMR)[2], [3]。這正是 DLCV 02 中的假陽性率與假陰性率;這裡的「陽性」類別是「同一個人」。
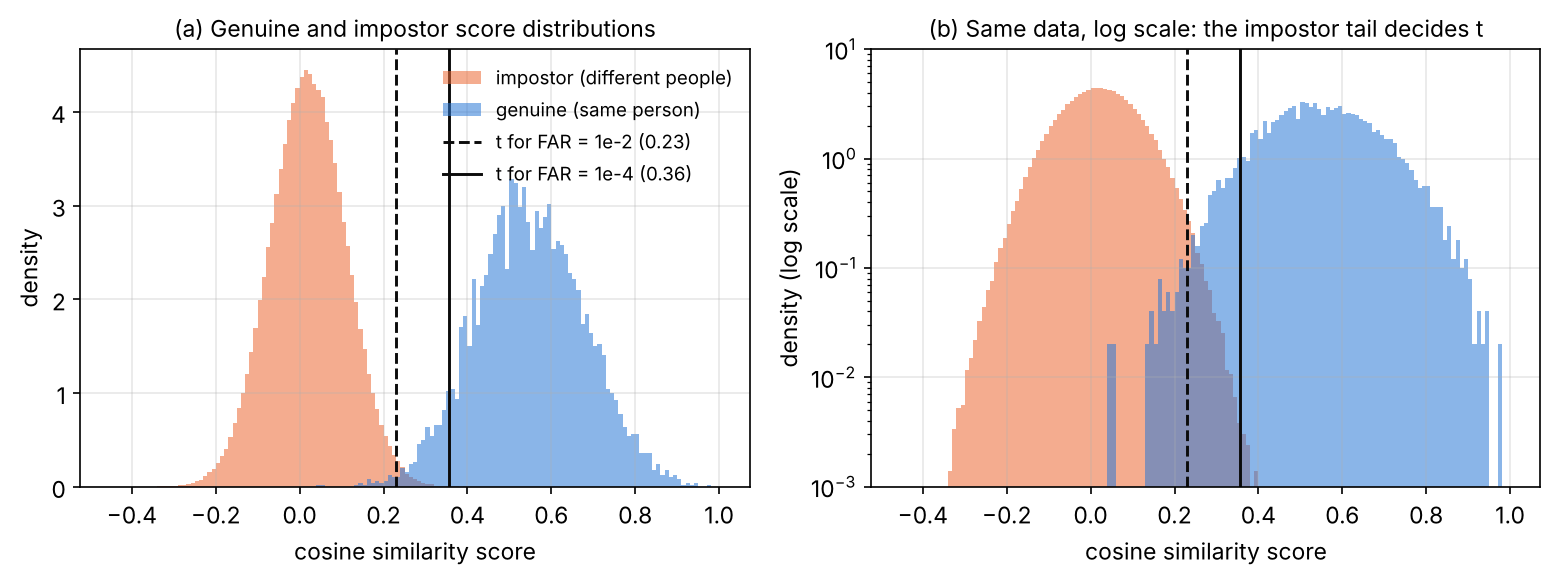
兩種分佈的大小差距很大。若有 個人、每人 張影像,則同人配對有 組,異人配對約有 組,隨 的平方增長。因為異人配對這麼多,工作點會寫成固定 FAR 下的 TAR:「TAR@FAR = 」是把門檻設在每一萬組異人配對只接受一組時,被接受的同人配對的比例。IJB-B 與 IJB-C 等基準回報 TAR@FAR = [16],NIST 持續進行的一對一評估則在它的某個資料集上,依 FMR = 時的 FNMR 為演算法排名 [3]。
程式碼 · Python · 15 行
import numpy as np
from sklearn.metrics import roc_curve

rng = np.random.default_rng(0)
genuine = np.clip(rng.normal(0.55, 0.13, 5_000), -1, 1)       # same-person cosines
impostor = np.clip(rng.normal(0.02, 0.09, 500_000), -1, 1)    # different-person cosines
y = np.r_[np.ones(genuine.size), np.zeros(impostor.size)]
fpr, tpr, thr = roc_curve(y, np.r_[genuine, impostor])

for far in [1e-2, 1e-3, 1e-4]:
    i = np.searchsorted(fpr, far, side="right") - 1          # last point with FPR <= far
    print(f"FAR <= {far:.0e}: threshold {thr[i]:.3f}, TAR {tpr[i]:.3f}, "
          f"false accepts {int(round(fpr[i] * impostor.size))}")
i = np.argmin(np.abs(fpr - (1 - tpr)))
print(f"EER ~ {(fpr[i] + 1 - tpr[i]) / 2:.4f} at threshold {thr[i]:.3f}")
輸出
FAR <= 1e-02: threshold 0.231, TAR 0.994, false accepts 4825
FAR <= 1e-03: threshold 0.300, TAR 0.975, false accepts 495
FAR <= 1e-04: threshold 0.356, TAR 0.936, false accepts 49
EER ~ 0.0072 at threshold 0.241等錯誤率(equal error rate, EER)是 FAR 等於 FRR 的門檻處的錯誤率;它是方便的單一數字,但描述的工作點是安全系統很少會採用的。請注意門檻如何移動:把 FAR 從 降到 ,門檻從 0.231 升到 0.356,並讓 TAR 少了 5.8 個百分點。也請注意最後一行依據的錯誤有多少:只有 49 次誤接受。用 500,000 組異人配對完全無法量測 的 FAR;你需要數百萬組,而且這些配對必須相當獨立。
選讀:量測極小的錯誤率(見「補充資料」頁)。「三法則」(rule of three)、二項式信賴區間,以及為什麼由同樣影像組成的異人配對並不獨立。
ROC 與 DET 曲線
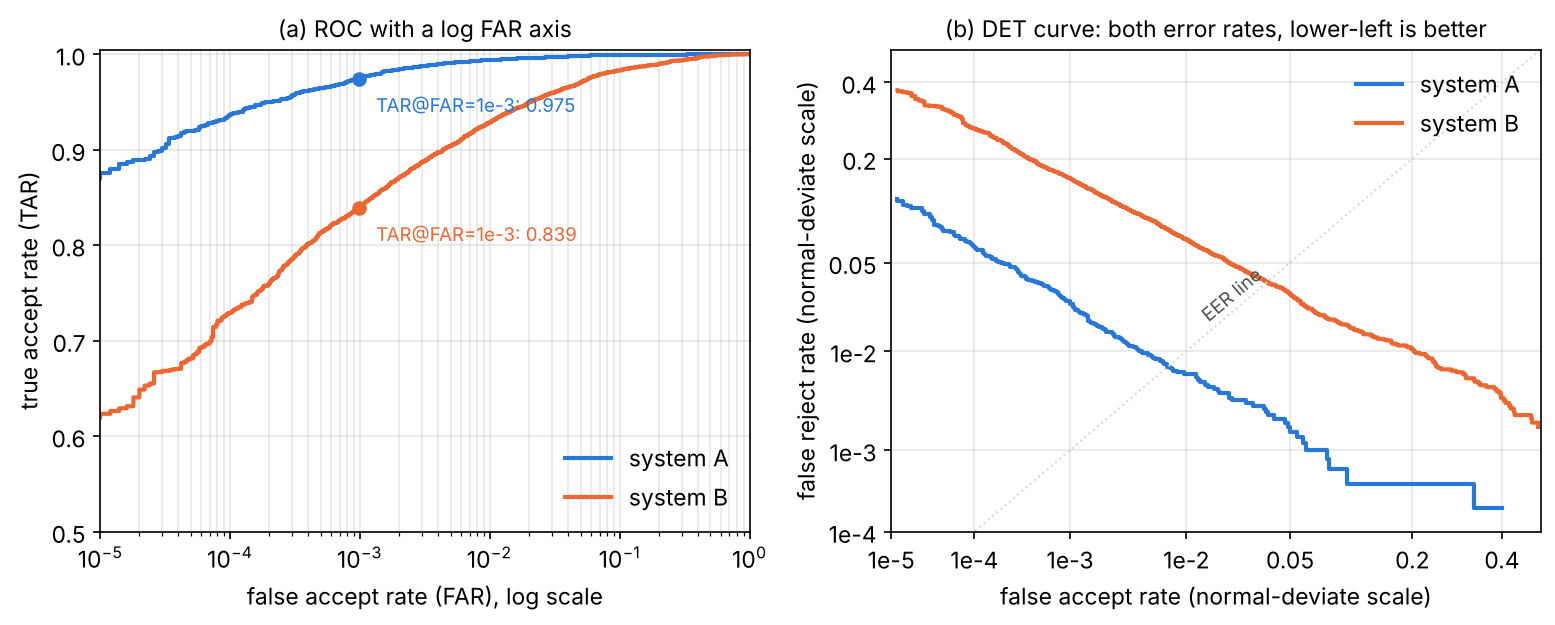
DLCV 02 的 ROC 曲線畫的是 TAR 對 FAR。臉部驗證常適合使用對數 FAR 軸:例如 FAR 介於 與 的操作區域,在線性軸上會被擠到左邊緣。座標尺度是呈現方式,不是 ROC 定義的一部分;零 FAR 也不能畫在對數軸上。偵測錯誤權衡曲線(detection error trade-off, DET)[22] 畫出兩種錯誤率,也就是 FRR 對 FAR,兩個軸都用標準常態累積分佈函數的反函數 轉換(「常態離差」尺度)。如果同人與異人分數都是高斯分佈,DET 曲線就是一條直線,越靠左下越好。Martin 等人為語者辨識提出它,並解釋了它為何傾向接近線性 [22];現在它是生物辨識系統的標準工具。
選擇門檻
門檻是系統的一部分,不是網路的一部分,而且必須在能代表部署情境的資料上選擇。從上面的公式可以得到三條規則。(1) 根據應用場景決定你能容忍的 FAR(手機解鎖與鑑識搜尋的代價差很多),再把 設成留出資料集上異人分數的對應分位數;在測試集上調整 會高估結果。(2) 在該門檻下,同時回報 TAR 與 FAR,絕不只報其中一個。(3) 確認你部署環境的異人分數,看起來與校準集相似:新的相機、新的族群或新的影像品質,都會改變異人分佈,因此改變固定 下的真實 FAR。最後一點我們會在公平性一節回頭談。
評估識別
白話版。 在搜尋中,探測影像要與每一位已註冊者比較。在封閉集合測試中,我們問:正確的人有沒有排第一(或在前 名內)?在開放集合測試中,我們還要問:當這個人根本沒有註冊時,系統有沒有保持沉默?
封閉集合:rank-1 與 CMC 曲線
對封閉集合識別,把圖庫依與探測影像的相似度排序。Rank-1 準確率是對應者排第一的探測影像比例,而累積匹配特徵(cumulative match characteristic, CMC)CMC() 是對應者在前 名內的比例。公式與程式碼在 DLCV 07;臉部圖庫通常每人只有一個模板,所以很少用 mAP。
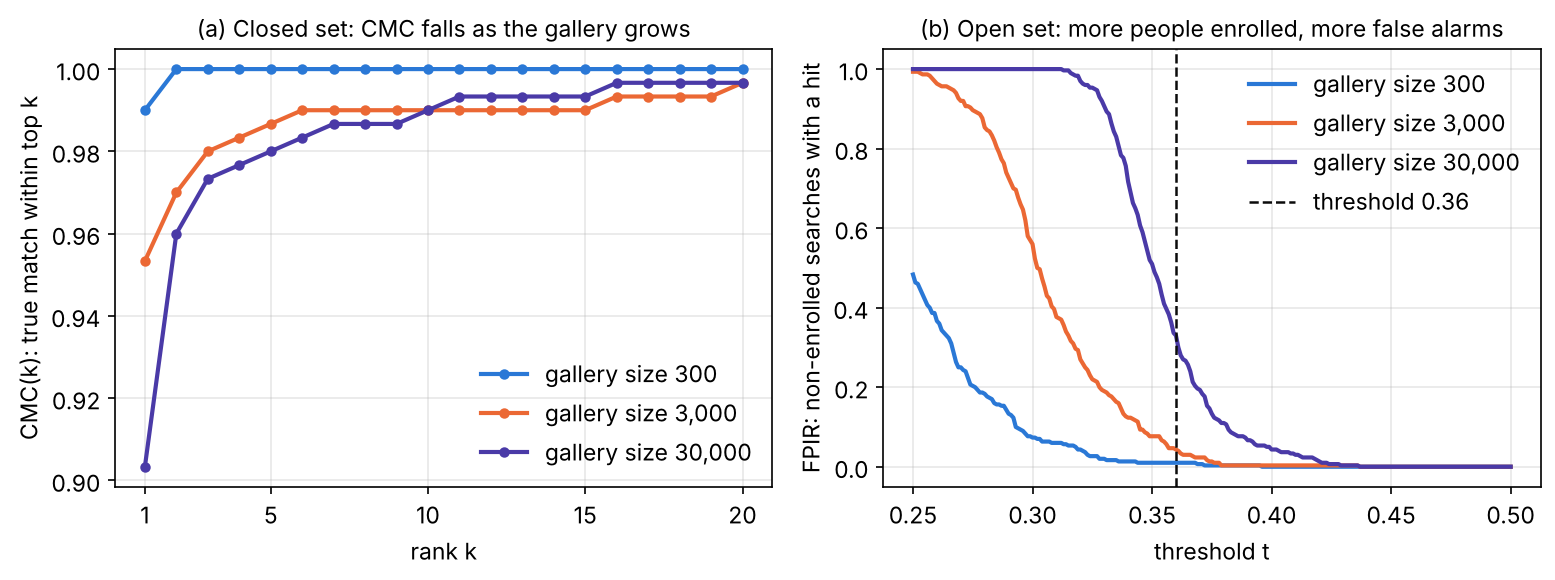
關鍵的影響因素是圖庫大小。每多一位已註冊者,就多一次冒名者得分超過真正對應者的機會。MegaFace 就是為了衡量這件事而建立:它在圖庫中加入多達一百萬張干擾照片,並回報干擾者數量從 10 增加到 1M 時的識別與驗證結果 [24]。
開放集合:FNIR 與 FPIR
在開放集合搜尋中,只有當候選者的分數達到門檻 時,系統才回傳它。兩個錯誤率描述這種情況 [2]:
有對應者(mated)的搜尋是指探測影像的那個人已經註冊;無對應者(non-mated)的搜尋是指探測影像的那個人沒有註冊。FNIR(假陰性識別率,false negative identification rate)與 FPIR(假陽性識別率,false positive identification rate)在一對多搜尋中扮演的角色,分別相當於 FRR 與 FAR;在這個簡化版本中,只有第 1 名的候選者才會被回傳。如果一個無對應者探測影像的 次圖庫比較,每一次都是誤匹配率為 FMR() 的獨立試驗,則
所以在固定門檻下,FPIR 大致與圖庫大小成正比。這就是為什麼一對多搜尋需要比驗證低得多的一對一誤匹配率。
程式碼 · Python · 22 行
import numpy as np

rng = np.random.default_rng(0)
dim, noise = 128, 1.1
unit = lambda v: v / np.linalg.norm(v, axis=-1, keepdims=True)

def identify(n_gallery, n_probe=300, thr=0.36):
    people = rng.normal(size=(n_gallery + n_probe, dim))
    gallery = unit(people[:n_gallery] + noise * rng.normal(size=(n_gallery, dim)))
    mated = rng.choice(n_gallery, n_probe, replace=False)             # enrolled people
    p_in = unit(people[mated] + noise * rng.normal(size=(n_probe, dim)))
    p_out = unit(people[n_gallery:] + noise * rng.normal(size=(n_probe, dim)))  # not enrolled
    S_in, S_out = p_in @ gallery.T, p_out @ gallery.T
    rank1 = (S_in.argmax(1) == mated).mean()
    # open set: a search "returns" the top candidate only if its score >= thr
    fnir = 1 - ((S_in.argmax(1) == mated) & (S_in.max(1) >= thr)).mean()
    fpir = (S_out.max(1) >= thr).mean()
    return rank1, fnir, fpir

for n in [300, 3_000, 30_000]:
    r1, fnir, fpir = identify(n)
    print(f"gallery {n:6d}: rank-1 {r1:.3f} | threshold 0.36: FNIR {fnir:.3f}, FPIR {fpir:.3f}")
輸出
gallery    300: rank-1 0.990 | threshold 0.36: FNIR 0.090, FPIR 0.010
gallery   3000: rank-1 0.953 | threshold 0.36: FNIR 0.113, FPIR 0.043
gallery  30000: rank-1 0.903 | threshold 0.36: FNIR 0.117, FPIR 0.330
在同樣的合成嵌入品質下,圖庫從 300 人增加到 30,000 人,rank-1 從 0.990 降到 0.903;在固定門檻下,未註冊的探測影像觸發誤報的比例,從 1% 升到 33%。圖 6 是類似實驗的 CMC 曲線與 FPIR 對門檻曲線。沒有圖庫大小的識別結果毫無意義,而且圖庫變大時,開放集合系統必須重新設定門檻。
資料集與基準
白話版。 臉部的訓練集是依人分組的大量網路照片清單;測試集則以固定的協定定義配對或搜尋。有幾個最知名的資料集是在未經照片中人物同意的情況下從網路蒐集的,其中有些已經被撤下。
| 資料集 | 角色 | 內容(依其來源的描述) | 狀態 |
|---|---|---|---|
| LFW [23] | 驗證測試 | 不受限制的新聞照片;約 13K 張照片、5K 個人 [24] | 已飽和;2019 年加上免責聲明,警告不可由它推斷商用適用性 [30] |
| IJB-B [27] | 驗證、識別、分群 | 1,845 位受試者;21,798 張靜態影像,以及來自 7,011 段影片的 55,026 個影格,附人工標註的框與眼睛/鼻子位置 | 標準測試集;媒體採用創用 CC 授權 [27] |
| IJB-C [28] | 同 IJB-B,規模更大 | 3,531 位受試者;31.3K 張靜態影像,以及來自 11,779 段影片的 117.5K 個影格 [16] | 標準測試集 [16] |
| MegaFace [24], [25] | 大規模識別 | 超過 690K 個人的 1M 張干擾照片;後來的訓練集有 672,057 個身分的 4.7M 張照片 | 已停止營運;資料不再發布 [25] |
| MS-Celeb-1M [26] | 訓練 | 網路影像,用於辨識與知識庫連結的一百萬名名人的基準 | 2019 年 4 月下架 [30] |
| WebFace260M / WebFace42M [29] | 訓練 | 4M 個身分/260M 張臉(含雜訊),以及清理後的 2M 個身分/42M 張臉 | 作者描述為最大的公開訓練集 [29] |
| DigiFace-1M [31] | 訓練 | 用電腦圖學管線算繪的合成臉 | 合成資料,不是真人照片 |
LFW(Labeled Faces in the Wild)[23] 定義了不受限制的臉部驗證與其標準協定。它的準確率現在已經飽和:最先進的模型在上面超過 99.8% [31],所以它不再能區分好系統與很好的系統。IJB-B 與 IJB-C(IARPA Janus Benchmarks)[27], [28] 取代它成為標準的學術測試:它們包含影片影格、大幅度的姿勢變化,以及在 TAR@FAR = 等與實際營運相關的工作點上的協定,而且評估的是模板(影像集合),不是單張影像。MegaFace [24] 讓圖庫大小成為核心問題。NIST 的評估 [2], [3] 使用大型、非公開的營運資料集,並直接測試送交的演算法,所以它們是部署規模錯誤率的參考。
被撤下的資料集。 MS-Celeb-1M 在 2019 年 4 月被 Microsoft 撤下;Peng、Mathur 與 Narayanan 指出,撤下發生在批評報導之後,許多「名人」其實是相當普通的人,影像是未經同意彙整的,而 Microsoft 給的理由是研究挑戰賽已經結束 [30]。MegaFace 自己的網站表示挑戰賽已經結束,資料不再發布 [25]。同一份研究發現,被撤回的資料常常透過副本、清理過的衍生版本與預訓練模型繼續流傳,而授權條款對限制這類使用幾乎沒有作用 [30];DLCV 07 中的 DukeMTMC 案例也很類似。實務上:不要使用被撤下的資料集或其衍生物,記錄每個訓練集的來源與授權,並預期審查者會問。
合成訓練資料是一種回應。DigiFace-1M 用電腦圖學管線算繪人臉,動機是網路爬取資料中的偏差、標籤雜訊與缺乏同意 [31];DCFace 用擴散模型生成身分與風格 [32]。Boutros 等人調查了這個方向及其尚待解決的挑戰 [33]。
公平性與族群差異
白話版。 一個系統可以和另一個系統有相同的整體準確率,卻對某些群體犯下多得多的錯誤。因為部署的系統通常對所有人用同一個門檻,不同群體之間分數分佈的小差異,可能變成錯誤率的大差異。
測量結果顯示什麼
最廣泛的公開測量是 NIST 2019 年關於族群效應的報告 [2]。它把來自四個美國政府資料集的 849 萬人、1,827 萬張影像,交給 99 個開發者所提供、大多為商用的 189 種演算法處理。以下是它的主要發現,依報告自己的說法:
- 假陽性的差異遠大於假陰性:在不同族群之間,假陽性率常常相差 10 倍到超過 100 倍,而假陰性則更取決於個別演算法,差異通常小於 3 倍。
- 這個模式取決於演算法與資料。例如,對高品質的申請照片,許多演算法在西非、東非與東亞人身上的假陽性率最高,但有一些中國開發的演算法,東亞的效應是相反的。假陽性在女性身上也比男性高,在老年人與兒童身上也偏高。
- 影像品質會影響假陰性:控制良好的拘留照片與品質較低的過境照片,結果不同。
- 有些高度準確的一對多演算法,假陽性差異測不出來,所以差異並非不可避免。
- 報告建議,每一項關於族群的主張都要說明指的是哪一種錯誤(假陽性或假陰性)、在固定門檻下、針對各個群體,因為許多先前的報告沒有這樣做 [2]。
學術研究補充了互補的證據。Wang 等人建立了 Racial Faces in-the-Wild(RFW)測試集,並測量商用 API 與研究演算法中的種族偏差 [34]。廣為引用的 Gender Shades 研究 [35] 測得,膚色較深的女性錯誤率高達 34.7%,而膚色較淺的男性最多 0.8%;請注意它評估的是商用的性別分類,不是臉部辨識,NIST 明確要求報告者要區分這兩者 [2]。Drozdowski 等人調查了生物辨識領域中偏差的估計與緩解方法 [36]。
玩具範例:一個門檻,兩個群體
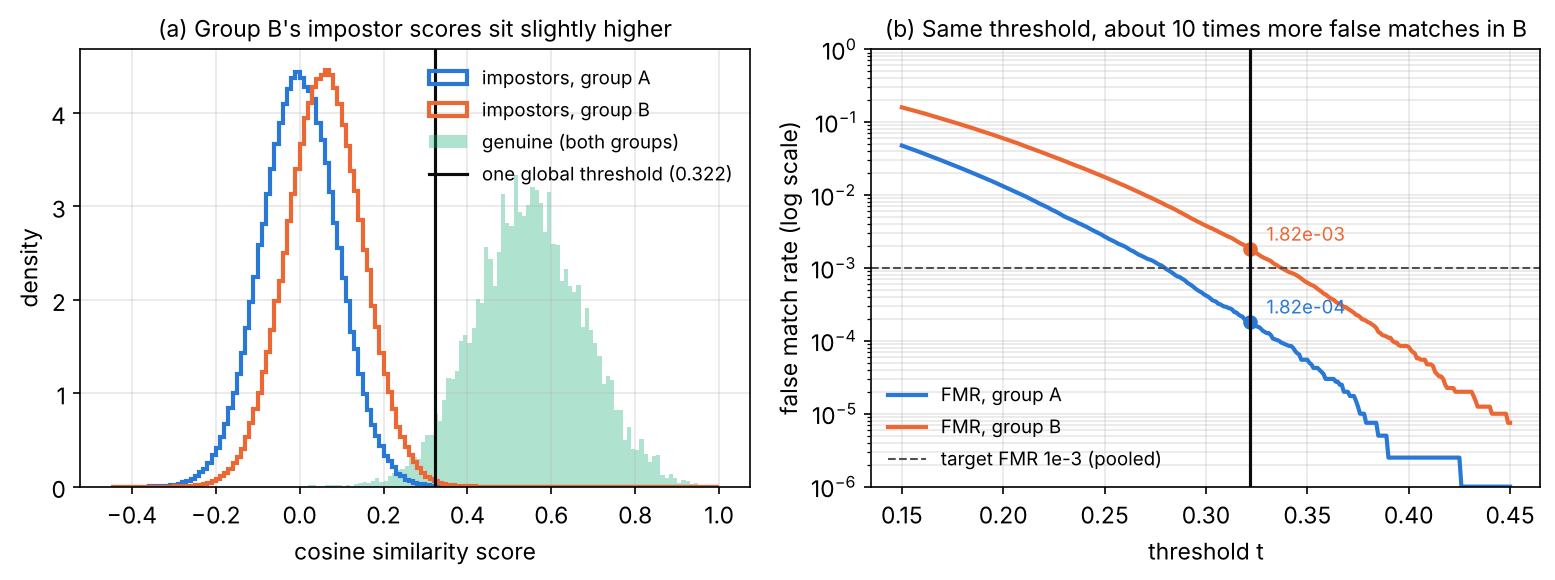
這個機制簡單到可以模擬。假設有兩個群體 A 與 B,同人分數分佈相同,但 B 的異人分數稍高:B 內不同的人在網路看來稍微更像。在這個玩具範例中我們直接假設有這個偏移;在真實系統中,必須調查它的成因。在合併的異人分數上,設定一個全域門檻使 FMR = 。
程式碼 · Python · 17 行
import numpy as np

rng = np.random.default_rng(0)
n_imp, n_gen = 400_000, 4_000
# Same genuine distribution; group B's impostor scores sit slightly higher.
imp = {"A": rng.normal(0.00, 0.09, n_imp), "B": rng.normal(0.06, 0.09, n_imp)}
gen = {"A": rng.normal(0.55, 0.13, n_gen), "B": rng.normal(0.55, 0.13, n_gen)}

pooled = np.r_[imp["A"], imp["B"]]
t_global = np.quantile(pooled, 1 - 1e-3)          # FMR = 0.1% on the pooled data
print(f"global threshold {t_global:.3f}")
for g in "AB":
    print(f"  group {g}: FMR {(imp[g] >= t_global).mean():.5f}, "
          f"FNMR {(gen[g] < t_global).mean():.4f}")
for g in "AB":
    t_g = np.quantile(imp[g], 1 - 1e-3)             # per-group threshold, FMR 0.1% each
    print(f"group {g} own threshold {t_g:.3f}: FNMR {(gen[g] < t_g).mean():.4f}")
輸出
global threshold 0.322
  group A: FMR 0.00018, FNMR 0.0403
  group B: FMR 0.00182, FNMR 0.0400
group A own threshold 0.279: FNMR 0.0210
group B own threshold 0.337: FNMR 0.0517
異人分數平均值偏移 0.06(三分之二個標準差),在同一個門檻下就使群體 B 的誤匹配率是群體 A 的 10 倍(0.182% 對 0.018%),雖然兩個群體的誤不匹配率相等。為每個群體選擇各自的門檻可以使 FMR 相等,但這時群體 B 的 FNMR 升到 5.2%,A 的則降到 2.1%:不是這種錯誤率不同,就是那種不同。哪一種取捨可以接受是政策與法律問題,不是純技術問題,而且依群體設定門檻本身也會引發疑慮。技術上的教訓則比較明確:在工作點的門檻下,針對每個群體測量兩種錯誤率,使用跟部署資料相似的資料;並記得整體 FAR 可能掩蓋十倍的差異(圖 7)。
呈現攻擊
白話版。 辨識網路回答的是「這是誰?」,不是「這是真實、活著的臉嗎?」。印出來的照片、播放影片的手機螢幕或面具,都可以拿給鏡頭看。偵測這類攻擊是另一個任務。
呈現攻擊(presentation attack)是試圖用人造物欺騙感測器;呈現攻擊偵測(presentation attack detection, PAD),也叫臉部反欺騙(face anti-spoofing),判斷輸入是真實的(bona fide,活人)還是攻擊。Yu 等人調查了它的深度學習方法 [37]:除了二元的「活體對攻擊」標籤之外,許多方法會使用逐像素的輔助監督,例如偽深度圖;這個領域現在強調領域泛化(訓練時沒見過的攻擊、相機與光線)與新型態的開放集合攻擊;多模態感測器(深度、紅外線)或特殊感測器(光場、閃光)也有幫助。PAD 與辨識並行運作,兩種錯誤分別評估;一個很強的辨識器若沒有 PAD,只要有已註冊者的一張好照片就很容易被騙。像臉部變形融合(morphing)的護照照片與深偽(deepfake)等數位攻擊與此相關,但屬於不同的威脅。
隱私、同意與法律
白話版。 臉部嵌入是生物辨識的識別碼:它可以把一個人在網路與各種攝影機中的照片串連起來,而且人不能像換密碼那樣換臉。許多法律體系因此把它視為敏感資料。本節描述背景,不構成法律建議。
兩點歐洲法律的內容,說明了監管者怎麼看臉部辨識(各司法管轄區的規則不同,也會改變):
- 在歐盟的《一般資料保護規則》(General Data Protection Regulation)下,「為了唯一識別自然人而處理的生物辨識資料」是敏感個人資料的類別之一,受到特定的處理條件約束(GDPR 第 9 條)[38]。
- 歐盟《人工智慧法》(AI Act,Regulation (EU) 2024/1689)在其禁止的做法中,列出了為建立或擴充臉部辨識資料庫而不分對象地從網際網路或監視錄影蒐集影像,以及在公共場所為執法目的進行即時遠端生物辨識;這些禁令自 2025 年 2 月 2 日起適用 [39]。確切的範圍與條件由法規本身定義。
對工程師來說,實際的影響很具體。要知道每一張訓練影像從哪裡來、依據什麼條款;上面提到被撤下的資料集顯示,「公開可見」不等於「可作任何用途」。把儲存的模板當作敏感資料處理:限制誰能查詢圖庫,記錄搜尋紀錄,並刪除不再需要的模板。應用場景允許時,優先採用驗證用的模板留在使用者裝置上的設計。如 NIST 所建議,記錄預期用途與各群體實測的錯誤率 [2]。合成訓練資料 [31], [33] 能減少但無法消除這些疑慮,因為部署的系統仍然處理真實的臉。
失效模式與實務建議
白話版。 大多數失敗來自訓練與測試條件不一致:臉轉向一側、被遮住一半、老了許多、模糊,或來自系統很少見到的族群。在一種情境調好的門檻,換到另一種情境,意義會悄悄改變。
- 姿勢。 大的偏航角(側臉)會破壞五點對齊,並讓一半的臉消失。IJB-B 使用人工標註的臉部框建立,正是因為由一般臉部偵測器篩選的資料集,會低估這類姿勢與遮擋 [27];ArcFace 的作者也指出,姿勢與年齡差距是普通 softmax 特徵表現下降的條件 [16]。
- 遮擋。 口罩、太陽眼鏡、手與頭髮會遮住臉的一部分;偵測器也許仍會觸發,但特徵點會漂移,嵌入則往異人區域移動。
- 年齡。 多年前註冊的模板比較容易對不上;MegaFace 評估了與年齡有關的表現 [24],NIST 則發現老年人與兒童的假陽性偏高 [2]。
- 影像品質。 低解析度、動態模糊、壓縮與光線不佳會提高誤不匹配;NIST 把幾項假陰性差異歸因於影像品質,而不是族群 [2]。品質感知的方法(MagFace、AdaFace [19], [20])以及拍攝時的品質檢查都有幫助。
- 門檻漂移。 在一個資料集上選的門檻,換到另一種相機、族群或圖庫大小,會得到不同的 FAR(圖 6 與圖 7)。要用類似部署環境的異人配對重新校準,並在部署後監控分數分佈,如 ML 11 所述。
- 標籤雜訊與身分重疊。 從網路蒐集的訓練集含有標籤錯誤的影像,以及同一個人用兩個名字出現;sub-center ArcFace [18] 與資料集清理 [29] 針對這個問題。訓練身分與測試身分重疊會高估開放集合的結果,所以在回報前要檢查。
- 評估捷徑。 只回報 LFW 上的準確率、只回報小型封閉圖庫的 rank-1,或只回報一種錯誤率,恰好會隱藏上面這些失敗。
現代觀點
綜述怎麼說
Wang 與 Deng 的綜述 [1] 是深度臉部辨識的標準地圖。它把損失分成歐氏距離類(對比、三元組、中心損失)、角度/餘弦邊界類(SphereFace、CosFace、ArcFace)與 softmax 變體(特徵與權重正規化),並追溯歐氏距離類損失如何主導早期幾年,以及角度/餘弦邊界損失與特徵、權重正規化如何自 2017 年起接手。Drozdowski 等人 [36] 調查了生物辨識中的族群偏差:偏差如何估計、可能如何緩解,以及仍待解決的社會與技術問題。Yu 等人 [37] 調查了深度臉部反欺騙,包括針對領域泛化與開放集合攻擊所設計的方法。Boutros 等人 [33] 調查了臉部辨識用的合成資料,整理其使用情境,並討論尚待解決的挑戰。
選讀:現代觀點綜述導讀(見「論文導讀」頁)。每篇綜述涵蓋什麼、怎麼組織,以及如何把它當作地圖使用。
2023–2026 年的最新進展
- 在超大資料集上使用以邊界為基礎的 softmax 損失,仍是標準做法。 自 ArcFace 以來的主要變化,是連到影像品質的自適應邊界(MagFace [19]、AdaFace [20])、對標籤雜訊的穩健性(sub-center ArcFace [18]),以及在數百萬個身分上高效率訓練(Partial FC [21],CNN 與 ViT 骨幹皆適用)。
- 基準轉向低 FAR、以模板為單位與實際營運的評估。 LFW 已經飽和 [31];IJB-B/C 在 TAR@FAR = 成為學術界的慣例 [16],NIST 的 FRTE(2023 年以前稱為 FRVT 的評估 [3])則在大型營運資料上測試送交的演算法,誤匹配率低到 。
- 合成與保護隱私的訓練資料是活躍的方向,有電腦圖學算繪(DigiFace-1M [31])與擴散生成(DCFace [32])的資料集,動機是網路資料的同意、偏差與標籤雜訊問題 [33]。
- 公平性要被測量與回報,而不是假設:NIST 的族群分析 [2] 與 RFW [34] 等專用測試集,讓各群體的錯誤率成為評估的一部分。
尚未解決的問題
- 對未見過條件的泛化:極端姿勢、遮擋、非常低的解析度與長時間的年齡差距。
- 族群差異:在類似部署環境的資料上,針對每個群體測量兩種錯誤,並在減少差異的同時,不只是把錯誤從一個群體搬到另一個群體。
- 沒有同意問題的訓練資料,並且仍能達到網路規模真實資料的準確率 [33]。
- 訓練時沒見過類型的呈現攻擊與數位攻擊 [37]。
- 經過校準、具品質感知的分數,讓門檻在不同相機與族群之間保持意義。
- 治理:資料集發布後的管理 [30],以及各司法管轄區不同的法律限制 [38], [39]。
重點整理
- 嵌入可比較訓練時未見的身分,單靠訓練分類標籤無法做到。
- 選擇指標或門檻前,先說明辨識任務與登錄庫大小。
- 偵測與對齊錯誤會傳遞到嵌入比較。
- 成對損失需要有資訊的樣本;間隔損失則塑造類別中心周圍的分隔。
- 報告驗證 TAR 時註明 FAR 與冒名配對數;搜尋則使用對應的識別指標。
- 依群體與操作條件檢查錯誤,確認資料集可用性,並保護生物特徵樣板。
練習
- 開放還是封閉? 對下列每個系統,說明它做的是驗證、封閉集合識別還是開放集合識別,以及哪一種錯誤最重要:(a) 手機解鎖,(b) 把一個家庭的相簿分給五位家庭成員,(c) 在體育場入口搜尋 10,000 人的監控名單。
提示
(a) 驗證;誤接受是安全失敗,誤拒絕只是不方便(使用者可以再試一次)。(b) 只有在每張照片都是這五人之一時才是封閉集合識別;真實的相簿裡有客人,所以實際上是開放集合。(c) 開放集合識別;經過的人大多不在名單上,所以選定門檻下的 FPIR 乘上經過的人數,就是誤報的數量。
- ArcFace 的邊界。 兩個類別中心相距 。對落在它們之間的弧上的特徵,分別求出正規化 softmax、 弧度的 ArcFace,以及 的 SphereFace,類別 1 的損失不再被滿足的、與 的夾角。這裡哪一種邊界最大?當 時,SphereFace 的邊界會怎樣?
提示
Softmax:。ArcFace:,所以間隙是 。SphereFace:,間隙 。當 時,SphereFace 的間隙加倍成 ,而 ArcFace 的仍是 。
- 玩具實驗中的 CosFace。 修改玩具實驗,讓目標 logit 為 ,(CosFace)。現在 是多少?執行它,並把印出的三個數字與 ArcFace 的比較。
提示
在 logits 中把 np.cos(th + margin) 換成 np.cos(th) - margin,並把梯度因子 np.sin(th + margin) / np.sin(th) 換成 1( 對 的導數是 1,所以整個因子就只是 )。預期結果會接近 ArcFace 的;確切的數字取決於這次執行。
- 需要多少異人配對? 你想宣稱 FAR = 。(a) 有 300,000 組異人配對且沒有觀察到任何誤接受時,真實 FAR 的 95% 上界大約是多少?(b) 需要多少組異人配對,才能讓零錯誤時的上界降到 ?(c) 為什麼你的配對所代表的「獨立試驗」,可能比它們的數量少?
提示
(a) 三法則:約 。(b) 約 300,000,但前提是沒有發生錯誤;若有幾個錯誤,就需要更多。(c) 重複使用同樣影像或同樣人的配對彼此相關:一張不尋常的影像可以同時產生許多誤接受。
- 圖庫成長。 在識別的程式碼中,圖庫為 300 人時,門檻 0.36 下無對應者探測影像觸發誤報的機率是 0.010。用 估計每次比較的 FMR,然後預測圖庫為 3,000 與 30,000 時的 FPIR。與印出的數值比較,並解釋任何差異。
提示
得到 ,預測 3,000 時約為 0.096,30,000 時約為 0.64。印出的 0.043 與 0.330 比較低。只有 300 個無對應者探測影像時,FPIR 0.010 只是 3 次誤報,所以 FMR 的估計非常不確定;應該改用大量異人比較直接估計 FMR。
- 公平的門檻。 在兩群體的程式碼中,找出使兩個群體 FNMR 相等的單一門檻,以及使 FMR 相等的門檻。一個門檻能同時做到兩者嗎?你會向決策者報告什麼?
提示
因為同人分佈相同,任何單一門檻都會給出相等的 FNMR(不計取樣雜訊:印出的執行中是 0.0403 對 0.0400);沒有任何單一門檻能使 FMR 相等,因為異人分佈不同。要報告在提議的門檻下兩個群體的兩種錯誤率,以及各種替代方案(依群體設門檻、更好的模型),並把取捨的選擇留給對此負責的人。
參考文獻
- M. Wang and W. Deng, “Deep face recognition: A survey,” Neurocomputing, vol. 429, pp. 215–244, 2021. doi
- P. Grother, M. Ngan and K. Hanaoka, “Face Recognition Vendor Test (FRVT) Part 3: Demographic Effects,” NIST Interagency Report 8280, National Institute of Standards and Technology, 2019. doi
- National Institute of Standards and Technology, “Face Recognition Technology Evaluation (FRTE) 1:1 Verification,” evaluation web page, accessed 2026. NIST
- K. Zhang, Z. Zhang, Z. Li and Y. Qiao, “Joint face detection and alignment using multitask cascaded convolutional networks,” IEEE Signal Processing Letters, vol. 23, no. 10, pp. 1499–1503, 2016. doi
- J. Deng, J. Guo, E. Ververas, I. Kotsia and S. Zafeiriou, “RetinaFace: Single-shot multi-level face localisation in the wild,” in Proc. IEEE/CVF CVPR, 2020. CVF
- Y. Taigman, M. Yang, M. Ranzato and L. Wolf, “DeepFace: Closing the gap to human-level performance in face verification,” in Proc. IEEE CVPR, 2014. CVF
- F. Schroff, D. Kalenichenko and J. Philbin, “FaceNet: A unified embedding for face recognition and clustering,” in Proc. IEEE CVPR, 2015. CVF
- S. Chopra, R. Hadsell and Y. LeCun, “Learning a similarity metric discriminatively, with application to face verification,” in Proc. IEEE CVPR, vol. 1, pp. 539–546, 2005. doi
- R. Hadsell, S. Chopra and Y. LeCun, “Dimensionality reduction by learning an invariant mapping,” in Proc. IEEE CVPR, vol. 2, pp. 1735–1742, 2006. doi
- A. Hermans, L. Beyer and B. Leibe, “In defense of the triplet loss for person re-identification,” arXiv:1703.07737, 2017. arXiv
- F. Wang, X. Xiang, J. Cheng and A. L. Yuille, “NormFace: L2 hypersphere embedding for face verification,” in Proc. ACM International Conference on Multimedia, pp. 1041–1049, 2017. doi
- W. Liu, Y. Wen, Z. Yu, M. Li, B. Raj and L. Song, “SphereFace: Deep hypersphere embedding for face recognition,” in Proc. IEEE CVPR, 2017. CVF
- H. Wang, Y. Wang, Z. Zhou, X. Ji, D. Gong, J. Zhou, Z. Li and W. Liu, “CosFace: Large margin cosine loss for deep face recognition,” in Proc. IEEE/CVF CVPR, 2018. CVF
- F. Wang, J. Cheng, W. Liu and H. Liu, “Additive margin softmax for face verification,” IEEE Signal Processing Letters, vol. 25, no. 7, pp. 926–930, 2018. doi
- J. Deng, J. Guo, N. Xue and S. Zafeiriou, “ArcFace: Additive angular margin loss for deep face recognition,” in Proc. IEEE/CVF CVPR, 2019. CVF
- J. Deng, J. Guo, J. Yang, N. Xue, I. Kotsia and S. Zafeiriou, “ArcFace: Additive angular margin loss for deep face recognition,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 10, pp. 5962–5979, 2022. doi
- Y. Wen, K. Zhang, Z. Li and Y. Qiao, “A discriminative feature learning approach for deep face recognition,” in Proc. ECCV, pp. 499–515, 2016. doi
- J. Deng, J. Guo, T. Liu, M. Gong and S. Zafeiriou, “Sub-center ArcFace: Boosting face recognition by large-scale noisy web faces,” in Proc. ECCV, pp. 741–757, 2020. doi
- Q. Meng, S. Zhao, Z. Huang and F. Zhou, “MagFace: A universal representation for face recognition and quality assessment,” in Proc. IEEE/CVF CVPR, 2021. CVF
- M. Kim, A. K. Jain and X. Liu, “AdaFace: Quality adaptive margin for face recognition,” in Proc. IEEE/CVF CVPR, 2022. CVF
- X. An, J. Deng, J. Guo, Z. Feng, X. Zhu, J. Yang and T. Liu, “Killing two birds with one stone: Efficient and robust training of face recognition CNNs by Partial FC,” in Proc. IEEE/CVF CVPR, 2022. CVF
- A. Martin, G. Doddington, T. Kamm, M. Ordowski and M. Przybocki, “The DET curve in assessment of detection task performance,” in Proc. Eurospeech, pp. 1895–1898, 1997. ISCA
- G. B. Huang, M. Mattar, T. Berg and E. Learned-Miller, “Labeled Faces in the Wild: A database for studying face recognition in unconstrained environments,” in Workshop on Faces in ‘Real-Life’ Images: Detection, Alignment, and Recognition, Marseille, 2008. HAL
- I. Kemelmacher-Shlizerman, S. M. Seitz, D. Miller and E. Brossard, “The MegaFace benchmark: 1 million faces for recognition at scale,” in Proc. IEEE CVPR, 2016. CVF
- University of Washington, “MegaFace and MF2: Million-scale face recognition,” project web page, accessed 2026. project page
- Y. Guo, L. Zhang, Y. Hu, X. He and J. Gao, “MS-Celeb-1M: A dataset and benchmark for large-scale face recognition,” in Proc. ECCV, pp. 87–102, 2016. doi
- C. Whitelam, E. Taborsky, A. Blanton, B. Maze, J. Adams, T. Miller, N. Kalka, A. K. Jain, J. A. Duncan, K. Allen, J. Cheney and P. Grother, “IARPA Janus Benchmark-B face dataset,” in Proc. IEEE CVPR Workshops, 2017. CVF
- B. Maze, J. Adams, J. A. Duncan, N. Kalka, T. Miller, C. Otto, A. K. Jain, W. T. Niggel, J. Anderson, J. Cheney and P. Grother, “IARPA Janus Benchmark – C: Face dataset and protocol,” in Proc. International Conference on Biometrics (ICB), pp. 158–165, 2018. doi
- Z. Zhu, G. Huang, J. Deng, Y. Ye, J. Huang, X. Chen, J. Zhu, T. Yang, J. Lu, D. Du and J. Zhou, “WebFace260M: A benchmark unveiling the power of million-scale deep face recognition,” in Proc. IEEE/CVF CVPR, 2021. CVF
- K. Peng, A. Mathur and A. Narayanan, “Mitigating dataset harms requires stewardship: Lessons from 1000 papers,” in Proc. NeurIPS Datasets and Benchmarks Track, 2021. proceedings
- G. Bae, M. de La Gorce, T. Baltrušaitis, C. Hewitt, D. Chen, J. Valentin, R. Cipolla and J. Shen, “DigiFace-1M: 1 million digital face images for face recognition,” in Proc. IEEE/CVF WACV, 2023. CVF
- M. Kim, F. Liu, A. Jain and X. Liu, “DCFace: Synthetic face generation with dual condition diffusion model,” in Proc. IEEE/CVF CVPR, 2023. CVF
- F. Boutros, V. Struc, J. Fierrez and N. Damer, “Synthetic data for face recognition: Current state and future prospects,” Image and Vision Computing, vol. 135, art. 104688, 2023. doi
- M. Wang, W. Deng, J. Hu, X. Tao and Y. Huang, “Racial Faces in the Wild: Reducing racial bias by information maximization adaptation network,” in Proc. IEEE/CVF ICCV, pp. 692–702, 2019. doi
- J. Buolamwini and T. Gebru, “Gender Shades: Intersectional accuracy disparities in commercial gender classification,” in Proc. Conference on Fairness, Accountability and Transparency, PMLR 81, pp. 77–91, 2018. PMLR
- P. Drozdowski, C. Rathgeb, A. Dantcheva, N. Damer and C. Busch, “Demographic bias in biometrics: A survey on an emerging challenge,” IEEE Transactions on Technology and Society, vol. 1, no. 2, pp. 89–103, 2020. doi
- Z. Yu, Y. Qin, X. Li, C. Zhao, Z. Lei and G. Zhao, “Deep learning for face anti-spoofing: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, pp. 5609–5631, 2023. doi
- European Commission, “What personal data is considered sensitive?,” data protection guidance referring to Article 9 of the GDPR, accessed 2026. European Commission
- European Commission, “AI Act” (Regulation (EU) 2024/1689), policy page, accessed 2026. European Commission
- M. Turk and A. Pentland, “Eigenfaces for recognition,” Journal of Cognitive Neuroscience, vol. 3, no. 1, pp. 71–86, 1991. doi
- P. N. Belhumeur, J. P. Hespanha and D. J. Kriegman, “Eigenfaces vs. Fisherfaces: Recognition using class specific linear projection,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 19, no. 7, pp. 711–720, 1997. doi
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 03・物件偵測:從 R-CNN 到 DETR · 30 分鐘