DLCV 09A.1・盲與真實世界影像超解析度
先備知識:DLCV 09A・非盲影像超解析度、DLCV 09B・生成式影像復原:取樣出一個合理的答案
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
- SRMD:一個網路處理多種已知退化(CVPR 2018)
- IKC:反覆修正模糊核(CVPR 2019)
- KernelGAN:以單圖 GAN 估計核(NeurIPS 2019)
- DAN:展開交替最佳化(NeurIPS 2020)
- DASR:對比退化表示(CVPR 2021)
- BSRGAN:實用的退化模型(ICCV 2021)
- Real-ESRGAN:純合成高階退化(ICCVW 2021)
- StableSR:以時間感知編碼器控制凍結先驗(IJCV 2024)
- DiffBIR:先移除退化,再生成細節(ECCV 2024)
- SeeSR:退化感知的語意提示(CVPR 2024)
- SUPIR:擴大先驗、資料與文字控制(CVPR 2024)
電腦視覺深度學習
你將學到
- 區分退化參數未知,以及真實世界退化家族不確定的情況。
- 比較顯式退化估計與隱式表示。
- 理解模糊核不匹配、影像內部統計與合成訓練管線。
- 追蹤生成先驗如何使用低解析度與語意條件。
- 在缺少乾淨參考時評估忠實度與感知品質。
先看全貌
DLCV 09A 假設已知退化,以固定縮圖方式訓練反向映射,再對照原 HR。真實照片沒有配方:鏡頭、失焦、手震、感光元件、光線,以及未知軟體的銳化、縮放與壓縮都會留下影響。盲與真實世界 SR 要在這些未知下仍然工作。
手機變焦、老照片、網路圖與影片放大幾乎都面對未知退化。Bicubic 基準很強的模型,可能不適合真實 JPEG;真實 JPEG 上看起來很好的輸出,也可能虛構細節。家族分類幫助辨識假設、能力與失敗方式。
本章位置。 DLCV 09A 提供退化、感知/失真取捨及基準;DLCV 09B 介紹一般生成復原;DLCV 09 定義無參考指標。少步方法另見 DLCV 09A.2。主線解釋家族,論文頁補完整設計。程式只用 NumPy、SciPy、scikit-image、OpenCV 與 skimage.data,可在 CPU 快速執行。
問題:沒有人量過的損傷
白話說。 退化未知時,必須由同一觀測推估清晰影像及其損傷過程。
簡述退化模型
DLCV 09A 的經典模型,將 LR 影像 寫為:
是 HR, 是鏡頭、失焦、運動、像素積分或抗混疊模糊核; 是逐色彩通道二維卷積, 以倍率 降取樣,可取每個 區塊一點或 bicubic 縮放; 是加性雜訊。真實管線還有品質 的 JPEG ,其位置可能改變,以及去馬賽克、去雜訊、銳化與色調處理。較完整但仍簡化的例子為 。
盲與真實世界的意思
文獻用詞不完全一致,本章採以下區分:
- 非盲 SR: 測試時已知 、 及雜訊程度;固定 bicubic 是每張圖共用設定的特例。
- 盲 SR: 至少一項未知且隨影像改變;許多研究仍假設高斯類模糊與高斯雜訊,只是不知道參數。
- 真實世界 SR/Real-ISR: 退化不只未知,也可能超出模型家族,包括壓縮、相機處理與空間變化,通常沒有對應 HR 真值。
因此,在正確模型家族內估未知參數很準,不代表遇到錯誤退化家族仍能工作。
為什麼 bicubic 訓練會失效
白話說。 只練習反解一種縮圖方式,就可能把另一種損傷當成同一件事來修。
DLCV 09A 的線性模型展示:銳利訓練、模糊測試會修不足,反之會過度銳化。Efrat 等人 [1] 說明正確模糊模型的重要性;無雜訊訓練也容易放大雜訊和 JPEG 區塊。SRMD [2] 指出:假設核比真核寬會振鈴,較窄則過度平滑,後面以小實驗驗證。
研究領域的地圖
白話說。 先問退化是顯式表示或隱式學習,再問證據來自外部資料或輸入本身。
Liu 等人 [3] 依顯式/隱式與外部/單圖整理,指出當時單圖隱式格仍空缺;Chen 等人 [4] 分退化建模、實拍配對、領域轉換及自我學習。兩篇早於擴散時代,因此表中另補 2023 年起擴大的生成先驗家族 [5]。
| 家族 | 估計或學習什麼 | 代表方法 | 優點 | 常見失敗 |
|---|---|---|---|---|
| 顯式、給定核 | 測試直接提供核與雜訊 | SRMD [2]、UDVD [6]、USRNet [7] | 單模型處理多種已知退化,控制可解釋 | 需要可靠核,錯誤造成模糊或振鈴 |
| 顯式、外部資料估核 | 核代碼與 SR 交替估計 | IKC [8]、DAN [9]、DCLS [10] | 退化符合假設時準確 | JPEG、相機處理與空間變化超出範圍 |
| 顯式、單圖統計 | 跨尺度重複區塊推估核 | Michaeli–Irani [11]、KernelGAN [12]、ZSSR [13] | 不需外部訓練,可逐圖調適 | 逐圖訓練慢,先驗弱且怕雜訊 |
| 退化表示 | 分辨退化的嵌入 | DASR [14]、KDSR [15] | 不需核標籤,快速前向 | 仍受訓練退化範圍限制 |
| 隱式、合成管線 | 廣泛隨機退化到清晰圖的映射 | BSRGAN [16]、Real-ESRGAN [17]、Liang 等人的 DASR [18] | 單模型處理多種照片 | 平滑、GAN 偽影與分布外退化 |
| 隱式、實拍配對 | 特定相機配對映射 | RealSR [19]、DRealSR [20]、City100 [21] | 真實資料 | 規模小、相機專屬、對齊誤差 |
| 隱式、未配對轉換 | 退化生成器或領域轉換器 | CinCGAN [22]、Bulat 等人 [23]、FSSR [24]、Ji 等人 [25] | 真 LR 不需 HR 配對 | GAN 不穩、虛假紋理 |
| 生成先驗(2023–2026) | LR 控制的預訓練擴散先驗 | StableSR [26]、DiffBIR [27]、PASD [28]、SeeSR [29]、SUPIR [30]、ResShift [31] | 強退化下仍有自然紋理 | 虛構、低 PSNR、取樣慢與偏色 |
分類可重疊:DAN 顯式卻由外部資料學估計器;BSRGAN 稱隱式,訓練退化仍是手寫公式。另有兩篇 DASR:Wang 等人的對比退化表示 [14],與 Liang 等人的高效率退化調適 [18],比較時先確認指哪篇。
顯式退化建模
白話說。 保留 ,把核和雜訊當旋鈕。可以由外部告知,也可以讓模型從影像估設定。
把核告訴網路
SRMD [2] 以 PCA 將 核壓成短向量,附加雜訊值,各數字展成 LR 大小常數圖,再與影像串接,學 ;控制圖也可空間變化。UDVD [6] 依退化產生動態卷積;USRNet [7] 展開 MAP 求解器,交替使用已知核/倍率/雜訊的資料步與學得去雜訊先驗,服務多種核及倍率。其分裂背景見 DLCV 09。
這些仍是非盲模型:從反解固定退化,改為接收退化條件;前提是有人能提供可靠估計。
選讀:SRMD(見「論文導讀」)。維度展開、訓練退化與模型不匹配的實驗。
估計並修正核
白話說。 錯核會留下特徵:太窄偏模糊,太寬偏振鈴。看輸出來辨識誤差,再修正核。
IKC [8] 先預測核代碼,以 SFTMD 做條件 SR,再讓 corrector 看目前 SR 與核代碼來修正。SFTMD 透過每個殘差區塊的空間特徵轉換注入條件 [32]。DAN [9] 將估計器與復原器展成共享權重的固定輪數交替;復原器以估計核而非真核訓練,學會容忍估計錯誤。DCLS [10] 則將估核及最小平方去模糊改在 LR 特徵空間進行。
經典模型下,交替最佳化寫成:
是輪數, 是目前影像/核估計, 是影像先驗;DAN [9] 以學得模組取代兩個最小化步。
選讀:IKC、DAN(見「論文導讀」)。Predictor/corrector、SFTMD、Gaussian8 規則與端到端交替的作用。
從影像本身估計核
白話說。 內部模糊核估計利用跨尺度區塊重複性,尋找能保留相似區塊統計的下採樣核。
Michaeli–Irani [11] 據此做非參數核估計。KernelGAN [12] 只用測試圖訓練深層線性生成器,做 ×2 縮圖;判別器比較其 7 × 7 區塊與原圖,最後讀出核供 ZSSR/SRMD。ZSSR [13] 另以輸入產生 LR—更低解析度配對,逐圖訓練小 CNN。KernelGAN 原文約每圖一分鐘 GPU,ZSSR 還有額外訓練時間。
選讀:KernelGAN(見「論文導讀」)。深但線性的生成器、四個核正規化、DIV2KRK 與由 ×2 建 ×4。
選讀:為什麼核難以識別(見「補充資料」)。以數值檢查位移和模糊交換的精確歧義。
核不匹配會怎麼樣
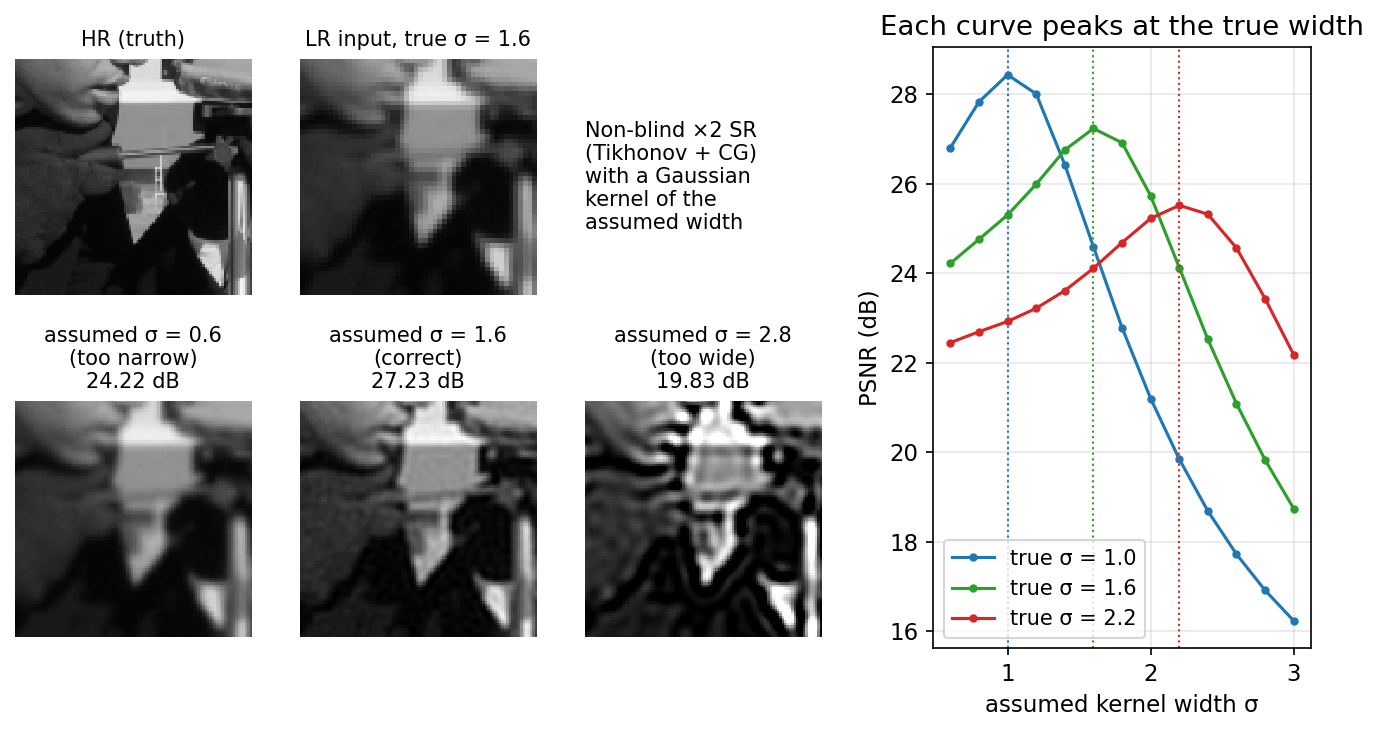
白話說。 非盲求解器會認真反解你給的錯誤模糊。假設模糊不足留下柔軟影像,假設過強則把本來銳利的邊緣過度銳化成振鈴。
最簡單的非盲 ×2 實驗以共軛梯度求解:
是假設寬度 的高斯核, 由真寬度 產生, 是梯度,以法方程式中的 Laplacian 實作; 控制平滑先驗。
程式碼 · Python · 39 行
import numpy as np
from scipy import ndimage as ndi
from scipy.sparse.linalg import LinearOperator, cg
from skimage import data, img_as_float64

s = 2                                                   # scale factor
x = img_as_float64(data.camera())[128:384, 128:384]     # HR test crop (256 x 256)
H, W = x.shape

def blur(z, sigma):                                     # circular Gaussian blur (self-adjoint)
    return ndi.gaussian_filter(z, sigma, mode="wrap")

def A(z, sigma):                                        # degradation: blur, then keep every s-th pixel
    return blur(z, sigma)[::s, ::s]

def At(r, sigma):                                       # its adjoint: zero-fill upsampling, then blur
    up = np.zeros((H, W)); up[::s, ::s] = r
    return blur(up, sigma)

def lap(z):                                             # discrete Laplacian (smoothness prior)
    return ndi.laplace(z, mode="wrap")

def nonblind_sr(y, sigma, lam=2e-3):
    """Solve min_x ||A_sigma x - y||^2 + lam ||grad x||^2 with conjugate gradients."""
    op = LinearOperator((H * W, H * W), dtype=float,
                        matvec=lambda v: (At(A(v.reshape(H, W), sigma), sigma) - lam * lap(v.reshape(H, W))).ravel())
    sol, _ = cg(op, At(y, sigma).ravel(), maxiter=200)
    return sol.reshape(H, W)

def psnr(a, b):
    return 10 * np.log10(1.0 / np.mean((a - np.clip(b, 0, 1)) ** 2))

rng = np.random.default_rng(0)
assumed = [0.6, 1.0, 1.6, 2.2, 2.8]
print("true \\ assumed " + "".join(f"{a:7.1f}" for a in assumed))
for true in [1.0, 1.6, 2.2]:
    y = A(x, true) + 0.003 * rng.standard_normal((H // s, W // s))   # LR observation
    row = [psnr(x, nonblind_sr(y, a)) for a in assumed]
    print(f"sigma = {true:.1f}      " + "".join(f"{p:7.2f}" for p in row))
輸出
true \ assumed     0.6    1.0    1.6    2.2    2.8
sigma = 1.0        26.80  28.43  24.59  19.84  16.91
sigma = 1.6        24.22  25.30  27.23  24.13  19.83
sigma = 2.2        22.45  22.92  24.11  25.51  23.43
每列最高分在真核與假設核相符的對角線;損失並不對稱。真 時,假設 2.8 損失約 11.5 dB,假設 0.6 損失 1.6 dB;過度去模糊放大雜訊與振鈴,修不足主要留模糊。圖 1 用真 展示,正是 IKC [8] 想辨識的特徵。
退化表示學習
白話說。 不一定要知道核的精確形狀,也可以學會分辨損傷種類,形成不需核標籤的緊湊指紋。
Wang 等人的 DASR [14] 假設同圖各處退化相同、跨圖不同:同圖兩區塊為正對,別圖為負對。編碼器搭配 MoCo 式負例佇列及 InfoNCE [33],再以表示預測深度卷積權重與通道縮放。KDSR [15] 讓看得到 HR—LR 的教師教只看 LR 的學生,以涵蓋模糊、雜訊及 JPEG;Liang 等人的 DASR [18] 則估顯式參數,再混合多個卷積專家。
嵌入將「逐點估核」改為「辨認退化」,免核標籤,卻仍依賴訓練退化多樣性,不保證處理未見家族。
選讀:DASR(見「論文導讀」)。完整對比損失、退化感知卷積與逐元件消融。
用退化合成做隱式建模
白話說。 不逐圖寫出損傷,而設計涵蓋廣泛情況的損傷生成器,製作大量配對,再訓練同一模型。
BSRGAN:打亂步驟
BSRGAN [16] 擴大模糊、降取樣與雜訊種類,也打亂順序:等向/非等向高斯、nearest/bilinear/bicubic/先縮後放、Gaussian/JPEG/反向再前向相機處理產生的感光雜訊,最後再 JPEG。固定 bicubic 與經典退化成為特例。沿用 ESRGAN 式網路 [34],先 L1 訓練 BSRNet,再加感知與對抗項成 BSRGAN。
Real-ESRGAN:重複步驟
Real-ESRGAN [17] 用兩輪退化模擬拍攝、編輯、重複壓縮縮放。每輪抽模糊、縮放、Gaussian/Poisson 雜訊與 JPEG;末端縮放和 sinc 視為一組,與 JPEG 隨機交換順序。有限 sinc 近似理想低通,可產生振鈴/過衝,教模型移除而非放大暈邊。另用 U-Net 式逐像素判別器 [35] 搭配頻譜正規化 [36] 穩定廣泛退化訓練。
選讀:逐步看高階退化管線、Sinc 濾波與振鈴(見「補充資料」)。完整抽樣與理想低通為何振鈴。
選讀:BSRGAN、Real-ESRGAN(見「論文導讀」)。元件、參數範圍、損失、測試集與消融。
訓練配對如何產生
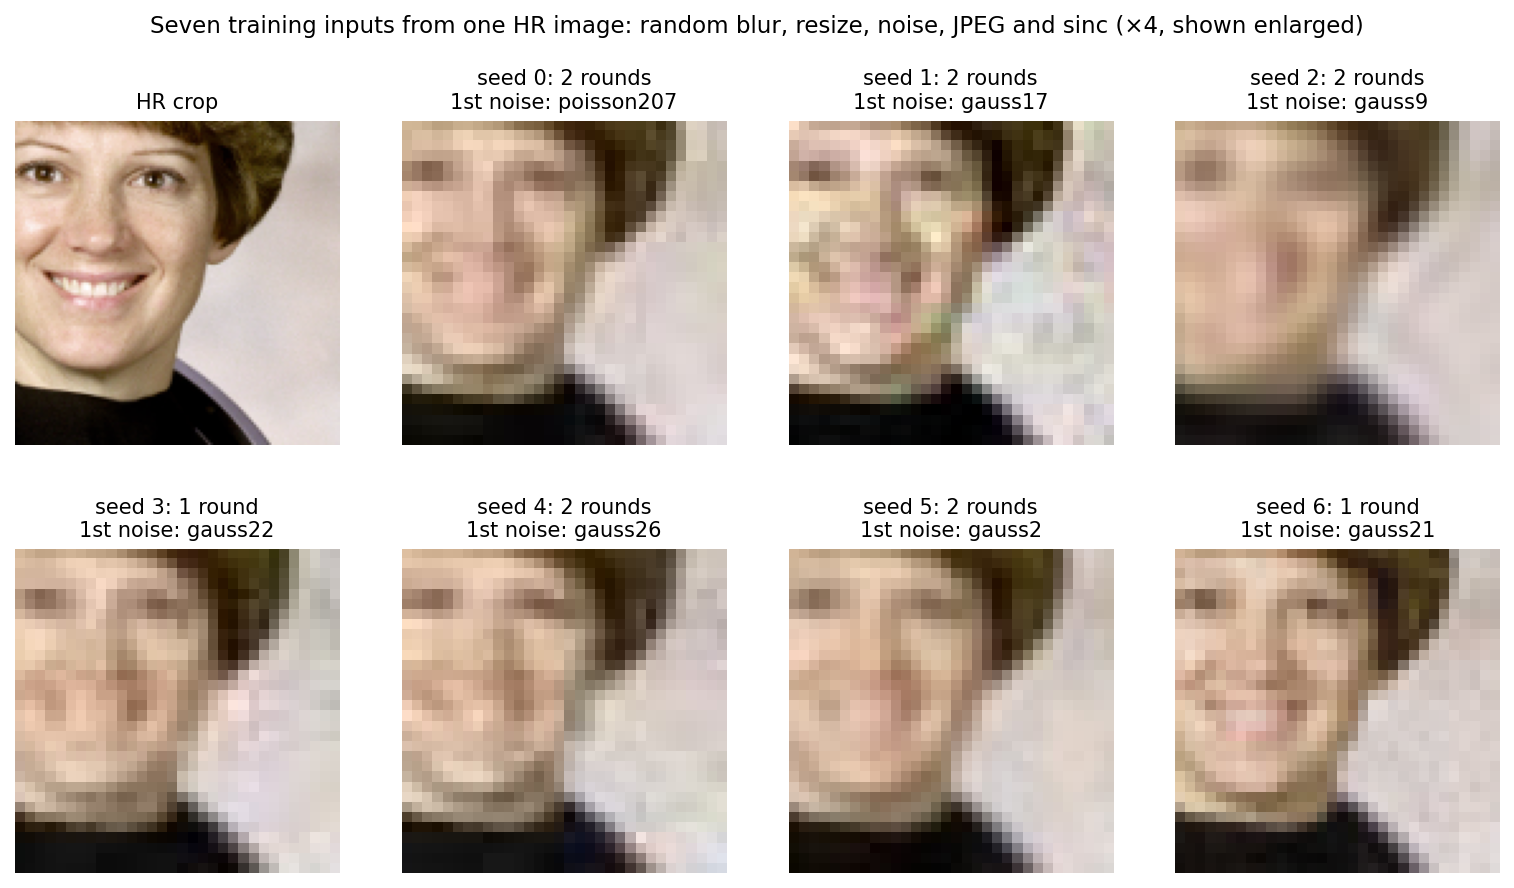
程式以兩輪模糊、隨機縮放、雜訊和 JPEG,再交換末端縮放/sinc 與 JPEG,示範二階退化。部分範圍依原文 [17],但縮放、光子雜訊及核家族有簡化;教學版有時略過整輪二階,官方只可能略過二階模糊。因此不是完整訓練配方重現。
程式碼 · Python · 76 行
import numpy as np, cv2
from scipy import ndimage as ndi
from scipy.special import j1
from skimage import data, img_as_float32

def gaussian_kernel(rng, size, smax):
    """Random isotropic or anisotropic Gaussian: k(c) ~ exp(-0.5 c^T S^-1 c), normalized."""
    s1, s2 = rng.uniform(0.2, smax, 2)
    if rng.random() < 0.5:
        s2 = s1                                                     # isotropic half of the time
    th = rng.uniform(0, np.pi)
    R = np.array([[np.cos(th), -np.sin(th)], [np.sin(th), np.cos(th)]])
    S = R @ np.diag([s1**2, s2**2]) @ R.T
    ax = np.arange(size) - size // 2
    C = np.stack(np.meshgrid(ax, ax, indexing="ij"), -1)
    k = np.exp(-0.5 * np.einsum("...i,ij,...j", C, np.linalg.inv(S), C))
    return k / k.sum(), f"gauss({s1:.1f},{s2:.1f})"

def sinc_kernel(size, wc):
    """2-D sinc low-pass: k(r) = wc J1(wc r) / (2 pi r), with k(0) = wc^2 / (4 pi)."""
    ax = np.arange(size) - size // 2
    r = np.hypot(*np.meshgrid(ax, ax, indexing="ij"))
    with np.errstate(invalid="ignore", divide="ignore"):
        k = np.where(r == 0, wc**2 / (4 * np.pi), wc * j1(wc * r) / (2 * np.pi * r))
    return k / k.sum()

def jpeg(img, q):
    ok, buf = cv2.imencode(".jpg", (np.clip(img, 0, 1) * 255).round().astype(np.uint8)[..., ::-1],
                           [cv2.IMWRITE_JPEG_QUALITY, int(q)])
    return cv2.imdecode(buf, cv2.IMREAD_COLOR)[..., ::-1].astype(np.float32) / 255

def one_round(img, rng, log, smax, nmax):
    """blur -> random resize -> noise -> JPEG: one 'classical' degradation."""
    size = int(rng.choice(np.arange(7, 22, 2)))
    if rng.random() < 0.1:
        k, name = sinc_kernel(size, rng.uniform(np.pi / 3, np.pi)), "sinc"
    else:
        k, name = gaussian_kernel(rng, size, smax)
    img = np.stack([ndi.convolve(img[..., c], k, mode="reflect") for c in range(3)], -1)
    f = rng.uniform(0.3, 1.2)                                       # resize factor (illustrative range)
    interp = rng.choice([cv2.INTER_AREA, cv2.INTER_LINEAR, cv2.INTER_CUBIC])
    img = cv2.resize(img, None, fx=f, fy=f, interpolation=interp)
    if rng.random() < 0.5:                                          # Gaussian noise, sigma in 1..nmax (8-bit units)
        sig = rng.uniform(1, nmax) / 255
        shape = img.shape[:2] + ((1,) if rng.random() < 0.4 else (3,))   # gray or color noise
        img = img + sig * rng.standard_normal(shape); noise = f"gauss{sig * 255:.0f}"
    else:                                                           # shot noise with a random photon count
        peak = 10 ** rng.uniform(1.5, 3)
        img = rng.poisson(np.clip(img, 0, 1) * peak) / peak; noise = f"poisson{peak:.0f}"
    q = rng.uniform(30, 95)
    img = jpeg(img, q)
    log.append(f"{name} x{f:.2f} {noise} q{q:.0f}")
    return img

def degrade(hr, rng, scale=4):
    """Second-order pipeline in the spirit of Real-ESRGAN (parameter ranges partly our own)."""
    log = []
    img = one_round(hr, rng, log, smax=3.0, nmax=30)
    if rng.random() < 0.8:
        img = one_round(img, rng, log, smax=1.5, nmax=25)          # second, milder round
    h, w = hr.shape[0] // scale, hr.shape[1] // scale
    def resize_sinc(z):
        z = cv2.resize(z, (w, h), interpolation=cv2.INTER_AREA)
        k = sinc_kernel(15, rng.uniform(np.pi / 3, np.pi))  # same kernel for all color channels
        return np.stack([ndi.convolve(z[..., c], k, mode="reflect") for c in range(3)], -1)
    final = [lambda z: jpeg(z, rng.uniform(30, 95)), resize_sinc]
    if rng.random() < 0.5:
        final = final[::-1]                                         # swap JPEG with the resize-and-sinc pair
    for op in final:
        img = op(img)
    return np.clip(img, 0, 1), log

hr = img_as_float32(data.astronaut())                               # (512, 512, 3)
for seed in range(3):
    lr, log = degrade(hr, np.random.default_rng(seed))
    print(f"seed {seed}: LR {lr.shape} | " + " ; ".join(log))
輸出
seed 0: LR (128, 128, 3) | gauss(0.3,0.2) x0.85 poisson207 q64 ; gauss(0.9,0.9) x0.84 gauss5 q90
seed 1: LR (128, 128, 3) | gauss(0.6,0.6) x1.04 gauss17 q71 ; gauss(1.4,0.6) x0.40 poisson42 q40
seed 2: LR (128, 128, 3) | gauss(2.5,0.5) x0.47 gauss9 q67 ; gauss(0.3,1.1) x1.04 gauss19 q50
每行代表新 LR:gauss(σ1,σ2) 是兩軸寬度,另有縮放、雜訊與品質值。每次對同一 HR 重抽損傷,圖 2 的七張輸入遠比固定 bicubic 多樣。Real-ESRGAN [17] 在 GPU 合成,使用 180 組近期配對池避免同批共享縮放因素。
後續改進
StableSR、SeeSR、SUPIR、ResShift 都用 Real-ESRGAN 類合成 [26]、[29]、[30]、[31]。但範圍不一定比複雜度次要:DiffBIR [27] 的前段復原器以範圍較廣的一階退化得到較佳無參考分數。LDL [37] 則從局部殘差統計建立偽影圖,專門懲罰 GAN 偽影,處理不同問題。
真實配對與未配對資料
白話說。 可以實際拍出損傷:用不同焦段拍同場景,或在配對不可能時,從真實高低品質集合學習。
實拍配對
RealSR [19] 用不同焦段拍 DSLR,再對齊與校色;DRealSR [20] 擴至五種 DSLR;City100 [21] 用相機/手機改變焦段或距離研究視野取捨。DPED [38] 的同時手機/DSLR 照片也常作無真值輸入。實拍可評估真實退化,卻仍規模小、相機專屬且有錯位,不能涵蓋所有網路照片。
未配對學習與領域轉換
CinCGAN [22] 先把真實 LR 轉乾淨 LR,再接預訓練 SR 並端到端調整。Bulat 等人 [23] 先學 HR→真實 LR 退化,再訓練復原;Lugmayr 等人 [39] 補回自然感光特性。DSGAN/FSSR [24] 將對抗項限制高頻,低頻另約束。Ji 等人 [25] 從目標領域估核與抽雜訊,贏得 NTIRE 2020 [40]。此類依賴資料分布,也可能產生嚴重 GAN 偽影 [3]。
用生成先驗處理真實世界 SR
白話說。 大型文字擴散從廣泛影像學得先驗。2023 年起,許多復原方法保留大部分預訓練權重,再以小控制網路提供 LR,補出合理細節。
為什麼借用生成先驗
嚴重損傷時,LR 不再含所有 HR 細節。L2 迴歸學條件平均,可能平均不相容細節;生成模型則取一個合理答案。DLCV 09B 說明感知/失真,擴散概覽 與虛構問題 補背景。本章聚焦 SR 如何餵 LR、額外條件及保真控制。
本節使用 Real-ESRGAN 或類似合成。多數採 Stable Diffusion [41],將 512 × 512 壓為 64 × 64 潛在網格再去雜訊;許多也調整 ControlNet [42],用零初始化卷積把可訓練編碼分支連到凍結模型。
每種方法接收什麼條件
| 方法 | 先驗 | LR 如何進入 | 額外條件 | 保真控制 | 原文步數 |
|---|---|---|---|---|---|
| StableSR [26] | 凍結 SD 2.1 | 時間編碼器、殘差區塊 SFT | 空提示 | 解碼器特徵包覆權重 | 200 DDPM |
| DiffBIR [27] | 凍結 SD 2.1 | 先復原,再餵 IRControlNet | 負提示 | 區域自適應復原引導 | 50 |
| PASD [28] | Stable Diffusion | 去退化、像素感知交叉注意力 | 語意特徵與描述 | 雜訊排程 | 20 |
| SeeSR [29] | 凍結 SD 2 | LR ControlNet、起始混入 LR | 退化感知硬標籤及軟嵌入 | — | 50 |
| SUPIR [30] | 凍結 SDXL | 強健編碼器、裁減 ControlNet 與 ZeroSFT | 多模態描述、負品質提示 | 復原引導 | 100 EDM |
| ResShift [31] | 從頭訓練、VQGAN 潛在空間 | 起點靠近 LR、移動殘差 | 無 | 排程 | 15 |
這些是原文預設,不代表等成本。SeeSR 補充資料 [29] 在同一 V100、128→512 比較:StableSR 18.70 秒/200 步,DiffBIR 5.85/50,PASD 6.07/20,SeeSR 7.24/50,ResShift 1.12/15,Real-ESRGAN 0.09 秒。
三個反覆出現的設計:
- 條件強度隨雜訊變化。 StableSR 時間編碼器約在訊雜比 最強,對應內容形成 [26]。
- 先移除損傷。 DiffBIR 先清理再生成,避免模型把雜訊/壓縮當內容;SUPIR 也調適編碼器增強退化強健性 [27]、[30]。
- 像素不足時加入語意。 PASD、SeeSR 從 LR 提取文字,SeeSR 讓乾淨/退化標籤一致;SUPIR 用多模態描述和使用者文字控制 [28]、[29]、[30]。
選讀:StableSR、DiffBIR、SeeSR、SUPIR(見「論文導讀」)。完整設計與驗證實驗;ResShift 見單步 SR。
擴散 Transformer 與新先驗
白話說。 生成先驗的去雜訊器從 U-Net 轉向 Transformer,SR 也跟著改變條件注入方式。
DreamClear [43] 使用 DiT、生成管線整理的一百萬高品質訓練圖及退化先驗專家混合。DiT4SR [44] 讓 LR 潛在串流持續參與注意力,再用跨串流卷積補局部細節。趨勢是更大先驗及更深入的條件交互。
保真、虛構與控制旋鈕
白話說。 強先驗畫得可信,也可能多畫不存在的東西。因此需要「靠近輸入」與「自然外觀」的控制。
StableSR 的 混合 LR 編碼特徵;DiffBIR 引導 在平坦區更強地拉向清理圖;SUPIR 的 讓每步預測靠向 LR 潛在;ResShift 的 改殘差排程 [26]、[27]、[30]、[31]。指標未必單調,部分設定可同時改善多項。常見錯誤是把模糊船補成鳥等語意錯誤,以及天空/牆面的虛構紋理;小字小臉也是明列限制 [26]、[29]、[45]。
減少步數
白話說。 每圖數十至數百次評估不利手機或影片。LR 已固定多數配置,若專門訓練,就可能從觀測附近以少步完成。
ResShift 的 15 步 [31] 是橋梁;SinSR [46] 蒸餾成一步,OSEDiff [45] 以 LoRA 和 VSD 學 LR→HR 潛在映射。詳細機制及計時見 DLCV 09A.2。
盲與真實世界的評估
白話說。 無真值的照片無法直接算真實重建誤差。可測已知合成退化、預測人類評分或請人比較,每一種都只回答部分問題。
合成測試集的全參考指標
顯式方法常用 IKC 的 Gaussian8 [8],或 KernelGAN 的 DIV2KRK [12]:DIV2K 驗證 100 張 [47],每張隨機非等向受擾核。真實方法也測自家合成,例如 3,000 個 Real-ESRGAN 退化裁切 [26]、[29]、[45],或 BSRGAN 的四種 DIV2K4D [16]。PSNR、SSIM [48] 測失真,LPIPS、DISTS [49]、[50] 測感知距離;同訓練管線的測試可能偏袒該模型。
RealSR/DRealSR 實拍也能算這些指標,但錯位會降低所有方法的 PSNR,並可能獎勵模糊;KernelGAN 也以此說明不採 NTIRE 2018 配對 [12]。
無參考指標
白話說。 無參考(NR)指標不看原圖,預測外觀品質;它是人類意見的模型,仍可能被欺騙。
NIQE [51] 比較自然場景統計,越低越好;MUSIQ [52]、MANIQA [53] 是評分訓練模型,CLIPIQA [54] 用 CLIP 比較好/壞照片提示,越高越好。定義見 DLCV 09。FID [55] 比較輸出與真實圖的特徵分布,不是逐圖正確性。
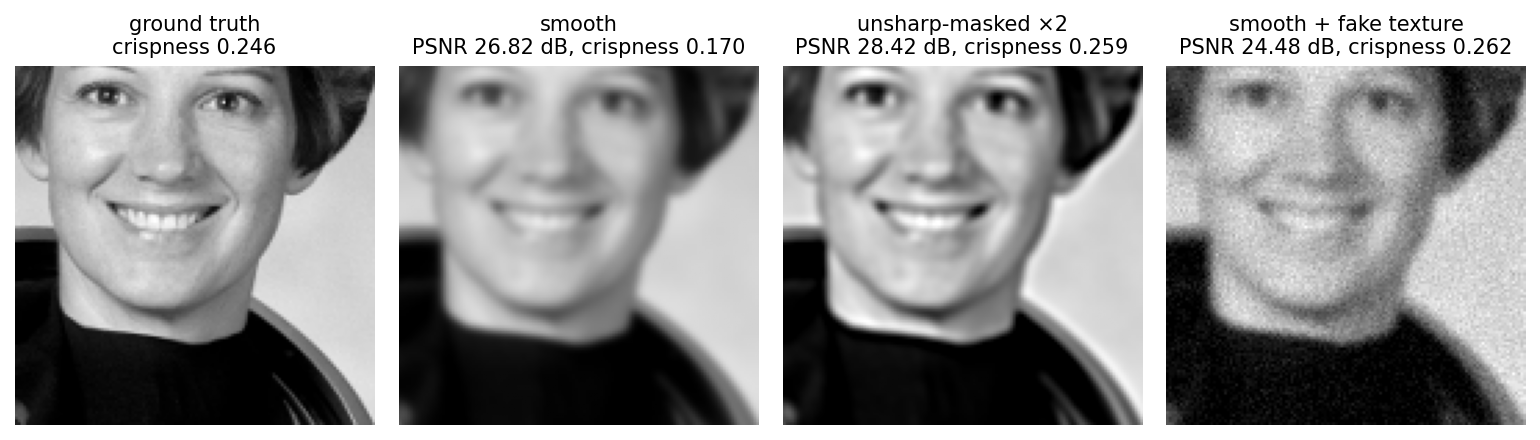
小實驗比較模糊、unsharp masking,以及模糊加細雜訊,以 PSNR 和刻意粗糙的 NR「清脆度」平均梯度評分。真正 NR 精細得多,但同樣評外觀而非真實內容。
程式碼 · Python · 25 行
import numpy as np
from scipy import ndimage as ndi
from skimage import data, img_as_float64
from skimage.color import rgb2gray

hr = img_as_float64(rgb2gray(data.astronaut()))
rng = np.random.default_rng(0)

def psnr(a, b):
    return 10 * np.log10(1.0 / np.mean((a - np.clip(b, 0, 1)) ** 2))

def crispness(img):
    """A crude no-reference score: mean gradient magnitude (higher = 'sharper looking')."""
    return np.mean(np.hypot(ndi.sobel(img, 0), ndi.sobel(img, 1)))

smooth = ndi.gaussian_filter(hr, 1.5)                               # a cautious, blurry restoration
candidates = {
    "smooth (posterior-mean-like)": smooth,
    "unsharp-masked x2": smooth + 2.0 * (smooth - ndi.gaussian_filter(smooth, 2)),
    "smooth + fake fine texture": smooth + 0.04 * rng.standard_normal(hr.shape),
}
for name, img in candidates.items():
    img = np.clip(img, 0, 1)
    print(f"{name:28s} PSNR {psnr(hr, img):6.2f} dB | crispness {crispness(img):.3f}")
print(f"{'ground truth':28s} PSNR    -     | crispness {crispness(hr):.3f}")
輸出
smooth (posterior-mean-like) PSNR  26.82 dB | crispness 0.170
unsharp-masked x2            PSNR  28.42 dB | crispness 0.259
smooth + fake fine texture   PSNR  24.48 dB | crispness 0.262
ground truth                 PSNR    -     | crispness 0.246
兩張「銳化」都比真值更清脆,虛假紋理最高、PSNR 最差。Unsharp 的 PSNR 改善是部分反解模糊;PSNR 也可能偏好稍模糊但位置正確,而非清楚卻偏移的紋理。
為什麼排名不一致
原文表格也呈現相同張力:
- 無參考與外觀。 BSRGAN 在 20 張 RealSRSet 的 NIQE 5.60,比其他方法 3.99–4.95 差,作者卻認為視覺較好 [16]。
- 保真與寫實。 StableSR 的 DIV2K 裁切 PSNR 23.26 dB,低於部分 GAN 的 24.62 dB,FID/CLIPIQA/MUSIQ 卻較好 [26]。SUPIR 也呈現無參考強、PSNR/SSIM/LPIPS 弱的取捨 [30]。
- 指標彼此衝突。 OSEDiff 表中多步 SeeSR/PASD 的 NIQE、MUSIQ、MANIQA 較強,OSEDiff 的 LPIPS、DISTS、FID、CLIPIQA 較強 [45]。
- 提示會推動分數。 負提示引導可提高 CLIPIQA、MUSIQ,過強又會銳化過度 [26];可被取樣技巧提高的分數不是獨立真實性裁判。
至少在合成/實拍配對報一種全參考,真實圖報不同家族的兩種 NR,重要偏好主張另做人類研究。說明解析度及裁切;512 × 512 訓練模型在小裁切與大圖的表現可能不同 [26]。
人類研究與挑戰
人類研究測偏好,不判定虛構細節是否真有。StableSR 收集 35 人、40 圖、1,400 票 [26];SeeSR 的 20 人研究中,誤認輸出為真值 38.6%,真實圖最佳偏好 57.1% [29]。方法匿名、隨機排序與足夠樣本等規則見 DLCV 09。
挑戰顯示領域從已知到未知退化的轉變:
- NTIRE 2018: 一個 bicubic、三個未知模擬相機退化賽道,提供配對可學習 [56]。
- NTIRE 2019: 實拍不同焦段配對,導入 RealSR [57]。
- AIM 2019/NTIRE 2020: 不提供配對,使用來源 LR 及部分賽道的未配對高品質圖;2020 依人類感知評比 [58]、[40]。
- AIM 2020: ×2/×3/×4 實拍,按 PSNR/SSIM [59]。
- NTIRE 2025: ×4 bicubic,並列感知與 PSNR 復原賽道 [60]。
失敗模式
白話說。 一種錯誤是誤判損傷、修太多或太少;另一種是太相信先驗、補出不存在內容。
- 分布外退化: 合成資料未保證涵蓋未知損傷,Real-ESRGAN 也列出可能反而放大的限制 [17]。
- 錯核: 造成圖 1 的模糊/振鈴,單核假設也難處理空間變化。
- GAN 偽影: 扭曲線條、氣泡紋理等,LDL 專門處理此問題 [17]、[16]、[37]。
- 語意虛構: 錯物件、平坦區假紋理,小字小臉尤其難 [29]、[26]。
- 偏色: StableSR 以輸入通道平均/變異數或低頻小波帶校正 [26]。
- 分塊與解析度: 大圖可能有塊間不一致,原文聚合取樣用來減少它 [26]。
- 迎合指標: 銳化、顆粒與提示可能增分而不保真。
可用合理退化把 SR 再縮回 LR,比較輸入;文字和平坦區的大差異值得檢查。但算子本身未知,小殘差也不能證明正確,DLCV 09B 有更完整說明。
現代觀點
綜述論文
白話說。 盲與真實 SR 的兩篇綜述建立用語,較新的擴散及廣義 SR 綜述再擴充它。
- Liu 等人,Blind Image Super-Resolution: A Survey and Beyond,TPAMI [3]:整理顯式外部資料、顯式單圖統計、隱式外部資料;回顧當時單圖隱式缺口、GAN 偽影與退化假設不一致的比較困難。
- Chen 等人,Real-World Single Image Super-Resolution: A Brief Review,Information Fusion 2022 [4]:分退化建模、實拍配對、領域轉換及自學習,提醒合成基準可能高估真實照片能力。
- Moser 等人,Diffusion Models, Image Super-Resolution, and Everything,TNNLS 2025 [5]:依輸入域、條件、引導與損傷空間整理擴散 SR,指出成本、偏色及可比較性問題。
- Zhang 等人,Deep-Learning-Empowered Super Resolution: A Comprehensive Survey and Future Prospects,Proceedings of the IEEE 2025 [61]:涵蓋單圖、影片、立體、光場,按 CNN/Transformer/GAN/擴散、資料及複雜度整理,適合作廣義索引。
2023–2026 年的研究方向
- 生成先驗成為重要家族。 StableSR 至 SUPIR 以編碼器、ControlNet、SFT 控制凍結文字模型 [26]、[27]、[28]、[29]、[30];DreamClear/DiT4SR 改用 Transformer [43]、[44]。
- 語意作為條件: 退化標籤、多模態描述及文字控制 [29]、[30]。
- 資料仍多為合成: BSRGAN/Real-ESRGAN 類管線,SUPIR 報 兩千萬帶文字圖,DreamClear 一百萬整理的合成圖 [30]、[43]。
- 速度成為工程目標: 從 200 步到 ResShift 的 15,再到 SinSR/OSEDiff 的一步 [31]、[46]、[45],詳見 DLCV 09A.2。
- 經典顯式盲 SR 持續發展: DCLS、KDSR 改善估計與表示,仍以 Gaussian8/DIV2KRK 評估 [10]、[15]。
開放問題
- 內容可信度: 指標難以穩定區分清楚正確和清楚虛構,已有多模態虛構評估提案 [62]。
- 管線外損傷: 空間變化、相機處理、反覆社群壓縮與影片編碼未完全涵蓋。
- 沒有真值的評估: NR 彼此及與人類不一致,還可能被取樣技巧提高 [16]、[26]。
- 成本: 大型先驗、多步取樣與完整管線仍受裝置預算限制。
- 單圖隱式建模: 是綜述當時指出的缺口,不代表之後完全無人處理 [3]。
重點整理
- 註明未知的是退化參數、退化家族,或兩者皆是。
- 依顯式/隱式退化處理,以及外部/內部證據區分方法。
- 模糊核不匹配可能造成模糊或振鈴,應共同評估估計器與重建。
- 合成退化擴大訓練涵蓋範圍,卻不保證能處理未見損傷。
- 生成先驗能提供逼真紋理,也可能捏造缺乏支持的細節。
- 結合有參考測試、多類無參考指標與使用者研究,並預期不同排名。
練習
- 核誤差的不對稱。 將實驗雜訊設零,再把 增到 ,各自重做表格。假設核太寬的懲罰如何改變?
提示
太寬會放大原本沒有被衰減的頻率。去雜訊後右側損失減少、仍有振鈴;加大平滑權重抑制放大,使兩側較平、最高分也可能下降。比較距對角線相同步數的差。
- 打亂或重複。 改
degrade支援 BSRGAN 式:等向/非等向模糊、×4 降取樣、雜訊、JPEG 用rng.permutation打亂,再最後 JPEG。對 50 組隨機 LR 做 bicubic 放大,與 HR 算平均 PSNR,哪一種更難?
提示
降取樣若先於模糊/雜訊,會在 LR 尺度模糊,雜訊也未經縮放平滑。應報平均及散布;散布有助理解退化空間涵蓋。
- 閱讀無參考分數。 新增真值 JPEG 品質 50 及位移一像素兩候選,按 PSNR/清脆度排序。哪個顯示 PSNR 懲罰了肉眼可能不在意的變化?
提示
一像素位移看起來近似,PSNR 可能大降;JPEG 降低部分清脆度,也可能因區塊邊提高它。實拍錯位因此可能偏袒較模糊方法。
- 選擇家族。 為下列情境各選一家族並解釋:(a)1990 年代掃描家庭照做相簿;(b)顯微影像數細胞;(c)手機 ×2 變焦須 30 ms;(d)可拍校正配對的固定監視器。
提示
(a)適度控制的生成先驗可處理混合損傷,但須檢查身分與細節。(b)優先量測點擴散函數及配對復原,不能虛構計數。(c)先評估小型回歸/GAN;短擴散仍須實測完整裝置成本。(d)用該相機實拍配對,必要時結合量測核。
- KernelGAN 的 ×4 核。 , 在係數間插零。用一維高斯驗證兩次 ×2 等於一次此核 ×4,並求 寬度 對應的 寬度。
提示
將第二次卷積移到第一次抽取前,核要膨脹兩倍:兩高斯寬度平方相加,得 。可用長度 256 隨機訊號與 np.convolve 測試。
參考文獻
- N. Efrat, D. Glasner, A. Apartsin, B. Nadler and A. Levin, “Accurate Blur Models vs. Image Priors in Single Image Super-Resolution,” in Proc. IEEE ICCV, 2013, pp. 2832–2839. doi · CVF
- K. Zhang, W. Zuo and L. Zhang, “Learning a Single Convolutional Super-Resolution Network for Multiple Degradations,” CVPR, 2018. paper
- A. Liu, Y. Liu, J. Gu, Y. Qiao, C. Dong, “Blind Image Super-Resolution: A Survey and Beyond,” IEEE TPAMI (early access), 2022. source
- Honggang Chen, Xiaohai He, Linbo Qing, Yuanyuan Wu, Chao Ren, Ray E. Sheriff, Ce Zhu, “Real-world single image super-resolution: A brief review,” Information Fusion, 2022. source
- B. B. Moser, A. S. Shanbhag, F. Raue, S. Frolov, S. Palacio and A. Dengel, “Diffusion Models, Image Super-Resolution, and Everything: A Survey,” IEEE Transactions on Neural Networks and Learning Systems, vol. 36, no. 7, pp. 11793–11813, 2025. doi · arXiv
- Y. Xu, S. R. Tseng, Y. Tseng, H. Kuo, Y. Tsai, “Unified Dynamic Convolutional Network for Super-Resolution with Variational Degradations,” CVPR, 2020. source
- K. Zhang, L. Van Gool, R. Timofte, “Deep Unfolding Network for Image Super-Resolution,” CVPR, 2020. source
- J. Gu, H. Lu, W. Zuo and C. Dong, “Blind Super-Resolution With Iterative Kernel Correction,” CVPR, 2019. paper
- Z. Luo, Y. Huang, S. Li, L. Wang and T. Tan, “Unfolding the Alternating Optimization for Blind Super Resolution,” NeurIPS, 2020. paper
- Z. Luo, H. Huang, L. Yu, Y. Li, H. Fan and S. Liu, “Deep Constrained Least Squares for Blind Image Super-Resolution,” CVPR, 2022. paper
- T. Michaeli, M. Irani, “Nonparametric Blind Super-resolution,” Proceedings of the IEEE International Conference on Computer Vision, 2013. source
- S. Bell-Kligler, A. Shocher and M. Irani, “Blind Super-Resolution Kernel Estimation using an Internal-GAN,” NeurIPS, 2019. paper
- A. Shocher, N. Cohen and M. Irani, “‘Zero-Shot’ Super-Resolution Using Deep Internal Learning,” in Proc. IEEE/CVF CVPR, 2018, pp. 3118–3126. doi · arXiv
- L. Wang, Y. Wang, X. Dong, Q. Xu, J. Yang, W. An and Y. Guo, “Unsupervised Degradation Representation Learning for Blind Super-Resolution,” CVPR, 2021. paper
- B. Xia, Y. Zhang, Y. Wang, Y. Tian, W. Yang, R. Timofte and L. Van Gool, “Knowledge Distillation Based Degradation Estimation for Blind Super-Resolution,” ICLR, 2023. paper
- K. Zhang, J. Liang, L. Van Gool, R. Timofte, “Designing a Practical Degradation Model for Deep Blind Image Super-Resolution,” Proceedings of the IEEE/CVF International Conference on Computer Vision, 2021. source
- X. Wang, L. Xie, C. Dong, Y. Shan, “Real-ESRGAN: Training Real-World Blind Super-Resolution With Pure Synthetic Data,” Proceedings of the IEEE/CVF International Conference on Computer Vision, 2021. source
- J. Liang, H. Zeng, L. Zhang, “Efficient and Degradation-Adaptive Network for Real-World Image Super-Resolution,” ECCV, 2022. source
- J. Cai, H. Zeng, H. Yong, Z. Cao, L. Zhang, “Toward Real-World Single Image Super-Resolution: A New Benchmark and a New Model,” Proceedings of the IEEE/CVF International Conference on Computer Vision, 2019. source
- P. Wei, Z. Xie, H. Lu, Z. Zhan, Q. Ye, W. Zuo, L. Lin, “Component Divide-and-Conquer for Real-World Image Super-Resolution,” ECCV, 2020. source
- C. Chen, Z. Xiong, X. Tian, Z. Zha, F. Wu, “Camera Lens Super-Resolution,” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019. source
- Y. Yuan, S. Liu, J. Zhang, Y. Zhang, C. Dong, L. Lin, “Unsupervised Image Super-Resolution using Cycle-in-Cycle Generative Adversarial Networks,” CVPR Workshops, 2018. source
- A. Bulat, J. Yang, G. Tzimiropoulos, “To learn image super-resolution, use a GAN to learn how to do image degradation first,” ECCV, 2018. source
- M. Fritsche, S. Gu, R. Timofte, “Frequency Separation for Real-World Super-Resolution,” ICCV Workshops, 2019. source
- X. Ji, Y. Cao, Y. Tai, C. Wang, J. Li, F. Huang, “Real-World Super-Resolution via Kernel Estimation and Noise Injection,” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops, 2020. source
- J. Wang, Z. Yue, S. Zhou, K. C. K. Chan, C. C. Loy, “Exploiting Diffusion Prior for Real-World Image Super-Resolution,” IJCV, 2024. source
- X. Lin, J. He, Z. Chen, et al., “DiffBIR: Towards Blind Image Restoration with Generative Diffusion Prior,” ECCV, 2024. source
- T. Yang, R. Wu, P. Ren, X. Xie, L. Zhang, “Pixel-Aware Stable Diffusion for Realistic Image Super-resolution and Personalized Stylization,” ECCV, 2024. source
- R. Wu, T. Yang, L. Sun, Z. Zhang, S. Li, L. Zhang, “SeeSR: Towards Semantics-Aware Real-World Image Super-Resolution,” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024. source · supplementary experiments
- F. Yu, J. Gu, Z. Li, et al., “Scaling Up to Excellence: Practicing Model Scaling for Photo-Realistic Image Restoration In the Wild,” CVPR, 2024. source
- Z. Yue, J. Wang, C. C. Loy, “ResShift: Efficient Diffusion Model for Image Super-resolution by Residual Shifting,” NeurIPS, 2023. source
- X. Wang, K. Yu, C. Dong, C. C. Loy, “Recovering Realistic Texture in Image Super-Resolution by Deep Spatial Feature Transform,” Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2018. source
- K. He, H. Fan, Y. Wu, S. Xie, R. Girshick, “Momentum Contrast for Unsupervised Visual Representation Learning,” CVPR, 2020. source
- X. Wang, K. Yu, S. Wu, J. Gu, Y. Liu, C. Dong, Y. Qiao and C. C. Loy, “ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks,” in Proc. ECCV Workshops, 2018 (Lecture Notes in Computer Science, 2019), pp. 63–79. doi · arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” in Proc. MICCAI, 2015, pp. 234–241. doi · arXiv
- T. Miyato, T. Kataoka, M. Koyama, Y. Yoshida, “Spectral Normalization for Generative Adversarial Networks,” ICLR, 2018. source
- J. Liang, H. Zeng, L. Zhang, “Details or Artifacts: A Locally Discriminative Learning Approach to Realistic Image Super-Resolution,” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022. source
- A. Ignatov, N. Kobyshev, R. Timofte, K. Vanhoey, L. Van Gool, “DSLR-Quality Photos on Mobile Devices with Deep Convolutional Networks,” ICCV, 2017. source
- A. Lugmayr, M. Danelljan, R. Timofte, “Unsupervised Learning for Real-World Super-Resolution,” arXiv preprint, 2019. source
- A. Lugmayr, M. Danelljan, R. Timofte, et al., “NTIRE 2020 Challenge on Real-World Image Super-Resolution: Methods and Results,” CVPR Workshops, 2020. source
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. source
- L. Zhang, A. Rao, M. Agrawala, “Adding Conditional Control to Text-to-Image Diffusion Models,” ICCV, 2023. source
- Y. Ai, X. Zhou, H. Huang, X. Han, Z. Chen, Q. You, H. Yang, “DreamClear: High-Capacity Real-World Image Restoration with Privacy-Safe Dataset Curation,” NeurIPS, 2024. source
- Z. Duan, J. Zhang, X. Jin, et al., “DiT4SR: Taming Diffusion Transformer for Real-World Image Super-Resolution,” ICCV, 2025. source
- R. Wu, L. Sun, Z. Ma, L. Zhang, “One-Step Effective Diffusion Network for Real-World Image Super-Resolution,” NeurIPS, 2024. source
- Y. Wang, W. Yang, X. Chen, et al., “SinSR: Diffusion-Based Image Super-Resolution in a Single Step,” CVPR, 2024. source
- E. Agustsson and R. Timofte, “NTIRE 2017 Challenge on Single Image Super-Resolution: Dataset and Study,” in Proc. IEEE CVPR Workshops, 2017, pp. 1122–1131. doi · CVF
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image Quality Assessment: From Error Visibility to Structural Similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018, pp. 586–595. doi · arXiv
- K. Ding, K. Ma, S. Wang, E. P. Simoncelli, “Image Quality Assessment: Unifying Structure and Texture Similarity,” IEEE TPAMI, 2022. source
- A. Mittal, R. Soundararajan and A. C. Bovik, “Making a “Completely Blind” Image Quality Analyzer,” IEEE Signal Processing Letters, vol. 20, no. 3, pp. 209–212, 2013. doi
- J. Ke, Q. Wang, Y. Wang, P. Milanfar, F. Yang, “MUSIQ: Multi-scale Image Quality Transformer,” ICCV, 2021. source
- S. Yang, T. Wu, S. Shi, S. Lao, Y. Gong, M. Cao, J. Wang, Y. Yang, “MANIQA: Multi-dimension Attention Network for No-Reference Image Quality Assessment,” CVPR Workshops, 2022. source
- J. Wang, K. C. K. Chan, C. C. Loy, “Exploring CLIP for Assessing the Look and Feel of Images,” AAAI, 2023. source
- M. Heusel, H. Ramsauer, T. Unterthiner, B. Nessler, S. Hochreiter, “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” NeurIPS, 2017. source
- R. Timofte, S. Gu, J. Wu, L. Van Gool, “NTIRE 2018 Challenge on Single Image Super-Resolution: Methods and Results,” Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition Workshops, 2018. source
- J. Cai, S. Gu, R. Timofte, L. Zhang, “NTIRE 2019 Challenge on Real Image Super-Resolution: Methods and Results,” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops, 2019. source
- A. Lugmayr, M. Danelljan, R. Timofte, et al., “AIM 2019 Challenge on Real-World Image Super-Resolution: Methods and Results,” ICCV Workshops, 2019. source
- P. Wei, H. Lu, R. Timofte, et al., “AIM 2020 Challenge on Real Image Super-Resolution: Methods and Results,” ECCV Workshops, 2020. source
- Z. Chen, K. Liu, J. Gong, J. Wang, L. Sun, Z. Wu, R. Timofte, Y. Zhang et al., “NTIRE 2025 Challenge on Image Super-Resolution (×4): Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2025, pp. 1525–1535. doi · arXiv
- Le Zhang, Ao Li, Qibin Hou, Ce Zhu, Yonina C. Eldar, “Deep-Learning-Empowered Super Resolution: A Comprehensive Survey and Future Prospects,” Proceedings of the IEEE, 2025. source
- W. Ren, R. Goyal, Z. Hu, T. T. Aumentado-Armstrong, I. Mohomed and A. Levinshtein, “Hallucination Score: Towards Mitigating Hallucinations in Generative Image Super-Resolution,” arXiv:2507.14367, 2025. arXiv
- Real-ESRGAN contributors, “Real-ESRGAN model and ×4-plus training configuration,” official source, accessed 2026-11-02. model · configuration
- D. P. Kingma, J. Ba, “Adam: A Method for Stochastic Optimization,” ICLR, 2015. source
- M. Bevilacqua, A. Roumy, C. Guillemot and M.-L. Alberi Morel, “Low-Complexity Single-Image Super-Resolution based on Nonnegative Neighbor Embedding,” in Proc. BMVC, 2012, pp. 135.1–135.10. doi
- R. Zeyde, M. Elad and M. Protter, “On Single Image Scale-Up Using Sparse-Representations,” in Curves and Surfaces, Lecture Notes in Computer Science, Springer, 2012, pp. 711–730. doi
- D. Martin, C. Fowlkes, D. Tal and J. Malik, “A Database of Human Segmented Natural Images and Its Application to Evaluating Segmentation Algorithms and Measuring Ecological Statistics,” in Proc. IEEE ICCV, 2001, vol. 2, pp. 416–423. doi
- J.-B. Huang, A. Singh and N. Ahuja, “Single Image Super-Resolution from Transformed Self-Exemplars,” in Proc. IEEE CVPR, 2015, pp. 5197–5206. doi · CVF
- J. Kim, J. K. Lee and K. M. Lee, “Accurate Image Super-Resolution Using Very Deep Convolutional Networks,” in Proc. IEEE CVPR, 2016, pp. 1646–1654. doi · arXiv
- C. Ledig, L. Theis, F. Huszár, J. Caballero, A. Cunningham, A. Acosta, A. Aitken, A. Tejani, J. Totz, Z. Wang and W. Shi, “Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network,” in Proc. IEEE CVPR, 2017, pp. 105–114. doi · arXiv
- R. Timofte, E. Agustsson, L. Van Gool, M.-H. Yang, L. Zhang et al., “NTIRE 2017 Challenge on Single Image Super-Resolution: Methods and Results,” in Proc. IEEE CVPR Workshops, 2017, pp. 1110–1121. doi · CVF
- Y. Matsui, K. Ito, Y. Aramaki, A. Fujimoto, T. Ogawa, T. Yamasaki and K. Aizawa, “Sketch-Based Manga Retrieval Using Manga109 Dataset,” Multimedia Tools and Applications, vol. 76, no. 20, pp. 21811–21838, 2017. doi
- KernelGAN contributors, “Adversarial losses and kernel constraints,” official source, accessed 2026-11-02. loss definitions · alternating updates
- X. Mao, Q. Li, H. Xie, R. Y. K. Lau, Z. Wang, S. P. Smolley, “Least Squares Generative Adversarial Networks,” ICCV, 2017. source
- DASR contributors, “MoCo logits and contrastive cross-entropy implementation,” official DASR source, commit
51524af8021c94a502ee002e135867a1b75dc7d0, accessed 2026-11-02. encoder · loss - Y. Zhang, K. Li, K. Li, L. Wang, B. Zhong and Y. Fu, “Image Super-Resolution Using Very Deep Residual Channel Attention Networks,” in Proc. ECCV, 2018, pp. 294–310. doi · arXiv
- K. Simonyan and A. Zisserman, “Very Deep Convolutional Networks for Large-Scale Image Recognition,” in Proc. ICLR, 2015. arXiv
- Y. Zhang, X. Huang, J. Ma, et al., “Recognize Anything: A Strong Image Tagging Model,” CVPR Workshops, 2024. source
- E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, W. Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” ICLR, 2022. source
- D. Podell, Z. English, K. Lacey, A. Blattmann, T. Dockhorn, J. Müller, J. Penna, R. Rombach, “SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis,” ICLR, 2024. source
- H. Liu, C. Li, Q. Wu, Y. J. Lee, “Visual Instruction Tuning,” NeurIPS, 2023. source
- T. Karras, M. Aittala, T. Aila, S. Laine, “Elucidating the Design Space of Diffusion-Based Generative Models,” NeurIPS, 2022. source
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 09A.2・單步擴散超解析度 · 14 分鐘