DLCV 14・穩健性:分布偏移、對抗樣本與異常
先備知識:DLCV 02・深度影像分類
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
在 64、256 或 1,024 個像素的雜訊條紋影像上訓練線性分類器,再把每個像素都改變相同的幾階:一次沿著損失梯度(FGSM),一次用隨機正負號。
你將學到
- 區分分布轉移、對抗擾動與不熟悉輸入。
- 讓轉移處理方式符合其資料假設。
- 指定威脅模型、實作攻擊並解讀穩健性憑證。
- 比較輸出式及特徵式 OOD 分數,以及區塊式異常偵測。
- 檢查資料污染、測試集調參與誤導性的總體指標。
先看全貌
一個在測試集上拿到 98% 的模型,只被檢查過「長得像訓練資料」的資料。部署後的模型會遇到別的資料:新相機拍的照片、被攻擊者修改過的影像,以及從來不在標籤集裡的物體。穩健性研究的就是這時候會發生什麼,以及怎麼讓答案不那麼令人擔心。
為什麼重要。 這三種失效造成的傷害不同。偏移會悄悄拉低現場的準確率,所以一個看起來已經完成的模型,在上線後會持續犯更多錯。對抗樣本是安全問題:任何決策值得被操縱的系統(內容過濾、身分檢查、交通標誌辨識)都會被攻擊。無法回答的輸入會產生信心十足的胡說,這是安全關鍵系統所能給出的最危險的輸出。解法也不一樣,所以第一項實務技能,就是說得出你面對的是哪一種問題。
本篇的位置。 DLCV 02 已經介紹過 ImageNet-C、-R 與 -A、一步式的 FGSM 攻擊、捷徑學習,以及用溫度縮放做校準;這裡在它們的基礎上往下談,不重複。ML 11 用重要性權重定義了共變量、標籤與概念偏移,也談到部署後的監控。PR 01 推導了拒絕選項,PR 10 則在一個小型手寫數字專案上,區分選擇性分類、開放集合辨識與異常偵測。ML 01 與 ML 06A 談了以重建為基礎的異常分數,ML 10 則解釋為什麼微調會侵蝕基礎模型的穩健性。本篇所有程式碼用 NumPy、SciPy、scikit-image 與 scikit-learn 就能在 CPU 上幾秒內跑完;其中的「網路」是 8×8 手寫數字上的小型多層感知器,所以我們印出的每個數字都來自玩具實驗,並且會標明。
三種穩健性問題,一張地圖
白話版。 先診斷失敗來自資料改變、刻意擾動,或任務外輸入;三者需要不同評估。
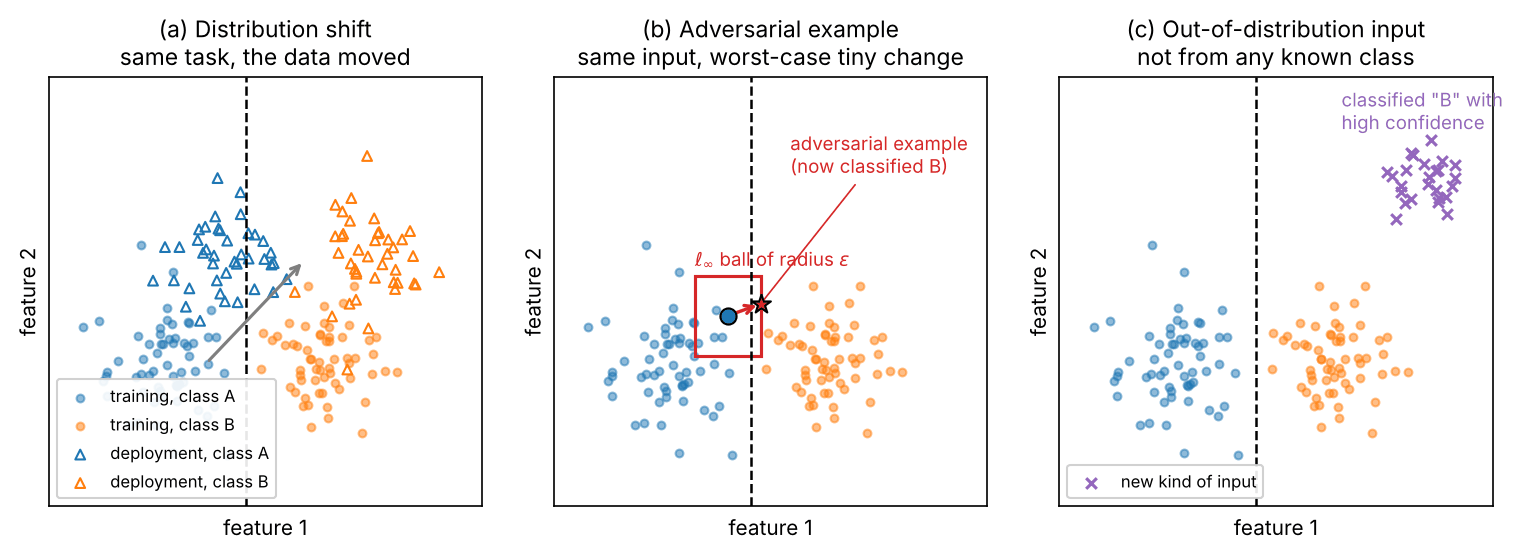
精確版。 設分類器 用取自分布 的樣本訓練,其中 是影像,標籤 。用 表示它在分布 上的準確率。
- 分布偏移。 測試資料來自 ,但標籤集 相同。問題是 比 低多少,以及怎麼減少這個落差。
- 對抗穩健性。 對每個測試配對 ,對手可以把 換成允許集合 中的任何 ,這個集合通常是 周圍的小球。若對 中的每一個 都有 ,模型在 上就是穩健的。問題問的是最壞情況,不是平均。
- OOD 與異常偵測。 有些測試輸入在 中沒有正確標籤(新的物體類別),或來自訓練資料從未涵蓋的輸入空間區域(有瑕疵的零件、損毀的影格)。我們想要一個分數 :分布內(in-distribution, ID)的輸入分數高,這些輸入分數低,讓系統可以拒答或發出警報。
| 分布偏移 | 對抗樣本 | OOD / 異常 | |
|---|---|---|---|
| 什麼變了 | 資料分布 | 某一個輸入,且是刻意的 | 輸入在任務之外 |
| 誰造成的 | 外在世界(相機、地點、時間) | 帶著目標的對手 | 外在世界(新類別、瑕疵) |
| 我們要什麼 | 維持準確率 | 在每一種允許的改動下標籤都不變 | 標記該輸入,不要作答 |
| 典型指標 | 偏移後測試集上的準確率 | 預算 下的穩健準確率 | AUROC、95% TPR 下的 FPR |
| 本篇位置 | 分布偏移 | 對抗樣本 | 分布外與異常偵測 |
三者在邊緣會重疊。嚴重的損壞可以讓輸入實質上變成 OOD;對抗樣本是由對手挑選的偏移;ImageNet-A 是一組因為會騙倒分類器而被挑出來的自然照片 [1],介於偏移與對抗樣本之間。不過這張表說明了為什麼單一個穩健性數字永遠無法涵蓋三者:它們問的問題不同,需要的測試資料也不同。
分布偏移
白話版。 熟悉任務也可能來自新相機、光線、風格或地點;轉移時準確率與信心未必一起變化。
偏移的種類
常用的詞彙用兩種方式拆解聯合分布,,並依哪個因子改變來為偏移命名:
- 共變量偏移(covariate shift): 改變, 不變。新的掃描儀、起霧、另一家醫院的染色方式。
- 標籤(先驗)偏移(label shift): 改變, 不變。疫情期間某種罕見疾病變得常見。
- 概念偏移(concept shift): 本身改變。某個類別的定義被修訂。
ML 11 用重要性權重與標籤偏移校正推導了這幾種偏移,這裡不重複。視覺領域還有兩個常用的詞。領域偏移(domain shift)是指名稱明確的資料來源之間的共變量偏移(合成對真實、這家醫院對那家醫院);子群體偏移(subpopulation shift)則保持相同種類的影像,但改變各個群體出現的頻率;WILDS 兩者都有 [2]。Yang 等人的綜述加了一個區分,後面會變得很重要:共變量偏移改變輸入的外觀而標籤仍然有效,語意偏移(semantic shift)則帶來標籤落在 之外的輸入 [3]。我們希望模型對共變量偏移保持穩健,並偵測出語意偏移。
衡量偏移穩健性的基準
白話版。 真正的部署資料很少能事先拿到,所以研究者建立了一次只改變一件事的測試集,或是收集同樣類別但自然地不太一樣的照片。
主要的幾個家族,除非另外說明,都以 ImageNet 類別標註:
- 合成損壞。 ImageNet-C 以五種嚴重程度加上雜訊、模糊、天氣與數位損壞,作者也提出了用於擾動序列的 ImageNet-P [4]。細節與平均損壞錯誤率在 DLCV 02。
- 風格化表現。 ImageNet-R 收集藝術品、卡通、雕塑與其他表現形式;同一篇論文還提出其他真實世界的偏移資料集,並發現對紋理與局部影像統計有幫助的方法,對其他偏移(例如地理變化)沒有幫助 [5]。
- 自然對抗影像。 ImageNet-A 保留未經修改、但被 ResNet-50 判錯的照片;它們能轉移到其他模型,顯示模型有共同的弱點 [1]。
- 受控收集。 ObjectNet 以隨機的背景、旋轉與視角拍攝物體,只當測試集,沒有訓練切分 [6]。
- 重新收集。 ImageNetV2 依照原本的收集流程重建測試集;即使盡可能照抄流程,準確率還是下降了 [7](見 ML 11)。
- 真實環境。 WILDS 收集十個來自真實應用的偏移資料集,例如不同醫院的組織切片與新地點的野外相機陷阱,並報告標準訓練在分布外的表現遠低於分布內,而現有的穩健性方法也沒有縮小這個差距 [2]。
怎麼讀這些數字。 乾淨準確率較高的模型,偏移後的準確率通常也較高,所以「它在 ImageNet-R 上分數更高」可能只是在說「它是個更好的模型」。Taori 等人在 213 種測試條件下評估了 204 個 ImageNet 模型,並提出有效穩健性(effective robustness):偏移測試集上的準確率,超出由標準模型擬合出的趨勢線根據乾淨準確率所預測的部分 [8]。Miller 等人發現,對許多偏移而言,不同架構與訓練選擇下的偏移準確率與乾淨準確率落在接近一條直線上(「線上的準確率」,accuracy on the line),只有某些合成偏移與一個醫療資料集的相關性較弱 [9]。實務上的結論:比較穩健性介入手段時,要在相同的乾淨準確率下比,或同時列出兩個數字。
選讀:有效穩健性與線上的準確率(見「補充資料」頁)。基準趨勢線如何擬合、為什麼用 logit 或 probit 座標軸,以及怎麼讀穩健性散布圖。
程式碼:損壞、資料擴增與測試批次正規化
這個玩具實驗在 scikit-learn 的 8×8 手寫數字上訓練一個小型 MLP,並用三種損壞、嚴重程度 1 到 5 去損壞測試影像。網路用訓練集算出的統計量把每個像素標準化,做法就像批次正規化層在測試時使用的滑動統計量。我們比較三個模型:一般模型;用雜訊擴增訓練的模型(每張訓練影像多一份隨機嚴重程度的雜訊副本);以及帶有測試批次正規化(test-batch normalization)的一般模型,它在損壞後的測試批次上重新計算每個像素的平均與標準差,而不是使用訓練統計量。
程式碼 · Python · 36 行
import numpy as np
from scipy.ndimage import gaussian_filter
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

X, y = load_digits(return_X_y=True)
X = X / 16.0                                          # 8x8 images, pixels in [0, 1]
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0)
rng = np.random.default_rng(0)

corruptions = {                                       # severity s = 1..5
    "noise":    lambda X, s: np.clip(X + rng.normal(0, 0.1 * s, X.shape), 0, 1),
    "blur":     lambda X, s: gaussian_filter(X.reshape(-1, 8, 8), (0, 0.25 * s, 0.25 * s)).reshape(-1, 64),
    "contrast": lambda X, s: 0.5 + (X - 0.5) * (1 - 0.15 * s),
}

def norm(X, ref):                                     # standardize each pixel with ref's statistics
    return (X - ref.mean(0)) / (ref.std(0) + 0.05)

def fit(X, y):
    return MLPClassifier(hidden_layer_sizes=(64,), alpha=1e-3, max_iter=400, random_state=0).fit(norm(X, Xtr), y)

plain = fit(Xtr, ytr)
s_rand = rng.integers(1, 6, (len(Xtr), 1))            # random noise severity per training image
augmented = fit(np.vstack([Xtr, corruptions["noise"](Xtr, s_rand)]), np.r_[ytr, ytr])

for name, corrupt in corruptions.items():
    rows = {"plain": [], "noise-aug": [], "test-norm": []}
    for s in range(6):
        Xs = Xte if s == 0 else corrupt(Xte, s)
        rows["plain"].append(plain.score(norm(Xs, Xtr), yte))
        rows["noise-aug"].append(augmented.score(norm(Xs, Xtr), yte))
        rows["test-norm"].append(plain.score(norm(Xs, Xs), yte))   # statistics of the test batch
    for k, v in rows.items():
        print(f"{name:8s} {k:9s}", " ".join(f"{a:.2f}" for a in v))
它印出嚴重程度 0(乾淨)到 5 的測試準確率:
程式碼 · 9 行
noise    plain     0.98 0.94 0.75 0.54 0.41 0.31
noise    noise-aug 0.97 0.96 0.93 0.82 0.74 0.62
noise    test-norm 0.98 0.97 0.90 0.83 0.73 0.61
blur     plain     0.98 0.98 0.96 0.82 0.46 0.21
blur     noise-aug 0.97 0.97 0.97 0.90 0.78 0.58
blur     test-norm 0.98 0.98 0.97 0.95 0.89 0.81
contrast plain     0.98 0.92 0.46 0.20 0.19 0.19
contrast noise-aug 0.97 0.98 0.96 0.93 0.84 0.60
contrast test-norm 0.98 0.98 0.98 0.98 0.98 0.98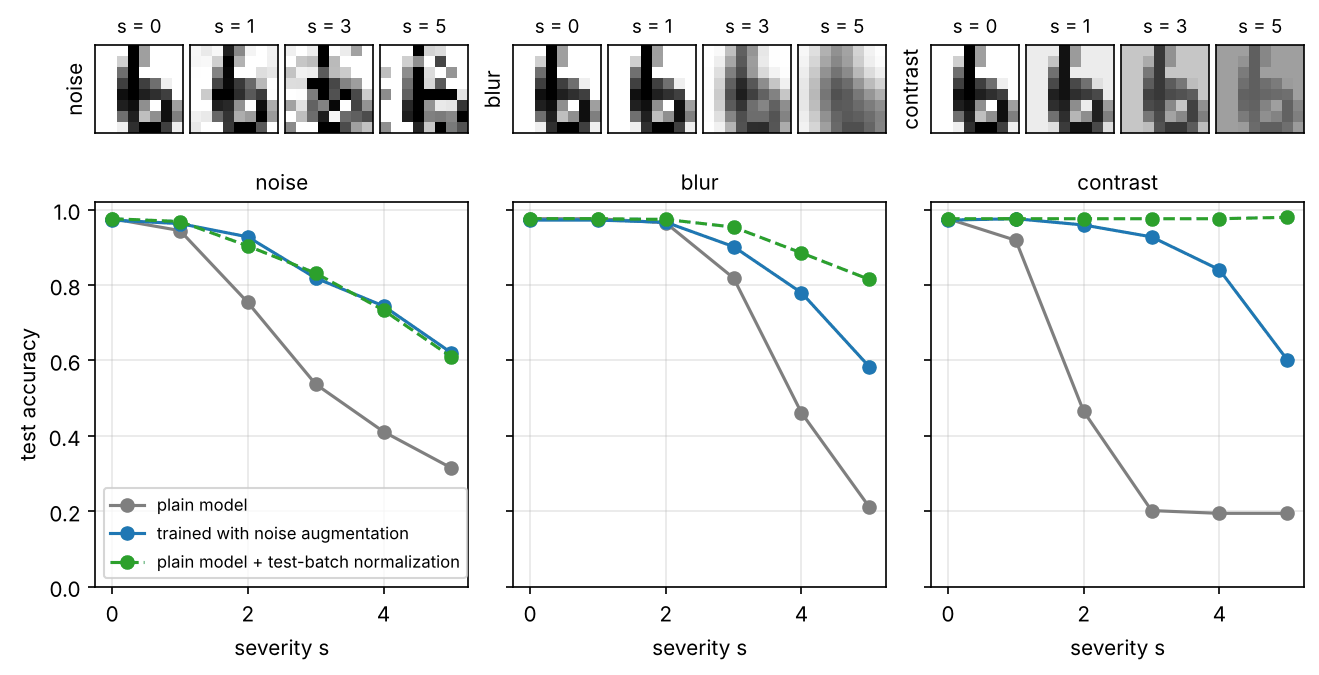
(所有數字都來自我們的玩具實驗。)有四個教訓可以帶到真實網路上:
- 看起來溫和的改變就足夠了。 把對比降到原本範圍的 70%(嚴重程度 2),就讓一般模型的準確率減半,即使人可以輕鬆讀出這些數字。
- 資料擴增有幫助,而且不只對它用過的那種損壞。 用雜訊訓練,在這裡對模糊與對比也有幫助,這正是多樣化擴增所寄望的。它犧牲了一點乾淨準確率(0.98 變成 0.97),而真實基準顯示,轉移到其他偏移遠遠不能保證 [5], [8]。
- 在假設成立時,重新估計正規化統計量是便宜又有效的修正。 對比損壞是對每個像素的仿射變換,逐像素標準化可以完全還原它,所以準確率維持在 0.98。雜訊改變統計量的方式是標準化還原不了的,所以收益較小。
- 測試批次正規化需要一個批次。 它一次使用了同一種損壞的全部 540 張測試影像。如果只有幾張影像,或批次混合了好幾種條件,統計量就會是錯的(練習 1)。
什麼有幫助,什麼沒有
白話版。 處理方式包括多樣訓練、廣泛預訓練、測試時調適、目標領域調適與多領域訓練;應依可用資料及部署限制選擇。
資料擴增。 資料擴增讓訓練分布變寬,使測試分布更有可能落在其中。AugMix 把同一張影像的幾條隨機擴增鏈混合起來,並加上 Jensen–Shannon 一致性損失,要求網路對原圖與擴增版本給出相近的預測 [10]。作者刻意移除了與 ImageNet-C 損壞重疊的運算,讓這個基準衡量的是對沒見過的損壞的轉移能力,而不是對測試損壞的背誦 [10]。風格化訓練把影像紋理換成繪畫風格,讓 ResNet-50 更依賴形狀,並改善了對多種失真的穩健性 [11]。要小心的是 ImageNet-R 那項研究:擴增與更大的模型在某些真實偏移(風格、模糊)上有幫助,在另一些(地理)上沒有,而且沒有任何受評估的方法能在所有偏移上一致地改善穩健性 [5]。通用的擴增配方在 DLCV 02。
在更多樣的資料上預訓練。 在 Taori 等人的測試平台中,大多數穩健性介入手段對自然偏移幾乎沒有帶來有效穩健性;主要的例外是用更大、更多樣的資料訓練 [8]。以網路上的影像–文字配對訓練的零樣本 CLIP 模型,在自然的 ImageNet 偏移上大幅提高了有效穩健性,但 CLIP 論文也指出,一旦用完全監督的方式在 ImageNet 上擬合分類器,這個好處幾乎消失 [12]。Fang 等人檢驗了五個可能的原因(資料集大小、訓練分布、訓練時的語言監督、測試時的語言監督、對比損失),發現更多樣的訓練分布是主因 [13]。所以微調會侵蝕穩健性;WiSE-FT 把零樣本模型與微調後模型的權重取平均,保留兩者的大部分優點 [14](另見 ML 10 的 LP-FT)。
測試時適應(test-time adaptation, TTA)。 如果未標註的測試影像是一批一批到達,模型可以在預測前先調整自己。最簡單的形式就是我們玩具實驗中的做法:Schneider 等人把 25 個預訓練模型的批次正規化統計量換成損壞測試影像的統計量,一致地改善了對損壞的穩健性,甚至只用單一樣本來適應也有效 [15]。TENT 再往前一步:它重新估計正規化統計量,並且在每個測試批次上,以最小化模型自身預測的熵,線上更新正規化層中逐通道的仿射參數 [16]。TTA 假設測試資料是一串偏移相當穩定的資料流;它在測試時增加運算量,如果資料流改變,還可能漂移。
選讀:測試時的熵最小化(見「補充資料」頁)。TENT 的目標函數、它改變哪些參數與原因,以及要留意的失敗情況。
非監督式領域適應(unsupervised domain adaptation, UDA)。 如果訓練期間有目標領域的未標註影像,就可以訓練模型在沒有目標標籤的情況下在那裡運作。領域對抗訓練(DANN)在特徵上加一個小型領域分類器,兩者之間放一個梯度反轉層(gradient-reversal layer),使特徵既對有標註來源領域上的標籤任務有用,同時又無法分辨來源與目標 [17]。這個想法根據領域適應理論:如果分類器在特徵空間中分不出兩個領域,好的來源分類器就應該能轉移過去。
選讀:領域對抗訓練與梯度反轉層(見「補充資料」頁)。DANN 的目標函數寫成最小–最大問題的形式、用一行實作它的那一層,以及對齊特徵何時有害。
領域泛化(domain generalization, DG)。 沒有任何目標資料時,在多個來源領域上訓練模型,期望它能在沒見過的領域上運作。Zhou 等人的綜述把 DG 方法分成領域對齊、元學習、資料擴增與集成學習等類別 [18]。Gulrajani 與 Lopez-Paz 接著在同一個測試平台 DomainBed 中,以相同的調參力氣與明確的模型選擇規則,重跑了許多 DG 演算法,發現搭配強網路與資料擴增的單純經驗風險最小化(ERM,也就是在合併後的來源資料上做一般訓練)表現與它們相當甚至更好 [19]。他們的重點在方法論:一個 DG 方法,如果沒有一套不偷看測試領域的超參數選擇規則,就是不完整的。
選讀:Gulrajani 與 Lopez-Paz:In Search of Lost Domain Generalization(ICLR 2021)(見「論文導讀」頁)。DomainBed 的三種模型選擇規則如何運作,以及怎麼讀它的表格。
沒有幫助,或不可靠的做法。 在 Taori 等人的測試平台中,對合成損壞的穩健性只能微弱地預測對自然偏移的穩健性, 對抗穩健性也是如此 [8]。在某個基準上調好的方法,常常只對那個基準有幫助 [5]。在固定資料下更換架構,影響小於資料本身 [8], [13]。實務規則由此而來:要在好幾種偏移上測試,其中至少包含一種來自你自己部署環境的真實偏移。
偏移下的信心
白話版。 在偏移下,模型犯錯變多,但它通常不會等比例地變得沒有信心,所以它的機率不再代表它說的意思。
Ovadia 等人在好幾個任務上對資料集偏移下的不確定性方法做了基準測試,發現偏移越大校準越差,在分布內驗證資料上擬合的事後校準(例如溫度縮放)在偏移下不夠用,而對多個模型取平均的方法(例如深度集成)表現最穩 [20]。溫度縮放在 DLCV 02 中解釋過,ML 11 則用玩具實驗示範了擬合好的溫度如何在偏移下失靈。實務上的結論:在乾淨驗證資料上選好的信心門檻,到了現場會接受更多錯誤答案,所以部署後要監控信心的分布(ML 11)。
對抗樣本
白話版。 對幾乎任何一張被正確分類的影像,附近都有另一張影像(人眼常常分辨不出來)會被網路分類錯誤。攻擊者的做法,是直接問網路:每個像素該往哪個方向移動。
什麼是對抗樣本
Szegedy 等人報告,只要加上一個經由最大化網路預測誤差而找到、人眼無法察覺的擾動,就能讓深度網路誤分類一張影像,而且同一個擾動往往也能騙過用另一個資料子集訓練的不同網路 [21]。Goodfellow 等人用網路在高維度下的近似線性來解釋這個現象,並提出一步式的快速梯度符號法(fast gradient sign method)[22],DLCV 02 已推導並測試過。本節補上評估與改善穩健性所需的部分:威脅模型、多步攻擊、對抗訓練、誠實的評估,以及認證。
威脅模型
白話版。 在說清楚「對什麼穩健」之前,「穩健」沒有任何意義:攻擊者可以改多少,攻擊者又知道些什麼?
威脅模型(threat model)固定了三件事。
1. 允許的擾動。 多數研究使用乾淨影像 周圍半徑為 的 球:
其中 是像素值的個數, 是擾動, 是它的第 個分量。 球讓每個像素最多改變 (到處都改一點點); 球限制改變的總能量;「範數」則計算有多少像素改變(只改幾個像素,但改很多)。在 CIFAR-10 上, 的 是標準預算:Madry 等人在 0–255 的像素尺度上以 訓練並攻擊 [23],RobustBench 則為 與 威脅模型以及常見損壞維護排行榜 [24]。小的 範數是「難以察覺」的方便替代,但不是它的定義。
2. 攻擊者的知識。 在白箱(white-box)攻擊中,攻擊者知道模型與權重,可以計算梯度。在黑箱(black-box)攻擊中,攻擊者只能查詢模型。Papernot 等人展示了一種實用的黑箱攻擊:查詢目標模型來標註輸入,用這些輸入訓練一個本地的替代模型,在替代模型上製作對抗樣本,再靠轉移(transfer)攻擊目標 [25]。其他黑箱攻擊只靠查詢來估計決策邊界。穩健性的主張應該針對白箱攻擊來做,因為今天某個攻擊者做不到的事,明天資訊更充分的攻擊者可能就做到了。
3. 目標。 無目標(untargeted)攻擊只要任何錯誤標籤;有目標(targeted)攻擊要的是指定的標籤(停車標誌被讀成速限標誌)。有目標攻擊比較難,所以兩者給出的數字不同。
FGSM 與 PGD 的精確版本
白話版。 FGSM 沿著損失往上爬一大步。PGD 則爬很多小步,每一步之後把影像拉回允許的球內。PGD 能找到更強的對抗樣本,是標準的一階攻擊。
令 是參數為 的網路在輸入 、標籤 上的交叉熵損失。對 球的 FGSM [22] 為
其中 是損失對輸入像素的梯度, 逐項作用(得到 、 或 ), 把每個像素截到合法範圍。把每個像素恰好往增加損失的方向移動 ,是損失的線性近似在 球內所能做到的最好。
投影梯度下降(projected gradient descent, PGD)[23] 從球內的隨機點開始,重複 次較小的步伐:
其中 是球內的均勻雜訊(隨機起點), 是步長, 計算步數, 是對允許集合的投影。對與合法像素範圍相交的 球,投影是兩次截斷:先做 ,再做 。最後的迭代點 就是對抗樣本。PGD 是「對損失做梯度上升」;這個名字來自最佳化領域,同一個演算法在那裡是最小化。因為損失曲面不是凹的,隨機起點與幾次重新啟動會有幫助;Madry 等人觀察到,從許多隨機起點到達的損失值相當集中,這支持了 PGD 是可靠的一階對手 [23]。
另一個常見的損失是 Carlini 與 Wagner 的邊際損失(margin loss),它直接最大化最大的錯誤 logit 與正確 logit 之間的差距,而不是交叉熵 [26]。交叉熵飽和時它就派上用場,這也是認真的評估要跑好幾種攻擊的原因之一。
選讀:決定評估結果的攻擊設定(見「補充資料」頁)。步長、步數、重新啟動、邊際損失、 PGD,以及 AutoAttack 固定了哪些選擇。
對抗訓練
白話版。 如果模型在附近最壞的影像上失敗,就用附近最壞的影像訓練它。訓練時,對每個批次先用 PGD 攻擊,然後用被攻擊過的影像而不是乾淨影像來擬合。
Madry 等人把穩健訓練寫成最小–最大(鞍點)問題 [23]:
其中 是資料分布, 是允許的擾動集合(例如 ),內層的最大化是攻擊者的最佳擾動,外層的最小化是防禦者的訓練。實務上,內層最大化用幾步的 PGD 近似,外層最小化則對得到的對抗批次做一般的隨機梯度下降。
它的代價:
- 運算量。 每個訓練步驟都需要一次 步的攻擊,所以訓練的成本大約是 倍。
- 容量。 Madry 等人發現,穩健分類需要比乾淨分類更大的網路;小網路對 PGD 訓練時可能崩潰成只預測一個類別,而用一步式 FGSM 訓練則會對它狹窄的擾動集合過擬合,在大 下無法抵擋 PGD [23]。
- 乾淨準確率。 穩健模型在乾淨資料上通常比較不準。Tsipras 等人證明了這個取捨在一個簡單而自然的設定中確實存在,並主張穩健模型學到的是不同的特徵,而這些特徵恰好和人類感知更一致 [27]。TRADES 把穩健錯誤拆成自然錯誤加上邊界錯誤,並用一個損失透過單一權重明確地在兩者間取捨 [28]。
選讀:Madry 等人:Towards Deep Learning Models Resistant to Adversarial Attacks(ICLR 2018)(見「論文導讀」頁)。鞍點的觀點、容量實驗,以及怎麼讀它的攻擊結果表。
程式碼:在手寫數字上做 FGSM、PGD 與對抗訓練
NumPy 手動計算單隱藏層 MLP 的輸入梯度:對 softmax 輸出 與 one-hot 標籤 ,交叉熵對 logits 的梯度是 ,再把它依序反傳過輸出層、ReLU 與第一層。兩個模型都對訓練資料做同樣的 50 趟;穩健模型擬合的是針對它當前權重製作的 PGD 樣本(,5 步)。
程式碼 · Python · 42 行
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

X, y = load_digits(return_X_y=True)
X = X / 16.0                                          # pixels in [0, 1]
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0)
rng = np.random.default_rng(0)

def input_grad(m, X, y):
    """Gradient of the cross-entropy loss with respect to the input pixels."""
    (W1, W2), (b1, b2) = m.coefs_, m.intercepts_
    h = np.maximum(X @ W1 + b1, 0)                    # hidden ReLU layer
    z = h @ W2 + b2                                   # logits
    g = np.exp(z - z.max(1, keepdims=True)); g /= g.sum(1, keepdims=True)
    g[np.arange(len(y)), y] -= 1                      # dL/dz = softmax(z) - one-hot(y)
    return ((g @ W2.T) * (h > 0)) @ W1.T              # back through ReLU and first layer

def fgsm(m, X, y, eps):
    return np.clip(X + eps * np.sign(input_grad(m, X, y)), 0, 1)

def pgd(m, X, y, eps, steps=10):
    alpha = 2.5 * eps / steps                         # step size
    Xa = np.clip(X + rng.uniform(-eps, eps, X.shape), 0, 1)        # random start in the ball
    for _ in range(steps):
        Xa = Xa + alpha * np.sign(input_grad(m, Xa, y))             # ascent step on the loss
        Xa = np.clip(np.clip(Xa, X - eps, X + eps), 0, 1)           # project: eps-ball, then [0, 1]
    return Xa

def train(adversarial, epochs=50, eps=0.15):
    m = MLPClassifier(hidden_layer_sizes=(128,), random_state=0)
    m.partial_fit(Xtr, ytr, classes=np.arange(10))    # first pass on clean images
    for _ in range(epochs - 1):                       # Madry et al.: fit the worst case found by PGD
        m.partial_fit(pgd(m, Xtr, ytr, eps, steps=5) if adversarial else Xtr, ytr)
    return m

standard, robust = train(False), train(True)
for eps in [0, 0.05, 0.1, 0.15, 0.2]:
    acc = [m.score(atk(m, Xte, yte, eps), yte) for m in (standard, robust) for atk in (fgsm, pgd)]
    print(f"eps={eps:.2f}  standard: FGSM {acc[0]:.3f} PGD {acc[1]:.3f}"
          f"   adversarially trained: FGSM {acc[2]:.3f} PGD {acc[3]:.3f}")
它印出(在筆電 CPU 上約 10–20 秒):
程式碼 · 5 行
eps=0.00  standard: FGSM 0.967 PGD 0.967   adversarially trained: FGSM 0.956 PGD 0.956
eps=0.05  standard: FGSM 0.861 PGD 0.854   adversarially trained: FGSM 0.891 PGD 0.889
eps=0.10  standard: FGSM 0.574 PGD 0.528   adversarially trained: FGSM 0.757 PGD 0.746
eps=0.15  standard: FGSM 0.237 PGD 0.178   adversarially trained: FGSM 0.626 PGD 0.593
eps=0.20  standard: FGSM 0.057 PGD 0.007   adversarially trained: FGSM 0.415 PGD 0.361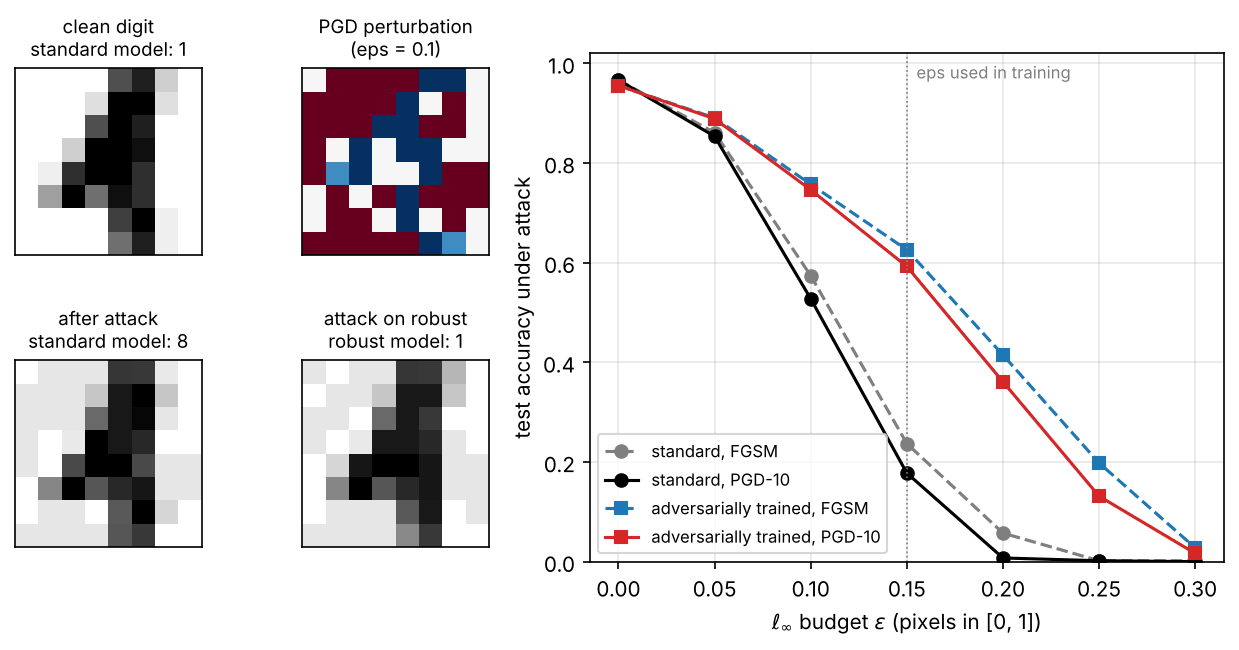
(所有數字都來自我們的玩具實驗。)這張表可以從三個方向讀:
- 沿著一欄往下: 準確率隨 快速下降。在 時,每個像素可以改變資料集 16 個灰階中的 1.6 個,標準模型在 PGD 下從 0.967 降到 0.528。
- 橫跨一組攻擊: PGD 從不比 FGSM 弱,而且差距隨 擴大(標準模型在 時是 0.057 對 0.007)。只用 FGSM 的評估會高估穩健性。
- 橫跨模型: 對抗訓練把 時的 PGD 準確率從 0.178 提高到 0.593,並犧牲約一個百分點的乾淨準確率(0.967 變成 0.956),是那個取捨的小規模版本。超出訓練預算後,穩健性就消退了(圖中 時是 0.131):對於訓練時所針對的威脅模型之外的任何事,穩健性都沒有保證。
誠實地評估穩健性
白話版。 很容易造出只會弄壞攻擊者工具的「防禦」,例如讓梯度變得沒用,但模型其實一樣容易被騙。這種穩健性只存在於紙面上,直到有人用更好的攻擊為止。
Athalye、Carlini 與 Wagner 把這個現象稱為混淆梯度(obfuscated gradients),是梯度遮蔽(gradient masking)的一種,並描述了三種類型 [29]:破碎梯度(shattered gradients;不可微或數值不穩定的運算,例如對輸入做量化,會讓梯度為零或錯誤);隨機梯度(stochastic gradients;測試時的隨機輸入變換讓單一次的梯度具有誤導性);以及消失或爆炸梯度(vanishing or exploding gradients;執行迭代流程的防禦,例如把輸入投影到學到的流形上,行為就像一個極深的網路)。他們為每一種類型各給出一個反制攻擊:BPDA(backward pass differentiable approximation,反向傳遞可微分近似)在前向傳遞照常執行防禦,反向傳遞則換成可微分的近似(通常是恆等函數);EOT(expectation over transformation,變換的期望)對隨機變換的梯度取平均;以及重新參數化(reparameterization),藉由變數變換讓迭代步驟從梯度路徑中消失。在針對 ICLR 2018 收錄的九個白箱防禦所做的案例研究中,有七個依賴混淆梯度,他們的攻擊完全繞過了其中六個,部分繞過一個 [29]。
同一篇論文還列出評估有問題的警訊:一步式攻擊比迭代式攻擊更有效;黑箱攻擊比白箱攻擊更有效;無界攻擊的成功率沒有達到 100%;隨機取樣找得到梯度攻擊找不到的對抗樣本;以及增加預算並沒有提高成功率 [29]。我們的玩具實驗通過了它能通過的檢查:PGD 勝過 FGSM,而且 增大時準確率會降到零。
為了讓評估較不依賴評估者的細心程度,Croce 與 Hein 提出了 AutoAttack,這是一個免調參數的集成,由兩個改良的 PGD 變體(有自動的步長排程與不同的損失)和兩個互補的既有攻擊組成;用在 50 多個已發表的防禦上,除了一個之外,所有防禦的穩健準確率都比原本報告的更低 [30]。RobustBench 以 AutoAttack 建立了公開排行榜,並對允許的模型訂有規則,同時也邀請在 AutoAttack 可能高估穩健性的地方使用適應性攻擊 [24]。所以,報告穩健準確率時,應該說明威脅模型、、所用的攻擊(至少要有 AutoAttack 或針對該防禦設計的適應性攻擊)、步數與重新啟動次數,以及測試集。
選讀:Athalye 等人:Obfuscated Gradients Give a False Sense of Security(ICML 2018)(見「論文導讀」頁)。三種遮蔽類型、能還原它們的攻擊,以及它的案例研究表顯示了什麼。
認證穩健性
白話版。 攻擊只能證明模型在某個點不穩健。認證則能證明,在某個半徑內沒有任何擾動能改變答案,無論用哪種攻擊。
據作者所述,隨機平滑(randomized smoothing)[31] 是當時唯一被證明能在 ImageNet 上實行的認證防禦,至今仍是標準的參照點。取任何基底分類器 ,定義平滑分類器 ,回傳 在高斯雜訊下最常預測的類別:
其中 是每個像素標準差為 的各向同性高斯雜訊, 是單位矩陣。Cohen、Rosenfeld 與 Kolter 證明,如果最高的類別 在雜訊下的機率至少為 ,其他每個類別至多為 ,那麼對每個滿足下式的擾動 , 都預測 :
其中 是標準常態累積分布函數的反函數 [31]。實務上, 是由蒙地卡羅樣本估計的信賴下界,而且無法認證時,方法會棄權。這個保證適用於 威脅模型,附帶選定的失敗機率,並且是針對平滑分類器 ,不是針對 。較大的 允許較大的半徑,但會降低乾淨準確率,同樣是一種取捨。
選讀:隨機平滑的實作(見「補充資料」頁)。認證演算法的逐步做法、為什麼半徑受樣本數限制,以及一段經過測試的 NumPy 程式碼。
實體攻擊與貼片攻擊
白話版。 攻擊不必隱形,也不必是數位的。一張列印出來的貼紙就能騙過相機。
Eykholt 等人產生了能在視角、距離與光線改變下依然有效的擾動,把它們印成黑白貼紙貼在真實的停車標誌上,結果讓道路標誌分類器在多數實驗室影像中,以及在經過路旁的影片的許多影格中,輸出攻擊者指定的目標類別 [32]。Brown 等人做出了對抗貼片(adversarial patch):通用、可列印的影像區域,放在場景中任何位置,都會讓分類器回報指定的類別 [33]。這類攻擊離開了 威脅模型:它們很大,但位置集中。它們對任何以相機為基礎的系統都很重要,也與 DLCV 02A 討論的人臉辨識呈現攻擊有關。
分布外與異常偵測
白話版。 分類器總是會從它認識的類別中挑一個,即使面對的是從沒見過的東西的照片。OOD 偵測多加了第二個輸出,一個分數,用來說「這個輸入看起來像我的訓練資料」或「不像」,讓系統可以拒絕作答。
你要解決的是哪一個任務?
好幾個密切相關的任務有著不同的名稱。Yang 等人把它們放進同一個框架,稱為廣義 OOD 偵測(generalized OOD detection),並依需要偵測哪一種偏移,以及 ID 資料是單一類別還是多個類別來區分 [3]:
| 任務 | 分布內資料 | 必須標記 | 典型例子 |
|---|---|---|---|
| OOD 偵測 | 一個 類的訓練集 | 來自其他類別的輸入(語意偏移),同時仍要分類 ID 輸入 | 寵物分類器看到一輛車 |
| 開放集合辨識(open-set recognition) | 個已知類別 | 未知類別,同時分類已知的 | PR 10、DLCV 02A |
| 感官異常偵測(sensory anomaly detection) | 同一種類的正常影像 | 看起來不同的輸入(共變量偏移) | 產線上有刮痕的零件 |
| 語意異常/新穎性偵測(semantic anomaly / novelty detection) | 一個或少數幾個類別 | 來自任何其他類別的輸入 | 相機陷阱影像中出現一個新物種 |
OOD 偵測與開放集合辨識的差別主要在於歷史與基準;該綜述把開放集合辨識視為多類別的新穎性偵測 [3]。它們都不同於 PR 01 的拒絕選項(reject option),後者是對已知類別之間模稜兩可的輸入棄權,而不是對新穎的輸入棄權。
分數
白話版。 每個偵測器最後都化為每個輸入一個數字。以輸出為基礎的分數問分類器有多有信心;以特徵為基礎的分數問輸入的特徵離訓練特徵有多遠。
令 為訓練好的分類器的 logits, 為它的倒數第二層特徵(最後一個線性層的輸入),並約定分數越大代表越像分布內。四個標準的事後分數,不需要重新訓練:
最大 softmax 機率(maximum softmax probability, MSP) [34]:
其中 是第 個 logit。Hendrycks 與 Gimpel 指出,被正確分類的樣本,其 MSP 往往高於被誤分類的樣本與 OOD 樣本,這讓 MSP 成為標準的基準線 [34]。
能量分數(energy score) [35]:
其中 是溫度(通常 )。負能量是 logits 的 log-sum-exp,是一種平滑的最大值,它保留了 logits 的大小,而這是 softmax 正規化掉的資訊。Liu 等人主張能量與輸入密度的對應比 softmax 信心更好,並報告在他們的 CIFAR 基準上,95% TPR 下的 FPR 比 MSP 更低 [35]。
馬氏距離(Mahalanobis distance) [36]:對訓練特徵為每個類別擬合一個高斯分布,各類別平均為 ,並共用一個(「綁定」的)共變異數 ,分數為
其中最小值遍歷 個類別。這就是 PR 01 的線性判別分析,放到學到的特徵上。Lee 等人還加上了小幅的輸入擾動,並結合多個層;我們只用最後一個隱藏層。
k 近鄰(kNN)距離 [37]:把特徵正規化成單位長度,,分數為
其中 是離 第 近的正規化訓練特徵。Sun 等人發現,這個不需要高斯假設的非參數分數表現良好,而且特徵正規化至關重要 [37]。
這些分數不更動分類器。訓練時的方法則會改變它:離群值暴露(Outlier Exposure)訓練分類器對一大批輔助的離群影像給出均勻(低信心)的預測,在原始實驗中改善了對沒見過的 OOD 資料的偵測 [38]。
指標
白話版。 把偵測當成二元決策,ID 對 OOD,問分數把兩群分開得多好:看所有門檻,或看一個能保留大多數 ID 輸入的門檻。
把 ID 測試輸入當作正例、OOD 輸入當作負例,當 時接受該輸入。則 是被接受的 ID 輸入的比例, 是被接受的 OOD 輸入的比例。有三個標準指標 [35]:
- AUROC,也就是 變化時 對 曲線下的面積。它等於隨機一個 ID 輸入的分數高於隨機一個 OOD 輸入的機率;0.5 是隨機猜測,1 是完美分開。
- FPR@95TPR ,其中 是使 的門檻:保留 95% 的 ID 輸入時,仍被接受的 OOD 輸入所占的比例。越低越好。它描述的是單一個工作點,也就是實際部署的系統所使用的那種。
- AUPR,精確率–召回率曲線下的面積,以 ID 輸入為正類(AUPR-In)或以 OOD 輸入為正類(AUPR-Out)來報告 [34]。它取決於 ID 與 OOD 測試輸入的比例,所以應該把這個比例一併報告。
ROC 曲線與精確率–召回率曲線本身,在 DLCV 02 中有說明。
程式碼:四個分數,近與遠的 OOD
ID 資料是數字 0–4。近 OOD 輸入是沒見過的數字 5–9:同一種影像,新的類別。遠 OOD 輸入是 scikit-image 中照片的 8×8 區塊,縮放到相同的像素範圍:完全不同種類的影像。分類器在訓練時兩者都沒見過。
程式碼 · Python · 46 行
import numpy as np
from scipy.special import logsumexp, softmax
from skimage import data, transform
from sklearn.datasets import load_digits
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

X, y = load_digits(return_X_y=True)
X = X / 16.0
known = y < 5                                         # in-distribution (ID): digits 0-4
Xtr, Xid, ytr, yid = train_test_split(X[known], y[known], test_size=0.3, stratify=y[known], random_state=0)
X_near = X[~known]                                    # near-OOD: unseen digits 5-9
rng = np.random.default_rng(0)
photos = [transform.resize(im / 255.0, (256, 256)) for im in (data.camera(), data.moon(), data.coins(), data.text())]
X_far = []                                            # far-OOD: 8x8 patches of photographs
for _ in range(600):
    im = photos[rng.integers(4)]; r, c = rng.integers(0, 224, 2)
    p = transform.resize(im[r:r + 32, c:c + 32], (8, 8), anti_aliasing=True)
    X_far.append(((p - p.min()) / (np.ptp(p) + 1e-8)).ravel())
X_far = np.array(X_far)

m = MLPClassifier(hidden_layer_sizes=(64,), alpha=1e-3, max_iter=500, random_state=0).fit(Xtr, ytr)
(W1, W2), (b1, b2) = m.coefs_, m.intercepts_
feat = lambda X: np.maximum(X @ W1 + b1, 0)           # penultimate (hidden) features
unit = lambda F: F / (np.linalg.norm(F, axis=1, keepdims=True) + 1e-12)
F = feat(Xtr)
mu = np.stack([F[ytr == c].mean(0) for c in range(5)])           # class means
cov = sum(np.cov(F[ytr == c].T, bias=True) * np.sum(ytr == c) for c in range(5)) / len(F)
P = np.linalg.inv(cov + 1e-3 * np.eye(len(cov)))                # shared precision matrix

def scores(X):                                        # every score: larger = "more in-distribution"
    H = feat(X); z = H @ W2 + b2; d = H[:, None] - mu[None]
    return {"MSP": softmax(z, axis=1).max(1),
            "energy": logsumexp(z, axis=1),           # = -E(x) with temperature 1
            "Mahalanobis": -np.einsum("ncd,de,nce->nc", d, P, d).min(1),
            "kNN": -np.sort(np.linalg.norm(unit(H)[:, None] - unit(F)[None], axis=2), 1)[:, 9]}

s_id = scores(Xid)
print(f"ID test accuracy {m.score(Xid, yid):.3f}")
for name, X_ood in [("near", X_near), ("far", X_far)]:
    s_ood = scores(X_ood)
    for k in s_id:
        auroc = roc_auc_score(np.r_[np.ones(len(Xid)), np.zeros(len(X_ood))], np.r_[s_id[k], s_ood[k]])
        fpr95 = np.mean(s_ood[k] >= np.quantile(s_id[k], 0.05))  # OOD accepted when 95% of ID is kept
        print(f"{name:4s} {k:11s} AUROC {auroc:.3f}  FPR@95TPR {fpr95:.3f}")
它印出:
程式碼 · 9 行
ID test accuracy 1.000
near MSP         AUROC 0.941  FPR@95TPR 0.291
near energy      AUROC 0.955  FPR@95TPR 0.258
near Mahalanobis AUROC 0.961  FPR@95TPR 0.209
near kNN         AUROC 0.970  FPR@95TPR 0.152
far  MSP         AUROC 0.870  FPR@95TPR 0.448
far  energy      AUROC 0.811  FPR@95TPR 0.660
far  Mahalanobis AUROC 1.000  FPR@95TPR 0.000
far  kNN         AUROC 0.995  FPR@95TPR 0.010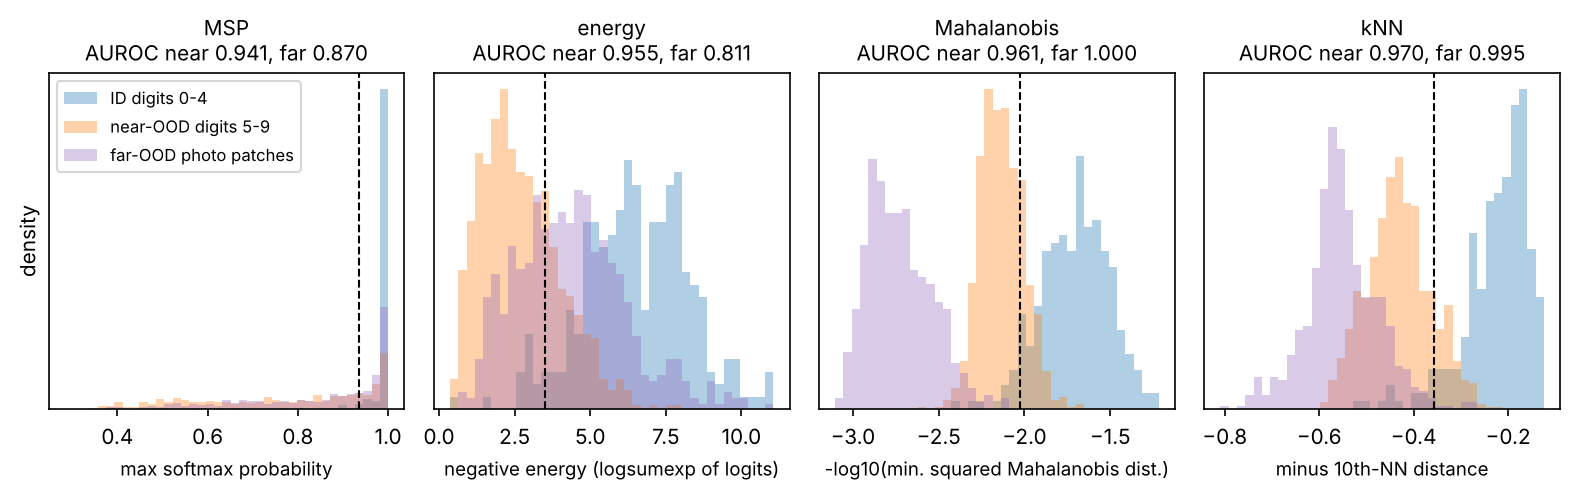
(所有數字都來自我們的玩具實驗。)有三個教訓:
- 內容上的「遠」並不代表每種分數都「容易」。 照片區塊和數字毫無相似之處,但在 95% TPR 的門檻下,MSP 接受了其中的 45%,能量接受了 66%。分類器信心十足地把它們對應到某個數字,因為信心衡量的是離決策邊界有多遠,而不是離資料有多遠。以特徵距離為基礎的分數看得出這些區塊的特徵離所有訓練特徵都很遠,因此幾乎全部拒絕。
- 分數的排名會隨 OOD 資料集改變。 在沒見過的數字上,能量勝過 MSP,在照片區塊上卻輸給它。大型基準研究 OpenOOD v1.5 同樣發現,沒有哪個方法能在所有資料集上都勝出 [39]。
- AUROC 與 FPR@95TPR 在大小上並不一致。 AUROC 0.941 聽起來很好,但在可部署的門檻下,MSP 仍然接受 29% 的沒見過的數字。
PR 10 用另一個分類器、以保留的數字跑了一個相關的開放集合實驗,並示範了代理的未知集合如何誤導人(PR 10)。
工業異常偵測
白話版。 在生產線上,瑕疵稀少而且五花八門,所以你不可能收集到每一種瑕疵的樣本。你改為只學正常零件看起來是什麼樣子,一個區塊一個區塊地學,然後標記任何和你見過的所有正常區塊都不像的區塊。
MVTec AD 讓這種設定成為標準基準:5354 張物體與紋理類別的高解析度影像,訓練用的無瑕疵影像,含有超過 70 種瑕疵(刮痕、凹陷、汙染、結構變化)的測試影像,以及瑕疵區域的像素級精確遮罩 [40]。方法在兩個層次上評分:影像層級(這個零件有瑕疵嗎?)與像素層級(瑕疵在哪裡?),通常用 AUROC;也會使用區域重疊的量測,例如 AU-PRO,MVTec AD 2 就是一例 [41]。用上表的說法,這是感官異常偵測。
PatchCore [42] 是建立在 kNN 想法上的強大而簡單的方法。它把無瑕疵的訓練影像送進在 ImageNet 上預訓練的網路,保留中層的區塊特徵(最後幾層對 ImageNet 類別太特定,對小瑕疵又太粗糙),每個特徵都在一個小鄰域內取平均以納入上下文。所有這些特徵放進一個記憶庫(memory bank),再用貪婪核心集(coreset)子取樣把它縮成一個仍能涵蓋罕見正常模式的小子集。測試時,每個區塊在記憶庫中的最近鄰距離構成異常圖,圖的最大值(稍加重新加權)就是影像分數。這個方法是為「冷啟動」(cold-start)設定設計的,也就是只有正常(無瑕疵)影像可用,它在 MVTec AD 上達到當時最先進的偵測與定位表現 [42]。
選讀:PatchCore 逐步解析(見「補充資料」頁)。鄰域聚合、極小化極大(minimax)的核心集目標與它的貪婪解,以及分數的重新加權,每個符號都有定義。
程式碼:磚牆上的區塊記憶庫
沒有網路權重,所以我們用原始的 7×7 像素區塊作為特徵,這保留了 PatchCore 的機制(記憶庫、核心集、最近鄰距離圖、最大值池化的影像分數),只拿掉學出來的特徵。「產品」是 scikit-image 磚牆紋理的 64×64 裁切:正常的訓練裁切取自影像上半部,測試裁切取自下半部,一半的測試裁切會被加上一條細的合成刮痕。
程式碼 · Python · 43 行
import numpy as np
from skimage import data, draw, transform
from skimage.util import view_as_windows
from sklearn.metrics import roc_auc_score
from sklearn.neighbors import NearestNeighbors

rng = np.random.default_rng(0)
tex = transform.rescale(data.brick() / 255.0, 0.5)   # 256x256 brick-wall "product surface"
S, P = 64, 7                                          # image size, patch size

def crop(top):                                        # normal images: top half; test images: bottom half
    r = rng.integers(0, 128 - S) + (0 if top else 128); c = rng.integers(0, 256 - S)
    return tex[r:r + S, c:c + S].copy()

def scratch(im):                                      # a thin line, 0.5 brighter or darker
    r, c = rng.integers(16, S - 16, 2); a = rng.uniform(0, np.pi); L = rng.integers(8, 16)
    rr, cc = draw.line(r, c, int(r + L * np.sin(a)), int(c + L * np.cos(a)))
    mask = np.zeros_like(im, bool); mask[rr, cc] = True
    im[mask] = np.clip(im[mask] + rng.choice([-0.5, 0.5]), 0, 1)
    return im, mask

def patches(im, step=1):                              # one 7x7 patch centred on each pixel
    return view_as_windows(np.pad(im, P // 2, mode="reflect"), (P, P), step).reshape(-1, P * P)

def greedy_coreset(M, n):                             # keep n patches that cover the bank well
    keep, d = [0], np.linalg.norm(M - M[0], axis=1)
    for _ in range(n - 1):
        i = int(d.argmax()); keep.append(i)
        d = np.minimum(d, np.linalg.norm(M - M[i], axis=1))
    return M[keep]

bank = np.vstack([patches(crop(top=True), step=2) for _ in range(16)])
memory = NearestNeighbors(n_neighbors=1).fit(greedy_coreset(bank, len(bank) // 10))

is_defect, img_score, pix_score, pix_true = [], [], [], []
for k in range(40):
    im, mask = scratch(crop(top=False)) if k % 2 else (crop(top=False), np.zeros((S, S), bool))
    amap = memory.kneighbors(patches(im))[0].reshape(S, S)   # nearest-neighbour distance per pixel
    is_defect.append(k % 2); img_score.append(amap.max())
    pix_score.append(amap.ravel()); pix_true.append(mask.ravel())
print(f"memory bank {len(bank)} -> {len(bank) // 10} patches")
print(f"image-level AUROC {roc_auc_score(is_defect, img_score):.3f}")
print(f"pixel-level AUROC {roc_auc_score(np.concatenate(pix_true), np.concatenate(pix_score)):.3f}")
它印出:
程式碼 · 3 行
memory bank 16384 -> 1638 patches
image-level AUROC 0.955
pixel-level AUROC 0.996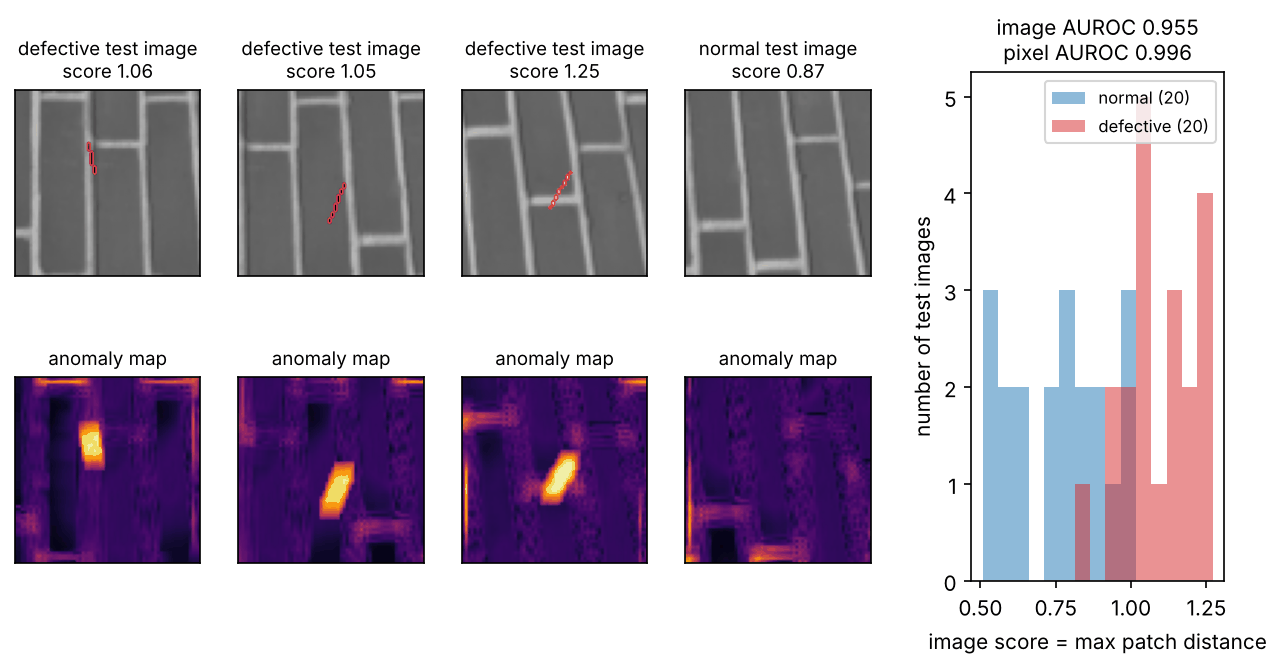
(所有數字都來自我們的玩具實驗。)像素層級的 AUROC 幾乎完美,影像層級的 AUROC 卻較低:一個影像分數是 4096 個區塊距離的最大值,所以單一個不尋常、卻是正常的區塊(記憶庫裡沒有的灰漿轉角),會把正常影像的分數拉高,程度和真正的瑕疵一樣。更多正常訓練影像會減少這類誤報;瑕疵越淡,誤報越多(練習 4)。在異常圖中,灰漿邊緣有些發亮:它們是最罕見的正常結構,這正是 PatchCore 要保留涵蓋它們的核心集,而不是隨機子樣本的原因。
OOD 與異常評估的陷阱
白話版。 OOD 的數字取決於選了哪些 OOD 資料,勝過取決於方法,而且許多已發表的 OOD 測試集有瑕疵。讀每個 OOD 結果時,都要連同它的測試集一起讀。
- 近 OOD 對遠 OOD。 OpenOOD 把 OOD 測試集分成近 OOD(與 ID 資料相似)和遠 OOD(明顯不同),並發現所有偵測器在這兩組之間的偵測表現都有很大的差距 [39]。我們的玩具實驗顯示這個標籤可能誤導:對以輸出為基礎的分數,「遠」的照片區塊比「近」的數字更難。
- 被汙染的 OOD 測試集。 Bitterwolf 等人發現,許多與 ImageNet-1K 搭配使用的 OOD 測試集,包含很大比例實際上顯示 ID 類別的影像,有些情況超過一半,這扭曲了評估;他們建立了 NINCO,一個每張影像都經過檢查、確認不含 ID 物體的 OOD 測試集 [43]。
- 預訓練重疊。 建立在以網路規模資料預訓練的模型上的偵測器,可能在預訓練時就見過「未知」類別。這樣一來,測試就不再與未知有關,必須據此描述設定。
- 門檻與模型選擇。 和任何超參數一樣,門檻與分數的選擇必須用驗證資料來定。在 OOD 測試集上(或在與它太相似的代理上)調整它們,會得到和 DomainBed 警告的「神諭式模型選擇」同樣的樂觀 [19]。
- ID 集合內的共變量偏移。 在部署中,ID 影像可能以模糊或新光線的樣子出現。OpenOOD v1.5 評估「全頻譜」(full-spectrum)偵測,其中共變量偏移的 ID 影像必須被接受,而語意 OOD 影像必須被拒絕,並發現這對目前所有方法都是重大挑戰 [39]。這裡正是本篇第一個與第三個問題交會的地方。
穩健性評估計畫
白話版。 在宣稱模型穩健之前,先寫下它對什麼穩健,用手邊最強的工具去測試,並把結果和乾淨的數字並列報告。
- 為問題命名。 偏移(哪一種?)、對手(哪個威脅模型?),還是未知的輸入(哪一種新穎性?)。如果不只一種,分別評估。
- 先建立測試資料。 至少有一組來自預期部署環境(新地點、裝置或時間)的真實偏移資料,合成損壞作為便宜的補充,以及一組確認過沒有 ID 汙染的保留 OOD 集。
- 使用強力的評估。 對抗性的主張:白箱攻擊、帶重新啟動的 PGD,以及 AutoAttack 或針對該防禦的適應性攻擊,上面提到的警訊檢查,還有確切的 與範數。對偏移:有效穩健性或相同的乾淨準確率。對 OOD:在近與遠 OOD 集上的 AUROC 與 FPR@95TPR。
- 別讓測試資料進入迴圈。 超參數、門檻與檢查點都用來自訓練分布的驗證資料來選,或清楚說明用了神諭。
- 報告取捨。 乾淨準確率、穩健準確率、校準與運算成本要一起報告;一項的進步不是免費的。
- 上線後要監控。 像 ML 11 那樣追蹤輸入統計量與信心分布,在多感測器系統中,還要追蹤 DLCV 03B 列出的感測器故障。
現代觀點
值得一讀的綜述。
- Yang、Zhou、Li 與 Liu [3](IJCV 2024)把異常偵測、新穎性偵測、開放集合辨識、OOD 偵測與離群值偵測統一為廣義 OOD 偵測的子任務,依需要偵測的是共變量或語意偏移,以及 ID 資料是一個還是多個類別來整理;接著逐一回顧各個領域,其中對 OOD 偵測方法(以分類為基礎、以密度為基礎與以距離為基礎)著墨最多。先讀它,可以釐清詞彙。
- Zhou 等人 [18](TPAMI)定義領域泛化,把它與領域適應和遷移學習連結起來,並回顧依領域對齊、元學習、資料擴增、集成學習等分組的方法,另外也涵蓋理論和視覺以外的應用。
- Liang、He 與 Tan [44](IJCV)依測試資料的形式,把測試時適應分成測試時領域適應、測試時批次適應與線上測試時適應,並為每組演算法整理分類,討論尚未解決的挑戰。
- Akhtar、Mian、Kardan 與 Shah [45](IEEE Access 2021)回顧 2018 年以來電腦視覺中的對抗攻擊與防禦:對分類器的攻擊、分類之外的攻擊、實體世界的攻擊、對抗樣本為何存在的理論,以及依模型修改、輸入修改與外部偵測器分組的防禦,認證防禦則另外處理。
- Pang、Shen、Cao 與 van den Hengel [46](ACM Computing Surveys 2021)把深度異常偵測整理成三種框架:用深度學習做通用特徵抽取、學習正常性的表示,以及端到端的異常分數學習,細分為十一個類別,並討論每一種的假設、優點與缺點。
- Liu 等人 [47](Machine Intelligence Research 2024)依網路架構、監督程度、損失函數、指標與資料集回顧工業影像異常偵測,並提出一個更貼近實際製造的設定。
它們共通的結論。 分布偏移、對抗穩健性與 OOD 偵測是各自發展的社群,有各自的基準,而這些綜述一再發現,基準的選擇、模型選擇與評估協定,對結果的影響不亞於方法本身。公平比較時,簡單的基準線(訓練得好的 ERM、MSP 或 kNN 分數、搭配 PGD 的對抗訓練)仍然很難被超越。
2023–2026 年的最新進展。 可以看到五個趨勢。(1) 基礎模型改變了起點。 大規模、多樣的預訓練,帶來了專門方法做不到的大部分自然偏移穩健性 [12], [13],而權重內插這類穩健微調嘗試保住它 [14];OOD 基準現在也納入了 CLIP 與 DINOv2 骨幹 [39]。(2) 用生成資料做對抗訓練。 在不使用外部真實資料的情況下,用現代擴散模型生成的影像訓練,在 RobustBench 的 CIFAR-10 與 CIFAR-100 上創下新的結果 [48];這些基準上的穩健準確率仍遠低於乾淨準確率。(3) 更好的 OOD 評估。 具有近與遠 OOD 切分和全頻譜設定的統一基準 [49], [39],以及清理過的測試集 [43],取代了臨時拼湊的比較。(4) 零樣本與少樣本異常偵測。 WinCLIP 使用 CLIP,搭配狀態詞的提示集成與視窗層級的特徵,在沒有或只有極少正常影像的情況下分類並分割異常 [50]。(5) 更難的工業基準。 由於 MVTec AD 上的結果已經飽和,MVTec AD 2 加入了透明與重疊的物體、不尋常的照明、正常資料的高變異、非常小的瑕疵,以及含光線變化的測試情境,並報告最先進的方法離解決它仍然很遠 [41]。
尚未解決的問題。 對任何基準都沒預料到的自然偏移保持穩健;超出小 球之外的對抗穩健性(貼片、實體改變、語意編輯),以及在基礎模型規模上的對抗穩健性;在大影像上、有用的半徑下仍然夠緊的認證;骨幹在預訓練時可能什麼都見過的情況下的 OOD 偵測;能接受共變量偏移的 ID 輸入、同時拒絕語意新穎性的偵測器;以及一套能在同一個模型上測試本篇三個問題的共通評估協定。
重點整理
- 分布轉移、對抗穩健性與 OOD 偵測,需要不同測試條件及指標。
- 比較調適與泛化前,先說明可用的目標資料。
- 對抗主張須註明威脅模型、攻擊存取方式與擾動預算。
- 強攻擊或適應性攻擊有助揭露梯度遮蔽;憑證只涵蓋其明定假設。
- 在多個近/遠 OOD 集合評估分數並檢查污染,沒有普遍最佳分數。
- 異常偵測須區分影像層級決策與定位,並驗證正常資料假設。
- 在明確協定下比較乾淨資料表現、穩健性、操作門檻與成本。
練習
- 用小批次或混合批次做測試批次正規化。 在損壞的程式碼中,改用 8 張測試影像組成的批次(而不是全部 540 張)做測試批次正規化,接著再對一個把三種損壞都以嚴重程度 3 混在一起的批次做一次。與一般模型和雜訊擴增模型相比,準確率有什麼變化?這對於把測試時適應部署在會在白天與夜間之間切換的相機上,說明了什麼?
提示
用 np.array_split(Xs, len(Xs) // 8) 把 Xs 切成區塊,每個區塊用自己的統計量正規化,再把預測串起來。在我們的執行中,嚴重程度 3 時,8 張一批保留了一部分增益(雜訊:整批 0.86,8 張一批 0.74,一般模型 0.56;模糊:0.95、0.87、0.82)。混合三種損壞的批次在這裡仍然有幫助(0.91,一般模型為 0.55),因為三種損壞都讓每個像素的統計量朝相近的方向改變(對比變低、分散變大);一般情況下別期待這樣。小批次的統計量雜訊很大,而混合了截然不同條件(白天與夜晚)的批次,其統計量對兩者都不合用,所以真正的 TTA 方法需要來自同一種條件的、夠大的批次,或是能偵測資料流發生變化並重設的辦法。
- 一個只弄壞梯度的防禦。 在對抗程式碼中加入一個「防禦」:標準模型看到每個輸入像素之前,先把它四捨五入到最近的 0.25 的倍數,並透過四捨五入重新計算輸入梯度(它幾乎處處為零)。FGSM 與 PGD 報告了什麼?接著改用 BPDA 再攻擊一次,只在反向傳遞時把四捨五入當作恆等函數。第一個結果顯示了評估一節中的哪些警訊?
提示
梯度為零時,np.sign 回傳零,PGD 就永遠不會離開它的隨機起點。在我們的執行中,「有防禦」的模型在 的這個 PGD 下保持了 0.96 的準確率,而隨機的 符號雜訊作為攻擊反而表現更好(0.93):隨機取樣勝過梯度攻擊,是警訊之一。使用 BPDA 時,用 input_grad(m, quantize(Xa), y) 作為 Xa 處的梯度。在 時,攻擊比對沒有防禦的模型弱(0.79 對 0.53),因為以 0.25 為間隔四捨五入,會抹掉小於半個間隔的擾動;在 時,BPDA 讓準確率降到 0.01,低於沒有防禦模型的 0.18。這就是 Athalye 等人所說的破碎梯度情形。
- 準確率–穩健性的取捨。 用訓練預算 訓練穩健模型,並畫出乾淨準確率對 時 PGD 準確率的圖。曲線的拐點在哪裡?如果把隱藏層從 128 個單元增加到 512 個,會有什麼變化?
提示
在我們用 128 個隱藏單元的執行中,訓練預算從 0.05 增加到 0.2 時,乾淨準確率從 0.972 降到 0.941,而 時的 PGD 準確率從 0.706 升到 0.754(在 0.1 與 0.15),然後降到 0.733:訓練預算遠大於測試預算,只會損失乾淨準確率而沒有進一步的收益。用 512 個隱藏單元時,每個預算下兩個數字都變好了(例如訓練預算 0.1 時,乾淨 0.980、穩健 0.806),符合 Madry 等人所說穩健性需要容量的發現。每種設定都要用相同的訓練輪數與相同的評估攻擊;確切數值會隨隨機種子略有不同。
- 淡的瑕疵與更多正常資料。 在磚牆程式碼中,把刮痕強度從 0.5 改成 0.35,然後再把正常訓練裁切的數量從 16 增加到 32。報告每種情況下的影像層級與像素層級 AUROC,並解釋這兩個指標的差異。
提示
在我們的執行中,強度 0.35、16 張裁切時,影像層級的 AUROC 明顯下降(約 0.70),32 張裁切時部分回復(約 0.88),而兩種情況下像素層級的 AUROC 都維持在 0.99 以上。影像層級的分數取 4096 個區塊的最大值,所以會被最罕見的正常區塊拖累;更多正常資料會把更多這類區塊放進記憶庫。像素層級的 AUROC 彙整了數百萬個像素,幾乎都是正常的,即使有少數正常區塊分數很高,也能把大多數刮痕像素排在它們之前。預期結果會隨隨機種子有些變動,因為只有 40 張測試影像。
- 選對工具。 對每個情境,說出它屬於三種穩健性問題中的哪一種、你會先跑哪一種評估、先試哪一種方法:(a) 一個皮膚病變分類器被搬到使用不同皮膚鏡的診所;(b) 使用者刻意用小幅影像編輯來繞過的內容過濾器;(c) 一個野外相機陷阱分類器,開始看到不在它標籤集裡的物種;(d) 一個沒有任何瑕疵焊接影像的焊接檢查相機。
提示
(a) 共變量(領域)偏移:從新診所收集有標註的測試集;試試正規化統計量適應,或用少數有標註的目標影像微調,並在相同的乾淨準確率下與更多樣的預訓練骨幹比較。(b) 對抗性,需要明確的威脅模型(允許哪些編輯?);用白箱與轉移攻擊評估,並試試對抗訓練;對貼片類的編輯, 穩健性不夠。(c) 語意偏移:OOD 或開放集合偵測;用保留的物種評估 AUROC 與 FPR@95TPR,在好的骨幹上使用特徵距離分數。(d) 感官異常偵測:對正常焊接建立區塊記憶庫;用之後收集到的少量真實瑕疵,在影像與像素層級評估。
參考文獻
- D. Hendrycks, K. Zhao, S. Basart, J. Steinhardt and D. Song, “Natural Adversarial Examples,” CVPR, 2021. CVF
- P. W. Koh, S. Sagawa, H. Marklund, S. M. Xie, M. Zhang, A. Balsubramani et al., “WILDS: A Benchmark of in-the-Wild Distribution Shifts,” ICML, PMLR 139, 2021. PMLR
- J. Yang, K. Zhou, Y. Li and Z. Liu, “Generalized Out-of-Distribution Detection: A Survey,” International Journal of Computer Vision, vol. 132, no. 12, pp. 5635–5662, 2024. doi · arXiv
- D. Hendrycks and T. Dietterich, “Benchmarking Neural Network Robustness to Common Corruptions and Perturbations,” ICLR, 2019. arXiv
- D. Hendrycks, S. Basart, N. Mu, S. Kadavath, F. Wang, E. Dorundo et al., “The Many Faces of Robustness: A Critical Analysis of Out-of-Distribution Generalization,” ICCV, 2021. CVF
- A. Barbu, D. Mayo, J. Alverio, W. Luo, C. Wang, D. Gutfreund, J. Tenenbaum and B. Katz, “ObjectNet: A large-scale bias-controlled dataset for pushing the limits of object recognition models,” NeurIPS, 2019. proceedings
- B. Recht, R. Roelofs, L. Schmidt and V. Shankar, “Do ImageNet Classifiers Generalize to ImageNet?,” ICML, PMLR 97, 2019. PMLR
- R. Taori, A. Dave, V. Shankar, N. Carlini, B. Recht and L. Schmidt, “Measuring Robustness to Natural Distribution Shifts in Image Classification,” NeurIPS, 2020. proceedings
- J. Miller, R. Taori, A. Raghunathan, S. Sagawa, P. W. Koh, V. Shankar, P. Liang, Y. Carmon and L. Schmidt, “Accuracy on the Line: on the Strong Correlation Between Out-of-Distribution and In-Distribution Generalization,” ICML, PMLR 139, 2021. PMLR
- D. Hendrycks, N. Mu, E. D. Cubuk, B. Zoph, J. Gilmer and B. Lakshminarayanan, “AugMix: A Simple Data Processing Method to Improve Robustness and Uncertainty,” ICLR, 2020. arXiv
- R. Geirhos, P. Rubisch, C. Michaelis, M. Bethge, F. A. Wichmann and W. Brendel, “ImageNet-trained CNNs are biased towards texture; increasing shape bias improves accuracy and robustness,” ICLR, 2019. arXiv
- A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, S. Agarwal et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML, PMLR 139, 2021. PMLR
- A. Fang, G. Ilharco, M. Wortsman, Y. Wan, V. Shankar, A. Dave and L. Schmidt, “Data Determines Distributional Robustness in Contrastive Language Image Pre-training (CLIP),” ICML, PMLR 162, 2022. PMLR
- M. Wortsman, G. Ilharco, J. W. Kim, M. Li, S. Kornblith, R. Roelofs et al., “Robust Fine-Tuning of Zero-Shot Models,” CVPR, 2022. CVF
- S. Schneider, E. Rusak, L. Eck, O. Bringmann, W. Brendel and M. Bethge, “Improving robustness against common corruptions by covariate shift adaptation,” NeurIPS, 2020. proceedings
- D. Wang, E. Shelhamer, S. Liu, B. Olshausen and T. Darrell, “Tent: Fully Test-Time Adaptation by Entropy Minimization,” ICLR, 2021. arXiv
- Y. Ganin, E. Ustinova, H. Ajakan, P. Germain, H. Larochelle, F. Laviolette, M. Marchand and V. Lempitsky, “Domain-Adversarial Training of Neural Networks,” Journal of Machine Learning Research, vol. 17, no. 59, pp. 1–35, 2016. JMLR
- K. Zhou, Z. Liu, Y. Qiao, T. Xiang and C. C. Loy, “Domain Generalization: A Survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2022. doi · arXiv
- I. Gulrajani and D. Lopez-Paz, “In Search of Lost Domain Generalization,” ICLR, 2021. arXiv
- Y. Ovadia, E. Fertig, J. Ren, Z. Nado, D. Sculley, S. Nowozin, J. V. Dillon, B. Lakshminarayanan and J. Snoek, “Can you trust your model’s uncertainty? Evaluating predictive uncertainty under dataset shift,” NeurIPS, 2019. proceedings
- C. Szegedy, W. Zaremba, I. Sutskever, J. Bruna, D. Erhan, I. Goodfellow and R. Fergus, “Intriguing properties of neural networks,” ICLR, 2014. arXiv
- I. J. Goodfellow, J. Shlens and C. Szegedy, “Explaining and Harnessing Adversarial Examples,” ICLR, 2015. arXiv
- A. Madry, A. Makelov, L. Schmidt, D. Tsipras and A. Vladu, “Towards Deep Learning Models Resistant to Adversarial Attacks,” ICLR, 2018. arXiv
- F. Croce, M. Andriushchenko, V. Sehwag, E. Debenedetti, N. Flammarion, M. Chiang, P. Mittal and M. Hein, “RobustBench: a standardized adversarial robustness benchmark,” NeurIPS Datasets and Benchmarks Track, 2021. proceedings · leaderboard
- N. Papernot, P. McDaniel, I. Goodfellow, S. Jha, Z. B. Celik and A. Swami, “Practical Black-Box Attacks against Machine Learning,” ACM Asia Conference on Computer and Communications Security (AsiaCCS), pp. 506–519, 2017. doi
- N. Carlini and D. Wagner, “Towards Evaluating the Robustness of Neural Networks,” IEEE Symposium on Security and Privacy (SP), pp. 39–57, 2017. doi
- D. Tsipras, S. Santurkar, L. Engstrom, A. Turner and A. Madry, “Robustness May Be at Odds with Accuracy,” ICLR, 2019. arXiv
- H. Zhang, Y. Yu, J. Jiao, E. P. Xing, L. El Ghaoui and M. I. Jordan, “Theoretically Principled Trade-off between Robustness and Accuracy,” ICML, PMLR 97, 2019. PMLR
- A. Athalye, N. Carlini and D. Wagner, “Obfuscated Gradients Give a False Sense of Security: Circumventing Defenses to Adversarial Examples,” ICML, PMLR 80, 2018. PMLR
- F. Croce and M. Hein, “Reliable evaluation of adversarial robustness with an ensemble of diverse parameter-free attacks,” ICML, PMLR 119, 2020. PMLR
- J. Cohen, E. Rosenfeld and J. Z. Kolter, “Certified Adversarial Robustness via Randomized Smoothing,” ICML, PMLR 97, 2019. PMLR
- K. Eykholt, I. Evtimov, E. Fernandes, B. Li, A. Rahmati, C. Xiao, A. Prakash, T. Kohno and D. Song, “Robust Physical-World Attacks on Deep Learning Visual Classification,” CVPR, 2018. CVF
- T. B. Brown, D. Mané, A. Roy, M. Abadi and J. Gilmer, “Adversarial Patch,” arXiv:1712.09665, 2017. arXiv
- D. Hendrycks and K. Gimpel, “A Baseline for Detecting Misclassified and Out-of-Distribution Examples in Neural Networks,” ICLR, 2017. arXiv
- W. Liu, X. Wang, J. D. Owens and Y. Li, “Energy-based Out-of-distribution Detection,” NeurIPS, 2020. proceedings
- K. Lee, K. Lee, H. Lee and J. Shin, “A Simple Unified Framework for Detecting Out-of-Distribution Samples and Adversarial Attacks,” NeurIPS, 2018. proceedings
- Y. Sun, Y. Ming, X. Zhu and Y. Li, “Out-of-Distribution Detection with Deep Nearest Neighbors,” ICML, PMLR 162, 2022. PMLR
- D. Hendrycks, M. Mazeika and T. Dietterich, “Deep Anomaly Detection with Outlier Exposure,” ICLR, 2019. arXiv
- J. Zhang, J. Yang, P. Wang, H. Wang, Y. Lin, H. Zhang et al., “OpenOOD v1.5: Enhanced Benchmark for Out-of-Distribution Detection,” arXiv:2306.09301, 2023. arXiv
- P. Bergmann, M. Fauser, D. Sattlegger and C. Steger, “MVTec AD — A Comprehensive Real-World Dataset for Unsupervised Anomaly Detection,” CVPR, 2019. CVF
- L. Heckler-Kram, J.-H. Neudeck, U. Scheler, R. König and C. Steger, “The MVTec AD 2 Dataset: Advanced Scenarios for Unsupervised Anomaly Detection,” International Journal of Computer Vision, vol. 134, no. 4, 2026. doi · arXiv
- K. Roth, L. Pemula, J. Zepeda, B. Schölkopf, T. Brox and P. Gehler, “Towards Total Recall in Industrial Anomaly Detection,” CVPR, 2022. CVF
- J. Bitterwolf, M. Müller and M. Hein, “In or Out? Fixing ImageNet Out-of-Distribution Detection Evaluation,” ICML, PMLR 202, 2023. PMLR
- J. Liang, R. He and T. Tan, “A Comprehensive Survey on Test-Time Adaptation Under Distribution Shifts,” International Journal of Computer Vision, vol. 133, no. 1, pp. 31–64, 2025. doi · arXiv
- N. Akhtar, A. Mian, N. Kardan and M. Shah, “Advances in Adversarial Attacks and Defenses in Computer Vision: A Survey,” IEEE Access, vol. 9, pp. 155161–155196, 2021. doi · arXiv
- G. Pang, C. Shen, L. Cao and A. van den Hengel, “Deep Learning for Anomaly Detection: A Review,” ACM Computing Surveys, vol. 54, no. 2, pp. 1–38, 2021. doi · arXiv
- J. Liu, G. Xie, J. Wang, S. Li, C. Wang, F. Zheng and Y. Jin, “Deep Industrial Image Anomaly Detection: A Survey,” Machine Intelligence Research, vol. 21, no. 1, pp. 104–135, 2024. doi · arXiv
- Z. Wang, T. Pang, C. Du, M. Lin, W. Liu and S. Yan, “Better Diffusion Models Further Improve Adversarial Training,” ICML, PMLR 202, 2023. PMLR
- J. Yang, P. Wang, D. Zou, Z. Zhou, K. Ding, W. Peng et al., “OpenOOD: Benchmarking Generalized Out-of-Distribution Detection,” NeurIPS Datasets and Benchmarks Track, 2022. proceedings
- J. Jeong, Y. Zou, T. Kim, D. Zhang, A. Ravichandran and O. Dabeer, “WinCLIP: Zero-/Few-Shot Anomaly Classification and Segmentation,” CVPR, 2023. CVF
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑這是「電腦視覺深度學習」單元的最後一篇。 回到學習地圖 →