DLCV 12A・影片生成
先備知識:DLCV 12・影像生成:從 GAN 到文字生成影像系統
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分影格品質、運動品質與時間一致性。
- 理解空間/時間壓縮及 token 預算取捨。
- 比較影像模型的時間擴充與原生影片注意力。
- 追蹤文字、影像、相機與運動條件如何作用於長影片生成。
- 以互補指標及人類研究評估整段聯合與串流模型。
先看全貌
影片生成器根據一個請求產生一小段會動的畫面:一句話(「一隻狗在日落時沿著海灘奔跑」)、一張要讓它動起來的靜態影像、一條相機路徑,或是要接續下去的一段短片開頭。結果必須每個影格都好看,動作要可信,而且東西從一個影格到下一個影格都要維持同一個東西。
為什麼重要。 影片生成用在創作工具、讓照片動起來、產生訓練資料與模擬場景,也被視為機器人與車輛可能的「世界模擬器」。它同時是最昂貴的一種視覺生成:五秒的片段包含幾十張必須彼此吻合的影像。大部分的工程都圍繞一個取捨:為了一致性,要把所有影格一起建模,但又不能讓每個影格的每個像素都和其他影格的每個像素互相作用。
本篇的位置。 影像方面的內容在別處已經講過,這裡不重複。DLCV 12 說明文字編碼器、交叉注意力、實務上的引導、控制與編輯、文字生成影像的評估與風險。ML 08 推導擴散、無分類器引導、潛在擴散、擴散 Transformer、流匹配與少步取樣器,其中的小節影片加入時間壓縮與一致性問題是簡短的預告,本篇把它展開。ML 09 涵蓋自迴歸生成與視覺 tokenizer。DLCV 13 討論以動作為條件的影片預測、大型生成式世界模型,以及逼真的影片是否代表理解物理。DLCV 09A.3 介紹光流、扭曲與時間一致性指標。這裡只談生成影片特有的部分。所有程式都只用 NumPy、SciPy 與 scikit-image,在 CPU 上數秒內執行完畢,不需要下載網路權重。
影片為什麼比影像難
白話版。 影片生成須兼顧單格品質、合理運動與身分一致性;獨立生成的好影格仍可能組成閃爍影片。
任務
下面每一種任務,都是從條件分布 取樣一支影片 ( 個影格,高 、寬 、三個色彩通道);各任務之間唯一的差別是條件 。
| 任務 | 條件 | 本篇中的例子 |
|---|---|---|
| 文字生成影片(T2V) | 一段文字提示 | Make-A-Video [1]、CogVideoX [2]、Wan [3] |
| 影像生成影片(I2V) | 第一個影格,常加上提示 | Stable Video Diffusion [4]、DynamiCrafter [5] |
| 影片延伸或預測 | 同一段片段較早的影格 | VDM [6]、Video LDM [7]、StreamingT2V [8] |
| 影格內插 | 要在中間補齊的關鍵影格 | Make-A-Video [1]、Stable Video Diffusion [4] |
| 影片編輯 | 輸入影片加上編輯要求 | Tune-A-Video [9]、Text2Video-Zero [10] |
| 受控生成 | 相機路徑或物體軌跡 | MotionCtrl [11]、CameraCtrl [12]、DragNUWA [13] |
和影像一樣(DLCV 12),同一個訓練好的模型常常能涵蓋好幾列:第一個影格、較早的影格或關鍵影格都是額外的條件,再用遮罩決定哪些影格要生成。
對每支影片的三項要求
- 逐影格品質。 每個影格單獨看都應該像一張真實的影像:清晰、沒有瑕疵、構圖良好。
- 動作品質。 片段應該會動,而且動作要合理:速度、方向與形變都要像真的。幾乎不動的片段即使每個影格都完美,仍然是失敗。
- 時間一致性。 同一個物體應該一直是同一個物體。有三種失敗各有名稱。閃爍(flicker)是亮度或細緻紋理在影格之間快速變化,而且沒有任何真實的動作可以解釋。身分漂移(identity drift)是主體的外觀(臉、標誌、襯衫上的花紋)在片段中緩慢改變。物體恆存性(object permanence)的失敗,是物體被遮住之後消失、變樣,或錯誤地重新出現。
這三項要求彼此拉扯。要消除閃爍,最容易的方法是幾乎不產生動作;要得到戲劇性的動作,最容易的方法是讓細節隨意變動。本篇後面的評估一節,必須同時檢查這三者。
成本
影片很大。一段 個影格、 像素的片段(以每秒 16 個影格計,約五秒)有 個數字,大約等於 81 張影像。生成器也不能把影格一個接一個地處理:一致性要求資訊能在相距很遠的影格之間流動。使用注意力時,讓每個位置看到其他每個位置的成本,會隨位置數量的平方增長。有兩個設計手段可以控制它:生成之前先壓縮影片(下一節),以及限制哪些位置可以注意到哪些位置(再下一節)。
壓縮影片:3D VAE 與影片 tokenizer
白話版。 影片自編碼器壓縮空間與時間以降低生成成本,其重建品質限制可恢復的細節與運動。
為什麼不直接用影像自編碼器逐影格壓縮?
最早的潛在影片模型沿用潛在影像擴散模型的自編碼器 [14],把每個影格分別編碼。Video LDM 的作者報告,這會造成閃爍,因為影像自編碼器只用影像訓練,不知道連續的影格應該要解碼得一致;他們用影片微調解碼器,加入時間層與 3D 卷積判別器,並發現這一步對好的結果至關重要 [7]。Stable Video Diffusion 同樣建立在預訓練的影像潛在模型上,只在空間上壓縮 [4]、[3]。逐影格的自編碼器也是每個影格保留一個潛在影格,所以對時間方向的成本毫無幫助。
3D 因果 VAE
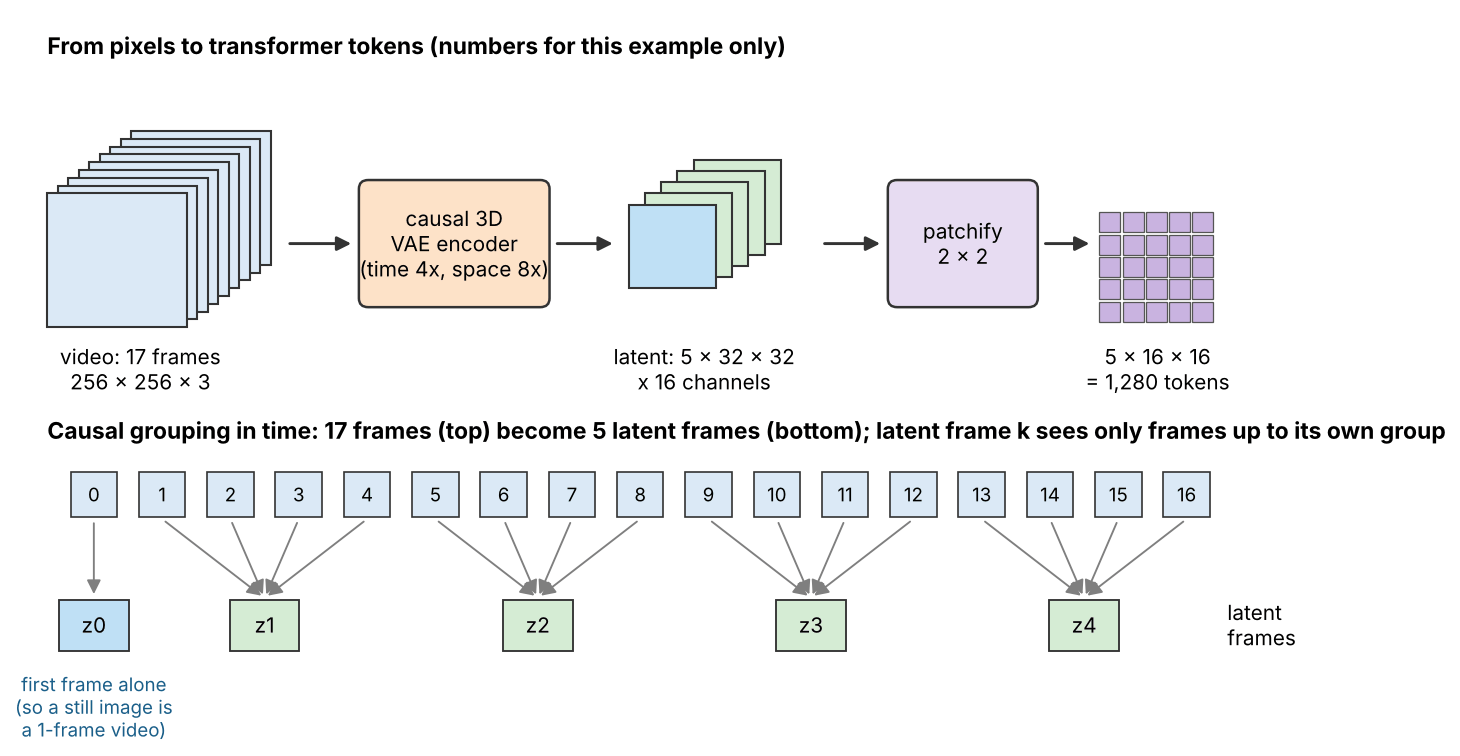
3D VAE 讓卷積同時在時間與空間上進行,因此兩個方向都能降取樣 [2]。最近的系統多半讓它在時間上具因果性:每個時間卷積只在片段開頭補零,所以一個潛在影格只依賴目前與更早的影格,絕不依賴後面的影格 [15]、[2]。一個有用的結果是,第一個影格會被單獨編碼。因此常用的影格排列是「」:第一個影格成為第一個潛在影格,之後每 個影格成為再多一個潛在影格。靜態影像就只是一支一個影格的影片,這讓同一個自編碼器、同一個生成器能同時用影像與影片訓練 [15]、[16]、[3]。
設一段片段有 個影格,尺寸為 ,在時間上壓縮 倍、在每個空間軸上壓縮 倍,並產生 個潛在通道。潛在網格與 transformer 的 token 數量為
其中 、、 分別是潛在影格數、列數與行數, 是 transformer 合成一個 token 的正方形 patch 邊長(常取 ), 是序列長度。Wan 的技術報告對它的 自編碼器與 patch,給出的正是這個數量: [3]。兩個數字可以概括一種設計:數值的壓縮率 ,以及每個 token 的像素數,約為 。由於潛在表徵的通道數多於 RGB 的 3 個,影片 VAE 對 token 的壓縮遠大於對數值的壓縮。
圖 1 示範 17 個影格的片段的計算。
已發表的系統都有記載它們的壓縮倍率。下表列出幾個(這是設計選擇的地圖,不是排名)。
| 系統 | 壓縮(時間 × 高 × 寬) | 潛在通道數 | 備註 |
|---|---|---|---|
| Stable Video Diffusion [4] | 1 × 8 × 8 | 4 | 影像自編碼器,沒有時間壓縮(倍率依 [3] 所列) |
| CogVideoX [2] | 4 × 8 × 8 | 16 | 3D 因果 VAE |
| HunyuanVideo [16] | 4 × 8 × 8 | 16 | 因果 3D VAE,輸入 個影格 |
| Wan [3] | 4 × 8 × 8 | 16 | 因果;第一個影格只在空間上壓縮 |
| Movie Gen [17] | 8 × 8 × 8 | 16 | 由影像自編碼器膨脹而來的時間自編碼器 |
| LTX-Video [18] | 8 × 32 × 32 | 128 | 整體約 1:192;沒有獨立的 patchify 步驟 |
| VideoPoet 中的 MAGVIT-v2 [19] | 128 × 128 的 17 個影格 → 5 × 16 × 16 個離散 token | 詞彙表大小 | 供語言模型使用的離散 token |
LTX-Video 用每個 token 的像素數來比較: 自編碼器再加上 patch,是每個 token 1,024 個像素,而它自己的設計是 8,192 個 [18]。進一步提高壓縮是有代價的。CogVideoX 的消融實驗發現, 的設定即使增加潛在通道數,生成器的訓練也很難收斂 [2];而 LTX-Video 則要求解碼器在像素空間中執行最後一步去雜訊,以找回強壓縮所損失的細節 [18]。
選讀:因果 3D 卷積與 1 + T 影格排列(見「補充資料」頁)。因果補零如何運作、為什麼第一個影格是獨立的,以及步幅卷積如何把 個影格對應到 個。
連續潛在表徵或離散 token
和影像模型一樣(DLCV 12),影片生成器若不是在連續的潛在網格(VAE,供擴散與流模型使用)上運作,就是在學得的 codebook 產生的離散 token(供遮罩式與自迴歸 token 模型使用)上運作。MAGVIT 提出一種 3D tokenizer,把影片量化成時空 token,供遮罩式生成使用 [20]。MAGVIT-v2 以因果 3D CNN tokenizer 和無查表量化器(lookup-free quantizer;詞彙表可以變得很大)取代了它,並且在作者的測試中,搭配它的語言模型在影像與影片基準上勝過擴散模型 [15];codebook 及其問題見 ML 09。
程式:潛在表徵大小與注意力成本
這段程式針對一段 81 個影格、 的片段,在三種自編碼器下計算潛在網格、token 數量,以及一層注意力中的查詢–鍵配對數。配對數預告了下一節的內容:「完整」是讓每個 token 注意每個 token,「分解式」則把注意力拆成每個潛在影格內的空間部分,以及每個位置上的時間部分。
程式碼 · Python · 22 行
def latent_grid(frames, height, width, ft, fs, channels=16):
    """Latent shape of a causal video VAE: the first frame alone, then groups of ft frames."""
    t = 1 + (frames - 1) // ft
    return t, height // fs, width // fs, channels

def attention_pairs(t, s):
    """Query-key pairs in one attention layer over t latent frames of s tokens each."""
    full = (t * s) ** 2                 # every token attends to every token
    factorized = t * s**2 + s * t**2    # spatial attention per frame + temporal attention per position
    return full, factorized

frames, H, W, patch = 81, 480, 832, 2   # about 5 s at 16 fps; DiT patches of 2 x 2 latent positions
pixels = frames * H * W * 3
print(f"pixel values: {pixels:,}")
for name, ft, fs, c in [("image VAE, every frame", 1, 8, 4),
                        ("video VAE 4x8x8", 4, 8, 16),
                        ("video VAE 8x16x16", 8, 16, 64)]:
    t, h, w, c = latent_grid(frames, H, W, ft, fs, c)
    s = (h // patch) * (w // patch)     # tokens per latent frame after patchify
    full, fact = attention_pairs(t, s)
    print(f"{name:23s} latent {t}x{h}x{w}x{c} ({pixels / (t*h*w*c):5.1f}x fewer numbers)  "
          f"tokens {t*s:7,}  full {full:.1e}  factorized {fact:.1e}  ratio {full/fact:4.0f}")
輸出:
程式碼 · 4 行
pixel values: 97,044,480
image VAE, every frame  latent 81x60x104x4 ( 48.0x fewer numbers)  tokens 126,360  full 1.6e+10  factorized 2.1e+08  ratio   77
video VAE 4x8x8         latent 21x60x104x16 ( 46.3x fewer numbers)  tokens  32,760  full 1.1e+09  factorized 5.2e+07  ratio   21
video VAE 8x16x16       latent 11x30x52x64 ( 88.4x fewer numbers)  tokens   4,290  full 1.8e+07  factorized 1.7e+06  ratio   11
(所有數字都是我們自己的算術結果;帶有 64 個通道的 那一列是假設的設定,不是某個特定模型。)有三點心得。第一, 影片 VAE 保留的數值數量和逐影格影像 VAE 差不多,但它把 token 減少為四分之一、把注意力配對數減少為十六分之一,因為每個潛在位置帶有更多通道。第二,32,760 個 token 與 Wan 針對這個片段大小的公式相符。第三,對 32,760 個 token 做完整注意力,每層大約有 個查詢–鍵配對,這就是為什麼完整注意力與分解式注意力的選擇,加上壓縮倍率,決定了一個模型負擔得起什麼。
架構:從膨脹的影像模型到影片 Transformer
白話版。 一條路線為影像模型加入時間層,另一條訓練影片 Transformer;兩者都須決定資訊如何跨越時空。
膨脹預訓練的影像模型
想法是重用影像模型已經知道的外觀知識,只學習動作。Video Diffusion Models(VDM)把影像擴散 U-Net 變成在空間與時間上分解的 3D U-Net:每個 卷積變成對每個影格分別作用的 卷積,每個空間注意力區塊仍在影格內做注意力,其後再加一個新的時間注意力區塊,在每個空間位置上對各影格做注意力 [6]。由於時間注意力可以關掉,同一個網路可以同時用單張影像與影片訓練,作者發現這種聯合訓練對樣本品質很重要 [6]。
後來的系統保留預訓練的影像層,並插入初始化為什麼都不做的新時間層,讓膨脹後的模型一開始與影像模型完全相同。令 為某個區塊的特徵,並重新排列成把各影格當作一批影像。膨脹後的區塊計算
其中 在每個空間位置上沿影格軸做注意力, 是權重從零開始的線性投影,因此訓練一開始 (與 DLCV 12 中 ControlNet 的零卷積是同一個想法)。訓練再把模型從「一批各自獨立的影像」逐步推向「一支影片」。Make-A-Video [1]、Video LDM [7]、AnimateDiff [21] 與 Open-Sora [22] 都用了這個想法的某個版本:恆等初始化的層、學得的混合權重,或零初始化的投影。Make-A-Video 也展示了好處:它從影像–文字配對學習外觀及其與文字的連結,只從無標註的影片學習動作,因此不需要成對的文字–影片資料 [1]。
選讀:從影像模型起步的四種方式(見「補充資料」頁)。Make-A-Video、Video LDM、AnimateDiff 與 Open-Sora 各自凍結了什麼、加入了什麼、怎麼初始化。
分解式或完整時空注意力
白話版。 一個 token 可以看到片段中其他每個 token(完整注意力),也可以先看自己所在影格的 token,再看其他影格中同一個位置的 token(分解式注意力)。分解式注意力便宜得多;完整注意力則能追蹤在影格之間移動很遠的物體。
設一段片段有 個潛在影格,每個影格 個 token,總共 個 token。一層完整注意力比較 個查詢–鍵配對。分解式注意力在每個影格內做空間注意力( 個大小為 的問題,所以是 個配對),並在每個位置做時間注意力( 個大小為 的問題,所以是 個配對)。比值為
當 時它接近 ,就像上面的程式那樣(21 個潛在影格時比值為 21)。分解式的樣式來自影片理解:TimeSformer 比較了幾種自注意力方案,發現「分離式」(divided)時空注意力在它試過的方案中,對影片分類最好 [23],ViViT 則提出了幾種把空間與時間維度分解的變體 [24]。Latte 在潛在影片擴散 transformer 內比較了四種這類分解方式(交錯的空間與時間區塊、後段融合,以及在區塊內拆分注意力的兩種方式),發現交錯的空間與時間 transformer 區塊在它的實驗中表現最好 [25]。
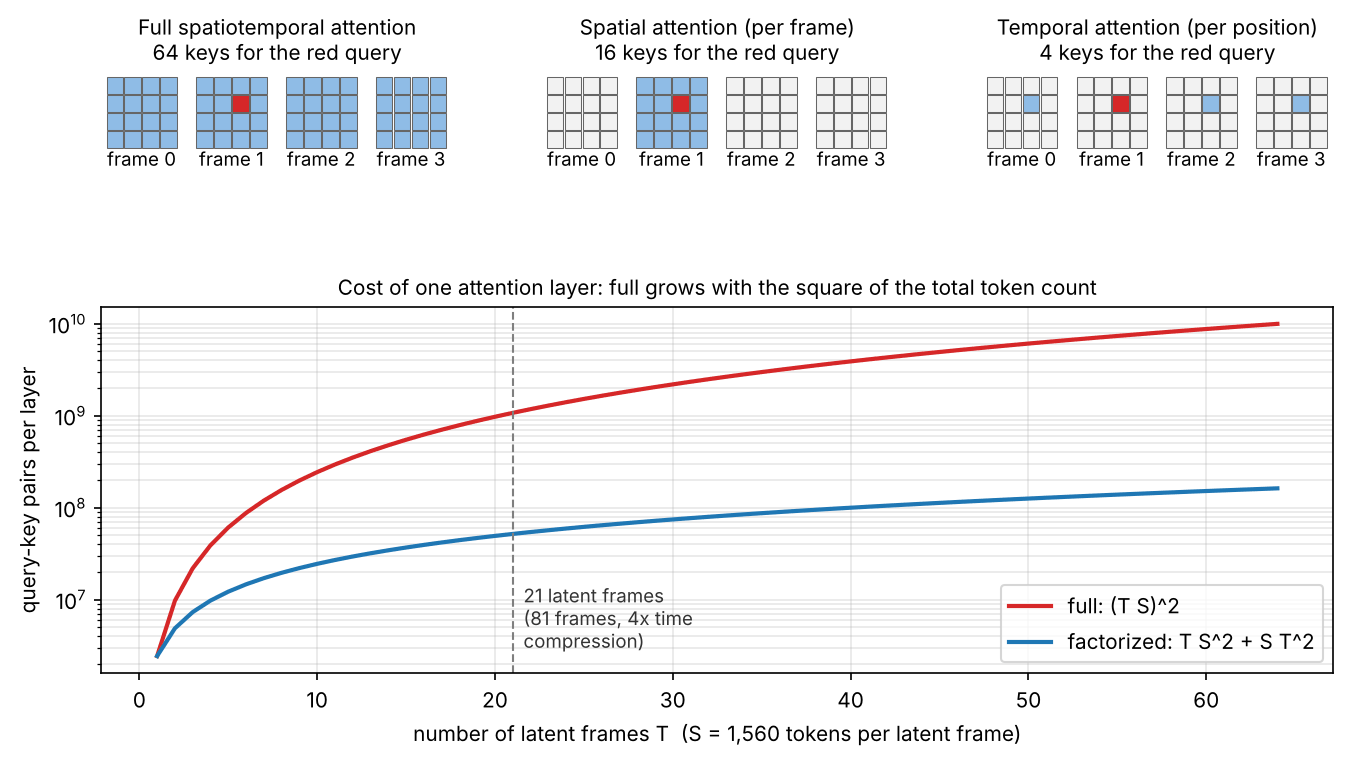
支持完整注意力的理由與動作有關。CogVideoX 主張,在空間與時間注意力分開時,一個在相鄰影格之間移動很遠的物體,無法直接注意到下一個影格中的它自己;資訊必須間接地經過其他 patch,這使得大幅度動作的一致性很難學;因此它對文字與影片 token 一起使用完整的 3D 注意力 [2]。HunyuanVideo 選擇完整注意力,理由是結果比分離式注意力更好、影像與影片可以用同一種設計,並且能重用為語言模型開發的加速方法 [16]。Wan 同樣使用完整時空注意力 [3];Open-Sora Plan 從分解式的「2+1D」去雜訊器改成 3D 完整注意力,並加入更便宜的稀疏注意力運算 [26];LTX-Video 使用極高的壓縮,正是為了讓完整注意力維持在負擔得起的範圍 [18]。實用的準則是:token 數量允許時,優先採用完整注意力,而自編碼器的設計目標,就是讓 token 數量允許這麼做。
級聯,還是整支影片用同一個模型
級聯(cascade)先生成一段短、小、低影格率的影片,再用另外的模型改善它。Imagen Video 使用七個子模型(一個基礎模型、三個空間超解析度模型和三個時間超解析度模型),得到 128 個影格、、每秒 24 個影格、約 5.3 秒的影片 [27]。Make-A-Video 結合一個基礎模型、一個影格內插網路和兩個超解析度模型 [1];Video LDM 先生成稀疏的關鍵影格,再用內插模型補齊影格 [7]。級聯讓每個階段都保持小巧,但基礎階段只用少數影格就決定了整體動作。Lumiere 主張,先生成相距很遠的關鍵影格再內插,會讓整體的時間一致性變得困難,因此它提出時空 U-Net(Space-Time U-Net),在時間與空間上都做降取樣與上取樣,一次就生成完整影格率的片段 [28]。帶有時間壓縮的大型潛在 transformer 走的是同樣的單階段路線;Movie Gen 指出,它的 時間壓縮讓它不必再使用早期工作中的影格內插模型 [17]。
代表性系統地圖
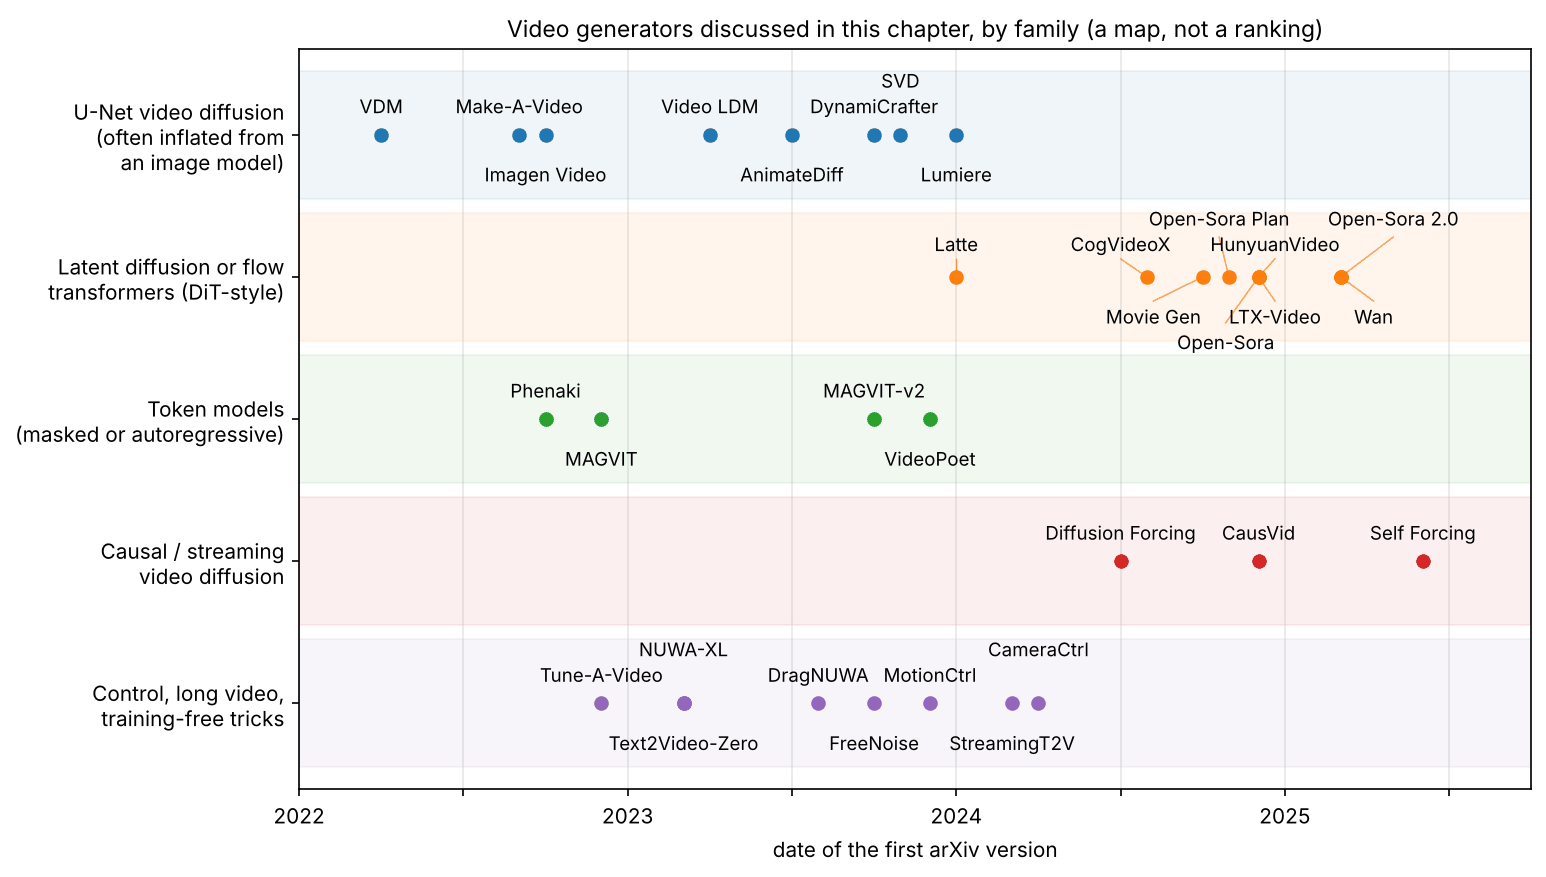
下表列出設計已記載於論文或技術報告的系統。這是設計選擇的地圖,不是排名;圖 3 則把它們放在時間軸上。
| 系統 | 生成器與骨幹 | 在哪裡生成 | 備註 |
|---|---|---|---|
| VDM [6] | 擴散,分解式 3D U-Net | 像素 | 影像與影片聯合訓練 |
| Make-A-Video [1] | 擴散,膨脹的 U-Net,級聯 | 像素 | 不需成對的文字–影片資料 |
| Imagen Video [27] | 擴散,七個模型的級聯 | 像素 | 空間與時間超解析度 |
| Video LDM [7] | 擴散,凍結的影像 LDM 加時間層 | 影像自編碼器的潛在空間 | 微調過的時間解碼器 |
| Stable Video Diffusion [4] | 擴散,膨脹的潛在 U-Net | 影像自編碼器的潛在空間 | 搭配資料篩選的分階段訓練 |
| Lumiere [28] | 擴散,時空 U-Net | 像素 | 整支影片一次生成 |
| Latte [25] | 擴散 transformer,分解式 | 潛在空間 | 比較四種分解方式 |
| CogVideoX [2] | 擴散 transformer,完整 3D 注意力 | 3D 因果 VAE 的潛在空間 | 文字與影片 token 串接 |
| Open-Sora [22] | 擴散 transformer,分解式(STDiT) | 3D 自編碼器的潛在空間 | 完全開放的訓練程式碼與權重 |
| Open-Sora Plan [26] | 擴散 transformer,3D 注意力與較便宜的稀疏變體(Skiparse) | wavelet-flow VAE 的潛在空間 | 附資料管線的開源專案 |
| HunyuanVideo [16] | 流匹配 transformer,完整注意力 | 因果 3D VAE 的潛在空間 | 超過 130 億個參數 |
| Movie Gen [17] | 流匹配 transformer | 時間自編碼器的潛在空間 | 300 億個參數,同步音訊 |
| Wan [3] | 流匹配擴散 transformer,完整注意力 | 因果 3D VAE 的潛在空間 | 1.3B 與 14B 兩種模型 |
| LTX-Video [18] | 潛在擴散 transformer,完整注意力 | 高度壓縮的潛在空間 | 解碼器負責最後一步去雜訊 |
| MAGVIT [20]、VideoPoet [19] | 遮罩式或自迴歸 token transformer | 離散 token | 見自迴歸生成一節 |
流匹配與擴散 transformer 在 ML 08 與 ML 08,擴散 Transformer 推導 [29]、[30]。上表的參數量是論文中所陳述的數字。
條件:文字生成影片與影像生成影片
白話版。 提示進入影片模型的方式,和進入影像模型一樣,都是對文字編碼器的輸出做注意力。影像生成影片中的第一個影格,則以額外輸入的方式進入,每個生成的影格都看得到它。和影像的差別在於,條件必須對整支片段都成立,而且「動多少」本身就是要控制的東西。
文字生成影片
文字編碼器、交叉注意力與文字–影像聯合注意力的說明見 DLCV 12。影片系統使用同樣的機制。Wan 用從影片 token 到文字編碼器輸出的交叉注意力嵌入文字 [3]。CogVideoX 把文字與影片 token 串接成一個序列,並使用專家式自適應 LayerNorm(expert adaptive LayerNorm)對兩種模態分別調變,因為它們的特徵空間與數值尺度不同 [2]。HunyuanVideo 先在分開的串流中處理影片與文字 token,再串接起來做聯合處理(「雙串流到單串流」),並以多模態語言模型作為主要的文字編碼器 [16]。文字描述必須講出動作與事件,不能只講外觀(見「資料」一節)。
Make-A-Video 還把影格率輸入給模型,既作為資料增強,也作為動作速度的控制 [1]。引導的作法和影像相同(DLCV 12)。
影像生成影片
影像生成影片(「讓這張照片動起來」)必須保留輸入影格的內容,同時創造出動作。有三種已有文獻記載的設計:
- Stable Video Diffusion 把文字嵌入換成條件影格的影像嵌入(來自預訓練的影像–文字模型),並把該影格加過雜訊的副本沿通道軸串接到去雜訊器的輸入,對每個影格重複一次。作者發現固定的引導強度會造成偏離條件影格或過度飽和,因此改成讓引導強度沿影格線性增加 [4]。
- DynamiCrafter 用 query transformer 把影像投影到與文字對齊的上下文空間,讓影片模型能像注意提示一樣注意它,同時也把完整影像與初始雜訊串接,以保留視覺細節 [5]。
- HunyuanVideo 直接把參考影像的潛在表徵當作第一個潛在影格 [16],當因果 VAE 把第一個影格單獨編碼時,這是很自然的選擇。
影像生成影片常見的失敗是動作太少:模型只要幾乎不改變輸入,就能在對輸入的保真度上得到高分。StreamingT2V 報告,當競爭的影像生成影片模型被反覆用來延伸片段時,容易出現「影片停滯」(video stagnation)[8]。
相機與運動控制
白話版。 用「相機緩緩繞著雕像轉」這樣的提示來描述動作,是很弱的方式。控制方法直接把動作交給生成器:一條相機路徑(每個影格相機在哪裡),或是軌跡(物體或被拖曳的點該往哪裡去)。難處在於遵從動作,卻不改變內容。
- 把相機運動做成小型轉接器。 Stable Video Diffusion 在基礎模型上,另外訓練了水平移動、變焦與固定相機的相機運動 LoRA 模組 [4];AnimateDiff 的 MotionLoRA 則以很低的成本,把它的運動模組調整到新的運動樣式,例如不同的鏡頭類型 [21]。
- 把相機位姿當作稠密輸入。 CameraCtrl 在影片擴散模型之上訓練一個隨插即用的相機模組,不更動基礎模型。它不直接輸入原始的相機矩陣,而是把每個影格的相機表示成逐像素的 Plücker 嵌入(Plücker embedding),也就是通過每個像素的視線射線的 6 個數字描述,把相機幾何與影像位置連結起來;作者發現,用相機路徑多樣、外觀與基礎模型資料相近的訓練影片,能在控制力與泛化之間取得最佳平衡 [12]。
- 相機與物體一起控制。 MotionCtrl 獨立控制相機運動與物體運動,把相機位姿與物體軌跡當作不攜帶外觀資訊的條件 [11]。DragNUWA 結合文字、影像與軌跡,對開放領域的影片做細粒度控制 [13]。
相機路徑就是 3D 重建所估計的那種位姿序列(DLCV 11)。遵循它並不會讓生成的場景在幾何上一致,而且控制訊號的可靠程度,只能和它訓練時所用的位姿或軌跡一樣。
選讀:相機位姿與 Plücker 嵌入(見「補充資料」頁)。每個像素的六個數字是什麼意思、平移與旋轉如何改變它們,並附一段經過測試的程式。
長影片
白話版。 模型是用幾秒鐘的短片段訓練的,因為記憶體會隨長度增加。要做出較長的影片,要嘛一段一段不斷延伸片段(容易漂移),要嘛先粗略規劃整支影片再填入細節(需要長的訓練影片)。無論哪一種,要在一分鐘之內維持劇情與身分一致,仍然很難。
有四種已有文獻記載的策略:
- 一段一段自迴歸地延伸。 生成一段片段,再以前一段的最後幾個影格為條件,生成下一段。VDM 顯示,在取樣時單純替換已知的影格,得到的延續單獨看很好,卻和先前的影格對不上,因此它提出重建引導(reconstruction guidance),把模型對條件影格的重建所產生的引導項加進去 [6]。Video LDM 訓練預測模型,透過遮罩接收幾個上下文影格 [7]。StreamingT2V 加入短期記憶(對前一段特徵的注意力)以得到平順的銜接,以及長期記憶(第一段的特徵),讓模型不會忘記最初的場景 [8]。
- 先粗後細。 NUWA-XL 用一個全域擴散模型在整個時間範圍內生成關鍵影格,再用局部擴散模型遞迴地補上它們之間的影格,因此可以直接用長影片訓練,並且平行生成各段 [31]。
- 改變雜訊,而不是模型。 FreeNoise 不需微調就能延伸預訓練的短片段模型:它重新排程一串具有長程相關性的初始雜訊,並在視窗上做時間注意力,還加入一種動作注入方法,用於隨時間變化的提示 [32]。
- 依故事生成可變長度的影片。 Phenaki 用在時間上具因果性的 tokenizer 把影片壓縮成離散 token,因此能處理可變長度,並根據一連串隨時間變化的提示生成長影片 [33]。
核心的困難是誤差累積:每一段都是以生成的、略有錯誤的影格為條件,誤差會層層疊加,就像學得的世界模型的展開(rollout)一樣(DLCV 13)。自迴歸生成一節中的因果擴散方法,則是從訓練端來處理同一個問題。
選讀:延伸影片的重建引導(見「補充資料」頁)。為什麼只替換已知影格並不夠,以及 VDM 加上的修正項。
時間一致性
白話版。 一致的影片會讓每個細節都附著在它所屬的東西上:狗移動時,牠的斑點跟著移動;相機平移時,牆面的紋理跟著滑過。最簡單的測試是把動作還原,再檢查其他東西是否有變。陷阱在於,完全不動的影片會完美地通過這個測試。
不一致從哪裡來
生成器會創造條件沒有指定的細節。如果這些創造出來的細節在每個影格都重新畫一次,就會閃爍。如果它們固定在螢幕上而不是固定在物體上,就會在場景於其下移動時「黏住」。一致性意味著創造出來的細節必須沿著動作傳遞。架構靠時間層與所有影格的聯合生成來做到這一點;有幾種免訓練方法則在預訓練的影像模型中強制做到。Text2Video-Zero 讓每個影格的自注意力都去注意第一個影格(跨影格注意力),以保留前景物體的外觀與身分,並在潛在碼中加入動態以維持背景的一致 [10]。Make-A-Video 在最後逐影格的超解析度階段,對每個影格使用相同的雜訊初始化,以促成各影格之間創造出來的細節一致 [1]。Tune-A-Video 在影像模型中加入時空注意力機制,並在單一影片上微調它 [9]。
衡量一致性
常見的衡量有三種,每一種都只用生成影片本身就能算出的量來定義:
- 影格差異 ,其中 是第 個影格, 是每個影格的像素數值個數。它很便宜,但把真實動作與閃爍混在一起;VBench 只在靜態場景(所有變化都是閃爍)上用這種方式衡量時間閃爍 [34]。
- 扭曲誤差 ,其中 是從影格 到影格 的動作(光流), 沿著它扭曲前一個影格。它在比較之前先扣除真實動作;光流、扭曲及其遮罩形式見 DLCV 09A.3。對生成的影片而言,光流必須從影片本身估計。
- 隨時間的特徵相似度。 VBench 的主體一致性,把每個影格的特徵和第一個與前一個影格的特徵比較,,其中 是影格 由自監督影像模型得到的單位長度特徵向量, 是內積(餘弦相似度)[34]。
這三種都會獎勵靜止的影片。因此 VBench 把它們與動態程度(dynamic degree)這個維度搭配,用光流網路衡量動作的多寡 [34]。
程式:閃爍、黏滯與凍結
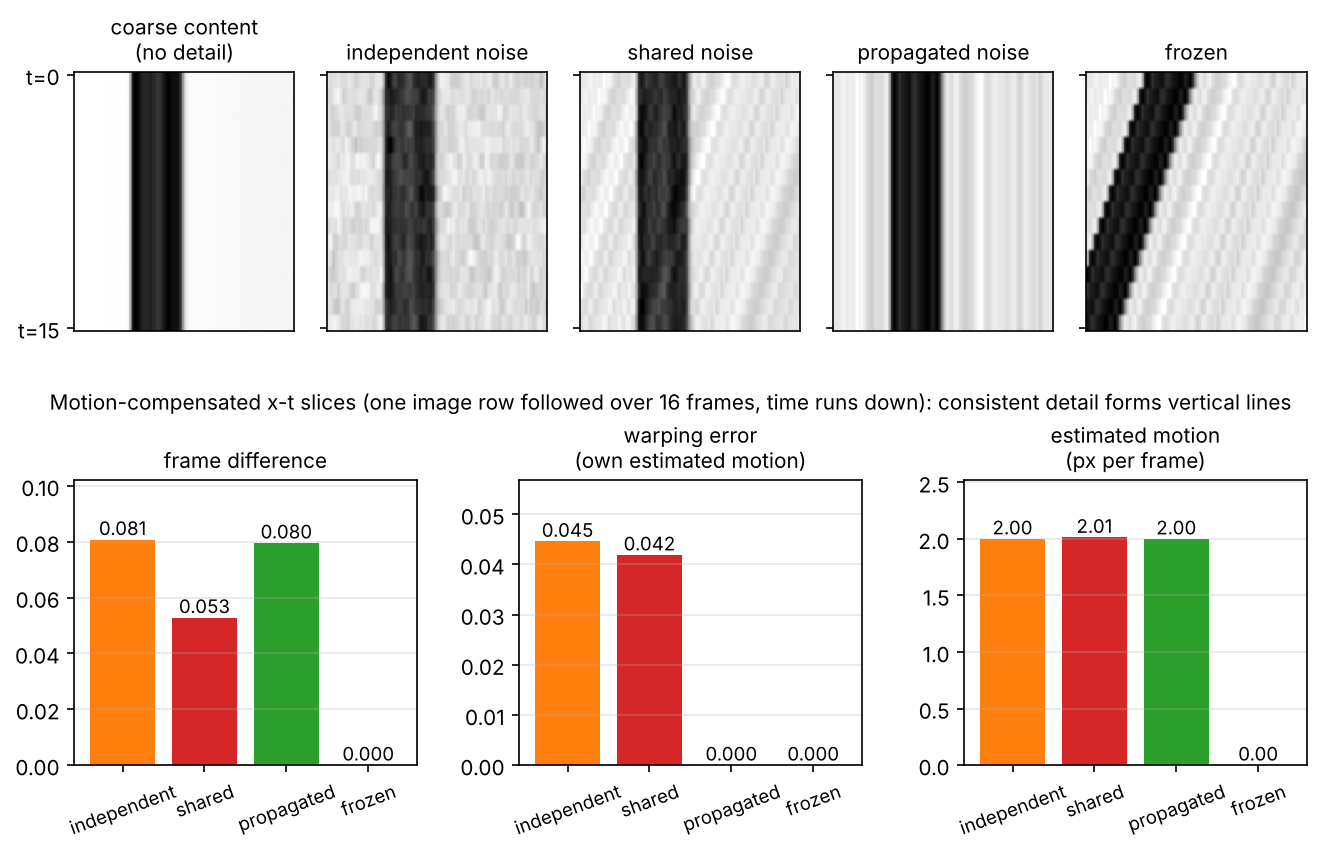
這個玩具實驗建立一支「粗略影片」,讓影像每個影格平移 2 個像素(就像提示可能要求的那樣),再用四種方式加入創造出來的細緻細節:每個影格都用新的雜訊、固定在螢幕上的同一份雜訊、隨場景一起移動的同一份雜訊,以及重複第一個影格的凍結影片。它用相位相關估計每支影片自己的動作,並回報這三個量。
程式碼 · Python · 33 行
import numpy as np
from scipy import ndimage as ndi
from skimage import data, transform
from skimage.registration import phase_cross_correlation

rng = np.random.default_rng(0)
T, v = 16, 2                                   # 16 frames; the prompt asks for a pan of 2 px per frame
scene = transform.resize(data.camera() / 255.0, (128, 128), anti_aliasing=True)
content = np.stack([np.roll(scene, v * t, axis=1) for t in range(T)])   # the "coarse" video

def detail():                                  # invented fine texture, as a generator would add
    n = ndi.gaussian_filter(rng.standard_normal(scene.shape), 0.7)
    return 0.04 * n / n.std()

d0 = detail()
videos = {
    "independent noise": content + np.stack([detail() for _ in range(T)]),  # new detail every frame
    "shared noise":      content + d0,                                       # same detail, fixed on screen
    "propagated noise":  content + np.stack([np.roll(d0, v * t, axis=1) for t in range(T)]),  # detail moves with the scene
}
videos["frozen"] = np.repeat(videos["propagated noise"][:1], T, axis=0)      # a still image repeated

c = (slice(None), slice(8, -8), slice(8, -8))  # ignore borders (np.roll wraps around)
def measure(vid):
    shifts = [phase_cross_correlation(a, b, upsample_factor=10)[0][1] for a, b in zip(vid[1:], vid[:-1])]
    flicker = np.abs(np.diff(vid, axis=0))[c].mean()                         # frame-difference energy
    warped = np.stack([np.roll(f, int(round(s)), axis=1) for f, s in zip(vid[:-1], shifts)])
    warp_err = np.abs(vid[1:] - warped)[c].mean()                            # error after the video's own motion
    return flicker, warp_err, np.mean(np.abs(shifts))

for name, vid in videos.items():
    f, w, m = measure(vid)
    print(f"{name:18s} frame difference {f:.4f}   warping error {w:.4f}   estimated motion {m:.2f} px/frame")
輸出:
程式碼 · 4 行
independent noise  frame difference 0.0808   warping error 0.0446   estimated motion 2.00 px/frame
shared noise       frame difference 0.0528   warping error 0.0419   estimated motion 2.01 px/frame
propagated noise   frame difference 0.0796   warping error 0.0000   estimated motion 2.00 px/frame
frozen             frame difference 0.0000   warping error 0.0000   estimated motion 0.00 px/frame
(所有數字都來自我們的玩具實驗。)把這四行放在一起讀:
- 只看影格差異會誤導。 它把固定在螢幕上的雜訊(0.0528)判定為比正確的、隨場景傳遞的細節(0.0796)更穩定,因為傳遞的細節會移動;它還給凍結的影片一個完美的零。
- 扭曲誤差能區分會動的幾種情況。 還原估計出的動作之後,只有隨場景傳遞的細節不留下任何殘差;每個影格都換新的雜訊,以及固定在螢幕上的雜訊,兩者的殘差仍然看得見。
- 還需要一個動作的衡量。 凍結的影片扭曲誤差同樣是零。只有估計出的動作(0.00,而不是要求的每影格 2 個像素)能揭露它,這正是 VBench 動態程度的作用。
圖 4 以經過動作補償的 x–t 切片顯示同樣的效果:正確、隨場景傳遞的細節會形成筆直的垂直線。
自迴歸與擴散影片生成
白話版。 產生一段片段有兩種方式。擴散(或流)模型把固定長度片段的所有影格放在一起,從雜訊精修成影片,所以每個影格既看得到過去,也看得到未來。自迴歸模型則一段一段地寫出影片,每一段都以先前的內容為條件,就像語言模型寫文字;它可以無限寫下去,也能串流,但早期的錯誤會留下來。最近的混合式做法試圖兩者兼得。
token 模型:遮罩式與自迴歸
有了離散的影片 tokenizer,影片生成就變成序列建模(ML 09)。MAGVIT 使用遮罩 token 建模,平行預測許多 token,並以單一模型支援許多生成任務(例如影格預測、內插與修補)[20]。Phenaki 用以文字為條件的雙向遮罩 transformer 生成它的因果影片 token [33]。VideoPoet 是處理文字、影像、影片與音訊 token 的 decoder-only transformer;MAGVIT-v2 把每秒 8 個影格、 的 17 個影格轉成 的網格,也就是 1,280 個 token,詞彙表大小為 ,而模型像語言模型一樣訓練,先在多種生成任務的混合上預訓練,再針對特定任務調適 [19]。token 模型重用語言模型的基礎設施(KV 快取,見 ML 09),並且能自然地延伸片段,但每個生成的 token 都是一個承諾,誤差會累積(ML 09)。
擴散:整段影片一次生成
標準的影片擴散 transformer 以雙向注意力,一起對所有潛在影格去雜訊。CausVid 直白地說出其後果:生成單一影格就必須處理整個序列,包括未來,這讓這類模型很難用於互動場合 [35]。它們的長處就是讓擴散在影像領域稱霸的那些(訓練穩定、品質高、可引導),再加上片段內的整體一致性。它們的限制是最大長度固定,且延遲高。
混合式:因果、可串流的擴散
- Diffusion Forcing 訓練擴散模型對一串 token 去雜訊,每個 token 有獨立的雜訊程度,並把它當作因果的下一個 token 模型,在不把過去完全擴散完的情況下生成未來的影格;這讓它可以把影片展開到超過訓練視野的長度,而它的基線在那裡會發散 [36]。
- CausVid 把預訓練的雙向影片擴散 transformer 調整成因果、自迴歸的版本,即時逐影格生成,並以雙向教師監督因果學生,把它的 50 步取樣器蒸餾成 4 步,同時使用 KV 快取做串流生成;作者報告這能減輕誤差累積,並讓模型儘管只用短片段訓練,仍能產生長影片 [35]。
- Self Forcing 直接處理曝光偏差:訓練時,每個影格都以模型自己先前的輸出為條件來生成(以 KV 快取做自迴歸展開),而不是以真實影格為條件,並對整段生成的影片施加損失;它報告在單張 GPU 上達到延遲不到一秒的即時串流生成 [37]。
| 面向 | 自迴歸或因果 | 雙向擴散 |
|---|---|---|
| 長度 | 無上限,一段一段生成 | 由訓練片段長度決定,除非另外延伸 |
| 延遲 | 最前面的影格很早就可取得,可串流 | 必須先對整段片段去雜訊 |
| 未來資訊 | 沒有(因果) | 每個影格都看得到過去與未來 |
| 主要風險 | 誤差累積、曝光偏差 | 長片段的記憶體與計算量 |
| 典型用途 | 互動式生成、世界模型、直播影片 | 離線的文字生成影片與影像生成影片 |
同樣的因果與雙向的區別,對世界模型也很重要,因為動作是一步一步到來的(DLCV 13)。也請記得 ML 08 講過的:因果自編碼器並不會讓生成器變成自迴歸;那是由生成器的注意力與取樣方式決定的。
評估影片生成模型
白話版。 你需要四方面的證據:影片整體看起來像真的影片(FVD 這類分布指標)、它們符合提示、它們的動作與一致性良好(VBench 這類逐維度的套件),以及人們比較喜歡它們(人類研究)。結果發現,標準的分布指標主要看的是單一影格,所以可能恰好漏掉本篇關心的時間問題。
Fréchet Video Distance
FVD 把 FID(ML 08)延伸到影片 [38]。每支影片(真實的或生成的)都通過一個預訓練的影片網路,也就是在 Kinetics-400 [40] 上訓練的 I3D 動作辨識模型 [39],並取它的輸出(logits)作為特徵向量。對每一組特徵擬合一個 Gaussian,然後
其中 是真實影片特徵的平均與共變異數, 是生成影片的, 是跡(trace), 是矩陣平方根。越低越好。原始論文引入 FVD 時附了一項人類研究,顯示它與人們對生成影片的判斷有良好的相關性 [38]。類別條件與無條件的基準常在 UCF-101(一個包含 101 個人類動作類別的資料集)上報告 FVD [41]、[1]、[25]。
它的主要限制:內容偏差。 Ge 等人發現,在逐影格品質相同的情況下,FVD 在大幅度的時間破壞下只上升一點點,而且精心挑選的一組沒有動作的生成影片子集,可以讓 FVD 大幅下降 [42]。他們把偏差追溯到特徵:在 Kinetics 上訓練的動作分類器學到的是物體與場景的外觀,因為許多動作只看一個影格就能辨認;來自自監督影片模型 VideoMAE v2 [43] 的特徵,偏差就小得多 [42]。FID 的各種陷阱同樣適用(DLCV 12),此外還有影片特有的陷阱:片段長度、影格率,以及縮放到低解析度的正方形 [42]。
選讀:Ge 等人,「On the Content Bias in Fréchet Video Distance」(見「論文導讀」頁)。這篇論文如何把影格品質與動作品質分開,以及如何閱讀它的敏感度圖。
程式:看不見時間的 Fréchet 距離
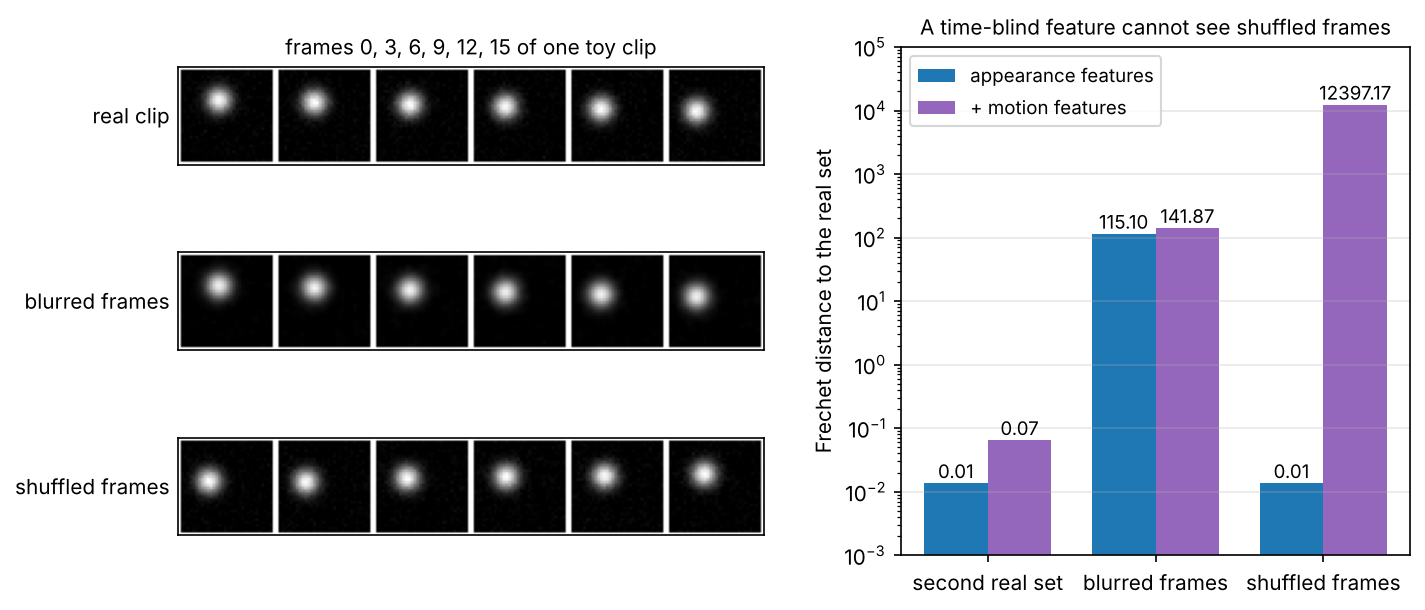
這個玩具實驗製作「真實」片段(一個沿直線移動的光斑),以及兩組被破壞的片段:一組是模糊的影格(影格較差,動作正確),另一組是打亂的影格(影格完美,動作被破壞)。它用兩個手工製作的特徵萃取器計算 Fréchet 距離:一個把每個影格的外觀統計量沿時間平均,就像主要只看內容的萃取器;另一個再加上兩個時間統計量。
程式碼 · Python · 45 行
import numpy as np
from scipy import linalg, ndimage as ndi

rng = np.random.default_rng(0)
T, S = 16, 32
yy, xx = np.mgrid[:S, :S]

def real_videos(n):
    """Toy 'real' clips: a bright blob moving in a straight line, plus mild sensor noise."""
    vids = np.empty((n, T, S, S))
    for i in range(n):
        p, vel, r = rng.uniform(10, 22, 2), rng.uniform(-0.7, 0.7, 2), rng.uniform(2.5, 4)
        for t in range(T):
            cy, cx = p + vel * t
            vids[i, t] = np.exp(-((yy - cy) ** 2 + (xx - cx) ** 2) / (2 * r**2))
    return vids + 0.02 * rng.standard_normal(vids.shape)

def frame_stats(f):                      # appearance of one frame
    gy, gx = np.gradient(f)
    return [f.mean(), f.std(), f.max(), np.abs(gx).mean() + np.abs(gy).mean()]

def appearance_features(v):              # frame statistics averaged over time: blind to frame order
    return np.mean([frame_stats(f) for f in v], axis=0)

def motion_features(v):                  # add how the content changes from frame to frame
    d = np.abs(np.diff(v, axis=0)).mean(axis=(1, 2))
    return np.concatenate([appearance_features(v), [d.mean(), d.std()]])

def frechet(a, b):                       # Fréchet distance between Gaussian fits of two feature sets
    mu1, mu2 = a.mean(0), b.mean(0)
    s1, s2 = np.cov(a, rowvar=False), np.cov(b, rowvar=False)
    covmean = linalg.sqrtm(s1 @ s2).real
    return float(((mu1 - mu2) ** 2).sum() + np.trace(s1 + s2 - 2 * covmean))

real, other_real = real_videos(400), real_videos(400)
blurred = ndi.gaussian_filter(other_real, sigma=(0, 0, 0.7, 0.7))          # worse frames, same motion
shuffled = np.stack([v[rng.permutation(T)] for v in other_real])          # perfect frames, broken motion

for name, feats in [("appearance features", appearance_features), ("+ motion features", motion_features)]:
    f = lambda vids: np.stack([feats(v) for v in vids])
    ref = f(real)
    scale = ref.std(0)                   # put all features on a comparable scale
    fd = {k: frechet(ref / scale, f(v) / scale) for k, v in
          [("second real set", other_real), ("blurred frames", blurred), ("shuffled frames", shuffled)]}
    print(f"{name:20s} " + "   ".join(f"{k} {d:6.2f}" for k, d in fd.items()))
輸出:
程式碼 · 2 行
appearance features  second real set   0.01   blurred frames 115.10   shuffled frames   0.01
+ motion features    second real set   0.07   blurred frames 141.87   shuffled frames 12397.17
(所有數字都來自我們的玩具實驗,使用的是玩具特徵,不是 I3D。)只用外觀特徵時,動作被破壞的打亂組,和第二組真實影片一樣接近真實組(0.01),而輕微的模糊卻被重重處罰。加入兩個時間統計量之後,打亂組變成遠遠最差的一組。真正的 FVD 沒有這麼極端,因為 I3D 確實看得到一些動作,但這正是 Ge 等人所測量的內容偏差的形狀 [42]:這個指標有多「時間性」,取決於它的特徵。圖 5 顯示這些片段與距離。
基準套件與人類評估
白話版。 現代的基準不給單一一個數字,而是問許多狹窄的問題,每個問題有自己的提示與自動檢查,並確認這些檢查和人的判斷一致。
- VBench 把「影片生成品質」拆成 16 個維度,每個維度都有量身訂做的提示與評估方法:時間品質(主體一致性、背景一致性、時間閃爍、動作平滑度、動態程度)、逐影格品質(美感與成像品質)、語意(物體類別、多個物體、人類動作、顏色、空間關係、場景)、風格(外觀風格與時間風格),以及整體一致性;它為每個維度提供人類偏好標註,用來驗證自動分數 [34]。VBench++ 把它延伸到影像生成影片(含自適應長寬比的影像套件)以及可信賴度 [44]。
- EvalCrafter 從對真實使用者資料的分析中建立 700 個提示,用 17 個客觀指標評估視覺品質、內容品質、動作品質與文字–影片對齊,並擬合係數,使合併後的分數與使用者的意見一致 [45]。
- 人類評估仍是基準。Stable Video Diffusion 用人類偏好研究來比較它的訓練選擇 [4];HunyuanVideo 報告專業人員所做的評估 [16];Movie Gen 則由專家標註者沿文字對齊、視覺品質,以及真實感與美感進行成對 A/B 測試,使用一組公開的 1,003 個提示,並報告 FVD 與 Inception Score 和它對影片品質的人類評估並不相關 [17]。Open-Sora 2.0 同時報告人類評估與 VBench 分數 [46]。
物理合理性需要自己的測試;DLCV 13 描述了一些基準,發現物理理解與視覺逼真度無關。
報告清單。 說明提示以及它們如何挑選、片段長度、影格率與解析度、樣本數與隨機種子、取樣器、步數與引導(包括跨影格的任何排程)、每個分布指標的特徵萃取器與前處理、所用的維度套件及其版本,以及人類研究的流程(成對或絕對、標註者人數、多數決規則)。報告時間衡量要搭配動作衡量與逐影格品質衡量,並且展示未經挑選的片段。
資料
白話版。 影片模型從訓練片段中學習外觀、動作與它和語言的連結。有良好文字描述的影片,比有文字描述的影像稀少得多,所以系統會結合影像與影片資料,並花費大量心力篩選片段與重新標註文字描述。
- 影像加影片。 VDM [6]、Phenaki [33] 與許多後來的系統都用影像與影片聯合訓練;Make-A-Video 只從影像–文字配對學習文字與視覺的連結 [1];因果「」自編碼器讓影像成為一個影格的影片 [16]、[3]。
- 網路影片集。 WebVid 是帶有弱文字描述的網路影片,隨 Frozen in Time 檢索模型一起提出(論文中是 WebVid-2M;依其 arXiv 紀錄,後來釋出 10M 版本)[47],Make-A-Video 就是用 WebVid-10M 訓練的 [1]。Panda-70M 整理了 380 萬個高解析度影片,把它們切成語意一致的片段,並用數個跨模態教師模型,加上一個挑選最佳文字描述的檢索模型為它們加上文字描述,得到 7,000 萬個附文字描述的片段 [48]。
- 資料篩選很重要。 Stable Video Diffusion 的 Large Video Dataset 一開始有 5.8 億個已標註的片段,內容長達 212 年,接著用光流分數移除近乎靜止的片段,用 OCR 移除含大量文字的片段,並移除美感分數低的片段;用篩選後子集訓練的模型,比用未篩選資料訓練的模型更受人們偏好 [4]。CogVideoX 則表示,它自己的影片文字描述模型是其資料管線的關鍵部分 [2]。
- 評估資料集。 UCF-101 [41] 與 Kinetics [40] 是人類動作資料集,提供 FVD 的基準,以及 FVD 的特徵網路。
選讀:Stable Video Diffusion(見「論文導讀」頁)。一篇論文如何把資料篩選與分階段訓練變成受控實驗,以及如何閱讀它的人類偏好圖。
網路影片和網路影像一樣,會引發著作權、同意與內容安全的問題;見 DLCV 12,資料。
風險與負責任的使用
白話版。 逼真的生成影片可以讓人「說出」他沒說過的話,或呈現從未發生的事件。防禦方式和影像相同,有三種(偵測偽造、標示生成內容、從源頭限制濫用),但影片更難:它每次上傳都會被重新編碼,而且幾秒鐘令人信服的畫面就足以誤導人。
- 深偽與偵測。 FaceForensics++ 是偵測臉部操弄的基準(四種操弄方法、隨機的壓縮程度與尺寸、超過 180 萬張被操弄的影像,並有不公開的測試集);其作者發現,領域專屬的知識即使在強壓縮下也能改善偵測,而且在他們的基準上,偵測器勝過人類觀察者 [49]。在某一種生成方法上訓練的偵測器,可能對較新的方法失效,所以偵測是一場軍備競賽。
- 影片浮水印。 Video Seal 聯合訓練浮水印嵌入器與萃取器,並在兩者之間施加影片編解碼器等轉換,同時沿時間傳遞浮水印,因此不必為每個高解析度影格都加上浮水印 [50]。簽章的出處資訊(provenance manifest)、不可見浮水印及其失效模式,在 DLCV 12,深偽、出處與浮水印 及其補充資料硬綁定、軟綁定與浮水印中說明;同樣的教訓也適用於影片,只是影片中重新編碼與裁切是家常便飯。
- 偏見、記憶與同意和影像一樣,源自資料(DLCV 12,風險);人物在網路影片中出現的頻率遠高於許多影像集,這讓同意問題的賭注更高。
- 虛假的權威。 看起來物理上正確的生成影片,很容易被當成證據。請把生成的片段視為插圖,而不是紀錄;為什麼逼真不等於物理正確,見 DLCV 13。
失效模式
白話版。 今天的影片生成器擅長常見場景的短片、單一鏡頭。它們在隨時間保持不變、物理、細緻的動作,以及任何較長的內容上,仍會失敗。
- 閃爍與紋理黏滯。 細節在影格之間變動,或在場景移動時維持固定(圖 4)。
- 身分漂移與變形。 臉、文字與花紋緩慢改變;兩個物體融合,或一個物體分裂。
- 物體恆存性。 物體被遮住時消失,或回來時變了樣。
- 動作太少。 近乎靜止的片段在一致性上得高分;動態程度的衡量就是因此而存在的 [34],而影像生成影片的延伸可能停滯 [8]。
- 不合理的物理與動力學。 動作看起來流暢,物理上卻是錯的(見 DLCV 13)。
- 長影片的漂移。 一段一段延伸片段時的誤差累積 [35]、[37];對最初場景的遺忘 [8]。
- 控制薄弱。 相機路徑只被粗略地遵循,軌跡改變了物體的形狀;MotionCtrl 以不含外觀資訊的動作條件為設計目標,針對的正是這一點 [11]。
- 繼承自影像的失敗。 計數、屬性綁定、文字渲染與手部,會像在影像中一樣失敗(DLCV 12,失效模式),而且現在還多了隨時間變化的可能。
如何測試。 針對每一類失敗建立小型的提示集(快速動作、遮擋、人轉身、書寫的文字、指定的相機動作),每個提示生成數個隨機種子,同時衡量一致性與動作,檢視經過動作補償的 x–t 切片以找出閃爍與黏滯,並實際觀看片段;影格拼貼會藏住大部分的時間性失敗。
現代觀點
值得閱讀的綜述。
- Melnik 等人 [51](TMLR 2024)綜述影片擴散模型:數學公式、架構選擇、時間一致性的方法、依輸入模態(文字、影像、影片、音訊)分類的應用,以及含資料集與指標的訓練與評估實務,還有長影片與計算成本等開放挑戰。
- Xing 等人 [52](2023)從三個領域回顧影片擴散模型:影片生成、影片編輯,以及其他影片理解任務,每個領域下又分更細的類別,並討論挑戰與未來趨勢。
- Liu 等人 [53](2024)依公開的技術報告與逆向工程,回顧 OpenAI 在 2024 年 2 月發表的 Sora:背景、相關技術、應用,以及安全與無偏見的生成等限制。由於它依賴逆向工程,請把其中的技術主張視為有根據的假設來讀。
歷史模型與可用服務要分開。 本篇論文用來解釋架構里程碑,不是現行採購清單。依 2026 年 11 月 5 日查核的 OpenAI 公告,Sora 網頁與 App 已於 2026 年 4 月 26 日停止服務,API 則於 2026 年 9 月 24 日停止服務 [54]。獨立的 Open-Sora 專案是不同專案。現行部署選項及鏡頭驗收重點,可參考影片生成模型選擇指南。
2023–2026 年的最新進展。 有五個趨勢特別突出。(1) 搭配完整注意力的潛在 transformer 與因果 3D VAE,成為大型開放模型的主流配方(CogVideoX [2]、HunyuanVideo [16]、Wan [3]),其中數個採用流匹配目標 [16]、[17]、[3]。(2) 開放模型報告在它們自己的人類評估與 VBench 分數上,縮小了與閉源系統的大部分差距,而訓練成本也成為研究主題:Open-Sora 2.0 報告以約 $200k 訓練出商業等級的模型 [46]。(3) 更高的壓縮減少 token,使完整注意力維持在負擔得起的範圍,由解碼器接手更多細節 [18]。(4) 因果、少步、串流的生成帶來互動與即時的使用 [35]、[37]、[36]。(5) 評估超越了 FVD,走向分維度套件 [34]、[44]、[45] 與大型人類研究 [17],並認識到需要對時間敏感的特徵 [42]。同步的音訊生成也出現了 [17]、[19]。
尚未解決的問題。 在數分鐘而非數秒的尺度上維持一致性與身分;物理正確的動力學與互動(DLCV 13);對相機、物體與時間點做精確、解耦的控制;能衡量動作與一致性、不會獎勵靜止,並且與人的判斷一致的指標;訓練與取樣長的高解析度片段的成本;對事件與動作的文字描述品質;以及經得起重新編碼的出處資訊。
重點整理
- 清晰單格不足以代表好影片,運動與身分還須跨時間一致。
- 壓縮降低生成成本,也限制可恢復的細節與時間資訊。
- 時間層、分解式注意力與完整時空注意力提供不同資訊傳遞方式及成本。
- 註明條件是文字、首格、相機姿態或運動軌跡。
- 分塊延伸與因果生成可增加輸出長度,但須處理累積誤差。
- 同時評估外觀、運動、時間一致性與偏好,並報告資料整理、時長及完整成本。
練習
- token 預算。 某個模型使用因果 VAE 與 patch。一段 121 個影格、 的片段會產生多少個 token?一層完整注意力有多少個查詢–鍵配對,分解式注意力把它減少了多少倍?下面哪一個單一改變能更有效地降低完整注意力的成本:把時間壓縮加倍,還是把 patch 大小加倍?
提示
,每個潛在影格有 個 token,所以 個 token,約有 個配對。分解式的比值為 。把 加倍得到 (配對數縮小約 3.8 倍);把 加倍則讓每個影格的 token 數除以 4(配對數縮小 16 倍),代價是空間 token 變得更粗。可以用程式中的函式檢查。
- 打破一致性衡量。 在一致性玩具實驗中,加入第五支影片:創造出來的細節每個影格平移 2 個像素,但粗略內容不移動(「靜止場景上移動的紋理」)。三種衡量各自回報什麼?你會相信哪一種能偵測出這個失敗?
提示
相位相關現在看到兩個互相競爭的動作:紋理在動,內容不動。依兩者相對強度而定,估計出的位移是 0 或 2,而沒被補償的那一層會留下扭曲誤差。對有多個移動部分的真實影片,單一的全域動作估計並不夠;實務上會使用帶有遮擋遮罩的稠密光流(DLCV 09A.3)。
- 你自己的特徵中的內容偏差。 修改 Fréchet 玩具實驗,讓「生成」組的影格正確,但光斑移動速度是真實組的兩倍。哪一個特徵萃取器能偵測出來?接著設計第三個特徵,也能偵測以正確速度移動、但在中途反向的光斑。
提示
速度改變會改變平均影格差異,所以只有動作特徵能偵測到。反向則會讓平均絕對差異保持相近;需要一個比較動作方向隨時間變化的特徵(例如質心軌跡前後兩半的相關性,或淨位移除以路徑長度)。真實的指標也面臨同樣的問題:這些特徵編碼了哪些時間性質?
- 選擇架構。 你要為商品照片建立影像生成影片模型(相機繞著物體緩慢轉動 3 秒),手上只有小型影片資料集,以及一個強大的預訓練影像模型。請在「用分解式時間層膨脹影像模型」與「從頭訓練完整注意力的影片 transformer」之間做選擇,並說明你會如何加入相機控制。
提示
影片少、影像模型強時,以零初始化或恆等初始化的時間層膨脹模型,能重用外觀知識,所需資料也較少;相機運動緩慢,分解式注意力在大幅度動作上的弱點就不那麼要緊。以照片為條件(串接的潛在表徵加上影像嵌入,如 Stable Video Diffusion),並加入使用逐像素 Plücker 嵌入的相機模組,用相機路徑多樣且已知的片段訓練。評估商品在各影格之間的身分是否保持、相機路徑的準確度,以及動態程度的衡量。
- 評估計畫。 某團隊宣稱他們的新模型有「更好的時間一致性」,理由是它的 VBench 主體一致性分數較高。請列出三種其他解釋,以及你會要求的額外證據。
提示
模型可能動得比較少(檢查動態程度與動作平滑度)、可能生成較簡單或較短的片段(檢查提示、片段長度與影格率),或逐影格品質不同而影響特徵萃取器(檢查逐影格品質)。要求提供同一個 VBench 版本的完整維度表、每個提示的未經挑選片段、在動作相當的條件下對一致性做的人類成對研究,以及用對時間敏感的特徵萃取器算出的 FVD。
參考文獻
- U. Singer, A. Polyak, T. Hayes et al., “Make-A-Video: Text-to-Video Generation without Text-Video Data,” arXiv:2209.14792, 2022. arXiv
- Z. Yang, J. Teng, W. Zheng et al., “CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer,” ICLR, 2025. arXiv
- Team Wan, A. Wang, B. Ai, B. Wen et al., “Wan: Open and Advanced Large-Scale Video Generative Models,” arXiv:2503.20314, 2025. arXiv
- A. Blattmann, T. Dockhorn, S. Kulal et al., “Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets,” arXiv:2311.15127, 2023. arXiv
- J. Xing, M. Xia, Y. Zhang et al., “DynamiCrafter: Animating Open-Domain Images with Video Diffusion Priors,” ECCV, LNCS, pp. 399–417, 2024. doi · arXiv
- J. Ho, T. Salimans, A. Gritsenko, W. Chan, M. Norouzi and D. J. Fleet, “Video Diffusion Models,” NeurIPS, 2022. proceedings · arXiv
- A. Blattmann, R. Rombach, H. Ling et al., “Align your Latents: High-Resolution Video Synthesis with Latent Diffusion Models,” CVPR, 2023. CVF
- R. Henschel, L. Khachatryan, H. Poghosyan et al., “StreamingT2V: Consistent, Dynamic, and Extendable Long Video Generation from Text,” CVPR, 2025. CVF
- J. Z. Wu, Y. Ge, X. Wang et al., “Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video Generation,” ICCV, 2023. CVF
- L. Khachatryan, A. Movsisyan, V. Tadevosyan et al., “Text2Video-Zero: Text-to-Image Diffusion Models are Zero-Shot Video Generators,” ICCV, 2023. CVF
- Z. Wang, Z. Yuan, X. Wang et al., “MotionCtrl: A Unified and Flexible Motion Controller for Video Generation,” SIGGRAPH 2024 Conference Papers, 2024. doi · arXiv
- H. He, Y. Xu, Y. Guo et al., “CameraCtrl: Enabling Camera Control for Text-to-Video Generation,” ICLR, 2025. arXiv
- S. Yin, C. Wu, J. Liang et al., “DragNUWA: Fine-grained Control in Video Generation by Integrating Text, Image, and Trajectory,” arXiv:2308.08089, 2023. arXiv
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser and B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. CVF
- L. Yu, J. Lezama, N. B. Gundavarapu et al., “Language Model Beats Diffusion — Tokenizer is Key to Visual Generation,” ICLR, 2024. arXiv
- W. Kong, Q. Tian, Z. Zhang et al., “HunyuanVideo: A Systematic Framework For Large Video Generative Models,” arXiv:2412.03603, 2024. arXiv
- A. Polyak, A. Zohar, A. Brown et al., “Movie Gen: A Cast of Media Foundation Models,” arXiv:2410.13720, 2024. arXiv
- Y. HaCohen, N. Chiprut, B. Brazowski et al., “LTX-Video: Realtime Video Latent Diffusion,” arXiv:2501.00103, 2024. arXiv
- D. Kondratyuk, L. Yu, X. Gu et al., “VideoPoet: A Large Language Model for Zero-Shot Video Generation,” ICML, PMLR 235, 2024. PMLR · arXiv
- L. Yu, Y. Cheng, K. Sohn et al., “MAGVIT: Masked Generative Video Transformer,” CVPR, 2023. CVF
- Y. Guo, C. Yang, A. Rao et al., “AnimateDiff: Animate Your Personalized Text-to-Image Diffusion Models without Specific Tuning,” ICLR, 2024. arXiv
- Z. Zheng, X. Peng, T. Yang et al., “Open-Sora: Democratizing Efficient Video Production for All,” arXiv:2412.20404, 2024. arXiv
- G. Bertasius, H. Wang and L. Torresani, “Is Space-Time Attention All You Need for Video Understanding?,” ICML, PMLR 139, 2021. PMLR
- A. Arnab, M. Dehghani, G. Heigold, C. Sun, M. Lučić and C. Schmid, “ViViT: A Video Vision Transformer,” ICCV, 2021. CVF
- X. Ma, Y. Wang, X. Chen et al., “Latte: Latent Diffusion Transformer for Video Generation,” Transactions on Machine Learning Research, 2025. arXiv
- B. Lin, Y. Ge, X. Cheng et al., “Open-Sora Plan: Open-Source Large Video Generation Model,” arXiv:2412.00131, 2024. arXiv
- J. Ho, W. Chan, C. Saharia et al., “Imagen Video: High Definition Video Generation with Diffusion Models,” arXiv:2210.02303, 2022. arXiv
- O. Bar-Tal, H. Chefer, O. Tov et al., “Lumiere: A Space-Time Diffusion Model for Video Generation,” SIGGRAPH Asia 2024 Conference Papers, 2024. doi · arXiv
- Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel and M. Le, “Flow Matching for Generative Modeling,” arXiv:2210.02747, 2022. arXiv
- W. Peebles and S. Xie, “Scalable Diffusion Models with Transformers,” ICCV, 2023. CVF
- S. Yin, C. Wu, H. Yang et al., “NUWA-XL: Diffusion over Diffusion for eXtremely Long Video Generation,” ACL, pp. 1309–1320, 2023. doi · arXiv
- H. Qiu, M. Xia, Y. Zhang et al., “FreeNoise: Tuning-Free Longer Video Diffusion via Noise Rescheduling,” ICLR, 2024. arXiv
- R. Villegas, M. Babaeizadeh, P.-J. Kindermans et al., “Phenaki: Variable Length Video Generation From Open Domain Textual Description,” arXiv:2210.02399, 2022. arXiv
- Z. Huang, Y. He, J. Yu et al., “VBench: Comprehensive Benchmark Suite for Video Generative Models,” CVPR, 2024. CVF
- T. Yin, Q. Zhang, R. Zhang et al., “From Slow Bidirectional to Fast Autoregressive Video Diffusion Models,” CVPR, 2025. CVF
- B. Chen, D. M. Monso, Y. Du, M. Simchowitz, R. Tedrake and V. Sitzmann, “Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion,” NeurIPS, 2024. proceedings · arXiv
- X. Huang, Z. Li, G. He, M. Zhou and E. Shechtman, “Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion,” NeurIPS, 2025. arXiv
- T. Unterthiner, S. van Steenkiste, K. Kurach, R. Marinier, M. Michalski and S. Gelly, “Towards Accurate Generative Models of Video: A New Metric & Challenges,” arXiv:1812.01717, 2018. arXiv
- J. Carreira and A. Zisserman, “Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset,” CVPR, 2017. CVF
- W. Kay, J. Carreira, K. Simonyan et al., “The Kinetics Human Action Video Dataset,” arXiv:1705.06950, 2017. arXiv
- K. Soomro, A. R. Zamir and M. Shah, “UCF101: A Dataset of 101 Human Actions Classes From Videos in The Wild,” technical report CRCV-TR-12-01, arXiv:1212.0402, 2012. arXiv
- S. Ge, A. Mahapatra, G. Parmar, J.-Y. Zhu and J.-B. Huang, “On the Content Bias in Fréchet Video Distance,” CVPR, 2024. CVF
- L. Wang, B. Huang, Z. Zhao et al., “VideoMAE V2: Scaling Video Masked Autoencoders With Dual Masking,” CVPR, 2023. CVF
- Z. Huang, F. Zhang, X. Xu et al., “VBench++: Comprehensive and Versatile Benchmark Suite for Video Generative Models,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 48, no. 3, pp. 3268–3285, 2026. doi · arXiv
- Y. Liu, X. Cun, X. Liu et al., “EvalCrafter: Benchmarking and Evaluating Large Video Generation Models,” CVPR, 2024. CVF
- Z. Zheng, X. Peng, Y. Lou et al., “Open-Sora 2.0: Training a Commercial-Level Video Generation Model in $200k,” arXiv:2503.09642, 2025. arXiv
- M. Bain, A. Nagrani, G. Varol and A. Zisserman, “Frozen in Time: A Joint Video and Image Encoder for End-to-End Retrieval,” ICCV, 2021. CVF · arXiv
- T.-S. Chen, A. Siarohin, W. Menapace et al., “Panda-70M: Captioning 70M Videos with Multiple Cross-Modality Teachers,” CVPR, 2024. CVF
- A. Rössler, D. Cozzolino, L. Verdoliva, C. Riess, J. Thies and M. Nießner, “FaceForensics++: Learning to Detect Manipulated Facial Images,” ICCV, 2019. doi · arXiv
- P. Fernandez, H. Elsahar, I. Z. Yalniz and A. Mourachko, “Video Seal: Open and Efficient Video Watermarking,” arXiv:2412.09492, 2024. arXiv
- A. Melnik, M. Ljubljanac, C. Lu, Q. Yan, W. Ren and H. Ritter, “Video Diffusion Models: A Survey,” Transactions on Machine Learning Research, 2024. arXiv
- Z. Xing, Q. Feng, H. Chen et al., “A Survey on Video Diffusion Models,” arXiv:2310.10647, 2023. arXiv
- Y. Liu, K. Zhang, Y. Li et al., “Sora: A Review on Background, Technology, Limitations, and Opportunities of Large Vision Models,” arXiv:2402.17177, 2024. arXiv
- OpenAI, “What to know about the Sora discontinuation,” official service notice, 2026, accessed 5 November 2026. Notice.
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 12B・單步生成 · 18 分鐘