DLCV 11・三維重建:從多視角幾何到 NeRF 與 Gaussian Splatting
先備知識:IP 12・特徵擷取、DLCV 01・深度學習的影像處理與電腦視覺
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 為算繪、幾何或編輯選擇場景表示。
- 使用相機投影、對極幾何與三角測量。
- 追蹤運動恢復結構與多視角立體重建。
- 比較神經場、高斯潑濺與前饋重建。
- 分開評估保留視角與幾何準確度。
先看全貌
你繞著一尊雕像走一圈,用手機拍了三十張照片。三維重建把這些照片變成一個可以旋轉、量測、3D 列印,或放進遊戲的三維模型。這裡有兩個問題必須一起回答:每張照片的相機在哪裡,以及雕像表面的每一小塊在哪裡。兩者都沒有現成答案,而且彼此互相幫忙。
為什麼重要。 地圖、電影布景、文化遺產典藏、機器人環境、擴增實境錨點,以及工廠的數位孿生(digital twin),都靠重建建立。它也清楚說明了深度學習如何改變電腦視覺:傳統流程是純粹的幾何與最佳化;神經輻射場(neural radiance field, NeRF)[5] 讓場景本身變成一個訓練出來的網路;3D Gaussian Splatting(3DGS)[6] 把網路換成數百萬個明確的小色塊,可以即時算繪;最新的模型則一次前向傳遞就預測出相機與幾何。
圖 1 是本篇的路線圖。左邊的傳統階段至今仍餵給幾乎所有現代方法:NeRF 與 3DGS 都是用 COLMAP [2]、[4] 這類運動恢復結構軟體算出的相機位姿來訓練的。
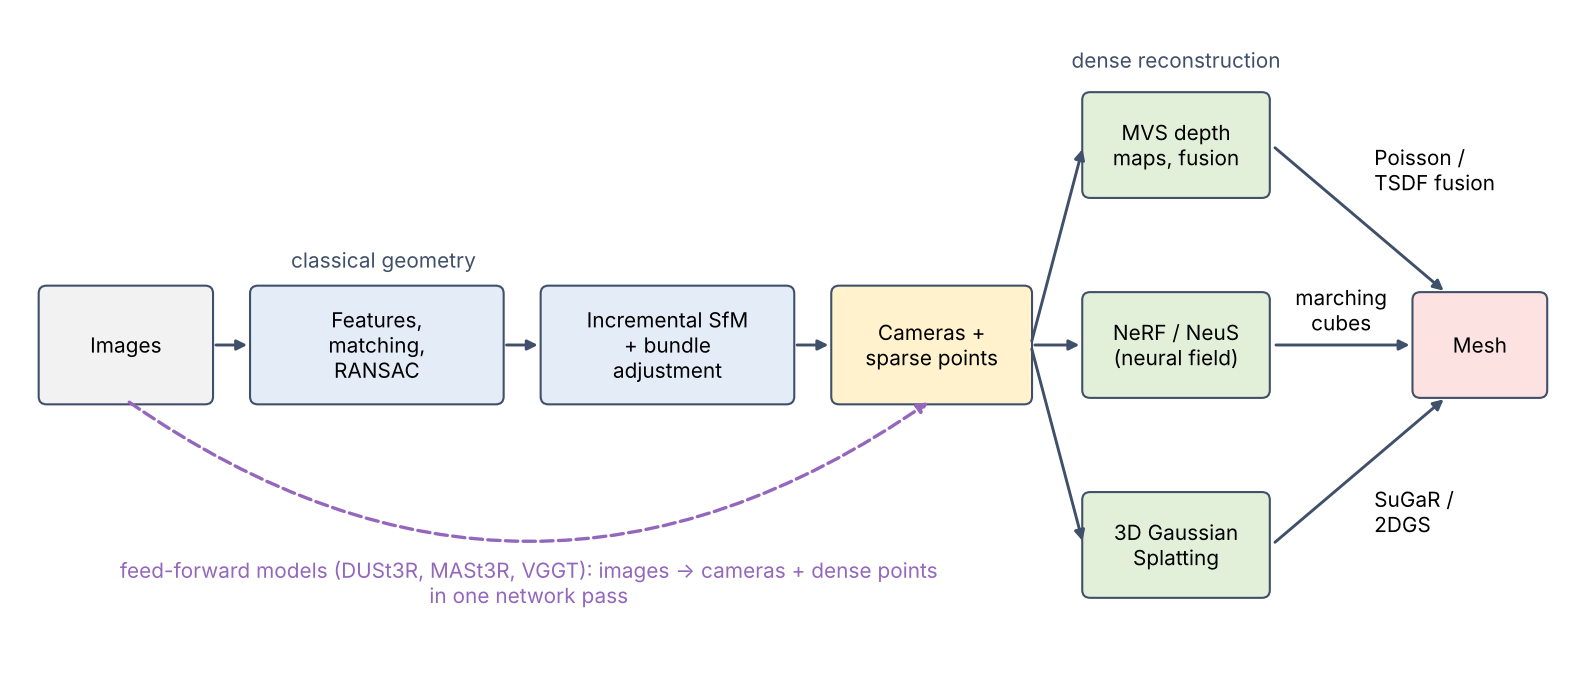
本篇假設你已經知道 IP 12 的關鍵點與描述子配對,也懂 DLCV 01 的深度網路基礎。幾何方面的標準教科書是 Hartley 與 Zisserman [1]。
相關篇章。 DLCV 11A 深入介紹重建背後的密集對應問題——立體匹配、單目深度與光流;DLCV 03B 則利用三維幾何來偵測物體。
什麼是三維重建
白話版。 從靜態場景照片估計相機姿態,以及形狀與外觀的三維表示。
精確版。 給定靜態場景的 張影像 。我們要求出每張影像的相機參數 (下一節定義),以及一個場景模型 ,使得用第 號相機算繪 時能重現 。有兩種變體很重要。幾何重建要求精確的曲面,並以雷射或結構光掃描作為標準來評判。新視角合成(novel-view synthesis)要求從沒有拍過的相機位置產生逼真的影像,並以保留不用的照片來評判。NeRF 與 3DGS 是為第二個目標設計的,所以要從它們取得好的曲面,需要額外的功夫。
這個問題有個內建的限制:光靠照片,整個場景放大或縮小都不會改變任何一張影像。近距離拍的玩具屋和遠距離拍的真房子,可以產生一模一樣的照片。因此除非有其他資訊(例如已知的距離,或校正過的立體相機組)來固定,否則從影像重建只能決定到差一個尺度(up to scale;也包括世界座標系的選擇)[1]。
儲存三維場景的七種方式
白話版。 依算繪、量測、編輯或學習需求選表示;圖 2 用同一場景比較常見形式。
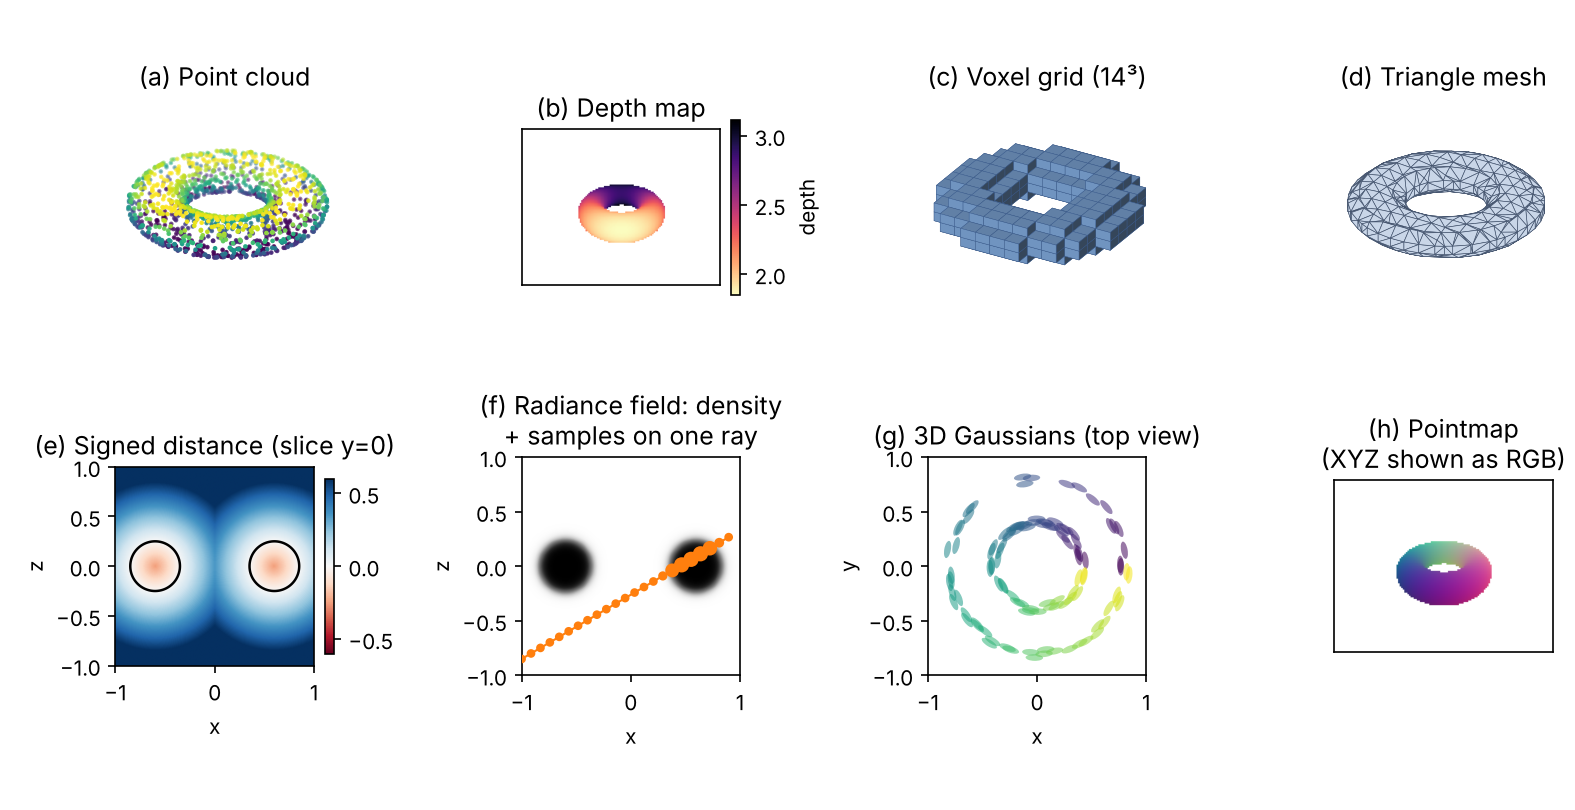
| 表示法 | 儲存什麼 | 優點 | 缺點 |
|---|---|---|---|
| 點雲(point cloud) | 三維點的清單,常附顏色與法向量 | 簡單;三角測量與深度感測器的直接輸出 | 沒有曲面與連接關係;有破洞;很難算繪得漂亮 |
| 深度圖(depth map) | 一台相機每個像素的一個距離 | 適合影像網路;容易逐視角估計 | 只涵蓋一個視角;必須融合 |
| 體素格(voxel grid) | 三維格網每個格子的一個值(佔據、顏色) | 規則,容易用三維卷積處理 | 記憶體隨解析度的三次方成長 |
| 網格(mesh) | 頂點與三角形 | 精簡、可編輯,是圖學引擎與 3D 印表機使用的格式 | 拓樸固定;很難直接從影像最佳化 |
| 有號距離函數(SDF) | 到最近表面的距離,內部為負 | 以零等值面表示不漏水的表面;梯度就是法向量 | 需要封閉曲面;算繪前必須轉換 |
| 輻射場(radiance field) | 每個三維點的密度與隨視角變化的顏色 | 逼真的新視角,包含細薄與毛茸茸的結構 | 光線步進算繪很慢;曲面是隱式的 |
| 3D 高斯 | 許多帶有顏色與不透明度的小橢球 | 即時算繪;明確且可編輯 | 基元數量多(吃記憶體);曲面定義不明確 |
SDF 可以是儲存下來的格網,也可以是網路算出的函數:DeepSDF [20] 學習一個輸出有號距離的網路,Occupancy Networks [21] 則學習某點在物體內部的機率。兩者都稱為神經隱式(neural implicit)表示法,因為曲面是以一個學出來的函數的等值面隱含地給出。
相機幾何基礎
白話版。 針孔模型透過相機變換、投影與透視除法,把三維點映射到影像座標。
針孔相機:內參與外參
相機對一個三維點做兩件事。它先描述這個點相對於相機自己的位置(在相機的左邊多遠、上方多高、前方多遠),再除以它的距離,把它壓平到感測器上。用符號寫:世界座標中的點 先被移到相機座標系,再投影:
其中 ( 旋轉)與 (平移)是外參(extrinsics):它們說明相機在哪裡、朝哪個方向; 是相機座標中的點, 軸沿著視線方向; 存放內參(intrinsics):以像素為單位的焦距 、光軸與影像相交的主點 ,以及偏斜量 (真實感測器中為零); 是像素; 等於該點的深度 。除以深度,就是遠的東西看起來比較小的原因。相機中心在世界座標中是 。把兩個步驟合併,得到 的投影矩陣(projection matrix)。
真實的鏡頭還會讓直線彎曲(徑向畸變);校正工具會估計額外的畸變係數並先把影像去畸變,所以本篇其餘部分假設是理想的針孔相機。這裡使用的齊次座標(結尾帶一個 1)與 IP 02 單應性筆記中的相同(單應性:投影轉換)。
兩個視角:對極幾何
白話版。 如果你在一張照片裡看到一個點,並不知道它有多遠,所以在三維中它可能落在一條射線上的任何位置。在第二張照片裡,這條射線會呈現為一條直線。真正的對應點一定落在這條線上。這把二維搜尋變成一維搜尋,反過來,也讓我們只憑配對點就能還原兩台相機的相對擺放。
圖 3 (a) 畫出這個幾何。兩個相機中心與三維點 張成一個平面,稱為對極平面(epipolar plane)。它與每張影像相交成一條對極線(epipolar line)。相機 1 同一條射線上的任何點 ,在相機 1 中都有相同的像 ,而它在相機 2 中的像會沿著那條線移動。
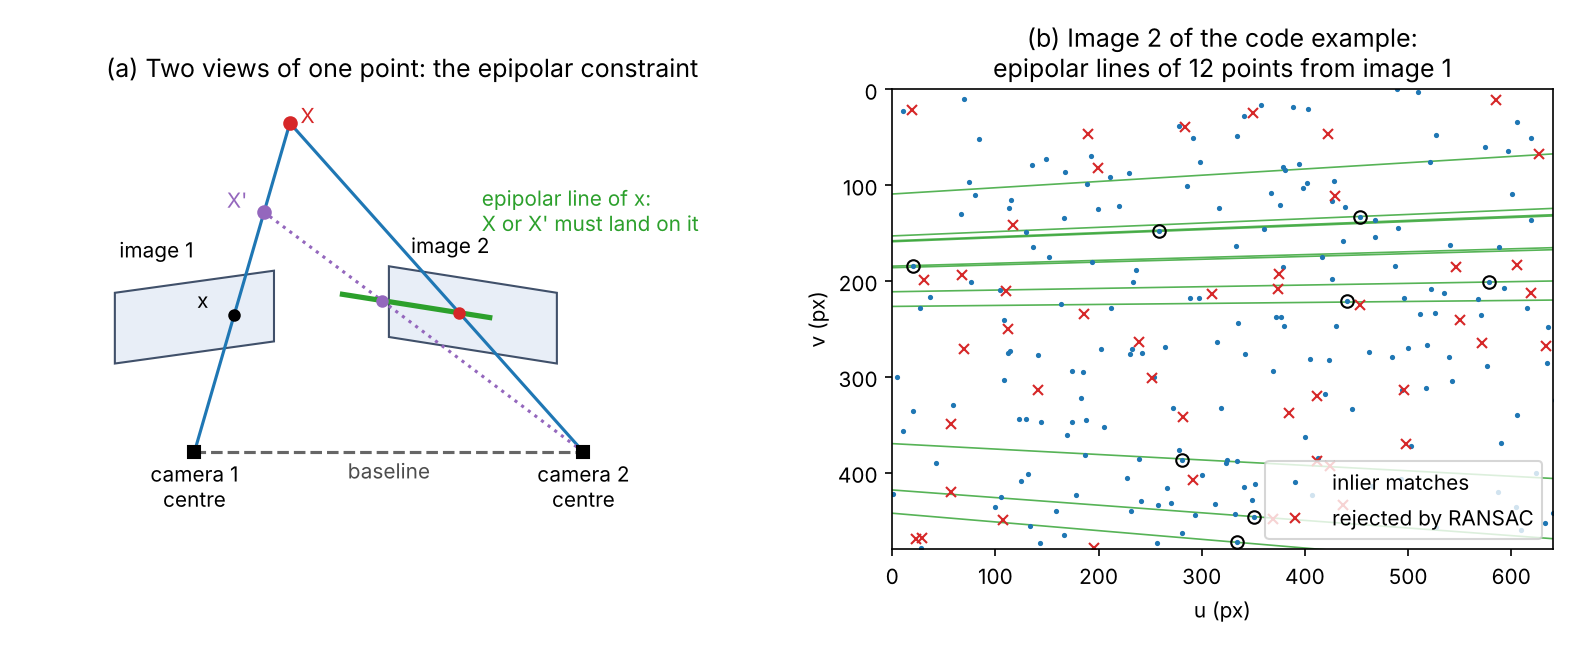
用代數來說,令 與 為一組配對點的正規化座標(把內參去掉的像素)。若相機 2 相對於相機 1 的旋轉為 、平移為 ,則每個正確的配對都滿足
其中 是 的本質矩陣(essential matrix)[7], 是與 做外積的矩陣。這個式子說的是:兩條視線與基線落在同一個平面上。在像素座標中,同一個約束寫成 ,其中基礎矩陣(fundamental matrix), 是齊次像素座標。 正是圖 3 (b) 中畫在影像 2 上的對極線。
用白話說: 編碼了兩台已校正相機的相對位姿, 則在內參未知時做同樣的事。 有五個自由度:旋轉三個,平移的方向兩個,平移的長度則因尺度不確定性而遺失。所以五組配對就夠了,這是 Nistér 的五點演算法 [9] 所解的最小情況。有八組或更多配對時,約束對 或 的九個元素是線性的:八點演算法 [7]、[8] 每組配對疊一個方程式,再用奇異值分解取零向量。
選讀:正規化八點演算法(見「補充資料」頁)。為什麼要先重新縮放像素座標、秩為 2 的那一步,以及兩種版本的測試。
知道 之後,可以把它分解成 和 的方向。分解會得到四個候選位姿;只有一個會讓這些點位在兩台相機的前方,這個檢查稱為手性檢查(cheirality check,或 chirality check)[1]。
三角測量
白話版。 兩台相機都已知時,一組配對點給出兩條射線。它們(幾乎)相交的地方就是三維點。有雜訊時,兩條線永遠不會剛好相交,所以我們挑一個最能同時解釋兩個觀測的點。
最簡單的方法是線性的。每張影像對未知點給出兩個線性方程式(把未知深度消去的針孔方程式),四個方程式就像八點系統一樣,用 SVD 取一個小矩陣的零向量來解 [1]。三角測量出的點好不好,用它的重投影誤差(reprojection error)來判斷:把它投影回每張影像,量它與觀測點之間的像素距離。
選讀:線性三角測量(DLT)(見「補充資料」頁)。四個方程式的完整寫法、為什麼線性解不是最佳解,以及基線如何控制誤差的測試。
準確度與兩條射線的夾角關係很大。對焦距為 、基線為 的兩台平行相機,深度為 的點在兩張影像之間會位移視差(disparity) 像素,所以視差的小誤差 會造成深度誤差 。深度誤差隨距離的平方成長,並隨基線變寬而縮小;練習 1 會用數字說明。
程式碼:相對位姿與三角測量
這段程式碼建立一個合成場景,把它投影到兩台帶有 0.5 像素雜訊的相機,將 15% 的配對換成隨機的錯誤配對,再用 OpenCV 還原相對位姿。cv2.findEssentialMat 在五點求解器外面包了一層 RANSAC(其文件指明用的是 Nistér 的演算法 [9]);cv2.recoverPose 執行手性檢查。RANSAC 的答案來自最小樣本,所以我們再用所有內點以線性方式重新擬合 ,也就是 IP 12 的 RANSAC 筆記(RANSAC:在有離群值時擬合模型)所說的「在共識集合上重新擬合」那一步。
程式碼 · Python · 56 行
import numpy as np
import cv2

rng = np.random.default_rng(0)
K = np.array([[800.0, 0, 320], [0, 800.0, 240], [0, 0, 1]])   # focal length 800 px, principal point (320, 240)

def look_at(C, target):
    """Rotation of a camera at centre C that looks at target (rows: camera x, y, z axes)."""
    z = (target - C) / np.linalg.norm(target - C)
    x = np.cross([0.0, 1.0, 0.0], z); x /= np.linalg.norm(x)
    return np.stack([x, np.cross(z, x), z])

def project(K, R, t, X):
    """Pinhole projection of world points X (N, 3) to pixels (N, 2)."""
    x = (X @ R.T + t) @ K.T           # world -> camera -> homogeneous pixels
    return x[:, :2] / x[:, 2:]        # divide by depth

def linear_E(x1, x2, K):
    """Least-squares E from many matches: each match gives one linear equation in E's 9 entries."""
    Ki = np.linalg.inv(K)
    a = np.c_[x1, np.ones(len(x1))] @ Ki.T               # normalized camera coordinates
    b = np.c_[x2, np.ones(len(x2))] @ Ki.T
    A = np.einsum('ni,nj->nij', b, a).reshape(-1, 9)      # row n encodes b_n^T E a_n = 0
    E = np.linalg.svd(A)[2][-1].reshape(3, 3)             # best null vector of A
    U, _, Vt = np.linalg.svd(E)
    return U @ np.diag([1.0, 1.0, 0.0]) @ Vt              # nearest valid essential matrix

X = rng.uniform([-3, -2, 4], [3, 2, 8], size=(300, 3))           # 300 scene points
C2 = np.array([2.0, 0.0, 0.0])                                    # camera 2 centre: 2 units to the right
R2 = look_at(C2, np.array([0.0, 0.0, 6.0])); t2 = -R2 @ C2        # camera 1 is the world frame
x1 = project(K, np.eye(3), np.zeros(3), X) + rng.normal(0, 0.5, (300, 2))   # 0.5 px noise
x2 = project(K, R2, t2, X) + rng.normal(0, 0.5, (300, 2))
x2[:45] = rng.uniform([0, 0], [640, 480], (45, 2))                # 45 wrong matches (15 %)

def pose_errors(R, t):
    rot = np.degrees(np.arccos(np.clip((np.trace(R.T @ R2) - 1) / 2, -1, 1)))
    return rot, np.degrees(np.arccos(t.ravel() @ t2 / np.linalg.norm(t2)))

E, mask = cv2.findEssentialMat(x1, x2, K, method=cv2.RANSAC, prob=0.999, threshold=1.5)
_, R, t, mask = cv2.recoverPose(E, x1, x2, K, mask=mask)
inl = mask.ravel() > 0
print(f"inliers kept: {inl.sum()} of 300 | wrong matches rejected: {(~inl[:45]).sum()} of 45")
print("RANSAC estimate      : rotation error %.2f deg, translation direction error %.2f deg" % pose_errors(R, t))
_, R, t, _ = cv2.recoverPose(linear_E(x1[inl], x2[inl], K), x1[inl], x2[inl], K)
print("refit on all inliers : rotation error %.2f deg, translation direction error %.2f deg" % pose_errors(R, t))
print(f"length of estimated t: {np.linalg.norm(t):.2f} (true baseline {np.linalg.norm(C2):.2f})")

P1 = K @ np.hstack([np.eye(3), np.zeros((3, 1))])     # P1 = K [I | 0]
P2 = K @ np.hstack([R, t])                            # P2 = K [R | t]
Xh = cv2.triangulatePoints(P1, P2, x1[inl].T, x2[inl].T)
Xe = (Xh[:3] / Xh[3]).T                               # homogeneous -> Euclidean
res = np.r_[np.linalg.norm(project(K, np.eye(3), np.zeros(3), Xe) - x1[inl], axis=1),
            np.linalg.norm(project(K, R, t.ravel(), Xe) - x2[inl], axis=1)]
print(f"reprojection error: RMS {np.sqrt(np.mean(res ** 2)):.2f} px")
rel = np.linalg.norm(2.0 * Xe - X[inl], axis=1) / np.linalg.norm(X[inl], axis=1)   # scale fixed by the true baseline
print(f"3D error after fixing the scale: median {100 * np.median(rel):.2f} % of the distance")
輸出
inliers kept: 250 of 300 | wrong matches rejected: 44 of 45
RANSAC estimate      : rotation error 0.30 deg, translation direction error 0.42 deg
refit on all inliers : rotation error 0.07 deg, translation direction error 0.46 deg
length of estimated t: 1.00 (true baseline 2.00)
reprojection error: RMS 0.40 px
3D error after fixing the scale: median 0.31 % of the distance
這些數字只來自這次合成實驗。RANSAC 剔除了 45 個錯誤配對中的 44 個。用所有內點重新擬合,把旋轉誤差從 0.30° 降到 0.07°;平移方向則無論哪種都在半度以內。估計出的平移長度剛好是 1:OpenCV 只回傳它的方向,因為影像無法告訴我們真正的基線是 2。一旦從外部提供尺度,三角測量出的點與真實距離相差約 0.3% 以內。0.40 像素的重投影誤差低於 0.5 像素的雜訊水準,這在意料之中,因為這些點是對自己的觀測做擬合。
運動恢復結構
白話版。 運動恢復結構(structure from motion, SfM)把兩視角的技巧一次用到幾百張照片上:它在所有照片之間找到相配的點,一台一台地放置相機,三角測量出各個點,並持續修整所有東西,讓每個三維點都投影到它真正被看到的像素上。
特徵、配對與幾何驗證
首先,SfM 必須知道不同照片中的哪些像素拍到同一個實際的點。它從局部特徵開始。每張影像產生帶有描述子的關鍵點,例如 SIFT [11](IP 12),再在影像對之間配對描述子(IP 12,配對)。許多配對是錯的,所以每個影像對都要做幾何驗證:用 RANSAC [10] 擬合基礎矩陣(或本質矩陣、單應性),只有足夠多配對互相吻合時才保留該影像對 [2]。通過驗證的影像對組成場景圖(scene graph):影像是節點,一條邊表示「這兩張影像看到相同的點」。
增量式重建
COLMAP 的論文描述了標準的增量式流程 [2],它源自早期處理網路照片集的系統,例如 Photo Tourism [12]:
- 初始化:選一對共享許多配對、基線又夠寬的影像;估計它們的相對位姿並三角測量共享的點。
- 註冊新影像:解透視 n 點(Perspective-n-Point, PnP)問題,也就是在 RANSAC 之中,由它的關鍵點與已三角測量的三維點之間的配對求出相機位姿。
- 三角測量新影像與至少一張已註冊影像都看到的新點。
- 光束法平差(見下)同時修整所有相機與點,然後過濾重投影誤差大的點。
- 回到步驟 2 重複,直到再也沒有影像可以註冊。
COLMAP 論文改進了其中每一步,包括如何挑選下一張影像,以及如何三角測量點。它最核心的教訓在步驟 4:註冊與三角測量必須與反覆的光束法平差、重新三角測量與離群值過濾交錯進行,因為沒有這些修整,小誤差會隨著影像一張張加入而累積,重建就會漂移 [2]。
光束法平差
白話版。 光束法平差(bundle adjustment, BA)是最後的修整:把每台相機和每個三維點都稍微移動一點,直到所有「光束」都和點實際被看到的像素對齊。
BA 解的是下面這個非線性最小平方問題
其中 是相機 的參數(位姿,內參未知時也包含內參), 是三維點, 是觀測的集合(點 出現在影像 中), 是觀測到的像素, 是針孔投影, 是降低離群值權重的穩健損失 [2]、[13]。標準的求解器是 Levenberg–Marquardt,一種帶阻尼的 Gauss–Newton 法。它之所以快,是因為每個殘差只依賴一台相機和一個點,所以 Jacobian幾乎全是零 [2]、[13]。BA 無法固定整體的尺度與座標系,而且只會找到局部最小值,所以需要增量式步驟提供的好起點。
選讀:程式碼中的光束法平差(見「補充資料」頁)。用 scipy.optimize.least_squares 寫成的完整小型 BA、它的稀疏模式,以及規範(gauge)問題。
實務上的 COLMAP
COLMAP 是隨 [2] 與 [3] 釋出的開源 SfM 與 MVS 流程,有圖形介面與命令列介面 [4]。它輸出相機內參與位姿,加上稀疏點雲,這正是下面稠密方法的標準輸入:NeRF 論文中真實場景的位姿取自 COLMAP [5],3DGS 則以 SfM 的點來初始化高斯 [6]。後面每個階段都繼承了這裡犯的誤差(見失效模式中的位姿誤差)。
多視角立體視覺
白話版。 SfM 給出相機與一組稀疏的點。多視角立體視覺(multi-view stereo, MVS)補上其餘部分:對參考影像的每個像素,沿著其他影像中的對極線搜尋,找出所有視角對表面長相意見一致的那個深度。
光度一致性與平面掃描
核心的檢驗是光度一致性(photo-consistency):如果某像素的表面點深度為 ,那麼它周圍的小區塊,在每一張看得到該點的影像裡看起來都應該一樣。一個深度假設的分數,由區塊之間的匹配代價來打分,例如差的平方和(sum of squared differences, SSD)或正規化互相關。
平面掃描(plane sweep)演算法 [14] 能有效率地檢驗許多深度。讓一個與參考影像平行的平面掃過一段深度範圍 。對每個深度,把每張來源影像扭曲(warp)到參考視角,就像整個場景都落在那個平面上一樣;單一平面的扭曲是一個單應性。逐像素計算代價,把代價疊成大小為 的代價體(cost volume),再為每個像素選出代價最低的深度:
其中 是被深度 處的平面扭曲後的來源影像, 是像素周圍的小視窗。對兩台平行的相機(一對校正過的相機),平面單應性簡化成依視差 做水平位移,程式碼也就能寫得很短。
選讀:平面誘導的單應性(見「補充資料」頁)。一般相機位姿與傾斜平面的扭曲。
程式碼 · Python · 36 行
import numpy as np
from scipy import ndimage as ndi

rng = np.random.default_rng(0)
H, W, f, B = 120, 160, 150.0, 0.5                     # image size, focal length (px), baseline
tex = ndi.gaussian_filter(rng.random((400, 400)), 1.5)   # random texture painted on the world
tex = (tex - tex.min()) / np.ptp(tex)

def render(cx):
    """Ray-cast a camera at (cx, 0, 0) looking down +Z: a square at Z=5 in front of a wall at Z=8."""
    v, u = np.mgrid[0:H, 0:W].astype(float)
    dx, dy = (u - W / 2) / f, (v - H / 2) / f          # ray direction (dx, dy, 1)
    Xs, Ys = cx + 5 * dx, 5 * dy                        # hit point on the plane Z = 5
    front = (np.abs(Xs) < 1) & (np.abs(Ys) < 1)         # inside the square?
    Z = np.where(front, 5.0, 8.0)
    X, Y = cx + Z * dx, Z * dy
    img = ndi.map_coordinates(tex, [200 + 40 * Y + 100 * front, 200 + 40 * X], order=1)
    img[~front & (X > 1.5) & (Y < -0.5)] = 0.5          # a textureless patch on the wall
    return img, Z

ref, Z_true = render(0.0)                              # reference camera
src, _ = render(B)                                     # source camera, B to the right

depths = 1 / np.linspace(1 / 10, 1 / 3.5, 80)          # depth hypotheses, uniform in 1/Z
cost = np.empty((len(depths), H, W))
for k, Z in enumerate(depths):
    d = f * B / Z                                      # the plane Z induces a horizontal shift d
    warped = ndi.shift(src, (0, d), order=1, mode='nearest')   # src pixel u - d lands on u
    cost[k] = ndi.uniform_filter((ref - warped) ** 2, 7)       # windowed SSD photo-consistency
Z_est = depths[cost.argmin(0)]                         # winner-take-all depth per pixel

ok = np.abs(Z_est - Z_true) / Z_true < 0.05
flat = (Z_true == 8) & (ref == 0.5)
inner = np.zeros_like(ok); inner[8:-8, 20:-8] = True    # ignore borders the source camera cannot see
print(f"pixels within 5% of the true depth: {100 * ok[inner & ~flat].mean():.1f}% (textured), "
      f"{100 * ok[inner & flat].mean():.1f}% (textureless patch)")
輸出
pixels within 5% of the true depth: 95.3% (textured), 14.8% (textureless patch)在有紋理的表面上,這次合成實驗中 95.3% 被評估的像素,其深度落在真值的 5% 以內。在無紋理的區塊裡只有 14.8%,因為對一塊平坦的灰色區塊來說,每個深度假設的匹配程度都一樣好。圖 4 (d) 直接顯示了這點:有紋理像素的代價曲線在真實深度處有一個尖銳的最小值;無紋理像素的曲線則是平的。有紋理表面上剩下的誤差出現在左邊界(只有一台相機看得到),以及方塊旁邊,那裡有一部分背景被第二台相機擋住(遮擋)。
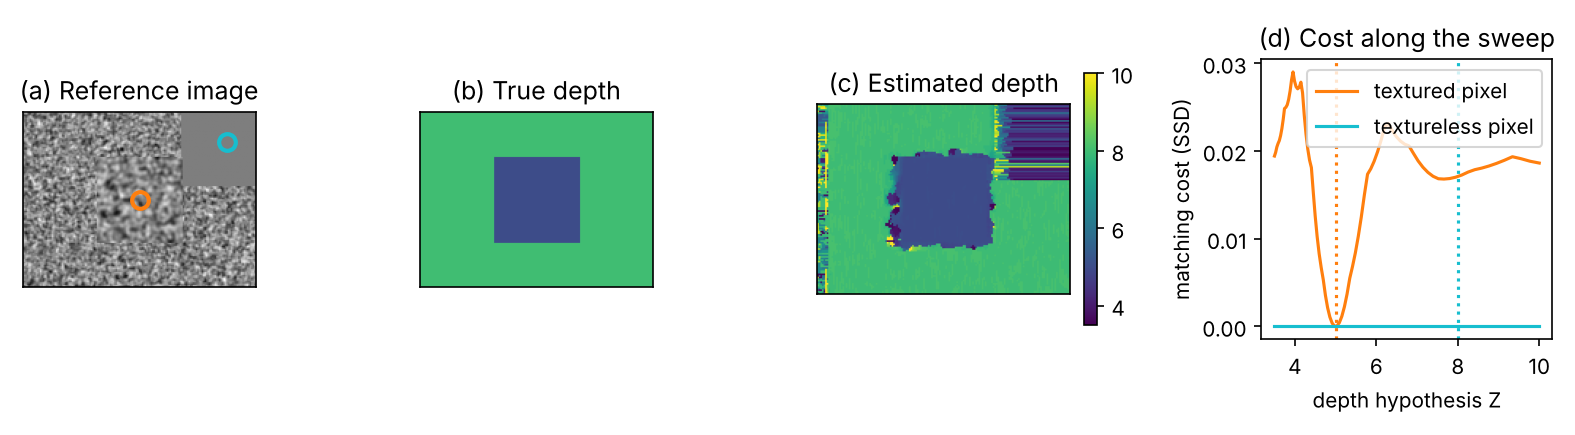
從深度圖到單一模型
每張影像一張深度圖,還不是一個模型。深度圖融合(depth-map fusion)把它們合併起來。Curless 與 Levoy 的體積法 [15] 在體素格裡存放每張深度圖所量到的、到表面的有號距離的滾動加權平均:
其中 是體素 沿視線方向到深度圖 所見表面的有號距離, 是它的信心權重,、 是累積了 張圖之後的距離與權重。表面是 的零等值面,由 marching cubes(見下)萃取。實務上,距離在表面附近會被截斷,所以這個方法叫做 TSDF(truncated signed distance function,截斷有號距離函數)融合。COLMAP 的 MVS [3] 則是逐像素估計深度與法向量,使用逐像素的視角選擇與多視角幾何一致性檢查,再把一致的深度融合成稠密點雲。
學習式 MVS
白話版。 MVS 中手工設計的部分,也就是區塊代價,以及清理代價體的規則,都可以從資料中學出來。
MVSNet [16] 保留平面掃描的結構,但讓每一步都可微分。共用的 CNN 從所有影像擷取特徵,每個來源視角的特徵被扭曲到參考相機的正面平行平面上(可微分的單應性扭曲)。以變異數為基礎的代價把任意數量的視角合併成一個代價體:變異數低代表各視角意見一致。接著用三維 CNN 對代價體做正則化,沿深度軸做 softmax 得到每個深度的機率,在這個分布下的期望深度(「soft argmin」)是連續的輸出,可以用迴歸損失來訓練 [16]。MVSNet 在 DTU [37] 上訓練,並在不微調的情況下於 Tanks and Temples [38] 上評估 [16]。作者提出學習的動機,是低紋理、鏡面與反光的區域,手工設計的代價在那裡會失效 [16]。
神經輻射場(NeRF)
白話版。 NeRF 把場景存成一個小小的神經網路,這個網路對空間中任何一點、任何觀看方向回答同一個問題:「這裡有多少東西,它朝我這個方向送出什麼顏色?」要產生一張影像,就對每個像素射出一條光線,在光線上許多點詢問網路,再把答案混合起來。訓練就是調整網路,直到算繪出來的影像和照片相符。
以函數表示場景
NeRF [5] 是一個多層感知器(multilayer perceptron),其中 是位置, 是觀看方向, 是 處的體積密度(volume density), 是朝 方向發出的 RGB 顏色。網路的設計讓密度只依賴位置,顏色則同時依賴方向,這讓 NeRF 能重現隨視角改變的亮面反光 [5]。一個網路只表示一個場景;沒有包含許多場景的訓練集。
選讀:NeRF(Mildenhall 等人,2020)(見「論文導讀」頁)。論文想解決什麼、它的表格與消融實驗顯示了什麼,以及它沒有主張什麼。
沿光線的體積算繪
白話版。 想像光線穿過一團濃淡不一的霧。每一小段霧都會用自己的顏色發光,同時擋住它後方的光。像素的顏色就是所有發光加起來,每一段發光都被它前方的霧減弱。
相機光線為 ,其中原點 是相機中心,方向是 ,距離 介於近界 與遠界 之間。依照經典的體積算繪 [17],期望顏色為
其中 是透射率(transmittance),即光線從 走到 沒有被擋住的機率 [5]。NeRF 用光線上的 個取樣 來計算它:
其中 是網路在第 個取樣處的輸出, 是間距, 是第 段的不透明度(opacity), 是通過它前面各段之後還剩下的光, 是第 個取樣在像素中的權重。這正是半透明圖層由前到後的 alpha 合成(alpha compositing)[5]。權重的總和 是像素的總不透明度, 則是深度的估計。每一步都可微分,所以照片誤差可以一路傳回網路的權重。
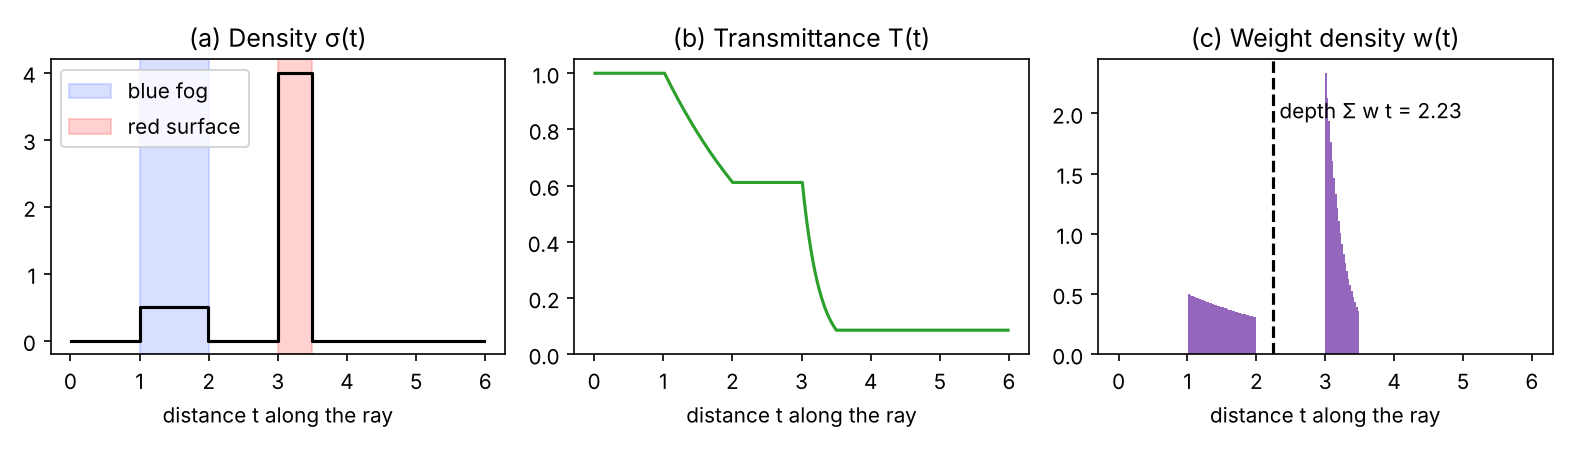
下面的程式碼用精確解來檢查這個數值積分。光線先穿過藍色的霧,再穿過一層紅色表面,最後抵達白色背景;對分段常數的密度,這些積分有封閉解。
程式碼 · Python · 40 行
import numpy as np

# One ray from t = 0 to t = 6: blue fog on [1, 2] (density 0.5), a red surface on [3, 3.5] (density 4),
# white background behind everything.
slabs = [(1.0, 2.0, 0.5, np.array([0.2, 0.4, 1.0])),
         (3.0, 3.5, 4.0, np.array([1.0, 0.1, 0.1]))]
bg = np.ones(3)

def field(t):
    """Density sigma(t) and colour c(t) at sample positions t."""
    sigma, c = np.zeros_like(t), np.zeros(t.shape + (3,))
    for a, b, s, col in slabs:
        inside = (t >= a) & (t < b)
        sigma[inside], c[inside] = s, col
    return sigma, c

def render(n):
    """NeRF quadrature: alpha_i = 1 - exp(-sigma_i delta_i), T_i = prod_{j<i} (1 - alpha_j), w_i = T_i alpha_i."""
    edges = np.linspace(0, 6, n + 1)
    t, delta = (edges[:-1] + edges[1:]) / 2, np.diff(edges)
    sigma, c = field(t)
    alpha = 1 - np.exp(-sigma * delta)
    T = np.concatenate([[1.0], np.cumprod(1 - alpha)[:-1]])
    w = T * alpha
    T_end = T[-1] * (1 - alpha[-1])                   # light that reaches the background
    return w @ c + T_end * bg, w.sum(), w @ t

# Analytic answer for piecewise-constant density (exact integrals of the volume rendering equation)
C, acc, depth, T0 = np.zeros(3), 0.0, 0.0, 1.0
for a, b, s, col in slabs:
    L = b - a
    absorbed = T0 * (1 - np.exp(-s * L))
    C, acc = C + absorbed * col, acc + absorbed
    depth += T0 * (a * (1 - np.exp(-s * L)) + (1 - np.exp(-s * L)) / s - L * np.exp(-s * L))
    T0 *= np.exp(-s * L)
C += T0 * bg
print(f"analytic : colour {np.round(C, 4)}, opacity {acc:.4f}, depth {depth:.4f}")
for n in [16, 64, 256, 1024]:
    Cq, accq, dq = render(n)
    print(f"N = {n:4d} : colour {np.round(Cq, 4)}, opacity {accq:.4f}, depth {dq:.4f}")
輸出
analytic : colour [0.6852 0.2919 0.528 ], opacity 0.9179, depth 2.2373
N =   16 : colour [0.7498 0.3318 0.5195], opacity 0.8466, depth 2.1655
N =   64 : colour [0.7006 0.2986 0.5232], opacity 0.9040, depth 2.2263
N =  256 : colour [0.689  0.2934 0.5267], opacity 0.9146, depth 2.2348
N = 1024 : colour [0.6862 0.2923 0.5277], opacity 0.9171, depth 2.2367
隨著取樣數增加,數值積分會收斂到解析解的顏色、不透明度與深度。取 16 個取樣時差距明顯,因為薄薄的表面層落進了一兩個太粗的區間。這就是 NeRF 不均勻取樣的原因:先由一個每條光線 64 個取樣的粗網路找出權重大的位置,再由細網路在那裡加上集中的 128 個取樣(階層式取樣)[5]。再看看深度:2.24(圖 5 用 256 個取樣時是 2.23),落在霧與表面之間,那裡其實沒有任何表面。半透明的「霧」出現在錯誤的位置,就是失效模式中所討論的漂浮物瑕疵的來源。圖 5 畫出這條光線的密度、透射率與權重。
位置編碼
白話版。 一個直接輸入原始 的普通 MLP,只能學到平滑而模糊的函數。改為輸入座標在許多頻率下的正弦與餘弦,它才能表示銳利的邊緣與細緻的紋理。
NeRF 把每個座標 (正規化到 )映射成
其中 是頻帶數量:位置用 ,方向用 [5]。沒有這個編碼,論文的結果會失去細節 [5]。Tancik 等人 [18] 解釋了原因:座標 MLP 偏向低頻(頻譜偏差,spectral bias),而對輸入做傅立葉特徵映射就能消除這個偏差。這些正弦函數類似 Transformer 的位置資訊(ML 05),但這裡編碼的是連續座標,而不是 token 的位置。
訓練,以及為什麼慢
訓練只需要有位姿的影像,其他都不用。每一步從訓練影像中取樣一批像素(光線),用粗網路與細網路把它們算繪出來,並最小化顏色的平方誤差 [5]。問題出在成本。每個像素需要幾百次網路評估,一個場景需要幾十萬步。論文報告每個場景 100–300k 次迭代,在一張 NVIDIA V100 GPU 上約 1–2 天 [5]。算繪慢也是同樣的原因:論文每條光線使用 256 次網路查詢,每張影像介於 1.5 億到 2 億次之間,並報告在 V100 上每個畫面約 30 秒 [5]。
加速:雜湊網格
白話版。 不要叫一個大網路記住所有東西,而是把學到的特徵存在多個解析度的查找表裡,再用一個很小的網路來解碼。查表比跑許多層網路便宜得多。
Instant-NGP [19] 以多解析度雜湊編碼(multiresolution hash encoding)取代頻率編碼。空間由 層網格覆蓋,從粗到細。每一層網格在它的角點存放可訓練的特徵向量,但是放在大小固定為 的表裡;在細的網格上,角點遠多於表中的項目,就由一個雜湊函數決定角點使用哪一項,所以好幾個角點共用同一項。要編碼一個點時,在每一層內插它周圍角點的特徵,串接起來,再交給一個小型 MLP。論文並不明確地解決共用項目的問題;它仰賴粗的層級和 MLP 自己把它們分開 [19]。作者報告在「幾秒內」就能訓練出高品質的結果,並在一張 GPU 上以 1920 × 1080 解析度做到幾十毫秒的算繪 [19]。這類以網格為基礎的編碼,現在在快速的 NeRF 變體中很常見。
選讀:多解析度雜湊編碼(見「補充資料」頁)。各層解析度、雜湊函數、參數量,以及一個範例演算。
神經隱式曲面:NeuS
白話版。 NeRF 的密度不一定會形成乾淨的表面:它可以是一團雲。如果你想要曲面,就讓網路改為輸出有號距離,並用一種讓算繪出的權重剛好在表面上達到峰值的方式,把距離轉成不透明度。
NeuS [22] 把場景表示成一個 SDF 網路 ,它的零等值面就是曲面。它透過 sigmoid 把 SDF 轉成不透明度,其中 是會在訓練中增大的、學出來的銳利度。作者指出,最直覺的做法是直接把 logistic 密度 當成體積密度,這樣得到的權重會在表面之前達到峰值(偏差),他們於是推導出一個一階無偏、又能處理遮擋的不透明度 [22]。離散形式為
其中 是光線上第 個取樣;權重之後使用與 NeRF 相同的合成公式。Eikonal 項 讓 保持為合法的距離函數 [22]。因為曲面是等值面,用 marching cubes 就能直接得到網格。NeuS 不需要前景遮罩就能重建物體,並且在 DTU [37] 等資料上做過評估 [22]。
選讀:為什麼 NeuS 的權重會在表面上達到峰值(見「補充資料」頁)。在一條光線上量測天真密度的偏差。
3D Gaussian Splatting
白話版。 3DGS 不用你得沿著每條光線去查詢的網路,而是用數百萬個小小的、有顏色的、半透明的橢球來表示場景,像一團柔軟的顏料滴。要產生影像時,把每一滴投影到螢幕上成為一個柔軟的橢圓,再由前到後疊起來。沒有光線步進,也沒有網路:只有排序與混合,GPU 做起來非常快。
高斯基元
每個色塊都是一個三維的鐘形曲線:中心最濃,向外平滑淡出,而且在某些方向被拉得比其他方向更長。精確地說,每個基元 [6] 有中心 、決定大小與方向的共變異數 、不透明度 ,以及以球諧函數(spherical harmonics)係數儲存的顏色(球面上一組平滑的函數,讓顏色可以隨觀看方向改變)。它在空間中的涵蓋範圍為
其中 存放三個軸長, 是以單位四元數儲存的旋轉 [6]。這個分解保證 在梯度下降期間一直是合法(半正定)的共變異數,直接最佳化 的六個元素則做不到這一點 [6]。
投影到影像
白話版。 透過相機看到的三維橢球,看起來是二維的橢圓。3DGS 用相機投影的局部線性近似來算出這個橢圓,對小的高斯來說很準確。
依照 EWA splatting [23],投影後高斯的二維共變異數為
其中 是世界到相機轉換的旋轉部分, 是在高斯中心處計算的透視投影 Jacobian,只取 左上角 的區塊,就得到影像空間中的橢圓 [6]、[23]。投影後的中心就是 的針孔投影。
選讀:投影 3D 高斯:局部仿射近似(見「補充資料」頁)。Jacobian 的完整寫法,以及近似何時失效。
Alpha 合成與即時算繪
像素顏色使用和 NeRF 相同的合成規則,只是對象換成覆蓋該像素、並依深度排序的高斯:
其中 是像素位置, 與 是高斯 投影後的中心與共變異數, 是它隨視角變化的顏色。為什麼快?算繪器 [6] 把螢幕切成 像素的圖塊(tile),把每個可見的高斯指派給它碰到的圖塊,用 GPU 基數排序(radix sort)把所有(圖塊, 深度)鍵值一次排好,然後平行地由前到後混合每個圖塊的清單,像素幾乎不透明時就停止。沒有網路要評估,也沒有空白空間要取樣。論文報告在 1080p 達到即時(至少每秒 30 個畫面)的新視角合成,品質可與當時最好的 NeRF 變體相比 [6]。
選讀:3D Gaussian Splatting(Kerbl 等人,2023)(見「論文導讀」頁)。閱讀論文時如何把表示法和工程細節分開,以及它自己陳述的限制。
最佳化與自適應密度控制
白話版。 訓練從稀疏的 SfM 點開始,每個點一個高斯,然後讓這組高斯長出來並修剪:缺少細節的地方就增加高斯,一個大高斯涵蓋太多的地方就把它分裂,看不見的高斯則移除。
所有參數都用梯度下降來最佳化,損失為算繪影像與真實影像之間的 ,其中 [6]。每 100 次迭代,這個方法會對視空間(view-space)位置梯度大的高斯進行加密,梯度大表示該區域還沒有被充分解釋 [6]:
- 在重建不足區域中的小高斯會被複製(clone;複製並沿梯度方向移動);
- 在高變異區域中的大高斯會被分裂(split)成兩個較小的高斯,尺度除以 1.6;
- 不透明度低於門檻的高斯會被修剪(prune);此外,每 3000 次迭代會把所有不透明度重設到接近零,這限制了靠近輸入相機的漂浮物所造成的高斯增長 [6]。
程式碼:二維 splatting 的小實驗
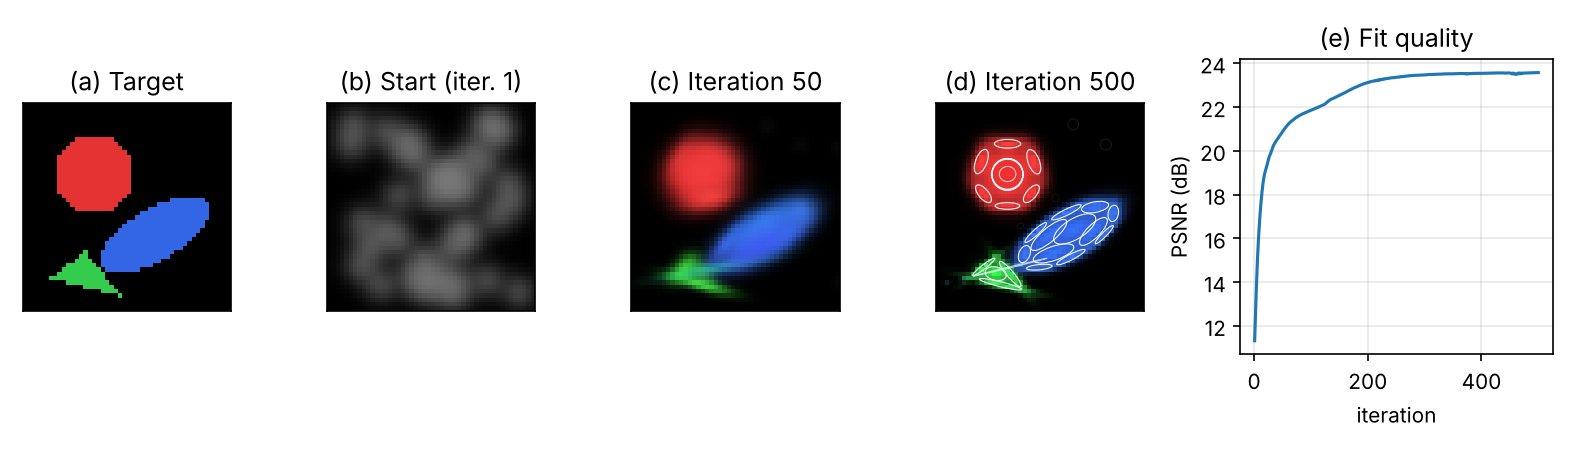
這段程式碼用 Adam 最佳化器 [49],把 40 個二維高斯擬合到一張 48 × 48 的影像,使用的正是上面的合成規則(深度順序固定,也沒有加密)。反向傳遞用鏈鎖律(chain rule)手寫出來(3DGS 論文也是明確推導梯度,而不是依賴自動微分 [6]);梯度在撰寫本篇時已與有限差分核對過。
程式碼 · Python · 64 行
import numpy as np
from skimage.draw import disk, polygon, ellipse

# Target: a small synthetic RGB image (48 x 48) on a black background
H = W = 48
target = np.zeros((H, W, 3))
target[disk((16, 16), 9)] = [0.9, 0.2, 0.2]
target[ellipse(30, 30, 6, 14, rotation=np.deg2rad(30))] = [0.2, 0.4, 0.9]
target[polygon([40, 44, 34], [6, 22, 14])] = [0.2, 0.8, 0.3]
ys, xs = np.mgrid[0:H, 0:W].astype(float)

def sig(z):
    return 1 / (1 + np.exp(-z))

def render(p, target=None):
    """Front-to-back alpha compositing of K 2D Gaussians (index order = depth order).
    p: mu (K,2), log_s (K,2), theta (K,), op (K,) opacity logits, col (K,3) colour logits."""
    c, s, th = sig(p['col']), np.exp(p['log_s']), p['theta']
    dx = xs[None] - p['mu'][:, 0, None, None]; dy = ys[None] - p['mu'][:, 1, None, None]
    ct, st = np.cos(th)[:, None, None], np.sin(th)[:, None, None]
    u1, u2 = ct * dx + st * dy, -st * dx + ct * dy                   # offsets in the Gaussian's own axes
    sx2, sy2 = (s[:, 0] ** 2)[:, None, None], (s[:, 1] ** 2)[:, None, None]
    g = np.exp(-0.5 * (u1 ** 2 / sx2 + u2 ** 2 / sy2))               # Gaussian footprint
    o = sig(p['op'])[:, None, None]
    a = np.minimum(o * g, 0.99)                                       # alpha of each Gaussian at each pixel
    T = np.cumprod(np.concatenate([np.ones((1, H, W)), 1 - a[:-1]]), axis=0)   # transmittance in front
    w = a * T                                                          # compositing weights
    img = np.einsum('khw,kc->hwc', w, c)                              # black background adds nothing
    if target is None:
        return img
    # backward pass for the loss L = mean squared error (the chain rule written out by hand)
    G = 2 * (img - target) / target.size                               # dL/dimg, shape (H, W, 3)
    contrib = w[..., None] * c[:, None, None, :]                       # (K, H, W, 3)
    behind = np.cumsum(contrib[::-1], axis=0)[::-1] - contrib          # colour from Gaussians behind k
    dC_da = T[..., None] * c[:, None, None, :] - behind / (1 - a[..., None])
    da = np.einsum('khwc,hwc->khw', dC_da, G) * (o * g < 0.99)
    dq = da * o * g * -0.5                                             # through g = exp(-q / 2)
    grads = {
        'col': np.einsum('khw,hwc->kc', w, G) * c * (1 - c),
        'op': (da * g).sum((1, 2)) * sig(p['op']) * (1 - sig(p['op'])),
        'log_s': np.stack([(dq * -2 * u1 ** 2 / sx2).sum((1, 2)), (dq * -2 * u2 ** 2 / sy2).sum((1, 2))], 1),
        'theta': (dq * 2 * u1 * u2 * (1 / sx2 - 1 / sy2)).sum((1, 2)),
        'mu': -np.stack([(dq * (2 * u1 * ct / sx2 - 2 * u2 * st / sy2)).sum((1, 2)),
                         (dq * (2 * u1 * st / sx2 + 2 * u2 * ct / sy2)).sum((1, 2))], 1),
    }
    return img, grads

rng = np.random.default_rng(0)
K = 40
p = {'mu': rng.uniform(4, 44, (K, 2)), 'log_s': np.full((K, 2), np.log(3.0)), 'theta': rng.uniform(0, np.pi, K),
     'op': np.zeros(K), 'col': np.zeros((K, 3))}
lr = {'mu': 0.5, 'log_s': 0.05, 'theta': 0.05, 'op': 0.1, 'col': 0.1}
m = {k: np.zeros_like(v) for k, v in p.items()}; v2 = {k: np.zeros_like(v) for k, v in p.items()}

def psnr(img):
    return 10 * np.log10(1 / np.mean((img - target) ** 2))

for it in range(1, 501):
    img, gr = render(p, target)
    for k in p:                                                        # Adam update
        m[k] = 0.9 * m[k] + 0.1 * gr[k]; v2[k] = 0.999 * v2[k] + 0.001 * gr[k] ** 2
        p[k] -= lr[k] * (m[k] / (1 - 0.9 ** it)) / (np.sqrt(v2[k] / (1 - 0.999 ** it)) + 1e-8)
    if it in (1, 50, 100, 200, 500):
        print(f"iteration {it:3d}: PSNR {psnr(img):.2f} dB")
輸出
iteration   1: PSNR 11.32 dB
iteration  50: PSNR 20.88 dB
iteration 100: PSNR 21.85 dB
iteration 200: PSNR 23.12 dB
iteration 500: PSNR 23.57 dB
PSNR(定義見 DLCV 09)上升很快,然後在這次實驗中於 23.6 dB 附近持平。這個高原正是這個實驗的重點:只有固定數量的柔軟色塊時,尖銳的角落和三角形的細尖端都擬合不出來,而一開始就放在錯誤位置的色塊也會留在原地。這正是自適應密度控制要修正的問題,練習 4 請你把它加進去。圖 6 顯示擬合結果與最終的橢圓。
取得網格
白話版。 圖學引擎、物理模擬器與 3D 印表機要的是三角形。上面每一種表示法都需要一個轉換步驟才能得到三角形,而轉換本身也會帶來誤差。
Marching cubes
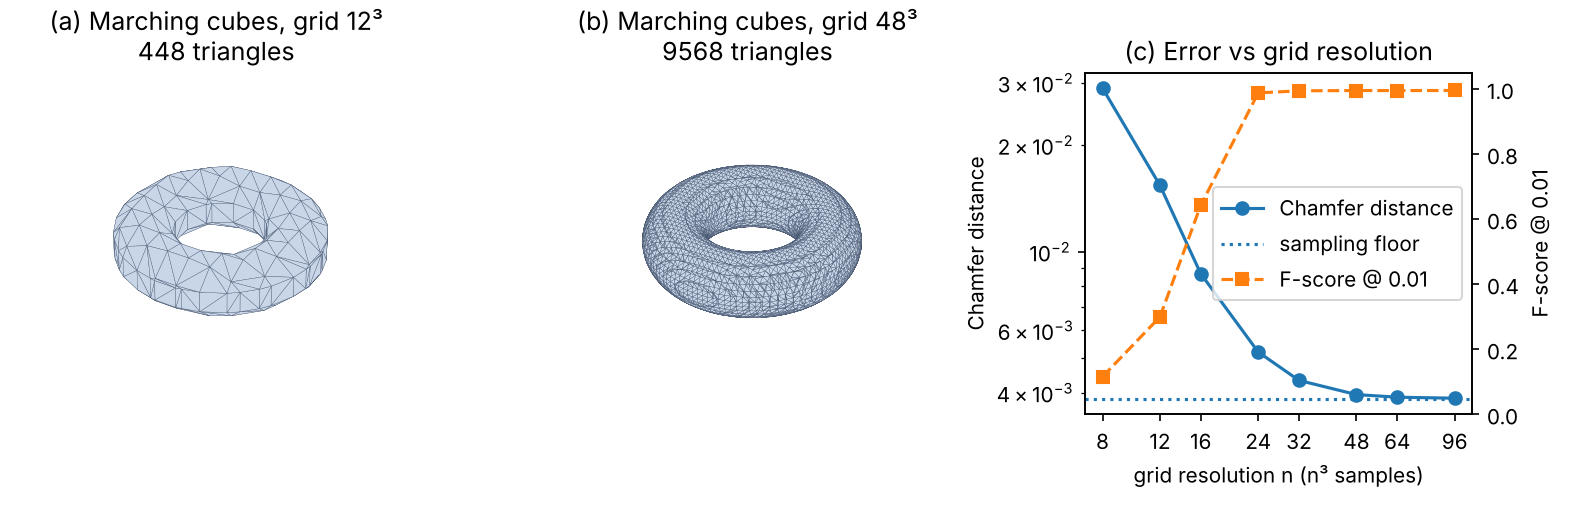
Marching cubes [24] 把取樣過的純量場(SDF、佔據或融合後的 TSDF)轉成某個等值面的三角形網格。它逐一走訪由八個相鄰格點取樣組成的每個立方體,看哪些角點在內部、哪些在外部,在符號改變的立方體邊上放置頂點(用場值的線性內插),再用查找表中的三角形把它們連起來。scikit-image 提供了實作 [46]。這段程式碼在幾種格網解析度下,萃取精確環面 SDF 的零等值面,並用下面評估一節定義的幾何指標來量測結果。
程式碼 · Python · 46 行
import numpy as np
from scipy.spatial import cKDTree
from skimage.measure import marching_cubes

R, r = 0.6, 0.25                                       # torus: ring radius R, tube radius r

def sdf_torus(x, y, z):
    """Exact signed distance to the torus (negative inside)."""
    return np.hypot(np.hypot(x, y) - R, z) - r

def sample_mesh(verts, faces, n, rng):
    """n points spread uniformly over the area of a triangle mesh."""
    tri = verts[faces]
    area = 0.5 * np.linalg.norm(np.cross(tri[:, 1] - tri[:, 0], tri[:, 2] - tri[:, 0]), axis=1)
    k = rng.choice(len(faces), n, p=area / area.sum())
    a, b = rng.random((2, n, 1))
    flip = a + b > 1; a[flip], b[flip] = 1 - a[flip], 1 - b[flip]
    return tri[k, 0] + a * (tri[k, 1] - tri[k, 0]) + b * (tri[k, 2] - tri[k, 0])

def sample_torus(n, rng):
    """n points uniform over the true torus surface (rejection sampling on the area element)."""
    u, v = rng.uniform(0, 2 * np.pi, (2, 3 * n))
    ok = rng.random(3 * n) * (R + r) < R + r * np.cos(v)   # keep with probability proportional to R + r cos v
    u, v = u[ok][:n], v[ok][:n]
    return np.c_[(R + r * np.cos(v)) * np.cos(u), (R + r * np.cos(v)) * np.sin(u), r * np.sin(v)]

def geometry_metrics(P, G, tau):
    """Accuracy, completeness, Chamfer (their mean) and F-score at threshold tau."""
    d_pg = cKDTree(G).query(P)[0]                      # each reconstructed point -> nearest true point
    d_gp = cKDTree(P).query(G)[0]                      # each true point -> nearest reconstructed point
    prec, rec = (d_pg < tau).mean(), (d_gp < tau).mean()
    return d_pg.mean(), d_gp.mean(), (d_pg.mean() + d_gp.mean()) / 2, 2 * prec * rec / (prec + rec)

rng = np.random.default_rng(0)
G = sample_torus(100_000, rng)
acc, comp, cd, fs = geometry_metrics(sample_torus(100_000, rng), G, tau=0.01)
print(f"true surface vs itself: Chamfer {cd:.4f} | F-score@0.01 {fs:.3f}   (the floor set by sampling)")
for n in [12, 24, 48, 96]:
    ax = np.linspace(-1, 1, n)
    vol = sdf_torus(*np.meshgrid(ax, ax, ax, indexing='ij'))
    verts, faces, _, _ = marching_cubes(vol, level=0.0, spacing=(ax[1] - ax[0],) * 3)
    verts -= 1.0                                       # grid index space -> world coordinates [-1, 1]
    P = sample_mesh(verts, faces, 100_000, rng)
    acc, comp, cd, fs = geometry_metrics(P, G, tau=0.01)
    print(f"grid {n:2d}^3: {len(faces):6d} triangles | acc {acc:.4f} comp {comp:.4f} "
          f"Chamfer {cd:.4f} | F-score@0.01 {fs:.3f} | max |SDF| on vertices {np.abs(sdf_torus(*verts.T)).max():.4f}")
輸出
true surface vs itself: Chamfer 0.0039 | F-score@0.01 0.995   (the floor set by sampling)
grid 12^3:    448 triangles | acc 0.0154 comp 0.0154 Chamfer 0.0154 | F-score@0.01 0.299 | max |SDF| on vertices 0.0084
grid 24^3:   2272 triangles | acc 0.0052 comp 0.0052 Chamfer 0.0052 | F-score@0.01 0.988 | max |SDF| on vertices 0.0032
grid 48^3:   9568 triangles | acc 0.0040 comp 0.0039 Chamfer 0.0040 | F-score@0.01 0.995 | max |SDF| on vertices 0.0008
grid 96^3:  38832 triangles | acc 0.0039 comp 0.0039 Chamfer 0.0039 | F-score@0.01 0.995 | max |SDF| on vertices 0.0002
這次實驗帶來兩個教訓。第一,即使在 12³ 的格網上,頂點也幾乎剛好落在曲面上(最大的 是 0.0084),但 Chamfer 距離卻是 0.0154:頂點之間的平坦三角形橫切過彎曲的管面。第二,指標在約 0.0039 就不再改善,因為把同一個真實曲面的兩次獨立隨機取樣互相比較,本來就是這個值。量到的誤差只有相對於這個底線才有意義,而這個底線取決於取樣了多少個點。圖 7 顯示網格與曲線。
Poisson 表面重建
當輸入是帶有法向量的點雲(例如來自 MVS)時,Poisson 表面重建 [25] 是標準工具。它尋找一個指示函數(indicator function)(內部為 1、外部為 0),使它的梯度與法向量相符,這就導出 Poisson 方程式 ,其中 是 Laplacian, 是由法向量建立的向量場;曲面是 的一個等值面 [25]。因為它一次用上所有的點,所以對雜訊很穩健 [25];屏蔽(screened)變體 [26] 還會把曲面拉向這些點。結果是不漏水的曲面,這很方便,但也表示資料中的破洞會被捏造出來的曲面補起來。
從高斯得到網格
3D 高斯並不定義曲面:最佳化之後,它們雜亂、互相重疊,而且常常和真實幾何對不齊。有兩條研究路線處理這個問題。SuGaR [27] 加入一個正則化項,鼓勵高斯平貼在曲面上,然後從高斯密度等值面上取樣的點,用 Poisson 重建萃取出網格,也可以選擇性地把新的高斯綁定到網格上,並一起精修兩者 [27]。2D Gaussian Splatting [28] 則改變基元:每個高斯是一個平坦、有方向的二維圓盤(曲面元素),用精確的光線–圓盤相交來算繪,再加上深度失真與法向量一致性損失。網格接著用 TSDF 融合把算繪出的深度圖融合得到 [28],與上面 Curless 和 Levoy 的方法是同一個想法。
前饋式重建
白話版。 到目前為止的方法,每次都只針對一個場景做最佳化。最新的模型只訓練一次,使用大量三維資料,之後給它新的照片,它就在一次傳遞中輸出相機以及每個像素對應的稠密三維點,不需要配對、RANSAC 或光束法平差。
DUSt3R [29] 輸入兩張內參與位姿都未知的影像,迴歸出兩張點圖(pointmap):對每張影像的每個像素,給出它所看到的三維點,兩者都表示在第一台相機的座標系中 [29]。點圖是一張有三個通道 的影像(圖 2 (h))。由它可以推得深度、焦距、相對位姿與像素對應。這個網路是 Transformer [48] 的編碼器–解碼器:兩張影像通過同一個 Vision Transformer 編碼器 [47],兩個解碼器透過交叉注意力交換資訊,再由迴歸頭輸出點圖與每個像素的信心值 [29]。輸出只定義到差一個未知的尺度 [29]。超過兩張影像時,DUSt3R 預測成對的點圖,再執行一次全域對齊,解出一組一致的點圖、位姿與每對影像的尺度,這是光束法平差在學習式幾何上的對應做法 [29]。
MASt3R [30] 加入一個輸出稠密局部特徵的頭(以匹配損失訓練),以及快速的互惠配對機制,讓點圖網路也能產生準確的像素對應 [30]。VGGT [31] 更進一步:一個大型 Transformer 以交替的逐畫面與全域注意力,接收一張、幾張或數百張影像,一次預測所有影像的相機參數、深度圖、點圖與點軌跡;作者報告這只需不到一秒,而且不需進一步處理就常常勝過以最佳化為基礎的替代方法 [31]。
這些模型並沒有讓幾何過時。它們的預測仍然可以精修:VGGT 的作者報告它的相機與軌跡是光束法平差很好的初始值,經過 BA 後準確度還能進一步提升 [31]。它們的準確度也取決於場景和訓練資料有多接近。不過,當影像很少、重疊很少或沒有校正時,它們是目前最好的工具。
動態場景(簡介)
白話版。 如果場景在動,單一個三維模型就不夠了:模型還必須依賴時間。
常見的做法是一個標準(靜態)場景,加上隨時間變化的形變。D-NeRF [32] 把時間當成輸入,並一起學習兩個網路:一個把場景編碼在標準空間中,另一個把標準場景對應到給定時間的形變狀態;它只需要一台繞著場景移動的相機 [32]。4D Gaussian Splatting [33] 保留同一組 3D 高斯,並用一個輕量 MLP 預測它們在每個時間點的形變,這個 MLP 的輸入是分解過的時空特徵網格;論文報告了即時算繪,例如在 RTX 3090 GPU 上以 800 × 800 解析度達到每秒 82 個畫面 [33]。動態重建比靜態重建的限制少得多,因為每個瞬間被看到的視角更少。
評估重建結果
白話版。 有兩件不同的事可以量測:從新視角算繪出來的畫面看起來像不像真的照片,以及形狀在幾何上對不對。一個方法可能其中一項做得很好,另一項卻很差。
新視角品質
留出一些照片,用它們的相機位姿算繪重建結果,再做比較。標準指標是 PSNR、SSIM [34] 與 LPIPS [35],全都定義在 DLCV 09。PSNR 與 SSIM 量測像素與結構的一致性;LPIPS 在深度特徵空間中量測感知相似度。常見的協定(3DGS 沿用自 Mip-NeRF 360)是把每次拍攝的每第 8 張照片留作測試集 [6]。新視角指標取決於留出的位姿是否正確,所以它們也會獎勵好的 SfM。
幾何準確度
令 為從重建結果取樣的點, 為從真值掃描取樣的點。定義兩個有方向的距離
其中 計算點的數目。準確度(accuracy)問的是「我的點離真值近嗎?」;完整度(completeness)問的是「真值是否全部被涵蓋?」。它們的和或平均是 Chamfer 距離,自 Fan 等人 [36] 以來被廣泛用作點集合的損失與指標,他們用的是平方距離的定義;各篇論文在是否平方、取總和還是平均上並不一致,所以比較數字前請先檢查定義。在 DTU 上,MVSNet 報告準確度與完整度的平均作為「整體」分數 [16]。
Tanks and Temples [38] 用門檻 而不是平均。令 為重建點到真值的距離, 為真值點到重建結果的距離,
其中 在條件成立時為 1,否則為 0, 是精確率(以百分比表示), 是召回率, 是它們的調和平均,即 F-score [38]。因為是調和平均,只有重建結果同時準確又完整時 才會高;一組稀疏但完美的點,或是填滿整個空間的點雲,兩者分數都很低 [38]。F-score 對少數遠處的離群值也很穩健,而這些離群值可能主導 Chamfer 的平均(練習 5)。
資料集與基準
- DTU [37]:包含 80 個桌面場景的多視角立體視覺資料集,每個場景有 49 或 64 個精確已知的相機位置(來自六軸工業機器人),參考幾何來自結構光掃描器 [37]。是 MVS 與神經曲面方法的標準資料集(NeuS 使用其中 15 個場景 [22])。
- Tanks and Temples [38]:在實驗室外拍攝的大型室內外場景的高解析度影片,真值來自工業雷射掃描器,分成中等與進階兩組,並在線上伺服器上用上面的 F-score 評估 [38]。
- Mip-NeRF 360 [39]:9 個無邊界場景(5 個室外、4 個室內),每個場景有一個中心物體與細節豐富的背景,為新視角合成而拍攝 [39]。3DGS 在它以及 Tanks and Temples 場景等資料上做評估 [6]。
失效模式
白話版。 上述方法依賴的證據與假設不同。傳統配對受益於穩定外觀、紋理與重疊視角;SfM 會估計相機姿態,不要求全部預先已知 [2]。NeRF 明確建模隨視角改變的顏色,但原始形式使用已知姿態 [5];DUSt3R 則能在沒有先驗相機校正與姿態的情況下推論幾何 [29]。靜態場景方法需要擴充才能處理動態。下列失效模式指出缺少哪些資訊、哪些假設受到挑戰,並非所有方法都有相同限制。
- 無紋理表面(白牆、天空)。光度一致性在每個深度都相同,如同平面掃描那次實驗;重建結果會有破洞或雜訊。學習式 MVS 與前饋式模型用學到的先驗把它們補起來,而那些先驗可能是錯的。
- 反光與透明表面。 鏡子或有光澤的汽車會顯示一個反射的場景,而它移動的方式和表面不同,所以配對與密度都會出錯。NeRF 傾向用藏在半透明表面底下、位於物體內部的光源來偽造亮面反光;Ref-NeRF [40] 則改為建模繞表面法向量反射的輻射,改善了鏡面表面 [40]。
- 視角太少。 只有兩三張影像時,許多場景都能同樣好地解釋這些照片,逐場景最佳化會過度擬合(訓練視角很好,新視角卻壞掉)。像 DUSt3R [29] 這類前饋式模型是常見的解決辦法。
- 漂浮物。 自由空間中半透明的密度團塊,常常靠近相機,從訓練視角看起來沒問題,但從新視角看就像霧。Mip-NeRF 360 為它們命名,並加入以失真為基礎的正則化項來抑制它們 [39];3DGS 為了同樣的原因會定期重設不透明度 [6]。
- 尺度模糊。 單眼影像集合只能把幾何固定到差一個尺度;要得到公制大小,需要已知距離、校正過的相機組,或其他感測器 [1]。
- 位姿誤差。 NeRF 與 3DGS 假設位姿準確;小誤差就會讓細節變模糊。BARF [41] 同時最佳化位姿與輻射場,並對位置編碼使用由粗到細的排程,因為高頻否則會妨礙對位 [41]。
- 移動的物體與光照變化,例如拍攝過程中有人走過或太陽移動,破壞的是靜態場景這個假設本身。
現代觀點
綜述論文怎麼說
有四篇回顧為本篇定下架構。Seitz 等人 [42] 為多視角立體視覺建立了傳統的分類法,至今仍能描述這裡的每一種方法:場景表示法、光度一致性量測、可見性模型、形狀先驗、重建演算法,以及對初始化的需求。Furukawa 與 Hernández [43] 把 MVS 呈現為由兩個要素組成的影像–幾何一致性最佳化:穩健的光度一致性量測與有效率的最佳化,並回顧成功的演算法與尚存的挑戰。Tewari 等人 [44] 回顧神經算繪,從場景表示法與可微分的影像形成,到新視角合成、跨場景泛化、動態內容、編輯與重新打光等應用,並列出尚未解決的問題,例如與傳統圖學工具的整合,以及可解釋性。Chen 與 Wang [45] 回顧 3D Gaussian Splatting:它的原理與最佳化、延伸它的七個方向、應用,以及效能比較;他們指出研究重心正從逐場景最佳化,轉向前饋式的高斯預測。
選讀:「現代觀點」綜述導讀(見「論文導讀」頁)。每篇回顧涵蓋什麼、如何整理這個領域,以及可以從中帶走什麼。
2023–2026 的最新進展
- 明確、可光柵化的表示法贏得了速度競賽。自 3DGS [6] 以來,大量的視角合成工作建立在高斯基元之上。3DGS 綜述 [45] 把後續工作分成稀疏輸入、省記憶體、逼真的變體、更好的最佳化、帶有額外屬性的高斯、混合表示法,以及新的算繪演算法;幾何(SuGaR [27]、2DGS [28])與動態(4DGS [33])本身就是活躍的方向。
- NeuS 這一系的神經隱式曲面 [22],在不漏水又準確的曲面比算繪速度重要時,仍是首選。
- 前饋式幾何是最大的改變。DUSt3R [29]、MASt3R [30] 與 VGGT [31] 直接從影像估計相機與稠密幾何;它們越來越常被用來初始化或取代傳統 SfM 流程的部分環節,3DGS 綜述 [45] 也描述了高斯上的同樣趨勢。
- 傳統流程仍是基準。 COLMAP [2]、[3] 仍是訓練與評估時相機位姿的常用來源,光束法平差也仍用來精修學習式的預測。
尚未解決的問題
- 幾何與外觀兼顧。 為新視角調校的方法產生的曲面很差,而曲面準確的方法算繪得比較不逼真。能快速兼顧兩者的單一表示法仍未出現。
- 反射、透明與光照。 把表面、材質與照明分開(逆向算繪,inverse rendering),對真實拍攝的資料仍未解決。
- 前饋式模型的泛化:遠離訓練分布時的準確度、公制尺度,以及非常大的場景。
- 動態與野外拍攝:有移動的人、變化的光線與很少的視角。
- 評估。 「真值」中的位姿誤差、與取樣有關的 Chamfer 數字,以及不一致的指標定義,讓跨論文比較很脆弱。
重點整理
- 場景重建需要相機幾何及適合輸出的表示;僅靠影像重建可能留下尺度歧義。
- 投影、對應與三角測量連結影像量測及三維結構。
- 運動恢復結構估計相機與稀疏結構,密集重建則加入更多對應假設。
- 神經場最佳化算繪觀測,良好新視角合成不單獨證明表面準確。
- 高斯與前饋表示改變算繪或推論成本,仍須檢查幾何。
- 報告視角指標及幾何準確度/完整度,並註明對齊、取樣與門檻。
練習
- 手算深度誤差。 一對校正過的立體影像, 像素,基線 m。用 ,如果視差差了 0.5 像素, m 的點深度誤差有多大? 要多大才能把誤差壓到 2 公分以下?
提示
m。解 得 m。基線變寬有幫助,但也會讓兩個視角看起來差異更大,使配對更困難。
- 看見尺度模糊。 在兩視角的程式碼中,投影之前把所有場景點
X與相機中心C2都乘以 3。證明像素座標不變,且估計出的位姿相同。列出三種可以固定尺度的外部資訊。
提示
投影要除以深度,所以把 和 一起縮放會抵消:。外部資訊:場景中量到的距離(尺或已知大小的標記)、立體相機組的已知基線,或其他感測器,例如慣性測量單元或 GPS。
- 讀懂權重。 在體積算繪的程式碼中,證明 。然後移除霧的那一層,重新計算深度。為什麼穿過霧的光線的「深度」不是任何一個表面的深度?
提示
用歸納法:,所以 ,總和可以逐項消去,得到 。沒有霧時,所有權重都落在紅色層上,深度接近 3。有霧時, 是兩個不同位置的平均,所以可能落在空白空間;漂浮物就是這樣破壞深度圖的。
- 加入自適應密度控制。 擴充二維 splatting 的程式碼:每 100 次迭代,找出累積位置梯度最大的高斯;複製小的、分裂大的(尺度除以 1.6),並移除不透明度低於 0.02 的高斯。把最後的 PSNR 與固定 40 個高斯的版本比較,也與單純從 80 個高斯開始的版本比較。
提示
陣列變大時,Adam 的動差陣列 m 與 v2 也必須跟著變大(新增的列初始化為零)。供參考:單純從 80 個高斯而不是 40 個開始、其他都不變,在我們的實驗中第 500 次迭代達到 27.00 dB(40 個時是 23.57 dB)。加密應該把新的高斯放在誤差所在之處,例如三角形的角落。
- Chamfer 與 F-score。 在 marching cubes 的程式碼中(格網 48),先在 附近加入 1,000 個「漂浮物」點,然後改成刪掉 的那一半網格取樣。重新計算準確度、完整度、Chamfer 距離與 F-score。哪個指標對哪種缺陷有反應?
提示
在我們的實驗中,漂浮物(占 1% 的點)讓準確度從 0.0040 升到 0.0097,Chamfer 距離從 0.0040 升到 0.0068,而門檻 0.01 的 F-score 幾乎沒動(0.995 到 0.990)。刪掉一半曲面後,準確度維持在 0.0040,但完整度升到 0.2226,Chamfer 距離升到 0.1133,F-score 降到 0.665。平均值對少數遠處的離群值很敏感;設門檻的分數則不會,但它們透過召回率清楚反映出缺少的部分。
- 平面掃描的視窗大小。 用 3、7 與 15 像素的 SSD 視窗執行平面掃描的程式碼。有紋理與無紋理的分數如何變化?方塊的邊緣又發生什麼事?
提示
在我們的實驗中,有紋理的分數是 95.2%、95.3% 與 96.6%,無紋理的分數是 4.9%、14.8% 與 27.7%。大視窗會碰到平坦區塊外面的紋理,所以區塊內的像素從周圍借用深度;代價是深度邊緣變模糊,方塊看起來被「撐胖」進背景。學習式 MVS 用三維 CNN 取得這種脈絡,卻不產生模糊。
本篇建立的場景模型,也是 DLCV 13 世界模型的建構元件,在那裡,代理人必須預測三維環境如何變化。
參考文獻
- R. Hartley and A. Zisserman, Multiple View Geometry in Computer Vision, 2nd ed., Cambridge University Press, 2004. doi
- J. L. Schönberger and J.-M. Frahm, “Structure-from-motion revisited,” in Proc. IEEE CVPR, 2016. CVF
- J. L. Schönberger, E. Zheng, J.-M. Frahm and M. Pollefeys, “Pixelwise view selection for unstructured multi-view stereo,” in Proc. ECCV, 2016. doi
- J. L. Schönberger et al., “COLMAP,” official documentation (general-purpose structure-from-motion and multi-view stereo pipeline). link
- B. Mildenhall, P. P. Srinivasan, M. Tancik, J. T. Barron, R. Ramamoorthi and R. Ng, “NeRF: Representing scenes as neural radiance fields for view synthesis,” in Proc. ECCV, 2020; also Communications of the ACM, vol. 65, no. 1, pp. 99–106, 2022. doi · CACM doi · arXiv
- B. Kerbl, G. Kopanas, T. Leimkühler and G. Drettakis, “3D Gaussian Splatting for real-time radiance field rendering,” ACM Transactions on Graphics, vol. 42, no. 4, 2023. doi · arXiv
- H. C. Longuet-Higgins, “A computer algorithm for reconstructing a scene from two projections,” Nature, vol. 293, pp. 133–135, 1981. doi
- R. I. Hartley, “In defense of the eight-point algorithm,” IEEE TPAMI, vol. 19, no. 6, pp. 580–593, 1997. doi
- D. Nistér, “An efficient solution to the five-point relative pose problem,” IEEE TPAMI, vol. 26, no. 6, pp. 756–770, 2004. doi
- M. A. Fischler and R. C. Bolles, “Random sample consensus: A paradigm for model fitting with applications to image analysis and automated cartography,” Communications of the ACM, vol. 24, no. 6, pp. 381–395, 1981. doi
- D. G. Lowe, “Distinctive image features from scale-invariant keypoints,” International Journal of Computer Vision, vol. 60, no. 2, pp. 91–110, 2004. doi
- N. Snavely, S. M. Seitz and R. Szeliski, “Photo tourism: Exploring photo collections in 3D,” ACM Transactions on Graphics, vol. 25, no. 3, pp. 835–846, 2006. doi
- B. Triggs, P. F. McLauchlan, R. I. Hartley and A. W. Fitzgibbon, “Bundle adjustment — A modern synthesis,” in Vision Algorithms: Theory and Practice, LNCS 1883, pp. 298–372, Springer, 2000. doi
- R. T. Collins, “A space-sweep approach to true multi-image matching,” in Proc. IEEE CVPR, pp. 358–363, 1996. doi
- B. Curless and M. Levoy, “A volumetric method for building complex models from range images,” in Proc. SIGGRAPH, pp. 303–312, 1996. doi
- Y. Yao, Z. Luo, S. Li, T. Fang and L. Quan, “MVSNet: Depth inference for unstructured multi-view stereo,” in Proc. ECCV, 2018. CVF · doi
- N. Max, “Optical models for direct volume rendering,” IEEE Transactions on Visualization and Computer Graphics, vol. 1, no. 2, pp. 99–108, 1995. doi
- M. Tancik, P. P. Srinivasan, B. Mildenhall, S. Fridovich-Keil, N. Raghavan, U. Singhal, R. Ramamoorthi, J. T. Barron and R. Ng, “Fourier features let networks learn high frequency functions in low dimensional domains,” in Proc. NeurIPS, 2020. proceedings
- T. Müller, A. Evans, C. Schied and A. Keller, “Instant neural graphics primitives with a multiresolution hash encoding,” ACM Transactions on Graphics, vol. 41, no. 4, 2022. doi · arXiv
- J. J. Park, P. Florence, J. Straub, R. Newcombe and S. Lovegrove, “DeepSDF: Learning continuous signed distance functions for shape representation,” in Proc. IEEE/CVF CVPR, 2019. CVF
- L. Mescheder, M. Oechsle, M. Niemeyer, S. Nowozin and A. Geiger, “Occupancy networks: Learning 3D reconstruction in function space,” in Proc. IEEE/CVF CVPR, 2019. CVF
- P. Wang, L. Liu, Y. Liu, C. Theobalt, T. Komura and W. Wang, “NeuS: Learning neural implicit surfaces by volume rendering for multi-view reconstruction,” in Proc. NeurIPS, 2021. proceedings · arXiv
- M. Zwicker, H. Pfister, J. van Baar and M. Gross, “EWA volume splatting,” in Proc. IEEE Visualization, 2001. doi
- W. E. Lorensen and H. E. Cline, “Marching cubes: A high resolution 3D surface construction algorithm,” in Proc. SIGGRAPH, pp. 163–169, 1987. doi
- M. Kazhdan, M. Bolitho and H. Hoppe, “Poisson surface reconstruction,” in Proc. Eurographics Symposium on Geometry Processing, 2006. doi
- M. Kazhdan and H. Hoppe, “Screened Poisson surface reconstruction,” ACM Transactions on Graphics, vol. 32, no. 3, 2013. doi
- A. Guédon and V. Lepetit, “SuGaR: Surface-aligned Gaussian splatting for efficient 3D mesh reconstruction and high-quality mesh rendering,” in Proc. IEEE/CVF CVPR, 2024. CVF · arXiv
- B. Huang, Z. Yu, A. Chen, A. Geiger and S. Gao, “2D Gaussian splatting for geometrically accurate radiance fields,” in Proc. SIGGRAPH (Conference Papers), 2024. doi · arXiv
- S. Wang, V. Leroy, Y. Cabon, B. Chidlovskii and J. Revaud, “DUSt3R: Geometric 3D vision made easy,” in Proc. IEEE/CVF CVPR, 2024. CVF · arXiv
- V. Leroy, Y. Cabon and J. Revaud, “Grounding image matching in 3D with MASt3R,” in Proc. ECCV, 2024. doi · arXiv
- J. Wang, M. Chen, N. Karaev, A. Vedaldi, C. Rupprecht and D. Novotny, “VGGT: Visual geometry grounded transformer,” in Proc. IEEE/CVF CVPR, 2025. CVF · arXiv
- A. Pumarola, E. Corona, G. Pons-Moll and F. Moreno-Noguer, “D-NeRF: Neural radiance fields for dynamic scenes,” in Proc. IEEE/CVF CVPR, 2021. CVF
- G. Wu, T. Yi, J. Fang, L. Xie, X. Zhang, W. Wei, W. Liu, Q. Tian and X. Wang, “4D Gaussian splatting for real-time dynamic scene rendering,” in Proc. IEEE/CVF CVPR, 2024. CVF · arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image quality assessment: From error visibility to structural similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The unreasonable effectiveness of deep features as a perceptual metric,” in Proc. IEEE/CVF CVPR, 2018. CVF
- H. Fan, H. Su and L. J. Guibas, “A point set generation network for 3D object reconstruction from a single image,” in Proc. IEEE CVPR, 2017. CVF
- R. Jensen, A. Dahl, G. Vogiatzis, E. Tola and H. Aanæs, “Large scale multi-view stereopsis evaluation,” in Proc. IEEE CVPR, pp. 406–413, 2014. doi
- A. Knapitsch, J. Park, Q.-Y. Zhou and V. Koltun, “Tanks and Temples: Benchmarking large-scale scene reconstruction,” ACM Transactions on Graphics, vol. 36, no. 4, 2017. doi · benchmark
- J. T. Barron, B. Mildenhall, D. Verbin, P. P. Srinivasan and P. Hedman, “Mip-NeRF 360: Unbounded anti-aliased neural radiance fields,” in Proc. IEEE/CVF CVPR, 2022. CVF · arXiv
- D. Verbin, P. Hedman, B. Mildenhall, T. Zickler, J. T. Barron and P. P. Srinivasan, “Ref-NeRF: Structured view-dependent appearance for neural radiance fields,” in Proc. IEEE/CVF CVPR, 2022. CVF
- C.-H. Lin, W.-C. Ma, A. Torralba and S. Lucey, “BARF: Bundle-adjusting neural radiance fields,” in Proc. IEEE/CVF ICCV, 2021. CVF
- S. M. Seitz, B. Curless, J. Diebel, D. Scharstein and R. Szeliski, “A comparison and evaluation of multi-view stereo reconstruction algorithms,” in Proc. IEEE CVPR, vol. 1, pp. 519–528, 2006. doi
- Y. Furukawa and C. Hernández, “Multi-view stereo: A tutorial,” Foundations and Trends in Computer Graphics and Vision, vol. 9, no. 1–2, pp. 1–148, 2015. doi
- A. Tewari, J. Thies, B. Mildenhall, P. Srinivasan, E. Tretschk, W. Yifan, C. Lassner, V. Sitzmann et al., “Advances in neural rendering,” Computer Graphics Forum, vol. 41, no. 2, pp. 703–735, 2022. doi · arXiv
- G. Chen and W. Wang, “A survey on 3D Gaussian splatting,” ACM Computing Surveys, vol. 58, no. 12, 2026. doi · arXiv
- scikit-image contributors, “skimage.measure.marching_cubes,” scikit-image documentation (API reference). docs
- A. Dosovitskiy, L. Beyer, A. Kolesnikov, D. Weissenborn, X. Zhai et al., “An image is worth 16x16 words: Transformers for image recognition at scale,” in Proc. ICLR, 2021. arXiv
- A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, Ł. Kaiser and I. Polosukhin, “Attention is all you need,” in Proc. NeurIPS, 2017. proceedings
- D. P. Kingma and J. Ba, “Adam: A method for stochastic optimization,” in Proc. ICLR, 2015. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 11A・深度估計與光流 · 34 分鐘