DLCV 04・影像分割:語意、實例與全景分割
先備知識:DLCV 03・物件偵測:從 R-CNN 到 DETR、IP 10・影像分割(一):邊緣偵測、閾值化與區域偵測
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
模擬一個以較粗的輸出步幅(stride)做預測的分割網路,比較像素準確率、平均 IoU 與最小類別的 IoU。
你將學到
- 區分語意、實例與全景分割的輸出要求。
- 追蹤全卷積網路、解碼器與跳接中的解析度。
- 為類別不平衡與邊界敏感任務選擇損失。
- 計算並解讀 mIoU、mask AP 與全景品質。
- 比較遮罩分類、可提示分割與開放詞彙介面。
先看全貌
偵測器為每個物體畫一個方框(DLCV 03)。方框只是粗略的答案:它包含背景像素,也沒有說出物體的精確輪廓。分割(segmentation)給出精確的答案:它替每個像素決定「這個像素屬於什麼」。
為什麼重要:自駕車需要知道哪些像素是可行駛的路面,而不只是「這個框裡某處有一條路」。放射科醫師量測腫瘤,需要它的精確面積。要把一個人從照片中移除的修圖軟體,需要這個人的輪廓。抓取物體的機器人、拍到農田與森林的衛星影像、醫學掃描,都需要逐像素的答案。
本篇是兩篇經典章節的深度學習續篇。IP 10 與 IP 11 用門檻、區域生長、圖切割(graph cut)、分水嶺與主動輪廓來分割影像,完全不需要訓練資料;本篇則是從有標註的範例中學出分割。DLCV 03 介紹過方框、IoU、錨框、特徵金字塔、focal loss 與 Mask R-CNN;這些想法我們直接沿用並連結回去,不重複說明。可提示的 Segment Anything 模型在 DLCV 01 與 ML 10 介紹過,這裡只說明它們在各種任務中的位置。三篇綜述勾勒出這個領域:Minaee 等人談 CNN 時代 [1],Li 等人談以 Transformer 為基礎的分割 [2],Zhou 等人談結合基礎模型的分割 [3]。我們會在「現代觀點」回頭討論。
三個任務,一張標籤圖
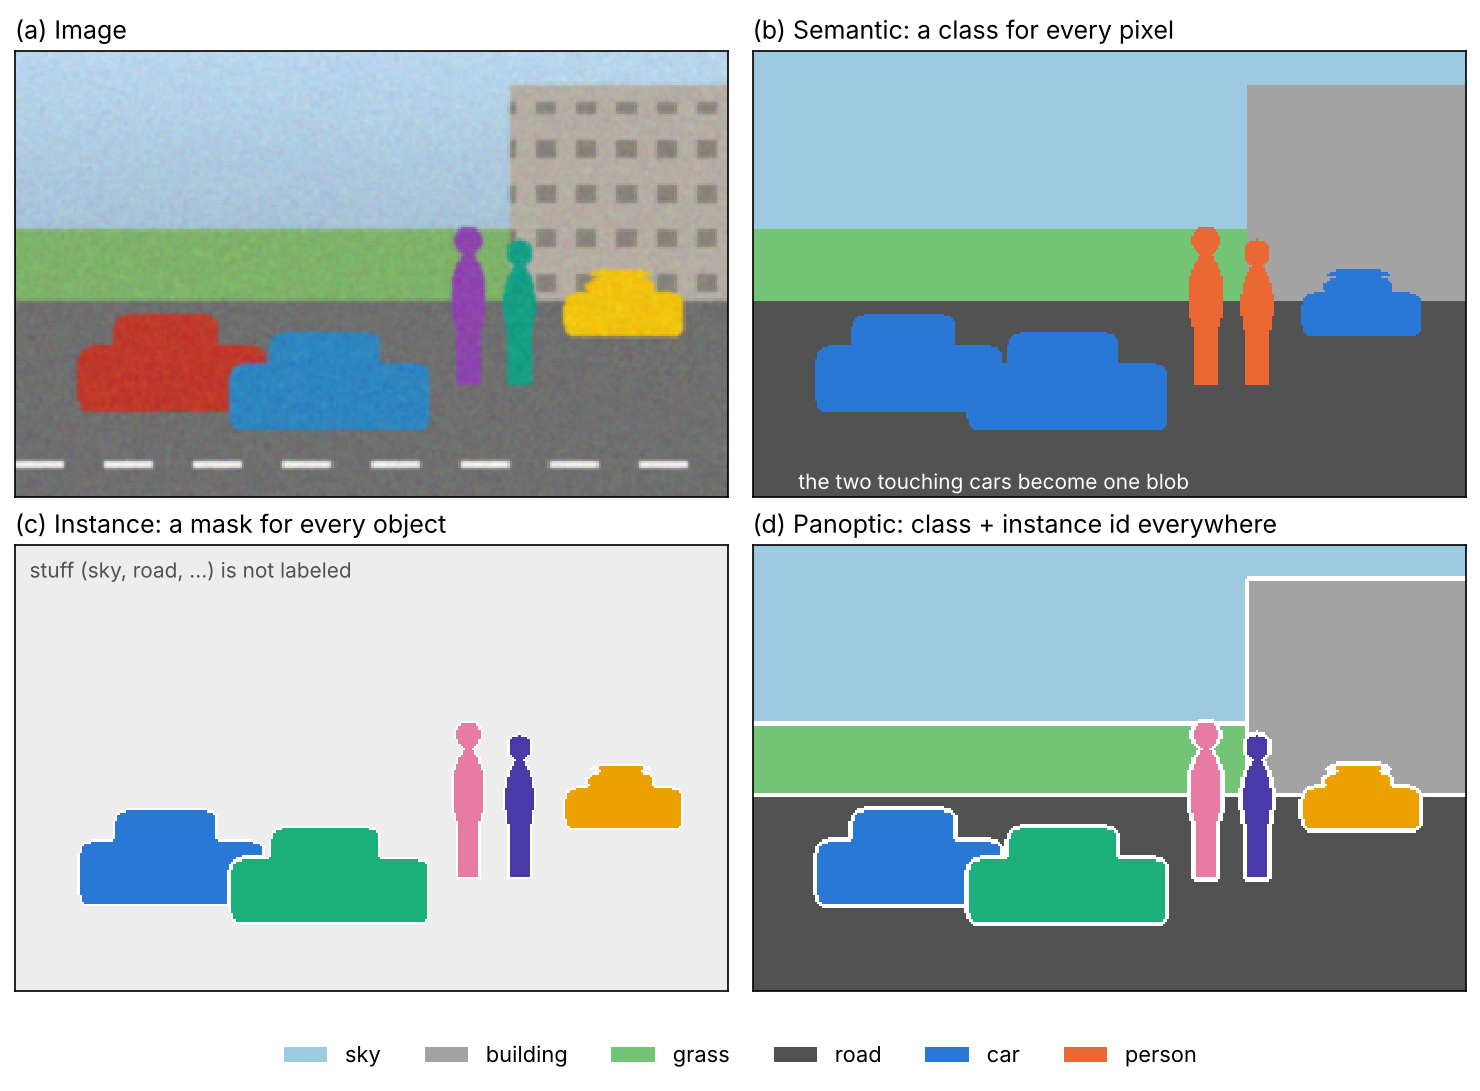
白話版。 語意分割為像素分類,實例分割區分物件,全景分割則結合類別與適用的物件身分。
精確版。 設 為 影像的像素位置集合, 為類別標籤。
- 語意分割預測一張標籤圖 ,每個像素 有一個類別 。它不區分同一類別的兩個物體。
- 實例分割預測一個集合 ,其中 是二值遮罩, 是它的類別, 是信心分數, 隨影像而變。遮罩之間可以重疊,而且只會分割可數的物體類別。它就是「輸出遮罩而不是方框」的偵測。
- 全景分割 [4] 把每個像素 對應到一個數對 ,其中 是類別, 是實例編號(instance id)。具有相同數對的像素組成一個區段(segment)。由於每個像素只帶一個數對,區段不能重疊,也不需要信心分數。
全景分割的論文沿用視覺領域的一個舊區分,替兩種類別命名。Things 是形狀明確、可以數的物體,例如人、車與動物。Stuff 是質地或材質相近的無定形區域,例如天空、馬路與草地 [4]。對 stuff 類別而言,實例編號會被忽略:一張影像裡所有的天空是同一個區段。哪些類別算 stuff、哪些算 things,由各資料集自行設計。含糊不清或不屬於任何類別的像素會得到特殊的 void 標籤,並且不參與評估。
| 語意 | 實例 | 全景 | |
|---|---|---|---|
| 標籤 | 每個像素一個類別 | 每個物體一個遮罩+類別+分數 | 每個像素一個(類別,實例編號) |
| 涵蓋的類別 | stuff 與 things | 僅 things | stuff 與 things |
| 允許重疊 | 否 | 是 | 否 |
| 信心分數 | 無 | 有 | 無 |
| 標準指標 | mean IoU | mask AP | 全景品質(PQ) |
這張表說明了為什麼這三種任務長期各有各的方法:它們的輸出形狀不同,每個指標獎勵的東西也不同。本篇大致依這段歷史展開:先是語意分割的逐像素分類器,接著是以偵測器為基礎的實例分割,然後是迫使兩者會合的全景任務,最後是能處理三種任務的單一架構。
從分類器到逐像素分類器
白話版。 保留空間特徵,不做全域池化;先預測類別分數格點,再上採樣至影像大小。
全卷積網路
Long、Shelhamer 與 Darrell 的全卷積網路(fully convolutional network, FCN)[5] 把分類網路的全連接層換成卷積。卷積可以處理任意大小的輸入,所以網路現在把 的影像對應成一張分數圖
其中 是類別數, 是輸出步幅(output stride),也就是輸入解析度與分數圖解析度的比值。分類骨幹網路會反覆地池化並加大步幅;對 FCN 當初採用的那些網路而言 ,所以一張 的影像只會得到 的類別分數格點。每個分數向量 概括了影像中很大的一塊視窗,這對辨認「是什麼」很好;但一格就涵蓋 個像素,對於說出邊界「確切落在哪裡」就很差。
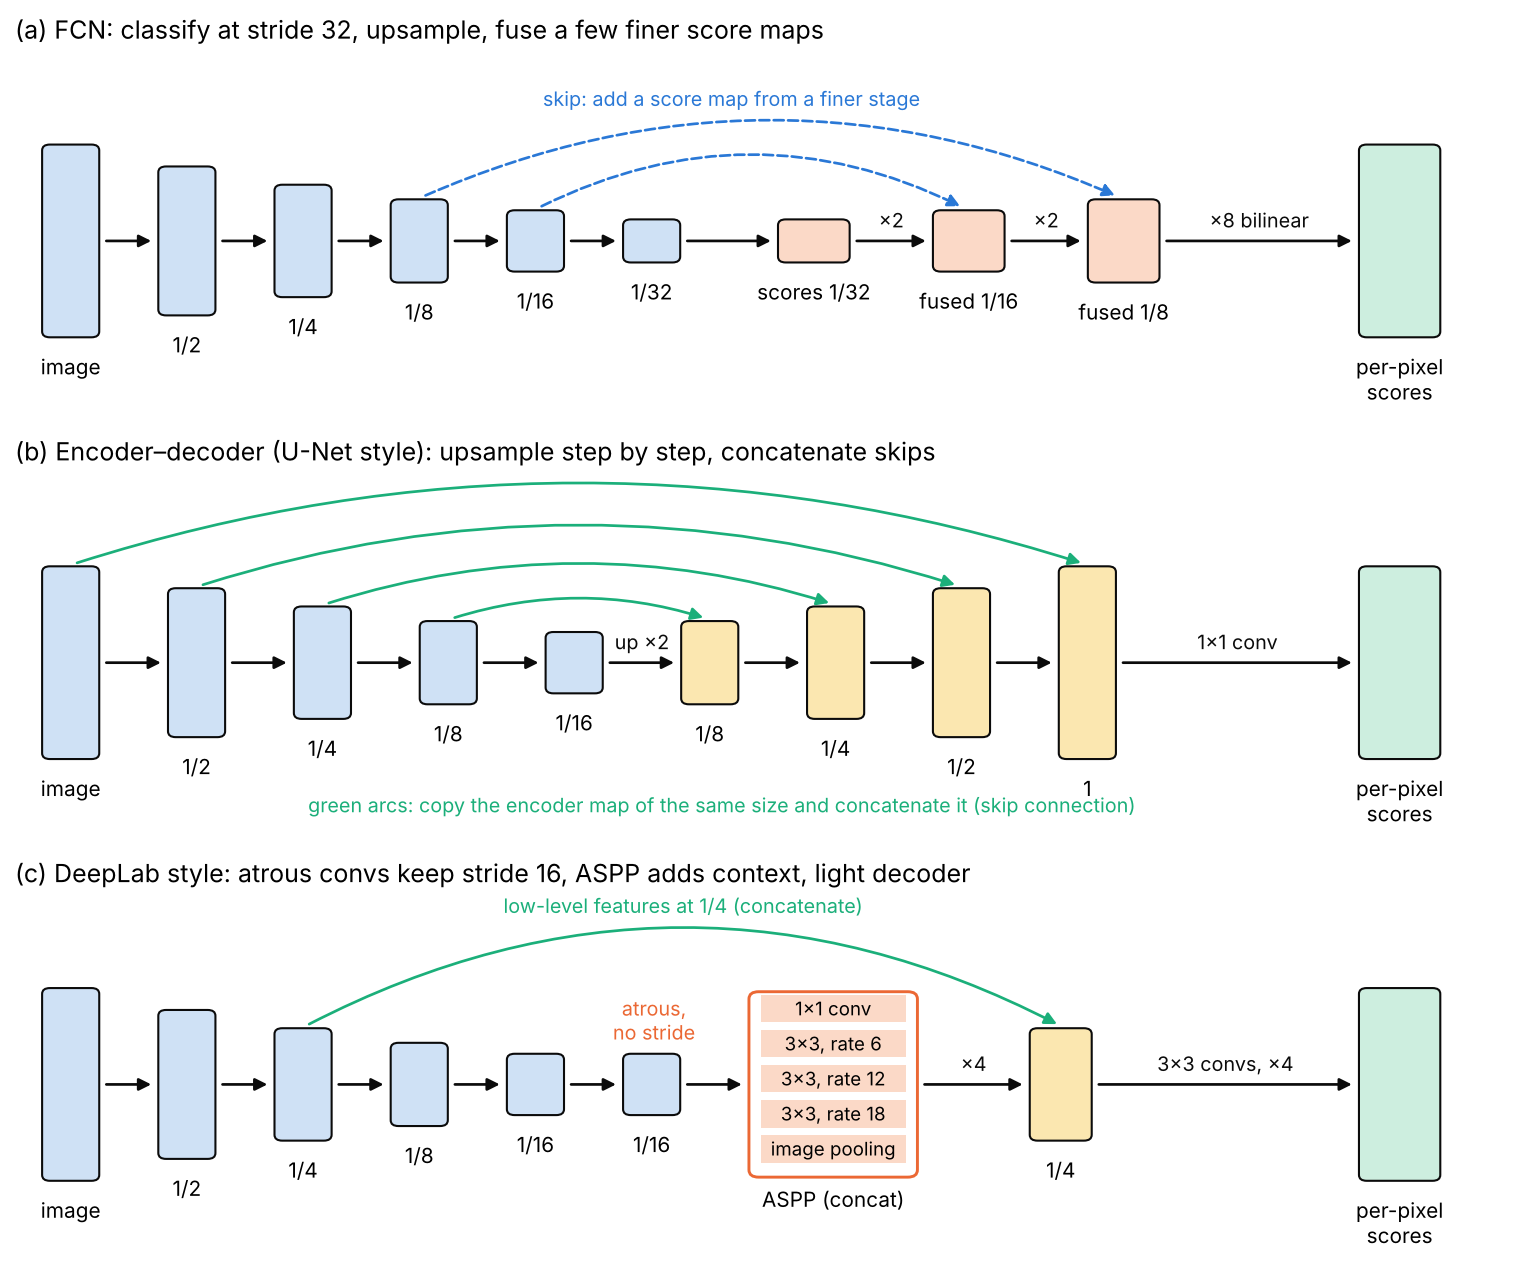
FCN 把分數 上取樣到輸入大小後,用逐像素交叉熵損失端到端地訓練整個網路,起點是為分類預訓練好的權重。為了找回細節,它融合更精細層的預測:步幅 32 的分數先上取樣 2 倍,再加上由步幅 16 那一層算出的分數圖,然後對步幅 8 再做一次。論文把三個版本稱為 FCN-32s、FCN-16s 與 FCN-8s,並顯示每多融合一個更精細的層,輪廓就更細緻 [5]。它的概念可以用一句話概括整個領域:把來自深而粗的層的「是什麼」,與來自淺而細的層的「在哪裡」結合起來。DLCV 01 在編碼器–解碼器那一節也介紹過同一個想法。
上取樣分數,不是標籤
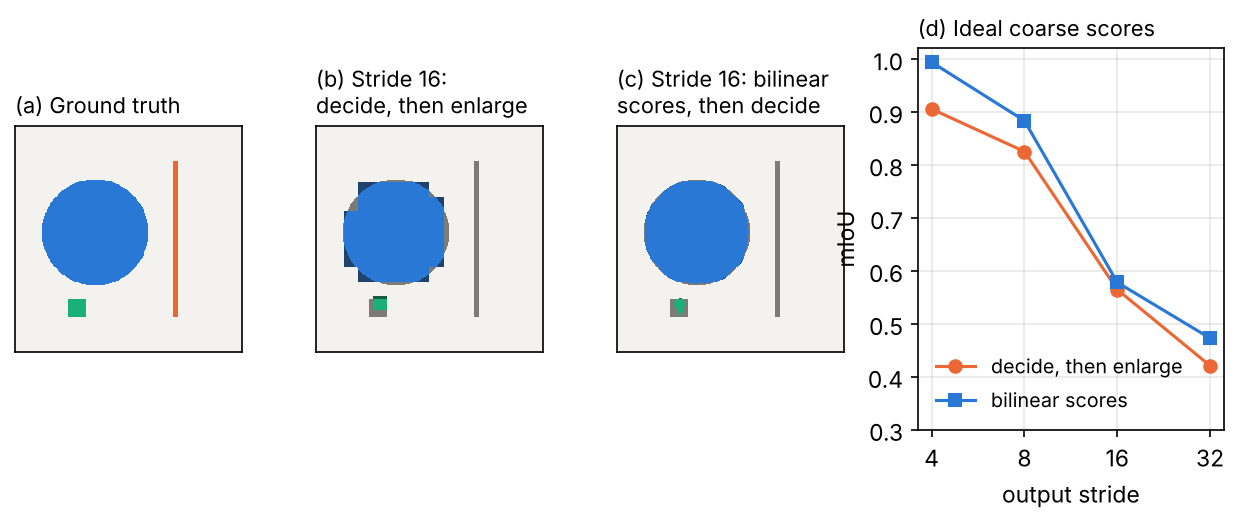
白話版。 如果先在低解析度決定類別,再把決定放大,每條邊界都會變成由 方塊組成的階梯。如果先把分數平滑地放大,再逐像素決定,邊界就會落在格點之間。
雙線性內插(bilinear interpolation)用最近的四個粗格點算出細位置的分數。對於位在粗座標 的細像素,其中 是整數、,
其中 是類別 的分數圖, 是內插後的分數。預測的標籤是 。FCN 把上取樣實作成以雙線性內插初始化的步幅轉置卷積,並讓網路自己學習它 [5];轉置卷積在 ML 03 說明過。後來的多數模型在最後一步直接使用固定的雙線性上取樣。
下面的實驗單獨觀察輸出步幅的影響。它建立一張理想的粗分數圖:每個 格子裡各類別所占的比例,也就是步幅為 的輸出頭(head)的理想輸出;然後比較「放大」與「決定」兩種先後順序。
程式碼 · Python · 28 行
import numpy as np
from scipy import ndimage as ndi

# Synthetic ground truth: 0 background, 1 large disk, 2 thin bar, 3 small square
H = W = 256
yy, xx = np.mgrid[0:H, 0:W]
gt = np.zeros((H, W), int)
gt[(yy - 120) ** 2 + (xx - 90) ** 2 < 60 ** 2] = 1
gt[40:216, 178:184] = 2                        # 6 pixels wide
gt[196:216, 60:80] = 3                         # 20 x 20 pixels
K = 4

def iou_per_class(gt, pred, K):
    return np.array([((gt == k) & (pred == k)).sum() / ((gt == k) | (pred == k)).sum()
                     for k in range(K)])

onehot = np.stack([(gt == k).astype(float) for k in range(K)])
print("stride | nearest labels: mIoU (per class) | bilinear scores: mIoU (per class)")
for s in [4, 8, 16, 32]:
    # ideal stride-s scores: the class fractions inside each s x s cell
    coarse = onehot.reshape(K, H // s, s, W // s, s).mean(axis=(2, 4))
    # (a) decide at low resolution, then enlarge the label map
    lab_nn = np.kron(coarse.argmax(0), np.ones((s, s), int))
    # (b) enlarge the scores with bilinear interpolation, then decide per pixel
    up = np.stack([ndi.zoom(c, s, order=1, mode="nearest", grid_mode=True) for c in coarse])
    lab_bi = up.argmax(0)
    a, b = iou_per_class(gt, lab_nn, K), iou_per_class(gt, lab_bi, K)
    print(f"{s:6d} | {a.mean():.3f} {np.round(a, 2)} | {b.mean():.3f} {np.round(b, 2)}")
輸出
stride | nearest labels: mIoU (per class) | bilinear scores: mIoU (per class)
     4 | 0.906 [0.99 0.97 0.67 1.  ] | 0.994 [1.   1.   0.99 0.99]
     8 | 0.825 [0.98 0.93 0.75 0.64] | 0.883 [0.99 0.99 0.7  0.86]
    16 | 0.565 [0.95 0.89 0.   0.41] | 0.578 [0.97 0.97 0.   0.37]
    32 | 0.421 [0.92 0.76 0.   0.  ] | 0.473 [0.96 0.93 0.   0.  ]
這個小實驗有三個教訓(數字來自上面的程式,不是來自任何論文)。第一,對分數做雙線性上取樣幾乎不花成本,而且對大圓盤而言總是至少一樣好。第二,沒有任何上取樣能找回粗格點從來沒看見的東西:在步幅 16 時,6 像素寬的長條在每個格子裡都是少數而消失了;在步幅 32 時,20 像素的方塊也消失了。細小的結構需要小的輸出步幅,或是能把精細特徵帶回來的解碼器。第三,mean IoU 對這些損失的懲罰很重,因為長條與方塊和背景的權重一樣(圖 2)。
編碼器–解碼器與跳接
白話版。 解碼器逐步提高解析度,並透過跳接重用對應的編碼器特徵以恢復細節。
U-Net [6] 把這個做法對稱化:一個由卷積與降取樣組成的收縮編碼器、一個由上取樣與卷積組成的擴張解碼器,並且在每一層用跳接(skip connection)把編碼器的特徵圖串接到解碼器。編碼器提供「是什麼」,跳接提供「在哪裡」。論文的設計選擇(無填補的卷積、重疊圖塊策略、為貼在一起的細胞所加的加權損失,以及強烈的彈性增強)在 IP 10 的 U-Net 導讀中說明。
選讀:U-Net:論文導讀(見 IP 10 的「論文導讀」頁)。論文的主張、有效卷積(valid convolution)的輸出尺寸算術,以及怎麼讀它的表格。
相反的設計則讓解碼器保持輕量。DeepLabv3+ [7] 讓編碼器跑到輸出步幅 16,把特徵上取樣 4 倍,串接骨幹網路在步幅 4 的低階特徵(先經過 卷積減少通道數),再用幾個 卷積精修,最後再上取樣 4 倍。論文提出解碼器的動機,是指出單純的 16 倍雙線性上取樣,也就是「簡單的解碼器」(naive decoder),可能無法還原物體的細節。圖 3 比較三種形狀:FCN 少數幾張融合的分數圖、U-Net 完整的階梯,以及 DeepLab 的脈絡模組加上單一一條跳接。
不犧牲解析度的脈絡
白話版。 要替一個像素貼標籤,需要兩樣方向相反的東西:寬廣的視野(這塊灰色是馬路還是牆?)和精細的解析度(馬路到底在哪裡結束?)。空洞卷積與池化金字塔能在不縮小特徵圖的情況下給你寬廣的視野。
空洞(atrous)卷積
降取樣是 CNN 擴大感受野(receptive field,一個輸出能看到的輸入區域)的慣用方法(DLCV 01 與 ML 03 有推導)。空洞(atrous;法文 “à trous”,意思是「有洞的」)卷積則是改把小卷積核的取樣點拉開。在一維情況下,DeepLab [8] 把輸入 與長度 的濾波器 做空洞卷積的輸出 定義為
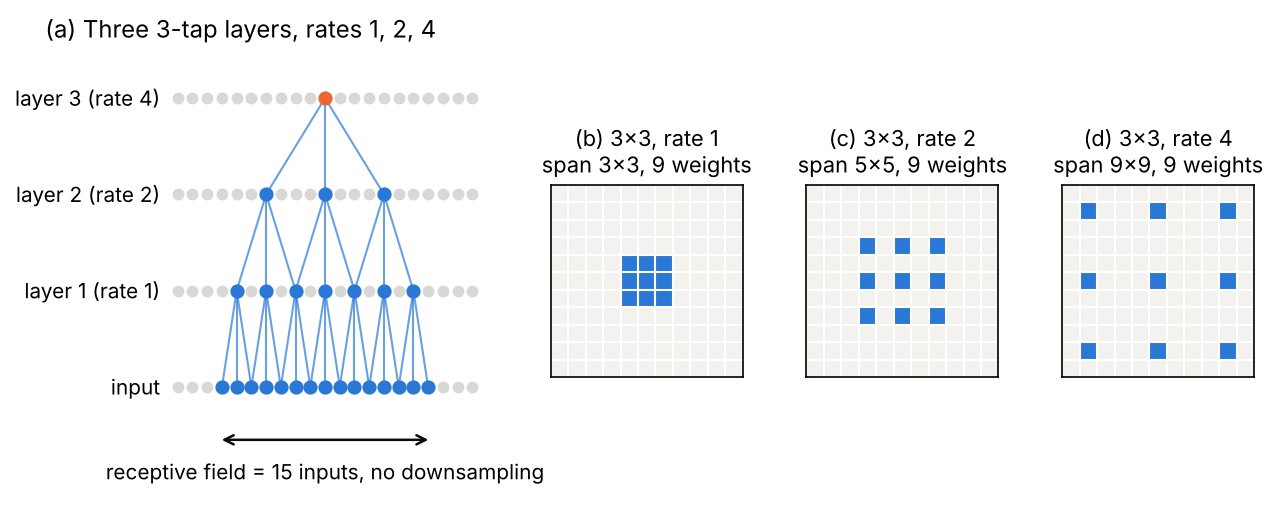
其中 是輸出位置的索引, 是比率(rate):輸入每隔 個位置取樣一次。比率 就是一般的卷積。比率為 的 卷積核每邊涵蓋 個像素,而權重一樣是 個、計算量也一樣 [8]。Yu 與 Koltun [9] 把同一個運算稱為膨脹卷積(dilated convolution),並證明堆疊膨脹率逐層加倍的卷積,能讓感受野呈指數成長而不損失解析度。
DeepLab 的做法,是把最後一個降取樣層的步幅設為 1,並把其後的卷積換成比率為 2 的空洞卷積,使它們用同樣的預訓練權重仍然看到同樣的影像區域;再多重複一個階段,密度又加倍 [8]。典型的模型輸出步幅是 8 或 16,而不是 32 [10]。代價是計算量與記憶體:在最後幾個階段,步幅 8 的位置數是步幅 16 的四倍。
程式碼 · Python · 25 行
import numpy as np

def atrous_1d(x, w, r):
    """y[i] = sum_k x[i + r*k] w[k] (DeepLab's Eq. 1), taps centred, zero padding."""
    K = len(w); c = K // 2
    xp = np.pad(x, r * c)
    return np.array([sum(xp[i + r * (k)] * w[k] for k in range(K)) for i in range(len(x))])

x = np.zeros(21); x[10] = 1.0                   # an impulse in the middle
w = np.array([1.0, 1.0, 1.0])
for r in [1, 2, 4]:
    print(f"rate {r}: taps at offsets {[(k - 1) * r for k in range(3)]},",
          "response", atrous_1d(x, w, r).astype(int))

def receptive_field(kernels, rates, strides):
    """Receptive field (in input pixels) of a stack of conv layers."""
    rf, jump = 1, 1                              # jump = distance between neighbouring outputs, in input pixels
    for k, r, s in zip(kernels, rates, strides):
        rf += (r * (k - 1)) * jump
        jump *= s
    return rf, jump

print("three 3x3, rates 1,1,1:", receptive_field([3, 3, 3], [1, 1, 1], [1, 1, 1]))
print("three 3x3, rates 1,2,4:", receptive_field([3, 3, 3], [1, 2, 4], [1, 1, 1]))
print("three 3x3, stride 2   :", receptive_field([3, 3, 3], [1, 1, 1], [2, 2, 2]))
輸出
rate 1: taps at offsets [-1, 0, 1], response [0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0]
rate 2: taps at offsets [-2, 0, 2], response [0 0 0 0 0 0 0 0 1 0 1 0 1 0 0 0 0 0 0 0 0]
rate 4: taps at offsets [-4, 0, 4], response [0 0 0 0 0 0 1 0 0 0 1 0 0 0 1 0 0 0 0 0 0]
three 3x3, rates 1,1,1: (7, 1)
three 3x3, rates 1,2,4: (15, 1)
three 3x3, stride 2   : (15, 8)
最後兩行就是空洞卷積的全部道理。比率為 1、2、4 的三層,看到的輸入像素數是 15,和三個步幅為 2 的層一模一樣;但它們每個輸入像素仍保有一個輸出(間隔 1),而不是每 8 個像素才一個(圖 4)。
膨脹有一個陷阱。單一膨脹層只讀取稀疏的輸入格點;而若堆疊的各層比率有共同因數,就會留下任何路徑都到不了的洞,形成棋盤格狀的瑕疵,Wang 等人稱之為網格效應(gridding)[11]。解法是選擇像 1、2、5 這樣能互相填補空隙的比率。
選讀:堆疊空洞卷積中的網格效應(見「補充資料」頁)。哪些比率序列會留下洞、混合膨脹的規則,以及用程式碼檢查。
多尺度脈絡:ASPP 與金字塔池化
白話版。 物體有各種大小,而一個像素是什麼,往往取決於它周圍是什麼。所以要同時透過好幾個大小不同的視窗看每個位置,其中包括一個看得到整張影像的視窗,再讓網路把這些答案結合起來。
空洞空間金字塔池化(atrous spatial pyramid pooling, ASPP)[8] 對同一張特徵圖平行地套用數個比率不同的空洞卷積,再融合它們的輸出,等於用好幾種有效尺度去探測影像。DeepLabv3 [10] 在輸出步幅 16 時,使用一個 卷積和三個比率為 6、12、18 的 卷積(步幅 8 時比率加倍),再加上一個影像層級特徵(image-level feature):對整張特徵圖做全域平均池化、經過 卷積,再用雙線性內插放大回來。加入影像層級分支的原因是論文指出的一種邊界效應:當比率接近特徵圖的大小時, 的取樣點會有越來越多落在特徵圖之外,濾波器退化成只用中心權重的 濾波器。下面的程式在 的特徵圖上數出這個現象。
程式碼 · Python · 8 行
import numpy as np

n = 65                                           # feature map is n x n
for r in [1, 6, 12, 18, 24, 36, 64]:
    pos = np.arange(n)
    inside_1d = np.array([[(0 <= p + r * d < n) for d in (-1, 0, 1)] for p in pos]).sum(1)
    mean_taps = np.mean(np.outer(inside_1d, inside_1d))   # taps inside the map, averaged over positions
    print(f"rate {r:2d}: mean valid taps {mean_taps:.2f} of 9")
輸出
rate  1: mean valid taps 8.82 of 9
rate  6: mean valid taps 7.93 of 9
rate 12: mean valid taps 6.92 of 9
rate 18: mean valid taps 5.98 of 9
rate 24: mean valid taps 5.11 of 9
rate 36: mean valid taps 3.58 of 9
rate 64: mean valid taps 1.06 of 9
在比率 64 時,一個「3×3」濾波器平均來說只剩下一個取樣點。全域池化是取得整張影像脈絡既便宜又可靠的方法。
金字塔場景解析網路(Pyramid Scene Parsing Network, PSPNet)[12] 用池化而不是膨脹達成同樣的目標。它的金字塔池化模組把最後的特徵圖池化成 、、 與 的格點,各自用 卷積降低通道數,全部上取樣回來,再與原本的特徵串接。論文的動機來自 FCN 基線模型在場景解析上的錯誤,例如「關係不符」(mismatched relationship):把河上的船標成車,儘管車子很少出現在河面上 [12]。
早期的 DeepLab 版本還會在網路之後,用全連接條件隨機場(conditional random field, CRF)來銳化邊界,它鼓勵顏色與位置相近的像素共用同一個標籤 [8]。DeepLabv3 不用它,也比先前的版本進步 [10]。
選讀:密集 CRF 後處理(見「補充資料」頁)。它的能量函數、兩個高斯核,以及為什麼平均場(mean-field)推論讓它夠快。
把注意力當成脈絡
Transformer 在每一層都讓每個 token 看得到所有其他 token,所以「脈絡」不再需要特別的模組(ML 05 說明了 Vision Transformer,即 ViT [13])。問題出在解析度:一般的 ViT 只有一個粗糙的 token 格點,而對大量 token 做全域注意力的成本又很高。SegFormer [14] 是語意分割中被廣泛使用的解答。它的編碼器是階層式的,像 CNN 一樣產生多尺度特徵;使用縮減的注意力,縮短 key 與 value 的序列;而且不需要位置編碼,這樣在測試解析度與訓練時不同時,就不必內插位置編碼。它的解碼器只是幾層 MLP,用來融合多尺度特徵。階層式的視覺 Transformer 在 ML 05 說明。
密集預測的損失函數
白話版。 訓練分割模型的方法,是把它逐像素的機率與真實的標籤圖相比。把分類損失在像素上取平均是預設做法,但當某個類別占了影像的 99%,這個平均幾乎只是在衡量那個容易的類別。
逐像素交叉熵。 設 為像素 上類別 的 softmax 機率, 為真實類別,
其中 是有標註(非 void)的像素集合, 是可選的類別權重,例如與類別出現頻率成反比。Void 像素直接不納入總和;多數框架用「ignore index」實作。
Dice 損失。 Milletari 等人 [15] 提出,與其重新加權樣本,不如直接最大化軟預測與二值真實標籤之間的 Dice 係數,因為感興趣的解剖結構常常只占醫學體積的一小部分,這時訓練很容易到處都預測成背景。對前景機率 與標籤 (共 個像素),他們的形式是
常見的變體在分母使用 ;當 與 都是二值時,兩者都等於重疊度量 ,與 IoU 關係密切。對於多類別,Dice 損失逐類別計算再取平均。由於 是整張影像上的比值,小物體和大背景的份量一樣重。
Focal 損失。 Focal 損失 [16] 把每個像素的交叉熵乘上 ,其中 是真實類別的機率,讓容易的像素貢獻很少;它在 DLCV 03 中有推導。組合很常見:後面會談到的 MaskFormer,就用 focal 損失與 Dice 損失的加權和訓練每個二值遮罩 [17]。
下面的實驗在一張 64×64 的影像上比較這些損失,前景是一個 49 像素的圓盤,並對三個候選預測計算。「IoU@0.5」把機率以 0.5 為門檻二值化,再算出評估時會回報的 IoU。
程式碼 · Python · 40 行
import numpy as np

H = W = 64
yy, xx = np.mgrid[0:H, 0:W]
r2 = (yy - 32) ** 2 + (xx - 32) ** 2
g = (r2 <= 4 ** 2).astype(float)                # small foreground disk
print(f"foreground pixels: {int(g.sum())} of {g.size} ({100 * g.mean():.1f}%)")

def bce(p, g):
    return -np.mean(g * np.log(p) + (1 - g) * np.log(1 - p))

def weighted_bce(p, g):                          # weight each class by inverse frequency
    wf, wb = 0.5 / g.mean(), 0.5 / (1 - g.mean())
    return -np.mean(wf * g * np.log(p) + wb * (1 - g) * np.log(1 - p))

def focal(p, g, gamma=2.0):
    pt = np.where(g == 1, p, 1 - p)
    return -np.mean((1 - pt) ** gamma * np.log(pt))

def soft_dice_loss(p, g, eps=1e-6):
    return 1 - (2 * (p * g).sum() + eps) / (p.sum() + g.sum() + eps)

def iou_at_half(p, g):                           # the metric we actually report
    m = p > 0.5
    return (m & (g == 1)).sum() / (m | (g == 1)).sum()

preds = {
    "all background (p=0.05)":  np.full((H, W), 0.05),
    "right shape, timid (0.4)": np.where(g == 1, 0.4, 0.05),
    "bloated, confident (0.9)": np.where(r2 <= 8 ** 2, 0.9, 0.05),
}
print(f"{'prediction':26s} {'BCE':>6s} {'wBCE':>6s} {'focal':>6s} {'Dice':>6s} {'IoU@0.5':>8s}")
for name, p in preds.items():
    print(f"{name:26s} {bce(p, g):6.3f} {weighted_bce(p, g):6.3f} "
          f"{focal(p, g):6.3f} {soft_dice_loss(p, g):6.3f} {iou_at_half(p, g):8.3f}")

# Where does the BCE gradient come from? dL/dz = p - g per pixel (z = logit)
p = preds["all background (p=0.05)"]
grad = np.abs(p - g)
print(f"share of |BCE gradient| from background pixels: {grad[g == 0].sum() / grad.sum():.2f}")
輸出
foreground pixels: 49 of 4096 (1.2%)
prediction                    BCE   wBCE  focal   Dice  IoU@0.5
all background (p=0.05)     0.087  1.524  0.032  0.981    0.000
right shape, timid (0.4)    0.062  0.484  0.004  0.855    0.000
bloated, confident (0.9)    0.133  0.119  0.068  0.791    0.249
share of |BCE gradient| from background pixels: 0.81
逐列讀這張表(所有數字都來自這個小實驗)。一般的二元交叉熵(binary cross-entropy, BCE)寧可選「全部是背景」,也不選那個膨脹的預測;但膨脹的預測是唯一在 0.5 門檻下找到物體的。原因是膨脹的遮罩在大約 150 個背景像素上錯了,而這些像素的數量比物體還多。沒有類別權重 的 focal 損失,也做出同樣的選擇。有類別加權的 BCE 與 Dice 都把膨脹的預測排最好、「全部是背景」排最差,順序與 IoU 相同。最後一行說明了一般 BCE 為什麼會這樣:它 81% 的梯度來自本來就幾乎正確的背景像素。另外也請注意軟 Dice 對那個畏縮的預測有多嚴苛:在 的 4,047 個背景像素,讓分母增加約 202,是物體面積的四倍多,所以軟預測在背景上也必須很有把握。
實務上,交叉熵(常搭配類別權重或 focal 調變)是自然場景語意分割的預設;Dice 或 Dice+交叉熵的和,常用於有小結構的醫學影像;以遮罩為基礎的模型則用 Dice+focal 訓練每個遮罩。也有同時懲罰邊界或拓撲錯誤的損失;其中三種以主動輪廓能量建立的,在 IP 11 的補充資料中有摘要。
選讀:軟 Dice 損失的梯度(見「補充資料」頁)。導數的閉式解、為什麼每個背景像素得到同樣大小的推力,以及空遮罩等邊界情況。
衡量語意分割
白話版。 在整個測試集上,數一數每個真實類別的像素被判成每個預測類別的各有多少。常見的分數都是這張表的不同摘要。標準的 mean IoU,對每個類別問:「在所有屬於這個類別、或被判成這個類別的像素中,有多少比例判對了?」再對類別取平均。
設 為真實類別 被預測成類別 的像素數(在所有測試影像上累計), 為類別 的像素數。FCN [5] 定義了四個指標,類別數為 :
在類別 的 IoU 中,分子 數的是真陽性,分母數的是真實像素與預測像素的聯集:(真陽性加上漏掉的)加上 (誤報)。Mean IoU(mIoU)是 PASCAL VOC、Cityscapes 與 ADE20K 的標準指標。
程式碼 · Python · 26 行
import numpy as np

def confusion(gt, pred, K, ignore=255):
    """K x K matrix: rows = true class, columns = predicted class; 'ignore' pixels are skipped."""
    keep = gt != ignore
    return np.bincount(K * gt[keep] + pred[keep], minlength=K * K).reshape(K, K)

def seg_metrics(C):
    tp = np.diag(C).astype(float)
    t = C.sum(1)                    # pixels of each true class
    p = C.sum(0)                    # pixels predicted as each class
    iou = tp / (t + p - tp)
    return {"pixel acc": tp.sum() / C.sum(), "mean acc": np.mean(tp / t),
            "mIoU": iou.mean(), "fwIoU": (t * iou).sum() / t.sum(), "IoU": np.round(iou, 3)}

# Toy: road (0) covers most of the image, car (1) is medium, pole (2) is thin
H, W = 120, 160
gt = np.zeros((H, W), int)
gt[60:100, 40:90] = 1
gt[10:110, 130:133] = 2
pred = gt.copy()
pred[60:100, 86:90] = 0                         # car slightly too short
pred[10:110, 130:133] = 0                       # the pole is missed entirely
m = seg_metrics(confusion(gt, pred, 3))
for k, v in m.items():
    print(f"{k:9s}: {v:.3f}" if np.isscalar(v) else f"{k:9s}: {v}")
輸出
pixel acc: 0.976
mean acc : 0.640
mIoU     : 0.631
fwIoU    : 0.953
IoU      : [0.974 0.92  0.   ]
完全漏掉電線桿,讓像素準確率只掉 1.6%、在頻率加權 IoU 上幾乎沒有影響,卻讓 mean IoU 掉了三分之一。這就是為什麼對每個類別一視同仁的 mIoU 是主要數字。比較論文時有四個實務細節要注意:
- 混淆矩陣是在整個資料集上累計的,然後才計算 IoU。對每張影像各算 IoU 再平均,會得到不同的數字。
- Void 像素透過 ignore 標籤排除,如同上面的
confusion。 - mIoU 仍然偏袒類別內部的大物體:一輛大車的份量超過十輛小車。因此 Cityscapes 還報告實例層級的 iIoU,其中每個像素的貢獻,是以該類別的平均實例大小與其真實實例大小的比值來加權 [18]。
- 區域重疊對大物體的邊界品質不敏感,邊界上差幾個像素幾乎不會改變 IoU。Boundary IoU [19] 只在沿著輪廓的一條細帶中衡量重疊。
選讀:Boundary IoU 詳解(見「補充資料」頁)。它的定義、帶寬,以及用程式碼檢查它對小物體與大物體的相同邊界誤差給出相同的分數。
實例分割
白話版。 實例分割就是「附輪廓的偵測」。主流做法是先像偵測器那樣找出每個物體,再分割它方框的內部。
先偵測再分割:Mask R-CNN
Mask R-CNN [20] 在兩階段偵測器 Faster R-CNN [21] 上加了一個小型的全卷積遮罩分支;DLCV 03連同 RoIAlign 一起說明了 Faster R-CNN。對每個感興趣區域(region of interest),這個分支預測 個大小為 的二值遮罩,每個類別一個(論文建立在特徵金字塔網路 FPN [22] 上的版本是 ),損失使用逐像素 sigmoid,並且只對真實類別的遮罩計算平均二元交叉熵。因此遮罩預測與類別預測是解耦的:由方框分支選擇類別,不同類別的遮罩不互相競爭,這與 FCN 的逐像素 softmax 不同;論文的消融實驗發現,逐類別 sigmoid 比 softmax 帶來很大的提升 [20]。測試時,把預測類別的 遮罩縮放到方框大小,再以 0.5 為門檻二值化。
選讀:RoI pooling 與 RoIAlign(見 DLCV 03 的「補充資料」頁)。為什麼把方框捨入到特徵格點會讓遮罩位移,以及修正它的雙線性取樣。
固定的 格點也是 Mask R-CNN 的弱點:大物體的輪廓只由幾百個格子畫出,因此過度平滑。PointRend [23] 把遮罩預測當成電腦圖學中的算繪(rendering):它從粗遮罩開始,反覆以雙線性內插上取樣,並且只在較密格點中最不確定的點(對二值遮罩來說,就是機率最接近 0.5 的點)重新計算預測,這些點大多沿著邊界分布。
另有其他路線。由下而上(bottom-up)的方法先預測逐像素的量,例如嵌入向量或到物體中心的距離,再把像素分組成實例;在預測的距離圖上做分水嶺,標記由網路找出,就是 IP 10 中標記控制分水嶺的學習版。還有以查詢為基礎(query-based)的方法,直接預測一組遮罩,詳見下面的遮罩分類一節。
Mask AP
實例分割的評分方式與偵測完全相同,都是 DLCV 03 的 COCO 平均精確度(average precision, AP),差別只在預測與真實物體之間的 IoU 是在遮罩上而不是方框上計算 [20]。這個指標每個遮罩都需要一個信心分數,因為 AP 要對預測排序;而且它允許遮罩重疊:偵測器可以輸出數個互相重疊的假設,只有不相符的那些會被扣分。這就是為什麼實例輸出若不經額外處理,就不能直接當作全景圖使用。
全景分割
白話版。 全景任務要求一幅一致的圖像:每個像素都有標籤,stuff 與 things 都一樣,沒有重疊,而且指標對天空區域和一輛車一視同仁。
任務與指標
Kirillov 等人 [4] 定義了這個任務(格式就是「三個任務,一張標籤圖」中給的那一種),並附上一個指標:全景品質(panoptic quality, PQ)。PQ 分兩步計算。
1. 配對。 同一類別的預測區段 與真實區段 ,只有在它們的 IoU 嚴格大於 0.5 時才算配對。由於全景圖的區段不能重疊,這個配對是唯一的:如果 與 是互不相交的預測,則 ,因為每一個 ,而且兩個交集沒有共同像素。所以每個 最多只有一個預測能超過 0.5,反過來也一樣 [4]。因此不需要最佳指派的步驟。
2. 評分。 對每個類別,配對把區段分成真陽性 (配對成功的數對)、偽陽性 (未配對的預測)與偽陰性 (未配對的真實區段)。於是
其中總和跨過配對成功的數對, 計算集合的元素個數。SQ 是配對成功區段的平均 IoU,RQ 則是偵測中大家熟悉的 F1 分數。PQ 對每個類別分別計算再對類別取平均,所以稀有類別和常見類別的份量一樣;每個區段的份量也相同,不論面積大小。 與 分別只對 stuff 與 thing 類別取平均。配對之前,void 像素會先從預測中移除,而主要由 void(或同類別的「crowd」區域)組成的未配對預測,不算偽陽性 [4]。這兩個因子並不獨立,因為 SQ 只在配對成功的區段上衡量,所以一定要把三個數字都報告出來。
下面的程式在圖 5 的玩具場景上實作這個配對與評分(void 的處理簡化到最簡單的形式)。
程式碼 · Python · 45 行
import numpy as np

def panoptic_quality(gt_seg, gt_cls, pr_seg, pr_cls):
    """gt_seg/pr_seg: integer segment-id maps (0 = void); *_cls: dict segment id -> class.
    Matches segments of the same class with IoU > 0.5 and returns per-class (PQ, SQ, RQ, TP, FP, FN)."""
    out = {}
    for c in sorted(set(gt_cls.values()) | set(pr_cls.values())):
        g_ids = [i for i, k in gt_cls.items() if k == c]
        p_ids = [i for i, k in pr_cls.items() if k == c]
        ious, matched_p = [], set()
        for gi in g_ids:
            G = gt_seg == gi
            for pj in p_ids:
                P = (pr_seg == pj) & (gt_seg != 0)          # ignore predicted pixels on void
                iou = (G & P).sum() / (G | P).sum()
                if iou > 0.5:                                # unique by the matching theorem
                    ious.append(iou); matched_p.add(pj)
        tp = len(ious); fn = len(g_ids) - tp; fp = len(p_ids) - len(matched_p)
        sq = np.mean(ious) if tp else 0.0
        rq = tp / (tp + 0.5 * fp + 0.5 * fn)
        out[c] = (sq * rq, sq, rq, tp, fp, fn)
    return out

H, W = 100, 200
SKY, ROAD, CAR, PERSON = 0, 1, 2, 3
def scene(boxes, sky_rows):
    seg = np.full((H, W), 2); seg[:sky_rows] = 1          # segment 1 = sky, 2 = road
    cls = {1: SKY, 2: ROAD}
    for sid, (c, r0, r1, c0, c1) in enumerate(boxes, start=3):
        seg[r0:r1, c0:c1] = sid; cls[sid] = c
    return seg, cls

gt_seg, gt_cls = scene([(CAR, 50, 80, 10, 55), (CAR, 50, 80, 65, 110),
                        (CAR, 38, 52, 125, 150), (PERSON, 30, 80, 165, 185)], sky_rows=30)
pr_seg, pr_cls = scene([(CAR, 52, 80, 13, 55),             # car A, slightly off
                        (CAR, 55, 80, 65, 96),             # car B, too small
                        (CAR, 84, 97, 110, 150),           # a car that is not there
                        (PERSON, 30, 52, 165, 185),        # the person, split in two
                        (PERSON, 52, 80, 165, 185)], sky_rows=33)   # car C is missed
names = ["sky", "road", "car", "person"]
res = panoptic_quality(gt_seg, gt_cls, pr_seg, pr_cls)
for c, (pq, sq, rq, tp, fp, fn) in res.items():
    print(f"{names[c]:6s} PQ {pq:.3f} = SQ {sq:.3f} x RQ {rq:.3f}  (TP {tp}, FP {fp}, FN {fn})")
pqs = np.array([v[0] for v in res.values()])
print(f"PQ {pqs.mean():.3f} | PQ_stuff {pqs[:2].mean():.3f} | PQ_things {pqs[2:].mean():.3f}")
輸出
sky    PQ 0.917 = SQ 0.917 x RQ 1.000  (TP 1, FP 0, FN 0)
road   PQ 0.805 = SQ 0.805 x RQ 1.000  (TP 1, FP 0, FN 0)
car    PQ 0.482 = SQ 0.723 x RQ 0.667  (TP 2, FP 1, FN 1)
person PQ 0.373 = SQ 0.560 x RQ 0.667  (TP 1, FP 1, FN 0)
PQ 0.644 | PQ_stuff 0.861 | PQ_things 0.428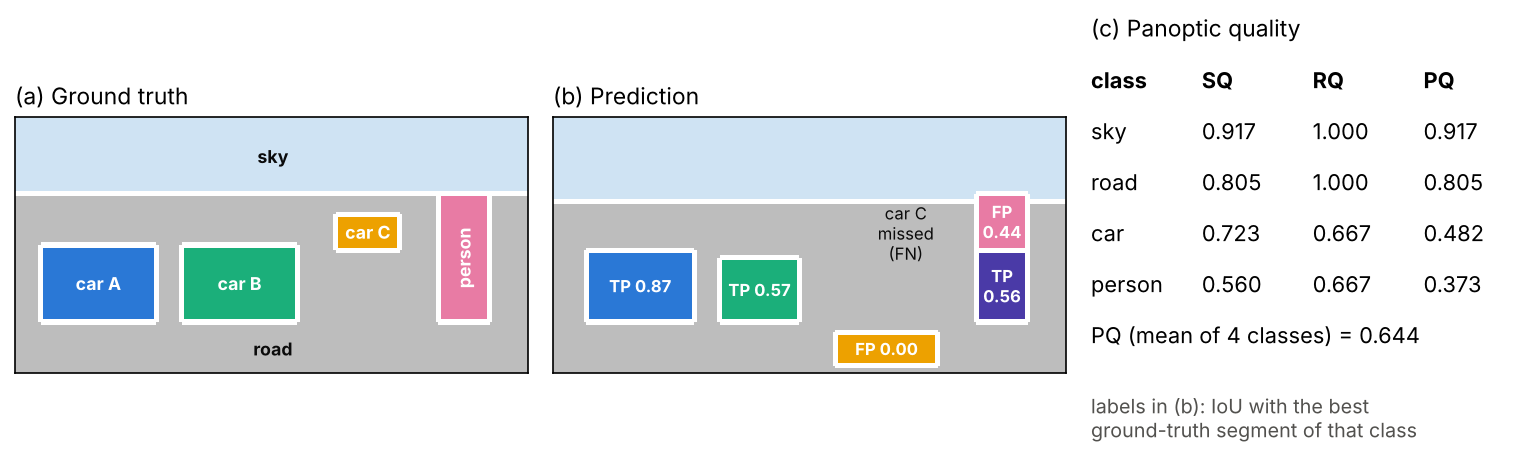
這個小例子顯示 PQ 如何解讀錯誤(數字來自這次執行)。被切成兩塊的人仍然得到一個配對,因為下半塊涵蓋了他的 56%,但上半塊變成偽陽性:把一個物體切開,傷到的是辨識品質,而不只是分割品質。車 B 的 IoU 是 0.57,被算作完全辨識出來,但它偏低的 IoU 拉低了車子的 SQ。漏掉一輛車與憑空多出一輛車,各讓分母多半個區段。
早期全景系統:合併兩個輸出
白話版。 最早的全景系統,就是把語意分割模型與實例分割模型各跑一次,再把結果拼貼在一起。
全景論文自己的基線 [4] 用一種類似非極大值抑制(non-maximum suppression)的做法來做。它依信心分數對實例遮罩排序,丟掉分數低的,然後沿著清單往下走:每個遮罩要扣掉前面遮罩已經占走的像素,只有剩下的部分夠多才保留。留下來的 thing 區段再與語意圖結合,同時被 thing 與 stuff 類別宣稱的像素歸給 thing。Panoptic FPN [24] 接著把兩個任務放進同一個網路:一個帶特徵金字塔網路的 Mask R-CNN(FPN [22],見 DLCV 03),加上一個輕量的語意分支,把所有金字塔層級上取樣到 1/4 尺度後相加。語意分支預測 stuff 類別,再加上一個代表所有 thing 像素的「other」類別,這樣兩個分支就不會為了物體互相爭奪。
選讀:Panoptic Segmentation:論文導讀(見「論文導讀」頁)。論文如何定義任務與指標、它的人類一致性研究呈現了什麼,以及怎麼讀它的表格。
遮罩分類:一個模型解決三種任務
白話版。 與其問「這個像素是什麼類別?」,不如問「有哪些區域,而每個區域是什麼?」模型預測固定數量的候選遮罩,並替每個遮罩給出一個類別(或「什麼都不是」)。語意圖、一組實例與全景圖,就只是用不同方式讀同一份清單。
MaskFormer
Cheng、Schwing 與 Kirillov [17] 把 FCN 的做法稱為逐像素分類(per-pixel classification),把 Mask R-CNN 與 DETR 的做法稱為遮罩分類(mask classification)。他們的觀察是:遮罩分類的通用性足以用在語意分割。MaskFormer 預測一組 個機率–遮罩數對 ,其中 是 個類別加上一個「無物體」標籤 上的分布, 是軟遮罩。三個模組產生它們:
- 一個骨幹網路與一個像素解碼器(pixel decoder)產生逐像素嵌入 ,其中 是嵌入維度。
- 一個 Transformer 解碼器把 個可學習的查詢(query)轉成 個逐區段嵌入,方法是像 DETR [25] 那樣對影像特徵做注意力。
- 一個線性分類器給出 ,一個小型 MLP 給出遮罩嵌入 。遮罩是一個內積再經過 sigmoid,
其中 是 logistic sigmoid, 是像素位置。
訓練時,預測與真實區段做一對一配對,如同 DETR 對方框做的那樣(DLCV 03),只是配對成本由類別機率與遮罩損失構成,而不是方框。配對到的預測得到交叉熵類別損失與 focal+Dice 遮罩損失;沒配對到的則被訓練去預測 [17]。
推論時,兩條規則以不同方式讀同一份輸出 [17]。語意推論對查詢做邊際化(marginalize),,其中 遍歷 個真實類別。全景推論把每個像素指派給一個查詢,,其中 是查詢 最可能的類別,因此同一類別的兩個查詢會給出兩個實例。下面的程式在一個小小的 例子上跑這兩條規則。
程式碼 · Python · 33 行
import numpy as np

rng = np.random.default_rng(0)
# Ground-truth layout of a tiny 6 x 10 image: sky on top, road below, two cars on the road
region = np.zeros((6, 10), int)               # 0 sky, 1 road, 2 car A, 3 car B
region[2:] = 1
region[3:5, 1:4] = 2
region[3:5, 6:9] = 3

# Pixel decoder output: a C_E = 4 dimensional embedding per pixel (here: noisy one-hot of the region)
E_pixel = 6 * np.eye(4)[region].transpose(2, 0, 1) - 3 + 0.5 * rng.standard_normal((4, 6, 10))

# Transformer decoder output for N = 5 queries: a mask embedding and class probabilities
# over K = 3 classes (sky, road, car) plus "no object" (last column)
E_mask = np.array([[1, 0, 0, 0], [0, 1, 0, 0], [0, 0, 1, 0], [0, 0, 0, 1], [.2, .2, .2, .2]], float)
p = np.array([[.90, .05, .03, .02],          # query 0: sky
              [.05, .85, .05, .05],          # query 1: road
              [.02, .08, .85, .05],          # query 2: a car
              [.03, .07, .75, .15],          # query 3: another car
              [.05, .05, .05, .85]])         # query 4: nothing

m = 1 / (1 + np.exp(-np.einsum("nc,chw->nhw", E_mask, E_pixel)))   # N masks, sigmoid(dot product)

# Semantic inference: sum over queries of p_i(c) * m_i, then argmax over the K real classes
sem = np.einsum("nk,nhw->khw", p[:, :3], m).argmax(0)
# Panoptic inference: each pixel goes to the query maximizing p_i(c_i) * m_i (no-object queries dropped)
c_i = p.argmax(1)
keep = c_i != 3
score = p[np.arange(5), c_i][:, None, None] * m
seg = np.where(keep[:, None, None], score, -1).argmax(0)
print("semantic (0 sky, 1 road, 2 car):\n", sem)
print("panoptic segment = query index:\n", seg)
print("query classes:", c_i, "-> car segments:", [int(i) for i in np.unique(seg) if c_i[i] == 2])
輸出
semantic (0 sky, 1 road, 2 car):
 [[0 0 0 0 0 0 0 0 0 0]
 [0 0 0 0 0 0 0 0 0 0]
 [1 1 1 1 1 1 1 1 1 1]
 [1 2 2 2 1 1 2 2 2 1]
 [1 2 2 2 1 1 2 2 2 1]
 [1 1 1 1 1 1 1 1 1 1]]
panoptic segment = query index:
 [[0 0 0 0 0 0 0 0 0 0]
 [0 0 0 0 0 0 0 0 0 0]
 [1 1 1 1 1 1 1 1 1 1]
 [1 2 2 2 1 1 3 3 3 1]
 [1 2 2 2 1 1 3 3 3 1]
 [1 1 1 1 1 1 1 1 1 1]]
query classes: [0 1 2 2 3] -> car segments: [2, 3]
語意圖把兩輛車合併成類別 2;全景圖則把它們分開,成為區段 2 與 3,而兩者來自完全相同的網路輸出。論文報告 MaskFormer 在 Cityscapes(19 個類別)上與逐像素分類相當,在詞彙量較大的資料集上則更好 [17]。
Mask2Former 與其後繼者
Mask2Former [26] 保留 MaskFormer 的整體架構(骨幹網路、像素解碼器、Transformer 解碼器),改動解碼器,使它訓練得更快,並且能把實例分割得很好。它的關鍵元件是遮罩注意力(masked attention):每個查詢只對前一層所預測的遮罩內部的像素做注意力。在第 層,查詢特徵為 ,
其中 是 的線性投影, 與 是影像特徵的投影, 是前一層的遮罩預測,經縮放並以 0.5 為門檻二值化。在 softmax 之前加上 ,會讓遮罩之外的注意力權重為零。作者的假設是:局部特徵就足以更新一個查詢,而先前模型收斂緩慢,是因為交叉注意力必須先學會把焦點放在物體上。另外兩項改動,一是在連續的解碼器層中輪流使用像素解碼器 1/32、1/16 與 1/8 的特徵圖,以利小物體;二是在取樣的點上而不是完整遮罩上計算遮罩損失,論文報告這讓訓練記憶體減少為三分之一 [26]。
選讀:Mask2Former:論文導讀(見「論文導讀」頁)。論文中「通用」的意思、它的消融實驗、怎麼讀它的比較表,以及它自己提到的限制。
後來有兩個方向建立在這個設計上。OneFormer [27] 用單一模型訓練三種任務:它從全景標註推導出語意與實例標籤,每張訓練影像隨機抽一個任務,並以「任務 token」作為查詢的條件,讓同一組權重服務所有任務。EoMT [28] 則把任務專用的部分全部拿掉。作者主張,經過大量預訓練的大型一般 ViT,能自行學會轉接器(adapter)、像素解碼器與 Transformer 解碼器原本提供的東西;他們在最後幾個 ViT 區塊之前,把可學習的查詢串接到圖塊 token 上,讓這些區塊同時處理兩者,並報告了與較複雜模型相近的準確率,而且速度快很多(用 ViT-L 時最多快四倍)。
可提示與開放詞彙分割
白話版。 上面的模型只分割訓練時固定的類別清單。兩個較新的家族放寬了這份清單:可提示模型分割你指到的任何東西;開放詞彙模型分割你叫得出名字的任何東西。
可提示分割。 Segment Anything Model(SAM)[29] 針對點、方框或粗略遮罩的提示傳回一個遮罩;遇到含糊的點(是襯衫還是人?),它會傳回數個有效的遮罩及其信心分數。它在 SA-1B 上訓練,這是一個用模型參與迴圈(model-in-the-loop)的資料引擎建成的資料集,在 1,100 萬張影像上有超過 10 億個遮罩。SAM 2 [30] 用串流記憶(streaming memory)把它擴展到影片,SAM 3 [31] 則加入可提示概念分割(promptable concept segmentation):給一個簡短的名詞片語或影像範例,它會傳回所有相符實例的遮罩與身分。這些模型在 DLCV 01 與 ML 10 有說明,SAM 2 當作追蹤器則在 DLCV 07。以本篇的三種任務來看:SAM 的遮罩沒有類別,所以單獨來看,它既不是語意也不是全景的輸出;偵測器給的方框加上 SAM,可以得到實例遮罩;而 SAM 3 的概念提示則讓它成為開放詞彙的實例分割模型。閱讀這類模型的「零樣本」(zero-shot)結果時,要檢查提示是從哪裡來的:從真實方框推導出來的提示,給了模型很多資訊。
開放詞彙分割。 關鍵成分是 CLIP [32] 這類視覺–語言模型,它的文字編碼器把任何類別名稱對應到與影像特徵相同的空間裡的嵌入(ML 10 有介紹)。把分割模型固定的分類器權重換成類別名稱的文字嵌入,詞彙就變成測試時才輸入的清單。LSeg [33] 做的正是這件事:Transformer 影像編碼器產生逐像素嵌入,文字編碼器嵌入標籤名稱,訓練則讓每個像素的嵌入與其類別的文字嵌入對齊,所以測試時不必重新訓練就能使用沒見過的標籤。CAT-Seg [34] 則改為建立一個代價體積(cost volume),裡面是 CLIP 影像與文字嵌入之間的餘弦相似度,並加以聚合;作者發現這讓他們能微調 CLIP 的編碼器而不會過擬合到訓練類別,而這個問題曾使多數先前的方法選擇凍結 CLIP。Zhu 與 Chen 的綜述 [35] 提醒,評估「未見過」的類別很困難,因為影像–文字預訓練資料可能早已包含它們。
資料集與基準
白話版。 逐像素標註很昂貴,所以由少數幾個公開資料集撐起整個領域。每個資料集都固定了類別清單、stuff/thing 的劃分,以及評估方式。
| 資料集 | 內容 | 規模與類別(來自論文) | 任務 |
|---|---|---|---|
| PASCAL VOC 2012 [36] | 日常物體 | 20 個物體類別+背景(如 [8] 所述) | 語意 |
| Cityscapes [18] | 來自 50 個城市的街景 | 5,000 張精細標註與 20,000 張粗略標註的影像;30 個類別,其中 19 個用於評估;8 個有實例標籤 [4] | 語意、實例、全景 |
| ADE20K [37] | 多樣的場景、物體與部件 | 訓練/驗證/測試各 20,210 / 2,000 / 3,000 張影像;基準取前 150 個類別(SceneParse150);全景用 100 個 things+50 個 stuff [4] | 語意、全景 |
| COCO [38] + COCO-Stuff [39] | 日常場景 | 80 個 thing 類別的實例遮罩 [24];COCO-Stuff 為 COCO 2017 全部 164K 張影像加上 91 個 stuff 類別的逐像素標籤;COCO 全景有 80 個 things+53 個 stuff [17] | 實例、語意、全景 |
| Mapillary Vistas [40] | 世界各地的街道層級影像 | 25k 張影像;28 個 stuff+37 個 thing 類別 [4] | 語意、實例、全景 |
有三個事實影響每一項結果。第一,標註昂貴且有雜訊:全景論文的人類一致性研究,讓兩份對同一批影像的標註互相評分,在它檢視的三個資料集上 PQ 值都遠低於 100 [4]。第二,類別清單很小,與世界上的詞彙量相比,這正是上面開放詞彙模型的動機。第三,領域不同:Cityscapes 是在 50 個城市錄製的,主要在德國,而且刻意避開惡劣天氣 [18],所以用它訓練的模型到了別處,會遇到不同的路面標線、天氣與相機。駕駛用的鳥瞰圖(bird’s-eye-view)地圖分割,是在地平面格點而不是影像上預測標籤,在 DLCV 03B 說明。
失效模式與實務建議
白話版。 分割模型會在可預期的地方失敗:結構細小之處、邊界、稀有類別,以及與訓練集不同的影像。
- 細小的結構(電線桿、電線、遠處的行人)在大的輸出步幅下會消失,如第一個實驗所示。使用輸出步幅 8,或帶有高解析度跳接的解碼器,並且評估時看每個類別的 IoU,而不只是 mIoU。
- 邊界會變得平滑或呈方塊狀。對分數做雙線性上取樣、解碼器、PointRend [23] 這類以點為基礎的精修,以及對邊界敏感的指標 [19],都能處理這個問題。
- 類別不平衡讓網路偏向頻繁的類別。加權交叉熵、focal 或 Dice 項,以及取樣含有稀有類別的影像,都有幫助(見損失函數的實驗)。
- 脈絡錯誤:某個區域被標成在周圍環境下說不通的類別([12] 中被標成車的船)。全域脈絡模組與注意力能減少這類錯誤。
- 破碎的遮罩與破洞:逐像素分類器沒有形狀的概念。對預測遮罩做形態學清理(開運算、閉運算、填洞;見 IP 09)是便宜而常見的後處理步驟。
- 高解析度輸入會超過 GPU 記憶體。在重疊的圖塊上執行再混合分數,與 U-Net 的重疊圖塊是同一個想法。
- 領域偏移:換到新的城市、天氣、感測器或醫學掃描儀,效能會下降。要用留出的領域來衡量,而不只是留出的資料切分。
現代觀點
綜述怎麼說
Minaee 等人 [1] 把語意與實例分割的 CNN 時代整理成十個家族:全卷積網路、搭配圖模型(如 CRF)的卷積模型、編碼器–解碼器、多尺度與金字塔網路、用於實例的 R-CNN 系模型、膨脹卷積與 DeepLab 家族、遞迴網路、注意力模型、生成式與對抗式模型,以及結合主動輪廓的卷積模型。他們也回顧了資料集與已發表的結果。大多數家族都出現在本篇各節,以 FCN、U-Net、PSPNet、DeepLab 與 Mask R-CNN 為例。
Li 等人 [2] 圍繞著一個整體架構(meta-architecture)來整理以 Transformer 為基礎的分割,這個架構有特徵擷取器、物體查詢與 Transformer 解碼器;他們依方法修改了哪個元件來分類:更好的骨幹網路、解碼器中的交叉注意力設計、最佳化查詢的方式,等等。他們也涵蓋影片與點雲分割、基礎模型的調校、效率與醫學分割,並在共同的基準上重新評估許多方法。
Zhou 等人 [3] 回顧基礎模型時代的 300 多種方法,把領域分成通用分割(語意、實例、全景)與可提示分割(互動式、指稱式與少樣本)。一個核心主題是:分割的知識會在沒有用遮罩訓練的模型中自然浮現,例如 CLIP、文字到影像的擴散模型與自監督 ViT,免訓練的方法就利用這一點。Zhu 與 Chen [35] 則聚焦於開放詞彙的偵測與分割,以及公平評估「新」類別有多困難。
2023–2026 的最新技術
- 通用的查詢式架構是封閉詞彙基準上的預設:Mask2Former [26] 與它的後代如 OneFormer [27],用一種設計處理語意、實例與全景分割;在速度或簡單性重要的地方,專門的逐像素模型仍然很常見(SegFormer [14]、DeepLab 風格的模型 [7])。
- 更簡單的模型搭配更大的預訓練:EoMT [28] 主張,把算力花在擴大一般 ViT 編碼器上,比加上解碼器與轉接器更划算。
- 可提示的基礎模型(SAM [29]、SAM 2 [30]、SAM 3 [31])把與類別無關的遮罩、影片傳播與概念提示變成可重複使用的元件,它們的資料引擎也改變了分割資料集的建造方式。
- 開放詞彙分割建立在視覺–語言模型上(LSeg [33]、CAT-Seg [34]);在許多應用中,現在是用類別名稱來提示模型,而不是重新訓練。
開放問題
- 邊界、小物體與細小結構。 Mask2Former 的作者承認它仍然不擅長小物體 [26],而區域指標會掩蓋大物體上的邊界錯誤 [19]。
- 一個模型,只訓練一次。 通用架構仍常常針對每個任務與資料集分別訓練;只用全景標籤訓練的 Mask2Former,在實例與語意指標上,略差於針對各任務分別訓練的版本 [26]。
- 開放詞彙的評估取決於提示,以及預訓練資料包含了什麼 [35]。
- 資料。 逐像素標註很昂貴;綜述指出可擴展的資料引擎、由生成式模型產生的合成影像–遮罩配對,以及弱監督或無監督,是可行的方向,但各有自己的領域差距 [3], [2]。
- 效率。 基礎模型的分割器很笨重;蒸餾、壓縮與參數高效率的調校,是尚未解決的工程問題 [3]。
- 理解「自然浮現」。 為什麼沒有用遮罩訓練的模型會學會分割,目前還沒有好的解釋 [3]。
重點整理
- 先定義輸出需要類別、物件身分,或兩者兼具。
- 輸出步幅限制空間細節;應先上採樣分數,再決定標籤。
- 帶跳接的解碼器恢復細節,空洞卷積、池化與注意力提供上下文。
- 交叉熵、焦點與 Dice 損失對錯誤的加權不同,須配合任務不平衡與指標選擇。
- mIoU、mask AP 與全景品質評估不同輸出結構,不能互換。
- 遮罩分類可支援多種任務;提示與詞彙介面會改變需要評估的內容。
練習
- 用手算輸出步幅。 一張路景是 像素,電線桿寬 6 個像素。在理想的粗分數(各格的類別比例)與 argmax 決策下,電線桿在哪些輸出步幅還有機會存活?為什麼它相對於格點的位置很重要?把第一段程式中的長條移動一兩個像素來檢驗你的答案。
提示
電線桿只有在涵蓋超過格子寬度一半時才贏得那一格,所以 ; 時,只有在它的 6 欄中至少有 5 欄落在同一個 8 像素格子裡的那些格子,它才存活。 時,它至少總是涵蓋一整個格子。移動長條會改變它主導哪些格子,這就是為什麼程式最近鄰標籤那一欄中,長條在步幅 4 的 IoU 是 0.67 而不是 1(剛好各占一半的平手,歸給背景,也就是第一個類別)。
- 空洞卷積的算術。 (a) 比率 12 的 卷積核,有效大小是多少?(b) 骨幹網路的一個階段常以步幅 2 開始,後面接 卷積。如果拿掉步幅,改用比率 2,輸出步幅、後續各層的感受野,以及那些層的計算成本,分別會怎麼變?
提示
(a) 。(b) 輸出步幅減半(例如 32 變成 16),之後每一層涵蓋的影像區域與先前相同(比率補償了較密的格點),而且之後的各層現在要在四倍多的位置上運算,所以成本約增加為四倍。
- 空遮罩下的損失。 修改損失函數的程式,讓影像中沒有前景。對「all background (p=0.05)」這個預測,每個損失各傳回什麼?沒有
eps項時,軟 Dice 損失會發生什麼事?實作上通常怎麼避免這個問題?
提示
當 處處成立,Dice 的分子是 0(加上 eps),分母是 ,所以無論預測多好,損失都幾乎是 1;若處處 ,沒有 eps 時是 ,有 eps 時變成 。當兩個遮罩都沒有任何像素時,iou_at_half 也會 0 除以 0。常見的修正:在分子與分母加平滑常數、對整個批次而不是每張影像計算 Dice,或是把 Dice 與交叉熵結合。
- 用手算 PQ。 在 PQ 的程式中,把兩塊人的預測換成單一個涵蓋第 32 到 80 列的預測。在執行程式之前,先預測新的人的 SQ、RQ 與 PQ。然後讓車 B 變大,過度分割到它的 IoU 掉到 0.5 以下;車子的 TP、FP 與 FN 個數怎麼變?
提示
單一的人預測,IoU 是 ,所以 、、。如果車 B 的 IoU 降到 0.5 或以下,這一對就不再算配對:車子的 TP 從 2 降到 1,FP 與 FN 各增加 1。
- 語意與全景之間的互相轉換。 用遮罩分類的程式:(a) 從全景區段圖推導出語意圖,並檢查它等於
sem;(b) 讓查詢 3 以 0.6 的機率預測「road」而不是「car」,並解釋兩個輸出。(c) 為什麼一般而言,語意圖不能轉回全景圖?
提示
(a) 把每個區段編號對應到它的類別,c_i[seg]。(b) 查詢 3 的遮罩仍然涵蓋車 B,所以在全景圖中車 B 仍是區段 3,但這個區段現在被標成 road;由於 stuff 類別在一張影像中只有一個區段,最後的輸出會把它和馬路合併。在語意圖中,車 B 也變成 road。兩種輸出裡都只剩下一輛車。(c) 語意圖沒有實例編號:貼在一起的同類物體形成一個區域,要把它分開,需要圖裡沒有的資訊。
參考文獻
- S. Minaee, Y. Boykov, F. Porikli, A. Plaza, N. Kehtarnavaz and D. Terzopoulos, “Image segmentation using deep learning: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 7, 2022. doi · arXiv
- X. Li, H. Ding, H. Yuan, W. Zhang, J. Pang, G. Cheng, K. Chen, Z. Liu and C. C. Loy, “Transformer-based visual segmentation: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 46, no. 12, 2024. doi · arXiv
- T. Zhou, W. Xia, F. Zhang, B. Chang, W. Wang, Y. Yuan, E. Konukoglu and D. Cremers, “Image segmentation in foundation model era: A survey,” arXiv:2408.12957, 2024. arXiv
- A. Kirillov, K. He, R. Girshick, C. Rother and P. Dollár, “Panoptic segmentation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019. doi · arXiv
- J. Long, E. Shelhamer and T. Darrell, “Fully convolutional networks for semantic segmentation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2015. doi · arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional networks for biomedical image segmentation,” in Medical Image Computing and Computer-Assisted Intervention (MICCAI), LNCS vol. 9351, 2015. doi
- L.-C. Chen, Y. Zhu, G. Papandreou, F. Schroff and H. Adam, “Encoder-decoder with atrous separable convolution for semantic image segmentation,” in Proc. European Conference on Computer Vision (ECCV), 2018. doi · arXiv
- L.-C. Chen, G. Papandreou, I. Kokkinos, K. Murphy and A. L. Yuille, “DeepLab: Semantic image segmentation with deep convolutional nets, atrous convolution, and fully connected CRFs,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 40, no. 4, 2018. doi · arXiv
- F. Yu and V. Koltun, “Multi-scale context aggregation by dilated convolutions,” in Proc. International Conference on Learning Representations (ICLR), 2016. arXiv
- L.-C. Chen, G. Papandreou, F. Schroff and H. Adam, “Rethinking atrous convolution for semantic image segmentation,” arXiv:1706.05587, 2017. arXiv
- P. Wang, P. Chen, Y. Yuan, D. Liu, Z. Huang, X. Hou and G. Cottrell, “Understanding convolution for semantic segmentation,” in Proc. IEEE Winter Conference on Applications of Computer Vision (WACV), 2018. doi · arXiv
- H. Zhao, J. Shi, X. Qi, X. Wang and J. Jia, “Pyramid scene parsing network,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2017. doi · arXiv
- A. Dosovitskiy, L. Beyer, A. Kolesnikov, D. Weissenborn, X. Zhai, T. Unterthiner et al., “An image is worth 16x16 words: Transformers for image recognition at scale,” in Proc. International Conference on Learning Representations (ICLR), 2021. arXiv
- E. Xie, W. Wang, Z. Yu, A. Anandkumar, J. M. Alvarez and P. Luo, “SegFormer: Simple and efficient design for semantic segmentation with transformers,” in Advances in Neural Information Processing Systems (NeurIPS), 2021. NeurIPS · arXiv
- F. Milletari, N. Navab and S.-A. Ahmadi, “V-Net: Fully convolutional neural networks for volumetric medical image segmentation,” in Proc. Fourth International Conference on 3D Vision (3DV), 2016. doi · arXiv
- T.-Y. Lin, P. Goyal, R. Girshick, K. He and P. Dollár, “Focal loss for dense object detection,” in Proc. IEEE International Conference on Computer Vision (ICCV), 2017. doi
- B. Cheng, A. G. Schwing and A. Kirillov, “Per-pixel classification is not all you need for semantic segmentation,” in Advances in Neural Information Processing Systems (NeurIPS), 2021. NeurIPS · arXiv
- M. Cordts, M. Omran, S. Ramos, T. Rehfeld, M. Enzweiler, R. Benenson, U. Franke, S. Roth and B. Schiele, “The Cityscapes dataset for semantic urban scene understanding,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016. doi · arXiv
- B. Cheng, R. Girshick, P. Dollár, A. C. Berg and A. Kirillov, “Boundary IoU: Improving object-centric image segmentation evaluation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2021. doi · arXiv
- K. He, G. Gkioxari, P. Dollár and R. Girshick, “Mask R-CNN,” in Proc. IEEE International Conference on Computer Vision (ICCV), 2017. doi · arXiv
- S. Ren, K. He, R. Girshick and J. Sun, “Faster R-CNN: Towards real-time object detection with region proposal networks,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 39, no. 6, 2017. doi
- T.-Y. Lin, P. Dollár, R. Girshick, K. He, B. Hariharan and S. Belongie, “Feature pyramid networks for object detection,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2017. doi
- A. Kirillov, Y. Wu, K. He and R. Girshick, “PointRend: Image segmentation as rendering,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020. doi · arXiv
- A. Kirillov, R. Girshick, K. He and P. Dollár, “Panoptic feature pyramid networks,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019. doi · arXiv
- N. Carion, F. Massa, G. Synnaeve, N. Usunier, A. Kirillov and S. Zagoruyko, “End-to-end object detection with transformers,” in Proc. European Conference on Computer Vision (ECCV), 2020. doi · arXiv
- B. Cheng, I. Misra, A. G. Schwing, A. Kirillov and R. Girdhar, “Masked-attention mask transformer for universal image segmentation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2022. doi · arXiv
- J. Jain, J. Li, M. Chiu, A. Hassani, N. Orlov and H. Shi, “OneFormer: One transformer to rule universal image segmentation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2023. doi · arXiv
- T. Kerssies, N. Cavagnero, A. Hermans, N. Norouzi, G. Averta, B. Leibe, G. Dubbelman and D. de Geus, “Your ViT is secretly an image segmentation model,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2025. CVF · arXiv
- A. Kirillov, E. Mintun, N. Ravi, H. Mao, C. Rolland, L. Gustafson et al., “Segment anything,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV), 2023. doi · arXiv
- N. Ravi, V. Gabeur, Y.-T. Hu, R. Hu, C. Ryali, T. Ma et al., “SAM 2: Segment anything in images and videos,” in Proc. International Conference on Learning Representations (ICLR), 2025. OpenReview · arXiv
- N. Carion, L. Gustafson, Y.-T. Hu, S. Debnath, R. Hu, D. Suris et al., “SAM 3: Segment anything with concepts,” in Proc. International Conference on Learning Representations (ICLR), 2026. OpenReview · arXiv
- A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, S. Agarwal et al., “Learning transferable visual models from natural language supervision,” in Proc. International Conference on Machine Learning (ICML), PMLR 139, 2021. PMLR
- B. Li, K. Q. Weinberger, S. Belongie, V. Koltun and R. Ranftl, “Language-driven semantic segmentation,” in Proc. International Conference on Learning Representations (ICLR), 2022. OpenReview · arXiv
- S. Cho, H. Shin, S. Hong, A. Arnab, P. H. Seo and S. Kim, “CAT-Seg: Cost aggregation for open-vocabulary semantic segmentation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024. doi · arXiv
- C. Zhu and L. Chen, “A survey on open-vocabulary detection and segmentation: Past, present, and future,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 46, no. 12, 2024. doi
- M. Everingham, L. Van Gool, C. K. I. Williams, J. Winn and A. Zisserman, “The PASCAL Visual Object Classes (VOC) challenge,” International Journal of Computer Vision, vol. 88, no. 2, 2010. doi
- B. Zhou, H. Zhao, X. Puig, S. Fidler, A. Barriuso and A. Torralba, “Scene parsing through ADE20K dataset,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2017. doi · CVF
- T.-Y. Lin, M. Maire, S. Belongie, J. Hays, P. Perona, D. Ramanan et al., “Microsoft COCO: Common objects in context,” in Proc. European Conference on Computer Vision (ECCV), 2014. doi · arXiv
- H. Caesar, J. Uijlings and V. Ferrari, “COCO-Stuff: Thing and stuff classes in context,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2018. doi · arXiv
- G. Neuhold, T. Ollmann, S. Rota Bulò and P. Kontschieder, “The Mapillary Vistas dataset for semantic understanding of street scenes,” in Proc. IEEE International Conference on Computer Vision (ICCV), 2017. doi
- P. Krähenbühl and V. Koltun, “Efficient inference in fully connected CRFs with Gaussian edge potentials,” in Advances in Neural Information Processing Systems (NeurIPS), 2011. NeurIPS · arXiv
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 05・人體姿態與關鍵點估計 · 35 分鐘