IP 11・影像分割(二):主動輪廓——蛇模型與水平集
先備知識:IP 10・影像分割(一):邊緣偵測、閾值化與區域偵測
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
在硬幣的照片上執行真正的蛇模型(IP 11 的 Kass–Witkin–Terzopoulos 輪廓):在一枚硬幣外畫一個起始圓,看看圓最遠可以離硬幣邊緣多遠,蛇模型才不會停在錯的地方。
你將學到
- 為什麼可以把分割問題寫成「移動一條曲線,直到能量不再下降」,以及這樣做比門檻化和邊緣連接多了什麼好處。
- 蛇模型(snake,一種顯式、參數式的主動輪廓)如何由內部能量與外部能量定義,以及 Euler–Lagrange 方程式如何把能量變成迭代演算法。
- 外力該怎麼選:影像梯度、邊緣圖、梯度向量流(gradient vector flow, GVF)與氣球力(balloon force),以及它們各自要解決的問題。
- 水平集方法(level-set method)如何把曲線隱式表示為函數 的零等高線,並在 CFL 限制下以迎風有限差分求解 。
- 速度函數如何編碼以邊緣為主的模型(測地主動輪廓)與以區域為主的模型(源自 Mumford–Shah 的 Chan–Vese),以及符號距離重新初始化、窄帶法與形態學近似。
- 主動輪廓在今天的位置:成為深度網路裡的輪廓精修模組,以及損失函數。
先看全貌
IP 10 用的是局部規則:這個像素過門檻、那段邊緣連起來、這塊區域往外長。這些規則完全不在乎結果的形狀。於是我們可能得到有缺口的邊界、從弱邊緣漏出去的區域,或是一堆零散的孤立像素。
主動輪廓(active contour)換了一個角度。先在物體附近放一條封閉曲線,然後讓它動起來。影像推著曲線走(朝向邊緣,或朝向「裡面」與「外面」分得最好的位置),曲線本身的彈性又把它拉住(不喜歡被拉長、也不喜歡被折彎)。當兩邊的力互相抵消,曲線停下來,它最後的位置就是分割結果。輸出永遠是一條封閉、平滑的邊界,而不是一堆邊緣碎片。
本章依照課本 [1] 的編排,依序介紹這兩大家族。蛇模型(Kass、Witkin 與 Terzopoulos [2])把曲線存成一串點,直接移動這些點。水平集(Osher 與 Sethian [5])把曲線隱式地存成某個曲面的零等高線,改為移動曲面,因此曲線的分裂與合併會自動發生。兩者都是變分法(variational):先寫下一個能量,再對它做梯度下降。這個想法本身,比任何一條特定公式都更長壽,一路延續到了深度學習。
背景:為什麼要讓曲線動起來
白話地說:與其逐一判斷每個像素,不如一次描述整條邊界,然後問「這條邊界有多好?」,再一點一點改進它。
精確地說,主動輪廓方法有三個要素:
- 封閉曲線 在影像定義域 中的表示法:顯式(參數化曲線 )或隱式(函數 的零水平集)。
- 一個能量 ,當 是好邊界時能量低。它總是混合了規則性項(偏好短而平滑的曲線)與資料項(曲線上的邊緣很強,或曲線內外兩區各自很均勻)。
- 一條演化規則,改變 讓 下降,通常是以人工時間 寫成的偏微分方程式(PDE)形式的梯度下降。
和 IP 10 相比,規則性項能補上邊緣的缺口,輸出永遠是可以直接交給 IP 12 形狀描述子的封閉曲線,而先驗知識(使用者點一下的位置、對平滑的偏好、物體內部的灰階模型)也能自然地放進來。代價是能量不是凸函數:梯度下降只會找到局部最小值,所以結果取決於起點。
以蛇模型做影像分割
蛇模型是一串在影像上滑動的封閉點鏈。每個點同時感受到兩種拉力:相鄰的點讓鏈子保持短而平滑,影像則把它拖向邊緣。
蛇模型是一條參數曲線
我們把輪廓寫成
其中 是沿曲線繞一圈的參數,、 是影像座標。對 的導數記為 、。在電腦裡,曲線被取樣成 個點 ,;對封閉蛇模型而言,索引以 取模。
能量泛函
白話說:能量替每條曲線打分數。它把曲線被拉長、被彎折的程度加起來,再加上一個在我們希望曲線停留之處較低的影像項;蛇模型要找的是分數最低的曲線。
[2] 的蛇模型能量是
- 是彈性(張力)權重。 在曲線被拉長時變大,所以 讓蛇模型像一條想縮短的鬆緊帶。
- 是剛性(彎曲)權重。 衡量曲線轉彎有多急,所以 讓蛇模型像一根不肯被折彎的細金屬棒。
- 是外部(影像)能量,一個定義在整張影像上的純量場,在我們希望蛇停下的地方數值較低。
對灰階影像 ,常見的外部能量是
其中 是標準差為 的高斯函數, 是卷積, 是梯度,、 是權重。 時蛇被強邊緣吸引; 時被暗線吸引, 時被亮線吸引。高斯模糊把 的谷底變寬,讓蛇在幾個像素外就能「感覺」到邊緣;[2] 稱之為尺度空間延續(scale-space continuation)。
從能量到運動:Euler–Lagrange 方程式
要最小化這個能量,我們用變分法:最小化的曲線必須滿足被積函數的 Euler–Lagrange 方程式。若 、 為常數,它是
把它讀成力平衡: 是張力(指向局部曲率中心,讓曲線縮短), 是彎曲力(把折角拉直), 是影像力。平衡時三者互相抵消。
這條方程式通常無法直接解,所以讓 隨人工時間 變化,沿著下坡滑動:
其中 是黏滯(阻尼)常數。當 ,就回到 Euler–Lagrange 方程式。
選讀:推導蛇模型方程式(見「補充資料」頁)。一般形式的 Euler–Lagrange 方程式如何得出蛇模型的力平衡。
離散化與迭代解法
白話說:把曲線取樣成一串點之後,平滑力就變成一個固定的矩陣,所以蛇模型每走一步,每個座標只需要一次矩陣與向量的乘法。
以單位間距取樣 個點,中央差分給出
把所有 座標排成向量 ( 同理),則 ,其中 是對稱、循環、五對角的 矩陣,每一列以對角線為中心為
(在頭尾處循環繞回)。內力對點的位置是線性的,外力則不是。[2] 的經典技巧是半隱式步驟:內力部分以新時刻 隱式處理,外力部分以舊時刻 顯式處理:
則搭配 做同樣的事。、 是 在目前點位上(以內插)取得的分量, 是單位矩陣。 固定不變,只需反矩陣或分解一次;之後每次迭代只是一次便宜的矩陣–向量乘法。把剛硬的四階項隱式處理,正是蛇模型能走合理步長而不爆掉的原因。步長是 : 越大,步伐越小越安全。
程式碼 · Python · 13 行
import numpy as np

def snake_step_matrix(n, alpha, beta, gamma):
    """(A + gamma*I)^-1 for a closed snake with n points (h = 1)."""
    row = np.zeros(n)
    row[[0, 1, 2, -2, -1]] = [2*alpha + 6*beta, -alpha - 4*beta, beta,
                              beta, -alpha - 4*beta]
    A = np.stack([np.roll(row, i) for i in range(n)])
    return np.linalg.inv(A + gamma * np.eye(n))

M = snake_step_matrix(100, alpha=0.05, beta=0.05, gamma=1.0)
# one iteration, given external forces fx, fy sampled at the points:
# x = M @ (gamma * x + fx);  y = M @ (gamma * y + fy)
scikit-image 的 active_contour 建立相同的內部能量矩陣,也提供上面的邊緣與線條能量,但它並不是上述更新式的完全複本:它自行計算影像梯度,並限制每次迭代每個點最多能移動多遠 [12]:
程式碼 · Python · 13 行
import numpy as np
from skimage import data
from skimage.color import rgb2gray
from skimage.filters import gaussian
from skimage.segmentation import active_contour

img = rgb2gray(data.astronaut())
s = np.linspace(0, 2 * np.pi, 400)
init = np.column_stack([100 + 100 * np.sin(s),   # rows
                        220 + 100 * np.cos(s)])  # columns
snake = active_contour(gaussian(img, sigma=3), init,
                       alpha=0.015, beta=10, gamma=0.001)
print(snake.shape)  # (400, 2): the final (row, col) points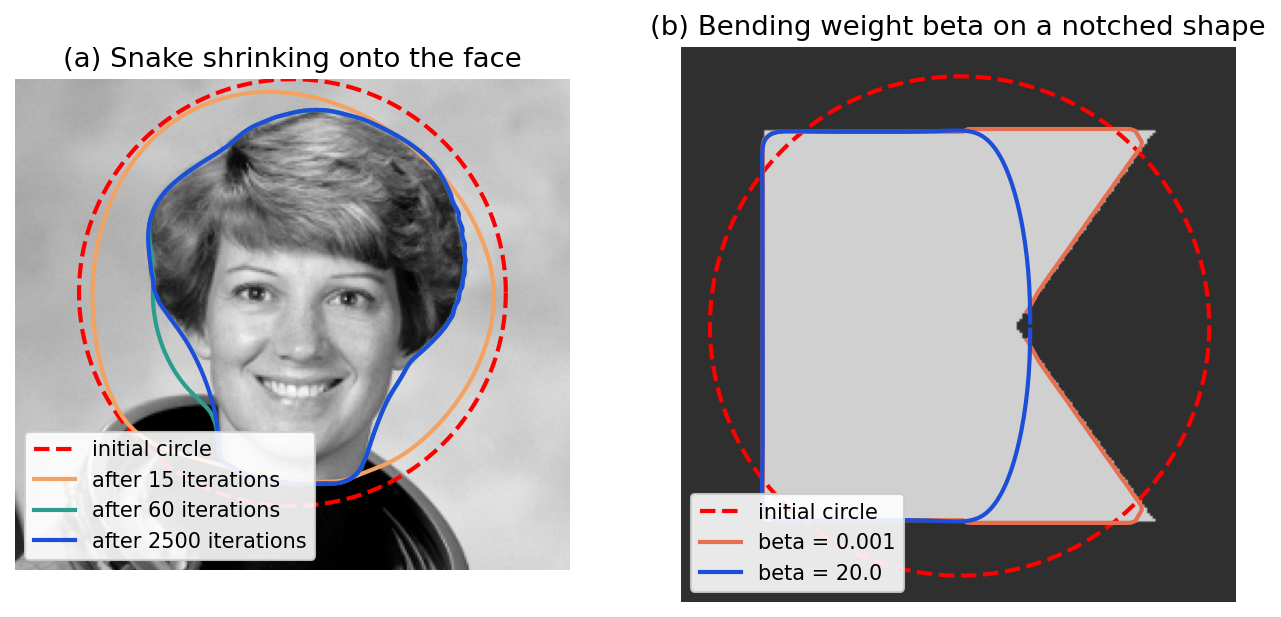
圖 11.1(a) 是蛇模型典型的一生:在平坦背景中只靠張力快速收縮,進入模糊邊緣圖有坡度的範圍後放慢,最後鎖定附近最強的邊緣。(b) 顯示 控制的取捨:剛硬的蛇不怕雜訊和小缺口,卻跟不上尖角與凹陷。
外力的選擇
外力決定蛇要找什麼。常見的選擇有:
- 邊緣圖的梯度。 先算一張在邊緣上數值大的邊緣圖 ,例如 (或其平方),再用 , 為權重。這個力沿 往上坡,指向邊緣的脊線。
- 線條吸引。 用 追蹤暗或亮的曲線狀結構(道路、血管、文字筆畫)。
它們有同一個弱點。邊緣圖的梯度在遠離邊緣處幾乎為零(圖 11.2a)。起點離邊界太遠的蛇,除了自己的張力之外什麼都感覺不到。而在狹窄的凹陷裡,兩側牆面的力都指向側面而互相抵消,沒有任何力把蛇往下拉進去。這兩個問題,捕捉範圍有限與難以收斂進凹陷,正是 GVF 的動機。
梯度向量流(GVF)
GVF 保留 好的部分(在有邊緣的地方準確指向邊緣),再以平滑擴散把其餘區域填滿。Xu 與 Prince [3] 把 GVF 場 定義為:在 大的地方貼近 、其餘地方盡量平滑的向量場;權重 平衡這兩個要求,雜訊越多應該越大。這個場以迭代擴散方程式計算:遠離邊緣時,場就只是從邊緣往外擴散,同時把邊緣的方向帶出去。顯式更新同時包含擴散,以及把向量場拉回邊緣梯度的反應項;時間步長必須一起考慮兩者。在單位網格間距下,程式使用 。其中 是保守的安全餘裕,不是 GVF 能量本身的參數。
選讀:GVF 能量與擴散方程式(見「補充資料」頁)。[3] 的泛函、每一項的要求,以及程式碼迭代的更新方程式。
程式碼 · Python · 23 行
import numpy as np
from scipy import ndimage as ndi

def gvf(f, mu=0.2, iters=500):
    """GVF on a unit-spaced grid, with a conservative explicit time step."""
    f = np.asarray(f, dtype=float)
    if f.ndim != 2 or min(f.shape) < 2 or not np.isfinite(f).all():
        raise ValueError("f must be a finite 2-D array with both dimensions >= 2")
    if not np.isfinite(mu) or mu <= 0:
        raise ValueError("mu must be finite and positive")
    fy, fx = np.gradient(f)
    mag2 = fx**2 + fy**2
    dt = 0.9 / (4 * mu + mag2.max())  # diffusion AND reaction enter the bound
    u, v = fx.copy(), fy.copy()
    for _ in range(iters):
        u += dt * (mu * ndi.laplace(u, mode="nearest") - (u - fx) * mag2)
        v += dt * (mu * ndi.laplace(v, mode="nearest") - (v - fy) * mag2)
    return u, v

edge_map = np.array([[0., 1.], [1., 0.]])
u, v = gvf(edge_map, mu=0.25, iters=100)
print(np.isfinite(u).all() and np.isfinite(v).all())  # True
print(np.round(u, 3))  # [[ 0.8  0.8], [-0.8 -0.8]]
接著蛇模型把 換成 ,演算法其餘部分完全不變。
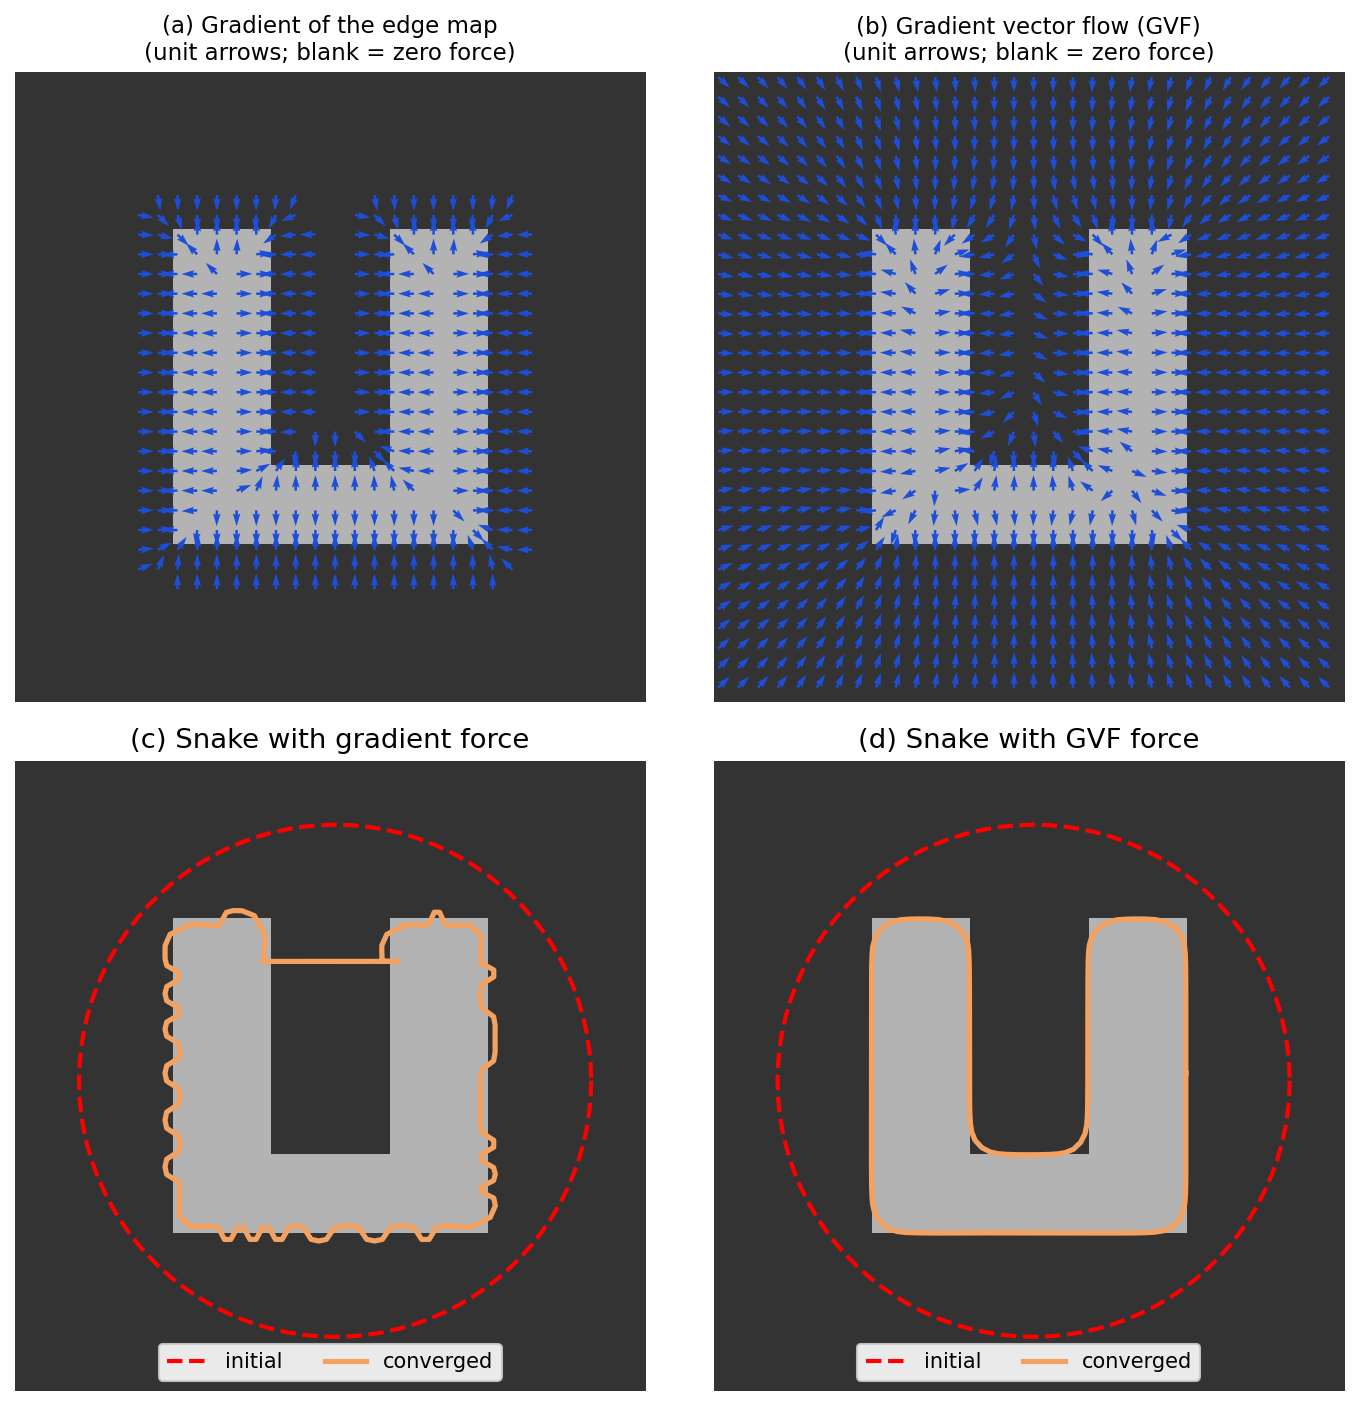
圖 11.2 在合成的 U 形上重現了 [3] 的經典測試。改變有兩點:蛇現在從影像任何地方都能感覺到物體(捕捉範圍大),而缺口內擴散後的向量是往下而非往側面指,所以蛇被拉進凹陷。有一個實作細節很重要:蛇進入缺口時長度變長,所以每隔幾十次迭代就要把點重新取樣成大致等間距,否則點鏈會太稀疏,貼不住牆面。
氣球力
Cohen [4] 從另一個角度處理捕捉範圍問題。如果把一條小蛇初始化在物體內部,張力會讓它在任何邊緣力碰得到它之前就縮成一點。那就加上壓力:
其中 是曲線在 的單位外法向量, 是壓力。 時蛇像氣球一樣膨脹; 時則洩氣收縮。在真正的邊界上,邊緣力必須能壓過壓力(那裡 ),但在物體內部微弱、雜亂的梯度處則不行。Cohen 也建議把邊緣力正規化成 ,讓一個常數就能控制各處的強度。
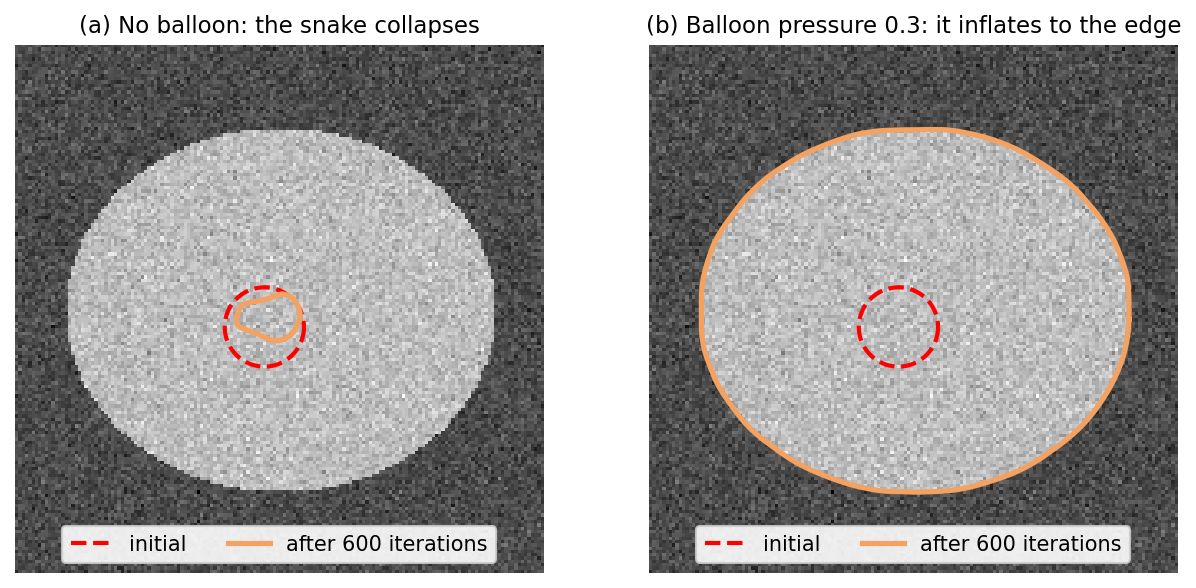
氣球力有代價:你必須事先知道該膨脹還是收縮,而壓力太大時蛇會直接衝過弱邊緣。GVF 與氣球力彼此互補,實務上常一起使用。
蛇模型的限制
- 初始化。 能量有許多局部最小值。即使用了 GVF,起點橫跨兩個物體、或落在雜亂強邊緣錯誤一側的蛇,仍會收斂到錯誤答案。
- 參數調整。 、、、、模糊程度 、壓力 與 GVF 的 互相影響。在一張影像上好用的數值,換一張常常就失效。
- 點的管理。 點會沿著曲線漂移,有的地方擠在一起,有的地方散開。實用的蛇模型需要重新取樣,還得偵測曲線是否自我相交。
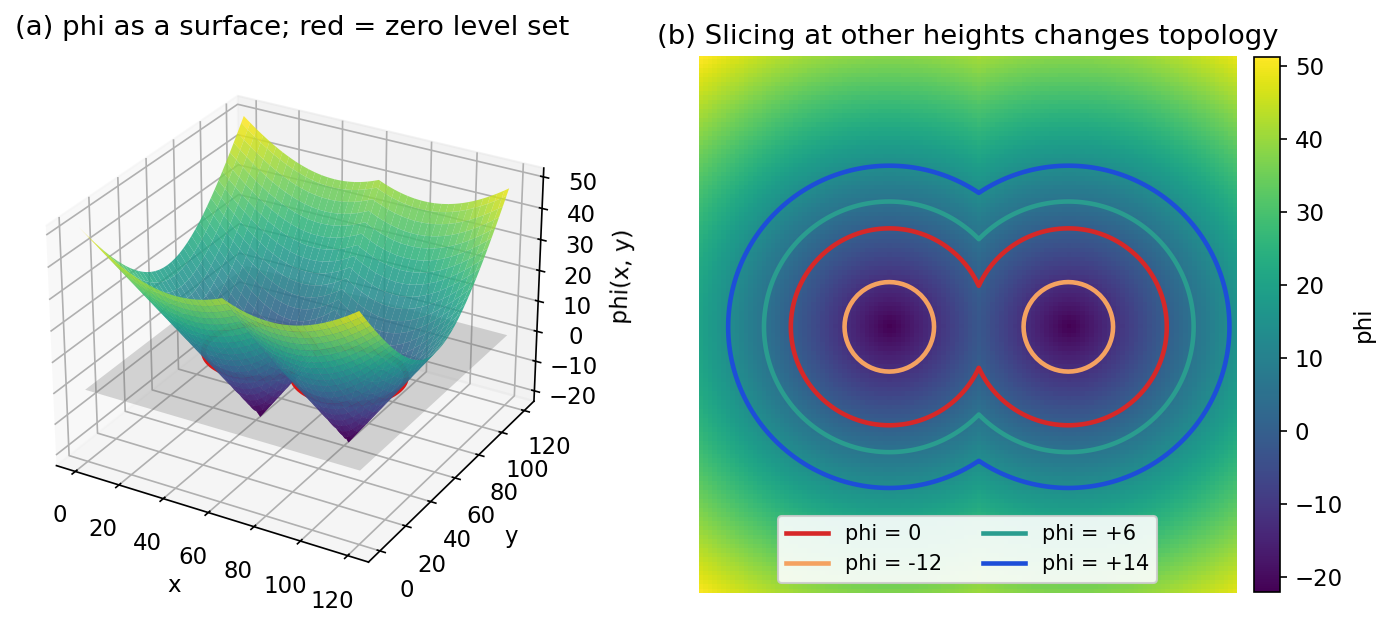
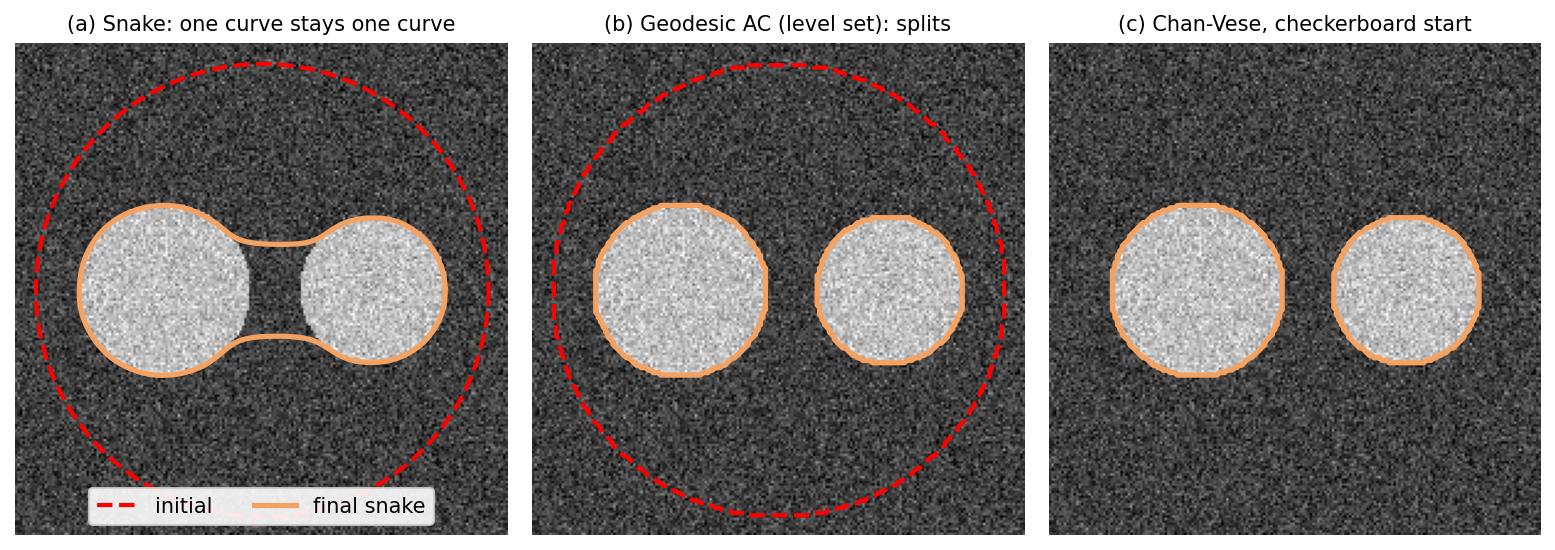
- 拓撲固定。 蛇是一條封閉點鏈。若不加額外且容易出錯的處理,它圍住兩個物體時無法分裂成兩條(圖 11.6a),也無法和另一條蛇合併。
最後這個限制,正是水平集要拿掉的。
以水平集做分割
不直接追蹤邊界,而是追蹤一片地形,讓它的海岸線就是邊界。把地形抬高或壓低,海岸線就跟著移動。如果水位上升到把兩座山丘分開,一條海岸線就變成兩條,不需要任何特殊程式碼。
隱式表示
白話說:在每個像素存一個高度,曲線就是高度為零的那條「海岸線」。
水平集函數(level-set function)是純量函數 ,使得時刻 的曲線就是它的零水平集:
本章採用的慣例是:曲線內部 ,外部 。(有些論文,包括 [8],採相反符號,方程式的正負號也隨之改變。)從 可以直接得到兩個幾何量:
其中 是單位外法向量, 是通過該點之等高線的曲率(凸的部分為正;半徑 的圓有 )。
最方便的 是符號距離函數(signed distance function): 是 到 的歐氏距離,正負號則區分內外。它幾乎處處滿足 ,讓數值計算保持良好。
水平集方程式
假設曲線上每一點沿外法向以速度 移動(正值代表向外):
曲線上的點始終保持零值,所以對所有 都有 。以連鎖律微分:
這就是 Osher 與 Sethian [5] 的水平集方程式。 是 對時間的導數, 是速度函數,可以取決於位置(影像資料)、曲線的幾何(曲率 )或全域統計量。方程式是在固定的像素網格上對所有 求解,而不只在曲線上;任何時刻都能取出零等高線得到曲線。方程式完全不在乎零集合有幾塊,所以分裂與合併自然發生。
離散計算:迎風差分與 CFL 條件
白話說:在網格上,波前必須用來的那一側的差分來更新,也就是 [5] 格式中的迎風(upwind)方向。令 為像素 在第 步(步長 ,網格間距 )的值;每一步都減去 乘上一個由單側差分組成的 迎風估計值,下面的 evolve 函式就是這樣實作的。若這裡改用普通的中央差分,會產生振盪,尖角也會被抹平甚至發散;迎風格式才能讓波前保持銳利且穩定。
選讀:迎風格式的公式(見「補充資料」頁)。完整寫出單側差分與兩個迎風梯度估計。
顯式格式只有在波前每步移動不超過一格時才穩定,這就是 Courant–Friedrichs–Lewy(CFL)條件:
實務上每一步都依目前的最大速度計算 ,下面的程式碼就是這樣做的。
程式碼 · Python · 26 行
import numpy as np
from scipy import ndimage as ndi

def signed_distance(mask):
    """Negative inside, positive outside, ~0 on the boundary."""
    return ndi.distance_transform_edt(~mask) - ndi.distance_transform_edt(mask)

def evolve(phi, F, steps=100, cfl=0.5):
    """Upwind scheme for phi_t + F |grad phi| = 0 (F is an array or scalar)."""
    for _ in range(steps):
        p = np.pad(phi, 1, mode="edge")
        dxm = phi - p[1:-1, :-2]; dxp = p[1:-1, 2:] - phi   # backward / forward
        dym = phi - p[:-2, 1:-1]; dyp = p[2:, 1:-1] - phi
        grad_plus = np.sqrt(np.maximum(dxm, 0)**2 + np.minimum(dxp, 0)**2 +
                            np.maximum(dym, 0)**2 + np.minimum(dyp, 0)**2)
        grad_minus = np.sqrt(np.minimum(dxm, 0)**2 + np.maximum(dxp, 0)**2 +
                             np.minimum(dym, 0)**2 + np.maximum(dyp, 0)**2)
        dt = cfl / (np.abs(F).max() + 1e-12)             # CFL: |F| dt <= dx
        phi = phi - dt * (np.maximum(F, 0) * grad_plus + np.minimum(F, 0) * grad_minus)
    return phi

yy, xx = np.mgrid[:128, :128]
phi = signed_distance((xx - 64)**2 + (yy - 64)**2 < 20**2)
phi = evolve(phi, F=1.0, steps=20)                # grow outward by 20 * 0.5 = 10 px
phi = signed_distance(phi < 0)                     # re-initialize
print(np.sqrt((phi < 0).sum() / np.pi))            # radius, about 30
指定速度函數
所有的影像分析都寫在 裡。主流有兩大家族。
以邊緣為主的速度:測地主動輪廓
白話說:讓波前在平坦區域跑得快、在邊緣上變慢,它就會停在邊緣所在之處。
定義一個邊緣停止函數,在平坦區域接近 、在邊緣上接近 ,例如
Caselles、Kimmel 與 Sapiro [6] 指出, 的蛇模型與尋找加權長度最小的曲線密切相關:
其中 是弧長。在 定義的度量下,邊緣是「便宜」的地方,所以最小化者是一條緊貼邊緣的測地線(最短路徑)。這就是測地主動輪廓(geodesic active contour, GAC)。對 做梯度下降,再加上一個類似 Cohen 氣球的選擇性常數壓力 ,在本章的符號慣例下得到
每一項各有任務。 是曲率流(縮短並平滑曲線),在邊緣附近減速到停止。 是壓力: 膨脹、 收縮,同樣在邊緣上被關掉。 是平流項,把曲線拉進邊緣谷底( 最小處),避免它衝過頭。與蛇模型不同,GAC 是內蘊的(intrinsic):它與曲線如何參數化無關;寫成水平集形式後,也能自由分裂與合併。
由於 永遠不會真正等於零,強壓力仍會從微弱或模糊的邊緣漏出去。這正是以區域為主之速度函數的動機。
以區域為主的速度:Mumford–Shah 與 Chan–Vese
白話說:不去找邊緣,而是挑一條曲線,把影像分成內外兩部分,並讓兩部分各自盡可能均勻。
Mumford 與 Shah [7] 把分割寫成:同時找出影像的分段平滑近似與一組邊界。他們的能量在三個願望之間取得平衡:貼近影像、除了跨越邊界之外處處平滑,以及邊界要短。這個能量一般而言很難最小化。
選讀:Mumford–Shah 能量(見「補充資料」頁)。完整的泛函,以及三項各自的要求。
Chan 與 Vese [8] 把 限制成只有兩個值的分段常數: 內為 , 外為 。能量變成
(原論文還有一個選擇性的面積項 ,通常設為零)。 是平滑權重, 衡量各區域被其常數擬合得多好。注意少了什麼:完全沒有梯度。這個模型可以分割邊界模糊、或只由平均亮度改變所定義的物體,這也是 [8] 取名為「沒有邊緣的主動輪廓」(active contours without edges)的原因。
要改寫成水平集形式,使用 Heaviside 函數 ( 時為 ,否則為 )及其導數 Dirac delta 。內部 時,內部指示函數是 ,長度是 。固定 時,最佳常數就是兩區的平均:
固定 時,對 做梯度下降得到
其中 是寬度為 的平滑化 delta。逐像素來讀:如果某像素的亮度離 遠、離 近,括號為正, 上升,這個像素就移到外面。曲率項讓邊界保持短。演算法交替更新平均值與 。由於 在零水平集以外也不為零,這個模型還能在離初始曲線很遠的地方產生新的輪廓,有助於在 [8] 的範例中偵測內部孔洞與不相連物件。這種行為取決於所選正規化;能量仍然非凸,不同初始曲線可能收斂至不同局部極小值。
選讀:Chan–Vese(見「論文導讀」頁)。閱讀原始區域擬合圖、初始化限制,以及擬合能量與完整目標的差別。
Chan–Vese 只是區域式模型大家族中的一員:任何區域的機率模型都可以取代那兩個常數 [14]。
選讀:其他區域模型(見「補充資料」頁)。同樣的結構如何搭配高斯、色彩、紋理或運動模型。
程式碼 · Python · 8 行
from skimage import data, img_as_float
from skimage.segmentation import chan_vese, morphological_chan_vese

cam = img_as_float(data.camera())
seg, phi, energies = chan_vese(cam, mu=0.25, lambda1=1, lambda2=1,
                               dt=0.5, max_num_iter=200, extended_output=True)
fast = morphological_chan_vese(cam, num_iter=100, init_level_set="checkerboard",
                               smoothing=3)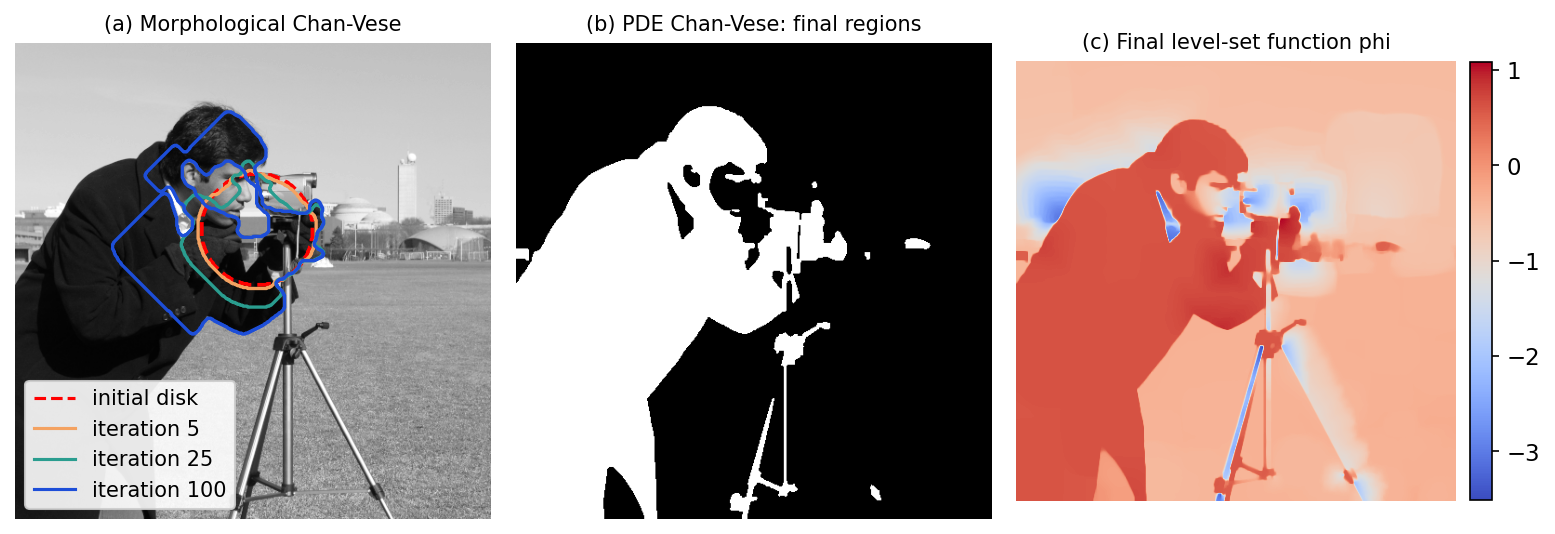
以符號距離函數初始化與重新初始化
初始的 通常是到某條曲線的符號距離:使用者畫的曲線、一個方框、一個圓盤,或許多小圓組成的「棋盤格」,讓演化從每個可能的物體附近開始。PDE 執行時, 會逐漸偏離距離函數:有些地方變得很陡,有些地方變得很平。陡的地方逼迫時間步長變得極小;平的地方則讓零交越點位置不準、容易受雜訊影響。
經典的補救方法是重新初始化(reinitialization):每隔幾次迭代,在不移動零水平集的前提下,把 換成到目前零水平集的符號距離,例如像上面程式那樣用快速歐氏距離轉換重算。Li、Xu、Gui 與 Fox [10] 提出距離正則化水平集演化(distance-regularized level-set evolution, DRLSE),在能量中加入一個讓 保持接近 的懲罰項,因此不再需要重新初始化。
選讀:重新初始化與 DRLSE 的細節(見「補充資料」頁)。取代距離轉換的 PDE 做法、它的缺點,以及 DRLSE 的懲罰項。
提升效率
全網格的水平集求解器每一步都更新每個像素,但真正重要的只有零交越處。三種標準的加速方式:
- 窄帶法(narrow band)。Adalsteinsson 與 Sethian [9] 只在零水平集周圍半寬 (幾個像素)的帶狀區域內更新 。波前接近帶的邊緣時,就以新波前為中心重建窄帶(同時重新初始化)。每步的工作量從整張影像面積降到大約曲線長度乘以 。
- 更大的穩定步長。 半隱式或算子分裂格式可讓剛硬的曲率項使用更大的 ,代價是每步要解一個線性系統。
- 形態學近似。 Márquez-Neila、Baumela 與 Álvarez [11] 以一連串作用在二值水平集上的二值形態學算子(膨脹、侵蝕與平滑算子)取代 PDE。結果速度快、沒有時間步長、不需要重新初始化,也不會數值不穩定。
scikit-image 依據 [11] 提供 morphological_geodesic_active_contour 與 morphological_chan_vese,另外也有以 PDE 為基礎的 chan_vese [12]。請記住,形態學版本是 PDE 的近似:它們在像素網格上移動,「smoothing」參數是算子套用的次數而不是權重 ,結果與連續模型相近,但並不相同。
選讀:形態學近似如何運作(見「補充資料」頁)。哪個算子取代哪一項 PDE,以及他們證明了什麼。
程式碼 · Python · 9 行
from skimage import data, img_as_float
from skimage.segmentation import (inverse_gaussian_gradient, disk_level_set,
                                  morphological_geodesic_active_contour)

coins = img_as_float(data.coins())
g = inverse_gaussian_gradient(coins, alpha=100, sigma=2)   # ~0 on edges, ~1 elsewhere
init = disk_level_set(coins.shape, radius=150)
mask = morphological_geodesic_active_contour(g, num_iter=250, init_level_set=init,
                                             smoothing=1, balloon=-1, threshold=0.69)
這裡 inverse_gaussian_gradient 建立邊緣停止函數 ,balloon=-1 讓初始圓盤收縮(相當於 ),threshold 決定 的哪些值算是能擋住氣球的邊緣。
實務比較:蛇模型與水平集
兩個家族最小化的能量很相似,差別主要在表示法,而表示法決定了什麼事情容易做。
簡單說:蛇模型的未知數少( 個點)、每次迭代便宜、容易互動編輯,點還能帶標籤,但拓撲固定,點會漂移,也可能交叉。水平集每個像素(或窄帶內每個像素)有一個未知數,但能自動分裂與合併、不可能自我相交,也能直接推廣到 3D。兩者典型的失敗也不同:蛇模型會卡在雜亂背景或凹陷處;邊緣式水平集會從弱邊緣漏出去;區域式水平集則會把外觀相似的區域合併。
選讀:蛇模型與水平集:逐項比較(見「補充資料」頁)。以十列的表格比較兩種表示法。
Xu、Yezzi 與 Prince 研究過兩種表述之間的關係 [3];對許多能量而言,選擇哪一種是實作上的考量,而不是原則上能不能建模。經驗法則:
- 需要一條拓撲已知的邊界、要互動、要快、或需要點的對應關係時(在影片各影格間追蹤輪廓、擬合嘴唇外形、描繪建物輪廓),用蛇模型。
- 物體數量未知、物體可能相接或分裂、邊界無法以梯度清楚定義(區域式模型),或在 3D 中工作時,用水平集。
現代觀點
主動輪廓已經不是分割影像的預設方法,深度網路才是。但本章的想法,包括結合邊界長度與區域擬合的能量、反覆變形的顯式輪廓,以及把水平集當作形狀表示,仍是深度分割中活躍的成分。以下六篇論文構成一張不錯的地圖。
醫學影像中的可變形模型。 McInerney 與 Terzopoulos [13] 寫下了經典的早期綜述。它的主要結論至今仍成立:當影像本身含糊不清、需要模型提供平滑性與先驗知識時,可變形模型最有用。
統計式區域水平集。 Cremers、Rousson 與 Deriche [14] 從同一個貝氏框架推導出以區域為主的水平集方法:每個區域都有一個機率模型(針對亮度、色彩、紋理或運動)。他們主張區域式能量比邊緣式蛇模型對雜訊較不敏感、局部最小值也較少。
近期的分類。 Chen、Ge、Wang 與 Chen [15] 把主動輪廓模型分為邊緣式、區域式與混合式,並與深度學習分割比較。傳統模型不需要訓練資料、能給出平滑的封閉邊界,但對初始化和參數敏感;在有標註資料的情況下,深度模型更準確;兩者是互補的。
深度分割中的形狀限制。 Bohlender、Oksuz 與 Mukhopadhyay [16] 綜述了如何把形狀知識(包括主動輪廓與符號距離圖)注入深度醫學影像分割,以修補逐像素分類器產生的破碎區域與拓撲錯誤。
選讀:四篇綜述的詳細內容(見「論文導讀」頁)。每篇綜述涵蓋什麼,以及它如何整理這個領域。
端對端學習的顯式輪廓。 Peng 等人的 Deep Snake [17] 保留了蛇模型的表示法,也就是一個反覆變形的封閉多邊形,但改用學習而來的更新:在頂點位置取樣 CNN 特徵,再沿多邊形做環狀卷積(circular convolution),預測每個頂點朝邊界的位移;作者報告它在實例分割上可達即時速度。環狀卷積扮演的正是經典蛇模型中五對角矩陣 的角色:沿著封閉曲線把每個頂點與它的鄰居耦合起來。
把主動輪廓能量當作損失函數。 有些方法不在測試時執行輪廓演化,而是把能量放進訓練損失:帶有長度項與區域項、類似 Chan–Vese 的監督式損失 [18];作用在網路 softmax 輸出上、不需要標註,因此也支援非監督與半監督訓練的 Mumford–Shah 風格損失 [19];以及邊界損失(boundary loss)[20],它是一個以真值符號距離圖加權的區域積分,專為微小病灶這類極度不平衡的問題設計。
選讀:三種主動輪廓損失的細節(見「補充資料」頁)。每種損失如何建構,以及作者報告了什麼。
深度學習改變了什麼、沒改變什麼:
- 改變了:資料項。 手工設計的力(、GVF、、區域平均)被學習到的特徵取代,這是準確度提升的主因。
- 沒改變:規則性先驗。 邊界長度、曲率懲罰、符號距離表示與區域均勻性,以損失項和輸出表示的形式重新出現,因為沒有它們,逐像素分類器仍會產生參差不齊、破碎的邊界。
- 沒改變:顯式與隱式的取捨。 以輪廓為基礎的網路繼承了蛇模型固定的拓撲(每個實例一個多邊形)與速度;以遮罩或距離圖為基礎的網路則繼承了水平集的彈性。
- 本身仍然有用。 沒有標註資料時,用 scikit-image 跑 Chan–Vese 或 GAC 只要幾行程式、不需訓練,很適合當基準、產生偽標籤,或作為清理網路遮罩的後處理步驟。
重點整理
- 主動輪廓透過在曲線上最小化能量來分割:規則性項(長度、彎曲)加上資料項(邊緣或區域擬合)。對能量做梯度下降,就是一條人工時間中的 PDE。
- 蛇模型是顯式的點鏈。它的 Euler–Lagrange 方程式 以半隱式步驟 求解。
- 單純的梯度力捕捉範圍小,也進不了凹陷。GVF 把邊緣向量擴散到整張影像;氣球力讓曲線膨脹或收縮。
- 水平集把曲線存成 ,在 CFL 步長限制下以迎風差分演化 ,拓撲改變自動發生。
- 模型寫在速度 裡:測地主動輪廓最小化以邊緣加權的長度;Chan–Vese 擬合兩個區域平均,不需要邊緣。
- 讓 保持接近符號距離(重新初始化或 DRLSE),並用窄帶或形態學近似節省計算;後者是近似 PDE,而不是精確求解。
- 在深度學習中,同樣的想法以學習式輪廓變形(Deep Snake)以及由長度、區域與符號距離項構成的損失函數延續下來。
練習
1. 只有張力。 一條 、沒有外力的封閉蛇,初始為半徑 的圓,以 個等距點取樣。利用離散內力 ,證明圓仍然是圓,並求出步長 的一次顯式更新後半徑如何改變。
提示
對角度間隔 的正多邊形(從圓心量起),。內力為 ,指向圓心,所以 。圓以等比方式縮小;注意縮小速率與 有關,這也是蛇模型參數會與取樣綁在一起的原因之一。
2. 凹陷測試。 用上面的 gvf 函數建立圖 11.2 的 U 形,改變 GVF 權重 (0.05、0.1、0.2)與 GVF 迭代次數。哪個參數決定場能從邊緣延伸多遠?哪個決定它有多平滑?
提示
擴散長度大致隨 成長,其中 是迭代次數。較大的 也改變平滑與資料擬合的平衡。程式依擴散和反應項調整 ,所以 不會自動導致不穩定;改變 時,應比較相同演化時間,或使用固定的收斂容許值。
3. 正負號與方向。 在本章慣例(內部 )下,當 時,圓在 下會怎樣? 時呢?分別寫出半徑 。
提示
:圓以單位速度縮小,。:曲線縮短流,,所以 ,圓在 時消失。
4. 實際體會 CFL。 用 evolve 程式碼片段,在同一個圓上分別以 cfl=0.5、1.0、2.0 執行。量測最後的半徑並觀察零等高線。哪裡壞掉了?為什麼窄帶法無法移除這個限制?
提示
超過 1 時,波前每一步試圖跨越不只一格;迎風資訊取自錯誤的位置,輪廓變得鋸齒狀,甚至數值發散。窄帶法減少的是更新的像素數,而不是每一步的大小。
5. Chan–Vese 失效的時候。 建立一張合成影像:左半部是由黑到白的平滑漸層;右半部是灰色背景上的一個灰色圓盤,兩者平均值相同但變異數不同(只在圓盤內加強烈雜訊)。執行 chan_vese,從能量的角度解釋結果,並提出一個能成功的區域模型修改。
提示
Chan–Vese 只比較平均值,所以(平均相同的)圓盤是看不見的,而漸層會從中間被切開。若像 [14] 的統計框架那樣,以各自擁有平均值和變異數的高斯分布描述每個區域,圓盤就能被分開。
6. 把能量當作損失。 改用軟遮罩 (屬於內部的機率)而非水平集來寫 Chan–Vese 能量,並以總變差 取代長度項。證明固定 時最佳的 是加權平均,並說明為什麼這個函數可以在沒有標註的情況下訓練網路。
提示
。令 得 。 中沒有任何地方用到真值,只用到影像本身,所以不需標註就能對產生 的網路求梯度;可與 [19] 對照。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 11. publisher page
- M. Kass, A. Witkin, and D. Terzopoulos, “Snakes: Active contour models,” International Journal of Computer Vision, vol. 1, no. 4, pp. 321–331, 1988. doi:10.1007/BF00133570
- C. Xu and J. L. Prince, “Snakes, shapes, and gradient vector flow,” IEEE Transactions on Image Processing, vol. 7, no. 3, pp. 359–369, 1998; see also C. Xu, A. Yezzi Jr., and J. L. Prince, “On the relationship between parametric and geometric active contours,” Proc. 34th Asilomar Conf. on Signals, Systems, and Computers, 2000. GVF project page with both papers
- L. D. Cohen, “On active contour models and balloons,” CVGIP: Image Understanding, vol. 53, no. 2, pp. 211–218, 1991. author PDF
- S. Osher and J. A. Sethian, “Fronts propagating with curvature-dependent speed: Algorithms based on Hamilton–Jacobi formulations,” Journal of Computational Physics, vol. 79, pp. 12–49, 1988. doi:10.1016/0021-9991(88)90002-2
- V. Caselles, R. Kimmel, and G. Sapiro, “Geodesic active contours,” International Journal of Computer Vision, vol. 22, no. 1, pp. 61–79, 1997. PDF
- D. Mumford and J. Shah, “Optimal approximations by piecewise smooth functions and associated variational problems,” Communications on Pure and Applied Mathematics, vol. 42, no. 5, pp. 577–685, 1989. doi:10.1002/cpa.3160420503
- T. F. Chan and L. A. Vese, “Active contours without edges,” IEEE Transactions on Image Processing, vol. 10, no. 2, pp. 266–277, 2001. doi:10.1109/83.902291
- D. Adalsteinsson and J. A. Sethian, “A fast level set method for propagating interfaces,” Journal of Computational Physics, vol. 118, pp. 269–277, 1995. summary page
- C. Li, C. Xu, C. Gui, and M. D. Fox, “Distance regularized level set evolution and its application to image segmentation,” IEEE Transactions on Image Processing, vol. 19, no. 12, pp. 3243–3254, 2010. doi:10.1109/TIP.2010.2069690
- P. Márquez-Neila, L. Baumela, and L. Álvarez, “A morphological approach to curvature-based evolution of curves and surfaces,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2014. doi:10.1109/TPAMI.2013.106
- scikit-image developers, “skimage.segmentation” API reference (
active_contour,chan_vese,morphological_chan_vese,morphological_geodesic_active_contour). docs - T. McInerney and D. Terzopoulos, “Deformable models in medical image analysis: A survey,” Medical Image Analysis, vol. 1, no. 2, 1996. author PDF
- D. Cremers, M. Rousson, and R. Deriche, “A review of statistical approaches to level set segmentation: Integrating color, texture, motion and shape,” International Journal of Computer Vision, vol. 72, no. 2, pp. 195–215, 2007. doi:10.1007/s11263-006-8711-1
- Y. Chen, P. Ge, G. Wang, and H. Chen, “An overview of intelligent image segmentation using active contour models,” Intelligence & Robotics, vol. 3, no. 1, pp. 23–55, 2023. open access
- S. Bohlender, I. Oksuz, and A. Mukhopadhyay, “A survey on shape-constraint deep learning for medical image segmentation,” IEEE Reviews in Biomedical Engineering, vol. 16, pp. 225–240, 2023. arXiv:2101.07721
- S. Peng, W. Jiang, H. Pi, X. Li, H. Bao, and X. Zhou, “Deep snake for real-time instance segmentation,” CVPR, 2020. arXiv:2001.01629
- X. Chen, B. M. Williams, S. R. Vallabhaneni, G. Czanner, R. Williams, and Y. Zheng, “Learning active contour models for medical image segmentation,” CVPR, 2019. CVF open access
- B. Kim and J. C. Ye, “Mumford–Shah loss functional for image segmentation with deep learning,” IEEE Transactions on Image Processing, vol. 29, pp. 1856–1866, 2020. doi · arXiv:1904.02872
- H. Kervadec, J. Bouchtiba, C. Desrosiers, E. Granger, J. Dolz, and I. Ben Ayed, “Boundary loss for highly unbalanced segmentation,” Medical Image Analysis, vol. 67, 2021 (first presented at MIDL 2019). arXiv:1812.07032
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 IP 12・特徵擷取 · 26 分鐘