IP 02・數位影像基礎
先備知識:IP 01・緒論
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 人眼如何感知光,以及為什麼我們「看到的」不一定是「實際存在的」(亮度適應、Weber 比、馬赫帶、同時對比)
- 影像在物理上從哪裡來:電磁波譜、感測器,以及照度–反射率模型
- 取樣與量化在做什麼、它們如何決定空間解析度與強度解析度,以及最近鄰、雙線性、雙三次內插如何縮放影像
- 像素之間關係的術語:鄰居、相鄰、連通、區域、邊界,以及三種距離量測
- 之後每一章都會用到的數學工具箱:逐元素運算與矩陣運算、線性、算術運算、集合與邏輯運算、幾何轉換、影像轉換,以及把直方圖當成機率
先看全貌
第 1 章說明了數位影像處理「是什麼」。這一章要回答「數位影像到底是什麼」:從離開場景的光開始,一路走到記憶體裡的一格格整數。途中我們會定義像素、鄰居、解析度、線性運算子等詞彙——之後整個系列都會直接使用它們,不再另外解釋。
這一章不只是記帳。第一,大多數影像最後是給人看的,所以我們必須知道眼睛在哪裡容易被騙、在哪裡又特別敏銳。第二,拍攝影像時做的每個選擇——取樣多少點、量化成幾階、用哪一種內插——都會留下痕跡,後續的演算法只能與之共處。深度學習並沒有讓這些選擇消失;它多半只是把這些選擇搬進了訓練資料與損失函數裡,「現代觀點」一節會說明這點。
視覺感知的要素
白話說:你的眼睛是一台由膠狀物質和神經細胞組成的相機。它非常擅長看出「差異」與「邊緣」,卻不太會判斷絕對亮度。
眼睛的構造與成像
光線穿過角膜,通過瞳孔(大小由虹膜控制),再由水晶體聚焦到視網膜上——那是眼球後方一層薄薄的感光細胞 [1]。水晶體是有彈性的:睫狀肌改變它的曲率,也就改變了焦距,讓遠近物體都能對焦。視網膜上的像是倒立的實像,和相機感測器上的像一樣。
視網膜上有兩種感光細胞 [1]:
- 錐細胞(cones)——每隻眼睛有數百萬個,最密集地分布在中央一個小凹處,稱為中央窩(fovea)。它們在明亮環境下運作(明視覺,photopic vision),分成三種光譜敏感度不同的類型,帶給我們色彩與細節。許多錐細胞擁有自己專屬的神經連結,所以中央窩的視覺特別清晰。
- 桿細胞(rods)——數量多出許多倍,散布在整個視網膜上,但中央窩正中央沒有。它們在昏暗環境下運作(暗視覺,scotopic vision),無法分辨顏色,而且許多桿細胞共用一條神經末梢,用細節換取靈敏度。這就是為什麼月光下的物體看起來沒有顏色、輪廓也比較柔和。
視神經離開眼球的地方完全沒有感光細胞,稱為盲點。你平常察覺不到,是因為大腦會自動把空缺補上——這是一個早期的線索:知覺是一種主動的重建,而不是單純的記錄。
亮度適應與亮度辨別
視覺系統能應付極大範圍的光強度,從星光到陽光都行。它靠的是亮度適應(brightness adaptation):在任一時刻,它只在以目前適應水準為中心的一個窄窗內運作,而這個窗會隨整體光線改變而滑動 [1]。在窗內,主觀亮度大致隨物理光強度的對數成長,而不是線性成長。
我們能察覺多小的變化?讓觀察者看一片強度為 的均勻背景,再閃一個強度為 的小光點。有一半機率被察覺到的增量記為 。比值
稱為 Weber 比(Weber ratio),其中 是背景強度, 是剛好能察覺的增量。 越小代表辨別能力越好(很小的相對變化就看得出來)。在很寬的中間強度範圍內, 大致是常數,這就是 Weber 定律:我們感受到的是相對變化,而不是絕對變化。在低強度、由桿細胞主導時, 很大,辨別能力很差 [1]。
這有直接的工程意義。因為我們感受的是相對變化,物理上等間隔的灰階在知覺上並不等間隔。這也是影像通常以非線性(gamma)編碼儲存的原因之一,以及 8 位元通常就足以顯示的原因之一。
馬赫帶、同時對比與錯覺
感受到的亮度並不是強度的簡單函數。兩個經典示範讓這件事一目了然 [1]:
- 馬赫帶(Mach bands)。給人看一組階梯狀、各自均勻的灰色條紋。每一條在物理上都是均勻的,但觀察者會說在每個邊緣的暗側看到一條更暗的細帶、亮側看到一條更亮的細帶。視覺系統會誇大邊緣,這與相鄰感受野之間的側向抑制(lateral inhibition)相符——本質上就是一個內建的銳化濾波器。
- 同時對比(simultaneous contrast)。同一塊中灰色方塊,放在暗背景上看起來較亮,放在亮背景上看起來較暗,儘管兩塊方塊完全相同。感受到的亮度取決於周圍環境。
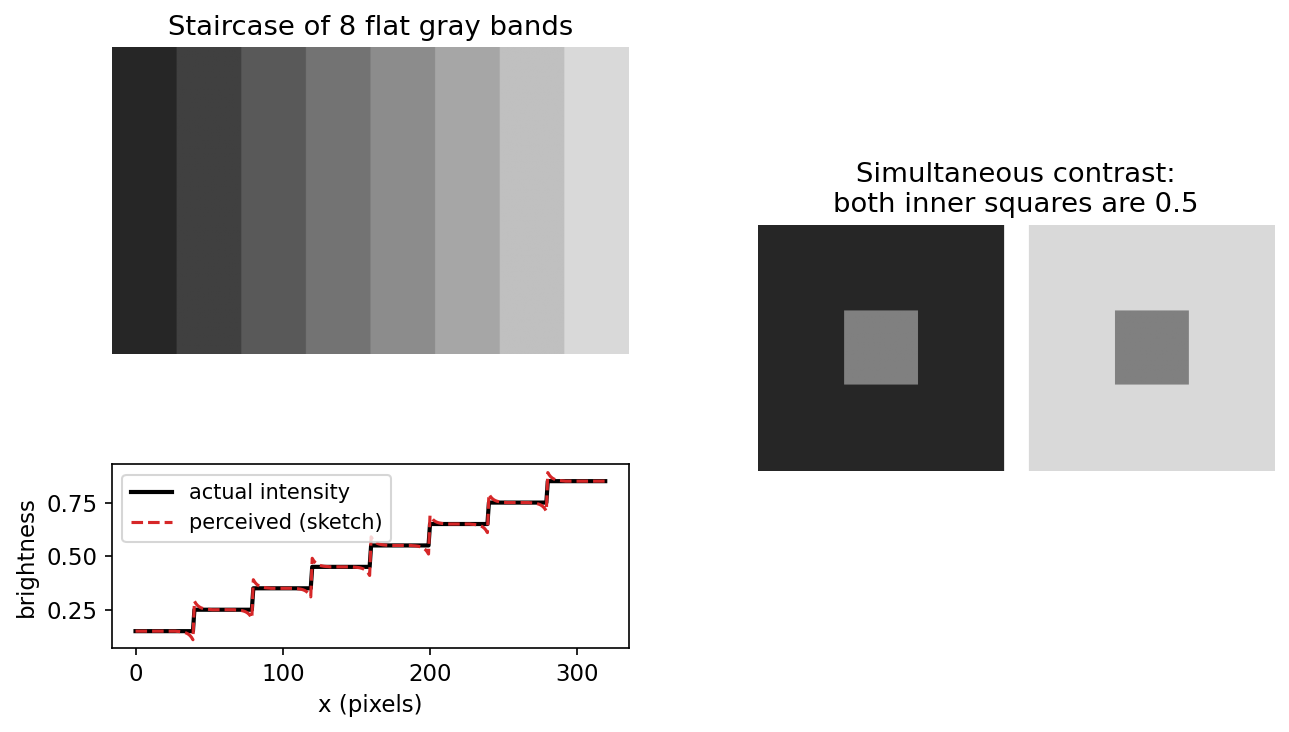
一般的視錯覺——看見沒畫出來的輪廓、等長線段看起來不等長——都顯示眼睛會補足並重新詮釋。這對影像處理有兩層意義:一個把平方誤差降到最低的演算法,產生的影像仍可能看起來不對;而數值上很小的瑕疵,若剛好落在邊緣上,可能非常顯眼。這正是感知品質指標的出發點,會在「現代觀點」中討論。
光與電磁波譜
白話說:光是一種能量波。可見光只是寬廣波譜中薄薄的一片,這個波譜還包括無線電波、微波、紅外線、紫外線、X 射線與伽瑪射線——而這些都可以拿來成像。
波長、頻率與能量
電磁輻射可以描述成正弦波,也可以描述成一串無質量的粒子,稱為光子 [1]。兩種描述的關係是
其中 是波長(公尺), 是頻率(赫茲), m/s 是光速, 是單一光子的能量(焦耳), 是普朗克常數。波長越短,頻率越高,每個光子的能量也越高。所以伽瑪射線和 X 射線能穿透組織,而無線電波需要很大的天線才能偵測。
可見光大約從 400 nm(紫)到 700 nm(紅)。物體看起來是什麼顏色,取決於它反射哪些波長:綠葉主要反射波段中段的光,其餘被吸收。沒有顏色、只有強度的光稱為無色光(achromatic)或單色光(monochromatic),它的強度稱為灰階(gray level)。
量測光的三個詞
「光有多少」可以指三件不同的事。輻射度(radiance)是光源發出的物理能量,輝度(luminance)是其中眼睛感受得到的部分,亮度(brightness)則是主觀的感覺,會受適應狀態與周圍環境影響。要記住的一點:感測器和眼睛一樣,只看得到它敏感波段裡的能量。
選讀:輻射度、輝度與亮度(見「補充資料」頁)。三個詞的精確定義,以及感測器的波段如何限制它能拍到什麼。
影像感測與擷取
白話說:感測器就是一個把光轉成電壓的小小測光表。把很多個排成一列或一個網格,就成了掃描器或相機。
單一、線型與陣列感測器
每一種成像裝置都結合了照明光源、場景,以及由對目標能量有反應的材料做成的感測器 [1]。感測器輸出的電壓經數位化後成為一個數字。感測器有三種排列方式:
- 單一感測器。一個偵測器(例如光二極體)加上兩個方向的機械移動,一次一個取樣點地掃出整張影像。速度慢,但便宜又非常精確,一些高精度掃描器採用這種方式。
- 線型(條狀)感測器。一排偵測器一次擷取一條線,再靠垂直於感測條的移動提供第二個維度。平台式掃描器和航空推掃式(push-broom)成像儀就是這樣運作。把感測器排成環狀、圍繞一個旋轉的光源,就是電腦斷層掃描(CT)的幾何架構;CT 的影像是重建出來的,而不是直接讀出。
- 陣列感測器。一個 2-D 的偵測器網格,例如 CCD 或 CMOS 晶片,一次擷取整張影像,這就是數位相機。鏡頭把場景聚焦到陣列上,每個偵測器在曝光時間內累積光量,讀出電路為每個偵測器產生一個值。
彩色相機通常在陣列上覆蓋一層紅、綠、藍濾光片組成的馬賽克,所以每個偵測器只量到一種顏色;每個像素缺少的另外兩個值,會在相機的影像處理管線中以內插補齊(去馬賽克,demosaicking)[8]。
簡單的成像模型
我們把一張單色影像寫成 2-D 函數 ,其值正比於抵達 的能量。因為它來自物理能量,所以 。對反射光而言,把 拆成兩個因子很有幫助 [1]:
其中 是照度(illumination)(照到該場景點的光有多少), 是反射率(reflectance)(表面反射了其中多少比例,從接近 0 的完全吸收到接近 1 的完全反射)。照度取決於光源;反射率則是物體本身的性質。在 X 射線之類的穿透式成像中,以穿透率(transmissivity)取代反射率。
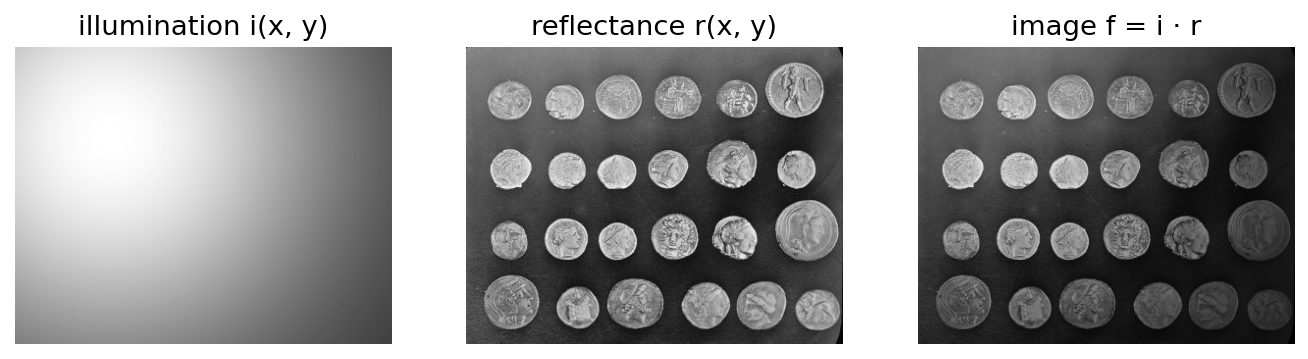
程式碼 · Python · 8 行
import numpy as np
from skimage import data, img_as_float

r = img_as_float(data.coins())          # reflectance in [0, 1]
h, w = r.shape
yy, xx = np.mgrid[0:h, 0:w]
i = 0.2 + 0.8 * xx / (w - 1)            # illumination ramp: dim left, bright right
f = i * r                               # what the sensor records
這個模型很簡單,卻很實用。照度通常在場景中緩慢變化,反射率則在物體邊緣處劇烈改變。後面的章節會利用這一點:同態濾波(homomorphic filtering,第 4 章)取 把兩者分開;陰影校正(本章稍後)則把已知的 除掉。
影像取樣與量化
白話說:相機只在有限個位置量測連續的場景(取樣),再把每個量測值四捨五入到有限個階層之一(量化)。
基本概念
感測器的輸出是在連續平面上的連續電壓波形。要變成數位的,座標和振幅都必須離散化 [1]:
- 取樣(sampling)把座標數位化:我們只保留網格位置上的值。
- 量化(quantization)把振幅數位化:每個保留的值都對應到有限個階層中最接近的那一個。
對陣列感測器而言,偵測器的數量與間距決定了取樣;類比數位轉換器決定了量化。需要取樣多密,取決於影像內容:根據取樣定理,一個頻寬有限的訊號,只要取樣頻率大於其最高頻率的兩倍,就能完美重建。第 4 章會正式推導;Unser 的回顧論文則提供了以樣條(spline)為基礎、較現代的取樣與重建觀點 [2]。
數位影像的表示法
經過取樣與量化後,影像是一個 列、 行的矩陣:
每個元素是一個像素(pixel,picture element)。依照教科書的慣例 [1], 是列索引、 是行索引,原點在左上角。(許多函式庫,包括 OpenCV 的點座標 API,用的是 =(行, 列)。務必確認。)
強度階數通常是 2 的冪次 ,所以值落在 。儲存一張影像需要
其中 是每像素的位元數。一張 、 的影像需要 262,144 位元組。成像系統的動態範圍(dynamic range)是可量測的最大強度(受飽和限制)與最小強度(受雜訊限制)之比;某一張影像的對比(contrast)則是其最高與最低強度之差。
空間解析度與強度解析度
空間解析度(spatial resolution)是能辨識的最小細節尺寸,必須帶單位才有意義:每毫米線對數,或印刷時的每英寸點數(dpi)。只說影像是「1024 × 1024」,在不知道它涵蓋多大實際面積前,並沒有說出任何解析度資訊。強度解析度(intensity resolution)是能辨識的最小階層變化,通常以位元數 表示。
程式碼 · Python · 12 行
import numpy as np
from skimage import data

img = data.camera()                       # 512 x 512, uint8 (k = 8)
small = img[::4, ::4]                     # keep every 4th sample -> 128 x 128

def quantize(x, bits):
    step = 2 ** (8 - bits)
    return (x // step) * step + step // 2 # map to the centre of each bin

q3 = quantize(img, 3)                     # 8 gray levels
print(small.shape, np.unique(q3).size)    # (128, 128) 8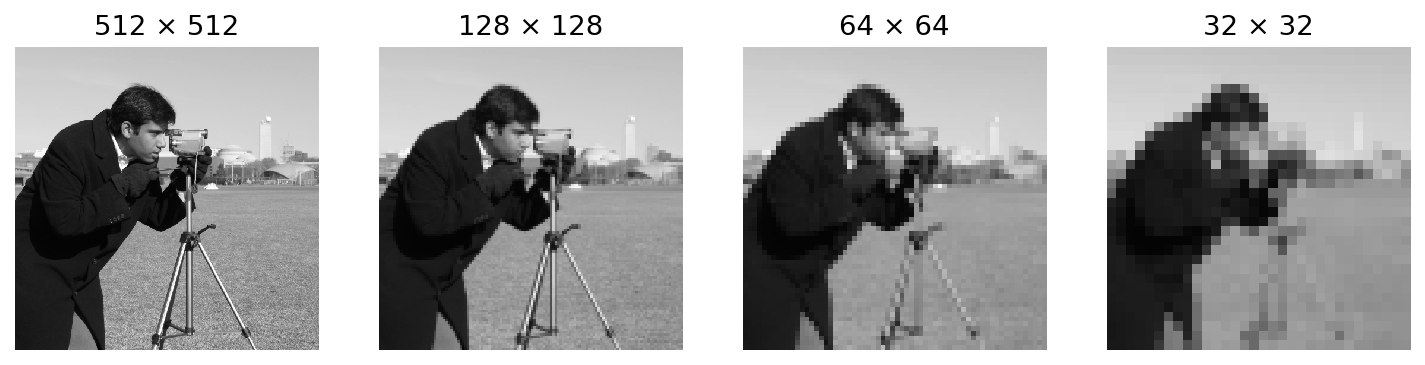
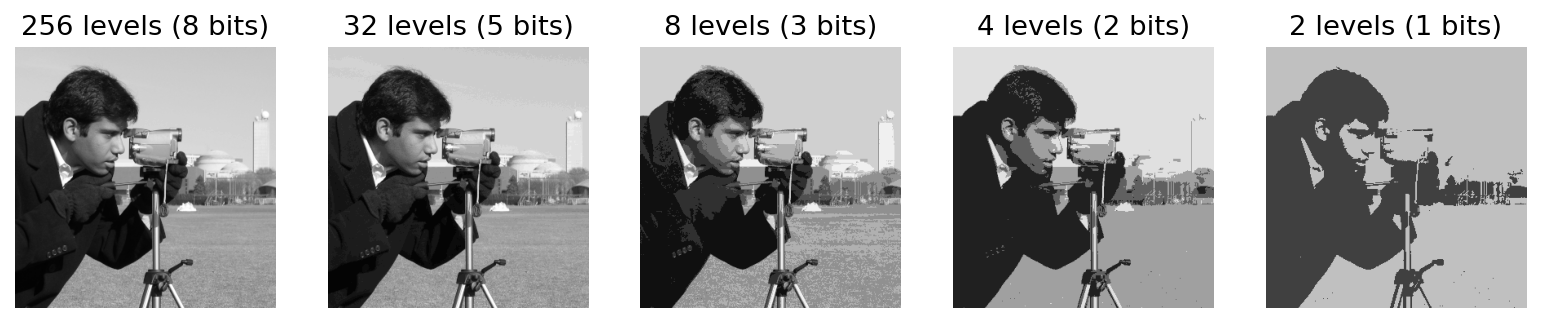
由此得到兩個教訓。減少取樣點時,首先被破壞的是細緻紋理(草、頭髮),接著才是邊緣。減少階層時,首先受損的是平滑區域:圖 2.4 的天空會碎成一階一階,稱為假輪廓(false contouring)——恰好出現在 Weber 比說眼睛最敏感的地方。細節多的影像比平滑的影像更能容忍較少的灰階,因為繁雜的紋理會把階梯掩蓋掉 [1]。
影像內插
內插(interpolation)是在沒有取樣值的位置估計數值。每當影像被縮放、旋轉、變形或對位時,都會用到它 [1]、[3]、[4]。
最近鄰(nearest neighbor)直接複製最近取樣點的值。它快速、保留原始數值,但會讓邊緣呈鋸齒方塊;縮小影像時,甚至可能讓細線整條消失。
雙線性(bilinear)內插使用最近的四個取樣點。對於距左上取樣點 的小數偏移量為 的位置,
其中 、、 分別是右、下、右下的鄰居。等價地,,四個係數由四個取樣點決定。結果是連續的,但略顯模糊。
程式碼 · Python · 16 行
import numpy as np

def bilinear(img, x, y):
    """Sample img (H, W) at real-valued column x, row y."""
    if img.ndim != 2 or not img.size:
        raise ValueError("img must be a nonempty 2-D array")
    if not (0 <= x <= img.shape[1] - 1 and 0 <= y <= img.shape[0] - 1):
        raise ValueError("sample coordinates must lie inside the image")
    x0, y0 = int(np.floor(x)), int(np.floor(y))
    x1, y1 = min(x0 + 1, img.shape[1] - 1), min(y0 + 1, img.shape[0] - 1)
    a, b = x - x0, y - y0
    top = (1 - a) * img[y0, x0] + a * img[y0, x1]
    bot = (1 - a) * img[y1, x0] + a * img[y1, x1]
    return (1 - b) * top + b * bot

print(bilinear(np.array([[0., 10.], [20., 30.]]), 0.5, 0.5))   # 15.0
這個函式只接受影像內的座標,包含最後一列與最後一行。它會拒絕越界座標,避免負的 NumPy 索引意外讀取另一側像素。幾何變形若需要影像外的數值,必須另選常數補值或鏡射等邊界政策。
雙三次(bicubic)內插使用最近的 16 個取樣點。它用一個平滑的分段三次核來加權這些取樣點——最常用的是 Keys 的三次卷積核 [3]——先沿列、再沿行套用。這個核帶有小小的負瓣,所以雙三次比雙線性更能保持邊緣清晰,但可能在強邊緣旁產生輕微的過衝(振鈴,ringing)。
選讀:三次卷積核(見「補充資料」頁)。Keys 核的公式與它的自由參數。
程式碼 · Python · 8 行
import cv2
from skimage import data

crop = data.camera()[150:214, 230:294]    # 64 x 64
up = {name: cv2.resize(crop, None, fx=4, fy=4, interpolation=flag)
      for name, flag in [("nearest", cv2.INTER_NEAREST),
                         ("bilinear", cv2.INTER_LINEAR),
                         ("bicubic", cv2.INTER_CUBIC)]}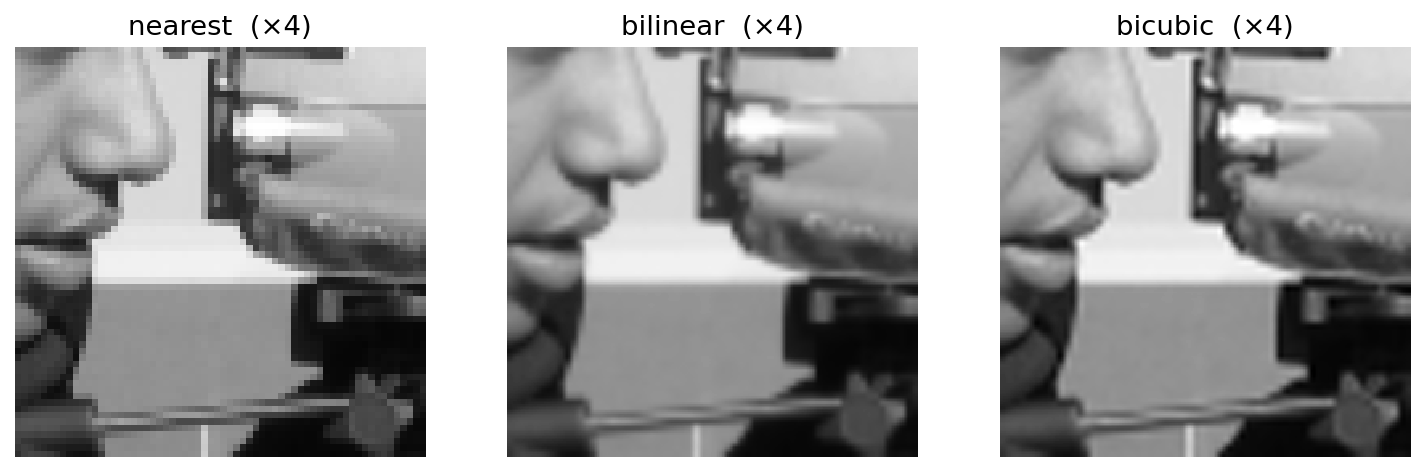
拖動滑桿,比較把 裁切區放大成 時,最近鄰與雙三次的差別。注意相機的邊緣與臉部輪廓。
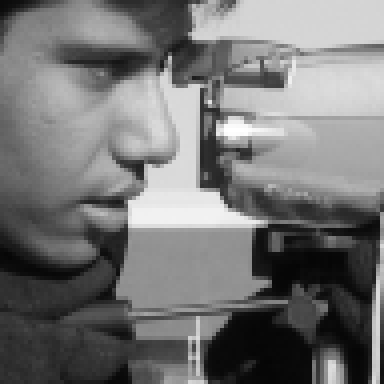
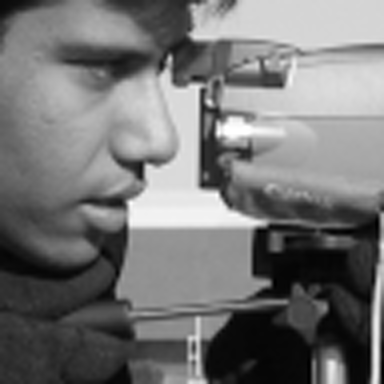 最近鄰雙三次
沒有任何內插方法能創造出取樣時已丟掉的細節。Thévenaz、Blu 與 Unser 的回顧 [4] 把這點說得很精確:內插器的品質取決於它的逼近階數,以及它的核有多接近理想(sinc)重建器;在相近的計算成本下,較高階的 B-spline 方法優於傳統的三次卷積。「現代觀點」中討論的學習式超解析度(super-resolution)更進一步,會根據訓練資料腦補出看似合理的細節。
像素之間的基本關係
白話說:在談論影像裡的物體之前,我們需要規定哪些像素彼此「相碰」,以及兩個像素相距多遠。
像素的鄰居
位於 的像素 有四個水平與垂直鄰居,
四個對角鄰居,
以及八個鄰居 [1]。在影像邊界上,有些鄰居會落在影像外;要怎麼處理(忽略、補值、鏡射)是一個選擇,在濾波時會再遇到。
相鄰、連通、區域與邊界
令 為被視為「相似」的強度值集合——二值影像中 ;灰階影像中可能是 100 到 120 之間的所有值。兩個值都在 中的像素 與 [1]:
- 若 ,則為 4-相鄰(4-adjacent);
- 若 ,則為 8-相鄰(8-adjacent);
- 若 ,或者 且集合 中沒有任何值屬於 的像素,則為 m-相鄰(m-adjacent,混合相鄰)。
為什麼需要 m-相鄰?在 8-相鄰下,一步對角線和兩步「繞過轉角」的路線可能同時連接同一對像素,使路徑產生歧義。m-相鄰只在不存在 4-連通路線時才保留對角連結,消除了多餘的迴圈(圖 2.6 右)。
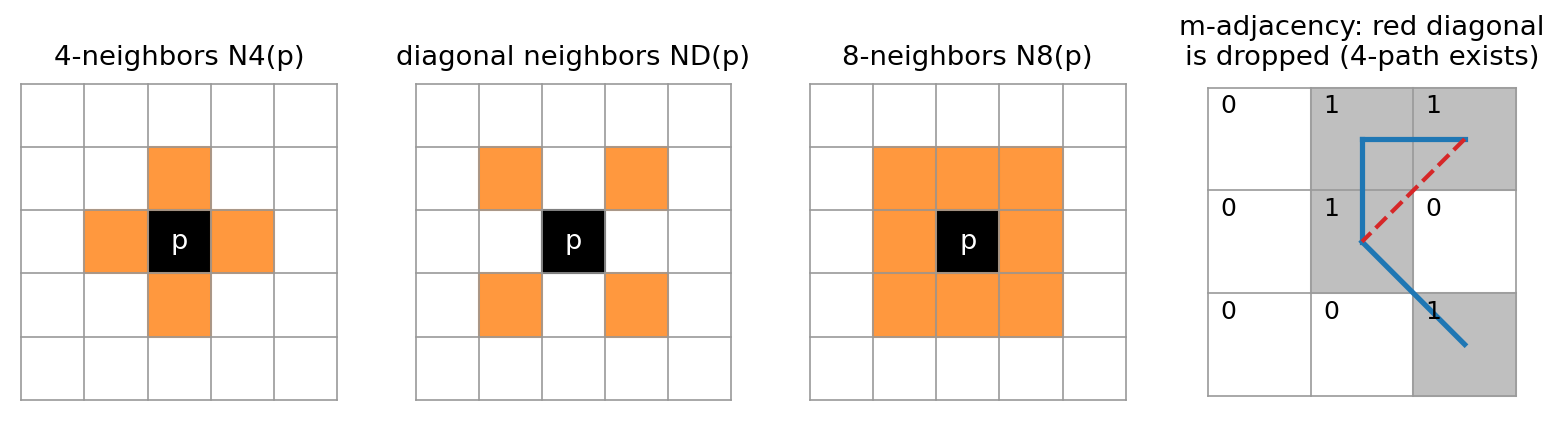
從 到 的數位路徑(digital path)是一串互不相同的像素 ,相鄰兩個像素彼此相鄰; 是路徑長度,若第一個與最後一個像素相同,則稱為封閉路徑。依所用的相鄰定義,我們稱之為 4-、8- 或 m-路徑。對於像素子集 ,若 與 之間存在一條完全位於 中的路徑,就說它們在 中連通。在 中與 連通的所有像素構成一個連通分量(connected component);若 只有一個連通分量,則 是連通集合。
連通集合稱為區域(region)。若兩個區域的聯集是連通的,就說它們相鄰。區域 的邊界(boundary,或 border)是 中至少有一個鄰居位於 外的像素集合。注意邊界與邊緣(edge)的差別:邊界是區域整體、封閉的性質;邊緣則是局部的強度不連續,未必會閉合(第 10 章)。
相鄰的選擇會改變「有幾個物體?」這類簡單問題的答案:
程式碼 · Python · 8 行
import numpy as np
from skimage.measure import label

b = np.array([[1, 0, 0],
              [0, 1, 0],
              [0, 0, 1]])
print(label(b, connectivity=1).max(),     # 4-connectivity: 3 objects
      label(b, connectivity=2).max())     # 8-connectivity: 1 object
一個經典結論:如果前景用 8-連通,背景就應該用 4-連通(反之亦然),否則一條封閉的數位曲線可能無法把內外分開。這是數位拓樸(digital topology)的基本結果 [1]。
距離量測
對像素 、 與 ,若函數 滿足 且僅在 時等號成立、,以及 ,則 是一個距離度量(distance metric)。三種標準度量是 [1]、[5]:
即歐氏距離、城市街區距離與棋盤距離。與 的 不超過某定值的像素構成圓盤; 構成菱形; 構成正方形。 的像素恰好是 , 的像素恰好是 。 與 只取決於座標,與像素值無關;反之,沿著 m-路徑量的距離會受像素值影響,因為路徑本身受像素值影響。
程式碼 · Python · 4 行
import numpy as np
p, q = np.array([2, 3]), np.array([5, 7])
d = np.abs(p - q)
print("D_E =", np.hypot(*d), " D_4 =", d.sum(), " D_8 =", d.max())   # 5.0, 7, 4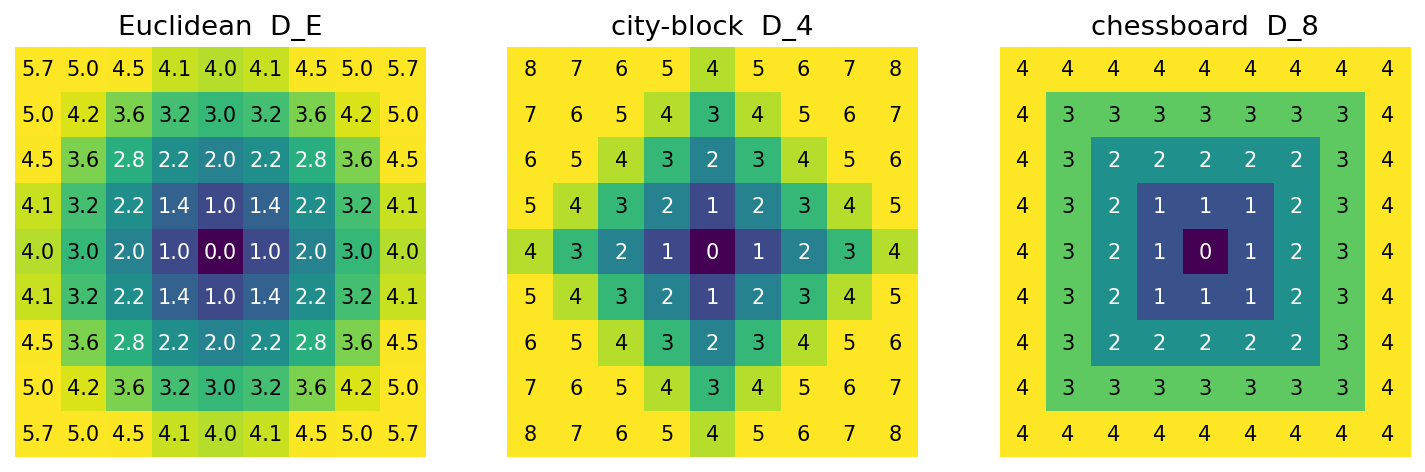
Rosenfeld 與 Pfaltz [5] 提出了高效率的兩趟(two-pass)演算法,一次算出每個像素到最近物體像素的距離——也就是距離轉換(distance transform),至今仍用於骨架化、形態學與形狀比對(第 9 章)。
數位影像處理的數學工具簡介
白話說:影像就是矩陣,所以大部分影像處理都是對矩陣做運算。本節列出我們會一再用到的運算,以及決定哪些工具適用的關鍵性質——線性。
逐元素運算與矩陣運算
逐元素(elementwise,又稱陣列)運算逐一像素作用。兩張 影像的逐元素乘積為
而矩陣乘積則遵守列乘行的規則。除非特別說明,影像運算——包括「兩張影像相乘」——都是逐元素的 [1]。在 NumPy 中,A * B 是逐元素乘積,A @ B 是矩陣乘積。
線性與非線性運算
考慮一個把輸入影像 對應到輸出 的運算子 。若對所有影像 與所有常數 都有
則它是線性的。這個性質的兩部分是可加性(和的輸出等於輸出的和)與齊次性(輸入縮放,輸出也同比例縮放)。把所有像素加總是線性的;取最大值則不是:
程式碼 · Python · 6 行
import numpy as np
rng = np.random.default_rng(0)
f1, f2 = rng.random((4, 4)), rng.random((4, 4))
a, b = 2.0, -3.0
print(np.isclose(np.sum(a*f1 + b*f2), a*np.sum(f1) + b*np.sum(f2)))   # True
print(np.isclose(np.max(a*f1 + b*f2), a*np.max(f1) + b*np.max(f2)))   # False
線性之所以重要,是因為線性運算子完全由它對簡單輸入的反應決定,而且有大量理論(卷積、傅立葉轉換,第 3–5 章)可以套用。中值濾波器或形態學等非線性運算子能做到線性運算子做不到的事,但較難分析。
算術運算
兩張同尺寸影像的和、差、積、商都是逐元素運算 [1]。其中三種用途特別重要。
平均多張含雜訊的影像。假設我們對一個靜止場景拍了 張影像,,其中 是乾淨影像, 是各張之間互不相關、平均為零、變異數為 的雜訊。平均值 滿足
所以雜訊標準差以 的速度下降。天文學家疊加多次曝光就是這個道理;手機的「夜間模式」在對齊一連串連拍畫面後,做的也是同一件事 [7]。
程式碼 · Python · 8 行
import numpy as np
from skimage import data, img_as_float

g = img_as_float(data.camera())
rng = np.random.default_rng(1)
for K in (1, 4, 16, 64):
    avg = np.mean([g + rng.normal(0, 0.2, g.shape) for _ in range(K)], axis=0)
    print(K, round(float(np.std(avg - g)), 3))    # 0.2, 0.1, 0.05, 0.025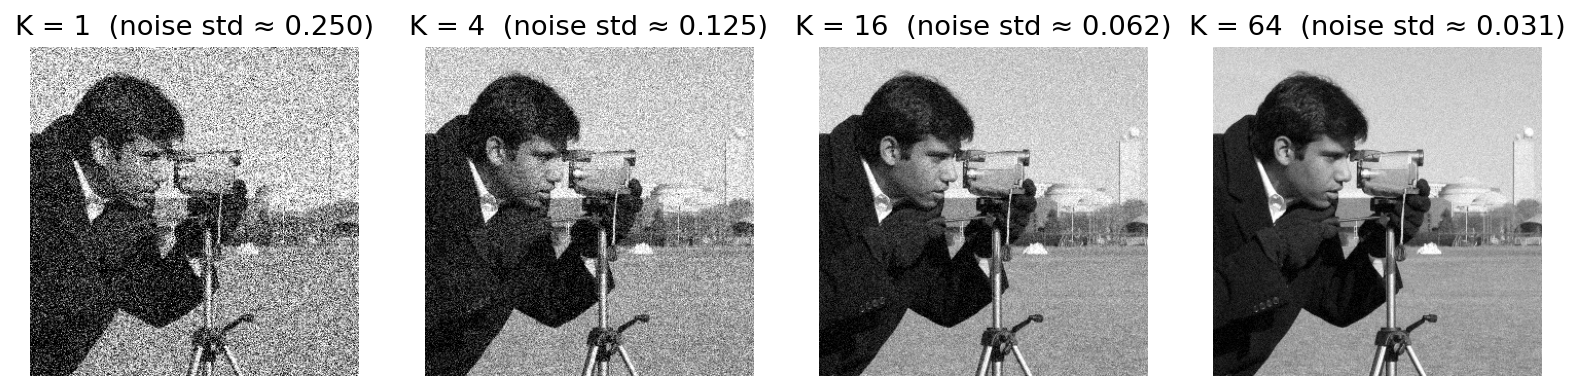
相減能凸顯差異。把視訊的兩張畫面相減,會凸顯移動;在醫學影像中,把顯影前的「遮罩」影像從顯影後的影像中減去,主要只會留下吸收了顯影劑的血管。
相乘與相除處理陰影與遮罩。若已知感測器的陰影型態 (例如拍攝均勻目標取得),觀察到的影像 可以用 校正。乘上二值遮罩則可保留感興趣區域、把其餘歸零。
一條實用規則:算術結果常常超出有效範圍(相減可能為負,相加可能超過 255)。請用浮點數運算,再重新縮放。縮放到 的簡單方法是先算 ,再算 。
集合與邏輯運算
把二值影像看成像素座標的集合 (前景),一般的集合運算就都適用 [1]:聯集 、交集 、補集 ,以及差集 。在二值陣列上,它們分別對應邏輯運算 OR、AND、NOT 與 AND-NOT。對灰階影像,聯集與交集通常定義為逐元素的最大值與最小值。模糊集合(fuzzy sets)更進一步,讓隸屬度可以介於 0 與 1 之間。
程式碼 · Python · 7 行
import numpy as np
from skimage import data

coins = data.coins()
A = coins > 100                                        # set A: bright pixels
B = np.zeros_like(A); B[:, : coins.shape[1] // 2] = True   # set B: left half
union, inter, diff = A | B, A & B, A & ~B
集合運算是數學形態學(第 9 章)以及合併分割遮罩時的共通語言。
空間運算
空間運算直接作用在像素值與位置上,分為三類 [1]。
單像素運算各自獨立地改變每個值:,其中 是輸入強度、 是輸出。影像負片 就是一例。這些就是第 3 章的強度轉換。
鄰域運算由 周圍的鄰域 計算每個輸出。局部平均
(其中 是以 為中心的 視窗)是最簡單的例子;第 3 章會把它推廣成空間濾波。
幾何轉換移動像素。它分兩步:座標的空間轉換,以及用強度內插填滿新網格。最常見的一族是仿射(affine)轉換。以齊次座標表示,
其中 是輸入位置、 是輸出位置, 編碼旋轉、縮放與剪切, 是平移。仿射轉換保持直線與平行性,串接多個轉換就等於把矩陣相乘。
實作上幾乎都用反向映射(inverse mapping):對每個輸出像素,套用反轉換找出它在輸入中的來源位置,再在該處內插。正向映射(把每個輸入像素推到輸出)會留下空洞與碰撞。
程式碼 · Python · 7 行
import cv2
from skimage import data

img = data.camera()
h, w = img.shape
M = cv2.getRotationMatrix2D(center=(w / 2, h / 2), angle=30, scale=0.8)  # 2x3 affine
rot = cv2.warpAffine(img, M, (w, h), flags=cv2.INTER_LINEAR) # inverse mapping inside有兩個相關的任務建立在這些轉換之上。影像對位(registration)在轉換未知時,利用兩張影像中都找得到的點把它估計出來,讓同一場景的兩張影像對齊。單應性(homography)是在仿射轉換之外再加上透視效果的 轉換;從不同視角拍攝同一個平面的兩張照片,就是以它相互對應。
選讀:影像對位(見「補充資料」頁)。如何用連結點估計對齊兩張影像的幾何轉換。
選讀:單應性:投影轉換(見「補充資料」頁)。把仿射轉換延伸到透視的 3×3 矩陣,以及如何由點對估計它。
向量與矩陣運算
彩色像素是一個向量 ,分量是紅、綠、藍值。向量工具因此可直接套用;例如 到參考色 的歐氏距離
是簡單彩色分割(第 6 章)的基礎。把 影像堆疊成 的向量,也能把任何線性運算寫成 ,這個形式會在影像復原(第 5 章)中用到。
影像轉換
有些問題換到另一個域會比較好解。2-D 線性轉換的一般形式為 [1]
其中 是輸入影像, 是正向轉換核, 是轉換域的變數。反轉換使用反向核 。當 時,核是可分離的,2-D 轉換可以先沿列、再沿行做 1-D 轉換,或寫成矩陣形式 。傅立葉轉換(第 4 章)與小波轉換(第 7 章)是你最常遇到的兩種。
機率方法
強度可以當成隨機量來處理。若 影像中有 個像素的強度為 ,則該強度的機率估計為
這就是正規化直方圖(normalized histogram)。強度的平均值與變異數為
其中 衡量平均亮度,(標準差)衡量對比。更高階的動差描述偏斜與尖峰程度。
程式碼 · Python · 9 行
import numpy as np
from skimage import data

img = data.camera()
p = np.bincount(img.ravel(), minlength=256) / img.size   # p(z_k)
z = np.arange(256)
m = np.sum(z * p)
sigma = np.sqrt(np.sum((z - m) ** 2 * p))
print(round(m, 2), round(sigma, 2))                      # 129.06 73.64
直方圖處理(第 3 章)與雜訊建模(第 5 章)都從這裡出發。
現代觀點
本章的基礎概念並沒有被深度學習取代,反而成了深度學習的介面。網路吃的是經過取樣與量化的陣列,用編碼了某種知覺模型的損失函數訓練,並在相機管線產生的資料上評估。以下幾個方向的回顧文獻勾勒出這片領域。
取樣與內插理論。Unser 的回顧 [2] 把取樣看成以實用的基底(例如 B-spline)來逼近,而不再要求理想的頻寬有限訊號與 sinc 重建器。重點是一起分析取樣基底、前置濾波與重建核;這些選擇都不能消除取樣率造成的資訊限制。Thévenaz、Blu 與 Unser [4] 在相同條件下比較各種內插核,發現以 B-spline 為基礎的內插,比 Keys 的三次卷積 [3] 有更好的品質與成本取捨。
學習式超解析度。Wang、Chen 與 Hoi [9] 以及 Moser 等人 [10] 綜述了深度超解析度,從 CNN 設計一路談到 transformer 與擴散模型。有兩個方法顯示古典概念如何在網路中延續:LIIF [11] 是可在任意座標查詢的學習式內插器;Real-ESRGAN [12] 則把模糊、雜訊、縮放與壓縮重複施加多次來合成訓練資料,因為用雙三次縮小產生的訓練資料對與真實退化並不相符。教訓是:雙三次內插既是比較基準,也是藏在訓練資料裡的假設。
知覺與影像品質。SSIM [13] 把感知一節的觀察轉成一個比較局部亮度、對比與結構的品質指標;Zhai 與 Min [14] 綜述了整個領域。深度網路特徵之間的距離(LPIPS)在該研究的人類判斷測試中,較所比較的傳統指標更吻合 [15];Ding 等人 [16] 則發現,一個指標在品質資料集上的排名,並不能可靠預測它當作訓練損失時是否好用。簡單說,馬赫帶與 Weber 比如今活在損失函數裡。
選讀:MSE、PSNR 與資料範圍(見「補充資料」頁)。PSNR 如何計算、資料範圍為何重要,以及常見陷阱。
相機感測器管線。Ramanath 等人 [8] 描述了傳統的機內管線(去馬賽克、白平衡、色彩轉換、gamma、壓縮);Delbracio 等人 [7] 說明手機如何以連拍、對齊與合併重塑這條管線——也就是大規模的「平均含雜訊影像」。如今已有學習式模型取代其中一部分甚至全部 [17]、[18]。
選讀:各篇回顧的詳細介紹(見「論文導讀」頁)。每篇回顧與代表方法涵蓋的內容與結論。
什麼沒有改變?像素網格、位元深度、相鄰與連通(至今仍是每個分割後處理步驟中連通分量標記的基礎)、仿射變形(如今成了網路中可微分的層),以及直方圖。正因為懂這些,你才能察覺模型的輸入是否用錯了縮放核、量化得太粗,或是用了一個與人類判斷不符的指標來比較。
重點整理
- 人類視覺感受的是相對變化(Weber 定律),並會誇大邊緣(馬赫帶);感受到的亮度取決於周圍。好的影像處理會尊重這些事實。
- 影像可以由電磁波譜的任何部分形成;對反射光而言, 把照度與反射率分開。
- 取樣決定空間解析度、量化決定強度解析度,儲存量是 位元。階數太少會在平滑區域造成假輪廓。
- 內插——最近鄰、雙線性、雙三次——估計取樣點之間的值,在速度、平滑度與銳利度之間取捨,但無法找回已遺失的細節。
- 4-、8- 與 m-相鄰定義了路徑、連通分量、區域與邊界; 與 是距離度量,其單位球分別是菱形與正方形。
- 除非特別說明,影像運算都是逐元素的;線性決定了卷積與傅立葉工具是否適用。
- 平均 張獨立的含雜訊畫面,可讓雜訊標準差降為 ;幾何轉換使用反向映射加上內插。
- 深度學習建立在這些基礎上:學習式內插器、感知損失與學習式相機管線,都承襲了本章的概念。
練習
- 一台灰階掃描器產生 、每像素 12 位元的影像。一張未壓縮的掃描需要多少 MB?若降為 8 位元呢?
提示
用 ,再除以 (若要 MiB 則除以 )。12 位元: MB。8 位元:7.92 MB。
- 把
skimage.data.moon()量化成 4、5、6 位元。對你而言,在哪個位元數時假輪廓消失?接著在以 4 位元量化之前,先加入少量均勻隨機雜訊(振幅為半個量化間距)。有什麼改變?為什麼?
提示
這種雜訊(稱為抖動,dither)會打散大片平坦的階梯,眼睛會把細小的雜訊平均掉,而不是看到輪廓。平均誤差差不多,但可見的結構改變了——再次提醒我們,平方誤差與感受到的品質是兩回事。
- 在下面的二值影像中,分別以 4-、8- 與 m-連通計算 1 像素的連通分量數。再分別以 4- 與 8-連通計算 0 像素的連通分量數。哪一種搭配能給出一致的「內/外」答案?
程式碼 · 5 行
0 0 0 0 0
0 1 1 1 0
0 1 0 1 0
0 1 1 0 0
0 0 0 0 0
提示
在三種相鄰定義下,1 都只構成一個連通分量;但因為右下角有個對角缺口,只有允許對角步時,這個環才是封閉的。中央的 0 在 4-連通下是孤立的(一個洞),在 8-連通下則與外部相連。4/4 搭配得到「不封閉的曲線卻有洞」;8/8 得到「封閉的曲線卻沒有洞」。只有前景 8-連通搭配背景 4-連通(或反過來)才一致。可用 skimage.measure.label 驗證。
- 證明對任意兩個像素都有 ,並找出讓每個不等式取等號的像素對。
提示
令 、,則 。當 其中之一為零時取等號。
- 寫一個用正向映射旋轉影像 角的函式(把每個輸入像素推到四捨五入後的輸出位置)。顯示 的結果,並解釋為什麼會有空洞。然後改用反向映射加雙線性內插修正它。
提示
旋轉保持距離不變,但旋轉後的像素中心通常落在輸出網格點之間。前向映射再四捨五入,可能留下空洞,或把多個取樣點送到同一像素。反向映射會逐一拜訪輸出像素,在對應的來源座標內插;來源座標若落在影像之外,仍須明訂邊界處理方式。
- 你有一個靜止場景的 10 張含雜訊畫面,雜訊標準差為 12 個灰階。要讓它低於 2 個灰階,需要幾張?在真實的手持連拍中,哪個假設可能不成立?手機管線怎麼處理?
提示
需要 ,所以要 37 張。「場景與相機都靜止」這個假設不成立;平均前必須先對齊(對位)各畫面,移動中的物體則需要穩健的合併方式 [7]。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 2. publisher page
- M. Unser, “Sampling—50 years after Shannon,” Proceedings of the IEEE, vol. 88, no. 4, pp. 569–587, 2000. doi
- R. Keys, “Cubic convolution interpolation for digital image processing,” IEEE Transactions on Acoustics, Speech, and Signal Processing, vol. 29, no. 6, pp. 1153–1160, 1981. doi
- P. Thévenaz, T. Blu, and M. Unser, “Interpolation revisited,” IEEE Transactions on Medical Imaging, vol. 19, no. 7, pp. 739–758, 2000. doi
- A. Rosenfeld and J. L. Pfaltz, “Distance functions on digital pictures,” Pattern Recognition, vol. 1, pp. 33–61, 1968. doi
- B. Zitová and J. Flusser, “Image registration methods: a survey,” Image and Vision Computing, vol. 21, no. 11, pp. 977–1000, 2003. doi
- M. Delbracio, D. Kelly, M. S. Brown, and P. Milanfar, “Mobile computational photography: A tour,” arXiv:2102.09000, 2021. arXiv
- R. Ramanath, W. E. Snyder, Y. Yoo, and M. S. Drew, “Color image processing pipeline,” IEEE Signal Processing Magazine, vol. 22, no. 1, pp. 34–43, 2005. doi
- Z. Wang, J. Chen, and S. C. H. Hoi, “Deep learning for image super-resolution: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2020. arXiv
- B. Moser, F. Raue, S. Frolov, J. Hees, S. Palacio, and A. Dengel, “Hitchhiker’s guide to super-resolution: Introduction and recent advances,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023. arXiv
- Y. Chen, S. Liu, and X. Wang, “Learning continuous image representation with local implicit image function,” CVPR, 2021. arXiv
- X. Wang, L. Xie, C. Dong, and Y. Shan, “Real-ESRGAN: Training real-world blind super-resolution with pure synthetic data,” arXiv:2107.10833, 2021. arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh, and E. P. Simoncelli, “Image quality assessment: From error visibility to structural similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. project page
- G. Zhai and X. Min, “Perceptual image quality assessment: A survey,” Science China Information Sciences, vol. 63, no. 11, 2020. doi
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman, and O. Wang, “The unreasonable effectiveness of deep features as a perceptual metric,” CVPR, 2018. arXiv
- K. Ding, K. Ma, S. Wang, and E. P. Simoncelli, “Comparison of full-reference image quality models for optimization of image processing systems,” International Journal of Computer Vision, 2021. arXiv
- C. Chen, Q. Chen, J. Xu, and V. Koltun, “Learning to see in the dark,” CVPR, 2018. arXiv
- A. Ignatov, L. Van Gool, and R. Timofte, “Replacing mobile camera ISP with a single deep learning model,” arXiv:2002.05509, 2020. arXiv
- Q. Huynh-Thu and M. Ghanbari, “Scope of validity of PSNR in image/video quality assessment,” Electronics Letters, vol. 44, no. 13, pp. 800–801, 2008. doi
- R. Hartley and A. Zisserman, Multiple View Geometry in Computer Vision, 2nd ed., Cambridge University Press, 2004. doi
- scikit-image contributors, “ProjectiveTransform.estimate,” scikit-image 0.25.2 documentation, accessed 5 November 2026. API 文件.
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 IP 03・強度轉換與空間濾波 · 26 分鐘