DLCV 11A・深度估計與光流
先備知識:DLCV 11・三維重建:從多視角幾何到 NeRF 與 Gaussian Splatting
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分立體對應、時間光流與單目深度推論。
- 連結視差、校準相機幾何與深度誤差。
- 比較匹配成本、成本體積與迭代細化。
- 區分相對深度、公尺尺度深度與視角合成監督。
- 評估時註明對齊、可見性遮罩、單位及資料切分。
先看全貌
深度圖告訴你每個像素上的表面有多遠。光流場告訴你每個像素上的那個點,在下一張影格裡移到哪裡。機器人、汽車、手機與影片剪輯軟體兩者都需要:用深度知道東西在哪裡,用光流知道東西怎麼動。兩者回答的是同一個問題:另一張影像中,哪個像素拍到的是同一個點?
為什麼重要。 立體深度讓機器人和汽車不靠雷射掃描器也能量距離;單張影像的深度讓手機把人像的背景模糊掉,也能把物件放進影片裡;光流則驅動影片超解析度、影格內插與影像穩定。
本篇與其他篇章的關係。 DLCV 11 介紹相機幾何、三角測量與多視角立體視覺;DLCV 09A.3 介紹亮度恆定與扭曲;長距離的點追蹤在 DLCV 07,稀疏關鍵點配對在 IP 12。我們連結過去,不重複它們。本篇的重點是密集的情況:每個像素都有一個答案。
圖 1 畫出本篇的四種模型家族:三種是比對兩張影像,第四種則靠它學到的知識。
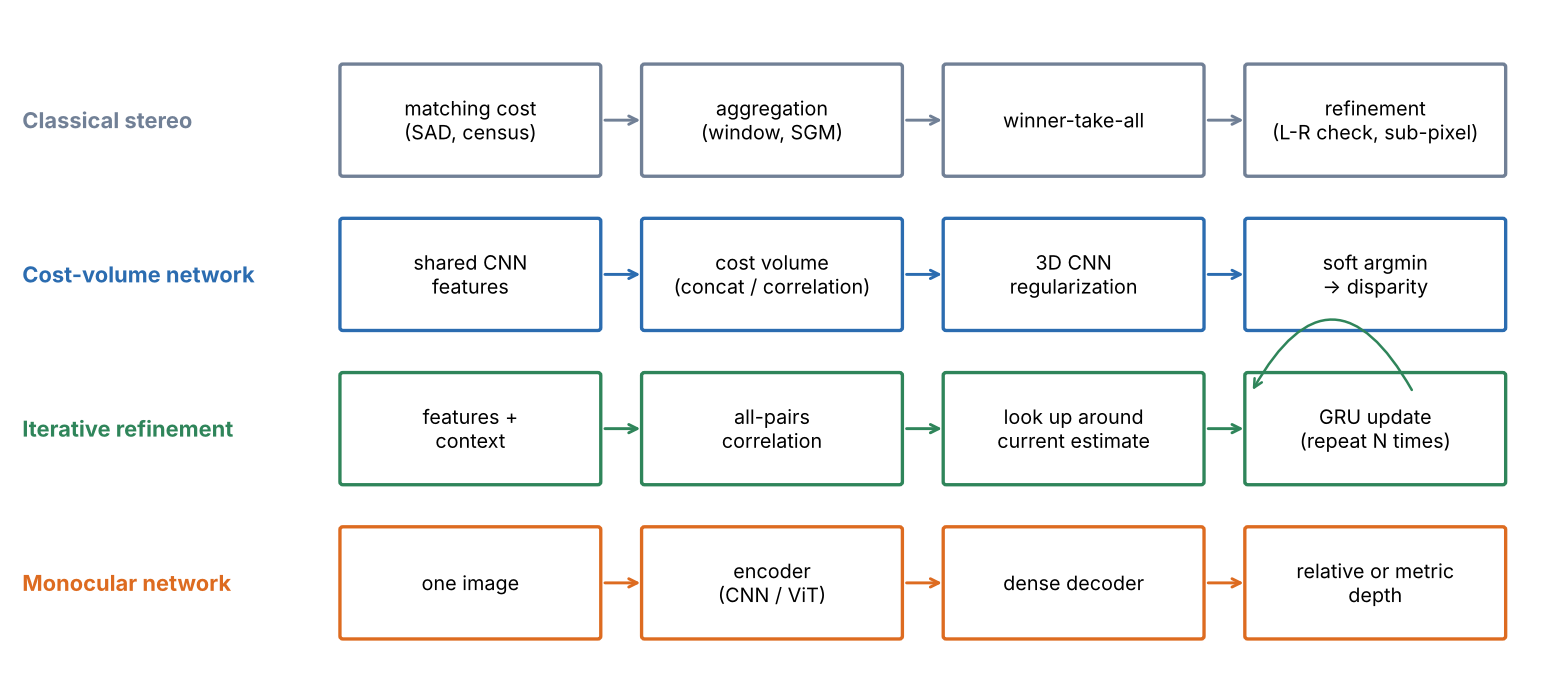
三個密集對應問題
白話版。 校正後立體匹配沿同一列找像素對應;光流跨影格匹配,單目深度則沒有第二張影像可用。
精確版。 令 為兩張 像素的影像, 為一個像素, 是欄、 是列。
- 光流是一個向量場 ,使得在 的 看到的點,在 的 被看到。每個像素有兩個未知數;相機與場景都可能在動。
- 立體視差是特殊情況:兩台相機在同一瞬間看著場景,並且已經校正(見下一節),所以每個配對都落在同一列上:。每個像素只有一個未知數,即視差 ,它可以換算成深度。
- 單目深度要求只從 得到深度圖 。沒有對應可用,所以答案來自學到的規律,而且除非網路學會了公制線索,否則只定義到一個未知的尺度。
- 場景流要求每個像素所見之點的三維運動;它結合兩個時刻的深度與光流(見下方的場景流(簡介))。
兩張影像的問題共享同一個結構:一個為候選配對打分的代價、一次在候選之間的搜尋,以及一種處理代價有歧義的像素的方法。
立體幾何:校正與視差
白話版。 校準並校正的影像對中,近點視差較大;焦距與相機基線把視差換成深度。
校正
對一般的相機對,一個像素的配對會落在另一張影像的對極線上(DLCV 11,對極幾何)。校正(rectification)對兩張影像各施加一個單應性,讓所有對極線變成水平,且對應的線有相同的列編號 [1]。校正之後,兩台虛擬相機有相同的內參、平行的光軸,以及純水平的基線。立體相機組只需校準一次,每個影格在匹配之前都先校正;下面所有立體基準提供的都是校正過的影像對。本篇其餘部分,影像對一律是校正過的。
視差與深度
把左相機中心放在原點,右相機放在 軸上距離 處(圖 2a)。深度為 、水平位置為 的點,在左影像投影到欄 ,在右影像投影到欄 ,兩者都從主點起算。相減得到
其中 是以像素為單位的焦距, 是基線(baseline,兩個相機中心之間的距離,單位為公尺), 是沿光軸的深度, 是以像素為單位的視差(disparity)。深度與視差成反比:視差是一種逆深度,只差一個係數 。大視差屬於近的物體,視差為零表示無窮遠的點。
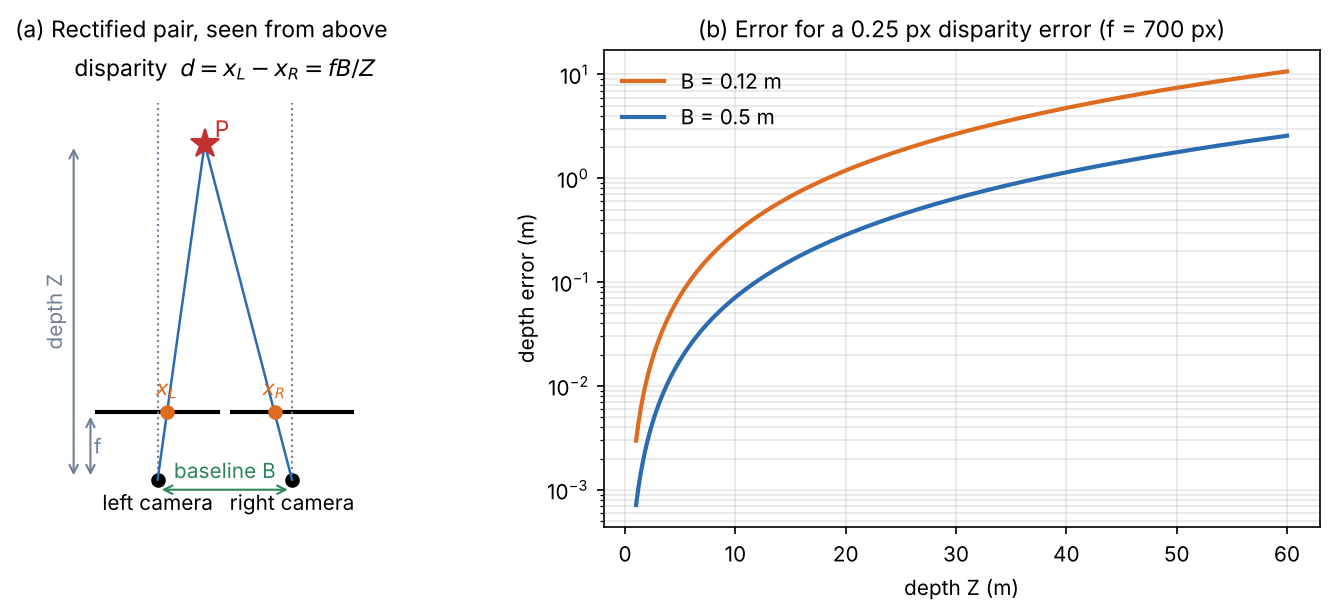
因為 ,視差的小誤差 會變成約 的深度誤差,這與 DLCV 11,三角測量推導的關係相同。下面的程式碼用一台假想的 像素的相機,把它換成數字。
程式碼 · Python · 9 行
import numpy as np

f = 700.0                                    # focal length in pixels (a hypothetical rig)
for B in [0.12, 0.5]:                        # baselines in metres
    print(f"baseline {B} m: depth at a disparity of 1 px = {f * B:.0f} m")
    for Z in [2, 10, 30, 60]:
        d = f * B / Z                        # disparity in pixels
        dZ = Z ** 2 * 0.25 / (f * B)         # depth error for a 0.25 px disparity error
        print(f"   Z = {Z:2d} m  d = {d:6.2f} px  depth error for 0.25 px: {dZ:6.3f} m ({100 * dZ / Z:4.1f}%)")
輸出
baseline 0.12 m: depth at a disparity of 1 px = 84 m
   Z =  2 m  d =  42.00 px  depth error for 0.25 px:  0.012 m ( 0.6%)
   Z = 10 m  d =   8.40 px  depth error for 0.25 px:  0.298 m ( 3.0%)
   Z = 30 m  d =   2.80 px  depth error for 0.25 px:  2.679 m ( 8.9%)
   Z = 60 m  d =   1.40 px  depth error for 0.25 px: 10.714 m (17.9%)
baseline 0.5 m: depth at a disparity of 1 px = 350 m
   Z =  2 m  d = 175.00 px  depth error for 0.25 px:  0.003 m ( 0.1%)
   Z = 10 m  d =  35.00 px  depth error for 0.25 px:  0.071 m ( 0.7%)
   Z = 30 m  d =  11.67 px  depth error for 0.25 px:  0.643 m ( 2.1%)
   Z = 60 m  d =   5.83 px  depth error for 0.25 px:  2.571 m ( 4.3%)
在 10 m 處,視差差四分之一像素,在基線 12 cm 時會造成 30 cm 的誤差,在基線 50 cm 時是 7 cm。在 60 m 處,短基線只看到 1.4 像素的視差,深度不確定性達 18%。這就是為什麼行車用的立體相機要用寬基線與高解析度,也是為什麼子像素精度很重要:最後那一小部分像素,決定了遠距離的表現。
傳統立體匹配
白話版。 傳統區塊匹配搜尋候選視差、比較局部區塊,再細化不可靠匹配。
Scharstein 與 Szeliski 把密集的雙影像立體匹配演算法整理成四個步驟,大多數方法都以某種形式執行這些步驟 [2]:
- 匹配代價計算:對每個像素、每個視差,算出一個相異度。
- 代價(支撐)聚合:在鄰域內結合代價以降低雜訊。
- 視差計算或最佳化:為每個像素選出一個視差,可以是局部的選擇,也可以是對整張影像最佳化一個能量函數。
- 視差精修:子像素估計、一致性檢查、填補與平滑。
隨那篇論文而設的 Middlebury 立體匹配網站,至今仍提供線上評估 [2], [3]。DLCV 11 的平面掃描,正是使用視窗化 SSD 的步驟 1–3;這裡我們把每個步驟看得更仔細,並加上精修。
匹配代價與代價體
最簡單的代價是比較小視窗內的強度。像素 在視差 時的絕對差總和(sum of absolute differences, SAD)為
其中 是左右影像, 是以該像素為中心、 視窗的位移集合, 遍歷整數假設 。改用平方差就是 SSD。對每個像素、每個 都算出 ,就填滿一個大小為 的代價體(cost volume)。贏者全拿(winner-take-all, WTA)規則選出 。
SAD 假設兩台相機對同一個點記錄到相同的亮度。真實的相機在增益與曝光上並不相同,所以實用的系統會用零均值正規化互相關(zero-mean normalized cross-correlation, ZNCC)或census 轉換,後者把「哪些鄰居比該像素暗」編碼成一個位元字串,再比較位元字串 [4]。
選讀:穩健的匹配代價:ZNCC 與 census(見「補充資料」頁)。給出定義,以及一個兩個視角之間亮度改變會讓 SAD 失敗、但另外兩者不受影響的測試。
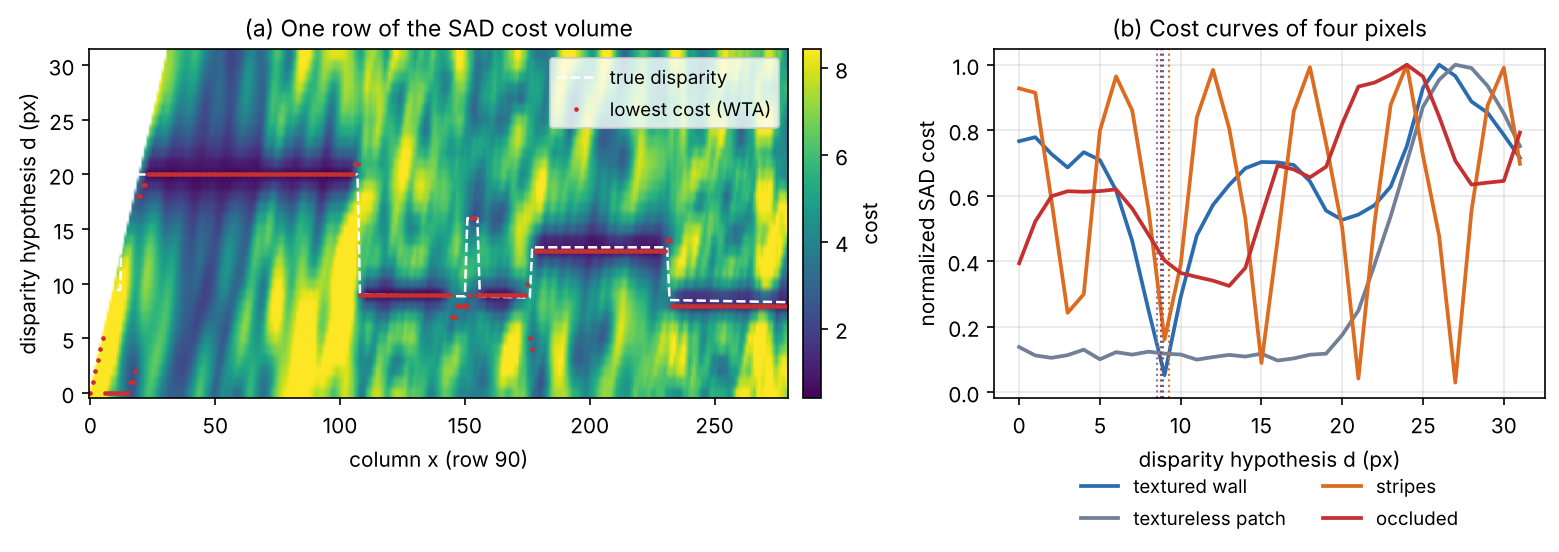
圖 3a 畫出代價體的一列:深色的谷底描出各個表面。圖 3b 畫出四種典型的代價曲線。有紋理的像素有一個尖銳的最小值;無紋理的像素是平坦的曲線;重複的圖案每個週期都有一個同樣深的最小值;被遮擋的像素在右影像中被藏起來,根本沒有正確的最小值。
程式碼:附左右一致性檢查的區塊匹配
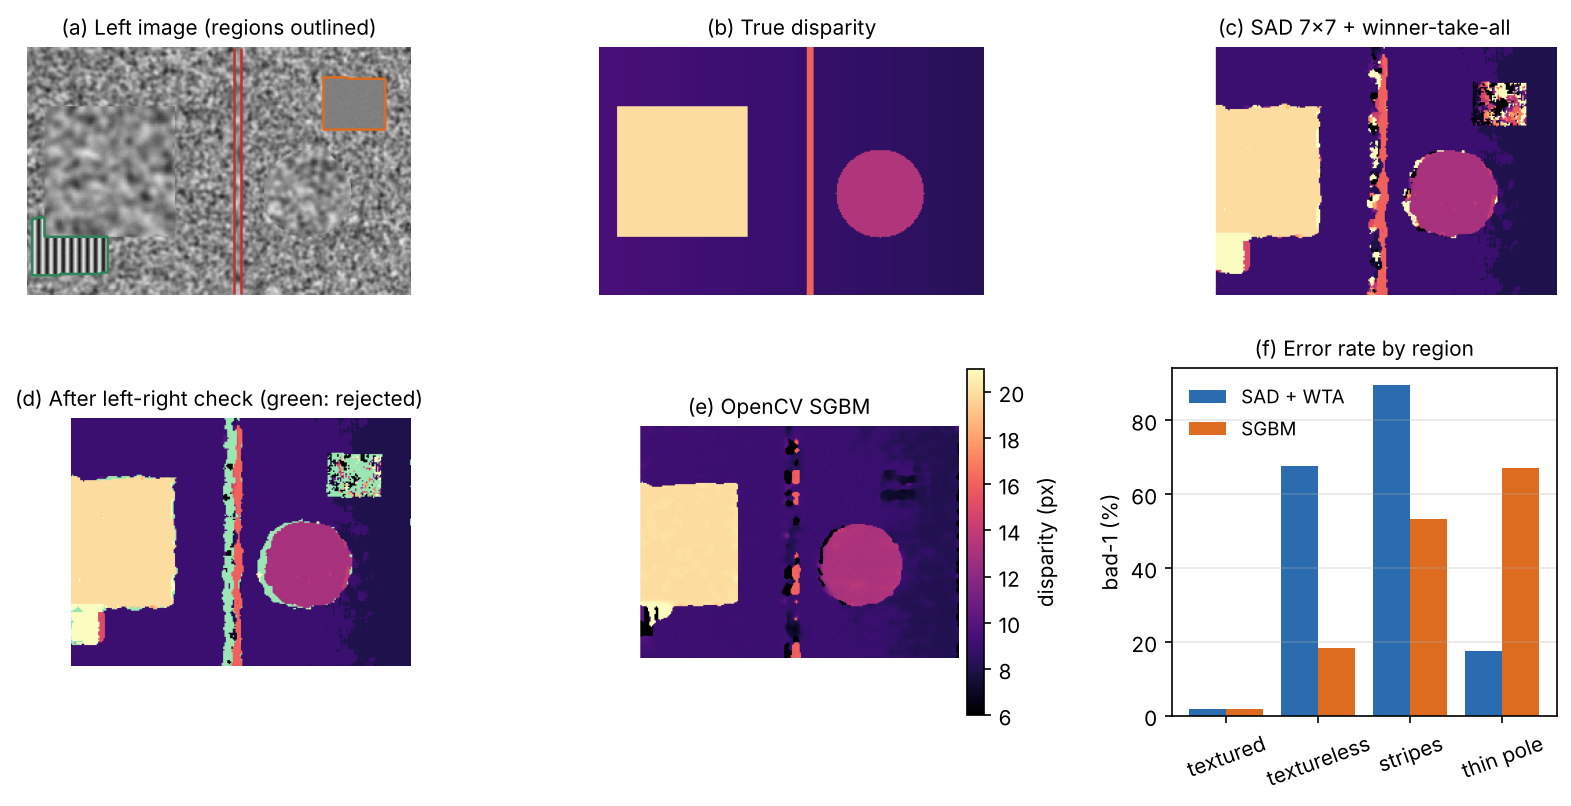
這段程式碼對一個已知深度的合成場景做光線投射,產生一對校正過的影像:一面傾斜、有紋理的牆,牆前有一個箱子、一個圓盤與一根細柱,牆上還有一塊無紋理的區塊與一塊細條紋。它建立 SAD 代價體,取 WTA 視差,並執行左右一致性檢查:改用右影像當參考再比對一次,兩個答案相差超過一個像素的像素就剔除。被遮擋的像素通常過不了這項檢查,因為它們在右影像中的「配對」屬於另一個表面,而那個表面自己的配對指向別處。為了比較,它也執行 OpenCV 的半全域匹配器(下一小節)。誤差以 bad-1 回報,也就是視差誤差超過 1 像素的像素百分比,並依各種區域分別計算。
程式碼 · Python · 68 行
import numpy as np
import cv2
from scipy import ndimage as ndi

rng = np.random.default_rng(0)
H, W, f, B = 180, 280, 320.0, 0.25                    # image size, focal length (px), baseline
tex = ndi.gaussian_filter(rng.random((700, 700)), 1.2)
tex = (tex - tex.min()) / np.ptp(tex)                 # random texture painted on every surface

def render(cx):
    """Ray-cast a rectified camera at (cx, 0, 0) looking down +Z: image, depth Z, region labels."""
    v, u = np.mgrid[0:H, 0:W].astype(float)
    dx, dy = (u - W / 2) / f, (v - H / 2) / f            # ray direction (dx, dy, 1)
    Z = (9 + 0.15 * cx) / (1 - 0.15 * dx)                # slanted wall Z = 9 + 0.15 X
    lab = np.zeros((H, W), int)                          # 0 wall, 1 box, 2 disc, 3 thin pole
    for k, z, inside in [(2, 6.0, lambda X, Y: (X - 1.2) ** 2 + (Y - 0.3) ** 2 < 0.36),
                         (3, 5.0, lambda X, Y: np.abs(X - 0.2) < 0.04),
                         (1, 4.0, lambda X, Y: (np.abs(X + 1.0) < 0.6) & (np.abs(Y) < 0.6))]:
        hit = inside(cx + z * dx, z * dy) & (z < Z)
        Z, lab = np.where(hit, z, Z), np.where(hit, k, lab)
    X, Y = cx + Z * dx, Z * dy
    img = ndi.map_coordinates(tex, [350 + 40 * Y + 60 * lab, 350 + 40 * X], order=1)
    flat = (lab == 0) & (X > 2.2) & (X < 3.6) & (Y > -2.0) & (Y < -0.9)
    rep = (lab == 0) & (X > -3.6) & (X < -2.2) & (Y > 0.9) & (Y < 2.0)
    img[flat] = 0.5                                                  # textureless patch: label 4
    img[rep] = 0.5 + 0.4 * np.sin(2 * np.pi * X[rep] / 0.15)        # repetitive stripes: label 5
    lab[flat], lab[rep] = 4, 5
    return img + rng.normal(0, 0.01, img.shape), Z, lab

left, Z_left, lab = render(0.0)
right, Z_right, _ = render(B)
d_true = f * B / Z_left                                # ground-truth disparity of the left view
rows, cols = np.mgrid[0:H, 0:W]
xr = np.round(cols - d_true).astype(int)               # where each left pixel lands in the right view
occluded = (xr < 0) | (np.abs(Z_right[rows, np.clip(xr, 0, W - 1)] - Z_left) > 0.05)

def sad_volume(ref, other, D, win, sign):
    """cost[d](y, x) = sum over a win x win window of |ref(y, x) - other(y, x - sign*d)|."""
    cost = np.full((D, H, W), np.inf)
    for d in range(D):
        c = ndi.uniform_filter(np.abs(ref - np.roll(other, sign * d, axis=1)), win) * win ** 2
        if sign > 0: c[:, :d] = np.inf                 # no partner pixel exists there
        else:        c[:, W - d:] = np.inf
        cost[d] = c
    return cost

D, win = 32, 7
d_left = sad_volume(left, right, D, win, +1).argmin(0)     # winner-take-all, left image as reference
d_right = sad_volume(right, left, D, win, -1).argmin(0)    # winner-take-all, right image as reference
lr_ok = np.abs(d_left - d_right[rows, np.clip(cols - d_left, 0, W - 1)]) <= 1   # left-right check

sgbm = cv2.StereoSGBM_create(minDisparity=0, numDisparities=D, blockSize=5,
                             P1=8 * 25, P2=32 * 25, uniquenessRatio=0, disp12MaxDiff=-1)
u8 = lambda a: np.clip(a * 255, 0, 255).astype(np.uint8)
d_sgbm = sgbm.compute(u8(left), u8(right)).astype(float) / 16    # OpenCV stores 16 x disparity

valid = ~occluded & (cols >= D)                        # visible in both views, away from the left strip
regions = {"textured": valid & np.isin(lab, [0, 1, 2]), "textureless": valid & (lab == 4),
           "stripes": valid & (lab == 5), "thin pole": valid & (lab == 3)}
bad = lambda d, m: 100 * np.mean(np.abs(d - d_true)[m] > 1)      # % of pixels off by > 1 px
print(f"disparity {d_true.min():.1f}-{d_true.max():.1f} px; occluded: {100 * occluded.mean():.1f}% of pixels")
print("bad-1 (%)          " + "".join(f"{k:>12s}" for k in regions))
for name, d in [("SAD + WTA", d_left), ("OpenCV SGBM", d_sgbm)]:
    print(f"{name:19s}" + "".join(f"{bad(d, m):12.1f}" for m in regions.values()))
print(f"left-right check: keeps {100 * lr_ok[valid].mean():.1f}% of visible pixels, "
      f"rejects {100 * (~lr_ok[occluded]).mean():.1f}% of occluded ones")
kept = valid & lr_ok
print(f"SAD + WTA bad-1 on all visible pixels: {bad(d_left, valid):.1f}% -> after the check {bad(d_left, kept):.1f}%")
輸出
disparity 8.3-20.0 px; occluded: 7.7% of pixels
bad-1 (%)              textured textureless     stripes   thin pole
SAD + WTA                   1.8        67.7        89.6        17.4
OpenCV SGBM                 1.7        18.2        53.3        67.2
left-right check: keeps 96.6% of visible pixels, rejects 93.0% of occluded ones
SAD + WTA bad-1 on all visible pixels: 6.1% -> after the check 3.6%
這些數字只來自這個合成場景。在有紋理的表面上,SAD 區塊匹配有 98% 的像素是對的;在無紋理的區塊上,三分之二是錯的;在條紋上,十個有九個是錯的,正如代價曲線所預測的。左右一致性檢查剔除了 93% 被遮擋的像素,同時保留了 96.6% 看得見的像素,保留的像素上的 bad-1 從 6.1% 降到 3.6%。被剔除的像素是洞,不是錯誤:後面的階段知道不要相信它們,可以從鄰居填補。
代價聚合與半全域匹配
白話版。 視窗匹配讓每個像素自己做決定。比較好的規則是讓相鄰的像素「投票」:空白區域中的像素,應該採用它有紋理的鄰居的視差,除非有充分的證據顯示這裡有深度跳變。
傳統的說法是對整張視差圖 寫一個能量函數,
其中第二個總和遍歷相鄰的像素對 , 在條件成立時為 1、否則為 0, 是視差改變一級(傾斜表面)時的小懲罰, 是視差跳變(深度邊緣)時較大的懲罰 [5], [6]。要在二維影像上精確地最小化這個能量,一般而言是不可行的。
Hirschmüller 的半全域匹配(semi-global matching, SGM)[5] 近似地做這件事:沿著穿過每個像素的許多條一維直線路徑最小化能量,每條路徑都能用動態規劃精確求解,再把結果加總。沿著方向為 的路徑,聚合後的代價為
其中 是路徑上的前一個像素,最後一項只是讓數字維持有界 [6]。所有方向的代價加總後,再用 WTA 選出視差,因此每個像素都從多個方向的遠處接收到證據,而計算成本與代價體的大小成線性關係。OpenCV 的 StereoSGBM 是修改過的版本:預設用 5 個方向,而不是完整演算法的 8 個;用小區塊,而不是單一像素;用 Birchfield–Tomasi 代價,而不是互資訊 [7]。
這段程式碼展示了 SGM 的取捨。在無紋理的區塊上,錯誤像素從 67.7% 降到 18.2%,因為平滑項把牆的視差帶進了區塊內。但寬度約五個像素的細柱大部分被抹掉了(17.4% → 67.2%):它要付兩次 的跳變,卻只換到很少的證據(圖 4e)。兩種方法都解不開條紋,這是資料本身真正的歧義。平滑先驗是在賭世界由大片表面組成,而這個賭注在細長結構上會輸。
選讀:半全域匹配一步一步來(見「補充資料」頁)。沿一條掃描線的遞迴程式碼、為什麼 ,以及兩條相反方向的路徑如何在不模糊深度階梯的前提下填補無紋理的缺口。
精修:子像素視差與後處理
WTA 回傳整數視差,但圖 2b 已顯示,不到一個像素的小數部分也很重要。常見的修正是用拋物線穿過最佳整數視差及其兩個鄰居的代價,取拋物線的最小值。其他後處理步驟包括左右一致性檢查、中值濾波器,以及從鄰居填補被剔除的像素;例如 MC-CNN 的流程就結合了交叉式聚合、SGM、左右一致性檢查、子像素強化、中值濾波器與雙邊濾波器 [6]。
選讀:子像素視差與 soft argmin(見「補充資料」頁)。拋物線公式,以及為什麼學習式的 soft argmin 在深度邊緣會落在兩個表面之間。
學習式立體匹配
白話版。 傳統流程的每一步都是手工規則。深度立體匹配一次一個地把它們換成學習出來的規則:先是代價,接著是聚合,最後是在大型合成資料集上端到端訓練的整條流程。
Laga 等人 [8] 與 Tosi 等人 [9] 的綜述,順序都和這一節相同:先是流程中被學習的部分,再是端到端網路,然後是 2020 年代的架構。
學習匹配代價
Žbontar 與 LeCun 的 MC-CNN [6] 訓練一個卷積網路,判斷兩個小區塊是否拍到同一個點,用由真實視差建出的區塊對作為二元分類資料集。網路的輸出取代 SAD 成為匹配代價,傳統流程的其餘部分(交叉式聚合、SGM、左右一致性檢查、子像素強化、濾波)接著執行。教訓是:學習出來的相似度,比原始強度更有辨別力得多,但手工設計的聚合仍然留著。
端到端的代價體網路
端到端訓練需要許多影像的密集真值,而真實掃描很少提供。Mayer 等人 [10] 算繪了三個資料集(FlyingThings3D、Monkaa、Driving);光是 FlyingThings3D 就有約 25,000 個立體影格,內容是沿著隨機三維路徑飛行的隨機物體,他們用它訓練了 DispNet,一個迴歸視差的編碼器–解碼器 [10]。這些「Scene Flow」資料集合起來,成為立體網路常用的預訓練資料。
Kendall 等人的 GC-Net [11] 讓代價體變得明確且可學習。一個共用的 2D CNN 從兩張影像擷取特徵。對每個視差級別,左特徵會與位移了該級別的右特徵串接,得到大小為高 × 寬 ×(最大視差 + 1)× 特徵維度的 4D 體 [11]。對這個體做 3D 卷積,學習聚合,同時利用空間與視差上的情境。最後,soft argmin 把正則化後的代價 變成子像素視差:
其中 是沿視差維度的 softmax, 是最大視差 [11]。它和 argmin 不同,是可微分的,所以網路可以對 用迴歸損失做端到端訓練。PSMNet [12] 在代價體之前加入一個空間金字塔池化模組,在多個尺度上收集情境,並加入堆疊的沙漏式 3D CNN 與中間監督來正則化代價體,用 smooth L1 損失訓練 [12]。兩者針對的都是病態區域,例如遮擋、重複圖案、無紋理與反光的表面,在這些地方局部區塊給不出答案 [12]。
3D 卷積的代價是記憶體與計算量都正比於 ,所以這些網路只能在降低的解析度與固定的最大視差下運作。
迭代精修與零樣本立體匹配
RAFT-Stereo [13] 把 RAFT 光流網路(在下方的光流一節說明)改造成適用於校正過的立體影像:它把 RAFT 的 4D 全對體換成只比較同一列像素的 3D 體,並用循環單元逐步精修視差場,這些單元在目前的估計附近查詢該體,還加入多層級 GRU,更有效率地把資訊傳遞到整張影像 [13]。沒有 3D 卷積,也沒有需要正則化的固定視差範圍。Tosi 等人稱這個設計是「game changer」,指出它對領域偏移的穩健性大幅提高,而且大多數近期的框架都跟隨它 [9]。IGEV-Stereo [14] 結合了這兩種想法:一個編碼幾何與情境的幾何編碼體,為循環更新提供良好的起點,並在每次迭代中被索引 [14]。
這些綜述強調的未解問題是泛化:在一個基準上微調的網路,常在另一個基準上失效 [9], [15]。FoundationStereo [16] 以零樣本使用為目標:它在一個約一百萬對立體影像的大型合成資料集上訓練,並自動移除有歧義的樣本,還透過 side-tuning 骨幹網路,改編單目視覺基礎模型的特徵,以縮小合成影像與真實影像之間的差距 [16]。
單目深度估計
白話版。 只有一張影像時,沒有東西可以比對。網路必須像人閉上一隻眼睛那樣辨認深度:靠透視、物體的已知大小、遮擋、陰影、霧氣,以及越遠越細緻的紋理。這些線索能告訴你哪些東西比較近,卻分不出玩具車和真車。
為什麼單張影像不夠:尺度歧義
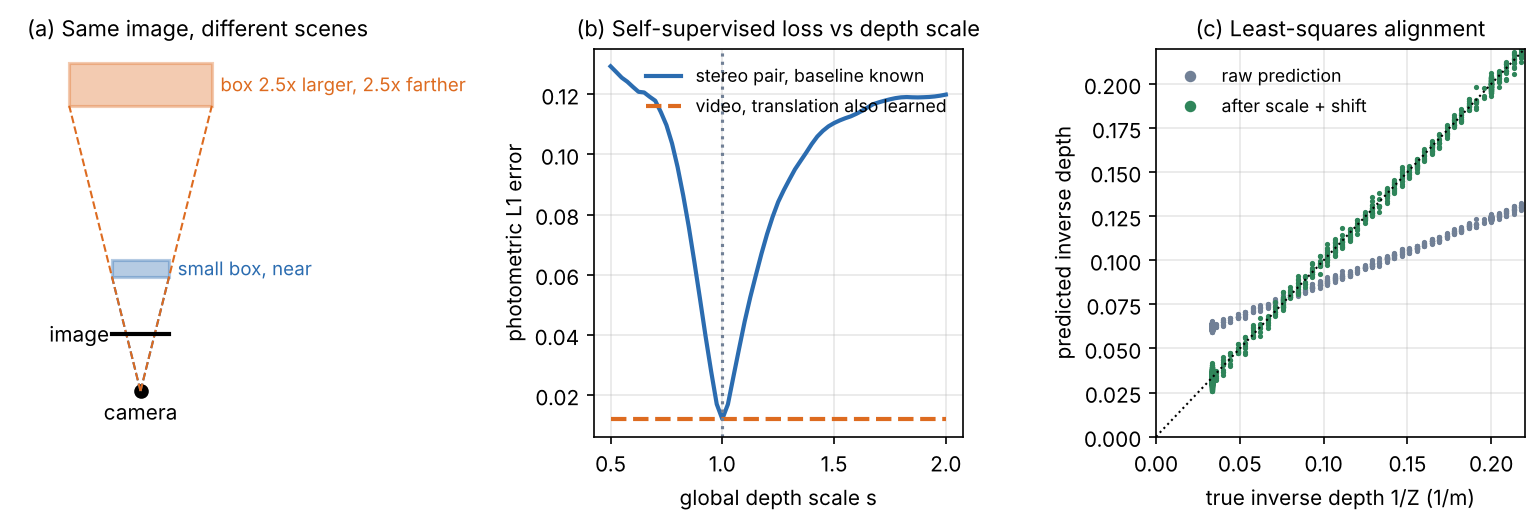
把整個場景縮放 倍,影像不會改變,因為投影會除以深度(圖 5a;另見 DLCV 11,以及三維偵測的 DLCV 03B)。Eigen 等人把全域尺度稱為「深度預測中的根本歧義」,並指出他們的大部分誤差單單來自平均深度 [17]。
網路仍然可以學到公制線索,例如物體的典型大小,或行車資料集的相機高度,但相機或場景類型一變,這些線索就失效。因此會用到兩種輸出:
- 相對(仿射不變)深度。 預測只對到一個未知的尺度與平移。許多這類模型,包括 MiDaS 與 Depth Anything,預測的是逆深度(類似視差的值)[18], [19],所以輸出 滿足 ,其中 與 未知。搭配少數幾個公制測量時,這對排序、分割、編輯與許多機器人任務就夠用了。
- 公制深度。 預測以公尺為單位。這需要已知的相機,或一個能從影像估計相機的模型。
忽略尺度與平移的損失函數
要在深度只知道到某個尺度、或單位不同的資料集上訓練,損失函數必須忽略那些未知的因子。Eigen 等人提出了尺度不變對數誤差(scale-invariant log error)[17]:
其中 與 是像素 的預測與真實深度, 是有真值的像素數, 是讓兩張圖最佳對齊的對數尺度偏移;把 乘上任何常數, 都不變 [17]。訓練時,他們用這個誤差與一般對數空間 L2 誤差的混合,權重 ,他們發現這能給出良好的絕對尺度預測 [17]。
Ranftl 等人的 MiDaS [18] 更進一步:它預測逆深度(視差)到尺度與平移,並在計算損失之前,先把每個預測對齊到真值。令 為 個有效像素上的預測視差, 為真值,對齊要解
這是一個直線的普通最小平方擬合,有封閉解 [18]。尺度與平移不變損失(scale-and-shift-invariant loss)則是 ,其中 是逐像素的損失,這裡取平方誤差 [18]。MiDaS 還有穩健版本(以中位數為基礎的對齊、修剪的絕對值損失)、一個讓深度邊緣保持銳利的梯度匹配項,並混合了五個訓練資料集,其中一個取自 3D 電影 [18]。它以零樣本跨資料集轉移來評估,也就是在訓練時從未見過的資料集上測試 [18]。
選讀:MiDaS(Ranftl 等人,2022)(見「論文導讀」頁)。論文提出什麼問題、它的表格如何對齊,以及拿它的數字與其他論文比較之前該檢查什麼。
這段程式碼建立一張玩具深度圖(地面、遠處的牆與一個箱子),模擬一個輸出為逆深度、帶有未知尺度與平移的相對模型,並比較三種解讀它的方式。
程式碼 · Python · 28 行
import numpy as np

rng = np.random.default_rng(1)
H, W, f, cam_h = 120, 160, 150.0, 1.5
v, u = np.mgrid[0:H, 0:W].astype(float)
Z = np.full((H, W), 30.0)                                      # far wall
below = v > H / 2 + 1
Z[below] = np.minimum(30.0, f * cam_h / (v[below] - H / 2))    # ground plane seen by a camera 1.5 m high
box = (np.abs(u - 50) < 15) & (v > 45) & (v < 80)
Z[box] = 5.0                                                   # an object 5 m away

# A "relative" network outputs inverse depth up to an unknown scale and shift, plus some noise.
pred = 0.37 / Z + 0.05 + rng.normal(0, 0.001, Z.shape)

def metrics(Zp, Zt):
    absrel = np.mean(np.abs(Zp - Zt) / Zt)
    rmse = np.sqrt(np.mean((Zp - Zt) ** 2))
    delta1 = np.mean(np.maximum(Zp / Zt, Zt / Zp) < 1.25)
    return f"AbsRel {absrel:6.3f}   RMSE {rmse:6.2f} m   delta<1.25 {100 * delta1:5.1f}%"

Z_raw = 1 / pred                                               # read the output as if it were metric
Z_med = Z_raw * np.median(Z) / np.median(Z_raw)                # median scaling (scale only)
A = np.c_[pred.ravel(), np.ones(pred.size)]                    # least squares for (s, t) in inverse depth
s, t = np.linalg.lstsq(A, (1 / Z).ravel(), rcond=None)[0]
Z_ssi = 1 / (s * pred + t)
print("raw output        ", metrics(Z_raw, Z))
print("median scaling    ", metrics(Z_med, Z))
print("scale+shift (LSQ) ", metrics(Z_ssi, Z), f"  s = {s:.3f}, t = {t:.4f}")
輸出
raw output         AbsRel  0.460   RMSE  10.46 m   delta<1.25  10.2%
median scaling     AbsRel  0.785   RMSE   7.24 m   delta<1.25  54.8%
scale+shift (LSQ)  AbsRel  0.043   RMSE   1.84 m   delta<1.25  99.5%   s = 2.699, t = -0.1348
這些是玩具數字。把輸出當成公制深度來讀,它毫無用處(只有 10% 的像素 δ < 1.25)。中位數縮放(median scaling)把深度乘上一個係數;它改善了 δ,卻讓 AbsRel 變得更糟,因為沒有任何單一係數能抵消逆深度中的平移。最小平方擬合求得 、,幾乎正好就是模擬時設定的 ,深度圖也變得幾近完美。同一個預測,視對齊方式而定,可以看起來很差,也可以看起來很棒,所以讀論文時一定要確認它用的是哪一種。
從相對深度到公制深度的基礎模型
現代的單目模型使用標準的密集預測網路;進步來自訓練資料,以及處理尺度的方式。在相對深度這一邊,DPT [20] 把 Vision Transformer 編碼器帶進密集預測,Depth Anything [19], [21] 用數千萬張偽標記影像擴大訓練,Marigold [22] 則把影像擴散模型改造成深度估計器。在公制深度這一邊,ZoeDepth [23] 在相對模型上加入公制預測頭,而 Metric3D [24], [25]、UniDepth [26] 與 Depth Pro [27] 則明確處理相機,做法是把影像映射到標準焦距,或從影像估計相機。要記住的一個想法是:相對深度現在已經能穩健地用在許多種影像上,而一旦模型知道、或能推斷出相機,公制深度就變得可用。DUSt3R 與 VGGT 這類同時預測幾何與相機的密集點圖模型,在 DLCV 11,前饋式重建中介紹。
選讀:單目深度基礎模型:資料與相機(見「補充資料」頁)。這七個模型各自改變了什麼,一個模型一個模型地說明。
從立體對與影片做自監督深度
白話版。 不用真值深度,改用第二個視角當老師。如果網路的深度是對的,你就能把第二個視角扭曲到第一個視角上,得到同一幅畫面。扭曲後的影像與真實影像之間的差異,就是訓練訊號。
以視角合成作為監督
Garg 等人 [28] 用相機位移已知且很小的立體影像對,訓練單目網路:左影像的預測深度,加上已知的基線,把右影像扭曲到左視角,這個重建的光度誤差就是損失,完全不需要深度標籤 [28]。Godard 等人 [29] 加入左右一致性(left–right consistency)損失,讓為兩個視角預測的視差彼此一致,改善了品質 [29]。Zhou 等人 [30] 拿掉了第二台相機:他們用無標記的單目影片,同時訓練一個深度網路和一個位姿網路(pose network),唯一的監督是相鄰影格之間的視角合成 [30]。
對目標影格 與來源影格 ,每個目標像素 (以齊次座標表示)會被映射到來源影格:
其中 是相機內參矩陣, 是該像素的預測深度, 是預測的相對相機位姿(旋轉與平移), 表示在齊次尺度之下相等。用雙線性取樣器(DLCV 09A.3)在 處對 取樣,就得到合成影像 ;梯度會穿過它,流進兩個網路。
Monodepth2
Godard 等人的 Monodepth2 [31] 指出,一個謹慎做出設計選擇的簡單模型,勝過更複雜的模型。它的兩張影像之間的光度誤差,結合了 SSIM(DLCV 09,全參考指標)與 L1:
其中 是目標影像與一張合成影像,逐像素比較 [31], [32]。三個想法讓它很穩健 [31]:
- 逐像素最小重投影。 有多個來源影格(前一張與後一張)時,取各來源的誤差最小值,而不是平均,即 ,因為一個在某個來源被遮擋的像素,通常在另一個來源看得見。
- 自動遮罩(auto-masking)。忽略「不扭曲時的誤差已經比扭曲後更低」的像素。這能排除靜止的相機,以及隨相機一起移動的物體,否則網路會從前方行駛的汽車學到「無限遠的深度」。
- 全解析度多尺度損失。 在計算誤差之前,先把較低解析度的深度預測上取樣到輸入尺寸,以減少瑕疵。
一個考慮邊緣的平滑項,權重為 ,用來抑制影像本身平滑處的深度變化 [31]。
再談尺度
從單目影片訓練時,深度網路從未看到任何公制量:深度與平移可以一起縮放,而不改變 。圖 5b 在合成立體場景上顯示了這一點:基線固定時,光度損失在真實尺度處有尖銳的最小值;如果平移跟著深度一起縮放,損失就是平的。這就是為什麼 Monodepth2 對單目訓練的結果,是在經過逐張影像的真值中位數縮放後才回報(沿用 SfMLearner 的做法),但對立體訓練的結果則不這麼做,因為「尺度可由已知的相機基線推得」 [31]。其他限制則是匹配本身的限制:無紋理與反光的表面、移動的物體與遮擋。
把光流當作學習問題
白話版。 光流就是沒有規則手冊的立體匹配:配對可能往任何方向移動,可能是不到一個像素,也可能是一百個像素,而且物體各自獨立運動。傳統方法為每一對影像解一個能量函數;深度方法則從合成影片學習如何匹配與精修。
從能量函數到網路
傳統方法從亮度恆定 出發,它對每個像素的兩個未知數只給一條方程式,所以要再加一個假設才能解開:流場的全域平滑性(Horn 與 Schunck [33])、小視窗內流為常數並以最小平方求解(Lucas 與 Kanade [34]),或影像的局部多項式模型(Farnebäck [35])。DLCV 04B 介紹了這些想法與孔徑問題(aperture problem)。
選讀:亮度恆定與傳統光流求解器(見 DLCV 04B 的「補充資料」頁)。線性化的光流方程式、Horn–Schunck 能量函數,以及 Farnebäck 方法背後的多項式展開。
Hur 與 Roth [36] 把轉向深度學習的過程描述成兩個家族:把 CNN 當作特徵擷取器,放在傳統能量公式之中;以及直接迴歸光流的端到端網路。第二個家族勝出了。有四個里程碑通往 RAFT:
- FlowNet [37] 用 CNN 端到端地迴歸光流。由於缺乏真實的訓練資料,作者建立了 Flying Chairs,這是 22,872 對影像,內容是算繪的 3D 椅子模型,以隨機仿射轉換移動在照片背景之上,他們發現用它訓練的網路仍然能泛化到 Sintel 與 KITTI [37]。它的 FlowNetC 變體加入了相關層(correlation layer),在一系列位移下比較兩張影像的特徵。
- FlowNet 2.0 [38] 堆疊了數個 FlowNet,每個都用目前的估計扭曲第二張影像,並顯示訓練資料集的順序影響很大 [38]。
- SPyNet [39] 使用傳統的影像金字塔:在每一層,其中一張影像被目前的光流扭曲,再由一個小網路預測不到一個像素的更新 [39]。
- PWC-Net [40] 在學習出來的特徵上結合金字塔(pyramid)、扭曲(warping)與代價體(cost volume),而且比 FlowNet2 小 17 倍 [40]。
RAFT:全對相關與迭代更新
白話版。 RAFT 把第一張影像的每個像素和第二張影像的每個像素比較,只做一次。然後它從零運動出發,像一個人在修改草圖那樣,反覆查看目前猜測附近的匹配分數,再把猜測微調一點;每次都是同一個小更新,一再重複。
Teed 與 Deng 的 RAFT [41] 有三個部分 [41]:
- 特徵。 CNN 編碼器把兩張影像映射成 1/8 解析度、 個通道的特徵;另有一個獨立的情境網路(context network),只編碼第一張影像。
- 全對相關。 相關體裝的是每一對特徵的內積,
其中 是位於第 列、第 欄的特徵的第 個通道, 是在特徵解析度下的大小。對最後兩個維度用核大小 1、2、4、8 做平均池化,就得到四層的相關金字塔(correlation pyramid),它對第一張影像保持完整解析度,並用較粗的層涵蓋大位移。 3. 迭代更新。 從 開始,一個卷積 GRU(閘控循環單元)反覆讀取每個像素目前所指位置周圍小鄰域(半徑 )內、所有金字塔層級的相關值,再加上情境特徵與目前的光流,輸出一個更新:。各次迭代共用權重。學習出來的凸組合上取樣(convex upsampling)把 1/8 解析度的光流變成完整解析度。
損失對每一次迭代都做監督,權重隨迭代次數指數增加,
其中 是第 次更新後上取樣的光流, 是更新次數, 是真值 [41]。RAFT 在訓練時展開 12 次更新,測試時可以跑更多次;論文在 Sintel 上用 32 次更新、在 KITTI 上用 24 次更新評估 [41]。訓練遵循標準排程:先 Flying Chairs,再 FlyingThings3D,然後在目標基準上微調 [41]。
這個設計為什麼贏?全對體避開了由粗到細方案的弱點,也就是小而快的物體可能在粗層級就永遠消失 [41];共用的更新表現得像一個學習出來的最佳化器;而這套做法也轉移到了立體匹配 [13] 與場景流 [42]。
選讀:RAFT(Teed 與 Deng,2020)(見「論文導讀」頁)。如何讀 RAFT 的消融實驗與基準表格。
RAFT 之後
後來的模型各自改變這套做法的一個部分。GMFlow [43] 與 Unimatch [44] 用 Transformer 特徵的全域匹配取代迭代查表:每個像素都和另一張影像的所有像素比較,光流是 softmax 加權的平均位置;Unimatch 用同一個模型做光流、立體匹配與有位姿影像的深度 [44]。FlowFormer [45] 用 Transformer 層編碼 RAFT 的代價體。SEA-RAFT [46] 保留 RAFT,但加入 mixture-of-Laplace 損失、直接迴歸的初始光流與剛體運動預訓練,以求更快的速度與更好的泛化 [46]。
程式碼:量測光流誤差
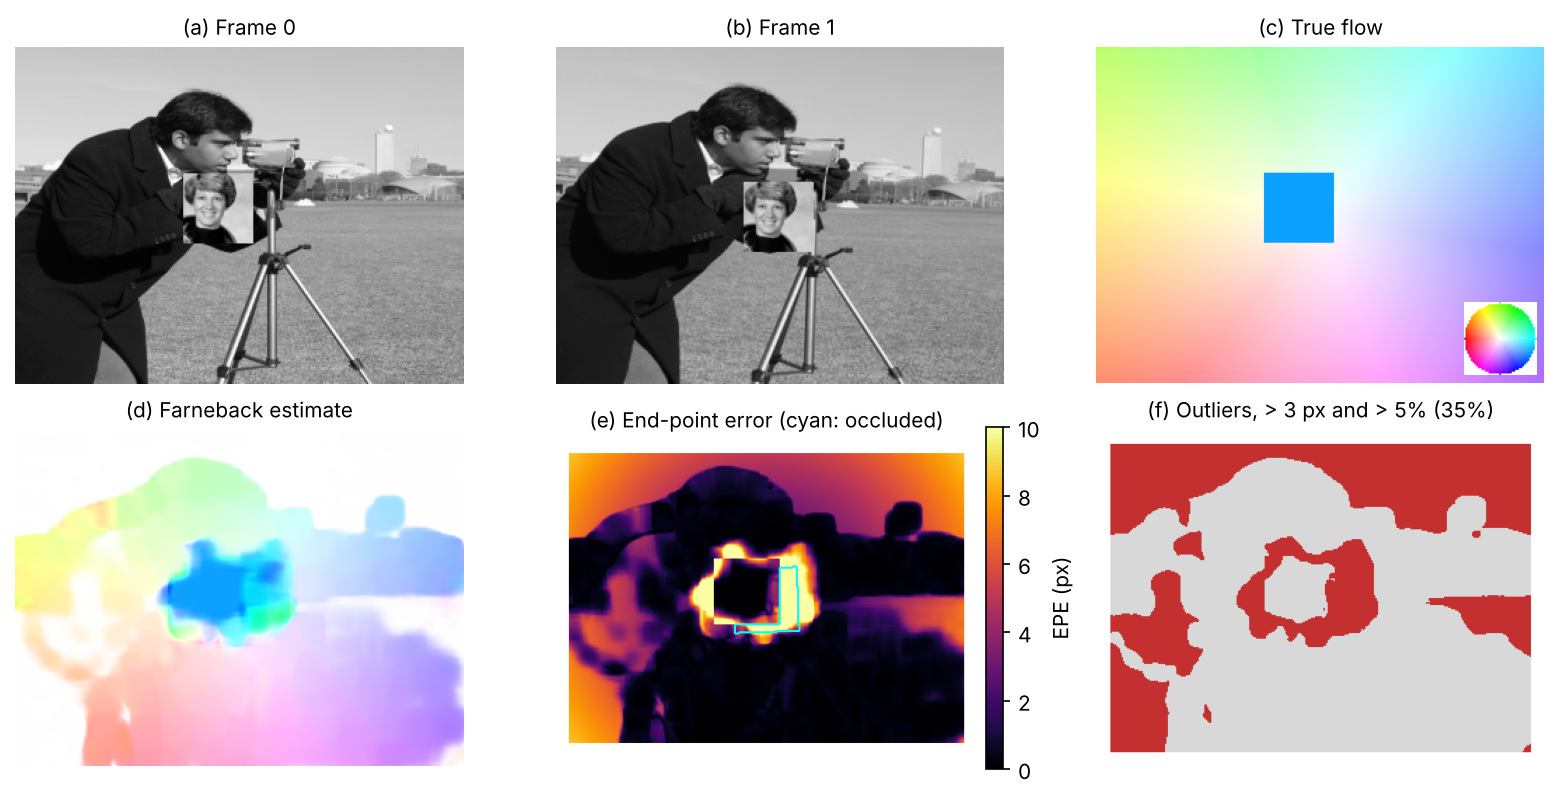
這段程式碼建立一對已知光流的影格:背景(camera 測試影像)繞中心旋轉 2° 並放大 3%,一塊有紋理的區塊疊在上面,移動 (14, 6) 像素。它用一層與四層金字塔執行 OpenCV 的 Farnebäck 光流,並對不同種類的像素回報端點誤差(end-point error, EPE,誤差向量的長度)與 KITTI 使用的 Fl 離群值比例(定義見評估)。
程式碼 · Python · 49 行
import numpy as np
import cv2
from scipy import ndimage as ndi
from skimage import color, data, transform

I0 = transform.resize(data.camera() / 255.0, (240, 320), anti_aliasing=True)
H, W = I0.shape
rows, cols = np.mgrid[0:H, 0:W].astype(float)
cy, cx = H / 2, W / 2

# Ground-truth motion from frame 0 to frame 1: the background rotates by 2 degrees and zooms by 3 %
# about the image centre; a 50 x 50 textured patch moves by (dx, dy) = (14, 6) pixels.
a, s = np.deg2rad(2.0), 1.03
bx = cx + s * (np.cos(a) * (cols - cx) - np.sin(a) * (rows - cy))     # where each background pixel goes
by = cy + s * (np.sin(a) * (cols - cx) + np.cos(a) * (rows - cy))
flow = np.stack([bx - cols, by - rows], -1)
patch = transform.resize(color.rgb2gray(data.astronaut())[30:230, 150:350], (50, 50), anti_aliasing=True)
obj0 = (rows >= 90) & (rows < 140) & (cols >= 120) & (cols < 170)
flow[obj0] = (14.0, 6.0)

# Render frame 1 by backward mapping (inverse rotation and zoom), then paste the moved patch.
xs = cx + (np.cos(a) * (cols - cx) + np.sin(a) * (rows - cy)) / s
ys = cy + (-np.sin(a) * (cols - cx) + np.cos(a) * (rows - cy)) / s
I1 = ndi.map_coordinates(I0, [ys, xs], order=3, mode="reflect")
I0 = I0.copy(); I0[90:140, 120:170] = patch
I1[96:146, 134:184] = patch
# occluded: background points of frame 0 that land under the patch in frame 1
occ = ~obj0 & (by >= 96) & (by < 146) & (bx >= 134) & (bx < 184)

def evaluate(est, mask):
    epe = np.linalg.norm(est - flow, axis=-1)[mask]
    mag = np.linalg.norm(flow, axis=-1)[mask]
    fl = np.mean((epe > 3) & (epe > 0.05 * mag))       # KITTI outlier: > 3 px and > 5 % of the true motion
    return f"EPE {epe.mean():5.2f} px  Fl {100 * fl:5.1f}%"

u8 = lambda im: (np.clip(im, 0, 1) * 255).round().astype(np.uint8)
inner = np.zeros((H, W), bool); inner[10:-10, 10:-10] = True
grad = ndi.gaussian_filter(np.hypot(ndi.sobel(I0, 0), ndi.sobel(I0, 1)), 4)
bg = inner & ~obj0 & ~occ
flat = grad < 0.05                                     # almost no texture (mostly the sky)
for levels in [1, 4]:
    est = cv2.calcOpticalFlowFarneback(u8(I0), u8(I1), None, pyr_scale=0.5, levels=levels, winsize=15,
                                       iterations=5, poly_n=7, poly_sigma=1.5, flags=0)
    print(f"Farneback, {levels} pyramid level(s):")
    for name, m in [("background, textured", bg & ~flat), ("background, flat", bg & flat),
                    ("moving patch", obj0), ("occluded", occ), ("all (Fl-all)", inner)]:
        print(f"   {name:21s} {evaluate(est, m)}")
print(f"true motion: background up to {np.linalg.norm(flow[~obj0], axis=-1).max():.1f} px, patch "
      f"{np.hypot(14, 6):.1f} px; occluded pixels: {occ.sum()}")
輸出
Farneback, 1 pyramid level(s):
   background, textured  EPE  0.87 px  Fl   9.3%
   background, flat      EPE  5.51 px  Fl  90.3%
   moving patch          EPE 18.24 px  Fl 100.0%
   occluded              EPE  5.07 px  Fl  68.0%
   all (Fl-all)          EPE  2.86 px  Fl  35.6%
Farneback, 4 pyramid level(s):
   background, textured  EPE  1.18 px  Fl  11.9%
   background, flat      EPE  5.52 px  Fl  90.5%
   moving patch          EPE  2.30 px  Fl  30.4%
   occluded              EPE 12.20 px  Fl  99.8%
   all (Fl-all)          EPE  2.55 px  Fl  35.2%
true motion: background up to 9.3 px, patch 15.2 px; occluded pixels: 871
這些數字只來自這對玩具影像。只用一層時,區塊 15 px 的運動超出能力範圍,區塊上每個像素都是離群值;用四層時找到了區塊(EPE 2.30 px),這是 SPyNet 與 PWC-Net 由粗到細想法的傳統版本。仍有兩種失敗。在平坦區域(主要是天空),90% 的像素是離群值:根本沒有東西可以匹配。在被遮擋的像素上,也就是區塊在第 1 張影格中蓋住的那一條帶,金字塔反而讓情況更糟(EPE 12.2 px),因為粗層級把它們跟著區塊一起拖走(圖 6)。學習式方法被訓練成能從資料中處理這兩種情況,但兩者都不會消失。
場景流(簡介)
白話版。 光流說的是一個點在影像中怎麼動。場景流說的是它在三維中怎麼動:變近、變遠、往左或往右,以公尺計。
場景流(scene flow)是場景的密集三維運動場,這個詞可追溯到 Vedula 等人 [47];光流是它在影像上的投影。RAFT-3D 把任務表述為:給定一對立體或 RGB-D 影片影格,估計每個像素的三維運動 [42]。用立體相機時,可以由兩個時刻的視差,加上兩者之間的光流來估計。Menze 與 Geiger 的 KITTI 2015 基準 [48] 評估的正是這幾個部分:D1(第一影格的視差)、D2(第二影格的視差)、Fl(光流),以及 SF,只要這三者中任何一個錯誤,該像素就算錯 [49]。Menze 與 Geiger 把場景建模為少數幾個剛性移動的物體,每個超像素是一個指派給其中一個物體的 3D 平面 [48];RAFT-3D [42] 則改用 RAFT 式的迭代,估計剛性三維運動的密集場,並以學習出來的嵌入把像素軟分組成剛性物體 [42]。動態重建(DLCV 11)與點追蹤(DLCV 07)是它的長距離親戚。
評估
白話版。 三項任務都是逐像素對照真值打分,用平均誤差與「錯誤像素的百分比」。細節,尤其是單目預測如何對齊、哪些像素要計算,對數字的影響比你想像的更大。
深度指標
標準的一組指標可追溯到 Eigen 等人 [17]。令 為預測深度、 為真實深度,共 個被評估的像素,
另外還有 的 RMSE [17]。AbsRel、SqRel 與 RMSE 是誤差(越低越好); 的 是準確率(越高越好)。AbsRel 以相對誤差衡量近處與遠處的像素;RMSE 由遠處的像素主導; 計算落在真值 25% 以內的像素。
每一個結果都要說明三個慣例:對齊(公制模型不對齊,自監督單目模型做逐張影像的中位數縮放 [31],仿射不變模型做最小平方尺度與平移 [18]);深度上限(KITTI 上標準是 80 m [31]);以及切分(KITTI 上常用 Eigen 等人的切分 [17], [31])。對齊的程式碼已顯示光是第一項就能改變多少。
立體匹配指標
- EPE(平均絕對視差誤差,單位為像素)。
- bad-τ:視差誤差大於 像素的像素百分比。Middlebury 的第 3 版評估預設回報 bad 2.0,分成全部像素或只算未被遮擋的像素 [3];KITTI 2012 回報誤差像素的百分比,門檻從 2 到 5 像素,分成未被遮擋區域(Out-Noc)與全部(Out-All)[50]。
- D1(KITTI 2015):一個像素的視差誤差低於 3 px 或低於真值的 5%,就算正確;D1 是離群值的百分比,可對背景、前景或全部像素回報(D1-bg、D1-fg、D1-all)[49]。後面那個相對條件,避免了視差很大的近處物體被評得太嚴。
光流指標
- EPE:估計與真實光流向量之間的平均歐氏距離,,其中 與 是像素 的估計與真實光流;FlowNet 稱它是光流的標準誤差量測,也用它來訓練 [37]。Sintel 的結果以平均 EPE(常寫成 AEPE)回報。
- Fl-all(KITTI 2015):端點誤差至少 3 px 且至少為真實光流長度 5% 的像素百分比,在所有有真值的像素上計算 [49]。程式碼中的
evaluate函式算的正是這個。
資料集與基準
| 資料集 | 任務 | 內容 | 真值 |
|---|---|---|---|
| KITTI 2012 [51], [50] | 立體匹配、光流 | 194 對訓練與 195 對測試的真實道路場景影像 | 稀疏,來自雷射掃描器 |
| KITTI 2015 [48], [49] | 立體匹配、光流、場景流 | 200 個訓練與 200 個測試場景,含移動的汽車 | 稀疏、半自動,並在移動車輛上擬合 3D CAD 模型 |
| Middlebury 2014 [52] | 立體匹配 | 33 個高解析度室內場景;第 3 版評估使用其中 20 個(10 個訓練、10 個測試) | 密集,子像素精度 |
| ETH3D [53] | 立體匹配、多視角立體視覺 | 室內與室外場景,含 DSLR 影像與低解析度立體影片;包含一個低解析度雙視角基準 | 高精度雷射掃描 |
| MPI Sintel [54] | 光流(也含立體匹配、深度) | 一部開源動畫電影的影格;有「clean」與「final」兩種通道,final 含動態模糊與大氣效果 | 密集,算繪產生 |
| Flying Chairs [37] | 光流(訓練) | 22,872 對合成影像 | 密集,算繪產生 |
| FlyingThings3D [10] | 立體匹配、光流、場景流(訓練) | 約 25,000 個 960 × 540 的合成立體影格 | 密集,算繪產生 |
| NYU Depth v2 [55] | 單目深度(室內) | 464 個室內場景的 Kinect 影片;1,449 對有密集標記的 RGB-D 影像 | 密集,來自 Kinect 深度相機,缺值已填補 |
大小與真值類型取自所引用的頁面與論文;Sintel 兩種通道的描述來自 [37],KITTI 2015 的半自動真值來自 [49], [48]。合成資料集用於預訓練,真實資料集用於微調與測試。
失效模式
白話版。 本篇的每個方法都依賴兩樣東西之一:有東西可以比對,或是從訓練資料學到的先驗。下面每一種失敗,都破壞了其中之一。
- 無紋理區域(白牆、天空、馬路):匹配代價是平的(圖 3b),要靠平滑性或學習的情境來填補,而兩者都可能出錯。
- 重複圖案(柵欄、磁磚):好幾個視差都同樣吻合,正如條紋所示。
- 反光與透明的表面:被匹配的內容是倒影或後方的場景。Tosi 等人把透明與反光物體,列為深度立體匹配四大未解挑戰之一,其餘是領域偏移、過度平滑與非對稱立體對 [9]。
- 遮擋:不存在正確的配對;需要偵測(左右一致性檢查)與填補,而在光流中,它們會被拖著跟鄰近的運動走。
- 細長結構與深度邊緣:視窗會讓前景物體變胖,平滑性會抹掉柱子和電線,而對雙峰代價取的 soft argmin 會落在兩個表面之間。
- 小物體的大運動:由粗到細的方案可能把它們弄丟;RAFT 的全對體就是針對這點 [41]。
- 領域差距:在合成資料上預訓練、在某個基準上微調的模型,面對新的相機、天氣與場景會退化 [9], [36]。
- 尺度與相機(單目):相對深度沒有尺度,而在焦距未知或影像被意外裁切時,公制深度會失效。
- 自監督中的移動物體會破壞靜止場景的假設;自動遮罩只能處理最簡單的情況 [31]。Rajapaksha 等人還把細小、微小與遠處的物體,列為單目深度尚未填補的缺口 [56]。
現代觀點
綜述怎麼說
有五篇綜述涵蓋本篇的範圍。Laga 等人 [8] 綜述了到約 2019 年為止的深度立體匹配(雙視角與多視角),分成學習傳統流程中某些部分的方法,以及端到端流程,並涵蓋資料集與監督方式;單目深度不在他們的範圍內。Poggi 等人 [15] 強調學習與立體匹配互相幫助:學習改善立體匹配,立體匹配又監督單目網路;他們也涵蓋信心估計與領域偏移。Tosi 等人 [9] 回顧 2020 年代:把架構分成代價體聚合、神經架構搜尋、迭代最佳化、Vision Transformer 與馬可夫隨機場,並列出四個未解挑戰(領域偏移、過度平滑、透明與反光物體、非對稱立體對);他們在 2024 年指出,立體匹配的基礎模型當時仍然缺席。Rajapaksha 等人 [56] 依輸入與輸出、架構與監督程度整理單目深度。Hur 與 Roth [36] 追溯光流從能量最小化到 CNN 的歷程,並指出領域過擬合與複雜的訓練排程是主要限制。
選讀:「現代觀點」綜述導讀(見「論文導讀」頁)。哪個問題該讀哪篇綜述,以及各篇沒有涵蓋什麼。
2023–2026 年的最新進展
- 單目深度的基礎模型。 大規模資料(Depth Anything [19], [21])、生成式先驗(Marigold [22])與明確的相機處理(Metric3D [24], [25]、UniDepth [26]、Depth Pro [27]),讓對任意照片做零樣本深度變得實用,先是相對深度,現在越來越多是公制深度。
- 立體匹配與光流的迭代匹配。 相關體加循環更新的 RAFT 做法,主導了這兩項任務 [9];近期的變體加入幾何體(IGEV-Stereo [14])、帶注意力的全域匹配(GMFlow、Unimatch [43], [44]),或更簡單的訓練(SEA-RAFT [46])。
- 零樣本立體匹配。 FoundationStereo [16] 結合一百萬對合成影像與單目先驗,回應了 Tosi 等人所說缺少基礎模型的問題。
- 與三維重建的匯流。 預測點圖與相機的前饋式模型(DLCV 11),模糊了深度估計、立體匹配與運動恢復結構之間的界線。
尚未解決的問題
- 野外的公制深度:未知、被裁切或不尋常的相機,以及每個預測都有可靠的不確定性。
- 非朗伯場景:玻璃、鏡子與水,對立體匹配與光流都是問題 [9]。
- 銳利的邊界與細長結構,且不能過度平滑,也不能在表面之間出現「飛點」(flying pixels)。
- 時間一致性:逐影格的深度在影片中會閃爍;長序列上的光流與深度應該彼此一致。
- 評估:稀疏或半自動的真值、不一致的對齊慣例,以及基準飽和,讓很小的差異難以解讀。
重點整理
- 校正後立體匹配限制在影像列上,光流跨時間尋找對應,單目深度則依賴學得或幾何假設。
- 視差越小,深度越敏感;校準、基線與次像素精度限制可用範圍。
- 成本聚合與正則化補足不確定區域,也可能抹去細窄結構。
- 區分相對與公尺尺度深度,並註明評估使用的尺度或平移對齊。
- 光度監督依賴可見性與場景假設,移動或遮擋內容需要另行處理。
- 報告誤差單位、評估像素、深度上限與切分;模型名稱相近不代表協定可比。
練習
- 選擇基線。 一台 像素的立體相機,必須在 40 m 處把深度誤差壓在 1 m 以下,假設視差誤差為 0.3 像素。最小的基線是多少?此時 40 m 處的點視差是多少?在 80 m 會發生什麼事?
提示
由 : m。40 m 處的視差為 px。在 80 m 處,誤差變成四倍(約 4 m),視差為 6 px。
- 視窗大小與變胖。 在區塊匹配的程式碼中,把
win改成 3、7 與 15,比較四個區域的 bad-1。為什麼大視窗在一個地方有幫助,在另一個地方卻有害?
提示
在我們的執行中,無紋理區域的 bad-1 從 84.4%(3 × 3)降到 67.7%(7 × 7)與 39.9%(15 × 15),而細柱則從 15.3% 升到 17.4% 與 74.6%。大視窗會從平坦區塊之外收集紋理,但在深度邊緣附近,它會混入兩個表面,把前景的視差擴散到背景(「前景變胖」),這就吞掉了細柱。
- 條紋與週期。 牆上條紋的週期是 0.15 個世界單位,那裡的牆約在 8.6 單位遠處。估計它們以像素為單位的週期(取 px),然後解釋為什麼區塊匹配在那裡會給出錯誤的視差。場景要怎麼改,條紋才能被匹配?演算法要怎麼改,可能有幫助?
提示
週期約為 px,比那裡的真實視差(約 9.3 px)還小,所以相差一個週期的位移同樣吻合。擴大搜尋範圍沒有幫助。非週期性的紋理有用;偏好周圍牆面視差的平滑項能減少錯誤(在我們的執行中,SGBM 在條紋上的 bad-1 是 53.3%,區塊匹配是 89.6%),但無法消除。
- 手算尺度不變損失。 證明當 乘上常數 時,Eigen 的誤差 不變。接著證明 MiDaS 的最小平方 使 在 (任何 與 )下維持不變。
提示
,而 吸收了 ,所以每個殘差都不變。對 MiDaS:如果 對 是最佳的,那麼 對 會給出同樣的對齊值。
- 金字塔與大運動。 在光流的程式碼中,把區塊移動 (24, 10) 而不是 (14, 6),分別用 1、4 與 6 層金字塔執行;然後只移動 (2, 1)。第 1 張影格中貼上的位置與遮擋遮罩也要一併更新。金字塔何時有幫助?
提示
在我們的執行中,(24, 10) 時,每種設定都弄丟了區塊(EPE 約 26 px),而 6 層的結果和 4 層完全相同,所以多出來的層在這裡沒有任何貢獻。(2, 1) 時,三種設定的區塊 EPE 都是 0.27 px。金字塔只有在運動能被它的粗層級帶到局部模型能處理的範圍內時才有幫助;超出這個範圍,就需要不同的搜尋方式,例如 RAFT 的全對相關。
參考文獻
- R. Hartley and A. Zisserman, Multiple View Geometry in Computer Vision, 2nd ed., Cambridge University Press, 2004. doi
- D. Scharstein and R. Szeliski, “A taxonomy and evaluation of dense two-frame stereo correspondence algorithms,” International Journal of Computer Vision, vol. 47, no. 1–3, pp. 7–42, 2002. doi
- D. Scharstein, R. Szeliski and H. Hirschmüller, “Middlebury Stereo Evaluation — Version 3,” official benchmark page (bad 2.0 metric, non-occluded and all masks). link · stereo home page
- R. Zabih and J. Woodfill, “Non-parametric local transforms for computing visual correspondence,” in Computer Vision — ECCV ‘94 (Lecture Notes in Computer Science), pp. 151–158, Springer, 1994. doi
- H. Hirschmüller, “Stereo processing by semiglobal matching and mutual information,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 30, no. 2, pp. 328–341, 2008. doi
- J. Žbontar and Y. LeCun, “Stereo matching by training a convolutional neural network to compare image patches,” Journal of Machine Learning Research, vol. 17, no. 65, pp. 1–32, 2016. JMLR · arXiv
- OpenCV contributors, “cv::StereoSGBM class documentation,” OpenCV source,
modules/calib3d/include/opencv2/calib3d.hpp(4.x branch). source - H. Laga, L. V. Jospin, F. Boussaid and M. Bennamoun, “A survey on deep learning techniques for stereo-based depth estimation,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 4, pp. 1738–1764, 2022. doi · arXiv
- F. Tosi, L. Bartolomei and M. Poggi, “A survey on deep stereo matching in the twenties,” International Journal of Computer Vision, vol. 133, no. 7, pp. 4245–4276, 2025. doi · arXiv
- N. Mayer, E. Ilg, P. Häusser, P. Fischer, D. Cremers, A. Dosovitskiy and T. Brox, “A large dataset to train convolutional networks for disparity, optical flow, and scene flow estimation,” in Proc. IEEE CVPR, pp. 4040–4048, 2016. CVF · doi
- A. Kendall, H. Martirosyan, S. Dasgupta, P. Henry, R. Kennedy, A. Bachrach and A. Bry, “End-to-end learning of geometry and context for deep stereo regression,” in Proc. IEEE ICCV, 2017. CVF
- J.-R. Chang and Y.-S. Chen, “Pyramid stereo matching network,” in Proc. IEEE/CVF CVPR, 2018. CVF
- L. Lipson, Z. Teed and J. Deng, “RAFT-Stereo: Multilevel recurrent field transforms for stereo matching,” in Proc. International Conference on 3D Vision (3DV), pp. 218–227, 2021. doi · arXiv
- G. Xu, X. Wang, X. Ding and X. Yang, “Iterative geometry encoding volume for stereo matching,” in Proc. IEEE/CVF CVPR, 2023. CVF
- M. Poggi, F. Tosi, K. Batsos, P. Mordohai and S. Mattoccia, “On the synergies between machine learning and binocular stereo for depth estimation from images: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2021. doi · arXiv
- B. Wen, M. Trepte, J. Aribido, J. Kautz, O. Gallo and S. Birchfield, “FoundationStereo: Zero-shot stereo matching,” in Proc. IEEE/CVF CVPR, 2025. CVF · arXiv
- D. Eigen, C. Puhrsch and R. Fergus, “Depth map prediction from a single image using a multi-scale deep network,” in Proc. NeurIPS, 2014. proceedings · arXiv
- R. Ranftl, K. Lasinger, D. Hafner, K. Schindler and V. Koltun, “Towards robust monocular depth estimation: Mixing datasets for zero-shot cross-dataset transfer,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 3, pp. 1623–1637, 2022. doi · arXiv
- L. Yang, B. Kang, Z. Huang, X. Xu, J. Feng and H. Zhao, “Depth Anything: Unleashing the power of large-scale unlabeled data,” in Proc. IEEE/CVF CVPR, 2024. CVF · arXiv
- R. Ranftl, A. Bochkovskiy and V. Koltun, “Vision transformers for dense prediction,” in Proc. IEEE/CVF ICCV, 2021. CVF
- L. Yang, B. Kang, Z. Huang, Z. Zhao, X. Xu, J. Feng and H. Zhao, “Depth Anything V2,” in Proc. NeurIPS, 2024. proceedings · arXiv
- B. Ke, A. Obukhov, S. Huang, N. Metzger, R. C. Daudt and K. Schindler, “Repurposing diffusion-based image generators for monocular depth estimation,” in Proc. IEEE/CVF CVPR, 2024. CVF · arXiv
- S. F. Bhat, R. Birkl, D. Wofk, P. Wonka and M. Müller, “ZoeDepth: Zero-shot transfer by combining relative and metric depth,” arXiv:2302.12288, 2023. arXiv
- W. Yin, C. Zhang, H. Chen, Z. Cai, G. Yu, K. Wang, X. Chen and C. Shen, “Metric3D: Towards zero-shot metric 3D prediction from a single image,” in Proc. IEEE/CVF ICCV, 2023. CVF · arXiv
- M. Hu, W. Yin, C. Zhang, Z. Cai, X. Long, K. Wang, H. Chen, G. Yu, C. Shen and S. Shen, “Metric3D v2: A versatile monocular geometric foundation model for zero-shot metric depth and surface normal estimation,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 46, no. 12, pp. 10579–10596, 2024. doi · arXiv
- L. Piccinelli, Y.-H. Yang, C. Sakaridis, M. Segu, S. Li, L. Van Gool and F. Yu, “UniDepth: Universal monocular metric depth estimation,” in Proc. IEEE/CVF CVPR, 2024. CVF · arXiv
- A. Bochkovskii, A. Delaunoy, H. Germain, M. Santos, Y. Zhou, S. R. Richter and V. Koltun, “Depth Pro: Sharp monocular metric depth in less than a second,” in Proc. ICLR, 2025. OpenReview · arXiv
- R. Garg, V. Kumar B.G., G. Carneiro and I. Reid, “Unsupervised CNN for single view depth estimation: Geometry to the rescue,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 740–756, 2016. doi · arXiv
- C. Godard, O. Mac Aodha and G. J. Brostow, “Unsupervised monocular depth estimation with left-right consistency,” in Proc. IEEE CVPR, 2017. CVF
- T. Zhou, M. Brown, N. Snavely and D. G. Lowe, “Unsupervised learning of depth and ego-motion from video,” in Proc. IEEE CVPR, 2017. CVF
- C. Godard, O. Mac Aodha, M. Firman and G. J. Brostow, “Digging into self-supervised monocular depth estimation,” in Proc. IEEE/CVF ICCV, 2019. CVF · arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image quality assessment: From error visibility to structural similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- B. K. P. Horn and B. G. Schunck, “Determining optical flow,” Artificial Intelligence, vol. 17, no. 1–3, pp. 185–203, 1981. doi
- B. D. Lucas and T. Kanade, “An iterative image registration technique with an application to stereo vision,” in Proc. International Joint Conference on Artificial Intelligence (IJCAI), 1981. pdf
- G. Farnebäck, “Two-frame motion estimation based on polynomial expansion,” in Image Analysis (Lecture Notes in Computer Science), pp. 363–370, Springer, 2003. doi
- J. Hur and S. Roth, “Optical flow estimation in the deep learning age,” in Modelling Human Motion, N. Noceti, A. Sciutti and F. Rea, Eds., pp. 119–140, Springer, 2020. doi · arXiv
- A. Dosovitskiy, P. Fischer, E. Ilg, P. Häusser, C. Hazırbaş, V. Golkov, P. van der Smagt, D. Cremers and T. Brox, “FlowNet: Learning optical flow with convolutional networks,” in Proc. IEEE ICCV, 2015. CVF · arXiv
- E. Ilg, N. Mayer, T. Saikia, M. Keuper, A. Dosovitskiy and T. Brox, “FlowNet 2.0: Evolution of optical flow estimation with deep networks,” in Proc. IEEE CVPR, 2017. CVF
- A. Ranjan and M. J. Black, “Optical flow estimation using a spatial pyramid network,” in Proc. IEEE CVPR, 2017. CVF
- D. Sun, X. Yang, M.-Y. Liu and J. Kautz, “PWC-Net: CNNs for optical flow using pyramid, warping, and cost volume,” in Proc. IEEE/CVF CVPR, 2018. CVF
- Z. Teed and J. Deng, “RAFT: Recurrent all-pairs field transforms for optical flow,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 402–419, 2020. doi · arXiv
- Z. Teed and J. Deng, “RAFT-3D: Scene flow using rigid-motion embeddings,” in Proc. IEEE/CVF CVPR, 2021. CVF · arXiv
- H. Xu, J. Zhang, J. Cai, H. Rezatofighi and D. Tao, “GMFlow: Learning optical flow via global matching,” in Proc. IEEE/CVF CVPR, 2022. CVF
- H. Xu, J. Zhang, J. Cai, H. Rezatofighi, F. Yu, D. Tao and A. Geiger, “Unifying flow, stereo and depth estimation,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, no. 11, pp. 13941–13958, 2023. doi · arXiv
- Z. Huang, X. Shi, C. Zhang, Q. Wang, K. C. Cheung, H. Qin, J. Dai and H. Li, “FlowFormer: A transformer architecture for optical flow,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 668–685, 2022. doi · arXiv
- Y. Wang, L. Lipson and J. Deng, “SEA-RAFT: Simple, efficient, accurate RAFT for optical flow,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 36–54, 2024. doi · arXiv
- S. Vedula, S. Baker, P. Rander, R. Collins and T. Kanade, “Three-dimensional scene flow,” in Proc. IEEE ICCV, vol. 2, pp. 722–729, 1999. doi
- M. Menze and A. Geiger, “Object scene flow for autonomous vehicles,” in Proc. IEEE CVPR, pp. 3061–3070, 2015. CVF · doi
- A. Geiger, P. Lenz, C. Stiller and R. Urtasun, “Scene flow evaluation 2015 (stereo 2015, flow 2015, scene flow 2015),” The KITTI Vision Benchmark Suite, official benchmark page (dataset size, D1, D2, Fl and SF outlier definitions). link
- A. Geiger, P. Lenz, C. Stiller and R. Urtasun, “Stereo evaluation 2012,” The KITTI Vision Benchmark Suite, official benchmark page (dataset size, Out-Noc and Out-All at 2–5 px). link
- A. Geiger, P. Lenz and R. Urtasun, “Are we ready for autonomous driving? The KITTI vision benchmark suite,” in Proc. IEEE CVPR, pp. 3354–3361, 2012. doi
- D. Scharstein, H. Hirschmüller, Y. Kitajima, G. Krathwohl, N. Nešić, X. Wang and P. Westling, “High-resolution stereo datasets with subpixel-accurate ground truth,” in Pattern Recognition (Proc. GCPR) (Lecture Notes in Computer Science), pp. 31–42, Springer, 2014. doi · datasets
- T. Schöps, J. L. Schönberger, S. Galliani, T. Sattler, K. Schindler, M. Pollefeys and A. Geiger, “A multi-view stereo benchmark with high-resolution images and multi-camera videos,” in Proc. IEEE CVPR, pp. 2538–2547, 2017. CVF · datasets
- D. J. Butler, J. Wulff, G. B. Stanley and M. J. Black, “A naturalistic open source movie for optical flow evaluation,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 611–625, 2012. doi · project page
- N. Silberman, D. Hoiem, P. Kohli and R. Fergus, “Indoor segmentation and support inference from RGBD images,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 746–760, 2012. doi · dataset page
- U. Rajapaksha, F. Sohel, H. Laga, D. Diepeveen and M. Bennamoun, “Deep learning-based depth estimation methods from monocular image and videos: A comprehensive survey,” ACM Computing Surveys, vol. 56, no. 12, 2024. doi · arXiv
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 12・影像生成:從 GAN 到文字生成影像系統 · 33 分鐘