影像就是陣列
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 2 個互動實驗
對一張真實照片的每個像素加上同一個數,並比較 8 位元回繞、飽和運算與浮點運算。
你將學到
- 灰階與彩色影像如何變成 NumPy 陣列,以及
shape、dtype與strides告訴你什麼。 - 為什麼影像是連續場景經過取樣與量化後的結果,以及保留較少像素或較少灰階時會失去什麼。
- 座標慣例(先列、後行),以及切片、翻轉、遮罩與攤平如何運作,包括視圖(view)與複本(copy)的差別。
- 每個人都會踩到的三個坑:BGR 與 RGB 的通道順序、
uint8回繞(wraparound),以及不小心透過視圖改寫原始資料。 - 同樣的陣列觀點如何延伸到深度學習的張量、影像區塊(patch)與神經網路影像表示。
先看全貌
本站所有方法,從 3×3 模糊到視覺 Transformer,起點都是同一個東西:一張數字網格。只要你能有把握地讀取、切片與轉換這張網格,其餘課程就只是選擇要組合哪些數字、如何組合。
為什麼重要:初學者的影像程式錯誤,幾乎都是陣列的問題,而不是演算法的問題。顏色偏藍,是因為通道被對調了;明亮區域變黑,是因為 8 位元數值回繞了;修改裁切區域卻改到原圖,是因為裁切得到的是視圖而不是複本。本頁用可執行的程式把這些陷阱一次講清楚,讓你之後一眼就能認出來。
影像是取樣並量化後的訊號
白話版。 真實世界沒有像素。相機測量每個感測器小區域收到多少光,再把測量結果寫成一個整數。兩個決定把連續場景變成數位影像:在哪裡測量(有幾個點),以及每個測量值寫得多細(有幾種可能的值)。
精確版。 令單色場景是一個連續的亮度函數。取樣(sampling)在 列、 行的規則網格上對它求值;量化(quantization)則把每個樣本四捨五入到 個整數階層之一,其中 是每個像素的位元數。結果是定義在有限網格上的函數:
其中 是列(row)索引(從上往下數), 是行(column)索引(從左往右數), 是像素值,常見的 8 位元情況下 ,數值從 0(黑)到 255(白)。彩色影像多一個通道索引 ,寫成 ,三個色彩通道的 。Gonzalez 與 Woods [1, 第 2 章] 以及 Torralba、Isola 與 Freeman [2] 等教科書都以這種方式處理影像形成與數位化。
寫成陣列時,網格的形狀(shape)在灰階時是 (H, W),彩色時是 (H, W, 3)。儲存的數值個數是 ( 個通道),所需記憶體則是這個數量乘以每個數值的位元組數。
形狀、dtype 與記憶體
白話版。 陣列知道自己的三件事:每個軸上有多少個數字(shape)、每個數字是哪一種(dtype),以及這些數字在記憶體中如何排列(strides)。
scikit-image 附帶幾張小型測試照片 [6]、[7],因此本頁所有例子都不必下載任何東西就能執行。下面的程式載入一張灰階與一張彩色影像,並印出它們的基本性質。
程式碼 · Python · 10 行
import numpy as np
from skimage import data

gray = data.camera()          # grayscale test photo bundled with scikit-image
rgb = data.astronaut()        # color test photo, also bundled

for name, a in [("gray", gray), ("rgb", rgb)]:
    print(name, a.shape, a.dtype, a.ndim, a.size, a.nbytes)
print(gray.min(), gray.max())
print(gray.strides, rgb.strides)
輸出:
程式碼 · 4 行
gray (512, 512) uint8 2 262144 262144
rgb (512, 512, 3) uint8 3 786432 786432
0 255
(512, 1) (1536, 3, 1)
解讀輸出:灰階影像有 512 列、512 行,所以 size 是 512 × 512 = 262,144 個數值;每個 uint8 佔一個位元組,所以 nbytes 是同一個數字。彩色影像的數值是它的三倍。像素範圍是完整的 0 到 255。
strides 是沿各軸前進一步時要跳過的位元組數。對 gray 而言,往右移一行花 1 個位元組,往下移一列花 512 個位元組,表示 NumPy 是一列接著一列儲存影像(C 順序)。在 rgb 中,同一個像素的三個通道值在記憶體中相鄰。這解釋了為什麼沿著列掃描很快,也解釋了為什麼把影像重塑成長向量時各列會維持在一起,下一節會看到。NumPy 論文 [3] 與文件 [4] 完整描述了陣列模型。
索引、切片與視圖
白話版。 因為影像就是陣列,你可以用與任何 NumPy 陣列相同的中括號語法取出單一像素、矩形區域或整列。令人意外的是,這樣取出的矩形是同一塊記憶體上的一扇窗,而不是獨立的複本。
精確版。 對陣列 a,a[r, c] 回傳單一像素,a[r0:r1, c0:c1] 回傳第 列與第 行組成的子區塊(結尾索引不含),而 a[::2, ::2] 這類寫法則每隔一列、一行取一個。基本切片是視圖:與原陣列共用記憶體的陣列物件。若整數索引已選定每個軸,例如 gray[r, c],回傳的是純量值;rgb[r, c] 則保留通道軸,因此回傳視圖。布林或整數陣列索引在讀取時回傳複本,但 a[mask] = 0 這種直接索引賦值仍會寫入 a。呼叫 .copy() 可以明確讓切片與來源分離 [13]。
程式碼 · Python · 16 行
r, c = 100, 200
print(gray[r, c])             # row first, then column
print(rgb[r, c])              # three numbers: R, G, B
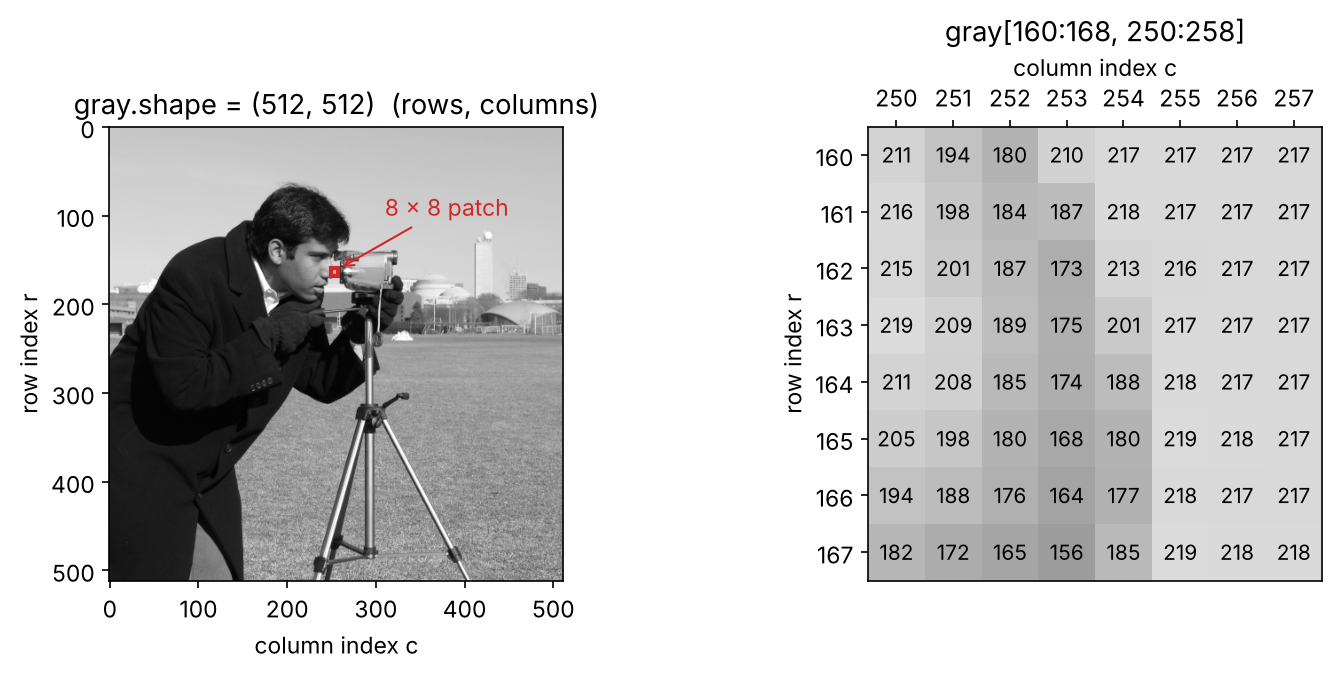
patch = gray[100:108, 200:208]            # rows 100..107, columns 200..207
print(patch.shape, np.shares_memory(patch, gray))

work = gray.copy()
work[100:108, 200:208] = 0                # writing through a slice edits `work`
print(work[100:108, 200:208].max(), gray[100:108, 200:208].max())

H, W = gray.shape
vec = gray.reshape(-1)                    # flatten: row-major order
print(vec.shape, vec[r * W + c] == gray[r, c], np.shares_memory(vec, gray))
print(np.array_equal(gray[::-1], np.flipud(gray)), gray[:, ::-1].shape)
mask = gray > 200
print(mask.dtype, mask.sum())
輸出:
程式碼 · 7 行
54
[81 57 17]
(8, 8) True
0 109
(262144,) True True
True (512, 512)
bool 55112
每一行告訴我們什麼:
gray[100, 200]是 54,rgb[100, 200]是[81 57 17]:彩色像素是一個短向量,每個通道一個數字。- 8 × 8 區塊與
gray共用記憶體,所以它是視圖。因為work是gray的複本,把work的區塊歸零不會動到gray(它的區塊最大值仍是 109)。如果當初是對gray本身的視圖寫入,原始照片就會被改掉。 - 攤平後得到 個數字的向量,像素 位於位置 。這種攤平形式就是傳統分類器與全連接網路第一層看到的輸入向量(見 ML 01A 與 ML 01)。
- 把影像上下翻轉是
gray[::-1],這是列步長為負的視圖,不需要迴圈。與np.flipud的比較結果是True。 - 像
gray > 200這樣的比較會得到同形狀的布林陣列,此處有 55,112 個True。布林遮罩是你選取、計數或編輯符合條件像素的方式。
彩色影像與通道順序
白話版。 彩色影像每個像素存三個數字,分別代表紅的程度、綠的程度與藍的程度。麻煩在於,兩種常見慣例對這三個數字的排列順序不同,而陣列本身不會告訴你它是哪一種。
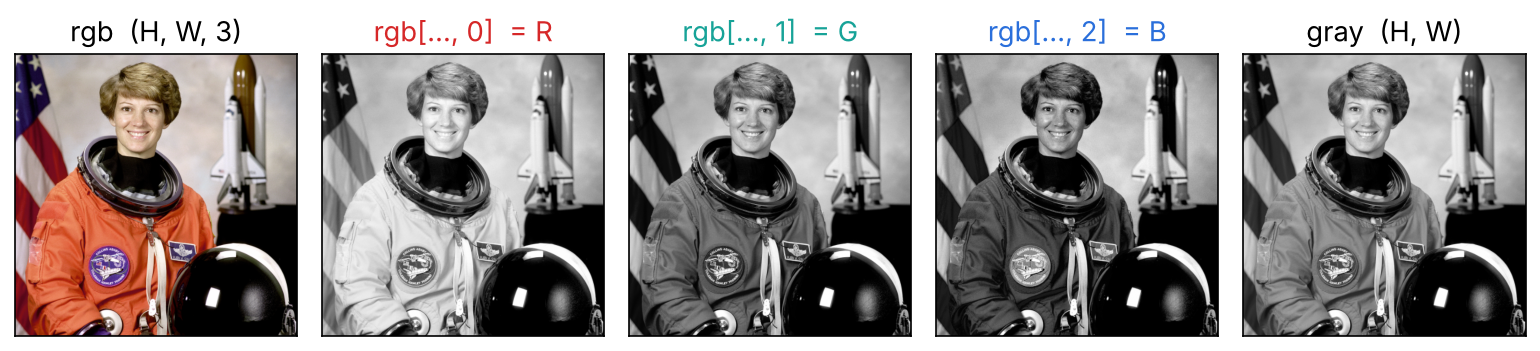
精確版。 多數 Python 影像程式碼(scikit-image [6] 的 NumPy 陣列、Matplotlib、Pillow)使用紅、綠、藍(RGB)順序。OpenCV 的 imread 回傳 BGR:藍色是通道 0,紅色是通道 2。混用兩者不會報錯,只會悄悄把紅與藍對調,於是膚色變藍、天空變橘。為了不依賴磁碟上的檔案就能看見這個效果,下面的程式把彩色測試影像寫成暫存 PNG,再用 OpenCV 讀回來比較。
程式碼 · Python · 18 行
import pathlib, tempfile
import cv2
from skimage import io

with tempfile.TemporaryDirectory() as d:
    path = pathlib.Path(d) / "astronaut.png"
    io.imsave(path, rgb)                   # a PNG written in R, G, B order
    bgr = cv2.imread(str(path))            # OpenCV hands the channels back as B, G, R
print(rgb[100, 200], bgr[100, 200])
print(np.array_equal(bgr[..., ::-1], rgb))
print(np.array_equal(cv2.cvtColor(bgr, cv2.COLOR_BGR2RGB), rgb))

weights = np.array([0.299, 0.587, 0.114])
manual = rgb @ weights                     # weighted sum of R, G, B -> float64 (H, W)
cv_gray = cv2.cvtColor(rgb, cv2.COLOR_RGB2GRAY)
print(cv_gray.dtype, np.abs(manual - cv_gray).max())
from skimage.color import rgb2gray
print(np.abs(rgb2gray(rgb) * 255 - cv_gray).max())
輸出:
程式碼 · 5 行
[81 57 17] [17 57 81]
True
True
uint8 0.5010000000000332
15.529299999999992
同一個像素以 RGB 讀是 [81 57 17],以 BGR 讀是 [17 57 81]。反轉最後一個軸 bgr[..., ::-1] 是不花成本的順序翻轉方式,而 cv2.cvtColor 搭配 COLOR_BGR2RGB 則是明確做同一件事。兩者都能完全還原原圖。
要把彩色轉成灰階,標準做法是對通道做加權和,因為人眼對綠色比對藍色敏感。權重 來自 ITU-R BT.601 電視標準的亮度(luma)定義 [8, 第 2.5.1 節],而上面的檢查顯示,OpenCV 的灰階轉換與這個加權和的差距在 0.501 個灰階以內,那只是四捨五入成整數造成的。不同函式庫使用不同的權重:在這張影像上,scikit-image 的 rgb2gray 與 OpenCV 的結果最多相差約 15.5 個灰階。所以不要假設「灰階」在不同函式庫中是同一組數字,請對照你所呼叫函式的文件。
資料型別與回繞陷阱
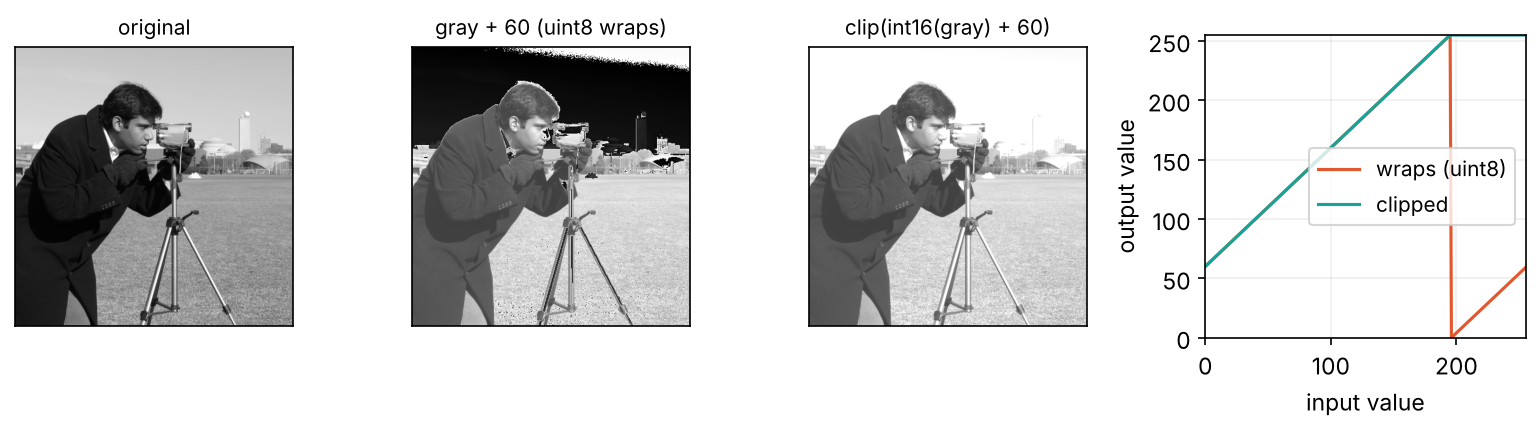
白話版。 影像最常見的儲存型別是 8 位元無號整數,只能存 0 到 255。如果計算超過 255,它不會停在 255,而是悄悄從 0 重新開始。一個幾乎全白的像素可能變成幾乎全黑。
精確版。 對無號整數型別 uint8,運算是以 為模進行的。所以 ,而 。由於數值不會飽和,在 uint8 中對影像做調亮或相減並不安全。NumPy 2 也不再允許陣列與放不進該陣列型別的 Python 整數混合運算:它會丟出錯誤,而不是悄悄擴大型別,這是依照 NEP 50 [5]。安全的做法有三個步驟:先轉成較寬的型別(int16、float32),再計算,最後裁切回有效範圍並轉回 uint8。
程式碼 · Python · 18 行
from skimage.util import img_as_float

a = np.array([250], dtype=np.uint8)
print(a + 10, a - 251, a.astype(np.int16) + 10)
try:
    a + 300
except OverflowError as e:
    print("OverflowError:", e)

wrapped = gray + np.uint8(60)
clipped = np.clip(gray.astype(np.int16) + 60, 0, 255).astype(np.uint8)
print((gray >= 196).sum(), (wrapped < gray).sum(), clipped.max())

x = gray.astype(np.float32) / 255.0
print(x.dtype, x.min(), x.max(), np.allclose(x, img_as_float(gray)))
y = np.clip(1.2 * x, 0, 1)
out = np.round(y * 255).astype(np.uint8)
print(out.dtype, out.max())
輸出:
程式碼 · 5 行
[4] [255] [260]
OverflowError: Python integer 300 out of bounds for uint8
72087 72087 255
float32 0.0 1.0 True
uint8 255
解讀:在 uint8 中,250 + 10 得到 4,250 - 251 得到 255;在 int16 中,和則正確地是 260。對每個像素加 60,回繞的恰好是數值至少為 的像素(因為 ):共有 72,087 個,而這同樣 72,087 個像素算完後反而比原來更暗。裁切版本則讓它們全部停在最大值 255。最後一段是常用的浮點流程:除以 255 以便在 中運算、計算、裁切、乘回去並四捨五入。skimage.util.img_as_float 對 uint8 影像做的是同樣的重新縮放。
在真實影像上做取樣與量化
白話版。 兩個獨立的旋鈕控制場景能保留多少:像素的數量(空間解析度)與灰階的階數(亮度解析度)。降低前者,畫面變成方塊狀;降低後者,平滑的明暗過渡會裂成一塊塊平坦的色帶。
精確版。 每隔 列、 行取一個,也就是 gray[::s, ::s],會把 的影像縮成約 個樣本。若事先沒有平滑,可能會產生混疊(aliasing):較粗的網格無法表示的細節,不會消失,而是變成假的圖樣(正式處理見 IP 02 與頻率域各章)。把位元深度從 8 降到 ,就只剩 個相異數值。下面的輔助函式把每個像素四捨五入到所屬區間的中心,所以 4 位元時有 16 個允許的灰階。
程式碼 · Python · 21 行
def quantize(img, bits):
    step = 256 // 2 ** bits
    return (img // step) * step + step // 2    # replace each bin by its center

for bits in (8, 4, 2, 1):
    print(bits, len(np.unique(quantize(gray, bits))))

small = gray[::4, ::4]                          # keep every 4th row and column
print(gray.shape, "->", small.shape, small.nbytes, gray.nbytes)

def invert_loop(img):
    out = np.empty_like(img)
    for r in range(img.shape[0]):
        for c in range(img.shape[1]):
            out[r, c] = 255 - img[r, c]
    return out

print(np.array_equal(invert_loop(gray), 255 - gray))
chw = np.transpose(rgb, (2, 0, 1))
print(rgb.shape, "->", chw.shape, np.shares_memory(chw, rgb))
print(np.mean(rgb, axis=(0, 1)))
輸出:
程式碼 · 8 行
8 256
4 16
2 4
1 2
(512, 512) -> (128, 128) 16384 262144
True
(512, 512, 3) -> (3, 512, 512) True
[141.56249237 105.75944519  96.47507477]
相異數值的個數以 下降。每隔 4 列、4 行取一個,會把影像從 262,144 位元組縮到 16,384 位元組,也就是記憶體的十六分之一。巢狀迴圈與單一運算式 255 - gray 的結果完全相同(True),但陣列運算式是以一次編譯過的運算執行,而不是二十六萬多次 Python 步驟:能寫成陣列運算式的影像程式就盡量這樣寫,把明確的迴圈留給檢查驗證用。轉置成通道優先 (3, 512, 512) 也是一個視圖,這是多數深度學習函式庫期望的排列。最後一行對兩個空間軸取平均,得到每個色彩通道一個平均值。
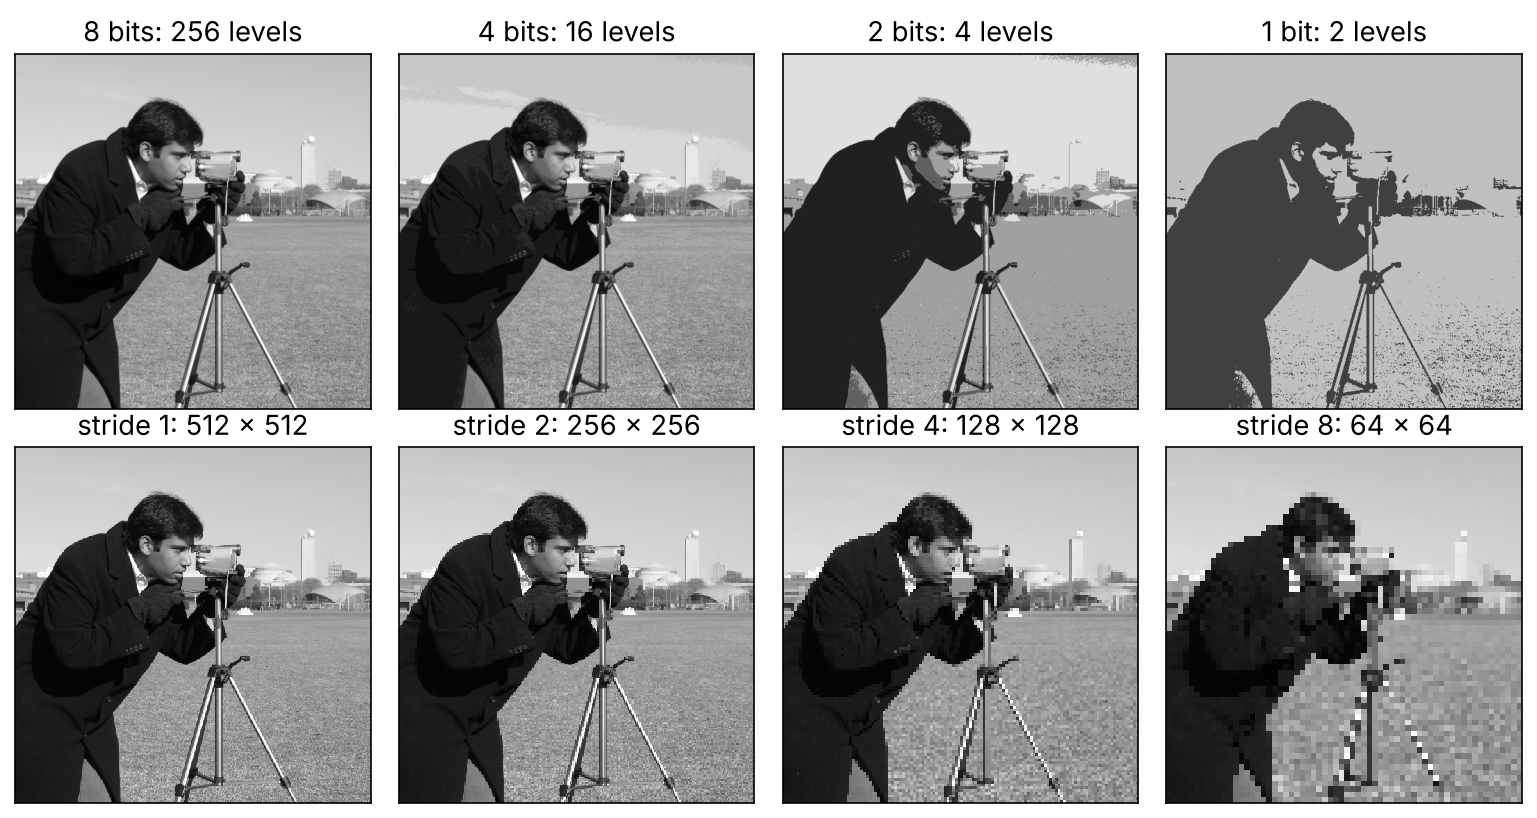
反過來想也很有用。8 位元每通道通常足以顯示影像,但不一定足以處理影像:把一張偏暗又有色帶的影像拉伸對比,只會放大色帶。這就是為什麼存在每通道位元數更多的影像格式與感測器,也是為什麼處理流程會先轉成浮點數再做運算。上方的實驗讓你在照片與一張會暴露混疊的測試圖樣上同時調整這兩個旋鈕。
處理影像前的簡短檢查表
| 檢查 | 原因 | 一行程式 |
|---|---|---|
印出 shape 與 dtype | 確認是灰階或彩色,以及數值範圍 | print(a.shape, a.dtype, a.min(), a.max()) |
| 確認通道順序 | RGB 與 BGR 看起來很像,直到顏色錯了 | rgb = bgr[..., ::-1] |
| 選擇運算用的 dtype | uint8 會回繞; 的 float32 對濾波安全 | x = a.astype(np.float32) / 255 |
| 編輯前先複製 | 切片是視圖,編輯會寫回原陣列 | b = a.copy() |
| 轉回前先裁切 | 超出範圍的浮點數轉成 uint8 會變成亂碼 | np.clip(y, 0, 1) |
記得 [列, 行] | 繪圖 API 的座標對是 (x, y) | a[y, x] |
現代觀點
本章沒有任何內容過時,因為深度學習框架把影像視為張量(tensor),而張量的行為就像 NumPy 陣列。改變的是排列方式、正規化,以及近年研究中對「影像是什麼」的想法。
張量與排列方式。 訓練批次會多一個前導軸,成為 (N, H, W, C),或許多函式庫期望的通道優先 (N, C, H, W),就像上面用 np.transpose 得到的視圖。像素值通常轉成 float32 並正規化,例如除以 255 再對每個通道標準化。上面所有陷阱都原封不動地延續:以 RGB 輸入訓練的模型若被餵入 BGR,會悄悄變差;在 uint8 中回繞的前處理步驟,可能不報任何錯誤就毒化整個資料集。卷積與 Transformer 各章直接建立在這個觀點上:ML 03 與 ML 05。
影像視為區塊序列。 Dosovitskiy 等人的 Vision Transformer [10](ICLR 2021)把影像切成固定大小區塊的網格,用本章的重塑方式把每個區塊攤平成向量,再把這個序列送進標準 Transformer。該論文報告,這類模型在大規模預訓練後,於影像分類基準上可以追平或超越卷積網路,同時需要較少的訓練運算量。對本章而言,重點在於陣列運算(切成區塊、重塑、轉置)就是模型的前端。
影像視為函式。 第二個現代想法,是用學習得到的函式取代網格。Sitzmann 等人 [11](NeurIPS 2020)提出正弦表示網路(sinusoidal representation networks),這是使用週期性活化函數的小型網路,輸入座標 、輸出像素值,並展示它們能細緻地表示影像、音訊、影片及其導數。Essakine 等人 [12](TMLR 2025)對這個隱式神經表示(implicit neural representation)領域做了綜述:他們針對四類方法(活化函數、位置編碼、組合策略與網路結構最佳化)提出分類架構、做實驗比較,並以開放問題作結,例如更具表現力的活化函數、更好的位置編碼,以及對高維資料的可擴展性。陣列仍然是這類模型訓練與評估的方式,因為網路是擬合在取樣後的像素上;但解析度成為查詢函式時的屬性,而不是儲存表格的屬性。
哪些仍未解決、哪些已經確定。 仍未定論的問題包括:如何在不同工具之間一致地儲存高動態範圍與廣色域色彩,以及在相同儲存成本下,學習得到的表示應如何與一般陣列比較。已經確定、值得練到自動反應的,就是本章這些:shape、dtype、通道順序、視圖與複本,以及先選運算型別再計算的習慣。
重點整理
- 數位影像是取樣並量化後的訊號,儲存成形狀
(H, W)或(H, W, C)的陣列; 表示第 列、第 行。 shape、dtype與strides描述陣列。一張 的 8 位元灰階影像有 262,144 個位元組;彩色版本是它的三倍。- 切片回傳與原陣列共用記憶體的視圖。編輯前先用
.copy(),並且用陣列運算式取代逐像素迴圈。 - 各函式庫對通道順序(OpenCV 用 BGR,多數其他用 RGB)以及灰階轉換權重的看法不同;要檢查,不要假設。
uint8運算以 256 為模回繞。先轉成int16或float32,計算、裁切,最後才轉回去。- 空間解析度與灰階解析度是兩個獨立的選擇,降低任一個都會以不同方式失去資訊:方塊化與混疊,對上色帶。
- 深度學習張量、影像區塊與隱式神經表示,都建立在同一個影像陣列觀點上。
練習
- 通道平均。 載入
data.astronaut(),用rgb.mean(axis=(0, 1))計算每個色彩通道的平均值。哪個通道最大?接著寫出同一張影像的 BGR 版本結果,並說明最大值現在位於哪個索引。
提示
這張影像的 R、G、B 平均值約為 141.6、105.8 與 96.5,所以紅色最大。在 BGR 陣列中,同樣的數字以相反順序出現,因此最大值在索引 2,而不是索引 0。
- 用切片翻轉。 只用切片(不用
np.flip、不用迴圈),產生gray的上下翻轉、左右鏡像與旋轉 180° 的版本。分別與np.flipud、np.fliplr和np.rot90(gray, 2)比對。
提示
在你想反轉的軸上使用步長 :gray[::-1]、gray[:, ::-1] 與 gray[::-1, ::-1]。這三個都是視圖,所以如果要編輯,請先複製。
- 找出回繞。 對本頁調亮 60 的例子,哪些輸入灰階值會回繞?輸入 200 會得到什麼輸出值?寫一行檢查程式,在不計算回繞後影像的情況下,計算被回繞的像素數。
提示
輸入為 以上的會回繞,因為 。輸入 200 得到 。計數是 (gray >= 196).sum()。
- 安全的差值。 兩個
uint8畫面 與 應以絕對差值 比較。用一對像素值說明A - B會出錯,並寫出 NumPy 的安全版本。
提示
在 uint8 中,若 、,A - B 等於 ,而不是 。安全版本是 np.abs(A.astype(np.int16) - B.astype(np.int16)).astype(np.uint8)。
- 設計位元深度預算。 一張灰階影像以 8 位元儲存,再量化到 位元。若每個像素剛好壓縮成 位元,請預測 與 、 時的相異數值個數與所需記憶體。為什麼圖 4 的 4 位元影像看得到色帶,而 8 位元看不到?
提示
有 個數值:16 與 4。壓縮儲存為 位元組,4 位元時是 131,072 位元組,2 位元時是 65,536 位元組。色帶出現在平滑漸層跨越兩個區間邊界的地方:8 位元時每一階只差 1 個灰階,在多數顯示器上低於人眼可分辨的程度,而 4 位元時每階相差 16 個灰階。
參考文獻
-
R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018 (Chapter 2, image sensing, sampling and quantization). publisher page
-
A. Torralba, P. Isola and W. T. Freeman, Foundations of Computer Vision, MIT Press, 2024 (open-access edition). book site
-
C. R. Harris et al., “Array programming with NumPy,” Nature, vol. 585, pp. 357–362, 2020. doi
-
NumPy developers, “Data types,” NumPy user guide, current documentation. docs
-
NumPy developers, “NEP 50: Promotion rules for Python scalars,” NumPy Enhancement Proposals. NEP 50
-
S. van der Walt et al., “scikit-image: image processing in Python,” PeerJ, vol. 2, e453, 2014. doi
-
scikit-image developers, “skimage.data: test images and example data,” scikit-image documentation. docs
-
ITU-R, “Recommendation BT.601-7: Studio encoding parameters of digital television for standard 4:3 and wide-screen 16:9 aspect ratios,” 2011. ITU page
-
Matplotlib developers, “matplotlib.pyplot.imshow,” Matplotlib documentation. docs
-
A. Dosovitskiy et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” International Conference on Learning Representations (ICLR), 2021. arXiv:2010.11929
-
V. Sitzmann, J. N. P. Martel, A. W. Bergman, D. B. Lindell and G. Wetzstein, “Implicit Neural Representations with Periodic Activation Functions,” Advances in Neural Information Processing Systems (NeurIPS), vol. 33, 2020. proceedings
-
A. Essakine et al., “Where Do We Stand with Implicit Neural Representations? A Technical and Performance Survey,” Transactions on Machine Learning Research (TMLR), 2025. arXiv:2411.03688
-
NumPy developers, “Indexing on ndarrays,” NumPy user guide, accessed 2026-11-05. documentation
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑這是「基礎」單元的最後一篇。 回到學習地圖 →