從這裡開始・學習路徑與推薦教科書
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 本站八個單元彼此的關係,以及各自的用途。
- 如何閱讀一篇教學頁面:難度、先備知識、單元側欄、筆記本與互動實驗。
- 依背景(剛學程式、數學生疏、已會訓練網路)與目標(視覺、理論、生成模型、語言、世界模型)選擇學習路徑。
- 如何建立一個小型 Python 環境,在 CPU 上執行程式碼區塊與筆記本。
- 每個單元適合搭配哪本主教材,以及教科書、綜述與論文各該怎麼讀。
- 如何把閱讀轉成可以檢驗的小里程碑。
先看全貌
你不必先學完所有數學才有資格碰影像,但你需要知道每個運算背後的假設。最快的學法,是從一個可以測試的問題開始:「為什麼模糊會削弱邊緣?」「分類器換到另一台相機的影像還有效嗎?」「模型改成預測下一個 token 而不是類別,會有什麼不同?」
本站分成八個單元。單元是一系列依序排列、圍繞同一主題的教學。編號說明的是各單元的角色,不代表一定要讀完一個才能進入下一個。
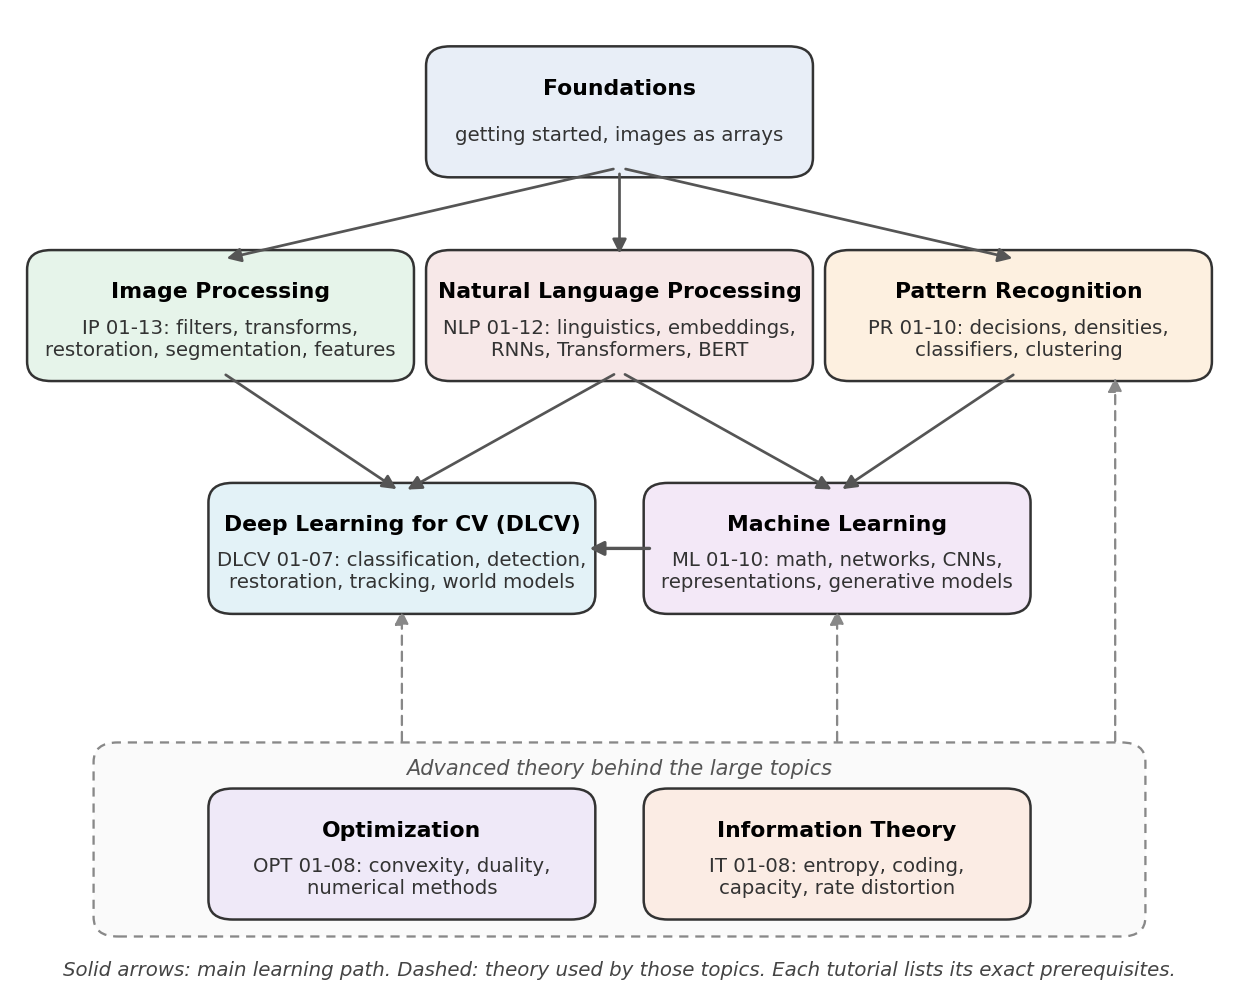
| 單元 | 核心問題 | 內容 | 適合的第一個成果 |
|---|---|---|---|
| 基礎・起點 | 資料是什麼? | 本頁與影像就是陣列 | 檢查影像的形狀、dtype 與座標慣例 |
| 影像處理(IP)・入門 | 如何變換或量測影像? | IP 01–13,從基礎到圖樣分類 | 解釋一個濾波器及其邊界行為 |
| 自然語言處理(NLP)・入門 | 文字與語言如何建模? | NLP 01–12,從導論與語言學基礎,經過詞嵌入、RNN、Transformer 與 BERT,到句法與語意任務 | 建立並評估一個小型語言應用 |
| 圖形識別(PR)・入門 | 如何用特徵在不確定性下做決策? | PR 01–10,從貝氏決策到辨識專題 | 用正確的訓練/測試切分比較分類器 |
| 機器學習(ML)・核心 | 表示、預測器與生成器如何被學出來? | ML 01–11、數學章節 ML 01A–01C,以及因子模型與自動編碼器的 ML 06A | 訓練並評估一個小模型 |
| 電腦視覺深度學習(DLCV)・核心 | 學習式模型如何解決視覺任務? | DLCV 01–14:辨識、幾何、復原、生成、世界模型與穩健性 | 從頭到尾理解一條分類或偵測流程 |
| 最佳化(OPT)・理論 | 如何建立並求解帶限制的決策問題? | OPT 01–08,從凸集合到求解器與應用 | 建立凸最佳化問題並檢查最適條件 |
| 資訊理論(IT)・理論 | 表示與傳遞不確定性的極限是什麼? | IT 01–08,從熵到編碼、通道、率失真與網路 | 計算熵,說明壓縮或通訊的極限 |
用一段話說明它們的關係:影像處理把影像當成訊號,以人工設計運算;圖形識別加入統計與決策理論:有了特徵之後該怎麼決定、又能有多確定?機器學習/深度學習用學出來的特徵取代人工特徵,並提供各處共用的機制(損失函數、最佳化、架構、生成模型);視覺深度學習把這套機制用在具體的視覺任務上,其中復原與增強章節大量借用影像處理的成像概念;自然語言處理則以文字為輸入,重複使用相同的機率、最佳化與 Transformer 概念。最佳化進一步發展估計與訓練背後的建模規則、限制、對偶性與數值方法。資訊理論解釋不確定性、編碼與通訊極限;熵與散度也串起分類、語言建模和壓縮。
教學頁面怎麼看
每篇教學都採用相同版面,看懂一頁就看懂全部。
- 難度標籤。分為入門、中階、進階。ML 數學章節與前幾篇 IP 屬入門;DLCV 各篇則假設你已懂 CNN 與反向傳播。
- 先備知識。標題下方的「先備知識」列出本頁預設你已讀過的教學。先備知識與語言無關,中英文頁面相同。遇到不熟的連結,先讀那一頁,至少讀它的「重點整理」。
- 單元側欄。左欄依序列出目前單元的所有教學;頁尾的「上一篇/下一篇」也照同樣順序。
- 段落結構。每篇以「你將學到」和「用最簡單的話說」開場,每個主題講兩遍:先用白話說,再給出含公式與程式碼的精確版本。結尾是「重點整理」、「練習」(提示預設收合,先自己試再打開)與編號的「參考文獻」,內文以 [1]、[2] 引用。
- 筆記本按鈕。有配套筆記本的教學,標題旁會出現「在 Colab 開啟」,頁尾則有「查看筆記本」連結。目前 ML 03 有一本(卷積與影像濾波)。
- 互動實驗。許多頁面內嵌即時實驗,在瀏覽器中對真實影像或資料集執行真正的演算法:濾波器、傅立葉轉換、門檻、最近鄰等等。每個實驗都先請你預測結果,再讓你親自驗證。所有實驗也都收錄在互動實驗頁面。
- 搜尋與語言。搜尋頁會在你目前閱讀的語言中尋找教學與部落格文章;頁首的語言切換可跳到另一種語言的同一頁。若某頁尚未翻譯,中文網站會顯示英文版並附上提示。
選擇你的入口
挑一個最符合你的描述。各路線刻意有所重疊。
如果程式設計也是新主題。先熟悉 Python 的函式、迴圈、串列與陣列索引,以及基本繪圖。接著讀影像就是陣列與 IP 01。建立一張合成影像,檢查它的列與欄,並說明兩張 uint8 影像相加為什麼會溢位。之後讀 IP 02 與 IP 03,這兩章的每條公式都有對應的 NumPy 程式。
如果會寫程式,但數學有點生疏。先讀 ML 01 熟悉機器學習的詞彙,再讀三篇數學章節:線性代數、機率與資訊理論與數值計算。它們依循 Goodfellow、Bengio、Courville [7] 的「應用數學」部分,並為每個概念搭配簡短的 NumPy 驗證。目標是能檢查矩陣形狀、解讀條件機率,並認出數值不穩定的計算。
如果已學過入門機率與線性代數。想學統計決策與傳統方法,從 PR 01 開始;想學習式表示,從 ML 02 開始。推導遇到明確缺口時,再回頭補數學章節。
如果已經會訓練神經網路。快速瀏覽 ML 03 與 ML 05,再從視覺深度學習選一篇應用章節,並搭配 ML 11 的評估與部署一起讀。
依目標建議的學習路徑
有了入口之後,再選一個目標。每條路徑是一個閱讀順序,通常八到十二篇。讀每頁時留意「先備知識」,有缺口就隨時補上。
| 目標 | 建議順序 |
|---|---|
| 傳統影像處理 | 影像就是陣列 → IP 01–05(基礎、濾波、頻率域、復原)→ IP 06–09(色彩、小波、壓縮、形態學)→ IP 10–13(分割、主動輪廓、特徵、分類) |
| 統計圖形識別 | ML 01A、ML 01B → PR 01 → PR 02(密度估計)→ PR 03(線性模型)→ PR 04(核方法)→ PR 05(特徵)→ PR 07(分群、EM)→ PR 08(近似推論)→ PR 09(集成、驗證)→ PR 10 |
| 視覺深度學習 | ML 01 → ML 01A–01C → ML 02 → ML 03 → ML 05 → DLCV 01 → DLCV 02 → DLCV 03 → 選讀 DLCV 09 復原或 DLCV 07 追蹤 → ML 11 |
| 生成模型 | ML 01B → ML 02 → ML 06 → ML 06A → ML 07 → ML 08 → ML 09 → ML 10 |
| 語言 | NLP 01 → NLP 02 → NLP 03–04(類神經網路、詞嵌入)→ NLP 05–06(RNN、序列標註)→ NLP 07–09(注意力與 Transformer、seq2seq、語言模型)→ NLP 10–11(BERT、分類)→ NLP 12;網路與序列模型基礎可搭配 ML 02 與 ML 04 |
| 凸建模與求解器 | ML 01A、ML 01C → OPT 01 → OPT 02–04(函數、問題、對偶性)→ OPT 05–07(估計、數值方法、限制式求解器)→ OPT 08 |
| 資訊、壓縮與通訊 | ML 01B → IT 01 → IT 02–03(典型性、來源編碼)→ IT 04–06(容量、高斯通道、率失真)→ IT 07–08(統計決策、網路) |
| 世界模型 | ML 04 → ML 05 → ML 07 → ML 08 → DLCV 13 |
若每週讀一篇、執行程式碼並做兩題練習,這是可以持續的步調;較長的教學可能需要兩週。速度不如能用自己的話說明每頁的重點整理重要。
執行程式碼
網站與 Python 範例使用不同的環境。只讀網站什麼都不用安裝;要執行程式碼需要 Python;要在本機預覽網站本身才需要 Node。
為教學建立 Python 環境
為所有教學建立一個專用的虛擬環境。Python 3.11 以上是實用的起點;若使用其他版本,請核對各套件的需求。
程式碼 · Bash · 4 行
python3 -m venv .venv-study
source .venv-study/bin/activate
python -m pip install --upgrade pip
python -m pip install numpy scipy matplotlib scikit-learn scikit-image opencv-python PyWavelets jupyterlab
Windows PowerShell 的啟用方式是 .venv-study\Scripts\Activate.ps1。這些套件涵蓋入門陣列與傳統學習範例;神經網路章節另用 PyTorch,專門範例可能還會列出額外相依套件。請使用 PyTorch 官方安裝選擇器 [11] 產生的安裝指令;沒有 GPU 就選 CPU 版本。本站每個範例都設計成能在筆電 CPU 上於數秒到約一分鐘內跑完。
執行一個程式碼區塊
有些範例可獨立執行,有些則刻意接續同一章前面的區塊。例如影像就是陣列要先在第一段載入 gray 與 rgb,才能執行後面的切片範例;PR 10 綜合專題的主要流程要依序執行,後續才會沿用原本的開發/測試切分。開始新章節時使用新的筆記本核心,信任儲存的結果前先重新啟動並執行全部儲存格。名稱尚未定義,通常表示前面的設定區塊還沒跑,不應隨意換成另一份資料。提供的 assert 用來檢查特定主張,並不保證涵蓋所有輸入。
好習慣是一次只改一件事再重跑:kernel 大小、學習率、亂數種子。練習題會提示該調哪個參數。
筆記本與 Colab
有配套筆記本的教學會出現「在 Colab 開啟」按鈕。Colab 在瀏覽器中、以雲端主機執行筆記本,已預先安裝 NumPy、OpenCV、scikit-image 與 Matplotlib,本機不必做任何設定。若要在本機執行同一本筆記本,從「查看筆記本」連結下載,於已啟用的環境中執行 jupyter lab 並開啟檔案。筆記本放在 repository 的 notebooks/ 資料夾。
預覽網站(選用)
只有想修改網站時才需要。本 repository 需要 Node 22.12 以上 [12]:
程式碼 · Bash · 2 行
npm install
npm run dev
開發伺服器會印出本機網址。教學是 src/content/tutorials/<lang>/<track>/ 底下的 MDX 檔案。
第一個 CPU 實驗
以下完整範例自行建立影像、加入雜訊再平滑,不需要下載任何東西。
程式碼 · Python · 15 行
import numpy as np
import cv2

rng = np.random.default_rng(0)
clean = np.zeros((32, 32), dtype=np.float32)
clean[8:24, 8:24] = 1.0
noisy = clean + rng.normal(0, 0.1, clean.shape).astype(np.float32)
smooth = cv2.GaussianBlur(noisy, (5, 5), 1.0,
                          borderType=cv2.BORDER_REFLECT_101)
print("Shape and type:", smooth.shape, smooth.dtype)
print("Noise-region standard deviation:",
      noisy[:5, :5].std(), smooth[:5, :5].std())
print("Across the edge:", np.round(smooth[16, 5:12], 3))
assert smooth.shape == clean.shape
assert np.isfinite(smooth).all()
輸出顯示兩個效果。平坦、全為背景的角落,標準差從約 0.074 降到約 0.026:平滑把雜訊平均掉了。在第 8 欄的邊緣處,數值不再從 0 直接跳到 1,而是在三、四個像素內從約 0.04 爬升到 0.93:平滑也把銳利的轉折擴散開了。因此雜訊估計變低,不等於所有重要細節都變好。IP 03 會解釋原因,練習 2 則請你實際量測這個取捨。
選一本主教材
用一本主教材維持連貫的進度,再用另一本提供同一概念的不同解釋。下列連結指向作者或出版社頁面,取得方式依各網站說明。這是精選的起點,不是排名。
| 需求 | 推薦教科書 | 建議用法 |
|---|---|---|
| 數學準備 | Deisenroth、Faisal、Ong,Mathematics for Machine Learning [1] | 從線性代數、矩陣分解、向量微積分與機率讀起,再透過迴歸與 PCA 應用 |
| 影像操作 | Gonzalez、Woods,Digital Image Processing,第 4 版 [2] | 把影像基礎、空間與頻率域濾波、復原與分割,搭配影像處理單元閱讀 |
| 圖形識別主教材 | Theodoridis、Koutroumbas,Pattern Recognition,第 4 版 [3] | 依序學分類器設計、特徵與分群;實際動手解題,而不只讀摘要 |
| 圖形識別配套教材 | Bishop,Pattern Recognition and Machine Learning [4] | 從機率、潛在變數與圖模型的角度重新理解同一主題 |
| 第一本現代深度學習書 | Prince,Understanding Deep Learning [5] | 搭配圖解、數學與隨書筆記本,理解網路與生成建模 |
| 另一種現代深度學習解釋 | C. M. Bishop、H. Bishop,Deep Learning: Foundations and Concepts [6] | 用它的機率觀點加深對架構與訓練原理的理解 |
| 深度學習基礎與參考 | Goodfellow、Bengio、Courville,Deep Learning [7] | 第一部分(應用數學)對應 ML 01A–01C;後續章節涵蓋最佳化、CNN、序列模型與表示學習 |
| 分類之外的電腦視覺 | Szeliski,Computer Vision: Algorithms and Applications,第 2 版 [8] | 串起成像、運動、幾何、辨識與重建 |
| 機率式機器學習 | Murphy,Probabilistic Machine Learning: An Introduction [9] | 以機率為主軸的現代參考書,適合機器學習與圖形識別單元 |
| 自然語言處理應用主教材 | Hagiwara,Real-World Natural Language Processing [13] | 依序學習應用流程、文字分類、序列模型、注意力、預訓練模型、訓練實務與部署 |
| 自然語言處理語言學配套教材 | McRoy,Principles of Natural Language Processing [14] | 搭配對應章節學習句法、文法、語意、篇章、檢索、生成與翻譯 |
| 文字與語言補充教材 | Jurafsky、Martin,Speech and Language Processing,第 3 版草稿 [10] | 深入 token、n-gram、分類、嵌入(embedding)、Transformer 與評估等主題 |
| 凸最佳化 | Boyd、Vandenberghe,Convex Optimization [15] | OPT 01–05 依第 1–8 章學建模與應用;OPT 06–08 深入第 9–11 章的數值方法與現代延伸 |
| 資訊理論 | Cover、Thomas,Elements of Information Theory,第 2 版 [16] | 從熵與典型性讀到來源/通道編碼、連續變數、率失真、統計決策、通用編碼與網路 |
圖形識別單元以 Theodoridis 與 Koutroumbas [3] 及 Bishop 的 PRML [4] 為兩本核心教材。先用 Theodoridis 建立完整的辨識流程,再比較 Bishop 對同一問題的機率處理方式。出版年份較早,不會讓貝氏決策理論或高斯模型失效;架構、資料規模或應用改變的部分,再用新論文補充。
若只選一本深度學習入門書,從 Prince [5] 開始,需要時搭配本站數學章節。偏好一路以機率觀點推導,就選 Bishop 與 Bishop [6]。Goodfellow 等人 [7] 仍是重要基礎,但 2016 年版早於視覺 Transformer、擴散模型與基礎模型;這些內容由機器學習/深度學習單元補上。
自然語言處理單元以 Hagiwara [13] 與 McRoy [14] 為兩本核心教材。Hagiwara 串起模型與應用,McRoy 補足理解語言系統所需的語言學與符號式概念。可以圍繞同一問題並讀兩書:分類器需要資料流程,剖析器或對話系統也需要明確的語言結構。兩書的 2021 年版再搭配新論文補充。
最佳化單元以 Boyd 與 Vandenberghe [15] 學習哪些問題變換保留凸性,以及最適性憑證的意義。資訊理論單元以 Cover 與 Thomas [16] 分辨可達成的構造與任何構造都無法突破的界限。兩個單元延伸 ML 01B–01C 的數學入門;每篇教學都有對應的教科書章節地圖。
Jurafsky 與 Martin 的草稿會持續更新,目前版本日期為 2026 年 8 月 19 日 [10]。做章節筆記時請記下版本日期,因為章號可能隨版本變動。其他教科書也要記下版次,讓練習題的出處能被重新找到。
教科書、綜述與論文怎麼讀
教科書提供定義與連貫的順序。每讀一段,至少重推一條公式、跑一個小例子、解一道練習,再往下讀。
綜述(survey/review)提供方法地圖、假設與未解問題。每篇教學的「現代觀點」都會摘要幾篇。閱讀時可整理成表格:它涵蓋的每個方法的預測目標、學習目標、所需資料、計算成本與評估方式。也要檢查涵蓋日期:「近期」是相對於作者當時而言。
原始論文提出一個方法及其證據。讀問題、方法、實驗規則與限制,把重要主張追到實際支持它的表格或消融實驗。知道它相對公平基準改變了什麼,比記住方法名稱更有用。
每篇閱讀筆記保留五項:問題、數學物件、主要假設、檢驗該假設的實驗,以及一個尚未解決的疑問。每篇教學的參考文獻是下一步閱讀的方向;不必讀完每篇引用的論文才開始跑程式。
用小里程碑安排進度
- 表示資料:檢查一張影像,說明各軸、數值範圍與 dtype。
- 變換資料:實作一個濾波器,與函式庫結果比對,並處理邊界。
- 做出決策:訓練一個簡單分類器,前處理參數只從訓練資料學。
- 學習特徵:訓練一個小型神經網路,說明損失函數與驗證方式的選擇理由。
- 研究現代方法:在合成資料上重現注意力、遮罩或加雜訊等機制。
- 完成小專題:報告基準方法、獨立測試結果、失敗案例與限制。
能不照抄原文、用自己的話說明上一個里程碑時,再往下走。一個比較乾淨的小實驗,比一個看不清資料與評估方式的大模型更能建立理解。
重點整理
- 八個單元:基礎、影像處理、自然語言處理、圖形識別、機器學習/深度學習、視覺深度學習、最佳化、資訊理論。它們互相支援,不必讀完一個才開始另一個。
- 每頁的「先備知識」、難度標籤與單元側欄告訴你它的位置;用它們取代從頭讀到尾。
- 依背景選入口、依目標選路徑;每週一篇並執行程式碼與練習,是可持續的步調。
- 範例以 CPU 學習為目標;有相依關係的區塊依章節順序執行,各章使用獨立筆記本,並依個別範例需求補裝套件。
- 每個單元搭配一本主教材與一本配套教材,並以不同目的閱讀教科書、綜述與論文。
練習
- 規劃。選一個入口、一條學習路徑與一本主教材。寫下第一個實驗要回答的問題,以及什麼具體結果算是進步。
提示
問題要小到能在 CPU 上一次做完,例如「5×5 高斯模糊在平坦區域降低多少雜訊?又讓邊緣變寬多少?」進步應該是一個可以量測的數字,而不是一種感覺。
- 掃描 kernel 大小。把平滑範例改成 kernel 大小 3、5、9( 跟著加大,例如 0.8、1.0、2.0)。回報平坦區域的標準差,以及邊緣從 0.1 升到 0.9 所需的像素數。
提示
固定亂數種子與含雜訊的影像,只改濾波器。雜訊下降與邊緣變寬應該同時發生:這就是線性平滑的偏差與變異取捨。
- 讀懂頁面資訊。打開 ML 02。它的難度是什麼?「先備知識」指向哪一頁?單元側欄中下一篇是哪一篇?
提示
「先備知識」就在標題下方。沿著它一路往回追,直到遇到你已具備先備知識的頁面;這條鏈就是你個人的閱讀順序。
- 為來源分類。從任一篇教學挑一筆參考文獻,判斷它是教科書、綜述、原始論文還是軟體文件。這種來源最適合回答什麼問題?
提示
綜述回答「有哪些選擇、彼此如何比較?」;原始論文回答「這個特定改動是否有幫助、在什麼實驗規則下?」;軟體文件回答「這個函式實際上算了什麼?」
- 用正確的單位切分。有一個資料集包含 50 段影片、每段有許多影格。請規劃訓練/驗證/測試切分,並說明為什麼隨機切分單一影格可能造成誤導。
提示
相鄰影格幾乎相同,隨機切影格會讓近乎重複的樣本同時出現在訓練集與測試集,使測試分數虛高。應改以影片(或錄製時段)為單位切分。
參考文獻
- M. P. Deisenroth, A. A. Faisal and C. S. Ong, Mathematics for Machine Learning, Cambridge University Press, 2020. Book site
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018. Book site
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2009. Companion site
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006(官方提供 PDF). Book page
- S. J. D. Prince, Understanding Deep Learning, MIT Press, 2023. Book and notebooks
- C. M. Bishop and H. Bishop, Deep Learning: Foundations and Concepts, Springer, 2024(提供免費線上版). Book site
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016. Book site
- R. Szeliski, Computer Vision: Algorithms and Applications, 2nd ed., Springer, 2022(PDF 限個人使用). Book site
- K. P. Murphy, Probabilistic Machine Learning: An Introduction, MIT Press, 2022. Book site
- D. Jurafsky and J. H. Martin, Speech and Language Processing, 3rd ed. draft, release of August 19, 2026. Draft site
- PyTorch, “Get Started Locally,” installation documentation. Documentation
- Node.js, “Download Node.js.” Download page
- M. Hagiwara, Real-World Natural Language Processing, Manning, 2021. Publisher
- S. McRoy, Principles of Natural Language Processing, open textbook, 2021. Open textbook
- S. Boyd and L. Vandenberghe, Convex Optimization, Cambridge University Press, 2004. Author site and book
- T. M. Cover and J. A. Thomas, Elements of Information Theory, 2nd ed., Wiley, 2006. Publisher
連結與草稿日期於 2026 年 10 月 4 日查核。配套網站不代表整本教科書可免費取得;取得方式以各網站說明為準。
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 影像就是陣列 · 14 分鐘