NLP 08・以 Transformer 建構序列到序列模型(機器翻譯、聊天機器人)
先備知識:NLP 07・注意力機制與 Transformer
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
- 你將學到1 分鐘
- 先看全貌1 分鐘
- 1. 從統計機器翻譯到神經機器翻譯1 分鐘
- 2. 條件序列學習2 分鐘
- 3. 用於翻譯的編碼器—解碼器 Transformer1 分鐘
- 4. 解碼:貪婪搜尋、束搜尋與長度正規化2 分鐘
- 5. 評估譯文:BLEU、chrF 與 COMET4 分鐘
- 6. 動手做:微型 Transformer 翻譯器2 分鐘
- 7. 翻譯跨形式保留意義2 分鐘
- 8. 聊天機器人:把對話當成序列到序列1 分鐘
- 9. 回合、對話行為與狀態2 分鐘
- 10. 信念狀態與有效澄清2 分鐘
- 11. 上下文、記憶與工具邊界1 分鐘
- 12. 評估完整對話,不只一個回覆1 分鐘
- 現代觀點2 分鐘
- 重點整理1 分鐘
- 練習1 分鐘
- 論文導讀
- 參考文獻
自然語言處理
你將學到
- 機器翻譯如何從統計片語表走到神經編碼器—解碼器,以及 Transformer 改變了什麼。
- 條件序列學習:目標位移、教師強制(teacher forcing)、考慮填補的損失,以及為何生成時會出現曝光偏差(exposure bias)。
- 如何在 CPU 上訓練小型編碼器—解碼器 Transformer 翻譯器,並以貪婪搜尋與帶長度正規化的束搜尋(beam search)解碼。
- BLEU 如何運作(從零實作)、chrF 與 COMET 補上什麼,以及為何它們都不能證明意義正確。
- 同一個條件生成觀點如何套用到聊天機器人,以及為何任務對話還需要明確狀態、澄清與工具邊界。
- 如何評估完整對話,而不是單一回覆。
先看全貌
序列到序列(seq2seq)模型讀一個序列、寫出另一個序列:由英文句寫出法文句、由對話歷史寫出回覆、由文件寫出摘要。編碼器把輸入變成每個詞元一個向量;解碼器一次寫一個輸出詞元,透過因果自注意力讀自己的前綴,再透過交叉注意力讀輸入(NLP 07)。同一套機制服務翻譯與對話,但兩種任務的失敗方式不同。譯文可能很流暢卻反轉否定;聊天機器人可能回覆親切,卻查錯裝置。
本章以兩種互補閱讀為錨。Hagiwara 第 6 章說明用於翻譯與對話應用的序列到序列模型,第 8 章介紹注意力與 Transformer [1]。McRoy 第 9 章把翻譯視為保留意義的生成 [2]。本章範例都是原創的本機 CPU 實驗,不需下載模型或資料集就能展示機制。NLP 09 接著討論開放式生成、摘要與服務。
1. 從統計機器翻譯到神經機器翻譯
直觀說法。 機器翻譯最初從對齊的句對學習詞與片語的對應,再結合另一個描述流暢目標文字的模型。神經翻譯則以一個端到端訓練的網路取代整條管線。
統計機器翻譯(SMT)把翻譯視為雜訊通道(noisy channel)。要把外語句 譯成英文 ,選擇
其中 是獎勵流暢英文的語言模型; 是獎勵忠實的翻譯模型; 是選出的譯文。Brown 等人的 IBM 模型從句子對齊的文字估計詞層級翻譯機率與對齊 [3]。Koehn、Och 與 Marcu 的片語式翻譯使用多詞片語對,比單詞更能掌握局部詞序調整與慣用語 [4]。這類系統結合許多分別訓練的元件與特徵。
神經網路先以元件身分加入:Cho 等人用 RNN 編碼器—解碼器在既有 SMT 系統中替片語對評分 [5]。接著 Sutskever、Vinyals 與 Le 訓練 LSTM 編碼器—解碼器直接翻譯 [6]。Bahdanau、Cho 與 Bengio 加入注意力,讓解碼器每一步都能搜尋來源 [7];Vaswani 等人則完全以注意力取代循環 [8]。位元組對編碼(byte-pair encoding)等子詞切分讓開放詞彙變得實際可行,罕見詞與名稱可以譯成已知片段的序列 [9];NLP 02 逐步建立 BPE 詞彙表。Stahlberg 的回顧詳細追溯了從計數式 SMT 到神經機器翻譯的轉變 [22]。
兩個近期錨點顯示領域的走向。NLLB 計畫建立了涵蓋 200 種語言的單一大規模多語模型,特別關注低資源語言 [21]。WMT24 一般翻譯任務在專業人工評估下,比較參賽系統與數個大型語言模型及線上服務;其標題概括了結論:LLM 時代已經到來,但機器翻譯尚未解決 [20]。
2. 條件序列學習
直觀說法。 翻譯器一次一個詞元,建模「給定來源時目標句」的機率。訓練時給它正確的先前目標詞元;生成時則要它使用自己的輸出。
條件序列模型寫成:
其中 是來源序列; 是含結束詞元的目標序列; 是其長度; 是位置 之前的詞元; 是學得參數。來源可以完整可見,目標仍保持因果。分解描述分布,不保證取樣輸出獲得來源支持。
訓練通常提供正確的先前目標詞元,稱為教師強制 [6]。批次的詞元損失為:
其中 是例數; 是範例 填補後的目標長度; 對真實目標為一、填補為零; 是真實詞元數;、、 分別是來源、目前目標與參考前綴。使用自然對數。遮罩從損失移除填補,不會自動從計算移除。
仔細檢查位移。解碼器輸入從起始詞元開始,目標從第一個輸出詞元開始;目標含結束符號讓模型學停止。填補與結束必須分開,否則可能獎勵錯誤停止。不同長度句子的批次要記錄按詞元或例子平均,因為它們給長句不同權重。
資料建構往往比小架構調整更重要。翻譯對若默默修正數字,就訓練模型改數字。來源版本、指南與目標來源要一起保留,按文件、對話或事件分組切分,防止近重複跨訓練測試。
教師強制與曝光偏差
教師強制提供正確前綴,即使模型自己會產生另一個前綴。假設參考從 Pump A 開始,生成卻選了 Pump B。後續詞元仍可能構成完全流暢的 Pump B 陳述。參考前綴損失卻始終在 Pump A 後評估那些位置,沒有測試如何從這次生成錯誤恢復。差別在於:給定歷史下的預測,以及模型自己持續建立歷史時的行為。
Ranzato 等人把這種訓練/推論不一致稱為曝光偏差:模型訓練時只接觸正確前綴,測試時卻必須讀自己的預測,錯誤可能累積 [10]。兩種回應說明了設計空間。排程取樣(scheduled sampling)在訓練中逐步把部分正確解碼器輸入換成模型自己的預測 [11]。序列層級訓練直接最佳化整個生成序列的分數(例如 BLEU),而不只是下一詞元概似 [10]。兩者都不能免除評估完整生成輸出的需要;以教師強制做最大概似仍是標準起點,分解本身也是精確的。ML 09 討論影像生成中的同一種不一致。
詞元平均也隱藏不同語意後果。替換 the 可能只影響風格;替換 not、裝置 ID 或單位,卻能反轉結果。每個詞元貢獻一項對數損失,應用對這些變化的成本可能差很多。如果常見用詞改善,稀少關鍵差異卻惡化,平均損失下降仍可能伴隨更多重要錯誤。多個正確說法也是問題:單一參考提供一種可接受表達,不是完整集合。
選讀:Bahdanau attention(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
3. 用於翻譯的編碼器—解碼器 Transformer
直觀說法。 編碼器以雙向自注意力讀完整個來源;解碼器以因果自注意力寫目標,並以交叉注意力讀編碼器。最後的線性層把每個解碼器狀態轉成目標詞元上的分布。
原始 Transformer [8] 由 NLP 07 的區塊組成:
- 輸入。 來源與目標文字切成子詞 [9](NLP 02)。每個詞元 ID 經嵌入、乘以 ,再加上正弦位置編碼。
- 編碼器。 個由自注意力與前饋子層組成的區塊,對來源鍵套用填補遮罩,產生記憶 ,每個來源詞元一個向量。
- 解碼器。 個區塊,包含遮罩自注意力(因果加目標填補)、讀取 的交叉注意力(遮蔽來源填補)與前饋子層。
- 輸出。 線性層與 softmax 在每個目標位置給出 。
訓練時,所有目標位置一次算完,因為因果遮罩讓每個位置只看到自己的前綴。生成時,編碼器只跑一次,解碼器每產生一個輸出詞元跑一次。實務解碼器會快取較早目標位置的鍵與值,而不是重算;NLP 09 分析這個快取。
原論文有兩個值得知道的訓練細節。模型使用標籤平滑(label smoothing):目標分布把大部分機率放在參考詞元,把一小部分分給詞彙表其餘詞元 [8, 29]。平滑參數為 、詞彙表為 時,訓練目標為 ;其中 在條件成立時為一。這抑制過度自信;Vaswani 等人回報它使困惑度變差,但改善了 BLEU [8]。模型也使用學習率暖身,Xiong 等人後來把它與後正規化配置連結起來(NLP 07)。
4. 解碼:貪婪搜尋、束搜尋與長度正規化
直觀說法。 訓練好的模型對每個可能的下一詞元給出機率。解碼器必須把這些機率變成一個輸出句。貪婪解碼每次取最好的下一詞元;束搜尋則同時保留幾個部分句子。
候選序列分數為:
其中 是完整序列對數機率; 包含結束詞元;其他符號同前。對所有序列精確最大化並不可行,因為候選數隨長度指數成長。貪婪解碼每一步選機率最高的詞元。寬度為 的束搜尋保留分數最高的 個前綴,把每個前綴延伸所有詞元,再保留最好的 個;完成的假說(以結束詞元結尾)另外存放。這些選擇控制搜尋與變化,不會讓無支持內容變可靠。
貪婪解碼可能錯過最佳完整序列:機率稍低的第一個詞元,可能接著一個機率高得多的延續,而束搜尋能把它保留到發現為止。NLP 09 用人工範例說明這點,並討論原始對數機率對未完成前綴提供的上界、搜尋錯誤與模型錯誤的差別,以及基於取樣的解碼。這裡聚焦翻譯多出來的部分:長度正規化,以及在訓練好的翻譯器上實際量測的貪婪與束搜尋比較(第 6 節)。
長度正規化
原始對數機率有內建偏好。每多一個詞元就多一個非正項,所以較長的假說即使是較好的譯文,分數也傾向較低。Wu 等人在 Google 神經機器翻譯系統中描述了這個偏差,並以正規化分數排序完成的假說 [12]:
其中 是假說的詞元長度; 控制正規化強度, 回到原始分數, 近似每詞元平均; 是用來排序完成假說的分數。他們的完整評分函數還加上以注意力為基礎的涵蓋懲罰,這裡省略。他們在開發資料上調整 [12];應把它當成超參數,而不是常數。
程式碼 · Python · 10 行
candidates = {                       # per-token log-probabilities, end token included
    "stop <eos>": [-0.9, -1.1],
    "stop pump b now <eos>": [-0.9, -0.5, -0.3, -0.4, -0.2],
}
def length_penalty(n, alpha):        # Wu et al. (2016): ((5 + n) / 6) ** alpha
    return ((5 + n) / 6) ** alpha
for alpha in [0.0, 0.6, 1.0]:
    scores = {c: sum(lp) / length_penalty(len(lp), alpha) for c, lp in candidates.items()}
    best = max(scores, key=scores.get)
    print(f"alpha={alpha}:", {c: round(s, 3) for c, s in scores.items()}, "->", best)
輸出:
程式碼 · 3 行
alpha=0.0: {'stop <eos>': -2.0, 'stop pump b now <eos>': -2.3} -> stop <eos>
alpha=0.6: {'stop <eos>': -1.823, 'stop pump b now <eos>': -1.693} -> stop pump b now <eos>
alpha=1.0: {'stop <eos>': -1.714, 'stop pump b now <eos>': -1.38} -> stop pump b now <eos>
原始分數偏好被截斷的指令; 與 偏好完整指令(若 很小,例如 ,仍會偏好短的那個)。哪個正確取決於來源,而分數看不到來源。
正規化也改變搜尋本身:使用原始分數時,若某個完成假說勝過所有未完成前綴,就可以安全回傳,因為延伸前綴只會降低原始分數;改用長度正規化分數後,這個論證不再成立,停止規則必須把懲罰考慮進去。
要明訂輸出限制、停止規則及達上限後的行為,截斷翻譯不能當完整結果。解碼參數與模型一起記錄,讓評估可重現。
5. 評估譯文:BLEU、chrF 與 COMET
直觀說法。 自動指標把系統輸出與一或多個人工參考譯文比較。它們便宜、可重現,適合比較系統;但一個小詞改動就能反轉意思,分數卻幾乎不變。
BLEU
BLEU 比較候選與參考的 n-gram [13]。對每個階數 ,它計算修正(截限)精確率:每個候選 n-gram 最多只計入它在「出現最多次的那個參考」中的次數。在整個測試語料上:
其中 是候選句中相異 n-gram 的集合; 是 n-gram 在候選中的次數; 是它在該句任一參考中的最大次數; 是整個語料的候選總長度; 是有效參考長度,即每句取最接近候選長度的參考長度後加總; 是短度懲罰(brevity penalty),防止系統靠寫極短輸出提高精確率; 是均勻權重。BLEU 是語料層級分數:精確率先在所有句子上合併,再取對數,所以它不是句子分數的平均。
程式碼 · Python · 38 行
import math
from collections import Counter

def ngrams(tokens, n):
    return Counter(tuple(tokens[i:i + n]) for i in range(len(tokens) - n + 1))

def corpus_bleu(hypotheses, references, max_n=4):
    """hypotheses: list of token lists; references: list of lists of token lists."""
    matched, total = [0] * max_n, [0] * max_n
    hyp_len = ref_len = 0
    for hyp, refs in zip(hypotheses, references):
        hyp_len += len(hyp)
        # effective reference length: the reference length closest to the hypothesis
        ref_len += min((abs(len(r) - len(hyp)), len(r)) for r in refs)[1]
        for n in range(1, max_n + 1):
            counts = ngrams(hyp, n)
            max_ref = Counter()
            for r in refs:
                max_ref |= ngrams(r, n)            # elementwise max over references
            matched[n - 1] += sum((counts & max_ref).values())   # clipped counts
            total[n - 1] += max(len(hyp) - n + 1, 0)
    if min(matched) == 0:
        return 0.0, matched, total
    log_p = sum(math.log(m / t) for m, t in zip(matched, total)) / max_n
    bp = 1.0 if hyp_len > ref_len else math.exp(1 - ref_len / hyp_len)
    return bp * math.exp(log_p), matched, total

refs = [["the cat is on the mat".split(), "there is a cat on the mat".split()]]
_, m, t = corpus_bleu(["the the the the the the the".split()], refs, max_n=1)
print("clipped unigram precision:", f"{m[0]}/{t[0]}")
ref = "pump a is not operating at 30 c".split()
for hyp in ["pump a is not operating at 30 c",
            "pump a is operating at 30 c",
            "pump a is not running at 30 c"]:
    score, _, _ = corpus_bleu([hyp.split()], [[ref]])
    print(f"{score:.3f}  {hyp}")
assert m[0] == 2 and t[0] == 7
assert corpus_bleu([ref], [[ref]])[0] == 1.0
輸出:
程式碼 · 4 行
clipped unigram precision: 2/7
1.000  pump a is not operating at 30 c
0.515  pump a is operating at 30 c
0.500 pump a is not running at 30 c第一項檢查重現經典的截限例子:重複七次「the」的候選只得到兩次的分數,因為沒有任何參考包含超過兩個「the」[13]。第二項檢查是警訊。去掉 not 會反轉意思,分數卻高於把 operating 換成 running 的正確改述。BLEU 量測的是與參考的表面重疊,它不知道哪些詞承載命題。
這個實作使用空白分詞、不做平滑(任一 n-gram 精確率為零就得零分),並採用最接近參考長度規則。發表的 BLEU 分數取決於這些選擇。Post 指出,光是分詞與正規化的差異就能大幅改變回報的 BLEU,並提出 sacreBLEU:它在去分詞後的文字上以標準內部分詞器計算分數,並印出版本簽章 [14]。回報任何 BLEU 數字時都應附上簽章;不同設定算出的分數不能比較。
chrF
chrF 以字元 n-gram 取代詞 n-gram 評分 [15]:
其中 與 是對各 n-gram 階數平均的字元 n-gram 精確率與召回率; 讓召回率的權重是精確率的 倍。Popović 在其實驗中發現 6-gram 效果最好,並比較了 與 [15]。字元 n-gram 對共享詞幹與屈折變化給部分分數,對形態豐富的目標語言有幫助;但 chrF 仍是重疊分數,分辨不出 not 比 the 重要。
學得指標:COMET
COMET 使用跨語言預訓練編碼器,訓練神經模型從來源、候選與參考預測人類品質判斷 [16]。它能獎勵與參考共享詞很少的正確改述。在以專家 MQM(多維品質指標,Multidimensional Quality Metrics)標註為準的 WMT22 指標任務中,神經學得指標與人類評分的相關性優於 BLEU、chrF 等重疊指標 [18]。學得指標帶有自己的模型版本、訓練分布與語言涵蓋,輸出只是在那些條件下的量測。應在應用重要的否定、數量與術語錯誤上檢查指標。
能排序系統的指標,不會自動成為輸出門檻
WMT25 評估結果分開片段品質預測、錯誤區段標註與品質導向修正,指出系統層級與片段層級評估可能偏好不同方法,語言多樣性仍然困難 [19]。這很重要:拒絕一個錯誤譯文,與比較模型平均品質,是不同決策。指標可能獎勵整體流暢系統,卻漏掉個別輸出的少見否定反轉。接受門檻需要在這些錯誤上驗證,不能直接由總體相關性結果繼承。
可交叉檢查生成器錯誤類別與評估器取得的輸入。只看參考的比較能檢查用詞一致,卻缺少驗證無支持陳述所需的來源;取得來源的評估器雖有證據,仍可能與生成器共享作用範圍或數量錯誤。應檢查分歧案例:正確改述被評差、流暢矛盾被評好,以及準確卻不完整的譯文。人工覆核保留原始來源,並分開充分性與風格。這能說明哪些評估訊號適合比較模型,哪些可用來判斷某次結果是否應接受。
重疊、召回與人工判斷
同一個反例也影響 ROUGE 用於摘要的偏召回重疊 [17]。簡單 unigram 召回檢查:
其中 遍歷詞型;、 是參考與候選詞頻;分母是參考詞元數。以下最小實作沒有重現完整套件的每項前處理或聚合。
程式碼 · Python · 14 行
import re
from collections import Counter

def words(text):
    return re.findall(r"[a-z0-9]+", text.lower())
def overlap_recall(reference, hypothesis):
    ref, hyp = Counter(words(reference)), Counter(words(hypothesis))
    return sum((ref & hyp).values()) / sum(ref.values())
reference = "Pump A is operating at 30 C."
contradiction = "Pump A is not operating at 30 C."
score = overlap_recall(reference, contradiction)
print("Unigram recall:", score)
assert score == 1.0
assert ("not" in words(reference)) != ("not" in words(contradiction))
矛盾句保留所有參考詞,因此召回 1.0。精確率會懲罰多出的詞,但小懲罰仍不能表達否定反轉的重要性。這是受控反例,不表示重疊指標永不與人類判斷相關,而是說明必須配合對意義敏感的檢查。
人工評估要隱藏系統身分、隨機呈現、保留來源並指定決策。Freitag 等人的大型 MQM 研究由能看到完整文件的專業譯者評分,得到的系統排名與同一共享任務中群眾評分者的排名有明顯差異 [30]。應請覆核者先標出具體錯誤,再判斷整體品質;回報誰覆核、涵蓋哪些語言,並把裁決過的挑戰集合與一般樣本分開。
6. 動手做:微型 Transformer 翻譯器
直觀說法。 我們發明一個小型語言對,在 CPU 上用 3,000 個句對訓練編碼器—解碼器 Transformer 不到一分鐘,再用上面的 BLEU 函數比較貪婪與束搜尋解碼。
來源語言類似英文:主詞、動詞、受詞,名詞前可有形容詞,也可有 never。目標語言是發明的:每個詞有固定譯詞,形容詞放在名詞之後,受詞後接助詞 o,動詞放最後,否定變成句尾詞 nai。例如 the small drone never lifts a red cable 譯為 la drono pico un kablo rosso o levi nai。因此翻譯同時需要字典與詞序調整,正是逐詞翻譯不足的兩個原因。訓練句與測試句不重疊,但來自同一個小文法,所以這是分布內測試。
模型使用 PyTorch 的編碼器與解碼器層(各兩層、寬度 64、四個頭)、縮放嵌入加正弦位置、布林遮罩(True 表示阻擋),並以 ignore_index 從損失中去掉填補目標,實作第 2 節的遮罩損失。請在 BLEU 程式區塊之後執行,因為它會呼叫 corpus_bleu。
程式碼 · Python · 142 行
# Run after the BLEU block above: this code calls its corpus_bleu function.
import math, random, time
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0); torch.set_num_threads(1); rng = random.Random(0)
lexicon = {"the": "la", "a": "un", "robot": "robo", "sensor": "senso",
           "pump": "pompa", "valve": "valva", "drone": "drono", "cable": "kablo",
           "red": "rosso", "blue": "blu", "big": "grando", "small": "pico",
           "sees": "vidi", "checks": "kontrolli", "moves": "movi",
           "opens": "aperi", "lifts": "levi"}
DET, NOUN = ["the", "a"], ["robot", "sensor", "pump", "valve", "drone", "cable"]
ADJ, VERB = ["red", "blue", "big", "small"], ["sees", "checks", "moves", "opens", "lifts"]

def noun_phrase():
    adj = [rng.choice(ADJ)] if rng.random() < 0.5 else []
    return rng.choice(DET), adj, rng.choice(NOUN)

def pair():          # source: SVO, adjective before noun; target: SOV, adjective after noun
    (d1, a1, n1), (d2, a2, n2) = noun_phrase(), noun_phrase()
    verb, neg = rng.choice(VERB), rng.random() < 0.3
    src = [d1, *a1, n1] + (["never"] if neg else []) + [verb, d2, *a2, n2]
    np_ = lambda d, a, n: [lexicon[d], lexicon[n]] + [lexicon[x] for x in a]
    tgt = np_(d1, a1, n1) + np_(d2, a2, n2) + ["o", lexicon[verb]] + (["nai"] if neg else [])
    return " ".join(src), " ".join(tgt)

pairs = list(dict(pair() for _ in range(6000)).items())   # unique source sentences
train_pairs, test_pairs = pairs[:3000], pairs[3000:3200]
PAD, BOS, EOS = 0, 1, 2
src_vocab = ["<pad>", "<bos>", "<eos>"] + sorted({w for s, _ in pairs for w in s.split()})
tgt_vocab = ["<pad>", "<bos>", "<eos>"] + sorted({w for _, t in pairs for w in t.split()})
s_id = {w: i for i, w in enumerate(src_vocab)}
t_id = {w: i for i, w in enumerate(tgt_vocab)}

def batch(texts, ids, L):
    rows = [[ids[w] for w in t.split()] + [EOS] for t in texts]
    return torch.tensor([r + [PAD] * (L - len(r)) for r in rows])
S = batch([s for s, _ in train_pairs], s_id, 10)
Y = batch([t for _, t in train_pairs], t_id, 12)
Y_in = torch.cat([torch.full((len(Y), 1), BOS), Y[:, :-1]], dim=1)   # shift right

def sinusoidal(n, d):
    pos = torch.arange(n)[:, None]
    omega = 1.0 / 10000 ** (torch.arange(0, d, 2) / d)
    pe = torch.zeros(n, d)
    pe[:, 0::2], pe[:, 1::2] = torch.sin(pos * omega), torch.cos(pos * omega)
    return pe

class TinyMT(nn.Module):
    def __init__(self, d=64):
        super().__init__()
        self.d = d
        self.src_emb = nn.Embedding(len(src_vocab), d)
        self.tgt_emb = nn.Embedding(len(tgt_vocab), d)
        self.register_buffer("pe", sinusoidal(32, d))
        enc = nn.TransformerEncoderLayer(d, 4, 128, dropout=0.0, batch_first=True)
        dec = nn.TransformerDecoderLayer(d, 4, 128, dropout=0.0, batch_first=True)
        self.encoder = nn.TransformerEncoder(enc, 2, enable_nested_tensor=False)
        self.decoder = nn.TransformerDecoder(dec, 2)
        self.out = nn.Linear(d, len(tgt_vocab))
    def embed(self, emb, x):
        return emb(x) * math.sqrt(self.d) + self.pe[: x.shape[1]]
    def encode(self, src):
        return self.encoder(self.embed(self.src_emb, src), src_key_padding_mask=src.eq(PAD))
    def decode(self, memory, src, y_in):
        T = y_in.shape[1]
        causal = torch.ones(T, T, dtype=torch.bool).triu(1)      # True = blocked
        h = self.decoder(self.embed(self.tgt_emb, y_in), memory, tgt_mask=causal,
                         tgt_key_padding_mask=y_in.eq(PAD),
                         memory_key_padding_mask=src.eq(PAD))
        return self.out(h)

@torch.no_grad()
def greedy(src_text, max_len=14):
    src = batch([src_text], s_id, len(src_text.split()) + 1)
    memory, y = model.encode(src), [BOS]
    for _ in range(max_len):
        logp = model.decode(memory, src, torch.tensor([y]))[0, -1].log_softmax(-1)
        y.append(int(logp.argmax()))
        if y[-1] == EOS:
            break
    return [tgt_vocab[i] for i in y[1:] if i != EOS]

@torch.no_grad()
def beam_search(src_text, width=4, alpha=0.6, max_len=14):
    src = batch([src_text], s_id, len(src_text.split()) + 1)
    memory = model.encode(src)
    beams, finished = [([BOS], 0.0)], []
    lp = lambda n: ((5 + n) / 6) ** alpha             # GNMT length penalty
    for _ in range(max_len):
        prefixes = torch.tensor([y for y, _ in beams])
        logp = model.decode(memory.expand(len(beams), -1, -1), src.expand(len(beams), -1),
                            prefixes)[:, -1].log_softmax(-1)
        cand = [(y + [t], s + logp[b, t].item()) for b, (y, s) in enumerate(beams)
                for t in logp[b].topk(width).indices.tolist()]
        cand.sort(key=lambda c: c[1], reverse=True)
        beams = []
        for y, s in cand:
            (finished if y[-1] == EOS else beams).append((y, s))
            if len(beams) == width:
                break
        if not beams:
            break
    best, _ = max(finished or beams, key=lambda c: c[1] / lp(len(c[0]) - 1))
    return [tgt_vocab[i] for i in best[1:] if i != EOS]

@torch.no_grad()
def log_prob(src_text, words):                       # model score of a full output
    src = batch([src_text], s_id, len(src_text.split()) + 1)
    y = [t_id[w] for w in words] + [EOS]
    logp = model.decode(model.encode(src), src, torch.tensor([[BOS] + y[:-1]])).log_softmax(-1)
    return logp[0, torch.arange(len(y)), y].sum().item()

def evaluate():
    model.eval()
    refs, outputs = [[t.split()] for _, t in test_pairs], {}
    for name, decode in [("greedy", greedy), ("beam-4", beam_search)]:
        hyps = [decode(s) for s, _ in test_pairs]
        exact = sum(h == r[0] for h, r in zip(hyps, refs)) / len(refs)
        mean_lp = sum(log_prob(s, h) for (s, _), h in zip(test_pairs, hyps)) / len(hyps)
        print(f"  {name}: BLEU {corpus_bleu(hyps, refs)[0]:.3f}  exact {exact:.3f}"
              f"  mean log p {mean_lp:.3f}")
        outputs[name] = hyps
    print("  outputs that differ:", sum(g != b for g, b in zip(*outputs.values())))
    model.train()

model = TinyMT()
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
start = time.time()
for step in range(1, 401):
    idx = torch.randint(0, len(S), (64,))
    logits = model.decode(model.encode(S[idx]), S[idx], Y_in[idx])   # teacher forcing
    loss = F.cross_entropy(logits.reshape(-1, len(tgt_vocab)), Y[idx].reshape(-1),
                           ignore_index=PAD)
    opt.zero_grad(); loss.backward(); opt.step()
    if step in (100, 400):
        print(f"after {step} steps: training loss {loss.item():.3f}")
        evaluate()
model.eval()
print(" ".join(greedy("the small drone never lifts a red cable")))
print(f"total time {time.time() - start:.0f}s")
輸出(CPU、單執行緒;時間依機器而異,其他 PyTorch 版本或硬體可能改變最後幾位數):
程式碼 · 10 行
after 100 steps: training loss 0.221
  greedy: BLEU 0.614  exact 0.365  mean log p -1.587
  beam-4: BLEU 0.618  exact 0.375  mean log p -1.553
  outputs that differ: 31
after 400 steps: training loss 0.003
  greedy: BLEU 1.000  exact 1.000  mean log p -0.027
  beam-4: BLEU 1.000  exact 1.000  mean log p -0.027
  outputs that differ: 0
la drono pico un kablo rosso o levi nai
total time 16s
分開解讀兩個檢查點。訓練 100 步後模型只訓練了一半:200 個測試譯文中只有約三分之一完全正確。此時束搜尋改變了 200 個輸出中的 31 個,找到平均模型對數機率較高的輸出,BLEU 與完全匹配率也略為提升。400 步後,模型在這個分布內測試上既有信心又正確,貪婪與束搜尋輸出完全相同:模型分布非常尖銳時,更寬的搜尋找不到別的東西。束搜尋藉由減少搜尋錯誤而有幫助;它修不好模型錯誤,在簡單輸入上也可能毫無改變。
這裡 BLEU 與完全匹配同步變化,是因為語言很小又確定:每個來源恰有一個正確譯文。使用真實參考時,正確譯文可能與參考不同,兩個數字就會分歧。測試也只檢查同一文法的句子,完全沒說明組合泛化,例如訓練中從未見過的形容詞—名詞組合;練習 1 請你測試這點。
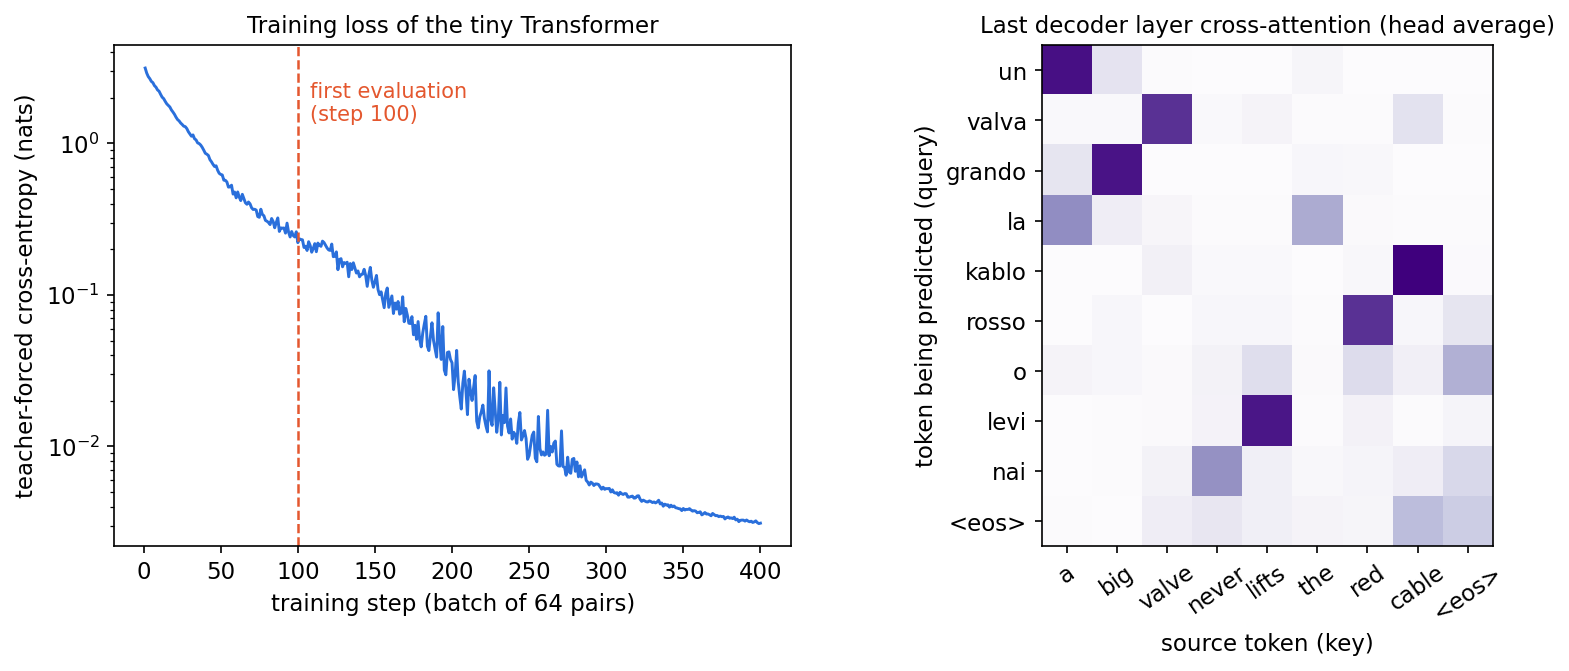
圖 1 的交叉注意力圖,是 Bahdanau 等人為 RNN 翻譯器視覺化的軟對齊的 Transformer 版本 [7]。目標中的形容詞讀取來源中位於名詞之前的形容詞;移到句尾的動詞讀取來源動詞;nai 讀取 never。這個對齊只從翻譯損失中浮現,沒有提供任何對齊標籤。
7. 翻譯跨形式保留意義
直觀說法。 好的譯文會改變用詞與詞序,但保留誰對誰做了什麼、何時、多少,以及事情是否真的發生。
翻譯是具強內容限制的條件生成:保留來源意義,同時產生自然目標語言。詞序、形態、慣用語與隱含上下文,使它不只是逐詞替換。McRoy 翻譯討論 [2] 可搭配 Hagiwara 序列到序列材料 [1]。
應分開評估充分性(adequacy)——來源意義是否保留——與流暢度(fluency)——目標是否自然。流暢譯文可能漏例外、反轉否定或改行動者;字面翻譯則可能保技術內容卻不自然。可接受平衡取決於用途,必須在選模型或指標前指定。
通用翻譯器可用詞彙表保術語,仍要在上下文測試。必需詞可能存在,卻附錯實體;保留數字也不夠,因為值可能重新分配。可測「Pump A 比 Pump B 熱」、「閥門可能保持關閉」、「中午前未偵測到故障」等關係。最小改動揭露比較、模態、否定與時間是否被尊重。
語言標籤與正規化屬於模型契約。繁體與簡體是不同輸出要求;廣泛語言標籤不指定書寫系統、地域術語與標點。存來源前不要破壞性轉換,應並存原文與正規化輸入,讓覆核者追查誤譯。
低資源情況的不確定性可能來自訓練涵蓋有限,而非輸入含糊。報告應記錄領域、方言、文字系統與語言對。短產品描述驗證不代表長技術指令也成立。覆核者不能讀兩語就無法直接評充分性,要使用合格雙語覆核並說明缺口。
保留命題,不只保留詞
翻譯時,把來源與目標當成具有參與者、關係與作用範圍的命題比較。「Pump A is warmer than Pump B」必須保留比較方向。譯文即使含兩個名稱與「較熱」,仍可能反轉方向。「No sensor exceeded the limit」也不同於「Not every sensor exceeded the limit」:後者允許部分超標。NLP 12 說明這兩種否定範圍為何不同。
有時歧義原本就在來源。May 可依脈絡表示可能或許可。如果孤立句子無法決定,把它譯成明確表示許可的說法,就新增了解讀。有周邊文件或對話上下文時應利用;否則保留或標明歧義。目標流暢,不足以合理化任意決定未充分指定的來源。
以意義為中心的比較,可逐項檢查實體綁定、事件狀態、數量、單位、否定與條件,再評整體可讀性。這允許詞彙變化,同時揭露命題改變,也能區分真正誤譯與來源已有的歧義:因缺來源脈絡造成的標註分歧,不能當成某個詞彙選擇就能修好模型的證據。
8. 聊天機器人:把對話當成序列到序列
直觀說法。 聊天機器人可以像翻譯器一樣建構:「來源」是目前為止的對話,「目標」是下一個回覆。這適合流暢閒聊,但任務助理還需要追蹤已經決定了什麼。
Vinyals 與 Le 在 IT 服務台資料集與電影字幕上訓練序列到序列模型,從先前回合預測下一回合;他們發現,即使最佳化的概似目標並不直接量測對話品質,模型仍能進行簡單對話 [23]。Li 等人觀察到這類模型傾向產生「I don’t know」之類安全、通用、與輸入無關的回覆,並提出偏好針對訊息內容回覆的最大互資訊目標 [24]。這個教訓延續到現代助理:高機率回覆不一定有資訊量,也不一定正確。
回覆生成可寫成 ,其中 是下一個系統話語、 是選定歷史、 是任務狀態、 是證據、 是模型參數。條件分布說明生成器收到什麼,不保證它遵守每個欄位或證據。
任務導向對話有明確結果:形成查詢、完成類似預約的紀錄、找正確觀察或產生指定報告。開放交談的目標較不明確,可接受回覆也更多。兩者都需要一致性,成功標準卻不同。模組化任務系統分開理解、狀態追蹤、政策、證據存取與文字實現,讓錯誤容易定位。端到端系統可整合這些功能,但仍要測出錯狀態與措辭問題的差別。Deriu 等人 [25] 與 Ni 等人 [26] 的綜述描述更廣的設計與評估家族。
任務政策可選澄清、查詢、解釋或拒絕不支援操作,再由生成器說出這個動作。這讓對話流暢度不決定查詢是否準備好。開放交談受益於彈性語言,但角色風格不能覆蓋事實一致性。系統可能很吸引人,卻編造過去互動,或暗示未發生的動作已完成。對話主張要對實際紀錄檢查,外部主張則對證據檢查。
9. 回合、對話行為與狀態
直觀說法。 對話是一個持續變化的共享問題。最新一句可能取代先前請求、回指先前事物,或修正系統。系統必須追蹤哪些被提議、哪些真正被接受。
對話回合是參與者在交談某時點的貢獻。它的功能,也就是對話行為(dialogue act),可以是請求、回答、修正、確認或澄清。同一表面詞依待回答問題而有不同功能:「週二」可能提供日期,也可能修正原日期。
任務導向對話狀態儲存繼續任務所需資訊。設備查詢助理的欄位可包含裝置、時間區間、測量項目與輸出語言。值應連同來源回合、信心與狀態儲存。未知、明確不存在與不適用,不能全部壓成同一個空字串。狀態更新可寫成:
其中 是回合 後的狀態; 是觀察話語或擷取對話行為; 指出說話者與其他回合脈絡; 是更新規則; 是下一系統動作; 是狀態到動作的政策。狀態不一定是單一確定紀錄,政策也不一定直接生成文字。
提案與已接受狀態應分開。使用者可以要求選項、檢視再改變。系統建議出現在逐字稿,不代表成為使用者偏好。修正需要範圍:「其實要 Pump B」可只換裝置而保留時間;「重新開始」可能清除整個任務;「不是昨天」否定值卻未必提供替代。
含修正測試的確定性狀態追蹤器
對狹義任務,結構化追蹤器是有用基準,揭露語言理解與動作選擇的契約。範例消費的是已擷取事件,不主張能理解任意自然語言。狀態儲存選定欄位與修訂編號。任何接受的欄位變更,都讓先前確認失效;確認只對明確展示給使用者的版本有效,避免舊的「是」授權新變更提案。
程式碼 · Python · 38 行
from copy import deepcopy

initial = {"device": None, "period": None, "revision": 0, "confirmed": None}
def update(state, event):
    result = deepcopy(state)
    kind = event["kind"]
    if kind == "set":
        slot, value = event["slot"], event["value"]
        allowed = {"device": {"pump_a", "pump_b"}, "period": {"today", "yesterday"}}
        if slot not in allowed or value not in allowed[slot]:
            raise ValueError("Unsupported slot or value")
        if result[slot] != value:
            result[slot] = value
            result["revision"] += 1
            result["confirmed"] = None
    elif kind == "confirm":
        if event["revision"] != result["revision"]:
            raise ValueError("Confirmation refers to an old proposal")
        if any(result[k] is None for k in ["device", "period"]):
            raise ValueError("Cannot confirm incomplete state")
        result["confirmed"] = result["revision"]
    else:
        raise ValueError("Unsupported event")
    return result
s1 = update(initial, {"kind": "set", "slot": "device", "value": "pump_a"})
s2 = update(s1, {"kind": "set", "slot": "period", "value": "today"})
s3 = update(s2, {"kind": "confirm", "revision": 2})
s4 = update(s3, {"kind": "set", "slot": "device", "value": "pump_b"})
print("Before correction:", s3)
print("After correction:", s4)
assert initial["device"] is None
assert s3["confirmed"] == 2 and s4["confirmed"] is None
try:
    update(s4, {"kind": "confirm", "revision": 2})
except ValueError:
    pass
else:
    raise AssertionError("Stale confirmation was accepted")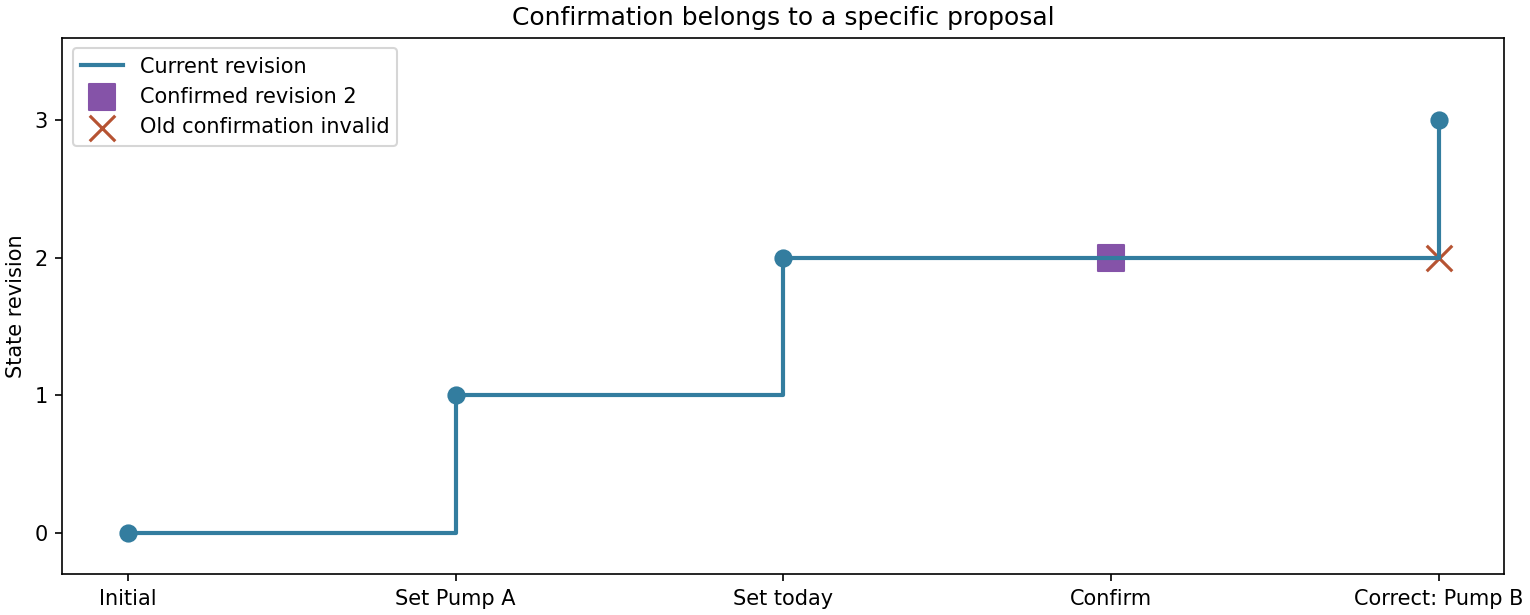
複製保留先前狀態,方便檢查與測試。真實系統也需要事件 ID,避免重複傳遞把更新套兩次。保存來源回合與剖析事件,才能追溯語言理解或狀態邏輯錯誤。欄位缺少不等於否定:「沒有發生故障」填入故障狀態,未提故障則仍未知。允許值有限,讓基準涵蓋範圍清楚。通用系統可使用學得欄位擷取與開放詞彙,但仍要驗證單位、結構與來源。模型信心不能代替合法值。
10. 信念狀態與有效澄清
直觀說法。 話語含糊時,保留幾個帶機率的解讀,而不是直接猜。再依錯誤動作的代價,決定要行動還是提問。
簡單貝氏更新為:
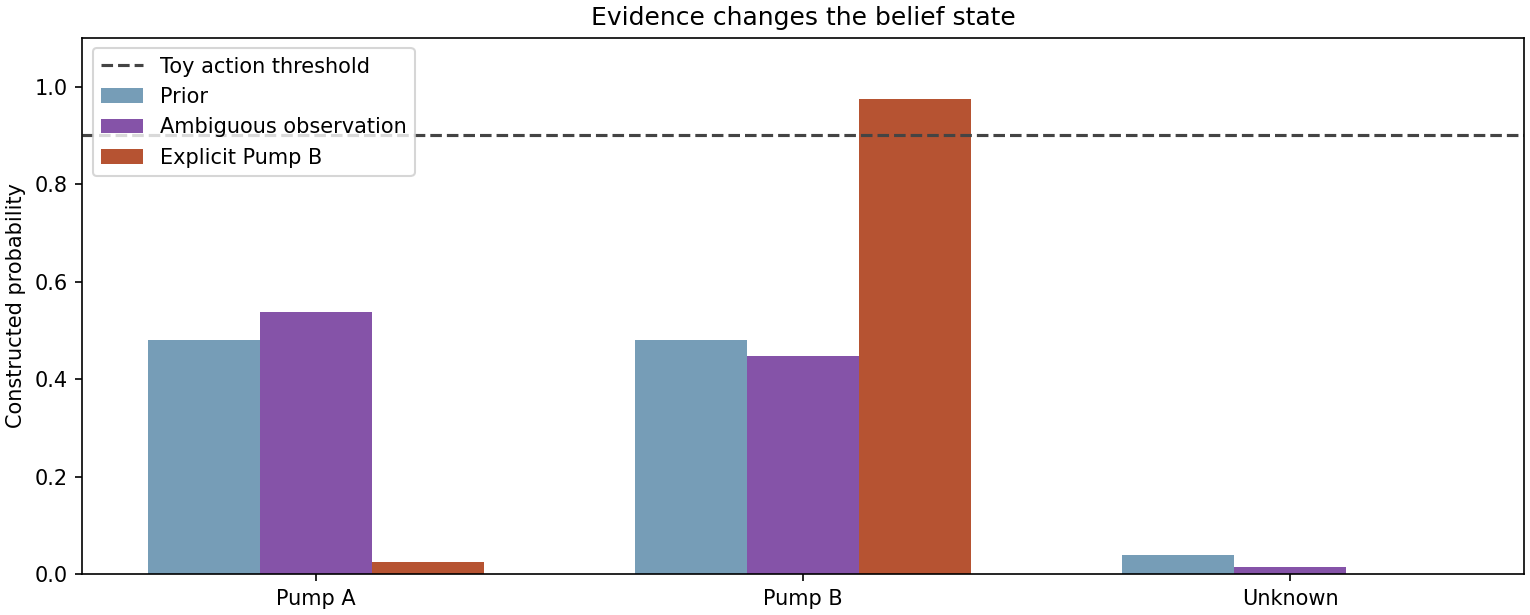
其中 是候選解讀; 是先前機率; 是新觀察; 是該解讀下的觀察概似;分母對候選 正規化。簡化更新假設固定假說空間與已指定觀察模型。任務變動需要轉移模型或明確修正操作,不能反覆把每句話當獨立證據。
程式碼 · Python · 17 行
import numpy as np

hypotheses = ["pump_a", "pump_b", "unknown"]
prior = np.array([0.48, 0.48, 0.04])
ambiguous_likelihood = np.array([0.6, 0.5, 0.2])
posterior = prior*ambiguous_likelihood
posterior /= posterior.sum()
print("After ambiguous evidence:", dict(zip(hypotheses, posterior.round(3).tolist())))
action = "clarify" if posterior.max() < 0.9 else "query"
assert action == "clarify"
# A second synthetic observation explicitly names Pump B.
named_likelihood = np.array([0.02, 0.95, 0.03])
updated = posterior*named_likelihood
updated /= updated.sum()
print("After explicit naming:", dict(zip(hypotheses, updated.round(3).tolist())))
assert updated[1] > 0.9
assert np.isclose(updated.sum(), 1)
概似是教學設定,不是校準模型分數或量測的人類行為。學得系統需要驗證校準與分布轉移下的不確定性。保留未知假說,也避免封閉清單假裝每個真實請求都指已知裝置。
決策理論政策最小化期望損失:。其中 遍歷允許動作, 是解讀 為真時執行動作 的代價。對候選問題 ,一步期望損失為:
其中 是提問後的期望損失, 是提問成本, 遍歷可能回答, 是目前信念下的回答機率, 是收到回答後對解讀 的後驗, 遍歷後續動作, 是動作損失。最小值假定系統收到回答後選擇最佳下一步。應將 與直接動作的最小期望損失比較。這個有限決策計算是教學模型,不是已校準的人類回答模型。
程式碼 · Python · 16 行
import numpy as np

prior = np.array([0.55, 0.45])  # true device A or B
reply_given_device = np.array([[0.8, 0.2], [0.2, 0.8]])
question_cost = 1.0
for wrong_cost in [10.0, 2.0]:
    immediate = wrong_cost * (1 - prior.max())
    expected_after_question = question_cost
    for reply in range(2):
        mass = prior * reply_given_device[:, reply]
        probability = mass.sum()
        posterior = mass / probability
        expected_after_question += probability * wrong_cost * (1 - posterior.max())
    action = 'clarify' if expected_after_question < immediate else 'query A'
    print(wrong_cost, round(immediate, 2), round(expected_after_question, 2), action)
assert np.allclose(reply_given_device.sum(axis=1), 1)
輸出在錯誤查詢成本 10 時,比較 4.5 與 3.0,選擇澄清;成本 2 時,比較 0.9 與 1.4,直接查詢 A。信念與問題沒有改變,錯誤後果卻改變最佳動作。固定信心門檻隱藏這個依賴;期望損失則把它說清楚。應問能區分重要不確定性的問題:只有裝置含糊時,不要再問已確定的時間。
修正還需要另一個區分。「Actually, Pump B」可能改變指定裝置,而不是提供 Pump B 從頭就是意圖的證據。舊信念針對較早狀態,新話語則改變狀態本身。機率追蹤器除了觀察概似,也需要狀態轉移;或使用能辨認修正的明確更新規則。
11. 上下文、記憶與工具邊界
直觀說法。 長對話放不進、也不需要放進每次模型輸入。保留下來的內容必須保留狀態:已撤回的請求不是有效請求。聊天機器人能呼叫工具時,「我做了」必須有實際結果支持。
可把上下文分為近期回合、結構化任務狀態與檢索證據。近期回合支持局部指涉與語氣;狀態保留已接受欄位及未解問題;證據支持事實主張。摘要不能把未驗證模型回覆升格為權威證據。有用記憶包含值、來源、時間、範圍與狀態(提議、接受或撤回)。滑動視窗可能只留「是」,卻刪了被確認的提案;摘要可能留某裝置,卻漏掉它已被另一裝置替換。應用合成對話測兩者,將重建狀態與明確事件紀錄比較。
工具連接的對話系統產生可由軟體執行的提案。提案、執行與結果是不同事件。「我查了資料庫」應由成功查詢結果支持,不能只是模型生成了查詢描述。工具學習研究討論基礎模型規劃、選工具、組參數及使用回饋 [27]。應用只應透過明確結構暴露允許操作,執行前驗證工具與參數,再把結果狀態及證據 ID 加入狀態。
唯讀證據也可能含命令文字。操作手冊可引用指令,檢索對話可含另一人的請求;它們仍是來源內容,不應更新當前使用者任務或擴大允許操作。結果要區分成功、沒有匹配觀察與執行錯誤;全部寫成一般流暢答案,會抹掉理解實際過程需要的資訊。重試唯讀查詢可能合理,重複改外部狀態的操作可能產生第二次效果,因此應在軟體中記錄請求 ID 與執行狀態,而不是靠語言模型記得。
12. 評估完整對話,不只一個回覆
直觀說法。 看起來正確的回覆可能隱藏錯欄位、過期記憶或從未執行的動作。應跨完整對話量測狀態與最終結果。
Deriu 等人的綜述 [25] 說明任務對話、開放交談與互動問答為何需要不同評估方法。對指定欄位集合 ,定義精確狀態準確率:
其中 是評估回合數; 是回合 的參考欄位 ; 是預測值; 在全部選定欄位匹配時為一,否則為零。嚴格指標揭露大量空值或簡單欄位平均所隱藏的錯誤。要指定欄位集合與未知值處理。
程式碼 · Python · 20 行
reference = [
    {"device": "pump_a", "period": None},
    {"device": "pump_a", "period": "today"},
    {"device": "pump_b", "period": "today"},
]
predicted = [
    {"device": "pump_a", "period": None},
    {"device": "pump_a", "period": "today"},
    {"device": "pump_a", "period": "today"},
]
slots = ["device", "period"]
joint = sum(all(p[j] == r[j] for j in slots)
            for p, r in zip(predicted, reference))/len(reference)
slot_accuracy = sum(p[j] == r[j] for p, r in zip(predicted, reference)
                    for j in slots)/(len(reference)*len(slots))
print("Exact state accuracy:", joint)
print("Per-slot accuracy:", slot_accuracy)
assert joint == 2/3 and slot_accuracy == 5/6
# The final device is wrong despite many correct fields.
assert predicted[-1]["device"] != reference[-1]["device"]
任務成功應檢查最終所求,不只看長度或親切風格。本例要求裝置、時間與證據正確,並尊重修正。短對話若查錯裝置,不是有效率的成功。以參考回覆計算 BLEU 在這裡並不合適,理由與翻譯相同,而且對話可接受的回覆更多,問題更嚴重。
人類評估要展示足夠歷史、指定判斷工作。只看最後回覆,無法判斷是否尊重修正。應隨機化並隱藏系統身分,定義錯誤類型並保留歧見。Schmidtova 等人 [28] 說明明確幻覺定義與方法報告為何重要。按對話切分資料,避免相鄰回合散落在訓練與測試;在對話層級回報不確定性,因為同一對話中的回合彼此相依。
現代觀點
直觀說法。 翻譯與對話都走向大型預訓練模型,但本章的評估問題變得更重要,而不是更不重要。
綜述。 Stahlberg 在 Journal of Artificial Intelligence Research(2020)的回顧,從詞與句子嵌入及早期編碼器—解碼器,追溯神經機器翻譯到注意力與 Transformer,最後綜述近期趨勢 [22]。它是第 1–4 節材料最好的單一地圖。對話方面,Ni 等人的系統性綜述(Artificial Intelligence Review,2023)依模型與系統類型整理深度學習對話系統;任務導向與開放領域的區分,解釋為何一個回覆指標不能描述所有對話 [26]。Deriu 等人 [25] 把評估方法對應到這些系統類型。Qin 等人關於基礎模型工具學習的綜述(ACM Computing Surveys,2024)提醒我們,除了文字品質,也要檢查參數構造與結果使用 [27]。
2023–2026 最新進展。 WMT 記錄了大型語言模型進入翻譯的過程:WMT24 一般任務結果以專業人工標註,評估數個 LLM、參賽機器翻譯系統與線上服務,標題道出了平衡點:「LLM 時代已經到來,但機器翻譯尚未解決」[20]。NLLB 等大規模多語模型把涵蓋擴展到 200 種語言,明確以低資源語言為目標 [21]。評估方面,WMT22 指標任務發現,以專家 MQM 判斷為準時,神經指標比重疊指標可靠 [18];WMT25 結果則把系統排名與片段層級錯誤偵測分開 [19]。
| 設計面向 | 要比較的選擇 | 需要的證據 |
|---|---|---|
| 架構 | 編碼器—解碼器、僅解碼器、多語 | 各語言對與領域的保留資料品質 |
| 解碼 | 貪婪、帶長度正規化的束搜尋、取樣 | 完整性、長度與語意錯誤,而不只是模型分數 |
| 評估 | BLEU/chrF(附簽章)、學得指標、MQM 式人工覆核 | 與應用失敗類別的一致性 |
| 對話狀態 | 端到端生成、明確狀態與政策 | 狀態準確率、修正恢復、最終任務成功 |
| 工具使用 | 自由形式主張、附結果的已驗證提案 | 實際執行結果與回報結果一致 |
開放問題。 低資源與方言翻譯、文件層級一致性、在罕見但關鍵的錯誤(否定、數字、名稱)上評估指標、可靠地自動接受個別輸出、任務變動下對話狀態的校準、多語修正,以及長對話中的過期記憶。較高的語料分數與流暢回覆都很容易取得;需要證據的是意義是否保留、最終動作是否正確。
重點整理
- SMT 結合分別估計的翻譯模型與語言模型;NMT 端到端訓練一個編碼器—解碼器,Transformer 讓它完全以注意力為基礎。
- 位移目標、保留結束詞元,在注意力與損失中都遮蔽填補;教師強制以正確前綴訓練,所以要在模型自己生成的輸出上測試(曝光偏差)。
- 貪婪與束搜尋以不同的搜尋量最佳化模型分數;長度正規化改變哪個假說勝出;兩者都修不好錯誤的模型。
- BLEU 是語料層級的截限 n-gram 精確率加短度懲罰;回報 sacreBLEU 簽章、加上 chrF 或學得指標,並直接檢查關鍵意義錯誤。
- 微型 Transformer 幾秒內就學會字典翻譯與詞序調整,它的交叉注意力在沒有監督下重現了對齊。
- 聊天機器人可以是 seq2seq 模型,但任務對話需要帶修訂的明確狀態、對含糊解讀的信念,以及依期望損失選擇的澄清。
- 讓工具提案、執行與結果保持分開,並以狀態與最終結果評估完整對話。
練習
- 組合測試。 在翻譯器程式碼中,移除所有
red修飾cable的訓練句對,再用含red cable的句子測試。比較這些句子與一般測試集的完全匹配率。
提示
在建立 S 與 Y 之前過濾 train_pairs,並保持詞彙表不變,讓失敗反映的是組合而不是未知詞。看看失敗案例的交叉注意力圖。
- 束寬與長度。 用束寬 1、2、4、8 及 評估 100 步的檢查點。回報 BLEU、完全匹配率、平均輸出長度與平均對數機率。較高的模型分數何時沒有改善 BLEU?
提示
束寬 1 且 就是貪婪解碼。保存輸出並比較改變的句子,而不只是平均值。
- 翻譯挑戰集合。 寫六個原創來源句,測否定、比較、單位、模態、時間與含糊指涉,指定任何可接受譯文都必須保留的意義。
提示
用加入 not 或交換裝置名等最小改動。來源充分性應獨立於目標是否優美。
- 指標分歧。 建立兩個候選譯文:一個詞重疊高卻數量錯,另一個重疊較低卻意義正確。用 BLEU 函數評分,並設計能顯示差別的標註表。
提示
先請覆核者標出無支持的數量與遺漏的必需事實,再給整體判斷。保留來源,隱藏系統身分。
- 修正範圍。 在追蹤器加測量欄位,測只改裝置、否定時間與完全重啟,不默默改不相關欄位。
提示
分別定義設定、撤回與重設事件。提案改變,就要使前一修訂的確認失效。
- 錯誤動作報告。 設計區分查詢成功、無匹配與執行失敗的證據結構,寫出各狀態的回覆要求,並為每種狀態寫一段測試對話。
提示
結果附執行 ID 與狀態。生成提案本身不能支持「查詢成功」。
參考文獻
- M. Hagiwara, Real-World Natural Language Processing, Manning, 2021, Chapters 6 and 8. Book · Sequence-to-sequence chapter
- S. McRoy, Principles of Natural Language Processing, open textbook, 2021, Chapter 9. Book · Generation chapter
- P. F. Brown, S. A. Della Pietra, V. J. Della Pietra and R. L. Mercer, “The Mathematics of Statistical Machine Translation: Parameter Estimation,” Computational Linguistics 19(2), 1993. Paper
- P. Koehn, F. J. Och and D. Marcu, “Statistical Phrase-Based Translation,” HLT-NAACL, 2003. Paper
- K. Cho, B. van Merriënboer, C. Gulcehre, D. Bahdanau, F. Bougares, H. Schwenk and Y. Bengio, “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation,” EMNLP, 2014. Paper
- I. Sutskever, O. Vinyals and Q. V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper
- D. Bahdanau, K. Cho and Y. Bengio, “Neural Machine Translation by Jointly Learning to Align and Translate,” ICLR, 2015. Paper
- A. Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. Paper
- R. Sennrich, B. Haddow and A. Birch, “Neural Machine Translation of Rare Words with Subword Units,” ACL, 2016. Paper
- M. Ranzato, S. Chopra, M. Auli and W. Zaremba, “Sequence Level Training with Recurrent Neural Networks,” ICLR, 2016. Paper
- S. Bengio, O. Vinyals, N. Jaitly and N. Shazeer, “Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks,” NeurIPS, 2015. Paper
- Y. Wu et al., “Google’s Neural Machine Translation System: Bridging the Gap between Human and Machine Translation,” arXiv:1609.08144, 2016. Paper
- K. Papineni, S. Roukos, T. Ward and W.-J. Zhu, “Bleu: a Method for Automatic Evaluation of Machine Translation,” ACL, 2002. Paper
- M. Post, “A Call for Clarity in Reporting BLEU Scores,” WMT, 2018. Paper
- M. Popović, “chrF: character n-gram F-score for automatic MT evaluation,” WMT, 2015. Paper
- R. Rei, C. Stewart, A. C. Farinha and A. Lavie, “COMET: A Neural Framework for MT Evaluation,” EMNLP, 2020. Paper
- C.-Y. Lin, “ROUGE: A Package for Automatic Evaluation of Summaries,” Text Summarization Branches Out, 2004. Paper
- M. Freitag et al., “Results of WMT22 Metrics Shared Task: Stop Using BLEU – Neural Metrics Are Better and More Robust,” WMT, 2022. Report
- A. Lavie et al., “Findings of the WMT25 Shared Task on Automated Translation Evaluation Systems: Linguistic Diversity is Challenging and References Still Help,” WMT, 2025. Report
- T. Kocmi et al., “Findings of the WMT24 General Machine Translation Shared Task: The LLM Era Is Here but MT Is Not Solved Yet,” WMT, 2024. Report
- NLLB Team et al., “Scaling neural machine translation to 200 languages,” Nature 630, 2024. DOI
- F. Stahlberg, “Neural Machine Translation: A Review,” Journal of Artificial Intelligence Research 69, 2020. DOI
- O. Vinyals and Q. V. Le, “A Neural Conversational Model,” ICML Deep Learning Workshop, 2015. Paper
- J. Li, M. Galley, C. Brockett, J. Gao and B. Dolan, “A Diversity-Promoting Objective Function for Neural Conversation Models,” NAACL-HLT, 2016. Paper
- J. Deriu, Á. Rodrigo, A. Otegi, G. Echegoyen, S. Rosset, E. Agirre and M. Cieliebak, “Survey on Evaluation Methods for Dialogue Systems,” Artificial Intelligence Review 54, 2021. Survey
- J. Ni, T. Young, V. Pandelea, F. Xue and E. Cambria, “Recent Advances in Deep Learning Based Dialogue Systems: A Systematic Survey,” Artificial Intelligence Review 56, 2023. Survey
- Y. Qin et al., “Tool Learning with Foundation Models,” ACM Computing Surveys 57, 2024. Author manuscript · Publication
- P. Schmidtova et al., “Do My Eyes Deceive Me? A Survey of Human Evaluations of Hallucinations in NLG,” INLG, 2025. Survey
- C. Szegedy, V. Vanhoucke, S. Ioffe, J. Shlens and Z. Wojna, “Rethinking the Inception Architecture for Computer Vision,” CVPR, 2016. Paper
- M. Freitag, G. Foster, D. Grangier, V. Ratnakar, Q. Tan and W. Macherey, “Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation,” Transactions of the Association for Computational Linguistics 9, 2021. DOI
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 09・以 Transformer 做語言模型(自然語言生成) · 43 分鐘