NLP 05・用於語言的循環神經網路
先備知識:NLP 04・詞彙語意與詞嵌入、ML 04・循環與遞迴神經網路
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 分清楚 n-gram 出現、文件特徵與條件語言模型,並從序列機率推導 unigram、bigram 與 trigram 預測。
- 計算、平滑與內插 n-gram 估計,再解讀保留資料的負對數概似及困惑度。
- 說明固定長度歷史為何造成更多資料也無法移除的記憶上限。
- 寫出 Elman 循環語言模型、其下一詞元交叉熵與困惑度,並說明時間反向傳播、梯度消失、LSTM 與 GRU 單元如何影響模型能學到什麼。
- 以串流打包、截斷時間反向傳播、梯度裁剪與提前停止訓練字元層級 LSTM 語言模型,並與調校過的 n-gram 基準公平比較。
- 以溫度從訓練好的模型取樣,並說明樣本能與不能告訴我們什麼。
先看全貌
語言模型根據前文預測下一個詞元,藉此替文字配置機率。本章建立兩種這樣的模型,並在同一套評估約定下比較。第一種是 n-gram 模型,它使用前文的一小部分預測下一個詞元。機率表可以直接檢查:我們能把預測追溯到訓練次數,並看清楚模型忽略了哪些較早的詞。因此,它適合作為第一個語言模型、受控基準,以及理解更複雜模型也會遇到的統計問題。第二種是循環神經網路(recurrent neural network,RNN),它以一個在每個詞元之後更新的學習狀態取代次數表,因此預測原則上可以依賴整個前綴。
Hagiwara 的語言模型章節把下一詞元預測連到實際文字生成 [1]。McRoy 的教材提供更完整的語言及應用背景 [2]。分詞放在 NLP 01;嵌入及其訓練目標放在 NLP 04。第 1–5 節專注於計數模型本身;第 6–12 節以循環網路取代次數表;以注意力為基礎的模型則在 NLP 07 與 NLP 09 介紹。循環網路的一般數學(完整的時間反向傳播推導、梯度界限、閘門方程式)在 ML 04;這裡採取語言模型的觀點。讀本章時持續追問:哪些資訊與觀察證據決定下一個詞元的機率?
1. 「n-gram」的三種意思
n-gram 是連續 個詞元組成的序列。詞元可以是詞、子詞或字元;分詞方式決定計算的單位。以詞序列 a cat sleeps 為例,unigram 是 a、cat、sleeps;bigram 是 a cat、cat sleeps;trigram 則是 a cat sleeps。
以下三種用途要分清楚:
| 用途 | 儲存或預測的物件 | 能告訴我們什麼 |
|---|---|---|
| n-gram 出現 | 一個連續詞元元組 | 某個序列的局部片段 |
| 文件特徵 | 一個元組在文件中的次數或是否出現 | 提供給分類器或檢索模型的證據 |
| n-gram 語言模型 | 每個保留歷史對應的正規化下一詞元分布 | 用來替序列評分或生成的機率 |
文件的 bigram 特徵 not ready 可以協助分類器區分操作狀態,但它本身沒有指定 not 後面出現 ready 的機率:還需要其他競爭詞元的次數與正規化規則。同樣地,語言模型中的片語機率取決於句子上下文;文件特徵次數通常會合併該片語在整篇文件中的所有出現。
語言模型的階數 包含正在預測的詞元。Bigram 使用前一個詞元,不是前兩個;trigram 使用前兩個。句子邊界需要一致規則:起始標記提供最初上下文,結束標記則是代表停止的預測結果。範例從不預測起始標記;若把它放進預測詞彙表,就會替句子格式不允許的事件配置機率。
2. 精確分解與有限歷史
逐一預測詞元,可以精確表示序列機率。捨棄較早上下文是模型假設,並不是機率理論要求這樣做。
其中 是位置 的詞元; 是預測位置數,若使用結束標記也將它計入; 是完整前綴; 是 n-gram 階數; 是最多包含前 個詞元的尾端歷史,需要時補上起始標記; 是有限歷史模型。第一個等式是鏈式法則,第二個式子則定義只依保留尾端內容預測的模型。它不一定等於真實序列分布。
| 階數 | 在 a cat sleeps 中預測 sleeps 前的上下文 | 條件分布 |
|---|---|---|
| Unigram, | 空歷史 | |
| Bigram, | cat | |
| Trigram, | a cat |
空歷史仍是有效上下文:unigram 模型在每個位置使用同一個下一詞元分布。Bigram 做出更細的區分,卻必須合併所有最後一個詞元相同的前綴。Trigram 可以區分最後兩個詞元不同的前綴,但這些模型都不保證保留內容包含語言依存關係真正需要的資訊。
逐步計算不同階數的差異
下面的教學語料刻意讓冠詞帶有預測資訊:以 the 開頭的範例都以 sleeps 結尾,以 a 開頭的範例都以 eats 結尾。這是受控的統計模式,不是對英語用法的主張。範例使用相同詞彙表及平滑強度,分別估計三種階數。
程式碼 · Python · 31 行
from collections import Counter, defaultdict

train = ["the cat sleeps", "the dog sleeps", "a cat eats", "a dog eats"]
START, END, UNK = "<s>", "</s>", "<unk>"
vocab = sorted({w for s in train for w in s.split()} | {END, UNK})
alpha = 0.2
models = {}
for order in (1, 2, 3):
    rows = defaultdict(Counter)
    for sentence in train:
        tokens = [START] * (order - 1) + sentence.split() + [END]
        for t in range(order - 1, len(tokens)):
            history = tuple(tokens[t-order+1:t])
            rows[history][tokens[t]] += 1
    models[order] = rows

def probability(order, history, word):
    row = models[order].get(tuple(history), {})
    return (row.get(word, 0) + alpha) / (sum(row.values()) + alpha * len(vocab))

for order, rows in models.items():
    for history in rows:
        assert abs(sum(probability(order, history, w) for w in vocab) - 1) < 1e-10
print("vocabulary size:", len(vocab))
print("unigram P(eats):", round(probability(1, (), "eats"), 3))
print("bigram P(eats | cat):", round(probability(2, ("cat",), "eats"), 3))
print("trigram P(eats | a cat):", round(probability(3, ("a", "cat"), "eats"), 3))
print("trigram P(eats | the cat):", round(probability(3, ("the", "cat"), "eats"), 3))
print("unseen-history P(eats):", round(probability(3, (UNK, "cat"), "eats"), 3))
assert probability(3, ("a", "cat"), "eats") > probability(3, ("the", "cat"), "eats")
assert abs(probability(3, (UNK, "cat"), "eats") - 1 / len(vocab)) < 1e-10
輸出:
程式碼 · 6 行
vocabulary size: 8
unigram P(eats): 0.125
bigram P(eats | cat): 0.333
trigram P(eats | a cat): 0.462
trigram P(eats | the cat): 0.077
unseen-history P(eats): 0.125
在 cat 後面,bigram 次數表有一次 eats 與一次 sleeps。兩種冠詞選擇都進入同一張表。Trigram 則把兩筆觀察分開:a cat 曾接過一次 eats,the cat 則沒有。因此 trigram 能表達這個差異,但它的每張表都只有一筆觀察。在這份語料中,更細的條件區分會減少每個上下文可用的證據。
未見歷史沒有任何轉移次數;加法平滑使其成為八個預測詞元上的均勻分布。這是完整的機率分布,卻捨棄了有用證據:最後一個詞元 cat 其實出現在訓練資料中。與低階分布內插,可以保留這項證據。正規化與有效泛化是不同性質。
3. 從次數到正規化機率
要估計分布,先計算訓練中的每個「歷史—目標」事件,再除以該歷史的總轉移次數。讓結果可重現的兩項細節是:哪些符號會被預測,以及哪些上下文被視為不同。
其中 是保留歷史; 是候選下一詞元; 是預測詞彙表; 遍歷詞彙表成員; 是訓練中由 接到 的次數; 是其總數; 是最大概似估計。Trigram 的 是兩個詞元的元組,unigram 則是空元組。若歷史從未出現,這個估計沒有定義。
為什麼觀察相對頻率能解出概似問題?對單一歷史,在機率總和為一的限制下,最大化 的分布,會讓有正次數的事件機率與次數成正比。正規化限制接著使它除以 。不同歷史可以獨立估計,因為計數表沒有在各歷史之間共享參數。
這種簡單性帶來兩種不同問題。未見轉移的歷史曾出現,但目標從未接在後面,因此機率為零;未見歷史則完全沒有次數表,使未平滑比例沒有定義。平滑能在固定詞彙表內處理兩者,卻無法生成已被詞彙表替換成未知標記的原始拼字。
加法平滑替每個可能的目標加上少量正次數:
其中 是平滑後分布; 與 分別是轉移次數及歷史總轉移次數; 是候選詞元; 是保留歷史; 是預測詞彙表; 是其大小; 是加到每個候選次數上的數量。把分子對整個詞彙表加總,恰好得到分母。即使歷史從未出現,分布仍有定義:所有候選都得到機率 。
詞彙表大小與加到單一候選上的次數同樣重要。詞彙表很大時,替每個詞元加上 可能占去大量總機率。在這個微小詞彙表上有效的參數,不能未經驗證就原封不動移用到大得多的詞彙表。
程式碼:訓練、評分與取樣一個 bigram 模型
這個完整範例不需要下載資料或 GPU。語料是為教學編寫的;測試句子與訓練句子分開。測試中任何不在訓練詞彙表內的詞,都對應到同一個未知 token。
程式碼 · Python · 57 行
from collections import Counter, defaultdict
import math
import random

train = [
    "the cat sleeps", "the dog sleeps", "the cat runs",
    "the dog runs", "a cat eats", "a dog eats",
    "the bird sings", "a bird sleeps",
]
test = ["the cat eats", "a dog runs", "the bird sleeps", "a robot runs"]
START, END, UNK = "<s>", "</s>", "<unk>"
words = {w for sentence in train for w in sentence.split()}
vocab = sorted(words | {END, UNK})       # START is context, never predicted
alpha = 0.2
counts = defaultdict(Counter)
unigrams = Counter()

def encode(sentence):
    return [w if w in words else UNK for w in sentence.split()] + [END]

for sentence in train:
    tokens = [START] + encode(sentence)
    for h, w in zip(tokens, tokens[1:]):
        counts[h][w] += 1
        unigrams[w] += 1

def bigram(h, w):
    row = counts.get(h, {})
    return (row.get(w, 0) + alpha) / (sum(row.values()) + alpha * len(vocab))

def unigram(h, w):
    return (unigrams[w] + alpha) / (sum(unigrams.values()) + alpha * len(vocab))

def perplexity(sentences, probability):
    nll, n = 0.0, 0
    for sentence in sentences:
        tokens = [START] + encode(sentence)
        for h, w in zip(tokens, tokens[1:]):
            nll -= math.log(probability(h, w))
            n += 1
    return math.exp(nll / n)

for h in [START] + vocab:
    assert abs(sum(bigram(h, w) for w in vocab) - 1) < 1e-10
print("unigram test perplexity:", round(perplexity(test, unigram), 3))
print("bigram test perplexity:", round(perplexity(test, bigram), 3))
assert UNK in encode(test[-1])

rng = random.Random(7)
h, sample = START, []
for _ in range(20):                     # cap length for this demonstration
    w = rng.choices(vocab, weights=[bigram(h, v) for v in vocab])[0]
    if w == END:
        break
    sample.append(w)
    h = w
print("sample:", " ".join(sample))
輸出:
程式碼 · 3 行
unigram test perplexity: 10.382
bigram test perplexity: 3.573
sample: a bird sings
assert 檢查每一個條件分布加總為一,以及「robot」被對應到未知 token。bigram 模型對測試句子的「驚訝程度」遠低於 unigram 模型,因為詞序帶有資訊。取樣仍可能產生彆扭的字串:機率大於零不代表合乎文法。長度上限只是讓示範停下來,並不改變評分所用的機率。
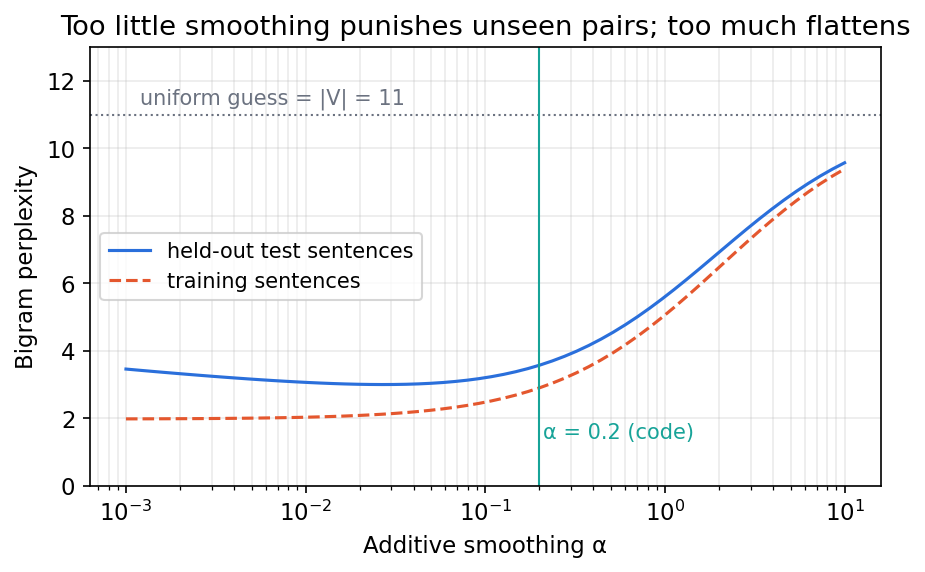
分清楚平滑與更長的記憶
平滑處理的是既定表示下尚未觀察到的轉移,無法補回已捨棄的歷史。在 “the technician did not repair the” 與 “the technician repaired the” 之後,bigram 都只看見 the。即使更早的詞會讓不同延續較合適,它仍必須給出相同的下一詞元分布。增加語料可以更準確地估計這個共同分布,卻不會改變兩者必須相等的限制。
加法平滑也有精確的混合解釋。對觀察次數大於零的上下文:
其中 是平滑後的分布, 是保留的歷史, 是候選詞元, 是該轉移的觀察次數, 是從此歷史出發的總次數, 是未平滑估計, 是平滑參數, 是詞彙表大小, 則是觀察資料的權重。計數為零的上下文直接使用均勻分布。
相同的平滑參數對罕見上下文影響較大,對常見上下文影響較小。上下文次數增加時,觀察證據得到較大的權重;平滑強度增加時,機率則移向均勻分布。這解釋了保留資料曲線為何可能先改善再惡化:保護未見轉移的同時,最終也會稀釋有用的已知差異。應以驗證資料選擇參數,不要使用最終測試集調整。
分詞器與未知詞元規則也是實驗的一部分。把多個未見詞映射成同一標記,會合併它們的機率。這樣得到的較低困惑度,可能部分來自較容易預測的符號集合,並不表示模型能辨識那些原始詞語。
內插不同歷史長度的證據
長上下文很少見時,較短上下文通常有更多觀察。內插會結合它們的完整分布,而不是給每個未見延續相同的機率。
其中 是最近兩個詞元; 是下一詞元; 是正規化的 trigram、bigram 與 unigram 分布; 是混合分布; 是第 階的非負權重。每個成分都必須對查詢歷史有定義,例如先透過平滑處理。把所有候選詞元的機率加總會得到一,因為各成分分布總和為一,權重也總和為一。
對前面小範例的未見上下文,即使完整的兩詞元歷史缺少觀察,混合仍可以使用 cat 後面已觀察到的 bigram。固定混合權重容易檢查;隨歷史改變的權重則可以更信任證據充分的長上下文。以驗證文字選擇權重。若在檢查最終測試困惑度後才決定權重,就讓那個分數參與了模型選擇。
內插與「只有轉移缺少時才替換成較短歷史」不同。這類退回(back-off)規則還必須考慮已配置給觀察轉移的機率,才能讓完整分布保持正規化。Chen 與 Goodman 的比較研究檢視不同平滑選擇及實驗行為 [4]。本章的加法與混合範例用來揭示運作方式,沒有實作該研究中的每一種估計方法。
4. 保留資料困惑度量測什麼?
評分量測模型給觀察目標多少機率。好分數代表:在指定分詞器與詞彙表下,這些特定詞元序列讓模型比較不驚訝;它不能證明事實正確或理解能力。
其中 是評分詞元位置數; 遍歷所有評估句子的這些位置; 是觀察目標; 是允許使用的歷史; 是被評估的模型; 是每詞元以 nat 為單位的平均負對數概似; 是困惑度(perplexity)。乘積形式顯示,困惑度是目標機率倒數的幾何平均,並不是每個位置合理延續的個數。
假設每個觀察目標都得到機率 ,困惑度就等於 ,其中 是這個假設分布中等可能選項的數目。實際預測不是均勻的:一個難以預測的目標可能造成很大的對數損失,許多容易目標則貢獻很少。只報平均值,可能掩蓋集中在罕見名稱或陌生領域的失敗。也應依詞頻與句型檢查損失。
跨批次彙整時,先加總各批次的總負對數概似,再除以總評分詞元數,最後取指數。直接平均批次困惑度,或對未加權的批次平均損失取指數,一般都不等於整個語料的困惑度。後者只有在各批次評分詞元數相同時才正確;填補與較短的最後一批很容易破壞此假設。以下合成計算直接來自上面的定義:
程式碼 · Python · 10 行
import math

# Synthetic evaluation batches: 2 targets of probability 1/2, then 8 of 1/4.
counts = [2, 8]
mean_nll = [math.log(2), math.log(4)]
corpus_ppl = math.exp(sum(n * loss for n, loss in zip(counts, mean_nll)) / sum(counts))
print('token-weighted perplexity:', round(corpus_ppl, 3))
print('mean batch perplexity:', round(sum(math.exp(loss) for loss in mean_nll) / 2, 3))
print('exp of mean batch loss:', round(math.exp(sum(mean_nll) / 2), 3))
assert math.isclose(corpus_ppl, (2**2 * 4**8)**(1 / 10))
輸出
token-weighted perplexity: 3.482
mean batch perplexity: 3.0
exp of mean batch loss: 2.828
Bigram 程式計入結束標記,因此停止同時屬於訓練及評估問題;起始標記則不計入。Unigram 與 bigram 結果可以比較,因為測試文字、分詞、未知映射及評分位置數一致。詞分詞器與字元分詞器的比較則有不同單位;即使原始句子相同,分數分母與預測符號集合也可能改變。
訓練、驗證與測試文字有不同角色。訓練決定詞彙表及次數;驗證選擇階數與平滑;測試則對選定流程評估一次。保留資料中未見於訓練的拼字,必須遵循固定未知規則。把測試文字納入重建詞彙表,會悄悄改變實驗。不同切分之間的重複句子或複製內容,也可能讓記住的局部延續看起來像泛化。
5. 生成、停止與記憶上限
生成反覆從正規化的下一詞元分布取樣,將取樣結果加入歷史,並在結束標記出現時停止。評分則由待評估文字提供觀察歷史。相同機率表支援兩種程序,但一種檢查提供的文字,另一種產生隨機軌跡。
示範輸出 a bird sings 只是固定隨機種子下的一次取樣,不是具代表性的品質估計。應檢查多個獨立種子的軌跡,並記錄局部錯誤及異常長的序列。長度上限保證程式停止執行;若在結束標記之前碰到上限,顯示的序列只是被截斷,並非模型完成的一個句子。
每一步選擇機率最大的詞元,會得到確定性的貪婪軌跡。這通常不會最大化整個序列的機率:局部看似有利的詞元,可能導向較差的後續延續。另一方面,取樣保留分布的多樣性,卻也可能選到低機率轉移。因此,生成選擇與模型是否給保留文字配置良好機率,是不同問題。
更多訓練也無法消除的失敗
考慮 the robot near the cabinets is 與 the robots near the cabinet are。一致關係取決於主詞中心語,不只是緊鄰動詞之前的名詞。若相關中心語在保留尾端之外,模型就會合併需要不同一致選擇的例子。更多觀察能改善合併估計,卻無法讓估計依賴模型輸入之外的詞元。
只要兩個前綴的最後 個詞元相同,n-gram 模型的下一詞元分布就必須完全相同。這是架構上的等式,不是實驗趨勢。提高 會把記憶上限往後推,但可能歷史的數目與次數表的稀疏程度也會增加。共享的神經表示可以連結相似上下文,實際行為仍需要測試;光是替換次數表,並不能證明模型學會了一致關係。
6. 循環語言模型
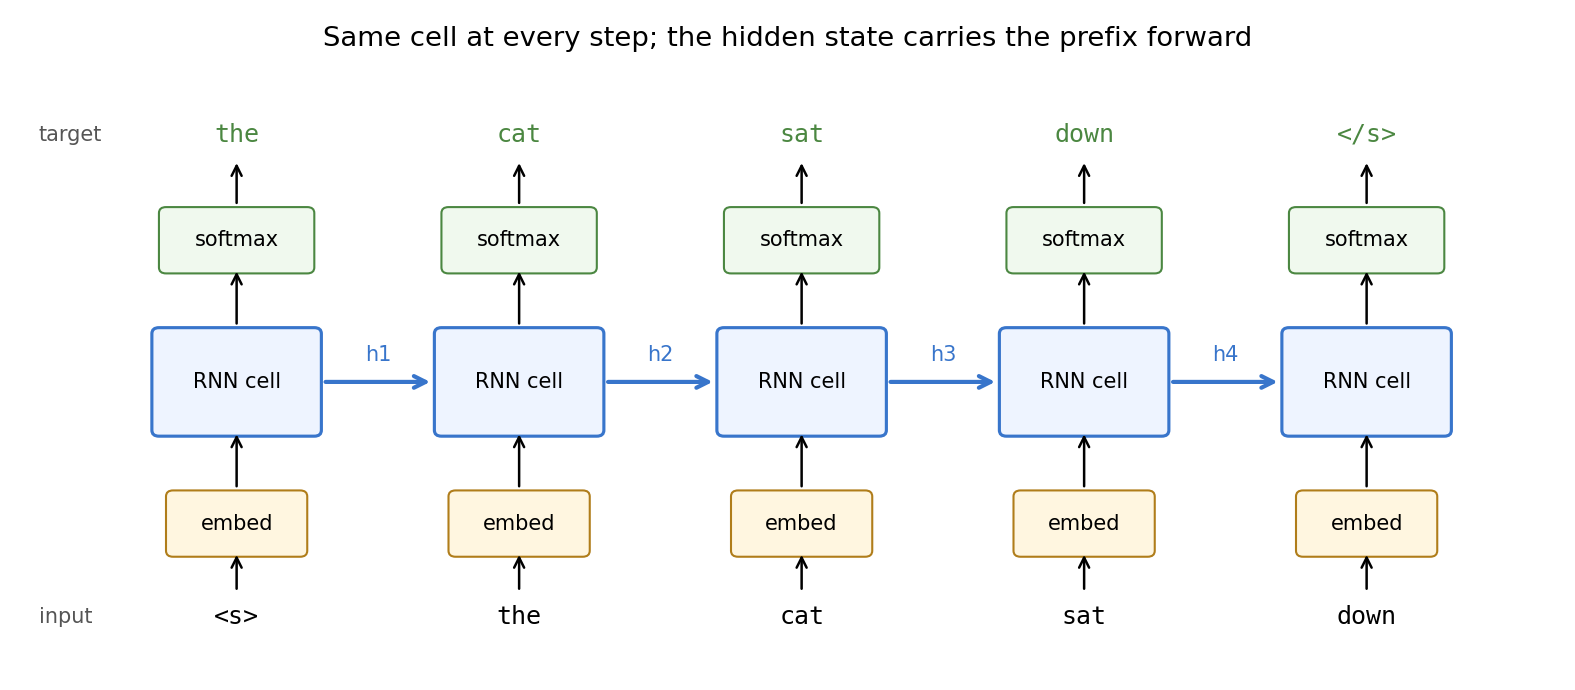
白話版。 n-gram 模型在表格中查找歷史。循環語言模型則一次讀一個詞元,並保留一個固定大小的向量,也就是隱藏狀態(hidden state),在每個詞元之後更新。下一詞元分布由這個狀態計算,因此模型不再被迫忘記 個詞元之前的所有內容。
Elman 的簡單循環網路提出把狀態回饋為下一步輸入的想法 [6];Mikolov 等人則證明,訓練成詞層級語言模型的循環網路,在語音辨識上可以勝過強大的平滑 n-gram 基準 [7]。第 2 節的鏈式法則完全不變,改變的只有條件分布。對有起始標記 的詞元序列 :
其中 是詞元 的嵌入(學習表格中的一列,如 NLP 04 所述); 是讀完 後的隱藏狀態;、 與 是循環參數; 與 把狀態對應到每個詞彙項目 的分數 ; 是預測詞彙表, 遍歷其成員; 收集所有參數; 逐元素作用。這與 ML 03A 的遞迴式相同,只是輸入改寫成嵌入,輸出改成整個詞彙表上的 softmax。
由方程式可直接得到三個結果。
- 條件不受限,記憶有上限。 是整個前綴的函數,因此最後 個詞元相同的兩個前綴可以得到不同預測。但 只有 個數字。模型必須學會保留什麼;沒有任何保證它會保留某個依存關係所需的資訊。
- 參數共享。 每個位置都使用相同的 、 與 。參數量不隨上下文長度增加,而 n-gram 可能歷史的數目以 成長。
- 透過相似性泛化。 相似的詞元得到相似的嵌入,相似的前綴可以產生相似的狀態。未見歷史不再退回均勻的一列:它被對應到某個狀態,而由該狀態做出的預測可以重用相似歷史教給模型的內容。
訓練損失是下一詞元交叉熵
訓練最小化的量,正是第 4 節用於評估的量,只是現在寫成 的可微函數:
其中 是受監督的目標位置數(排除填補及其他忽略位置), 是位置 的觀察目標, 是其前綴, 把 nat 換算成 bit。每個位置的項,是 one-hot 目標與模型 softmax 分布之間的交叉熵;IT 01 說明交叉熵及其與編碼長度的關係。字元層級的研究常以每字元位元數(bits per character)取代困惑度;兩者攜帶相同資訊。
計數模型的兩項實作細節在這裡仍然適用。第一,位移一格:輸入序列是 ,目標序列是 。若把同一位置的詞元同時當作輸入與目標,就會產生瑣碎的複製捷徑。第二,教師強制(teacher forcing):訓練時每一步收到觀察到的前一個詞元,而不是模型自己較早的取樣。生成時,模型的取樣成為它的輸入,錯誤可能自我累積。因此,訓練損失與取樣行為需要分別檢查,正如第 5 節對 n-gram 模型的論證。
7. 時間上的訓練:梯度能到達哪裡
白話版。 把遞迴展開後,模型成為一個權重共享的極深網路。某個預測的梯度必須穿過每一個中間步驟,才能到達本應影響它的詞元。距離很長時,梯度往往縮小到幾乎為零,或者較少見地爆炸。
時間反向傳播(backpropagation through time,BPTT)把一般反向傳播套用到展開後的計算圖,並把每個共享權重的梯度貢獻加總 [8]。較晚狀態對較早狀態的敏感度,是一步 Jacobian 的有序乘積:
其中 是位置, 逐元素平方, 以 導數組成對角矩陣。當各因子的範數通常小於一時,乘積隨距離 指數衰減(梯度消失);大於一時則可能指數成長(梯度爆炸)。Bengio、Simard 與 Frasconi 分析了為何以梯度下降學習長期依存關係很困難 [9];Pascanu、Mikolov 與 Bengio 重新檢視這個問題,並推廣以裁剪梯度範數處理爆炸 [10]。ML 03A 完整推導並量測了這些結果。
這對語言代表什麼?回到第 5 節的一致關係例子:在 the robots near the cabinet are 中,動詞取決於往前四個詞的 robots,而中間的名詞指向另一個方向。普通 RNN 能夠表示記住複數主詞的狀態,但教它這麼做的訓練訊號,必須從 are 一路傳回 robots。在詞層級只有幾步;在字元層級,同一個依存關係大約跨越二十步。因此模型可能有足夠容量表示某個依存關係,卻仍學不會它;這與 n-gram 的架構上限是不同的失敗。
8. 閘控單元:LSTM 與 GRU
白話版。 閘控單元加入一條主要以加法更新、並由學習開關控制的記憶路徑。資訊與梯度因此可以跨越許多步,而不必在每一步都被壓縮。
Hochreiter 與 Schmidhuber 的長短期記憶(long short-term memory,LSTM)單元 [11],加上 Gers、Schmidhuber 與 Cummins 引入的遺忘閘 [12],在隱藏狀態旁另外保留細胞狀態 :
其中 、 與 是遺忘閘、輸入閘與輸出閘(由 sigmoid 層根據目前輸入與 計算、落在 的向量), 是以相同方式計算的 候選值, 是逐元素乘法。沿著細胞路徑, 近似 :沒有權重矩陣,也沒有壓縮函數。當遺忘閘維持在接近一時,在複數主詞處寫入的值可以保留到動詞出現。
Cho 等人的閘控循環單元(gated recurrent unit,GRU)[13] 合併細胞與隱藏狀態,並使用兩個閘:
其中 是更新閘, 是以重設閘計算的候選狀態。(有些資料會對調 與 的角色。)完整的閘門方程式、以 PyTorch 驗證的從零實作 LSTM 步驟及參數量,都在 ML 03A。對語言模型而言,實務結論是:LSTM 與 GRU 比普通 RNN 穩定得多,兩者在不同任務上互有勝負,而閘控只是緩解、並未消除極長依存關係的困難。
9. 堆疊與雙向循環網路
白話版。 循環層可以堆疊,讓較高層讀取下層的狀態序列。再加上一個由右向左執行的網路,每個位置也能看到它的未來;這對文字標註很有用,但在預測下一個詞元時是禁止的。
堆疊(深層)RNN 把第 層的 當作第 層的輸入序列,softmax 讀取最上層。循環語言模型常用兩到四層;層與層之間的 dropout 是常見的正則化方式 [16]。
雙向 RNN 同時執行一個前向與一個反向網路,並串接兩者的狀態 [14]。位置 的反向狀態已讀過 。這非常適合標註:整個句子都已給定,而某個詞的標籤可能取決於右邊的詞;它是 NLP 06 的主要編碼器。但它對由左到右的語言模型是錯誤的:若用來預測 的狀態已經看過 ,損失就會獎勵複製,困惑度也失去意義。任何語言模型都可以做一個有用的健全性檢查:改變一個未來詞元,所有較早位置的預測都必須保持不變。
選讀:Seq2Seq(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
10. 字元層級語言模型
白話版。 預測單位可以是字元而非詞。詞彙表變得極小,也永遠不會出現未知拼字;但序列會長上好幾倍,模型必須先學會拼字,才能學文法。
字元層級 RNN 曾是展示循環網路學到什麼的熱門例子;Graves 證明以字元訓練的 LSTM 可以生成較長且局部連貫的文字與手寫軌跡 [15]。與詞或子詞單位相比,取捨相當具體:
| 選擇 | 詞彙表 | 未知輸入 | 序列長度 | 長距離成本 |
|---|---|---|---|---|
| 詞 | 大;罕見詞需要未知標記 | 對應到同一標記,拼字遺失 | 最短 | 相關詞之間的步數最少 |
| 子詞(NLP 01) | 中等,由分詞器固定 | 拆成已知片段 | 中等 | 中等 |
| 字元 | 極小的字母表 | 字母表上的任何拼字 | 最長 | 相關詞之間的步數很多 |
第 4 節的評估規則帶來兩點提醒。第一,字元困惑度與詞困惑度的單位不同;困惑度 11 的字元模型並不比困惑度 3.6 的詞模型「更好」,因為兩者在不同字母表上計算不同數量的預測。若要以共同文字單位比較,應對相同文字報告總負對數概似(或位元數),必要時再除以共同的位元組數。這要求相容、無損的文字前處理,並交代邊界慣例:把未知拼字合併成一個標記,並沒有編碼那些遺失字元。只改分母,無法補回評分前已擦除的資訊。第二,固定的字元字母表仍需要處理表外符號的規則,例如帶重音字母或表情符號。應在檢查保留文字之前決定。
11. 取樣與溫度
白話版。 訓練好的模型替每個可能的下一詞元給出機率。生成時,我們抽出一個、附加上去,然後重複。溫度設定可以讓抽取更保守或更大膽,而不必重新訓練。
對 logit 與溫度 ,從下列分布取樣:
其中 與 遍歷詞彙表 , 是模型在第 步給 的分數, 是取樣分布。 時從模型自己的分布取樣; 時趨近於貪婪選擇最高分詞元; 會壓平分布,讓不太可能的詞元得到更多權重。溫度只改變生成程序,不改變計算困惑度所用的機率,因此模型的保留資料分數在任何溫度下都相同。
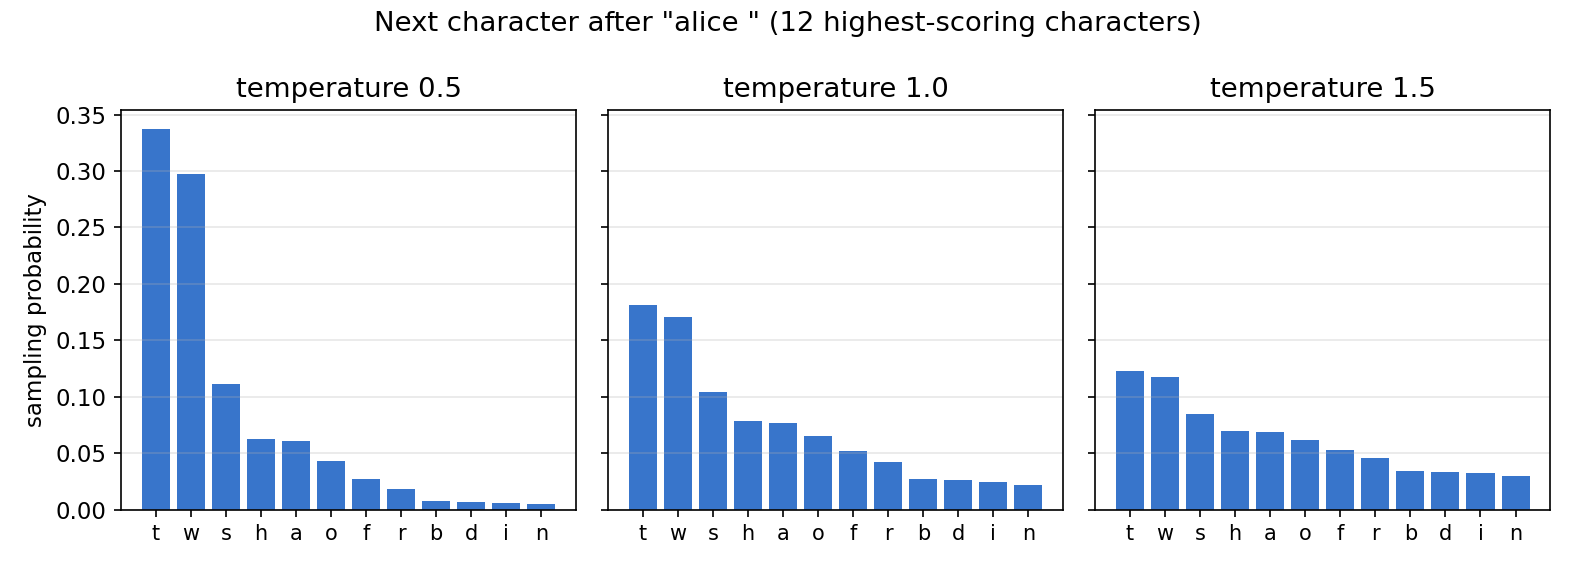
生成還涉及停止規則、長度限制,以及束搜尋(beam search)與 nucleus 取樣等搜尋策略。這些內容屬於 NLP 08 與 NLP 09。但有一項提醒現在就適用:一個樣本只是一條隨機軌跡。應以保留資料概似與任務檢查評判模型,樣本則用來尋找質性的失敗模式,而不是替模型排名。
12. 實務訓練,以及一個完整實驗
訓練檢查清單
白話版。 大多數失敗的循環語言模型,失敗原因都很平凡:把填補當成文字計分、梯度爆炸、狀態在無關文件之間洩漏,或是用測試集挑選模型。每一項都有標準的補救方式。
- 把語料打包成串流。 對連續文字,把詞元串流切成 條等長的平行串流,排成 矩陣。每個訓練步驟讀取接下來的 欄。每個位置都是真實詞元,因此不需要填補。第 條串流會正好從上一個視窗停下的地方繼續。
- 填補與遮罩。 當範例是長度不同的獨立句子時,把它們填補到相同長度並保留布林遮罩。遮罩必須把填補位置排除在損失之外(否則模型會因預測填補而得到獎勵),對雙向編碼器還必須排除在狀態更新之外;PyTorch 的
pack_padded_sequence負責後者。NLP 06 會在標註器中實作兩者。 - 截斷 BPTT。 反向傳播穿過數千步,記憶體成本隨長度線性成長。改為把隱藏狀態從一個 步視窗帶到下一個視窗,但將它分離(detach),讓前向計算仍看到完整過去,而梯度最多只往回流 步。
- 梯度裁剪。 若梯度範數 超過門檻 ,就把它縮放成 [10]。這會保留更新方向並限制其長度。
- 正則化與提前停止。 在非循環連接上使用 dropout [16] 與權重衰減,可以限制記憶;選擇驗證困惑度最低的訓練週期,最後只報告一次測試困惑度。
- 公平的基準。 Melis、Dyer 與 Blunsom 發現,在給予相當的超參數搜尋後,仔細調校的標準 LSTM 勝過幾種較新、較複雜的架構 [17]。同樣的原則在小規模也成立:在宣稱神經模型勝出之前,先用同一份驗證資料調校 n-gram 基準。
程式碼:字元層級 LSTM 對上內插 n-gram
文字是 Lewis Carroll《愛麗絲夢遊仙境》(Alice’s Adventures in Wonderland,1865)第一章的開頭,屬於公有領域;取自 Project Gutenberg 電子書 #11 [24],移除斜體底線、把彎引號改成直引號、把破折號寫成 --,再轉成小寫。第 1–7 段是訓練資料,第 8 段是驗證資料,第 9 段是測試集。字母表事先固定,在檢查保留文字之前就決定。兩個模型都以所有較早的文字作為每個保留字元的條件。n-gram 基準完全依照第 3 節的方式,內插經平滑的 unigram、bigram 與 trigram 字元分布,權重與平滑強度在驗證資料上選擇。LSTM 以不同種子訓練三次,因為在這麼少的資料上,單次結果可能誤導。整個程式在 CPU 上遠少於一分鐘即可完成,也不下載任何東西。
程式碼 · Python · 215 行
import copy
import math
from collections import Counter, defaultdict

import torch
from torch import nn

# Opening paragraphs of Chapter I of Lewis Carroll's "Alice's Adventures in
# Wonderland" (1865, public domain; Project Gutenberg eBook #11). Italic
# underscores removed, curly quotes straightened, em dashes written as "--".
PARAGRAPHS = [
    'Alice was beginning to get very tired of sitting by her sister on the '
    'bank, and of having nothing to do: once or twice she had peeped into the '
    'book her sister was reading, but it had no pictures or conversations in '
    'it, "and what is the use of a book," thought Alice "without pictures or '
    'conversations?"',
    'So she was considering in her own mind (as well as she could, for the hot '
    'day made her feel very sleepy and stupid), whether the pleasure of making '
    'a daisy-chain would be worth the trouble of getting up and picking the '
    'daisies, when suddenly a White Rabbit with pink eyes ran close by her.',
    'There was nothing so very remarkable in that; nor did Alice think it so '
    'very much out of the way to hear the Rabbit say to itself, "Oh dear! Oh '
    'dear! I shall be late!" (when she thought it over afterwards, it occurred '
    'to her that she ought to have wondered at this, but at the time it all '
    'seemed quite natural); but when the Rabbit actually took a watch out of '
    'its waistcoat-pocket, and looked at it, and then hurried on, Alice started'
    ' to her feet, for it flashed across her mind that she had never before '
    'seen a rabbit with either a waistcoat-pocket, or a watch to take out of '
    'it, and burning with curiosity, she ran across the field after it, and '
    'fortunately was just in time to see it pop down a large rabbit-hole under '
    'the hedge.',
    'In another moment down went Alice after it, never once considering how in '
    'the world she was to get out again.',
    'The rabbit-hole went straight on like a tunnel for some way, and then '
    'dipped suddenly down, so suddenly that Alice had not a moment to think '
    'about stopping herself before she found herself falling down a very deep '
    'well.',
    'Either the well was very deep, or she fell very slowly, for she had plenty'
    ' of time as she went down to look about her and to wonder what was going '
    'to happen next. First, she tried to look down and make out what she was '
    'coming to, but it was too dark to see anything; then she looked at the '
    'sides of the well, and noticed that they were filled with cupboards and '
    'book-shelves; here and there she saw maps and pictures hung upon pegs. She'
    ' took down a jar from one of the shelves as she passed; it was labelled '
    '"ORANGE MARMALADE", but to her great disappointment it was empty: she did '
    'not like to drop the jar for fear of killing somebody underneath, so '
    'managed to put it into one of the cupboards as she fell past it.',
    '"Well!" thought Alice to herself, "after such a fall as this, I shall '
    "think nothing of tumbling down stairs! How brave they'll all think me at "
    "home! Why, I wouldn't say anything about it, even if I fell off the top of"
    ' the house!" (Which was very likely true.)',
    'Down, down, down. Would the fall never come to an end? "I wonder how many '
    'miles I\'ve fallen by this time?" she said aloud. "I must be getting '
    'somewhere near the centre of the earth. Let me see: that would be four '
    'thousand miles down, I think--" (for, you see, Alice had learnt several '
    'things of this sort in her lessons in the schoolroom, and though this was '
    'not a very good opportunity for showing off her knowledge, as there was no'
    ' one to listen to her, still it was good practice to say it over) "--yes, '
    "that's about the right distance--but then I wonder what Latitude or "
    'Longitude I\'ve got to?" (Alice had no idea what Latitude was, or Longitude'
    ' either, but thought they were nice grand words to say.)',
    'Presently she began again. "I wonder if I shall fall right through the '
    "earth! How funny it'll seem to come out among the people that walk with "
    'their heads downward! The Antipathies, I think--" (she was rather glad '
    "there was no one listening, this time, as it didn't sound at all the right"
    ' word) "--but I shall have to ask them what the name of the country is, '
    'you know. Please, Ma\'am, is this New Zealand or Australia?" (and she tried'
    " to curtsey as she spoke--fancy curtseying as you're falling through the "
    'air! Do you think you could manage it?) "And what an ignorant little girl '
    "she'll think me for asking! No, it'll never do to ask: perhaps I shall see"
    ' it written up somewhere."',
]

paras = [p.lower() for p in PARAGRAPHS]
train = "\n".join(paras[:7]) + "\n"     # paragraphs 1-7: fit parameters
valid = paras[7] + "\n"                 # paragraph 8: choose settings
test = paras[8] + "\n"                  # paragraph 9: report once
ALPHABET = "\n !\"'(),-.:;?abcdefghijklmnopqrstuvwxyz"  # fixed in advance
V = len(ALPHABET)
assert set(train + valid + test) <= set(ALPHABET)
print("characters train/valid/test:", len(train), len(valid), len(test))
print("letters never seen in training:", sorted(set(valid + test) - set(train)))

# ---- Baseline: interpolated character n-grams (orders 1-3) ----
def count(order):
    rows = defaultdict(Counter)
    for t in range(len(train)):
        rows[train[max(0, t - order + 1):t]][train[t]] += 1
    return rows

tables = {k: count(k) for k in (1, 2, 3)}

def p_add(k, history, ch, alpha):
    row = tables[k].get(history[len(history) - k + 1:] if k > 1 else "", {})
    return (row.get(ch, 0) + alpha) / (sum(row.values()) + alpha * V)

def ngram_ppl(prefix, target, lams, alpha):
    full, nll = prefix + target, 0.0
    for pos in range(len(prefix), len(full)):
        h = full[max(0, pos - 2):pos]
        p = sum(l * p_add(k, h, full[pos], alpha) for k, l in zip((1, 2, 3), lams))
        nll -= math.log(p)
    return math.exp(nll / len(target))

grid = [(l1, l2, round(1 - l1 - l2, 2)) for l1 in (0.1, 0.2, 0.3)
        for l2 in (0.2, 0.3, 0.4, 0.5) if l1 + l2 < 1]
best_cfg = min(((ngram_ppl(train, valid, lams, a), lams, a) for lams in grid
                for a in (0.01, 0.1, 0.5)), key=lambda r: r[0])
ng_valid, ng_lams, ng_alpha = best_cfg
ng_test = ngram_ppl(train + valid, test, ng_lams, ng_alpha)
print(f"n-gram  weights={ng_lams} alpha={ng_alpha}  "
      f"valid PPL={ng_valid:.2f}  test PPL={ng_test:.2f}")

tri_alpha = min((0.01, 0.1, 0.5), key=lambda a: ngram_ppl(train, valid, (0, 0, 1), a))
tri_test = ngram_ppl(train + valid, test, (0, 0, 1), tri_alpha)
print(f"trigram only  alpha={tri_alpha}  test PPL={tri_test:.2f}")

# ---- Character-level LSTM language model ----
stoi = {c: i for i, c in enumerate(ALPHABET)}
encode = lambda s: torch.tensor([stoi[c] for c in s])

class CharLSTM(nn.Module):
    def __init__(self, vocab, emb=24, hidden=96, dropout=0.3):
        super().__init__()
        self.emb = nn.Embedding(vocab, emb)
        self.rnn = nn.LSTM(emb, hidden, batch_first=True)
        self.drop = nn.Dropout(dropout)
        self.out = nn.Linear(hidden, vocab)

    def forward(self, x, state=None):
        h, state = self.rnn(self.emb(x), state)
        return self.out(self.drop(h)), state

def lstm_ppl(model, prefix, target):
    model.eval()
    with torch.no_grad():
        ids = encode(prefix + target).unsqueeze(0)
        logits, _ = model(ids[:, :-1])          # condition on all earlier text
        nll = nn.functional.cross_entropy(logits[0, len(prefix) - 1:],
                                          ids[0, len(prefix):])
    model.train()
    return math.exp(nll.item())

def train_lstm(seed, epochs=80, B=16, T=48):
    torch.manual_seed(seed)
    model = CharLSTM(V)
    opt = torch.optim.Adam(model.parameters(), lr=3e-3, weight_decay=1e-4)
    ids = encode(train)
    n = (len(ids) - 1) // B                     # B parallel streams of n characters
    X, Y = ids[:n * B].view(B, n), ids[1:n * B + 1].view(B, n)  # targets shifted by one
    history, best = [], (float("inf"), None, 0)
    for epoch in range(1, epochs + 1):
        state, total, steps = None, 0.0, 0
        for i in range(0, n, T):
            if state is not None:               # truncated BPTT: keep values, cut graph
                state = tuple(s.detach() for s in state)
            logits, state = model(X[:, i:i + T], state)
            loss = nn.functional.cross_entropy(logits.reshape(-1, V),
                                               Y[:, i:i + T].reshape(-1))
            opt.zero_grad()
            loss.backward()
            nn.utils.clip_grad_norm_(model.parameters(), 1.0)
            opt.step()
            total, steps = total + loss.item(), steps + 1
        v = lstm_ppl(model, train, valid)
        history.append((epoch, math.exp(total / steps), v))
        if v < best[0]:                         # early stopping on validation only
            best = (v, copy.deepcopy(model.state_dict()), epoch)
    model.load_state_dict(best[1])
    return model, best, history

runs = {}
for seed in (0, 1, 2):
    m, best, hist = train_lstm(seed)
    runs[seed] = (m, hist, lstm_ppl(m, train + valid, test))
    print(f"LSTM seed={seed}  best epoch={best[2]}  valid PPL={best[0]:.2f}  "
          f"test PPL={runs[seed][2]:.2f}")
mean_test = sum(r[2] for r in runs.values()) / len(runs)
print(f"LSTM mean test PPL over 3 seeds: {mean_test:.2f}")
assert mean_test < tri_test
model = runs[0][0]

# ---- Sampling at several temperatures ----
def sample(prompt, tau, length=80, seed=1):
    g = torch.Generator().manual_seed(seed)
    model.eval()
    with torch.no_grad():
        logits, state = model(encode(prompt).unsqueeze(0))
        out = prompt
        for _ in range(length):
            probs = torch.softmax(logits[0, -1] / tau, dim=-1)
            nxt = torch.multinomial(probs, 1, generator=g)
            out += ALPHABET[nxt.item()]
            logits, state = model(nxt.view(1, 1), state)
    return out.replace("\n", " / ")

for tau in (0.5, 1.0, 1.5):
    print(f"tau={tau}:", sample("alice ", tau))

# ---- Same last two characters, different earlier context ----
def next_dist(prefix):
    model.eval()
    with torch.no_grad():
        logits, _ = model(encode(prefix).unsqueeze(0))
    return torch.softmax(logits[0, -1], dim=-1)

a, b = "alice was beginning to get ", "the rabbit-hole went "
assert a[-2:] == b[-2:]                     # a trigram sees only these two
def ngram_dist(prefix):
    return torch.tensor([sum(l * p_add(k, prefix[-2:], c, ng_alpha)
                             for k, l in zip((1, 2, 3), ng_lams)) for c in ALPHABET])

tv = lambda p, q: 0.5 * (p - q).abs().sum().item()
print("total variation, n-gram:", round(tv(ngram_dist(a), ngram_dist(b)), 3),
      " LSTM:", round(tv(next_dist(a), next_dist(b)), 3))
輸出:
程式碼 · 12 行
characters train/valid/test: 2633 706 682
letters never seen in training: ['z']
n-gram  weights=(0.1, 0.4, 0.5) alpha=0.01  valid PPL=9.70  test PPL=11.24
trigram only  alpha=0.1  test PPL=13.37
LSTM seed=0  best epoch=43  valid PPL=10.13  test PPL=12.09
LSTM seed=1  best epoch=41  valid PPL=9.76  test PPL=11.05
LSTM seed=2  best epoch=39  valid PPL=10.09  test PPL=11.30
LSTM mean test PPL over 3 seeds: 11.48
tau=0.5: alice whas she sor of the to her fear the she was she sely and it she save of the was
tau=1.0: alice whas nyt ook "hente tome urabuint, mubbeit-insiwselly bulith ver to welf was bor
tau=1.5: alice wherany fowh ".pvenst gime feurdt, )ubger and iwselly ?hont  ver, vermef wamen r
total variation, n-gram: 0.0  LSTM: 0.197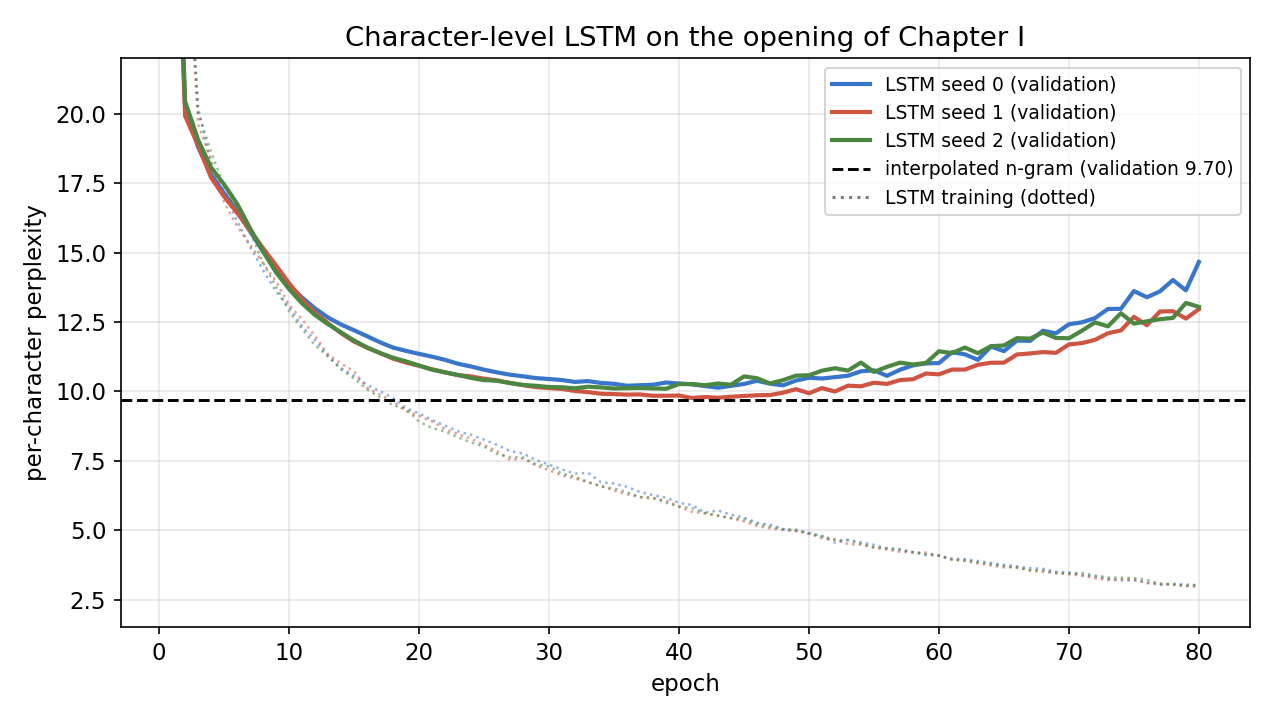
解讀結果
基準很重要。 使用加法平滑的單一 trigram 測試困惑度為 13.37,三次 LSTM 都勝過它。在同一驗證段落上調校的內插 n-gram 達到 11.24,而三次 LSTM 分別是 12.09、11.05 與 11.30(平均 11.48)。在 2,633 個訓練字元上,循環模型大致與平滑良好的計數模型打平,並明顯勝過平滑不佳的計數模型。這是 Melis 等人論點的小資料版本 [17]:對未調校基準宣稱的改善,面對調校過的基準可能就消失了。隨著資料增加,神經語言模型會拉開差距,因為共享表示能利用許多稀疏表格無法合併的微弱規律;Jozefowicz 等人記錄了循環語言模型在大型語料與模型上的進展 [19]。我們的實驗太小,無法呈現那種情況,也不需要:它示範的是如何誠實地比較。
種子很重要。 不同種子之間的差異(11.05 到 12.09),大於 LSTM 平均值與 n-gram 之間的差距。若只用一個種子,我們可能報告「LSTM 勝出」,也可能報告「LSTM 落敗」。差異這麼小時,應報告多次執行結果,或對保留文件計算信賴區間。
驗證曲線顯示記憶現象。 在圖 4 中,訓練困惑度持續下降,遠低於驗證值;模型正在學習特定的訓練段落。提前停止選出第 39–43 週期;若沒有它,最後一個週期在保留文字上會差上不少。
單位。 這些是 39 個符號字母表上的每字元困惑度;n-gram 的 每字元位元。它們不能與第 3 節的詞層級數值(例如 3.573)比較,因為後者在不同詞彙表上計算不同事件。
量測記憶上限。 最後幾行比較 alice was beginning to get 與 the rabbit-hole went 之後的下一字元分布,這兩個前綴的最後兩個字元相同。內插 trigram 必須給出完全相同的分布(總變異距離 0.0),正如第 5 節所證明。LSTM 的分布則不同(總變異距離 0.197),因為它的狀態取決於更早的字元。這確認循環模型有使用較長的上下文;至於是否用得好,則是另一個問題,要由保留資料困惑度與針對性測試回答。
樣本。 在 時,樣本重複 she was、of the 等常見片段;在 時出現詞的形狀,但拼錯很多;在 時輸出瓦解成罕見標點與隨機字母。一個只用不到三千個字元訓練的字元模型,學到的是常見字母序列、空白與一些短詞,並沒有學會英語。這些都是單一種子的單次抽樣,應視為溫度效果的示意,而不是品質估計。
現代觀點
綜述觀點。 Jurafsky 與 Martin 的 2026 年 8 月草稿仍保留 n-gram 專章,依機率預測、估計、評估、生成及平滑來組織 [3]。它提供有效的概念橋梁:讀者可以先檢查局部次數,再接觸共享可學習表示的模型。Chen 與 Goodman 的平滑比較則解釋了為何除了歷史長度,估計方法本身也很重要 [4]。兩種來源用途不同:教材發展模型,實證研究比較如何在稀疏證據下配置機率。Tiezzi 等人的 2024 年綜述回顧循環處理為何在 Transformer 時代重新受到重視 [20]。它把兩股趨勢放在「循環」這個統一框架下:一類結合 Transformer 與循環網路想法、以避開自注意力的二次方成本;另一類是作為特殊線性 RNN 的深層狀態空間模型。它提出的主要開放問題,是從長度事先未知的串流中學習,這把序列建模連到終身線上學習。
循環語言模型的成就。 從 Mikolov 的 RNN 語言模型 [7],到大規模 LSTM 語言模型 [19] 與仔細正則化的 LSTM [18],循環網路一直是最強的通用語言模型,直到 Transformer 在多數大規模工作中取代它們。Merity 等人的 AWD-LSTM 研究顯示,那份實力有很大一部分來自正則化與最佳化選擇,而不是新的單元設計 [18];Melis 等人透過受控的超參數搜尋得到相似結論 [17]。
2023–2026 年。 循環以新形式回歸,目標是降低長上下文注意力的成本。RWKV 重新表述類 Transformer 模型,使它能平行訓練,並在推論時以 RNN 方式執行 [21]。Mamba 使用依輸入而變的(選擇性)狀態空間更新,並以平行掃描計算 [22]。xLSTM 以指數閘控與新的記憶結構重新檢視 LSTM [23]。這些模型保留了讓 RNN 語言模型具吸引力的性質:固定大小的狀態,因此每個詞元的生成成本不隨上下文長度增加。它們也繼承了第 7 節提出的問題:固定大小的狀態必須決定要忘記什麼。ML 03A 對狀態空間模型有更詳細的介紹。
評估。 Chang 等人的 2024 年綜述以「評估什麼、在哪裡評估、如何評估」組織大型語言模型評估 [5],涵蓋詞元預測之外的任務行為與評估方法。套用到本章,較低困惑度仍應搭配真正重要的任務檢查,例如拼字恢復、一致關係、語意保存或適當停止規則。在 2023–2026 年的工作流程中,n-gram 基準的實際作用是讓問題可以量測。更複雜的模型是否在相同分詞下改善保留預測?是否區分了既定 n-gram 歷史必須合併的兩個前綴?增加記憶體與延遲是否改善下游結果?應用可比較的實驗回答,而不是比較條件不一致的分數,或假設較長上下文一定被有效利用。
開放問題。 開放問題包括領域改變後的稀疏證據、新名稱的機率,以及分詞與量測難度之間的互動。字元或子詞會改變詞彙覆蓋與序列長度的取捨。更長的歷史,無論存在表格或循環狀態中,都提供更多資訊,卻也帶來更困難的估計與功勞分配(credit assignment)問題。應一起選擇預測單位與保留歷史,並在解讀結果之前說明限制。
重點整理
- n-gram 出現或文件特徵,不會自動成為正規化語言模型;第 階使用前 個詞元,而機率鏈式法則本身沒有要求有限記憶。
- 平滑保護未觀察事件,內插重用較短歷史的證據;兩者都無法恢復模型已捨棄的歷史。
- 比較困惑度需要一致的預測單位、未知映射與邊界規則;字元與詞的困惑度不能比較。
- 循環語言模型以依賴整個前綴的學習狀態取代次數表,參數在各位置之間共享。
- BPTT 梯度隨距離縮小或放大;裁剪處理爆炸,LSTM 或 GRU 的閘控緩解梯度消失,但沒有消除長依存關係的困難。
- 雙向 RNN 適合標註,不適合由左到右的語言模型。
- 實務訓練需要位移目標、遮罩或打包串流、截斷 BPTT、梯度裁剪、正則化,以及以驗證資料為準的提前停止。
- 在極小資料上,調校過的內插 n-gram 可以與 LSTM 打平;應與調校過的基準比較,並報告多個種子。
練習
- 手算第 2 節第一個程式中,
a cat與the cat後面的平滑 trigram 機率。確認八個目標詞元上的總和。
提示
每個歷史只有一筆觀察。分母是一加上平滑強度乘以八;只有觀察到的延續額外得到一次計數。
- 混合第一個範例的三種階數。任選總和為一的非負權重,並對未見兩詞元歷史驗證正規化。
提示
讓每個成分都使用相同候選詞彙表。比較未見歷史下的機率、純均勻退回,以及 cat 後面觀察到的 bigram。
- 分別在計入與不計入結束標記的條件下,替 bigram 測試集評分。解釋為什麼兩種困惑度回答不同預測問題。
提示
一致地改變累積損失與位置數。不計入結束標記,移除了停止行為的評估,不只是改變顯示慣例。
- 建立兩個最後兩詞元相同的前綴,讓它們因更早的否定、一致關係或篇章資訊,而需要不同的下一詞元機率。說明 trigram 能與不能學到什麼,以及 RNN 語言模型原則上能學到什麼。
提示
先確認保留歷史完全相同,再區分資料不足與根本無法依省略的差異設定條件這兩種問題。對 RNN,要區分它的狀態能表示什麼,以及它的梯度能教會它什麼。
- 在字元層級實驗中,把
nn.LSTM換成nn.GRU(狀態變成單一張量,所以要調整 detach 那一行)與nn.RNN。以三個種子比較驗證與測試困惑度。接著移除普通 RNN 的梯度裁剪,記錄訓練損失發生什麼事。
提示
nn.GRU 與 nn.RNN 的狀態是張量而不是元組。保持其他所有設定不變,包括提前停止規則,讓單元類型成為唯一的改變。
- 刻意破壞因果性:給 LSTM 模型在同一輸入上加一個反向 LSTM(雙向層)並重新訓練。解釋你觀察到的訓練與驗證困惑度,並寫一個本來能抓到這個錯誤的測試。
提示
有了反向計算,用來預測位置 字元的狀態已經讀過該字元。好的測試會改變一個未來字元,並檢查所有較早位置的預測分布保持不變。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapter 5, Manning, 2021. Publisher
- Susan McRoy, Principles of Natural Language Processing, 2021. Chapter
- Daniel Jurafsky and James H. Martin, Speech and Language Processing, third-edition draft, Chapter 3, August 19, 2026. Chapter
- Stanley F. Chen and Joshua Goodman, “An Empirical Study of Smoothing Techniques for Language Modeling,” ACL, 1996. Paper
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Paper
- Jeffrey L. Elman, “Finding Structure in Time,” Cognitive Science 14(2), 1990. DOI
- Tomáš Mikolov, Martin Karafiát, Lukáš Burget, Jan Černocký and Sanjeev Khudanpur, “Recurrent Neural Network Based Language Model,” Interspeech, 2010. DOI
- Paul J. Werbos, “Backpropagation Through Time: What It Does and How to Do It,” Proceedings of the IEEE 78(10), 1990. DOI
- Yoshua Bengio, Patrice Simard and Paolo Frasconi, “Learning Long-Term Dependencies with Gradient Descent Is Difficult,” IEEE Transactions on Neural Networks 5(2), 1994. DOI
- Razvan Pascanu, Tomas Mikolov and Yoshua Bengio, “On the Difficulty of Training Recurrent Neural Networks,” ICML, 2013. arXiv
- Sepp Hochreiter and Jürgen Schmidhuber, “Long Short-Term Memory,” Neural Computation 9(8), 1997. DOI
- Felix A. Gers, Jürgen Schmidhuber and Fred Cummins, “Learning to Forget: Continual Prediction with LSTM,” Neural Computation 12(10), 2000. DOI
- Kyunghyun Cho et al., “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation,” EMNLP, 2014. arXiv
- Mike Schuster and Kuldip K. Paliwal, “Bidirectional Recurrent Neural Networks,” IEEE Transactions on Signal Processing 45(11), 1997. DOI
- Alex Graves, “Generating Sequences With Recurrent Neural Networks,” arXiv:1308.0850, 2013. arXiv
- Wojciech Zaremba, Ilya Sutskever and Oriol Vinyals, “Recurrent Neural Network Regularization,” arXiv:1409.2329, 2014. arXiv
- Gábor Melis, Chris Dyer and Phil Blunsom, “On the State of the Art of Evaluation in Neural Language Models,” arXiv:1707.05589, 2017. arXiv
- Stephen Merity, Nitish Shirish Keskar and Richard Socher, “Regularizing and Optimizing LSTM Language Models,” arXiv:1708.02182, 2017. arXiv
- Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer and Yonghui Wu, “Exploring the Limits of Language Modeling,” arXiv:1602.02410, 2016. arXiv
- Matteo Tiezzi, Michele Casoni, Alessandro Betti, Tommaso Guidi, Marco Gori and Stefano Melacci, “On the Resurgence of Recurrent Models for Long Sequences: Survey and Research Opportunities in the Transformer Era,” arXiv:2402.08132, 2024. arXiv
- Bo Peng et al., “RWKV: Reinventing RNNs for the Transformer Era,” Findings of EMNLP, 2023. Paper
- Albert Gu and Tri Dao, “Mamba: Linear-Time Sequence Modeling with Selective State Spaces,” COLM, 2024. arXiv
- Maximilian Beck et al., “xLSTM: Extended Long Short-Term Memory,” NeurIPS, 2024. Paper
- Lewis Carroll, Alice’s Adventures in Wonderland, 1865; Project Gutenberg eBook #11. Project Gutenberg
- Ilya Sutskever, Oriol Vinyals and Quoc V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 06・以 RNN 做序列標註(詞性標註、資訊擷取) · 30 分鐘