Seq2Seq — Sequence to Sequence Learning with Neural Networks
選讀・NLP 05・用於語言的循環神經網路 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
循環標記器可以每讀一個 token 就輸出一個標籤,但翻譯可能重排詞序,輸出長度也不同。Sutskever、Vinyals 與 Le 展示編碼器加上獨立解碼器,如何學習這種變長映射 [25]。論點是深層 LSTM 配合適當的序列安排,可以透過固定維度句子表示進行翻譯。先理解本章的循環狀態、LSTM 閘門與 teacher forcing。
方法
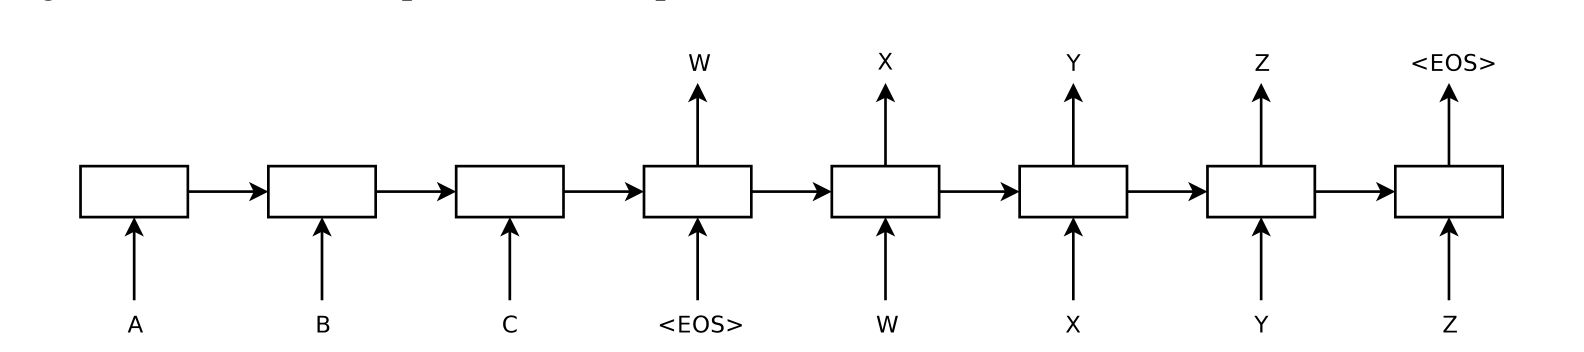
編碼器讀完來源序列,把最後的表示交給解碼器。解碼器預測下一個目標 token 的分佈,再持續生成到序列結束符號。目標序列機率分解為:
是來源序列, 是固定維度的編碼器表示, 是包含結束符號的目標序列, 是目標長度, 是先前的目標 token。每一項都是解碼器的下一 token 機率。訓練時使用已知的正確前綴來最大化機率;推論時只能使用先前自行生成的 token。
由左向右讀圖 1:輸入更新循環狀態,輸出生成再使用累積的資訊。實際系統採用分開的編碼器、解碼器 LSTM,並堆疊四層循環層。只反轉來源詞序,能讓許多對應的來源詞與目標詞在計算路徑上更靠近,但不會移除循環,也不會讓解碼器直接讀取全部來源狀態。束搜尋保留多個部分候選,仍是近似搜尋。
結果
表 1 在 WMT’14 英譯法 ntst14 評估。五模型反向輸入集成、束寬 12 得到 34.81 BLEU,論文列出的片語式基準為 33.30。這是集成結果,不是單一 LSTM 分數。表 2 的 36.5 則來自用集成重新評分基準系統的 1000 個候選。候選重評分與從頭生成翻譯是不同任務,不應混成一個未註明條件的「最高分」。
消融與設計證據
表 1 中,束寬同為 12,單一正向輸入 LSTM 得到 26.17 BLEU,單一反向輸入 LSTM 為 30.59,直接支持該訓練設定下序列安排的重要性。集成數量與束寬則有各自的影響:五模型集成在束寬 1 為 33.00,束寬 2 為 34.50。不能把最終提升全部歸因於反轉,也不能假設束寬加大就會等比例改善。
結論
核心抽象是條件序列生成:編碼器整理一段序列,解碼器展開另一段。先追蹤第一個輸入詞的資訊,必須經過哪些位置才能影響第一個輸出。接著讀 NLP 08 的 Bahdanau 導讀,理解注意力如何讓解碼器反覆存取來源表示。
問題與限制
固定表示可能遺失細節,尤其輸入變長或偏離訓練樣本時。來源反轉緩解部分相依性,沒有消除瓶頸。以正確前綴訓練,也不同於推論時面對不完美的生成前綴。詞彙表限制、近似解碼及資料特定的詞序,也限制了結果的適用範圍。這篇建立實用架構,並未保證任意長序列都能忠實壓縮。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapter 5, Manning, 2021. Publisher
- Susan McRoy, Principles of Natural Language Processing, 2021. Chapter
- Daniel Jurafsky and James H. Martin, Speech and Language Processing, third-edition draft, Chapter 3, August 19, 2026. Chapter
- Stanley F. Chen and Joshua Goodman, “An Empirical Study of Smoothing Techniques for Language Modeling,” ACL, 1996. Paper
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Paper
- Jeffrey L. Elman, “Finding Structure in Time,” Cognitive Science 14(2), 1990. DOI
- Tomáš Mikolov, Martin Karafiát, Lukáš Burget, Jan Černocký and Sanjeev Khudanpur, “Recurrent Neural Network Based Language Model,” Interspeech, 2010. DOI
- Paul J. Werbos, “Backpropagation Through Time: What It Does and How to Do It,” Proceedings of the IEEE 78(10), 1990. DOI
- Yoshua Bengio, Patrice Simard and Paolo Frasconi, “Learning Long-Term Dependencies with Gradient Descent Is Difficult,” IEEE Transactions on Neural Networks 5(2), 1994. DOI
- Razvan Pascanu, Tomas Mikolov and Yoshua Bengio, “On the Difficulty of Training Recurrent Neural Networks,” ICML, 2013. arXiv
- Sepp Hochreiter and Jürgen Schmidhuber, “Long Short-Term Memory,” Neural Computation 9(8), 1997. DOI
- Felix A. Gers, Jürgen Schmidhuber and Fred Cummins, “Learning to Forget: Continual Prediction with LSTM,” Neural Computation 12(10), 2000. DOI
- Kyunghyun Cho et al., “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation,” EMNLP, 2014. arXiv
- Mike Schuster and Kuldip K. Paliwal, “Bidirectional Recurrent Neural Networks,” IEEE Transactions on Signal Processing 45(11), 1997. DOI
- Alex Graves, “Generating Sequences With Recurrent Neural Networks,” arXiv:1308.0850, 2013. arXiv
- Wojciech Zaremba, Ilya Sutskever and Oriol Vinyals, “Recurrent Neural Network Regularization,” arXiv:1409.2329, 2014. arXiv
- Gábor Melis, Chris Dyer and Phil Blunsom, “On the State of the Art of Evaluation in Neural Language Models,” arXiv:1707.05589, 2017. arXiv
- Stephen Merity, Nitish Shirish Keskar and Richard Socher, “Regularizing and Optimizing LSTM Language Models,” arXiv:1708.02182, 2017. arXiv
- Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer and Yonghui Wu, “Exploring the Limits of Language Modeling,” arXiv:1602.02410, 2016. arXiv
- Matteo Tiezzi, Michele Casoni, Alessandro Betti, Tommaso Guidi, Marco Gori and Stefano Melacci, “On the Resurgence of Recurrent Models for Long Sequences: Survey and Research Opportunities in the Transformer Era,” arXiv:2402.08132, 2024. arXiv
- Bo Peng et al., “RWKV: Reinventing RNNs for the Transformer Era,” Findings of EMNLP, 2023. Paper
- Albert Gu and Tri Dao, “Mamba: Linear-Time Sequence Modeling with Selective State Spaces,” COLM, 2024. arXiv
- Maximilian Beck et al., “xLSTM: Extended Long Short-Term Memory,” NeurIPS, 2024. Paper
- Lewis Carroll, Alice’s Adventures in Wonderland, 1865; Project Gutenberg eBook #11. Project Gutenberg
- Ilya Sutskever, Oriol Vinyals and Quoc V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper