InstructGPT — Training Language Models to Follow Instructions with Human Feedback
選讀・NLP 09・以 Transformer 做語言模型(自然語言生成) 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
預測可能出現的文字,並不等於直接訓練模型遵循使用者指令。Ouyang 等人研究示範答案與回覆排序,如何改變預訓練語言模型的行為 [25]。論點是相對少量的人類回饋,就能在所評估的提示分佈上明顯改善偏好表現。先理解本章的自迴歸概似與監督式微調;「較受偏好」、「事實正確」與「安全」應保留為不同評估問題。
方法
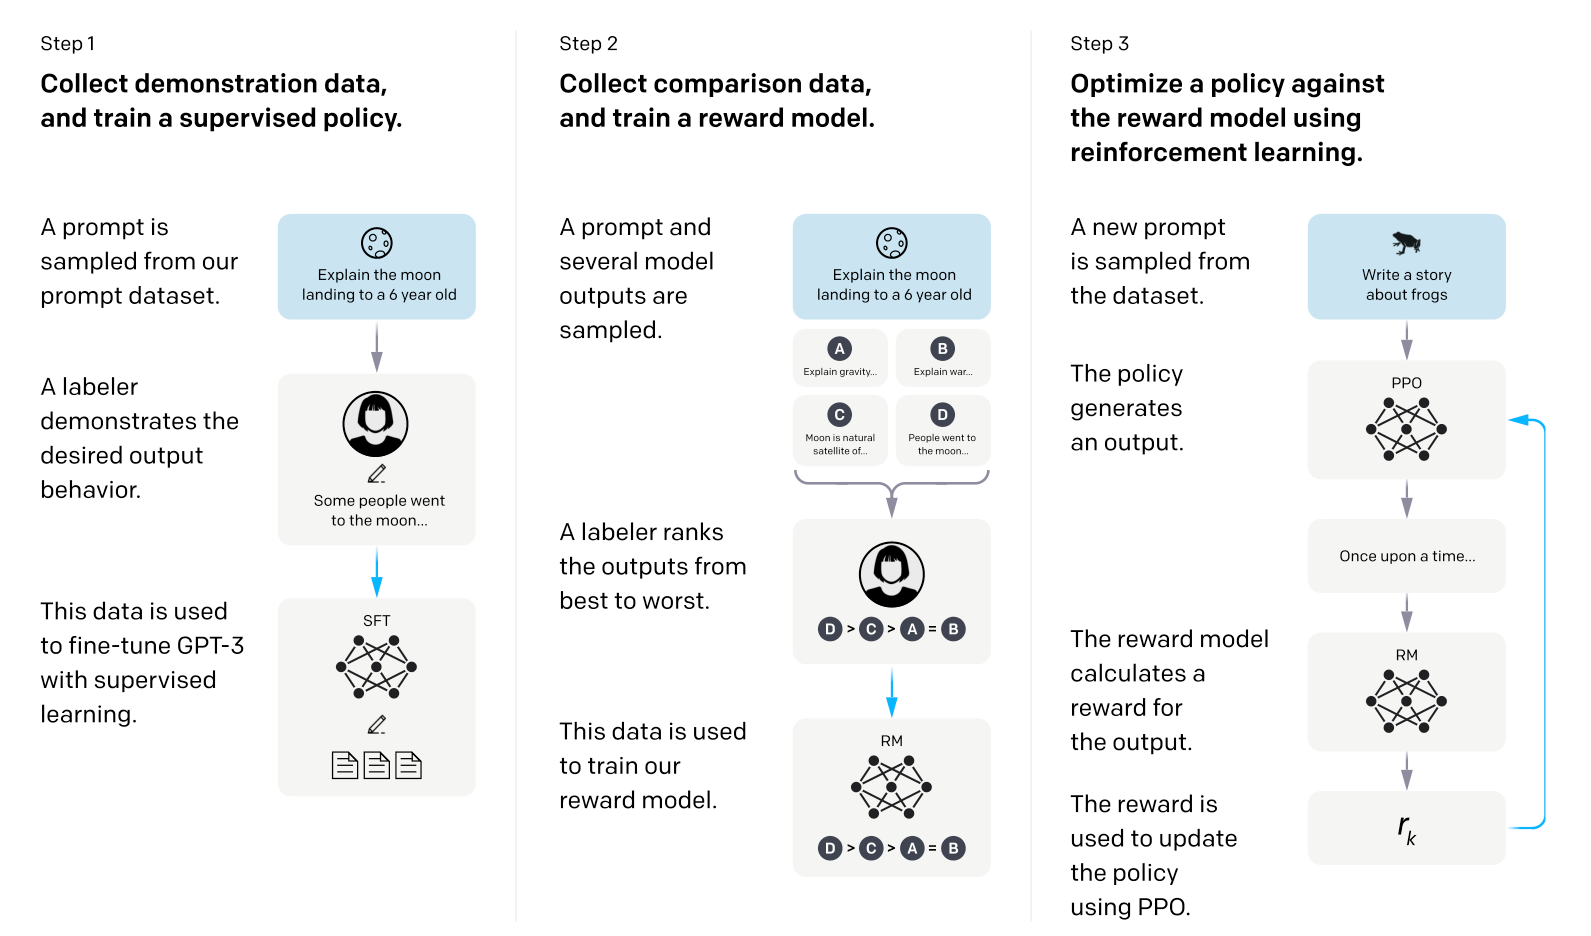
監督式微調(SFT)先擬合標註者的示範回覆。獎勵模型再從排序轉成的成對偏好學習評分。對一組較受偏好與較不受偏好的回覆,損失可寫成:
是提示, 是較受偏好的回覆, 是較不受偏好的回覆, 是參數為 的純量獎勵模型。sigmoid 函數 把分數差映射為偏好機率; 是這一對的負對數概似。訓練彙整這類配對,不要求人類給出絕對的數值品質分數。
策略從 SFT 初始化,以近端策略最佳化(PPO)提高學得的獎勵,同時透過懲罰避免偏離 SFT 策略太遠。PPO-ptx 額外混合預訓練目標的梯度,降低能力退化。圖 2 中,示範模型、獎勵模型與更新後的策略有不同工作;部署時產生回覆的不是獎勵模型。分佈差異懲罰限制行為改變,並不保證事實正確。
結果
論文報告,在研究的 API 提示分佈上,標註者較偏好 1.3B 參數 InstructGPT 的輸出,而非 175B GPT-3 基準。圖 1 必須仔細讀:圖上的勝率使用共同的 175B SFT 比較模型,並非列出所有模型兩兩對戰。這是特定提示與標註者群體的偏好證據,不代表小模型在所有基準都勝出。收集的提示也以英文為絕大多數,進一步限制主張範圍。
消融與設計證據
比較 SFT、PPO 與 PPO-ptx,才能分開理解示範、獎勵最佳化及額外預訓練混合的作用。第 4.2 節顯示混合目標緩解數個公開基準的退步,但未消除所有落差。真實性與毒性測試也依模型大小和提示方式而變;要求尊重作答時的毒性優勢,不能直接推廣到沒有此指示的生成。這支持分開評估多種行為,而不是全部壓成獎勵分數。
結論
可沿用的區分是:模仿示範、學習排序回覆,以及用學得的排序器最佳化生成器。讀偏好圖前,先追蹤每個階段由哪種資料監督。若要比較另一種以表示學習為主、而非指令生成的目標,接著讀 NLP 10。
問題與限制
偏好反映選定的標註者與資料蒐集程序。策略可能利用獎勵模型的缺陷,有說服力或迎合的文字仍可能錯誤。分佈轉移、多語提示及對抗請求都需要另外的證據。這個歷史上的三階段流程,不是現今部署助理的完整規格;論文也沒有證明人類回饋訓練普遍解決幻覺、偏差或對齊問題。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapters 5, 8, 9, 10 and 11, Manning, 2021. Publisher · Training practices · Deployment
- Susan McRoy, Principles of Natural Language Processing, open textbook, Chapters 6 and 9, 2021. Benchmark chapter · Generation chapter
- Ashish Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. Paper
- Alec Radford, Karthik Narasimhan, Tim Salimans and Ilya Sutskever, “Improving Language Understanding by Generative Pre-Training,” OpenAI technical report, 2018. Paper
- Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei and Ilya Sutskever, “Language Models are Unsupervised Multitask Learners,” OpenAI technical report, 2019. Paper
- Tom B. Brown et al., “Language Models are Few-Shot Learners,” NeurIPS, 2020. Paper
- Jared Kaplan et al., “Scaling Laws for Neural Language Models,” arXiv:2001.08361, 2020. arXiv
- Jordan Hoffmann et al., “Training Compute-Optimal Large Language Models,” arXiv:2203.15556, 2022; published as “An empirical analysis of compute-optimal large language model training,” NeurIPS, 2022. arXiv
- Ilya Loshchilov and Frank Hutter, “Decoupled Weight Decay Regularization,” ICLR, 2019. Paper
- Dan Hendrycks and Kevin Gimpel, “Gaussian Error Linear Units (GELUs),” arXiv:1606.08415, 2016, revised 2023. Paper
- Jimmy Lei Ba, Jamie Ryan Kiros and Geoffrey E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. Paper
- Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes and Yejin Choi, “The Curious Case of Neural Text Degeneration,” ICLR, 2020. Paper
- Angela Fan, Mike Lewis and Yann Dauphin, “Hierarchical Neural Story Generation,” ACL, 2018. Paper
- Jade Goldstein and Jaime Carbonell, “Summarization: (1) Using MMR for Diversity-Based Reranking and (2) Evaluating Summaries,” TIPSTER Phase III Workshop, 1998. Paper
- Sam Wiseman, Stuart M. Shieber and Alexander M. Rush, “Challenges in Data-to-Document Generation,” EMNLP, 2017. Paper
- Ilya Sutskever, Oriol Vinyals and Quoc V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper
- Chin-Yew Lin, “ROUGE: A Package for Automatic Evaluation of Summaries,” Text Summarization Branches Out, 2004. Paper
- Lianmin Zheng et al., “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena,” NeurIPS Datasets and Benchmarks Track, 2023. Paper
- Peiyi Wang et al., “Large Language Models are not Fair Evaluators,” ACL, 2024. Paper
- Ziwei Ji et al., “Survey of Hallucination in Natural Language Generation,” ACM Computing Surveys 55, 2023. Survey
- Joshua Maynez, Shashi Narayan, Bernd Bohnet and Ryan McDonald, “On Faithfulness and Factuality in Abstractive Summarization,” ACL, 2020. Paper
- Patrick Lewis et al., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,” NeurIPS, 2020. Paper
- OWASP GenAI Security Project contributors, “LLM01: Prompt Injection,” OWASP guidance, accessed 2026. Official guidance
- Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang and Weizhu Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” ICLR, 2022. Author publication page
- Long Ouyang et al., “Training language models to follow instructions with human feedback,” NeurIPS, 2022. Paper
- Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D. Manning, Stefano Ermon and Chelsea Finn, “Direct Preference Optimization: Your Language Model is Secretly a Reward Model,” NeurIPS, 2023. Paper
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” Frontiers of Computer Science, 2026. Updated survey
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Survey
- Junyi Li, Tianyi Tang, Wayne Xin Zhao, Jian-Yun Nie and Ji-Rong Wen, “Pre-Trained Language Models for Text Generation: A Survey,” ACM Computing Surveys, 2024. Publisher · Author manuscript
- Patricia Schmidtova et al., “Do My Eyes Deceive Me? A Survey of Human Evaluations of Hallucinations in NLG,” INLG, 2025. Survey
- Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Meng Wang and Haofen Wang, “Retrieval-Augmented Generation for Large Language Models: A Survey,” arXiv:2312.10997, revised 2024. Survey
- Woosuk Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” SOSP, 2023. Conference · Paper
- Christopher D. Manning, Prabhakar Raghavan and Hinrich Schütze, Introduction to Information Retrieval, Chapters 6, 8 and 11, Cambridge University Press, 2008. Author-hosted book
- scikit-learn developers, “Text feature extraction,” scikit-learn documentation, accessed 2026. Documentation
- Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick Lewis, Ledell Wu, Sergey Edunov, Danqi Chen and Wen-tau Yih, “Dense Passage Retrieval for Open-Domain Question Answering,” EMNLP, 2020. Paper
- Kalervo Järvelin and Jaana Kekäläinen, “Cumulated Gain-Based Evaluation of IR Techniques,” ACM Transactions on Information Systems 20(4), 422–446, 2002. Publisher