BiLSTM-CRF — Bidirectional LSTM-CRF Models for Sequence Tagging
選讀・NLP 06・以 RNN 做序列標註(詞性標註、資訊擷取) 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
逐 token 獨立預測的標籤可能各自合理,組成整條序列卻不一致。Huang、Xu 與 Yu 結合依上下文變化的循環特徵,以及全域正規化的序列模型 [13]。論點把工作分成兩部分:雙向 LSTM 讀句子,CRF 一起評分相鄰標籤決策。先理解本章的 BIO 標籤、發射分數、轉移分數及動態規劃。本導讀針對 2015 年稿件,也包含其中使用的人工輸入特徵。
方法
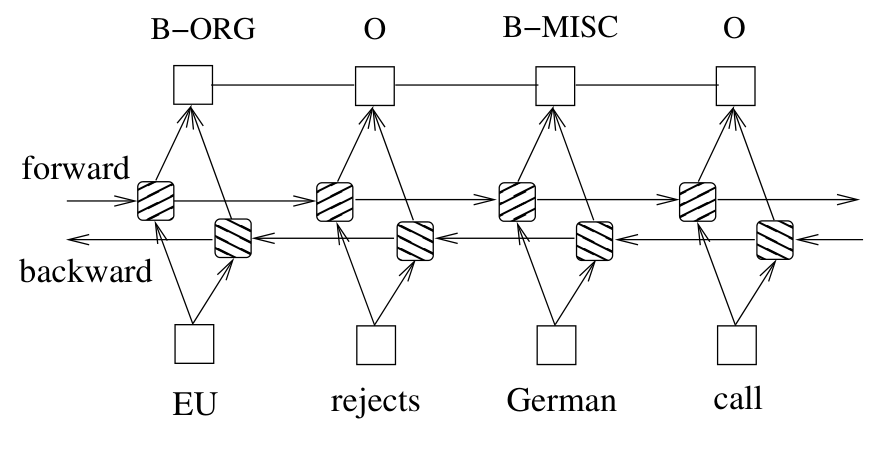
前向與後向 LSTM 讓各 token 的表示能使用句子兩側資訊,再產生候選標籤的發射分數。線性鏈 CRF 加入轉移分數,並對完整標籤路徑正規化:
是輸入句子, 是長度, 是標籤路徑, 是位置 對標籤 的發射分數, 是標籤 轉到 的學得分數。 表示起始狀態,結束邊界也可類似處理。 是候選路徑集合, 是分母中走訪的路徑。這些分數是未正規化實數,不是 token 機率。
訓練最大化正確路徑的條件概似。前向動態規劃有效率地計算路徑總和;Viterbi 解碼則尋找最高分路徑。求和與取最大值是不同操作。學得的轉移矩陣可以壓低不合法 BIO 轉移,但除非實作明確遮罩,否則不保證硬性合法。
結果
表 2 使用 Senna 預訓練嵌入的 BiLSTM-CRF,POS 準確率為 97.55、分塊 F1 為 94.46、NER F1 為 88.83。括號中的 NER F1 90.10 額外使用詞表特徵(gazetteer),兩個 NER 分數不是相同輸入設定。POS 準確率計算 token 決策,分塊及 NER F1 評估擷取的跨度,不能把數值高低當成同一能力的排名。
消融與設計證據
相應的隨機嵌入 BiLSTM-CRF 得到 97.43、94.13、84.26。逐列比較可看出,在此設定中預訓練對 NER 的影響更大。架構比較也區分循環方向性與加入 CRF 的效果。特徵實驗同樣重要:移除拼寫及上下文特徵後,分塊 F1 從 94.46 變成 94.40。這篇不能作為流程已完全移除人工特徵的證據。
結論
這個模型適合用來理解上下文 token 證據與結構化輸出限制為何互補。面對兩條競爭的 BIO 路徑,試著指出哪些差異來自發射分數、哪些來自轉移。接著讀 NLP 12,認識超越相鄰標籤鏈的結構,例如跨度及共指連結。
問題與限制
雙向特徵需要未來輸入,因此不是因果式串流標記器。線性鏈 CRF 直接處理相鄰標籤,無法涵蓋所有文件級關係。特徵、嵌入與標籤規約都影響可重現性;即使路徑形式合法,實體跨度仍可能錯誤。決定是否需要更大的上下文編碼器前,應分別檢查邊界與實體類別錯誤。
參考文獻
- Susan McRoy, Principles of Natural Language Processing, open textbook, 2021; Chapters 3–5 and 8. Open textbook
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Manning, 2021; Chapter 5, “Sequential labeling and language modeling.” Chapter
- L. R. Rabiner, “A tutorial on hidden Markov models and selected applications in speech recognition,” Proceedings of the IEEE, 77(2), 1989. Paper
- M.-C. de Marneffe, C. D. Manning, J. Nivre and D. Zeman, “Universal Dependencies,” Computational Linguistics, 47(2), 2021. Paper
- J. Lafferty, A. McCallum and F. Pereira, “Conditional random fields: Probabilistic models for segmenting and labeling sequence data,” ICML, 2001. Paper
- Erik F. Tjong Kim Sang and Fien De Meulder, “Introduction to the CoNLL-2003 Shared Task: Language-Independent Named Entity Recognition,” CoNLL, 2003. Paper
- Jing Li, Aixin Sun, Jianglei Han and Chenliang Li, “A Survey on Deep Learning for Named Entity Recognition,” IEEE Transactions on Knowledge and Data Engineering 34(1), 2022. Author-hosted paper
- Derong Xu, Wei Chen, Wenjun Peng, Chao Zhang, Tong Xu, Xiangyu Zhao, Xian Wu, Yefeng Zheng, Yang Wang and Enhong Chen, “Large language models for generative information extraction: a survey,” Frontiers of Computer Science 18(6), 2024. Survey
- Urchade Zaratiana, Nadi Tomeh, Pierre Holat and Thierry Charnois, “GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer,” NAACL, 2024. Paper
- Lance Ramshaw and Mitch Marcus, “Text Chunking using Transformation-Based Learning,” Third Workshop on Very Large Corpora, 1995. Paper
- Mitchell P. Marcus, Beatrice Santorini and Mary Ann Marcinkiewicz, “Building a Large Annotated Corpus of English: The Penn Treebank,” Computational Linguistics 19(2), 1993. Paper
- Ronan Collobert, Jason Weston, Léon Bottou, Michael Karlen, Koray Kavukcuoglu and Pavel Kuksa, “Natural Language Processing (Almost) from Scratch,” Journal of Machine Learning Research 12, 2011. Paper
- Zhiheng Huang, Wei Xu and Kai Yu, “Bidirectional LSTM-CRF Models for Sequence Tagging,” arXiv:1508.01991, 2015. arXiv
- Guillaume Lample, Miguel Ballesteros, Sandeep Subramanian, Kazuya Kawakami and Chris Dyer, “Neural Architectures for Named Entity Recognition,” NAACL-HLT, 2016. Paper
- Xuezhe Ma and Eduard Hovy, “End-to-end Sequence Labeling via Bi-directional LSTM-CNNs-CRF,” ACL, 2016. Paper
- Alan Akbik, Duncan Blythe and Roland Vollgraf, “Contextual String Embeddings for Sequence Labeling,” COLING, 2018. Paper
- Sameer Pradhan, Alessandro Moschitti, Nianwen Xue, Hwee Tou Ng, Anders Björkelund, Olga Uryupina, Yuchen Zhang and Zhi Zhong, “Towards Robust Linguistic Analysis using OntoNotes,” CoNLL, 2013. Paper
- Leon Derczynski, Eric Nichols, Marieke van Erp and Nut Limsopatham, “Results of the WNUT2017 Shared Task on Novel and Emerging Entity Recognition,” Workshop on Noisy User-generated Text, 2017. Paper
- Christopher Walker, Stephanie Strassel, Julie Medero and Kazuaki Maeda, ACE 2005 Multilingual Training Corpus, LDC2006T06, Linguistic Data Consortium, 2006. Catalog
- Yuhao Zhang, Victor Zhong, Danqi Chen, Gabor Angeli and Christopher D. Manning, “Position-aware Attention and Supervised Data Improve Slot Filling,” EMNLP, 2017. Paper
- Yuan Yao, Deming Ye, Peng Li, Xu Han, Yankai Lin, Zhenghao Liu, Zhiyuan Liu, Lixin Huang, Jie Zhou and Maosong Sun, “DocRED: A Large-Scale Document-Level Relation Extraction Dataset,” ACL, 2019. Paper
- Wenxuan Zhou, Sheng Zhang, Yu Gu, Muhao Chen and Hoifung Poon, “UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition,” ICLR, 2024. arXiv
- Mike Schuster and Kuldip K. Paliwal, “Bidirectional Recurrent Neural Networks,” IEEE Transactions on Signal Processing 45(11), 1997. DOI