Sentence-BERT — Sentence Embeddings using Siamese BERT-Networks
選讀・NLP 11・以 BERT 做分類(情感分析、自然語言推論) 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
成對交叉編碼器必須聯合處理每一組候選句對,大規模語意搜尋因此昂貴。Reimers 與 Gurevych 探討如何產生可獨立計算、有效率比較的句向量 [20]。論點是共用編碼器配合合適句對目標,能比直接池化預訓練 BERT 得到更有用的餘弦相似度空間。先理解本章的雙編碼器/交叉編碼器、池化與餘弦相似度。
方法
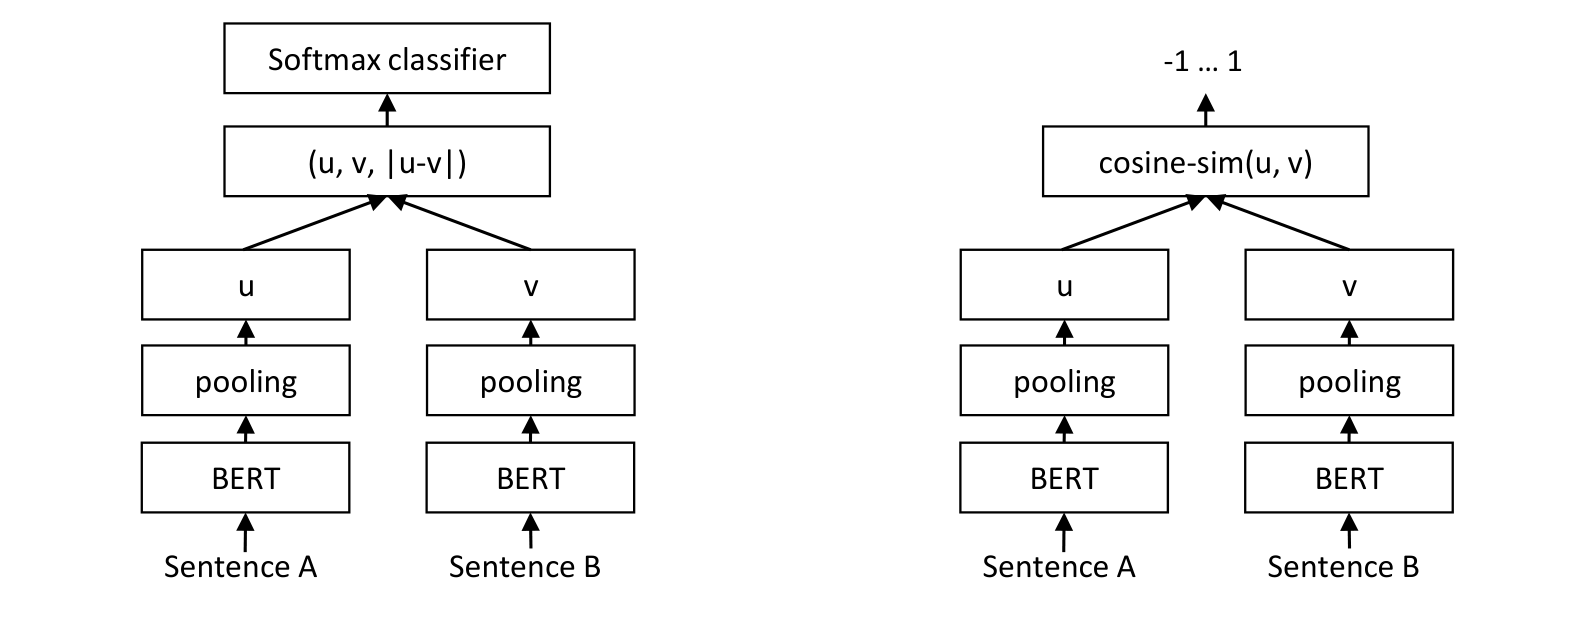
用相同 BERT 參數編碼各句,再對 token 狀態池化,通常取平均,得到一個向量。自然語言推論訓練把兩向量及其逐元素絕對差串接,送入 softmax 分類器。檢索時移除分類頭,直接比較向量:
、 是池化後句向量, 是訓練分類器的輸入,分號表示串接, 是各座標差值的絕對值。 是餘弦相似度,要求向量非零; 表示歐氏範數。分類器與餘弦評分器是不同函數,因此分類機率不是檢索分數。
圖 1 說明監督式句對標籤如何塑造共用編碼器。圖 2 說明效率來源:語料庫的句向量能預先計算並儲存。新查詢只需編碼自己,再做向量搜尋。這免除了每個查詢—候選配對重新聯合編碼的成本,但不會讓所有配對比較或索引成本消失。
結果
表 1 中,以 NLI 訓練的 SBERT-base 在 STS-B 得到 77.03,所列七個語意相似度任務的平均為 74.89,指標是 Spearman 相關乘以 100。直接平均池化 BERT 分別為 46.35、54.81。表格稱為「非監督式」相似度評估,是因為未在被評估的 STS 資料集上訓練;SBERT 仍使用有標籤的 NLI 訓練,不能稱為完全無標籤學習。
消融與設計證據
表 6 使用 STS-B 開發集,平均十個隨機種子。在 NLI 訓練設定中,平均、最大值及特殊 token 池化分別為 80.78、79.07、79.80。只串接兩個句向量為 66.04,加入絕對差後為 80.78。表中另外以 STS 訓練的迴歸設定呈現不同結果,因此池化結論必須連同訓練目標解讀。這些開發集分數也不能與表 1 的評估分數互換。
結論
訓練任務頭可以塑造一種表示,讓輸出頭移除後仍有用途。實際檢查理解時,列出固定文件集合中哪些計算可以快取、哪些需要對每個新查詢重做。接著回到本章的檢索討論,選擇如何搭配有效率的候選擷取與較昂貴的聯合重排序。
問題與限制
餘弦相似度不是校準過的機率,也不保證蘊涵或事實一致。即使詞彙高度重疊,否定與角色對調仍可能困難。領域、語言與句長影響遷移,截斷也可能刪除關鍵證據。應在實際集合評估檢索相關性,而不只看句子相似度相關;近似索引本身還有召回率與延遲的取捨。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapters 9–11, Manning, 2021. Publisher
- Susan McRoy, Principles of Natural Language Processing, Chapters 6 and 8, open textbook, 2021. Open textbook
- Jacob Devlin, Ming-Wei Chang, Kenton Lee and Kristina Toutanova, “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,” NAACL-HLT, 2019. Paper
- Google Research, BERT: original implementation, software, 2018. Classification, Question answering, Optimizer
- Richard Socher, Alex Perelygin, Jean Wu, Jason Chuang, Christopher D. Manning, Andrew Ng and Christopher Potts, “Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank,” EMNLP, 2013. Paper
- Andrew L. Maas, Raymond E. Daly, Peter T. Pham, Dan Huang, Andrew Y. Ng and Christopher Potts, “Learning Word Vectors for Sentiment Analysis,” ACL-HLT, 2011. Paper
- Samuel R. Bowman, Gabor Angeli, Christopher Potts and Christopher D. Manning, “A large annotated corpus for learning natural language inference,” EMNLP, 2015. Paper
- Adina Williams, Nikita Nangia and Samuel R. Bowman, “A Broad-Coverage Challenge Corpus for Sentence Understanding through Inference,” NAACL-HLT, 2018. Paper
- Suchin Gururangan, Swabha Swayamdipta, Omer Levy, Roy Schwartz, Samuel R. Bowman and Noah A. Smith, “Annotation Artifacts in Natural Language Inference Data,” NAACL-HLT, 2018. Paper
- Adam Poliak, Jason Naradowsky, Aparajita Haldar, Rachel Rudinger and Benjamin Van Durme, “Hypothesis Only Baselines in Natural Language Inference,” *SEM, 2018. Paper
- R. Thomas McCoy, Ellie Pavlick and Tal Linzen, “Right for the Wrong Reasons: Diagnosing Syntactic Heuristics in Natural Language Inference,” ACL, 2019. Paper
- Pranav Rajpurkar, Jian Zhang, Konstantin Lopyrev and Percy Liang, “SQuAD: 100,000+ Questions for Machine Comprehension of Text,” EMNLP, 2016. Paper
- Pranav Rajpurkar, Robin Jia and Percy Liang, “Know What You Don’t Know: Unanswerable Questions for SQuAD,” ACL, 2018. Paper
- Alex Wang, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy and Samuel R. Bowman, “GLUE: A Multi-Task Benchmark and Analysis Platform for Natural Language Understanding,” ICLR, 2019. Paper
- Alex Wang, Yada Pruksachatkun, Nikita Nangia, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy and Samuel R. Bowman, “SuperGLUE: A Stickier Benchmark for General-Purpose Language Understanding Systems,” NeurIPS, 2019. Paper
- Marius Mosbach, Maksym Andriushchenko and Dietrich Klakow, “On the Stability of Fine-tuning BERT: Misconceptions, Explanations, and Strong Baselines,” ICLR, 2021. Paper
- Chuan Guo, Geoff Pleiss, Yu Sun and Kilian Q. Weinberger, “On Calibration of Modern Neural Networks,” ICML, 2017. Paper
- Shrey Desai and Greg Durrett, “Calibration of Pre-trained Transformers,” EMNLP, 2020. Paper
- scikit-learn developers, “Classification metrics,” scikit-learn documentation, current online edition. Documentation
- Nils Reimers and Iryna Gurevych, “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks,” EMNLP-IJCNLP, 2019. Paper
- Shervin Minaee, Nal Kalchbrenner, Erik Cambria, Narjes Nikzad, Meysam Chenaghlu and Jianfeng Gao, “Deep Learning–based Text Classification: A Comprehensive Review,” ACM Computing Surveys 54(3), 2021. Survey
- Wenxuan Zhang, Yue Deng, Bing Liu, Sinno Jialin Pan and Lidong Bing, “Sentiment Analysis in the Era of Large Language Models: A Reality Check,” Findings of NAACL, 2024. Paper
- Benjamin Warner, Antoine Chaffin, Benjamin Clavié, Orion Weller, Oskar Hallström, Said Taghadouini et al., “Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference,” ACL, 2025. Paper
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Survey
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” Frontiers of Computer Science, 2026. Updated survey
- Ilya Loshchilov and Frank Hutter, “Decoupled Weight Decay Regularization,” ICLR, 2019. Paper