SinSR:蒸餾確定性的影像條件映射(CVPR 2024)
選讀・DLCV 09A.2・單步擴散超解析度 的論文導讀(第 2/8 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
SinSR [3] 要把 ResShift 完整映射壓成一次預測。但原反向鏈會持續加新雜訊,同一起點可有不同終點,平方誤差學生可能學到平均。
因此先建構確定性教師,再加學得反向映射/真值循環。前者固定種子—終點配對,後者加入超出教師樣本的 HR 監督。
方法
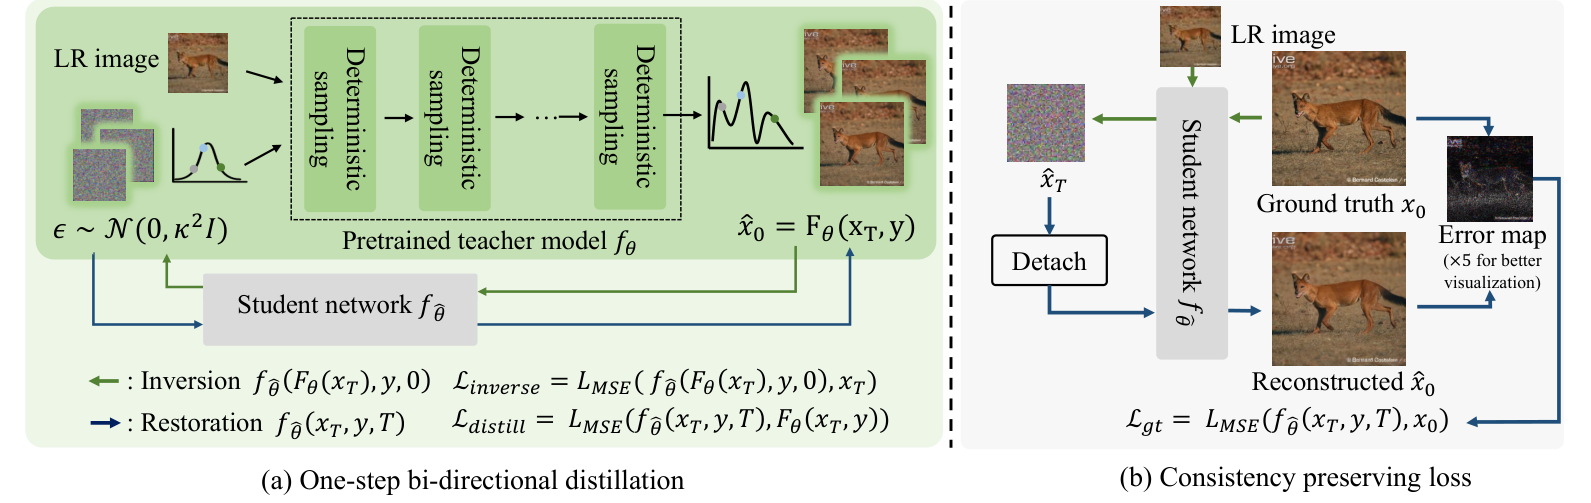
圖片來源: [3], arXiv:2311.14760v1, PDF 第 4 頁. 原始 PDF.
確定性教師。 從 ResShift 邊際 推導非馬可夫確定性更新;理想條件保留預期邊際,反向對 HR 預測為仿射:
是凍結復原器,係數依排程推導:、、。更新不新增反向雜訊,但初始狀態仍隨機。
教師端點。 對標準高斯 形成 ,執行多步教師得 。給定起點與觀測即固定;教師多次評估只在訓練建構目標。
直接蒸餾。 學生由教師初始化,以時間 查詢復原,最小化 。時間也區分反向查詢,不代表任意中間時間都已訓練。
學得反向。 同一網路在時間 0 從教師 HR 終點預測起點,使 接近 。這提供雙向關係,不新增部署反向網路。
真值循環。 以反向映射編碼配對 HR,再復原:
停止梯度 很重要。否則反向分支可能把額外 HR 殘差藏進起點,使分布偏離部署的 LR 加雜訊;復原分支就解了部署時不可取得的較簡單問題。
總目標與使用。 端點、反向與真值三項預設等權,以教師表示及合成配對訓練。部署只形成 LR 條件起點、做復原查詢與解碼,不執行循環或教師。固定種子有助比較,不證明細節正確;縮放、編解碼也要計時。
結果
ImageNet-Test 一步 SinSR 的 LPIPS/CLIPIQA 為 0.221/0.611,同表 15 步 ResShift 0.228/0.603;原模型直接截成一步則 0.383/0.340。學端點明顯不同於任意截短。
A100、×4、64 × 64 至 256 × 256:批次一 SinSR 0.058 秒,15 步 ResShift 0.633 秒;批次 64 的每圖時間變成 0.012/0.047 秒。速度比依合批而變,不能當成所有裝置與大圖的固定倍率。
消融實驗
補充損失消融的 PSNR/LPIPS/CLIPIQA:端點單獨 24.69/0.222/0.607,完整 24.56/0.221/0.611;移除端點但保留反向/真值為 23.49/0.226/0.671。無參考分數上升,像素保真卻下降。
RealSet65 停止梯度研究:僅蒸餾 CLIPIQA 0.6536,不停止循環 0.6994,選定停止循環 0.7150;MUSIQ 對應 61.330/61.342/62.169。推論起點視覺化也顯示不停止時的不匹配,因此梯度邊界有實質學習意義。
結論
確定性條件教師可直接蒸餾;學得反向讓配對 HR 加入監督,停止梯度避免不可用資訊捷徑。
限制與問題
學生仍繼承教師與合成退化假設,會遺漏或虛構細節。循環不證明所有輸出可逆或起點精確高斯。大型先驗方法的容量、目標不同,跨方法成績不是單一步損失的獨立比較。
參考文獻
- R. Wu, L. Sun, Z. Ma, L. Zhang, “One-Step Effective Diffusion Network for Real-World Image Super-Resolution,” NeurIPS, 2024. source
- Z. Yue, J. Wang, C. C. Loy, “ResShift: Efficient Diffusion Model for Image Super-resolution by Residual Shifting,” NeurIPS, 2023. source
- Y. Wang, W. Yang, X. Chen, et al., “SinSR: Diffusion-Based Image Super-Resolution in a Single Step,” CVPR, 2024. source · supplementary ablations
- A. Zhang, Z. Yue, R. Pei, W. Ren, X. Cao, “Degradation-Guided One-Step Image Super-Resolution with Diffusion Priors,” arXiv preprint, 2024. paper
- Y. Tai, R. Xie, C. Zhao, K. Zhang, Z. Zhang, J. Zhou, J. Yang, “AddSR: Accelerating diffusion-based blind super-resolution with adversarial diffusion distillation,” Pattern Recognition, 2026. published version · manuscript supplying the discussed tables
- L. Dong, Q. Fan, Y. Guo, Z. Wang, Q. Zhang, J. Chen, Y. Luo, C. Zou, “TSD-SR: One-Step Diffusion with Target Score Distillation for Real-World Image Super-Resolution,” CVPR, 2025. paper
- Z. Yue, K. Liao, C. C. Loy, “Arbitrary-steps Image Super-resolution via Diffusion Inversion,” CVPR, 2025. paper
- L. Sun, R. Wu, Z. Ma, S. Liu, Q. Yi, L. Zhang, “Pixel-level and Semantic-level Adjustable Super-resolution: A Dual-LoRA Approach,” CVPR, 2025. paper
- A. Liu, Y. Liu, J. Gu, Y. Qiao, C. Dong, “Blind Image Super-Resolution: A Survey and Beyond,” IEEE TPAMI (early access), 2022. source
- B. B. Moser, A. S. Shanbhag, F. Raue, S. Frolov, S. Palacio and A. Dengel, “Diffusion Models, Image Super-Resolution, and Everything: A Survey,” IEEE Transactions on Neural Networks and Learning Systems, vol. 36, no. 7, pp. 11793–11813, 2025. doi · arXiv
- E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, W. Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” ICLR, 2022. source
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018, pp. 586–595. doi · arXiv
- Z. Wang, C. Lu, Y. Wang, F. Bao, C. Li, H. Su, J. Zhu, “ProlificDreamer: High-Fidelity and Diverse Text-to-3D Generation with Variational Score Distillation,” NeurIPS, 2023. paper
- A. Sauer, D. Lorenz, A. Blattmann, R. Rombach, “Adversarial Diffusion Distillation,” ECCV, 2024. paper
- J. Cai, H. Zeng, H. Yong, Z. Cao, L. Zhang, “Toward Real-World Single Image Super-Resolution: A New Benchmark and a New Model,” Proceedings of the IEEE/CVF International Conference on Computer Vision, 2019. source
- P. Wei, Z. Xie, H. Lu, Z. Zhan, Q. Ye, W. Zuo, L. Lin, “Component Divide-and-Conquer for Real-World Image Super-Resolution,” ECCV, 2020. source
- E. Agustsson and R. Timofte, “NTIRE 2017 Challenge on Single Image Super-Resolution: Dataset and Study,” in Proc. IEEE CVPR Workshops, 2017, pp. 1122–1131. doi · CVF
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image Quality Assessment: From Error Visibility to Structural Similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- K. Ding, K. Ma, S. Wang, E. P. Simoncelli, “Image Quality Assessment: Unifying Structure and Texture Similarity,” IEEE TPAMI, 2022. source
- A. Mittal, R. Soundararajan and A. C. Bovik, “Making a “Completely Blind” Image Quality Analyzer,” IEEE Signal Processing Letters, vol. 20, no. 3, pp. 209–212, 2013. doi
- J. Ke, Q. Wang, Y. Wang, P. Milanfar, F. Yang, “MUSIQ: Multi-scale Image Quality Transformer,” ICCV, 2021. source
- S. Yang, T. Wu, S. Shi, S. Lao, Y. Gong, M. Cao, J. Wang, Y. Yang, “MANIQA: Multi-dimension Attention Network for No-Reference Image Quality Assessment,” CVPR Workshops, 2022. source
- J. Wang, K. C. K. Chan, C. C. Loy, “Exploring CLIP for Assessing the Look and Feel of Images,” AAAI, 2023. source
- X. Fan, Z. Wu, H. Wu, L. Cao, “A Survey on Pre-Trained Diffusion Model Distillations,” arXiv preprint, version 2, 2025. paper
- Z. Wu, Y. Dong, X. Wei, “TUDSR: Twice Upsampling-Diffusion for Higher Super-Resolution,” CVPR, 2026. paper
- P. Esser, R. Rombach, B. Ommer, “Taming Transformers for High-Resolution Image Synthesis,” CVPR, 2021. paper
- X. Wang, L. Xie, C. Dong, Y. Shan, “Real-ESRGAN: Training Real-World Blind Super-Resolution With Pure Synthetic Data,” Proceedings of the IEEE/CVF International Conference on Computer Vision, 2021. source
- J. Deng, W. Dong, R. Socher, L. Li, Kai Li, Li Fei-Fei, “ImageNet: A large-scale hierarchical image database,” CVPR, 2009. doi
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. source
- R. Wu, T. Yang, L. Sun, Z. Zhang, S. Li, L. Zhang, “SeeSR: Towards Semantics-Aware Real-World Image Super-Resolution,” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024. source · supplementary experiments
- H. Liu, C. Li, Q. Wu, Y. J. Lee, “Visual Instruction Tuning,” NeurIPS, 2023. source
- Y. Li, K. Zhang, J. Liang, et al., “LSDIR: A Large Scale Dataset for Image Restoration,” CVPR Workshops, 2023. paper
- T. Karras, S. Laine, T. Aila, “A Style-Based Generator Architecture for Generative Adversarial Networks,” CVPR, 2019. paper
- I. Loshchilov, F. Hutter, “Decoupled Weight Decay Regularization,” ICLR, 2019. paper
- P. Esser, S. Kulal, A. Blattmann, et al., “Scaling Rectified Flow Transformers for High-Resolution Image Synthesis,” ICML, 2024. paper
- J. Ho, T. Salimans, “Classifier-Free Diffusion Guidance,” arXiv preprint, 2022. paper
- R. Timofte, E. Agustsson, L. Van Gool, M.-H. Yang, L. Zhang et al., “NTIRE 2017 Challenge on Single Image Super-Resolution: Methods and Results,” in Proc. IEEE CVPR Workshops, 2017, pp. 1110–1121. doi · CVF