ViT:影像區塊與預訓練規模的角色
選讀・ML 05・注意力與視覺 Transformer 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
問題與論點
大致標準的 Transformer 能否從影像區塊序列學到有用表示?Dosovitskiy 等人顯示可以,而且預訓練規模是關鍵因素 [2]。先讀區塊 token 化、自注意力與殘差區塊。論點不是卷積永遠較差;論文明確研究資料量如何改變比較結果。
方法與圖解
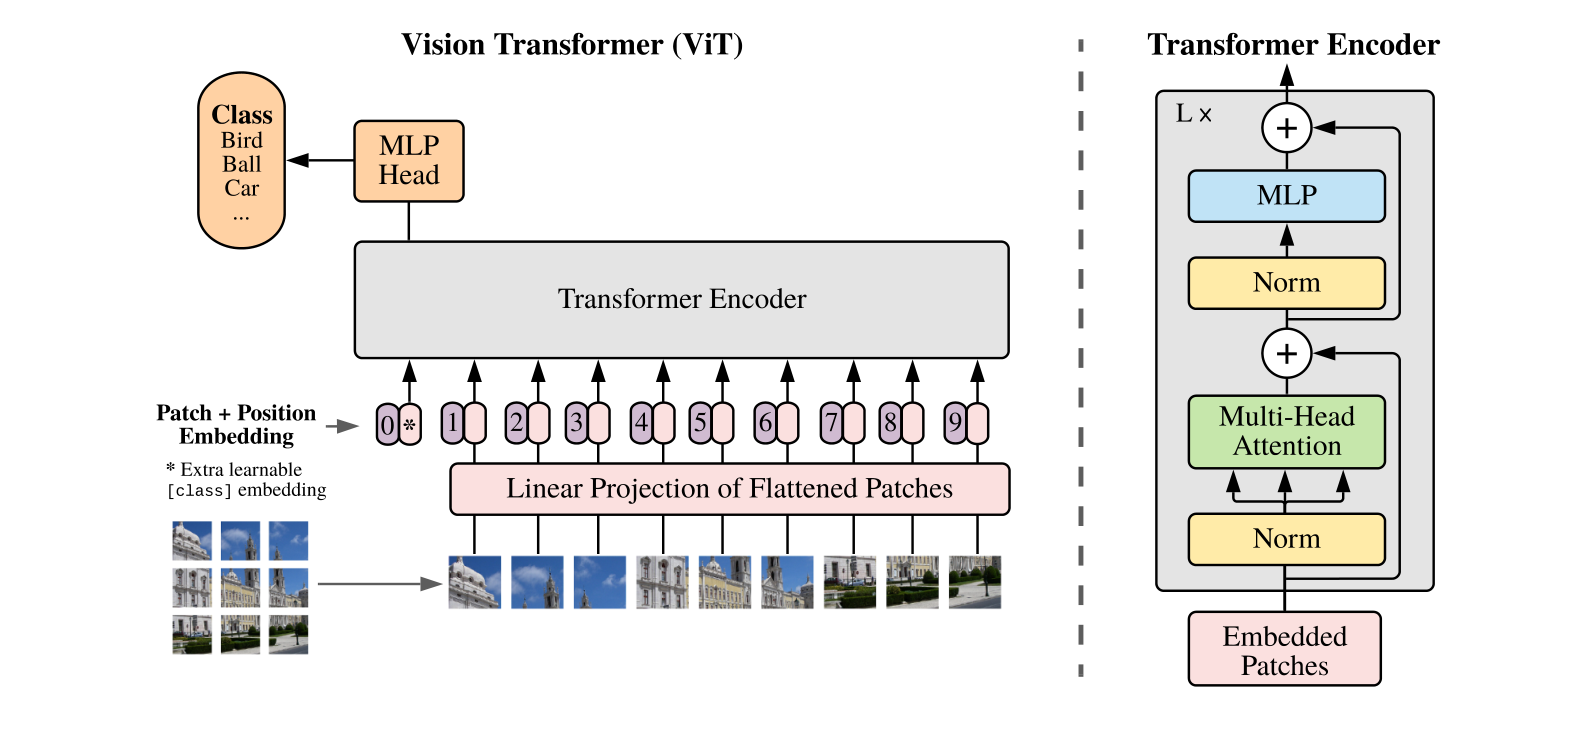
圖 1 先將影像切成互不重疊的區塊。各區塊展平後經共享的可學習線性投影,前面加上可學習分類 token,再加入位置嵌入。影像尺寸可被區塊寬度整除時,
其中 、 是影像像素高度與寬度, 是正方形區塊寬度, 是加入分類 token 前的影像 token 數。投影把區塊內容映到 Transformer 隱藏維度。位置嵌入補上空間資訊;只有內容向量的序列,本身無法辨認這些位置關係。
編碼器交替使用注意力及多層轉換,搭配正規化與殘差連接;最後把分類 token 的表示送入分類頭。即使影像尺寸不變,較小區塊也會增加 token 數,進而改變注意力成本。
證據
圖 3 比較 ImageNet、ImageNet-21k 與 JFT-300M 預訓練。相對表現隨資料條件改變:大型 ViT 在較少預訓練資料下較不具競爭力,大規模預訓練則支持良好的遷移。表 2 同時報告遷移結果與微調變動。看下游準確度時,也要一起看預訓練資料及計算量欄位;資源不同,不能把每列都當成只改架構的比較。
設計分析
卷積內建局部性與跨位置權重共享。ViT 仍使用區塊輸入結構,但更依賴資料學習有效空間關係。因此,資料規模研究是方法解釋的一部分,不只是實作細節。也要區分模型變寬與區塊變小:兩者都影響成本,但固定解析度時,只有後者直接改變輸入 token 數。
閱讀檢查點
固定影像大小,將區塊寬度減半。先算影像 token 數如何改變,再推理兩兩注意力矩陣的大小。指出圖 1 在哪裡加入空間順序,並解釋為何只看注意力視覺化,不能證明模型預測的因果解釋。
限制與下一步
大規模遷移成功,不保證小資料或低計算預算也有優勢。分類證據本身也不足以證明密集預測表現。接著讀 ML 06 表示學習,將監督式預訓練與 SimCLR 的目標比較:相近的下游用途,可以來自不同學習訊號。
接著閱讀: SimCLR:正樣本對如何塑造表示
參考文獻
- A. Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. arXiv
- A. Dosovitskiy et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” ICLR, 2021. arXiv
- S. Khan, M. Naseer, M. Hayat, S. W. Zamir, F. S. Khan and M. Shah, “Transformers in Vision: A Survey,” ACM Computing Surveys, 2022. arXiv
- H. Touvron et al., “Training data-efficient image transformers & distillation through attention,” ICML, 2021. arXiv
- Z. Liu et al., “Swin Transformer: Hierarchical Vision Transformer using Shifted Windows,” ICCV, 2021. arXiv
- T. Dao, D. Y. Fu, S. Ermon, A. Rudra and C. Ré, “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” NeurIPS, 2022. arXiv
- PyTorch,
scaled_dot_product_attentionandTransformerEncoderLayerdocumentation. Attention, Encoder layer MultiheadAttention mask semantics - R. Xu et al., “Visual Mamba: A Survey and New Outlooks,” arXiv:2404.18861, 2024. arXiv
- W. Yu and X. Wang, “MambaOut: Do We Really Need Mamba for Vision?,” CVPR, 2025. Paper
- C. M. Bishop and H. Bishop, Deep Learning: Foundations and Concepts, Springer, 2024, ch. 12. Book
- K. Han et al., “A Survey on Vision Transformer,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023. DOI
- Y. Liu et al., “A Survey of Visual Transformers,” IEEE Transactions on Neural Networks and Learning Systems, 2024. DOI
- L. Papa, P. Russo, I. Amerini and L. Zhou, “A Survey on Efficient Vision Transformers: Algorithms, Techniques, and Performance Benchmarking,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2024. DOI
- J. L. Ba, J. R. Kiros and G. E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. arXiv
- R. Xiong et al., “On Layer Normalization in the Transformer Architecture,” ICML, 2020. arXiv
- J. Su, M. Ahmed, Y. Lu, S. Pan, W. Bo and Y. Liu, “RoFormer: Enhanced Transformer with Rotary Position Embedding,” Neurocomputing, 2024. DOI
- P. Shaw, J. Uszkoreit and A. Vaswani, “Self-Attention with Relative Position Representations,” NAACL, 2018. arXiv
- M. Raghu, T. Unterthiner, S. Kornblith, C. Zhang and A. Dosovitskiy, “Do Vision Transformers See Like Convolutional Neural Networks?,” NeurIPS, 2021. arXiv
- H. Wu et al., “CvT: Introducing Convolutions to Vision Transformers,” ICCV, 2021. arXiv
- Z. Dai, H. Liu, Q. V. Le and M. Tan, “CoAtNet: Marrying Convolution and Attention for All Data Sizes,” NeurIPS, 2021. arXiv
- D. Bolya et al., “Token Merging: Your ViT But Faster,” ICLR, 2023. arXiv
- T. Darcet, M. Oquab, J. Mairal and P. Bojanowski, “Vision Transformers Need Registers,” ICLR, 2024. arXiv
- M. Oquab et al., “DINOv2: Learning Robust Visual Features without Supervision,” Transactions on Machine Learning Research, 2024. arXiv
- M. Dehghani et al., “Scaling Vision Transformers to 22 Billion Parameters,” ICML, 2023. arXiv
- A. Steiner et al., “How to train your ViT? Data, Augmentation, and Regularization in Vision Transformers,” Transactions on Machine Learning Research, 2022. arXiv
- D. Hendrycks and K. Gimpel, “Gaussian Error Linear Units (GELUs),” arXiv:1606.08415, 2016. arXiv
- H. Touvron, M. Cord and H. Jégou, “DeiT III: Revenge of the ViT,” ECCV, 2022. arXiv
- S. Mehta and M. Rastegari, “MobileViT: Light-weight, General-purpose, and Mobile-friendly Vision Transformer,” ICLR, 2022. arXiv
- T. Dao, “FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning,” ICLR, 2024. arXiv
- L. Zhu et al., “Vision Mamba: Efficient Visual Representation Learning with Bidirectional State Space Model,” ICML, 2024. arXiv
- Y. Liu et al., “VMamba: Visual State Space Model,” NeurIPS, 2024. arXiv
- Z. Liu et al., “Swin Transformer V2: Scaling Up Capacity and Resolution,” CVPR, 2022. arXiv
- A. Gu and T. Dao, “Mamba: Linear-Time Sequence Modeling with Selective State Spaces,” COLM, 2024. Author version
- T. Dao and A. Gu, “Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,” ICML, PMLR 235, 2024. Paper