第 13 章・影像圖樣分類
先備知識: 第 12 章・特徵擷取
你將學到
- 圖樣、圖樣向量與圖樣類別如何把「這張影像裡是什麼?」變成一個精確的決策問題
- 原型比對(prototype matching)怎麼運作:最小距離分類器、以相關進行的樣板比對、SIFT 特徵比對,以及結構描述的比對
- 為什麼貝氏分類器是最佳的,以及當每個類別都是高斯分布時它會變成什麼
- 感知器如何學習、多層網路如何用反向傳播訓練,以及卷積神經網路(CNN)如何自己學出特徵
- 訓練的實務面:過擬合、資料擴增與正則化
- 影像分類如何從 AlexNet 走到 Vision Transformer、CLIP 與 DINOv2,以及為什麼基準測試的數字值得懷疑
先看全貌
第 10 到 12 章把影像切成區域,再用數字描述每個區域:面積、矩、傅立葉描述子、紋理統計量、關鍵點描述子。這一章替整條流程收尾:拿這些描述,替每一個指定一個標籤,例如「硬幣」、「數字 7」、「水體」、「腫瘤」、「貓」。幾乎所有實用的視覺系統最後都要做這樣的決定,所以這裡正是影像處理與機器學習交會的地方。
本章的順序既是歷史,也是觀念的推進 [1]。先是直接使用原型(每個類別的典型成員)的分類器;接著是統計上最佳的分類器,它需要知道各類別的機率分布;最後是類神經網路,它直接從資料學出決策規則。卷積形式的網路連特徵也一併學習,取代了第 12 章大部分的人工特徵設計。若想先溫習監督式學習、成本函數與梯度下降,可以參考部落格文章 Introduction to Machine Learning(英文)。
背景
白話版。 分類器就是一個函數:看一份「描述」,回答「這東西屬於哪一組?」。我們用一批已知答案的例子來建立它。
圖樣(pattern)是代表某個物體或區域的一組描述子。圖樣類別(pattern class)是一群具有某種共同性質的圖樣。我們把 個類別記為 。機器的圖樣辨識,就是自動把每個圖樣指派到它的類別,而且錯誤越少越好。
工作分成兩個階段:
- 表示(representation)。 決定要量什麼:像素值、區域描述子、關鍵點描述子,或學出來的特徵。第 12 章處理的就是這一階段。
- 決策(decision)。 有了量測值之後選出類別。本章處理這一階段。
方法通常以監督式學習訓練:手上有一組標籤已知的訓練集,用來設定分類器的參數;再用分類器從沒看過的測試集評估表現。第三份資料驗證集用來挑選設定,例如網路大小或何時停止訓練。把這幾份資料混用,是結果過度樂觀最常見的原因。
理解任何分類器的好方法是決策函數(decision function)。替每個類別 定義一個函數 ,再把 指派給函數值最大的類別:
其中 是圖樣, 是類別 的純量分數。類別 與 之間的決策邊界,就是 的集合。本章從最簡單到深度網路的每一種分類器,都只是建立這些函數的不同方式。
圖樣與圖樣類別
白話版。 描述物體的方式有兩種:一串數字(向量),或描述各部件怎麼連在一起(字串或樹)。
圖樣向量
最常見的表示法是 個量測值組成的行向量:
其中每個 是一個描述子,例如區域面積、色相、某個矩不變量,或某個紋理濾波器的響應。一個向量就是 維特徵空間中的一個點。好的特徵會讓同類別的圖樣彼此靠近、不同類別的圖樣彼此遠離;特徵若不好,再厲害的分類器也救不回來。
這裡有兩個實務重點。第一,單位不同的特徵需要正規化,否則數值範圍最大的那個特徵會主宰所有距離。以水果為例,色相落在 ,直徑卻以公分計,所以比較距離前要先把每個特徵標準化成平均 0、變異數 1。第二,整張影像本身也可以是圖樣向量:把 影像攤平成 維向量。類神經網路就是這樣「看」影像的,這也是它們需要大量資料的原因,因為這個空間非常巨大。
結構圖樣:字串與樹
有些物體用「部件如何排列」來描述,比用一串數字更恰當。以鏈碼(chain code,第 12 章)描出的邊界,就是一個符號字串,例如 0 0 1 2 2 3 ...。一個場景可以用樹描述:根節點是整張影像,子節點是主要區域,再往下是子區域。結構描述保留了「在裡面」、「在上方」、「接在後面」這類關係,而向量會把它們丟掉。對形狀、字元與圖表這類「部件的順序與連接方式承載意義」的物體,結構描述特別有用。
以原型比對進行圖樣分類
白話版。 每個類別留一個典型範例。要分類新東西時,看它最像哪一個典型範例。
最小距離分類器
最簡單的原型是每個類別的平均向量,由該類別的訓練圖樣算出:
其中 是類別 的訓練圖樣數。新圖樣被指派到歐氏距離 最小的類別。
對 最小化 ,等同於最大化
因為 與 無關。這個 對 是線性的。類別 與 之間的邊界為
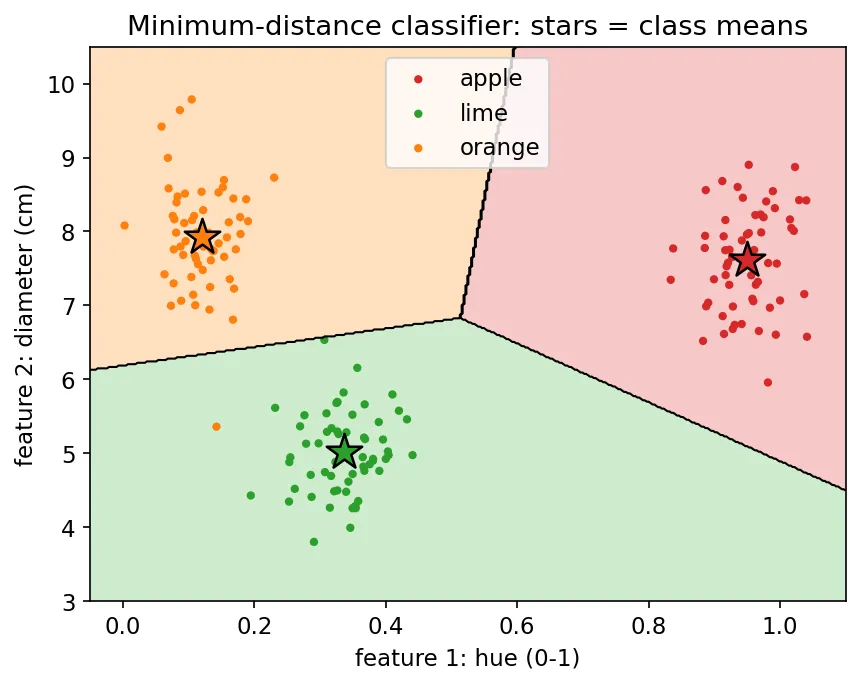
也就是連接 與 線段的垂直平分線:在 2 維是一條直線,3 維是一個平面,一般情況下是超平面。圖 13.1 是它在水果資料上的結果。
import numpy as np

def fit_min_distance(X, y):
    """X: (n, d) pattern vectors, y: (n,) labels -> class list and mean vectors."""
    classes = np.unique(y)
    M = np.stack([X[y == c].mean(axis=0) for c in classes])
    return classes, M

def predict_min_distance(X, classes, M):
    d2 = ((X[:, None, :] - M[None, :, :]) ** 2).sum(axis=-1)  # (n, W) squared distances
    return classes[d2.argmin(axis=1)]

rng = np.random.default_rng(0)
X = np.r_[rng.normal([0, 0], 1, (100, 2)), rng.normal([4, 3], 1, (100, 2))]
y = np.repeat([0, 1], 100)
classes, M = fit_min_distance(X, y)
print("training accuracy:", (predict_min_distance(X, classes, M) == y).mean())當各類別是緊密、大致圓形的群集,而且平均之間的距離遠大於群集本身的散布時,這個分類器表現很好。若某個類別是細長的、彎曲的,或由好幾群組成,它就會失敗,因為一個平均代表不了整個類別。兩個簡單的延伸可以改善:每個類別保留多個原型,或乾脆保留所有訓練圖樣,取最近的那一個(最近鄰規則)。
以相關進行比對(樣板比對)
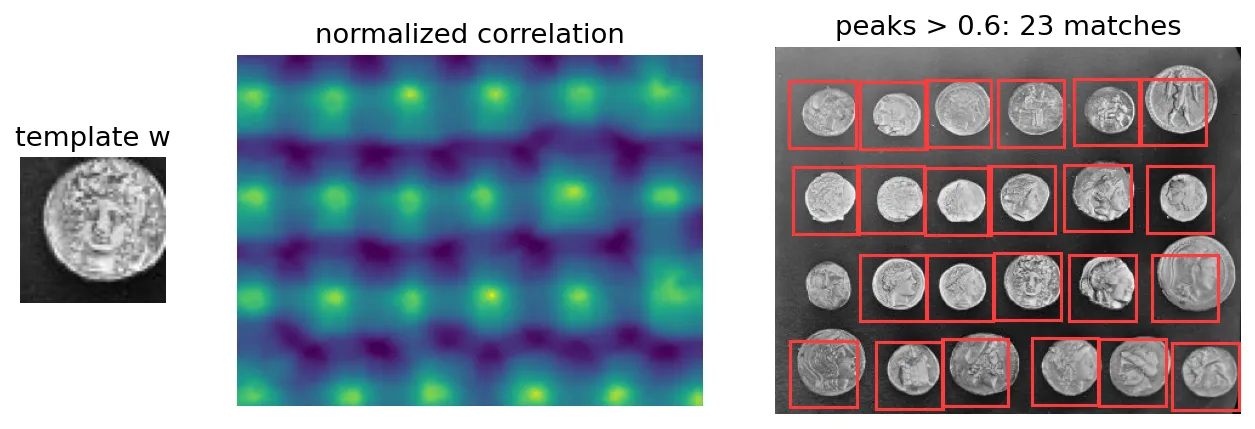
當原型是一張小影像而不是向量時,就把它拿去跟大影像的每個位置比較,這是原型比對的 2 維版本。原始相關 會偏好亮的區域,因此改用正規化相關係數(normalized correlation coefficient):
其中 是樣板, 是它的平均, 是影像, 是樣板左上角位於 時其下方影像區塊的平均;總和範圍是樣板的支撐區。因為先減去平均再除以標準化項, 落在 ,而且區塊亮度被縮放或平移時不會改變。 表示在亮度與對比之外完全吻合。注意這是相關而非卷積:樣板不翻轉(見 卷積與影像濾波)。
import cv2
import numpy as np
from skimage import data

img = data.coins().astype(np.float32)
w = img[170:225, 180:235]                            # one coin as the template
R = cv2.matchTemplate(img, w, cv2.TM_CCOEFF_NORMED)  # values in [-1, 1]
y0, x0 = np.unravel_index(R.argmax(), R.shape)
print("best match at", (int(x0), int(y0)), "score", round(float(R.max()), 3))
圖 13.2 也顯示了這個方法的極限。樣板幾乎找到了每一枚硬幣,因為每枚硬幣都是暗背景上大小相近的亮圓盤;在這個解析度下,它分不出不同的硬幣圖案。相關對旋轉與縮放也很敏感:樣板轉 30° 或放大 30%,峰值可能就不明顯了。常見的補救方式是用一組旋轉、縮放過的樣板去搜尋,或改為比對不變特徵而非原始像素。
比對 SIFT 特徵
第 12 章的尺度不變特徵轉換(scale-invariant feature transform,SIFT)[3] 正好提供這類不變特徵。每個關鍵點都有位置、尺度、方向和一個 128 維描述子。要判斷某個原型物體是否出現在場景影像中:
- 分別從原型與場景擷取關鍵點與描述子。
- 對原型的每個描述子,以歐氏距離找出場景中最近與第二近的描述子。
- 只有當最近距離明顯小於第二近距離時才接受,例如 。這個比值檢定(ratio test)[3] 能排除重複紋理中的模稜兩可配對。
- 檢查被接受的配對是否符合同一個幾何轉換(相似、仿射或投影轉換);不符合的就是離群值。
若通過幾何一致性檢查的配對夠多,就判定「物體存在」。這仍然是原型比對:原型是一組描述子,而「距離」是一致配對的數量。它能容忍旋轉、尺度變化、部分遮蔽和中等程度的視角改變,這些都是樣板比對做不到的。
比對結構原型
對字串與樹,距離必須同時比較符號與它們的順序。兩個簡單的量度:
- 形狀數相似度。 若兩個封閉邊界被編碼成形狀數(shape number,正規化的鏈碼差分,第 12 章),它們的相似程度 就是兩個形狀數仍然相同的最大階數(編碼長度)。相似的形狀在高階時仍然一致。距離可以定義為 :形狀相同時為零,在粗略階數就已不同時則很大。
- 字串相似度。 把字串 和 逐個符號對齊。令 為相符的位置數, 為不相符的位置數, 是 的長度。則 在完全相符時為無限大,完全不符時為 0。比較寬容的版本是編輯距離(edit distance):把一個字串變成另一個所需的最少插入、刪除與替換次數,可用動態規劃計算。
新字串被指派給原型字串最相似的類別。結構比對如今較少見,但「比較部件的序列與圖」這個想法,仍延續在圖比對,以及比較一組 token 的 Transformer 模型中。
最佳(貝氏)統計分類器
白話版。 如果我們知道每個類別出現得有多頻繁、它的量測值通常長什麼樣子,就存在一條最好的規則:選出「在已量到的值之下,機率最高」的類別。平均而言,沒有任何規則犯的錯會比它更少。
推導
令 為圖樣 來自類別 的機率, 為把真正屬於 的圖樣判為 時的損失。選擇類別 的期望損失稱為條件風險(conditional risk):
利用貝氏定理 ,可以改用類別條件密度 (類別 的圖樣長什麼樣子)與事前機率 (這個類別有多常見)來表示。 對每個 都一樣,比較風險時可以省略。
對每個 都選出 最小之 的分類器,會使整體平均損失最小,這就是它被稱為最佳的原因:在已知真實分布的前提下,沒有任何規則能做得更好。在常見的 0–1 損失下( 時 ,否則為 1),每種錯誤代價相同,
最小化它等於最大化決策函數
換句話說:選出事後機率最大的類別。問題在於我們從來不知道真實的密度,只能從訓練資料估計,而分類器的好壞取決於這些估計的好壞。
高斯圖樣類別的貝氏分類器
假設每個類別都是平均為 、共變異數矩陣為 的多變量高斯分布:
其中 是 的維度, 是 的行列式。因為對數是遞增函數,可以改為最大化 ,並丟掉常數 :
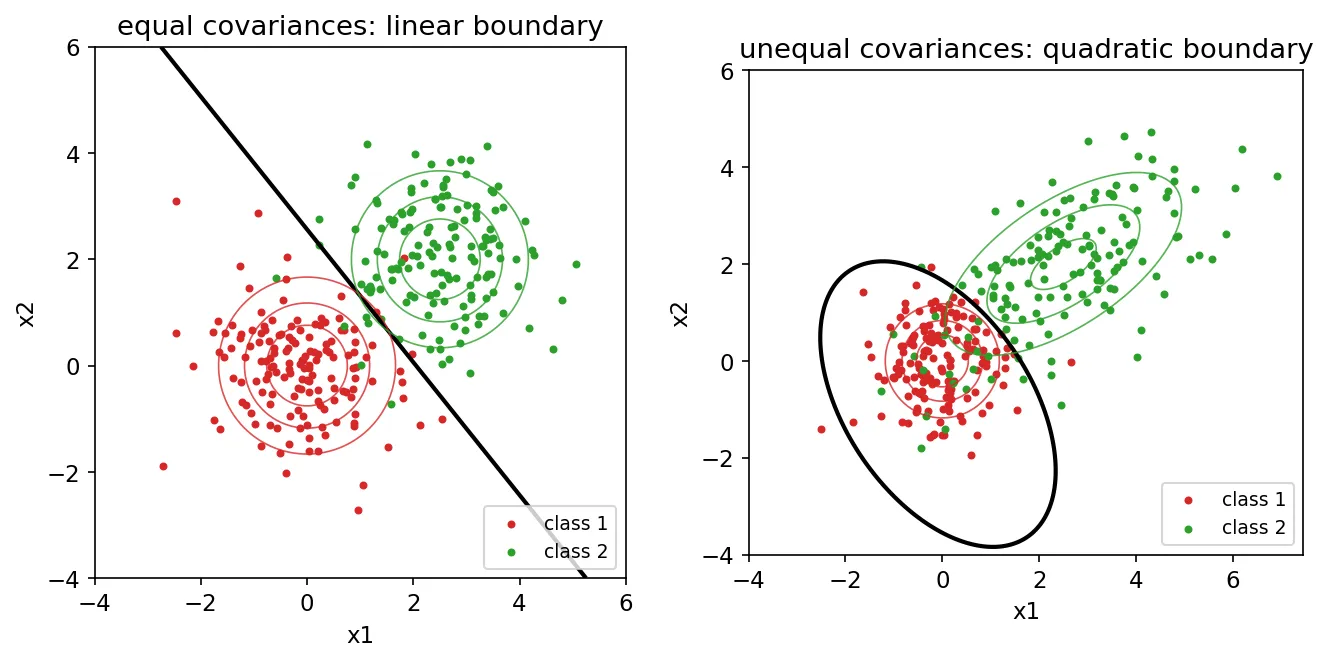
最後一項是馬氏距離(Mahalanobis distance)平方的一半;這種距離會把空間拉伸,使每個類別的散布看起來是圓的。這個 對 是二次的,所以類別之間的邊界是二次曲面:在 2 維是橢圓、拋物線或雙曲線。兩個特例把我們帶回前面的小節:
- 共變異數相同(所有 皆 )。二次項 對所有類別都相同而抵消,剩下線性函數 。邊界變成超平面。
- 單位共變異數且事前機率相等(,)。函數化簡為 ,正是最小距離分類器。所以最小距離分類器只在「類別是圓形、散布相同、出現機率相等的高斯分布」時才是貝氏最佳。
從樣本估計 與 很容易:樣本平均與樣本共變異數。若訓練集中各類別的比例反映真實情況,事前機率就可以用這些比例。
import numpy as np

class GaussianBayes:
    def fit(self, X, y):
        self.classes = np.unique(y)
        self.m = [X[y == c].mean(0) for c in self.classes]
        self.C = [np.cov(X[y == c].T) for c in self.classes]
        self.logP = [np.log((y == c).mean()) for c in self.classes]
        return self

    def decision(self, X):
        scores = []
        for m, C, lp in zip(self.m, self.C, self.logP):
            d = X - m
            maha = np.einsum("ni,ij,nj->n", d, np.linalg.inv(C), d)
            scores.append(lp - 0.5 * np.linalg.slogdet(C)[1] - 0.5 * maha)
        return np.stack(scores, axis=1)            # (n, W): one d_j(x) per class

    def predict(self, X):
        return self.classes[self.decision(X).argmax(1)]
每個類別的共變異數參數數量是 。4 個特徵時每類 10 個數字,很容易估計;1,000 個特徵時約有 50 萬個,除非資料極多,否則估計會很不可靠。這是高斯貝氏分類器最適合用在「短而精挑細選」的特徵向量上的原因之一。
應用:多光譜影像的像素分類
遙測衛星會在多個光譜波段記錄地面上的每個位置。於是每個像素自然就是一個圖樣向量 ,NIR 代表近紅外光。健康的植被在近紅外光反射強、在紅光反射弱;水體在近紅外光很暗;建成區在各波段都中等偏亮。
我們合成了一張 的場景,含三個類別(水體、植被、建成區),替每個類別設定四個波段的平均反射率,並在每個波段加上標準差 的獨立高斯雜訊。每類只隨機挑 50 個像素當訓練資料,估計 與 ,再用高斯貝氏規則分類所有像素。
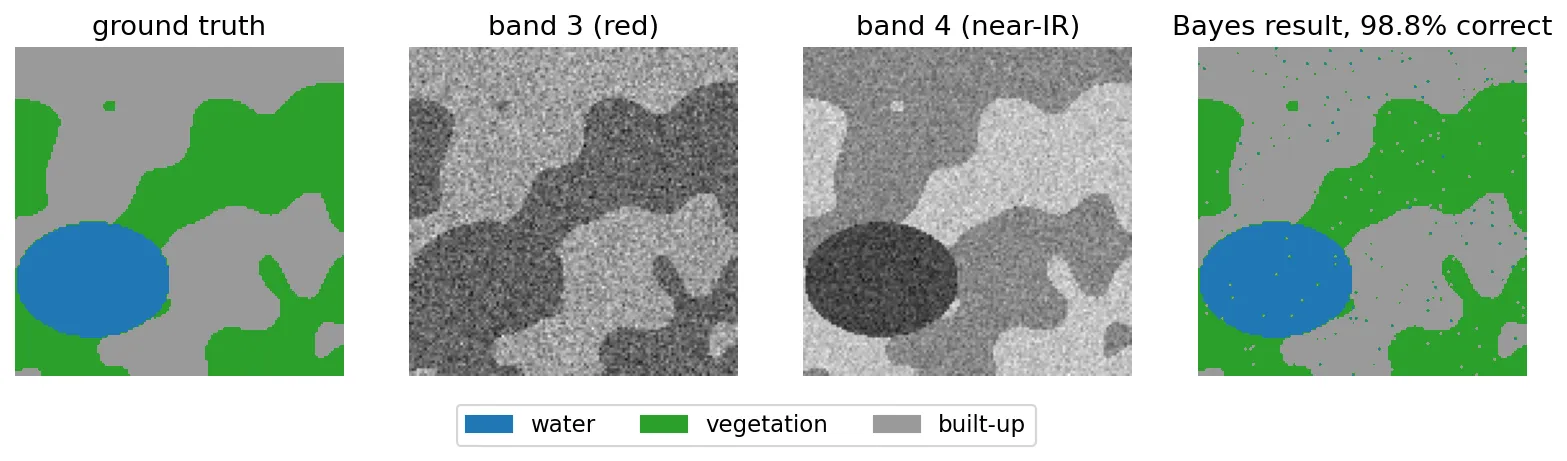
這裡有兩個教訓。第一,單一波段不夠:在紅光波段中,水體與植被的值很接近,是波段的組合把它們分開的。第二,剩下的錯誤都是零散的單一像素。這裡的貝氏規則把每個像素獨立處理,忽略了鄰居。加入空間脈絡,例如平滑決策分數,或使用能看到一整個鄰域的分類器,就能去掉大部分這類錯誤。這個觀察自然地把我們帶到卷積網路。
類神經網路與深度學習
白話版。 類神經網路是一疊非常簡單的單元。每個單元把輸入乘上權重加總,再決定要「發射」多強。每犯一次錯就微調一下權重,網路就能自己學會決策規則,不需要我們寫出機率分布。
背景
貝氏分類器需要密度估計,而在高維空間中這很難。另一條路是直接從訓練資料學出決策函數。類神經網路用許多簡單、可調整、分層排列的運算單元做到這一點。這個想法可追溯到 1950 年代末的感知器 [4];1986 年反向傳播廣為人知後,多層網路才變得實用 [5];2012 年深度卷積網路贏得 ImageNet 競賽後,它在影像領域成為主流 [7]。關於感知器、MLP、激活函數與訓練技巧的精簡整理,可參考部落格筆記 機器學習及類神經網路筆記。
感知器
感知器(perceptron)計算輸入的加權和加上偏差,然後輸出正負號:
其中 是權重, 是偏差(bias)。邊界 是一個超平面。為了簡化符號,在每個圖樣後面補一個常數 1,,並把偏差併入權重 ,於是 。
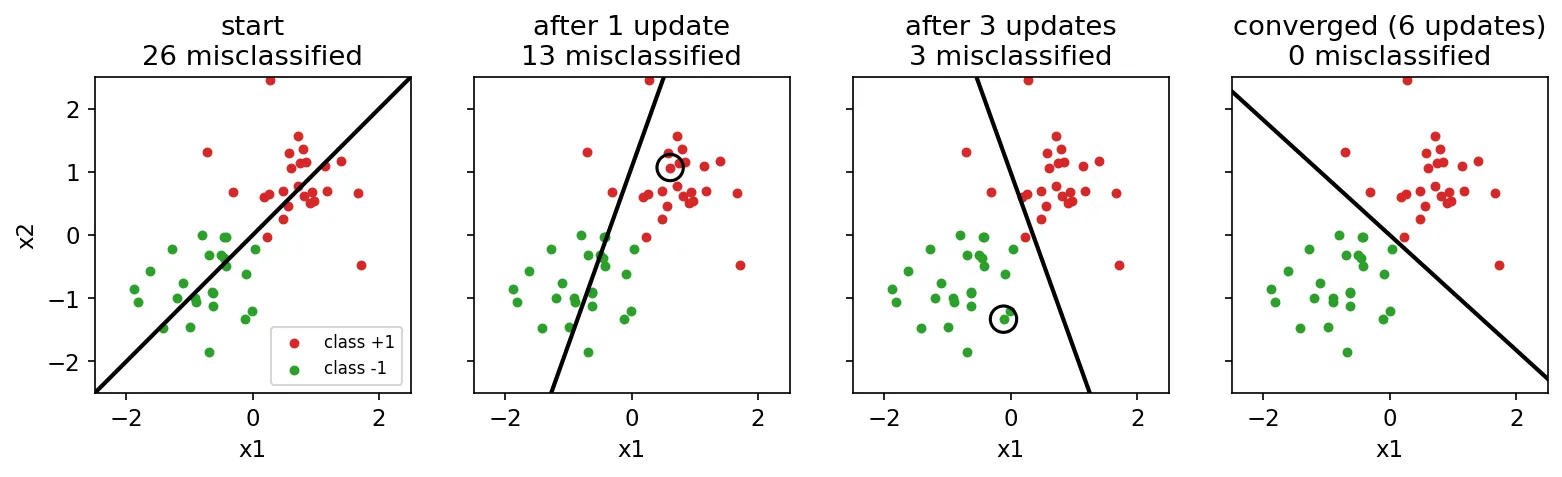
學習規則。 把標籤編碼成: 為 、 為 。一次呈現一個訓練圖樣,在第 步:
其中 是學習率。每次修正都會移動超平面,把出錯的圖樣推向正確的一側:更新後 會增加 。若兩個類別線性可分,這個程序保證在有限次修正後停止,並得到一個分隔超平面;若不可分,它永遠不會穩定下來。這時改用梯度下降去最小化一個平滑的誤差,例如 與 的差的平方(最小均方法,又稱 delta 規則)。這個想法直接通往反向傳播。
import numpy as np

def train_perceptron(X, y, alpha=0.5, epochs=100):
    """X: (n, d), y in {-1, +1}. Returns augmented weights (w_1..w_d, w_0)."""
    Xa = np.c_[X, np.ones(len(X))]                 # append the constant input 1
    w = np.zeros(Xa.shape[1])
    for _ in range(epochs):
        mistakes = 0
        for xi, yi in zip(Xa, y):
            if yi * (w @ xi) <= 0:                 # wrong side (or on the line)
                w += alpha * yi * xi
                mistakes += 1
        if mistakes == 0:                          # a full clean pass: converged
            break
    return w
單一感知器只能畫出一個超平面。它解不了 XOR:兩個類別位於正方形的對角。要畫出彎曲或分成多段的邊界,就需要更多層。
多層前饋網路
多層前饋網路(multilayer feedforward network,又稱多層感知器 MLP)把多層單元疊起來。第 層接收第 層的輸出,預測時沒有任何訊號往回流。與感知器不同的是,每個單元會把加權和送進一個平滑、可微分的激活函數 ,例如 sigmoid 、雙曲正切,或線性整流單元 。平滑性讓以梯度為基礎的訓練成為可能;非線性則讓深度有意義,因為一疊純線性的層會塌縮成單一線性層。
只要有兩個隱藏層和足夠的單元,網路幾乎能形成任何形狀的決策區域。實務上的問題不是網路能不能表示某個邊界,而是訓練能不能從手邊的資料中找到它。
前向傳遞
把層編號為 ,第 0 層是輸入 。每一層:
其中 是權重矩陣(第 列是進入單元 的權重), 是偏差向量, 是淨輸入, 是激活值, 逐元素作用。對 類問題,輸出層有 個單元,其淨輸入以 softmax 函數轉成機率:
預測類別就是 最大的那一個。注意輸出層就是一組決策函數 ,和「背景」一節完全相同。隱藏層算出的特徵,讓這些簡單的線性決策函數就足夠了。
反向傳播
訓練就是調整所有權重,降低衡量輸出錯得多離譜的損失 。分類問題的標準選擇是交叉熵 ,其中 是 one-hot 標籤(正確類別為 1,其餘為 0)。對 sigmoid 輸出,經典的替代選擇是平方誤差 。我們需要每一層的 ,反向傳播用一次由後往前的連鎖律就把它們全部算出來 [5]。
定義第 層的誤差訊號為 。
步驟 1:輸出層。 softmax 搭配交叉熵時,導數出奇地簡單:
(sigmoid 輸出搭配平方誤差時則是 , 表示逐元素相乘。)
步驟 2:往回傳。 第 層的單元 只透過第 層的淨輸入影響 ,且 。由連鎖律得到
誤差沿著前向時傳遞訊號的同一組權重(轉置後)往回走。
步驟 3:梯度。 因為 ,
每個權重的梯度就是「輸出端的誤差」乘以「輸入端的激活值」。
步驟 4:更新。 以學習率 做梯度下降:
反向傳遞的計算量和前向傳遞差不多,這正是擁有數百萬個權重的網路能被訓練的原因。感知器規則可以看成「單層、使用階梯激活函數」的特例。
訓練
實務上,我們在一小批隨機挑選的訓練圖樣(mini-batch)上平均梯度、更新,然後重複,這就是隨機梯度下降(SGD)。走過整個訓練集一次稱為一個 epoch。訓練會持續許多個 epoch,同時觀察驗證集上的損失。學習率是最重要的設定:太大,損失會震盪甚至發散;太小,訓練慢如蝸牛。權重必須以小的隨機數初始化而不是全零,否則同一層的所有單元會算出同樣的東西、收到同樣的更新,永遠分不開。
下面的 NumPy 程式訓練一個兩層網路解 XOR,也就是單一感知器解不了的問題:
import numpy as np

rng = np.random.default_rng(0)
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], float)
y = np.array([[0], [1], [1], [0]], float)         # XOR: not linearly separable

W1, b1 = rng.normal(0, 1, (2, 8)), np.zeros(8)    # input -> 8 hidden units
W2, b2 = rng.normal(0, 1, (8, 1)), np.zeros(1)    # hidden -> 1 output
sig = lambda z: 1 / (1 + np.exp(-z))
alpha = 1.0

for step in range(5000):
    # forward pass
    a1 = np.tanh(X @ W1 + b1)
    out = sig(a1 @ W2 + b2)
    # backward pass (cross-entropy loss with a sigmoid output)
    d2 = (out - y) / len(X)                        # delta at the output layer
    d1 = (d2 @ W2.T) * (1 - a1 ** 2)               # delta at the hidden layer
    W2 -= alpha * a1.T @ d2;  b2 -= alpha * d2.sum(0)
    W1 -= alpha * X.T @ d1;   b1 -= alpha * d1.sum(0)

print(out.round(3).ravel())                        # close to [0, 1, 1, 0]
(這裡每一列是一個圖樣,所以矩陣乘法相對於上面的式子是轉置的。)
深度卷積神經網路
白話版。 我們不告訴網路該量哪些特徵,而是讓它把可學習的小濾波器在影像上滑動,就像第 3 章的濾波器一樣,並自己學會哪些濾波器有助於分類。結果前幾層會找出邊緣和斑點,後面幾層再把它們組合成部件與整個物體。
為什麼全連接網路處理影像很吃力
把一張 影像送進一個有 2,048 個隱藏單元的全連接層,這一層就有 個權重。而且這一層忽略了「相鄰像素彼此相關」以及「往右移兩個像素的 3 還是 3」這兩件事。CNN 把這兩點直接建進結構裡 [6]。
卷積層
卷積層對輸入套用 個小核(例如 )。若有 個輸入通道 ,輸出通道 在像素 的淨輸入為
再接一個激活函數,通常是 ReLU:。這個總和和第 3 章一樣是空間相關,但核的值 是學出來的。每個輸出通道是一張特徵圖(feature map):在核所對應的圖樣出現的地方,值就大。有兩個想法大幅減少參數量:
- 局部連接。 每個輸出只取決於一個小鄰域(它的感受野,receptive field)。
- 權重共享。 同一個核用在每一個位置,所以在某處學到的特徵,在任何地方都能偵測到。
在單通道影像上用 8 個 核,只需要 個參數,相比之下前面是 819,200 個。
池化層
池化層(pooling layer)縮小每張特徵圖,通常是取每個不重疊 區塊的最大值(max-pooling)或平均值。它讓寬和高減半,使響應能容忍小幅位移,也擴大了後續層的感受野。卷積與池化堆疊數次後,得到的特徵會對更大、更抽象的結構產生響應。
全連接層與整條流程
最後一個池化層之後,特徵圖被攤平成一個向量,經過一或多個全連接層,最後接 softmax。圖 13.6 是我們訓練的小網路。
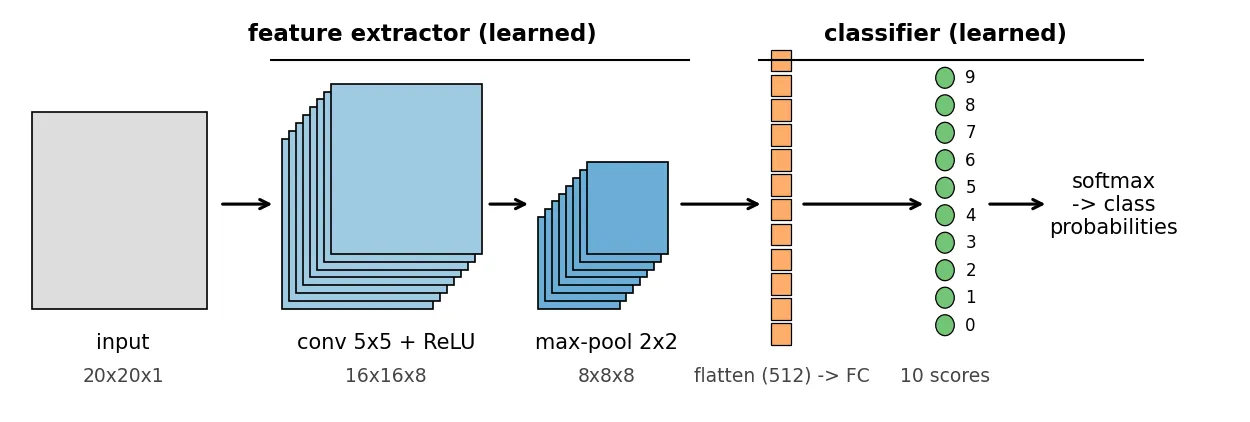
這是本章最關鍵的觀念。傳統流程是人工設計的特徵 → 分類器;CNN 則是學出來的特徵 → 分類器,兩部分一起用反向傳播訓練,最小化同一個損失。最後的全連接 softmax 層只是一組線性決策函數,和最小距離分類器、等共變異數貝氏分類器中遇到的是同一種東西。改變的是:這些線性函數所作用的空間本身是學出來的。
訓練 CNN
反向傳播完全照用,只是局部導數不同:
- 卷積。 因為一個權重在所有位置共享,它的梯度是所有位置的總和:,本身就是輸入與誤差圖的相關。傳回輸入的誤差,則是 與(翻轉後的)核的卷積。
- 最大池化。 梯度只流向每個區塊中原本是最大值的那個輸入,其他為零。
- ReLU。 處讓梯度通過, 處擋下。
以下用 SciPy 寫出一個「卷積、ReLU、池化」階段的前向傳遞:
import numpy as np
from scipy.signal import correlate2d
from skimage import data, transform

img = transform.resize(data.camera(), (64, 64), anti_aliasing=True)
k = np.array([[-1, 0, 1], [-2, 0, 2], [-1, 0, 1]], float)    # one 3x3 "filter"
fmap = np.maximum(correlate2d(img, k, mode="valid") + 0.0, 0)  # conv + bias + ReLU
pooled = fmap[:62, :62].reshape(31, 2, 31, 2).max(axis=(1, 3))  # 2x2 max-pooling
print(img.shape, "->", fmap.shape, "->", pooled.shape)
實作範例:數字辨識
CNN 的經典試驗場是手寫數字辨識,LeNet 類型的網路就是在 MNIST 數字資料上發展出來的 [6]。為了讓一切自給自足、可重現,我們自行產生類 MNIST 的 數字:每個 0–9 的數字以六種 OpenCV 字型之一繪出,大小、筆畫粗細、位移與旋轉(±15°)都是隨機的,最後加上雜訊(圖 13.7)。
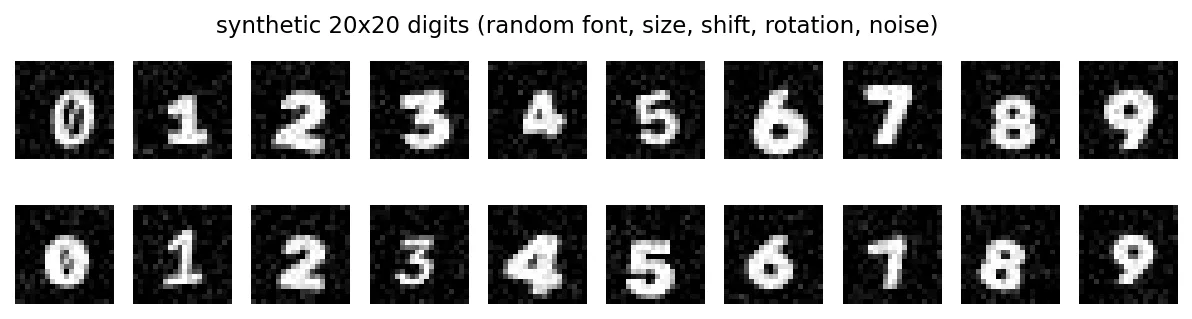
圖 13.6 的網路(八個 濾波器、ReLU、 最大池化、接到 10 個輸出的全連接層、softmax 搭配交叉熵)在 scripts/figures/dip_ch13.py 中用大約 80 行 NumPy 寫成。我們以 mini-batch SGD(batch 大小 32、學習率 0.05、少量權重衰減)在 3,000 張數字上訓練 12 個 epoch,在另外 1,000 張驗證數字上達到 98.5% 準確率。圖 13.8 呈現它學到了什麼。
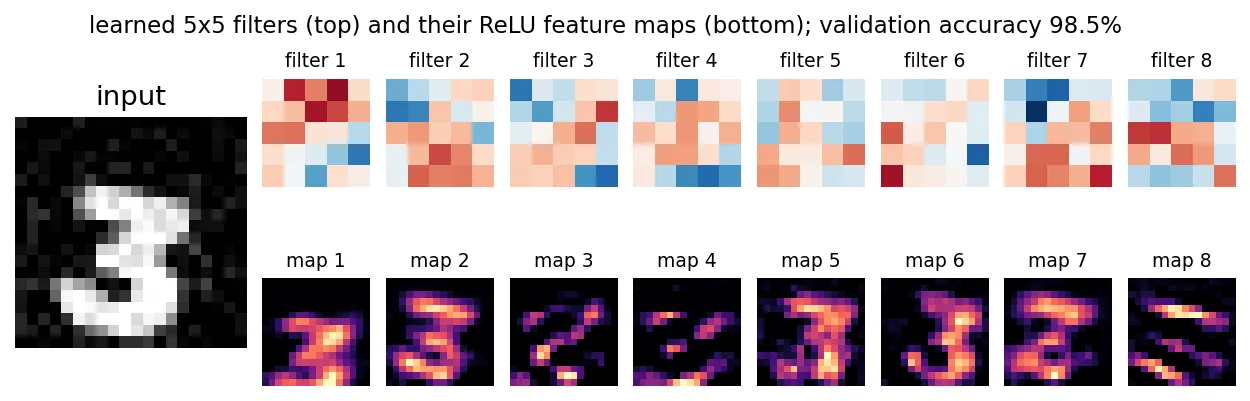
沒有人叫網路去偵測邊緣。有方向性、像邊緣的核之所以出現,是因為它們對分辨數字有用。在自然影像上訓練的大型網路,第一層也有相同的現象,越深的層則出現越複雜的圖樣。
一些實作上的細節
白話版。 把作業背得滾瓜爛熟的網路,考試還是可能考砸。訓練的實務技巧,大多是在讓它學會一般規則,而不是記住特定例子。
過擬合
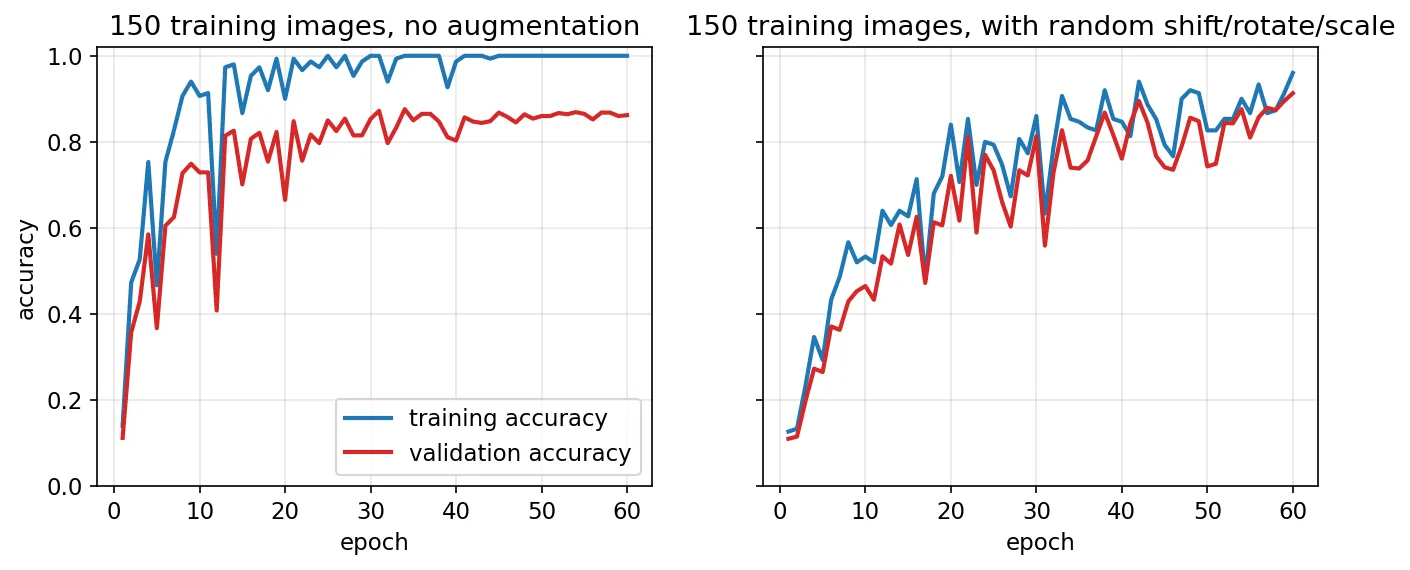
參數多、訓練例子少的網路,可以靠死背把訓練誤差壓到零,但對新資料的誤差仍然很高。訓練表現與驗證表現之間的這個落差就是過擬合(overfitting)。圖 13.9(左)清楚呈現了這一點:只用 150 張數字訓練時,CNN 的訓練準確率達到 100%,驗證準確率卻只有 86.2%。
基本的防線:
- 更多資料。 沒有什麼比它更可靠。資料擴增(見下)是取得更多資料的便宜方法。
- 驗證集與提早停止(early stopping)。 追蹤驗證準確率,保留最佳 epoch 的權重。
- 更小或結構更好的模型。 與全連接層相比,CNN 的權重共享本身就是很強的正則化。
資料擴增
資料擴增(data augmentation)以保留標籤的轉換產生新的訓練例子:小幅位移、旋轉、縮放、翻轉(只在合理時使用:翻轉的貓還是貓,但翻轉的 b 會變成 d)、裁切、亮度與對比變化,以及加入雜訊 [18]。每個 epoch 看到的每張影像都略有不同,因此更難死背,而對這些轉換的不變性則從資料中學到。
正則化
正則化(regularization)加入對較簡單解的偏好:
- 權重衰減(weight decay, 正則化)在損失中加上 ,等於在每個權重的梯度上加 ,把權重往零收縮。我們的訓練腳本使用 。
- Dropout 在每個訓練步驟隨機把一部分單元設為零,讓任何單元都無法依賴特定的夥伴。測試時使用所有單元,並適當縮放權重。效果類似於把許多「變瘦」的網路做集成平均 [17]。
其他實務細節同樣重要:輸入正規化(平均 0、變異數 1)、以「依輸入數量縮放的變異數」初始化權重(讓激活值在層與層之間既不爆炸也不消失)、訓練過程中逐步降低學習率,以及永遠只在開發期間沒被用來做任何決定的測試集上報告最終結果。
現代觀點
教科書這一章結束的地方,正是現代影像分類開始的地方。以下六篇綜述與回顧論文,勾勒出這個領域此後的走向。
深度學習之前的統計圖樣辨識。 Jain、Duin 與 Mao 的回顧 [2] 至今仍是傳統領域最清楚的地圖:表示、特徵擷取與選擇、貝氏與最近鄰規則、線性與非線性分類器、分類器結合,以及錯誤率估計。它的主要結論是:特徵表示與評估流程比分類器的選擇更重要。這個結論經得起時間考驗。深度學習並沒有推翻它,而是把「表示」這一部分自動化了。
CNN 時代。 Rawat 與 Wang [11] 回顧了用於影像分類的 CNN,從 1980 年代末的起源一路到 2017 年,依架構、正則化、最佳化與實務技巧整理了三百多篇論文。他們描繪的脈絡始於 LeCun 等人以梯度訓練、用於文件辨識的網路 [6];AlexNet [7] 使用 GPU、ReLU、dropout 與資料擴增,在 2012 年贏得 ImageNet 大規模視覺辨識競賽 [10],讓這條路線加速;VGG [8] 顯示以小型 核堆出的深度有幫助;ResNet [9] 透過恆等捷徑連接學習殘差函數,讓非常深的網路變得可以訓練。這些架構都仍看得出圖 13.6 的影子:卷積、非線性、池化、線性分類器,以反向傳播訓練。
視覺中的 Transformer。 Vision Transformer(ViT)[12] 把影像切成 的小塊,把每塊當成一個 token,以自注意力(self-attention)而非卷積處理這個序列。只要預訓練資料足夠,它能追平甚至超越 CNN。Khan 等人的綜述 [13] 涵蓋了用於分類、偵測、分割等任務的眾多視覺 Transformer 變體,並討論它們對大規模預訓練的依賴。隨後 ConvNeXt [14] 顯示:一個純 CNN,只要借用 Transformer 的設計選擇一步步現代化,又能再度與之匹敵。實務上的教訓是:架構家族的差異,不如訓練資料、規模與訓練配方來得重要。
基礎模型特徵與零樣本分類。 2021–2023 年的兩項發展改變了「訓練分類器」的意義。CLIP [15] 同時訓練一個影像編碼器與一個文字編碼器,讓相符的影像–說明文字對擁有相近的嵌入向量。於是不需要任何標註影像,就能建出新的分類器:把 a photo of a {class} 這類提示文字嵌入,再把每張影像指派給文字嵌入最相似的類別。這就是一個最小距離分類器,只是原型來自語言。DINOv2 [16] 在一個大型、經過篩選的影像集上以自監督方式學習通用視覺特徵,完全不用標籤;它凍結的特徵只要在上面接一個線性層或最近鄰規則,就能做出很強的分類。兩者都把最昂貴的部分,也就是特徵擷取器,只訓練一次;上面的分類器往往正是本章前半的簡單規則之一。
資料擴增與正則化。 Shorten 與 Khoshgoftaar 的綜述 [18] 把擴增方法分成基本影像操作(幾何與色彩轉換、核濾波、影像混合、隨機抹除)與學習式方法(對抗式訓練、以 GAN 合成、神經風格轉換、以後設學習搜尋擴增策略)。它的結論和圖 13.9 一致:在標註資料有限時,擴增是降低過擬合最便宜也最有效的方法之一。
評估陷阱與資料集偏差。 Torralba 與 Efros [19] 問了一個簡單的問題:分類器能不能分辨一張影像來自哪個資料集?答案是可以,而且遠高於隨機猜測,顯示每個基準資料集都有自己的「指紋」;在一個資料集上訓練的模型,換到另一個資料集時也泛化得很差。Liu 與 He [20] 用現代網路,以及非常大、非常多樣的網路規模資料集重做了這個實驗:現代網路仍能在未見過的影像上高準確率地辨認出來源資料集,而且靠的是可泛化的特徵而不是死背。資料集偏差並沒有因為規模變大而消失。由此有兩個實務結論:在某個基準上的準確率,描述的是那個基準,而不是真實的視覺世界;只要可能,就用與訓練資料獨立蒐集的資料來測試。
改變了什麼,沒改變什麼。 深度學習取代了人工特徵,也讓分類器本身幾乎成了附屬品:一個線性 softmax 層。但它沒有改變決策理論的基礎。softmax 輸出被訓練來估計事後機率,所以網路是在逼近貝氏規則;交叉熵就是負對數概似。原型比對以「嵌入空間中的最近鄰搜尋」形式延續,用於零樣本分類與檢索。在物體外觀固定、訓練資料稀少的受控工業檢測中,以正規化相關做樣板比對仍然是對的工具。理解傳統方法,才知道現代方法到底在最佳化什麼,以及什麼時候簡單的方法就夠了。
重點整理
- 分類透過決策函數 替圖樣指定標籤;兩個決策函數相等之處就是邊界。
- 最小距離分類以類別平均為原型,邊界是垂直平分線。正規化相關與 SIFT 比對則是針對影像與關鍵點的原型比對。
- 貝氏分類器使平均損失最小。對高斯類別它是二次的;共變異數相同時是線性的;單位共變異數且事前機率相等時就化簡為最小距離。
- 感知器靠修正錯誤學出分隔超平面。使用平滑激活函數的多層網路能學出非線性邊界,反向傳播用一次反向傳遞算出所有梯度。
- CNN 是學出來的特徵擷取器(卷積、非線性、池化)加上學出來的線性分類器。權重共享讓它有效率,也能容忍位移。
- 過擬合是最主要的實務風險。使用驗證資料、資料擴增、權重衰減與 dropout,並且不要碰測試集。
- 現代系統常把大型預訓練特徵擷取器(CLIP、DINOv2)與非常簡單的分類器搭配。基準準確率反映了資料集偏差,所以要用獨立蒐集的資料測試。
練習
- 手算平分線。 兩個類別平均為 與 。把最小距離邊界 寫成 的方程式,並驗證兩個平均的中點落在邊界上。
提示
,且 。邊界為 ,即 。中點 代入得 。✓
- 事前機率的影響。 在一維問題中,類別 是平均 0 的高斯分布,類別 是平均 4 的高斯分布,變異數都是 1。求 時與 時的貝氏門檻值。門檻往哪個方向移動?為什麼這樣合理?
提示
令 ,得 。事前機率相等時 ; 時 。門檻往較少見的類別移動,於是更多模稜兩可的圖樣被判給常見的類別。
- 相關的不變性。 證明若把影像區塊的每個像素換成 (),正規化相關係數 不變。若 會怎樣?接著用
cv2.matchTemplate在skimage.data.camera()上驗證。
提示
減去平均就消去了 。 在分子出現一次,在分母則以 出現,所以 時抵消。(相片負片)時 變號:完美吻合變成 。
- 停不下來的感知器。 產生兩團互相重疊的高斯點雲,用本章的感知器規則跑 100 個 epoch,畫出每個 epoch 的錯誤數。接著改用梯度下降最小化平方誤差 ,比較兩條學習曲線。
提示
感知器的錯誤數會一直起伏,因為即使沒有任何直線能完美分開,每一次錯誤仍會移動直線。最小平方規則則會收斂到一條固定的折衷直線,因為它的損失平滑且為凸函數。
- 計算參數量。 某網路的輸入是 灰階影像。比較 (a) 有 1,024 個隱藏單元的全連接層與 (b) 有 32 個 核的卷積層的權重數量(含偏差)。不補邊時,(b) 會產生多少個輸出?
提示
(a) 。(b) 個參數,產生 32 張 的特徵圖,也就是 個輸出。參數少、輸出多,這就是權重共享。
- 有害的擴增。 使用
scripts/figures/dip_ch13.py中的數字產生器,在擴增中加入隨機 180° 旋轉。重新訓練後,檢查哪兩個數字之間的混淆增加最多,並解釋原因。
提示
6 轉 180° 看起來像 9(0、1、8 則看起來和自己一樣)。這個擴增不再保留標籤,等於教網路對同一個形狀給出互相矛盾的標籤。可以預期 6 與 9 的混淆會大幅上升。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 13. publisher page
- A. K. Jain, R. P. W. Duin, and J. Mao, “Statistical Pattern Recognition: A Review,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 22, no. 1, pp. 4–37, 2000. doi:10.1109/34.824819
- D. G. Lowe, “Distinctive Image Features from Scale-Invariant Keypoints,” International Journal of Computer Vision, vol. 60, 2004. doi:10.1023/B:VISI.0000029664.99615.94
- F. Rosenblatt, “The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain,” Psychological Review, vol. 65, 1958. doi:10.1037/h0042519
- D. E. Rumelhart, G. E. Hinton, and R. J. Williams, “Learning Representations by Back-Propagating Errors,” Nature, vol. 323, 1986. doi:10.1038/323533a0
- Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-Based Learning Applied to Document Recognition,” Proceedings of the IEEE, vol. 86, 1998. doi:10.1109/5.726791
- A. Krizhevsky, I. Sutskever, and G. E. Hinton, “ImageNet Classification with Deep Convolutional Neural Networks,” Advances in Neural Information Processing Systems 25 (NIPS), 2012. paper
- K. Simonyan and A. Zisserman, “Very Deep Convolutional Networks for Large-Scale Image Recognition,” arXiv:1409.1556, 2014. arXiv
- K. He, X. Zhang, S. Ren, and J. Sun, “Deep Residual Learning for Image Recognition,” arXiv:1512.03385, 2015. arXiv
- O. Russakovsky, J. Deng, H. Su, J. Krause, S. Satheesh, et al., “ImageNet Large Scale Visual Recognition Challenge,” arXiv:1409.0575, 2014. arXiv
- W. Rawat and Z. Wang, “Deep Convolutional Neural Networks for Image Classification: A Comprehensive Review,” Neural Computation, vol. 29, no. 9, 2017. doi:10.1162/neco_a_00990
- A. Dosovitskiy, L. Beyer, A. Kolesnikov, et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” ICLR, 2021. arXiv
- S. Khan, M. Naseer, M. Hayat, S. W. Zamir, F. S. Khan, and M. Shah, “Transformers in Vision: A Survey,” ACM Computing Surveys, 2022. arXiv
- Z. Liu, H. Mao, C.-Y. Wu, C. Feichtenhofer, T. Darrell, and S. Xie, “A ConvNet for the 2020s,” CVPR, 2022. arXiv
- A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, et al., “Learning Transferable Visual Models From Natural Language Supervision,” arXiv:2103.00020, 2021. arXiv
- M. Oquab, T. Darcet, T. Moutakanni, et al., “DINOv2: Learning Robust Visual Features without Supervision,” arXiv:2304.07193, 2023. arXiv
- N. Srivastava, G. Hinton, A. Krizhevsky, I. Sutskever, and R. Salakhutdinov, “Dropout: A Simple Way to Prevent Neural Networks from Overfitting,” Journal of Machine Learning Research, vol. 15, pp. 1929–1958, 2014. JMLR
- C. Shorten and T. M. Khoshgoftaar, “A Survey on Image Data Augmentation for Deep Learning,” Journal of Big Data, vol. 6, 2019. doi:10.1186/s40537-019-0197-0
- A. Torralba and A. A. Efros, “Unbiased Look at Dataset Bias,” CVPR, 2011. paper page
- Z. Liu and K. He, “A Decade’s Battle on Dataset Bias: Are We There Yet?,” ICLR, 2025. arXiv