第 1 章・緒論
先備知識: 影像就是陣列
你將學到
- 什麼是數位影像——用文字說明,也用函數 表示——以及「處理」一張影像是什麼意思
- 從低階、中階、高階處理的角度,看影像處理在哪裡結束、電腦視覺從哪裡開始
- 這個領域的起源:用電報傳送的新聞照片、月球探測器,以及醫學掃描儀
- 我們處理的影像來自電磁波譜的哪些波段,以及哪些非光學的訊號
- 數位影像處理的基本步驟,同時也是本系列 13 章的路線圖
- 一套影像處理系統由哪些硬體與軟體組成,以及深度學習如何重塑相機的處理流程
先看全貌
今天你看到的幾乎每一張影像,在抵達你眼前之前都經過了影像處理。從光線打到手機感測器,到照片出現在螢幕上,手機已經執行了幾十道運算。醫院的電腦斷層掃描儀根本不「拍照」:它量測 X 光沿著成千上萬條直線被吸收了多少,再把影像算出來。氣象衛星記錄的是人眼看不見的能量,再把它變成你看得懂的地圖。
這一章是出發前的地圖。它界定這個領域、說明它的來歷、展示它能處理的訊號種類,並列出後續各章逐一介紹的步驟 [1]。本章沒有艱深的內容,但後面每一章都會用到我們在這裡建立的詞彙。
什麼是數位影像處理?
白話版。 把一張圖切成由小方格組成的網格,每個方格存一個數字(彩色影像則存幾個數字),這張圖就變成了數位影像。處理的意思是:把這個數字網格交給電腦,得到某種有用的結果。
影像是一個函數
在數學上,灰階影像是一個二維函數
其中 與 是空間座標,函數值 是影像在該點的強度(intensity),也稱為灰階值(gray level)。對相機而言,強度正比於抵達感測器的光能;對 X 光底片而言,則正比於穿透人體的輻射量。在真實世界中,、 與 都可以連續變化。
當這三個量都是有限且離散的,影像就是數位影像。我們在一個 的網格上取樣,並把每個值量化成 個等級之一:
是列數, 是行數, 是每個值所用的位元數( 就得到熟悉的 0 到 255)。網格中的每個元素稱為像素(pixel,即 picture element 的縮寫)。第 2 章會說明取樣與量化該如何選擇;現在只要記得:影像就是一個矩陣。
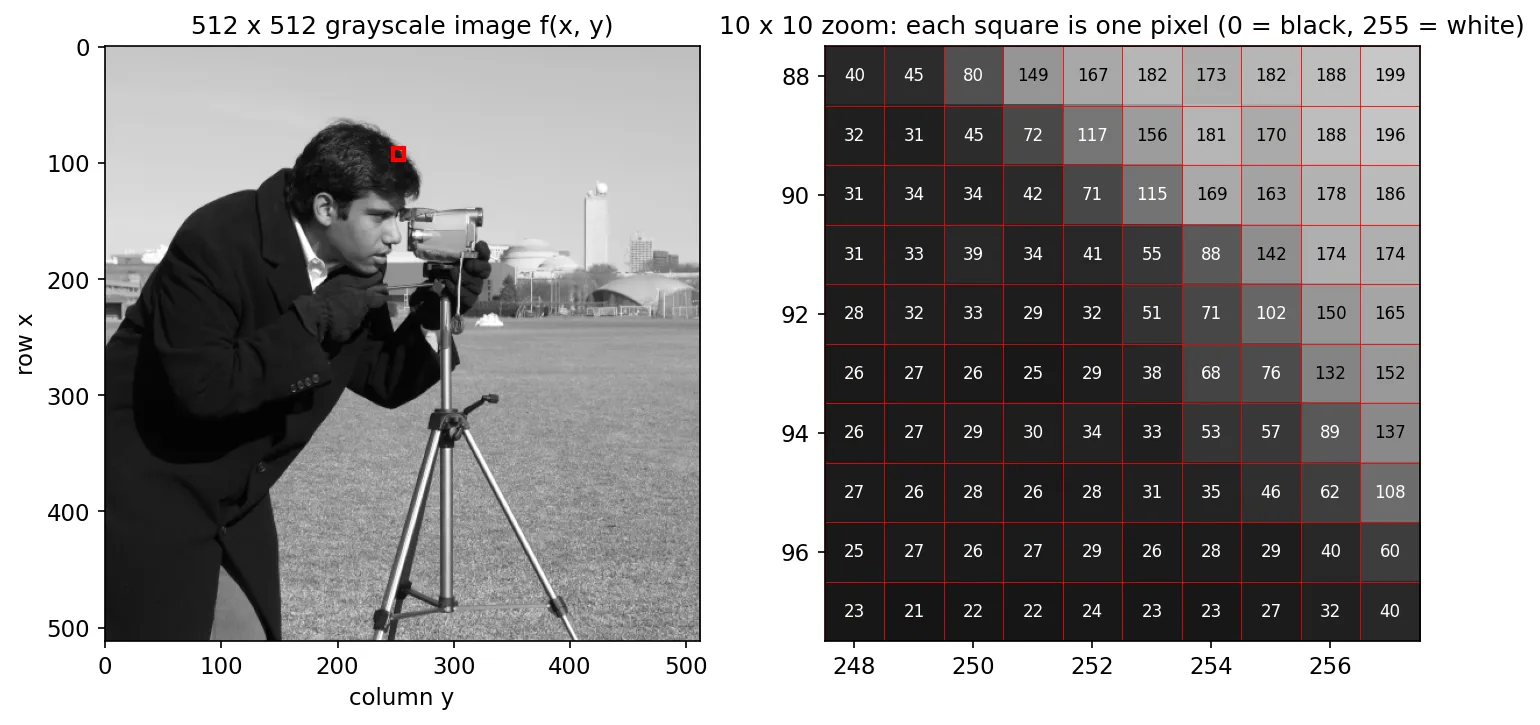
在程式中,這個矩陣就是一個 NumPy 陣列。用 [列, 行] 索引可以讀取單一像素,用切片則取得一塊鄰域:
from skimage import data

f = data.camera()            # 一張 512 x 512 的灰階照片
print(f.shape, f.dtype)      # (512, 512) uint8
print(f[100, 250])           # 第 100 列、第 250 行的強度
print(f.min(), f.max())      # 最暗與最亮的值
patch = f[88:92, 248:252]    # 4 x 4 鄰域就是一個子陣列
print(patch)彩色影像會多一個通道索引,寫成 ;醫學體積資料則多一個深度索引,寫成 。本章的觀念完全適用。
處理在哪裡結束,視覺從哪裡開始
影像處理在哪裡結束、影像分析或電腦視覺從哪裡開始,大家看法不一。一種極端的說法是:影像處理只包含輸入與輸出都是影像的運算。這個規則很乾淨,卻太狹隘——連計算一張照片的平均亮度這麼簡單的事都會被排除在外。另一個極端是電腦視覺,它的目標是模仿人類視覺:理解場景、辨識物體,並據此行動。電腦視覺的教科書把它視為一個獨立領域,核心是幾何、三維重建與辨識 [7]。
比較實用的看法,是把它想成一條連續光譜,上面有三種處理 [1]:
- 低階處理:輸入影像,輸出影像。例如去除雜訊、提高對比、銳化。不涉及任何解讀。
- 中階處理:輸入影像,輸出屬性(attributes):區域、邊緣、輪廓,或對個別物體的量測。影像分割(把影像切成有意義的部分),以及把這些部分描述成電腦能分類的形式,都是典型的中階工作。
- 高階處理:替一群已辨識出的物體「賦予意義」。讀懂一整頁文字,或判斷一張醫學影像裡有沒有腫瘤,都屬於高階工作。光譜的這一端,就是影像分析與電腦視覺交會之處。
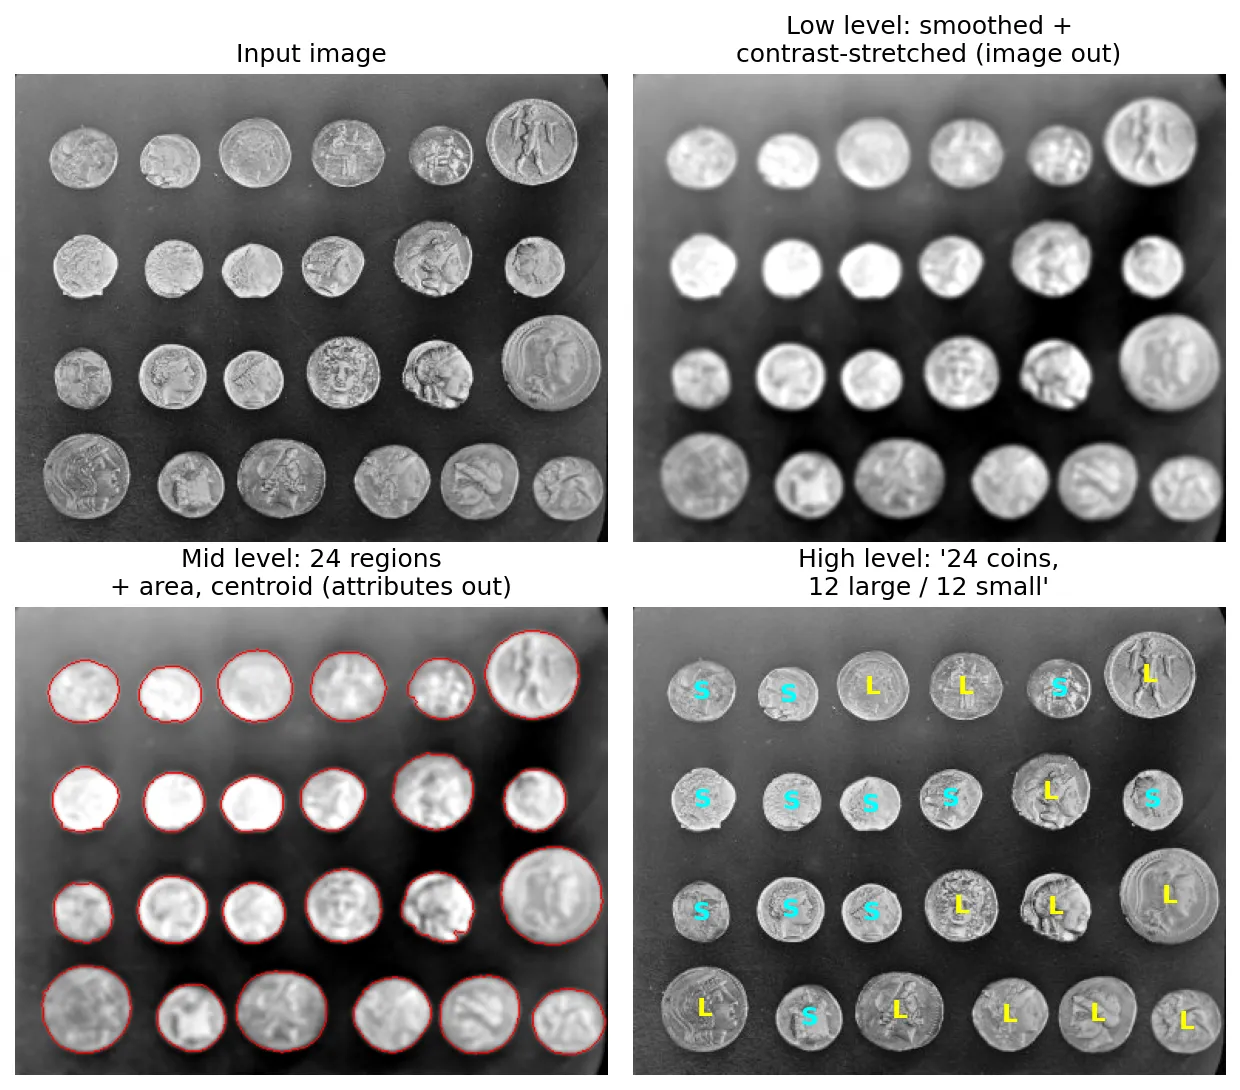
在本系列中,「數位影像處理」涵蓋從低階一路到辨識個別區域或物體為止。這個範圍足以包含分割、特徵擷取與分類(第 10–13 章),但不包括完整的場景理解。
數位影像處理的起源
白話版。 最早的數位圖片,是用打孔電報紙帶橫越大西洋傳送的新聞照片。真正用電腦處理影像始於 1960 年代,當時太空機構需要修正月球探測器傳回的影像;到了 1970 年代,能從量測資料「算出」影像的醫學掃描儀,讓這個領域蓬勃發展。
經由電報電纜傳送的圖片
1920 年代初期,Bartlane 電纜圖片傳輸系統透過橫越大西洋的海底電報電纜,在倫敦與紐約之間傳送新聞照片 [2]。照片先被轉換成打在一般五單位電報紙帶上的代碼,用標準電報設備傳送,再於接收端離線重組。根據 Kobayashi 對這套系統的歷史整理,直到 1939 年戰爭爆發為止,它一共橫越大西洋傳送了將近 500 張新聞照片 [2]。最早的 Bartlane 圖片只有五種灰階;到 1920 年代末,增加到十五種 [1]。
嚴格說來,這些圖片沒有經過任何電腦,所以這算是數位影像處理的史前史。但核心觀念已經出現:把圖片轉成一組有限的代碼,傳送出去,再重建回來;而灰階等級的多寡,決定了結果有多逼真。
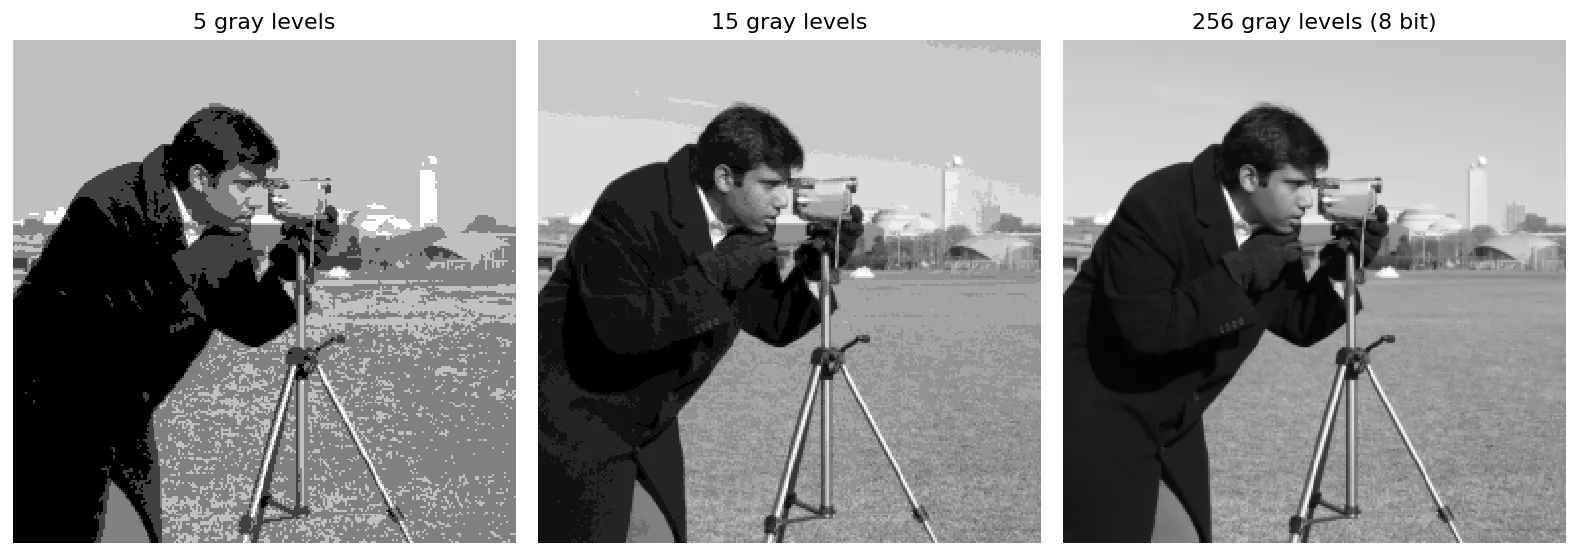
幾行程式就能重現這個實驗。把強度 均勻量化成 個等級的映射為
其中 表示四捨五入到最接近的整數,因此輸出只會是 這 個值之一。
import numpy as np
from skimage import data

def quantize(img, levels):
    """把 uint8 影像映射到 `levels` 個等間距的灰階。"""
    x = img.astype(np.float64) / 255.0
    q = np.round(x * (levels - 1)) / (levels - 1)
    return (q * 255).astype(np.uint8)

f = data.camera()
for L in (5, 15, 256):
    g = quantize(f, L)
    print(L, "levels ->", len(np.unique(g)), "distinct values,",
          f"mean abs error {np.abs(g.astype(int) - f).mean():.2f}")
在這張測試影像上,平均絕對誤差從 時的約 18 個灰階,降到 時的約 5,再到 時的 0。
電腦遇上影像:太空計畫
我們今天所知的數位影像處理,需要兩樣直到 1960 年代才到位的東西:夠強大、能存放並操作影像的電腦,以及一個重要到值得為它花錢的問題。太空計畫兩者兼具。
1964 年 7 月 31 日,美國探測器 Ranger 7 拍下了美國太空船所攝的第一張月球影像,那是在它按計畫撞上月球表面前約 17 分鐘 [3]。在最後這幾分鐘裡,它傳回了超過 4,300 張影像,最後幾張的解析度約為每像素半公尺 [3]。用電腦修正這類探測器影像中的失真,成為數位影像處理的奠基計畫之一 [1]。同樣的技術後來又在之後的月球與行星任務中持續精進。
由量測算出的影像:電腦斷層
第二個奠基應用來自醫學。1973 年,Godfrey Hounsfield 描述了一套電腦化橫向軸向掃描(computerized transverse axial scanning)系統,也就是今天所說的電腦斷層掃描(computed tomography,CT)[4]。它不是只曝光一張底片,而是讓 X 光源與偵測器繞著病人旋轉,記錄光束沿著許多角度、許多直線被吸收的程度,再由電腦算出一個橫切面上每一點的吸收值。Hounsfield 指出,這能呈現傳統 X 光底片看不出的軟組織差異 [4]。
CT 之所以是里程碑,是因為影像不是拍出來的,而是重建出來的。掃描儀量測的是未知切面 的線積分:
其中 是光束的角度, 是偵測器在投影方向上的位置, 是狄拉克 delta 函數,它只保留落在直線 上的點。所有投影 合起來稱為正弦圖(sinogram)。從 還原出 是一個反問題(inverse problem),也是第 5 章後半「重建」的主題。這類演算法的標準測試物件,是 Shepp 與 Logan 在 1974 年提出、由多個橢圓組成的合成頭部切面 [5]。
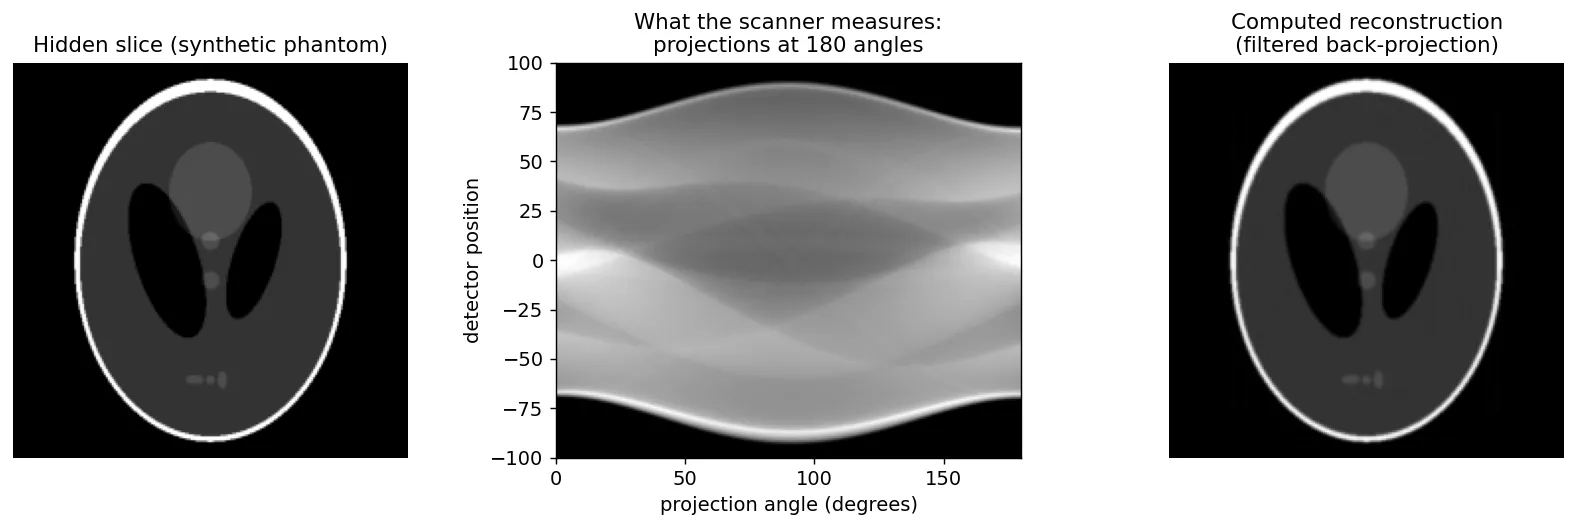
import numpy as np
from skimage.data import shepp_logan_phantom
from skimage.transform import radon, iradon, rescale

slice_ = rescale(shepp_logan_phantom(), 0.5)           # 200 x 200 的合成頭部切面
angles = np.linspace(0, 180, 180, endpoint=False)
sinogram = radon(slice_, theta=angles)                  # 掃描儀記錄到的資料
recon = iradon(sinogram, theta=angles, filter_name="ramp")
err = np.sqrt(np.mean((recon - slice_) ** 2))
print(sinogram.shape, recon.shape, f"RMS error {err:.3f}")   # (200, 180) (200, 200) ~0.025
從 1960 年代起,同樣的想法擴散到遙測、天文、生物、工業檢測、執法,最後走進每個人口袋裡的手機。所有這些應用背後有兩大目標:改善影像以便人來判讀,以及處理影像資料以便儲存、傳輸與機器感知。
使用數位影像處理的領域舉例
白話版。 我們的眼睛只看得到「光」的一小段。其他種類的光,從伽瑪射線到無線電波,也都能形成影像;聲波和電子束也可以。影像處理能處理所有這些來源,因為它們最後都會變成一個數字網格。
整理應用最好的方式,是依影像的來源來分類 [1]。主要來源是電磁(electromagnetic,EM)能量;其他還有聲波、電子,以及純粹由計算產生的影像。
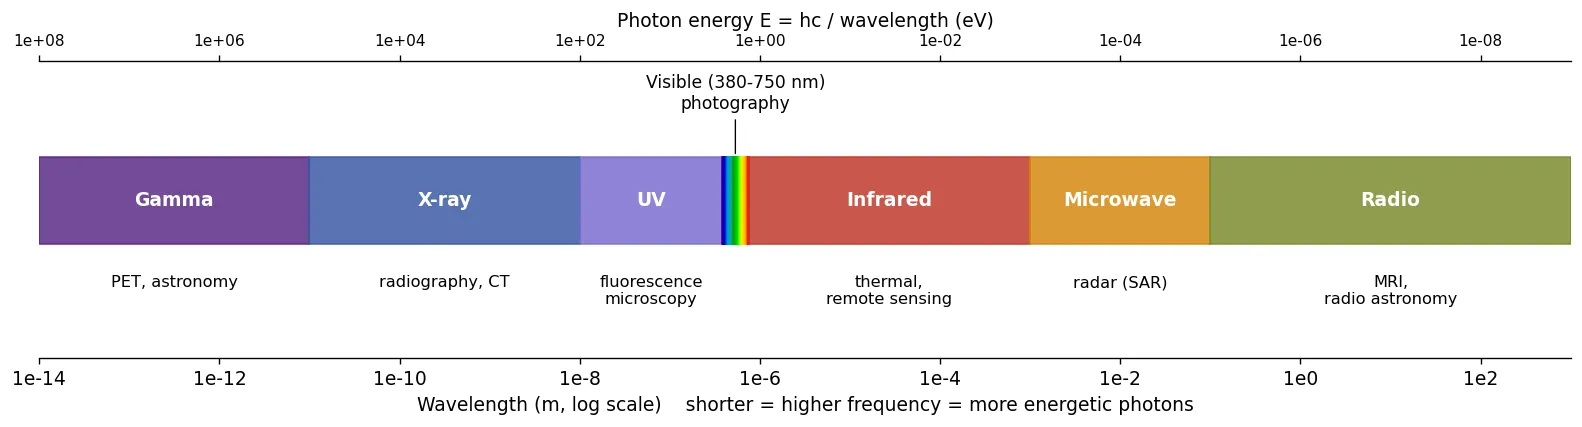
電磁波譜
電磁波可以用波長 或頻率 描述,兩者的關係為
其中 m/s 是光速。光也以一包一包的光子(photon)形式存在,每個光子帶有能量
其中 J·s 是普朗克常數。波長短代表頻率高、光子能量大;波長長代表頻率低、光子能量小。光是這一點就能解釋成像的許多現象:高能光子能穿透組織與金屬(X 光),低能量的波則能穿透雲層與黑暗(雷達與無線電)。
h, c, eV = 6.626e-34, 2.998e8, 1.602e-19   # 普朗克常數、光速、每 eV 的焦耳數

def photon_energy_ev(wavelength_m):
    return h * c / wavelength_m / eV

for name, lam in [("X-ray (0.1 nm)", 1e-10), ("green light (550 nm)", 550e-9),
                  ("thermal IR (10 um)", 10e-6), ("radar (3 cm)", 0.03)]:
    print(f"{name:22s} {photon_energy_ev(lam):10.3g} eV")
# X-ray ~1.24e4 eV, green ~2.25 eV, thermal IR ~0.124 eV, radar ~4.1e-5 eV
一個 X 光光子的能量大約是綠光光子的一萬倍,而雷達光子的能量還不到綠光光子的萬分之一。以下各波段依能量由高到低排列。
伽瑪射線成像
伽瑪射線是能量最高的光子。在核子醫學中,病人接受放射性示蹤劑,偵測器記錄示蹤劑放出的伽瑪射線;影像呈現的是示蹤劑聚集在哪裡,因此它描繪的是功能(例如代謝),而不是解剖構造。正子斷層掃描(positron emission tomography,PET)是這個概念的斷層版本,使用與 CT 相同的重建數學。在天文學中,伽瑪射線望遠鏡拍攝爆炸恆星殘骸這類劇烈事件。伽瑪射線影像通常雜訊很多,因為每個像素只累積到有限數量的光子事件;因此去雜訊與復原(第 3、5 章)在這裡特別重要。
X 光成像
X 光是最古老的醫學成像來源。在一般的 X 光攝影(radiograph)中,X 光穿過人體後讓偵測器曝光;骨骼等高密度組織吸收較多,因此看起來較亮。血管攝影(angiography)把顯影劑注入血管,再把注射前與注射後的影像相減以凸顯血管——這是第 2 章會介紹的影像算術運算。前面介紹的 CT 則把大量 X 光投影轉成切面,並堆疊成立體資料 [4]。醫學以外,X 光可以檢查焊接點與電路板裡看不見的瑕疵,X 光望遠鏡則能拍攝星系團中的高溫氣體。
紫外線成像
紫外線(UV)位於紫光之外。它最重要的應用是螢光顯微術(fluorescence microscopy):有些物質吸收紫外線光子後,會再放出能量較低的可見光。在一台濾掉紫外激發光、只讓放射光通過的顯微鏡下,會發螢光的構造就在黑色背景上發亮。生物學家用螢光標記特定蛋白質,觀察它們在細胞中的位置。紫外線成像也用於天文與工業檢測,例如找出白光下看不見的殘留物。
可見光與紅外線成像
日常的成像大多發生在可見光波段:攝影、光學顯微術、工業機器視覺(machine vision;例如檢查藥片包裝是否填滿、辨識車牌、量測零件尺寸)、文件掃描,以及人臉與指紋分析。可見光常與相鄰的紅外線(IR)波段搭配使用。
遙測(remote sensing)衛星會在從藍光到紅外線的數個窄波段中記錄同一個場景,稱為多光譜(multispectral)影像。由於植被、水與土壤對這些波段的反射率不同,組合不同波段就能繪製作物、洪水或都市擴張的地圖。熱紅外線相機感測的是物體放出的熱,而不是反射光,因此能用於夜間、消防與建築檢測。氣象衛星也利用紅外線頻道全天候追蹤雲層與暴風。
微波成像(雷達)
微波成像的主力是成像雷達。雷達自帶照明:它發出微波脈衝並記錄回波。由於微波能穿透雲、霾與黑暗,雷達可以拍攝光學衛星可能連續數週都看不到的地區,例如終年雲霧籠罩的雨林。合成孔徑雷達(synthetic aperture radar,SAR)利用飛機或衛星的移動,合成出一面非常大的天線,以獲得很高的解析度;把記錄下來的回波變成影像,本身就是一個計算步驟 [8]。
無線電波段成像
在長波長的一端,醫學上的主要應用是磁振造影(magnetic resonance imaging,MRI)。病人躺在強磁場中,短暫的射頻脈衝激發氫原子核,再記錄它們放出的微弱無線電訊號。1973 年,Paul Lauterbur 證明加上磁場梯度後,這些訊號會隨位置而不同,因此可以由它們形成影像 [6]。和 CT 一樣,MRI 必須經過計算才會產生影像:原始量測值位於頻率域(第 4 章的主題),必須轉換回來。
在電波天文學中,波長很長意味著單一碟形天線的解析度很差,所以天文學家會結合許多望遠鏡的訊號。2019 年,事件視界望遠鏡合作團隊(Event Horizon Telescope Collaboration)發表了第一張超大質量黑洞陰影的影像,位於 M87 星系中心,由結合全球各地電波天文台的資料而成 [9]。這張影像既是望遠鏡的成果,也同樣是重建演算法的成果。
其他成像方式
並非所有影像都來自電磁輻射。
- 聲波成像。 聲波會在不同材料的交界處反射。地質學家把低頻聲波送入地底並記錄回波,藉此描繪地下岩層,用於石油、天然氣與礦產探勘(震測成像,seismic imaging)。醫學超音波使用高頻聲波(每秒數百萬次振動),能即時、且不使用游離輻射地拍攝胎兒、心臟與腹部器官。這兩種情況都是靠回波的時間來形成影像。
- 電子顯微術。 電子可以像光一樣被聚焦,但它的等效波長短得多,因此電子顯微鏡能解析比光學顯微鏡細得多的細節。穿透式電子顯微鏡讓電子束穿過薄標本;掃描式電子顯微鏡則讓聚焦的電子束掃過表面,記錄被反彈或撞擊出來的電子。這類影像常帶有雜訊,需要強化與復原。
- 合成影像。 電腦也會產生沒有任何感測器拍過的影像:碎形、算繪出來的三維場景、模擬結果,以及越來越多由生成模型產生的影像。這些影像用同一套工具處理,也大量用來製作訓練資料與測試案例。
這趟巡禮的重點是:一旦資料變成數字網格,同一套工具就都適用,不論這些數字來自伽瑪射線、聲波回音或電腦程式。真正改變的是雜訊、解析度與成像的物理原理,而這些差異決定了你該拿出哪一種工具。
數位影像處理的基本步驟
白話版。 讓一張影像派上用場就像做菜:先備料(擷取影像),再清洗、處理(強化、復原),有時改變食材的形態(色彩、轉換、壓縮),然後切塊(分割),描述每一塊,最後判斷每一塊是什麼(分類)。不是每道菜都需要每個步驟。
把這些步驟分成兩組會比較好理解 [1]:輸出通常是影像的方法,以及輸出通常是從影像擷取出的屬性的方法。關於問題領域的知識庫(knowledge base)——例如瑕疵通常出現在哪裡、什麼樣的標籤才合理——引導著每一個步驟。這份清單並不是非走不可的流程;實際應用只會用到需要的步驟,並依合理的順序排列。
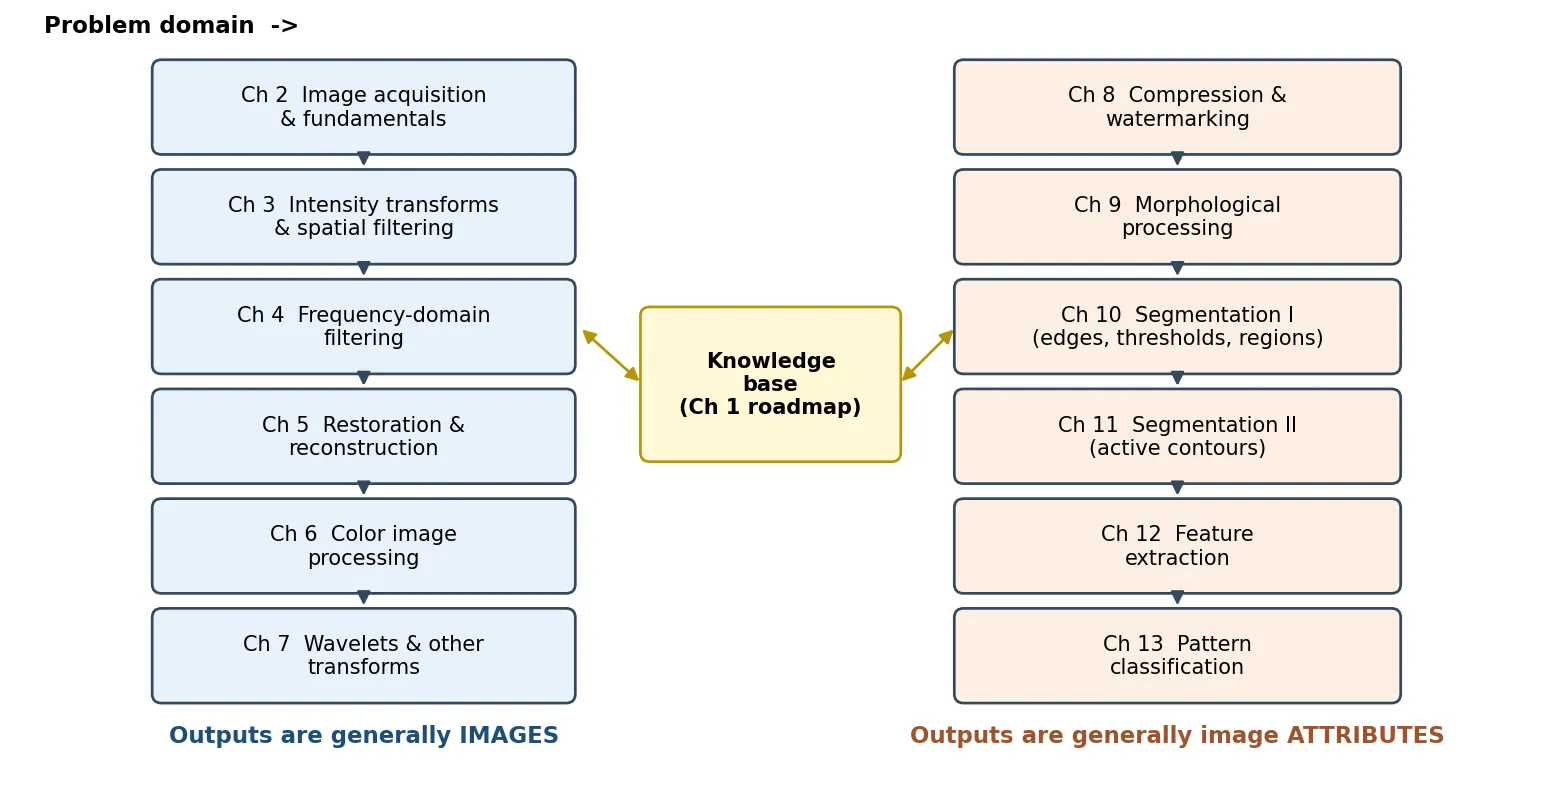
以下逐一介紹各步驟,以及負責的章節。
- 影像擷取(image acquisition)——取得數位形式的影像,包括感測、取樣與量化。第 2 章也會建立之後處處用到的數學工具(像素間的關係、影像算術、幾何轉換)。→ 第 2 章・數位影像基礎
- 影像強化(image enhancement)——讓影像更適合特定用途,例如提高對比或銳化細節。強化是主觀的:「更好」取決於觀看者與任務。→ 第 3 章・強度轉換與空間濾波 與 第 4 章・頻域濾波
- 影像復原(image restoration)——消除已知或估計出的劣化,例如模糊或雜訊。和強化不同,復原是客觀的:它依賴描述影像如何劣化的數學模型。同一章也介紹由投影重建影像(CT)。→ 第 5 章・影像復原與重建
- 彩色影像處理(color image processing)——色彩模型、虛擬色彩,以及全彩影像的處理。→ 第 6 章・彩色影像處理
- 小波與其他影像轉換——同時以多種解析度表示影像,是現代壓縮與金字塔方法的基礎。→ 第 7 章・小波與其他影像轉換
- 壓縮與浮水印——減少影像所需的儲存空間或頻寬,以及嵌入看不見的資訊以保護所有權。→ 第 8 章・影像壓縮與浮水印
- 形態學處理(morphological processing)——擷取與整理形狀成分的工具,例如細線化、填補孔洞、分開相黏的物體。從這裡開始,輸出逐漸變成屬性。→ 第 9 章・形態學影像處理
- 影像分割(segmentation)——把影像切分成組成它的部分或物體。這是最困難的步驟之一,這裡的錯誤會延續到之後的每一步。→ 第 10 章・影像分割(一)(邊緣、閾值、區域)與 第 11 章・影像分割(二)(主動輪廓:snakes 與 level sets)
- 特徵擷取(feature extraction)——把分割出的區域轉成數字:邊界與區域描述子,以及角點這類點特徵。它包含兩部分:偵測特徵與描述特徵。→ 第 12 章・特徵擷取
- 影像樣式分類(image pattern classification)——根據物體的特徵替它貼上標籤,從最小距離分類器一路談到類神經網路與深度學習。→ 第 13 章・影像樣式分類
第 1 章(也就是本頁)是把它們串在一起的總覽。
下面的程式把其中四個步驟串起來,用在圖 1.2 的硬幣影像上。每個步驟在這裡只需一兩個函式呼叫;後面的章節會解釋每一步內部在做什麼。
from scipy import ndimage as ndi
from skimage import data, filters, measure, segmentation

img = data.coins()

# 1) 強化:低階,輸入影像 -> 輸出影像
smooth = filters.gaussian(img, sigma=1, preserve_range=True)

# 2) 分割:中階,輸入影像 -> 輸出區域
markers = (smooth < 30) * 1 + (smooth > 150) * 2       # 確定的背景 / 確定的硬幣
regions = segmentation.watershed(filters.sobel(smooth), markers) == 2
regions = ndi.binary_fill_holes(regions)
labels = measure.label(regions)

# 3) 特徵擷取:輸入區域 -> 輸出數字
props = [p for p in measure.regionprops(labels) if p.area > 300]
areas = [p.area for p in props]

# 4) 分類 / 解讀:輸入數字 -> 輸出一句結論
median = sorted(areas)[len(areas) // 2]
n_large = sum(a >= median for a in areas)
print(f"{len(areas)} coins found, {n_large} at or above the median size")
# 24 coins found, 12 at or above the median size
注意藏在這段程式裡的知識庫:閾值 30 與 150、最小面積 300,以及「大於等於中位數就算大」這條規則,全都編碼了這個特定問題的知識。換了光源或換了硬幣,這些數字就得跟著改。這個領域的大半歷史——包括深度學習的崛起——說穿了,就是把這類知識從手動設定的常數,搬進從資料中學出來的模型。
影像處理系統的組成元件
白話版。 一套影像處理系統就像一支團隊:感測器負責接住影像,快速的專用晶片負責粗重的運算,電腦執行程式,記憶體存放圖片,螢幕讓人觀看,印表機輸出紙本,網路把一切連在一起。
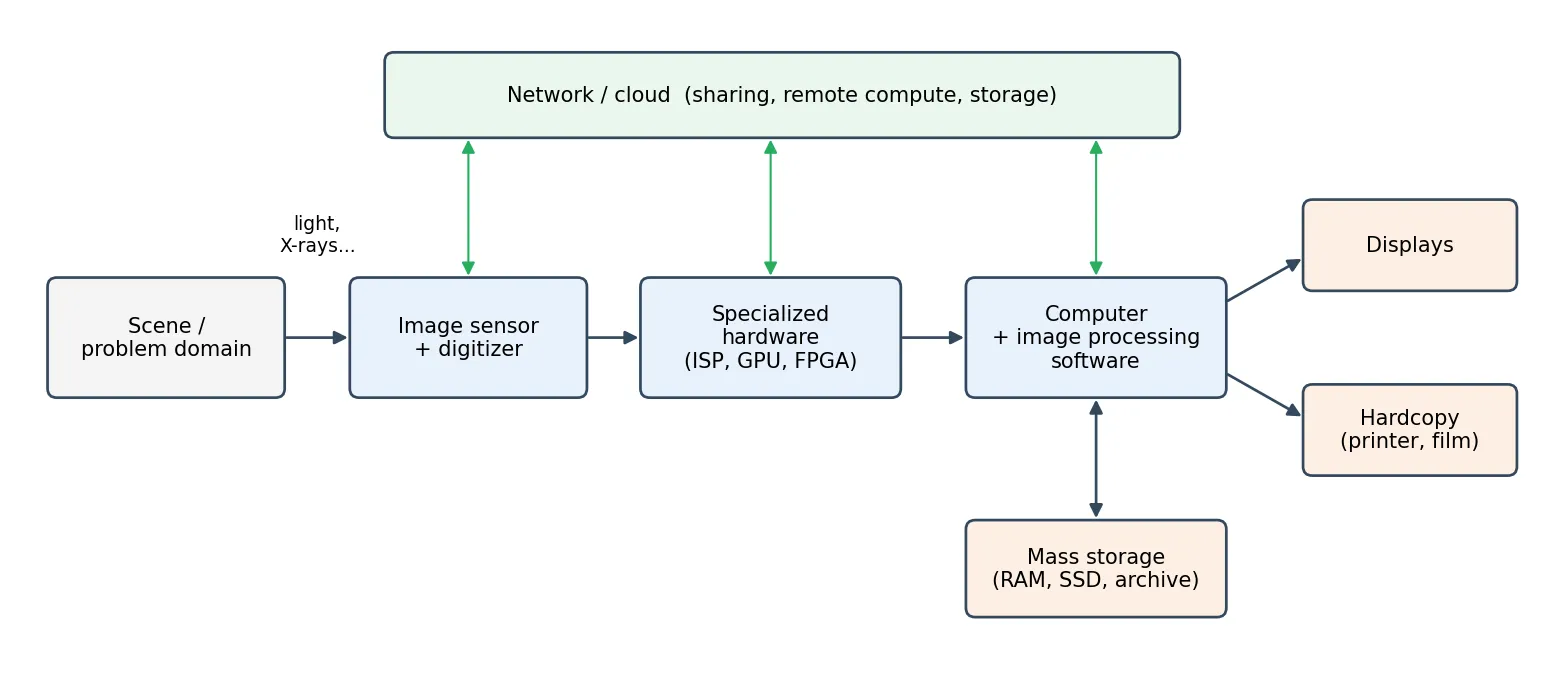
- 影像感測器。 擷取影像需要兩個元件:一個會對物體輻射出的能量產生反應的實體裝置(CCD 或 CMOS 晶片、X 光偵測器、超音波探頭),以及把裝置的電訊號轉成數字的數位轉換器(digitizer)。在手機中,兩者做在同一顆晶片上。
- 專用影像處理硬體。 有些運算必須以影片速率對每個像素執行,比通用處理器能負擔的還快。早期系統使用專門的算術運算板;今天這個角色由每顆相機晶片裡的影像訊號處理器(image signal processor,ISP)、繪圖處理器(GPU)、現場可程式化邏輯閘陣列(FPGA),以及手機中的神經網路處理器擔任。
- 電腦。 從智慧門鈴裡的嵌入式微控制器,到整個伺服器叢集都有可能。專用任務的電腦可以量身訂做;研究與一般用途則一台普通工作站就夠了。
- 軟體。 執行特定任務的模組,再加上把它們組合起來的方法。本系列使用 Python 搭配 NumPy、SciPy、scikit-image 與 OpenCV。本系列希望培養的,是自己寫程式的能力,而不只是呼叫現成的函式。
- 大量儲存裝置。 影像很大,而且大批湧入。儲存分成三層:處理期間的短期儲存(RAM、GPU 記憶體、影格緩衝區)、可快速取用的線上儲存(SSD 與磁碟陣列),以及很少存取的封存儲存(磁帶、冷儲存雲端服務)。
- 影像顯示器。 今天大多是彩色平面顯示器。醫學診斷使用經過校正的專用螢幕;立體視覺或虛擬實境則使用頭戴式顯示器。
- 硬拷貝裝置。 雷射與噴墨印表機、底片相機、熱感印表機。底片仍提供極高的解析度,而紙本依然是書面資料與許多報告的首選媒介。
- 網路與雲端。 幾乎每套系統都已連網。傳輸影像是頻寬問題,這正是壓縮(第 8 章)是核心主題的原因。雲端服務把儲存與繁重的運算(例如訓練深度模型)從裝置上移走。
「很大」到底有多大?一張有 列、 行、 個通道、每個值 位元的影像,在壓縮前需要
其中灰階影像 ,RGB 彩色影像 。
def raw_size_mb(height, width, channels=1, bits=8, frames=1):
    return height * width * channels * bits * frames / 8 / 1e6

print(f"{raw_size_mb(512, 512):.2f} MB   - this chapter's 8-bit test photo")         # 0.26
print(f"{raw_size_mb(3000, 4000, 3):.0f} MB   - one 12-megapixel RGB photo")         # 36
print(f"{raw_size_mb(512, 512, bits=16, frames=300):.0f} MB  - a 300-slice 16-bit CT volume")  # 157
print(f"{raw_size_mb(2160, 3840, 3, frames=30*60):.0f} MB - one minute of uncompressed 4K video")  # 44790
一分鐘、每秒 30 影格、未壓縮的 4K 影片大約是 45 GB。沒有壓縮,串流影片與充滿圖片的網頁都將窒礙難行。
現代觀點
教科書把這個領域看成一條由理解透徹、人工設計的步驟組成的流程,這仍然是學習影像處理的正確方式。但大約 2010 年以後,有兩項發展改變了這個領域的實務:計算被搬進了成像過程本身,而學習出來的模型取代或強化了許多人工設計的步驟。以下的綜述論文是很好的入門。
計算成像與可見光以外成像的綜述
- Mait、Euliss 與 Athale,〈Computational imaging〉(2018) [8] 回顧了二十年來光學與計算一起設計的系統:感測器記錄下的資料,要經過處理才會成為認得出來的圖片。這篇綜述涵蓋空間光調變器、合成孔徑雷達與計算顯微術等主題。主要結論是:圖 1.6 中「擷取」與「處理」的分界,如今是一個設計選擇——CT、MRI 與雷達是早期的例子,而手機讓這種做法成為主流。
- Delbracio、Kelly、Brown 與 Milanfar,〈Mobile computational photography: a tour〉(2021) [10] 追溯手機相機如何靠演算法克服微小的感測器與鏡頭:連拍多張影格再合併、強力的降噪,以及多影格超解析度。這趟巡禮顯示,現代手機照片其實是一條長長處理流程的輸出,它幾乎可以當作本系列每一章的搭配讀物。
- Gallego 等人,〈Event-based vision: a survey〉(2020) [11] 介紹一種完全打破圖 1.1 那種「影格」模型的感測器。事件相機(event camera)的每個像素在自己的亮度改變時就非同步地觸發,提供微秒等級的時間解析度與非常高的動態範圍。這篇綜述說明,當輸入是一串事件而不是一個數字網格時,特徵偵測、光流、影像重建等經典任務都必須重新思考。
- Wang、Ye 與 De Man,〈Deep learning for tomographic image reconstruction〉(2020) [12] 回顧類神經網路如何進入 CT、MRI、PET 等成像方式——正是 1970 年代開啟這個領域的那些重建問題。內容涵蓋清理傳統重建結果的網路、把量測模型保留在流程中的物理引導(physics-informed)方法、直接學習的重建,以及生成模型,目標包括更快的掃描、更低的輻射劑量與更好的影像品質。作者的展望強調:大型、經過妥善整理的資料集將是未來進展的關鍵。
深度學習如何重塑處理流程
LeCun、Bengio 與 Hinton(2015) 的回顧文章 [13] 概括了這個大轉變:深度網路直接從範例中學習多層次抽象的資料表示,而不再依賴人工設計的特徵。在影像處理中,這個轉變在圖 1.2 的連續光譜各層級上,呈現出不同的樣貌。
在高階,改變幾乎是全面的。分類與辨識(第 13 章)如今由學習模型主導;第 12、13 章會介紹在那之前的人工特徵與分類器,它們在資料稀少或重視可解釋性時依然有用。
在低階,最清楚的案例是相機自己的處理流程。傳統 ISP 是一串分別調校的階段,把感測器的原始數值變成完成的照片:黑階校正、去馬賽克(demosaicing)、去雜訊、白平衡、色彩校正、色調映射與壓縮。Ramanath 等人(2005) [14] 清楚地概述了這條流程與其中的取捨,很適合在讀第 3、5、6 章時放在手邊。
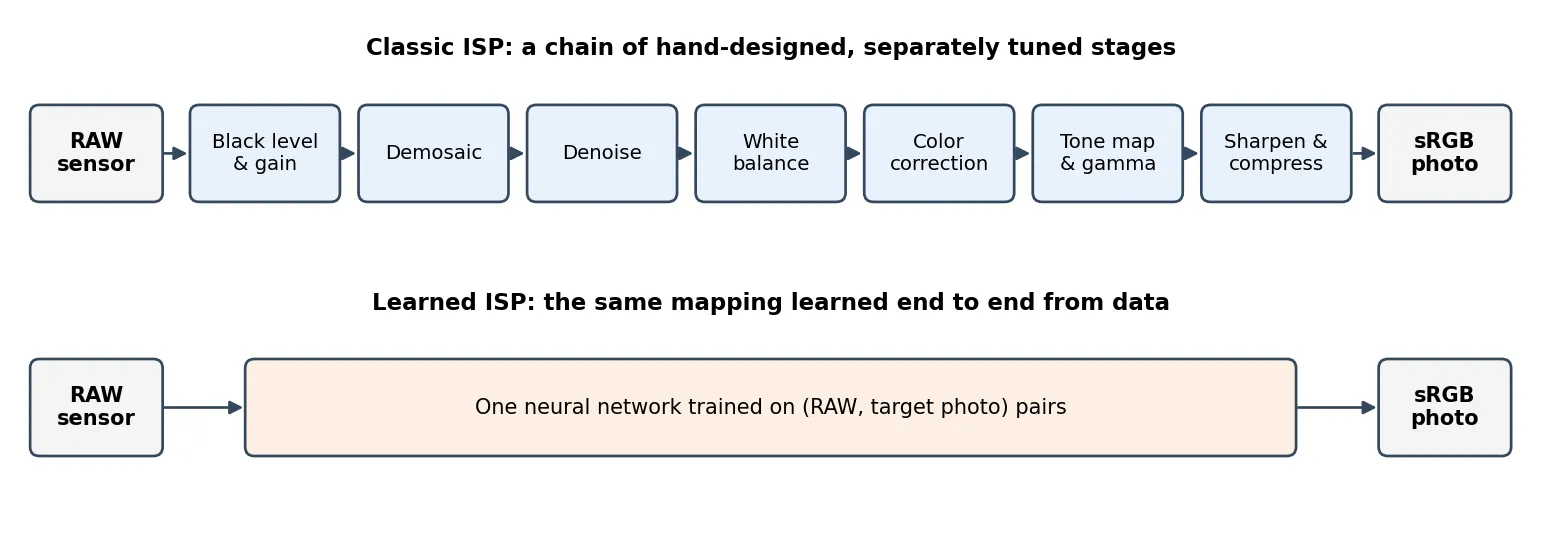
深度學習從幾個方向切入這條流程:
- 端到端學習困難的階段。 Chen 等人(2018)訓練一個全卷積網路,把在極暗環境下以短曝光拍攝的原始影像,直接映射成乾淨的照片,並以同一場景的長曝光照片作為目標 [15]。傳統流程在這種情況下會嚴重放大雜訊。
- 讓訓練資料更逼真。 Brooks 等人(2018)提出把一般照片「反處理」(unprocess)的方法:反轉相機流程的各個步驟來合成逼真的原始資料,讓以此訓練的去雜訊網路能用在真實的感測器輸出上 [16]。這是傳統流程知識讓學習模型變得更好的好例子。
- 取代整個 ISP。 Ignatov、Van Gool 與 Timofte(2020)提出 PyNET,一個金字塔形的卷積網路,把手機感測器的原始資料直接映射成高品質照片,在單一模型中學會去馬賽克、去雜訊、色彩與色調 [17]。他們以手機原始影像與高階單眼相機拍攝同一場景的照片配對來訓練。
- 整體綜述。 da Silva 等人(2023)綜述了用於影像訊號處理的深度學習方法,比較只取代個別階段的做法與用單一網路取代整個 ISP 的做法 [18]。
有什麼沒有改變?第 2、4、5 章的成像數學,依然決定了任何方法——不論是不是學習而來——能還原多少資訊。學習模型的訓練與評估,用的仍是經典章節定義的品質指標、轉換與色彩空間。而且許多實際部署的系統是混合式的:在傳統流程中放進一個學習式去雜訊器,或是以物理為基礎的重建再交給網路精修 [12]。理解經典步驟,才能看出這類系統中哪一部分在做什麼,以及它失敗時為什麼失敗。
重點整理
- 數位影像是在 網格上取樣、並量化為 個等級的函數 ;在程式中它就是一個陣列。
- 影像處理是一條連續光譜:低階(影像到影像)、中階(影像到屬性)與高階(屬性到意義)。電腦視覺位於高階那一端。
- 這個領域源自電報圖片傳輸(1920 年代)、太空探測器影像的電腦修正(1960 年代),以及 CT 這類由計算產生的醫學影像(1970 年代)。
- 影像來自電磁波譜的每個部分,從伽瑪射線到無線電波,也來自超音波、震波與電子束等非電磁來源。來源的物理特性決定了雜訊與解析度,也就決定了你需要哪些工具。
- 基本步驟分成輸出為影像的步驟(從擷取到壓縮)與輸出為屬性的步驟(從形態學到分類),全部由領域知識引導。第 2–13 章依循這份路線圖。
- 一套可運作的系統結合了感測器、專用硬體、電腦、軟體、儲存、顯示器、硬拷貝與網路。
- 深度學習已大致接管高階辨識,並正在重塑相機 ISP 這類低階步驟;但經典的成像模型依然是學習方法賴以建立的基礎。
練習
- 儲存預算。 一台顯微鏡以縮時方式拍攝 2048 × 2048、16 位元的灰階影像,每 30 秒一張,連續 48 小時。整個實驗需要多少未壓縮的儲存空間?一顆 1 TB 的硬碟可以放幾張?
提示
每張影像是 位元 位元組,約 8.4 MB。共有 張,總計約 48 GB。1 TB 硬碟大約可放 張。
- 放到光譜上。 判斷下列工作屬於低階、中階或高階,並說明理由:(a) 去除掃描文件上的椒鹽雜訊;(b) 在顯微影像中描出每個細胞的輪廓並回報每個細胞的面積;(c) 判斷一張胸部 X 光片是否正常;(d) 把一張太暗的照片調亮。
提示
看輸出是什麼。輸出影像就是低階((a)、(d))。輸出區域或量測值是中階((b))。輸出對場景的判斷是高階((c))。
- 為什麼用 X 光而不是可見光? 用 計算 0.05 nm X 光與 600 nm 橙光的光子能量。用兩句話解釋為什麼前者能用來拍攝骨骼,後者卻不行。
提示
約 24.8 keV 對約 2.07 eV,比值大約 12,000。可見光光子在組織中幾公釐內就被吸收或散射;高能的 X 光光子能穿過軟組織,而骨骼吸收的比例較高,因此產生對比。
- 需要幾個灰階? 使用本章的
quantize函式,畫出data.camera()與其量化版本之間的平均絕對誤差,。接著實際看看這些影像:大約在哪個 以後,你不再明顯看到假輪廓?誤差曲線能不能準確預測你看到的結果?
提示
均勻量化的誤差大約以 的速度下降。看得見的色帶主要取決於影像中平滑的區域(這裡是天空),而不是平均誤差——這也是第 2 章把感知品質與數值誤差分開討論的原因之一。
- 設計一套系統。 一間工廠想在輸送帶上剔除有裂痕的陶瓷磁磚,速度是每秒兩片。列出你需要圖 1.7 中的哪些元件;並針對圖 1.6 的每個基本步驟,說明你是否會使用它以及原因。
提示
你需要一個搭配受控照明的感測器、每秒能處理兩張影像的運算能力,以及連到剔除機構的連線。可能用到的步驟:擷取、強化(對比)、或許形態學、分割出像裂痕的結構、特徵(裂痕長度),以及一條分類規則。色彩、小波與壓縮大概用不到,除非影像需要存檔備查。
- 學習式還是傳統式? 從圖 1.8 的傳統 ISP 中挑一個階段。提出一個用學習模型取代它的理由,以及一個保留人工設計版本的理由。
提示
支持學習:網路能適應實際的感測器雜訊與場景統計特性。支持保留:人工設計的階段行為可預測、執行成本低、容易調校,而且不需要配對的訓練資料。現代觀點中的幾篇參考文獻正好討論了這個取捨。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 1. publisher page
- K. Kobayashi, “Birth of a Digital Phototelegraph — the Bartlane System,” Journal of the Institute of Image Electronics Engineers of Japan, vol. 31, no. 2, pp. 244–249, 2002. J-STAGE
- NASA, “First Image of the Moon Taken by a U.S. Spacecraft” (Ranger 7, PIA02975), NASA Photojournal. NASA
- G. N. Hounsfield, “Computerized transverse axial scanning (tomography): Part 1. Description of system,” British Journal of Radiology, vol. 46, no. 552, pp. 1016–1022, 1973. doi:10.1259/0007-1285-46-552-1016
- L. A. Shepp and B. F. Logan, “The Fourier reconstruction of a head section,” IEEE Transactions on Nuclear Science, vol. 21, no. 3, pp. 21–43, 1974. doi:10.1109/TNS.1974.6499235
- P. C. Lauterbur, “Image formation by induced local interactions: examples employing nuclear magnetic resonance,” Nature, vol. 242, pp. 190–191, 1973. doi:10.1038/242190a0
- R. Szeliski, Computer Vision: Algorithms and Applications, 2nd ed., Springer, 2022. book site
- J. N. Mait, G. W. Euliss and R. A. Athale, “Computational imaging,” Advances in Optics and Photonics, vol. 10, no. 2, pp. 409–483, 2018. doi:10.1364/AOP.10.000409
- The Event Horizon Telescope Collaboration, “First M87 Event Horizon Telescope Results. I. The Shadow of the Supermassive Black Hole,” The Astrophysical Journal Letters, vol. 875, no. 1, 2019. doi:10.3847/2041-8213/ab0ec7
- M. Delbracio, D. Kelly, M. S. Brown and P. Milanfar, “Mobile Computational Photography: A Tour,” arXiv:2102.09000, 2021. arXiv
- G. Gallego et al., “Event-based Vision: A Survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2020. arXiv
- G. Wang, J. C. Ye and B. De Man, “Deep learning for tomographic image reconstruction,” Nature Machine Intelligence, vol. 2, no. 12, pp. 737–748, 2020. doi:10.1038/s42256-020-00273-z
- Y. LeCun, Y. Bengio and G. Hinton, “Deep learning,” Nature, vol. 521, pp. 436–444, 2015. doi:10.1038/nature14539
- R. Ramanath, W. E. Snyder, Y. Yoo and M. S. Drew, “Color image processing pipeline,” IEEE Signal Processing Magazine, vol. 22, no. 1, pp. 34–43, 2005. doi:10.1109/MSP.2005.1407713
- C. Chen, Q. Chen, J. Xu and V. Koltun, “Learning to See in the Dark,” CVPR, 2018. arXiv
- T. Brooks, B. Mildenhall, T. Xue, J. Chen, D. Sharlet and J. T. Barron, “Unprocessing Images for Learned Raw Denoising,” arXiv:1811.11127, 2018. arXiv
- A. Ignatov, L. Van Gool and R. Timofte, “Replacing Mobile Camera ISP with a Single Deep Learning Model,” arXiv:2002.05509, 2020. arXiv
- M. H. M. da Silva et al., “ISP meets Deep Learning: A Survey on Deep Learning Methods for Image Signal Processing,” arXiv:2305.11994, 2023. arXiv