第 7 章・小波與其他影像轉換
先備知識: 第 6 章・色彩影像處理
你將學到
- 為什麼所有線性影像轉換(傅立葉、餘弦、沃爾什–哈達瑪、哈爾、小波)其實是同一件事:用另一組積木來描述影像,這組積木叫做基底(basis)。
- 如何把轉換寫成兩次矩陣乘法,以及為什麼可分離(separable)的二維轉換很省計算。
- DCT、沃爾什–哈達瑪、斜轉換(slant)與哈爾轉換的基底影像長什麼樣子,以及 DCT 為何是 JPEG 的主力。
- 如何用時頻平面(time–frequency plane)理解傅立葉分析與小波分析的差別。
- 多解析度分析、尺度函數與小波函數如何導出快速小波轉換,也就是一個由兩個濾波器組成的濾波器組。
- 如何用 PyWavelets 做二維離散小波轉換,並應用在去雜訊、邊緣偵測與壓縮。
先看全貌
第 4 章把影像拆成許多正弦波的總和。這只是其中一種積木,並不是唯一的選擇。本章退一步問一個更一般的問題:給定任意一組積木,我要怎麼算出影像裡每塊積木各有多少?又該挑哪一組積木最適合手上的工作?
「挑積木」的嚴謹說法是線性代數:內積、基底與基底轉換。這套工具一旦建立,本章的每一種轉換都只是一個不同的矩陣。小波會占最多篇幅,因為它是第一種在空間與頻率兩邊同時具有局部性的基底。這個特性讓小波成為 JPEG 2000 標準的核心 [15],也是現代稀疏表示,以及近年部分神經網路層背後的重要想法。
預備知識
白話版:一個有 個取樣的訊號,就是 維空間中的一支箭頭(向量)。轉換就是量這支箭頭在 支參考箭頭上各投下多長的影子。如果參考箭頭兩兩垂直且長度為 1,影子就包含全部資訊,把影子加回去就能還原原本的箭頭。
內積空間
內積(inner product) 接收兩個向量、回傳一個數,用來衡量兩者指向同一方向的程度。對長度為 的實數或複數向量:
其中 、 是 、 的第 個元素, 是複數共軛(對實數資料沒有作用), 是 的長度,也就是範數(norm)。對連續函數,總和改成積分:。當兩個向量的內積為零時稱為正交(orthogonal):它們彼此毫無共同成分。
正交歸一基底
若一組向量 每一個長度都是 1,而且兩兩正交,即 ( 時 為 1,否則為 0),就稱為正交歸一基底(orthonormal basis)。此時任何向量都能乾淨地拆開:
稱為轉換係數。第一式是分析(正向)步驟,第二式是合成(反向)步驟。正交歸一基底還會保持能量:(帕塞瓦定理,Parseval’s theorem),所以我們才能談「每個係數裝了多少能量」。
雙正交基底
有時最好用的積木並不互相垂直。這時需要兩組向量:一組 負責量測(分析),一組 負責重建(合成)。若滿足
就稱為雙正交(biorthogonal)基底對,量測用的 稱為對偶(dual)基底。雙正交換來的是設計自由度:例如 JPEG 2000 採用雙正交小波濾波器,可以同時做到長度短且左右對稱,這個組合用正交小波很難達成 [15]。
框架
框架(frame)是一組向量數量多於維度的生成集合,所以帶有冗餘。它的定義性質是:量到的能量被固定的上下界夾住,
、 稱為框架界(frame bounds)。若 ,則稱為緊框架(tight frame),重建公式就是 。一個經典的例子:平面上三支夾角 120° 的單位箭頭。它們能張成整個平面,任兩支都不正交,卻構成 的緊框架。當你需要穩健性或平移不變性時,多花一些係數換冗餘是值得的,例如不抽樣小波轉換(undecimated wavelet transform),以及「現代觀點」會提到的散射轉換。
import numpy as np

v = np.array([3.0, 1.0, 2.0])
e = np.eye(3)                         # standard orthonormal basis
c = e @ v                             # coefficients = inner products <v, e_k>
print(c, np.allclose(c @ e, v))       # synthesis: sum_k c_k e_k

# A biorthogonal pair in 2-D: analysis rows A, synthesis columns B = A^{-1}
A = np.array([[1.0, 0.0], [1.0, 1.0]])
B = np.linalg.inv(A)
x = np.array([2.0, 5.0])
print(A @ x, B @ (A @ x))             # [2. 7.] -> back to [2. 5.]
以矩陣表示的轉換
白話版:把量測用的向量疊成矩陣的每一列。訊號乘上這個矩陣,就一次量完所有係數;再乘上反矩陣,就把訊號拼回來。
對長度為 的一維訊號 ,把基底向量 依序放進 轉換矩陣 的各列,則
若基底是正交歸一的, 就是么正矩陣(unitary,;實數情形稱為正交矩陣,),反轉換幾乎不用成本。
對 的影像 ,一般的二維線性轉換需要 的巨大矩陣。實務上幾乎所有影像轉換都是可分離的:先對每一行做一維轉換,再對每一列做一維轉換。寫成矩陣:
其中 ()作用在行上,()作用在列上;方形影像且兩方向使用同一種轉換時 。可分離性把直接計算 轉換的成本從 降到 ,而快速演算法(FFT、快速 DCT、快速小波轉換)還能再進一步降低。
import numpy as np
from scipy.fft import dct, dctn
from skimage import data, img_as_float

N = 8
A = dct(np.eye(N), norm="ortho", axis=0)  # row u = u-th cosine basis vector

print(np.allclose(A @ A.T, np.eye(N)))    # orthonormal -> True

F = img_as_float(data.camera())[200:208, 200:208]
T = A @ F @ A.T                           # forward 2-D transform
print(np.allclose(T, dctn(F, norm="ortho")))   # same as scipy -> True
print(np.allclose(A.T @ T @ A, F))             # inverse -> True
相關運算
白話版:每個係數都在回答一個問題:「我的影像有多像這個圖樣?」這個問題本身就是相關(correlation)運算。
把分析公式和第 3 章的互相關比一比。係數
正是 與基底函數 在位移為零時的相關值。 大代表 和 很像; 代表 完全不含 的成分。由此得到兩個結論:
- 轉換就是樣板比對。 每個基底函數都是一個樣板,轉換一次替所有樣板打分數。傅立葉轉換替正弦波打分數,哈爾轉換替階梯狀圖樣打分數。
- 小波是在許多位移與尺度上做相關。 小波基底包含同一個圖樣的各種平移與伸縮版本。和某一尺度的所有平移版本做相關,就是一次濾波,所以本章後面的小波轉換會變成一組濾波器。
時頻平面上的基底函數
白話版:有些積木能告訴你事情何時發生,有些能告訴你它的音高,但沒有一塊能把兩者都說得完美。時頻平面就是描繪這種取捨的地圖。
對一個能量為 1 的基底函數 ,用 與 的標準差定義它在時間(空間)與頻率上的展開程度:
其中 是 的傅立葉轉換,、 分別是兩個能量分布的質心。訊號版的海森堡測不準原理(Heisenberg uncertainty principle)指出
只有高斯形狀的函數能取到等號。把每個基底函數畫成一個以 為中心、寬 、高 的矩形,稱為海森堡盒(Heisenberg box)或時頻磚。磚的面積不能小於某個下限,但形狀可以自由選擇。
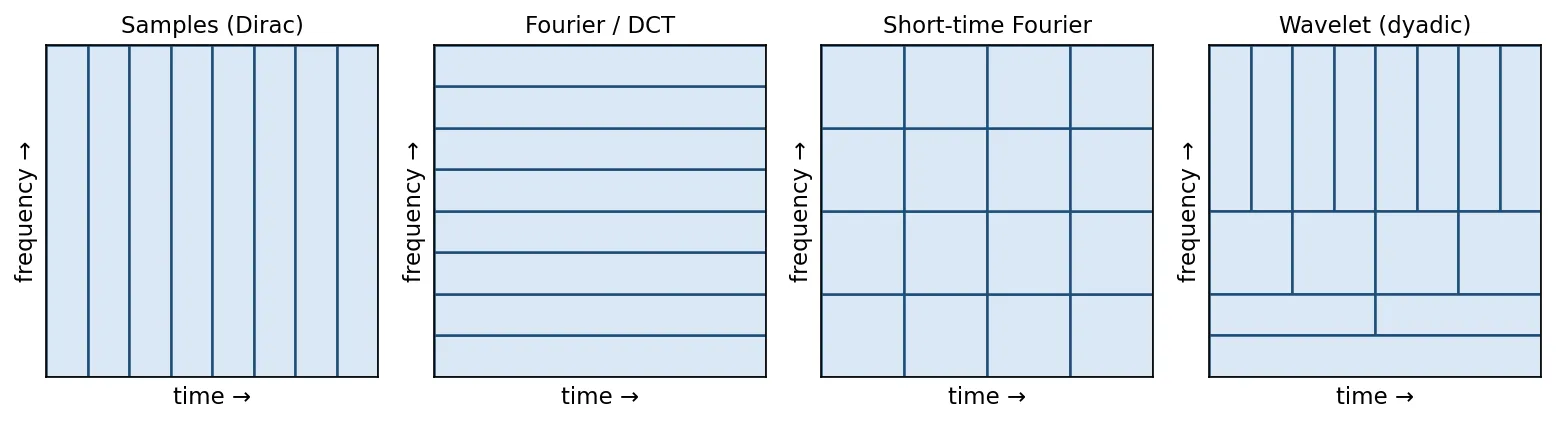
圖 7.1 呈現四種標準情形:
- 取樣(單位基底): 位置完全精確,沒有任何頻率資訊。
- 傅立葉或 DCT: 頻率完全精確,沒有位置資訊。一條銳利的邊緣會擴散到所有係數上。
- 短時傅立葉轉換(short-time Fourier transform, STFT):把訊號切成一個個窗,各自做傅立葉轉換。每塊磚形狀相同,一次決定就套用到所有頻率 [2]。
- 小波: 高頻的磚在時間上窄、頻率上高;低頻的磚則寬而矮。這很符合自然影像:邊緣是短暫的高頻事件,平緩的明暗變化則是緩慢的低頻成分。
基底影像
白話版:二維轉換的每個係數都對應一張小圖。影像就是這些小圖的加權總和,係數就是權重。
對矩陣 (第 列為 )定義的可分離轉換,可以把反轉換改寫成外積的總和:
每個 矩陣 就是一張基底影像(basis image)。 告訴你要加入多少第 張基底影像; 對應垂直方向的圖樣, 對應水平方向。把 張基底影像排在一起,是理解一種轉換「看到什麼」最快的方法。
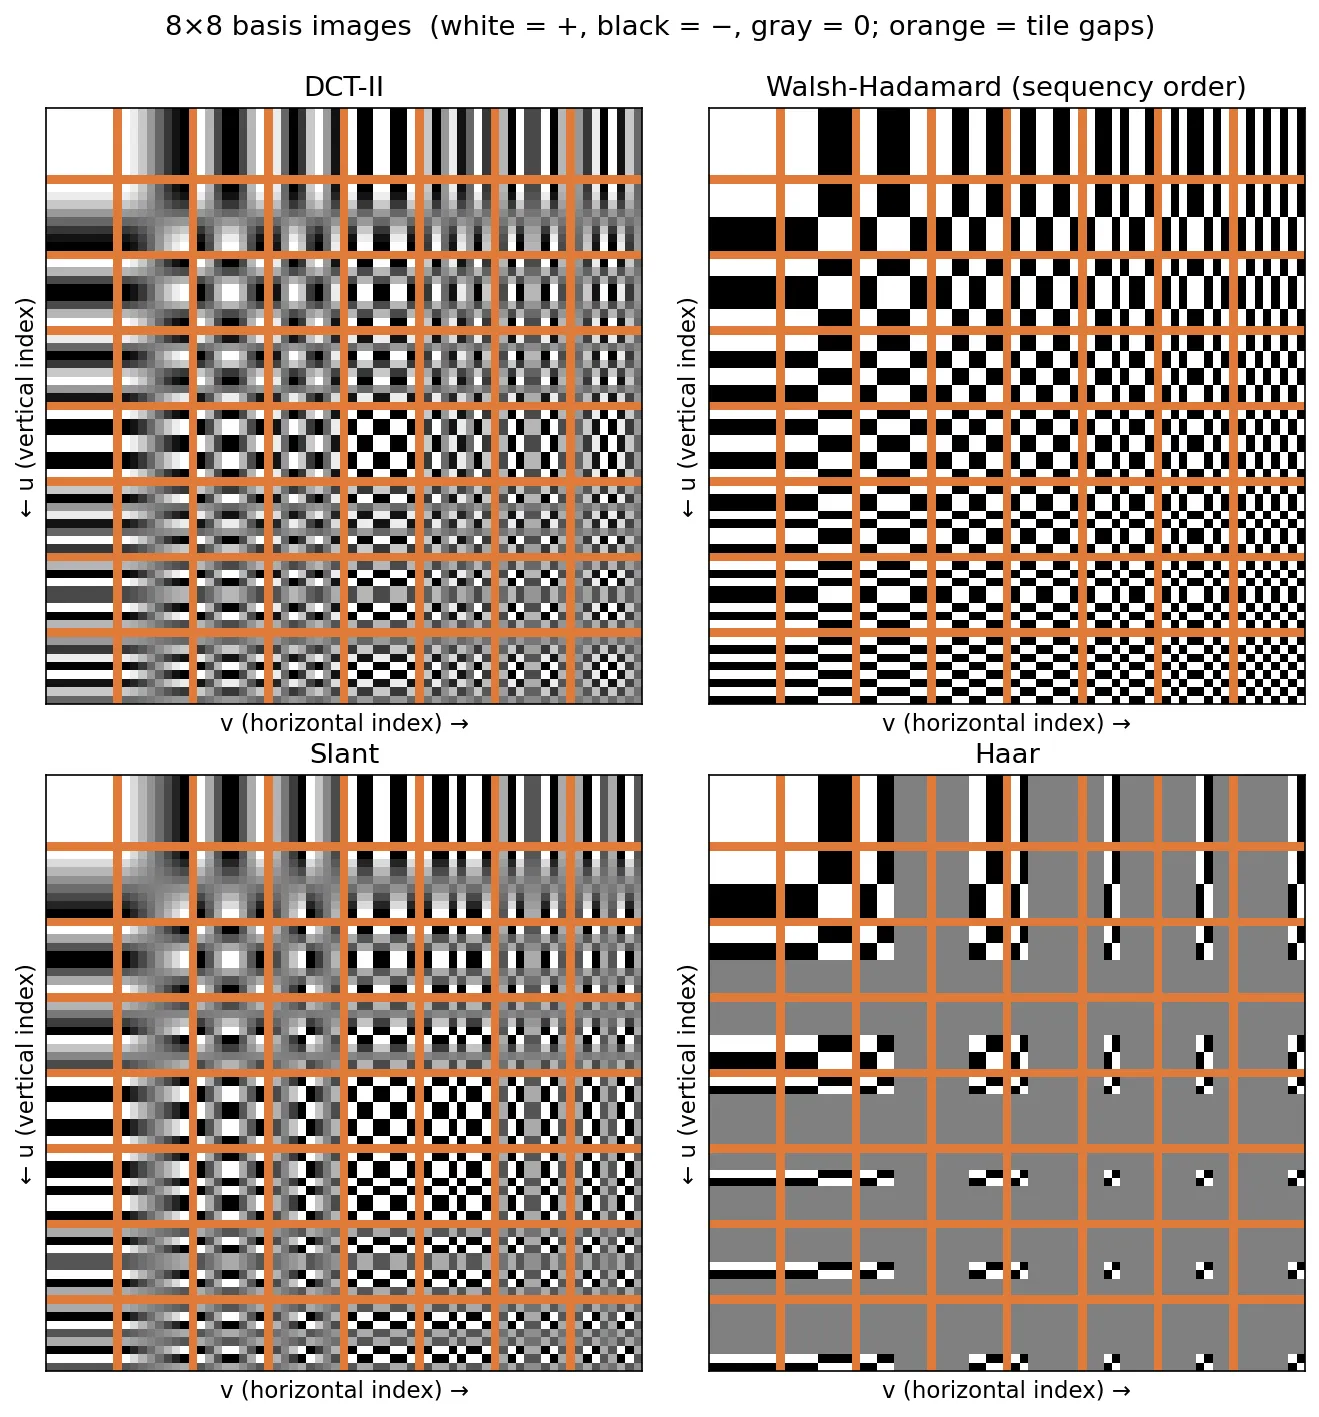
四種轉換左上角的基底影像都是常數,它量的是平均亮度,稱為 DC 係數。越往右、往下,圖樣振盪越快。DCT 平滑地振盪,沃爾什–哈達瑪在 之間突然切換,斜轉換多了線性斜坡,哈爾則把每個圖樣限制在格子中的一小塊區域。
與傅立葉相關的轉換
白話版:傅立葉家族用波當積木。其中餘弦轉換在區塊邊界的表現最好,所以你手機裡的 JPEG 檔用的就是它。
以矩陣看離散傅立葉轉換
第 4 章的一維 DFT 是一個矩陣轉換:
是第 列第 行的元素,。乘上 後矩陣是么正的。對壓縮來說它有兩個缺點:係數是複數,而且 DFT 默默把訊號當成週期性的。若區塊左右邊界的值不同,週期延伸就會出現跳躍,而跳躍需要大量高頻係數來表示。
離散餘弦轉換
(第二型)離散餘弦轉換(discrete cosine transform, DCT)[3] 使用實數餘弦:
是頻率索引, 讓基底正交歸一。DCT 等於(差一個縮放)把訊號鏡射成長度 的偶對稱延伸後再做 DFT。鏡射消除了邊界跳躍,能量因此集中在少數低頻係數。這種能量集中(energy compaction)特性,正是 JPEG 標準對 影像區塊做 DCT 的原因 [4]。Ahmed、Natarajan 與 Rao 在 1974 年提出 DCT,並指出它在維納濾波與率失真(rate–distortion)準則下的表現,與統計上最佳的 Karhunen–Loève 轉換非常接近 [3]。
離散正弦轉換
離散正弦轉換(discrete sine transform, DST)改用正弦。第一型 DST 的矩陣為
對應的是訊號的奇對稱延伸。它是實數、正交歸一且對稱的矩陣(),適合兩端接近零的訊號,例如預測殘差。在 SciPy 中可寫成 scipy.fft.dst(x, type=1, norm="ortho")。
沃爾什–哈達瑪轉換
白話版:每個基底向量都只由 和 組成。這樣轉換完全不需要乘法,只要加減。
階的哈達瑪矩陣以遞迴方式建構:
的每個元素都是 ,各列互相正交,因此 是正交歸一(而且對稱)的。 的列天生是自然順序(哈達瑪順序)。做分析時,改依序率(sequency,一列中正負號改變的次數,扮演頻率的角色)排序會更好讀。依序率排列的列稱為沃爾什函數,圖 7.2 就是它們的二維基底影像。
沃爾什–哈達瑪轉換(Walsh–Hadamard transform, WHT)因為計算便宜,很早就被用於影像編碼 [5]。對自然影像而言,它的能量集中能力不如 DCT,因為方波基底不擅長逼近平滑的明暗變化(見後面的圖 7.7)。在講求速度或硬體簡單的場合,以及作為快速隨機化演算法的元件時,它仍然很有用。
import numpy as np
from scipy.linalg import hadamard

H = hadamard(8)                                    # natural (Hadamard) order
changes = (np.diff(np.sign(H), axis=1) != 0).sum(1)
W = H[np.argsort(changes)] / np.sqrt(8)            # sequency order
print((np.diff(np.sign(W), axis=1) != 0).sum(1))   # [0 1 2 3 4 5 6 7]

x = np.array([10, 12, 11, 13, 40, 42, 41, 43], float)
print(np.round(W @ x, 2))
這個測試訊號是一個帶有小漣漪的階梯。它的 WHT 幾乎全落在係數 0(平均值)與係數 1(恰好一次正負號變化,對應那個階梯);其餘只剩幾個小數值。
斜轉換
白話版:影像中很多區域不是平的,而是逐漸變亮或變暗。斜轉換準備了一塊「斜坡」積木,讓這種區域只需要一兩個係數。
Pratt、Chen 與 Welch 為影像編碼設計了斜轉換(slant transform)[6]。它和 WHT 一樣是正交歸一、遞迴建構的,從 開始:
其中 是一個稀疏的 混合矩陣,內含兩個常數
它們的取值讓 的第二列成為等差遞減的階梯(「斜」向量),同時保持矩陣正交歸一。本章的繪圖腳本(scripts/figures/dip_ch07.py)就是這樣建出 ,並以數值檢查這兩個性質。圖 7.2 中,斜轉換第一列與第一行的基底影像都是看得見的斜坡。斜轉換有 的快速演算法,但實務上同樣能處理斜坡的 DCT 取代了它。
哈爾轉換
白話版:把相鄰的兩個值拿來,記下它們的平均和差。再對平均值重複同樣的步驟。這就是哈爾轉換,也是最簡單的小波。
哈爾轉換(Haar transform)[1] 的基底函數要不是常數,就是一個「先上後下」的階梯,具有不同的寬度與位置。對 個取樣,用尺度 與位置 來編號, 時 。不計歸一化,第 個基底向量在區間 的前半段為 、後半段為 ,其餘為 0(位置以訊號長度的比例表示); 的向量是常數。 時:
第 0、1 列看整段訊號;第 2、3 列各自只看一半。這是它和前面所有轉換最關鍵的不同:哈爾基底函數是局部的。邊緣這類局部事件只會改變覆蓋到它的少數幾個哈爾係數。在時頻圖上,哈爾正好對應圖 7.1 的二進位(dyadic)鋪法。它是通往小波轉換的橋梁:以哈爾小波做的離散小波轉換,就是哈爾轉換。
小波轉換
白話版:用許多種縮放倍率看同一張影像。每往下一層,保留一張更模糊的版本,並只記下模糊時被抹掉的細節。模糊版本疊成一座金字塔,而那些細節就是小波係數。
多解析度分析
多解析度分析(multiresolution analysis, MRA)由 Mallat 形式化 [7],把上面的想法變成一組基底。先取一個尺度函數(scaling function),做出平移與伸縮的版本:
其中 是尺度( 越大,函數越窄、細節越精細), 是整數平移量, 讓能量維持為 1。令 為 所張成的空間,也就是在解析度 下能表示的所有訊號。MRA 要求四件事:
- 彼此正交歸一(或至少是 的穩定基底)。
- 空間是巢狀的,:粗尺度看得到的東西,細尺度也看得到。
- 所有 唯一的共同元素是 。
- 當 ,任何平方可積函數都能被逼近到任意精確。
因為 ,尺度函數本身必須能由更細的版本組合出來,於是得到精細化方程式(refinement equation,亦稱 dilation equation):
係數 稱為尺度函數係數,稍後它會變成低通濾波器。
小波函數
從 降到 時遺失的細節,落在互補空間 中,使得 ( 表示 中每個元素都能唯一拆成 的一部分加上 的一部分;對正交小波,兩部分互相正交)。 由小波函數(wavelet function)張成:
對正交小波,小波函數係數可由尺度係數經調變與時間反轉得到:,它們構成高通濾波器。一再重複這個拆分,得到
其中 是所有有限能量函數構成的空間:一個粗略的近似,加上每個更細尺度的細節。
哈爾小波的 、:就是平均與差。Daubechies 展示了如何建構具有緊支撐(compact support,即有限長度濾波器)且平滑度可調的正交小波,其正則性隨濾波器長度線性增加 [8]。PyWavelets [10] 中的 dbN 家族就是這些小波,N 是消失矩(vanishing moments)的個數:對 都有 。具有 個消失矩的小波對次數低於 的多項式完全「視而不見」,因此平滑區域的細節係數幾乎為零。
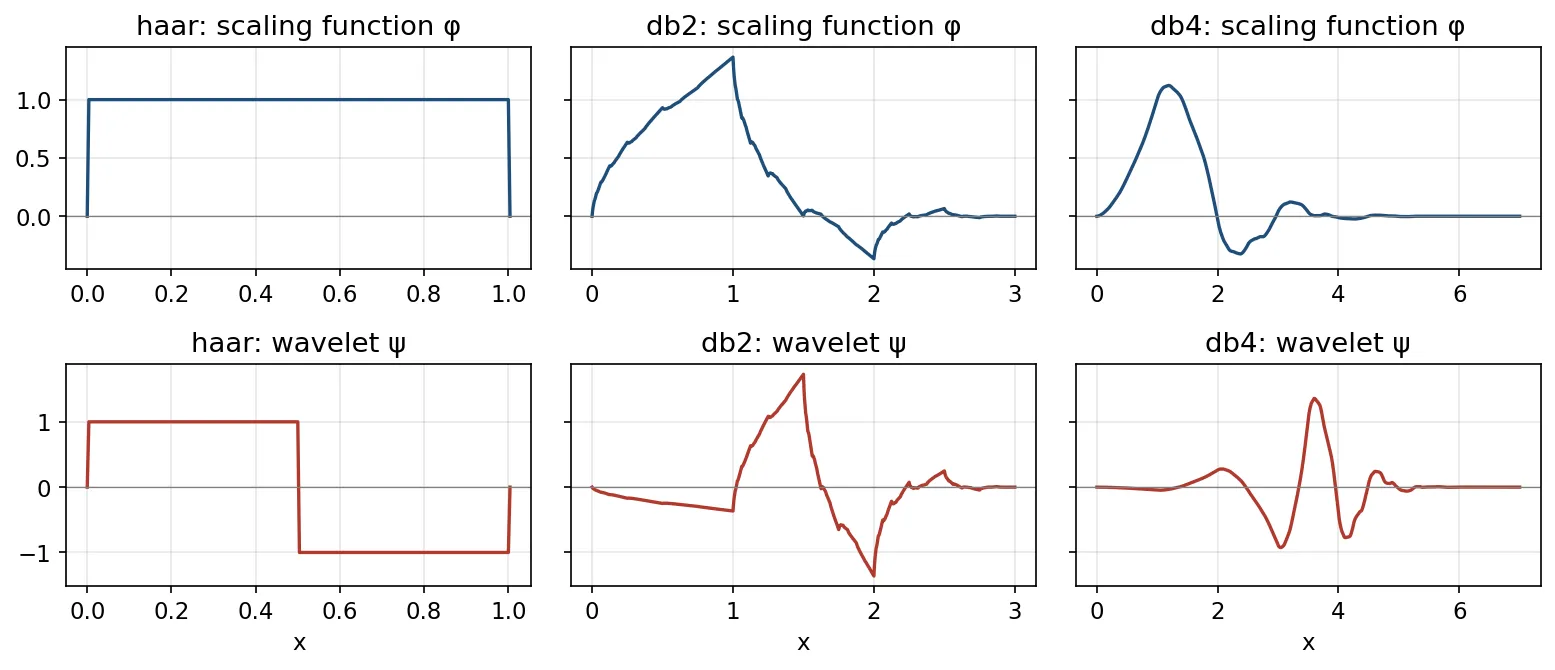
小波級數展開
有了這兩族函數,連續訊號 可以展開成
是任選的起始(最粗)尺度。 稱為近似(或尺度)係數, 稱為細節(或小波)係數。注意每個係數又是一個內積,與預備知識中完全相同。Unser 與 Blu 說明了消失矩、逼近階數與平滑度這些性質在此展開式中從何而來 [9]。
一維離散小波轉換
對取樣訊號 ,,,總和變成有限項:
、 是離散小波轉換(discrete wavelet transform, DWT)的近似係數與細節係數,此處的 、 是在 取樣的連續函數。對正交小波,係數總數恰好等於 :DWT 是一次基底轉換,而不是擴張。
快速小波轉換
白話版:你完全不需要去算 或 的值。兩個短濾波器加上「每隔一個取一個」,一層一層做下去就夠了。
把精細化方程式代入 DWT,就得到 Mallat 的金字塔演算法,今天稱為快速小波轉換(fast wavelet transform, FWT)[7]:
讀法:把較細一層的近似 與 (或 )做相關,再每隔一個取一個輸出(2 倍降取樣)。用訊號處理的語言,這就是雙通道分析濾波器組(analysis filter bank):低通分支產生下一層近似,高通分支產生細節。把低通輸出再送進同一組濾波器,如此反覆。每一層資料量減半,所以總成本是 ,比 FFT 的 還快。
反向 FWT 是合成濾波器組:每個分支先 2 倍升取樣(插零)、經合成濾波器濾波,再相加。對正交小波,合成濾波器就是分析濾波器的時間反轉,整組濾波器能達成完美重建(perfect reconstruction):即使每個分支的降取樣都造成混疊(aliasing),兩個分支的混疊項會互相抵消,輸出與輸入完全相同。Vetterli 與 Kovačević 的教科書從子頻帶編碼(subband coding)的角度深入發展了這個觀點 [2]。
import numpy as np
import pywt

x = np.array([4.0, 6.0, 10.0, 12.0, 8.0, 6.0, 5.0, 5.0])
w = pywt.Wavelet("haar")
h0, h1 = np.array(w.dec_lo), np.array(w.dec_hi)   # [.707 .707], [-.707 .707]

def analysis(x):
    lo = np.convolve(x, h0)[1::2]   # filter, then keep every 2nd sample
    hi = np.convolve(x, h1)[1::2]
    return lo, hi

a1, d1 = analysis(x)
a2, d2 = analysis(a1)
print("a2", a2, "d2", d2, "d1", d1.round(3))

ref = pywt.wavedec(x, "haar", level=2)            # [a2, d2, d1]
print(all(np.allclose(p, q) for p, q in zip(ref, [a2, d2, d1])))
print(np.allclose(pywt.waverec(ref, "haar"), x))
這兩行濾波器組與 pywt.wavedec 的結果完全一致。注意 (5, 5) 這一對的細節係數為 0:沒有變化,就沒有細節。
二維小波轉換
白話版:先沿著列跑一維濾波器組,再沿著行跑一次。你會得到一張小而模糊的影像,以及三張分別對應不同方向的「邊緣圖」。
二維 DWT 是可分離的。一層分解使用一個二維尺度函數與三個二維小波,各由一維函數相乘而成:
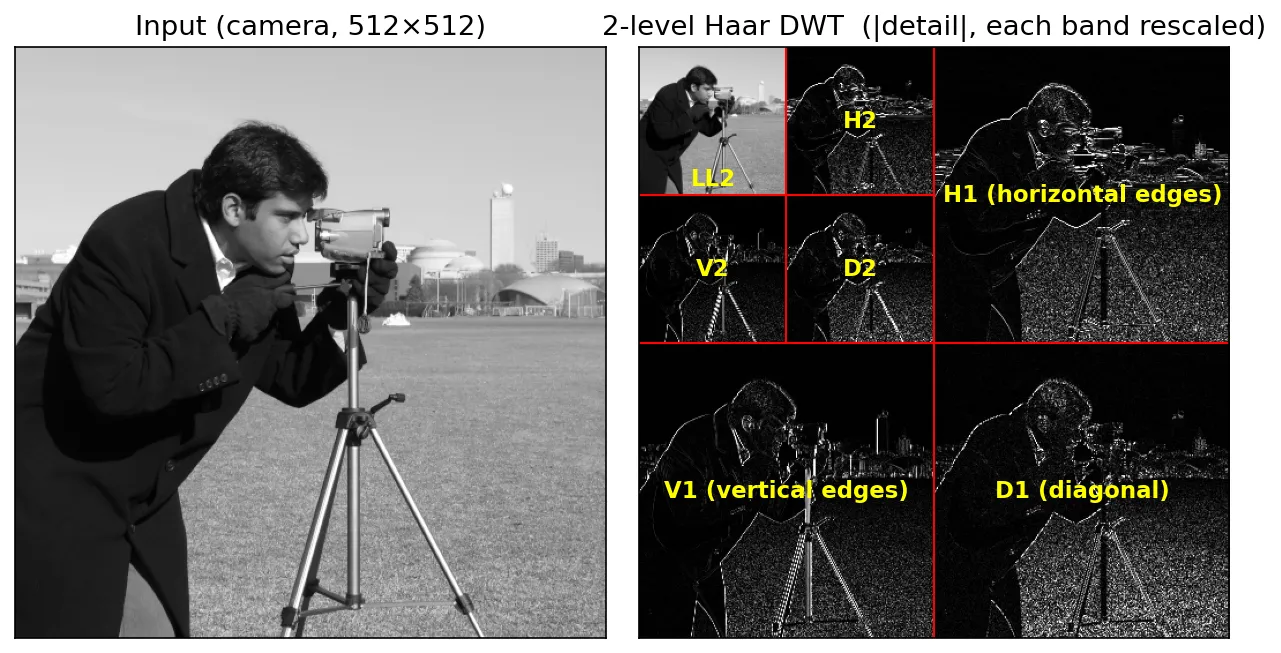
依照課本慣例, 是列索引(垂直位置), 是行索引。 沿垂直方向變化、水平方向平滑,所以對水平邊緣有反應; 對垂直邊緣有反應; 則對對角細節與角點有反應。一層分解把 影像變成四個 的子頻帶(subband):
| 子頻帶 | 垂直方向濾波 | 水平方向濾波 | 常見稱呼 | PyWavelets 名稱 |
|---|---|---|---|---|
| 近似 | 低通 | 低通 | LL | cA |
| 水平細節 | 高通 | 低通 | LH 或 HL(慣例不一) | cH |
| 垂直細節 | 低通 | 高通 | HL 或 LH | cV |
| 對角細節 | 高通 | 高通 | HH | cD |
由於不同教科書與函式庫對 LH/HL 的標記剛好相反,本章一律使用不會混淆的 H、V、D。對近似子頻帶重複分解,就得到圖 7.4 那種熟悉的巢狀排列。
import numpy as np
import pywt
from skimage import data, img_as_float

img = img_as_float(data.camera())
LL1, (H1, V1, D1) = pywt.dwt2(img, "haar")   # one level
LL2, (H2, V2, D2) = pywt.dwt2(LL1, "haar")   # second level on LL1
print(img.shape, LL1.shape, LL2.shape)       # (512, 512) (256, 256) (128, 128)

e = lambda a: float((a ** 2).sum())
total = e(img)
print(f"energy in LL2: {e(LL2) / total:.4f}")

coeffs = pywt.wavedec2(img, "haar", level=2)  # same thing in one call
print(np.allclose(pywt.waverec2(coeffs, "haar"), img))
兩層之後, 的近似子頻帶只占係數的十六分之一,卻裝了 camera 影像約 99% 的能量。其餘 15/16 的係數大多接近零,這正是壓縮與去雜訊所利用的稀疏性。
小波封包
標準 DWT 只會再拆分低通子頻帶。小波封包(wavelet packet)分解則連細節子頻帶也全部再拆,形成一棵完整的二元樹(二維時是四元樹)。 層之後,二維封包樹有 片葉子。任何一組能不重疊地覆蓋頻率軸的節點都是合法的正交歸一基底,所以這棵樹是一座基底圖書館。Coifman 與 Wickerhauser 的最佳基底(best basis)演算法能有效率地搜尋這座圖書館,挑出使某個可加成本(例如歸一化係數的熵)最小的基底 [11]。封包特別適合紋理,因為紋理在中高頻有大量能量,而一般 DWT 只把它們放在一個寬寬的子頻帶裡。
import pywt
from skimage import data, img_as_float

img = img_as_float(data.camera())
wp = pywt.WaveletPacket2D(img, "haar", maxlevel=2)
print([n.path for n in wp.get_level(2)][:6], len(wp.get_level(2))) # 16 subbands節點路徑記錄每一層走的分支(a 為近似,h、v、d 為細節),所以 "hd" 是水平細節子頻帶裡的對角細節。
應用
以門檻值去雜訊
白話版:在小波域裡,乾淨的影像只是少數幾個大數字,白雜訊則是散布各處的許多小數字。把小的歸零,再轉回來就好。
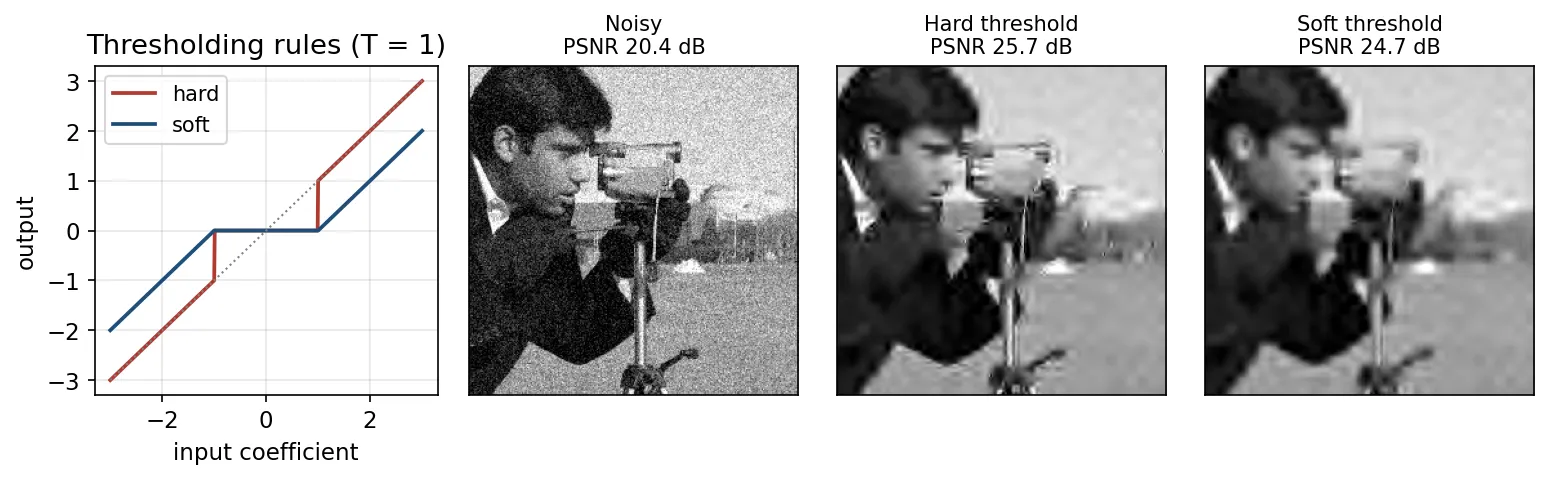
正交轉換會把標準差為 的白高斯雜訊,變成每個子頻帶中標準差同樣為 的白高斯雜訊,而影像的能量則集中在少數係數上。對細節係數 與門檻值 ,兩種門檻規則為:
硬門檻(hard thresholding)只決定留或砍;軟門檻(soft thresholding)還會把留下的係數往零縮 ,得到連續的規則,假影較少,但對比會稍微損失。兩種經典的 :
- 通用門檻值(universal threshold,VisuShrink): 個取樣時 ,出自 Donoho 與 Johnstone [12]。Donoho 證明用此 做軟門檻,所得估計有很高機率至少與真實訊號一樣平滑 [13]。雜訊強度通常由最細的對角子頻帶穩健地估計: [12]。
- BayesShrink:Chang、Yu 與 Vetterli 為每個子頻帶設定各自的門檻 ,其中 是該子頻帶中乾淨係數的估計標準差 [14]。它會依各子頻帶含有多少訊號自動調整,通常優於通用門檻值。
import numpy as np
import pywt
from skimage import data, img_as_float
from skimage.metrics import peak_signal_noise_ratio as psnr

rng = np.random.default_rng(7)
clean = img_as_float(data.camera())
noisy = clean + rng.normal(0, 0.1, clean.shape)

def wavelet_denoise(y, wavelet="db4", level=3, mode="soft"):
    c = pywt.wavedec2(y, wavelet, mode="periodization", level=level)
    sigma = np.median(np.abs(c[-1][2])) / 0.6745       # noise level from finest HH
    T = sigma * np.sqrt(2 * np.log(y.size))            # universal threshold
    c = [c[0]] + [tuple(pywt.threshold(d, T, mode) for d in lvl) for lvl in c[1:]]
    return pywt.waverec2(c, wavelet, mode="periodization")

for mode in ["hard", "soft"]:
    out = np.clip(wavelet_denoise(noisy, mode=mode), 0, 1)
    print(mode, round(psnr(clean, out, data_range=1), 1), "dB")
print("noisy", round(psnr(clean, np.clip(noisy, 0, 1), data_range=1), 1), "dB")
在這個例子中,含雜訊影像的 PSNR 為 20.4 dB,硬門檻 25.7 dB,軟門檻 24.7 dB。通用門檻值本身就很保守(設計目標是幾乎清除所有雜訊),再加上軟門檻的收縮,就會過度平滑;圖 7.5 那種卡通般的外觀就是代價。BayesShrink 這類依子頻帶調整的門檻,或改用不抽樣(平移不變)的轉換,可以同時減輕模糊與方塊假影。scikit-image 在 skimage.restoration.denoise_wavelet 中包裝了這些變體。
拖動滑桿,比較含雜訊的輸入與軟門檻的結果:
 含雜訊軟門檻
邊緣偵測
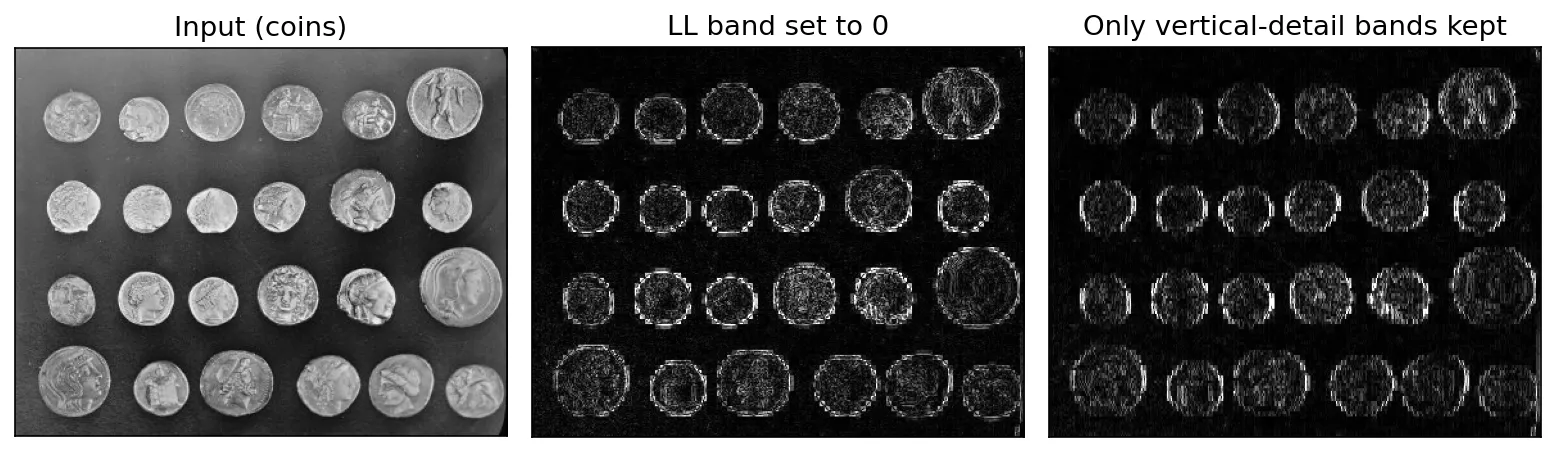
細節子頻帶是三個方向的高通響應,因此小波能當成快速的邊緣偵測器:把近似子頻帶設為零,再做反轉換。剩下的是影像減去它的粗略版本,主要集中在邊緣。只保留部分細節子頻帶就能挑選邊緣方向,如圖 7.6。越粗的層級得到的邊緣越粗,但對雜訊越穩健,這種多尺度行為類似於選擇高斯微分邊緣偵測器的 。
壓縮預告
壓縮建立在能量集中之上:轉換、保留少數大係數、再有效率地編碼。圖 7.7 對整張 影像做四種轉換,只保留最大的 5% 係數。兩種小波比 DCT 高出 2 dB 以上、比 WHT 高出 4 dB 以上,而且誤差的樣貌不同:傅立葉類的基底會在邊緣周圍產生振鈴,並到處損失紋理;小波則保持邊緣清晰,主要在平滑或紋理區域損失細節。
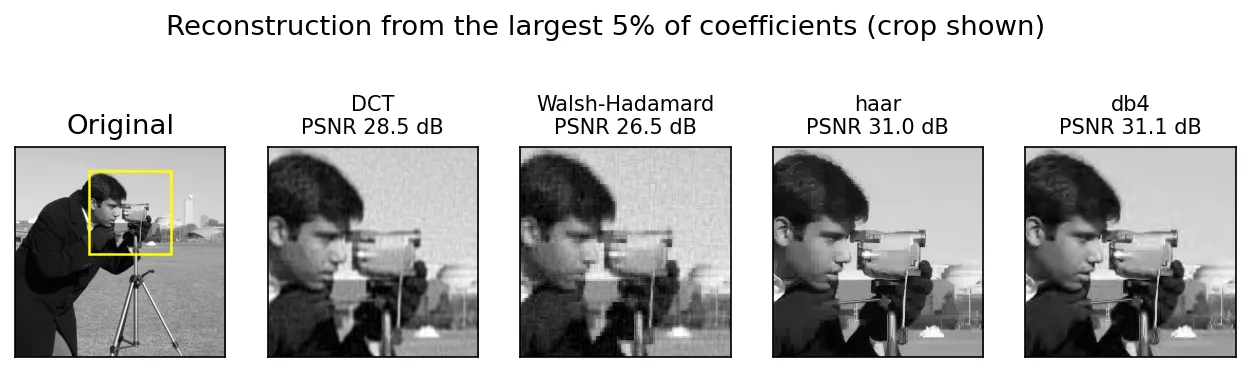
真正的編解碼器比「留下前 5%」細緻得多。JPEG 使用區塊 DCT 加上量化與熵編碼 [4];JPEG 2000 則使用多層二維 DWT 與雙正交濾波器,再對每個子頻帶做位元平面編碼 [15]。第 8 章會詳細介紹這些流程。
現代觀點
小波在 1980 年代末以統一理論之姿進入影像處理,1990 與 2000 年代成為去雜訊與 JPEG 2000 的骨幹,如今則多半是一種成分:存在於稀疏模型、受訊號處理啟發的網路層,以及高效率的生成模型之中。以下是值得一讀的綜論與里程碑論文,以及各自的貢獻。
基礎:Mallat(1989)與 Daubechies(1988)。 Mallat 的論文 [7] 為影像引入多解析度分析,建立正交小波與雙通道濾波器組之間的連結,並提出讓轉換只需 的金字塔演算法。它也提出了分成水平、垂直、對角三個子頻帶的二維可分離分解,至今每個函式庫仍沿用。Daubechies [8] 補上了最後一塊拼圖:具有緊支撐且平滑度可選的正交小波,讓濾波器又短又實用。兩篇合起來,就解釋了 pywt.wavedec2(img, "db4") 為何存在。
教科書等級的綜覽:Vetterli 與 Kovačević(1995)。 《Wavelets and Subband Coding》[2] 從訊號處理的角度建立整套理論:濾波器組、完美重建、時頻鋪磚與編碼。作者買回版權並免費公開全書,是本章濾波器組觀點最好的開放參考資料。
什麼讓小波好用:Unser 與 Blu(2003)。 〈Wavelet theory demystified〉[9] 把任何尺度函數寫成一個 B 樣條(B-spline)與一個殘餘「不規則」部分的卷積,藉此以自成一體的方式重建古典理論。它的主要結論是:實務上在乎的五個性質,也就是逼近階數、多項式重現、消失矩、多尺度微分性質與平滑度,全都由那個 B 樣條因子單獨決定。想知道為什麼 db4 在平滑影像上比 Haar 好,這篇論文給了答案。
從基底到字典:Rubinstein、Bruckstein 與 Elad(2010)。 〈Dictionaries for sparse representation modeling〉[16] 綜覽了從解析式轉換(傅立葉、DCT、小波及其方向性後繼者)到從資料學習的字典這段演變。它的重點是通往現代方法的橋梁:小波「少數係數就能解釋影像」的想法保留了下來,但基底變成可以訓練的東西。這條路線直接通往影像復原中的學習式先驗。
標準的實際樣貌:Skodras、Christopoulos 與 Ebrahimi(2001)。 他們的 JPEG 2000 概論 [15] 說明了 DWT、雙正交濾波器、子頻帶量化與嵌入式編碼如何在真實編解碼器中組合,以及多解析度帶來了哪些功能(解析度可調性、感興趣區域編碼、無失真模式)。
古典去雜訊理論:Donoho 與 Johnstone;Chang、Yu 與 Vetterli。 這幾篇收縮(shrinkage)論文 [12]、[13]、[14] 證明在小波域套一個簡單的非線性函數,對廣泛的訊號類別都接近最佳,而且依子頻帶調整門檻在實務上更有幫助。所有「對轉換係數做門檻來去雜訊」的方法,包括深度學習之前許多手工設計的先驗,都源自這些結果。
深度學習改變了什麼、沒改變什麼
散射網路。 Bruna 與 Mallat 的小波散射轉換(wavelet scattering transform)[17] 把小波卷積、取模(modulus)非線性與平均化層層串接。它是一個濾波器固定為小波、而非經由訓練的卷積網路,具有平移不變性且對形變穩定。第一層的行為類似 SIFT 類描述子,更高層則補充更多資訊,能分辨傅立葉功率頻譜相同的紋理。它在當時的手寫數字與紋理分類上取得最佳結果,並成為解釋 CNN 為何有效的參考點:一個小波框架(如預備知識所述,是冗餘的)加上簡單的非線性,就已經能得到不變性。
把小波當成池化與降取樣層。 跨步卷積與最大池化在降取樣前沒有做適當的低通濾波,因此會混疊。Li 等人在標準分類網路中以 DWT 層取代這些運算(WaveCNet),只保留低頻子頻帶,提升了對雜訊的穩健性 [19]。在影像復原方面,Liu 等人的 MWCNN 以二維 DWT 及其反轉換取代 U-Net 的池化與反池化 [18]。由於 DWT 可逆,網路縮小特徵圖時不會遺失資訊,又能便宜地得到很大的感受野。這種「可逆且能抑制混疊的降取樣」想法,後來出現在許多影像復原與生成模型中。
大感受野。 Finder 等人的 WTConv 層(ECCV 2024)在多層 DWT 的各子頻帶上做小卷積,因此有效感受野隨層數指數成長,而參數量只隨核大小對數成長 [20]。它可以直接放進 ConvNeXt、MobileNetV2 等架構中替換原本的層,作者報告它提升了對影像損壞的穩健性,並使模型更偏重形狀而非紋理。
沒有改變的部分。 DCT 仍然在 JPEG 裡,DCT 及其整數近似也仍是傳統影像與視訊編解碼器的核心工具。手工調校的小波門檻去雜訊,在品質上已被訓練出來的網路超越,但它仍是最快的強基準、不需要訓練資料,而且有理論保證。最重要的是,本章的詞彙(基底、框架、濾波器組、多解析度、混疊、稀疏性)正是用來分析卷積網路在做什麼的詞彙。
重點整理
- 線性轉換就是換基底。每個係數都是一個內積,也就是影像與某個基底函數的相關值。
- 正交歸一轉換就是矩陣乘法;可分離的二維情形為 ,反轉換用轉置即可,且能量守恆。
- 因為隱含的偶對稱延伸沒有邊界跳躍,DCT 對平滑影像的能量集中優於 DFT 與 WHT,這也是 JPEG 採用它的原因。
- WHT 與斜轉換分別以簡單性(只有 )或明確的斜坡向量換取部分能量集中能力;哈爾則多了局部性。
- 時頻平面呈現了取捨:傅立葉基底頻率精確、取樣時間精確,小波則依頻率調整磚的形狀。
- 多解析度分析把兩個短濾波器變成 的快速小波轉換;在二維中,每一層產生一個近似子頻帶與水平、垂直、對角三個細節子頻帶。
- 小波域的稀疏性帶動了去雜訊(硬/軟門檻)、快速邊緣圖與壓縮(JPEG 2000)。
- 現代網路把小波當成固定特徵擷取器(散射)、可逆降取樣器(MWCNN、WaveCNet),以及便宜的大感受野層(WTConv)。
練習
- 親手做一個框架。 取平面上角度為 90°、210°、330° 的三個單位向量。分別對 與 計算 。框架界是多少?要如何由三個係數重建 ?
提示
兩個總和都等於 ;事實上對任何單位向量 總和都是 ,所以這是 的緊框架。重建公式為 。
- 可分離的成本。 對一張 影像,計算下列情形所需的乘法次數:(a) 把一般二維線性轉換寫成一個 矩陣;(b) 以稠密 做可分離形式 ;(c) 三層哈爾 FWT。
提示
(a) 。(b) 兩次各 的乘法,。(c) 每一層以 2 個係數的濾波器、在半速率下處理目前近似的每一列與每一行;總量是 乘上一個小常數,約數十萬次。
- 為什麼要鏡射? 取 (一個斜坡),用 SciPy 計算它的 DFT 與 DCT,分別數一數要多少個係數才能涵蓋 99% 的能量,並用隱含的週期延伸與偶對稱延伸解釋差異。
提示
週期延伸會從 8 跳回 1,需要很多 DFT 諧波。偶對稱延伸 是連續的,所以 DCT 只需要兩三個係數。
- 手算哈爾。 對 做兩層哈爾 DWT(平均與差都乘上 )。哪些細節係數是零?為什麼?用
pywt.wavedec驗證你的答案。
提示
第一層的配對是 (2,2)、(6,6)、(3,5)、(9,9),只有 (3,5) 的差不為零。第二層比較相鄰兩對縮放後的和。注意 PyWavelets 的正負號慣例:用它的哈爾濾波器,每個細節係數等於(前 − 後),所以 (3, 5) 這一對得到 。
- 實際調整門檻。 修改去雜訊程式碼,改用 (a) 門檻值 ,以及 (b) 依子頻帶計算的 BayesShrink 門檻 ,其中每個子頻帶的 。在 與 下,和通用門檻值比較 PSNR。
提示
影像的通用門檻值約為 ,所以 (a) 會保留更多係數。軟門檻時,(b) 應該是三者中最好的。若 ,就把整個子頻帶設為零。
- 對平移的敏感度。 把 camera 影像水平平移一個像素,對兩個版本各做一層哈爾 DWT,比較 V 子頻帶的能量。為什麼平移一個像素會讓係數變化這麼大?不抽樣轉換(
pywt.swt2)又會如何表現?
提示
2 倍降取樣讓 DWT 對平移敏感:落在同一個哈爾配對內部的邊緣會產生細節係數,落在兩對之間的同一條邊緣卻不會。平穩(不抽樣)轉換省略降取樣,因此是一個冗餘框架,係數會跟著影像一起平移。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 7. publisher page
- M. Vetterli and J. Kovačević, Wavelets and Subband Coding, Prentice Hall, 1995(作者提供免費版本). book site
- N. Ahmed, T. Natarajan and K. R. Rao, “Discrete Cosine Transform,” IEEE Transactions on Computers, 1974. doi
- G. K. Wallace, “The JPEG still picture compression standard,” IEEE Transactions on Consumer Electronics, 1992. doi
- W. K. Pratt, J. Kane and H. C. Andrews, “Hadamard transform image coding,” Proceedings of the IEEE, 1969. doi
- W. K. Pratt, W.-H. Chen and L. R. Welch, “Slant transform image coding,” IEEE Transactions on Communications, 1974. doi
- S. G. Mallat, “A theory for multiresolution signal decomposition: the wavelet representation,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 1989. doi
- I. Daubechies, “Orthonormal bases of compactly supported wavelets,” Communications on Pure and Applied Mathematics, 1988. doi
- M. Unser and T. Blu, “Wavelet theory demystified,” IEEE Transactions on Signal Processing, 2003. doi
- G. R. Lee, R. Gommers, F. Waselewski, K. Wohlfahrt and A. O’Leary, “PyWavelets: A Python package for wavelet analysis,” Journal of Open Source Software, 2019. doi
- R. R. Coifman and M. V. Wickerhauser, “Entropy-based algorithms for best basis selection,” IEEE Transactions on Information Theory, 1992. doi
- D. L. Donoho and I. M. Johnstone, “Ideal spatial adaptation by wavelet shrinkage,” Biometrika, 1994. doi
- D. L. Donoho, “De-noising by soft-thresholding,” IEEE Transactions on Information Theory, 1995. doi
- S. G. Chang, B. Yu and M. Vetterli, “Adaptive wavelet thresholding for image denoising and compression,” IEEE Transactions on Image Processing, 2000. doi
- A. Skodras, C. Christopoulos and T. Ebrahimi, “The JPEG 2000 still image compression standard,” IEEE Signal Processing Magazine, 2001. doi
- R. Rubinstein, A. M. Bruckstein and M. Elad, “Dictionaries for sparse representation modeling,” Proceedings of the IEEE, 2010. doi
- J. Bruna and S. Mallat, “Invariant scattering convolution networks,” arXiv:1203.1513, 2012. arXiv
- P. Liu, H. Zhang, K. Zhang, L. Lin and W. Zuo, “Multi-level wavelet-CNN for image restoration,” CVPR Workshops (NTIRE), 2018. arXiv
- Q. Li, L. Shen, S. Guo and Z. Lai, “Wavelet integrated CNNs for noise-robust image classification,” CVPR, 2020. arXiv
- S. E. Finder, R. Amoyal, E. Treister and O. Freifeld, “Wavelet convolutions for large receptive fields,” ECCV, 2024. arXiv