第 10 章・影像分割(一):邊緣偵測、閾值化與區域偵測
先備知識: 第 9 章・形態學影像處理
你將學到
- 影像分割(image segmentation)的正式定義,以及兩大類方法:找不連續(邊緣)與找相似(區域)。
- 導數如何找出點、線與邊緣,以及 Sobel、Marr–Hildreth(LoG)和 Canny 偵測器的每個步驟。
- 如何把零散的邊緣像素串成邊界,包括用 Hough 轉換。
- Otsu 法如何自動選出閾值,以及單一閾值不夠用時該怎麼辦。
- 區域成長、分裂合併、k-means、SLIC、正規化切割、分水嶺與運動資訊,如何把像素變成區域。
先看全貌
到目前為止,大多數運算都是輸入一張影像、輸出另一張影像。影像分割輸出的則是一張部件地圖:每個像素都拿到一個標籤,說明它屬於哪個物體或區域。量測物體、計數細胞、辨識文字,全都仰賴這張地圖正不正確。
本章的方法都不需要從標註資料學習。它們不用訓練資料、容易解釋,而且其中的想法(梯度、遲滯、類間變異數、圖切割、淹水)至今仍活在現代深度學習流程裡。
基本概念
白話版:分割就是把影像切成彼此不重疊、合起來涵蓋全部、而且每一塊內部「看起來一樣」的幾塊。
令 為整張影像所佔的空間區域。分割是把 劃分成 個子區域 ,滿足
其中 是邏輯述詞(logical predicate):對一組像素回答是或否的測試,例如「所有強度彼此相差不超過 10 個灰階」。也就是說:每個像素都有標籤 (a)、每個區域是連通的一整塊 (b)、沒有像素同時有兩個標籤 (c)、每個區域都通過測試 (d)、相鄰的兩個區域一旦合併就會不通過 (e)。
幾乎所有單色影像的分割演算法,都建立在強度的兩種性質之一 [1]:
- 不連續性(discontinuity):邊界就是強度突然改變的地方。點、線與邊緣偵測都靠它。
- 相似性(similarity):同一區域的像素共享某種性質(強度、顏色、紋理)。閾值化、區域成長、分群、圖切割與分水嶺都靠它。
邊緣定位精確但常常斷斷續續;區域天生是封閉的,但邊界可能歪掉。
點、線與邊緣偵測
白話版:邊緣就是亮度變化很快的地方,而「變化有多快」正是導數在量的東西。
背景:像素格上的導數
一維數位函數 最簡單的近似是
其中 是整數像素位置, 是它的強度。走過一段斜坡時,一階導數在整段斜坡上都不為零,因此響應很粗。二階導數只在斜坡兩端不為零、而且正負相反,形成雙重響應,中間夾著一個零交越(zero crossing);它對細節與雜訊也敏感得多。後面所有偵測器都從這幾個事實出發。
偵測孤立點
點是一個和周圍不一樣的小斑點。拉普拉斯運算子(Laplacian)
可用中心為 、八個鄰居都是 的 核(含對角線的版本)實作。令 為濾波結果,凡是 ( 為非負閾值)的位置就標為點。核的係數總和為零,所以平坦區域沒有響應。
偵測線
線是寬度只有一到數個像素的結構。拉普拉斯運算子也會對線起反應,但會產生雙重響應,而且沒有方向性。要找特定角度的線,就用一個沿該角度排著 、其餘為 的核(水平線的核中間那一列是 )。比較水平、、垂直與 四個核的響應,就能知道每個像素上哪個方向最強。
邊緣模型
真實的邊緣可理想化成三種形狀:
- 階梯邊緣(step edge):在一個像素內從一個灰階跳到另一個,多出現在合成影像;
- 斜坡邊緣(ramp edge):在數個像素內線性變化,這是光學與取樣造成的模糊在真實影像中的樣子;
- 屋脊邊緣(roof edge):先升後降,像一條被模糊過的細線。
在斜坡上,一階導數的大小告訴我們有邊緣,二階導數的正負告訴我們哪一側比較亮,而它的零交越標出斜坡中心。問題是,肉眼幾乎看不見的雜訊就足以毀掉二階導數,所以先平滑再微分是所有像樣的邊緣偵測器的一部分。
用梯度做基本邊緣偵測
在 的梯度(gradient)是向量
、 是兩個方向的偏導數, 是梯度大小(邊緣強度), 是梯度方向(強度上升最快的方向);邊緣本身與 垂直。實務上常用較省計算的 來近似 。
導數用小型核計算,經典運算子整理於 [1]。Roberts 交叉運算子使用 的對角差分;Prewitt 運算子使用列為 的 核;Sobel 運算子則把中間一列加權為 ,例如
也就是一個方向做差分、另一個方向乘上 的平滑。正因為內建平滑,Sobel 通常比 Prewitt 更受青睞。
import cv2
import numpy as np
from skimage import data

f = data.camera().astype(np.float32) / 255.0
gx = cv2.Sobel(f, cv2.CV_32F, 1, 0, ksize=3)   # d/dx (columns)
gy = cv2.Sobel(f, cv2.CV_32F, 0, 1, ksize=3)   # d/dy (rows)
M = np.hypot(gx, gy)                           # gradient magnitude
alpha = np.arctan2(gy, gx)                     # gradient direction, radians
edges = M > 0.3 * M.max()                      # crude thresholded edge map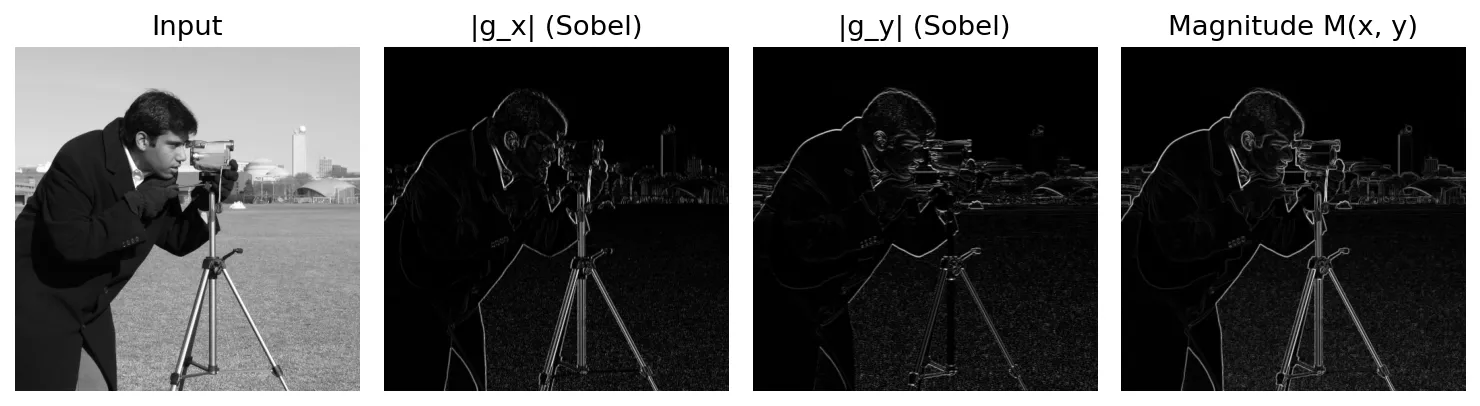
自己動手試試 Sobel 核:換成 方向的版本,或把 改成 變成 Prewitt,看看響應怎麼變。
直接對 做閾值化得到的邊緣圖並不好:邊緣太粗、弱邊緣消失、紋理造成雜亂。接下來兩個偵測器把平滑與細化直接設計進去。
Marr–Hildreth 邊緣偵測器
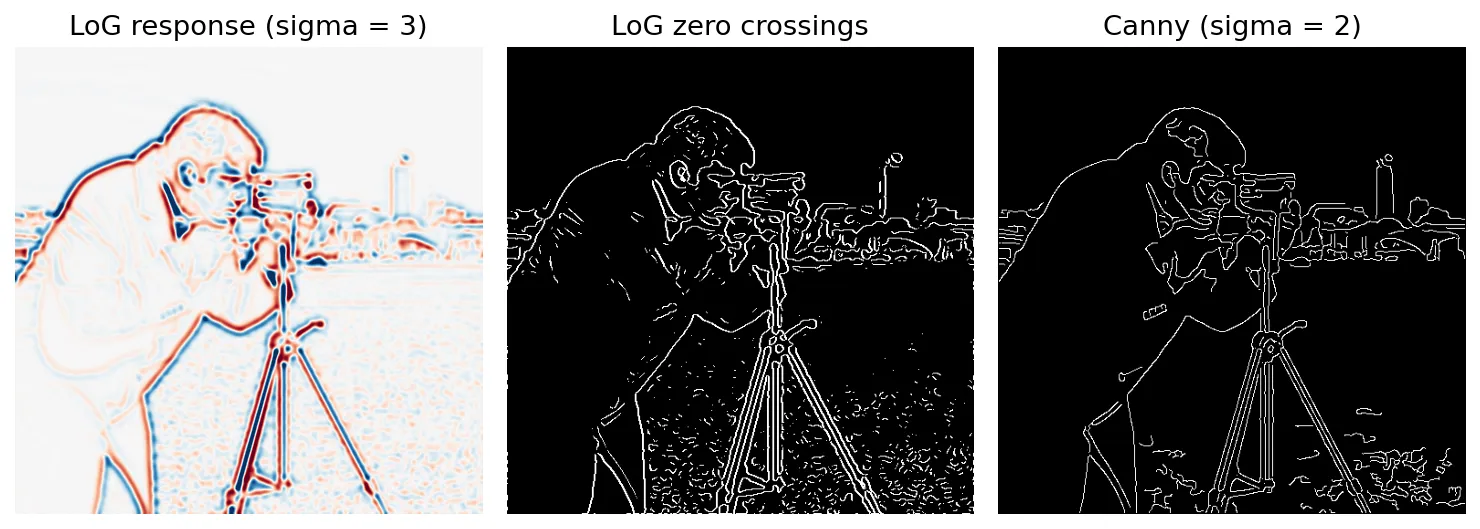
Marr 與 Hildreth [2] 主張強度變化發生在許多尺度上,所以偵測器的大小必須可調;而二階導數的零交越正好標出邊緣中心。他們的運算子是高斯的拉普拉斯(Laplacian of a Gaussian, LoG),其中
是高斯的標準差,決定尺度( 越大,只有越粗的邊緣留下來);因為只在乎零交越,所以省略了正規化常數。由於形狀的關係, 又稱為墨西哥帽(Mexican hat)。演算法如下:
- 用 的高斯核平滑, 取不小於 的最小奇數。
- 對結果取拉普拉斯(由於線性,步驟 1–2 等於與 做一次卷積)。
- 標出零交越:某一對相對鄰居的正負號不同,且差的絕對值超過閾值的像素。沒有這個閾值,平坦區域的每個小波動都會變成「邊緣」。
高斯差(difference of Gaussians, DoG),取 ,可以近似 LoG [1]。零交越會形成封閉輪廓,但在紋理處會產生一團「義大利麵」,也會把角落磨圓。
Canny 邊緣偵測器
Canny [3] 把邊緣偵測寫成一個最佳化問題,有三個準則:
- 低錯誤率:找到所有真正的邊緣,不產生假邊緣。
- 定位準確:偵測到的邊緣要盡量貼近真正的邊緣。
- 單一響應:一條真正的邊緣只產生一條偵測結果,而不是雙線。
對白雜訊中的一維階梯邊緣,最佳濾波器可以用高斯的一階導數很好地近似。實用的二維演算法如下:
- 用標準差為 的高斯平滑影像:。
- 計算 的梯度大小 與角度 。
- 非極大值抑制(non-maximum suppression)。把 量化成四個方向;若某像素的 小於梯度方向上兩個鄰居中的任一個,就設為零。脊線因此只剩一個像素寬。
- 雙閾值。選 與 , 約為 到 [1]。高於 的是強邊緣,介於兩者之間的是弱邊緣。
- 遲滯(hysteresis)。弱像素只有在透過其他弱像素連到強像素時才保留。
遲滯是關鍵。單一閾值不是把輪廓切斷,就是放進雜訊;雙閾值加上連通性,能保留掛在強邊緣上的微弱輪廓,同時丟掉孤立的弱響應。
import cv2
from scipy import ndimage as ndi
from skimage import data, feature

f8 = data.camera()
canny_cv = cv2.Canny(cv2.GaussianBlur(f8, (0, 0), 2), 30, 90)      # uint8 0/255
canny_sk = feature.canny(f8 / 255.0, sigma=2, low_threshold=0.05, high_threshold=0.15)
log = ndi.gaussian_laplace(f8 / 255.0, sigma=3)                   # Marr-Hildreth steps 1-2
cv2.Canny 沒有平滑參數,所以我們先自己模糊;scikit-image 的版本則直接接受 sigma。
拖動滑桿,看看 Canny 留下了哪些結構(邊緣以白底黑線顯示)。
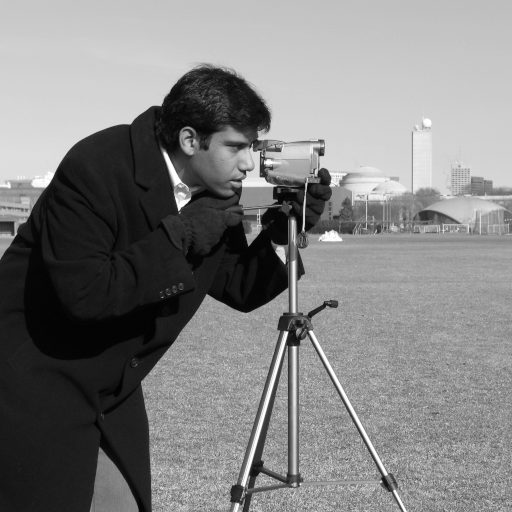
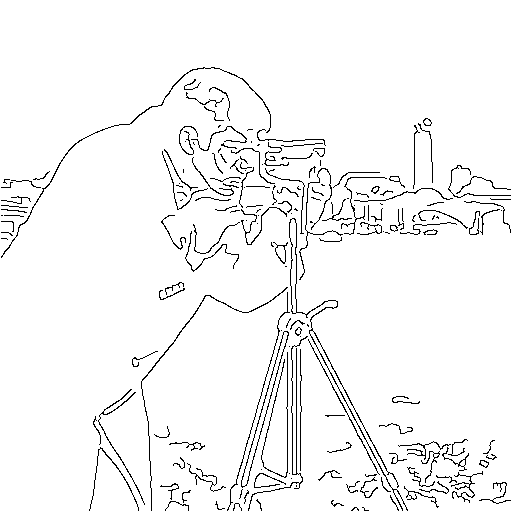 輸入Canny σ=2
串接邊緣點
即使是 Canny 也會留下缺口。邊緣串接(edge linking)把邊緣像素組成有意義的邊界。
局部處理。 在每個邊緣像素 的小鄰域 中,若鄰居 的梯度大小與角度都相近,就把兩者連起來:
其中 、 是正的容許值。更省計算的做法是:先對 做閾值化,只留下角度接近目標方向的像素,再沿每一列補上短缺口;把影像旋轉就能處理其他方向。
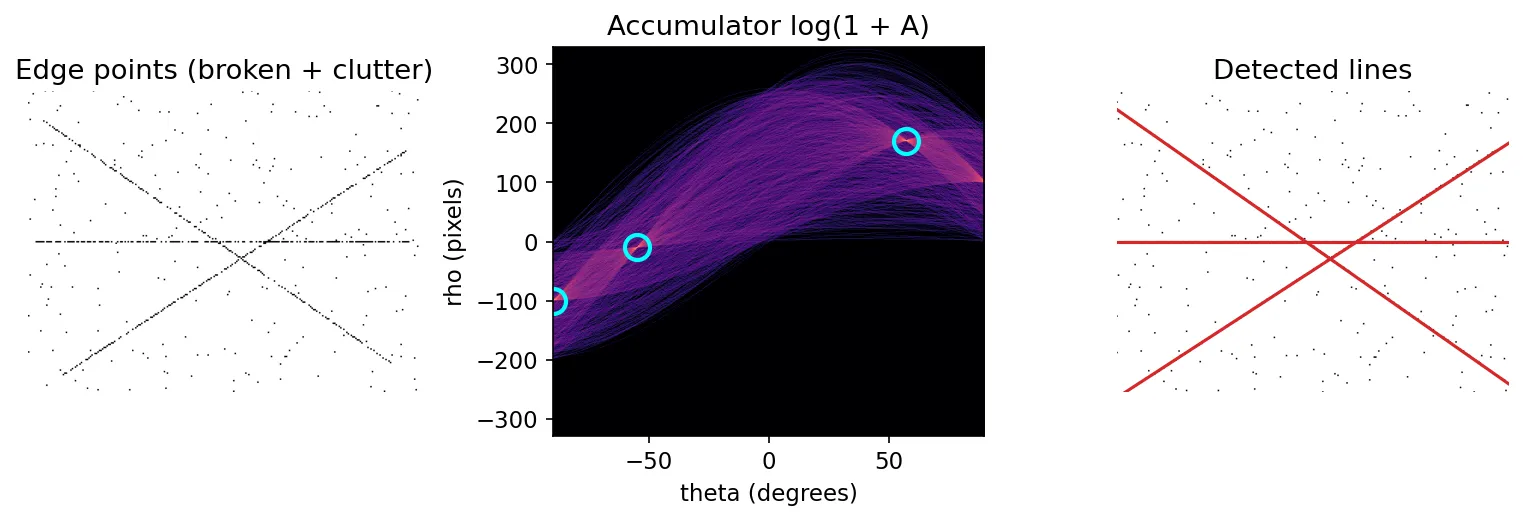
以 Hough 轉換做全域處理。 若已知形狀,就讓每個邊緣像素替所有可能通過它的形狀投票。對直線,Duda 與 Hart [4] 提出法線表示法
其中 是直線法線的角度, 是原點到直線的有號距離;和斜率–截距不同,垂直線時它仍然有界。每個點 在 平面上變成一條正弦曲線,共線點的曲線會交在同一格。演算法如下:
- 計算二值邊緣圖(例如用 Canny)。
- 把 平面量化成累加器格(accumulator cells),全部設為零。
- 對每個邊緣像素和每個 ,算出 並把 加一。
- 計數大的局部極大值就是直線;也可以檢查投票像素的連續性,把直線切成線段。
# continues from the Canny snippet above (uses cv2, np and canny_cv)
import numpy as np

lines = cv2.HoughLines(canny_cv, rho=1, theta=np.pi / 180, threshold=120)
for rho, theta in lines[:5, 0]:
    print(f"rho = {rho:6.1f} px, theta = {np.degrees(theta):5.1f} deg")
OpenCV 回傳的 , 可為負,和上面是同一種表示法,只是範圍不同。投票的想法也能延伸到圓與其他參數更多的形狀。
閾值化
白話版:選一個灰階,比它亮的是「物體」,比它暗的是「背景」。學問全在怎麼選。
基礎
給定強度閾值 ,全域閾值化(thresholding)得到
對整張影像固定時稱為全域閾值;隨位置改變時稱為可變閾值(也叫局部或自適應);用兩個以上閾值則稱為多重閾值化。當直方圖的各個峰分得很開時,閾值化效果很好。雜訊會把峰變寬,不均勻的照明與反射會讓峰在影像各處移動,而很小的物體只會在直方圖上形成一個容易被忽略的小突起。
基本全域閾值化
當峰分得很清楚時,下面這個簡單的疊代規則就很好用:
- 選一個初始 ,例如平均強度。
- 把像素分成 (值 )與 (值 )。
- 計算兩組的平均 、。
- 令 。
- 重複 2–4,直到 的變化小於某個 。
def basic_global(img, dT=0.5):
    T = img.mean()
    while True:
        m1, m2 = img[img > T].mean(), img[img <= T].mean()
        T_new = 0.5 * (m1 + m2)
        if abs(T_new - T) < dT:
            return T_new
        T = T_new
Otsu 最佳全域閾值
Otsu [5] 選的是讓兩類可分離性最大的閾值,以類間變異數(between-class variance)衡量。它只需要直方圖,因此很快。
設影像有 個灰階,灰階 有 個像素,總像素數為 ,正規化直方圖為 。閾值 把灰階分成 與 。定義
其中 是像素落在 的機率, 是到灰階 為止的累積平均, 是全域平均。於是 ,兩類的平均為 、。
推導。 全域平均是 。類間變異數定義為兩類平均在全域平均周圍的加權散佈:
代入 ,得到 與 ,因此
兩類平均離得越遠, 越大。再代入 與 ,就得到只需要累積和的形式:
最佳閾值為 (若有多個並列就取平均)。由於全域變異數 等於類間與類內變異數之和,而且與 無關,所以這同時也最小化類內變異數。比值
衡量可分離性:兩個乾淨的峰時接近 ,峰重疊時較低。
import numpy as np
from skimage import data, filters

def otsu(img):
    p = np.bincount(img.ravel(), minlength=256) / img.size   # normalized histogram
    P1 = np.cumsum(p)                                         # class-1 probability
    m = np.cumsum(np.arange(256) * p)                         # cumulative mean
    mG = m[-1]                                                # global mean
    with np.errstate(divide="ignore", invalid="ignore"):
        sB2 = (mG * P1 - m) ** 2 / (P1 * (1 - P1))
    sB2 = np.nan_to_num(sB2)
    k = int(np.argmax(sB2))
    return k, sB2[k] / np.var(img)                            # threshold, separability

coins = data.coins()
k, eta = otsu(coins)          # k = 107, eta ≈ 0.76
assert k == filters.threshold_otsu(coins)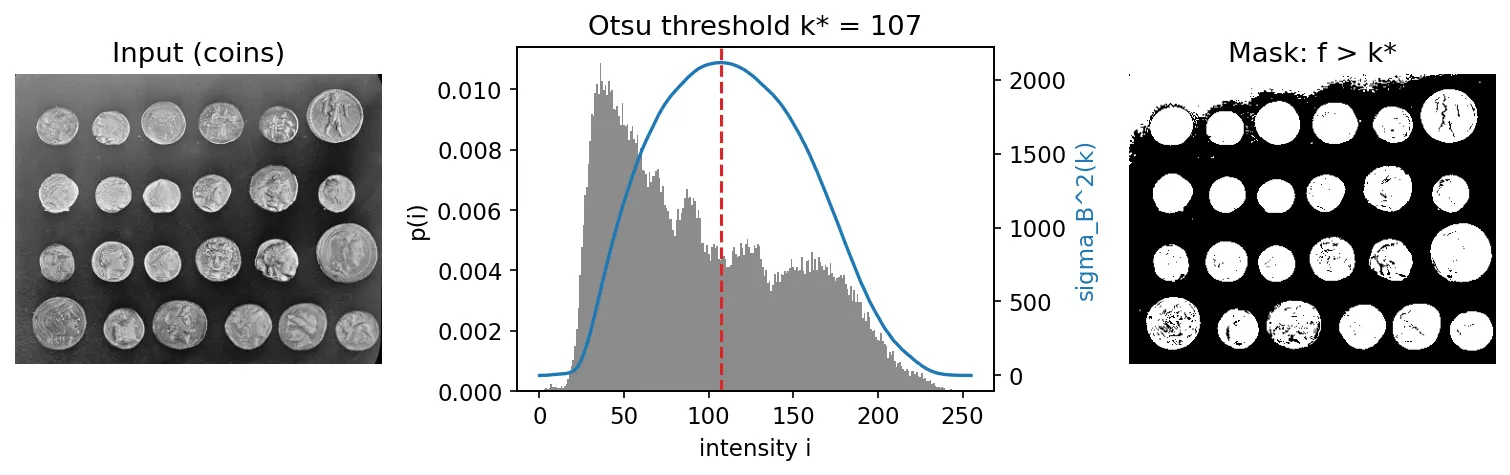
用平滑與邊緣改善閾值化
- 先平滑。 雜訊會讓峰變寬直到合併;平滑可以讓峰再變窄,前提是物體比濾波器大得多。
- 只用邊緣附近的像素。 小物體的峰會被背景的峰淹沒。保留邊緣指標(梯度大小或 )很高的像素,例如高於第 99.7 百分位數者,並只用這些像素計算直方圖。它們大約一半落在邊界兩側,因此直方圖變得平衡而雙峰。再把得到的閾值套用到整張影像。
多重閾值
Otsu 準則可以推廣到用 個閾值分出的 類:
、 是第 類的機率與平均,以窮舉搜尋求解。skimage.filters.threshold_multiotsu(coins, classes=3) 回傳 [77, 139]。
可變閾值化
照明不均時,沒有任何單一 管用。三種常見對策:
- 分塊。 每一塊用自己的 Otsu 值做閾值化;每一塊都必須同時含有兩類。
- 局部性質。 令 、 為 周圍視窗的平均與標準差,使用 (),或更一般的述詞 。Sauvola 與 Pietikäinen 的文件二值化規則 [7],, 為 的動態範圍、 為小正數,就屬於這一族。
- 移動平均。 對文字影像以之字形掃描,以 做閾值,其中 是最近 個像素的平均, 略小於 。
from skimage import data, filters

page = data.page()
global_mask = page > filters.threshold_otsu(page)
local_T = filters.threshold_local(page, block_size=35, offset=10)  # Gaussian-weighted local mean - 10
local_mask = page > local_T
sauvola_mask = page > filters.threshold_sauvola(page, window_size=25, k=0.2)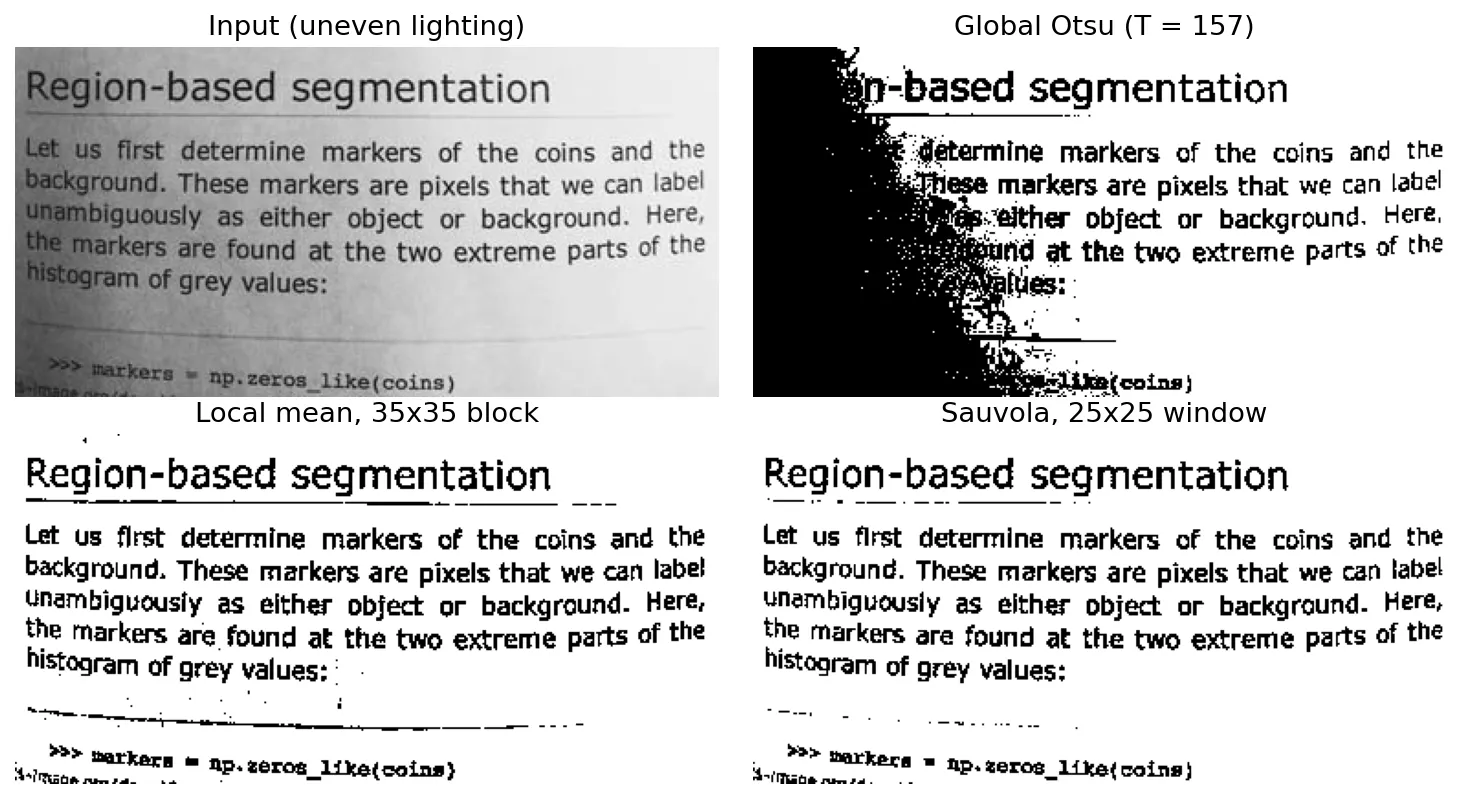
區域成長、分裂與合併
白話版:從幾個「種子」像素出發,不斷加入長得像它們的鄰居;或者從整張影像出發,不斷切成四塊,直到每一塊都均勻為止。
區域成長
區域成長(region growing)把滿足相似性述詞的鄰近像素加入每個種子。需要決定的有:種子(人工指定、用很保守的閾值選出,或取自直方圖峰值)、述詞(例如 ,或對區域統計量的測試)、連通性(4 或 8 連通),以及停止規則(沒有鄰居通過測試時停止;加上大小或形狀限制會更穩健)。
from collections import deque
import numpy as np

def region_grow(img, seed, tol):
    """Grow from `seed` over 8-connected pixels whose value is within `tol` of the seed value."""
    H, W = img.shape
    ref = float(img[seed])
    mask = np.zeros((H, W), bool)
    mask[seed] = True
    q = deque([seed])
    while q:
        r, c = q.popleft()
        for dr in (-1, 0, 1):
            for dc in (-1, 0, 1):
                rr, cc = r + dr, c + dc
                if 0 <= rr < H and 0 <= cc < W and not mask[rr, cc] \
                        and abs(float(img[rr, cc]) - ref) <= tol:
                    mask[rr, cc] = True
                    q.append((rr, cc))
    return mask
skimage.segmentation.flood(img, seed, tolerance=tol) 以編譯過的程式碼做同樣的事。
以四元樹做區域分裂與合併
不用種子,而是從整張影像 與述詞 開始:
- 對 的區域 ,分裂成四個等大的象限。
- 重複,直到所有區域都通過 ,或達到最小尺寸。
- 對任意兩個相鄰區域 ,若 就合併。
- 無法再分裂或合併時停止。
分裂的過程以四元樹(quadtree)儲存:根節點是整張影像,每個節點有四個子節點。只分裂會得到方塊狀的區域;合併才讓區域能跨越象限邊界。典型的述詞如「標準差大於 ,且平均介於 與 之間」。
以分群與超像素做區域分割
白話版:把每個像素當成用幾個數字(顏色、或許加上位置)描述的點,再把靠得近的點聚成一群。
k-means 分群
把每個像素表示成特徵向量 ,例如它的 Lab 顏色()。k-means 尋找 個群中心 與集合 ,使
最小,也就是到群平均的總平方距離。求全域最小值是 NP-hard,所以標準演算法交替進行:把每個向量指派給最近的中心,再把每個中心移到其成員的平均。它只會收斂到局部最小值,因此要從多個初始值執行。只用顏色分群會忽略位置,所以同一群可能散布在整張影像上。
超像素與 SLIC
超像素(superpixel)是一小塊緊密、相似且連通的像素。用幾百個超像素取代 個像素,可以讓後續問題變小,又不會移動重要的邊界。Achanta 等人的 SLIC [8] 就是在五維空間 中做 k-means。設有 個像素、想要 個超像素,格距為 。
- 在格距為 的網格上放 個中心,每個再移到其 鄰域中梯度最小的位置。
- 每個中心只搜尋周圍 的視窗,依下列距離指派像素
其中 、 分別是 Lab 顏色與 上的歐氏距離, 是緊緻度(compactness): 大時超像素接近方形, 小時會緊貼顏色邊緣。 3. 把每個中心移到其像素的平均;重複約十次。 4. 強制連通性:把零星碎片併入相鄰的超像素。
局部搜尋讓每次疊代的成本為 ,與 無關。
from skimage import data, segmentation

img = data.astronaut()
sp = segmentation.slic(img, n_segments=300, compactness=10, start_label=1)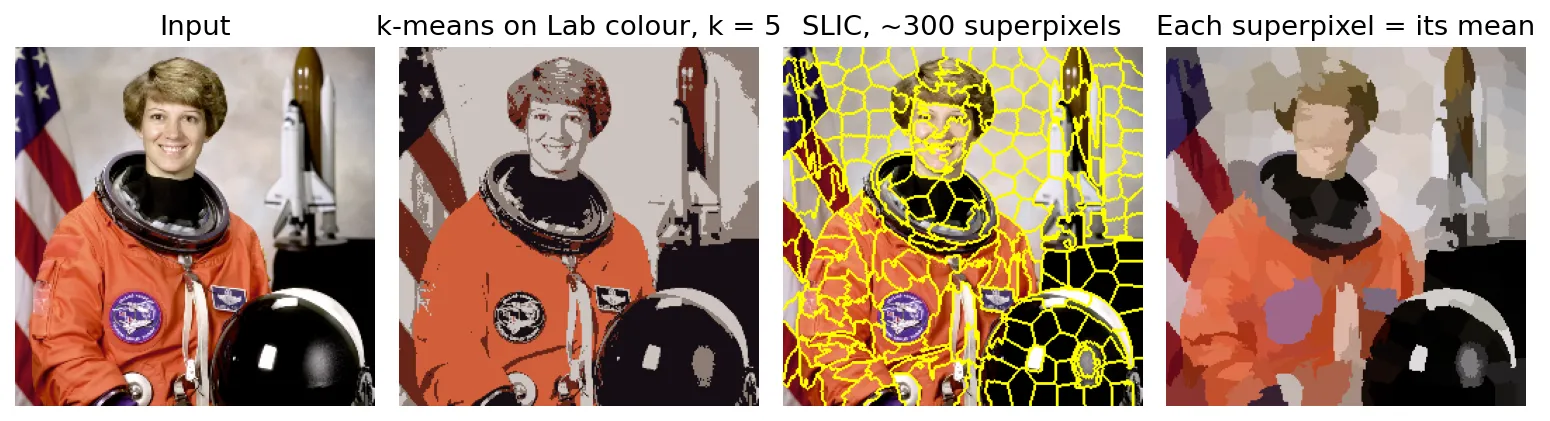
以圖切割做區域分割
白話版:把影像畫成一張網,相鄰像素之間綁著繩子,像的就綁粗繩、不像的就綁細繩。分割就是只剪斷細繩,把網分成幾塊。
把影像視為圖
圖(graph) 由節點 與邊 組成。每個像素(或超像素)是一個節點,鄰近節點之間以非負的相似度權重 相連,例如
其中 是特徵向量(強度、顏色), 是空間位置,、 是尺度參數, 是讓圖保持稀疏的半徑。
最小圖切割
切割(cut)把 分成兩個不相交的集合 、,並移除兩者之間的邊。其成本為
最小切割移除的相似度最少。一種常見的形式會加入一個源點(source,代表物體)與一個匯點(sink,代表背景),並以「多像物體、多像背景」的權重連到每個像素。最小源–匯切割會替每個像素貼上標籤,而且能用最大流演算法有效率地求得;使用者只要在物體與背景上各畫幾筆的互動式工具,就是以此為基礎。
正規化切割
沒有源點與匯點時,單純的最小切割偏好切下單一節點或極小的一群,因為要移除的邊很少。Shi 與 Malik [9] 以正規化切割(normalized cut)修正這個問題:
是 到所有節點的總連結。極小的 其 也很小,因此切下它變得很貴。精確最小化是 NP-hard,但鬆弛後可化為特徵值問題;令 為權重矩陣、 為度數 構成的對角矩陣,
第二小特徵值對應的特徵向量是一個連續的分割指標;對它做閾值化就能把圖一分為二,遞迴下去就得到更多區塊。實務上會在超像素圖上執行。
import numpy as np
from skimage import data, segmentation, graph

img = data.coffee()
sp = segmentation.slic(img, n_segments=400, compactness=30, start_label=1)
rag = graph.rag_mean_color(img, sp, mode="similarity")   # edge weight = exp(-|c_i - c_j|^2 / sigma)
ncut = graph.cut_normalized(sp, rag, rng=0)              # recursive two-way Ncut
print(sp.max(), "superpixels ->", len(np.unique(ncut)), "regions")
以形態學分水嶺做分割
白話版:把影像想成一片地形,越亮越高。從每個山谷灌水;兩個山谷的水快要相遇時,就築一道牆。這些牆就是分割結果。
背景:集水盆與水壩
把強度當成高度。每個區域極小值(regional minimum)都有一個集水盆(catchment basin),也就是水會流到它的所有點;分水線把相鄰的集水盆隔開。通常淹的是梯度大小而不是原影像:物體內部低、邊界是山脊,因此每個集水盆就是一個物體。
水壩用到第 9 章的形態學。當兩個已淹水的連通成分快要合併時,以 結構元素分別膨脹它們,並限制在低於目前水位的像素內;在同一步被兩者同時碰到的像素就是水壩像素,設成比影像最大值還高。這樣築出的水壩只有一個像素寬,而且是連通的。
分水嶺演算法
令 為影像 的區域極小值,、 為其極值, 為低於水位 的像素集合, 為水位 時所有集水盆已淹部分的聯集。淹水從 進行到 ,以 開始。在每個水位,對 的每個連通成分 與 比較:
- 為空:出現新的極小值, 成為新的集水盆。
- 只含 的一個成分: 位於某個既有集水盆中,把它加進去。
- 含兩個以上成分:集水盆正在相遇,依上述方法在 中築壩。
Vincent 與 Soille [10] 提出今日通用的高效實作:先依高度排序像素,再以 FIFO 佇列逐層淹水(「浸沒模擬」,immersion simulation)。
使用標記
直接用在梯度上,分水嶺會嚴重過度分割:雜訊與紋理造成成千上萬個極小值。解法是標記(markers),也就是事先確定位於物體內(內部標記)或背景中(外部標記)的連通成分。淹水只從標記開始,所以區域數就等於標記數。標記可以來自保守的閾值、平滑後的極小值、距離轉換的峰值,或使用者的點擊。
import numpy as np
from scipy import ndimage as ndi
from skimage import data, filters, morphology, segmentation

coins = data.coins()
elevation = filters.sobel(coins.astype(float))
markers = np.zeros_like(coins, dtype=np.int32)
markers[coins < 30] = 1        # sure background
markers[coins > 150] = 2       # sure object
ws = segmentation.watershed(elevation, markers)
coins_mask = morphology.remove_small_objects(ndi.binary_fill_holes(ws == 2), 100)
labels, n = ndi.label(coins_mask)   # n = 24 coins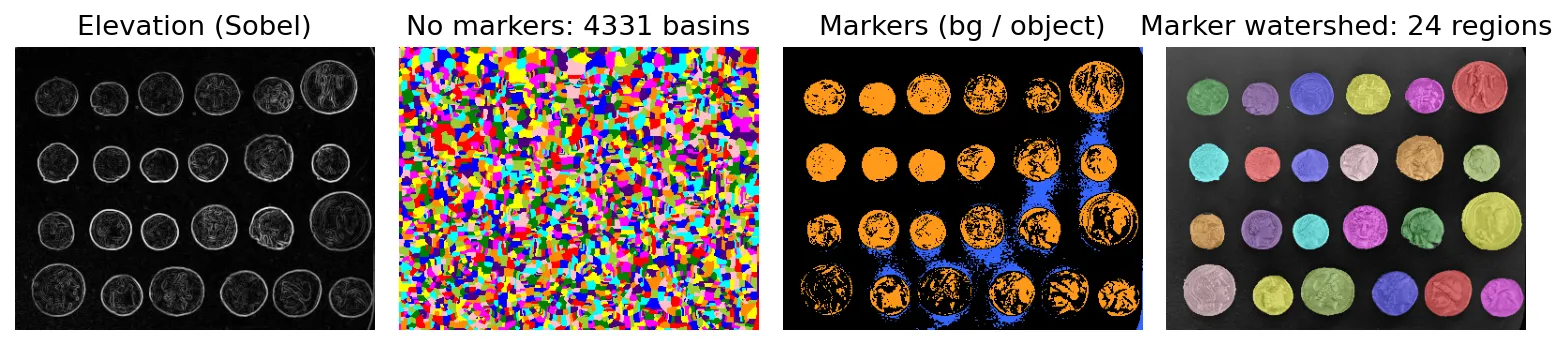
利用運動做分割
白話版:如果攝影機不動,兩張畫面之間有變的東西,就是你在意的東西。把兩張畫面相減,移動的物體就亮起來了。
空間技術:差異影像
給定靜止攝影機拍攝靜態場景的兩張畫面 與 ,差異影像(difference image)為
取略高於雜訊水準的值。雜訊造成的小點,可以靠丟棄太小的連通成分去除。
累積差異
單一差異影像會把移動物體顯示兩次:它原本在的地方和現在在的地方。累積差異影像(accumulative difference image, ADI)把參考畫面 與之後每張畫面比較並計數:
其他情況維持不變,初始為零()。若物體比背景亮,正 ADI 標出物體在參考畫面中的位置;負 ADI 朝運動方向增長,增長速度取決於物體速度;絕對 ADI 則兩者都包含。
import numpy as np

def accumulative_differences(frames, T):
    R = frames[0].astype(float)
    A = np.zeros(R.shape, int); P = np.zeros(R.shape, int); N = np.zeros(R.shape, int)
    for f in frames[1:]:
        d = R - f.astype(float)
        A += np.abs(d) > T
        P += d > T
        N += d < -T
    return A, P, N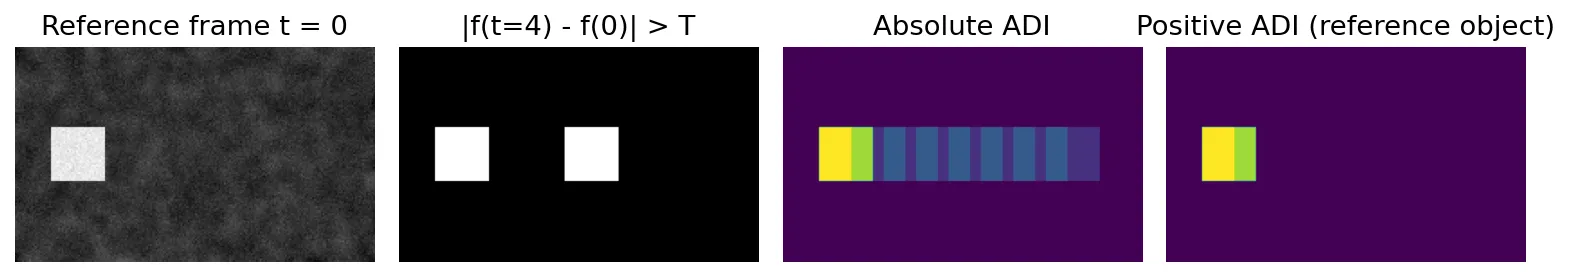
建立參考影像
不含任何移動物體的參考畫面很少見。當正 ADI 顯示某物體已完全離開它的起始位置時,就從目前畫面把那些像素複製到參考影像;對每個移動物體都這麼做,就得到一張背景參考影像。背景相減(background subtraction)方法則以逐像素的統計模型延伸這個想法。
現代觀點
以下五篇綜述描繪了這個領域,並說明深度學習改變了什麼、沒改變什麼。
傳統閾值化。 Sezgin 與 Sankur [6] 依所利用的資訊,把閾值化方法分成六族(直方圖形狀、量測空間分群、熵、物體屬性、空間相關、局部灰階曲面),並在非破壞檢測與文件影像上評估其中四十種,挑出在兩個領域都表現穩定的方法。Otsu 法屬於分群這一族。
深度分割。 Minaee 等人 [11] 綜述深度學習的語意分割與實例分割,把模型分成全卷積網路、編碼器–解碼器、多尺度與金字塔模型、遞迴網路、注意力模型與對抗式生成模型,並回顧了資料集與結果。幾個里程碑設計都呼應著傳統想法:
- FCN [13] 把分類網路改成全卷積,讓它輸出標籤圖,並融合深層粗略特徵與淺層精細特徵:一種學出來的多尺度分析。
- U-Net [14] 加上對稱的擴張路徑與跳接(skip connection),用少量訓練資料就能得到精確邊界,成為生醫影像的預設選擇之一。
- DeepLab [16] 以空洞卷積(atrous convolution)與空洞空間金字塔池化兼顧解析度與脈絡,再用全連接 CRF 讓邊界更銳利。
- Mask R-CNN [15] 在物體偵測器上加一個遮罩分支,能分開同類別而互相接觸的物體,也就是分水嶺中標記所做的工作。
基礎模型與可提示分割。 Segment Anything(SAM)[17] 是可用點、框或遮罩當提示的模型,訓練於 SA-1B:1,100 萬張影像上的十億個以上遮罩。點一下、回傳一個遮罩,這正是種子區域成長與互動式圖切割的介面,只是相似度改由學習而來。Zhou 等人 [12] 回顧了這個「基礎模型時代」的三百多種方法,分為一般任務(語意、實例、全景分割)與可提示任務(互動式、指稱式、少樣本),並說明大型預訓練模型如何帶有分割知識。
邊緣偵測。 Sun 等人 [18] 把傳統邊緣偵測器分成梯度、高斯差、多尺度與結構化學習四類,把深度方法分成編碼器–解碼器、網路重構與多尺度融合三類。HED [19] 是關鍵的早期深度設計:把網路多個深度的側輸出融合成一張邊緣圖,可說是 Marr 與 Hildreth 多尺度論點的學習版後代。該綜述的結論是:學習式偵測器在標準評測上已接近甚至超越人類水準,剩下的開放問題是輕量化模型、弱監督與可解釋性。
超像素。 Stutz、Hermans 與 Leibe [20] 評測了 28 種演算法,強調要調好參數並嚴格強制連通性,提出與超像素數量無關的指標,並測試對雜訊、模糊與仿射轉換的穩健性。
改變了什麼、沒改變什麼。 學習出的特徵取代了手工設計的述詞與邊緣強度,在自然影像上尤其明顯。但傳統的骨架還在:網路輸出的是機率圖,仍然要做閾值化;互相接觸的實例仍需要分開,靠的是偵測框、學出來的標記,或在預測的距離圖上跑分水嶺;而在資料稀少、運算受限或行為必須可預測的場合,例如文件掃描與工業檢測,Otsu、Canny 與 Hough 仍然勝出。
重點整理
- 分割把影像劃分成連通、不重疊、各自滿足述詞 的區域;方法不是找不連續(邊緣),就是找相似(區域)。
- 一階導數給出粗的邊緣響應;二階導數給出雙重響應,邊緣中心是零交越,而且對雜訊非常敏感,所以要先平滑再微分。
- Canny = 高斯平滑 + 梯度 + 非極大值抑制 + 帶遲滯的雙閾值;最後一步讓微弱但連通的邊緣得以保留。
- Hough 轉換把找直線變成在 空間投票,對缺口與雜點很穩健。
- Otsu 閾值最大化類間變異數 ,可由直方圖的累積和算出;照明不均時改用局部閾值。
- 區域方法(成長、分裂合併、k-means、SLIC、正規化切割)依相似性分組;正規化切割避免了單純最小切割偏好小區塊的問題。
- 分水嶺從極小值開始淹梯度影像,在水相遇處築壩;要避免過度分割,標記不可或缺。
- 深度網路學會了相似度與邊緣的衡量方式,但閾值化、多尺度融合、種子或提示、實例分離,仍是現代流程的骨架。
練習
- 一個一維訊號先有五個樣本為 10,接著在四個樣本內線性上升到 50,之後維持 50。寫出它的一階與二階差分,並標出二階差分的零交越相對於斜坡的位置。
提示
一階差分在四個斜坡步上都是 10,其他地方為 0。二階差分在斜坡起點為 +10、終點為 −10,中間為 0,所以零交越在斜坡中段。
- 證明最大化類間變異數 等價於最小化加權類內變異數 。
提示
把 在 處拆開,每一類內加減該類平均;交叉項為零,剩下 ,而 與 無關。
- 在 Canny 偵測器中,若設 會怎樣?若 呢?先預測結果,再用
skimage.feature.canny在data.camera()上驗證。
提示
等於關掉遲滯:輪廓會斷掉。 會保留每個與強邊緣相連、通過細化的像素,所以邊緣會滲進草地紋理。
- 一個 Hough 累加器對 的影像, 在 間以 1° 為一格, 以 1 像素為一格。累加器共有幾格?一張有 20,000 個邊緣像素的邊緣圖會造成多少次加一?
提示
,所以約有 1,601 個 格與 180 個 格,約 288,000 格。每個邊緣像素對每個 投一票: 萬次。
- 以權重均為 的 4 連通像素圖,說明為什麼單純的最小切割傾向切下單一像素。再計算在 個像素的影像中切下一個內部像素的 Ncut,說明它接近 1,而沿著短邊界的平衡切割則接近 0。
提示
切下一個像素只需成本 ,比任何長邊界都小。對 Ncut 而言,,第一項為 ,第二項極小:Ncut ≈ 1,是很差的分數。
- 依上文在
data.coins()上執行標記控制分水嶺(背景標記coins < 30、物體標記coins > 150),再把物體閾值改成 120、190 與 230。哪些硬幣會合併或消失?為什麼?
提示
在 120 時,物體標記落在上方較亮的背景帶上,硬幣與背景合併成大區域(我們數到 11 個)。在 190 時仍有 24 個,因為每枚硬幣只要一個標記像素就夠;到 230 時,較暗的硬幣失去標記而消失(剩 13 個)。標記決定了結果。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 10. publisher page
- D. Marr and E. Hildreth, “Theory of edge detection,” Proceedings of the Royal Society of London. Series B, vol. 207, no. 1167, pp. 187–217, 1980. doi
- J. Canny, “A Computational Approach to Edge Detection,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. PAMI-8, no. 6, pp. 679–698, 1986. doi
- R. O. Duda and P. E. Hart, “Use of the Hough transformation to detect lines and curves in pictures,” Communications of the ACM, vol. 15, pp. 11–15, 1972. doi
- N. Otsu, “A Threshold Selection Method from Gray-Level Histograms,” IEEE Transactions on Systems, Man, and Cybernetics, vol. 9, no. 1, pp. 62–66, 1979. doi
- M. Sezgin and B. Sankur, “Survey over image thresholding techniques and quantitative performance evaluation,” Journal of Electronic Imaging, vol. 13, no. 1, pp. 146–165, 2004. doi
- J. Sauvola and M. Pietikäinen, “Adaptive document image binarization,” Pattern Recognition, vol. 33, no. 2, pp. 225–236, 2000. doi
- R. Achanta, A. Shaji, K. Smith, A. Lucchi, P. Fua and S. Süsstrunk, “SLIC Superpixels Compared to State-of-the-Art Superpixel Methods,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 34, no. 11, pp. 2274–2282, 2012. doi
- J. Shi and J. Malik, “Normalized cuts and image segmentation,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 22, no. 8, pp. 888–905, 2000. doi
- L. Vincent and P. Soille, “Watersheds in digital spaces: an efficient algorithm based on immersion simulations,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 13, no. 6, pp. 583–598, 1991. doi
- S. Minaee, Y. Boykov, F. Porikli, A. Plaza, N. Kehtarnavaz and D. Terzopoulos, “Image Segmentation Using Deep Learning: A Survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 7, pp. 3523–3542, 2022. doi · arXiv
- T. Zhou, W. Xia, F. Zhang, B. Chang, W. Wang, Y. Yuan, E. Konukoglu and D. Cremers, “Image Segmentation in Foundation Model Era: A Survey,” arXiv:2408.12957, 2024. arXiv
- J. Long, E. Shelhamer and T. Darrell, “Fully Convolutional Networks for Semantic Segmentation,” arXiv:1411.4038, 2014. arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” MICCAI 2015, arXiv:1505.04597. arXiv
- K. He, G. Gkioxari, P. Dollár and R. Girshick, “Mask R-CNN,” arXiv:1703.06870, 2017. arXiv
- L.-C. Chen, G. Papandreou, I. Kokkinos, K. Murphy and A. L. Yuille, “DeepLab: Semantic Image Segmentation with Deep Convolutional Nets, Atrous Convolution, and Fully Connected CRFs,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 40, no. 4, pp. 834–848, 2018. doi · arXiv
- A. Kirillov, E. Mintun, N. Ravi et al., “Segment Anything,” arXiv:2304.02643, 2023. arXiv
- R. Sun, T. Lei, Q. Chen, Z. Wang, X. Du, W. Zhao and A. K. Nandi, “Survey of Image Edge Detection,” Frontiers in Signal Processing, 2022. doi
- S. Xie and Z. Tu, “Holistically-Nested Edge Detection,” arXiv:1504.06375, 2015. arXiv
- D. Stutz, A. Hermans and B. Leibe, “Superpixels: An Evaluation of the State-of-the-Art,” Computer Vision and Image Understanding, vol. 166, pp. 1–27, 2018. doi