第 4 章・頻域濾波
先備知識: 第 3 章・強度轉換與空間濾波
你將學到
- 傅立葉轉換(Fourier transform)在描述訊號的什麼,以及為什麼「頻率」是描述影像的好方法
- 取樣(sampling)如何運作、什麼是奈奎斯特取樣率(Nyquist rate),以及取樣太稀疏為什麼會產生混疊(aliasing)與摩爾紋(moiré)
- 一維與二維的離散傅立葉轉換(DFT),以及每天都會用到的性質:中心化、對稱性、頻譜與相位、卷積定理
- 頻域濾波的標準步驟,包括避免環繞誤差(wraparound error)所需的填補
- 低通、高通、同態、帶拒與陷波濾波器,以及「理想」濾波器為什麼會產生振鈴(ringing)
- 快速傅立葉轉換(FFT)如何讓這一切變得便宜,以及傅立葉的想法在現代深度學習中出現在哪裡
先看全貌
在第 3 章,我們讓一個小卷積核在像素上滑動來濾波。這一章換一個完全不同的角度看同一張影像。我們不再問「這個像素有多亮?」,而是問「這張影像裡含有多少各種不同的波?」第二種描述叫做影像的頻譜(spectrum),產生它的工具就是傅立葉轉換。
為什麼要這麼麻煩?有三個理由。第一,有些操作用「保留這些頻率、拿掉那些頻率」來描述,比設計一個卷積核容易得多。第二,根據卷積定理,大型卷積會變成簡單的乘法,而 FFT 讓它跑得很快。第三,頻率的觀點能解釋許多在像素觀點下很神祕的現象:為什麼縮小影像會冒出奇怪的花紋、為什麼截止得很陡的濾波器會產生漣漪,以及為什麼重複出現的條紋雜訊幾乎可以被完美移除。本章依照 Gonzalez 與 Woods 教科書的章節安排 [1]。
背景
白話版。 任何合理的訊號,都可以由許多不同頻率的正弦波和餘弦波相加而成,每個波有自己的強度和起始位置。傅立葉轉換就是要找出這些強度和起始位置。
十九世紀初,傅立葉(Joseph Fourier)主張:週期函數可以寫成正弦與餘弦的加權總和;即使是非週期函數,只要曲線下的面積有限,也能寫成正弦與餘弦的積分。最驚人的是,這個過程不會遺失任何資訊:你可以轉到頻率描述,再一模一樣地轉回來。
對影像而言,這件事有兩層意義。低頻是橫跨影像緩慢變化的波,它承載整體亮度與大片平滑區域。高頻變化得很快,它承載邊緣、細紋理與雜訊。平滑影像就是削弱高頻;銳化影像就是加強高頻。本章要把這個說法講得精確。
傅立葉分析要到 1965 年快速傅立葉轉換出現之後 [4],才真正成為實用的影像處理工具;在那之前,對一張影像做轉換實在太慢了。Heideman、Johnson 與 Burrus 後來指出,高斯(Gauss)早在 1805 年左右就用過同樣的想法,遠早於電腦的出現 [5]。
預備概念
白話版。 在轉換影像之前,我們需要五樣工具:複數(把一個波的強度和起始位置一起存起來)、傅立葉級數(波的總和)、脈衝(完美的「尖峰」)、傅立葉轉換本身,以及卷積。
複數
複數寫成 ,其中 是實部, 是虛部,。它也可以寫成極座標形式
其中 是大小(長度), 是角度。歐拉公式 把兩種寫法連在一起。這就是傅立葉轉換使用複指數的原因:一個複數就能同時記錄一個波的振幅(amplitude)與相位(phase,也就是波從哪裡開始)。複數的共軛為 。
傅立葉級數
一個以週期 重複的函數 可以寫成
其中 是整數, 是在一個週期內完成 個循環的那個波的(複數)係數, 是連續變數(時間或位置)。
脈衝與篩選性質
連續的單位脈衝(unit impulse) 是一個理想化的尖峰:除了 以外處處為零,而總面積為 1,即 。它最有用的性質是篩選性質(sifting property):
其中 是任意位置。乘上一個平移過的脈衝再積分,就把 在 的值「挑」出來。離散脈衝 在 時為 1、其他地方為 0,篩選性質變成 。
脈衝串(impulse train) 是一排間距為 的脈衝,它就是取樣的數學模型。
連續函數的傅立葉轉換
的傅立葉轉換與反轉換為
其中 是連續頻率(每單位 的循環數), 一般是複數。這兩個式子合稱傅立葉轉換對,記作 。
用一個例子建立直覺。取一個高度為 、只在 時不為零的方框函數,它的轉換是
其中 。這裡有兩個教訓。第一,有銳利邊緣的函數,其轉換會向外擴散,帶著緩慢衰減的漣漪。第二,兩個域之間存在反比關係:方框越寬,sinc 越窄。在一個域裡窄,在另一個域裡就寬。等一下「理想」濾波器產生振鈴時,這兩個教訓會再次出現。
另外兩組轉換對值得記住。脈衝的轉換是常數:。間距為 的脈衝串,其轉換是另一個間距為 的脈衝串:
卷積
兩個連續函數的卷積為
其中 是積分用的虛擬變數。卷積定理(convolution theorem)說
一個域裡的卷積,就是另一個域裡的乘法。頻域濾波之所以存在,全靠這一個事實。
取樣與取樣函數的傅立葉轉換
白話版。 相機並不會記錄連續的場景,它只在一個格點上量測。格點太疏的話,快速的細節會被誤認成緩慢的變化,你會看到其實不存在的花紋。只要取樣頻率超過最快頻率的兩倍,原則上就能把原訊號完整重建。
取樣就是相乘
把取樣模型化為 乘上脈衝串:
其中 是取樣間隔, 是取樣值。由卷積定理,相乘變成與 卷積,而與一串脈衝卷積,效果就是把頻譜複製很多份:
所以,取樣後函數的頻譜,是原頻譜以 為間隔、無限重複的週期性複本。
取樣定理與奈奎斯特取樣率
假設 是帶限(band-limited)的:當 時 。只要複本之間的間距大於一份複本的寬度,它們就不會重疊:
這就是取樣定理,因 Shannon 而在工程界廣為人知 [2]。 稱為奈奎斯特取樣率。取樣速度超過它,取樣值就包含 的全部資訊。
重建
如果複本沒有重疊,把 乘上一個高度為 、涵蓋 的方框 ,就能分離出原本的頻譜。在時域,這相當於與 sinc 函數卷積,得到內插公式
每個取樣點都貢獻一個以自己為中心的 sinc,加總後的曲線剛好通過所有取樣點。Unser 的回顧論文 [3] 說明了現代實務如何用樣條(spline)等緊湊的核心,來取代不切實際的無限長 sinc,並把它近似得很好。
混疊
若 ,相鄰的複本會重疊,尾巴互相疊加。之後不論用什麼濾波器都無法把它們分開:高頻偽裝成了低頻。這就是混疊。唯一的解法是預防:在取樣之前用低通濾波器(抗混疊濾波器,anti-aliasing filter)去除高頻。
一個小實驗就能看到這種偽裝。以每秒 10 個樣本取樣一個 9 Hz 的餘弦波,此時奈奎斯特上限是 5 Hz:
import numpy as np

fs = 10.0                      # samples per second
t = np.arange(0, 2, 1 / fs)    # 2 seconds of samples
x = np.cos(2 * np.pi * 9 * t)  # a 9 Hz tone: above fs/2 = 5 Hz
X = np.abs(np.fft.rfft(x))
freqs = np.fft.rfftfreq(len(x), d=1 / fs)
print("peak at", freqs[X.argmax()], "Hz")   # -> 1.0 Hz, not 9 Hz
在這些取樣時間點上,9 Hz 的音和 1 Hz 的音完全無法區分。電影裡馬車車輪看起來倒著轉,也是同一個效應。
一維離散傅立葉轉換
白話版。 電腦手上只有有限個取樣值,所以它使用有限版本的傅立葉轉換。DFT 吃進 個數字,吐出 個數字,每個數字代表某一個特定的波有多少。
定義
對取樣值 :
其中 是取樣點的索引, 是離散頻率的索引(頻率 代表在 個樣本內完成 個循環),係數 放在反轉換上(也有慣例把它拆成兩邊各 )。
與取樣的關係
這個公式從哪裡來?取樣後函數的轉換 是連續的,並以 為週期。在其中一個週期內等間隔地取 個點,,,得到的正好就是上面的 DFT。所以 DFT 就是取樣資料之轉換、在一個週期內的取樣值。DFT 相鄰頻率之間的間距為
其中 是全部樣本所涵蓋的總長度。紀錄越長,頻率解析度越細。
實務上有兩個後果。因為在頻率上也取了樣,DFT 會把資料當作以 為週期重複。而且 與 都是週期性的:、。
這個定義其實就是一次矩陣與向量的乘法,很容易驗證:
import numpy as np

def dft(f):
    M = len(f)
    x = np.arange(M)
    u = x.reshape(-1, 1)
    W = np.exp(-2j * np.pi * u * x / M)   # M x M matrix of complex exponentials
    return W @ f

f = np.random.default_rng(0).standard_normal(64)
print(np.allclose(dft(f), np.fft.fft(f)))  # True
推廣到二變數函數
白話版。 影像有兩個方向,所以波也有兩個頻率:一個橫向、一個縱向。二維的波看起來像一組平行條紋,兩個頻率決定了條紋有多密、朝哪個方向。
二維脈衝與連續轉換
二維脈衝 的體積為 1,篩選方式和一維相同:。二維連續轉換為
其中 是空間座標, 是對應的頻率。
二維取樣與混疊
以間距 、 在格點上取樣,會把頻譜複製到一個二維格子上。一張帶限影像(在 、 之外為零)可以被完整復原的條件是
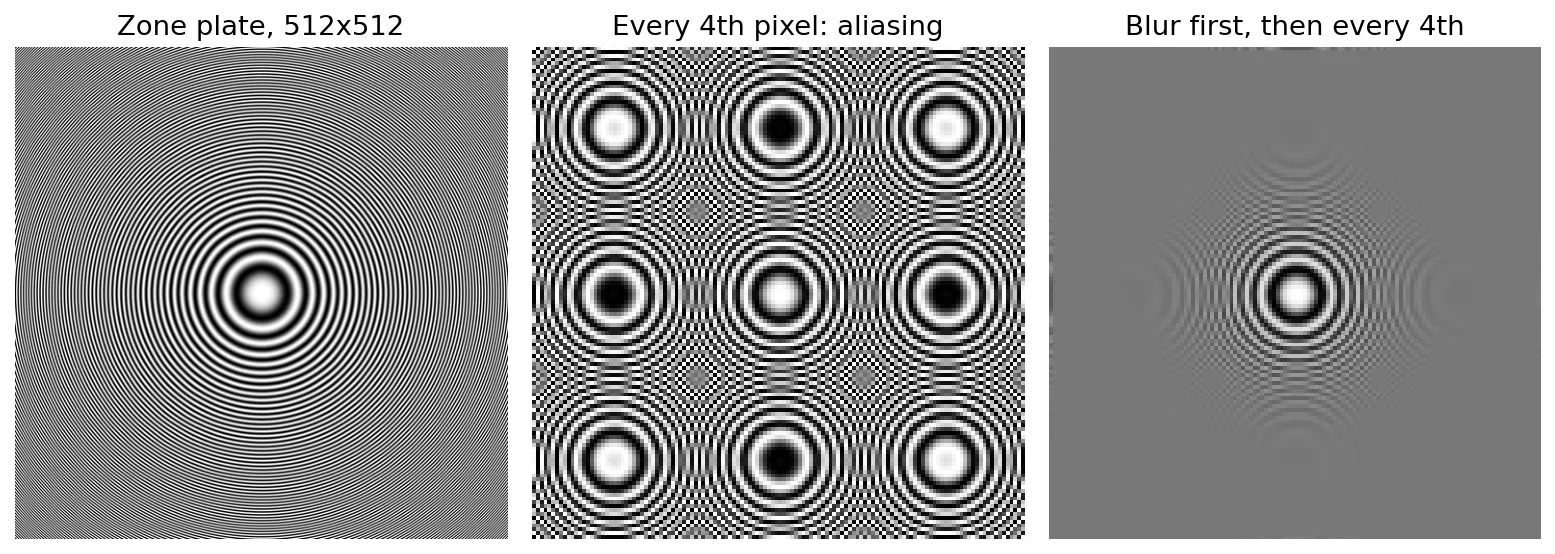
影像經常違反這條規則。真實場景含有銳利邊緣,而銳利邊緣根本不是帶限的,所以每張數位影像多少都有混疊。當你用丟棄像素的方式降取樣(縮小)影像時,混疊就會變得明顯。圖 4.1 使用一張波帶片(zone plate),它的頻率隨著與中心的距離增加。每 4 個像素只留 1 個,外圈的細環就變成原圖中根本不存在的假圓圈。先模糊再取樣,就能移除那些無法保留的頻率,假圓圈也隨之消失。
摩爾紋
摩爾紋是日常生活中看得到的混疊:當細密的週期紋理(襯衫的織紋、紗窗、印刷照片的網點)被間距相近的感測器格點取樣時,兩種週期互相「拍」出又大又慢的波浪狀條帶。圖 4.1 中間那張就是這種摩爾紋。相機在感測器前面放一片光學抗混疊濾鏡來減輕它;軟體則在縮放之前先模糊。
二維 DFT
對一張 的影像 :
其中 是像素座標(列、行), 是離散頻率索引, 是 的複數陣列。 的每一個元素都描述一個覆蓋整張影像的二維波。
二維 DFT 的性質
白話版。 頻譜的行為是可以預測的。移動物體不會改變頻譜的大小;旋轉物體會讓頻譜跟著旋轉;(移位後的)頻譜中心存的是平均亮度。最令人意外的是:我們在圖中認得出來的東西,大部分存在相位裡,而不是在大小裡。
空間間隔與頻率間隔
如果影像是以間距 、 取樣的,DFT 的頻率間距為
視野越大,頻率解析度越細;像素越小,DFT 能表示的最高頻率就越高。
平移與旋轉
平移影像等於把轉換乘上一個線性相位,反之亦然:
其中 是平移量。因為 ,大小 不受平移影響,只有相位改變。若使用極座標 、 以及 、,把 旋轉 , 也會旋轉同樣的角度:。
週期性與中心化
DFT 與其反轉換在兩個方向上都是週期性的:對任意整數 ,。因此,原始的 DFT 陣列把零頻率放在左上角,四個四分之一週期在陣列中央相遇。不論是觀察頻譜還是設計濾波器,把零頻率移到中央都方便得多。利用平移性質,令 、:
此式在 、 為偶數時成立。在 NumPy 中,轉換之後呼叫 np.fft.fftshift 可以達到同樣的重新排列。
對稱性
對實數影像而言,轉換具有共軛對稱性:。因此大小是偶函數,,相位則是奇函數。頻譜中的每一個亮點,都有一個對中心鏡像的雙胞胎。設計陷波濾波器時會用到這一點。
傅立葉頻譜與相位角
令 ,則
分別是傅立葉頻譜(大小)、相位角與功率譜(power spectrum)。零頻率項稱為 DC 成分,,其中 是平均灰階值。由於 通常比其他值大上數千倍,顯示頻譜時會用 。
import numpy as np
from skimage import data, img_as_float

f = img_as_float(data.camera())
F = np.fft.fft2(f)
Fc = np.fft.fftshift(F)                       # move (0,0) to the centre
spectrum = np.log1p(np.abs(Fc))               # log(1+|F|) for display
phase = np.angle(Fc)

M, N = f.shape
y, x = np.mgrid[0:M, 0:N]
print(np.allclose(np.fft.fft2(f * (-1.0) ** (x + y)), Fc))  # True for even M, N
print(np.isclose(F[0, 0].real, f.sum()))                    # DC term = sum of pixels
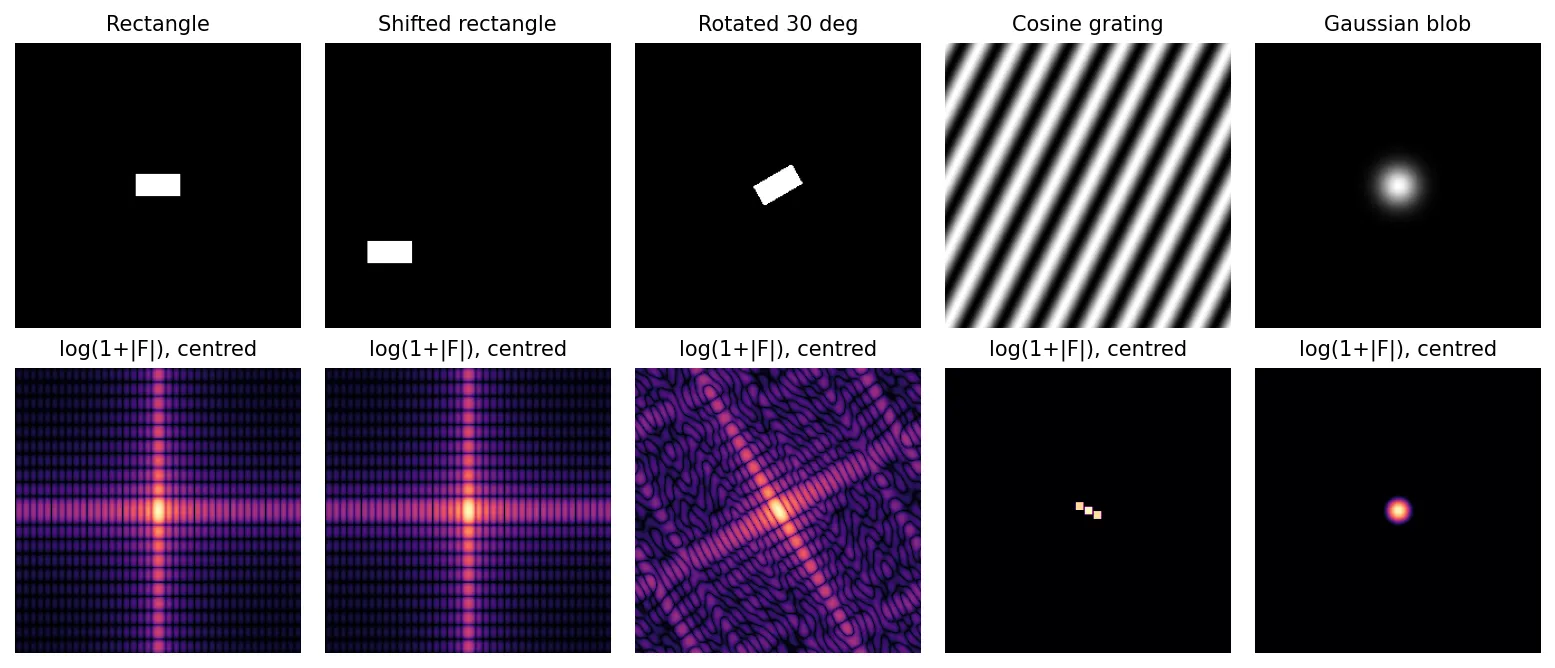
圖 4.2 顯示簡單圖案與頻譜的對應。矩形的轉換是二維 sinc:一個明亮的十字,沿著矩形短邊方向的那一臂比較長(空間中窄、頻率中寬)。平移矩形,頻譜完全不變;旋轉矩形,頻譜跟著旋轉。餘弦光柵只含一個二維頻率,所以頻譜只有三個點:DC 項與一對對稱的點。高斯函數轉換後仍是高斯函數。
相位與大小的交換實驗
轉換中的哪一部分,承載了我們認得出來的內容?取兩張影像,保留其中一張的大小、另一張的相位,再做反轉換。Oppenheim 與 Lim 讓這個實驗廣為人知 [7]。
import numpy as np
from skimage import color, data, img_as_float

a = img_as_float(data.camera())
b = img_as_float(color.rgb2gray(data.astronaut()))
A, B = np.fft.fft2(a), np.fft.fft2(b)
mixed = np.real(np.fft.ifft2(np.abs(A) * np.exp(1j * np.angle(B))))
# 'mixed' looks like the astronaut, not the cameraman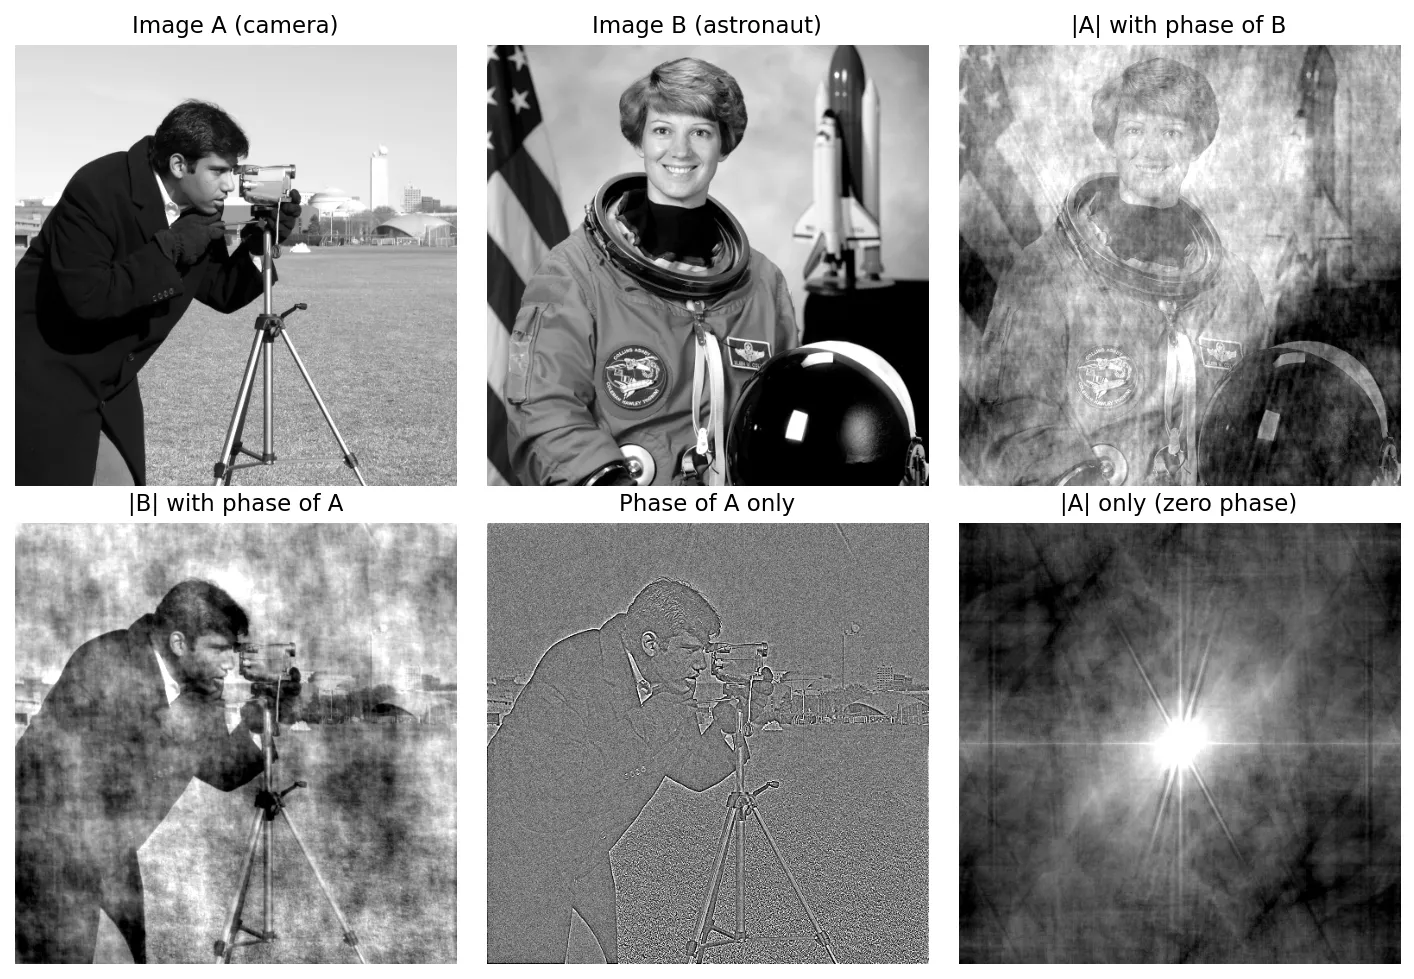
結果非常明確:結構由相位承載。大小告訴你每個頻率上有多少能量,而大多數自然照片的這部分都差不多。相位告訴你各個波在哪裡對齊,而邊緣恰好就是許多波對齊的地方。這也是為什麼後面的濾波器都設計成不動相位。
二維卷積定理
離散版本的卷積定理為
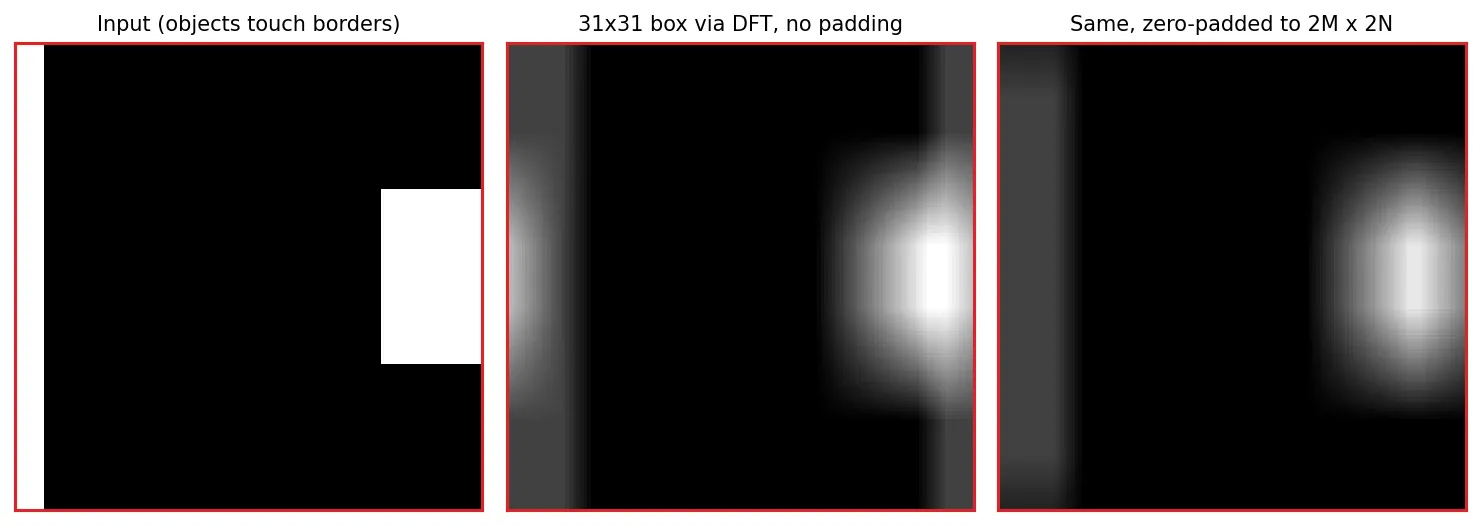
其中索引 與 要對 、 取餘數。這是循環卷積(circular convolution):DFT 假設影像無限重複,所以從右邊緣推出去的東西會從左邊冒出來。
環繞誤差與填補
循環卷積並不是我們要的,它會把影像左右邊界的內容混在一起。這就是環繞誤差。解法是把兩個陣列都補零,讓週期之間的距離大到複本永遠不會碰在一起。若 大小為 、 大小為 ,則填補後的大小 應滿足
如果濾波器直接在頻域中指定、而且和影像一樣大,常見的選擇就是 、。
頻域濾波基礎
白話版。 先轉換影像,再把每個頻率乘上一個代表「保留」或「移除」的數字,最後轉換回來。這一整份數字清單就是濾波器。
濾波步驟
給定 的影像 與濾波器轉移函數(transfer function):
- 選擇填補大小 、。
- 在影像後方補零(或補鏡像像素),得到 的填補影像 。
- 把 乘上 ,使其轉換中心化。
- 計算 DFT,得到 。
- 建立大小為 、中心位於 的實數對稱濾波器 ,並計算 。
- 計算 。
- 裁切左上角 的區域,得到 。
第 6 步取實部,只是丟掉浮點數捨入誤差造成的微小虛部;對實數影像與實數對稱濾波器而言,精確的結果本來就是實數。
import numpy as np

def filter_freq(f, H_of_D):
    """Filter image f with a radially symmetric, zero-phase transfer function.
    H_of_D maps a distance array D (from the centre of the P x Q grid) to H."""
    M, N = f.shape
    P, Q = 2 * M, 2 * N                                  # 1. padding size
    fp = np.zeros((P, Q)); fp[:M, :N] = f                # 2. zero-pad
    y, x = np.mgrid[0:P, 0:Q]
    fp = fp * (-1.0) ** (x + y)                          # 3. centre the transform
    F = np.fft.fft2(fp)                                  # 4. DFT
    D = np.hypot(y - P / 2, x - Q / 2)
    G = H_of_D(D) * F                                    # 5. multiply
    gp = np.real(np.fft.ifft2(G)) * (-1.0) ** (x + y)    # 6. inverse, undo centring
return gp[:M, :N] # 7. crop補零之後再模糊,右側與下側邊緣會出現一條變暗的帶狀區域,因為濾波器把黑色像素也平均進來了。改用鏡像填補(np.pad(f, ..., mode="reflect"))可以避免這個問題,本章的繪圖程式就是這樣做的。
零相位濾波器
本章所有濾波器都是實數,並且對中心對稱。把一個複數乘上一個實數,只會縮放它的大小、不會改變它的角度(頂多正負號),所以這些濾波器只改變每個頻率留下多少,從不改變各個波在哪裡對齊。這類濾波器稱為零相移(zero-phase-shift)濾波器。看過圖 4.3 就知道為什麼必須如此:改變相位會讓邊緣跑掉。
空間濾波器與頻域濾波器的對應
由卷積定理,每個頻域濾波器 都對應一個空間卷積核 ,每個空間卷積核也都有它的轉移函數。高斯是最乾淨的例子。在一維中,
其中 是高斯在頻域中的寬度。頻域中寬的高斯,對應到空間中窄的卷積核,反之亦然。因此,一個常見的實務策略是:在頻域中設計(「讓 40 個循環以下通過」很容易描述),然後實作一個近似 的小型空間卷積核。
什麼時候走頻域比較快?用 的卷積核做空間卷積,每個像素大約要 次乘法;走 FFT 的話,每個像素的成本只隨 增加。小卷積核(3×3、5×5)走空間域划算;寬達數十個像素的卷積核,走 FFT 划算。
用低通頻域濾波器平滑影像
白話版。 低通濾波器保留慢的波、移除快的波,所以影像會變模糊。濾波器從「保留」降到「移除」的方式非常重要:降得太突然,就會產生漣漪。
令 為與 頻率矩形中心的距離,
並令 為截止頻率(cutoff frequency)。
理想低通濾波器(ILPF)
它讓半徑 的圓內所有頻率通過,圓外全部擋掉。選擇 的一個好方法,是看它保留了總功率的多少比例:。
巴特沃斯低通濾波器(BLPF)
其中 是階數(order)。在 時濾波器值恰為 。 小時衰減平緩; 時 BLPF 趨近理想濾波器。
高斯低通濾波器(GLPF)
其中 扮演 的角色。在 時濾波器值為 。
振鈴
圖 4.5 以相同的截止頻率比較三者。理想濾波器產生明顯的振鈴:邊緣的淡淡分身一圈圈向外重複,就像往池塘丟石頭激起的漣漪。原因正是前面提過的方框與 sinc 轉換對。頻域中的陡峭截止,對應到一個中央主瓣、外圍環繞正負交替旁瓣的空間卷積核。邊緣與這種卷積核卷積之後,旁邊就會畫出一串淡淡的明暗回音。
高斯則是另一個極端:它的空間卷積核也是高斯,永遠為正,所以絕不會振鈴。巴特沃斯介於兩者之間:1 階完全沒有振鈴,2 階有幾乎看不見的負旁瓣,階數越高振鈴越明顯。2 階是在陡峭截止與乾淨結果之間常見的折衷。
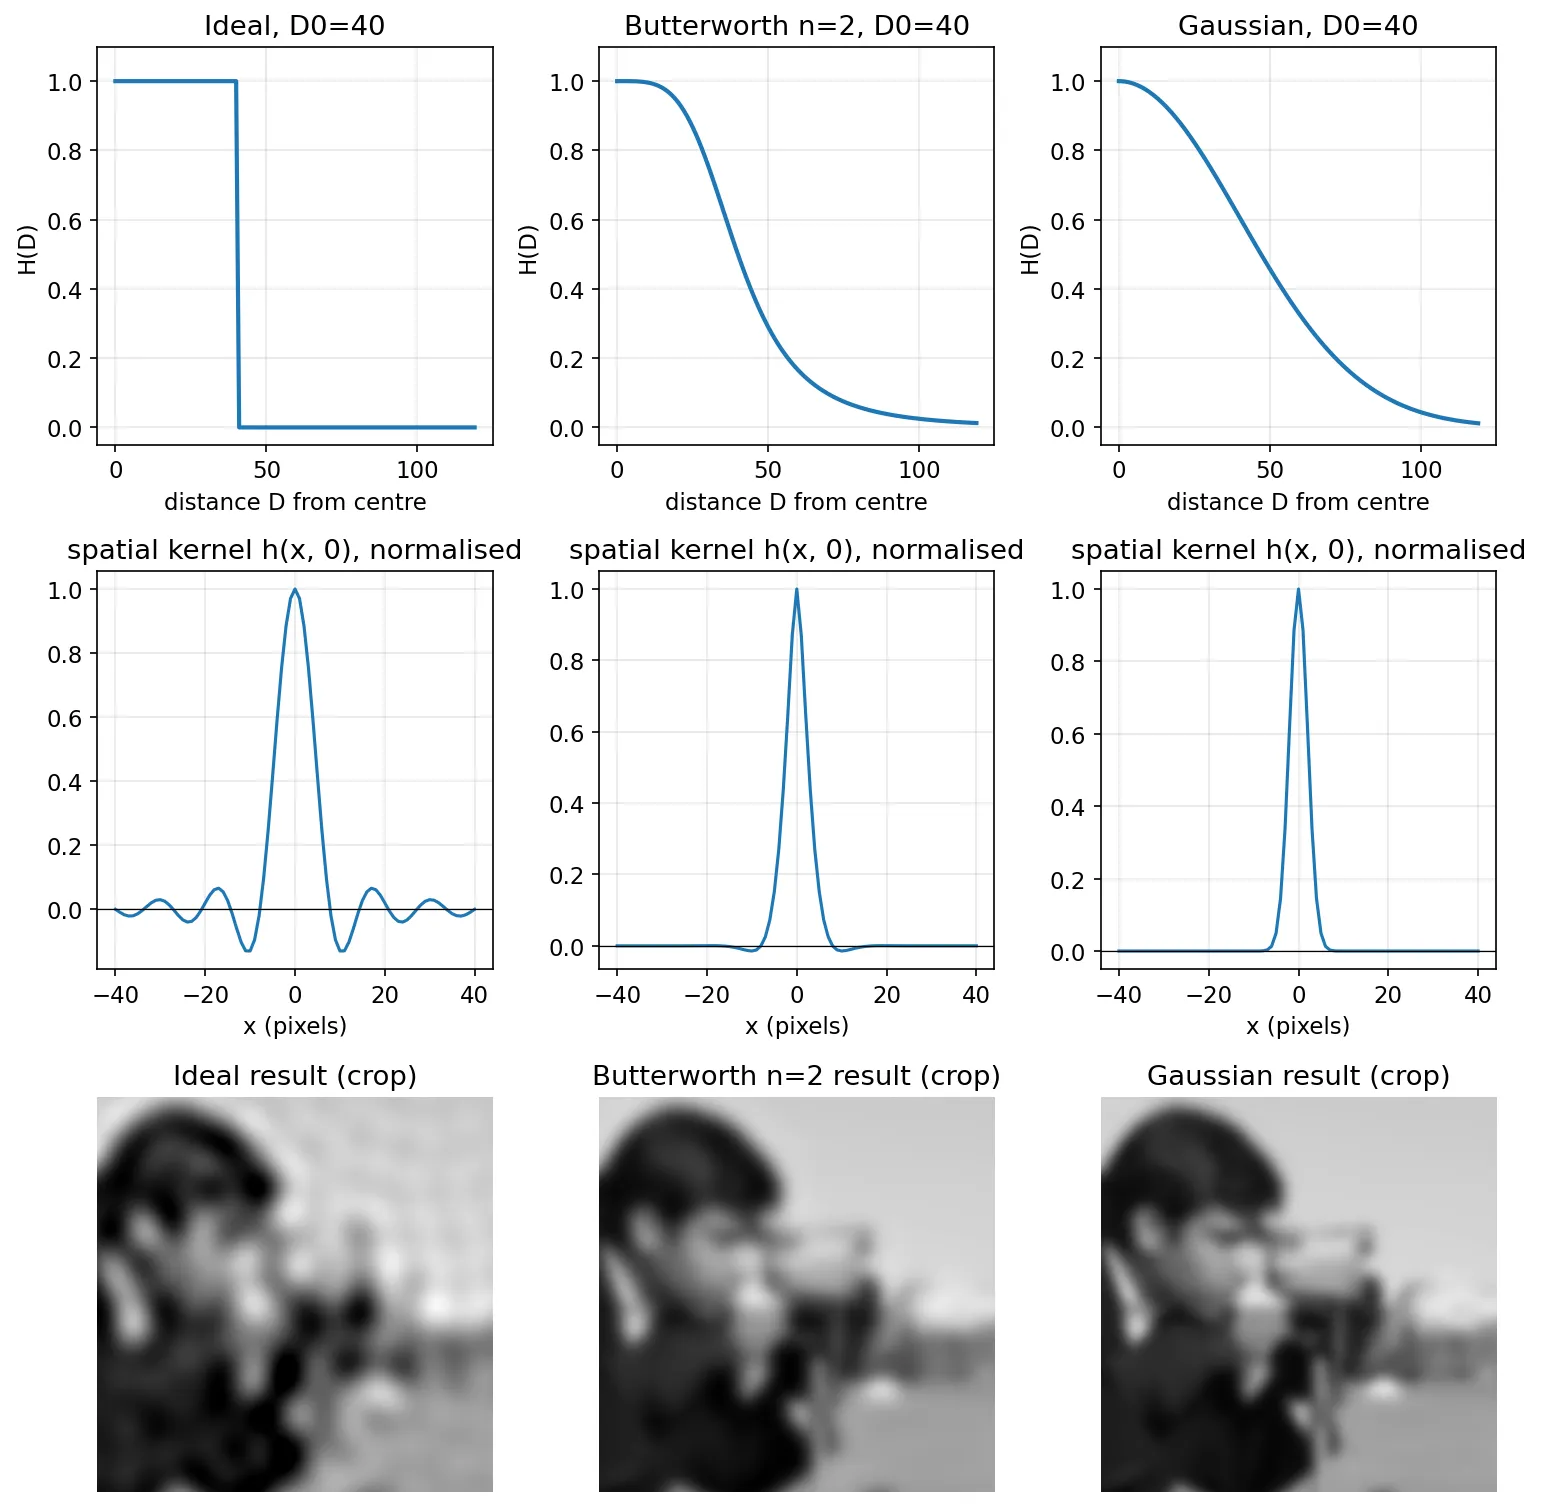
D0 = 40
ideal  = lambda D: (D <= D0).astype(float)
butter = lambda D, n=2: 1 / (1 + (D / D0) ** (2 * n))
gauss  = lambda D: np.exp(-D**2 / (2 * D0**2))
smooth = filter_freq(f, gauss)
低通濾波有很多不起眼但實用的用途:把低解析度掃描中斷掉的字跡筆畫連起來、柔化人像的皮膚紋理,以及壓抑遙測影像中的掃描線紋路。
用高通濾波器銳化影像
白話版。 高通濾波器正好相反:它丟掉慢的波、保留快的波,所以只剩下邊緣與紋理。把其中一部分加回原圖,影像看起來就更清晰。
理想、巴特沃斯與高斯高通濾波器
每個高通濾波器都可以由低通濾波器得到:
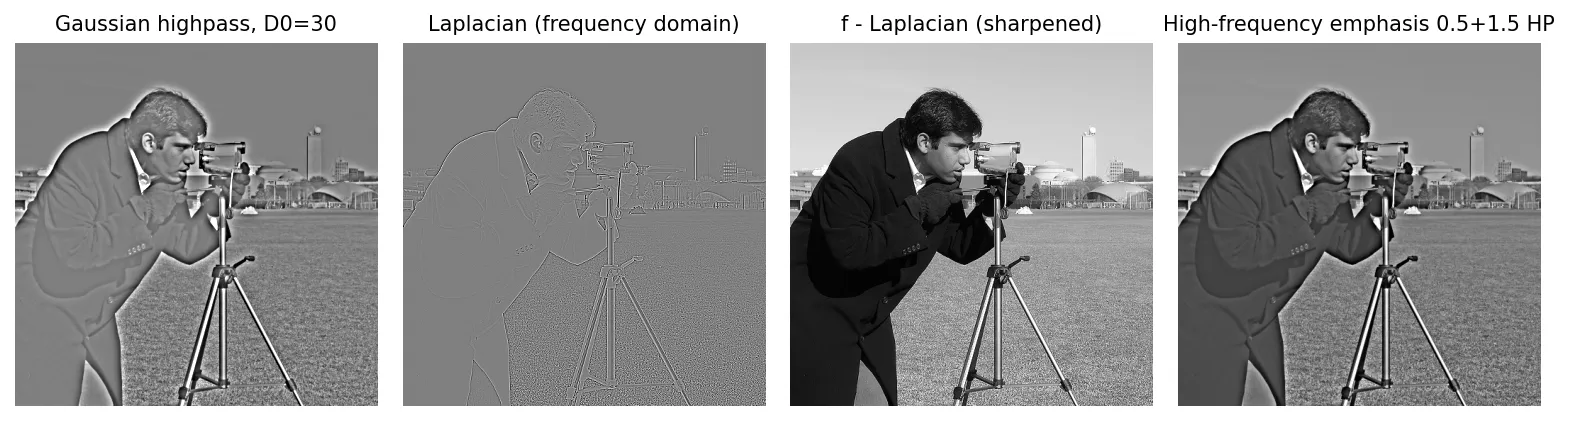
所以高斯高通為 ,巴特沃斯高通為 ,理想高通則是圓內為 0、圓外為 1。振鈴的道理一樣:理想的會振鈴,高斯的不會。由於高通濾波器令 ,輸出的平均值為零,所以平坦區域在顯示縮放後會變成灰色(零)。
頻域中的拉普拉斯運算子
第 3 章的拉普拉斯運算子(Laplacian) 也有轉移函數。微分等於把轉換乘上 ,在兩個方向各微分兩次,得到
此處頻率以「每張影像的循環數」為單位。銳化後的影像為 ;用減號是因為 的中心為負。實務上拉普拉斯的輸出比 大得多,相減前必須先把兩者縮放到可比較的範圍(例如 在 , 除以其最大絕對值)。
反銳化遮罩、高提升與高頻強調
反銳化遮罩(unsharp masking)先減去模糊版本得到細節「遮罩」,再把它加回去:
其中 是低通濾波後的 , 是權重(:反銳化遮罩;:高提升,high-boost)。在頻域中,整個操作只是一個轉移函數 。把它一般化,就得到高頻強調(high-frequency emphasis):
其中 控制低頻(以及 DC 項)留下多少, 控制高頻被放大多少。選 也會降低整體對比,所以高頻強調之後常接著做直方圖等化(histogram equalization)。
同態濾波
一個簡單的成像模型說,每個像素是照度(illumination)(照到場景上的光有多少)與反射率(reflectance)(表面反射多少光)的乘積:。照度在場景中變化緩慢;反射率則在物體邊界處劇烈變化。我們想壓低照度、加強反射率,但乘積的傅立葉轉換並不等於轉換的乘積。
Oppenheim、Schafer 與 Stockham 提出的技巧 [8] 是先取對數,把乘積變成和:
接著用一個對低頻與高頻有不同處理的轉移函數對 濾波,最後取指數:
其中 削弱低頻(照度), 放大高頻(反射率), 控制過渡的陡峭程度, 控制過渡的位置。結果同時壓縮了動態範圍、又增強了對比。
def homomorphic(f, gL=0.4, gH=1.6, c=1.0, D0=30, eps=1e-3):
    z = np.log(f + eps)                       # eps avoids log(0)
    H = lambda D: (gH - gL) * (1 - np.exp(-c * D**2 / D0**2)) + gL
    return np.exp(filter_freq(z, H)) - eps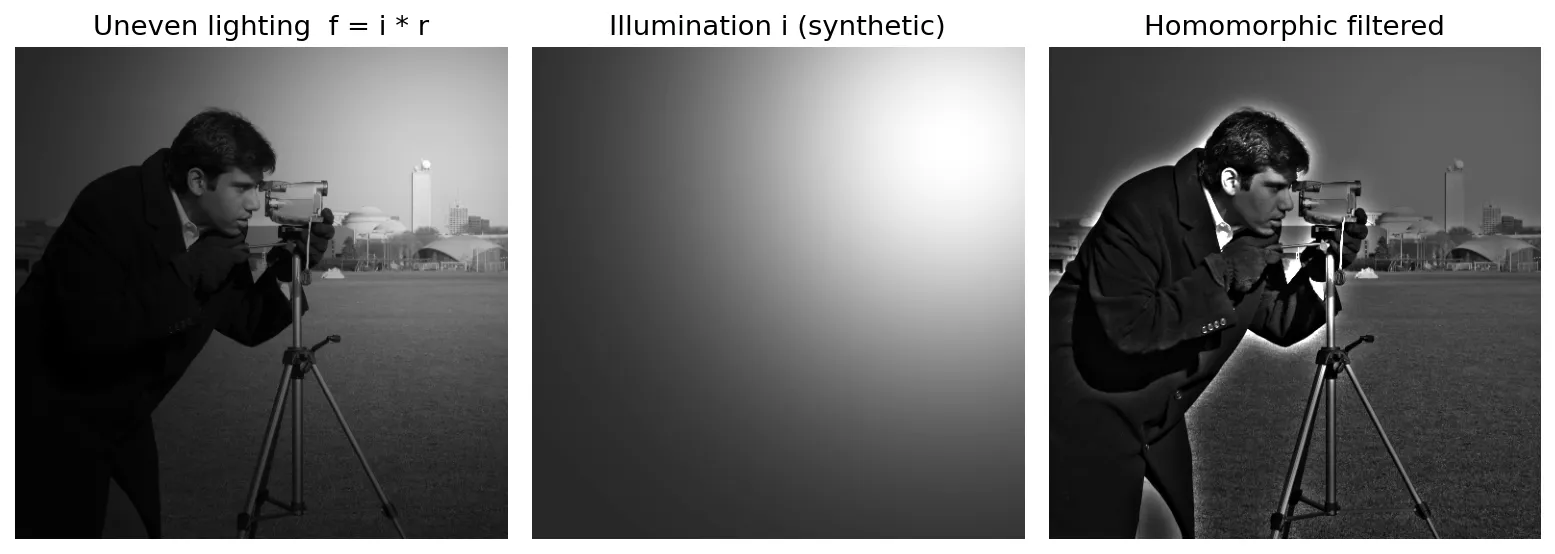
選擇性濾波
白話版。 有時候問題不在於「細節太多」或「太少」,而是某個特定、重複出現的花紋,例如電子干擾造成的條紋。在頻譜中,這種花紋只是幾個亮點。選擇性濾波器只移除那幾個點,其他什麼都不動。
帶拒與帶通濾波器
帶拒(bandreject)濾波器移除以半徑 為中心、寬度為 的一圈頻率。高斯版本為
階巴特沃斯版本為
其中 是環的中心半徑, 是環的寬度。帶通(bandpass)濾波器只保留那一圈:。環狀濾波器適合在所有方向上都出現在固定距離的雜訊,但這在實務中並不常見。
陷波濾波器
陷波濾波器(notch filter)只作用在選定頻率周圍的小鄰域。由於實數影像的頻譜共軛對稱,每個陷波都必須搭配它對中心的鏡像。具有 對陷波的陷波拒斥濾波器,是由多個中心移到亮點位置的高通濾波器相乘而成:
其中 是中心位於 的高通濾波器(理想、巴特沃斯或高斯), 是中心位於 的同一個濾波器,兩者都相對於頻率矩形的中心量測。距離為
陷波通過濾波器為 。套用陷波通過濾波器再反轉換,可以單獨取出干擾花紋本身,用來確認你移除的是雜訊而不是影像內容。
import numpy as np
from skimage import data, img_as_float

f = img_as_float(data.camera())
M, N = f.shape
y, x = np.mgrid[0:M, 0:N]
g = f + 0.2 * np.cos(2 * np.pi * (40 * x / N + 25 * y / M))   # add a ripple

G = np.fft.fftshift(np.fft.fft2(g))
u, v = y - M // 2, x - N // 2               # centred frequency coordinates
H = np.ones((M, N))
for uk, vk in [(25, 40)]:                    # spike location (row, column offset)
    for s in (+1, -1):                       # the conjugate-symmetric partner
        Dk = np.hypot(u - s * uk, v - s * vk)
        H *= 1 - np.exp(-Dk**2 / (2 * 4.0**2))   # Gaussian notch reject
out = np.real(np.fft.ifft2(np.fft.ifftshift(G * H)))
這裡刻意不做填補。干擾在整張影像上是週期性的,填補反而會把它的亮點抹散到許多頻率樣本上,降低陷波的效果。
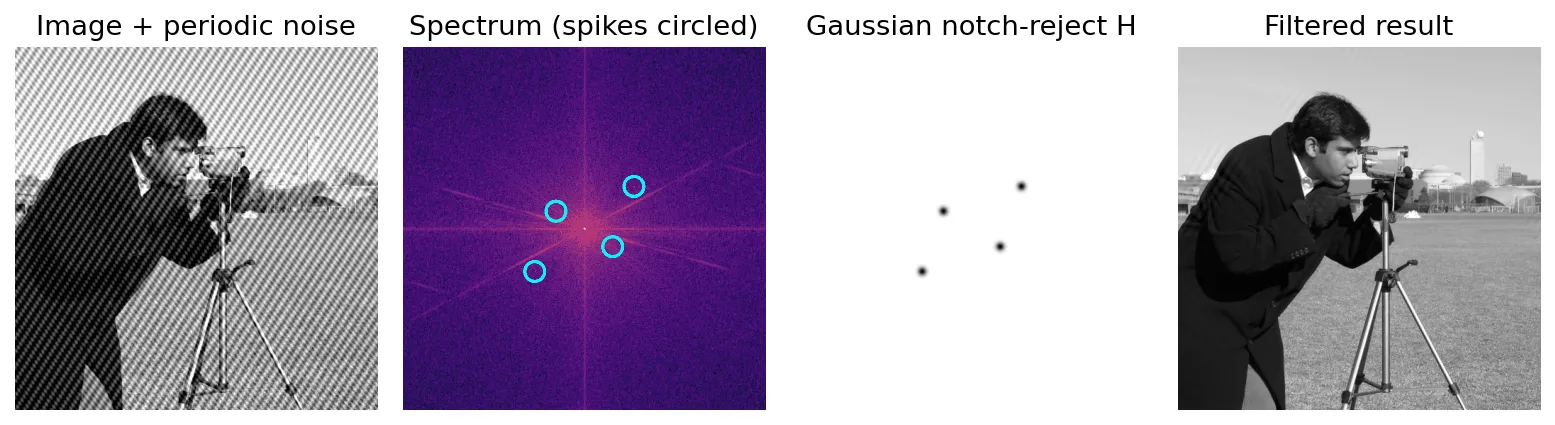
拖動滑桿,直接比較受干擾與濾波後的影像:
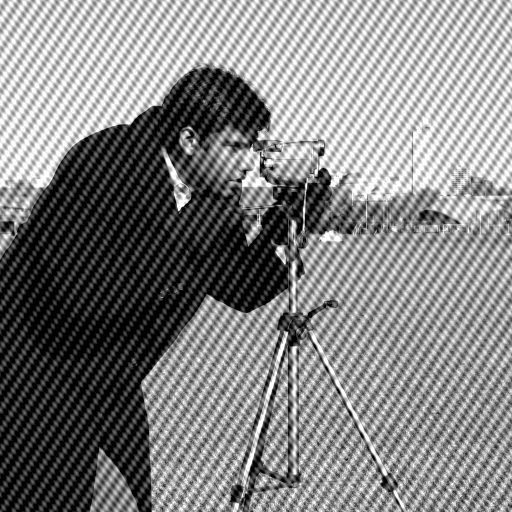
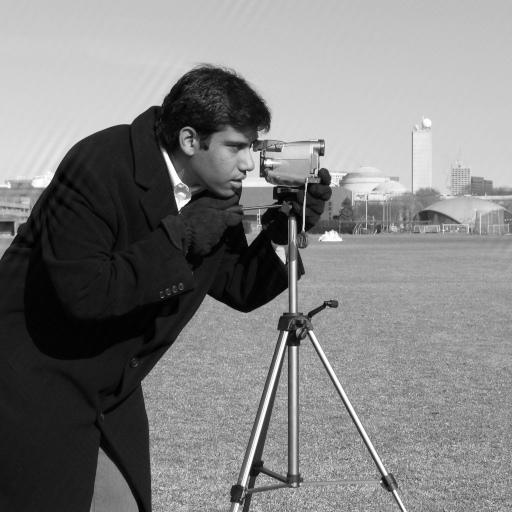 含週期性雜訊陷波濾波後
實作
白話版。 二維 DFT 可以拆成許多一維 DFT 來算;反 DFT 可以用正向轉換的程式來算;而 FFT 演算法讓每一次一維轉換快上非常多。
可分離性
二維的核 可以分解成 ,所以
其中 是第 列的一維 DFT。先對每一列做一維 DFT,再對結果的每一行做一維 DFT。只要有一維的 FFT 函式,就能組出二維的。
用正向轉換計算反 DFT
把反轉換公式取共軛,再乘上 :
右邊正是 的正向 DFT。所以:把 取共軛、做正向轉換、除以 ,再取一次共軛。對實數影像而言,最後那次共軛可以省略。
import numpy as np
F = np.fft.fft2(np.random.default_rng(1).random((8, 8)))
f_back = np.conj(np.fft.fft2(np.conj(F))) / F.size
print(np.allclose(f_back, np.fft.ifft2(F)))   # True
快速傅立葉轉換
照定義計算一維 DFT,大約需要 次複數乘法與加法: 個輸出,每個都是 項的和。Cooley 與 Tukey 的 FFT [4] 在 為 2 的冪次時,把成本降到大約 。核心想法是分而治之:把總和拆成偶數索引與奇數索引兩半,
其中 ,、 是長度 的 DFT。每個半長度的 DFT 再繼續拆,直到長度為 1。總共有 層,每層的成本約為 次運算。
兩者的成本比 成長得很快。 時約為 100;對 的影像,直接做二維轉換(成本 )與用 FFT(成本 )相比,比值約為 50,000。在筆電上就能明顯看出差異:
import time
x = np.random.default_rng(2).standard_normal(4096)
t0 = time.perf_counter(); dft(x); t1 = time.perf_counter(); np.fft.fft(x); t2 = time.perf_counter()
print(f"direct {t1 - t0:.3f}s  fft {t2 - t1:.5f}s")   # e.g. ~0.7 s vs ~0.2 ms
現代函式庫遠遠超越教科書上的基數 2(radix-2)演算法。Frigo 與 Johnson 介紹的 FFTW [6] 能處理任意長度,在執行時實際量測哪個演算法在這台機器上最快再做選擇,並自動產生小型的「codelet」核心程式。實務上,質因數都很小(2、3、5、7)的長度很快,大質數則較慢。scipy.fft.next_fast_len 會傳回一個合適的填補大小。
現代觀點
傅立葉轉換比本系列中任何其他工具都古老,卻老得特別好。深度學習並沒有取代它;相反地,傅立葉的想法以三種角色回歸:作為計算卷積的方法、作為建構具有全域視野之網路層的方法,以及作為理解網路學到什麼、在哪裡失敗的透鏡。
值得一讀的綜述與回顧
- Unser,〈Sampling — 50 years after Shannon〉[3]。 回顧取樣理論從 Shannon 的帶限模型,一路發展到現代的樣條與平移不變空間(shift-invariant space)表述。重點:理想的 sinc 內插只是數學上的理想化;實際系統使用緊湊的核心搭配相應的前置濾波器,而其近似誤差可以在傅立葉域中精確分析。這是從本章的取樣定理通往實際重取樣程式碼的最佳橋樑。
- Heideman、Johnson 與 Burrus,〈Gauss and the history of the fast Fourier transform〉[5]。 一篇歷史回顧,把類 FFT 演算法追溯到高斯約 1805 年未發表的手稿,以及 1965 年前的多次重新發現。重點:這個演算法的想法很簡單,被發現過很多次;1965 年真正改變的是數位電腦讓它變得重要。
- Xu、Zhang 與 Luo,〈Overview frequency principle/spectral bias in deep learning〉[13]。 一篇關於頻率原則(frequency principle)的綜述:以梯度下降訓練的神經網路,傾向先擬合目標的低頻成分、之後才擬合高頻成分。文中整理了這個現象背後的理論與實驗,以及它在演算法設計上的應用。重點:神經網路在訓練過程中有點像一個慢慢打開的低通濾波器。
- Kovachki 等人,〈Neural Operator: Learning Maps Between Function Spaces〉[15]。 一篇完整而深入的神經算子(neural operator)專論。神經算子學習的是函數之間的映射,而不是固定大小陣列之間的映射,傅立葉神經算子是其四種主要參數化方式之一。重點:用頻率響應來參數化一層網路,可以讓它在很大程度上不受網格解析度影響,這正是本章「濾波 = 在頻域中相乘」想法的直系後代。
傅立葉轉換作為快速卷積引擎
卷積定理保證大型卷積可以變成便宜的乘法。Mathieu、Henaff 與 LeCun [9] 把這一點用在卷積神經網路上:他們在 GPU 上把卷積算成 FFT 之間的逐點乘積,並重複使用每個轉換過的特徵圖,回報了大幅的訓練加速。如今多數 CNN 使用 3×3 的小卷積核,此時直接做空間卷積通常較快,所以 FFT 卷積主要用於大型卷積核。前面「空間濾波器與頻域濾波器的對應」一節的推論在這裡完全適用。
具有全域感受野的傅立葉層
頻域中的逐點乘積會影響每一個像素,所以單一個傅立葉層就擁有整張影像的感受野(receptive field)。好幾種架構利用了這一點。Fast Fourier Convolution [10] 加入一個全域分支,直接在影像層級的頻譜上運算,把全域資訊混入每一層。Global Filter Networks [11] 把視覺 Transformer 的自注意力換成正是本章的步驟:二維 FFT、與一個可學習的全域濾波器逐元素相乘、再做反 FFT,成本對 token 數量為對數線性。Fourier Neural Operator [14] 在截斷後的一組低頻上使用可學習的濾波器來解偏微分方程;由於權重存在於頻率空間中,訓練好的模型可以在比訓練時更細的網格上使用。這些名副其實就是可學習的頻域濾波器。
另一條相關的路線直接在轉換係數上運作。Xu 等人 [16] 把常見有損影像編碼已經算好的區塊離散餘弦轉換(DCT)係數直接餵給網路,並學習要保留哪些頻率通道。他們發現許多高頻通道可以丟掉而幾乎不損失準確率,這與頻率原則一致。
頻譜偏差
Rahaman 等人 [12] 證明深度 ReLU 網路偏好學習低頻函數:高頻成分學得較晚,也較不穩健。搭配 [13] 的綜述,可以得到一個實用的心智模型:網路很擅長目標函數的「貝斯」,但要把「鈸」學好,就需要更多訓練、更多資料或特殊的輸入編碼。這也解釋了為什麼以座標為輸入的網路,除非先把輸入座標映射成正弦形式的傅立葉特徵(Fourier features),否則常常難以表現細緻的紋理 [20]。
混疊在深度網路中捲土重來
步幅卷積與池化都是降取樣,而沒有低通前置濾波的降取樣就會混疊,跟圖 4.1 一模一樣。Zhang [17] 指出,標準 CNN 對一個像素的平移出乎意料地敏感,原因正在於此;而在每次降取樣前插入一個小模糊(也就是教科書裡的抗混疊濾波器),可以改善平移不變性,在他的實驗中也提升了影像分類準確率。Karras 等人 [18] 追查到一個現象:生成影像的細節似乎黏在像素座標上,而不是隨著畫面中的表面移動,其根源是生成器內部的混疊。他們的無混疊(alias-free)設計把特徵圖當作連續訊號的取樣,並在每個非線性運算與重取樣步驟周圍套用精心設計的低通濾波器。
頻率假影就像指紋
生成器需要上取樣,而沒有適當內插濾波器的上取樣,會在頻譜中留下週期性的花紋,很像圖 4.8 中的亮點。Frank 等人 [19] 發現,GAN 生成的影像在頻域中有強烈且一致的假影,並追溯到上取樣操作,據此建立了簡單又準確的偵測器。更廣泛的啟示是:觀察頻譜這個本章最古老的診斷工具,至今仍是看出生成模型哪裡出錯的最快方法之一。
沒有改變的部分
對於已經很清楚的問題,深度學習並沒有取代傳統的頻域濾波。移除已知的週期性干擾、縮放前的抗混疊、快速的大卷積核模糊,以及同態照明校正,至今仍然用本章這些明確的濾波器來做,因為它們精確、快速、而且不需要訓練資料。改變的是,這些同樣的想法如今被內建到網路架構中,也被用來解釋網路的行為。
重點整理
- 傅立葉轉換把訊號改寫成波的總和。低頻承載平滑結構;高頻承載邊緣、紋理與雜訊。
- 取樣會把頻譜週期性地複製。取樣頻率要超過最高頻率的兩倍(奈奎斯特取樣率),或先模糊,否則會出現無法復原的混疊與摩爾紋。
- DFT 把影像當成週期性的,因此得到循環卷積;要填補到至少 (通常是 )以避免環繞誤差。
- 平移只改變相位;旋轉使頻譜旋轉;實數影像的頻譜共軛對稱;而大部分可辨識的結構存在相位中。
- 濾波就是「轉換、乘上實數對稱的 、反轉換、裁切」。陡峭截止會振鈴;高斯不會;巴特沃斯介於兩者之間。
- 高通、拉普拉斯、高頻強調與同態濾波器用來銳化或平衡照明;陷波濾波器能精準移除週期性干擾。
- FFT 把每次一維轉換的成本從 降到 ,可分離性則讓二維轉換由一維轉換組成。
- 在深度學習中,傅立葉的想法支撐了快速卷積、全域濾波層與神經算子,也解釋了頻譜偏差、CNN 中的混疊與 GAN 的假影。
練習
- 一個一維訊號含有每公尺 3、7、12 個循環的成分。你每 0.1 公尺取樣一次。哪些成分能正確保留?每個混疊成分會出現在什麼頻率?
提示
取樣率是每公尺 10 個樣本,所以奈奎斯特上限是每公尺 5 個循環。3 個循環的成分沒問題。其他成分要減去 10 的倍數,摺回 :7 會變成 ,也就是每公尺 3 個循環;12 會變成 個循環。這時 7 個循環的成分和真正 3 個循環的成分已無法區分。
- 證明:若 是實數且對稱,即 (索引對 、 取餘數),則它的 DFT 是實數。用 NumPy 建一個對稱陣列加以驗證。
提示
對任何實數 ,共軛對稱給出 。在定義中代入 、,由 的對稱性得到 。兩者合起來 ,所以 是實數。驗證時,對隨機陣列 a 建立 g = a + np.roll(a[::-1, ::-1], 1, axis=(0, 1)),確認 np.abs(np.fft.fft2(g).imag).max() 趨近於零。
- 使用
filter_freq函式,以 、階數 1、2、5、20 的巴特沃斯低通濾波器處理攝影師影像。從第幾階開始能明顯看到振鈴?畫出每個濾波器空間卷積核的中央列,並與你看到的現象對照。
提示
把中心化的濾波器做反轉換,再移回中央,就得到卷積核。當卷積核出現明顯的負旁瓣時就會振鈴。1 階完全沒有,2 階只有很小的旁瓣,到了 5 至 20 階,旁瓣已接近理想濾波器。
- 你要用 FFT 以 51 × 51 的空間卷積核濾波一張 300 × 400 的影像。避免環繞誤差的最小填補大小是多少?你會選這個大小,還是稍大一點的?為什麼?
提示
最小值是 。兩者都可以,但只含小質因數的長度在 FFT 函式庫中較快。、 本身就已符合,所以是好選擇;scipy.fft.next_fast_len 可以確認這一點。
- 拍攝(或合成)一張含有兩種不同週期干擾的影像。設計一個只移除其中一種的陷波拒斥濾波器,再用對應的陷波通過濾波器顯示被你移除的花紋。陷波的半徑該怎麼選?
提示
在對數頻譜中找出亮點,忽略 DC 峰值與座標軸上的線條,並記得每個亮點都有鏡像雙胞胎。半徑剛好能蓋住亮點擴散範圍時效果最好:太小會留下殘餘條紋,太大會移除那些頻率附近的影像內容。陷波通過的輸出應該是乾淨的條紋,看不到任何場景。
- 運用本章的觀念解釋:為什麼在每個步幅為 2 的層之前插入模糊,可以讓 CNN 在輸入影像平移一個像素時輸出更穩定?
提示
步幅 2 的降取樣讓取樣率減半,高於新奈奎斯特上限的頻率會以混疊的形式摺回來。平移一個像素會改變這些成分的相位,經過混疊後就改變了低頻輸出,於是後面的層看到不同的訊號。先用低通濾波器移除這些頻率,平移對輸出的影響就小得多。參見 [17]。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 4. publisher page
- C. E. Shannon, “Communication in the presence of noise,” Proceedings of the IRE, vol. 37, no. 1, pp. 10–21, 1949. doi
- M. Unser, “Sampling—50 years after Shannon,” Proceedings of the IEEE, vol. 88, no. 4, pp. 569–587, 2000. doi
- J. W. Cooley and J. W. Tukey, “An algorithm for the machine calculation of complex Fourier series,” Mathematics of Computation, vol. 19, no. 90, 1965. doi
- M. T. Heideman, D. H. Johnson and C. S. Burrus, “Gauss and the history of the fast Fourier transform,” IEEE ASSP Magazine, vol. 1, no. 4, pp. 14–21, 1984. doi
- M. Frigo and S. G. Johnson, “The design and implementation of FFTW3,” Proceedings of the IEEE, vol. 93, no. 2, 2005. doi
- A. V. Oppenheim and J. S. Lim, “The importance of phase in signals,” Proceedings of the IEEE, vol. 69, no. 5, 1981. doi
- A. V. Oppenheim, R. W. Schafer and T. G. Stockham, “Nonlinear filtering of multiplied and convolved signals,” Proceedings of the IEEE, vol. 56, no. 8, pp. 1264–1291, 1968. doi
- M. Mathieu, M. Henaff and Y. LeCun, “Fast training of convolutional networks through FFTs,” arXiv:1312.5851, 2013. arXiv
- L. Chi, B. Jiang and Y. Mu, “Fast Fourier convolution,” Advances in Neural Information Processing Systems (NeurIPS), vol. 33, 2020. proceedings
- Y. Rao, W. Zhao, Z. Zhu, J. Lu and J. Zhou, “Global filter networks for image classification,” NeurIPS, 2021. arXiv
- N. Rahaman, A. Baratin, D. Arpit, F. Draxler, M. Lin, F. A. Hamprecht, Y. Bengio and A. Courville, “On the spectral bias of neural networks,” ICML, 2019. arXiv
- Z.-Q. J. Xu, Y. Zhang and T. Luo, “Overview frequency principle/spectral bias in deep learning,” arXiv:2201.07395, 2022. arXiv
- Z. Li, N. Kovachki, K. Azizzadenesheli, B. Liu, K. Bhattacharya, A. Stuart and A. Anandkumar, “Fourier neural operator for parametric partial differential equations,” arXiv:2010.08895, 2020. arXiv
- N. Kovachki, Z. Li, B. Liu, K. Azizzadenesheli, K. Bhattacharya, A. Stuart and A. Anandkumar, “Neural operator: Learning maps between function spaces,” Journal of Machine Learning Research, vol. 24, 2023. arXiv
- K. Xu, M. Qin, F. Sun, Y. Wang, Y.-K. Chen and F. Ren, “Learning in the frequency domain,” CVPR, 2020. arXiv
- R. Zhang, “Making convolutional networks shift-invariant again,” ICML, 2019. arXiv
- T. Karras, M. Aittala, S. Laine, E. Härkönen, J. Hellsten, J. Lehtinen and T. Aila, “Alias-free generative adversarial networks,” arXiv:2106.12423, 2021. arXiv
- J. Frank, T. Eisenhofer, L. Schönherr, A. Fischer, D. Kolossa and T. Holz, “Leveraging frequency analysis for deep fake image recognition,” ICML, 2020. arXiv
- M. Tancik, P. P. Srinivasan, B. Mildenhall, S. Fridovich-Keil, N. Raghavan, U. Singhal, R. Ramamoorthi, J. T. Barron and R. Ng, “Fourier features let networks learn high frequency functions in low dimensional domains,” arXiv:2006.10739, 2020. arXiv