第 8 章・影像壓縮與浮水印
先備知識: 第 7 章・小波與其他影像轉換
你將學到
- 壓縮要去除的三種冗餘,以及熵(entropy)如何替無失真編碼設下下限
- 經典無失真編碼器的原理:霍夫曼、Golomb、算術、LZW、游程、符號式與位元平面編碼
- JPEG 如何把影像切成 8×8 的 DCT 區塊並量化,以及低品質時為什麼會出現方塊
- 預測編碼(DPCM、運動補償)與小波編碼(JPEG 2000)如何利用相鄰像素
- 如何把浮水印藏在最低有效位元或 DCT 係數中,以及為什麼一個撐得過 JPEG、另一個撐不過
- 學習式(神經網路)編解碼器與深度學習浮水印在今天的位置
先看全貌
一張未壓縮的 512×512 彩色照片是 786,432 位元組。同一張照片存成 JPEG 可能只有幾十 KB,看起來卻沒什麼差別。壓縮就是找出哪些位元可以預測、哪些細節看不出來,然後不去儲存它們。
我們每天看到的影像幾乎都經過壓縮,許多電腦視覺資料集也以 JPEG 儲存,所以模型其實是在帶有壓縮瑕疵的影像上訓練的。浮水印則關係到著作權,也越來越常用來標記生成式模型產生的影像。本章依照教科書 [1] 的順序:先談基礎,再介紹一整套編碼方法,最後談浮水印。
基礎概念
白話版:影像檔裡的位元數通常比它真正承載的資訊多。壓縮就是去掉多餘的位元,而「資訊量」的度量告訴我們最多能壓到哪裡。
壓縮比與冗餘
若一張影像未壓縮時佔 位元,壓縮後佔 位元,則壓縮比與相對資料冗餘為
是無因次的數字(10 代表「十比一」), 是原始資料中屬於冗餘的比例。 時 :九成的位元沒有帶來新資訊。
影像中有三種冗餘:
- 編碼冗餘(coding redundancy):固定 8 位元的碼對每個灰階都花 8 位元,不論常見或罕見。變長碼可以少浪費一些位元。
- 空間與時間冗餘(spatial and temporal redundancy):相鄰像素、相鄰的視訊畫格高度相關,把每個像素獨立編碼就是在重複資訊。
- 不相關資訊(irrelevant information):觀看者察覺不到的細節。去掉它是不可逆的(失真壓縮,lossy);只去掉前兩種則是無失真壓縮(lossless)。
度量資訊:熵
機率為 的符號帶有 位元的資訊:越罕見的事件越令人意外,資訊越多。對整個符號集合取平均就得到熵
其中 是所有可能的符號(8 位元影像就是 256 個灰階), 是它們的機率。無雜訊信源編碼定理指出:當符號被逐一、獨立編碼時,沒有任何無失真碼的平均長度能低於 位元/符號;好的碼可以逼近 。
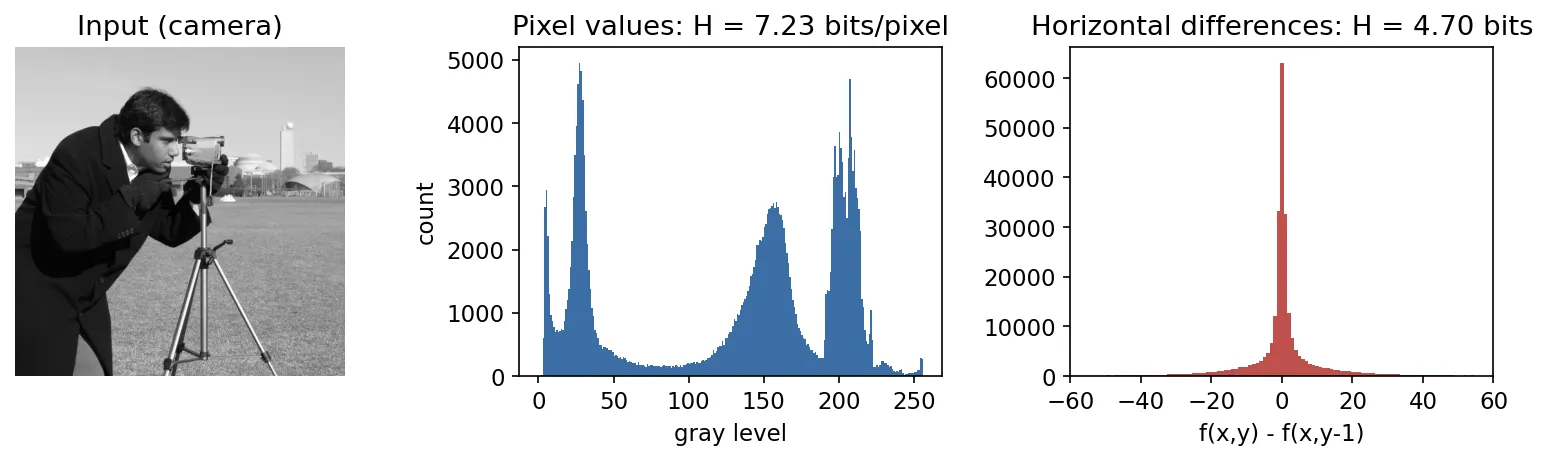
對真實影像我們只能估計。一階估計使用正規化直方圖 ,其中 是 影像中灰階為 的像素數。圖 8.1 說明這個估計取決於你把什麼當成「符號」。camera 影像的一階熵是 7.23 位元/像素,幾乎等於 8;如果改為編碼每個像素與左鄰像素的差值,熵降到 4.70 位元。差值並沒有比較聰明,它只是去掉了直方圖看不到的空間冗餘。這正是本章後面預測編碼的核心想法。
import numpy as np
from skimage import data

def entropy(x):
    _, counts = np.unique(x, return_counts=True)
    p = counts / counts.sum()
    return -(p * np.log2(p)).sum()

img = data.camera()
print(f"H(pixels) = {entropy(img):.2f} bits")                          # 7.23
print(f"H(diffs)  = {entropy(np.diff(img.astype(int), axis=1)):.2f} bits")  # 4.70
保真度準則
有失真時,我們需要衡量損害。設 為原始影像、 為解壓縮後的 影像。均方根誤差與峰值訊噪比為
其中 是像素可能的最大值(8 位元影像為 255)。PSNR 越高,誤差越小;粗略來說,40 dB 左右的差異很難看出,低於 25 dB 則很明顯,但仍取決於影像內容。
這些客觀準則容易計算,卻不一定與人眼一致。主觀準則請觀察者以量表(從「極佳」到「無法使用」)評分,或兩兩比較。
影像壓縮模型
本章幾乎所有編解碼器都符合同一張方塊圖。編碼器有三個階段:
- 映射器(mapper):把影像轉成冗餘較少的形式(差值、轉換係數、游程長度);
- 量化器(quantizer):依保真度目標丟棄精度(唯一有失真的階段,無失真編解碼器沒有這一步);
- 符號編碼器(symbol coder):給常見符號較短的碼(霍夫曼、算術、Golomb……)。
解碼器由符號解碼器與反映射器組成。失去的精度不存在「反量化」可以找回。
格式、容器與標準
檔案格式決定位元如何排列;容器把編碼後的影像與中繼資料包在一起(可裝不同的編解碼器);壓縮標準則定義編碼方法本身。常見的有:
| 名稱 | 類型 | 核心方法 | 無失真? |
|---|---|---|---|
| JPEG(ISO/IEC 10918-1、ITU-T T.81)[2] | 標準+格式 | 8×8 DCT、量化、霍夫曼或算術編碼 | 有失真(baseline) |
| JPEG 2000(ISO/IEC 15444)[3] | 標準+格式 | 離散小波轉換、位元平面算術編碼 | 兩者皆可 |
| PNG [4] | 格式 | 逐列預測濾波器+deflate(LZ77 衍生) | 無失真 |
| JPEG-LS [10] | 標準 | 依情境的預測+Golomb 類碼 | 無失真/近無失真 |
| JPEG XL(ISO/IEC 18181)[5] | 標準+格式 | 有失真與無失真模式;可無損轉存 JPEG 檔 | 兩者皆可 |
| HEIF(ISO/IEC 23008-12)[7] | 容器 | 可裝 HEVC 編碼影像(.heic)等 | 視編解碼器而定 |
| AVIF [6] | 基於 HEIF 的格式 | 把 AV1 畫格內編碼存進 HEIF | 兩者皆可 |
霍夫曼編碼
白話版:最常見的符號給最短的碼,而且任何一個碼都不是另一個碼的開頭,這樣位元流不需要分隔符號也能讀。
霍夫曼演算法(Huffman coding)[8] 在已知符號機率、且逐一編碼的條件下,建出最佳的前綴碼(prefix code)。它由下往上建構:
- 列出所有符號與機率。
- 把機率最小的兩項合併成新節點,機率為兩者之和。
- 重複直到只剩一個節點(機率 1)。
- 從根走到每個葉節點,一邊寫 0、另一邊寫 1,路徑就是碼字。
實作範例
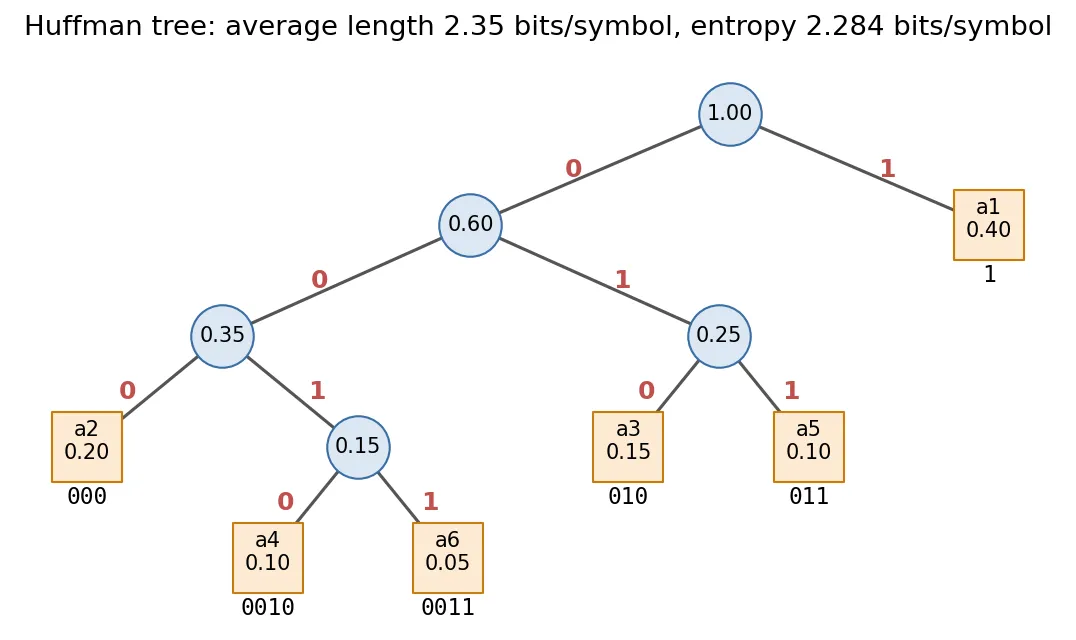
考慮六個符號:、、、、、。合併順序如下:
| 步驟 | 合併 | 新節點 |
|---|---|---|
| 1 | (0.05)+ (0.10) | 0.15 |
| 2 | (0.10)+ (0.15) | 0.25 |
| 3 | (0.20)+ 節點 0.15 | 0.35 |
| 4 | 節點 0.25 + 節點 0.35 | 0.60 |
| 5 | (0.40)+ 節點 0.60 | 1.00 |
從圖 8.2 的樹可得 1、 000、 010、 0010、 011、 0011。平均碼長為
其中 是 的碼長。固定長度碼需要 3 位元,熵則是 位元,所以霍夫曼碼離下限不到 3%。機率相同時的平手可以任意處理;不同的選擇會改變碼字,但不會改變平均長度。
解碼就是沿著樹往下走:讀位元直到碰到葉節點,輸出符號,再回到根。因為沒有碼字是另一碼字的前綴,這種碼是即時可解且唯一可解的。JPEG 用霍夫曼表來編碼量化後的係數 [2]。
import heapq, itertools

def huffman_codes(probs):
    tick = itertools.count()                       # tie-breaker for equal probabilities
    heap = [(p, next(tick), {s: ""}) for s, p in probs.items()]
    heapq.heapify(heap)
    while len(heap) > 1:
        p1, _, c1 = heapq.heappop(heap)            # least probable
        p2, _, c2 = heapq.heappop(heap)            # second least
        merged = {s: "1" + c for s, c in c1.items()}
        merged |= {s: "0" + c for s, c in c2.items()}
        heapq.heappush(heap, (p1 + p2, next(tick), merged))
    return heap[0][2]

P = {"a1": .40, "a2": .20, "a3": .15, "a4": .10, "a5": .10, "a6": .05}
print(huffman_codes(P))   # a1:'1', a2:'000', a3:'010', a4:'0010', a5:'011', a6:'0011'
它的限制是:每個符號至少花 1 個完整位元。若某符號機率是 0.95,它只帶 0.07 位元的資訊,霍夫曼碼卻仍要花 1 位元。下面的算術編碼可以突破這個限制。
Golomb 編碼
白話版:當小數字很常見、大數字很少見時,把數字寫成「有幾整組 」(用畫記表示)再加「剩下多少」(用一般二進位表示)。
Golomb 碼 [9] 是為近似幾何分布的非負整數 設計的,而預測殘差經過映射後正是這種分布。給定參數 ,碼 由兩段串接而成:
- 商 的一元碼: 個 1 後接一個 0;
- 餘數 的截斷二進位碼:令 、, 時用 位元,其餘則把 寫成 位元。
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 000 | 001 | 010 | 011 | 1000 | 1001 | 1010 | 1011 | 11000 | |
| 00 | 010 | 011 | 100 | 1010 | 1011 | 1100 | 11010 | 11011 |
當 是 2 的冪次時,餘數就是 的最低 個位元,編碼只需要位移與遮罩。預測殘差 有正負號,所以要先映射成非負整數,例如 時 、 時 ,得到 交錯排列。JPEG-LS [10] 結合這種映射,以及參數為 2 的冪次、並依局部情境調整的 Golomb 碼。
import numpy as np

def golomb(n, m):
    q, r = divmod(n, m)
    unary = "1" * q + "0"
    k = int(np.ceil(np.log2(m)))
    c = 2**k - m                        # how many remainders get k-1 bits
    if r < c:
        tail = format(r, f"0{k-1}b") if k > 1 else ""
    else:
        tail = format(r + c, f"0{k}b")
    return unary + tail

print([golomb(n, 3) for n in range(9)])
算術編碼
白話版:不替每個符號各自配碼,而是把整段訊息描述成 0 到 1 之間一個非常精確的數字。
算術編碼(arithmetic coding)[11] 從區間 開始。每讀一個符號,就把目前的區間依該符號的機率縮小到它所屬的子區間。訊息結束後,最終區間中的任何一個數都能代表這段訊息。若目前區間是 ,下一個符號 擁有累積範圍 ,則
最終寬度等於各符號機率的乘積,所需位元數約為 ,正好是訊息的資訊量,沒有「每個符號至少 1 位元」的下限。
實作範例
令 、、,於是 擁有 、 擁有 、 擁有 。編碼訊息 abac:
| 讀入 | 區間 |
|---|---|
a | |
b | |
a | |
c |
寬度為 ,即 位元的資訊。7 位元的二進位小數 落在區間內,所以 7 個位元就能識別這段訊息(另外需要標示結尾,例如長度或結束符號)。
實際的編碼器使用整數運算並不斷重新正規化,避免區間下溢;也通常使用自適應機率模型,邊編碼邊更新,因此不必傳送機率表。JPEG 2000 的係數編碼器最後接的是自適應二元算術編碼器 [14],「現代觀點」中的學習式編解碼器最後也是用算術編碼。
LZW 編碼
白話版:一邊讀一邊建立詞組字典;詞組再次出現時,只傳它在字典裡的編號。
Lempel–Ziv–Welch(LZW)演算法 [12] 一開始的字典只含所有單一符號(8 位元像素就是 0–255)。它持續延長目前詞組 ,只要「 加上下一個符號」仍在字典中。一旦不在,就輸出 的碼,把延長後的詞組加為新項目(256、257……),再從新符號重新開始。解碼器能從收到的碼重建同一本字典,因此字典不需要傳送。
對一列重複四次 39 39 126 126 的 16 個像素,輸出是十個碼:
def lzw_encode(seq):
    table = {(v,): v for v in range(256)}
    w, out = (), []
    for x in seq:
        wx = w + (x,)
        if wx in table:
            w = wx
        else:
            out.append(table[w])
            table[wx] = len(table)
            w = (x,)
    if w:
        out.append(table[w])
    return out

row = [39, 39, 126, 126] * 4
print(lzw_encode(row))   # [39, 39, 126, 126, 256, 258, 260, 259, 257, 126]
從 256 起的碼依序代表 39 39、39 126、126 126、126 39、39 39 126……重複越長,詞組越長,壓縮比越好。LZW 不需要事先知道機率,因此在通用檔案格式中很受歡迎。PNG 使用的是相關的 LZ77 系 deflate 方法 [4]。
游程編碼
白話版:「0000 11 00000 1」變成「四個 0、兩個 1、五個 0、一個 1」。
游程編碼(run-length encoding, RLE)把每一段相同值的連續序列換成(值, 長度)。二值影像只要約定第一段的顏色,就只需要記長度。游程長度本身再用變長碼編碼,因為短游程比長游程常見。
import numpy as np

def rle(row):
    starts = np.r_[0, np.flatnonzero(np.diff(row)) + 1]
    lengths = np.diff(np.r_[starts, len(row)])
    return list(zip(row[starts].tolist(), lengths.tolist()))

print(rle(np.array([0, 0, 0, 0, 1, 1, 0, 0, 0, 0, 0, 1])))  # [(0, 4), (1, 2), (0, 5), (1, 1)]
RLE 對文件、線條圖和位元平面很有效,對游程很短的雜訊照片則效果不佳。二維版本會以上一列的顏色轉換位置為參考,編碼目前這列的轉換位置,因此也利用了垂直方向的相關性。JPEG 對量化後大量為零的係數也採用一種游程編碼 [13]。
符號式編碼
白話版:一頁掃描文件大多是同樣幾個字母一再出現。每種字形只存一次,然後只要說「第 7 號字母放在這裡」。
在符號式(symbol-based,或稱 token-based)編碼中,經常出現的子影像稱為符號,只在符號字典中存一次。影像變成一串三元組 :每次出現的位置,以及它在字典中的編號 。一頁有上千個字元、卻只有約一百種字形的文字,壓縮效果非常好,因為每次出現只花兩個座標和一個編號,這些再以熵編碼處理。
如果允許出現的圖樣與字典項目只是「相似」就算匹配,方法就變成有失真。這能提高壓縮比,但粗心的匹配器可能換錯字元,例如在低解析度掃描中把兩個長得像的數字互換。穩健的系統會把匹配門檻設得保守,或另外編碼圖樣與字典項目之間的殘差,以維持無失真。
位元平面編碼
白話版:把 8 位元影像拆成八張黑白影像,每個位元一張,再用二值方法分別壓縮。
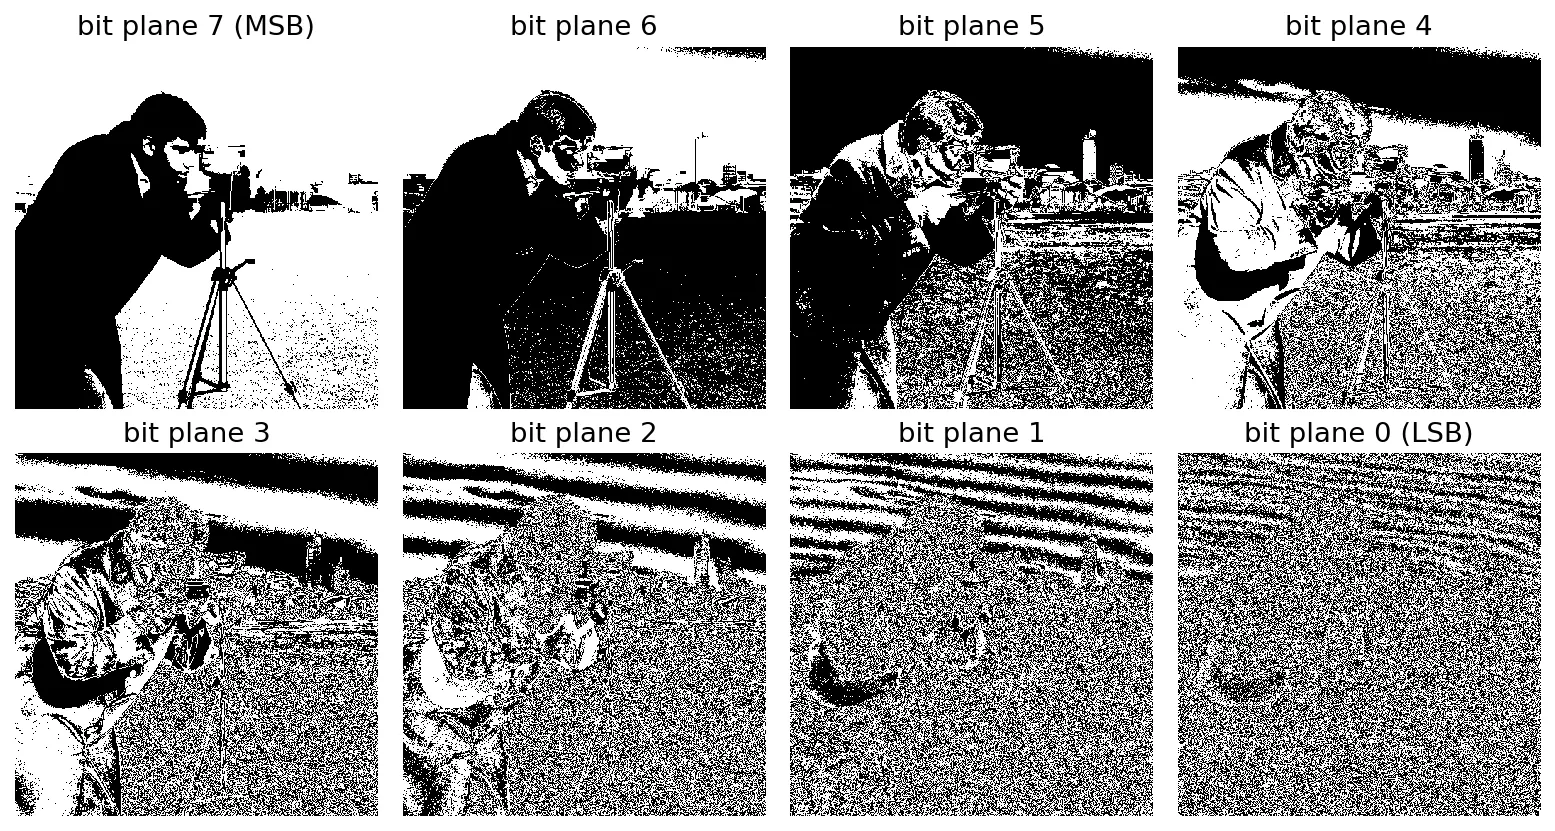
灰階 有八個位元 。把每個像素的第 位元收集起來,就是位元平面 (圖 8.3)。高位元平面看起來像影像的粗略版本,有大片均勻區域;低位元平面看起來像雜訊。每個平面都可以用游程或其他二值方法編碼。
一般二進位碼的缺點是灰階的微小變化可能翻轉許多位元:127 是 01111111,128 是 10000000。格雷碼(Gray code)讓相鄰的值只差一個位元:
其中 是互斥或(XOR)。以格雷碼拆出的平面在平滑區域會有更長的游程。以 camera 影像為例,位元平面 6 在水平相鄰像素間改變值的比例是 6.4%,對應的格雷碼平面只有 3.2%,平均游程約長一倍。在 NumPy 中轉換只要一行:gray = img ^ (img >> 1)。
JPEG 2000 也是逐個位元平面、由最高位往下編碼小波係數,這讓它的位元流可以在任何位元率截斷 [14]。
區塊轉換編碼
白話版:把影像切成小磚,每塊用一組標準圖樣(從平滑到細碎)的組合來描述,保留重要的圖樣,丟掉人眼幾乎看不出的細碎圖樣。
區塊轉換編碼器把影像切成不重疊的 子影像,對每塊做轉換、量化係數,再做熵編碼。轉換本身不會壓縮;它把大部分能量集中到少數係數,讓其他係數可以粗略量化或直接丟掉。
轉換的選擇
對 區塊 ,二維離散餘弦轉換(DCT)為
其中 , 時 ; 是水平與垂直頻率的索引。Karhunen–Loève 轉換(KLT,見第 7 章)在均方意義下集中能量的效果最好,但它的基底取決於資料,必須另外計算並傳送。DCT 是固定的、有快速演算法,而且對高度相關的影像,它的基底很接近 KLT。在區塊上它也勝過 DFT:DFT 把區塊視為週期函數,左右邊界的落差會產生假的高頻;DCT 隱含的偶對稱延伸則沒有這種落差。
子影像大小
較大的區塊能涵蓋更多相關性、集中能量的效果更好,但計算量更大,誤差也會擴散到更大的範圍。超過約 或 後效益很快趨緩。JPEG 固定使用 ;許多較新的編解碼器會在多種區塊大小間選擇,平滑區用大區塊,細節處用小區塊。
位元分配
轉換之後,要決定每個係數分到多少位元。
- 區域編碼(zonal coding)在每個區塊都保留固定區域的係數(通常是變異量最大的低頻)。
- 門檻編碼(threshold coding)在每個區塊保留超過門檻的係數,保留哪些係數會隨內容改變。
門檻編碼常見的實作是把每個係數除以正規化(量化)陣列 的對應元素再四捨五入:
就是實際被編碼的整數。解碼器再乘回去,,然後做反 DCT。 在高頻的大數值丟掉細節,在低頻的小數值保留粗略結構。
JPEG baseline
8 位元灰階的 JPEG baseline 編碼器 [2][13] 正是這樣做:
- 像素值減 128,使其以 0 為中心。
- 對每個區塊做 DCT。
- 用 表量化。標準提供一張亮度範例表;常見的慣例是以品質因子 縮放它: 時縮放比例 ,否則 (以百分比計)。
- DC 係數 以與前一區塊 DC 的差值編碼。
- 63 個 AC 係數以之字形(zigzag)由低頻排到高頻,讓零集中在後段,再以(零的游程, 非零值)配對及霍夫曼表編碼,每個區塊以區塊結束符號收尾。
圖 8.4 追蹤一個暗而平滑的區塊在 時經過步驟 2–3 的過程。它的 DC 項很大(,來自位準平移),另有少數低頻項。量化後 64 個整數只剩 6 個非零,重建結果卻只差幾個灰階。
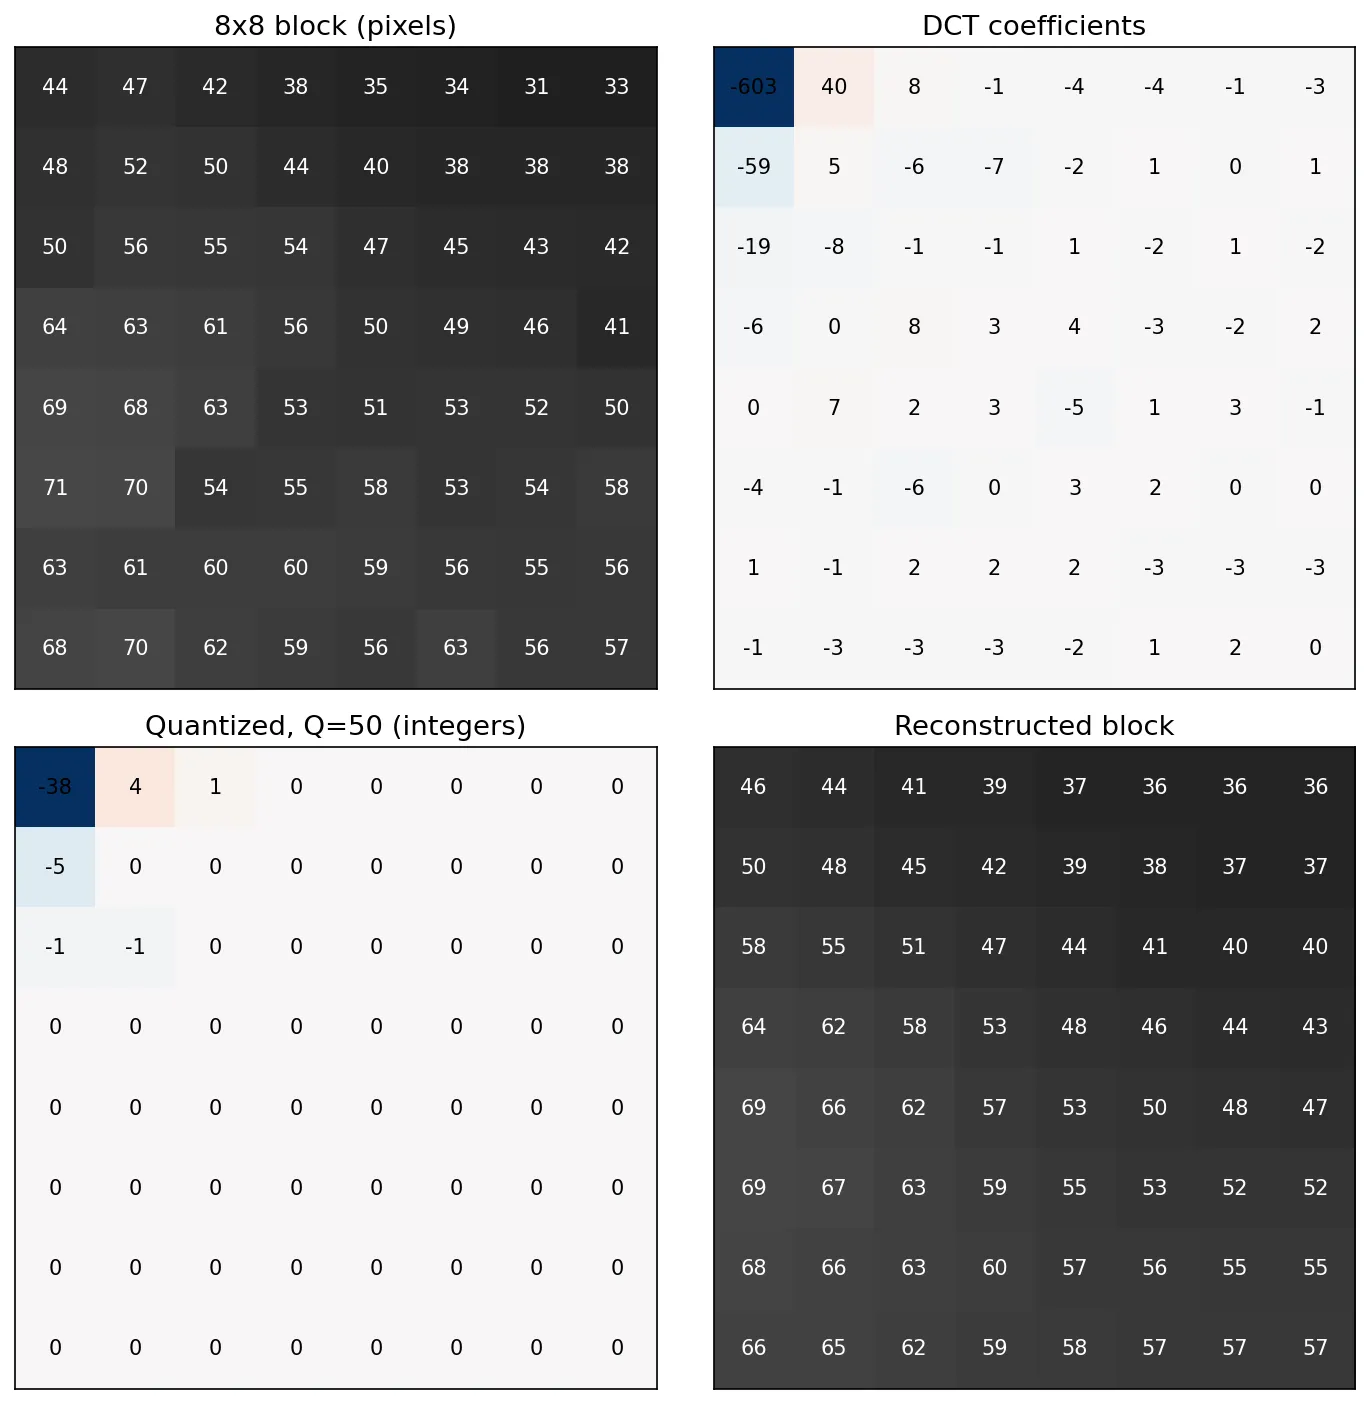
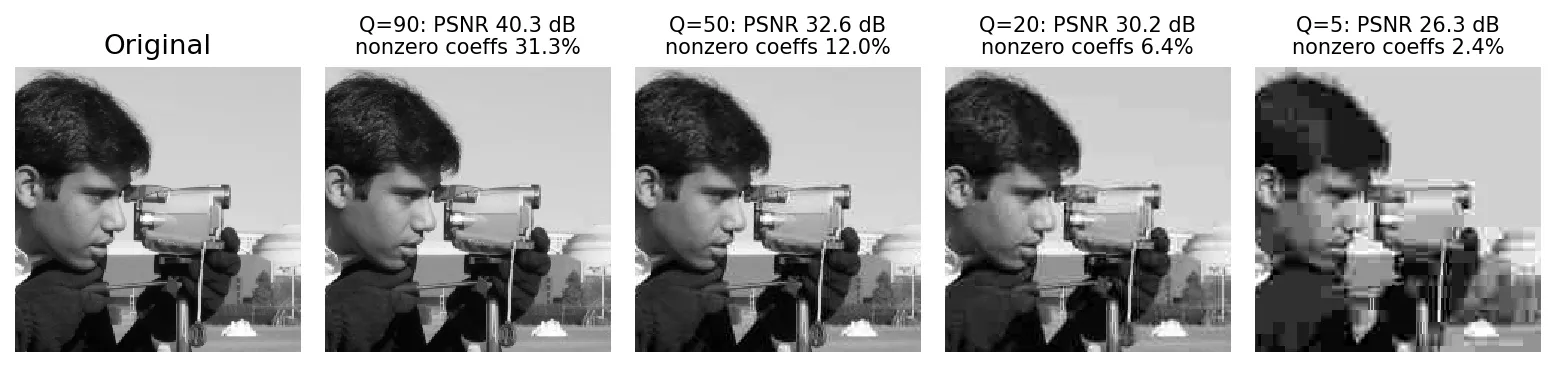
圖 8.5 把同樣的流程(不含熵編碼)套用到整張影像、四種品質設定。PSNR 從 的 40.3 dB 降到 的 26.3 dB,非零係數的比例則從 31.3% 降到 2.4%。低品質時會出現熟悉的瑕疵:方塊效應(blocking,各區塊獨立編碼,8×8 的接縫清晰可見)以及邊緣附近的振鈴(ringing,形成銳利邊緣所需的高頻被去掉了)。
import numpy as np
from scipy.fft import dctn, idctn

Q50 = np.array([[16,11,10,16,24,40,51,61],[12,12,14,19,26,58,60,55],
                [14,13,16,24,40,57,69,56],[14,17,22,29,51,87,80,62],
                [18,22,37,56,68,109,103,77],[24,35,55,64,81,104,113,92],
                [49,64,78,87,103,121,120,101],[72,92,95,98,112,100,103,99]])

def dct_codec(img, Q):
    f = img.astype(float) - 128                       # level shift
    H, W = f.shape
    B = f.reshape(H//8, 8, W//8, 8).swapaxes(1, 2)   # (H/8, W/8, 8, 8) blocks
    q = np.round(dctn(B, axes=(2, 3), norm="ortho") / Q)
    rec = idctn(q * Q, axes=(2, 3), norm="ortho")
    rec = rec.swapaxes(1, 2).reshape(H, W) + 128
    return np.clip(rec.round(), 0, 255).astype(np.uint8), q

rec, q = dct_codec(img, Q50)     # PSNR 32.6 dB, 12.0% nonzero coefficients
拖動下方的滑桿,比較一張彩色測試影像的無失真 PNG(465 kB)與品質 4 的真實 JPEG(7.6 kB,約小 60 倍)。注意平坦的背景、臉部和色彩邊緣:方塊、振鈴與顏色暈開(色彩通道以較低解析度儲存,量化也更粗)都看得到。
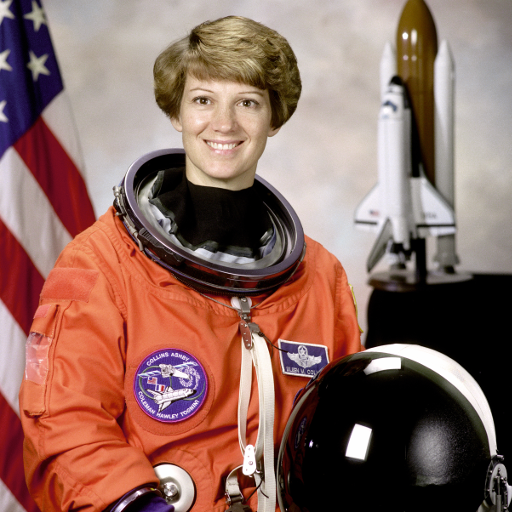
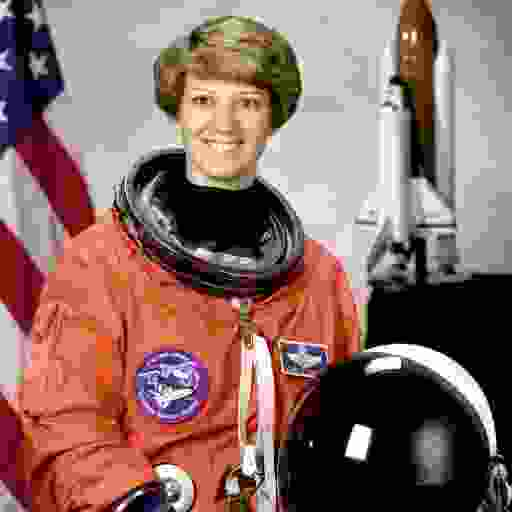 原圖(PNG)JPEG q=4
預測編碼
白話版:用已經送出的像素猜下一個像素,只傳「猜錯多少」。猜得準,數字就小;數字小,就便宜。
無失真預測編碼
編碼器由先前已編碼的像素算出像素 的預測值 ,並編碼預測誤差
其中 是預測器的階數, 是預測係數。解碼器算出同樣的預測值再加回 ,所以重建完全精確。圖 8.1 已經展示了效果:最簡單的「等於左鄰像素」預測器就把熵從 7.23 降到 4.70 位元/像素。
PNG 讓每一列從五種濾波器中選擇:不處理、左(Sub)、上(Up)、左與上的平均,以及 Paeth 預測器 [4]。JPEG-LS [10] 使用中位數邊緣偵測器(median edge detector):令 為左鄰、 為上鄰、 為左上鄰,
前兩種情況在水平或垂直邊緣處選擇位於正確一側的鄰居;第三種則假設局部是平滑平面。
運動補償
視訊多了時間軸。運動補償(motion compensation)預測器不從同一畫格的鄰居預測,而是從先前解碼的畫格複製一個區塊,並依運動向量 位移;運動向量透過搜尋最佳匹配(例如絕對差值總和最小)求得。編碼器傳送運動向量和殘差,殘差通常再以上一節的轉換編碼處理。只用自身編碼的畫格(intra frame)提供隨機存取的入口;預測畫格則小得多。HEVC(其靜態影像形式存於 HEIC 檔 [7])與 AV1(AVIF 所用 [6])都結合了這類畫格間預測與轉換編碼。
有失真預測編碼(DPCM)
若把預測誤差量化,,就得到差分脈衝碼調變(differential pulse-code modulation, DPCM)。關鍵細節是:編碼器必須以重建值 做預測,也就是解碼器會擁有的那些值。如果編碼器改用原始值預測,量化誤差會在解碼器中累積(漂移,drift)。
import numpy as np

def dpcm(row, step):
    """Lossy DPCM with previous-sample prediction and a uniform quantizer."""
    rec = np.empty(len(row)); prev = 128.0; idx = []
    for i, x in enumerate(row.astype(float)):
        e = x - prev                       # prediction error
        k = int(np.round(e / step))        # quantizer index: this is what is sent
        prev = prev + k * step             # reconstruction, identical in the decoder
        rec[i] = prev; idx.append(k)
    return np.array(idx), rec
在 camera 影像的一列上以步長 8 執行,量化索引的熵是 1.87 位元/樣本,重建的 PSNR 為 40.8 dB。量化很粗時會出現兩種典型失真:斜率過載(slope overload,陡峭邊緣處重建值爬升得不夠快)以及顆粒雜訊(granular noise,平坦區域來回抖動)。
最佳預測器與量化器
最佳線性預測器選擇 使均方預測誤差 最小。令導數為零得到正規方程式
其中 是 自相關矩陣,元素為 ; 是元素為 的向量。(這個分析通常忽略迴路中的量化器,量化夠細時這樣近似很準確。)
最佳量化器在給定層數下,使誤差分布的均方量化誤差最小。它有兩個條件:每個判定邊界位於相鄰兩個重建值的正中間;每個重建值是其區間內機率質量的重心(條件平均)。由於預測誤差集中在零附近,最佳的重建值在零附近密、在尾端疏。實務上,均勻量化器加上變長碼幾乎一樣好,而且簡單得多。
小波編碼
白話版:不把影像切成磚塊,而是拆成一張模糊的小圖,加上好幾層不同尺度的細節。大多數細節值接近零,儲存成本低,而且沒有磚塊接縫。
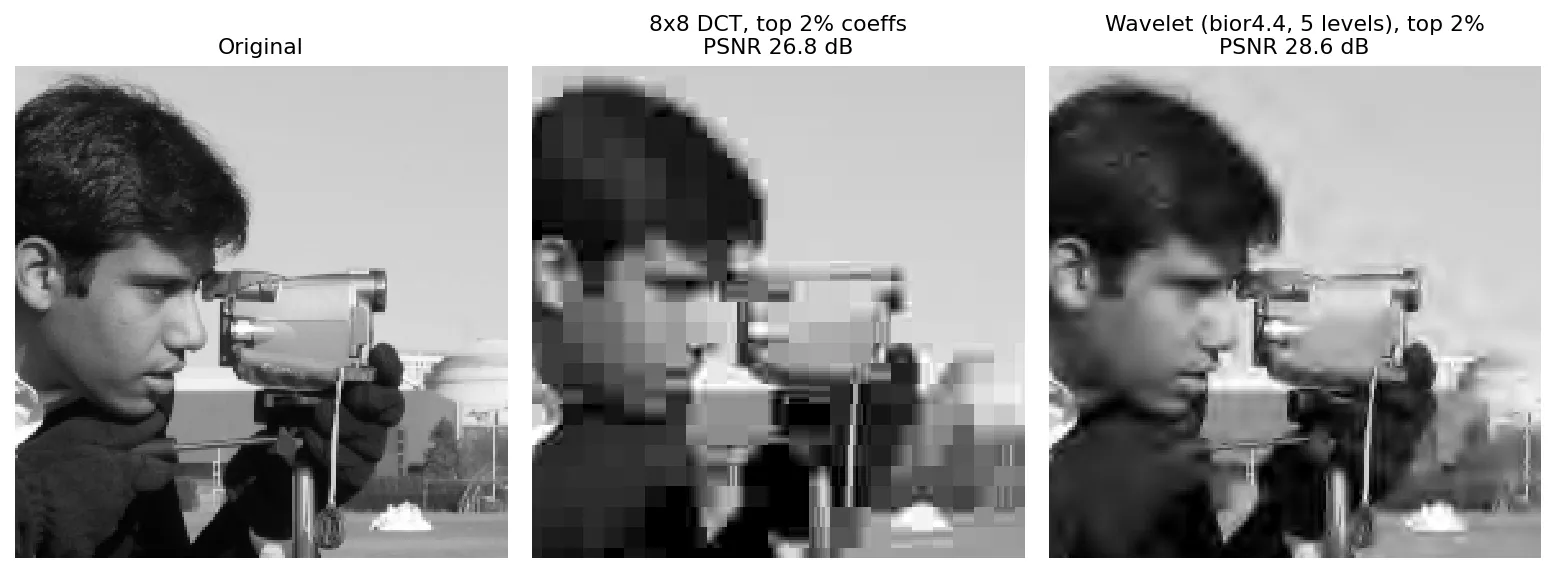
小波編碼器先做第 7 章的離散小波轉換,再量化係數並做熵編碼。因為小波基底函數彼此重疊、在多個尺度上局部化,小波編碼器沒有區塊邊界,失真表現為模糊與輕微振鈴,而不是方塊。圖 8.6 比較 8×8 DCT 與五層小波轉換,兩者都只保留同樣 2% 的係數(絕對值最大者)。DCT 的結果是一片馬賽克,PSNR 26.8 dB;小波的結果較平滑,達到 28.6 dB。
import numpy as np, pywt

def wavelet_code(img, keep=0.02, wavelet="bior4.4", level=5):
    c = pywt.wavedec2(img.astype(float), wavelet, level=level, mode="periodization")
    arr, slices = pywt.coeffs_to_array(c)
    t = np.quantile(np.abs(arr), 1 - keep)            # keep the largest 2%
    arr[np.abs(arr) < t] = 0
    c = pywt.array_to_coeffs(arr, slices, output_format="wavedec2")
return np.clip(pywt.waverec2(c, wavelet, mode="periodization"), 0, 255)這個簡化範例算的是係數數量,不是位元數。真正的編碼器還必須告訴解碼器哪些係數留下來,而聰明的顯著性編碼正是在這裡發揮作用。
小波的選擇
小波決定了能量集中的程度與瑕疵的樣貌。影像編碼器偏好雙正交(biorthogonal)小波,因為它們可以是對稱的(邊緣不會位移),而且濾波器短。JPEG 2000 規定了兩種:有失真編碼用不可逆的 9/7 抽頭濾波器組,無失真編碼用可逆的整數 5/3 濾波器組 [14]。上面使用的 PyWavelets bior4.4 也有同樣的 9 與 7 抽頭長度。
分解層數
每一層把目前的近似子帶拆成四個一半大小的子帶。層數越多表示法越稀疏,但對常見的影像尺寸,超過約五層後效益遞減,而且量化非常粗的係數會影響大片區域。
量化器設計
小波編碼器通常使用在零附近有加大死區(dead zone)的均勻純量量化器:
其中 是子帶 中的係數, 是該子帶的步長, 是整數索引。小係數(多半是雜訊)會落入零區間。步長依子帶選擇,高頻子帶的誤差比較不明顯,所以步長較大。
JPEG 2000
JPEG 2000 [3][14] 把這些元件組成完整的系統。影像可以切成大塊的 tile,色彩分量先經過分量轉換去相關,每個 tile 做小波轉換與死區量化。每個子帶再切成小的編碼區塊(code block),各自獨立地逐位元平面、以自適應算術編碼器編碼。最後,編碼後的片段被組織成品質層,同一個檔案只要讀取位元流的前段,就能以較低解析度或較低品質解碼。它也支援無失真編碼,以及以較高品質編碼的感興趣區域(region of interest)。
數位影像浮水印
白話版:浮水印是藏在影像裡、跟著影像一起流傳的額外資訊,例如簽名、擁有者 ID,或「這是模型生成的」標記。
浮水印的種類
- 可見浮水印是疊加的圖案(半透明商標),會降低畫質,也常可被裁掉或塗掉。不可見浮水印的改變低於可見門檻,靠偵測器取回。
- 強健(robust)浮水印能撐過壓縮、縮放、濾波與裁切(用於著作權與來源追溯);脆弱(fragile)浮水印任何改動都會破壞(用於真偽驗證);半脆弱浮水印能撐過輕度壓縮,但撐不過內容修改。
- 私有(非盲)偵測需要原始影像;盲偵測則不需要。
每種方案都要在不可察覺性(影像改變多小)、強健性、容量(藏多少位元)與安全性(沒有金鑰的人能否找到、移除或偽造浮水印)之間取捨。
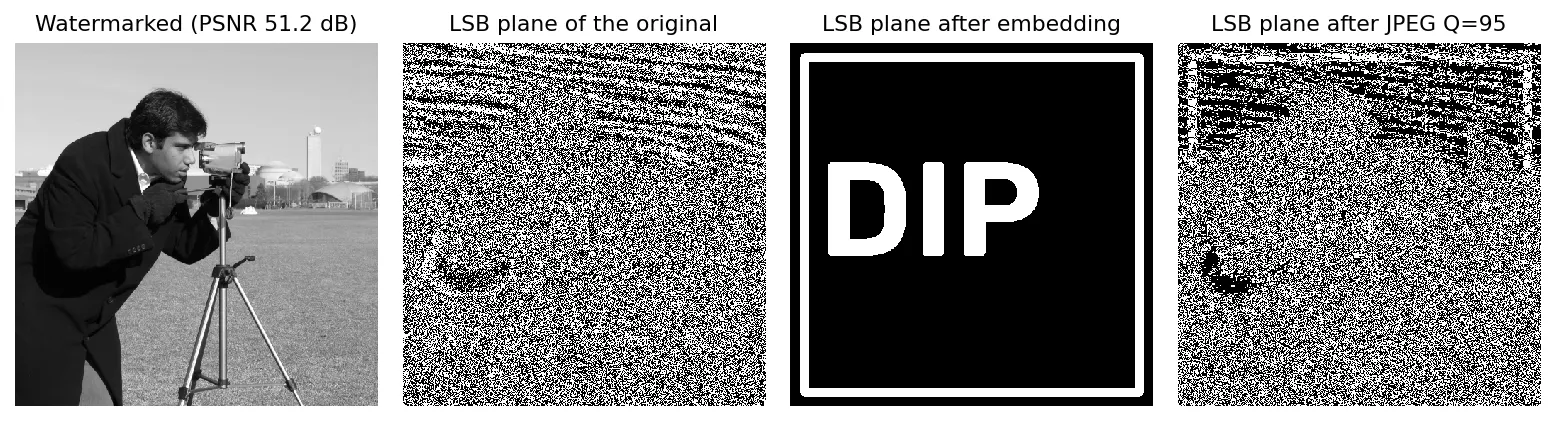
脆弱範例:最低有效位元
最簡單的不可見浮水印是把每個像素的最低有效位元(least significant bit, LSB)換成浮水印的一個位元:,。每個像素最多只改變一個灰階,所以 PSNR 約 51 dB。
def lsb_embed(cover, mark):          # cover: uint8 image, mark: 0/1 array of the same shape
    return (cover & 0xFE) | mark

def lsb_extract(img):
    return img & 1
圖 8.7 嵌入了一個二值的「DIP」標誌。從 PNG 取回時完全正確;但只要經過一次品質 95 的 JPEG 壓縮(肉眼看不出差別),取回的位元只有 55% 與浮水印相符,幾乎等於擲銅板。LSB 平面正是影像中像雜訊的部分,也是每個有失真編碼器最先丟掉的部分。因此 LSB 浮水印不適合宣示著作權,但可以當作脆弱的完整性檢查。
強健範例:DCT 域浮水印
要撐過 JPEG,就把浮水印藏在 JPEG 會保留資訊的地方:中低頻 DCT 係數。下面是我們自己設計的簡單方案。在每個 8×8 區塊中比較兩個中頻係數 與 ,JPEG 對它們的量化步長相近。要嵌入位元 1,就讓 比 至少大 ;嵌入位元 0 則相反。偵測器只檢查哪個係數較大,因此是盲偵測。
import numpy as np
from scipy.fft import dctn, idctn

def blocks(img):
    H, W = img.shape
    return img.astype(float).reshape(H//8, 8, W//8, 8).swapaxes(1, 2).reshape(-1, 8, 8)

def unblocks(B, H, W):
    return B.reshape(H//8, W//8, 8, 8).swapaxes(1, 2).reshape(H, W)

def dct_embed(img, bits, alpha=12.0):
    C = dctn(blocks(img), axes=(1, 2), norm="ortho")
    for i, b in enumerate(bits):               # one bit per 8x8 block
        x, y = C[i, 2, 3], C[i, 3, 2]
        if (x - y if b else y - x) < alpha:    # enforce the order with margin alpha
            m = (x + y) / 2
            s = alpha / 2 if b else -alpha / 2
            C[i, 2, 3], C[i, 3, 2] = m + s, m - s
    out = unblocks(idctn(C, axes=(1, 2), norm="ortho"), *img.shape)
    return np.clip(out.round(), 0, 255).astype(np.uint8)

def dct_extract(img):
    C = dctn(blocks(img), axes=(1, 2), norm="ortho")
    return (C[:, 2, 3] > C[:, 3, 2]).astype(int)
在 512×512 的 camera 影像上,這個方案藏了 4,096 個位元(每個區塊一個)。邊距 就是調整強健性的旋鈕:
| 邊距 | 加浮水印後 PSNR | JPEG q=90 後位元錯誤率 | q=75 | q=50 |
|---|---|---|---|---|
| 12 | 43.2 dB | 0.10% | 0.56% | 36.6% |
| 30 | 38.4 dB | 0% | 0% | 0.05% |
小邊距幾乎看不出來,但當 JPEG 在這些位置的步長超過邊距時就會失效。大邊距能撐過品質 50,代價是 PSNR 少了約 5 dB。實際系統還會加上錯誤更正碼、用秘密金鑰把每個位元分散到多個區塊,並依局部紋理調整強度,因為人眼在紋理複雜處能容忍較大的改變。
現代觀點
經典流程(轉換、量化、熵編碼)至今仍是所有實際部署的影像編解碼器的基礎。大約 2016 年以後的改變是:每個階段都可以被學習,而同樣的「訓練編碼器與解碼器」想法也重塑了浮水印。
值得一讀的綜述
- Wallace(1992)[13] 仍是 JPEG 設計最清楚的概述:DCT、量化表、之字形排序,以及霍夫曼與算術編碼兩種選項。適合搭配區塊轉換編碼一節閱讀。
- Skodras、Christopoulos 與 Ebrahimi(2001)[14] 是 JPEG 2000 的教學型回顧:tile 切割、9/7 與 5/3 小波、死區量化、編碼區塊的位元平面編碼與位元率控制。重點是:JPEG 2000 的價值與其說在單純的壓縮效率,不如說在功能——可分級性、感興趣區域編碼,以及在同一個位元流中支援無失真。
- Hu、Yang、Ma 與 Liu(2021)[16] 沿著網路架構、熵模型與位元率控制三個軸向綜述端到端學習式有失真影像壓縮,整理各自的里程碑,並在 CPU 與 GPU 上評測代表性方法。他們自己提出的由粗到細超先驗(coarse-to-fine hyperprior)也呼應了綜述的主軸:許多進展在於熵模型能多準確地預測潛在表示。
- Yang、Mandt 與 Theis(2023)[17] 是一本專書篇幅的神經壓縮入門,寫給機器學習讀者。它先回顧所需的資訊理論(熵編碼、率失真理論)以及影像品質與感知度量,再帶讀者認識以正規化流、變分自編碼器、擴散模型與 GAN 建構的編解碼器。
- Zhong、Das、Alrasheedi 與 Tanvir(2023)[18] 綜述深度學習影像浮水印,將方法分成三類:聯合訓練的嵌入器—擷取器網路、把網路當作特徵轉換再搭配傳統嵌入規則,以及兩者混合。
學習式影像壓縮
Ballé 等人 [15] 以學習得到的非線性分析轉換(卷積神經網路)取代 DCT,把影像 映射到潛在表示 ,量化成 後再由學習得到的合成轉換解碼。整個系統以率失真損失訓練:
其中 是在熵模型 下的期望碼長, 是失真(例如 MSE), 決定兩者的取捨。他們的關鍵貢獻是尺度超先驗(scale hyperprior):額外傳送一個小的潛在變數 作為旁資訊,用來預測 每個元素的尺度,讓熵模型隨每張影像調整。這和 JPEG 每張影像專屬的霍夫曼表、或 JPEG-LS 的情境建模是同一個想法,只是改成端到端學習。訓練時以加性均勻雜訊取代四捨五入,讓梯度能夠傳遞。
沒有改變的部分:量化仍是四捨五入,位元仍由算術編碼器 [11] 產生。學習式編解碼器可以理解為同一張編碼器方塊圖中更好的映射器與更好的機率模型。它們在實務上的障礙是解碼器的運算量,以及熵模型需要在各平台上逐位元一致。
現代標準編解碼器
同一時期,標準化的編解碼器也持續以人工設計的工具進步。AVIF [6] 把 AV1 的畫格內編碼存進 HEIF 容器,HEIC 檔 [7] 則把 HEVC 的畫格內編碼存進同一系列的容器。兩者都沿用視訊編解碼器的畫格內(單張畫面)編碼工具,讓靜態影像直接受惠於數十年的視訊編碼研究。JPEG XL [5] 鎖定攝影與網頁,支援有失真與無失真編碼、高動態範圍與透明通道,還能把現有 JPEG 檔無損轉存成更小的檔案,並可還原成完全相同的原始位元組。PNG [4] 仍是無失真圖形的首選;第三版(2025)加入 HDR 標示並把動態 PNG 納入標準。這些格式沒有取代教科書的觀念,而是更彈性地組合預測編碼、區塊轉換與自適應熵編碼。
深度學習浮水印
HiDDeN [19] 聯合訓練三個部分:把位元串藏進封面影像的編碼器、取回位元的解碼器,以及中間模擬裁切、模糊與 JPEG 的雜訊層(真正的 JPEG 無法微分,因此訓練時使用可微分的近似)。對抗損失讓加浮水印的影像保持自然。強健性是從模擬的攻擊中學來的,而不像前面那樣靠挑選係數來設計,因此它的強健程度取決於模擬得多好。
生成式模型帶來新的用途:在影像誕生時就加上標記。Stable Signature [20] 微調潛在擴散模型的解碼器,讓它生成的每張影像都帶有固定的隱藏簽章;即使經過裁切等編輯,擷取器仍能取回,誤報率低於百萬分之一。它回答的是來源問題(這張圖是不是模型 X 產生的?),而不是某張照片的著作權。移除與偽造攻擊仍是開放問題。
重點整理
- 壓縮去除編碼冗餘、空間/時間冗餘與不相關資訊;只有最後一種是有失真的。
- 熵是獨立符號無失真編碼的下限,而符號的選擇很重要:預測差值的熵遠低於原始像素。
- 霍夫曼碼是逐符號最佳;算術編碼逼近整段訊息的熵;Golomb、LZW、游程、符號式與位元平面編碼各自利用特定結構。
- JPEG = 位準平移 + 8×8 DCT + 量化表 + 之字形 + 游程/霍夫曼編碼;品質由縮放量化表決定,低品質時出現方塊與振鈴。
- 預測編碼器必須以重建值預測;運動補償預測是視訊編碼的核心。
- 小波編碼(JPEG 2000)沒有區塊接縫,並支援可分級、無失真與感興趣區域編碼。
- LSB 浮水印看不見但很脆弱;DCT 域浮水印只要強度超過量化步長,就能撐過 JPEG。
- 學習式編解碼器與深度浮水印用訓練出的網路取代人工設計的轉換,但核心仍是量化與算術編碼。
練習
- 某信源有四個符號,機率分別為 0.5、0.25、0.125、0.125。建出霍夫曼碼,計算平均碼長與熵,並解釋為什麼兩者在這裡相等。
提示
碼字為 0、10、110、111;兩個值都是 1.75 位元。所有機率都是 1/2 的冪次,所以 是整數,每個碼字都能恰好是那個長度。
- 預測殘差 先用 Golomb 一節的 映射,再用 編碼。寫出位元串並計算位元數。改用 會比較短嗎?
提示
。 時碼為 00、01、1100、1101、100(15 位元); 時為 000、001、1000、1001、010(17 位元)。殘差小時,較小的參數勝出。
- 使用算術編碼範例的機率(、、),解出標記值 的前三個符號。
提示
0.70 落在 ,第一個符號是 b。重新縮放:,落在 的範圍。再縮放:,又是 a。訊息開頭為 baa。
- 修改 DPCM 程式,讓編碼器以原始的前一像素預測,而不是重建值,但解碼器不變。測量一列的 PSNR 並解釋看到的現象。
提示
解碼器把量化誤差加到自己的重建值上,而這個參考值已和編碼器不同。誤差沿著該列累積(漂移)。在 camera 影像第 200 列、步長 8 的情況下,PSNR 從 40.8 dB 掉到約 17 dB。
- 把 LSB 浮水印改用位元平面 3 而不是位元平面 0。測量加浮水印後的 PSNR,以及經品質 95 與 75 的 JPEG 後位元相符率。你得到什麼、又付出了什麼?
提示
每個像素現在最多改變 8 個灰階,PSNR 大約下降 dB(隨機浮水印時約 33 dB)。JPEG 後的相符率在品質 95 時升到約 82%,在品質 75 時卻掉到約 57%:和 DCT 域方案相比,你付出了大量可見度,卻只換到一點強健性。
- 從量化後留下的基底函數的支撐範圍,解釋為什麼小波編碼器在極低位元率時看起來模糊,而區塊 DCT 編碼器看起來是方塊。
提示
留下的 DCT 基底函數被限制在各自的 8×8 區塊內,相鄰區塊各自近似,交界處形成接縫。留下的粗尺度小波函數平滑且與鄰居重疊,所以近似結果連續,只是缺少細節。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 8. publisher page
- Joint Photographic Experts Group, “JPEG 1 (ISO/IEC 10918-1 | ITU-T Rec. T.81): Digital compression and coding of continuous-tone still images,” JPEG overview page. jpeg.org
- Joint Photographic Experts Group, “JPEG 2000 (ISO/IEC 15444),” JPEG overview page. jpeg.org
- W3C, “Portable Network Graphics (PNG) Specification (Third Edition),” W3C Recommendation, 2025. w3.org
- Joint Photographic Experts Group, “JPEG XL (ISO/IEC 18181),” JPEG overview page. jpeg.org
- Alliance for Open Media, “AV1 Image File Format (AVIF),” v1.2.0, 2025. aomediacodec.github.io
- Nokia Technologies, “High Efficiency Image File Format (HEIF), ISO/IEC 23008-12: technical information.” nokiatech.github.io
- D. A. Huffman, “A Method for the Construction of Minimum-Redundancy Codes,” Proceedings of the IRE, vol. 40, pp. 1098–1101, 1952. doi
- S. W. Golomb, “Run-length encodings,” IEEE Transactions on Information Theory, vol. 12, pp. 399–401, 1966. doi
- M. J. Weinberger, G. Seroussi and G. Sapiro, “The LOCO-I lossless image compression algorithm: principles and standardization into JPEG-LS,” IEEE Transactions on Image Processing, vol. 9, pp. 1309–1324, 2000. doi
- I. H. Witten, R. M. Neal and J. G. Cleary, “Arithmetic coding for data compression,” Communications of the ACM, vol. 30, pp. 520–540, 1987. doi
- T. A. Welch, “A Technique for High-Performance Data Compression,” Computer, vol. 17, pp. 8–19, 1984. doi
- G. K. Wallace, “The JPEG still picture compression standard,” IEEE Transactions on Consumer Electronics, vol. 38, no. 1, pp. xviii–xxxiv, 1992. doi
- A. Skodras, C. Christopoulos and T. Ebrahimi, “The JPEG 2000 still image compression standard,” IEEE Signal Processing Magazine, vol. 18, pp. 36–58, 2001. doi
- J. Ballé, D. Minnen, S. Singh, S. J. Hwang and N. Johnston, “Variational image compression with a scale hyperprior,” ICLR, 2018. arXiv
- Y. Hu, W. Yang, Z. Ma and J. Liu, “Learning End-to-End Lossy Image Compression: A Benchmark,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2021. arXiv
- Y. Yang, S. Mandt and L. Theis, “An Introduction to Neural Data Compression,” Foundations and Trends in Computer Graphics and Vision, vol. 15, no. 2, 2023. arXiv
- X. Zhong, A. Das, F. Alrasheedi and A. Tanvir, “A Brief Yet In-Depth Survey of Deep Learning-Based Image Watermarking,” Applied Sciences, 2023. arXiv
- J. Zhu, R. Kaplan, J. Johnson and L. Fei-Fei, “HiDDeN: Hiding Data With Deep Networks,” arXiv:1807.09937, 2018. arXiv
- P. Fernandez, G. Couairon, H. Jégou, M. Douze and T. Furon, “The Stable Signature: Rooting Watermarks in Latent Diffusion Models,” ICCV, 2023. arXiv