第 12 章・特徵擷取
先備知識: 第 11 章・影像分割(二):主動輪廓——蛇模型與水平集
你將學到
- 「特徵」(feature)與「描述子」(descriptor)的差別,以及描述子最常追求的四種不變性:平移、旋轉、尺度與光照。
- 如何把分割出來的邊界變成可以量測的東西:鏈碼、多邊形、標記圖(signature)與骨架,再進一步算出形狀數與傅立葉描述子。
- 如何用大小、形狀、拓撲(尤拉數)、紋理(直方圖動差、共生矩陣、頻譜)與動差不變量描述整個區域。
- 主成分分析(PCA)如何把物體轉正,並把大量量測壓縮成少數幾個數字。
- Harris–Stephens 角點偵測器、最大穩定極值區域(MSER)與 SIFT 如何找出並描述可以在兩張照片之間配對的興趣點。
- 近二十年的綜述論文如何評價這些手工設計的特徵,以及學習式特徵(SuperPoint、LoFTR、LightGlue、DINOv2)在哪些地方取代了它們。
先看全貌
分割(第 10、11 章)告訴我們物體「在哪裡」。但程式沒辦法像人一樣「看」一個區域,它需要一小串數字來說明這個區域「長什麼樣子」,才能比較、排序、搜尋和辨識。產生這串數字的過程,就是特徵擷取。
本章依照 Gonzalez 與 Woods 教科書的順序 [1]:先談邊界,再談區域,接著是處理大量量測的統計工具(PCA),最後是完全不需要分割的特徵:角點、穩定區域與 SIFT 關鍵點。最後這一類把傳統影像處理接上了現代電腦視覺的任務,例如全景接圖、三維重建與視覺定位。
背景:特徵、描述子與不變性
白話版。 特徵是你在影像中找到的有趣東西(一個角、一團斑點、一個區域)。描述子是你用來描述它的一串數字。我們希望那些「無關緊要的變化」發生時,描述子不要跟著變。
精確版。 依照 [1],我們把工作拆成兩步:
- 特徵偵測(feature detection):找出特徵在哪裡——一條邊界、一個區域,或一個帶有尺度與方向的點。
- 特徵描述(feature description):替每個偵測到的特徵指定一個向量 。
若描述子 對一族轉換 滿足
就稱它對 不變(invariant),其中 是影像(或區域), 是施加在它上面的轉換。若偵測到的量會以可預期的方式跟著轉換一起變(例如關鍵點的位置隨物體移動,物體放大兩倍時偵測到的尺度也變成兩倍),就稱它是共變的(covariant)。偵測器應該共變,描述子應該不變。
我們最在意的轉換是:
| 變化 | 對影像的影響 | 常見的解法 |
|---|---|---|
| 平移 | 座標整體位移 | 減去質心,或改用差值 |
| 旋轉 | 座標旋轉 | 使用標準方向、取絕對值,或使用與旋轉無關的量 |
| 尺度 | 座標乘上倍率 | 依大小正規化,或在各尺度上搜尋 |
| 光照 | 強度改變,大致為 | 用梯度消去 ,再正規化消去 |
不變性與鑑別力之間永遠有取捨。對一切都不變的描述子,其實什麼也描述不了:「6」轉 180° 就變成「9」。挑選特徵,其實就是在決定哪些差異對你的任務是重要的。
邊界前處理
白話版。 在量測邊界之前,得先把邊界像素按順序排好;通常還要簡化它,免得雜訊和像素造成的鋸齒主導了結果。
邊界追蹤
分割出的區域是一堆像素的集合,而大多數邊界描述子需要的是有順序、封閉的點列。標準的 Moore 邊界追蹤法 [1] 從最上方、最左邊的前景像素 以及它西邊的背景鄰居 出發,從 開始沿順時針方向檢查目前邊界像素的 8 鄰域,直到碰到前景像素。這個像素就是下一個邊界點,而它前一個被檢查的背景像素成為新的 ;如此重複,直到回到 且即將走向第二個點為止。結果就是一串點 。OpenCV 的 cv2.findContours 和 scikit-image 的 measure.find_contours 都能直接給你這串點。
鏈碼
鏈碼(chain code)把點列換成方向序列。從一個邊界像素走到下一個,每一步都是 4 或 8 個方向之一,從正東開始逆時針編號為 0–3 或 0–7 [1]。鏈碼很精簡(8 方向時每步 3 位元),而且本來就與平移無關。
剩下兩個問題:鏈碼取決於起點,也取決於旋轉。解法都很簡單:
- 起點。 把碼視為環狀序列,選擇能組成最小整數的那個循環位移。
- 旋轉(45° 的倍數)。 改用一階差分(first difference):相鄰兩個元素之間逆時針轉了幾個方向,,其中 是第 個碼。物體轉 90° 時每個 都加 2,而每個 不變。
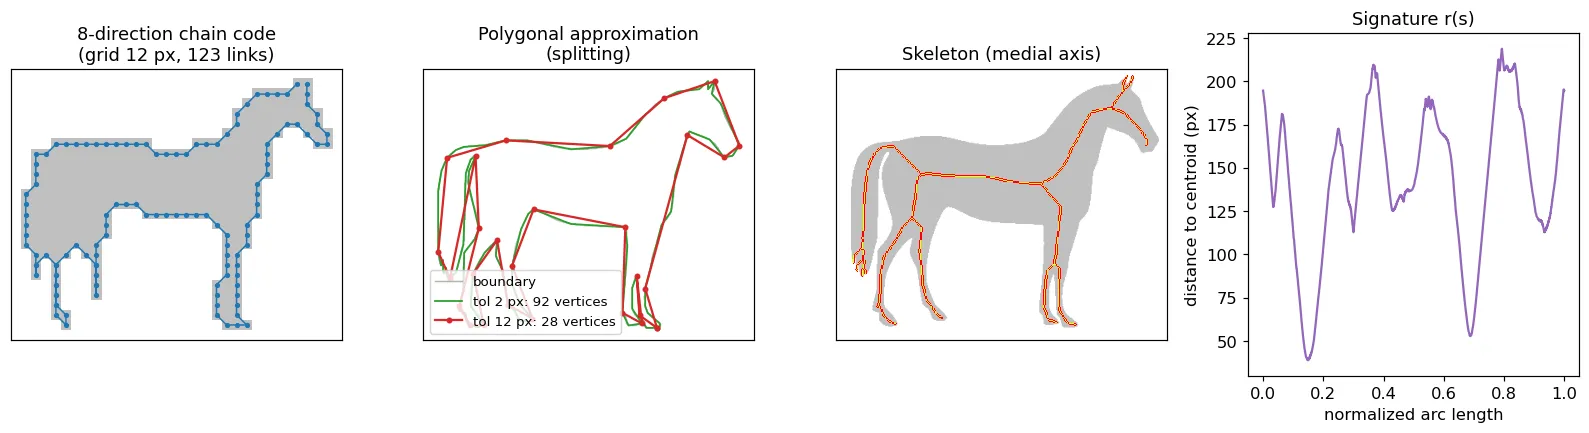
直接在原始像素格點上算出的鏈碼又長又雜,所以實務上會先把邊界重新取樣到較粗的格點上,讓每一節跨過好幾個像素(圖 12.1 左)。
import numpy as np, cv2
from skimage import data

mask = (data.horse() == 0).astype(np.uint8)          # True inside the horse
cnts, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_NONE)
pts = max(cnts, key=len)[:, 0, :]                    # (x, y), 8-connected boundary

# Freeman 8-direction code: 0 = east, counted counter-clockwise (y points down)
DIRS = {(1, 0): 0, (1, -1): 1, (0, -1): 2, (-1, -1): 3,
        (-1, 0): 4, (-1, 1): 5, (0, 1): 6, (1, 1): 7}
steps = np.diff(np.vstack([pts, pts[:1]]), axis=0)
code = np.array([DIRS[tuple(s)] for s in steps])

diff = (code - np.roll(code, 1)) % 8                 # first difference: rotation invariant
shifts = [tuple(np.roll(diff, -i)) for i in range(len(diff))]
shape_number = min(shifts)                           # start-point invariant
print(len(code), code[:12], diff[:12])
斜率鏈碼
一般鏈碼只認得八個方向。斜率鏈碼(slope chain code, SCC)[1] 則是沿著曲線首尾相接地放上等長的直線段,記錄相鄰兩段之間的斜率變化,並把它正規化成區間 內的實數( 代表完全折返)。因為只記錄方向的變化,SCC 對平移和旋轉不變;又因為每段等長,只要依曲線長度設定段長,它也對尺度不變。所有斜率變化絕對值的總和,正好是曲線「有多彎曲」(曲折度,tortuosity)的自然量度。
多邊形近似
用少數幾個頂點的多邊形,就能抓住邊界的精髓。
最小周長多邊形(minimum-perimeter polygon, MPP)。用一條由方格組成的帶子(cellular complex)把邊界蓋住,帶子的內牆與外牆形成兩道封閉的圍籬。想像在兩道圍籬之間放一條橡皮筋,讓它自然收縮:它最後會停在帶子內最短的封閉路徑上,這就是 MPP [1]。它的頂點一定落在內牆的凸角或外牆的凹角上,因此可以設計出很有效率的演算法。方格大小控制細節多寡:方格越大,多邊形越粗略。
合併法(merging)。沿著邊界前進,只要目前這段的最小平方直線擬合誤差低於門檻 ,就繼續把點加進來;誤差超過 時就開新的一段。方法簡單,但頂點不一定落在真正的轉角上。
分裂法(splitting)。把距離最遠的兩個邊界點連成一條弦,找出離這條弦最遠的邊界點;若距離超過 ,就把它設為頂點,問題一分為二,再遞迴處理。分裂法較容易把頂點放在真正的反曲點上。skimage.measure.approximate_polygon 實作的就是這種遞迴分裂的概念;圖 12.1 第二格顯示兩種容許誤差的結果。
標記圖
標記圖(signature)把二維邊界降成一維函數。最簡單的是質心到邊界的距離,表示成角度的函數 ,或正規化弧長的函數 [1]。圓形得到常數;正方形得到四個一模一樣的凸起。標記圖天生與平移無關;旋轉變成函數的循環位移,尺度變成乘法,所以只要選一個標準起點(例如最遠點),再除以最大值或標準差即可正規化。 只有在星形區域才是函數;像圖 12.1 的馬,從質心射出的一條射線可能穿過邊界不只一次,所以那裡改用 。
骨架與中軸
白話版。 在一片草地的整圈邊緣同時點火,火線從四面八方往內燒,不同方向的火線相遇的地方就構成骨架。
精確版。 區域 (邊界為 )的中軸(medial axis)是 中那些在 上有不只一個最近點的點所組成的集合 [1]。每個中軸點加上它到邊界的距離,定義了一個最大內切圓;所有這些圓的聯集能完整重建 (這就是中軸轉換,medial axis transform)。直接計算的代價很高,所以實務上用細化(thinning)求骨架:反覆刪除那些不是端點、且刪掉後不會破壞連通性的邊界像素,直到再也刪不動為止。骨架對邊界上的小突起非常敏感,通常需要先平滑,或事後修剪短分支。
邊界特徵描述子
白話版。 邊界一旦變成有序點列,就可以量它:有多長、有多寬、有多彎,以及把它寫成一堆波的總和時長什麼樣子。
基本描述子
- 長度。 邊界上的像素數是粗略估計。若用 8 連通鏈碼,水平與垂直步長算 1,斜向步長算 。
- 直徑。 ,其中 是邊界點, 是距離(通常是歐氏距離)。連接這兩個最遠點的線段稱為長軸;短軸與之垂直,長度取到能讓以兩軸為邊的方框剛好包住邊界。這個方框稱為基本矩形(basic rectangle)。
- 離心率。 長軸長度與短軸長度的比值。(後面的區域離心率改用二階動差定義。)
- 曲率。 沿邊界的斜率變化率。數位邊界上的曲率很雜,所以通常改算某點兩側擬合線段的斜率差。曲率變號處就是反曲點;(沿行進方向)曲率為正表示凸的部分,為負表示凹的部分。
形狀數
邊界的形狀數(shape number)是其 4 方向鏈碼的一階差分,再循環位移成最小整數 [1]。它的長度稱為形狀的階數(order)。在 4 連通格點上,封閉邊界的 一定是偶數,而且每個階數只有有限多種形狀。要公平比較兩個形狀,先固定方向:讓格點對齊形狀的基本矩形(或長軸),選擇能得到指定階數的格點大小,在該格點上算鏈碼,再算形狀數。兩個形狀的相似度(degree of similarity)定義為它們的形狀數仍然相同的最大階數。
傅立葉描述子
白話版。 沿著邊界走一圈,把每個點寫成一個複數。這串數每走一圈就重複一次,所以可以拆成許多波。前幾個慢的波給出大致輪廓,快的波負責補細節。
精確版。 設邊界有 個點 ,,把每個點寫成
對 做離散傅立葉轉換,就得到傅立葉描述子
反轉換則可以重建邊界。如果只保留其中 個係數(正負頻率中最低的那些),其餘設為零,就得到平滑、但保留整體形狀的近似 (圖 12.2)。這就是為什麼少數幾個傅立葉描述子就能精簡地表示一個形狀。
這些描述子對基本幾何變化的反應很單純 [1]:
| 邊界的變化 | 對 的影響 |
|---|---|
| 平移 | 只有 改變:變成 |
| 旋轉 | 每個係數乘上 |
| 縮放 | 每個係數乘上 |
| 起點移動 | 乘上 |
因此可以組出不變的描述子:丟掉 (平移)、除以 (尺度)、只保留大小 (旋轉與起點)。只留大小的代價是丟掉了相位,而相位也帶有一部分形狀資訊。
import numpy as np
from skimage import data, measure

mask = data.horse() == 0
c = max(measure.find_contours(mask.astype(float), 0.5), key=len)
z = c[:, 1] + 1j * c[:, 0]                       # boundary as complex numbers x + jy

def fourier_descriptor(z, n=16):
    a = np.fft.fft(z)
    a[0] = 0                                     # drop DC   -> translation invariance
    a = a / np.abs(a[1])                         # divide by |a(1)| -> scale invariance
    return np.abs(np.r_[a[1:n + 1], a[-n:]])     # magnitudes -> rotation and start-point invariance

f1 = fourier_descriptor(z)
f2 = fourier_descriptor(0.5 * np.exp(1j * 0.7) * np.roll(z, 300) + (40 + 10j))
print(np.abs(f1 - f2).max())                     # ~1e-16: same descriptor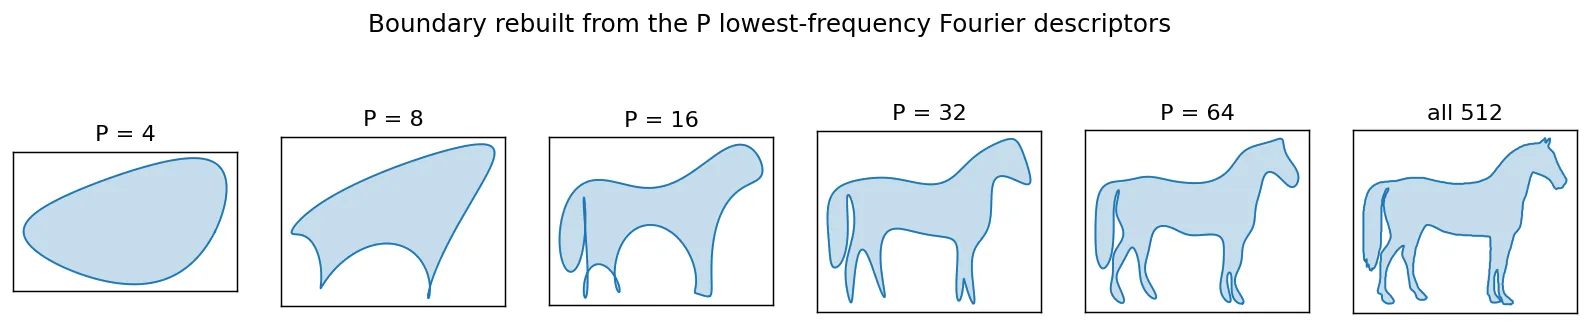
邊界的統計動差
一段邊界或一個標記圖可以看成一維函數 。把它的振幅當成隨機變數 ,建立直方圖 ,,其中 是振幅的分箱數。則
其中 是平均振幅, 是第 階中心動差 [1]。 量的是分散程度, 量的是不對稱性。另一種做法是把 正規化成面積為 1,視為 的機率密度,這時動差描述的就是曲線的形狀。動差計算便宜、物理意義清楚,而且(若在旋轉正規化後的標記圖上計算)對旋轉不敏感。
區域特徵描述子
白話版。 除了描邊,也可以看整塊區域:多大、多圓、有幾個洞,以及內部看起來如何(平滑、粗糙、有條紋)。
基本描述子
- 面積 :區域中的像素數。
- 周長 :邊界的長度。
- 緊緻度(compactness):。它沒有單位,所以對尺度不變(在數位化誤差範圍內也對平移與旋轉不變)。圓盤使它最小。
- 圓度(circularity):。圓盤為 1,越細長或越不規則就越小,等於緊緻度的倒數再乘上常數。
- 等效直徑:,即同面積圓盤的直徑。
- 離心率(用動差定義):設 為像素座標共變異數矩陣的特徵值,。圓盤為 0,線段趨近 1。(scikit-image 採用此定義。)
import numpy as np
from skimage import data, filters, measure, morphology, segmentation

img = data.coins()
bw = img > filters.threshold_otsu(img)
bw = morphology.binary_closing(bw, morphology.disk(2))
bw = segmentation.clear_border(morphology.remove_small_objects(bw, 200))
for r in measure.regionprops(measure.label(bw))[:4]:
    circ = 4 * np.pi * r.area / r.perimeter ** 2  # 1 for a perfect disk
    print(f"area={r.area:5.0f}  circularity={circ:.2f}  "
          f"eccentricity={r.eccentricity:.2f}  euler={r.euler_number}  "
          f"hu1={r.moments_hu[0]:.4f}")
在 coins 影像上,分割良好的硬幣圓度約 0.9、離心率約 0.3–0.4(數位周長會略為高估,所以即使是完美的數位圓盤,得分也會比 1 低一點)。
拓撲描述子
拓撲研究的是在「橡皮膜」變形下保持不變的性質:可以拉伸、彎折,但不能撕開或黏合。面積和周長不是拓撲性質;連通塊的數目和洞的數目才是。尤拉數(Euler number)定義為
其中 是連通成分數, 是洞數 [1]。字母「A」的 (一個成分、一個洞);「B」的 。對於由直線段構成的區域(多邊形網路),尤拉公式把拓撲與計數連在一起:
其中 是頂點數, 是邊數, 是面數。注意 會受前景與背景所用的連通定義(4 或 8 連通)影響。
紋理
白話版。 紋理是表面在眼睛裡的「觸感」:平滑、粗糙、規則。我們用像素值的統計,以及「像素值彼此如何相鄰」的統計來描述它。
直方圖的統計動差。 設 為代表強度的隨機變數, 為正規化直方圖,,平均值 。則 [1]:
對常數區域為 0,變異數越大越接近 1(先把 正規化到 ,例如除以 )。 量的是直方圖的偏斜。這些量完全不管像素在哪裡,所以棋盤格和把它打亂後的影像會得到一模一樣的值。
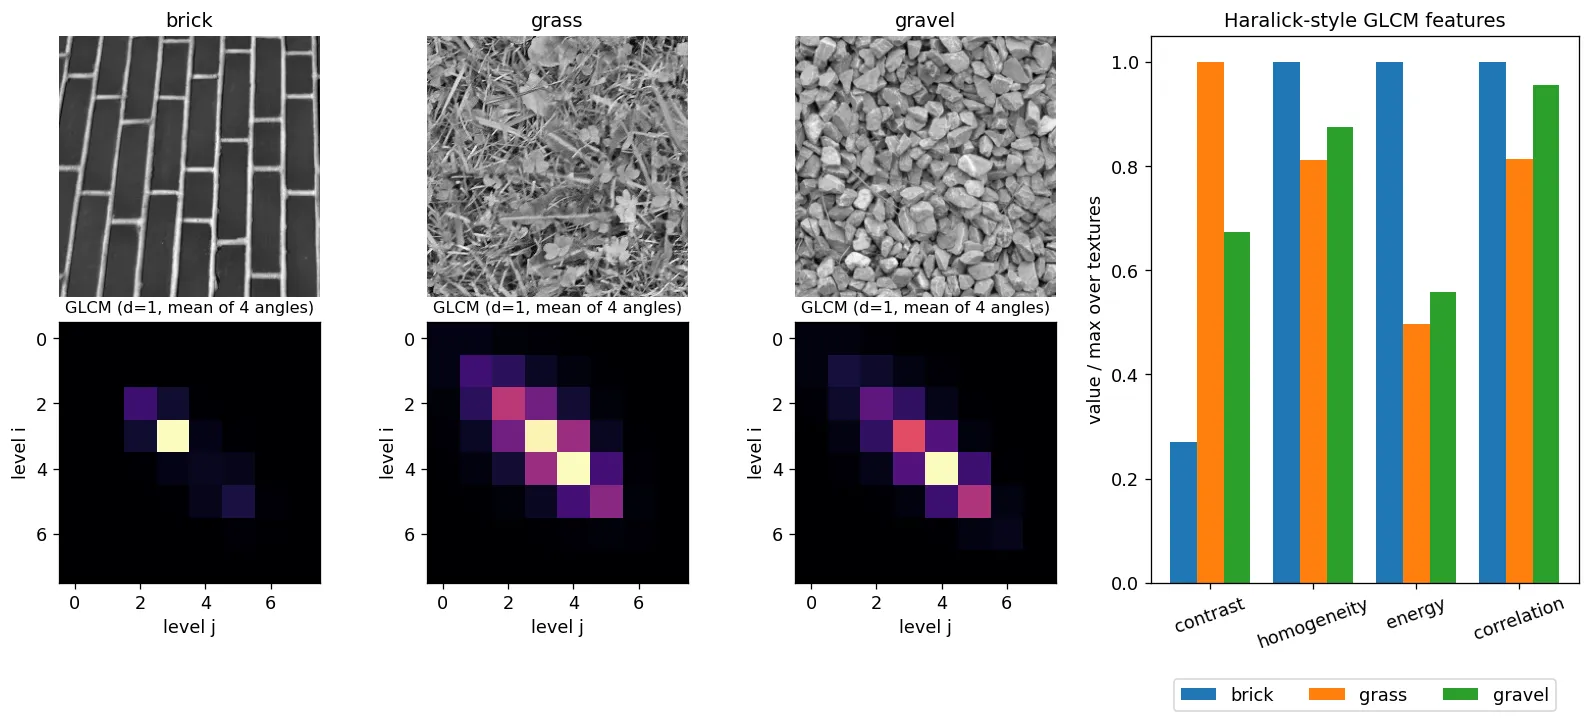
共生矩陣。 為了描述空間排列,Haralick、Shanmugam 與 Dinstein 提出了灰階共生矩陣(gray-level co-occurrence matrix, GLCM)[3]。先固定一個位置運算子 ,例如「右邊一個像素」。 是 矩陣,元素 計算「灰階為 的像素,在 指定的位置上出現灰階為 的像素」的次數。令 ,
就是該像素對出現的機率估計。由 可以算出幾個好用的描述子( 與 分別是列、行邊際分布的平均值與標準差):
(scikit-image 的 graycoprops 所回報的 “energy” 是均勻度總和的平方根。)質量集中在對角線附近,表示鄰居的值相近(平滑紋理:均質性高、對比低);質量遠離對角線,表示變化劇烈(對比高)。實務上會先量化到少數幾階(8–32 階),對多個角度與距離計算 ,再對角度取平均,以得到近似的旋轉不變性。
import numpy as np
from skimage import data
from skimage.feature import graycomatrix, graycoprops

for name in ["brick", "grass", "gravel"]:
    q = (getattr(data, name)()[:256, :256] // 32).astype(np.uint8)   # 8 gray levels
    P = graycomatrix(q, distances=[1], angles=[0, np.pi/4, np.pi/2, 3*np.pi/4],
                     levels=8, symmetric=True, normed=True)
    feats = {p: graycoprops(P, p).mean() for p in ["contrast", "homogeneity", "energy", "correlation"]}
    print(name, {k: round(float(v), 3) for k, v in feats.items()})
brick {'contrast': 0.269, 'homogeneity': 0.883, 'energy': 0.579, 'correlation': 0.817}
grass {'contrast': 0.995, 'homogeneity': 0.717, 'energy': 0.288, 'correlation': 0.664}
gravel {'contrast': 0.669, 'homogeneity': 0.772, 'energy': 0.323, 'correlation': 0.78}磚牆以大片平坦的磚面為主,GLCM 集中在少數幾個對角線格子:能量高、對比低。草地每根草葉都不同,GLCM 散得很開:對比最高、能量最低。光是四個數字,就足以把三種紋理分開(圖 12.3)。
頻譜紋理。 週期性或有方向性的紋理,會在傅立葉頻譜上產生強烈而集中的峰值。把頻譜寫成極座標 , 是到原點的距離(頻率), 是方向。兩個一維函數可以摘要它 [1]:
其中 是角度 那條射線上的頻譜, 是半徑 的半圓上的頻譜, 是考慮的最大半徑。 的峰值揭露圖樣的週期(例如磚塊的間距); 的峰值揭露主要方向。只需要半圈,因為實數影像的頻譜對原點對稱。
動差不變量
對大小為 的二維影像(或區域指示函數), 階動差為
中心動差為
其中 是質心。中心動差對平移不變。正規化中心動差
則再加上尺度不變。Hu [2] 從二階與三階的 推導出七個對平移、尺度以及旋轉都不變的組合。前兩個是
是對質心的正規化「轉動慣量」:質量離中心越遠就越大。 量的是細長程度。第七個不變量在鏡射下會變號,因此可以分辨形狀與它的鏡像。由於高階動差會放大雜訊,而且數值跨越好幾個數量級,一般會比較 。在 scikit-image 中,regionprops(...).moments_hu 會傳回全部七個;OpenCV 則是 cv2.HuMoments(cv2.moments(mask))。
以主成分作為特徵描述子
白話版。 量測一個物體很多項時,有些量測其實在重複講同一件事。PCA 會找出一組新的座標軸,從「最有資訊」排到「最沒資訊」,讓我們只留前幾個、丟掉其他。對二維形狀來說,第一個軸就是形狀最長的那個方向。
精確版。 設 是 維向量,例如多光譜影像中每個像素的 個波段值,或某區域中每個像素的 座標。它們的平均與共變異數為
是實對稱矩陣,因此有 個正交單位特徵向量 ,對應特徵值 。把特徵向量當成矩陣 的各列。Hotelling 轉換(也稱離散 Karhunen–Loève 轉換,或 PCA)為
新向量的平均為零,共變異數是對角矩陣 : 的各分量互不相關,第 軸上的變異數為 。若只保留前 列 ,重建 的均方誤差為
也就是被丟掉的特徵值總和。在這個意義下,沒有其他投影到 維的線性方法做得更好。
在影像處理中的三種用途 [1]:
- 壓縮多光譜影像。 有 個對齊好的波段時,每個像素是一個 維向量。大部分變異通常集中在前兩、三個主成分影像,因此可以用它們代替全部 個波段來顯示或分類。
- 正規化物體姿態。 把區域的像素座標當作向量, 會把質心移到原點,並把區域轉到長軸與第一座標軸對齊(圖 12.4)。之後算出的描述子就與平移、旋轉無關;再除以 就連尺度也無關。要注意:特徵向量的正負號是任意的,轉正後的物體可能被翻轉;可以用「三階動差較重的一側朝右」之類的規則決定。
- 特徵影像(eigen-images)。把同一類物體的大量同尺寸影像各自攤平成向量,前幾個特徵向量重新排回影像形狀,就是涵蓋該組影像大部分變化的「特徵影像」。任何新影像都可以用少數幾個座標 描述,成為精簡的辨識特徵。
import numpy as np
from skimage import data, transform

mask = transform.rotate((data.horse() == 0).astype(float), 35, resize=True) > 0.5
X = np.argwhere(mask)[:, ::-1].astype(float)     # (x, y) of every object pixel
m = X.mean(axis=0)
C = np.cov((X - m).T)                            # 2x2 covariance matrix
evals, evecs = np.linalg.eigh(C)                 # ascending eigenvalues
A = evecs[:, ::-1].T                             # rows = eigenvectors, largest first
Y = (X - m) @ A.T                                # Hotelling transform y = A(x - m)
print(np.round(np.cov(Y.T), 3))                  # diagonal: the axes are decorrelated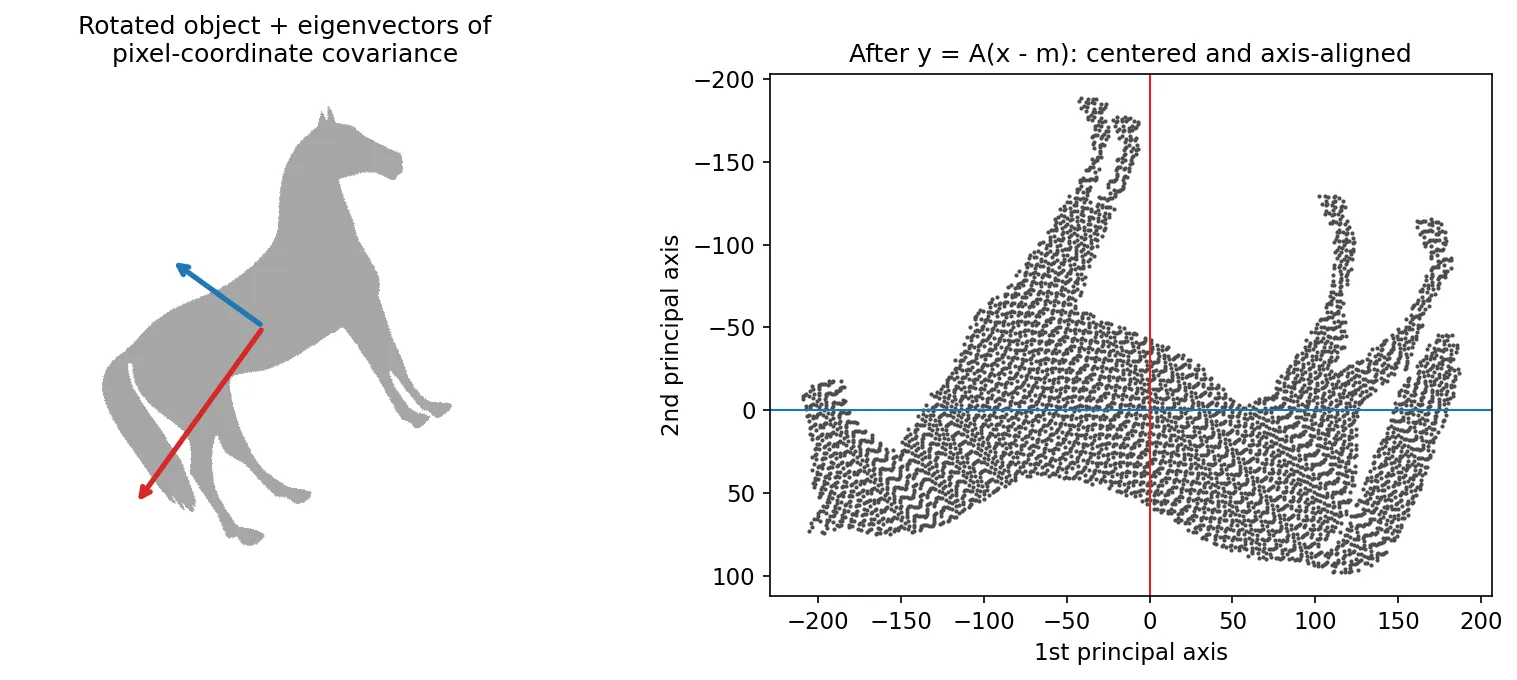
整張影像的特徵
白話版。 前面都需要先分割出物體。但很多任務(全景接圖、追蹤、三維重建)需要的是地標:能在任何照片中自動找到,並且能在同一場景的另一張照片中再找到。角點和穩定的斑塊就是好地標。
Harris–Stephens 角點偵測器
白話版。 透過一個小窗口看影像,然後把窗口稍微挪一下。在平坦區域,什麼都沒變;在邊緣上,沿著邊緣挪不會變,橫越邊緣才會變;在角點上,往任何方向挪,看到的都會變。Harris 與 Stephens 把這個想法寫成公式 [4]。
精確版。 窗口 位移 所造成的變化為
這裡用了一階泰勒展開,結構張量(structure tensor,又稱二階動差矩陣)為
其中 是影像的偏導數, 是窗函數(通常為高斯)。 的特徵值 說明一切:兩個都小是平坦區,一大一小是邊緣,兩個都大是角點。1988 年時逐像素算特徵值太昂貴,所以 Harris 與 Stephens 改用響應函數
是一個小常數(常見值約 0.04–0.06)。 在角點為大的正值,在邊緣為負值,在平坦區接近零。角點就是 在非極大值抑制後、超過門檻的局部極大值。
性質: 由導數組成,所以 不受亮度加減的影響;它的特徵值與旋轉無關,所以偵測器對旋轉共變。但它不對尺度共變:在小窗口中看到的角點,換成大窗口可能就像一條邊緣。補上尺度的正是 SIFT。
import numpy as np
from scipy import ndimage as ndi
from skimage import data, feature, util

def harris(img, sigma_d=1.0, sigma_i=1.5, k=0.05):
    Ix = ndi.gaussian_filter(img, sigma_d, order=(0, 1))   # derivative along x (columns)
    Iy = ndi.gaussian_filter(img, sigma_d, order=(1, 0))   # derivative along y (rows)
    Sxx = ndi.gaussian_filter(Ix * Ix, sigma_i)            # entries of the structure tensor M
    Syy = ndi.gaussian_filter(Iy * Iy, sigma_i)
    Sxy = ndi.gaussian_filter(Ix * Iy, sigma_i)
    det, tr = Sxx * Syy - Sxy ** 2, Sxx + Syy
    return det - k * tr ** 2                               # R > 0 corner, R < 0 edge, |R| small flat

img = util.img_as_float(data.camera())
R = harris(img)
corners = feature.corner_peaks(R, min_distance=7, threshold_rel=0.02)   # (row, col) list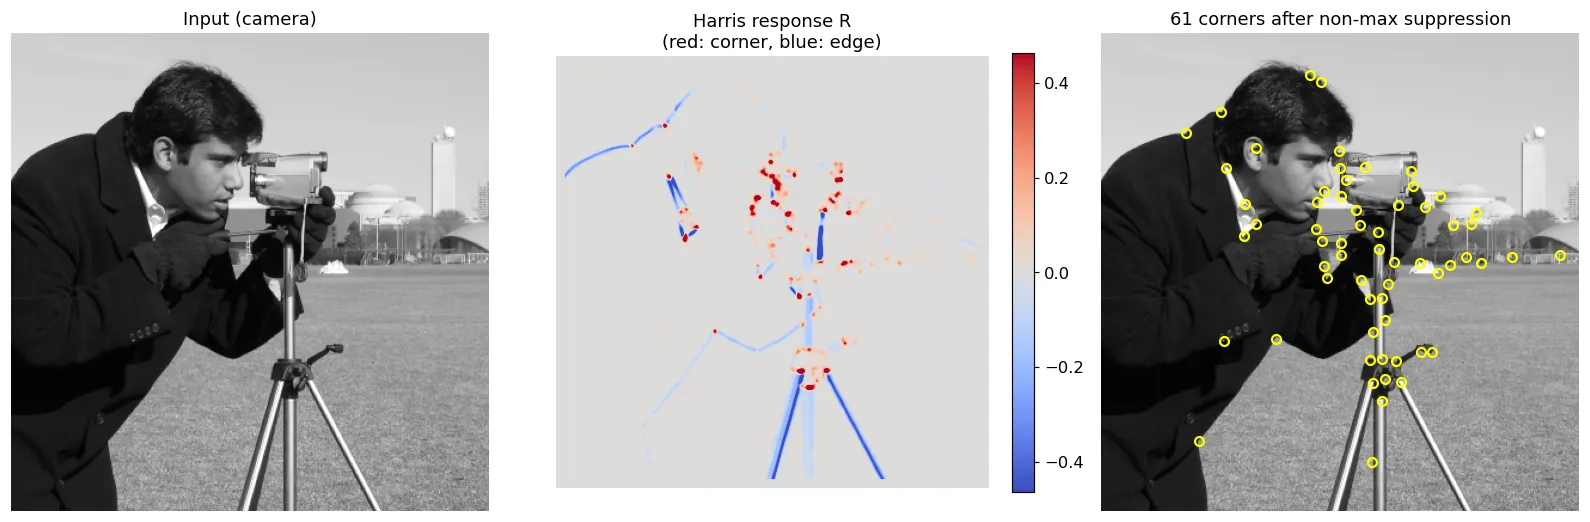
最大穩定極值區域(MSER)
白話版。 想像把一片灰階地形慢慢灌水。白紙上的黑字會變成一個個小湖。水位上升時,大部分湖泊會迅速擴大或彼此合併,但字母形成的湖,在很長一段水位範圍內都維持同樣形狀,因為墨水比周圍的紙暗得多。水位變化很大、形狀卻幾乎不變的區域,就是最大穩定的區域。Matas、Chum、Urban 與 Pajdla 為寬基線立體視覺提出了這個方法 [5]。
精確版。 在每個灰階 對影像做門檻化。(亮區域則為 )的一個連通成分稱為極值區域 :區域內每個像素都比它外圍邊界上的每個像素暗(或亮)。隨著 增加,成分逐漸長大、合併,形成一棵樹。對每個區域定義穩定度
其中 是面積, 是灰階步長。 出現局部最小值時,該區域就是最大穩定的。把像素依強度排序後,用 union-find 結構就能在接近線性的時間內建出整棵樹。
為什麼有效:這個定義只用到強度的大小順序,所以 MSER 對任何單調的亮度變化都不變。在連續的幾何變換下,連通區域仍映射成連通區域,所以 MSER 對仿射變換共變(常見做法是對每個區域擬合橢圓,再正規化成圓形後才描述)。MSER 最適合邊界清楚的均勻斑塊,例如文字、標誌、窗戶;在模糊或紋理繁雜的場景中表現較差。
import cv2
from skimage import data

img = data.page()                                    # uint8 grayscale
mser = cv2.MSER_create(delta=5, min_area=10, max_area=800, max_variation=0.5)
regions, boxes = mser.detectRegions(img)             # pixel lists + bounding boxes
print(len(regions), "regions")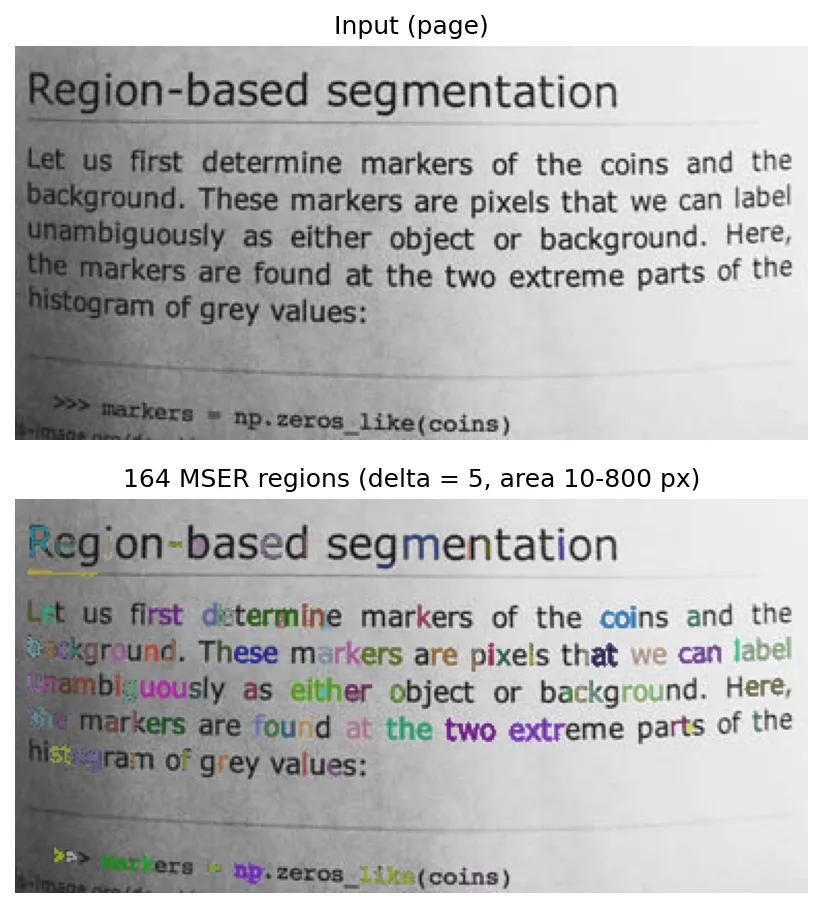
尺度不變特徵轉換(SIFT)
白話版。 Lowe 提出的 SIFT [6] 對每個地標回答三個問題:它在哪裡、它多大、它朝哪個方向?接著在這個地標自己的大小與方向下,寫下周圍梯度的摘要。如此一來,不論照片是近拍、遠拍、傾斜,還是光線較暗,這份摘要都一樣。
尺度空間
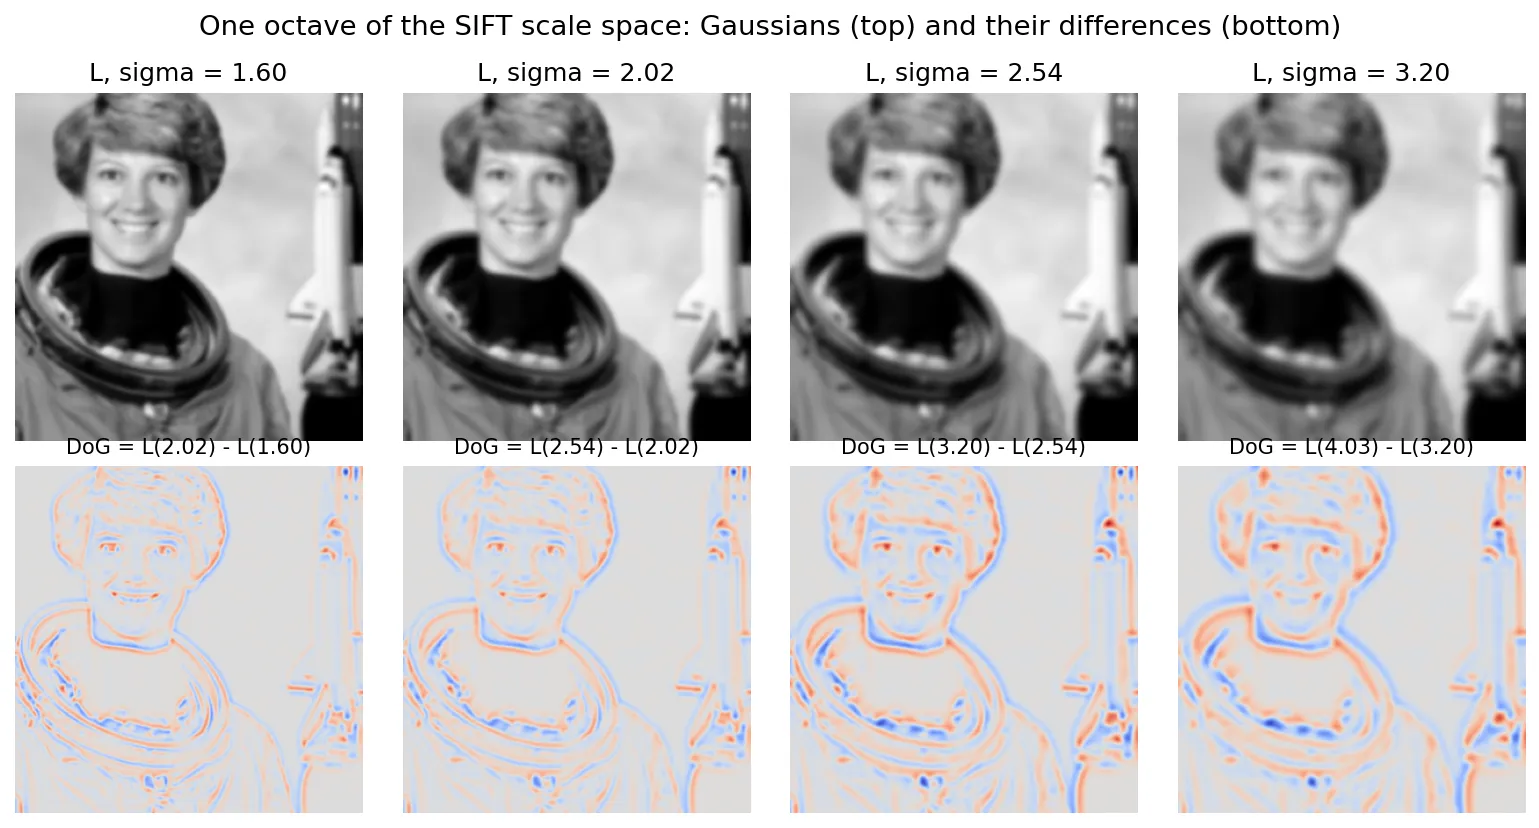
為了找出各種大小的特徵,SIFT 先建立尺度空間(scale space):用寬度越來越大的高斯核模糊影像,
其中 表示卷積, 是尺度。尺度分成好幾個八度(octave);每個八度讓 加倍,並切成 個間隔,所以相鄰尺度相差 倍。Lowe [6] 使用 與基礎尺度 。每完成一個八度就把影像降取樣一半,以節省計算。
以高斯差偵測關鍵點
把相鄰的模糊影像相減:
這個高斯差(difference of Gaussians, DoG)非常接近尺度正規化的高斯拉普拉斯 ,只差常數倍 。它對大小與 相符的斑塊反應最強(圖 12.7)。候選關鍵點是 值比全部 26 個鄰居都大或都小的像素:同一張 DoG 影像中的 8 個,加上上下兩個尺度各 9 個。因此每個關鍵點同時帶有位置和特徵尺度。
關鍵點定位
極值是在離散格點上找到的。為了精修位置,用泰勒展開對樣本點附近的 擬合三維二次函數,
其中 是相對於樣本點的偏移, 是極值在次像素、次尺度上的位置。接著用兩個測試剔除不穩定的點 [6]:
- 低對比:若 (強度範圍為 時)就捨棄。
- 邊緣響應:DoG 在邊緣上也有反應,但邊緣上的位置定不準。用 的 空間 Hessian 矩陣 ,只有在
時才保留,其中 限制兩個主曲率的比值;Lowe 使用 。這和 Harris 的想法相同:好的點必須在兩個方向上都彎得厲害。
方向指定
在關鍵點附近、以它的尺度在 上計算梯度大小與方向,建立 36 格(每格 10°)的方向直方圖;每個樣本以梯度大小加權,並乘上 為關鍵點尺度 1.5 倍的高斯窗。最高峰就是關鍵點的方向;其他超過最高峰 80% 的峰值,會產生同位置但方向不同的額外關鍵點 [6]。此後所有量測都相對於這個方向進行,因而得到旋轉不變性。
關鍵點描述子
在關鍵點周圍取一個窗口,依其方向旋轉、依其尺度決定大小,再切成 個格子。每個格子累積一個 8 格的梯度方向直方圖,以梯度大小與以關鍵點為中心的高斯加權,並用三線性內插,避免小小的位移造成數值在格子之間突然跳動。這樣得到 個數字 [6]。最後:
- 把向量正規化成單位長度(抵消 的對比變化;梯度本身已抵消 );
- 把每個元素截在 0.2 以下(限制少數超大梯度的影響,例如反光等非線性光照);
- 再正規化一次。
配對
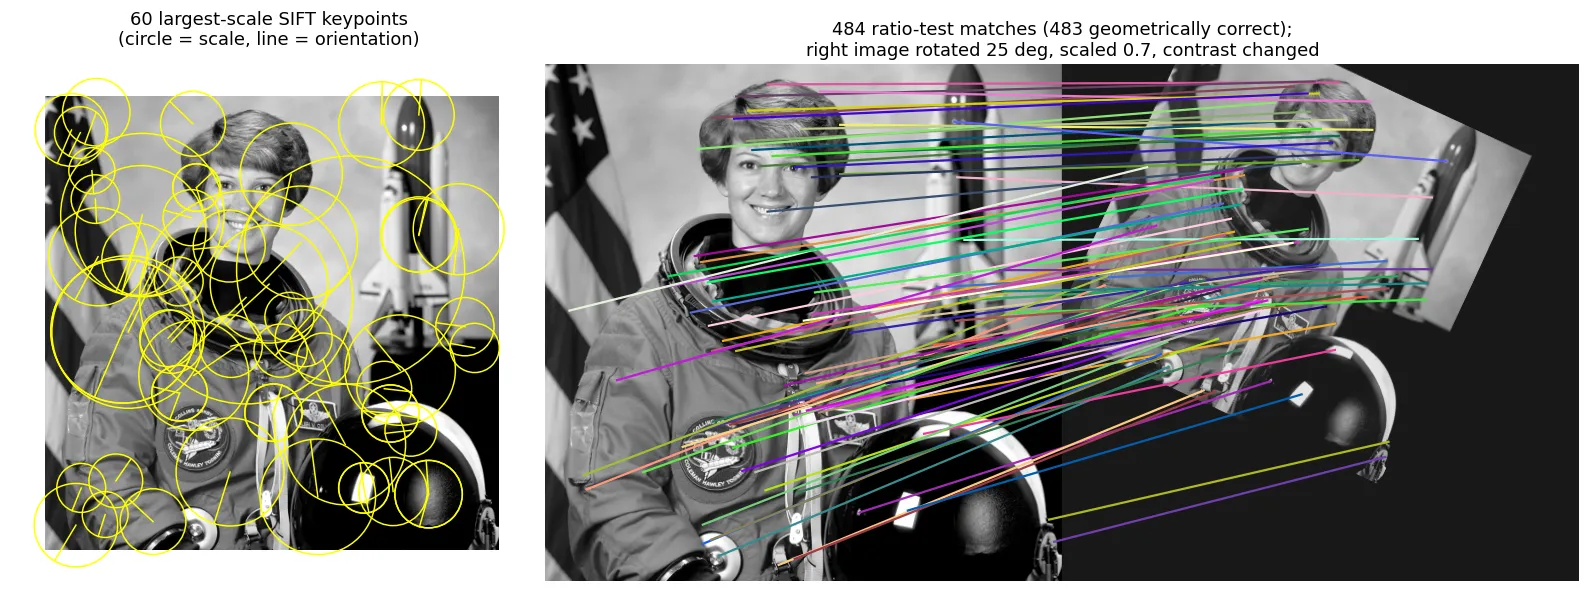
兩張影像的描述子用歐氏距離比較。只看最近鄰並不可靠:很多關鍵點根本沒有真正的對應點。Lowe 的比值測試(ratio test)只在
時保留配對,其中 是另一張影像中最近與次近的描述子, 是門檻(Lowe 建議 0.8)[6]。有鑑別力的配對會比第二名近得多。大型資料庫會改用近似最近鄰搜尋,而留下來的配對通常還要經過幾何驗證,例如用 RANSAC(random sample consensus,隨機取樣一致)[21] 擬合相似、仿射或投影轉換,只保留內點(inlier)。
import numpy as np
from skimage import data, feature, transform
from skimage.color import rgb2gray
from skimage.measure import ransac

img1 = rgb2gray(data.astronaut())
tf = transform.AffineTransform(scale=0.7, rotation=np.deg2rad(25), translation=(140, -60))
img2 = 0.8 * transform.warp(img1, tf.inverse) + 0.1        # second "view"

sift = feature.SIFT()
sift.detect_and_extract(img1); k1, d1 = sift.keypoints, sift.descriptors
sift.detect_and_extract(img2); k2, d2 = sift.keypoints, sift.descriptors

matches = feature.match_descriptors(d1, d2, max_ratio=0.6, cross_check=True)  # ratio test
src, dst = k1[matches[:, 0]][:, ::-1], k2[matches[:, 1]][:, ::-1]           # (row, col) -> (x, y)
model, inliers = ransac((src, dst), transform.SimilarityTransform,
                        min_samples=3, residual_threshold=2, max_trials=500)
print(len(matches), "matches,", inliers.sum(), "inliers")
print("recovered scale %.3f, rotation %.1f deg" % (model.scale, np.degrees(model.rotation)))
在這組合成影像上,程式找到 484 個配對,其中 483 個與真正的轉換一致,並還原出尺度 0.700、旋轉 25.0°。真實照片有視角變化、遮擋和重複圖樣,內點比例會低得多,所以幾何驗證絕對不能省。
現代觀點
綜述論文怎麼說
形狀描述子。 Zhang 與 Lu 的綜述 [9] 沿兩個軸分類形狀描述子:以輪廓為主或以區域為主,以及全域式(整個形狀一個向量)或結構式(把形狀拆成基本單元)。本章前半段的方法都能放進這個表格:鏈碼與多邊形是結構式輪廓方法;傅立葉描述子與邊界動差是全域式輪廓方法;面積、尤拉數與 Hu 動差是全域式區域方法;骨架則是結構式區域方法。綜述對每種技術說明實作方式,並列出優缺點;實務上的訊息是:沒有一種描述子適用於所有應用,該選哪一種,取決於任務需要哪些不變性、需要多少細節。
局部特徵偵測器。 Tuytelaars 與 Mikolajczyk [10] 綜述了興趣點與區域偵測器:角點偵測器(Harris 及其尺度、仿射調適版本)、斑點偵測器(Laplacian/DoG、Hessian)與區域偵測器(MSER 等)。他們以好的局部特徵應具備的性質來組織這個領域:可重複性(repeatability)、鑑別性(distinctiveness)、局部性(locality)、數量、準確度與效率。他們指出,最重要的可重複性可以用兩種方式達成:不變性(用數學模型描述大的形變,再設計不受其影響的偵測器)或強健性(容忍雜訊、模糊、壓縮等小的形變)。他們也提醒,有些性質彼此競爭:鑑別性與局部性無法同時最大化,因為越局部的特徵看到的強度圖樣越少,也就越難正確配對;該怎麼取捨要看應用。SIFT 的兩個重速度的後繼者正是用準確度換時間的例子:SURF [7] 在積分影像上用方框濾波器近似高斯導數,ORB [8] 結合 FAST 角點測試與有方向性的二元描述子,以漢明距離比較,快到可以在手機上執行。
紋理。 Liu 等人 [11] 回顧了約二十年的紋理分類表示法,分為詞袋(bag-of-words)流程(局部描述子、編碼與池化)、以 CNN 為基礎的方法,以及以屬性為基礎的方法。共生統計 [3] 位在這段歷史的源頭:它們是第一批被廣泛使用的「像素對」描述子。這篇涵蓋兩百多篇論文的綜述,描繪了領域如何從以詞袋編碼的手工局部描述子,轉向以 CNN 特徵為基礎的表示法,最後並整理了尚待解決的問題與未來方向。
影像配對:從手工到深度。 Ma 等人 [12] 沿著完整的配對流程(偵測、描述、配對與離群值剔除),從手工方法談到可訓練的方法,並在標準資料集上做實驗比較;可以看到學習已經進入流程的每一個階段,而不只是描述子。Jin 等人 [13] 建立了一個以最終相機姿態準確度、而非中間指標來評分的基準。他們的關鍵發現是一個警訊:只要把每種方法的設定(比值門檻、RANSAC 參數、關鍵點數量)調好,像 SIFT 這樣的傳統流程仍可能勝過被視為最先進的方法,這暗示部分已發表的進步其實反映了沒調好的基準線。
深度學習如何改變特徵擷取
學習式關鍵點與描述子。 SuperPoint [14] 訓練一個全卷積網路,同時輸出關鍵點熱度圖與稠密描述子。它是自我監督的:先在合成形狀上學會角點,再透過單應性調適(homographic adaptation)——把同一張影像做許多次隨機變形並彙整自己的偵測結果——在真實影像上自我改進。DISK [16] 用強化學習(策略梯度)端到端地訓練偵測與描述,獎勵那些能帶來正確配對的關鍵點。它們用學來的函數取代 Harris 與 SIFT 的公式,但保留了相同的概念:稀疏、可重複的點,加上描述子。
學習式配對。 SuperGlue [15] 以圖神經網路取代最近鄰比值測試,讓兩張影像的關鍵點彼此注意(attend),再解一個能回答「沒有配對」的最佳傳輸(optimal transport)指派問題。LightGlue [18] 改寫這個設計,使它更快且能自我調適,在容易的影像對上花較少計算。LoFTR [17] 乾脆拿掉偵測器:以具有自注意力與交叉注意力的 Transformer 在粗特徵圖上做稠密配對,再精修位置,這對偵測器找不到東西的低紋理區域特別有幫助。
通用深度特徵。 最深遠的改變是:特徵越來越不是為某個任務設計的。像 DINOv2 [19] 這樣的自我監督基礎模型所產生的區塊(patch)特徵,不需微調就能用於分類、分割、深度估計與檢索。RoMa [20] 展示了它對配對的影響:以凍結的 DINOv2 特徵做粗配對,再結合細緻的卷積特徵做精確定位。換句話說,SIFT 核心那個手工設計的描述子,已經被一個在極大量影像上訓練出的網路取代。
沒有改變的部分。 本章的問題拆解方式依然存在。現代流程仍然是偵測、描述、配對、再做幾何驗證,而且通常仍使用 RANSAC 類的強健估計器 [21]。尺度與旋轉仍然必須處理,不是內建(SIFT 的尺度空間、ORB 的方向),就是透過資料擴增讓模型學會。不變性依然是設計選擇:過度不變的描述子會失去鑑別力,無論它是手工設計還是學出來的。在以量測為主的領域(材料、顯微影像、品質檢測),面積、圓度、尤拉數與 GLCM 統計等區域描述子仍然很受歡迎,因為每個數字都有人可以檢查的物理意義。
重點整理
- 偵測器找出特徵(點、區域、邊界);描述子把每個特徵轉成向量。偵測器應對幾何變化共變,描述子應對任務中無關緊要的變化不變。
- 邊界要先排序(邊界追蹤)、再簡化(鏈碼、最小周長多邊形、合併與分裂、標記圖、骨架),之後才拿來量測。
- 傅立葉描述子用少數係數壓縮封閉輪廓;丟掉 、除以 、只取大小,就得到平移、尺度、旋轉與起點不變性。
- 區域描述子從大小與形狀(面積、圓度、離心率)、拓撲(尤拉數 )、紋理(直方圖動差、GLCM 特徵、頻譜)一路到 Hu 動差不變量。
- PCA(Hotelling 轉換)讓量測去相關、把物體轉到主軸方向,並提供精簡的特徵影像描述子;丟掉分量造成的誤差等於被丟掉的特徵值總和。
- Harris 由結構張量找角點;MSER 找在多個門檻下都穩定的區域;SIFT 加上尺度空間、方向與正規化的 128 維梯度直方圖,再以比值測試配對。
- 學習式偵測器、配對器與基礎模型特徵如今是多數配對研究的焦點,但仔細調整的傳統流程仍是強勁的基準線,而「偵測—描述—配對—驗證」的架構並未改變。
練習
- 手算鏈碼。 寫出一個與座標軸對齊、寬 3 節、高 2 節的長方形邊界的 8 方向鏈碼,從左下角出發、逆時針行走。算出它的一階差分與形狀數(最小循環位移)。再把長方形轉 90°,說明形狀數不變。
提示
從左下角逆時針走(0 = 東、2 = 北):。一階差分的每個元素是相對前一個方向逆時針轉了幾格:(開頭的 2 來自首尾相接的 )。最小循環位移為 。轉 90° 後每個碼都加 2(mod 8),差分不變。
- 實測傅立葉描述子的不變性。 使用本章的
fourier_descriptor函數。(a) 用數值說明它無法分辨形狀與其鏡像。(b) 從轉換效果表解釋原因,並提出一個能分辨鏡像的修改。
提示
用 mask[:, ::-1] 翻轉遮罩,並用 find_contours 追蹤兩條輪廓;兩組描述子的差距約在 以內。追蹤器總是以相同的旋轉方向走過每條邊界,因此鏡像邊界是 (共軛且反向),最多差一個位移。它的 DFT 是 :大小相同、相位相反,所以只看大小看不出鏡射。改為保留部分相位:複數 (索引取模 )不受平移、旋轉、尺度與起點影響,但在鏡射下會變成共軛,因此它虛部的正負號就能區分形狀與其鏡像。
- 格點上的圓度。 用
skimage.draw.disk與regionprops計算半徑 5、10、20、50 像素的數位圓盤之 。為什麼結果不完全等於 1?它如何隨半徑變化?也試試perimeter_crofton。
提示
數位周長是階梯狀的,不同估計方法用不同方式修正。小圓盤的相對誤差較大。兩種周長估計都列出來,其中一種應該明顯更接近真正的 。
- 紋理的方向。 做一張週期 8 像素的水平條紋合成紋理,加一點雜訊。計算 0°、45°、90°、135° 四個角度、位移 1 像素的 GLCM 對比,以及角度頻譜標記 。兩者各自哪個角度最突出?為什麼兩種方法的結論一致?
提示
沿著條紋(0°)移動時強度幾乎不變,對比低;橫越條紋(90°)才會變。頻譜中,水平條紋的能量落在垂直頻率軸上。注意慣例:scikit-image 的角度 0 代表水平方向的像素位移。
- 以特徵值理解 PCA。 對半軸 、 的實心橢圓,預測座標共變異數特徵值的比 ,再用程式驗證。用你的答案說明 與
regionprops回報的離心率之間的關係。
提示
均勻實心橢圓沿長度為 的半軸方向,變異數為 。所以 ,而 。
- 比值測試的取捨。 使用 SIFT 配對程式,把
max_ratio從 0.5 調到 0.95,畫出 (a) 配對數量與 (b) RANSAC 內點比例。接著加上 0.6 倍縮放、30° 旋轉與高斯雜訊()再做一次。你會把門檻設在哪裡?為什麼答案取決於雜訊?
提示
寬鬆的比值會收進更多配對,但錯的也更多;嚴格的比值只留下少數、多半正確的配對。RANSAC 能容忍大量離群值,但需要最低數量的正確配對,所以最佳門檻落在兩個極端之間,並隨影像品質移動。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 12. publisher page
- M.-K. Hu, “Visual pattern recognition by moment invariants,” IRE Transactions on Information Theory, vol. 8, no. 2, pp. 179–187, 1962. doi
- R. M. Haralick, K. Shanmugam, and I. Dinstein, “Textural features for image classification,” IEEE Transactions on Systems, Man, and Cybernetics, vol. SMC-3, no. 6, pp. 610–621, 1973. doi
- C. Harris and M. Stephens, “A combined corner and edge detector,” in Proc. Alvey Vision Conference, pp. 23.1–23.6, 1988. doi
- J. Matas, O. Chum, M. Urban, and T. Pajdla, “Robust wide-baseline stereo from maximally stable extremal regions,” Image and Vision Computing, vol. 22, no. 10, pp. 761–767, 2004. doi
- D. G. Lowe, “Distinctive image features from scale-invariant keypoints,” International Journal of Computer Vision, vol. 60, no. 2, pp. 91–110, 2004. doi
- H. Bay, A. Ess, T. Tuytelaars, and L. Van Gool, “Speeded-up robust features (SURF),” Computer Vision and Image Understanding, vol. 110, no. 3, pp. 346–359, 2008. doi
- E. Rublee, V. Rabaud, K. Konolige, and G. Bradski, “ORB: An efficient alternative to SIFT or SURF,” in Proc. IEEE International Conference on Computer Vision (ICCV), pp. 2564–2571, 2011. doi
- D. Zhang and G. Lu, “Review of shape representation and description techniques,” Pattern Recognition, vol. 37, no. 1, pp. 1–19, 2004. doi
- T. Tuytelaars and K. Mikolajczyk, “Local invariant feature detectors: A survey,” Foundations and Trends in Computer Graphics and Vision, vol. 3, no. 3, pp. 177–280, 2008. doi
- L. Liu, J. Chen, P. Fieguth, G. Zhao, R. Chellappa, and M. Pietikäinen, “From BoW to CNN: Two decades of texture representation for texture classification,” International Journal of Computer Vision, vol. 127, pp. 74–109, 2019. arXiv
- J. Ma, X. Jiang, A. Fan, J. Jiang, and J. Yan, “Image matching from handcrafted to deep features: A survey,” International Journal of Computer Vision, vol. 129, pp. 23–79, 2021. doi
- Y. Jin, D. Mishkin, A. Mishchuk, J. Matas, P. Fua, K. M. Yi, and E. Trulls, “Image matching across wide baselines: From paper to practice,” International Journal of Computer Vision, 2021. doi · arXiv
- D. DeTone, T. Malisiewicz, and A. Rabinovich, “SuperPoint: Self-supervised interest point detection and description,” arXiv:1712.07629, 2017. arXiv
- P.-E. Sarlin, D. DeTone, T. Malisiewicz, and A. Rabinovich, “SuperGlue: Learning feature matching with graph neural networks,” arXiv:1911.11763, 2019. arXiv
- M. J. Tyszkiewicz, P. Fua, and E. Trulls, “DISK: Learning local features with policy gradient,” arXiv:2006.13566, 2020. arXiv
- J. Sun, Z. Shen, Y. Wang, H. Bao, and X. Zhou, “LoFTR: Detector-free local feature matching with Transformers,” arXiv:2104.00680, 2021. arXiv
- P. Lindenberger, P.-E. Sarlin, and M. Pollefeys, “LightGlue: Local feature matching at light speed,” arXiv:2306.13643, 2023. arXiv
- M. Oquab, T. Darcet, T. Moutakanni, et al., “DINOv2: Learning robust visual features without supervision,” arXiv:2304.07193, 2023. arXiv
- J. Edstedt, Q. Sun, G. Bökman, M. Wadenbäck, and M. Felsberg, “RoMa: Robust dense feature matching,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024. arXiv
- M. A. Fischler and R. C. Bolles, “Random sample consensus: A paradigm for model fitting with applications to image analysis and automated cartography,” Communications of the ACM, vol. 24, no. 6, pp. 381–395, 1981. doi