第 5 章・影像復原與重建
先備知識: 第 4 章・頻域濾波
你將學到
- 如何把影像受到的傷害寫成模型 ,以及這個模型為什麼把「復原」和「增強」區分開來
- 常見的雜訊模型、如何從直方圖辨認它們,以及如何從平坦區塊量測雜訊參數
- 不同雜訊該配哪一種空間濾波器:平均濾波器、次序統計濾波器與自適應濾波器
- 如何在頻域用陷波濾波器(notch filter)去除週期性干擾
- 如何估計模糊並用逆濾波、Wiener 濾波、受限最小平方與幾何平均濾波器還原,以及為什麼直接相除會失敗
- CT 掃描儀如何把一組一維投影變回二維斷層:Radon 轉換、傅立葉切片定理與濾波反投影
先看全貌
第 3、4 章的目標是讓影像「看起來」更好。本章問的是更嚴格的問題:影像在受損之前原本長什麼樣子? 要回答它,必須先有一個描述傷害的模型。有了模型,還原就變成一個定義清楚(至少是被充分理解)的數學問題。本章依照 Gonzalez 與 Woods 教科書的編排 [1]。
只要真實場景才是重點,就需要復原:天文、顯微鏡、鑑識照片、醫學影像,以及每一支手機的相機處理流程。本章最後的「從投影重建影像」是同一個想法推到極致:CT 掃描儀根本看不到斷層本身,只看得到它從許多角度投下的「影子」,我們必須從這些影子重建出斷層。
影像退化/復原過程的模型
白話說:相機看到的是場景稍微模糊後的版本,上面再疊一層隨機雜訊。復原就是設法把場景找回來。
我們把退化寫成
其中 是理想(未知)的影像, 是退化函數,也稱為點擴散函數(point spread function, PSF), 代表二維卷積, 是加成性雜訊, 是我們實際觀測到的影像。依第 4 章的卷積定理,同一個模型在頻域是
其中大寫字母代表對應小寫函數的二維離散傅立葉轉換(DFT), 是頻率座標。 稱為光學轉移函數(optical transfer function, OTF)。
復原的目標是求出一個估計 ,讓它盡可能接近 。我們對 和 知道得越多,就能越接近。
復原與增強的差別
增強(第 3、4 章)大多是主觀的:調整對比或銳化,直到觀看者覺得好看為止。復原則是客觀的:它使用退化模型,並以結果和真實影像有多接近來評判,通常用可量測的準則,例如均方誤差。有些工具在兩章都會出現(例如中值濾波器),但使用的理由不同。在復原裡,我們挑某個濾波器,是因為雜訊模型告訴我們它是對的選擇。
本章先處理 (沒有模糊、只有雜訊)的情況,再加入模糊。
雜訊模型
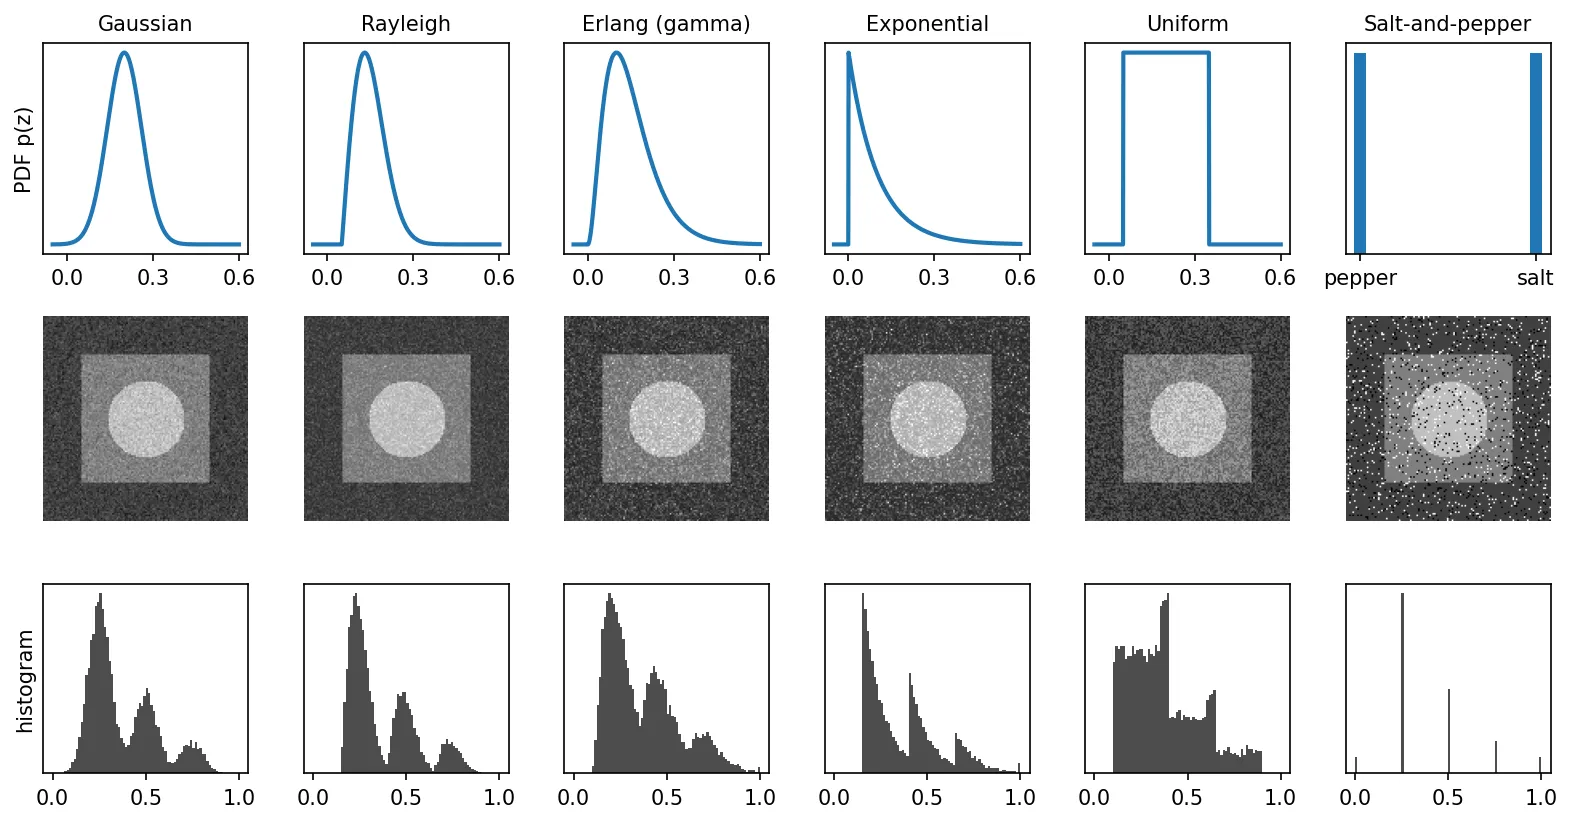
白話說:雜訊是疊在畫面上的隨機「顆粒」。不同的感測器與情境會產生不同的顆粒,每一種在直方圖上都有自己的指紋。
雜訊的空間與頻率特性
描述雜訊要問兩件事。空間上:某個像素的雜訊和鄰居的雜訊有沒有關聯?和影像本身有沒有關聯?除非特別說明,本章假設雜訊與位置無關,也與影像不相關。頻率上:雜訊的功率如何分布在 上?傅立葉頻譜大致為常數的雜訊稱為白雜訊(white noise),名稱來自包含所有可見光頻率的白光。週期性雜訊正好相反:它的功率集中在少數幾個孤立的頻率。
在這些假設下,雜訊完全由其數值的機率密度函數(probability density function, PDF) 描述, 代表強度值。
常見的 PDF
高斯(Gaussian)。 最常用的模型,因為數學上方便,也很符合電子感測器的雜訊:
其中 為平均值, 為標準差( 為變異數)。約 68% 的值落在 之內,約 95% 落在 之內。
Rayleigh。 單邊、偏斜的密度,用來描述距離成像(range imaging)中的雜訊:
其中 決定起點位置, 控制分散程度。
Erlang(gamma)。 同樣偏斜,但尾巴更長:
其中 是速率, 是正整數(形狀參數)。允許 為非整數,就得到一般的 gamma 密度。
指數(exponential)。 即 的 Erlang 密度:
它出現在雷射成像(斑點強度)中。
均勻(uniform)。 區間 內每個值出現的機率相同:
它主要用於模擬(量化誤差近似均勻分布)。
椒鹽(脈衝)雜訊(salt-and-pepper / impulse noise)。 每個像素要嘛不變,要嘛以機率 被換成很亮的值(鹽),或以機率 被換成很暗的值(胡椒)。被破壞的像素比例 稱為雜訊密度。故障的感測元件與傳輸位元錯誤會產生這種雜訊。它和其他雜訊不同,不是加上去的,而是取代原本的像素值。
週期性雜訊
擷取影像時的電氣或機電干擾,可能在影像上疊加一個像 的正弦波,其中 為振幅, 為頻率, 為影像大小。它與位置相關,所以無法用 PDF 描述。不過在傅立葉頻譜中,每個正弦波都是位於 的一對亮點,因此在頻域很容易去除(見下方的週期性雜訊消除)。
估計雜訊參數
如果你能控制成像系統,就拍一張均勻照明的平坦目標:看到的一切都是雜訊。如果手上只有影像,就找一個本來應該是常數的小區域 (天空、空白牆面、背景),計算它的直方圖 ,也就是 中強度為 的像素比例。接著
區塊直方圖的形狀告訴你該用哪一種 PDF,平均值與變異數再決定參數(Rayleigh、Erlang 的 和 等)。對脈衝雜訊,則計算落在極端值的像素數量來估計 與 。
import numpy as np
from skimage import data, img_as_float

rng = np.random.default_rng(0)
f = img_as_float(data.camera())                  # values in [0, 1]

g_gauss = f + rng.normal(0.0, 0.05, f.shape)     # additive Gaussian, sigma = 0.05
g_unif = f + rng.uniform(-0.1, 0.1, f.shape)     # additive uniform on [-0.1, 0.1]
g_sp = f.copy()
r = rng.random(f.shape)
g_sp[r < 0.05] = 0.0                             # 5 % pepper
g_sp[r > 0.95] = 1.0                             # 5 % salt

# Estimate the noise from a patch that should be flat (here: sky, top-left)
patch = g_gauss[10:60, 10:60]
print(f"mean = {patch.mean():.3f}, std = {patch.std():.3f}")   # std close to 0.05
只有雜訊時的復原:空間濾波
白話說:如果唯一的問題是雜訊,就把每個像素換成它鄰域的一個「聰明摘要」。最好的摘要方式取決於雜訊種類。
沒有模糊時,模型簡化為 (脈衝雜訊則是取代)。以下 是以 為中心的 視窗, 走遍視窗內的像素。
平均濾波器
算術平均(arithmetic mean):一般的平均:
它能降低高斯或均勻雜訊,但會模糊邊緣。
幾何平均(geometric mean):乘積開 次方根:
平滑效果與算術平均相近,但細節損失較少。
調和平均(harmonic mean):
它能處理鹽雜訊與類高斯雜訊,但對胡椒雜訊完全失效,因為只要一個接近 0 的像素,就會主宰倒數和。
階反調和平均(contraharmonic mean):
稱為階數。 為正時去除胡椒雜訊,為負時去除鹽雜訊,無法同時去除兩者。 即算術平均, 即調和平均。正負號選錯會造成災難,如圖 5.2 所示。
次序統計濾波器
這類濾波器把 內的像素排序,再從排序結果中挑值。
- 中值(median):。處理脈衝雜訊最好用的通用工具。它能去除孤立的離群值,模糊程度遠小於同尺寸的平均濾波器。
- 最大值(max) 與 最小值(min):取最大與最小值。最大值濾波器去除胡椒(暗)雜訊,最小值濾波器去除鹽(亮)雜訊。
- 中點(midpoint):。結合排序與平均,適合高斯或均勻雜訊。
- alpha 修剪平均(alpha-trimmed mean):去掉最低與最高各 個值,再對剩下的 個值 取平均:
時是算術平均, 時是中值。介於兩者之間時,它能處理混合雜訊,例如高斯雜訊加上少量脈衝。
import numpy as np
from scipy import ndimage as ndi

def arithmetic_mean(g, m=3):
    return ndi.uniform_filter(g, m)

def geometric_mean(g, m=3):
    return np.exp(ndi.uniform_filter(np.log(g + 1e-6), m))

def harmonic_mean(g, m=3):
    return 1.0 / ndi.uniform_filter(1.0 / (g + 1e-6), m)

def contraharmonic_mean(g, m=3, Q=1.5):
    g = g + 1e-6                                  # avoid 0 ** negative
    return ndi.uniform_filter(g ** (Q + 1), m) / ndi.uniform_filter(g ** Q, m)

def alpha_trimmed_mean(g, m=5, d=6):
    def trim(v):
        v = np.sort(v)
        return v[d // 2: v.size - d // 2].mean()
    return ndi.generic_filter(g, trim, size=m)

median = lambda g, m=3: ndi.median_filter(g, m)
maxf = lambda g, m=3: ndi.maximum_filter(g, m)    # removes pepper
minf = lambda g, m=3: ndi.minimum_filter(g, m)    # removes salt
midpoint = lambda g, m=3: 0.5 * (maxf(g, m) + minf(g, m))
自適應濾波器
上面的濾波器對每個像素一視同仁。自適應濾波器則依 內的局部統計量改變行為,通常只需多花一點計算就能表現更好。
自適應局部雜訊消除濾波器(adaptive, local noise reduction filter)。 令 為雜訊變異數(整張影像估計一次), 與 為 內的局部平均與局部變異數。濾波器為
可以分三種情況理解。若 ,表示沒有雜訊,濾波器原封不動傳回 。若局部變異數遠大於雜訊變異數,視窗裡很可能有邊緣,濾波器就保持接近 ,保住邊緣。若兩個變異數相等,視窗是平坦區域,濾波器傳回局部平均。實務上會把比值上限截在 1,因為局部變異數的估計值可能碰巧比 小。
自適應中值濾波器(adaptive median filter)。 固定尺寸的中值濾波器在脈衝稀疏時效果很好;雜訊密度一高,一個視窗裡的脈衝可能比真實像素還多,而加大固定視窗又會把一切都模糊掉。自適應中值濾波器在需要時才放大視窗,而且不去動沒有被污染的像素。令 、、 為 內的最小、最大與中值, 為中心像素, 為允許的最大視窗尺寸 [2]。
- 階段 A: 若 ,中值不是脈衝,進入階段 B。否則放大視窗;若尺寸超過 ,輸出 ;否則重複階段 A。
- 階段 B: 若 ,中心像素不是脈衝,原樣輸出 。否則輸出 。
這樣同時達成三個目標:去除脈衝、平滑其他雜訊,並減少一般中值濾波造成的邊緣變細與模糊。
import numpy as np
from scipy import ndimage as ndi

def adaptive_local(g, noise_var, m=7):
    """Adaptive local noise reduction: f = g - (s_n^2 / s_L^2)(g - m_L)."""
    mean = ndi.uniform_filter(g, m)
    var = ndi.uniform_filter(g * g, m) - mean ** 2
    ratio = np.minimum(noise_var / np.maximum(var, 1e-12), 1.0)  # never above 1
    return g - ratio * (g - mean)

def adaptive_median(g, s_max=7):
    out, done = g.copy(), np.zeros(g.shape, bool)
    for s in range(3, s_max + 1, 2):
        zmin, zmax = ndi.minimum_filter(g, s), ndi.maximum_filter(g, s)
        zmed = ndi.median_filter(g, s)
        stage_a = (zmin < zmed) & (zmed < zmax) & ~done          # median is not an impulse
        keep = (zmin < g) & (g < zmax)                            # centre pixel is not an impulse
        out[stage_a] = np.where(keep, g, zmed)[stage_a]
        done |= stage_a
    out[~done] = zmed[~done]                                      # window grew to s_max
    return out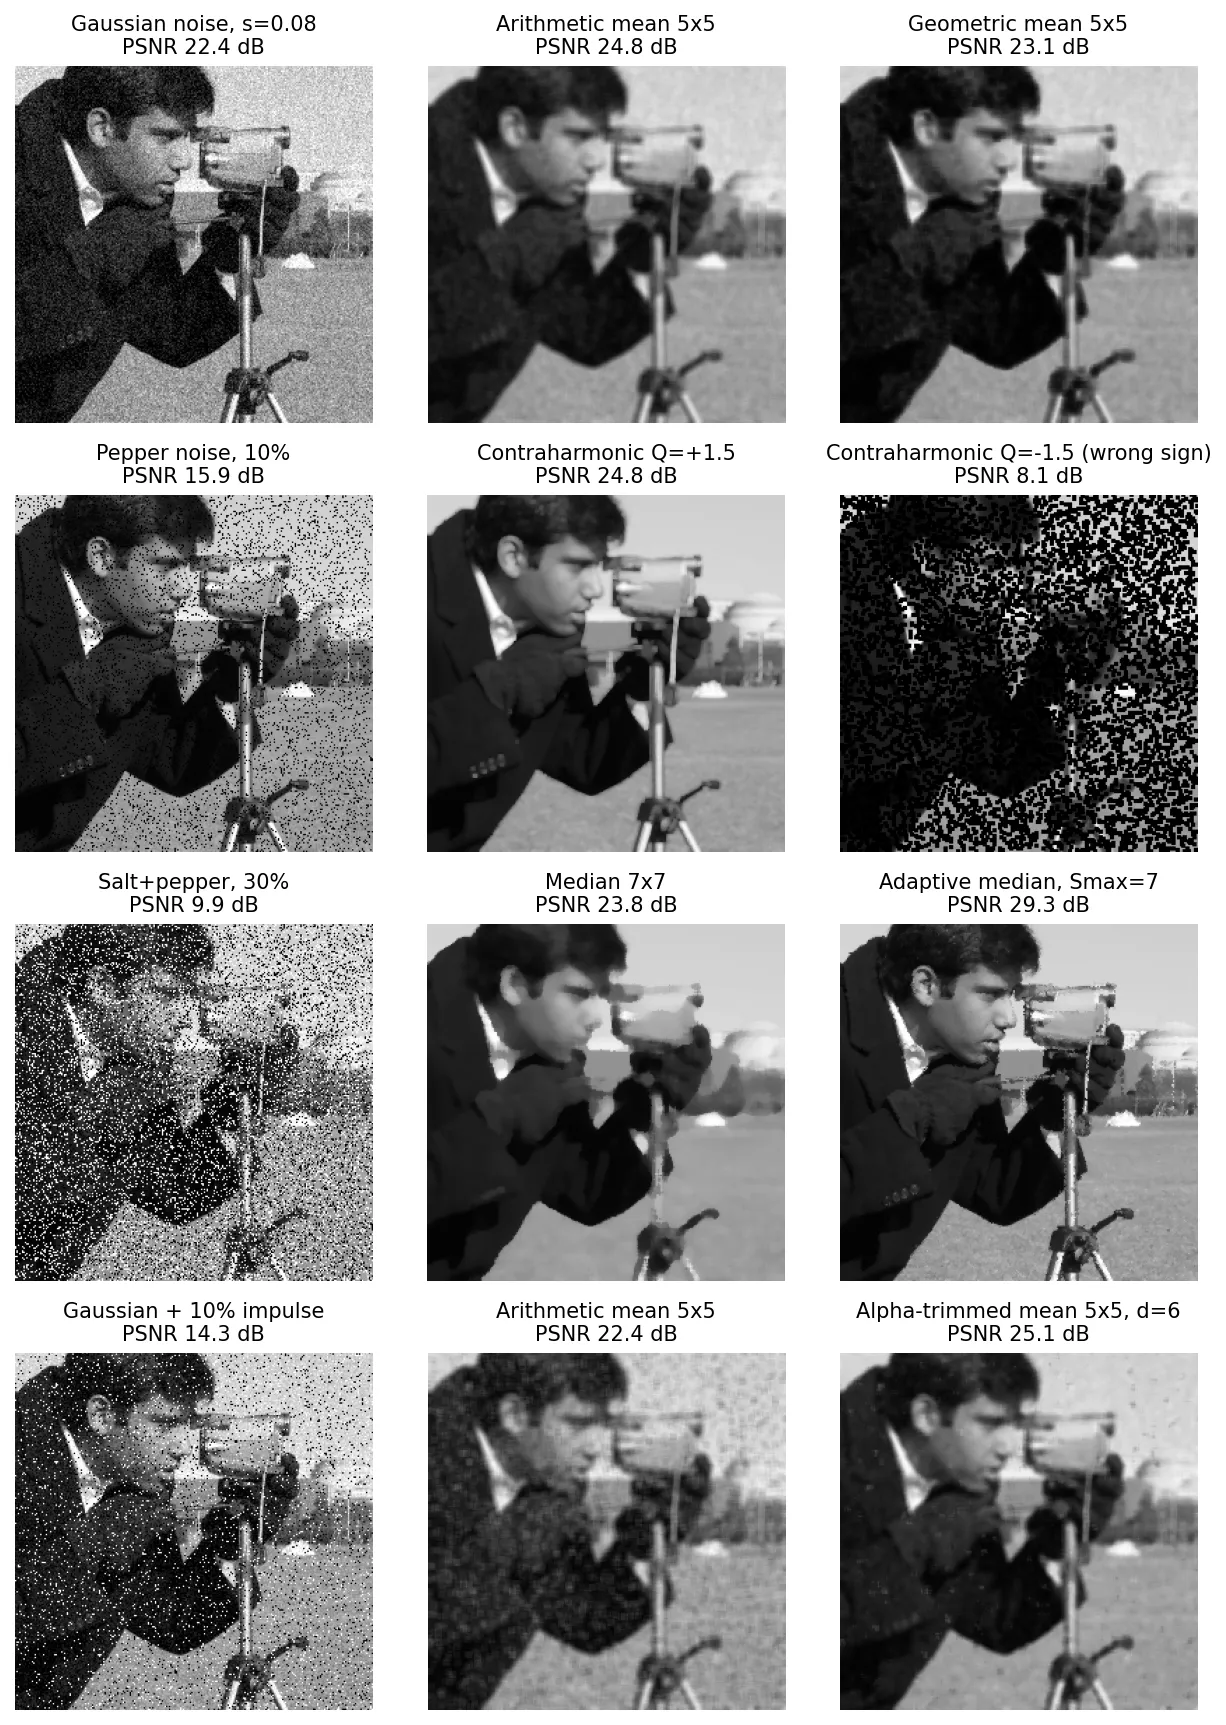
以頻域濾波消除週期性雜訊
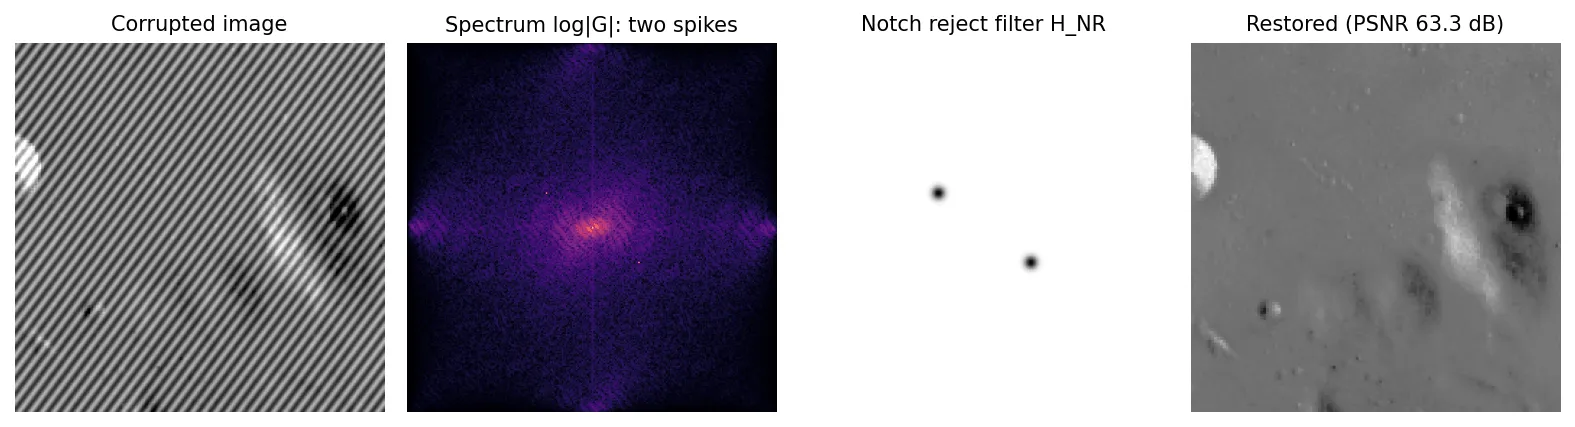
白話說:週期性雜訊是藏在影像裡的幾個純「音調」。它們在頻譜上是亮點,所以我們只挖掉那幾個點,其他一律保留。
陷波拒斥與陷波通過濾波器
陷波濾波器(notch filter)會拒斥(或通過)以指定中心為圓心的小鄰域內的頻率。由於實數影像的 DFT 具有共軛對稱性,陷波一定成對出現,相對頻譜中心位於 與 。具有 對陷波的陷波拒斥濾波器,是一組中心被移到陷波位置的高通濾波器的乘積:
其中 與 是中心分別在 與 的高通濾波器(理想、Butterworth 或高斯,同第 4 章)。例如高斯陷波使用 , 是 到 的距離, 是陷波半徑。對應的陷波通過濾波器為
陷波通過濾波器本身也很有用:把它乘上 再轉回空間域,就得到只有干擾圖樣的影像。其他形狀的陷波(例如沿座標軸的細線)可去除掃描線圖樣。
import numpy as np
from skimage import data, img_as_float

f = img_as_float(data.moon())
M, N = f.shape
y, x = np.mgrid[:M, :N]
g = f + 0.2 * np.sin(2 * np.pi * (40 * y / M + 25 * x / N))    # periodic interference

G = np.fft.fftshift(np.fft.fft2(g))
U, V = np.mgrid[-M // 2:M // 2, -N // 2:N // 2]
H = np.ones((M, N))
for u0, v0 in [(40, 25), (-40, -25)]:                         # a spike and its mirror
    D2 = (U - u0) ** 2 + (V - v0) ** 2
    H *= 1 - np.exp(-D2 / (2 * 3.0 ** 2))                     # Gaussian notch, radius ~3
f_hat = np.real(np.fft.ifft2(np.fft.ifftshift(H * G)))
最佳陷波濾波
當干擾成分很多,或者它們不是尖銳的亮點時,單純的陷波濾波器不是去得不夠,就是連真實影像內容一起切掉。最佳陷波濾波(optimum notch filtering)分兩步。第一步,用陷波通過濾波器分離出干擾的估計:
其中 是反 DFT。第二步,減去它的加權版本,而權重隨位置改變:
權重 的選法是讓 盡可能平滑:讓每個像素周圍小視窗內 的變異數最小。把這個局部變異數對 微分並令其為零,得到
每個上橫線代表視窗內的局部平均。分子是 與 的局部共變異數,分母是 的局部變異數。所以在影像和估計出的圖樣一起變動的地方減得多,不同步的地方減得少。
線性、位置不變的退化
白話說:我們假設模糊是「公平」的。光線加倍,模糊後的光也加倍;而且左上角的模糊和右下角的一樣。
把(不含雜訊的)退化寫成運算子 ,即 。若對任意影像 與常數 都有
則 是線性的。若平移輸入只會平移輸出,
對任意平移量 都成立,則 是位置不變的。對這種運算子,把 寫成許多平移脈衝的和。線性讓我們可以分別對每個脈衝套用 ,位置不變則保證每個脈衝都產生相同的響應 ,只是位置不同。把這些響應加總,正是卷積:
這裡 是脈衝響應,在光學中就是點擴散函數:單一光點所成的像。這就是為什麼還原模糊影像常被稱為反卷積(deconvolution),也是下面的濾波器都在頻域建構的原因。
許多真實退化只是近似線性位置不變(LPI)。鏡頭在影像角落可能更模糊,在靜止背景前移動的物體也和背景模糊得不一樣。空間變異的復原方法存在,但代價高得多;常見的變通是把影像切成大致符合 LPI 的小塊。
估計退化函數
白話說:要還原模糊之前,得先知道模糊是什麼。可以從照片裡找線索、自己測試相機,或從物理推導。
觀察法
在模糊影像中找一個結構簡單而明顯的小區域 ,例如一條邊或一個小亮點,而且訊號遠強於雜訊。用手工(或銳化加上判斷)建立該區域應有樣貌的估計 。則
就是從這個小區域估計出的 OTF。若模糊是位置不變的, 告訴我們整張影像 的形狀,再放大到全尺寸即可。這很費工,主要用於只有影像可用的情況,例如歷史照片。
實驗法
如果手上有相同(或等效)的成像系統,就在相同設定下拍一個極小的亮點。夠小的亮點近似強度為 的脈衝,其傅立葉轉換是常數 。觀測到的亮點影像直接給出 OTF:
顯微鏡使用者正是用小於解析度的螢光微珠這樣做。
數學建模法
有時物理會直接給答案。本章會用到兩個經典模型。
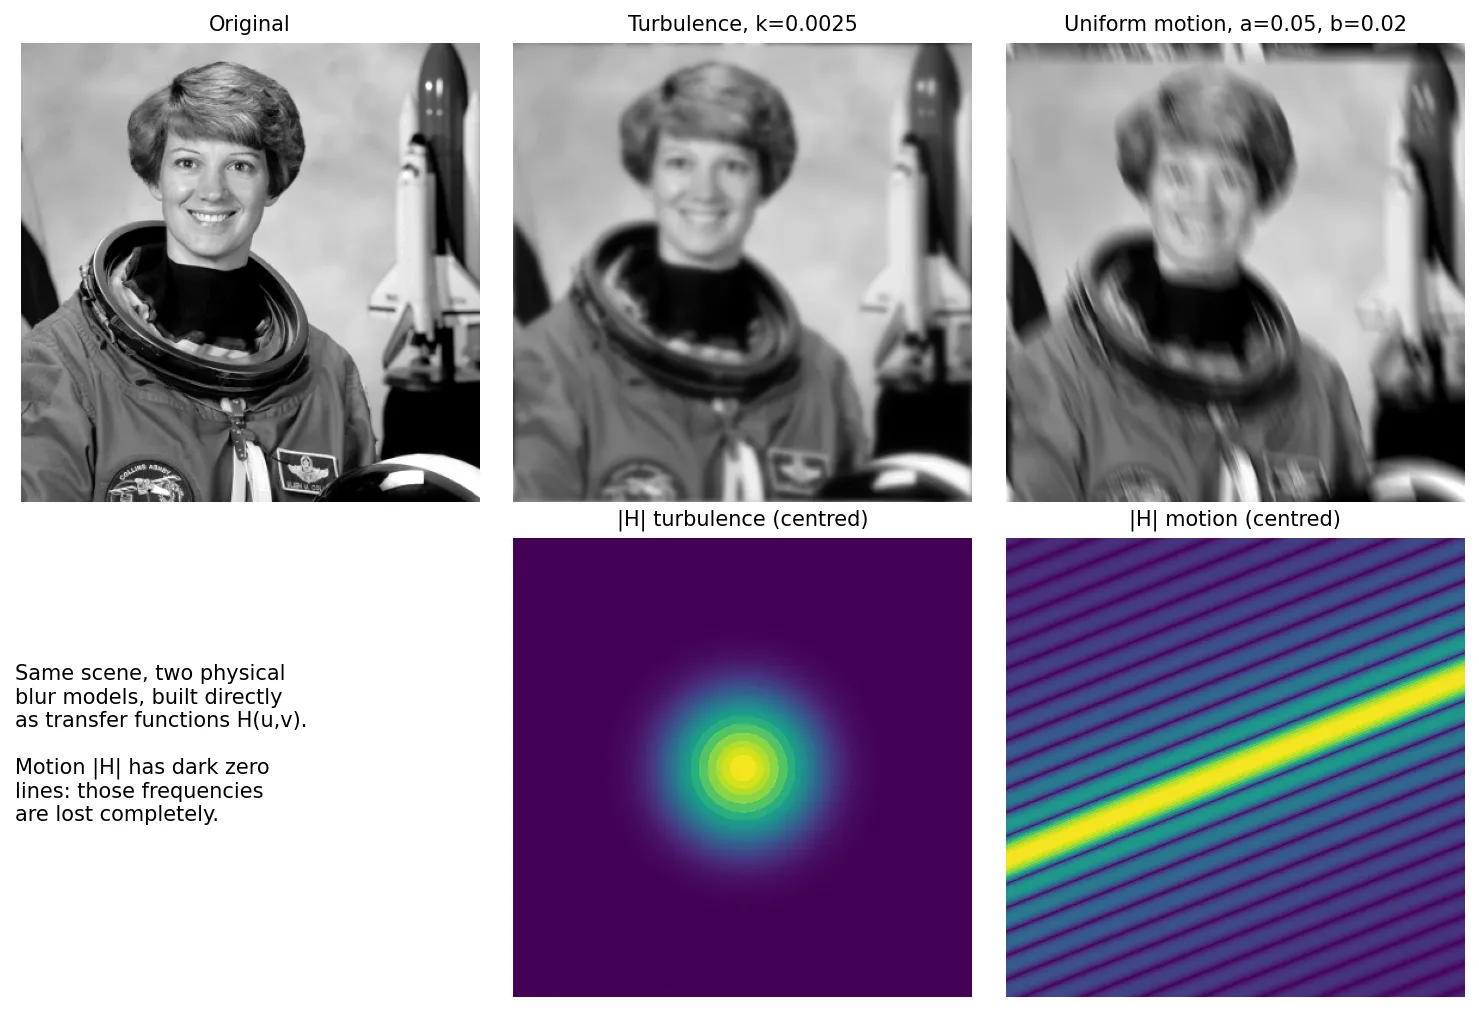
大氣擾流(atmospheric turbulence)。 透過擾動空氣長時間曝光的成像,常以下式建模:
其中常數 隨擾流強度增加。除了 次方之外,它看起來像高斯低通濾波器,而且永遠不會剛好等於零。
均勻直線運動模糊(uniform linear motion blur)。 假設影像 在長度為 的曝光期間移動,位移為 與 。感測器把每個位置都累加起來:
取傅立葉轉換並利用平移性質,得到
對等速運動,、, 與 是 、 方向的總位移。積分結果為
這是沿運動方向的 sinc 函數,再乘上線性相位項。關鍵是:只要 是非零整數,它就剛好等於零,因此整條整條的頻率線被完全摧毀(圖 5.4)。
import numpy as np

def freq_grid(shape):
    u = np.fft.fftfreq(shape[0]) * shape[0]            # 0, 1, ..., -1 (un-centred)
    v = np.fft.fftfreq(shape[1]) * shape[1]
    return np.meshgrid(u, v, indexing="ij")

def motion_blur_otf(shape, a, b, T=1.0):
    U, V = freq_grid(shape)
    s = np.pi * (U * a + V * b)
    return T * np.sinc(s / np.pi) * np.exp(-1j * s)    # np.sinc(x) = sin(pi x) / (pi x)

def turbulence_otf(shape, k):
    U, V = freq_grid(shape)
return np.exp(-k * (U ** 2 + V ** 2) ** (5 / 6))逆濾波
白話說:既然模糊把每個頻率乘上了 ,那就除回去。這是最直覺的想法,而只要有雜訊,它就會慘敗。
直接逆濾波器(direct inverse filter)的估計為
代入 就看出問題:
即使完全知道 ,也無法精確還原 ,因為 是未知的。更糟的是,模糊讓 在高頻非常小(運動模糊甚至剛好為零),而雜訊大致是白的,在高頻仍保有功率。於是 變得極大,淹沒整張影像。在圖 5.5 中,雖然雜訊標準差只有強度範圍的 0.3% 與 1%,完整的逆濾波仍把兩張影像都變成純雜訊。
一個局部的補救是只在頻譜原點附近( 夠大的地方)做逆濾波,例如把 乘上半徑 的陡峭 Butterworth 低通濾波器。對 平滑遞減的擾流模糊有效;對運動模糊則不太行,因為 的零線也穿過低頻。半徑還得手動調整。我們需要一個能自動決定每個頻率該信任多少的方法。
最小均方誤差(Wiener)濾波
白話說:在每個頻率問一句「這裡畫面比較多,還是雜訊比較多?」畫面佔優勢的地方就還原模糊;雜訊佔優勢的地方就收手。
Wiener 濾波器把影像與雜訊都視為隨機場,尋找使均方誤差
最小的估計, 代表期望值。假設雜訊與影像不相關、其中之一平均為零,而且 是 的線性函數。
推導概要。 對平穩訊號,DFT 會讓各頻率彼此解耦,因此可以對每個頻率分別選一個增益 ,令 。某個頻率上的期望誤差為
其中 是影像的功率頻譜, 是雜訊的功率頻譜, 表示共軛複數,而與 的交叉項因影像和雜訊不相關而消失。這是 的二次式;對 微分並令其為零,得到
分子分母同除以 ,得到最容易解讀的形式:
第一個因子就是逆濾波器。第二個因子介於 0 和 1 之間。訊號遠強於雜訊時,,這個因子接近 1,濾波器表現得像逆濾波器。雜訊佔優勢時,因子趨近 0,把那個頻率關掉。若某頻率 ,括號在該處為 (寫成 就不必除以零)。沒有雜訊時 ,Wiener 濾波器就是逆濾波器。
常數 近似
我們很少知道 ,因為那正是我們要找的影像的功率頻譜。常見的捷徑是把比值 換成一個常數 :
可以目視調整,或選擇讓某個品質指標最佳的值。雜訊變異數與影像變異數的比值(也就是訊雜比的倒數)是不錯的起點。 小,結果較銳利但雜訊多; 大,結果較平滑。
import numpy as np
from skimage import data, img_as_float

rng = np.random.default_rng(0)
f = img_as_float(data.camera())[::2, ::2]                # 256 x 256
H = motion_blur_otf(f.shape, a=0.1, b=0.1)               # from the snippet above
g = np.real(np.fft.ifft2(H * np.fft.fft2(f))) + rng.normal(0, 0.01, f.shape)
G = np.fft.fft2(g)

def wiener(G, H, K):
    return np.real(np.fft.ifft2(np.conj(H) / (np.abs(H) ** 2 + K) * G))

f_hat = wiener(G, H, K=0.01)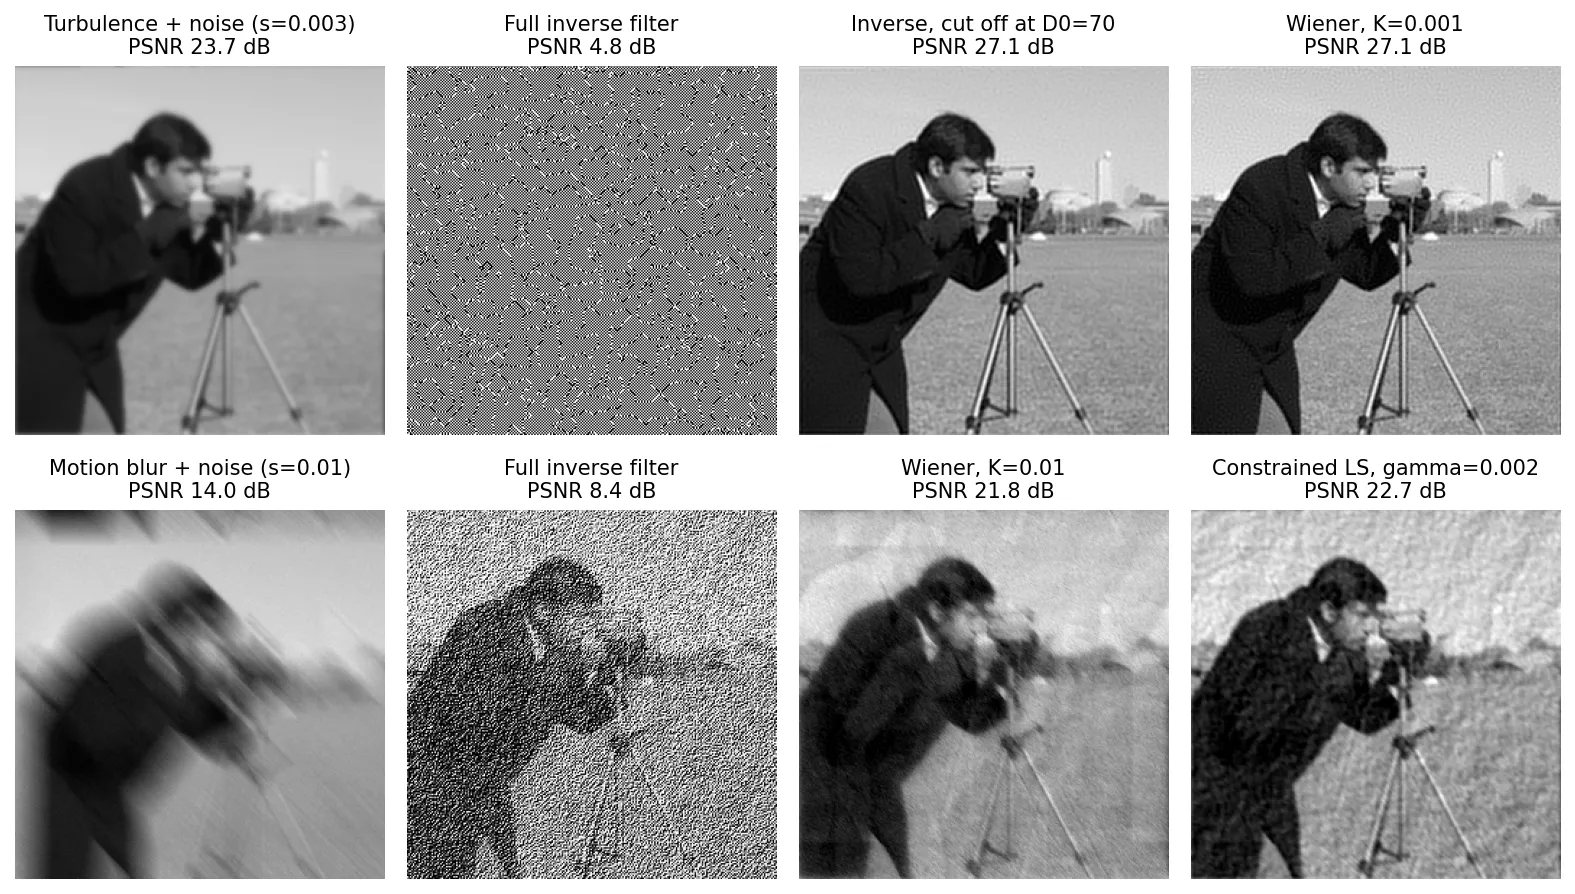
拖動滑桿,比較運動模糊加雜訊的影像與其 Wiener 復原結果(512 × 512 完整版,)。
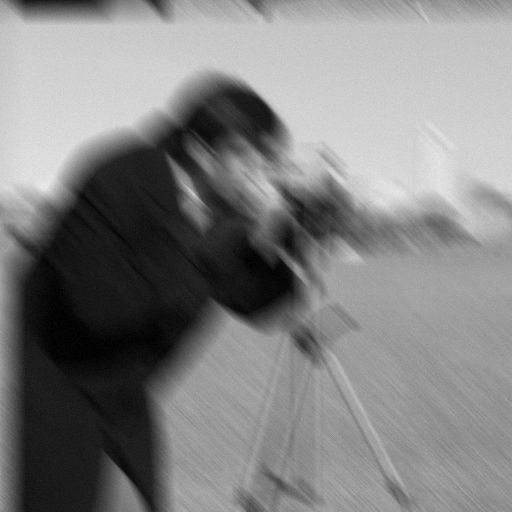
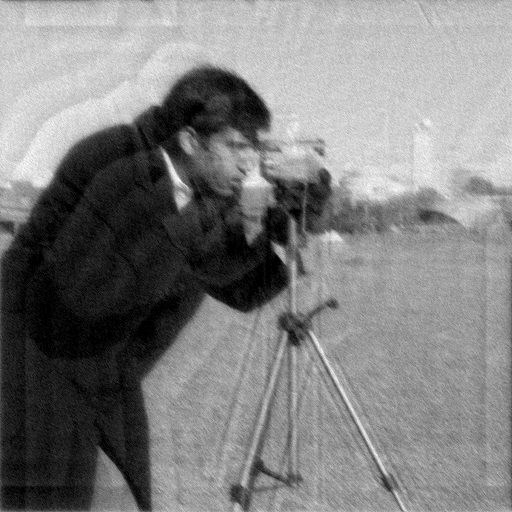 運動模糊 + 雜訊Wiener,K=0.01
受限最小平方濾波
白話說:在所有「扣掉預期雜訊量後,能解釋觀測結果」的影像之中,挑最平滑的那一張。
Wiener 濾波器需要功率頻譜,或一個意義不明確的常數 。受限最小平方(constrained least squares, CLS)濾波只需要雜訊的平均值與變異數 [3]。以矩陣向量形式,把像素排成向量,模型為
其中 是 向量, 是 的模糊矩陣。這些矩陣大到無法直接求反矩陣,但因為 代表循環卷積,它可以被 DFT 對角化,這正是頻域閉式解得以存在的原因。
這類反問題是病態的(ill-conditioned): 的微小變化會造成解的巨大變化。CLS 的對策是偏好平滑的解。它以拉普拉斯運算子 衡量粗糙程度,求解
其中 為歐氏範數。這個限制條件的意思是:殘差應該剛好和雜訊一樣大,不能更大(等於忽略資料),也不能更小(等於在擬合雜訊)。用拉格朗日乘數求得的解為
其中 是乘數, 是拉普拉斯卷積核
補零到 之後的 DFT。 時回到逆濾波器。和常數 的 Wiener 濾波器比較:CLS 把平坦的 換成 ,它在低頻小、高頻大,因此正好在雜訊容易佔優勢的地方收手。
如何選
不是可以隨意轉的旋鈕:它必須讓限制條件成立。定義殘差 與 ,可以證明 隨 單調遞增。因此:
- 從某個 開始。
- 計算 與殘差 (用 FFT 都很便宜)。
- 若 ,增大 ;若 ,減小 ;否則停止。 是一個小的容許誤差。
目標值只需要雜訊統計量:, 與 是雜訊的變異數與平均值,而我們已經知道如何從平坦區塊估計它們。
def cls(G, H, gamma):
    p = np.zeros(H.shape)
    p[[0, 0, 0, 1, -1], [0, 1, -1, 0, 0]] = [4, -1, -1, -1, -1]   # Laplacian centred at (0, 0)
    P = np.fft.fft2(p)
    return np.real(np.fft.ifft2(np.conj(H) / (np.abs(H) ** 2 + gamma * np.abs(P) ** 2) * G))

f_hat = cls(G, H, gamma=0.002)
Wiener 和 CLS 哪個比較好?一般而言沒有定論。Wiener 是對一群具有假設功率頻譜的影像平均而言最佳;CLS 則針對手上這一張影像,當雜訊統計量已知時,對這張影像可能得到更好的結果。若 或 是手動調的(這很常見),兩者看起來往往差不多(圖 5.5)。
幾何平均濾波器
白話說:一個旋鈕,在「完全還原模糊」和「對雜訊保守一點」之間滑動。
幾何平均濾波器(geometric mean filter)結合了逆濾波器與(參數化)Wiener 濾波器:
其中 與 是非負實數常數。特殊情況:
- :逆濾波器。
- :參數化 Wiener 濾波器; 時就是標準 Wiener 濾波器。
- 、:逆濾波器與 Wiener 濾波器的幾何平均,這也是這個家族名稱的由來。它又稱為頻譜等化濾波器(spectrum equalization filter):可以驗證此時輸出的期望功率頻譜 剛好等於原始影像的功率頻譜 。
時濾波器比 Wiener 更保守; 時更大膽。
def geometric_mean_filter(G, H, alpha, beta, K):
    """K stands in for S_eta / S_f, as in the constant-K Wiener filter."""
    H2 = np.abs(H) ** 2
    inv = np.conj(H) / np.maximum(H2, 1e-12)
    wie = np.conj(H) / (H2 + beta * K)
    # Both factors have the phase of conj(H): combine magnitudes, keep that phase.
    return np.real(np.fft.ifft2(np.abs(inv) ** alpha * np.abs(wie) ** (1 - alpha)
                                * np.exp(1j * np.angle(wie)) * G))
從投影重建影像
白話說:從許多角度讓 X 光穿過身體。每個角度得到一個「影子」,它只告訴我們光線一路總共穿過了多少東西。把夠多的影子巧妙地組合起來,就能重建出身體內部的切面。
電腦斷層(CT)原理
在 X 光 CT 中,射源與一排偵測器繞著病人旋轉。在每個角度,每個偵測器量測 X 光沿其直線路徑被衰減了多少。沿一條射線的衰減是累加的(強度比的對數等於衰減係數的線積分),所以每個量測值都是未知斷層 的一個線積分。同一角度的一組量測值稱為一個投影(projection)。CT 掃描儀從平移加旋轉的單一射源-偵測器對(平行射束),演進到配有多個偵測器的扇形射束,再到能擷取整個體積的螺旋與錐形射束;但下面的重建數學是它們共同的核心 [4]。
投影與 Radon 轉換
以法線式描述一條直線:, 是它到原點的距離, 是法線的角度。 沿該直線的線積分為
其中 是 Dirac 脈衝,只保留直線上的點。把 視為 的函數,就是 的 Radon 轉換(Radon transform)。以 為一軸、 為另一軸畫成影像,稱為正弦圖(sinogram):斷層中的單一點會畫出一條正弦曲線 。
最簡單的逆向做法是反投影(backprojection):把每個投影沿著它來的方向抹回整張影像,再把所有角度的抹痕加起來:
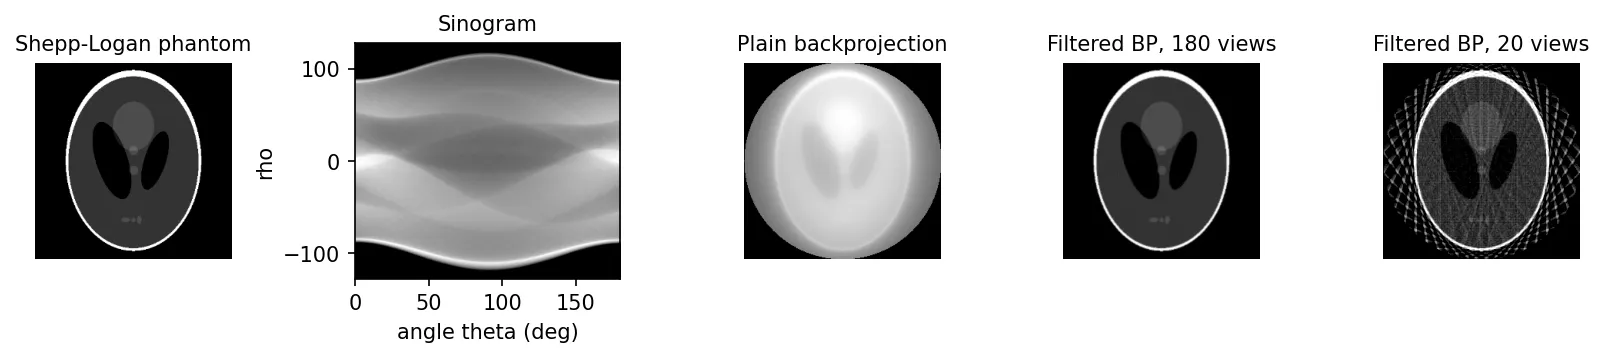
這會把質量放到正確的位置,但也會放到每條射線經過的所有地方,所以結果是 被嚴重模糊的版本(圖 5.6 第三格)。這個模糊並非隨機:它等於與 做卷積, 是到中心的距離。傅立葉切片定理告訴我們如何去除它。
傅立葉切片定理
令 為固定角度 下,投影 對 的一維傅立葉轉換:
傅立葉切片定理(Fourier-slice theorem,又稱投影切片定理)指出
其中 是 的二維傅立葉轉換。換句話說:一個投影的一維轉換,等於物體二維轉換中通過原點、角度為 的一條徑向切片。證明很短:把 Radon 積分代入 ,積掉 delta,指數就變成 ,這正是二維轉換在 的值。
所以原則上,所有角度的投影會一片一片填滿二維頻譜,再做二維反轉換就得到 。實務上這些切片是在極座標網格上取樣:原點附近密、遠處稀,內插到直角座標網格容易出錯。這種不均勻取樣也是單純反投影會模糊的原因:它過度加權了低頻。
平行射束的濾波反投影
把二維反傅立葉轉換寫成極座標 、。面積元素 變成 ,再用傅立葉切片定理:
由內往外讀:對每個角度,把投影的一維頻譜乘上 (斜坡濾波器,ramp filter),再轉回來;接著把濾波後的投影反投影,並對所有角度加總。這就是濾波反投影(filtered backprojection, FBP)。斜坡濾波器正好抵消了單純反投影的 模糊。
斜坡濾波器會無限增長,所以會放大高頻雜訊,而且不可積分。實務上會限制頻寬並乘上平滑的窗函數,例如 Hamming 窗:在頻帶 內 ,頻帶外為 , 是頻寬,。窗函數在 時為 1,在頻帶邊緣降到 。它犧牲一點銳利度,換來少得多的振鈴與雜訊。Shepp 與 Logan 在提出那個著名頭部假體(phantom)的論文中一併提出的濾波器 [5],至今仍是標準選項之一。視角數量也很重要:角度太少時,FBP 會產生條紋(圖 5.6 最後一格)。
import numpy as np
from skimage.data import shepp_logan_phantom
from skimage.transform import radon, iradon, rescale

f = rescale(shepp_logan_phantom(), 0.64)                 # 256 x 256
theta = np.linspace(0.0, 180.0, 180, endpoint=False)     # projection angles in degrees
sinogram = radon(f, theta=theta)                         # shape: (detector bins, angles)
backproj = iradon(sinogram, theta=theta, filter_name=None)    # blurry, no filter
fbp = iradon(sinogram, theta=theta, filter_name="ramp")       # filtered backprojection
rmse = np.sqrt(np.mean((fbp - f) ** 2))
iradon 也接受 "shepp-logan"、"cosine"、"hamming" 與 "hann" 窗函數,而 skimage.transform.iradon_sart 提供迭代式的替代方案 [6]。
扇形射束濾波反投影
現代掃描儀使用扇形射束(fan beam):一個點射源搭配一排彎曲或平面的偵測器,因此同一視角中的射線並不平行。每條扇形射線仍是某條直線 ,所以有兩條路可走。重新分組(rebinning)把來自許多視角的扇形射線整理成一組組平行射線,再套用平行 FBP。直接扇形 FBP 則在 FBP 積分中變數變換:投影先乘上一個取決於射線在扇形內角度的餘弦權重,再用修改過的斜坡濾波器濾波,最後以取決於與射源距離的權重做反投影。整體結構「加權-濾波-反投影」不變 [4]。
現代觀點
本章的工具不是博物館裡的展品。 仍是這個領域陳述問題的方式,類似 Wiener 的步驟也仍藏在現代網路裡。深度學習改變的是先驗(prior):我們不再假設「影像是平滑的」(CLS)或「影像的功率頻譜是 」(Wiener),而是從資料中學習乾淨影像長什麼樣子。想更全面地了解本章以外的深度影像復原(超解析度、除霧、除雨、低光增強、all-in-one 復原與擴散先驗),可以參考站長的文章 Low-Level Vision Task — Image Restoration 簡介。以下的綜述聚焦在本章的三個主題:去雜訊、去模糊與 CT 重建。
去雜訊:從區塊到網路
兩個經典方法代表了手工設計去雜訊的巔峰。非局部平均(non-local means, NLM)[7] 把每個像素換成一群「周圍區塊看起來相似」的像素的加權平均,不管它們在影像的哪裡。這是把自適應濾波器的想法推得更遠:「鄰域」由相似度而非距離定義。BM3D [8] 把相似區塊堆成三維堆疊,在轉換域中聯合濾波,第二階段再以第一階段結果作為 的估計,套用 Wiener 型濾波器。它當了大約十年的標準基準。
DnCNN [9] 證明了一個以殘差學習(預測雜訊而非乾淨影像)加上批次正規化(batch normalization)訓練的單純深度卷積網路,在高斯雜訊上勝過 BM3D,而且單一模型能處理未知的雜訊強度。
- Tian 等人,〈Deep learning on image denoising: An overview〉(2020) [10]。把 CNN 去雜訊方法分成四類:加成性白高斯雜訊、真實(相機)雜訊、盲去雜訊(雜訊未知),以及同時含有模糊或低解析度的混合情況。重點(我們的解讀):這個分類本身就是依雜訊類型組織的,真實相機雜訊與未知雜訊強度被列為和合成高斯雜訊不同的類別。本章的雜訊模型以及它有多貼近真實,在深度去雜訊中依然關鍵。
- Elad、Kawar 與 Vaksman,〈Image Denoising: The Deep Learning Revolution and Beyond〉(2023) [11]。回顧從經典先驗到深度去雜訊器的歷史,並主張去雜訊器的意義遠超過去雜訊本身:好的去雜訊器可以當作解其他反問題時的先驗,也是擴散式影像生成的引擎。重點:本章「只有雜訊」的經典問題,已經成為幾乎所有其他問題的基本構件。
去模糊與一般反問題
- Zhang 等人,〈Deep Image Deblurring: A Survey〉(IJCV 2022) [12]。涵蓋模糊成因、資料集與評估指標,再依架構與損失函數整理以 CNN 為基礎的非盲與盲去模糊方法,以及特定領域(人臉、文字、立體影像)。重點:非盲去模糊(如本章, 已知)主要在對付我們在逆濾波看到的雜訊放大與振鈴;盲去模糊還得估計 ,至今仍是比較難的問題。
- Ongie 等人,〈Deep Learning Techniques for Inverse Problems in Imaging〉(2020) [13]。為任何 問題提出分類:前向模型 在訓練時已知、只在測試時已知,還是完全未知?訓練是監督式還是非監督式?重點(我們的解讀):對 了解多少,是第一個設計決策,綜述也討論了這些方法的失效模式。像本章這樣已知 ,就能使用純端對端網路忽略掉的選項。
- Kamilov、Bouman、Buzzard 與 Wohlberg,〈Plug-and-Play Methods for Integrating Physical and Learned Models in Computational Imaging〉(2023) [14]。回顧隨插即用(plug-and-play, PnP)先驗:在「滿足物理()」的步驟與「呼叫去雜訊器(代替先驗)」的步驟之間交替的迭代演算法。重點:前向模型和學習式先驗可以分開開發,執行時再組合。DPIR [15] 是廣泛使用的例子,它把深度 CNN 去雜訊器插入半二次分裂(half-quadratic splitting)演算法,用於去模糊、超解析度與去馬賽克。
這和本章的關係很直接。對模糊 ,這種分裂方法的物理步驟要在每個頻率求使 最小的 ,其中 是目前去雜訊後的估計, 是懲罰權重。它的解是 ,也就是一個被拉向 (而不是拉向零)的常數 Wiener 濾波器。
CT 重建:學習式與展開式
資料完整、雜訊低時,FBP 又快又準。但為了降低輻射劑量而減少資料時,它就吃力了:不論是視角變少(條紋,圖 5.6),還是每個視角的光子變少(雜訊)。經典解法是搭配全變分(total variation)等手工先驗的迭代方法。深度學習提供三種主要模式:
- 後處理: 先做 FBP,再用 CNN 去除偽影。FBPConvNet [16] 正是用 CNN 這樣做,並報告在稀疏視角 CT 上比全變分重建品質更好,而執行時間只需一小部分。
- 展開式(學習式迭代)重建: 取一個迭代演算法,固定迭代次數,把每次迭代的部分步驟換成小型網路,再端對端訓練。Learned Primal-Dual [17] 展開一個原始-對偶(primal-dual)演算法,並在每次迭代中保留前向投影與反投影。Monga、Li 與 Eldar,〈Algorithm Unrolling〉(2019) [18] 綜述了這種設計模式在訊號與影像處理中的應用。重點:由於每一層都對應演算法的一個步驟,展開式網路比通用網路更容易解讀,也更有效率。
- Wang、Ye 與 De Man,〈Deep learning for tomographic image reconstruction〉(2020) [19] 回顧 CT 及其他斷層成像模態的全貌:影像域、感測器域與混合式網路、融入物理的設計,以及資料取得、穩健性與臨床驗證等開放問題。
沒有改變的是:Radon 轉換與傅立葉切片定理定義了上述每個方法都使用的前向模型,而 FBP 仍是臨床掃描儀的預設方法,也是許多學習式方法的輸入或起點。學習式方法也帶來本章線性濾波器沒有的新風險:網路可能產生看似合理、但資料中並不存在的結構。這就是為什麼在醫療應用上,必須在真實且分布外的掃描上做驗證。
重點整理
- 復原是客觀的:把退化建模為 (或 ),再把這個模型反過來。
- 從平坦區塊的直方圖辨認雜訊類型,再從同一區塊估計平均值與變異數。
- 讓空間濾波器對上雜訊:類高斯雜訊用平均類濾波器;單邊脈衝用正負號正確的反調和濾波器;椒鹽雜訊用中值與自適應中值;混合雜訊用 alpha 修剪平均。
- 週期性雜訊是頻譜中的幾個亮點;陷波濾波器去除它們,最佳陷波濾波則在局部自適應地調整減去的量。
- 逆濾波 會在 小的地方放大雜訊。Wiener、受限最小平方與幾何平均濾波器都在分母加上一項,抑制這些頻率。
- CT 量測的是線積分(Radon 轉換)。依傅立葉切片定理,每個投影提供二維頻譜的一條切片,而濾波反投影(先斜坡濾波、再反投影)重建出影像。
- 深度學習用學來的先驗取代手工先驗,但最好的方法仍把前向模型保留在內(隨插即用、展開式網路)。
練習
- 一張暗視野顯微影像的背景區域直方圖是單邊的:在 12 處陡然開始,右側拖著長尾;平均值為 20,變異數為 64(灰階單位)。你會先試本章的哪一種 PDF?參數是多少?
提示
陡然開始加上長尾,指向指數、Rayleigh 或 Erlang 家族。試試平移到 12 開始的指數分布:需要 且 ,兩者在 時同時成立。Rayleigh 則不一致: 得到 ,它的起點會是 ,而不是 12。
- 一張影像只受到鹽雜訊污染。先不做實驗,預測下列做法的結果:(a) 最大值濾波器、(b) 最小值濾波器、(c) 的反調和濾波器、(d) 的反調和濾波器。再用本章的程式驗證。
提示
鹽像素是視窗中最大的值。最大值濾波器會把它們擴散(更糟),最小值濾波器會去除它們(但會讓亮的細節變暗、變細)。正的 加重大值的權重,所以 讓鹽雜訊更糟; 則能去除它。
- 證明常數 的 Wiener 濾波器在 時退化成逆濾波器,而在 的頻率上輸出約為 。這說明 Wiener 濾波如何對待被模糊摧毀的頻率?
提示
當 時分母約為 。輸出因此很小,與 成正比,所以濾波器不會試圖找回這些頻率。它體面地放棄,而不是放大雜訊。
- 一張 的影像沿 方向有 8 個像素的等速運動模糊, 方向沒有。頻率以整數(每張影像的週期數)表示,與上面的程式一致。利用運動模糊 OTF,找出所有 的頻率 。解釋為什麼沒有任何線性濾波器能還原這些頻率的細節,以及這在復原影像中會呈現什麼樣子。
提示
當 以每張影像的週期數表示時, 是模糊長度佔影像尺寸的比例,所以 、。當 為非零整數時 :,對所有 都成立。由於 在這些頻率不含任何 的成分,任何線性濾波器在那裡只能輸出雜訊(或零)。預期會看到沿 方向、以該空間週期出現的淡淡振鈴。
- 用上面的 CT 程式,分別以 180、60、20、10 個視角,以及
ramp與hann濾波器重建。畫出 RMSE 對視角數的關係。接著在正弦圖加上高斯雜訊再重複一次。什麼時候較平滑的hann濾波器會勝出?
提示
沒有雜訊、視角很多時,ramp 應該勝出。雜訊增加後,斜坡濾波器在高頻放大雜訊,而在高頻衰減的 hann 就會勝出。這和逆濾波器對 Wiener 濾波器是同一種取捨。
- 推導 的逐頻率解 。當 時,你得到本章的哪一個濾波器?
提示
對 微分:。 時就是常數 的 Wiener 濾波器。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 5. publisher page
- H. Hwang and R. A. Haddad, “Adaptive median filters: new algorithms and results,” IEEE Transactions on Image Processing, vol. 4, no. 4, pp. 499–502, 1995. DOI
- B. R. Hunt, “The application of constrained least squares estimation to image restoration by digital computer,” IEEE Transactions on Computers, vol. C-22, no. 9, pp. 805–812, 1973. DOI
- A. C. Kak and M. Slaney, Principles of Computerized Tomographic Imaging, IEEE Press, 1988 (SIAM reprint 2001). free online edition
- L. A. Shepp and B. F. Logan, “The Fourier reconstruction of a head section,” IEEE Transactions on Nuclear Science, vol. 21, no. 3, pp. 21–43, 1974. DOI
- scikit-image developers, “Radon transform,” scikit-image documentation (gallery example). docs
- A. Buades, B. Coll and J.-M. Morel, “A non-local algorithm for image denoising,” IEEE CVPR, vol. 2, pp. 60–65, 2005. DOI
- K. Dabov, A. Foi, V. Katkovnik and K. Egiazarian, “Image denoising by sparse 3-D transform-domain collaborative filtering,” IEEE Transactions on Image Processing, vol. 16, no. 8, pp. 2080–2095, 2007. DOI
- K. Zhang, W. Zuo, Y. Chen, D. Meng and L. Zhang, “Beyond a Gaussian denoiser: Residual learning of deep CNN for image denoising,” IEEE Transactions on Image Processing, vol. 26, no. 7, pp. 3142–3155, 2017. doi · arXiv
- C. Tian, L. Fei, W. Zheng, Y. Xu, W. Zuo and C.-W. Lin, “Deep learning on image denoising: An overview,” Neural Networks, vol. 131, pp. 251–275, 2020. arXiv
- M. Elad, B. Kawar and G. Vaksman, “Image denoising: The deep learning revolution and beyond — A survey paper,” SIAM Journal on Imaging Sciences, vol. 16, no. 3, pp. 1594–1654, 2023. arXiv
- K. Zhang, W. Ren, W. Luo, W.-S. Lai, B. Stenger, M.-H. Yang and H. Li, “Deep image deblurring: A survey,” International Journal of Computer Vision, 2022. arXiv
- G. Ongie, A. Jalal, C. A. Metzler, R. G. Baraniuk, A. G. Dimakis and R. Willett, “Deep learning techniques for inverse problems in imaging,” arXiv:2005.06001, 2020. arXiv
- U. S. Kamilov, C. A. Bouman, G. T. Buzzard and B. Wohlberg, “Plug-and-play methods for integrating physical and learned models in computational imaging: Theory, algorithms, and applications,” IEEE Signal Processing Magazine, vol. 40, no. 1, pp. 85–97, 2023. arXiv
- K. Zhang, Y. Li, W. Zuo, L. Zhang, L. Van Gool and R. Timofte, “Plug-and-play image restoration with deep denoiser prior,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 10, pp. 6360–6376, 2022. arXiv
- K. H. Jin, M. T. McCann, E. Froustey and M. Unser, “Deep convolutional neural network for inverse problems in imaging,” IEEE Transactions on Image Processing, vol. 26, no. 9, pp. 4509–4522, 2017. arXiv
- J. Adler and O. Öktem, “Learned primal-dual reconstruction,” IEEE Transactions on Medical Imaging, 2018. arXiv
- V. Monga, Y. Li and Y. C. Eldar, “Algorithm unrolling: Interpretable, efficient deep learning for signal and image processing,” arXiv:1912.10557, 2019. arXiv
- G. Wang, J. C. Ye and B. De Man, “Deep learning for tomographic image reconstruction,” Nature Machine Intelligence, vol. 2, no. 12, pp. 737–748, 2020. DOI