第 3 章・強度轉換與空間濾波
先備知識: 第 2 章・數位影像基礎
你將學到
- 一條曲線 如何讓影像變亮、變暗、反相或拉開對比,以及何時該選對數、gamma 或分段線性曲線。
- 直方圖等化(histogram equalization)為什麼有效(一步步推導),以及直方圖匹配、CLAHE 這類區域方法與區域統計量如何建立在它之上。
- 什麼是線性空間濾波、相關(correlation)與卷積(convolution)差在哪裡,以及可分離卷積核為什麼快。
- 平滑(低通)濾波器,包括非線性的中值濾波器,如何去除雜訊;以微分為基礎的(高通)濾波器如何銳化。
- 如何從低通卷積核推導出高通、帶通與帶拒卷積核,以及如何把多個方法串成一條處理流程。
先看全貌
這一章談的是:不離開像素格子,直接改善影像。本章所有方法都直接作用在像素值上,這就是「空間域」(spatial domain)的意思。方法分成兩大類。點運算(point operation)只用每個像素自己的值來改變它;鄰域運算(neighborhood operation,也就是空間濾波器)則參考周圍像素的值來改變它。
為什麼重要:這些是大家第一個會拿出來用的工具,手機相機、醫學影像檢視器、顯微鏡,以及電腦視覺模型的前處理都會用到。它們也是卷積層在概念上的祖先:CNN 的第一層就是一組空間濾波器,而許多學習式的影像增強網路,輸出的仍然是一條曲線或一個濾波器,這點會在「現代觀點」中看到。
背景
白話版。 我們把輸出影像寫成「對輸入影像套用某個運算」。如果這個運算一次只看一個像素,它就是一張查找表;如果它看一個小視窗,它就是濾波器。
精確版。 令 為輸入影像、 為輸出影像, 為整數像素座標(與卷積教學使用相同的符號)。空間域處理可寫成
其中 是定義在 鄰域(neighborhood)上的運算子。鄰域通常是以 為中心的小正方形或長方形。把鄰域中心逐一移過每個像素,就能在每個位置套用這個運算子。
當鄰域只有一個像素()時, 只取決於該像素的值,這時稱為強度轉換(intensity transformation,也稱灰階轉換或點轉換),並以純量寫成:
其中 是某像素的輸入強度, 是同一像素的輸出強度,兩者都落在 , 為強度階數(8 位元影像 )。因為 只有 種可能值,任何 都能存成長度為 的查找表(lookup table),這也是點運算極快的原因。
基本強度轉換函數
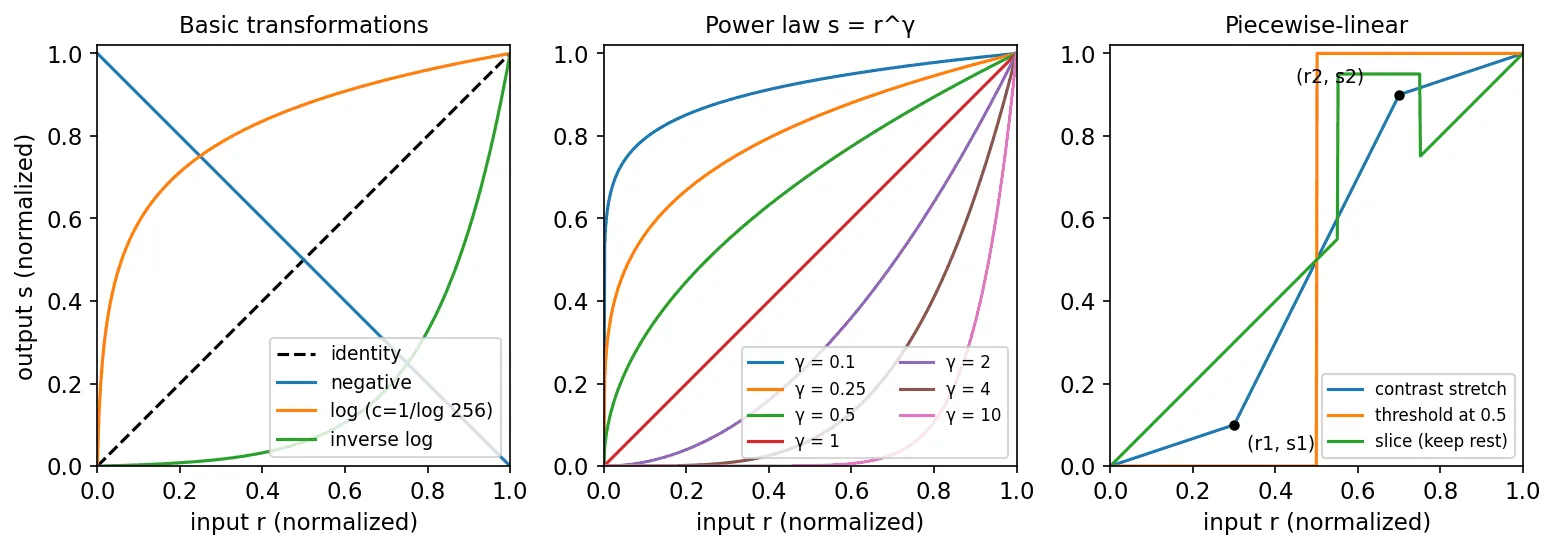
白話版。 畫一條曲線,橫軸是輸入亮度、縱軸是輸出亮度。曲線陡的地方,相近的灰階會被拉開,對比增加;曲線平的地方,灰階被擠在一起,對比下降。
斜率 就是局部的對比增益:兩個相鄰像素間的小差異 ,轉換後大約變成 。下面每一條曲線,都是在決定要把這份增益花在哪裡。
影像反相
暗變亮、亮變暗。斜率處處為 ,所以對比的大小不變,只是極性反轉。當大片暗區中有細小的亮細節時,反相很有幫助,因為人通常比較容易在淺色背景上判讀灰階細節。
對數轉換
其中 為縮放常數,通常取 ,讓最大輸入對應到 。加 1 是為了避開 。斜率 在 小時大、在 大時小,因此對數曲線會擴張暗部、壓縮亮部。
它的經典用途是顯示動態範圍極大的資料,例如傅立葉頻譜的強度,數值可以橫跨好幾個數量級。線性縮放時只看得到最亮的那一點;取對數之後,結構就浮現了(圖 3.2 下排)。反對數(指數)曲線的作用則恰好相反。
冪次(gamma)轉換
其中 、 為常數(若 已正規化到 ,取 )。 時曲線往上拱,像對數一樣提亮暗部; 時曲線往下彎,壓暗暗部。和對數不同的是,一個參數就能產生一整族曲線(圖 3.1 中)。
Gamma 的重要性不只在增強。顯示器與相機都有冪次型的響應,影像檔通常儲存的是經過 gamma 編碼的值,而不是與光量成正比的值。預先補償裝置響應的做法稱為 gamma 校正(gamma correction)。一個實務上的後果是:對 gamma 編碼過的像素做平均、模糊或縮放,和在線性光上做並不相同,所以嚴謹的流程會先線性化。
import numpy as np
from skimage import data, img_as_float

r = img_as_float(data.camera())        # 強度縮放到 [0, 1]
negative = 1.0 - r                     # s = (L-1) - r 的正規化版本
log_t = np.log1p(r) / np.log(2.0)      # s = c log(1 + r),c 讓 s(1) = 1
bright = r ** 0.4                      # gamma < 1 提亮暗部
dark = r ** 2.5                        # gamma > 1 壓暗暗部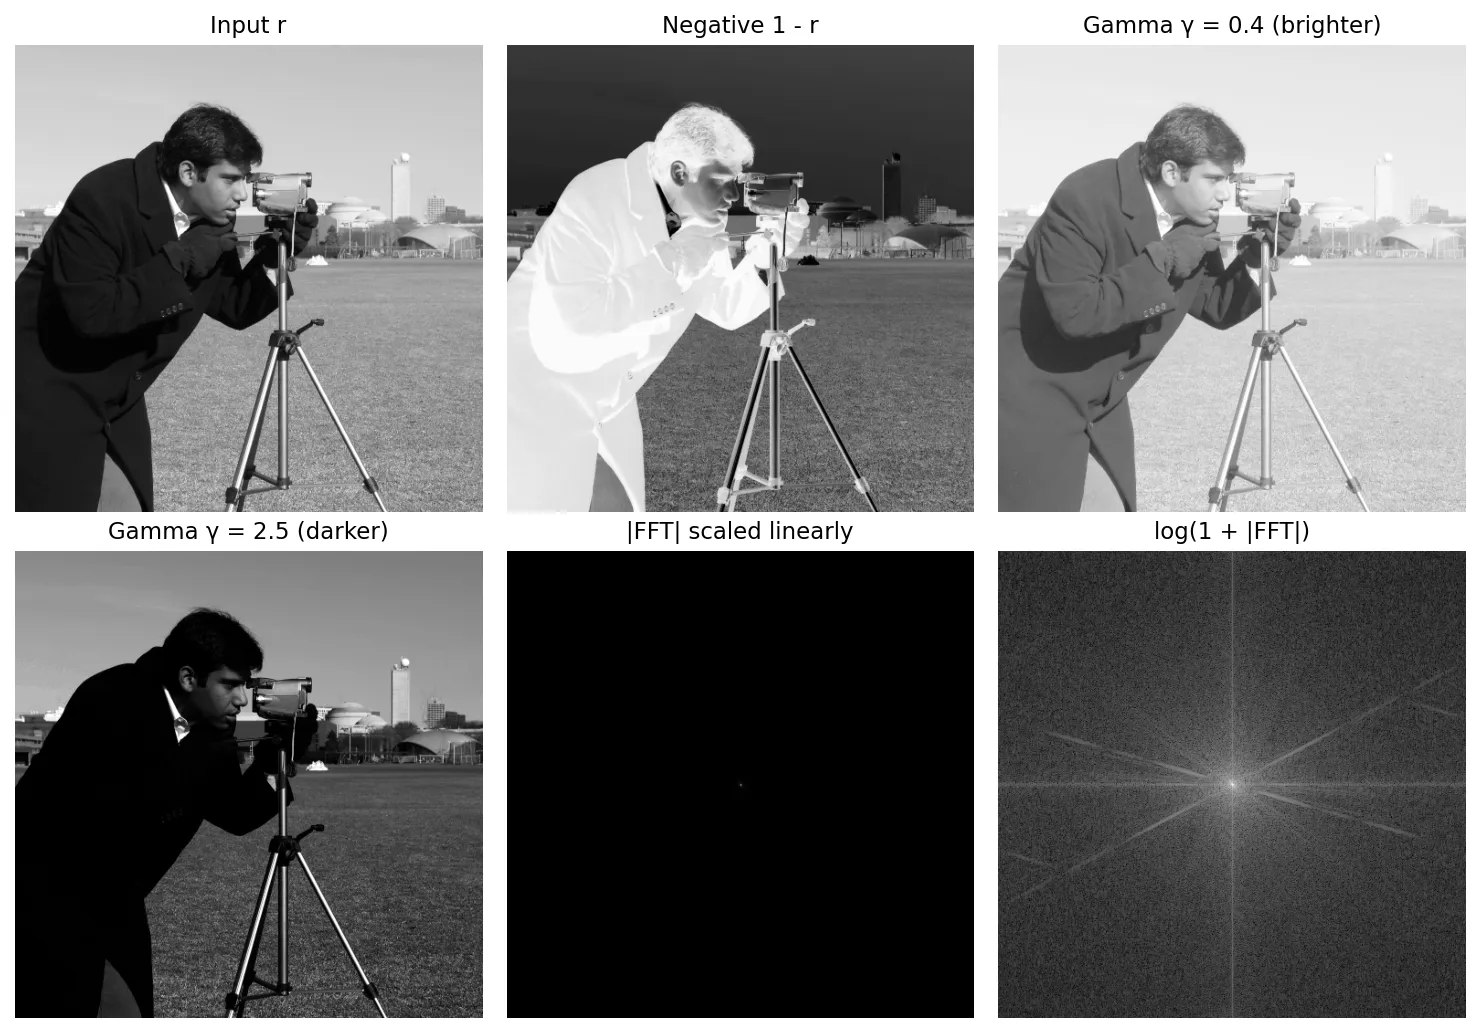
分段線性轉換
不用單一公式,而是把幾段直線接起來。好處是控制精確,代價是參數較多。
對比拉伸(contrast stretching)。選兩個控制點 與 ,用直線連接 。中間那段的斜率是 。只要 且 ,曲線就是單調的,不會顛倒灰階的順序。有兩個特例值得記住:
- 、、、:把影像實際的範圍對應到完整範圍(最小–最大拉伸)。實務上改用第 1 與第 99 百分位數取代最小值與最大值,避免少數離群像素主導結果。
- 、、:產生二值影像,也就是在 處做門檻化(threshold)。
def stretch(img, r1, s1, r2, s2, L=256):
    lut = np.interp(np.arange(L), [0, r1, r2, L - 1], [0, s1, s2, L - 1])
    return lut.astype(np.uint8)[img]

img = data.camera()
lo, hi = np.percentile(img, [1, 99])
out = stretch(img, lo, 0, hi, 255) # 穩健的最小–最大拉伸強度切片(intensity-level slicing)。突顯某一段強度 。做法有兩種:把這段設成高值、其他設成低值(得到二值結果);或只提亮這段、其他保持不變。當感興趣的灰階範圍已知時(例如 X 光中的某種組織或材料),切片就很好用。
位元平面切片(bit-plane slicing)。8 位元像素值是各位元的加總:,其中 。把每個像素的第 個位元收集起來,就得到一張二值影像,稱為位元平面 。平面 7 是最高有效位元(MSB),恰好等於在 128 處門檻化。低位元平面看起來像雜訊,因為它們承載的是細微變化。只保留最高四個平面重建出的影像,與原圖非常接近,最大誤差小於 階(圖 3.3)。這說明了位元平面為何與壓縮有關,也說明最低幾個平面為何常被拿來藏浮水印。
img = data.camera()                                    # uint8
planes = [(img >> b) & 1 for b in range(8)]            # planes[7] 是 MSB
top4 = sum(planes[b].astype(np.uint8) << b for b in range(4, 8))
print(np.abs(img.astype(int) - top4).max())            # 15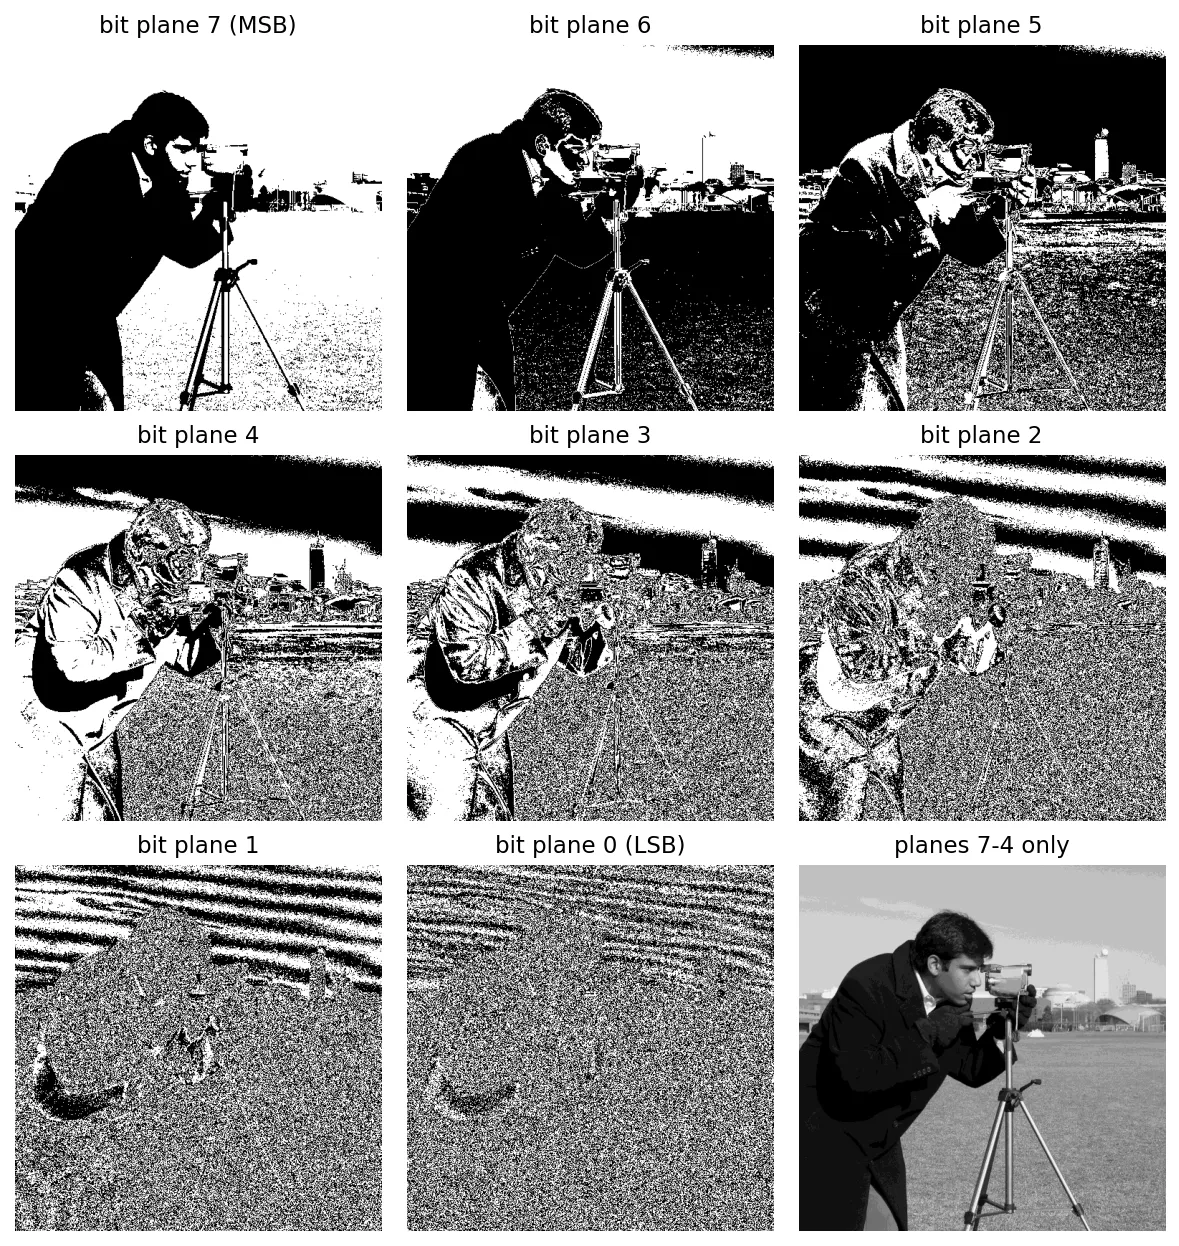
直方圖處理
白話版。 直方圖(histogram)統計每種亮度各有多少像素。暗影像的計數堆在左邊;灰濛濛的影像則擠在一條窄帶裡。直方圖處理就是根據這些計數自動選出曲線 ,讓輸出的直方圖變成我們想要的形狀。
精確版。 對一張 、灰階為 ()的影像,令 為值等於 的像素數。正規化直方圖
估計了「隨機挑一個像素,其值為 」的機率,總和為 1。
直方圖等化
目標是找一條曲線 ,讓輸出直方圖盡可能平坦,也就是每個灰階被使用的頻率大致相同。
推導(連續情形)。 把強度視為連續隨機變數 ,其機率密度函數(PDF)為 。假設 在此區間嚴格遞增。那麼像素落在小區間 ,恰好等於輸出落在 ,其中 。機率相等給出 ,因此
現在把 選為 的累積分布函數(CDF)乘上比例:
其中 是積分用的虛擬變數。由微積分基本定理,。代入得
不論輸入的 PDF 長什麼樣,輸出的 PDF 都是均勻分布。CDF 正是那條能把機率平均攤開的單調曲線:像素多的地方它陡(把像素拉開),像素少的地方它平。
離散版本。 把積分換成加總:
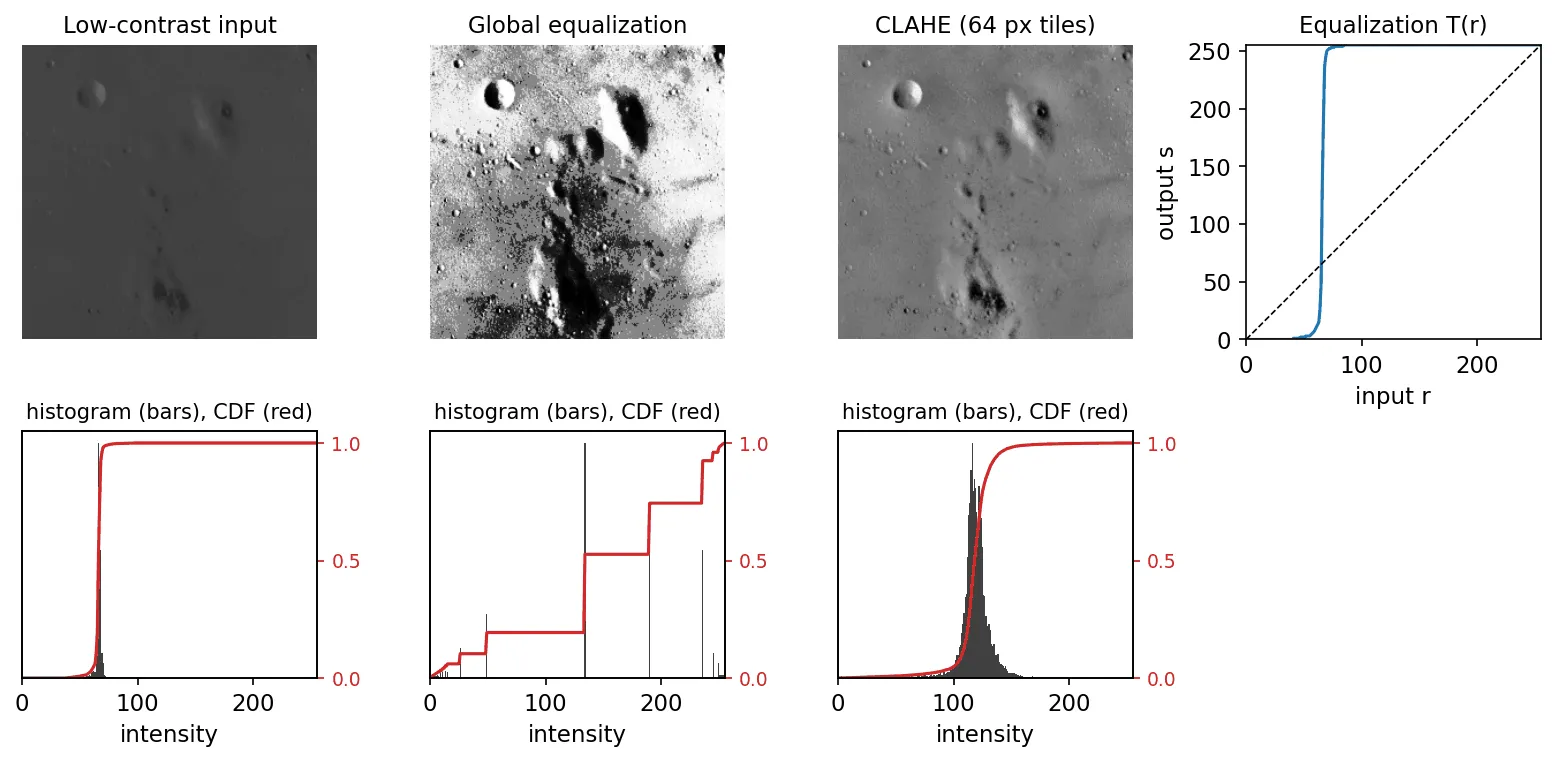
再把 四捨五入到最近的整數。由於多個輸入灰階可能捨入到同一個輸出灰階,而一個灰階又無法拆開,離散結果只會近似平坦。輸出直方圖通常會出現高聳的尖峰,中間夾著空隙(圖 3.4 中)。真正能保證的是:輸出涵蓋完整範圍,且輸出的 CDF 接近一條直線。
def equalize(img, L=256):
    hist = np.bincount(img.ravel(), minlength=L)      # n_k
    cdf = np.cumsum(hist) / img.size                  # j <= k 的 p_r(r_j) 加總
    lut = np.round((L - 1) * cdf).astype(np.uint8)    # s_k
    return lut[img]
OpenCV 的 cv2.equalizeHist 使用稍微不同的正規化 ,讓最暗的有值灰階對應到 0,結果大約只差一階。
拖動滑桿,比較一張刻意壓低對比的影像與它的全域等化結果。注意等化並不是「免費的」:它會誇大大片平滑區域與顆粒感,因為它把對比花在像素數量多的地方,而不是有意義的細節所在之處。
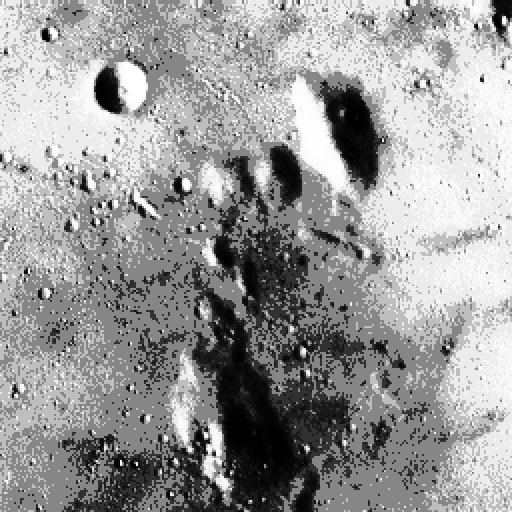 輸入等化後
直方圖匹配(規定化)
有時候平坦的直方圖並不是我們要的目標。我們可能希望影像看起來像某張參考影像,或希望直方圖是手動指定的形狀。直方圖匹配(histogram matching,也稱 histogram specification)把輸入對應成直方圖接近指定 PDF 的影像。
技巧是用兩次等化。等化輸入得到均勻的 ;對目標分布做等化,得到
它同樣產生均勻變數。兩個均勻變數可以互相對應,因此令 並解出:
其中 是輸出強度、 是目標分布的縮放 CDF、 是虛擬變數。離散情形下 是階梯函數,未必可逆,所以對每個輸入灰階取滿足 的最小 ,只要一個 searchsorted 就能完成:
def match(img, ref, L=256):
    cdf_in = np.cumsum(np.bincount(img.ravel(), minlength=L)) / img.size
    cdf_ref = np.cumsum(np.bincount(ref.ravel(), minlength=L)) / ref.size
    # 對每個輸入灰階,取滿足 G(z) >= T(r) 的最小 z
    lut = np.searchsorted(cdf_ref, cdf_in).clip(0, L - 1).astype(np.uint8)
    return lut[img]
skimage.exposure.match_histograms 實作了相同的概念,也支援彩色影像的逐通道匹配。
精確直方圖匹配
上面兩種方法都是查找表,所以輸入值相同的像素必然得到相同的輸出值。如果 30% 的像素共用同一個值,任何查找表都無法把它們拆開,輸出直方圖也就不可能完全平坦或完全符合目標。
精確直方圖規定化(exact histogram specification)先讓每個像素都能被區分,以消除這個限制 [5]。每個像素得到一組特徵向量:自己的值、小鄰域的平均、較大鄰域的平均,依此類推。依這組向量做字典序排序,實務上就能得到嚴格的順序,因為某個特徵相同時,會由下一個特徵來打破平手。接著依序指定輸出值:前 個像素給灰階 0,接下來 個給灰階 1,以此類推, 是目標直方圖要求的確切數量。結果的直方圖與要求完全一致。Coltuc、Bolon 與 Chassery 指出,用由小到大的區域平均來排序,打破平手的方式在視覺上很合理,因為周圍較亮的像素會被稍微往上推 [5]。
區域直方圖處理
全域方法對整張影像只用一條曲線。如果重要細節藏在暗角落、而那裡的像素又不多,全域直方圖幾乎不會注意到它。
區域直方圖等化對每個像素周圍的鄰域計算直方圖,由此算出轉換,只套用到中心像素,再移到下一個像素。自適應直方圖等化(adaptive histogram equalization, AHE)及其變體由 Pizer 等人做了系統性的研究,其中包括 AHE 在近乎均勻的區域會過度放大雜訊的問題:那裡的區域直方圖只是一根尖峰,CDF 變成近乎垂直的階梯 [2]。
對比受限自適應直方圖等化(contrast-limited AHE, CLAHE)透過限制對應曲線的斜率來解決這個問題。由於等化曲線的斜率與直方圖高度成正比,把每個區域直方圖在某個上限處截斷,再把截掉的計數重新分配到所有 bin,就能為對比增益設上限。為了加速,影像被切成小塊(tile),每塊算一條對應曲線,每個像素的輸出由最近四塊的對應結果做雙線性內插,避免出現明顯的接縫。Zuiderveld 在 Graphics Gems 的章節給出了被廣泛沿用的實作 [3],Reza 則描述了即時的硬體實現 [4]。
import cv2
clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
out = clahe.apply(data.moon())         # 輸入 uint8,輸出 uint8
在 scikit-image 中,對應的是 skimage.exposure.equalize_adapthist(img, clip_limit=0.01)。
利用直方圖統計量增強影像
直方圖是一個分布,因此可以用動差(moment)來描述它。令 為正規化直方圖,平均與變異數為
其中 衡量平均亮度,(標準差)衡量對比。若改在以 為中心的鄰域 上計算,就得到區域平均 與區域標準差 。
這給了我們一條簡單又有針對性的增強規則。假設只想增強偏暗、而且有一些但不太多對比的區域(同時跳過平坦背景與強烈邊緣)。令全域平均為 、全域標準差為 ,只有在下列條件成立時,才把像素乘上增益 ,否則保持不變:
其中 是使用者選定的比例(例如 )。區域統計量只需要兩次方框濾波,一次作用在 、一次作用在 ,再利用 :
from scipy.ndimage import uniform_filter

f = img_as_float(data.moon())
m = uniform_filter(f, size=3)                                     # 區域平均
sd = np.sqrt(np.maximum(uniform_filter(f**2, size=3) - m**2, 0))  # 區域標準差
mG, sG = f.mean(), f.std()
mask = (m <= 0.5 * mG) & (sd >= 0.02 * sG) & (sd <= 0.5 * sG)
g = np.where(mask, np.clip(3.0 * f, 0, 1), f)                     # 增益 E = 3
同樣「用方框濾波器求區域平均與區域變異數」的模式,也出現在導引濾波器(guided filter)[8] 中,它是「現代觀點」會談到的保邊濾波器之一。
空間濾波的基礎
白話版。 空間濾波器把一小格權重(卷積核,kernel)滑過整張影像。在每個位置,把權重乘上底下的像素再加總,結果就是中心像素的新值。
卷積教學已經用從零寫起的 NumPy 迴圈、OpenCV 呼叫與邊界處理,把操作細節講清楚了。這裡專注於本章後面需要的理論。
線性空間濾波與相關
沿用該教學的符號,對大小為 的卷積核 , 與 的相關(correlation)為
其中 是相對於卷積核中心的位移, 是卷積核的半寬。奇數尺寸讓卷積核有明確的中心。這個濾波器是線性的,因為輸出是輸入值的線性組合:對 濾波,等於 倍的 結果加上 倍的 結果。它也是平移不變的,因為每個位置用的是同一組權重。
相關與卷積
卷積是同樣的計算,只是先把卷積核旋轉 180°:
對旋轉 180° 後不變的對稱卷積核(方框、高斯、拉普拉斯),兩者相同;對反對稱的卷積核(Sobel、任何方向導數),兩者結果相同但正負號相反。真正有用的差別出現在脈衝(impulse,一堆 0 中的一個 1)上:卷積核與脈衝做相關,得到的是旋轉過的卷積核;做卷積,得到的則是一模一樣的卷積核。這就是為什麼代數性質漂亮的是卷積而不是相關:
- 交換律: ,
- 結合律: ,所以一連串濾波器可以合併成單一卷積核,
- 分配律: 。
接下來兩小節都靠結合律。就像卷積教學提到的,cv2.filter2D 計算的是相關;大多數深度學習的「卷積」層其實也是相關,但因為權重是學出來的,翻不翻轉並不重要。
可分離卷積核
若卷積核可以寫成行向量 與列向量 的外積,就稱它是可分離的(separable):
於是 :先用 濾每一列,再用 濾每一行。對 的卷積核,每個像素的乘法次數從 降為 ,加速比為 , 時是 倍,且隨尺寸線性成長。矩陣恰好是外積若且唯若它的秩(rank)為 1,這也提供了一個檢驗方法:做奇異值分解,確認只有一個奇異值不為零。方框與高斯卷積核都可分離;Sobel 也可以,它是一個平滑向量乘上一個差分向量。
g1 = cv2.getGaussianKernel(7, 1.5)          # 7x1 行向量,總和為 1
K = g1 @ g1.T                               # 7x7 高斯卷積核
print(np.linalg.matrix_rank(K))             # 1  ->  可分離
f = img_as_float(data.camera()).astype(np.float32)
a = cv2.filter2D(f, -1, K.astype(np.float32))
b = cv2.sepFilter2D(f, -1, g1, g1)          # 兩次一維濾波
print(np.abs(a - b).max())                  # 約 1e-7
空間域與頻域
卷積定理指出,空間中的卷積等於頻率中的相乘:若 表示傅立葉轉換,則 。因此每個線性、平移不變的濾波器都有兩種等價描述:空間中的卷積核 ,以及說明每個頻率保留多少的轉移函數(transfer function)。平滑卷積核的轉移函數在零頻率附近大、在高頻小,所以是低通(lowpass);銳化卷積核相反,是高通(highpass)。第 4 章會正式發展這個觀點;目前只要記得這組詞彙:「低通」就是「平滑」,「高通」就是「邊緣與細節」。
小卷積核通常在空間域計算比較便宜;非常大的卷積核則常透過快速傅立葉轉換在頻域計算比較划算。
建構空間濾波卷積核
常見的做法有三種:
- 從數學性質出發。 取平均得到方框卷積核;取導數得到差分卷積核(拉普拉斯、Sobel)。
- 對連續函數取樣。 在整數格點上對二維高斯取樣,再把權重正規化成總和為 1。
- 從頻率規格出發。 在頻域設計 ,做反轉換得到空間卷積核,通常再截斷成可處理的大小。
所有做法都適用兩個檢查。平滑卷積核的權重總和應為 1,平坦區域才能保持亮度;導數卷積核的權重總和應為 0,平坦區域才會輸出 0。
平滑(低通)空間濾波器
白話版。 把每個像素換成鄰域的平均。隨機雜訊被拉向平均而淡去,但銳利的邊緣也會被抹開,因為平均跨過了邊緣兩側。
方框濾波器
方框卷積核(box kernel)的每個權重都是 。它是最簡單的低通濾波器,可分離,而且搭配累加和(running sum)時,每個像素的計算量與尺寸無關。它的弱點在頻率響應:方框的傅立葉轉換是類似 sinc 的函數,帶有旁瓣(side lobe),所以會讓部分高頻以反相的方式通過,而且它以正方形、與方向有關的方式抹開影像,細小文字與細線可能變成塊狀條紋。
高斯濾波器
高斯卷積核是對下式取樣:
其中 是相對於卷積核中心的位移,(標準差)決定模糊程度, 讓權重總和為 1。它有三個性質,讓它成為預設的平滑卷積核:
- 等向性(isotropy)。它只取決於距離 ,所以各方向模糊程度相同。
- 可分離性。 。
- 平滑且非負的頻率響應。 它的傅立葉轉換也是高斯,沒有旁瓣。
一維高斯約 99.7% 的質量落在 之內,所以約 大小(向上取到最近的奇數)的卷積核就幾乎涵蓋全部。更大只是浪費計算,更小則會截掉尾巴。兩個標準差分別為 、 的高斯做卷積,得到 的高斯,所以重複的小模糊可以預測地組合起來。
順序統計(非線性)濾波器
順序統計濾波器(order-statistic filter)把鄰域中的值排序後挑一個出來。它們是非線性的:沒有任何卷積核能表示它們,卷積定理也不適用。
- 中值濾波器(median filter):輸出中間值(第 50 百分位數)。它是處理脈衝雜訊(impulse noise,又稱椒鹽雜訊 salt-and-pepper)的標準方法,也就是被強制變成全黑或全白的孤立像素。脈衝是極端值,排序後會跑到兩端,幾乎不可能是中值。只要視窗中被汙染的像素少於一半,中值就會忽略它們。在同樣大小下,它保留階梯邊緣的能力也遠勝線性平均。
- 最大值濾波器(第 100 百分位數):找出最亮的點;能去除胡椒(暗)雜訊,但會讓亮點長大。
- 最小值濾波器(第 0 百分位數):相反;能去除鹽(亮)雜訊,但會讓暗點長大。
最大值與最小值濾波器會在第 9 章以灰階膨脹與侵蝕的形式再次出現。
from scipy import ndimage as ndi

f = img_as_float(data.camera()).astype(np.float32)
noisy = f.copy()
u = np.random.default_rng(0).random(f.shape)
noisy[u < 0.05], noisy[u > 0.95] = 0.0, 1.0       # 10% 椒鹽雜訊

box = cv2.blur(noisy, (5, 5))
gauss = cv2.GaussianBlur(noisy, (0, 0), sigmaX=1.5)
med = cv2.medianBlur(noisy, 3)
mn, mx = ndi.minimum_filter(noisy, 3), ndi.maximum_filter(noisy, 3)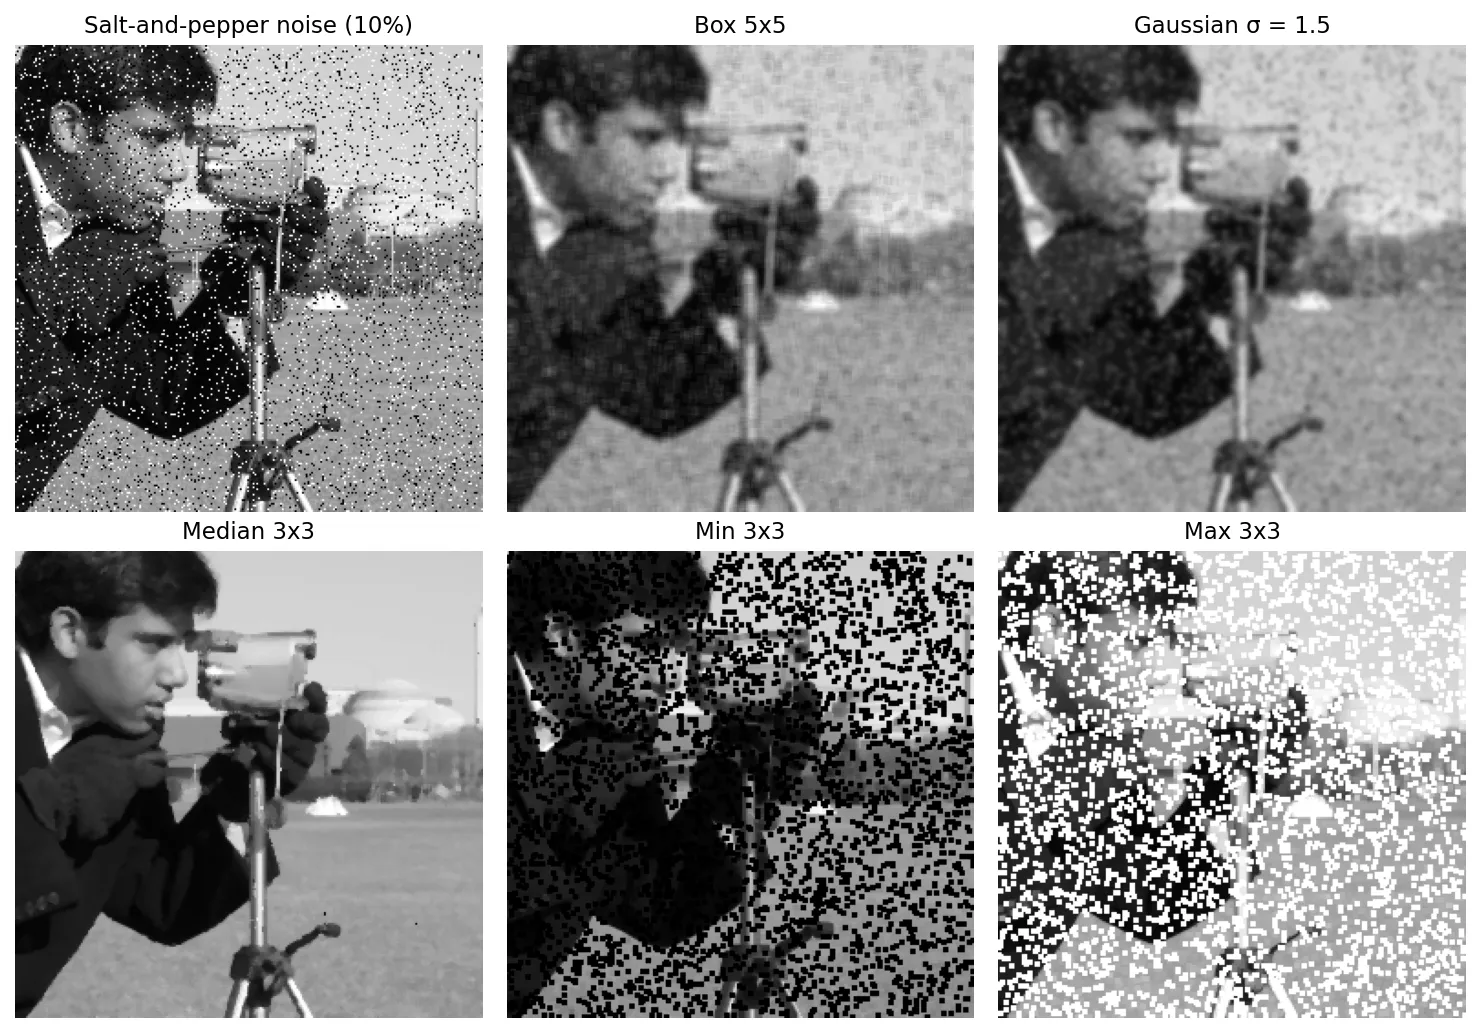
銳化(高通)空間濾波器
白話版。 平滑是取平均;銳化則相反,要突顯差異。鄰居之間的差異就是導數,所以銳化是用導數做出來的。
一階與二階導數
對像素格點上的一維訊號 ,最簡單的近似是
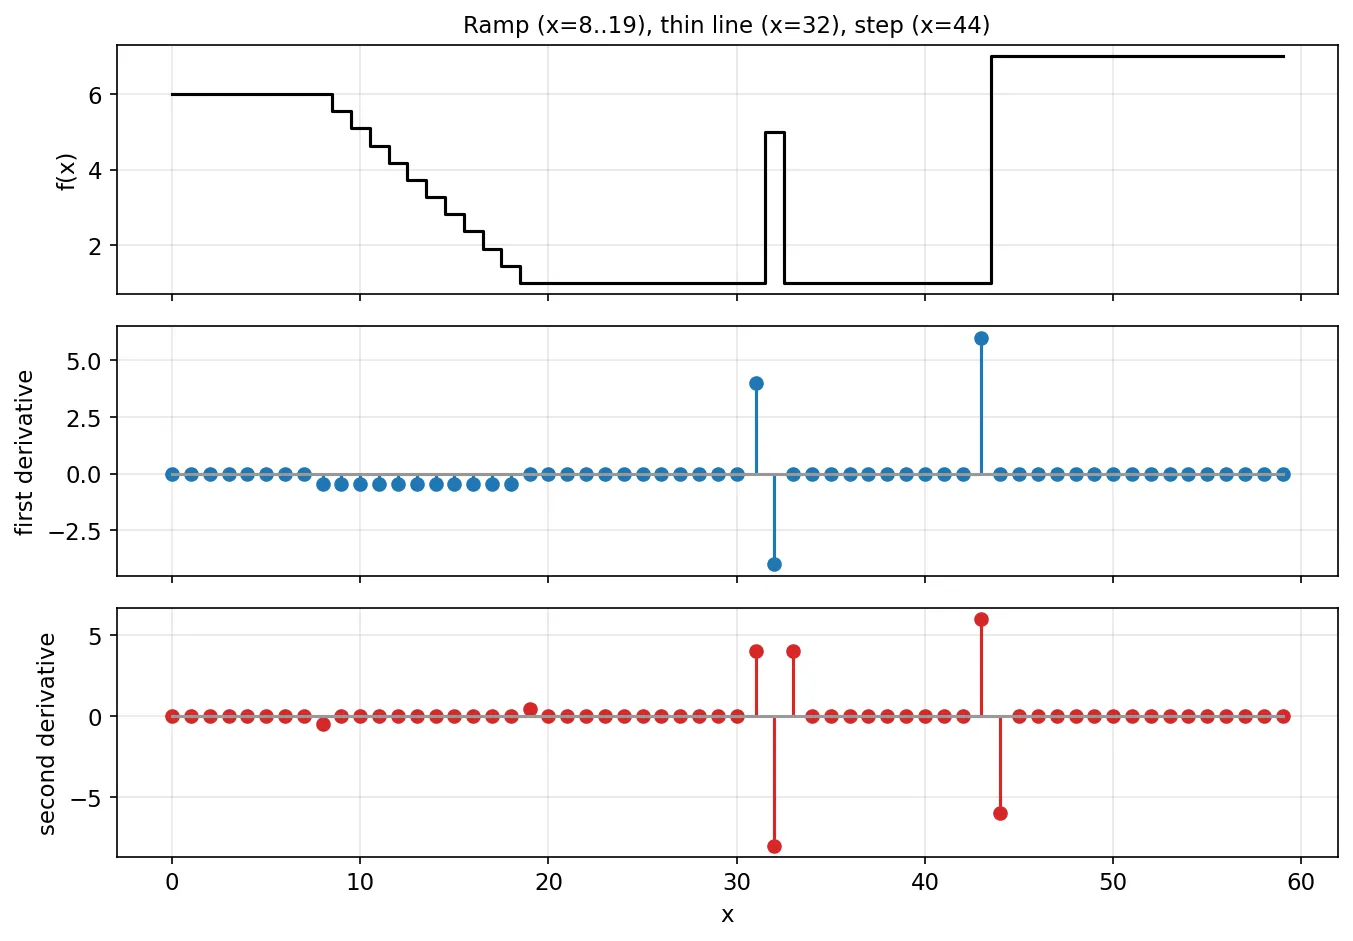
圖 3.6 把兩者套用在一條手工製作的剖面上,其中有一段斜坡、一條一個像素寬的細線和一個階梯。從圖中可以讀出選擇導數的規則:
- 在平坦區域,兩種導數都是 0。
- 沿著斜坡,一階導數一路都不為零,因此響應很粗;二階導數只在斜坡的起點與終點不為零。
- 在細線處,二階導數有強烈的雙重響應(正、強負、正),而且幅度比一階導數大。細小的細節正是銳化該強調的東西。
- 在階梯處,二階導數產生相鄰的一正一負值,兩者之間的零交越(zero crossing)可精確定位邊緣,第 10 章會把它用在邊緣偵測上。
所以要增強細節時,二階導數是比較自然的選擇。
拉普拉斯運算子
最簡單的等向性二階導數運算子(影像旋轉時響應不變)是拉普拉斯運算子(Laplacian):
把上面的一維差分分別用在 與 方向並相加,得到
也就是與下列卷積核做相關:
若再加入兩個對角方向,會得到外圈八格都是 、中心為 的版本,它以 45° 而非 90° 為間隔具有等向性。把所有正負號翻轉,同樣是有效的卷積核。權重總和為 0,所以平坦區域會消失,只留下變化。
用拉普拉斯銳化。 拉普拉斯影像大多是灰色(零),在邊緣處有亮暗的鑲邊。把它加回原圖,就把這些鑲邊疊到邊緣上:
其中中心為負的卷積核(如上面的 )取 ,中心為正的卷積核取 。正負號很重要:選錯號,邊緣反而會被模糊。由於卷積具有分配律, 本身就是單一卷積核:中心為 、上下左右為 ,正是下方實驗室中的 sharpen 預設。
試試 gaussian 與 box-blur 預設來平滑,再試 laplacian 看純粹的二階導數響應。把 sharpen 卷積核的中心從 5 改成 6,權重總和就變成 2,整張影像會變亮,這說明了總和為什麼重要。
反銳化遮罩與高增強濾波
這是來自傳統暗房的技巧:減去一份模糊的副本來分離出細節,再把細節加回去。
其中 是 的模糊(低通)版本, 是反銳化遮罩(unsharp mask,即被模糊去掉的細節), 是權重。 時稱為反銳化遮罩(unsharp masking); 時稱為高增強濾波(highboost filtering); 時效果溫和。因為 是高通訊號,這是另一種加入高通細節的方式;若 是高斯模糊,模糊的 就決定了哪種大小的細節會被增強。
太大會產生明顯的光暈(halo):強烈邊緣兩側出現過衝,輸出也可能超出有效範圍,所以要裁切(clip)。
梯度與 Sobel 運算子
一階導數是以梯度(gradient)的形式使用,也就是偏導數組成的向量
它指向強度增加最快的方向。它的長度,即梯度大小
在邊緣處大、在平坦區域接近 0。右邊的近似省去了開根號,但不具等向性。
Sobel 運算子用 卷積核估計 與 :
兩者都可分離:,即一個方向的中央差分乘上另一個方向的輕微平滑。中間的 讓中央那一列或那一行的權重較大,降低運算子對雜訊的敏感度。(卷積教學就是用 當作邊緣偵測的例子。)梯度大小很少直接拿來銳化,更常用來找出邊緣,或當作遮罩來決定哪裡允許銳化,就像下面的綜合範例。
f = img_as_float(data.chelsea()[..., 1]).astype(np.float32)
lap_k = np.array([[0, 1, 0], [1, -4, 1], [0, 1, 0]], np.float32)
lap = cv2.filter2D(f, -1, lap_k)
sharp = np.clip(f - lap, 0, 1)                 # 中心為負,所以 c = -1

blur = cv2.GaussianBlur(f, (0, 0), 2)
mask = f - blur                                # g_mask
unsharp = np.clip(f + 1.0 * mask, 0, 1)        # alpha = 1
highboost = np.clip(f + 3.0 * mask, 0, 1)      # alpha = 3

gx = cv2.Sobel(f, cv2.CV_32F, 1, 0, ksize=3)
gy = cv2.Sobel(f, cv2.CV_32F, 0, 1, ksize=3)
M = np.hypot(gx, gy)                           # 梯度大小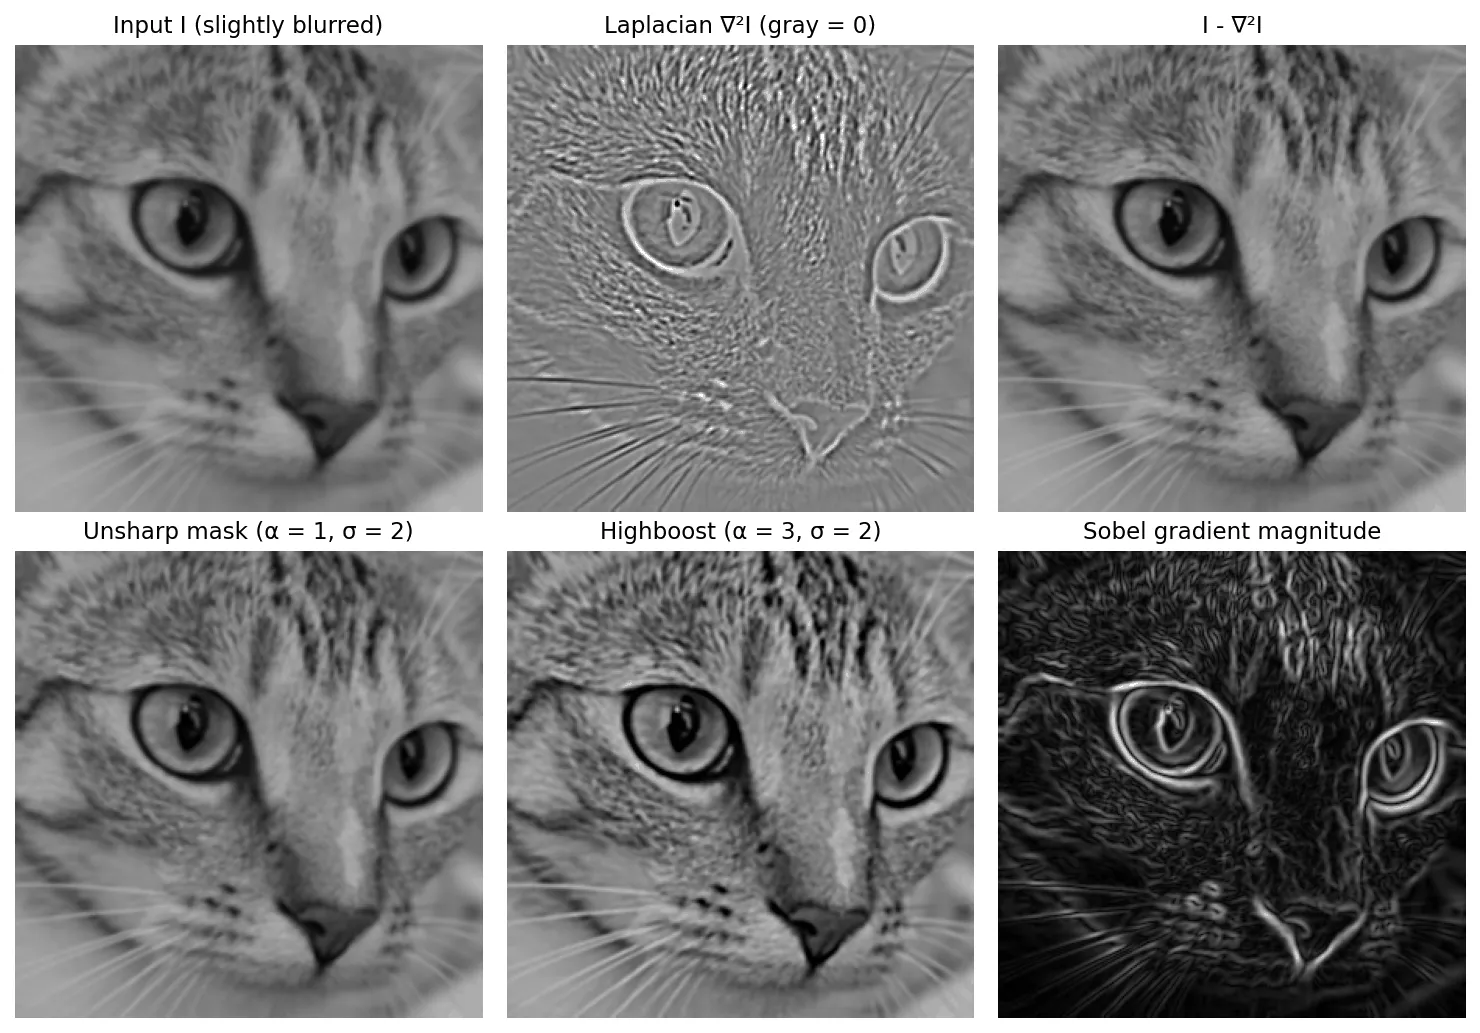
濾波時一律使用浮點數。uint8 的流程會把拉普拉斯或 Sobel 響應的負值裁成 0,悄悄丟掉一半的資訊。
由低通濾波器構成高通、帶拒與帶通濾波器
白話版。 如果你知道怎麼保留平滑的部分,你也就知道怎麼保留平滑部分以外的一切:相減就好。
令 為單位脈衝卷積核:中心為 1、其餘為 0,因此 。它的轉移函數在所有頻率都等於 1(全通濾波器)。若 是轉移函數為 的低通卷積核,則
反銳化遮罩正是如此:。
要隔離某一頻帶,就組合兩個低通濾波器。令 為 較小的高斯(截止頻率高,保留較多細節), 為 較大的高斯(截止頻率低)。則
帶通(bandpass)卷積核 保留 讓過、但 擋下的頻率。帶拒(bandreject)卷積核 是一個低通加一個高通,只去除中間那段頻帶。帶通 就是高斯差(difference of Gaussians, DoG),它也是高斯拉普拉斯的良好近似,並且是第 12 章尺度空間偵測器的基礎。權重總和可以驗證設計:高通與帶通卷積核總和為 0,帶拒卷積核總和為 1。
def gauss_kernel(sigma):
    n = 2 * int(np.ceil(3 * sigma)) + 1          # 約 6 sigma,取奇數
    g = cv2.getGaussianKernel(n, sigma)
    return g @ g.T

def delta_like(K):
    D = np.zeros_like(K); D[K.shape[0] // 2, K.shape[1] // 2] = 1
    return D

lp2 = gauss_kernel(4.0)                          # 低截止頻率
lp1 = gauss_kernel(1.0)                          # 高截止頻率
lp1 = np.pad(lp1, (lp2.shape[0] - lp1.shape[0]) // 2)   # 補零到相同大小
hp = delta_like(lp1) - lp1                       # 高通,總和為 0
bp = lp1 - lp2                                   # 帶通(DoG),總和為 0
br = delta_like(bp) - bp                         # 帶拒,總和為 1
結合多種空間增強方法
白話版。 真實影像很少只有一個問題。有用的增強通常是一條短短的處理流程,而且步驟的順序很重要。
以下是一個實作範例。輸入(圖 3.8a)是一張曝光不足的人像,帶有少量高斯雜訊,以及 4% 的椒鹽脈衝。我們希望得到更亮、更清晰的影像,又不放大雜訊。
- 先用 3×3 中值濾波器去除脈衝(b)。脈衝是極端值,後續任何拉對比或銳化都會讓它們更糟,而線性模糊只會把它們攤開。中值濾波能去除它們又保留邊緣。
- 用 gamma 0.45 提亮暗部(c)。全域的亮度問題,正適合用點運算處理。在中值之後才做,曲線就不會被黑白脈衝干擾。
- 建立邊緣權重圖(d)。用高斯()模糊影像,計算模糊後影像的 Sobel 梯度大小 ,再正規化成 ,其中 是 的第 90 百分位數。因為是在平滑之後計算, 在真正的邊緣上接近 1,在平坦區域殘留的雜訊上接近 0。
- 套用由權重圖控制的反銳化遮罩(f): ,其中 是 gamma 校正後的影像、 是它的高斯模糊、,乘法逐像素進行。
(e) 是用相同 的一般反銳化遮罩:背景與深色衣領都變得粗糙,因為雜訊同樣是高頻細節。受控版本 (f) 對臉、頭髮與太空衣輪廓的銳化程度幾乎一樣,卻讓平滑的背景保持乾淨。這種「用平滑後的一階導數影像來決定哪裡要做二階銳化」的模式,可以看作「現代觀點」中保邊處理的手工版本。
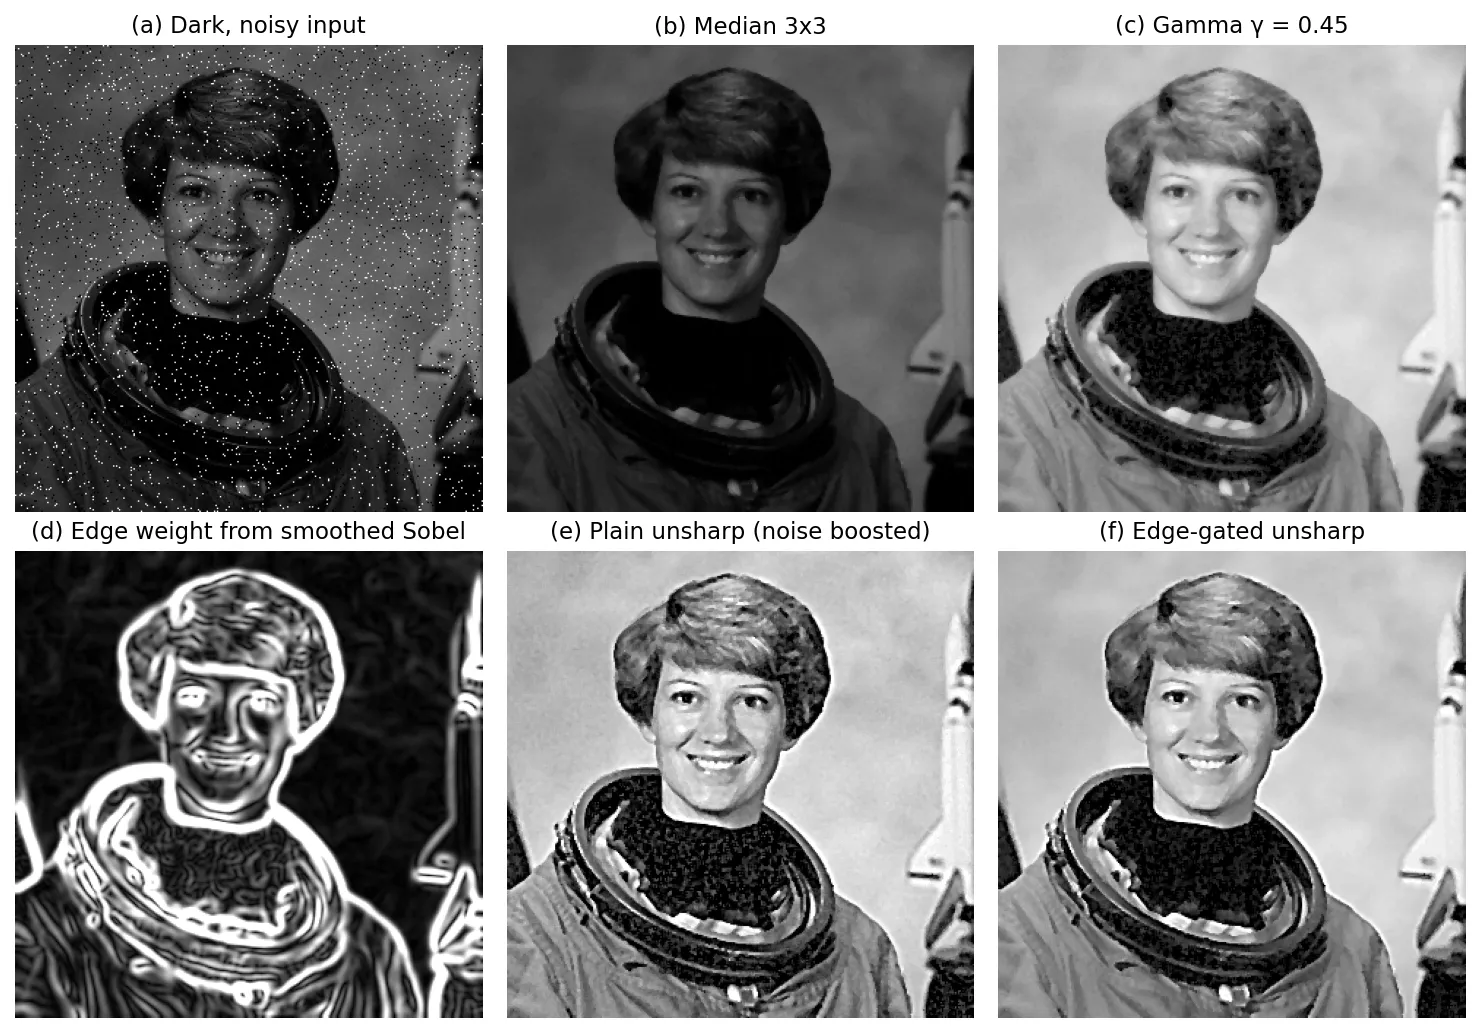
每一步都用到本章的一個概念。步驟順序遵循三條經驗法則:在任何會放大差異的步驟之前先去除離群值;用點運算修正整體色調;只在訊號強於雜訊的地方銳化。
現代觀點
本章的技術已有數十年歷史,卻至今隨處可見:CLAHE 是醫學影像與遙測的標準前處理步驟,gamma 與色調曲線存在於每一條相機處理流程,高斯、中值與 Sobel 濾波器則存在於每一套視覺函式庫。後來的研究朝三個方向推進:更聰明的對比增強、能平滑卻不模糊邊緣的濾波器,以及兩者的學習式替代方案。下面的綜述是很好的入門點。
對比增強與直方圖方法。 Pizer 等人 [2] 至今仍是自適應直方圖等化的代表性分析:說明區域對應如何運作、AHE 為何在均勻區域過度增強雜訊,以及讓這個方法變得實用的各種變體(包括對比限制與在小塊對應之間做內插)。Zuiderveld 的章節 [3] 是後來各函式庫沿用的精簡 CLAHE 實作,Reza [4] 則展示了同一演算法如何對應到即時硬體。在直方圖規定化方面,Coltuc、Bolon 與 Chassery [5] 說明如何用區域平均嚴格排序像素,以得到完全符合目標的直方圖。若想要更全面的領域地圖,Qi 等人 [11] 綜述了過去二十年的影像增強方法,將其分為監督式與非監督式演算法,並把品質評估列為第三個面向;它的價值在於並排討論各類方法的限制、優點與缺點。
保邊濾波器。 方框與高斯濾波器的弱點是會跨越邊緣取平均。Tomasi 與 Manduchi 的雙邊濾波器(bilateral filter)[6] 在空間高斯權重之外,再乘上一個隨強度差異遞減的權重,讓邊緣另一側的像素幾乎沒有貢獻。Paris、Kornprobst、Tumblin 與 Durand 的綜述 [7] 解釋了它的行為、快速實作,以及色調映射、細節增強等應用,在這些應用中影像會被拆成平滑的基底層與細節層。He、Sun 與 Tang 的導引濾波器(guided filter)[8] 假設輸出是導引影像的區域線性函數;它只需要以方框濾波器計算區域平均與變異數,所以計算量與半徑無關,而且在強烈邊緣附近的表現比雙邊濾波器好,後者在細節增強時可能產生梯度反轉(gradient reversal)的瑕疵。Milanfar 的教學文章 [9] 把雙邊、非局部平均(non-local means)等濾波器統一看作資料自適應的加權平均,即卷積核權重取決於影像本身,並用線性代數工具加以分析。Gingichashvili 與 Lischinski [10] 指出眾多保邊濾波器過去大多只靠肉眼比較,並提出系統化的評估方法與共同基準。
深度學習改變了什麼。 最有意思的發現是,本章有多少內容在學習式系統內部存活下來。許多成功的增強網路並不直接輸出像素,而是預測某個傳統運算子的參數,再套用它。
- 學習曲線。 Zero-DCE [13](2020)預測逐像素的高階曲線(反覆套用形如 的簡單二次式, 逐像素預測)來提亮低光影像。它的訓練完全不需要參考影像,而是使用直接評分增強結果的非參考損失函數。這就是 gamma 與對比拉伸的概念,只是曲線由一個小型 CNN 逐像素決定。
- 學習查找表。 Zeng 等人 [14](2020)學習幾張基底 3D 色彩查找表,再用一個極小的 CNN 預測每張影像該如何混合它們,能在高解析度照片上即時執行。這是強度轉換的查找表觀點,從灰階延伸到色彩。
- 學習式保邊濾波器。 Gharbi 等人的 HDRNet [15] 在低解析度的雙邊網格(bilateral grid)中預測區域仿射色彩轉換,再以輸入影像為導引在全解析度套用,等於把雙邊濾波器的保邊能力變成可學習的層。Wu 等人 [16] 則把導引濾波器做成可微分的層,可以在網路中端對端訓練。
- 低光增強。 Li 等人的綜述 [12] 依學習策略、網路結構、損失函數與訓練資料,回顧了深度學習的低光影像與影片增強,並提出一個以多款手機在各種照明下拍攝的低光資料集,以及一個比較方法的線上平台。後續模型如 Retinexformer [17](2023)則結合 Retinex 模型(把影像視為照明乘以反射率)與由照明估計導引的 Transformer 注意力機制。
沒有改變的部分:中值濾波器仍是脈衝雜訊的首選,Sobel 卷積核仍出現在損失函數與邊緣圖中,CLAHE 仍是預設的前處理步驟,而 gamma 處理仍是混用線性與編碼像素值的學習式流程中常見的錯誤來源。深度模型也往往繼承了傳統方法的失敗模式:光暈、暗部雜訊放大與過度增強,仍是審查者會特別檢查的瑕疵。
重點整理
- 強度轉換 就是一張查找表,斜率就是局部對比增益。對數與 的曲線擴張暗部, 擴張亮部,分段線性曲線則提供精確控制。
- 直方圖等化以縮放後的 CDF 作為 ,在連續情形下讓輸出 PDF 成為均勻分布,在離散情形下則近似平坦。匹配是把一次等化接上另一次等化的反函數;精確匹配則先用區域平均打破平手。
- 區域方法(AHE、CLAHE、區域平均與變異數規則)會依區域調整;CLAHE 藉由截斷每個區域直方圖來限制對比增益。
- 線性空間濾波就是與卷積核做相關;卷積會翻轉卷積核,並具有漂亮的代數性質。可分離卷積核每個像素只需 次運算,而非 次。
- 低通濾波器(方框、高斯)以平均去除雜訊,但會模糊邊緣;非線性的中值濾波器是對付脈衝雜訊的工具。
- 銳化就是加入高通細節:拉普拉斯(二階導數)、反銳化遮罩與高增強;梯度與 Sobel 運算子則用來衡量邊緣強度。
- 高通、帶通與帶拒卷積核都能由低通卷積核從脈衝 相減得到;好的處理流程會安排步驟順序,不讓後面的步驟放大前面本該去除的東西。
練習
- 替霧濛濛的照片設計曲線。 一張 8 位元影像的像素值全落在 90 到 160 之間。寫出把這個範圍對應到 的分段線性轉換、它的斜率,並說明值為 120 與 122 的兩個相鄰像素會怎樣。
提示
時 ,範圍外則裁切到 。斜率為 ,所以相差 2 會變成約 7.3 個灰階。四捨五入後 、。
- 手算等化。 一張 3 位元()、共 16 個像素的小影像,灰階 到 的計數為 。計算等化查找表與輸出直方圖。為什麼輸出不是平坦的?
提示
CDF 為 ,所以 得到 ( 捨入為 4)。輸出直方圖為:灰階 4 有 8 個像素、5 有 4 個、6 有 2 個、7 有 2 個。灰階 1 的 8 個像素共用同一個輸入值,查找表無法拆開它們,只有精確直方圖規定化才能做到。
- 順序重要嗎? 先套用 gamma 曲線再做方框(平均)濾波,和先做方框濾波再套用 gamma 曲線,結果一樣嗎?請證明,或用 2 個像素的平均舉出反例。
提示
不一樣。取兩個像素 0 與 1、。先 gamma:;先平均:。非線性的點運算與線性濾波器不能交換順序。這也是為什麼模糊 gamma 編碼的影像,不等於模糊線性光。
- 可不可以分離? 判斷下列卷積核是否可分離,若可以,寫出兩個向量:(a) 中心為 的 拉普拉斯;(b) 全部為 1 的 卷積核;(c) 。
提示
(a) 不行:它的秩為 2(但它是兩個可分離卷積核的和,每個軸各一個)。(b) 可以:。(c) 可以:,是高斯的小型二項式近似。可用 np.linalg.matrix_rank 驗證。
- 邊緣上的中值與平均。 一維訊號 是完美的階梯。分別做 3 點平均與 3 點中值(忽略兩端樣本)。接著把位置 1(從 0 起算)的樣本換成值為 255 的脈衝,再做一次。你得到什麼結論?
提示
在乾淨的階梯上,平均得到一段斜坡(),中值則完整保留階梯。加入脈衝後,平均在位置 1 與 2 產生兩個約 92 的升高值;中值在這兩處輸出 10,完全去除脈衝。
- 設計帶通卷積核。 用 與 的高斯,在 NumPy 中建立帶通與帶拒卷積核。驗證兩者的權重總和,用它們濾波
skimage.data.brick(),並描述各自保留了哪些結構。
提示
先把兩個卷積核補成相同大小(較小者補零),再計算 與 。總和應約為 0 與 1。帶通輸出保留灰縫線條與磚塊尺度的紋理,去除整體明暗與最細的顆粒;帶拒輸出保留明暗與細顆粒,但減弱了磚塊圖樣。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 3. publisher page
- S. M. Pizer, E. P. Amburn, J. D. Austin, R. Cromartie, A. Geselowitz, T. Greer, B. ter Haar Romeny, J. B. Zimmerman and K. Zuiderveld, “Adaptive histogram equalization and its variations,” Computer Vision, Graphics, and Image Processing, 1987. doi
- K. Zuiderveld, “Contrast limited adaptive histogram equalization,” in P. S. Heckbert (ed.), Graphics Gems IV, Morgan Kaufmann, 1994, pp. 474–485. entry
- A. M. Reza, “Realization of the contrast limited adaptive histogram equalization (CLAHE) for real-time image enhancement,” Journal of VLSI Signal Processing, 2004. doi
- D. Coltuc, P. Bolon and J.-M. Chassery, “Exact histogram specification,” IEEE Transactions on Image Processing, 2006. doi
- C. Tomasi and R. Manduchi, “Bilateral filtering for gray and color images,” in Proc. IEEE International Conference on Computer Vision (ICCV), 1998. pdf
- S. Paris, P. Kornprobst, J. Tumblin and F. Durand, “Bilateral filtering: Theory and applications,” Foundations and Trends in Computer Graphics and Vision, vol. 4, no. 1, pp. 1–73, 2009. doi
- K. He, J. Sun and X. Tang, “Guided image filtering,” in Proc. European Conference on Computer Vision (ECCV), 2010, pp. 1–14; extended version in IEEE TPAMI, 2013. doi
- P. Milanfar, “A tour of modern image filtering,” IEEE Signal Processing Magazine, vol. 30, no. 1, pp. 106–128, 2013. IEEE Xplore
- S. Gingichashvili and D. Lischinski, “Evaluation and comparison of edge-preserving filters,” arXiv:2012.13778, 2020. arXiv
- Y. Qi, Z. Yang, W. Sun et al., “A comprehensive overview of image enhancement techniques,” Archives of Computational Methods in Engineering, 2021. doi
- C. Li, C. Guo, L. Han, J. Jiang, M.-M. Cheng, J. Gu and C. C. Loy, “Low-light image and video enhancement using deep learning: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2021 (arXiv:2104.10729). arXiv
- C. Guo, C. Li, J. Guo, C. C. Loy, J. Hou, S. Kwong and R. Cong, “Zero-reference deep curve estimation for low-light image enhancement,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- H. Zeng, J. Cai, L. Li, Z. Cao and L. Zhang, “Learning image-adaptive 3D lookup tables for high performance photo enhancement in real-time,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2020. arXiv
- M. Gharbi, J. Chen, J. T. Barron, S. W. Hasinoff and F. Durand, “Deep bilateral learning for real-time image enhancement,” ACM Transactions on Graphics (SIGGRAPH), 2017. arXiv
- H. Wu, S. Zheng, J. Zhang and K. Huang, “Fast end-to-end trainable guided filter,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- Y. Cai, H. Bian, J. Lin, H. Wang, R. Timofte and Y. Zhang, “Retinexformer: One-stage Retinex-based transformer for low-light image enhancement,” in Proc. IEEE/CVF ICCV, 2023. arXiv