第 2 章・數位影像基礎
先備知識: 第 1 章・緒論
你將學到
- 人眼如何感知光,以及為什麼我們「看到的」不一定是「實際存在的」(亮度適應、Weber 比、馬赫帶、同時對比)
- 影像在物理上從哪裡來:電磁波譜、感測器,以及照度–反射率模型
- 取樣與量化在做什麼、它們如何決定空間解析度與強度解析度,以及最近鄰、雙線性、雙三次內插如何縮放影像
- 像素之間關係的術語:鄰居、相鄰、連通、區域、邊界,以及三種距離量測
- 之後每一章都會用到的數學工具箱:逐元素運算與矩陣運算、線性、算術運算、集合與邏輯運算、幾何轉換、影像轉換,以及把直方圖當成機率
先看全貌
第 1 章說明了數位影像處理「是什麼」。這一章要回答「數位影像到底是什麼」:從離開場景的光開始,一路走到記憶體裡的一格格整數。途中我們會定義像素、鄰居、解析度、線性運算子等詞彙——之後整個系列都會直接使用它們,不再另外解釋。
這一章不只是記帳。第一,大多數影像最後是給人看的,所以我們必須知道眼睛在哪裡容易被騙、在哪裡又特別敏銳。第二,拍攝影像時做的每個選擇——取樣多少點、量化成幾階、用哪一種內插——都會留下痕跡,後續的演算法只能與之共處。深度學習並沒有讓這些選擇消失;它多半只是把這些選擇搬進了訓練資料與損失函數裡,「現代觀點」一節會說明這點。
視覺感知的要素
白話說:你的眼睛是一台由膠狀物質和神經細胞組成的相機。它非常擅長看出「差異」與「邊緣」,卻不太會判斷絕對亮度。
眼睛的構造與成像
光線穿過角膜,通過瞳孔(大小由虹膜控制),再由水晶體聚焦到視網膜上——那是眼球後方一層薄薄的感光細胞 [1]。水晶體是有彈性的:睫狀肌改變它的曲率,也就改變了焦距,讓遠近物體都能對焦。視網膜上的像是倒立的實像,和相機感測器上的像一樣。
視網膜上有兩種感光細胞 [1]:
- 錐細胞(cones)——每隻眼睛有數百萬個,最密集地分布在中央一個小凹處,稱為中央窩(fovea)。它們在明亮環境下運作(明視覺,photopic vision),分成三種光譜敏感度不同的類型,帶給我們色彩與細節。許多錐細胞擁有自己專屬的神經連結,所以中央窩的視覺特別清晰。
- 桿細胞(rods)——數量多出許多倍,散布在整個視網膜上,但中央窩正中央沒有。它們在昏暗環境下運作(暗視覺,scotopic vision),無法分辨顏色,而且許多桿細胞共用一條神經末梢,用細節換取靈敏度。這就是為什麼月光下的物體看起來沒有顏色、輪廓也比較柔和。
視神經離開眼球的地方完全沒有感光細胞,稱為盲點。你平常察覺不到,是因為大腦會自動把空缺補上——這是一個早期的線索:知覺是一種主動的重建,而不是單純的記錄。
亮度適應與亮度辨別
視覺系統能應付極大範圍的光強度,從星光到陽光都行。它靠的是亮度適應(brightness adaptation):在任一時刻,它只在以目前適應水準為中心的一個窄窗內運作,而這個窗會隨整體光線改變而滑動 [1]。在窗內,主觀亮度大致隨物理光強度的對數成長,而不是線性成長。
我們能察覺多小的變化?讓觀察者看一片強度為 的均勻背景,再閃一個強度為 的小光點。有一半機率被察覺到的增量記為 。比值
稱為 Weber 比(Weber ratio),其中 是背景強度, 是剛好能察覺的增量。 越小代表辨別能力越好(很小的相對變化就看得出來)。在很寬的中間強度範圍內, 大致是常數,這就是 Weber 定律:我們感受到的是相對變化,而不是絕對變化。在低強度、由桿細胞主導時, 很大,辨別能力很差 [1]。
這有直接的工程意義。因為我們感受的是相對變化,物理上等間隔的灰階在知覺上並不等間隔。這也是影像通常以非線性(gamma)編碼儲存的原因之一,以及 8 位元通常就足以顯示的原因之一。
馬赫帶、同時對比與錯覺
感受到的亮度並不是強度的簡單函數。兩個經典示範讓這件事一目了然 [1]:
- 馬赫帶(Mach bands)。給人看一組階梯狀、各自均勻的灰色條紋。每一條在物理上都是均勻的,但觀察者會說在每個邊緣的暗側看到一條更暗的細帶、亮側看到一條更亮的細帶。視覺系統會誇大邊緣,這與相鄰感受野之間的側向抑制(lateral inhibition)相符——本質上就是一個內建的銳化濾波器。
- 同時對比(simultaneous contrast)。同一塊中灰色方塊,放在暗背景上看起來較亮,放在亮背景上看起來較暗,儘管兩塊方塊完全相同。感受到的亮度取決於周圍環境。
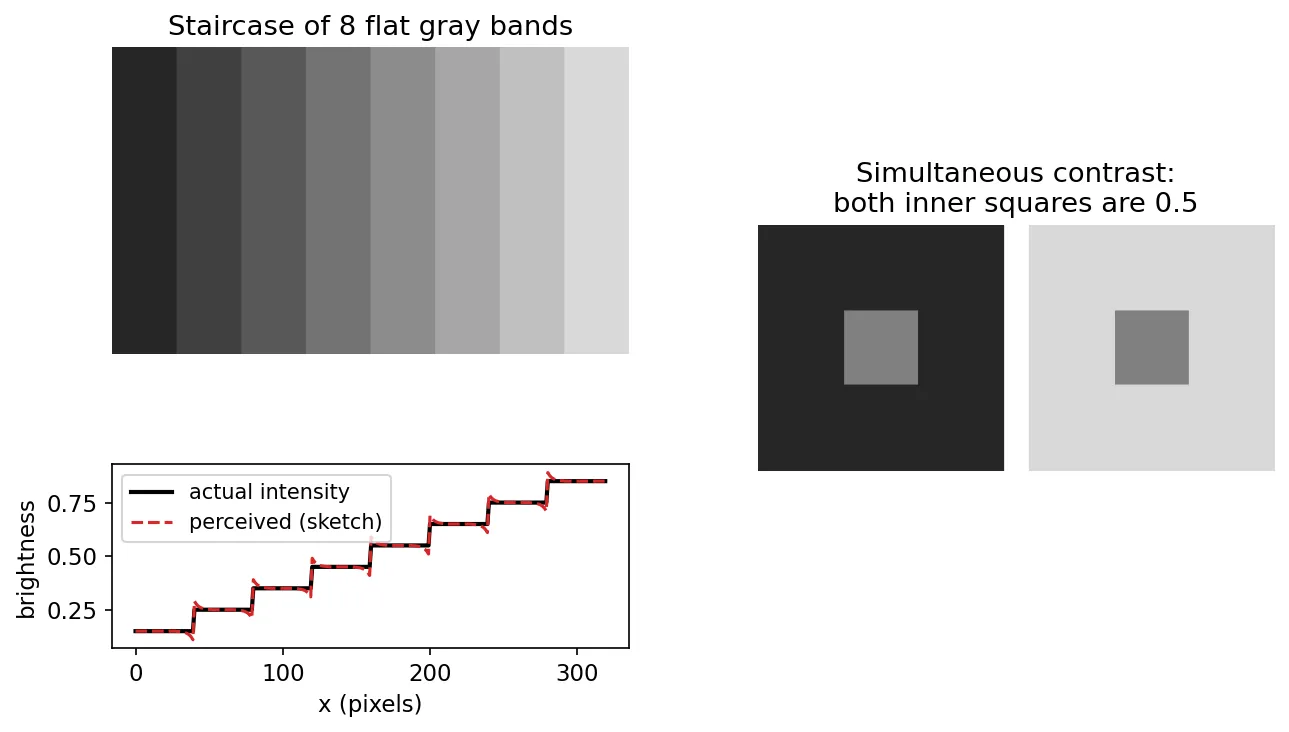
一般的視錯覺——看見沒畫出來的輪廓、等長線段看起來不等長——都顯示眼睛會補足並重新詮釋。這對影像處理有兩層意義:一個把平方誤差降到最低的演算法,產生的影像仍可能看起來不對;而數值上很小的瑕疵,若剛好落在邊緣上,可能非常顯眼。這正是感知品質指標的出發點,會在「現代觀點」中討論。
光與電磁波譜
白話說:光是一種能量波。可見光只是寬廣波譜中薄薄的一片,這個波譜還包括無線電波、微波、紅外線、紫外線、X 射線與伽瑪射線——而這些都可以拿來成像。
波長、頻率與能量
電磁輻射可以描述成正弦波,也可以描述成一串無質量的粒子,稱為光子 [1]。兩種描述的關係是
其中 是波長(公尺), 是頻率(赫茲), m/s 是光速, 是單一光子的能量(焦耳), 是普朗克常數。波長越短,頻率越高,每個光子的能量也越高。所以伽瑪射線和 X 射線能穿透組織,而無線電波需要很大的天線才能偵測。
可見光大約從 400 nm(紫)到 700 nm(紅)。物體看起來是什麼顏色,取決於它反射哪些波長:綠葉主要反射波段中段的光,其餘被吸收。沒有顏色、只有強度的光稱為無色光(achromatic)或單色光(monochromatic),它的強度稱為灰階(gray level)。
輻射度、輝度與亮度
有三個詞很容易混淆 [1]:
- 輻射度(radiance)——從光源流出的總能量,以瓦特計,是純物理量。
- 輝度(luminance)——觀察者感受到的能量多少,以流明計。它用眼睛的光譜敏感度來加權輻射度:紅外光源的輻射度可以很高,輝度卻幾乎為零。
- 亮度(brightness)——對強度的主觀感受。它無法直接量測,而且如上一節所示,會受適應狀態與周圍環境影響。
感測器的敏感度曲線扮演眼睛的角色:影像好不好,取決於感測器偵測的波段與物體發出或反射的波長是否相配。要對一個物體成像,波長還必須與物體尺寸相當或更小——這也是電子顯微鏡(有效波長極短)能解析比光學顯微鏡小得多的結構的原因之一。
影像感測與擷取
白話說:感測器就是一個把光轉成電壓的小小測光表。把很多個排成一列或一個網格,就成了掃描器或相機。
單一、線型與陣列感測器
每一種成像裝置都結合了照明光源、場景,以及由對目標能量有反應的材料做成的感測器 [1]。感測器輸出的電壓經數位化後成為一個數字。感測器有三種排列方式:
- 單一感測器。一個偵測器(例如光二極體)加上兩個方向的機械移動,一次一個取樣點地掃出整張影像。速度慢,但便宜又非常精確,一些高精度掃描器採用這種方式。
- 線型(條狀)感測器。一排偵測器一次擷取一條線,再靠垂直於感測條的移動提供第二個維度。平台式掃描器和航空推掃式(push-broom)成像儀就是這樣運作。把感測器排成環狀、圍繞一個旋轉的光源,就是電腦斷層掃描(CT)的幾何架構;CT 的影像是重建出來的,而不是直接讀出。
- 陣列感測器。一個 2-D 的偵測器網格,例如 CCD 或 CMOS 晶片,一次擷取整張影像,這就是數位相機。鏡頭把場景聚焦到陣列上,每個偵測器在曝光時間內累積光量,讀出電路為每個偵測器產生一個值。
彩色相機通常在陣列上覆蓋一層紅、綠、藍濾光片組成的馬賽克,所以每個偵測器只量到一種顏色;每個像素缺少的另外兩個值,會在相機的影像處理管線中以內插補齊(去馬賽克,demosaicking)[8]。
簡單的成像模型
我們把一張單色影像寫成 2-D 函數 ,其值正比於抵達 的能量。因為它來自物理能量,所以 。對反射光而言,把 拆成兩個因子很有幫助 [1]:
其中 是照度(illumination)(照到該場景點的光有多少), 是反射率(reflectance)(表面反射了其中多少比例,從接近 0 的完全吸收到接近 1 的完全反射)。照度取決於光源;反射率則是物體本身的性質。在 X 射線之類的穿透式成像中,以**穿透率(transmissivity)**取代反射率。
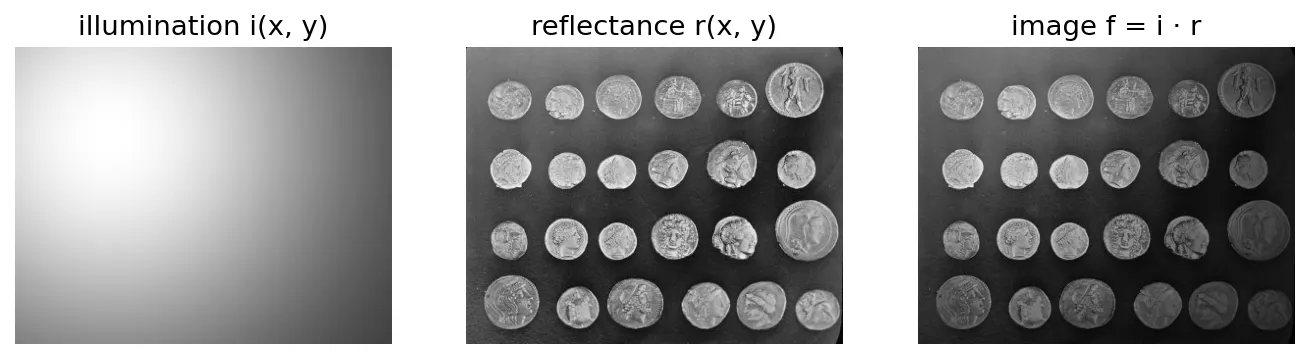
import numpy as np
from skimage import data, img_as_float

r = img_as_float(data.coins())          # 反射率,範圍 [0, 1]
h, w = r.shape
yy, xx = np.mgrid[0:h, 0:w]
i = 0.2 + 0.8 * xx / (w - 1)            # 照度斜坡:左暗右亮
f = i * r                               # 感測器記錄到的影像
這個模型很簡單,卻很實用。照度通常在場景中緩慢變化,反射率則在物體邊緣處劇烈改變。後面的章節會利用這一點:同態濾波(homomorphic filtering,第 4 章)取 把兩者分開;陰影校正(本章稍後)則把已知的 除掉。
影像取樣與量化
白話說:相機只在有限個位置量測連續的場景(取樣),再把每個量測值四捨五入到有限個階層之一(量化)。
基本概念
感測器的輸出是在連續平面上的連續電壓波形。要變成數位的,座標和振幅都必須離散化 [1]:
- **取樣(sampling)**把座標數位化:我們只保留網格位置上的值。
- **量化(quantization)**把振幅數位化:每個保留的值都對應到有限個階層中最接近的那一個。
對陣列感測器而言,偵測器的數量與間距決定了取樣;類比數位轉換器決定了量化。需要取樣多密,取決於影像內容:根據取樣定理,一個頻寬有限的訊號,只要取樣頻率大於其最高頻率的兩倍,就能完美重建。第 4 章會正式推導;Unser 的回顧論文則提供了以樣條(spline)為基礎、較現代的取樣與重建觀點 [2]。
數位影像的表示法
經過取樣與量化後,影像是一個 列、 行的矩陣:
每個元素是一個像素(pixel,picture element)。依照教科書的慣例 [1], 是列索引、 是行索引,原點在左上角。(許多函式庫,包括 OpenCV 的點座標 API,用的是 =(行, 列)。務必確認。)
強度階數通常是 2 的冪次 ,所以值落在 。儲存一張影像需要
其中 是每像素的位元數。一張 、 的影像需要 262,144 位元組。成像系統的**動態範圍(dynamic range)是可量測的最大強度(受飽和限制)與最小強度(受雜訊限制)之比;某一張影像的對比(contrast)**則是其最高與最低強度之差。
空間解析度與強度解析度
**空間解析度(spatial resolution)**是能辨識的最小細節尺寸,必須帶單位才有意義:每毫米線對數,或印刷時的每英寸點數(dpi)。只說影像是「1024 × 1024」,在不知道它涵蓋多大實際面積前,並沒有說出任何解析度資訊。**強度解析度(intensity resolution)**是能辨識的最小階層變化,通常以位元數 表示。
import numpy as np
from skimage import data

img = data.camera()                       # 512 x 512,uint8(k = 8)
small = img[::4, ::4]                     # 每 4 個取樣點保留一個 -> 128 x 128

def quantize(x, bits):
    step = 2 ** (8 - bits)
    return (x // step) * step + step // 2 # 對應到每個區間的中心

q3 = quantize(img, 3)                     # 8 個灰階
print(small.shape, np.unique(q3).size)    # (128, 128) 8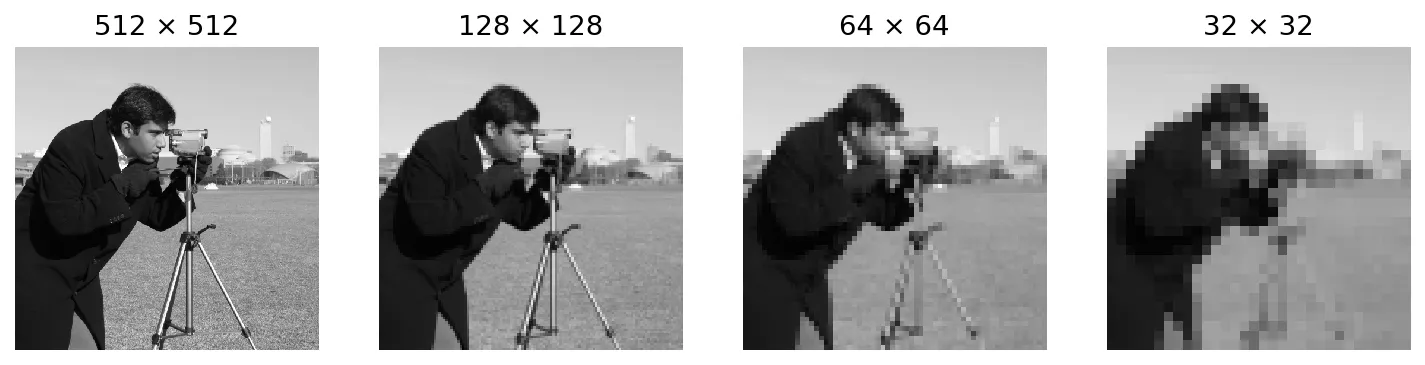
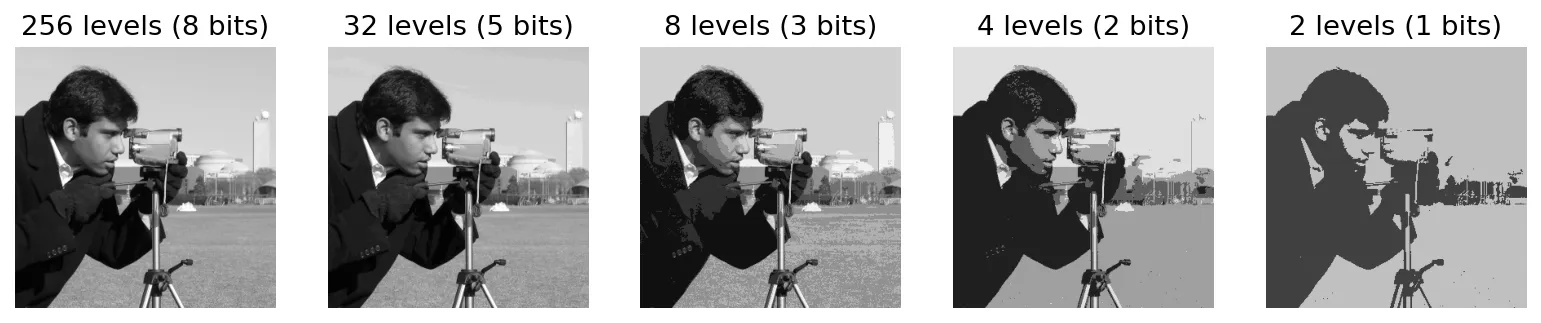
由此得到兩個教訓。減少取樣點時,首先被破壞的是細緻紋理(草、頭髮),接著才是邊緣。減少階層時,首先受損的是平滑區域:圖 2.4 的天空會碎成一階一階,稱為假輪廓(false contouring)——恰好出現在 Weber 比說眼睛最敏感的地方。細節多的影像比平滑的影像更能容忍較少的灰階,因為繁雜的紋理會把階梯掩蓋掉 [1]。
影像內插
內插(interpolation)是在沒有取樣值的位置估計數值。每當影像被縮放、旋轉、變形或對位時,都會用到它 [1]、[3]、[4]。
**最近鄰(nearest neighbor)**直接複製最近取樣點的值。它快速、保留原始數值,但會讓邊緣呈鋸齒方塊;縮小影像時,甚至可能讓細線整條消失。
**雙線性(bilinear)**內插使用最近的四個取樣點。對於距左上取樣點 的小數偏移量為 的位置,
其中 、、 分別是右、下、右下的鄰居。等價地,,四個係數由四個取樣點決定。結果是連續的,但略顯模糊。
import numpy as np

def bilinear(img, x, y):
    """在實數座標(行 x、列 y)處對 img (H, W) 取樣。"""
    x0, y0 = int(np.floor(x)), int(np.floor(y))
    x1, y1 = min(x0 + 1, img.shape[1] - 1), min(y0 + 1, img.shape[0] - 1)
    a, b = x - x0, y - y0
    top = (1 - a) * img[y0, x0] + a * img[y0, x1]
    bot = (1 - a) * img[y1, x0] + a * img[y1, x1]
    return (1 - b) * top + b * bot

print(bilinear(np.array([[0., 10.], [20., 30.]]), 0.5, 0.5))   # 15.0
**雙三次(bicubic)**內插使用最近的 16 個取樣點,擬合 。實務上,它以分段三次核的可分離卷積實作。Keys 提出、廣為使用的核是 [3]
其中 是內插位置到某取樣點的距離(以取樣間距為單位), 是自由參數。Keys 證明在這一族核中, 有最好的逼近階數;不過各函式庫實際採用的值不盡相同。 的負瓣會讓邊緣更銳利,但也可能在強邊緣旁產生輕微的過衝(振鈴,ringing)。
import cv2
from skimage import data

crop = data.camera()[150:214, 230:294]    # 64 x 64
up = {name: cv2.resize(crop, None, fx=4, fy=4, interpolation=flag)
      for name, flag in [("nearest", cv2.INTER_NEAREST),
                         ("bilinear", cv2.INTER_LINEAR),
                         ("bicubic", cv2.INTER_CUBIC)]}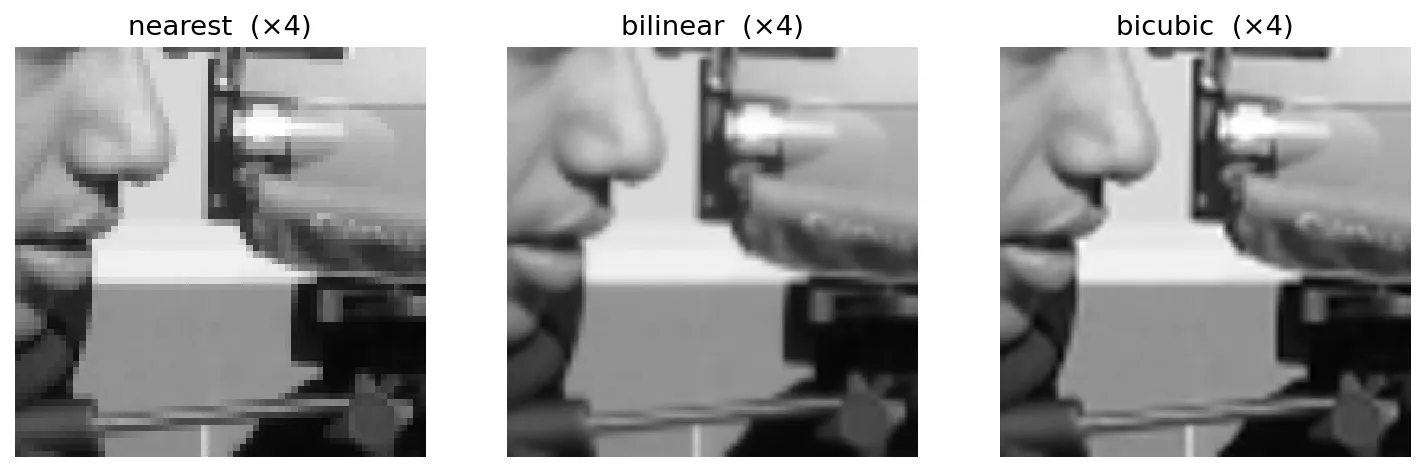
拖動滑桿,比較把 裁切區放大成 時,最近鄰與雙三次的差別。注意相機的邊緣與臉部輪廓。
 最近鄰雙三次
沒有任何內插方法能創造出取樣時已丟掉的細節。Thévenaz、Blu 與 Unser 的回顧 [4] 把這點說得很精確:內插器的品質取決於它的逼近階數,以及它的核有多接近理想(sinc)重建器;在相近的計算成本下,較高階的 B-spline 方法優於傳統的三次卷積。「現代觀點」中討論的學習式超解析度(super-resolution)更進一步,會根據訓練資料腦補出看似合理的細節。
像素之間的基本關係
白話說:在談論影像裡的物體之前,我們需要規定哪些像素彼此「相碰」,以及兩個像素相距多遠。
像素的鄰居
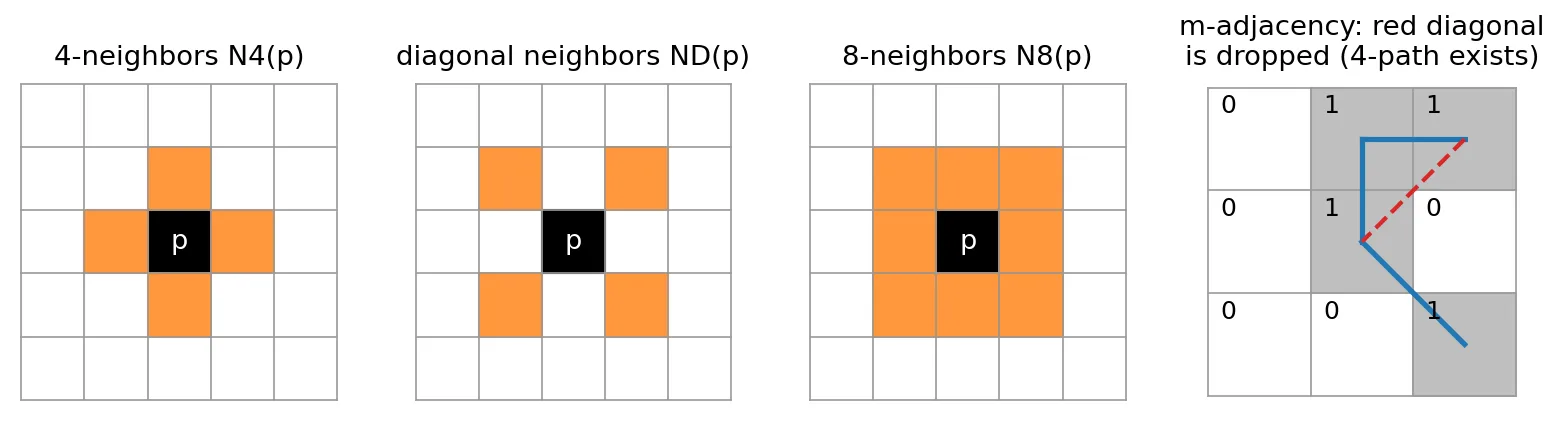
位於 的像素 有四個水平與垂直鄰居,
四個對角鄰居,
以及八個鄰居 [1]。在影像邊界上,有些鄰居會落在影像外;要怎麼處理(忽略、補值、鏡射)是一個選擇,在濾波時會再遇到。
相鄰、連通、區域與邊界
令 為被視為「相似」的強度值集合——二值影像中 ;灰階影像中可能是 100 到 120 之間的所有值。兩個值都在 中的像素 與 [1]:
- 若 ,則為 4-相鄰(4-adjacent);
- 若 ,則為 8-相鄰(8-adjacent);
- 若 ,或者 且集合 中沒有任何值屬於 的像素,則為 m-相鄰(m-adjacent,混合相鄰)。
為什麼需要 m-相鄰?在 8-相鄰下,一步對角線和兩步「繞過轉角」的路線可能同時連接同一對像素,使路徑產生歧義。m-相鄰只在不存在 4-連通路線時才保留對角連結,消除了多餘的迴圈(圖 2.6 右)。
從 到 的數位路徑(digital path)是一串互不相同的像素 ,相鄰兩個像素彼此相鄰; 是路徑長度,若第一個與最後一個像素相同,則稱為封閉路徑。依所用的相鄰定義,我們稱之為 4-、8- 或 m-路徑。對於像素子集 ,若 與 之間存在一條完全位於 中的路徑,就說它們在 中連通。在 中與 連通的所有像素構成一個連通分量(connected component);若 只有一個連通分量,則 是連通集合。
連通集合稱為區域(region)。若兩個區域的聯集是連通的,就說它們相鄰。區域 的**邊界(boundary,或 border)是 中至少有一個鄰居位於 外的像素集合。注意邊界與邊緣(edge)**的差別:邊界是區域整體、封閉的性質;邊緣則是局部的強度不連續,未必會閉合(第 10 章)。
相鄰的選擇會改變「有幾個物體?」這類簡單問題的答案:
import numpy as np
from skimage.measure import label

b = np.array([[1, 0, 0],
              [0, 1, 0],
              [0, 0, 1]])
print(label(b, connectivity=1).max(),     # 4-連通:3 個物體
      label(b, connectivity=2).max())     # 8-連通:1 個物體
一個經典結論:如果前景用 8-連通,背景就應該用 4-連通(反之亦然),否則一條封閉的數位曲線可能無法把內外分開。這是數位拓樸(digital topology)的基本結果 [1]。
距離量測
對像素 、 與 ,若函數 滿足 且僅在 時等號成立、,以及 ,則 是一個距離度量(distance metric)。三種標準度量是 [1]、[5]:
即歐氏距離、城市街區距離與棋盤距離。與 的 不超過某定值的像素構成圓盤; 構成菱形; 構成正方形。 的像素恰好是 , 的像素恰好是 。 與 只取決於座標,與像素值無關;反之,沿著 m-路徑量的距離會受像素值影響,因為路徑本身受像素值影響。
import numpy as np
p, q = np.array([2, 3]), np.array([5, 7])
d = np.abs(p - q)
print("D_E =", np.hypot(*d), " D_4 =", d.sum(), " D_8 =", d.max())   # 5.0, 7, 4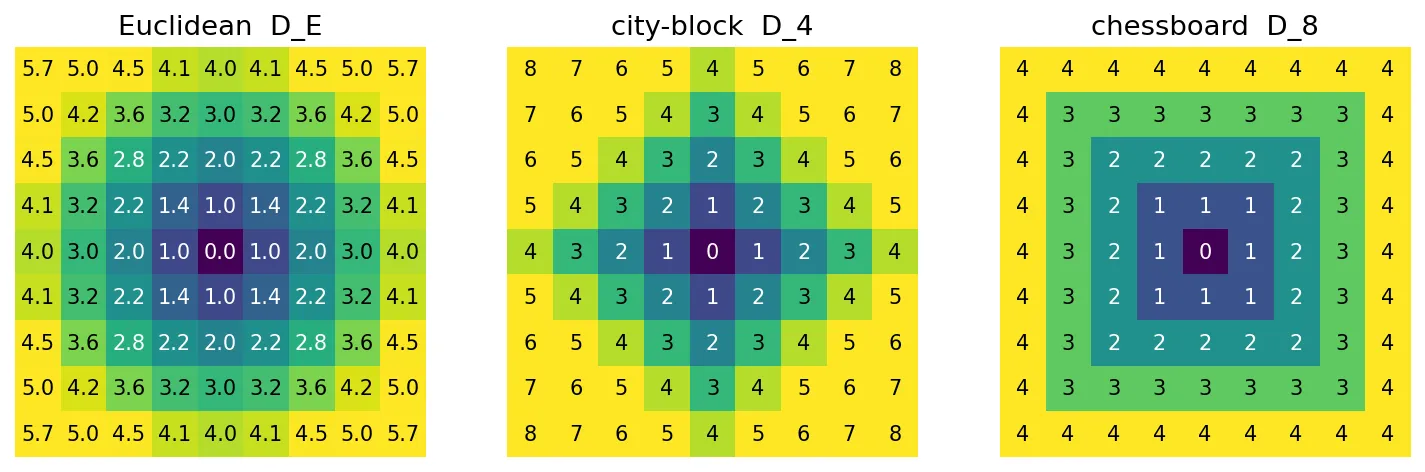
Rosenfeld 與 Pfaltz [5] 提出了高效率的兩趟(two-pass)演算法,一次算出每個像素到最近物體像素的距離——也就是距離轉換(distance transform),至今仍用於骨架化、形態學與形狀比對(第 9 章)。
數位影像處理的數學工具簡介
白話說:影像就是矩陣,所以大部分影像處理都是對矩陣做運算。本節列出我們會一再用到的運算,以及決定哪些工具適用的關鍵性質——線性。
逐元素運算與矩陣運算
逐元素(elementwise,又稱陣列)運算逐一像素作用。兩張 影像的逐元素乘積為
而矩陣乘積則遵守列乘行的規則。除非特別說明,影像運算——包括「兩張影像相乘」——都是逐元素的 [1]。在 NumPy 中,A * B 是逐元素乘積,A @ B 是矩陣乘積。
線性與非線性運算
考慮一個把輸入影像 對應到輸出 的運算子 。若對所有影像 與所有常數 都有
則它是線性的。這個性質的兩部分是可加性(和的輸出等於輸出的和)與齊次性(輸入縮放,輸出也同比例縮放)。把所有像素加總是線性的;取最大值則不是:
import numpy as np
rng = np.random.default_rng(0)
f1, f2 = rng.random((4, 4)), rng.random((4, 4))
a, b = 2.0, -3.0
print(np.isclose(np.sum(a*f1 + b*f2), a*np.sum(f1) + b*np.sum(f2)))   # True
print(np.isclose(np.max(a*f1 + b*f2), a*np.max(f1) + b*np.max(f2)))   # False
線性之所以重要,是因為線性運算子完全由它對簡單輸入的反應決定,而且有大量理論(卷積、傅立葉轉換,第 3–5 章)可以套用。中值濾波器或形態學等非線性運算子能做到線性運算子做不到的事,但較難分析。
算術運算
兩張同尺寸影像的和、差、積、商都是逐元素運算 [1]。其中三種用途特別重要。
**平均多張含雜訊的影像。**假設我們對一個靜止場景拍了 張影像,,其中 是乾淨影像, 是各張之間互不相關、平均為零、變異數為 的雜訊。平均值 滿足
所以雜訊標準差以 的速度下降。天文學家疊加多次曝光就是這個道理;手機的「夜間模式」在對齊一連串連拍畫面後,做的也是同一件事 [7]。
import numpy as np
from skimage import data, img_as_float

g = img_as_float(data.camera())
rng = np.random.default_rng(1)
for K in (1, 4, 16, 64):
    avg = np.mean([g + rng.normal(0, 0.2, g.shape) for _ in range(K)], axis=0)
    print(K, round(float(np.std(avg - g)), 3))    # 0.2, 0.1, 0.05, 0.025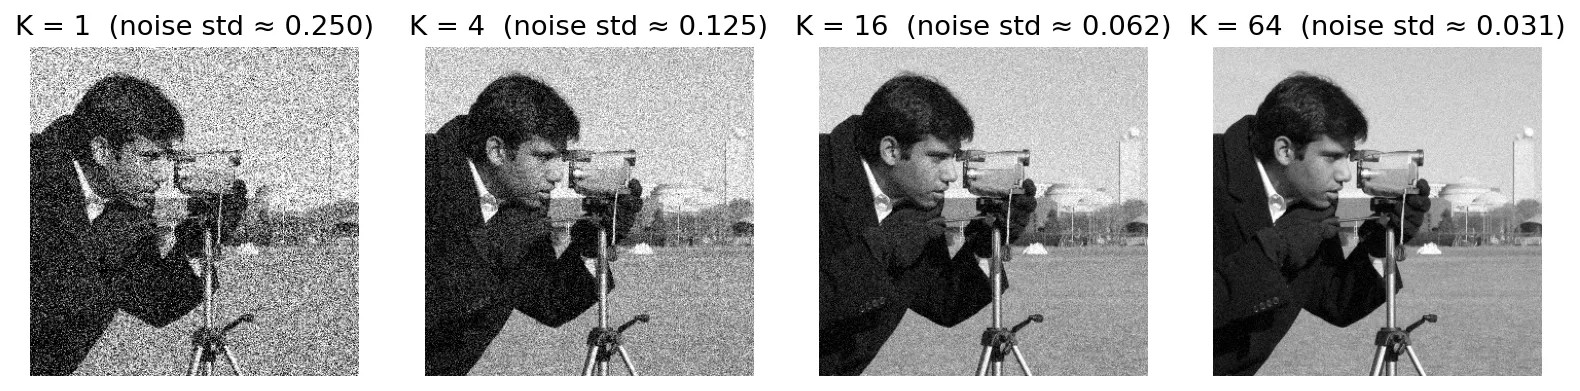
相減能凸顯差異。把視訊的兩張畫面相減,會凸顯移動;在醫學影像中,把顯影前的「遮罩」影像從顯影後的影像中減去,主要只會留下吸收了顯影劑的血管。
相乘與相除處理陰影與遮罩。若已知感測器的陰影型態 (例如拍攝均勻目標取得),觀察到的影像 可以用 校正。乘上二值遮罩則可保留感興趣區域、把其餘歸零。
一條實用規則:算術結果常常超出有效範圍(相減可能為負,相加可能超過 255)。請用浮點數運算,再重新縮放。縮放到 的簡單方法是先算 ,再算 。
集合與邏輯運算
把二值影像看成像素座標的集合 (前景),一般的集合運算就都適用 [1]:聯集 、交集 、補集 ,以及差集 。在二值陣列上,它們分別對應邏輯運算 OR、AND、NOT 與 AND-NOT。對灰階影像,聯集與交集通常定義為逐元素的最大值與最小值。模糊集合(fuzzy sets)更進一步,讓隸屬度可以介於 0 與 1 之間。
import numpy as np
from skimage import data

coins = data.coins()
A = coins > 100                                        # 集合 A:亮像素
B = np.zeros_like(A); B[:, : coins.shape[1] // 2] = True   # 集合 B:左半邊
union, inter, diff = A | B, A & B, A & ~B
集合運算是數學形態學(第 9 章)以及合併分割遮罩時的共通語言。
空間運算
空間運算直接作用在像素值與位置上,分為三類 [1]。
單像素運算各自獨立地改變每個值:,其中 是輸入強度、 是輸出。影像負片 就是一例。這些就是第 3 章的強度轉換。
鄰域運算由 周圍的鄰域 計算每個輸出。局部平均
(其中 是以 為中心的 視窗)是最簡單的例子;第 3 章會把它推廣成空間濾波。
幾何轉換移動像素。它分兩步:座標的空間轉換,以及用強度內插填滿新網格。最常見的一族是**仿射(affine)**轉換。以齊次座標表示,
其中 是輸入位置、 是輸出位置, 編碼旋轉、縮放與剪切, 是平移。仿射轉換保持直線與平行性,串接多個轉換就等於把矩陣相乘。
實作上幾乎都用反向映射(inverse mapping):對每個輸出像素,套用反轉換找出它在輸入中的來源位置,再在該處內插。正向映射(把每個輸入像素推到輸出)會留下空洞與碰撞。
import cv2
from skimage import data

img = data.camera()
h, w = img.shape
M = cv2.getRotationMatrix2D(center=(w / 2, h / 2), angle=30, scale=0.8)  # 2x3 仿射矩陣
rot = cv2.warpAffine(img, M, (w, h), flags=cv2.INTER_LINEAR)  # 內部使用反向映射
影像對位
影像對位(image registration)是把同一場景在不同時間、不同視角或以不同感測器拍攝的影像對齊。此時轉換是未知的,必須估計。經典做法是挑選在兩張影像中位置都已知的連結點(tie points,又稱控制點),再用它們擬合一個模型;例如雙線性模型
把輸入座標 對應到參考座標 ,四組連結點提供八個方程式,解出八個未知數 。Zitová 與 Flusser 的綜述 [6] 把對位整理成四個步驟,至今仍是標準描述:特徵偵測、特徵匹配、轉換模型估計,以及重新取樣。
向量與矩陣運算
彩色像素是一個向量 ,分量是紅、綠、藍值。向量工具因此可直接套用;例如 到參考色 的歐氏距離
是簡單彩色分割(第 6 章)的基礎。把 影像堆疊成 的向量,也能把任何線性運算寫成 ,這個形式會在影像復原(第 5 章)中用到。
影像轉換
有些問題換到另一個域會比較好解。2-D 線性轉換的一般形式為 [1]
其中 是輸入影像, 是正向轉換核, 是轉換域的變數。反轉換使用反向核 。當 時,核是可分離的,2-D 轉換可以先沿列、再沿行做 1-D 轉換,或寫成矩陣形式 。傅立葉轉換(第 4 章)與小波轉換(第 7 章)是你最常遇到的兩種。
機率方法
強度可以當成隨機量來處理。若 影像中有 個像素的強度為 ,則該強度的機率估計為
這就是正規化直方圖(normalized histogram)。強度的平均值與變異數為
其中 衡量平均亮度,(標準差)衡量對比。更高階的動差描述偏斜與尖峰程度。
import numpy as np
from skimage import data

img = data.camera()
p = np.bincount(img.ravel(), minlength=256) / img.size   # p(z_k)
z = np.arange(256)
m = np.sum(z * p)
sigma = np.sqrt(np.sum((z - m) ** 2 * p))
print(round(m, 2), round(sigma, 2))                      # 129.06 73.64
直方圖處理(第 3 章)與雜訊建模(第 5 章)都從這裡出發。
現代觀點
本章的基礎概念並沒有被深度學習取代,反而成了深度學習的介面。網路吃的是經過取樣與量化的陣列,用編碼了某種知覺模型的損失函數訓練,並在相機管線產生的資料上評估。以下幾個方向的回顧文獻勾勒出這片領域。
**取樣與內插理論。**Unser 的〈Sampling—50 years after Shannon〉[2] 把取樣重新定位為在平移不變空間中的逼近:不再要求訊號完美頻寬有限、也不再要求理想的 sinc 重建器,而是選擇一個實用的基底(例如 B-spline)並投影上去。它的主要結論是:取樣前的良好前置濾波與取樣後的良好重建核,比精確的取樣率更重要。Thévenaz、Blu 與 Unser [4] 把這套觀點用在影像內插上,在相同條件下比較許多核。他們指出,逼近階數與核的支撐範圍可以解釋大部分差異,而且以 B-spline 為基礎的內插(搭配適當的前置濾波)比 Keys 的三次卷積 [3] 有更好的品質與成本取捨。任何要實作影像縮放的人,這兩篇仍是參考基準。
**學習式超解析度。**Wang、Chen 與 Hoi [9] 整理了截至約 2019 年的深度超解析度:網路設計、放在前段或後段的上取樣層、損失函數與基準測試。Moser 等人 [10] 把圖像延伸到 transformer 與擴散模型(diffusion models),並強調尚未解決的問題,例如彈性的放大倍率與更好的評估方式。有兩篇工作展示了古典概念如何在網路中延續。LIIF [11] 把影像表示成可在任意座標查詢的連續函數——一個可以任意倍率放大(包括訓練時沒見過的倍率)的學習式內插器。Real-ESRGAN [12] 處理的是「大多數訓練資料對用雙三次縮小產生」與「真實世界退化」之間的落差,做法是以高階退化模型合成訓練資料,將模糊、雜訊、縮放與壓縮重複施加多次。本章的教訓是:雙三次內插既是每個方法都要比較的基準,也透過它在產生訓練資料中的角色,成了一個可能讓模型在真實影像上失效的隱藏假設。
**知覺與影像品質。**Wang 等人的 SSIM [13] 把感知一節的觀察——對結構與相對變化敏感,而非絕對誤差——轉成一個全參考品質指標,比較局部的亮度、對比與結構。Zhai 與 Min [14] 綜述了整個感知品質評估領域:全參考、部分參考與無參考方法,以及針對特殊內容的模型。深度特徵大幅改變了這個領域。Zhang 等人 [15] 收集了人類的相似度判斷,發現深度網路特徵之間的距離(LPIPS)與人的判斷吻合程度遠勝 PSNR 或 SSIM,而且在不同架構與訓練方式下都成立。Ding 等人 [16] 接著提出更尖銳的問題:如果拿每個品質指標當損失函數來最佳化影像處理網路,哪個指標產生的結果最受人喜愛?他們的主觀實驗顯示,在標準品質資料集上的排名,並不能可靠預測一個指標作為訓練目標時是否好用。簡單說,馬赫帶與 Weber 比如今活在損失函數裡。
**相機感測器管線。**Ramanath 等人 [8] 描述了位於本章感測器陣列與你存下的壓縮檔之間的傳統機內管線:去馬賽克、白平衡、色彩轉換、gamma 與壓縮,每一級都是固定的人工設計。Delbracio 等人 [7] 回顧了行動計算攝影在二十年間如何重塑這條管線:連拍擷取、對齊與合併(也就是大規模的「平均含雜訊影像」)、多張畫面的超解析度。如今已有學習式方法取代其中一部分甚至全部。Chen 等人 [17] 訓練網路,在極低光源下把原始短曝光感測器資料直接轉成乾淨影像,繞過傳統管線。Ignatov 等人 [18] 則用單一網路(PyNET)取代整個手機影像訊號處理器(ISP),把原始馬賽克感測器資料轉成近似單眼相機拍出的影像。
什麼沒有改變?像素網格、位元深度、相鄰與連通(至今仍是每個分割後處理步驟中連通分量標記的基礎)、仿射變形(如今成了網路中可微分的層),以及直方圖。正因為懂這些,你才能察覺模型的輸入是否用錯了縮放核、量化得太粗,或是用了一個與人類判斷不符的指標來比較。
重點整理
- 人類視覺感受的是相對變化(Weber 定律),並會誇大邊緣(馬赫帶);感受到的亮度取決於周圍。好的影像處理會尊重這些事實。
- 影像可以由電磁波譜的任何部分形成;對反射光而言, 把照度與反射率分開。
- 取樣決定空間解析度、量化決定強度解析度,儲存量是 位元。階數太少會在平滑區域造成假輪廓。
- 內插——最近鄰、雙線性、雙三次——估計取樣點之間的值,在速度、平滑度與銳利度之間取捨,但無法找回已遺失的細節。
- 4-、8- 與 m-相鄰定義了路徑、連通分量、區域與邊界; 與 是距離度量,其單位球分別是菱形與正方形。
- 除非特別說明,影像運算都是逐元素的;線性決定了卷積與傅立葉工具是否適用。
- 平均 張獨立的含雜訊畫面,可讓雜訊標準差降為 ;幾何轉換使用反向映射加上內插。
- 深度學習建立在這些基礎上:學習式內插器、感知損失與學習式相機管線,都承襲了本章的概念。
練習
- 一台灰階掃描器產生 、每像素 12 位元的影像。一張未壓縮的掃描需要多少 MB?若降為 8 位元呢?
提示
用 ,再除以 (若要 MiB 則除以 )。12 位元: MB。8 位元:7.92 MB。
- 把
skimage.data.moon()量化成 4、5、6 位元。對你而言,在哪個位元數時假輪廓消失?接著在以 4 位元量化之前,先加入少量均勻隨機雜訊(振幅為半個量化間距)。有什麼改變?為什麼?
提示
這種雜訊(稱為抖動,dither)會打散大片平坦的階梯,眼睛會把細小的雜訊平均掉,而不是看到輪廓。平均誤差差不多,但可見的結構改變了——再次提醒我們,平方誤差與感受到的品質是兩回事。
- 在下面的二值影像中,分別以 4-、8- 與 m-連通計算 1 像素的連通分量數。再分別以 4- 與 8-連通計算 0 像素的連通分量數。哪一種搭配能給出一致的「內/外」答案?
0 0 0 0 0
0 1 1 1 0
0 1 0 1 0
0 1 1 0 0
0 0 0 0 0
提示
在三種相鄰定義下,1 都只構成一個連通分量;但因為右下角有個對角缺口,只有允許對角步時,這個環才是封閉的。中央的 0 在 4-連通下是孤立的(一個洞),在 8-連通下則與外部相連。4/4 搭配得到「不封閉的曲線卻有洞」;8/8 得到「封閉的曲線卻沒有洞」。只有前景 8-連通搭配背景 4-連通(或反過來)才一致。可用 skimage.measure.label 驗證。
- 證明對任意兩個像素都有 ,並找出讓每個不等式取等號的像素對。
提示
令 、,則 。當 其中之一為零時取等號。
- 寫一個用正向映射旋轉影像 角的函式(把每個輸入像素推到四捨五入後的輸出位置)。顯示 的結果,並解釋為什麼會有空洞。然後改用反向映射加雙線性內插修正它。
提示
旋轉會讓某些方向上的網格間距略微拉開,所以有些輸出像素收不到任何輸入像素。在反向映射中,每個輸出像素都會問「我是從哪裡來的?」,而且一定得到答案。
- 你有一個靜止場景的 10 張含雜訊畫面,雜訊標準差為 12 個灰階。要讓它低於 2 個灰階,需要幾張?在真實的手持連拍中,哪個假設可能不成立?手機管線怎麼處理?
提示
需要 ,所以要 37 張。「場景與相機都靜止」這個假設不成立;平均前必須先對齊(對位)各畫面,移動中的物體則需要穩健的合併方式 [7]。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 2. publisher page
- M. Unser, “Sampling—50 years after Shannon,” Proceedings of the IEEE, vol. 88, no. 4, pp. 569–587, 2000. doi
- R. Keys, “Cubic convolution interpolation for digital image processing,” IEEE Transactions on Acoustics, Speech, and Signal Processing, vol. 29, no. 6, pp. 1153–1160, 1981. doi
- P. Thévenaz, T. Blu, and M. Unser, “Interpolation revisited,” IEEE Transactions on Medical Imaging, vol. 19, no. 7, pp. 739–758, 2000. doi
- A. Rosenfeld and J. L. Pfaltz, “Distance functions on digital pictures,” Pattern Recognition, vol. 1, pp. 33–61, 1968. doi
- B. Zitová and J. Flusser, “Image registration methods: a survey,” Image and Vision Computing, vol. 21, no. 11, pp. 977–1000, 2003. doi
- M. Delbracio, D. Kelly, M. S. Brown, and P. Milanfar, “Mobile computational photography: A tour,” arXiv:2102.09000, 2021. arXiv
- R. Ramanath, W. E. Snyder, Y. Yoo, and M. S. Drew, “Color image processing pipeline,” IEEE Signal Processing Magazine, vol. 22, no. 1, pp. 34–43, 2005. doi
- Z. Wang, J. Chen, and S. C. H. Hoi, “Deep learning for image super-resolution: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2020. arXiv
- B. Moser, F. Raue, S. Frolov, J. Hees, S. Palacio, and A. Dengel, “Hitchhiker’s guide to super-resolution: Introduction and recent advances,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023. arXiv
- Y. Chen, S. Liu, and X. Wang, “Learning continuous image representation with local implicit image function,” CVPR, 2021. arXiv
- X. Wang, L. Xie, C. Dong, and Y. Shan, “Real-ESRGAN: Training real-world blind super-resolution with pure synthetic data,” arXiv:2107.10833, 2021. arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh, and E. P. Simoncelli, “Image quality assessment: From error visibility to structural similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. project page
- G. Zhai and X. Min, “Perceptual image quality assessment: A survey,” Science China Information Sciences, vol. 63, no. 11, 2020. doi
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman, and O. Wang, “The unreasonable effectiveness of deep features as a perceptual metric,” CVPR, 2018. arXiv
- K. Ding, K. Ma, S. Wang, and E. P. Simoncelli, “Comparison of full-reference image quality models for optimization of image processing systems,” International Journal of Computer Vision, 2021. arXiv
- C. Chen, Q. Chen, J. Xu, and V. Koltun, “Learning to see in the dark,” CVPR, 2018. arXiv
- A. Ignatov, L. Van Gool, and R. Timofte, “Replacing mobile camera ISP with a single deep learning model,” arXiv:2002.05509, 2020. arXiv