DL 01・深度學習的影像處理與電腦視覺
先備知識: ML 02・類神經網路:從感知器到深度網路, 第 3 章・強度轉換與空間濾波
你將學到
- 傳統影像工作的三個層次(影像處理、影像分析、電腦視覺),如何對應到深度學習實際使用的兩大類:低階(low-level)與高階(high-level)視覺任務。
- 為什麼教科書上的圖形識別流程(感測器 → 特徵 → 分類器 → 驗證)會被端對端學習(end-to-end learning)取代,以及它又如何以「預訓練骨幹+輕量 head」的形式悄悄回歸。
- 卷積層為什麼就是一組學習而來的空間濾波器,以及卷積核大小、步幅、填補與池化如何決定感受野(receptive field)與特徵階層。
- 經典 CNN(LeNet-5、AlexNet、VGG、GoogLeNet、ResNet)背後的設計理由,以及用於密集預測的編碼器–解碼器(FCN、U-Net)。
- Vision Transformer 怎麼運作、為什麼需要大規模預訓練,以及 Swin、ConvNeXt 與自監督骨幹網路(DINO、MAE、DINOv2/v3)各自如何回應它。
- 現今任務與代表模型的全貌:分類、偵測、分割(SAM 系列)、復原與增強、生成(擴散模型、潛在擴散、DiT),以及視覺–語言模型(CLIP、LLaVA)。
先看全貌
這篇是深度學習系列的入口。它不會深入任何單一任務,而是先給你一張地圖:影像問題有哪些種類、哪些網路設計能解決它們、這些設計又為什麼長成現在這樣。後續的教學會再分別深入影像分類、物件偵測、影像復原、低光源增強與物件追蹤。
為什麼重要:幾乎所有現代相機的處理流程、醫學影像產品、駕駛輔助系統與修圖 App,都是由本篇介紹的元件組成。看懂這張地圖,你就能為新問題挑一個合理的起點、帶著批判的眼光讀論文,也能看出數位影像處理系列裡的哪些傳統想法仍活在網路裡面(其實很多)。
影像任務的三個層次
白話版。 廣義的「影像處理」包含三種工作。有些操作把一張影像變成一張更好的影像;有些操作從影像中取出某個部分或某種性質;有些則試著像人一樣理解影像。
精確版。 依照 Gonzalez 與 Woods [2] 的分法,可以用「輸入什麼、輸出什麼」把影像工作分成三個層次。
| 層次 | 輸入 → 輸出 | 典型操作 | 傳統例子 |
|---|---|---|---|
| 影像處理(狹義;低階) | 影像 → 影像 | 逐像素或鄰域的基本步驟 | 直方圖等化、濾波、傅立葉轉換(DIP 03、DIP 04) |
| 影像分析(中階) | 影像 → 屬性或被標示出的區域 | 分割、特徵擷取、描述,運用先驗知識 | 人臉影像中的膚色區域、X 光影像中的血管區域(DIP 10、DIP 12) |
| 電腦視覺(高階;理解) | 影像 → 意義 | 辨識、詮釋、判斷 | 分類、「畫面中有沒有行人?」(DIP 13) |
這三者的界線並不嚴格,實際系統往往三者都會用到。例如一個血管分割工具,會先去雜訊(低階)、再擷取血管圖(中階),最後可能標記出狹窄處(高階)。這三個層次描述的是計算的種類,而不是三個分開的部門。
深度學習如何重畫這張地圖
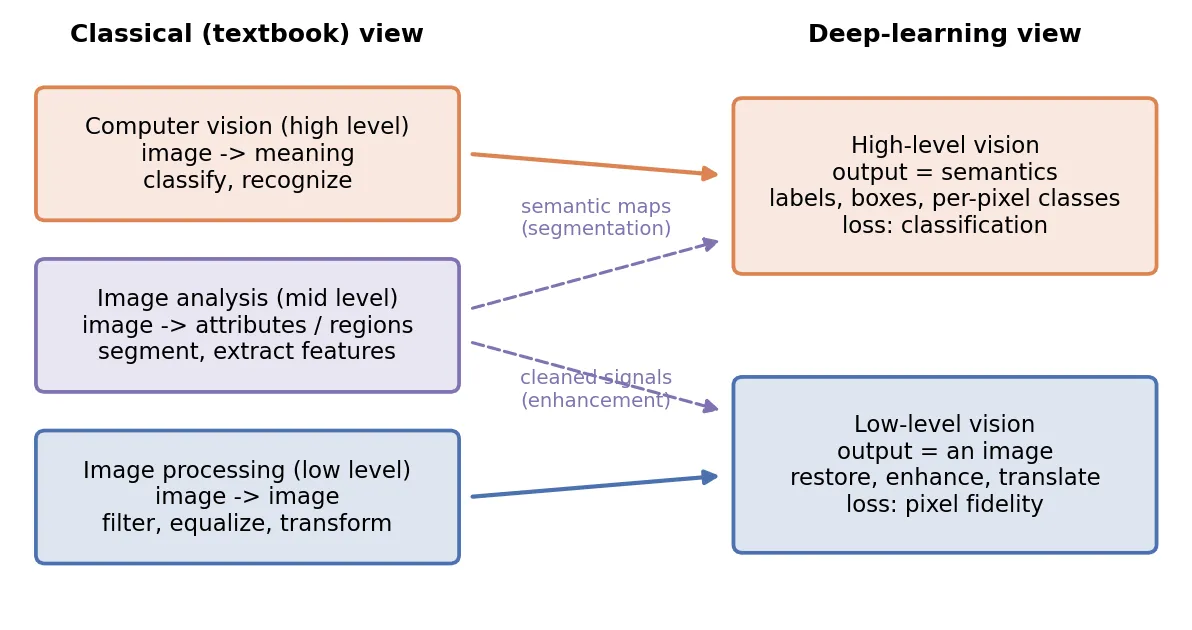
在深度學習的論文裡,你幾乎看不到「中階」這個詞。這個領域依照輸出的形式,只把任務分成兩大類 [1]:
- 低階視覺:輸出是一張和輸入(大致)同樣大小的影像,目標是逐像素準確的訊號。例如去雜訊、去模糊、超解析度、除霧、低光源增強、影像到影像轉換。
- 高階視覺:輸出是語意描述,可能是一個標籤、一組帶標籤的方框,或是每個像素一個標籤。
原本的「影像分析」被併入兩者之一。分割的輸出是逐像素的圖,看起來像影像到影像的任務;但它的數值是需要辨識才能得到的類別標籤,所以被歸為高階視覺。至於輸出一張更乾淨的亮度影像的邊緣或血管增強,則歸為低階視覺。
這樣分的理由很實際。兩類任務在損失函數(像素迴歸 vs. 分類)、架構(全解析度的編碼器–解碼器 vs. 逐步降採樣的骨幹網路)、訓練資料(劣化/乾淨影像對 vs. 人工標註)與評估指標(保真度 vs. 正確率)上都不同。圖 1 畫出了這個重新整理。
從圖形識別流程到端對端學習
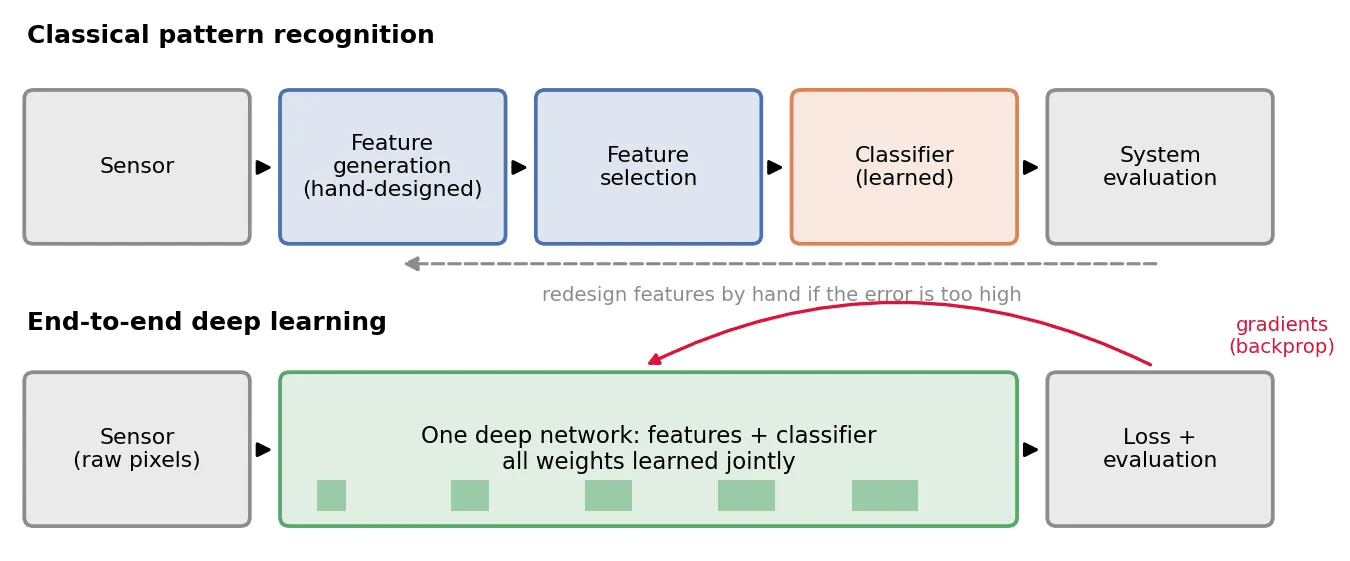
白話版。 在深度學習之前,辨識系統像一條生產線:先有相機,再由人設計的步驟量出有用的性質,最後由分類器做決定。深度學習把中間的步驟融合成一個網路,讓它自己學會要量什麼。
精確版。 傳統流程 [3] 有四個階段:
- 感測器(sensor)。擷取圖形(相機、掃描器、顯微鏡)。
- 特徵生成與選擇(feature generation & selection)。以人工設計的映射 (動差、紋理統計、邊緣直方圖、關鍵點描述子),從影像 計算出向量 ,再保留最有資訊量的分量。
- 分類器設計(classifier)。學習決策規則 , 為參數,例如貝氏分類器、最近鄰規則或支援向量機。
- 系統驗證(evaluation)。在保留的資料上量測錯誤率,太高就回到第 2 或第 3 步。
被學習的只有 。特徵映射 由工程師固定,所以整個系統的上限就是 的品質。特徵擷取(DIP 12)那一章可以看到,這些映射背後花了多少巧思。
端對端學習讓特徵映射也變成可學習的。深度網路計算
其中 是權重為 的多層網路, 是一個小的 head, 與 在標註資料 上以梯度下降與反向傳播共同最小化損失 。輸入就是原始像素;除了架構與損失函數之外,沒有任何東西是人工設計的。
網路內部的功能區分其實還在:前面的層像特徵擷取器,最後幾層像分類器。但實務上,你通常無法指著某一層說「特徵到這裡結束」[1]。這帶來兩個結果:
- 資料取代了設計。 端對端系統需要大量標註資料;人工設計的 原本承載的先驗知識,現在得由網路從資料中學到。
- 分工以更大的規模回歸。 大約從 2021 年起,標準作法是用一個預訓練骨幹(在巨大的資料集上訓練一次,常常不需要標註)加上一個在你的小資料集上訓練的輕量任務 head。這又是「特徵擷取器+分類器」,只是特徵擷取器是學來的,而不是設計出來的。我們會在自監督骨幹那一節回到這一點。
卷積神經網路
白話版。 卷積層拿一個小視窗在影像上滑動,在每個位置計算加權和,跟 DIP 03 的空間濾波器一模一樣。差別在於:CNN 會學習濾波器的權重、一次使用很多個濾波器,並把數十層這樣的層與非線性函數交錯疊起來。
卷積層是一組學習而來的濾波器
精確版。 設輸入特徵圖為 (通道、高、寬)。一個有 個 濾波器的卷積層計算
其中奇數 時 , 是第 個濾波器在輸入通道 、位移 的權重, 是偏差。嚴格來說這是相關(correlation,不翻轉卷積核),如卷積教學所述;由於權重是學出來的,翻不翻轉沒有差別。之後接一個逐元素的非線性函數,例如 。如果沒有它,一疊卷積層會塌縮成一個大的線性濾波器 [1]。
有兩個性質讓這種層特別適合影像:
- 局部連接(local connectivity)。每個輸出只依賴一個 鄰域,因為相鄰像素彼此高度相關,距離遠的像素則關係弱得多。
- 權重共享(weight sharing)。同一個濾波器用在每一個位置。這讓卷積層具有平移等變性(translation equivariance:輸入平移,輸出也跟著同樣平移),也大幅減少參數量。
省下的量非常可觀。從 的影像連到 64 個神經元的全連接層需要 萬個參數。從 3 個通道到 64 個通道的 卷積只需要 個,而且輸出的是 64 張全解析度的特徵圖,而不是 64 個數字。
下面的程式把 PyTorch 卷積層的兩個濾波器手動設成 Sobel 卷積核,讓這一層變成邊緣偵測器。訓練則會改由梯度下降來決定這些數字。
import torch, torch.nn as nn, torch.nn.functional as F
from skimage import data, img_as_float

x = torch.tensor(img_as_float(data.camera()), dtype=torch.float32)[None, None]  # (1, 1, 512, 512)
conv = nn.Conv2d(1, 2, kernel_size=3, padding=1, bias=False)
sobel_x = torch.tensor([[-1., 0., 1.], [-2., 0., 2.], [-1., 0., 1.]])
with torch.no_grad():
    conv.weight[0, 0] = sobel_x        # 通道 0:對垂直邊緣有反應
    conv.weight[1, 0] = sobel_x.T      # 通道 1:對水平邊緣有反應
    y = F.relu(conv(x))                # (1, 2, 512, 512):兩張特徵圖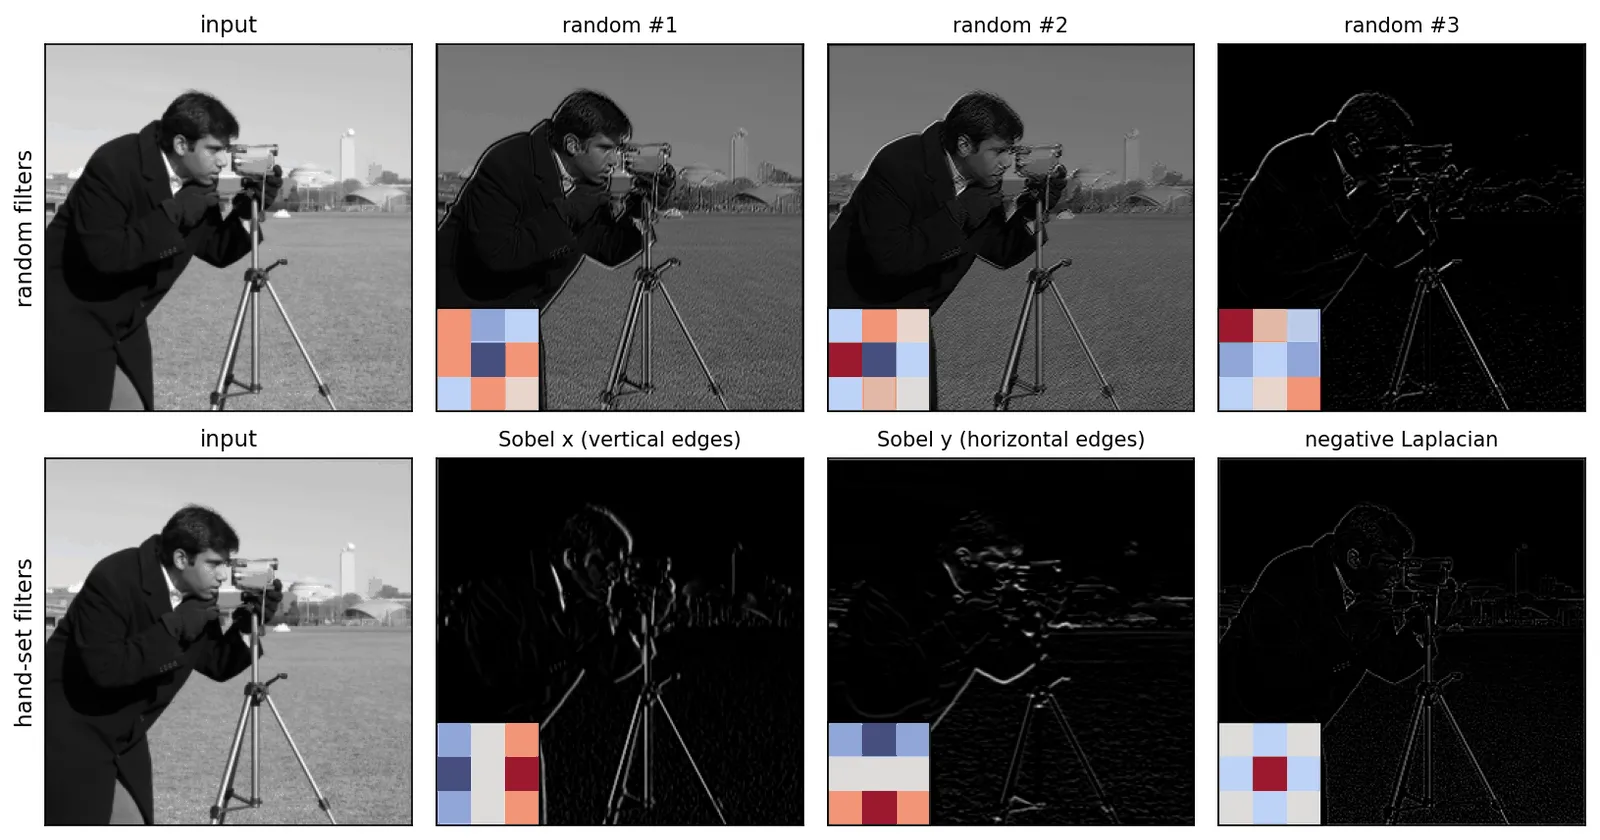
訓練好的第一層濾波器長什麼樣子?我們可以用 scikit-learn 內建的 8×8 手寫數字 [36],在 CPU 上幾秒鐘就訓練完一個極小的 CNN。
import torch, torch.nn as nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
X, y = load_digits(return_X_y=True)                    # 1,797 張 8x8 影像
X = torch.tensor(X / 16.0, dtype=torch.float32).reshape(-1, 1, 8, 8)
Xtr, Xte, ytr, yte = train_test_split(X, torch.tensor(y), test_size=0.25, random_state=0)

net = nn.Sequential(
    nn.Conv2d(1, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),     # 8x8 -> 4x4
    nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),    # 4x4 -> 2x2
    nn.Flatten(), nn.Linear(16 * 2 * 2, 10),
)
opt = torch.optim.Adam(net.parameters(), lr=1e-2)
for epoch in range(30):
    for i in range(0, len(Xtr), 64):
        loss = nn.functional.cross_entropy(net(Xtr[i:i + 64]), ytr[i:i + 64])
        opt.zero_grad(); loss.backward(); opt.step()
print((net(Xte).argmax(1) == yte).float().mean())       # 約 0.97
filters = net[0].weight.detach()[:, 0]                   # (8, 3, 3) 學到的卷積核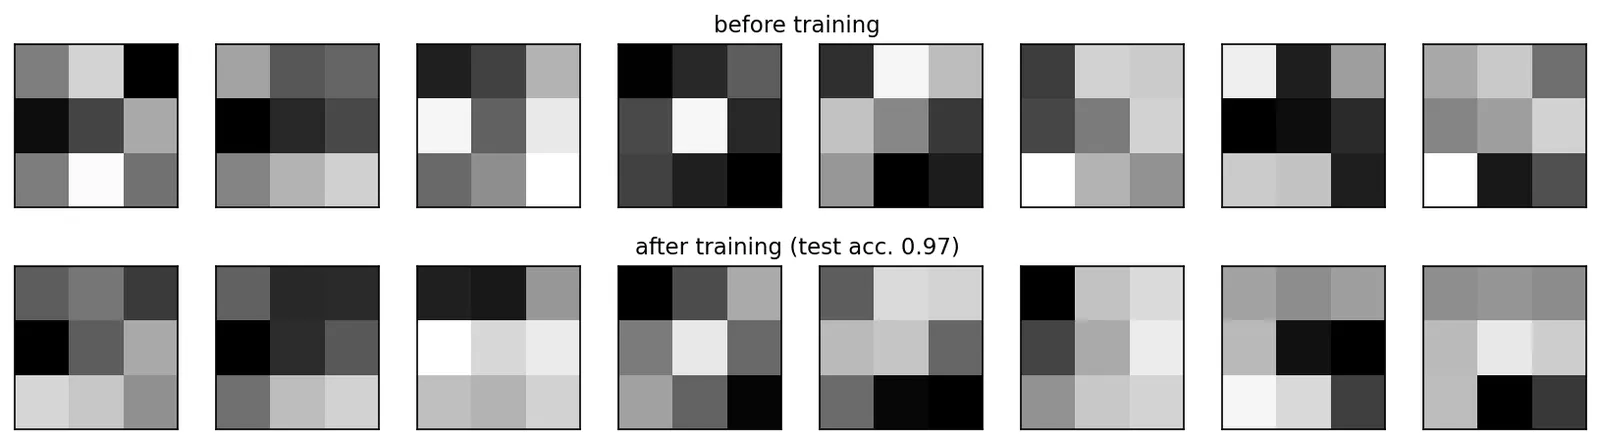
步幅、填補與輸出大小
白話版。 填補(padding)在影像外圍加一圈邊框,讓視窗可以停在邊緣像素上。步幅(stride)讓視窗一次跳不只一個像素,因此輸出會變小。
精確版。 對寬度為 的輸入、卷積核大小 、每邊填補 個像素、步幅 ,輸出寬度為
、、 時大小不變(“same” 填補); 時減半。預設是補零;但在低階網路中,常偏好鏡射或複製邊界的填補(與 DIP 03 討論的邊界處理相同),因為補零會在影像邊緣產生暗色瑕疵。
池化
池化(pooling)用一個數字概括每個小視窗,通常取最大值(max pooling)或平均值(average pooling),一般使用 視窗、步幅 2。它把解析度減半、讓表示對小幅平移較不敏感,並以很低的成本擴大感受野。許多現代網路改用步幅卷積取代池化,讓網路自己學會怎麼降採樣。在分類網路的最後,全域平均池化(global average pooling)把 的特徵圖變成給分類 head 用的 維向量。
感受野
白話版。 一個神經元的感受野,是輸入影像中能影響它的那一塊區域。一層 看得到 個像素;疊兩層,每個輸出看得到 。降採樣會讓它長得快得多。
精確版。 將各層編號為 ,卷積核大小 、步幅 。令 為跳距(jump),也就是第 層兩個相鄰單元在輸入影像上相距多少像素; 為感受野大小;輸入層 、。則
每一層增加 個輸入單元,而每個輸入單元相當於 個像素。若處處步幅為 1, 層 得到 :線性成長。每一次步幅 2 都讓跳距加倍,後面的層讓感受野長得兩倍快,因此隨深度大致呈指數成長。
def receptive_field(layers):
    r, j = 1, 1                       # 感受野與跳距,以輸入像素為單位
    for k, s in layers:               # 每一層的(卷積核大小, 步幅)
        r, j = r + (k - 1) * j, j * s
    return r

print(receptive_field([(3, 1)] * 3))                                             # 7
print(receptive_field([(3, 1), (3, 1), (2, 2), (3, 1), (3, 1), (2, 2), (3, 1)])) # 24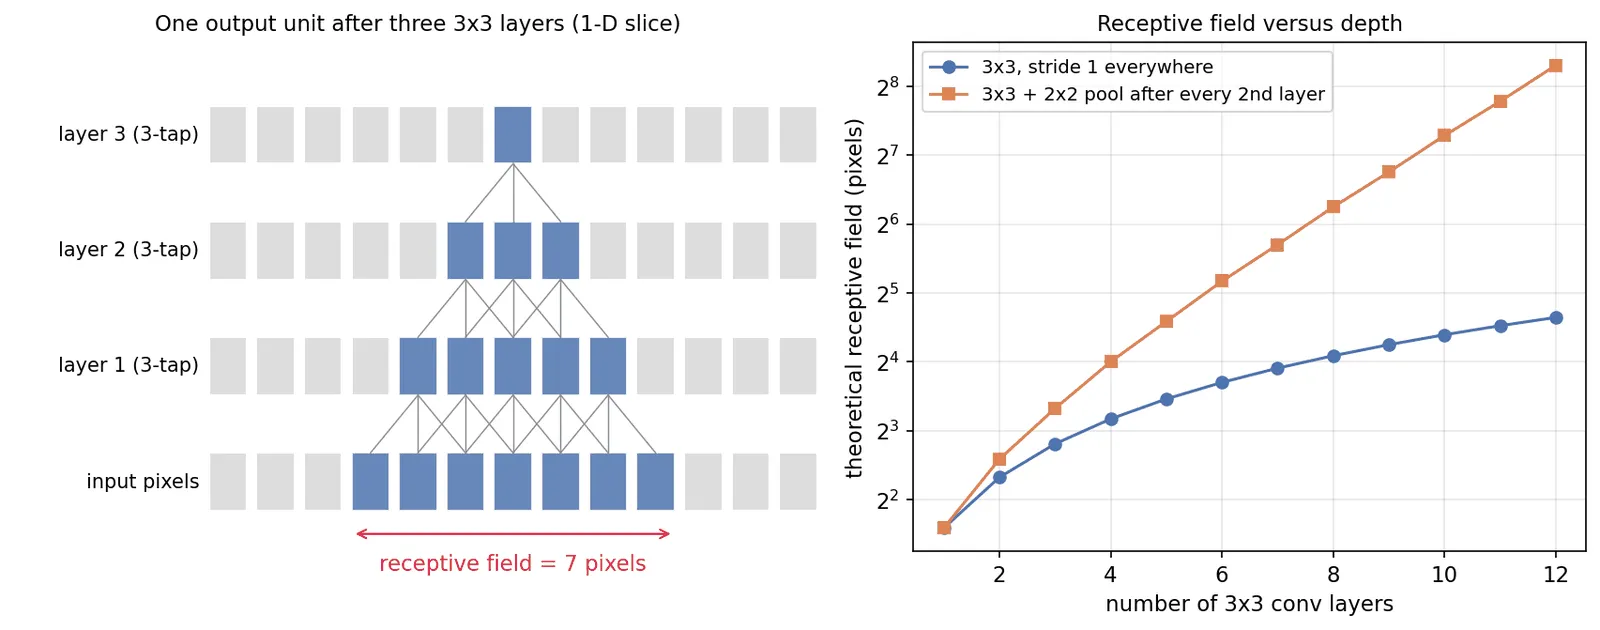
實務上還有兩點要注意。第一,上面的公式給的是理論感受野。Luo 等人 [12] 發現,以「每個輸入像素對輸出梯度實際影響多少」來量測的有效感受野(effective receptive field)大致呈高斯分佈,只佔理論感受野的一小部分,中心附近的像素佔主導地位。第二,感受野決定網路能用到什麼:感受野比雜訊相關長度還小的去雜訊器,無法去除那種雜訊;最後一層只看得到物體一部分的分類器,也無法從上下文辨識它。
特徵階層
由於感受野隨深度變大、解析度變小,CNN 會建立一個特徵階層:前面的層對邊緣與色塊有反應(圖 4),中間的層對紋理與部件有反應,後面的層則對大範圍的物體層級圖樣有反應。典型的骨幹網路分成好幾個階段(stage),每個階段結束時做 2 倍降採樣並把通道數加倍,所以特徵從「高解析度、通道少、局部」一路變成「低解析度、通道多、語意」。高階任務讀取後面的階段;密集預測與低階任務還需要前面高解析度的階段,這正是編碼器–解碼器存在的原因(見下文)。
經典 CNN 架構
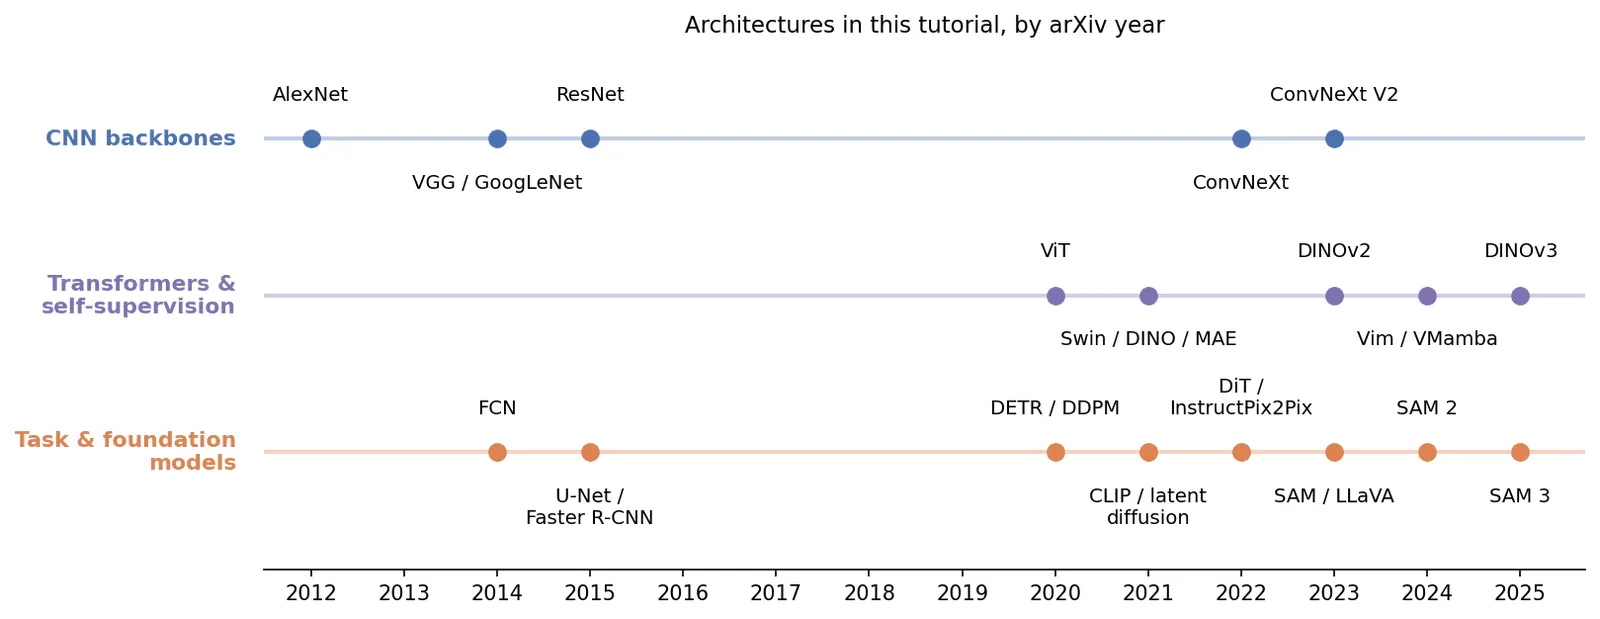
白話版。 2012 到 2016 年間,一系列一個比一個深的網路贏得了 ImageNet 大規模視覺辨識挑戰賽(ILSVRC)[6]。每一個都帶來一個至今仍在使用的設計想法。
LeNet-5,以及 CNN 真正的起點
原文的標題寫著「CNN(1998~)」。1998 年是 LeCun、Bottou、Bengio 與 Haffner 發表 LeNet-5 [5] 的年份,並不是 CNN 的起點:以反向傳播訓練的卷積網路,早在 1989 年就已經用來辨識手寫郵遞區號 [4]。
LeNet-5 是一個以網路形式呈現的標準圖形識別系統 [1]。C1 到 C5 是特徵擷取器:卷積層(C1、C3、C5)與子取樣層(S2、S4)交錯,把 32×32 的數字影像變成 120 維的特徵向量;F6 與輸出層則是分類器。包含特徵在內的所有東西,都以分類損失透過梯度下降訓練。端對端的想法其實早已到位,只是還需要再等十五年的資料量與運算力,才成為主流。
AlexNet(2012)
AlexNet [7] 有五個卷積層與三個全連接層(共八個可學習的層,約 6,000 萬個參數)。它的元件個別來看並不新,新的是組合:訓練速度遠快於飽和型 sigmoid 的 ReLU 激活函數、高效率的 GPU 實作、大量的資料擴增,以及全連接層中的 dropout。它以很大的差距贏得 ILSVRC 2012,這也是為什麼 2012 年通常被視為視覺深度學習時代的起點。
VGG(2014)
Simonyan 與 Zisserman [8] 只問了一個問題:如果只用 卷積,並把網路加深,會怎樣?他們最好的配置有 16 與 19 個權重層。 之所以足夠,答案就在上面的感受野公式:兩層 看得到 ,三層看得到 。輸入、輸出都是 個通道時,三層 需要 個權重,而一層 需要 個,而且前者還多插入了兩個非線性函數。VGG 整齊一致的設計,讓它多年來都是預設的預訓練特徵擷取器。
GoogLeNet / Inception(2014)
22 層深的 GoogLeNet [9] 贏得 ILSVRC 2014。它的 Inception 模組平行執行 、、 卷積與一個池化分支,再把輸出串接起來,讓每個模組同時看到好幾種尺度。為了負擔得起,便宜的 卷積會先減少通道數。 卷積在每個像素上混合通道而不看鄰居,相當於逐像素的全連接層,至今仍是到處可見的基本元件。
ResNet(2015),以及殘差連接為什麼有效
照理說越深越好,但實際上並非如此:He 等人 [10] 觀察到,一個普通的 56 層網路,訓練誤差反而比 20 層的高。這不是過擬合(overfitting),而是最佳化失敗:較深的網路理論上可以複製淺網路、再把多出來的層設成恆等映射,但梯度下降找不到那個解。
解法是殘差區塊(residual block,圖 7)。與其讓一疊層直接學習映射 ,不如讓它學殘差 ,再把輸入加回來:
其中 是區塊輸入, 通常是 conv–BN–ReLU–conv–BN(BN 為批次正規化,batch normalization),權重為 , 為 ReLU。當通道數或解析度改變時,捷徑改用 卷積取代恆等映射。
為什麼有效:
- 恆等映射變得容易。 如果多出來的深度沒有用處,區塊只需要把 推向零,這比讓一疊非線性層模仿恆等映射容易得多。把 最後一個 BN 的縮放參數初始化為零,每個區塊一開始就是恆等映射。
- 梯度有一條高速公路。 忽略最後的非線性,。恆等項把梯度從損失直接帶到前面的層,不必穿過每一個權重矩陣,所以不會隨深度消失。
- 集成的觀點。 把 個區塊展開,會得到許多長短不一的路徑之和,因此一個很深的 ResNet 在某種程度上就像許多較淺網路的集合。
class ResidualBlock(nn.Module):
    """基本區塊:y = ReLU(x + F(x)),F = conv-BN-ReLU-conv-BN。"""
    def __init__(self, c):
        super().__init__()
        self.f = nn.Sequential(
            nn.Conv2d(c, c, 3, padding=1, bias=False), nn.BatchNorm2d(c), nn.ReLU(),
            nn.Conv2d(c, c, 3, padding=1, bias=False), nn.BatchNorm2d(c),
        )
    def forward(self, x):
        return torch.relu(x + self.f(x))

blk = ResidualBlock(16)
nn.init.zeros_(blk.f[4].weight)                  # 把最後一個 BN 的縮放設為零,使 F(x) = 0
x = torch.randn(2, 16, 32, 32)
print(torch.allclose(blk(x), torch.relu(x)))     # True:區塊一開始就是恆等映射(再接 ReLU)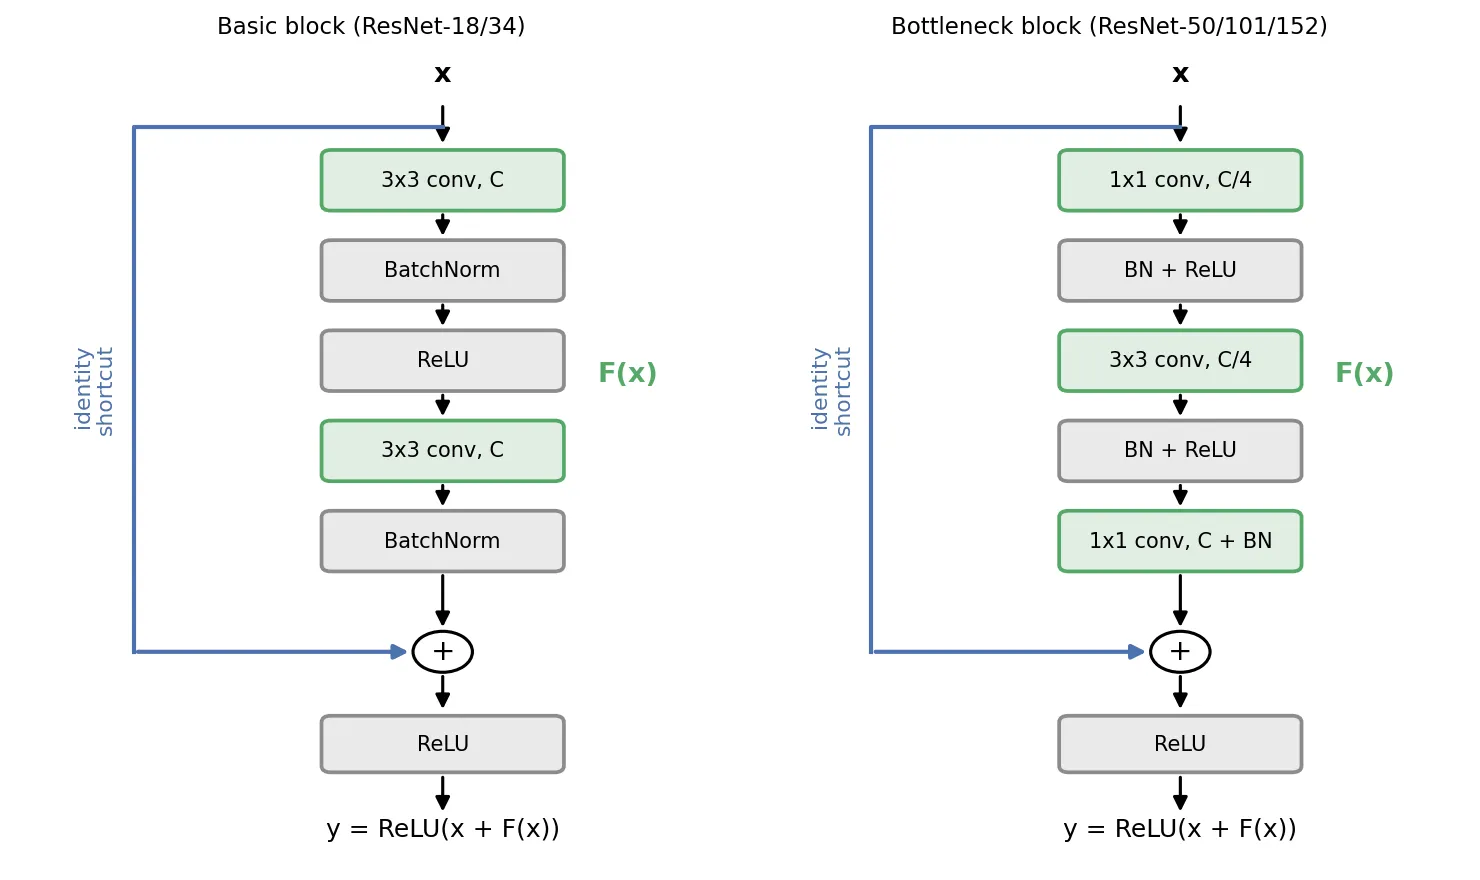
論文在 ImageNet 上訓練了 18、34、50、101 與 152 層的 ResNet,其中較深的三種使用瓶頸區塊。有名的 1202 層網路只出現在論文的 CIFAR-10 實驗中 [10]、[11](32×32 的小影像);它可以順利訓練,但過擬合,測試結果反而比 110 層的版本差。ResNet 家族贏得 ILSVRC 2015,而殘差連接如今幾乎存在於所有深度網路中,Transformer 也不例外。
用於密集預測的編碼器–解碼器
白話版。 分類骨幹為了換取語意而丟掉解析度。分割或復原需要在每個像素上都給出答案,所以要再加上後半段,把解析度找回來。
精確版。 Long 等人提出的全卷積網路(fully convolutional network, FCN)[13] 把分類器中的全連接層換成卷積,讓網路對任意大小的輸入輸出一張粗略的類別分數圖,再以學習而來的轉置卷積上採樣,並與前面較精細層的分數融合。U-Net [14] 把這個想法做成對稱的形式:收縮的編碼器(卷積區塊與降採樣)與擴張的解碼器(上採樣與卷積區塊),中間以跳接(skip connection)把每個編碼器階段的特徵圖串接到同一解析度的解碼器階段。編碼器提供「是什麼」,跳接提供「在哪裡」。U-Net 原本是為標註很少、需要大量資料擴增的生醫影像設計的;同樣的形狀如今撐起了醫學影像分割、DL 04 介紹的幾乎所有復原網路,以及許多擴散模型內部的去雜訊器。
Vision Transformer
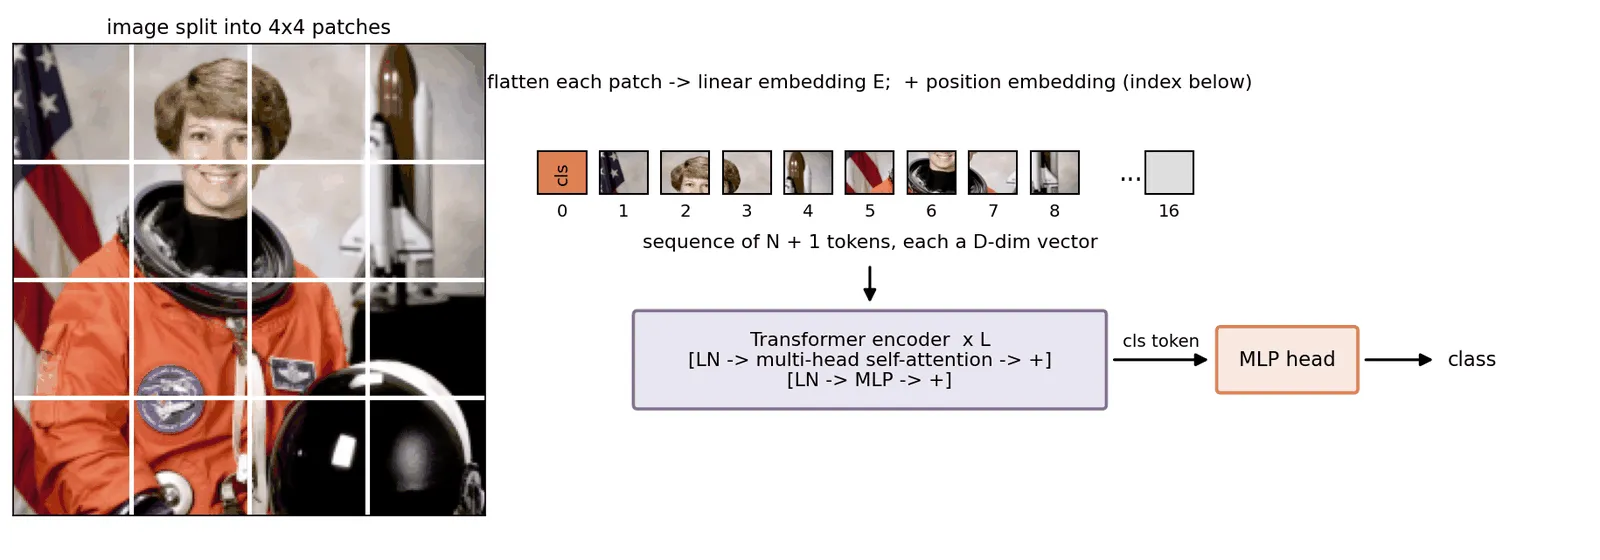
白話版。 Transformer [15] 原本是為句子設計的:它把輸入當成一串 token,讓每個 token 都能看到其他所有 token。Vision Transformer(ViT)[16] 把影像切成小方塊(patch),把每個 patch 當成一個「字」,再把這串序列送進一個沒有修改過的 Transformer 編碼器。
切塊、嵌入、注意力
精確版。 對影像 與 patch 大小 :
- 切塊。 把 切成 個不重疊的 patch,並把每一塊攤平成向量 。對 的 RGB 影像與 ,,每個向量有 個元素。
- 嵌入。 把每個 patch 線性映射成 維 token,,。在最前面加上一個可學習的類別 token ,並加上可學習的位置嵌入(position embedding),因為注意力本身不知道 token 來自哪裡:。
- 編碼。 套用 個 Transformer 編碼器區塊,每個區塊包含多頭自注意力(MSA)子層與 MLP 子層,兩者都搭配層正規化(LN)與殘差連接:
- Head。 把最後的類別 token(或所有 token 的平均)送進 MLP head,它扮演的就是圖形識別中分類器的角色 [1]。
對 token 矩陣 ,單一注意力頭計算
其中 是學習而來的投影, 是每個頭的維度。softmax 矩陣的第 列表示 token 從其他每個 token 汲取多少資訊。和卷積相比,這裡的「濾波器」是依內容計算出來的,而且從第一層起就涵蓋整張影像。代價是計算量隨 token 數呈平方成長,,這也是為什麼使用 patch 而不是像素。
img = torch.randn(1, 3, 224, 224)
P, D = 16, 768
patches = img.unfold(2, P, P).unfold(3, P, P)                    # (1, 3, 14, 14, 16, 16)
patches = patches.permute(0, 2, 3, 1, 4, 5).reshape(1, -1, 3 * P * P)
print(patches.shape)                                              # (1, 196, 768)
embed = nn.Conv2d(3, D, kernel_size=P, stride=P)                  # 切塊+線性嵌入,一步完成
tokens = embed(img).flatten(2).transpose(1, 2)                    # (1, 196, 768)
最後兩行說明了一個實用的等式:patch 嵌入就是一個卷積核大小與步幅都等於 的卷積。
歸納偏置與規模的需求
原文提到 ViT「更難收斂」。更精確的說法 [1]、[16] 與歸納偏置(inductive bias)有關,也就是架構在看到資料之前就內建的假設。CNN 假設局部性與權重共享,所以它已經「知道」相鄰像素要一起看,也知道同一個圖樣出現在影像中任何位置都代表同一件事。ViT 幾乎沒有任何假設:除了切 patch 之外,所有空間結構,甚至位置嵌入的二維排列,都必須自己學。
這是一種取捨,而不是缺陷。資料少的時候,CNN 的假設是寶貴的先發優勢,只在 ImageNet-1k 上從頭訓練的 ViT 表現不如同等的 ResNet。資料夠多時,這些假設反而成為限制;在非常大的資料集上預訓練的 ViT,微調後可以追平甚至超越最好的 CNN [16]。實務上的結論是:ViT 都是預訓練後才使用,預訓練資料可能是巨大的標註資料集,也越來越常是自監督學習。
ViT 之後的骨幹網路
白話版。 ViT 之後,研究朝三個方向走:讓 Transformer 更適合影像(Swin)、證明現代化之後的 CNN 也能追上(ConvNeXt),以及在沒有標註的情況下預訓練,讓一個骨幹就能服務所有任務(DINO、MAE、DINOv2/v3)。
Swin Transformer:局部性回歸
Swin [17] 只在不重疊的局部視窗(例如 個 token)內計算注意力,讓計算量對影像大小呈線性。在交替的區塊中,視窗格線會位移半個視窗,讓資訊跨越視窗邊界。在階段之間,相鄰的 token 會被合併,使解析度減半。結果是一個階層式、多尺度的特徵金字塔,形狀就像 CNN 骨幹,正好是偵測與分割 head 所需要的。Swin 把 CNN 的歸納偏置,也就是局部性與階層性,放回了 Transformer 裡。
ConvNeXt:CNN 的反擊
Liu 等人 [18] 從 ResNet-50 出發,一步一步採用 Transformer 的訓練方法與設計選擇來將它現代化:「切塊式」的 stem(步幅 4 的 卷積)、大的 逐通道卷積(depthwise convolution)、倒置瓶頸的 MLP、較少的激活與正規化層,以及層正規化。得到的純 CNN,ConvNeXt,在分類、偵測與分割上的準確度與擴展性都與 Swin 打平。結論是:ViT 的優勢有很大一部分來自訓練方法與宏觀設計,而不是注意力本身。ConvNeXt V2 [18] 接著加入了為卷積改寫的遮罩自編碼器預訓練(全卷積遮罩自編碼器,FCMAE)以及全域響應正規化(global response normalization)層。如今大型基礎模型多以 ViT 為骨幹,但在低階任務與邊緣裝置上,卷積仍然很常見 [1]。
自監督預訓練:DINO 與 MAE
自監督學習(self-supervised learning)從影像本身產生訓練訊號,因此不需要標註。主流的作法有兩種,而且常常被混為一談。
DINO:自蒸餾(self-distillation)[19]。學生網路 與教師網路 架構相同,各自輸出一個 維的機率向量。對一張影像做好幾個隨機裁切:兩個大的「全域」視圖與數個小的「局部」視圖。教師只看全域視圖,學生看所有視圖,並被訓練去符合教師的輸出:
其中 是所有視圖的集合,、 是教師與學生的 softmax 輸出, 是學生的權重。教師不經由梯度訓練,它的權重是學生權重的指數移動平均,, 接近 1;教師的輸出還會經過置中(centering)與銳化(sharpening),避免訓練塌縮成常數輸出。讓「小裁切」去符合「整張圖」,會迫使網路從局部辨識出物體。一個令人驚訝的湧現性質是:DINO ViT 的注意力圖在從未看過任何遮罩的情況下,就能分割出主要物體。
MAE:遮罩預測(masked prediction)[20]。遮罩自編碼器(masked autoencoder)隨機遮住大部分的 patch(75 % 效果最好),只用 ViT 編碼看得見的 patch,再讓一個輕量解碼器重建被遮住的像素:
其中 是被遮住的 patch 索引集合, 是 patch (正規化後)的像素, 是重建結果。這種「遮住再預測」的遊戲,相當於語言模型中遮字預測的影像版本;相對地,DINO 是教師–學生蒸餾法 [1]。MAE 的編碼器只處理四分之一的 token,所以很省計算,微調效果也非常好;DINO 類的特徵則更適合凍結使用,直接接一個線性 head。
DINOv2 與 DINOv3:凍結即用的通用特徵
DINOv2 [21] 把 DINO 式的自蒸餾擴展到 10 億參數的 ViT,在一個自動篩選(curated)過的大型影像集合上訓練,再蒸餾成較小的模型。它凍結後的特徵,只需要一個輕量 head,就能同時勝任影像層級任務(分類、檢索)與像素層級任務(分割、深度估計)。DINOv3 [21] 進一步擴大資料與模型規模,並提出 Gram anchoring,這是一種正則化方法,能防止密集的 patch 特徵在非常長的訓練過程中退化,讓同一個凍結骨幹提供高品質的密集特徵。
這讓我們回到了圖形識別流程。「特徵擷取器+分類器」以預訓練凍結骨幹+輕量 head 的形式回來了,只是特徵擷取器現在是在極大規模、沒有標註的情況下學一次就好。
狀態空間骨幹
**Vision Mamba(Vim)**與 VMamba [22] 以選擇性狀態空間模型(selective state-space model)取代注意力,用與序列長度呈線性的成本掃描 token 序列。影像不是序列,所以這些模型會沿不只一條路徑掃描 patch 網格(Vim 是雙向的;VMamba 的二維選擇性掃描會走好幾條路線)。它們對高解析度輸入很有吸引力,但目前仍偏向研究路線,還不是預設的骨幹。
高階視覺任務
白話版。 高階任務的差別在於答案要多精確地指出位置:整張圖一個標籤、每個物體一個方框,或是每個像素一個標籤。
| 任務 | 輸出 | 典型損失 | 典型指標 | 代表模型 |
|---|---|---|---|---|
| 分類 | 一個標籤(或機率向量) | 交叉熵 | top-1 / top-5 正確率 | ResNet、ViT、ConvNeXt [10]、[16]、[18] |
| 物件偵測 | 一組(方框、類別、分數) | 分類+方框迴歸,或集合匹配 | 多個 IoU 門檻下的平均精確度(AP) | Faster R-CNN、DETR [23] |
| 語意分割 | 每個像素一個類別 | 逐像素交叉熵、Dice(重疊損失,見下文) | mean IoU | FCN、U-Net [13]、[14] |
| 實例分割 | 每個物體一個遮罩與類別 | 偵測+遮罩損失 | mask AP | 可提示式:SAM 系列 [24] |
分類
為整張影像指定一個標籤。網路是骨幹+全域池化+線性層,以交叉熵 訓練,其中 是真實類別 的預測機率。在自監督學習出現之前,分類也是產生大多數骨幹網路的預訓練任務。DL 02 會深入介紹。
物件偵測
找出每個物體、它的類別,以及它的位置;位置以軸對齊的方框表示(感興趣區域,ROI,由角點座標或中心與長寬決定)[1]。有兩條設計路線可以說明這個領域 [23]。Faster R-CNN 是兩階段式:區域提議網路(region proposal network)從共享的 CNN 特徵中提出候選方框,第二個 head 再對每個候選分類並微調;重複的框由非極大值抑制(non-maximum suppression)移除。DETR 把偵測視為集合預測:Transformer 解碼器輸出固定數量的預測,再以預測與真實物體之間的二分匹配定義損失,省去了人工設計的錨框與非極大值抑制。方框品質以交併比(intersection over union)衡量:
其中 、 分別是預測與真實區域。與它密切相關的 Dice 係數 ,以可微分的軟性形式作為分割損失。平均精確度則在一個或多個 IoU 門檻下概括精確率–召回率曲線。細節請見 DL 03。
語意分割與實例分割
這裡的感興趣區域是物體確切的像素集合,而不是方框 [1]。
- 語意分割(semantic segmentation)為每個像素標上類別。兩個重疊的人會變成同一塊「人」的區域。
- 實例分割(instance segmentation)還要把同一類別的不同物體分開。兩個人會變成「人 1」與「人 2」。
語意分割是上面編碼器–解碼器 [13]、[14] 的本行。實例分割則再加上一個類似偵測的元件,為每個物體提出一個遮罩。
可提示的分割:SAM、SAM 2、SAM 3
分割領域如今有了可提示的基礎模型 [24]。SAM(Segment Anything)接收一張影像與一個提示(點、方框或粗略遮罩),回傳被指定物體的遮罩。笨重的 ViT 影像編碼器每張影像只跑一次,輕量的提示編碼器與遮罩解碼器則每個提示跑一次,所以互動很快。它在 SA-1B 上訓練;SA-1B 包含 1,100 萬張影像上超過 10 億個遮罩,是以「模型在迴圈中」的資料引擎建立的。SAM 2 把這個能力擴展到影片,以串流記憶(streaming memory)把物體一幀一幀帶下去,並在新的影片資料集(SA-V)上訓練。SAM 3 加入了可提示的概念分割(promptable concept segmentation):給它一個短名詞片語,例如「黃色校車」,或是影像範例,或兩者並用,它會找出、分割並(在影片中)追蹤所有符合的實例,而不只是點擊指向的那一個物體。到了 SAM 3,偵測、實例分割與追蹤之間的界線已經變得很薄;追蹤請見 DL 06。
低階視覺任務
白話版。 低階任務輸入一張影像,回傳同一個場景經過改善或轉換的影像。輸出以逐像素的方式評判,或以看起來有多自然來評判。
一般的形式是一個反問題。劣化的觀測 被建模為
其中 是乾淨影像, 是劣化運算子(模糊、降採樣、霧、曝光不足), 是雜訊,與 DIP 05 的模型相同。網路 在成對資料上訓練,最小化例如 。由於真實的成對資料很少,通常會對乾淨影像套用一個建模好的劣化來合成成對資料,而合成劣化與真實劣化之間的落差,正是這個領域的核心難題。
- 影像復原(image restoration)找回乾淨影像,又可稱為「清晰化」:去雜訊、去模糊、超解析度(小圖變大圖)、除霧(霧濛濛的影像變清楚)、去雨。架構是全解析度的編碼器–解碼器(類 U-Net),或不降採樣的殘差網路,現在也常加入視窗注意力。請見 DL 04。
- 影像增強(image enhancement)讓內容更容易看清楚,但沒有唯一的「正確答案」:低光源增強(讓暗影像中的細節變清楚,某種程度上是聰明的調亮;如果是把黑夜變白天,就屬於轉譯了)與水下影像增強。請見 DL 05。
- 影像對齊(image alignment,或稱影像配準)估計把一張影像對應到另一張影像的幾何轉換或稠密位移場,是連拍融合、HDR 與醫學影像比對的前置步驟。
- 影像到影像轉換(image-to-image translation)把影像從一個領域或風格轉到另一個:白天變黑夜、夏天變冬天、草圖變照片。換臉的「深偽」(deepfake)就是同一個想法的(被濫用的)延伸應用。自從擴散模型出現後,轉換與編輯常改由一個以輸入影像為條件的生成模型完成,見下一節。
生成與視覺–語言模型
白話版。 有兩類較新的模型不太能放進舊地圖:一類從文字創造影像,另一類能談論影像。兩者都依賴大規模預訓練,以及把影像和語言連結起來。
擴散模型:從雜訊到影像
去雜訊擴散機率模型(denoising diffusion probabilistic model, DDPM)[27] 定義了一個前向過程,在 步內逐漸對影像 加入高斯雜訊。寫成封閉形式為
其中 是步數, 是固定的排程,從接近 1 遞減到接近 0。網路 被訓練來預測加入的雜訊:
生成時則反向執行這個過程:從純雜訊開始,一步一步去雜訊。換句話說,生成器就是反覆套用許多次的學習式去雜訊器,這讓生成直接和上面的復原問題連在一起。
- 潛在擴散(latent diffusion)[28] 不在像素上、而是在預訓練自編碼器的壓縮潛在空間中進行擴散,大幅降低成本,使高解析度的文字生成影像變得可行;文字條件透過交叉注意力(cross-attention)加入。它是 Stable Diffusion 的基礎。
- DiT(Diffusion Transformer)[28] 把 U-Net 去雜訊器換成作用在潛在 patch 上的 Transformer,並顯示品質會隨模型計算量穩定提升。
- InstructPix2Pix [29] 依照文字指令(「把它變成冬天」)編輯給定的影像,讓傳統的影像到影像轉換成為條件生成的一個特例。
視覺–語言模型
視覺問答(visual question answering, VQA),也就是針對一張影像回答自由形式的問題,以前需要串起影像特徵、影像描述(captioning)與文字問答的流程 [1]。兩個進展讓它變成單一模型。
CLIP [25] 以對比式(contrastive)目標,在 4 億組影像–文字對上訓練影像編碼器 與文字編碼器 。在一個包含 組配對的批次中,令正規化後的嵌入為 、,溫度為 ,影像到文字的損失為
總損失則與對稱的文字到影像項平均。配對的組合被拉近,批次中其他所有組合被推開。由於標籤空間變成了「任何一句話」,CLIP 可以做零樣本(zero-shot)分類:把「a photo of a cat」、「a photo of a dog」……等提示嵌入,再挑出與影像最接近的那一個。
LLaVA [26] 透過一個投影層,把 CLIP 視覺編碼器接上大型語言模型(LLM);投影層把視覺 token 映射到 LLM 的詞嵌入空間,再以關於影像的指令跟隨對話進行微調。目前大多數多模態 LLM 都沿用這種視覺編碼器+投影層+LLM 的架構,所以 VQA、影像描述與許多辨識任務,現在都可以透過對同一個模型下提示來完成。
現代觀點
貫穿本篇的趨勢,是從「一個任務一個模型」走向「一個基礎模型+提示或輕量 head」。以下的綜述論文,是理解這個領域如何走到今天的好地圖。
CNN 架構。 Li 等人 [30] 回顧了 CNN 的歷史、卷積運算本身、經典與進階架構(LeNet 到 ResNet 一脈,以及輕量化與加入注意力的網路)、一維/二維/多維卷積與各種應用。他們也整理了每個元件的改進(層設計、激活與損失函數、正則化、最佳化、快速計算),透過實驗歸納出挑選函數與超參數的經驗法則,最後討論開放問題與有潛力的方向。若想一次看到 CNN 的設計空間被逐個元件攤開,這是最好的單一參考。
Vision Transformer。 Khan 等人 [31](ACM Computing Surveys)依任務整理 Transformer 的研究:先是基礎(自注意力、大規模預訓練、雙向編碼),接著是辨識(分類、偵測、分割、動作辨識)、生成模型、多模態任務(VQA、視覺推理、視覺定位)、影片、低階視覺(超解析度、增強、上色)與三維點雲。他們的核心對比與本篇一致:Transformer 以極少的歸納偏置建模長距離依賴,因此需要大規模預訓練或架構上的先驗(視窗、階層)才能有好的資料效率。
自監督視覺學習。 Jing 與 Tian [32](TPAMI)綜述了 2020 年以前那一代的自監督方法,依前置任務(pretext task)分為生成式、上下文式、免費語意標籤式與跨模態式四類,並說明以遷移到下游任務來評估特徵的標準流程。Balestriero 等人 [33] 則以實用的「食譜」形式涵蓋新一代方法,把它們分成四個家族:深度度量學習(對比式)、自蒸餾(DINO 家族)、典型相關分析類方法,以及遮罩影像建模(MAE)。他們強調許多隱藏的「旋鈕」(資料擴增、投影 head、防止塌縮的機制),這也解釋了為什麼自監督結果難以重現。
視覺基礎模型。 Awais 等人 [34](TPAMI)依模態組合(視覺搭配文字、音訊、深度)、訓練目標(對比式 vs. 生成式)與提示類型(文字提示;視覺提示,例如 SAM 的點、框、遮罩;以及異質混合提示)為視覺基礎模型分類。他們列出的開放挑戰包括評估與基準測試、真實世界理解與上下文推理、偏差、對抗強健性與可解釋性。Zhang 等人 [35](TPAMI)聚焦於用於視覺辨識的視覺–語言模型:架構與預訓練目標、遷移方法(提示微調、特徵轉接器),以及把知識蒸餾到偵測器與分割器。他們主張網路規模的影像–文字資料降低了對群眾標註的依賴,並讓一個模型服務許多任務。
2024–2026 年的最新進展。 不引用任何基準數字,大致的局面如下:
- 骨幹網路。 以自監督或影像–文字資料預訓練的大型 ViT 是高階任務的預設選擇,凍結的 DINOv2/DINOv3 特徵 [21] 是密集任務的強基準。現代 CNN(ConvNeXt V2 [18])仍具競爭力,在延遲、記憶體或高解析度是主要考量時更受青睞。狀態空間骨幹 [22] 是活躍的替代路線。
- 分割與追蹤已收斂到可提示模型:影片物體用 SAM 2,開放詞彙概念用 SAM 3 [24]。
- 生成已轉向以 Transformer 為去雜訊器的潛在擴散 [28],編輯則轉向以指令為條件的擴散 [29]。
- 理解越來越多交給 LLaVA 架構的多模態 LLM [26]。
- 低階視覺仍大量依賴在合成劣化上訓練的任務專用編碼器–解碼器,並越來越常結合生成式(擴散)先驗;見 DL 04 與 DL 05。
開放問題。 (1) 資料與評估:基準測試趨於飽和,也可能與網路規模的預訓練資料重疊,難以區分泛化與記憶 [34]。(2) 真實世界的劣化:在合成雜訊或模糊上訓練的模型,遇到真實相機流程仍會失敗。(3) 保真度與幻覺:生成式先驗產生銳利、但有時是捏造的細節,這在醫學或鑑識用途中無法接受。(4) 效率:注意力對 token 數呈平方成長,基礎模型也很難在裝置端執行。(5) 大規模下的密集特徵:DINOv3 之所以需要 Gram anchoring [21],正是因為密集特徵品質可能隨訓練規模擴大而退化。(6) 以未篩選網路資料訓練的模型,其偏差、強健性與可解釋性 [34]。
重點整理
- 深度學習把傳統的三個層次縮減為兩類:低階(影像 → 影像,以保真度評判)與高階(影像 → 語意,以正確率評判)。中階分析則依輸出的形式歸入其中之一。
- 端對端學習以學習而來的特徵取代人工設計的特徵;而分工以預訓練骨幹+輕量 head 的形式在更大規模下回歸。
- 卷積層是一組具局部連接與權重共享的學習式空間濾波器。步幅、填補與池化決定輸出大小;感受野依 成長,而有效感受野比理論值小。
- LeNet-5(1998)不是第一個 CNN;以反向傳播訓練的卷積網路可追溯到 1989 年。ResNet 在 ImageNet 上訓練的是 18/34/50/101/152 層;1202 層只出現在 CIFAR-10。殘差連接讓恆等映射變得容易,也給梯度一條直達的路徑。
- 帶跳接的編碼器–解碼器(FCN、U-Net)是密集預測與影像復原的標準形狀。
- ViT 的歸納偏置很少,因此需要大規模預訓練。Swin 把局部性加回去;ConvNeXt 則證明現代化的 CNN 可以與之打平。
- DINO 是教師–學生自蒸餾;MAE 是遮罩預測。DINOv2/v3 提供凍結即用的通用特徵。
- 各種任務越來越收斂到可提示或與語言連結的基礎模型:分割用 SAM 1/2/3,生成用潛在擴散與 DiT,視覺–語言用 CLIP 與 LLaVA。
練習
- 手算感受野。 一個網路依序為: 卷積、步幅 2; 最大池化、步幅 2;接著四個 、步幅 1 的卷積。計算每一層之後的理論感受野與跳距,並用
receptive_field函式驗證。
提示
從 、 開始。第一個卷積之後:、。池化之後:、。之後每一層 增加 ,所以 ,。
- 參數預算。 輸入與輸出通道都是 時,比較(忽略偏差)一層 卷積、兩層疊起來的 卷積,以及一個瓶頸結構( 降到 64 通道、64 通道的 、 回到 256)的權重數。哪些的感受野相同?
提示
萬; 萬;瓶頸 萬。前兩者都看得到 ;瓶頸只看得到 ,但便宜得多,這就是 ResNet-50 以上使用它的原因。
- 沒有捷徑時,恆等映射為什麼很難。 在網路內部,區塊的輸入通常來自前一個 ReLU,因此是非負的。證明對這樣的輸入, 的殘差區塊輸出恰好是 。接著說明普通區塊(conv–BN–ReLU–conv–BN–ReLU)要輸出 必須學到什麼。這對非常深的普通網路代表什麼?
提示
對 ,。普通區塊則必須學到恰好抵消兩次卷積與兩次正規化的權重,這是一個精確又脆弱的解,梯度下降很少找得到。殘差區塊只需要 ,而權重衰減與零初始化本來就把它往那裡推。因此很深的普通網路很難讓多出來的層「什麼都不做」,這與 ResNet 作者觀察到的退化現象一致。
- ViT 的 token 數與計算量。 對 的輸入,計算 patch 大小為 32、16、8 時的 token 數,以及一層全域注意力的相對成本()。Swin 使用 視窗的視窗注意力,會如何改變這個成長趨勢?
提示
:256、1024、4096 個 token;成本比為 1 : 16 : 256。視窗注意力每層成本為 (每個 token 只關注 49 個 token),所以隨 線性成長。
- 學來的與手動設定的濾波器。 修改數字 CNN,讓第一層凍結為四個手動設定的卷積核(兩個 Sobel、一個 Laplacian、一個平均模糊)加上四個隨機卷積核,只訓練其餘部分。與完全學習的網路比較測試正確率;再解凍隨機卷積核,觀察它們會變成什麼樣子。
提示
設定好權重之後執行 conv.weight.requires_grad_(False),並只把其餘參數交給最佳化器。在這個簡單的資料集上兩者正確率相近;重點在於手動設定的微分濾波器本來就是合理的第一層,而解凍後的隨機卷積核往往會朝有方向性、類微分的圖樣移動(可對照圖 4)。
- 選擇配方。 你有 2,000 張標註過的顯微鏡影像,需要 (a) 每張影像的品質標籤、(b) 逐像素的細胞遮罩、(c) 去雜訊後的影像。根據本篇的地圖,為每一項提出骨幹、head 與訓練策略,並說明哪一項最能受益於凍結的自監督骨幹。
提示
(a) 凍結的 DINOv2/v3,或微調的 ConvNeXt+線性 head。(b) U-Net(可搭配預訓練編碼器),或以點提示 SAM 再微調。(c) 全解析度的復原網路,在符合該顯微鏡雜訊特性的合成雜訊/乾淨影像對上訓練。凍結的語意特徵對 (a) 與 (b) 幫助最大;(c) 更依賴逐像素準確的統計特性,而不是語意。
參考文獻
- Shyandram, “深度學習的數位影像處理介紹,” blog post, 2024; updated 2026. link
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018. publisher page
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2008. publisher page
- Y. LeCun, B. Boser, J. S. Denker, D. Henderson, R. E. Howard, W. Hubbard, and L. D. Jackel, “Backpropagation applied to handwritten zip code recognition,” Neural Computation, vol. 1, no. 4, pp. 541–551, 1989. doi:10.1162/neco.1989.1.4.541
- Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-based learning applied to document recognition,” Proceedings of the IEEE, vol. 86, no. 11, pp. 2278–2324, 1998. doi:10.1109/5.726791
- O. Russakovsky, J. Deng, H. Su, et al., “ImageNet large scale visual recognition challenge,” International Journal of Computer Vision, vol. 115, no. 3, pp. 211–252, 2015. doi:10.1007/s11263-015-0816-y · arXiv:1409.0575
- A. Krizhevsky, I. Sutskever, and G. E. Hinton, “ImageNet classification with deep convolutional neural networks,” NeurIPS, 2012. proceedings
- K. Simonyan and A. Zisserman, “Very deep convolutional networks for large-scale image recognition,” ICLR, 2015. arXiv:1409.1556
- C. Szegedy, W. Liu, Y. Jia, P. Sermanet, S. Reed, D. Anguelov, D. Erhan, V. Vanhoucke, and A. Rabinovich, “Going deeper with convolutions,” CVPR, 2015. doi:10.1109/CVPR.2015.7298594 · arXiv:1409.4842
- K. He, X. Zhang, S. Ren, and J. Sun, “Deep residual learning for image recognition,” CVPR, 2016. doi:10.1109/CVPR.2016.90 · arXiv:1512.03385
- A. Krizhevsky, “Learning multiple layers of features from tiny images,” technical report, University of Toronto, 2009 (the CIFAR-10/100 datasets). dataset page
- W. Luo, Y. Li, R. Urtasun, and R. Zemel, “Understanding the effective receptive field in deep convolutional neural networks,” NeurIPS, 2016. arXiv:1701.04128
- J. Long, E. Shelhamer, and T. Darrell, “Fully convolutional networks for semantic segmentation,” CVPR, 2015. arXiv:1411.4038
- O. Ronneberger, P. Fischer, and T. Brox, “U-Net: Convolutional networks for biomedical image segmentation,” MICCAI, 2015. arXiv:1505.04597
- A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, Ł. Kaiser, and I. Polosukhin, “Attention is all you need,” NeurIPS, 2017. ML anthology
- A. Dosovitskiy, L. Beyer, A. Kolesnikov, D. Weissenborn, X. Zhai, T. Unterthiner, M. Dehghani, M. Minderer, G. Heigold, S. Gelly, J. Uszkoreit, and N. Houlsby, “An image is worth 16x16 words: Transformers for image recognition at scale,” ICLR, 2021. arXiv:2010.11929
- Z. Liu, Y. Lin, Y. Cao, H. Hu, Y. Wei, Z. Zhang, S. Lin, and B. Guo, “Swin Transformer: Hierarchical vision Transformer using shifted windows,” ICCV, 2021. doi:10.1109/ICCV48922.2021.00986 · arXiv:2103.14030
- Z. Liu, H. Mao, C.-Y. Wu, C. Feichtenhofer, T. Darrell, and S. Xie, “A ConvNet for the 2020s,” CVPR, 2022, arXiv:2201.03545; and S. Woo, S. Debnath, R. Hu, X. Chen, Z. Liu, I. S. Kweon, and S. Xie, “ConvNeXt V2: Co-designing and scaling ConvNets with masked autoencoders,” CVPR, 2023, arXiv:2301.00808.
- M. Caron, H. Touvron, I. Misra, H. Jégou, J. Mairal, P. Bojanowski, and A. Joulin, “Emerging properties in self-supervised vision Transformers,” ICCV, 2021. doi:10.1109/ICCV48922.2021.00951 · arXiv:2104.14294
- K. He, X. Chen, S. Xie, Y. Li, P. Dollár, and R. Girshick, “Masked autoencoders are scalable vision learners,” CVPR, 2022. doi:10.1109/CVPR52688.2022.01553 · arXiv:2111.06377
- M. Oquab, T. Darcet, T. Moutakanni, et al., “DINOv2: Learning robust visual features without supervision,” Transactions on Machine Learning Research, 2024, arXiv:2304.07193; and O. Siméoni, H. V. Vo, M. Seitzer, F. Baldassarre, M. Oquab, et al., “DINOv3,” arXiv preprint, 2025, arXiv:2508.10104.
- L. Zhu, B. Liao, Q. Zhang, X. Wang, W. Liu, and X. Wang, “Vision Mamba: Efficient visual representation learning with bidirectional state space model,” ICML, 2024, arXiv:2401.09417; and Y. Liu, Y. Tian, Y. Zhao, H. Yu, L. Xie, Y. Wang, Q. Ye, J. Jiao, and Y. Liu, “VMamba: Visual state space model,” NeurIPS, 2024, arXiv:2401.10166.
- S. Ren, K. He, R. Girshick, and J. Sun, “Faster R-CNN: Towards real-time object detection with region proposal networks,” NeurIPS, 2015, arXiv:1506.01497; and N. Carion, F. Massa, G. Synnaeve, N. Usunier, A. Kirillov, and S. Zagoruyko, “End-to-end object detection with Transformers,” ECCV, 2020, arXiv:2005.12872.
- A. Kirillov, E. Mintun, N. Ravi, et al., “Segment anything,” ICCV, 2023, arXiv:2304.02643; N. Ravi, V. Gabeur, Y.-T. Hu, R. Hu, et al., “SAM 2: Segment anything in images and videos,” ICLR, 2025, arXiv:2408.00714; and N. Carion, L. Gustafson, Y.-T. Hu, S. Debnath, et al., “SAM 3: Segment anything with concepts,” ICLR, 2026, arXiv:2511.16719.
- A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, et al., “Learning transferable visual models from natural language supervision,” ICML, 2021. arXiv:2103.00020
- H. Liu, C. Li, Q. Wu, and Y. J. Lee, “Visual instruction tuning,” NeurIPS, 2023. arXiv:2304.08485
- J. Ho, A. Jain, and P. Abbeel, “Denoising diffusion probabilistic models,” NeurIPS, 2020. arXiv:2006.11239
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, and B. Ommer, “High-resolution image synthesis with latent diffusion models,” CVPR, 2022, arXiv:2112.10752; and W. Peebles and S. Xie, “Scalable diffusion models with Transformers,” ICCV, 2023, arXiv:2212.09748.
- T. Brooks, A. Holynski, and A. A. Efros, “InstructPix2Pix: Learning to follow image editing instructions,” CVPR, 2023. arXiv:2211.09800
- Z. Li, F. Liu, W. Yang, S. Peng, and J. Zhou, “A survey of convolutional neural networks: Analysis, applications, and prospects,” IEEE Transactions on Neural Networks and Learning Systems, vol. 33, 2022. doi:10.1109/TNNLS.2021.3084827 · arXiv:2004.02806
- S. Khan, M. Naseer, M. Hayat, S. W. Zamir, F. S. Khan, and M. Shah, “Transformers in vision: A survey,” ACM Computing Surveys, vol. 54, no. 10s, 2022. doi:10.1145/3505244 · arXiv:2101.01169
- L. Jing and Y. Tian, “Self-supervised visual feature learning with deep neural networks: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 43, 2021. doi:10.1109/TPAMI.2020.2992393 · arXiv:1902.06162
- R. Balestriero, M. Ibrahim, V. Sobal, et al., “A cookbook of self-supervised learning,” arXiv preprint, 2023. arXiv:2304.12210
- M. Awais, M. Naseer, S. Khan, R. M. Anwer, H. Cholakkal, M. Shah, M.-H. Yang, and F. S. Khan, “Foundation models defining a new era in vision: A survey and outlook,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 47, 2025. doi:10.1109/TPAMI.2024.3506283 · arXiv:2307.13721
- J. Zhang, J. Huang, S. Jin, and S. Lu, “Vision-language models for vision tasks: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 46, 2024. doi:10.1109/TPAMI.2024.3369699 · arXiv:2304.00685
- scikit-learn developers, “sklearn.datasets.load_digits” (a copy of the test set of the UCI optical recognition of handwritten digits dataset). docs