DL 04・深度影像復原:低階視覺
先備知識: DL 01・深度學習的影像處理與電腦視覺, 第 5 章・影像復原與重建
你將學到
- 什麼是「低階視覺」(low-level vision),以及為什麼超解析度、去雜訊、去模糊、除霧、除雨、除雪與低光增強其實是同一個問題:反轉一個退化 。
- 深度影像復原在實務上怎麼設定:成對資料、合成退化流程(synthetic degradation pipeline),以及它與真實世界(盲)退化之間的落差。你會用 PyTorch 實作一條退化流程,並訓練一個小小的殘差去雜訊網路。
- 各任務的里程碑與目前主流家族,從 SRCNN、DnCNN、DehazeNet 與 GoPro 去模糊基準,到 SwinIR、Restormer、NAFNet、MambaIR 與以擴散模型為基礎的超解析度(SUPIR、OSEDiff)。
- All-in-one 模型(AirNet、TransWeather、PromptIR、AdaIR、DA-CLIP、InstructIR)如何用一個網路處理未知或混合的退化。
- 該用哪些損失函數與評估指標、為什麼 PSNR 和「看起來真實」會互相矛盾(感知–失真權衡,perception–distortion trade-off),以及 NTIRE 挑戰賽如何追蹤這個領域。
先看全貌
低階視覺處理的是像素本身。在系統能辨認人臉、讀出路牌或偵測車輛之前,影像得先清楚到「看得見」。影像復原模型就是流程中負責這一步的部分:拿到一張受損的照片(太小、雜訊多、模糊、起霧、下雨、太暗),輸出對乾淨場景更好的估計。
為什麼重要:每支手機相機在你看到照片之前,都已經做過去雜訊、去馬賽克(demosaicking)與超解析度。衛星、顯微鏡、醫學與監視影像在量測之前都要先復原。影音串流服務會把低位元率的畫面放大。自駕車需要偵測器在雨霧中照常運作。從研究的角度看,許多架構想法也是先在復原任務上被驗證的:殘差學習、通道注意力、高效率 Transformer 與擴散先驗,都有知名的復原版本。
本篇假設你已熟悉 CNN 與反向傳播(DL 01),以及傳統影像復原(DIP 第 5 章),後者詳細介紹了雜訊模型、Wiener 濾波與退化模型。這裡會直接連結過去,不再重複。
什麼是低階視覺?
白話版。 高階視覺問的是「圖裡有什麼?」(分類、偵測);低階視覺問的是「這張圖逐個像素來看,實際上長什麼樣?」前者關於理解,後者關於感知。
作者在原文 [1] 中的比喻,來自人與外界互動的方式:我們先感知(光打在視網膜上,看見邊緣、顏色與對比),再理解(那是一個杯子)。兩者缺一不可。如果感知很差(杯子很模糊),理解也會跟著受影響。低階視覺任務就是為了讓感知重新變好而存在:當我們說一個東西「很模糊」,代表感官對它的判定並不靈敏,於是就有了把它變「清晰」的去模糊任務。
精確版。 低階視覺任務把一張影像映射成內容(通常)相同的另一張影像:
輸出是逐像素的估計,而不是一個標籤。 是輸入的高、寬與通道數, 是輸出的(超解析度倍率為 時 ,其他情況通常相等)。這帶來三個影響整個領域的特性:
- 輸出密集且高解析度。 每個像素都重要,所以架構不能大幅降採樣,必須保留細節,這讓高解析度下的運算成本很高。
- 監督訊號很容易合成。 拿一張乾淨影像,用已知的方式把它弄壞,就得到一組輸入–目標配對。這是相對於辨識任務(需要人工標註)的巨大優勢,也是這個領域最大弱點的來源:合成的損傷終究不是真實的損傷。
- 「正確答案」並不唯一。 很多張乾淨影像都和同一張受損影像相容。哪一張「最好」,取決於你重視的是忠於真實還是看起來自然,後面的評估章節會詳細討論。
這類任務範圍很廣:去模糊、超解析度、去雜訊、修補(inpainting)、色彩校正、紅外線與可見光融合等等。過去大家常在 Papers with Code 上依任務瀏覽分類與排行榜,但它已停止營運,原網址現在會直接轉址到 Hugging Face 的 Trending Papers 頁面,依任務分類的 SOTA 頁面已無法瀏覽。現在追蹤進展的可靠方式,是每年的 NTIRE 挑戰賽報告(New Trends in Image Restoration and Enhancement,CVPR 的一個 workshop),本篇接近結尾時會介紹 [2], [3]。
一個問題、許多面貌:退化模型
白話版。 本篇的每一個任務都可以寫成:「相機看到乾淨的場景 ,某種東西破壞了它,我們拿到的是 。」改變的只有那個「破壞」。只要能把破壞寫下來,就能說出這是哪個任務。
統一的觀點
其中 是未知的乾淨影像, 是退化運算子(可能是非線性的,也可能未知), 是雜訊, 是觀測到的影像。復原就是從 估計 。以下是原文 [1] 與本篇後面用到的具體形式,圖 1 把每一種套用在同一張照片上。
模糊(課本上的模型)。 和 DIP 第 5 章 一樣,
其中 是清晰影像, 是點擴散函數(模糊核), 是二維卷積, 是加性雜訊, 是觀測影像, 是像素座標。去雜訊是 (單位脈衝,也就是沒有模糊)的特例。
超解析度。 低解析度影像是高解析度影像經過模糊、次取樣再加上雜訊的結果:
其中 是模糊(抗鋸齒)核, 表示每個方向每 個像素取一個, 是放大倍率(2、3、4……)。經典的「bicubic」基準設定則把這一切換成 MATLAB 風格的雙三次降採樣,並且不加雜訊。
壓縮。 , 是品質因子。JPEG 會量化 區塊的 DCT 係數(見 DIP 第 8 章),產生區塊效應與振鈴。它既非加性也非線性,所以通常直接當成黑盒子放進退化流程。
霧(大氣散射模型)。
其中 是像素位置, 是有霧影像, 是無霧的場景輻射, 是全域大氣光(霧的顏色), 是透射率, 是散射係數, 是場景深度。第一項是被衰減的場景;第二項是被散射進相機的「空氣光」(airlight)。越遠的物體( 大) 越小,逐漸融入 。
雨。 雨線(rain streak)常用加性模型:
其中 是無雨背景, 是雨層。附著在鏡頭或擋風玻璃上的雨滴(raindrop)行為不同:它會遮住並折射背景,所以常用的模型是 ,其中 是雨滴的二值遮罩, 是逐元素乘積, 是穿過雨滴的光 [39]。
低光(Retinex)。 Retinex 理論 [5] 把影像分解成反射率與光照:
其中 是觀測影像, 是反射率(物體表面本身的顏色與紋理,這是我們要的), 是光照, 是逐元素乘積。暗照片的 很小;增強就是估計 並把它提亮,同時原本藏在暗處的雜訊也會被放大。
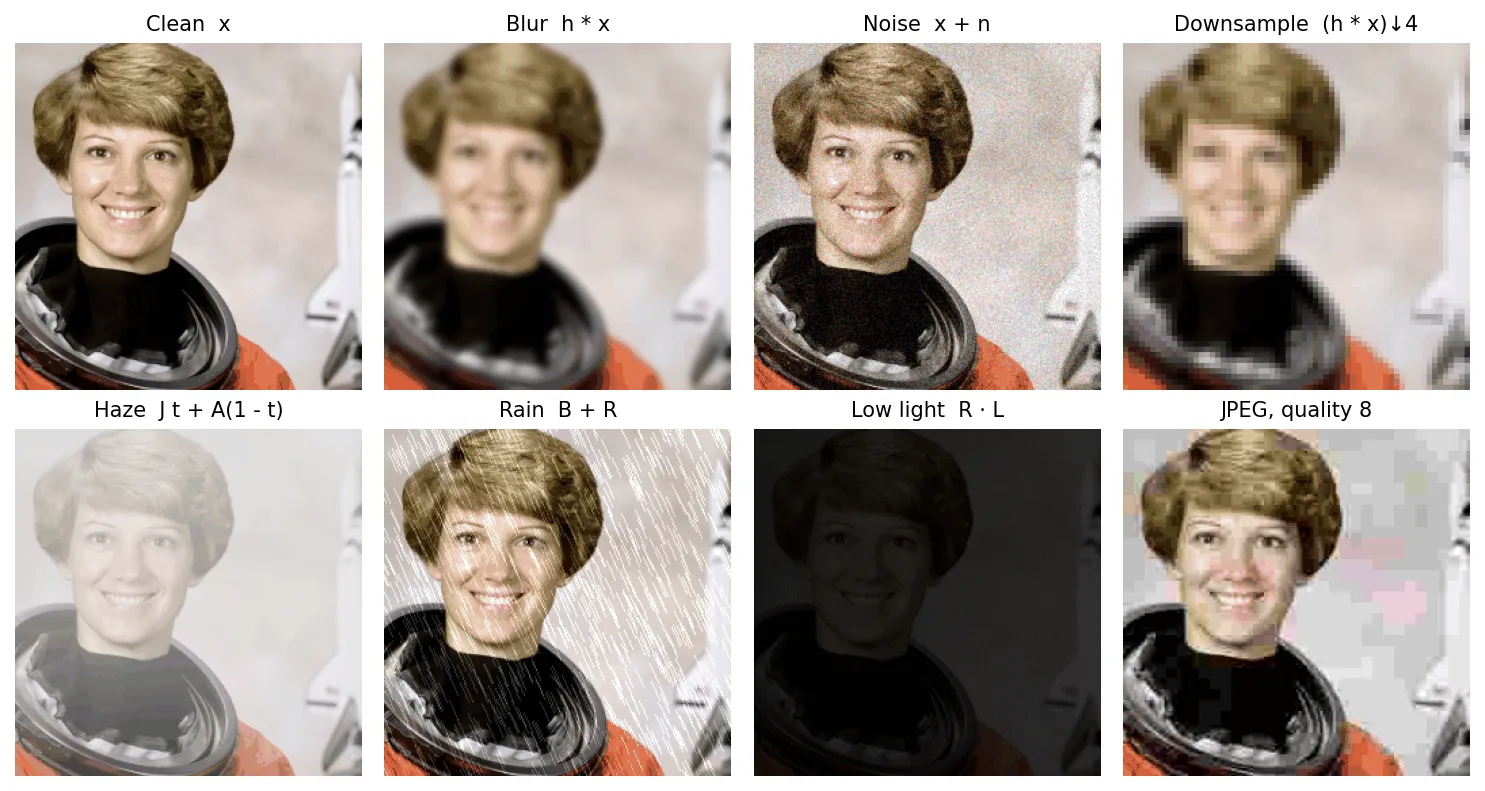
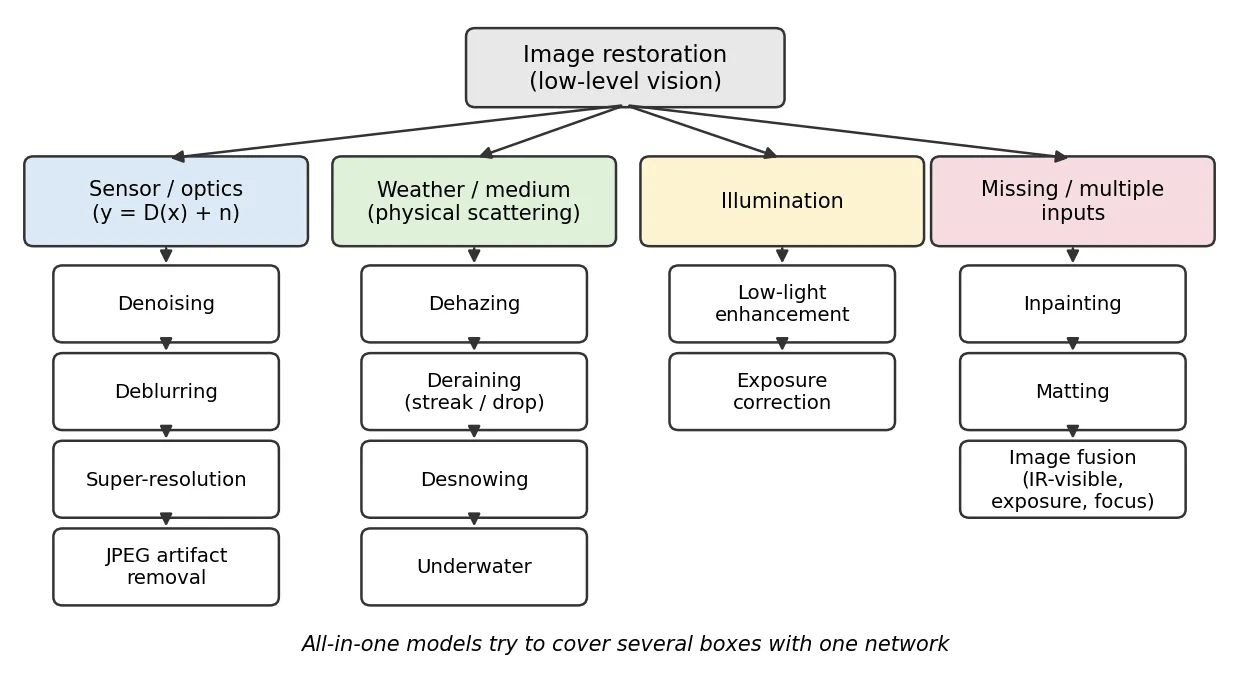
這些模型都不完全精確,卻有相同的形狀:乾淨影像進去,運算子加上雜訊出來。這正是原文 [1] 的核心觀點:雖然不是很嚴謹,但透過退化模型來看,它們本質上都可以用同一種方式「理解」,屬於同一種問題,同一套工具(而且常常是同一個網路)都適用。圖 2 依照損傷的來源把它們分類。
為什麼困難:病態問題
上面幾乎每一種 ,都有許多不同的 會產生相同的 。降採樣 4 倍丟掉每 16 個像素中的 15 個;模糊把高頻壓到幾乎為零; 的濃霧會抹去遠處的物體。這個反問題是病態的(ill-posed),我們需要一個關於乾淨影像長相的先驗(prior)。用貝氏(MAP)形式寫:
第一項(資料保真項)要求 必須能解釋觀測, 是編碼先驗的正則項(自然的影像 小), 平衡兩者。整個領域的歷史,就是一部尋找更好先驗 的歷史。
深度學習之前:手工先驗的時代
在深度學習興起之前,每個任務都有自己精心推導的先驗,成敗取決於對問題是否有足夠充分的物理或統計知識(prior knowledge)。去雜訊用局部平滑、非局部自相似與稀疏性;去模糊用 Wiener 與限制最小平方濾波,加上重尾的梯度先驗;除霧用暗通道先驗 [25];超解析度用插值與以範例為基礎的字典;低光增強用直方圖等化與 Retinex 分解。DIP 第 5 章 涵蓋了這套工具的核心(雜訊模型、平均/中位數/自適應濾波、反濾波、Wiener 與 CLS 濾波),結尾也簡短回顧了走向學習式去雜訊的歷史。作者在 [1] 中的看法是:深度學習逐漸解決並超越這些模型能做到的程度之後,關鍵不再是為每個任務建立強大的理論先驗,而是強大的學習機制與特徵擷取方法。退化模型並沒有消失,它從求解器搬進了資料產生器。
深度學習的問題設定
白話版。 做出大量(受損, 乾淨)的影像對,訓練網路把受損的變成乾淨的。大部分的苦工都在讓損傷看起來夠真實。
以成對資料做監督式訓練
給定乾淨影像集合 與一個退化取樣器,建立配對 ,其中 ,然後求
其中 是參數為 的復原網路, 是訓練對數量, 是損失函數(L1、L2、感知、對抗……見損失函數一節)。訓練時使用隨機裁切的小塊(patch,例如 到 )並搭配翻轉與旋轉,因為卷積與視窗注意力網路具有平移等變性,而全解析度影像也放不進 GPU 記憶體。
有一個事實可以解釋後面很多現象:用 L2 損失時,最佳網路輸出的是後驗平均 。當許多清晰影像都與 相容時,它們的平均是模糊的。這就是為什麼以 MSE 訓練的超解析度看起來很平滑,也是後來引入 GAN 與擴散模型的原因。
合成退化流程
配對資料有三種來源。(1) 合成:用已知模型(雙三次降採樣、高斯雜訊、高斯模糊、JPEG)弄壞乾淨影像。便宜且無限量,但受限於模型有多真實。(2) 實拍:同一個場景拍兩次,例如短曝光與長曝光,或把連拍平均成乾淨參考(如真實雜訊資料集 SIDD [22]),或把高速攝影的連續影格平均,得到真實的動態模糊(GoPro [44])。真實但昂貴,且侷限於特定相機。(3) 非成對/自監督:只用受損影像學習,靠 GAN、循環一致性或雜訊統計。今天大多數強模型都用豐富退化流程產生的合成配對訓練,再同時在合成與實拍資料上評估。
典型的「經典」流程是 模糊 → 降採樣 → 雜訊 → JPEG,模仿相機與圖片分享網站依序破壞照片的順序:
import numpy as np, cv2, torch, torch.nn.functional as F
from skimage import data, img_as_float32

def gaussian_kernel(sigma, size=21):
    ax = torch.arange(size) - size // 2
    g = torch.exp(-ax**2 / (2 * sigma**2))
    k = torch.outer(g, g)
    return k / k.sum()

def degrade(x, scale=4, sigma_blur=1.6, sigma_noise=0.03, jpeg_q=40, rng=None):
    """x: float tensor (C,H,W) in [0,1]. Returns the low-quality image y = D(x) + n."""
    rng = rng or np.random.default_rng(0)
    C = x.shape[0]
    k = gaussian_kernel(sigma_blur).to(x)[None, None].repeat(C, 1, 1, 1)
    y = F.conv2d(F.pad(x[None], (10,) * 4, mode="reflect"), k, groups=C)   # 1) 模糊  h * x
    y = y[..., ::scale, ::scale]                                           # 2) 降採樣  (.)↓s
    y = y + sigma_noise * torch.from_numpy(rng.standard_normal(y.shape).astype(np.float32))  # 3) 雜訊 n
    y = y.clamp(0, 1)[0]
    img = (y.permute(1, 2, 0).numpy() * 255).round().astype(np.uint8)      # 4) JPEG 編碼再解碼
    ok, buf = cv2.imencode(".jpg", img[..., ::-1], [cv2.IMWRITE_JPEG_QUALITY, jpeg_q])
    img = cv2.imdecode(buf, cv2.IMREAD_COLOR)[..., ::-1]
    return torch.from_numpy(img.copy()).permute(2, 0, 1).float() / 255

x = torch.from_numpy(img_as_float32(data.astronaut())).permute(2, 0, 1)    # (3, 512, 512)
y = degrade(x)
print(x.shape, "->", y.shape)        # torch.Size([3, 512, 512]) -> torch.Size([3, 128, 128])
實際訓練時,每個參數(模糊核的寬度與形狀、雜訊強度與種類、JPEG 品質,甚至順序)都會對每張影像隨機取樣,讓網路看到的是一整個退化分布,而不是單一一種。
真實世界與盲退化
只用一種固定 (例如雙三次 )訓練的模型,遇到真實照片就會失效,因為真實退化是未知的、隨位置變化的,而且是多種效應的混合。這就是盲(blind,或稱真實世界)復原問題。大致有兩種策略:
- 把合成分布做得夠寬,寬到能涵蓋真實情況。 Real-ESRGAN [4] 把經典流程連續套用兩次(「高階」退化,每一輪都隨機取樣模糊核、縮放、雜訊與 JPEG),並加入 sinc 濾波器來模擬振鈴與過衝。即使只用合成資料訓練,它在真實低品質影像上的泛化也比雙三次訓練的模型好得多。
- 引入強大的生成先驗。 預訓練的文字生成影像擴散模型已經知道自然影像長什麼樣。DiffBIR [16]、SUPIR [17] 與 OSEDiff [18] 都以受損輸入作為條件來驅動這類模型,讓先驗「補上」合理的細節。這是真實世界超解析度近年的主要趨勢,後面會再討論。
第三種互補的策略是估計退化本身(雜訊強度、模糊核、退化種類),再餵給網路,例如 FFDNet 的雜訊強度圖 [21] 與各種 all-in-one 模型。
超解析度(Super-Resolution, SR)
白話版。 把小圖變大而且變清楚,也就是預測缺少的高解析度像素,而不只是把現有的像素拉伸開來。
問題設定
單張影像超解析度(SISR)在 之下,從 估計 。傳統做法是插值法(interpolation):最近鄰(nearest neighbor)、雙線性(bilinear)與雙三次(bicubic)。其中雙三次插值以 鄰域擬合三次多項式,最為知名,至今仍被廣泛使用,既是基準方法,也是產生低解析度測試輸入的標準方式。插值只會重新分配既有資訊,無法重建被 丟掉的高頻。
網路怎麼「變大」:三種上採樣策略
輸出比輸入大,所以每個 SR 網路都得決定解析度在哪裡提升。
a. 先上採樣(先插值)。 SRCNN [6] 先用雙三次插值把輸入放大到目標尺寸,再接三層卷積(區塊擷取、非線性映射、重建)。簡單直觀,但每一層都在高解析度上運算,速度慢,網路還得清理插值造成的瑕疵。
b. 轉置卷積(反卷積,deconvolution)。 FSRCNN [7] 在低解析度上運算,只在最後用學習得到的轉置卷積放大,速度比 SRCNN 快很多。步長無法整除核大小的轉置卷積會產生不均勻的重疊,容易出現棋盤狀瑕疵(checkerboard artifact)[9],所以現在很少被當作 SR 的最終上採樣器;不過在其他類型的神經網路中(例如分割與生成模型的解碼器)仍然相當常見。
c. 子像素卷積(pixel shuffle)。 ESPCN [8] 在低解析度上計算 個通道,再重新排列成 倍大的影像:
其中 是有 個通道的低解析度特徵張量, 是低解析度位置, 是子像素偏移, 是輸出通道。所有學習都在低解析度進行,重新排列本身沒有參數。這是現代 SR 網路的主流選擇(torch.nn.PixelShuffle)。
里程碑
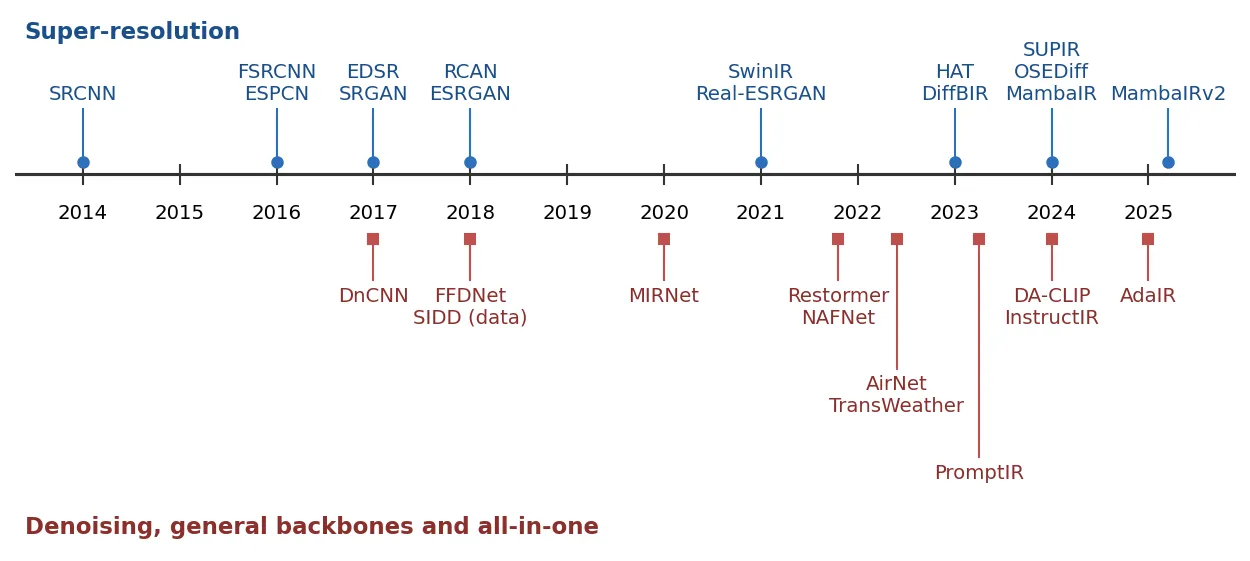
- SRCNN(2014/2016)[6]:第一個端到端的 SR CNN,在雙三次放大的輸入上接三層卷積。
- FSRCNN(2016)[7] 與 ESPCN(2016)[8]:後上採樣,達到即時速度。
- EDSR(2017)[10]:拿掉批次正規化(BN 會削弱復原任務所需的數值範圍彈性)的深層殘差網路,用殘差縮放穩定訓練,並有多尺度版本。它贏得 NTIRE 2017 SR 挑戰賽。
- RCAN(2018)[11]:非常深的「殘差中的殘差」結構,加上通道注意力(channel attention),用全域統計量重新加權特徵通道,讓網路專注於高頻資訊。
- SRGAN(2017)[12] 與 ESRGAN(2018)[13]:對抗損失與感知(VGG 特徵)損失產生銳利、逼真的紋理,而不是 MSE 的模糊平均。ESRGAN 改良了生成器(不含 BN 的 Residual-in-Residual Dense Block)、使用相對判別器(relativistic discriminator),並在激活前的特徵上計算感知損失。
大約在 2018 年,這些模型的結果在人眼看來已經遠勝插值,領域也開始質疑該怎麼評判 SR,評判標準本身的界定引起更多疑慮(見感知–失真一節)。
Transformer、真實世界 SR 與擴散模型(目前的主流家族)
- Transformer。 SwinIR [14](2021)以殘差 Swin Transformer 區塊(在位移的局部視窗內做自注意力)處理 SR、去雜訊與 JPEG 去壓縮瑕疵。HAT [15](CVPR 2023)結合通道注意力、視窗自注意力與重疊交叉注意力模組,讓每個輸出「啟動更多像素」。兩者至今仍是常見的比較基準。
- 狀態空間模型。 MambaIR [49] 與 MambaIRv2 [50] 以選擇性狀態空間(Mamba)掃描取代注意力,以線性成本取得全域感受野;見骨幹網路一節。
- 真實世界(盲)SR。 前面介紹過的 Real-ESRGAN [4] 與其高階退化流程。
- 擴散先驗。 DiffBIR [16] 先去除退化,再用預訓練的潛在擴散模型重新生成細節;SUPIR [17] 把這個做法放大,使用大型擴散骨幹、兩千萬張附文字描述的訓練影像,以及負向品質提示(negative-quality prompt);OSEDiff [18] 把過程蒸餾成單一步擴散,直接從低品質影像出發,並以變分分數蒸餾(variational score distillation)維持輸出的真實感。這些方法在真實照片上能產生更有說服力的紋理,但也可能捏造出場景中不存在的細節。
資料集與指標
標準訓練集是 DIV2K [19](為 NTIRE 2017 推出的 2K 解析度影像)。評估使用幾個經典的小型測試集(自然、都市與漫畫影像),在亮度(Y)通道上報告 PSNR 與 SSIM,通常會先裁掉 個邊界像素。真實世界 SR 則以感知與無參考指標評估(LPIPS、NIQE 等,見評估指標一節)。
去雜訊(Denoising)
白話版。 把照片上隨機的顆粒去掉,同時不要把真正的紋理也抹平。雜訊是最單純的退化,所以去雜訊成了大多數深度復原想法最先出現的試驗場。
問題設定
。合成設定中 (加性白高斯雜訊,AWGN,標準差 通常以 0–255 的尺度表示,例如 )。真實相機的雜訊不一樣:它和訊號相關(光子散粒雜訊隨亮度增加),去馬賽克後在空間上具相關性,還會被相機的影像處理流程改變形狀。
里程碑
DnCNN [20] 做了兩個後來成為標準的選擇。第一是殘差學習(residual learning):網路 不直接預測 ,而是預測雜訊,輸出為
其中 。殘差(雜訊)比乾淨影像「更容易學」,使得搭配批次正規化的深層純 CNN 能訓練得很好。單一 DnCNN 也能針對一段範圍的雜訊強度訓練(盲高斯去雜訊),而且同一個網路也能處理 SR 與 JPEG 去區塊。
FFDNet [21] 把雜訊強度圖 (與影像同尺寸,每個像素的值為 )和降採樣後的輸入一起餵給網路。測試時調整 ,可以在去雜訊與保留細節之間取捨;非均勻的 則能處理隨位置變化的雜訊。它的速度快到可以在 CPU 上執行。
真實雜訊。 SIDD 資料集 [22] 提供真實的智慧型手機雜訊影像,乾淨參考影像則透過仔細拍攝連拍並加以處理而得。只用 AWGN 訓練的模型在它上面表現很差,這推動了整個領域走向真實的雜訊合成與實拍訓練資料。
通用骨幹。 MIRNet [30]、Restormer [23] 與 NAFNet [24] 是通用的復原架構,在 SIDD 以及去模糊等任務上都報告了最先進的結果,會在骨幹網路一節介紹。
程式碼:一個小小的殘差去雜訊網路
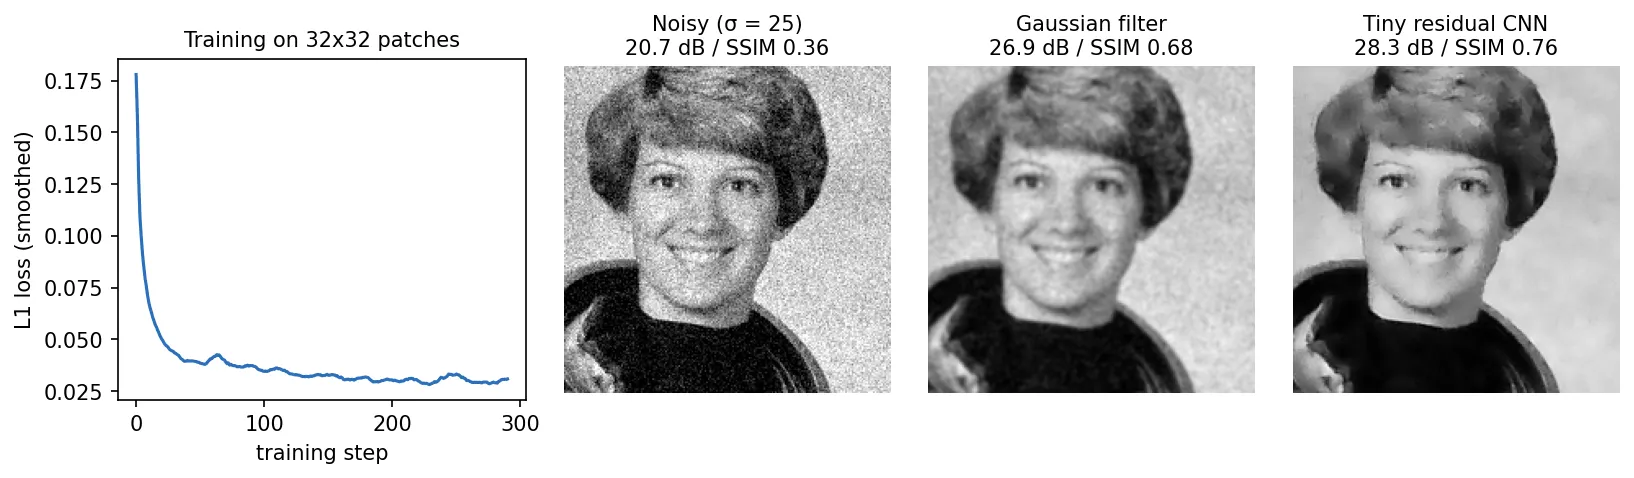
下面的程式在四張 skimage 影像隨機切出的 小塊上訓練一個五層、DnCNN 風格的網路,每一步都加上新的高斯雜訊,然後在一張從沒看過的影像上測試。在筆電 CPU 上大約一分鐘內就能跑完(我們在負載很重的機器上量到約一分鐘)。
import time, numpy as np, torch, torch.nn as nn
from skimage import data, img_as_float32
from skimage.color import rgb2gray

torch.manual_seed(0); torch.set_num_threads(2)
rng = np.random.default_rng(0)
sigma = 25 / 255                                    # 雜訊強度([0,1] 尺度)
train_imgs = [img_as_float32(im) for im in (data.camera(), data.coins(), data.moon(), data.page())]
test_img = img_as_float32(rgb2gray(data.astronaut()))   # 測試用,不參與訓練

def random_patches(n=32, p=32):
    batch = []
    for _ in range(n):
        im = train_imgs[rng.integers(len(train_imgs))]
        i, j = rng.integers(0, im.shape[0] - p), rng.integers(0, im.shape[1] - p)
        batch.append(im[i:i + p, j:j + p])
    return torch.from_numpy(np.stack(batch))[:, None]   # (n, 1, p, p)

class TinyDnCNN(nn.Module):
    """conv-ReLU, (depth-2) x conv-BN-ReLU, conv。預測的是雜訊,不是影像。"""
    def __init__(self, depth=5, ch=32):
        super().__init__()
        layers = [nn.Conv2d(1, ch, 3, padding=1), nn.ReLU(inplace=True)]
        for _ in range(depth - 2):
            layers += [nn.Conv2d(ch, ch, 3, padding=1), nn.BatchNorm2d(ch), nn.ReLU(inplace=True)]
        layers += [nn.Conv2d(ch, 1, 3, padding=1)]
        self.body = nn.Sequential(*layers)
    def forward(self, y):
        return y - self.body(y)                         # x_hat = y - R(y):殘差學習

net = TinyDnCNN()
opt = torch.optim.Adam(net.parameters(), lr=2e-3)
t0 = time.time()
for step in range(300):
    x = random_patches()
    y = x + sigma * torch.randn_like(x)                 # 即時產生合成配對
    loss = nn.functional.l1_loss(net(y), x)
    opt.zero_grad(); loss.backward(); opt.step()
print(f"trained in {time.time() - t0:.0f} s, last L1 = {loss.item():.4f}")

net.eval()
with torch.no_grad():
    x = torch.from_numpy(test_img)[None, None]
    y = x + sigma * torch.randn_like(x)
    x_hat = net(y).clamp(0, 1)
mse = lambda a, b: torch.mean((a - b) ** 2).item()
print(f"PSNR noisy {10*np.log10(1/mse(y.clamp(0,1), x)):.2f} dB -> denoised {10*np.log10(1/mse(x_hat, x)):.2f} dB")
# 例如 PSNR noisy 20.74 dB -> denoised 28.64 dB
即使是這個只用四張圖、訓練 300 個小步驟的玩具模型,在沒看過的照片上也能提升約 8 dB,而且勝過手動調整的高斯濾波(圖 4)。拖動滑桿,比較雜訊輸入與小網路的輸出。
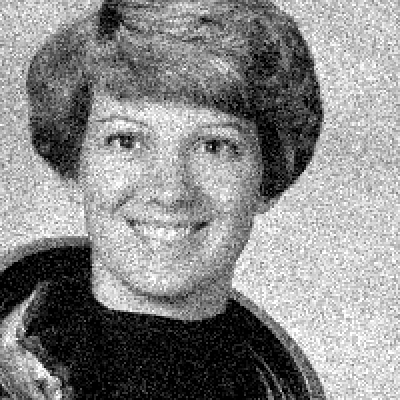
 雜訊(σ = 25)小型殘差 CNN
除霧(Dehazing)
白話版。 去掉霧或霾造成的灰白色面紗,找回對比與顏色,遠處物體尤其明顯。用原文的說法,它是去雜訊與去模糊的一種延伸,只是多了一個物理模型。
傳統做法與暗通道先驗
傳統方法先估計 中的未知量(透射率圖 與大氣光 ),再代回公式求解。最困難的部分,就是想出能把這些未知量確定下來的可靠關係。最知名的是何凱明等人的暗通道先驗(dark channel prior)[25]:在無霧的戶外影像中,大多數局部區塊裡至少有一個像素在某個顏色通道上非常暗(陰影、深色或鮮豔的物體):
其中 是以 為中心的小區塊, 是顏色通道 。對霧的模型做同樣的雙重取最小值,再利用 ,就得到透射率估計
其中 (論文中取 0.95)刻意保留一點霧,以維持深度感。接著 ,小小的 用來避免除以零。這個先驗在大片與大氣光相近的明亮區域(白牆、天空)會失效,而以區塊為單位得到的粗糙 也必須再精修,才能貼合邊緣。
深度除霧:兩個流派
原文 [1] 把深度除霧分成兩派,這個分法至今仍很貼切。
1. 物理引導(「套公式」)。 學出未知參數,再反轉模型。DehazeNet [26] 用 CNN(搭配 Maxout 單元與有界 ReLU)從有霧區塊迴歸出透射率 。AOD-Net [27] 進一步簡化大氣散射模型,把 與 合併成單一函數 :
其中 是常數偏移。一個輕量 CNN 預測 ,於是整個網路是端到端的,還可以接在偵測器前面一起訓練。
2. 強大的通用架構(「超級模型」)。 跳過物理,直接用強大的網路學 。GridDehazeNet [28] 使用以注意力為基礎的多尺度網格;FFA-Net [29] 堆疊通道注意力與像素注意力區塊,並做自適應特徵融合。這類設計的學習能力很強,換句話說,很有機會也適用於其他退化任務,這正是 MIRNet [30] 等通用復原網路走的路。之後出現了 Transformer 除霧模型:DehazeFormer [31] 修改正規化層、激活函數與空間聚合方式,把 Swin Transformer 調整成適合除霧。
資料集
- RESIDE [32]:大型基準,包含以深度與散射模型合成的室內外有霧影像,以及用於任務導向評估的真實有霧影像。它的 SOTS 測試集是最常被引用的除霧基準。
- O-HAZE [33] 與 Dense-Haze [34]:以專業造霧機拍攝的真實有霧/無霧配對,分別是戶外場景與濃霧場景。規模小,但能突顯合成與真實之間的落差。
- KITTI [35] 不是除霧資料集。它是在 Karlsruhe 一帶錄製的自駕車情境視覺基準(立體視覺、光流、里程計、3D 物件偵測、追蹤)。部分除霧研究會在它的影像上合成霧氣(它有光達與立體視覺提供的深度),或用它評估除霧對下游偵測的影響。
除雪(Desnowing)
白話版。 去掉飄落的雪。看起來像除雨的親戚,但行為上也很像除霧。
除雪比看起來困難。雪花的大小與透明度差異極大,從不透明的白色團塊到半透明的條紋都有,而大雪還會造成類似霧的朦朧效應(veiling effect)。所以除雪模型不只要處理呈現為白點的「雪」,也得處理朦朧的霧氣。DesnowNet [36] 推出 Snow100K 資料集(在真實影像上合成雪,另附真實雪景影像),以及一個同時估計雪的半透明程度與其殘留的網路。JSTASR [37] 明確建模雪的大小與透明度,並加入去除朦朧效應的步驟。現在除雪通常被放進 TransWeather [52] 這類「惡劣天氣」all-in-one 模型中一起研究。
除雨(Deraining)
白話版。 把照片裡的雨去掉。「雨」其實指兩種很不一樣的東西:在空中落下的細雨線,以及停在鏡頭或擋風玻璃上的雨滴。
雨線與雨滴
- 雨線(rain streak)是疊加在場景上、細而亮、有方向性的線條,模型為 。遠處的雨線累積起來會形成類似霧的面紗。方法的目標是把兩層分開。一個早期具影響力的深度方法同時偵測並去除雨 [38],並提供了被廣泛使用的輕雨與大雨合成資料集。
- 雨滴(raindrop)附著在玻璃表面,像一個個小透鏡:遮住並折射背景、常常失焦,而且沒有一致的方向。Qian 等人的注意力 GAN [39] 用注意力圖(雨滴在哪裡?)同時引導生成器與判別器,並推出一個透過玻璃拍攝、有無水滴成對的雨滴資料集。
走向真實場景
大多數除雨資料集是合成的,用合成雨線訓練的模型面對真實的雨常常失效。NTIRE 2025 Day and Night Raindrop Removal for Dual-Focused Images 挑戰賽 [40] 反映了研究重心轉向真實資料:它使用真實拍攝的 Raindrop Clarity 資料集,涵蓋白天與夜晚,以及對焦在雨滴與對焦在背景兩種情況(訓練 14,139 張、驗證 240 張、測試 731 張)。對焦設定很關鍵:相機對焦在雨滴上時,背景也是模糊的,於是去除雨滴有一部分變成了去模糊。
低光增強(簡介)
白話版。 讓暗照片看起來曝光正常、細節可見、色調自然,同時不要把雜訊放大。
訓練時對比暗影像與同一場景正常曝光的參考影像,例如隨 RetinexNet [41] 推出、包含低光/正常光配對的 LOL 資料集。傳統方法以對比度調整(直方圖等化)與 Retinex 模型為主(較少見的還有反轉大氣散射模型)。深度方法有兩條路線:受 Retinex 啟發、分解 再調整 的網路(RetinexNet [41]),以及特別設計的通用網路。Retinexformer [42](ICCV 2023)結合兩者:單階段的 Retinex 公式加上光照引導的注意力,作者稱它是第一個以 Transformer 為基礎的低光增強方法。低光增強本身的內容(零參考方法、曲線估計、雜訊、色彩、影片)多到值得獨立一章:見 DL 05。
影像融合(簡介)
白話版。 把同一場景、各有所長的幾張影像組合成一張,讓結果同時擁有每一張的優點,資訊更豐富多樣。
原文 [1] 提到三種常見設定:紅外線與可見光融合(紅外線提供熱目標,可見光相機提供紋理與色彩)、多重曝光融合(結合曝光不足與過度照片的細節,得到類似 HDR 的結果),以及多焦點融合(由對焦在不同深度的照片合成全景深影像)。與其他任務不同,融合通常沒有真實的「正確融合影像」,所以深度融合依賴保留來源影像梯度與強度的非監督式損失,或使用 GAN。Zhang 等人的綜述 [43] 依這些情境與學習策略整理了深度融合方法。
去模糊(Deblurring)
白話版。 從被手震、物體移動或失焦弄糊的影像中,還原出清晰的影像。
問題設定
去模糊就是 的直接應用。模糊核 已知時稱為非盲(non-blind)去模糊(DIP 第 5 章中 Wiener 與 CLS 濾波的設定,以及學習式非盲求解器); 未知時稱為盲(blind)去模糊。動態場景中的真實動態模糊更麻煩:不同物體的運動不同、深度也不同,所以根本沒有單一的全域 。
資料與里程碑
Nah 等人 [44](CVPR 2017)用 GoPro 資料集處理這個問題:他們以高速攝影機拍攝清晰的影片,把連續影格平均起來,得到真實的模糊影像,並以中間那一格作為清晰目標。他們的網路是多尺度的:先還原粗略版本,再逐步在更細的尺度上精修,類似傳統盲去模糊由粗到細的策略,但完全不需要估計模糊核。GoPro 至今仍是最常用的去模糊基準。
今天最常被比較的基準是通用骨幹 Restormer [23] 與 NAFNet [24]。NAFNet 有一個驚人的發現:常用的非線性激活函數(ReLU、GELU、Sigmoid)其實不是必要的,可以用兩半特徵的逐元素相乘(「SimpleGate」)取代,或直接移除,得到一個「無非線性激活」(nonlinear activation free)的網路,不但更簡單,在 GoPro 與 SIDD 上也更強。Zhang 等人的去模糊綜述 [69] 涵蓋了更廣的範圍(盲與非盲、影片、失焦、損失函數)。
影像修補(Inpainting,簡介)
白話版。 把缺失或破損的區域(刮痕、被移除的物體、破洞)補上合理的內容。
修補是最接近影像生成的復原任務:在大破洞裡沒有東西可以「還原」,只能創造出和周圍相符的內容。它的退化是一個遮罩,,其中 在破洞處為 0、其他地方為 1。前陣子相當知名的遮罩自編碼器(masked autoencoder, MAE)[45] 也可以歸類於此,可視為把修補當作預訓練任務:遮住 75% 的影像區塊,訓練 ViT 把它們重建回來,結果學到了很強的視覺表徵。實務上的修補方面,LaMa [46] 使用具備全影像感受野的快速傅立葉卷積,並以大型遮罩訓練,能在高解析度下填補大破洞;如今,以擴散模型為基礎的修補是大範圍、語意層級編輯的預設做法。
去背(Matting,簡介)
白話版。 把前景(一個人、他的頭髮)連同柔和、半透明的邊緣一起摳出來,好貼到新背景上。
去背假設每個像素是前景與背景的混合:
其中 是不透明度(alpha matte), 是前景顏色, 是背景顏色。每個像素有七個未知數( 與兩組 RGB 顏色),卻只有三個觀測值,嚴重不足,所以傳統方法要求使用者提供三色圖(trimap:確定前景、確定背景、不確定區域)。它也可以視為分割的一種軟性變形。Background Matting [47] 用一張不含主體的背景照片取代三色圖,先在合成影像上訓練網路,再以對抗損失(判斷新合成圖看起來是否自然)在真實影像上訓練。
通用骨幹網路
白話版。 在上述所有任務中,總是那幾種網路設計反覆勝出。它們是通用的「影像到影像引擎」,可以拿來訓練上面任何一種退化。
| 骨幹 | 核心想法 | 為什麼適合復原 |
|---|---|---|
| U-Net [48] | 編碼器–解碼器,每個尺度都有跳躍連接 | 降採樣路徑提供大感受野,跳躍連接保留細節 |
| SwinIR [14] | 在全解析度上堆疊位移視窗自注意力的殘差群組 | 權重隨內容自適應;SR、去雜訊、JPEG 表現強 |
| Restormer [23] | 由 Transformer 區塊組成的 U-Net;注意力在通道維度計算(轉置注意力),搭配門控前饋網路 | 成本與像素數呈線性,可擴展到大影像 |
| NAFNet [24] | 由簡單卷積區塊組成的 U-Net,使用 LayerNorm、SimpleGate 與簡化通道注意力;沒有非線性激活 | 每單位 FLOP 的準確度極高;預設的「簡單基準」 |
| MambaIR / MambaIRv2 [49], [50] | 選擇性狀態空間(Mamba)掃描,加上局部增強與通道注意力;v2 加入「注意力式」非因果掃描 | 以線性成本取得全域感受野 |
反覆出現的設計理由。(1)全域殘差:預測 (或 減去上採樣的 ),讓網路只學缺少的部分。(2)自 EDSR [10] 以來,大多數 SR/復原網路不用批次正規化:訓練小塊與完整測試影像的 BN 統計量不同,會損害色彩與數值範圍的保真度。(3)以可控成本取得大感受野:多尺度 U-Net、視窗或通道注意力、狀態空間掃描。復原既需要上下文(分辨紋理與雜訊),也需要全解析度的細節。(4)用注意力或門控做內容自適應處理:通道注意力(RCAN)、門控(NAFNet、Restormer)。原文的「Extension」清單預言了 ViT、Flow、GAN、Diffusion 等新架構;到了 2026 年,狀態空間模型也加入 CNN 與 Transformer,成為第三種骨幹選項 [49], [50]。
All-in-one 與通用復原
白話版。 不要為雨、霧、雜訊各訓練一個模型,而是訓練一個模型,讓它自己判斷影像哪裡出了問題,再把它修好。
動機
原文的「Extension」一節把 all-in-one 復原列為 2023 年最熱門的題目之一,大約從 2021 年開始。動機很實際:在實際部署的系統中,我們事先不知道某張影像有哪一種退化(或哪幾種混合),各種天氣也可能隨時出現或同時發生。一整組任務專屬模型需要前面再接一個可靠的分類器,還浪費記憶體;一個能自我調整的模型方便得多。困難在於任務干擾:不同退化需要不同、甚至相反的操作(去雜訊是平滑,去模糊是銳化),所以直接做多任務訓練的效果會輸給專用模型。
代表方法
- AirNet [51](CVPR 2022),也就是原文提到的 airnet:以對比學習訓練的退化編碼器,在沒有標籤的情況下擷取影像「如何」受損的表徵,再用它引導復原網路。它用單一模型處理未知類型的退化;它的雜訊+雨+霧設定後來成為標準的「三任務」基準。
- TransWeather [52](CVPR 2022):單一 Transformer 編碼器–解碼器處理雨、霧、雪,解碼器中有可學習的天氣類型查詢(weather-type query)。
- PromptIR [53](NeurIPS 2023):Restormer 風格的網路加上輕量的提示區塊(prompt block)。可學習的提示元件依照輸入特徵預測出的權重組合,注入解碼器,編碼退化相關的資訊。在去雜訊、除雨、除霧上測試。
- AdaIR [54](ICLR 2025):觀察到不同退化影響的是不同的頻帶,於是從輸入中挖掘低頻與高頻特徵並自適應地調變。涵蓋五種退化:雜訊、霧、雨、動態模糊與低光。
- DA-CLIP [55](ICLR 2024):以一個訓練好的控制器調整視覺語言模型 CLIP,讓它的影像編碼器能從受損影像同時產生乾淨內容的嵌入與退化的嵌入,再透過交叉注意力引導復原網路。
- InstructIR [56](ECCV 2024):使用者寫一句自然語言指令(「把雨去掉」、「調亮一點」),文字編碼器把它轉成嵌入,再用這個嵌入調變復原網路。
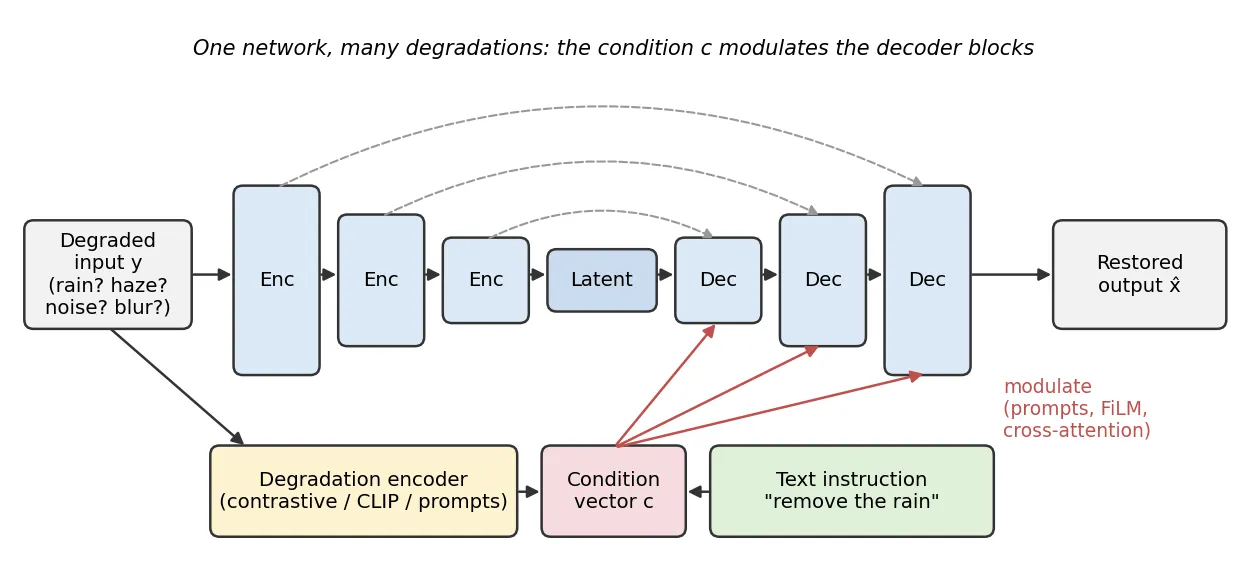
原文的動機仍是核心;改變的是「由誰決定退化類型」。它從固定的任務標籤,轉移到學習出的提示、視覺語言嵌入,最後到人類的指令,背後往往有大型預訓練模型支撐。All-in-one 綜述 [72] 對此有詳細討論。
損失函數
白話版。 損失函數決定了什麼叫「好」。像素損失獎勵平均而言接近真實;感知與對抗損失獎勵看起來真實;頻率損失獎勵把細節做對。
像素損失。 令 ,
其中 是像素值的總數, 是一個小常數,讓最後一個成為平滑、可微分的 L1 版本。L2 直接最佳化 PSNR,但對大誤差懲罰很重,而且會收斂到後驗平均。Zhao 等人 [57] 證明在架構固定的情況下,光是換損失函數就能明顯改變結果,而且 L1 與受感知啟發的損失(包括和 SSIM 的組合)常常勝過 L2,甚至在與 L2 相關的指標上也是。L1 是現代大多數 SR 與復原論文的預設選擇。
感知(特徵)損失。 在預訓練分類網路 (通常是 VGG)的特徵空間中比較影像 [58]:
其中 是第 層的特徵圖,有 個通道、尺寸為 。它能容忍小的位移,獎勵的是邊緣與紋理吻合,而不是數值完全相同。
對抗損失。 判別器 學習分辨復原影像與真實影像,復原網路則學著騙過它,例如 。這會把輸出推向自然影像的流形上(SRGAN [12]、ESRGAN [13]、Real-ESRGAN [4]),代價是可能出現憑空捏造的紋理。實務上以 GAN 為基礎的復原網路會使用加權和,例如 ,權重為 。
頻率損失。 網路傾向先擬合低頻,對細節擬合不足。在傅立葉轉換 上加一項損失,例如對複數值或振幅計算 ,就能直接懲罰缺少的高頻。焦點頻率損失(focal frequency loss)[59] 更進一步,自適應地加重目前最難重建的頻率成分。頻率項現在在去模糊與 all-in-one 模型中很常見。
評估指標
白話版。 「復原結果是否接近真實?」與「它看起來像不像真的照片?」是兩個不同的問題,由不同的指標回答,而且你無法同時把兩者做到最好。
全參考指標
PSNR(峰值訊雜比):
其中 是像素可能的最大值(1 或 255), 是均方誤差。單位是 dB;提升 1 dB 約等於 MSE 降低 21%。
SSIM(結構相似度)[60] 比較局部平均、變異數與共變異數:
在兩張影像的局部視窗 、 上計算再取平均,其中 是局部平均, 是局部變異數, 是局部共變異數, 是維持數值穩定的小常數。它和人眼感受到的結構相關性比 PSNR 好,但仍然偏好平滑的結果。
LPIPS [61] 衡量深度網路特徵之間的距離(依人類相似度判斷校準)。越低越好,它會獎勵 PSNR 所懲罰的逼真紋理。
import numpy as np
from scipy import ndimage as ndi
from skimage import data, img_as_float32
from skimage.metrics import peak_signal_noise_ratio, structural_similarity

x = img_as_float32(data.camera())
y = np.clip(x + np.random.default_rng(0).normal(0, 0.1, x.shape), 0, 1).astype(np.float32)
x_hat = ndi.gaussian_filter(y, 1.0)

def psnr(ref, est, peak=1.0):
    mse = np.mean((ref.astype(np.float64) - est) ** 2)
    return 10 * np.log10(peak ** 2 / mse)

print(f"PSNR  ours {psnr(x, x_hat):.2f} dB | skimage {peak_signal_noise_ratio(x, x_hat, data_range=1):.2f} dB")
print(f"SSIM  {structural_similarity(x, x_hat, data_range=1):.3f}")
# PSNR  ours 27.20 dB | skimage 27.20 dB
# SSIM  0.639
一定要寫清楚計算慣例(RGB 或 Y 通道、邊界裁切、數值範圍、是否先四捨五入成 8 位元):光是這些差異,就足以讓論文中的 PSNR 相差零點幾 dB。
無參考指標
沒有真實參考影像時(真實照片),只能用無參考品質指標。NIQE [62] 用多變量高斯分布擬合原始自然影像的自然場景統計,再量測測試影像的統計量離它多遠(越低越好,不需要用人類評分訓練)。PIRM 2018 挑戰賽的感知指數(Perceptual Index, PI)[63] 把 NIQE 與另一個學習式無參考分數合成一個數字。FID [64] 比較一組輸出與一組真實影像在 Inception 特徵上的分布;它原本是為生成模型設計的,現在用於擴散 SR 這類生成式復原。原文也提到的 IS(Inception Score)衡量類別預測的信心與多樣性,比較適合條件式生成而非復原,如今在復原任務中很少使用。
感知–失真權衡
Blau 與 Michaeli [65] 把這個矛盾形式化。令 為任意失真度量(MSE、 SSIM……), 為真實影像分布與復原影像分布之間的散度(感知品質: 越小,輸出在統計上越無法與真實影像區分)。感知–失真函數定義為
其中最小值取遍所有(可能帶隨機性的)復原方法。他們證明 是非遞增的,而且(當散度對第二個引數為凸時)是凸函數:原點附近有一塊無法達到的區域。一個方法不可能同時擁有最小失真與完美的真實感。特別是 MMSE 估計 的失真最低,但輸出分布模糊、不真實;想看起來真實,就必須接受較高的 MSE。GAN(以及現在的擴散模型)是沿著這條邊界移動的原則性方法。
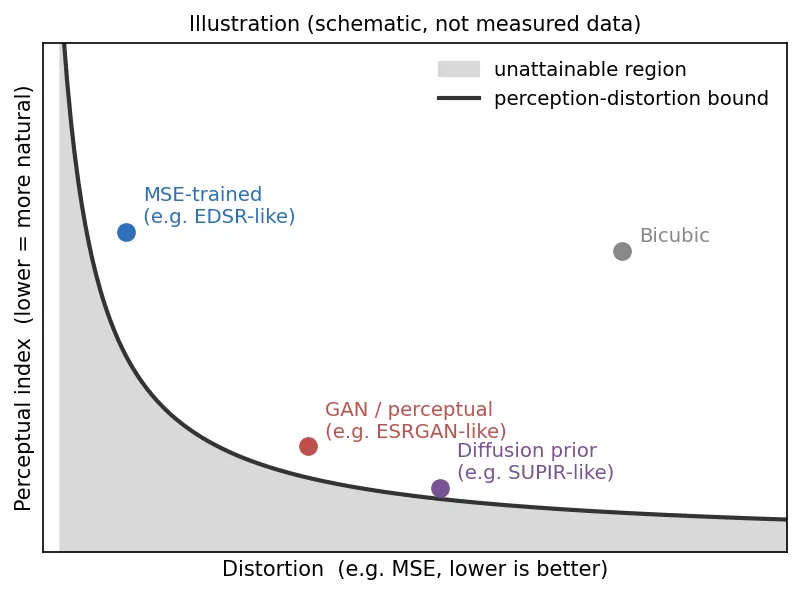
這正是原文評估指標一節的更新:擴散模型能「生成」看似合理但不一定忠於原圖的細節,保真度(PSNR/SSIM)與感知品質之間的落差因此更受重視。NTIRE 2025 SR 挑戰賽就分成兩個賽道:以 PSNR 排名的 restoration track,以及以感知分數排名的 perceptual track [3];2024 年的版本則以 PSNR 排名 [2]。實務建議:同時報告一個失真指標與一個感知指標,並說明你的方法瞄準權衡曲線上的哪個位置。
NTIRE 挑戰賽
白話版。 每年 CVPR 的一個 workshop 會在固定資料集上舉辦公開競賽,並發表報告說明勝出的想法:這是了解「現在什麼有用」最簡單的方式。
既然依任務分類的排行榜已經消失,NTIRE 挑戰賽報告就是追蹤復原領域的好管道。每份報告都會說明任務、資料、評估方式,以及名列前茅隊伍的方法。本篇引用的例子:
- NTIRE 2017 SR [19]:推出 DIV2K;EDSR [10] 奪冠。
- NTIRE 2024 SR [2]:在 DIV2K 上做雙三次 ,以 PSNR 排名。
- NTIRE 2025 SR [3]:restoration(PSNR)與 perceptual 兩個賽道分開評比。
- NTIRE 2025 雨滴去除 [40]:真實的白天與夜晚雨滴影像,並有雙重對焦設定。
近年的報告有兩個共同模式:勝出的作品通常是上述骨幹(HAT、Restormer、NAFNet 或 Mamba 風格,有時再加上擴散先驗)的集成或大型混合模型,並使用大量資料與算力訓練;而挑戰賽也越來越常使用真實拍攝的資料與感知賽道。
現代觀點
原文最後列出了延伸方向(醫學影像、多模態、非監督、新架構、all-in-one、低階結合高階、即時與低運算、水下)。其中大多數現在都是活躍的研究領域。以下依任務整理綜述文獻,再談 2023–2026 年的最新進展與尚未解決的問題。
綜述論文
- Wang、Chen 與 Hoi,〈Deep Learning for Image Super-resolution: A Survey〉(TPAMI 2021) [66]。把 SR 分成監督式、非監督式與特定領域 SR;在監督式 SR 中,再依上採樣位置(前、後、漸進、迭代上下採樣)、上採樣運算(插值、轉置卷積、子像素)、網路設計(殘差、遞迴、密集、注意力、多路徑)、損失函數與訓練策略來拆解模型。重點:大部分 SR 的進展都能描述成在這些軸上的選擇,而非監督/真實世界 SR 被點名為主要的開放方向,領域後來也確實往這裡走。
- Tian 等人,〈Deep Learning on Image Denoising: An Overview〉(Neural Networks 2020) [67]。把 CNN 去雜訊方法分成加性白雜訊、真實雜訊、盲去雜訊,以及混合了模糊或低解析度的雜訊四類,並在公開基準上比較。重點:瓶頸往往是雜訊模型的真實程度,而不是網路。
- Elad、Kawar 與 Vaksman,〈Image Denoising: The Deep Learning Revolution and Beyond〉(SIAM J. Imaging Sciences 2023) [68]。回顧去雜訊從傳統先驗到深度網路的歷史,接著主張去雜訊器如今是其他反問題(plug-and-play、regularization by denoising)以及擴散式影像生成的基本元件,並主張復原應該接受多個合理解(後驗取樣),而不是只給一個答案。重點:前沿已經從「更好的 MMSE 去雜訊器」移到「從後驗分布取樣」。
- Zhang 等人,〈Deep Image Deblurring: A Survey〉(IJCV 2022) [69]。涵蓋模糊成因、資料集與指標,以及依架構、損失函數與應用(人臉、文字、立體)分類的 CNN 去模糊方法,包含盲與非盲設定。重點:動態場景去模糊已從估計模糊核,轉向以 GoPro 這類實拍配對訓練的端到端多尺度網路。
- Gui 等人,〈A Comprehensive Survey and Taxonomy on Single Image Dehazing Based on Deep Learning〉(ACM Computing Surveys 2023) [70]。把方法分成監督式、半監督式與非監督式,並在各類中依是否及如何使用散射模型細分;也整理資料集、網路模組、損失函數與指標,並實驗比較基準方法。重點:物理引導與無物理的設計並存,合成到真實的落差是主要未解問題。
- Yang 等人,〈Single Image Deraining: From Model-Based to Data-Driven and Beyond〉(TPAMI 2021) [71]。回顧雨的外觀模型、以模型為基礎的方法(先驗與最佳化),以及資料驅動的方法(架構、限制條件、損失函數、資料集)。重點:真實的雨模型與真實世界的評估,比在合成資料上繼續微調架構更重要。
- Jiang 等人,〈A Survey on All-in-One Image Restoration: Taxonomy, Evaluation and Future Trends〉(TPAMI 2025) [72]。依架構設計、學習範式與核心創新(退化表徵、提示、混合專家、語言引導)整理 all-in-one 方法,並彙整資料集與評估協定。重點:各論文的任務組合不一致,讓比較變得困難;對未見過與混合退化的泛化仍是開放問題。
- Li 等人,〈Diffusion Models for Image Restoration and Enhancement: A Comprehensive Survey〉(IJCV 2025) [73]。依學習範式(監督式 vs. 零樣本使用預訓練先驗)、條件策略、框架設計與建模策略分類以擴散模型為基礎的復原,聚焦於 SR、去模糊、修補與盲/真實世界復原。重點:擴散模型的感知品質最好,但運算成本高,也有保真度與捏造細節的疑慮;蒸餾成少步驟與更好的評估方式是關鍵方向。
2023–2026 年的最新進展
- All-in-one 與盲復原成為主流設定,不再是小眾題目。方法從學習式退化表徵(AirNet)發展到提示(PromptIR)、頻率感知的自適應(AdaIR)與語言引導(DA-CLIP、InstructIR)。
- 以預訓練擴散模型作為生成先驗,大幅改變了真實世界 SR 與盲復原(DiffBIR、SUPIR),一步式變體(OSEDiff)則把推論成本從數十、數百步降到一步。
- 狀態空間模型(MambaIR、MambaIRv2)加入 CNN 與 Transformer,成為以線性成本取得全域感受野的骨幹選項。
- 評估方式跟上了生成能力:挑戰賽把保真度賽道與感知賽道分開 [3],真實拍攝的資料集(SIDD、O-HAZE、Dense-Haze、Raindrop Clarity)也和合成基準一起成為標準。
尚未解決的問題
- 真實世界的泛化。 合成流程仍然漏掉真實相機的影像處理、隨位置變化的模糊與混合天氣;模型遇到沒見過的組合時表現會下滑。
- 保真度 vs. 捏造。 生成先驗可能憑空創造文字、人臉或紋理。在醫學、鑑識與科學用途中這是不能接受的,而我們還缺少衡量「忠實又清晰」的好指標。
- 評估。 PSNR/SSIM 獎勵模糊;無參考指標可以被刻意迎合;人類評測成本高。對生成式復原而言,指標與人類偏好的一致性仍然很弱。
- 效率。 在手機與相機上做高解析度、即時(以及影片)復原仍是很強的限制,對 Transformer 與擴散模型尤其如此。
- All-in-one 模型的任務干擾與擴展,以及如何在不重新訓練的情況下加入新的退化。
- 低階結合高階。 讓復原幫助下游偵測或分割,而不是給人看,是另一種目標(任務導向評估,例如 RESIDE [32])。
作者的觀點
原文以兩個至今仍成立的觀察作結。第一,由於每個任務都簡單明瞭,現階段 SOTA 的比拼大多靠特殊的架構取勝,也就代表大量的算力與複雜的實驗設計;但這些任務在應用上都相當實用且容易上手,所以在應用面與任務的組合上還有很多著墨空間(all-in-one 復原正是往這裡發展)。第二,相較於高階任務,這個領域的學習成本不高:入門時很容易想像模型的架構與樣貌(受損的影像進去、更乾淨的影像出來),進而接觸更進一步的內容,是進入深度學習研究的好入口。
重點整理
- 低階視覺關注的是把像素感知好;幾乎每個任務都是 的一個特例,差別只在 (模糊、降採樣、JPEG、散射、雨層、Retinex 光照、遮罩)。
- 深度學習把退化模型從求解器搬進了資料產生器:真實、隨機化的合成流程(以及實拍配對)和網路一樣重要。
- SR 的上採樣方式從雙三次先放大(SRCNN),經過轉置卷積(FSRCNN),演進到今天標準的子像素卷積(ESPCN)。
- 少數幾種通用骨幹主導了這個領域:U-Net 風格的 CNN(NAFNet)、Transformer(SwinIR、Restormer、HAT)與狀態空間模型(MambaIR);常見的設計習慣是全域殘差、不用 BN、大感受野,以及門控/注意力。
- All-in-one 模型(AirNet、TransWeather、PromptIR、AdaIR、DA-CLIP、InstructIR)透過以學習、提示或文字給定的退化描述作為條件,讓一個網路處理未知的退化。
- L2/L1 損失得到忠實但平滑的結果;感知、對抗與擴散式方法得到真實但較不忠實的結果。感知–失真權衡告訴我們在極限上兩者不可兼得,所以兩類指標都要報告。
- KITTI 是自駕車基準,不是除霧資料集;除霧請用 RESIDE,並搭配 O-HAZE、Dense-Haze 這類真實配對。
練習
- 退化的順序。 用
degrade函式,在相同參數下比較 (a) 模糊 → 降採樣 → 雜訊 → JPEG 與 (b) 雜訊 → 模糊 → 降採樣 → JPEG。從視覺上,以及在平坦區塊量測雜訊標準差,說明為什麼順序會影響網路要學的東西。
提示
在 (b) 中,模糊與降採樣會過濾雜訊:標準差變小,而且在空間上變得相關(變成平滑的斑塊,而不是逐像素的顆粒)。在 (a) 中,雜訊在低解析度下仍然是白雜訊。只用 (a) 訓練的網路,測試時遇到相關雜訊會去除不足。這也是 Real-ESRGAN 隨機化並重複各個階段的原因之一。
- 手算 pixel shuffle。 一個特徵張量的形狀為 ,、,第 個通道全部填入常數 。用 SR 一節的公式寫出 pixel shuffle 的 輸出,再用
torch.nn.PixelShuffle(2)驗證。
提示
輸出像素 取自通道 。所以每個 區塊都是 , 的輸出就是把這個區塊重複四次。每個輸出區塊都從同一個低解析度位置上的四個通道各取一個值。
- 殘差還是直接預測? 把
TinyDnCNN.forward改成回傳self.body(y)(直接預測乾淨影像),以相同的隨機種子與步數訓練兩個版本,比較 PSNR 與損失曲線。再用 重做一次。殘差學習在什麼情況下幫助最大?
提示
在訓練步數很少時,殘差版本通常收斂更快、PSNR 更高,因為它在初始化時就已經大約輸出 (PSNR 不差),只需要學一個小修正。低雜訊時直接預測的版本最吃力,因為它必須透過好幾層 ReLU 學出一個近乎恆等的映射。
- 用數字算暗通道。 某個有霧像素 ,其區塊內所有通道 的最小值為 ,。取 、,計算這個像素的 與還原後的 。
提示
。接著 ,約為 。輸出比輸入更暗、飽和度更高,這正是去掉霧的面紗後該有的樣子。
- 感知 vs. 失真。 把小型去雜訊網路的輸出再加上少量新的高斯雜訊(),計算加入前後的 PSNR 與 SSIM。雖然兩個指標都下降了,影像看起來卻可能更自然(比較不像塑膠)。把這個現象和感知–失真函數 連結起來。
提示
近似 MMSE 的輸出位於低失真的位置,但離自然影像分布很遠(太平滑)。加入顆粒會讓輸出分布更接近真實照片( 變小),代價是 MSE 變高:這是沿著(或朝向)凸邊界的移動,而不是越過它。
- 設計一個 all-in-one 實驗。 你要為雜訊()、雨線與霧建立單一模型。說明訓練資料的混合方式、如何為網路提供條件(測試時沒有標籤)、要和哪些基準比較,以及如何偵測任務干擾。
提示
每個任務各自取資料集並平衡取樣;加入一個與網路一起訓練的退化編碼器(如 AirNet 的對比學習,或 PromptIR 的提示)。與三個使用相同骨幹、相同大小的單任務模型比較,也和不加條件的版本比較。任務干擾的跡象是:all-in-one 模型在某個任務上落後單任務模型,在其他任務上卻打平;另外也要在訓練時沒見過的混合退化(雨+霧)上測試。
參考文獻
- Shyandram, “Low-Level Vision Task-Image Restoration簡介,” blog post, 2023; updated 2026. link
- Z. Chen, Z. Wu, E. Zamfir, K. Zhang, Y. Zhang, R. Timofte et al., “NTIRE 2024 Challenge on Image Super-Resolution (×4): Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2024. arXiv
- Z. Chen, K. Liu, J. Gong, J. Wang, L. Sun et al., “NTIRE 2025 Challenge on Image Super-Resolution (×4): Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2025. arXiv
- X. Wang, L. Xie, C. Dong and Y. Shan, “Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data,” in Proc. IEEE/CVF ICCV Workshops, 2021. arXiv
- E. H. Land and J. J. McCann, “Lightness and Retinex Theory,” Journal of the Optical Society of America, vol. 61, no. 1, pp. 1–11, 1971. doi
- C. Dong, C. C. Loy, K. He and X. Tang, “Image Super-Resolution Using Deep Convolutional Networks,” IEEE TPAMI, 2016 (conference version ECCV 2014). arXiv
- C. Dong, C. C. Loy and X. Tang, “Accelerating the Super-Resolution Convolutional Neural Network,” in Proc. ECCV, 2016. arXiv
- W. Shi, J. Caballero, F. Huszár, J. Totz, A. P. Aitken, R. Bishop, D. Rueckert and Z. Wang, “Real-Time Single Image and Video Super-Resolution Using an Efficient Sub-Pixel Convolutional Neural Network,” in Proc. IEEE CVPR, 2016. arXiv
- A. Odena, V. Dumoulin and C. Olah, “Deconvolution and Checkerboard Artifacts,” Distill, 2016. link
- B. Lim, S. Son, H. Kim, S. Nah and K. M. Lee, “Enhanced Deep Residual Networks for Single Image Super-Resolution,” in Proc. IEEE CVPR Workshops, 2017. arXiv
- Y. Zhang, K. Li, K. Li, L. Wang, B. Zhong and Y. Fu, “Image Super-Resolution Using Very Deep Residual Channel Attention Networks,” in Proc. ECCV, 2018. arXiv
- C. Ledig, L. Theis, F. Huszár, J. Caballero, A. Cunningham, A. Acosta, A. Aitken, A. Tejani, J. Totz, Z. Wang and W. Shi, “Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network,” in Proc. IEEE CVPR, 2017. arXiv
- X. Wang, K. Yu, S. Wu, J. Gu, Y. Liu, C. Dong, C. C. Loy, Y. Qiao and X. Tang, “ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks,” in Proc. ECCV Workshops, 2018. arXiv
- J. Liang, J. Cao, G. Sun, K. Zhang, L. Van Gool and R. Timofte, “SwinIR: Image Restoration Using Swin Transformer,” in Proc. IEEE/CVF ICCV Workshops, 2021. arXiv
- X. Chen, X. Wang, J. Zhou, Y. Qiao and C. Dong, “Activating More Pixels in Image Super-Resolution Transformer,” in Proc. IEEE/CVF CVPR, 2023. arXiv
- X. Lin, J. He, Z. Chen, Z. Lyu, B. Dai, F. Yu, W. Ouyang, Y. Qiao and C. Dong, “DiffBIR: Towards Blind Image Restoration with Generative Diffusion Prior,” arXiv:2308.15070, 2023. arXiv
- F. Yu, J. Gu, Z. Li, J. Hu, X. Kong, X. Wang, J. He, Y. Qiao and C. Dong, “Scaling Up to Excellence: Practicing Model Scaling for Photo-Realistic Image Restoration In the Wild,” in Proc. IEEE/CVF CVPR, 2024. arXiv
- R. Wu, L. Sun, Z. Ma and L. Zhang, “One-Step Effective Diffusion Network for Real-World Image Super-Resolution,” in Proc. NeurIPS, 2024. arXiv
- E. Agustsson and R. Timofte, “NTIRE 2017 Challenge on Single Image Super-Resolution: Dataset and Study,” in Proc. IEEE CVPR Workshops, 2017. doi
- K. Zhang, W. Zuo, Y. Chen, D. Meng and L. Zhang, “Beyond a Gaussian Denoiser: Residual Learning of Deep CNN for Image Denoising,” IEEE Transactions on Image Processing, vol. 26, no. 7, pp. 3142–3155, 2017. arXiv
- K. Zhang, W. Zuo and L. Zhang, “FFDNet: Toward a Fast and Flexible Solution for CNN-Based Image Denoising,” IEEE Transactions on Image Processing, 2018. arXiv
- A. Abdelhamed, S. Lin and M. S. Brown, “A High-Quality Denoising Dataset for Smartphone Cameras,” in Proc. IEEE/CVF CVPR, 2018. doi
- S. W. Zamir, A. Arora, S. Khan, M. Hayat, F. S. Khan and M.-H. Yang, “Restormer: Efficient Transformer for High-Resolution Image Restoration,” in Proc. IEEE/CVF CVPR, 2022. arXiv
- L. Chen, X. Chu, X. Zhang and J. Sun, “Simple Baselines for Image Restoration,” in Proc. ECCV, 2022. arXiv
- K. He, J. Sun and X. Tang, “Single Image Haze Removal Using Dark Channel Prior,” in Proc. IEEE CVPR, 2009. doi
- B. Cai, X. Xu, K. Jia, C. Qing and D. Tao, “DehazeNet: An End-to-End System for Single Image Haze Removal,” IEEE Transactions on Image Processing, 2016. arXiv
- B. Li, X. Peng, Z. Wang, J. Xu and D. Feng, “AOD-Net: All-in-One Dehazing Network,” in Proc. IEEE ICCV, 2017. doi · arXiv
- X. Liu, Y. Ma, Z. Shi and J. Chen, “GridDehazeNet: Attention-Based Multi-Scale Network for Image Dehazing,” in Proc. IEEE/CVF ICCV, 2019. arXiv
- X. Qin, Z. Wang, Y. Bai, X. Xie and H. Jia, “FFA-Net: Feature Fusion Attention Network for Single Image Dehazing,” in Proc. AAAI, 2020. arXiv
- S. W. Zamir, A. Arora, S. Khan, M. Hayat, F. S. Khan, M.-H. Yang and L. Shao, “Learning Enriched Features for Real Image Restoration and Enhancement,” in Proc. ECCV, 2020. arXiv
- Y. Song, Z. He, H. Qian and X. Du, “Vision Transformers for Single Image Dehazing,” IEEE Transactions on Image Processing, vol. 32, 2023. arXiv
- B. Li, W. Ren, D. Fu, D. Tao, D. Feng, W. Zeng and Z. Wang, “Benchmarking Single-Image Dehazing and Beyond,” IEEE Transactions on Image Processing, 2019. arXiv
- C. O. Ancuti, C. Ancuti, R. Timofte and C. De Vleeschouwer, “O-HAZE: A Dehazing Benchmark with Real Hazy and Haze-Free Outdoor Images,” in Proc. IEEE/CVF CVPR Workshops, 2018. doi
- C. O. Ancuti, C. Ancuti, M. Sbert and R. Timofte, “Dense-Haze: A Benchmark for Image Dehazing with Dense-Haze and Haze-Free Images,” in Proc. IEEE ICIP, 2019. doi
- A. Geiger, P. Lenz and R. Urtasun, “Are We Ready for Autonomous Driving? The KITTI Vision Benchmark Suite,” in Proc. IEEE CVPR, 2012. project page
- Y.-F. Liu, D.-W. Jaw, S.-C. Huang and J.-N. Hwang, “DesnowNet: Context-Aware Deep Network for Snow Removal,” IEEE Transactions on Image Processing, 2018. arXiv
- W.-T. Chen, H.-Y. Fang, J.-J. Ding, C.-C. Tsai and S.-Y. Kuo, “JSTASR: Joint Size and Transparency-Aware Snow Removal Algorithm Based on Modified Partial Convolution and Veiling Effect Removal,” in Proc. ECCV, 2020. doi
- W. Yang, R. T. Tan, J. Feng, J. Liu, Z. Guo and S. Yan, “Deep Joint Rain Detection and Removal from a Single Image,” in Proc. IEEE CVPR, 2017. arXiv
- R. Qian, R. T. Tan, W. Yang, J. Su and J. Liu, “Attentive Generative Adversarial Network for Raindrop Removal from a Single Image,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- X. Li, Y. Jin, X. Jin, Z. Wu, B. Li, Y. Wang et al., “NTIRE 2025 Challenge on Day and Night Raindrop Removal for Dual-Focused Images: Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2025. arXiv
- C. Wei, W. Wang, W. Yang and J. Liu, “Deep Retinex Decomposition for Low-Light Enhancement,” in Proc. BMVC, 2018. arXiv
- Y. Cai, H. Bian, J. Lin, H. Wang, R. Timofte and Y. Zhang, “Retinexformer: One-stage Retinex-based Transformer for Low-light Image Enhancement,” in Proc. IEEE/CVF ICCV, 2023. arXiv
- H. Zhang, H. Xu, X. Tian, J. Jiang and J. Ma, “Image Fusion Meets Deep Learning: A Survey and Perspective,” Information Fusion, vol. 76, pp. 323–336, 2021. doi
- S. Nah, T. H. Kim and K. M. Lee, “Deep Multi-scale Convolutional Neural Network for Dynamic Scene Deblurring,” in Proc. IEEE CVPR, 2017. doi · arXiv
- K. He, X. Chen, S. Xie, Y. Li, P. Dollár and R. Girshick, “Masked Autoencoders Are Scalable Vision Learners,” in Proc. IEEE/CVF CVPR, 2022. arXiv
- R. Suvorov, E. Logacheva, A. Mashikhin, A. Remizova, A. Ashukha, A. Silvestrov, N. Kong, H. Goka, K. Park and V. Lempitsky, “Resolution-robust Large Mask Inpainting with Fourier Convolutions,” in Proc. IEEE/CVF WACV, 2022. arXiv
- S. Sengupta, V. Jayaram, B. Curless, S. Seitz and I. Kemelmacher-Shlizerman, “Background Matting: The World is Your Green Screen,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” in Proc. MICCAI, 2015. arXiv
- H. Guo, J. Li, T. Dai, Z. Ouyang, X. Ren and S.-T. Xia, “MambaIR: A Simple Baseline for Image Restoration with State-Space Model,” in Proc. ECCV, 2024. arXiv
- H. Guo, Y. Guo, Y. Zha, Y. Zhang, W. Li, T. Dai, S.-T. Xia and Y. Li, “MambaIRv2: Attentive State Space Restoration,” in Proc. IEEE/CVF CVPR, 2025. arXiv
- B. Li, X. Liu, P. Hu, Z. Wu, J. Lv and X. Peng, “All-In-One Image Restoration for Unknown Corruption,” in Proc. IEEE/CVF CVPR, 2022. code & paper
- J. M. J. Valanarasu, R. Yasarla and V. M. Patel, “TransWeather: Transformer-based Restoration of Images Degraded by Adverse Weather Conditions,” in Proc. IEEE/CVF CVPR, 2022. arXiv
- V. Potlapalli, S. W. Zamir, S. Khan and F. S. Khan, “PromptIR: Prompting for All-in-One Image Restoration,” in Proc. NeurIPS, 2023. arXiv
- Y. Cui, S. W. Zamir, S. Khan, A. Knoll, M. Shah and F. S. Khan, “AdaIR: Adaptive All-in-One Image Restoration via Frequency Mining and Modulation,” in Proc. ICLR, 2025. arXiv
- Z. Luo, F. K. Gustafsson, Z. Zhao, J. Sjölund and T. B. Schön, “Controlling Vision-Language Models for Multi-Task Image Restoration,” in Proc. ICLR, 2024. arXiv
- M. V. Conde, G. Geigle and R. Timofte, “InstructIR: High-Quality Image Restoration Following Human Instructions,” in Proc. ECCV, 2024. arXiv
- H. Zhao, O. Gallo, I. Frosio and J. Kautz, “Loss Functions for Image Restoration with Neural Networks,” IEEE Transactions on Computational Imaging, 2017 (arXiv title: “Loss Functions for Neural Networks for Image Processing”). arXiv
- J. Johnson, A. Alahi and L. Fei-Fei, “Perceptual Losses for Real-Time Style Transfer and Super-Resolution,” in Proc. ECCV, 2016. doi · arXiv
- L. Jiang, B. Dai, W. Wu and C. C. Loy, “Focal Frequency Loss for Image Reconstruction and Synthesis,” in Proc. IEEE/CVF ICCV, 2021. arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image Quality Assessment: From Error Visibility to Structural Similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- A. Mittal, R. Soundararajan and A. C. Bovik, “Making a ‘Completely Blind’ Image Quality Analyzer,” IEEE Signal Processing Letters, 2013. doi
- Y. Blau, R. Mechrez, R. Timofte, T. Michaeli and L. Zelnik-Manor, “The 2018 PIRM Challenge on Perceptual Image Super-resolution,” in Proc. ECCV Workshops, 2018. arXiv
- M. Heusel, H. Ramsauer, T. Unterthiner, B. Nessler and S. Hochreiter, “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” in Proc. NeurIPS, 2017. arXiv
- Y. Blau and T. Michaeli, “The Perception-Distortion Tradeoff,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- Z. Wang, J. Chen and S. C. H. Hoi, “Deep Learning for Image Super-Resolution: A Survey,” IEEE TPAMI, 2021. arXiv
- C. Tian, L. Fei, W. Zheng, Y. Xu, W. Zuo and C.-W. Lin, “Deep Learning on Image Denoising: An Overview,” Neural Networks, vol. 131, pp. 251–275, 2020. arXiv
- M. Elad, B. Kawar and G. Vaksman, “Image Denoising: The Deep Learning Revolution and Beyond — A Survey Paper,” SIAM Journal on Imaging Sciences, vol. 16, no. 3, pp. 1594–1654, 2023. doi · arXiv
- K. Zhang, W. Ren, W. Luo, W.-S. Lai, B. Stenger, M.-H. Yang and H. Li, “Deep Image Deblurring: A Survey,” International Journal of Computer Vision, 2022. arXiv
- J. Gui, X. Cong, Y. Cao, W. Ren, J. Zhang, J. Zhang, J. Cao and D. Tao, “A Comprehensive Survey and Taxonomy on Single Image Dehazing Based on Deep Learning,” ACM Computing Surveys, 2023. doi · arXiv
- W. Yang, R. T. Tan, S. Wang, Y. Fang and J. Liu, “Single Image Deraining: From Model-Based to Data-Driven and Beyond,” IEEE TPAMI, 2021. doi · arXiv
- J. Jiang, Z. Zuo, G. Wu, K. Jiang and X. Liu, “A Survey on All-in-One Image Restoration: Taxonomy, Evaluation and Future Trends,” IEEE TPAMI, 2025. arXiv
- X. Li, Y. Ren, X. Jin, C. Lan, X. Wang, W. Zeng, X. Wang and Z. Chen, “Diffusion Models for Image Restoration and Enhancement: A Comprehensive Survey,” International Journal of Computer Vision, 2025. arXiv