DL 05・低光影像增強
先備知識: DL 04・深度影像復原:低階視覺, 第 3 章・強度轉換與空間濾波, 第 6 章・色彩影像處理
你將學到
- 為什麼低光影像增強(low-light image enhancement, LLIE)其實是兩個問題的合體:色調強化與細節(含雜訊)還原,以及為什麼「直接調亮」行不通。
- 傳統工具箱如何運作:HSV、HSI、YCbCr、Lab 中的亮度通道;直方圖等化與 CLAHE;gamma 曲線;Retinex(SSR、MSR、LIME);以及「反轉後去霧」的技巧。
- 深度 LLIE 方法如何依訓練訊號分類(監督式、展開式、非配對、零參考、生成式),並推導 Retinex-Net 分解損失函數與 Zero-DCE 曲線的數學。
- 如何誠實地評估增強結果:全參考與無參考指標、GT-mean 陷阱,以及以任務為導向的評估。
- 常用資料集與挑戰賽(LOL、LOL-v2、LSRW、SDSD、SID、FiveK、ExDark、NTIRE 2024/2025)各自用來做什麼,以及還有哪些問題沒解決。
先看全貌
在暗處拍到的照片,並不只是「把亮度調低的正常照片」。感測器收到的光子非常少,所以影像又暗、又有雜訊,還常常帶著色偏。低光影像增強的目標,是產生「如果當時光線充足,你會拍到的那張照片」:曝光正確、顏色自然、細節乾淨,而且不引入新的假影。
為什麼重要:手機每天都在暗處拍照,車輛與機器人必須在夜間看得見,監視系統、科學影像與醫療內視鏡也都在跟同樣的物理限制奮戰。低光也會傷害下游模型:用白天照片訓練的偵測器,到了晚上準確率會下降。因此 LLIE 既是畫質問題,也是電腦視覺的強健性問題。
目的與難點
白話版。 我們想把一張暗的影像對應成一張曝光正常的影像。難的地方在於「變亮」和「修復」是兩件不同的工作:變亮改變的是色調(每個區域多亮多暗),修復則是找回被黑暗與雜訊破壞的細節與乾淨的顏色。
精確版。 LLIE 和影像轉換(image-to-image translation)不同:後者會改變影像的屬性(夏天變冬天、照片變畫作),LLIE 則應該完整保留場景與內容,只把光線不足造成的破壞還原。原文 [1] 把這些破壞分成兩個難點:
- 色調強化。 在全域與局部提高曝光,同時不壓垮亮部、也不把對比壓平。燈具這類亮區必須維持明亮,暗區要被打開,而且區域之間的明暗順序應該保留。
- 細節還原。 找回埋在雜訊與量化誤差裡的紋理與顏色,同時抑制雜訊而不是放大它。
在深度學習裡,只要網路被訓練成輸出乾淨的影像,細節還原本來就是它在做的事,因此多數方法的設計重點放在色調(要把哪些影像性質或物理模型放進網路)與學習機制(用什麼監督方式與損失函數),而不是另外設計一個專門的細節模組。
為什麼不是單純調亮
線性增益 ()會在四個地方失敗,全都可以在圖 1 看到:
- 雜訊。 光子到達是隨機的。光子很少時,訊噪比很低,而增益會把訊號和雜訊一起放大。影像變亮了,卻沒有變乾淨。
- 色偏。 低光環境的光常帶有顏色(鎢絲燈、鈉燈路燈),相機的白平衡與三個色彩通道的雜訊程度也不同。三通道等比例放大會保留色偏;分別放大又可能產生奇怪的顏色。
- 飽和與過曝。 已經接近上限的像素(燈、窗戶、螢幕)會在 1 被截斷。大到足以照亮暗部的全域增益,會毀掉亮部。
- 量化。 一張暗的 8 位元影像可能只用到 20 到 40 個灰階。把它們拉開,就會出現明顯的色階斷層(banding)。
低光拍攝的模型
明確寫出退化模型很有幫助,一方面便於理解,另一方面可用來合成訓練資料。請在線性光(數值正比於光子數)上操作,而不是在經過 gamma 編碼的像素上(gamma 請見 DIP 第 3 章)。常用的是 Foi 等人的 Poisson–Gaussian 模型 [7]:
其中 是乾淨的線性影像, 是到達感測器的光量比例, 是把強度換算成光子數的尺度( 越大代表光子越多、相對雜訊越小), 是模擬散粒雜訊(shot noise)的 Poisson 隨機變數, 是標準差 的高斯讀出雜訊(read noise)。之後相機再套上色調曲線並量化。 的變異數約為 ,會隨訊號增加,也就是說雜訊是與訊號相關的;這就是為什麼「加高斯雜訊」很難代表真實的低光。
import numpy as np
from skimage import data, img_as_float

rng = np.random.default_rng(0)
clean = img_as_float(data.coffee())            # H x W x 3, sRGB-encoded, in [0, 1]

def synth_low_light(x, k=0.05, peak=2000.0, read_std=8e-4, gamma=2.2):
    lin = k * x ** gamma                           # 1) less light, in linear units
    lin = rng.poisson(lin * peak) / peak           # 2) shot noise (Poisson)
    lin = lin + rng.normal(0, read_std, lin.shape) # 3) read noise (Gaussian)
    out = np.clip(lin, 0, 1) ** (1 / gamma)        # 4) re-encode for display
    return np.round(out * 255) / 255               # 5) 8-bit quantization

dark = synth_low_light(clean)
print(clean.mean(), dark.mean())                   # about 0.39 -> 0.10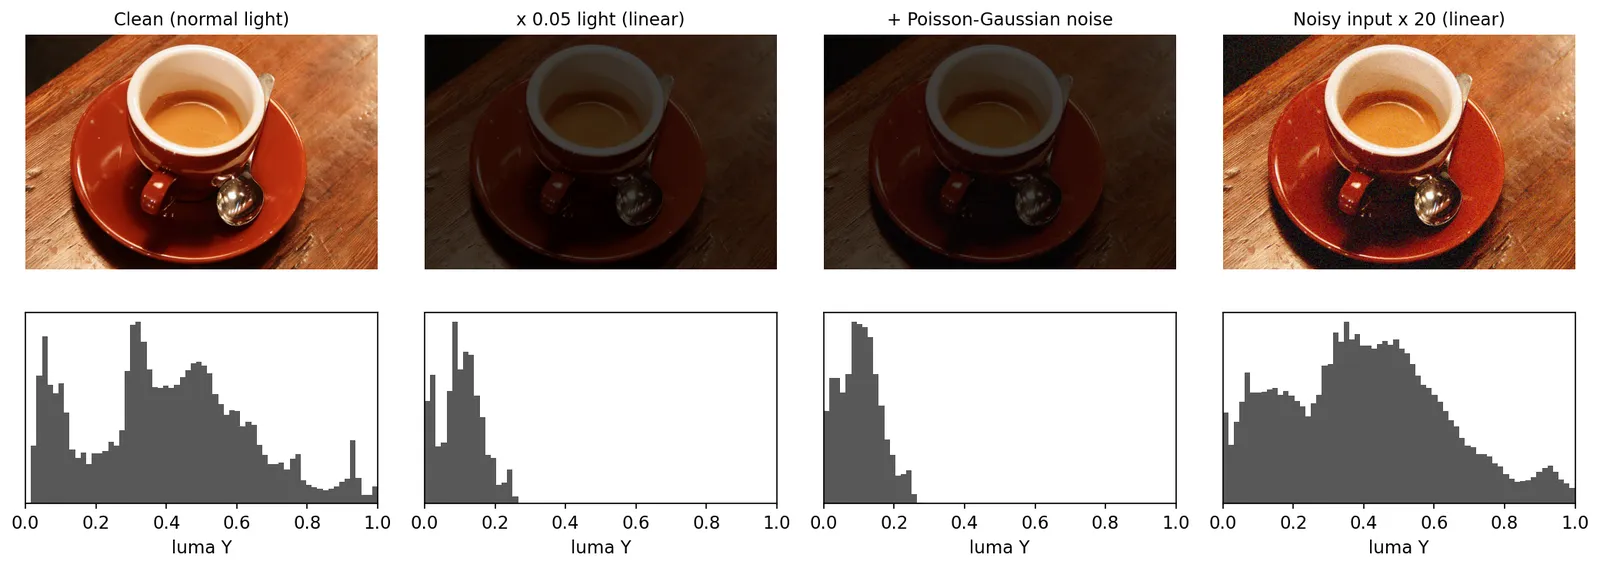
最右邊那張是本篇最重要的一張圖:即使是理想的亮度校正,雜訊依然存在。這就是為什麼 LLIE 是一個復原問題(請見 DL 04・影像復原),而不只是色調對應問題。
非深度學習的 LLIE 與低光影像的特性
白話版。 在深度學習之前,主要有兩大流派:直方圖類方法重新分配灰階;Retinex 類方法把影像拆成「光照」和「物體」兩部分,再修正光照。第三種想法借自去霧,可以歸進 Retinex 家族;統計方法則延伸了以上各類。
低光影像在色彩空間上的特性
許多色彩空間會把「有多亮」的通道和「是什麼顏色」的通道分開。不同空間稱它為明度(value)、強度(intensity)、亮度(luma)或明亮度(lightness),定義也各不相同。設 (色彩空間本身請見 DIP 第 6 章):
其中 是經 gamma 編碼的值; 是線性光的亮度, 是參考白的亮度; 在一個小門檻以上為 ,以下為線性。幾點說明:
- 就是「亮通道」(bright channel)。 它是逐像素的最大值,與去霧中使用的暗通道(dark channel,逐區塊的最小值)[14] 相對。在暗影像中, 是被黑暗破壞最少的通道,這也是 LIME [17] 用它來初始化光照的原因。
- 亮度權重。 ITU-R BT.601 [8] 定義亮度為 ,這個全範圍(full range)形式就是 JPEG/JFIF 使用的版本。8 位元的有限範圍(limited range,又稱 studio range)影片中,BT.601 把黑色放在 16、白色放在 235:。若 ,就變成 ,因為 。兩個公式描述的是同一個亮度,只差在範圍與偏移量。
- 被設計成感知上均勻,相同的數值差在人眼看來差不多大,因此很適合拿來做對比增強。
實務上的結論是:既然亮度可以和顏色拆開,就可以只增強亮度通道並保留色度。圖 2 顯示,選哪個通道影響很大。
R, G, B = dark[..., 0], dark[..., 1], dark[..., 2]
V = dark.max(axis=2)                          # HSV value
I = dark.mean(axis=2)                         # HSI intensity
Y = 0.299 * R + 0.587 * G + 0.114 * B         # BT.601 luma, full range (JPEG/JFIF)
Y_limited = 16 + 219 * Y                      # 8-bit limited ("studio") range, 16..235
print(np.allclose(Y_limited, 16 + (65.481 * R + 128.553 * G + 24.966 * B)))  # True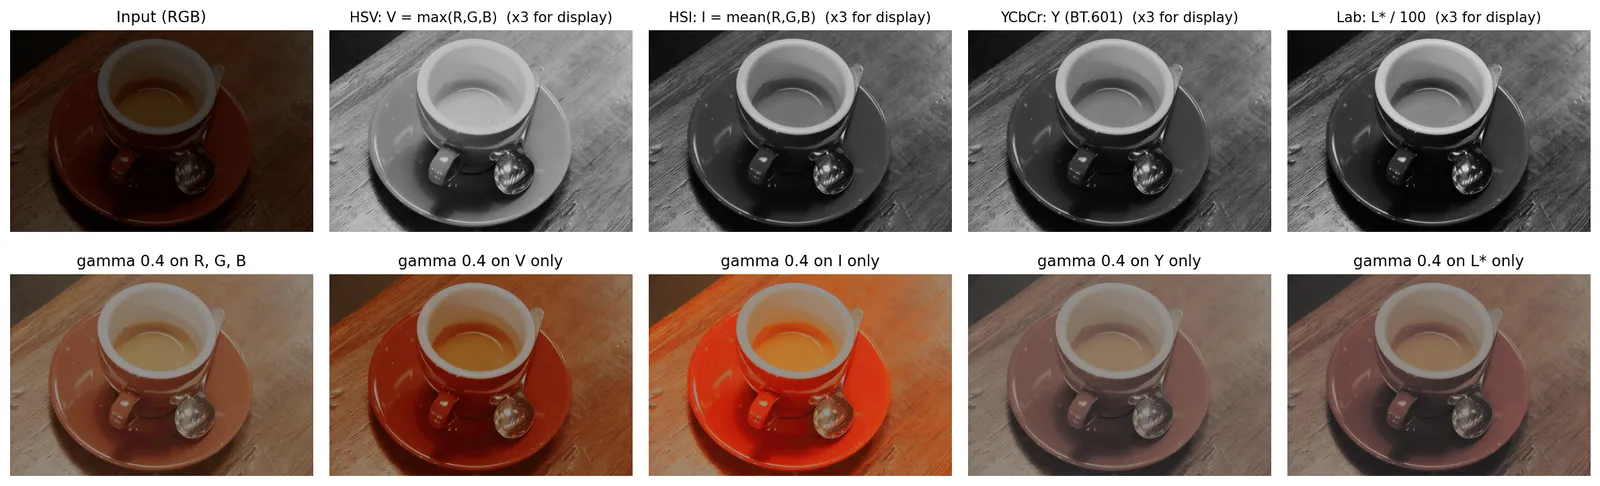
圖中可以看到兩種效應。以共同倍數縮放 RGB(HSV、HSI)會保留色相與通道比例,於是本來就飽和的物體變得非常飽和;只改 或 、固定 Cb/Cr 或 a*/b*,則是只加亮度不加顏色,影像看起來就褪色了。色調與色彩的這種耦合,正是後來 HVI-CIDNet [27] 想用學習出來的色彩空間處理的問題。
直方圖等化與 CLAHE
白話版。 直方圖等化(histogram equalization, HE)把影像的灰階攤開,讓每個亮度值被使用的機會差不多。暗影像的值擠在 0 附近,等化後就會被拉滿整個範圍。
精確版。 對 個灰階、正規化直方圖 的影像,HE 以縮放後的累積分布函數(CDF)作為對應:
其中 是灰階 的像素數, 是影像大小。 的斜率正比於直方圖,所以像素很多的灰階會被拉開。推導請見 DIP 第 3 章。對彩色影像,常見做法是先轉到有亮度通道的色彩空間,只等化該通道,再轉回來,例如 RGB → Lab → 等化 → RGB。
全域 HE 在低光下有兩個問題:它會過度拉伸大片平坦區域(連同其中的雜訊),而且單一對應無法同時照顧暗角與明亮的燈。自適應 HE(adaptive HE)為每個區塊計算對應;CLAHE(contrast-limited AHE)在計算 CDF 前先把每個區塊的直方圖在某個上限截斷,藉此限制 的斜率,也就限制了雜訊增益,最後在相鄰區塊間內插以避免接縫 [9], [10]。
Gamma 校正
冪次律 在 時對暗部的提升大於亮部;它的斜率 在 附近很大。它便宜又單調,但屬於全域操作:整張圖只有一個 、不會去噪,而且依套用的空間不同,同樣面臨上述「褪色或過飽和」的選擇。
from skimage import color, exposure

gamma_out = dark ** 0.4                                     # power-law curve on every channel
lab = color.rgb2lab(dark)
L = lab[..., 0] / 100                                       # L* scaled to [0, 1]
he = lab.copy();    he[..., 0] = 100 * exposure.equalize_hist(L)
clahe = lab.copy(); clahe[..., 0] = 100 * exposure.equalize_adapthist(L, clip_limit=0.01)
he_out, clahe_out = color.lab2rgb(he), color.lab2rgb(clahe)
for name, im in [("gamma", gamma_out), ("HE", he_out), ("CLAHE", clahe_out)]:
    print(f"{name:6s} mean {im.mean():.3f}   std {im.std():.3f}")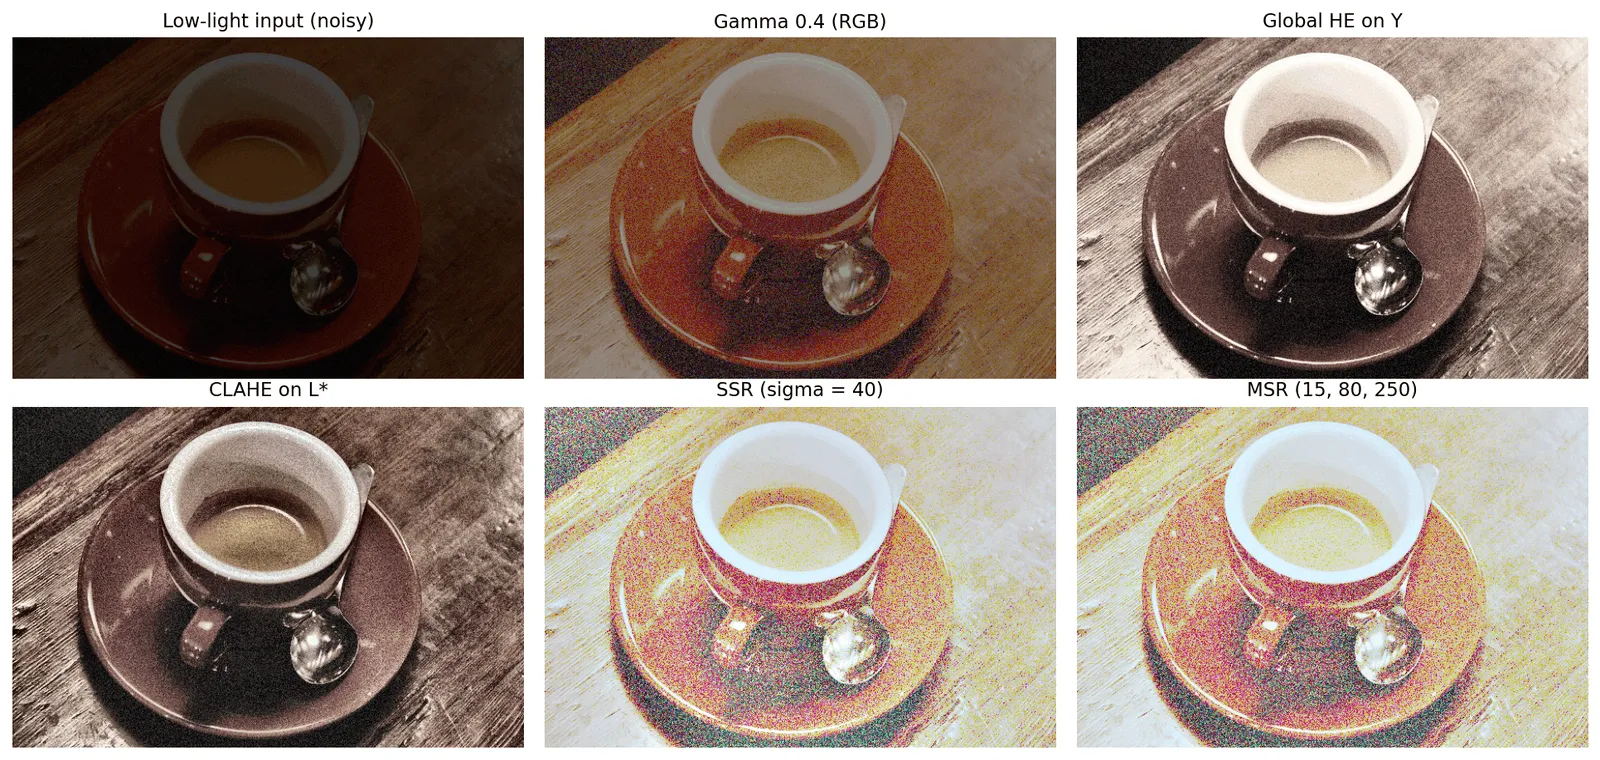
Retinex 理論
白話版。 Retinex 認為,眼睛(或相機)接收到的影像是「物體本身的顏色」乘上「照在它上面的光」。如果能估計出光,就能把它除掉,看到物體真正的樣子,再換上一個更好的光。
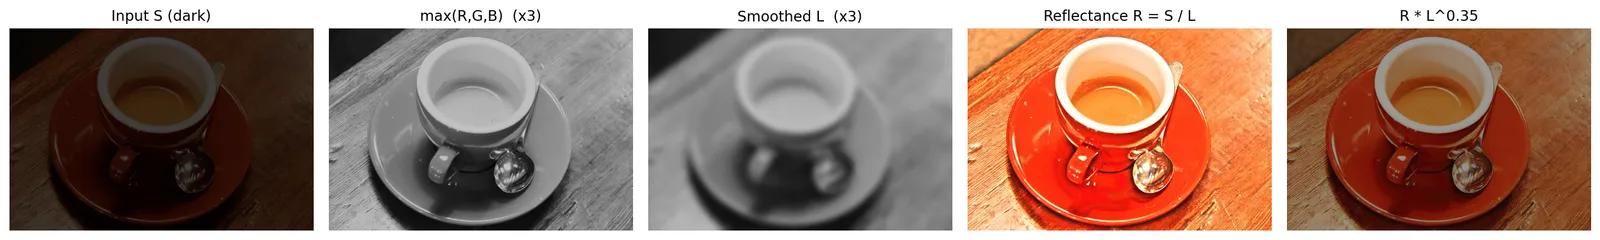
精確版。 Land 的 Retinex 理論 [11] 把觀察到的影像 表示為
其中 是像素位置, 是反射率(reflectance,物體表面的性質,假設在任何光照下都不變), 是照度(illumination,照在場景上的光,除了陰影邊界之外在空間上平滑變化), 是逐元素相乘。請注意用詞: 是照度,不是 luminance;luminance 通常指色彩空間裡的亮度通道,例如上面的 。
從一個乘積解出兩個未知數是病態問題(ill-posed),因此每個 Retinex 方法都會加上先驗。最經典的是「照度是平滑的」。
單尺度 Retinex(SSR) [12] 用高斯模糊 估計 ,並在對數域運算,讓乘法變成加法:
對每個色彩通道 計算, 為卷積, 為周圍(surround)尺度。 小,局部對比強但邊緣出現光暈(halo); 大,色調較好但細節較弱。多尺度 Retinex(MSR) [13] 以權重 平均多個尺度(通常三個)的 SSR 輸出:
由於 SSR 與 MSR 逐通道運算,顏色容易變灰。MSRCR(帶色彩還原的 MSR)[13] 將結果乘上一個色彩還原因子,依據是各通道佔 的比例;其他變體則只對強度通道做 MSR,並保留輸入的色度。
from scipy import ndimage as ndi

def ssr(img, sigma=40.0, eps=1e-3):
    log_s = np.log(img + eps)
    log_l = np.log(ndi.gaussian_filter(img, sigma=(sigma, sigma, 0)) + eps)  # L ~ Gaussian blur
    r = log_s - log_l                                       # log R = log S - log L
    lo, hi = np.percentile(r, [1, 99])                      # robust stretch for display
    return np.clip((r - lo) / (hi - lo), 0, 1)

msr = np.mean([ssr(dark, s) for s in (15, 80, 250)], axis=0) # MSR, equal weights (simplified)做增強時,我們通常不只要 ,因為單獨的 看起來平板又不自然。我們要的是把 調亮再組合回去:,例如 、。這個「分解、調整 、重組」的模式,就是大多數 Retinex 深度網路的範本。
LIME:把 Retinex 寫成最佳化問題
LIME [17] 只估計照度。它以亮通道 初始化,再解一個保留結構的平滑問題來精修:讓 接近 ,但除了影像有強結構的地方之外都要平滑。增強後的影像為 ;由於除法會放大雜訊,LIME 可以選擇在之後去噪。LIME 論文的影像(常稱 LIME 資料集)成為標準測試集,而這個方法正是傳統配方的好例子:一個物理模型、一個手工設計的先驗、再加上最佳化。
另一個模型:對反轉影像去霧
Retinex 並不是唯一的成像模型。去霧使用的是大氣散射模型(atmospheric scattering model):
其中 是有霧的觀測影像, 是無霧的場景輻射, 是透射率(場景光有多少能留下來), 是全域大氣光。這個模型不能直接套用在暗影像上,因為暗影像看起來並不像有霧的影像。
Dong 等人觀察到,反轉後的低光影像 確實像有霧:暗區變成明亮、低對比的區域,就像霧一樣。因此他們先反轉影像,套用去霧演算法(精神上與暗通道先驗 [14] 相同),再把結果反轉回來 [15], [16]。以上面的符號表示:
從「哪些資訊可靠」的角度看:去霧假設暗通道代表無霧的內容;但在低光影像裡,暗通道大多是被破壞的像素,所以重點轉向亮通道,也就是受黑暗影響最少的區域。LIME 論文 [17] 分析了這種反轉做法,並說明它可以改寫成 Retinex 的形式,所以兩個模型本質上是同一個假設,只是 Retinex 的表述較簡單。
統計方法
許多傳統方法在這些模型之上再加入統計量或先驗:保持場景明暗順序的自然度約束(NPE [18])、分層或二維直方圖模型(DICM 資料集背後的方法 [59]),以及融合多張合成曝光。它們都是手工設計、不需要訓練資料,泛化行為可預期;弱點則是雜訊,通常被忽略或交給另一個去噪器處理。
深度學習 LLIE
白話版。 深度網路從資料中學習「暗到亮」的對應。問題不在於要不要用網路,而在於用什麼訓練訊號:成對的暗/亮照片、非配對的照片、完全沒有參考影像,或者是一個描述「亮影像長什麼樣子」的生成模型。物理知識(通常是 Retinex)可以放進以上任何一種。
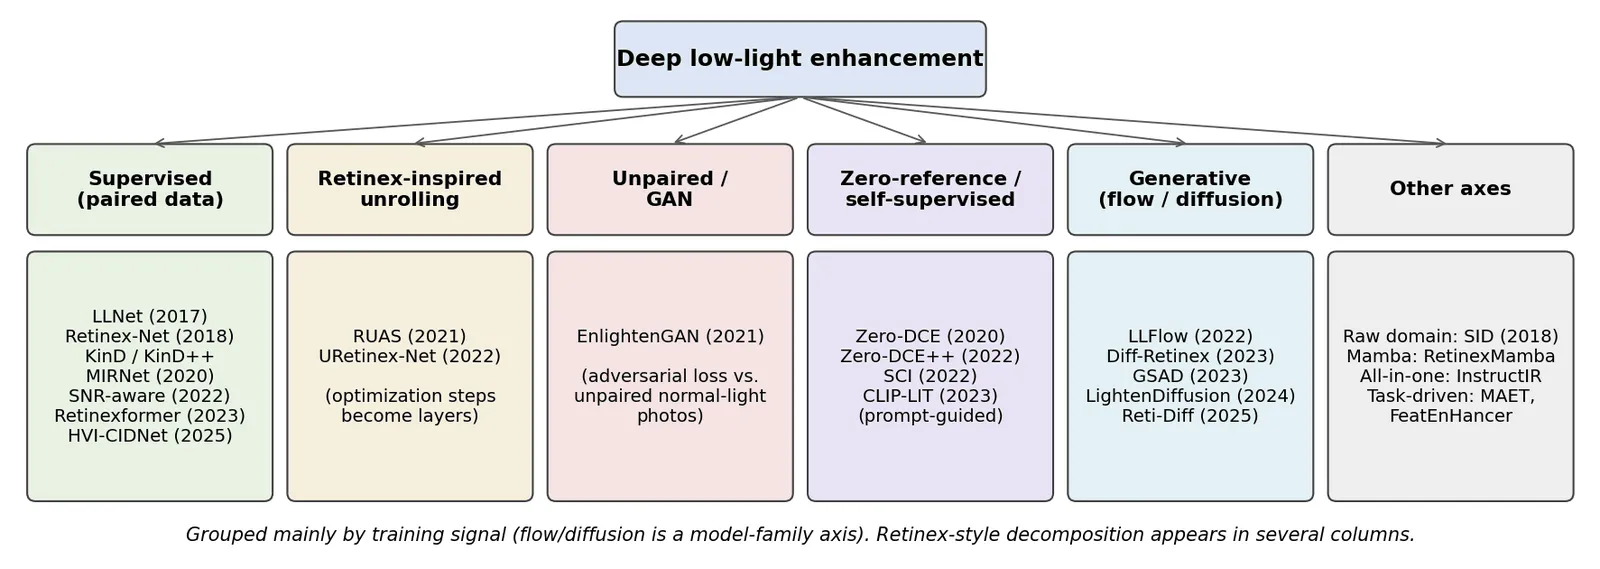
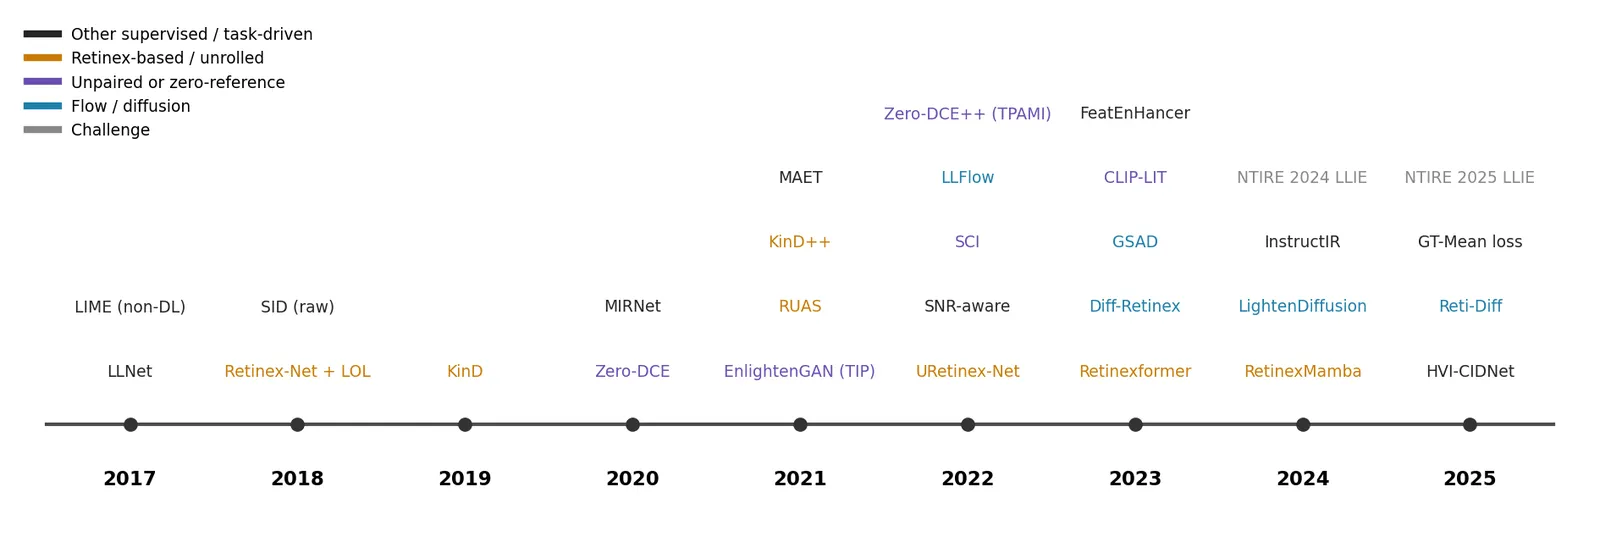
深度學習本身就是一個龐大的最佳化過程,而它的黑盒子特性讓我們能省掉許多手工假設。常見的第一種分法是以理論為基礎(通常是 Retinex)與不以理論為基礎(學習能力強的通用網路)。實務上兩者常交織在一起,所以不能用二元方式一刀切。圖 5 主要改以訓練訊號分組,參考了綜述論文 [2], [3] 的做法。
監督式方法(成對資料)
給定低光與正常光影像對 ,訓練 最小化重建損失,通常是 再加上感知或結構項。成對資料取得成本高(同一靜態場景拍兩種曝光,或用合成的),而且網路會學到參考影像特定的亮度與色彩風格,這一點在後面談評估時很重要。
- LLNet [19](2017)是最早的深度 LLIE 模型之一:一個堆疊稀疏去噪自編碼器(stacked sparse denoising autoencoder),用人工變暗並加雜訊的小區塊訓練,同時學習調亮與去噪。
- CNN + 亮通道先驗(Tao 等人 [20],2017)依序處理兩個難點:先用 CNN 去噪,再以亮通道驅動、類似大氣散射模型的方式增強對比,是把學習與上述反轉想法結合的早期例子。
- MIRNet [24](2020)是一個通用的復原骨幹網路:保留一條全解析度的支線,並行多條低解析度支線、讓它們彼此交換資訊,再用 selective kernel 注意力融合;論文除了增強之外,也在去噪與超解析度上評估。
- SNR-aware [25](2022)估計逐像素的訊噪比圖。訊噪比高的地方,局部卷積就夠了;訊噪比很低的地方,局部鄰域不可靠,模型改用長距離的 Transformer 注意力,從影像其他地方借用資訊。
- HVI-CIDNet [27](2025)處理的是圖 2 的色彩空間問題:sRGB 對顏色非常敏感,容易產生色偏與亮度假影;HSV 解決了亮度問題,卻帶來紅色與黑色的雜訊假影。作者提出 HVI 色彩空間,由極化的色相/飽和度圖與可學習的強度構成,並搭配一個把色彩與強度解耦的網路。
以 Retinex 為基礎的網路
Retinex-Net [21](2018)把目標從「估計 」改成「輸入與輸出各自有自己的 和 」。流程是:分解低光與正常光影像、把 增強成 、再與 重組。它也提出了 LOL 資料集(見後文)。它的分解網路沒有 或 的真值,只靠一致性來訓練,損失函數為
論文的記號是 ,所以這裡的 就是照度(我們記號中的 )。 是輸入影像 , 與 是影像 分解出的反射率與照度, 是水平加垂直的梯度。各項的意義:
- :每組分解都必須重建出自己的影像(),而且把兩張影像的反射率與照度交叉組合也應該大致成立( 時 )。
- :兩張影像拍的是同一個場景,所以反射率應該相同;網路正是藉此學到「反射率」是什麼。
- :照度應該平滑,除了反射率有強邊緣的地方。權重 在物體邊界上放寬平滑懲罰。這是 LIME 結構感知先驗的學習版。
論文使用 、、。增強網路則以 加上同樣的平滑項訓練。
這個模式很快就流行起來,許多方法的名字都帶有「Retinex」:
- KinD [22](2019)把工作拆成三個子網路:分解、反射率還原(因為暗影像的反射率帶有雜訊與色偏,所以放寬了「R 不變」的假設),以及可由使用者控制亮度倍率的照度調整。KinD++ [23](2021)進一步改良設計以減少視覺缺陷。
- Retinexformer [26](2023)指出拍攝與調亮都會破壞分解出的成分,於是把模型改寫為帶擾動項的形式:,其中 與 模擬雜訊、假影與色彩失真。它採單階段訓練(取代 Retinex-Net 的多階段訓練),使用 L1 損失;它的照度引導多頭自注意力(illumination-guided multi-head self-attention)用照度估計來引導注意力,讓曝光程度不同的區域彼此交流。它後來成為常見的比較基準。
- RetinexMamba [42](2024 年預印本)沿用 Retinex Transformer 的架構,把注意力換成 Mamba 狀態空間(state space)模組,其計算量隨像素數線性成長。「Retinex 分解+新骨幹」多年來一直是很穩定的設計模式。
另一條較少見的路線是以大氣散射模型、而非單純的 Retinex 為基礎。CPGA-Net [28] 結合通道先驗與 gamma 校正,建構一個同時處理全域與局部資訊的輕量網路;CPGA-Net+ [29] 則重新檢視理論上的照度模型,以提升效率。這條研究路線也觀察到:不同功能模組學到的特徵,會對應到先驗的物理角色;這表示受模型引導的網路,並不是完全無法理解的黑盒子。
Retinex 啟發的展開式網路
展開(unrolling,或 unfolding)是把 Retinex 問題的迭代最佳化演算法,每一次迭代變成一個帶有可學習參數的網路階段。網路架構繼承了演算法的結構與可解釋性,而訓練取代了手工調整的先驗。
- RUAS [30](2021)展開照度估計與去噪的最佳化模型,搜尋先驗模組的架構,並以協同式的無參考(reference-free)策略訓練,所以它同時也屬於非監督那一欄。它非常小也非常快。
- URetinex-Net [31](2022)把 Retinex 分解的最佳化展開成網路,包含初始化、 與 的展開更新,以及照度調整等學習模組。
非配對訓練:EnlightenGAN
EnlightenGAN [32](2021)使用生成對抗網路(GAN),只需要一組暗影像和另一組不相關的明亮影像。生成器是 U-Net,並以輸入照度推得的自正則化注意力圖引導,產生增強影像。全域判別器評估整張影像,局部判別器評估隨機小區塊,讓輸出在整體與細節上都像光線充足的照片。由於沒有真值,自特徵保持(self-feature-preserving)損失比較輸入與輸出的 VGG 特徵,讓內容維持不變。
零參考方法與曲線估計
白話版。 Zero-DCE 不直接輸出新影像,而是替每個像素輸出一條調亮曲線,套用它,再用不需要任何參考照片的損失來評分:「曝光好不好?顏色平不平衡?曲線平不平滑?局部對比有沒有保留?」
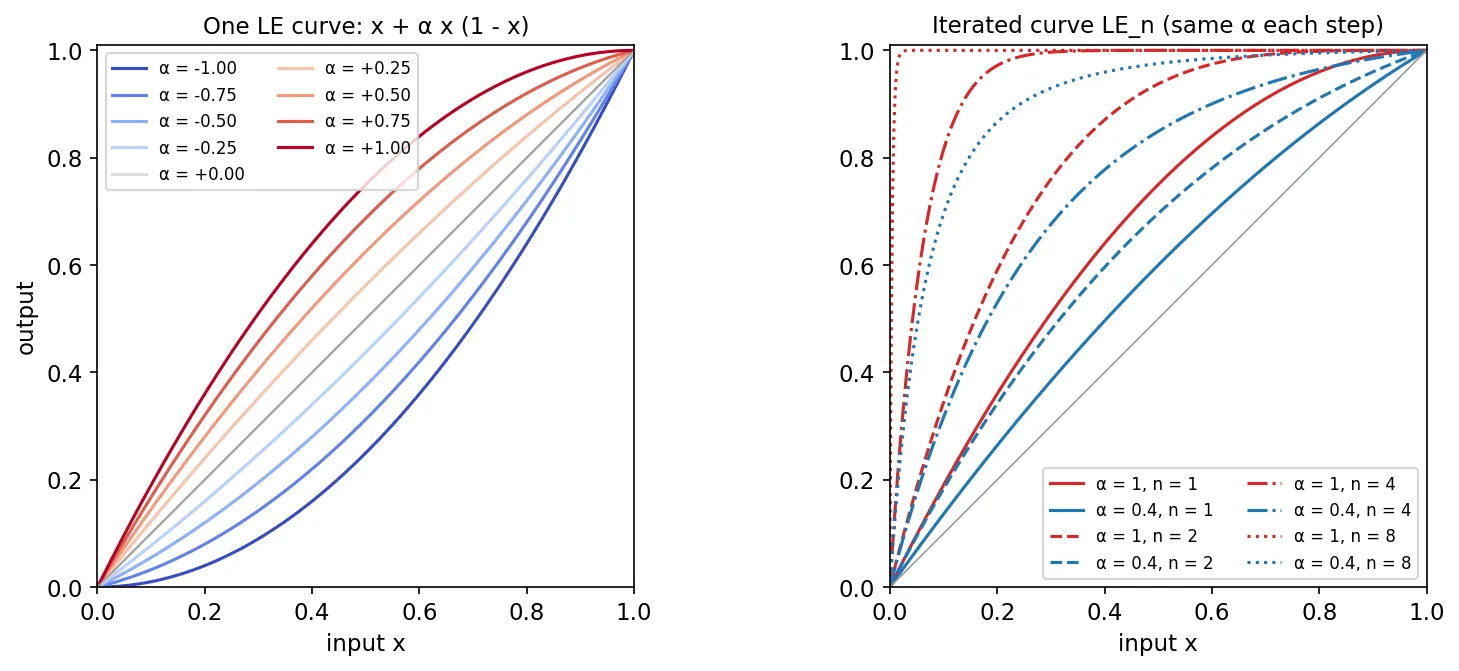
LE 曲線。 Zero-DCE [33](2020)定義了一條二次的光增強曲線(light-enhancement curve)
其中 是像素值。這條曲線有三個好性質: 且 ,範圍不變、不需要截斷;當 時單調,因為 ,明暗順序得以保留;而且可微分,能用反向傳播訓練。單一條二次曲線不夠靈活,所以要迭代套用:
其中 是輸入,,而 是逐像素、逐通道的參數圖,而非單一的 。一個七層的 CNN(DCE-Net,每層 32 個通道、約 79k 個參數、沒有降取樣)以 tanh 輸出 張參數圖。每個像素因此都有自己的高階曲線,局部調整就是這樣從看似全域的公式中產生的。
def le_iterate(x, alphas):
    """Zero-DCE curve: LE_n = LE_{n-1} + a_n * LE_{n-1} * (1 - LE_{n-1})."""
    y = x.copy()
    for a in alphas:              # a can be a scalar or a per-pixel map
        y = y + a * y * (1 - y)
    return y

x = np.array([0.0, 0.02, 0.1, 0.3, 0.6, 1.0])
print(le_iterate(x, [1.0] * 8).round(3))   # [0. 0.994 1. 1. 1. 1.]
print(le_iterate(x, [0.4] * 8).round(3))   # [0. 0.245 0.695 0.93 0.985 1.]
第一行輸出顯示了危險之處:對很小的 ,每一步大約乘上 ,所以 迭代八次的增益接近 。暗部裡的雜訊也會被放大同樣的倍數。
無參考損失。 Zero-DCE 用四個不需要真值的損失函數訓練:
在 (空間一致性)中, 是 區域的數量, 是區域 的四個鄰居, 與 分別是增強影像與輸入影像中該區域的平均強度:相鄰區域之間的對比應該保留。在 (曝光控制)中, 是 個不重疊 區域中第 個的平均強度, 是目標的良好曝光程度。在 (色彩恆常)中, 是通道 在整張影像上的平均,:這是灰色世界(gray-world)假設,認為場景的平均顏色是灰色。在 (照度平滑)中, 是迭代次數, 是水平與垂直梯度:相鄰像素應該得到相似的曲線。總損失為 ,論文中 、;訓練資料是 SICE [56] 的多重曝光影像,同時提供曝光不足與過曝的輸入。
後續方法改良了這個想法:
- Zero-DCE++ [34](2022)改用深度可分離卷積(depthwise separable convolution),只預測 3 張曲線參數圖並在所有迭代中重複使用,而且在降取樣後的輸入上估計,再縮放回原尺寸。模型因此縮小到約 10k 個參數,即使在 CPU 上也跑得相當快。
- SCI [35](2022)以權重共享的多階段串接學習照度,並用自校正(self-calibrated)模組讓各階段的輸出在訓練時收斂到相同狀態,因此測試時只需要一個基本模組。它以非監督損失訓練。
- CLIP-LIT [36](2023)針對逆光影像。它使用視覺-語言模型 CLIP,學習一對文字提示(prompt),一個代表逆光、一個代表光線良好,再迭代地精修提示與增強網路,讓輸出與「光線良好」提示的 CLIP 相似度成為訓練訊號。
用 PyTorch 寫一個零參考小玩具
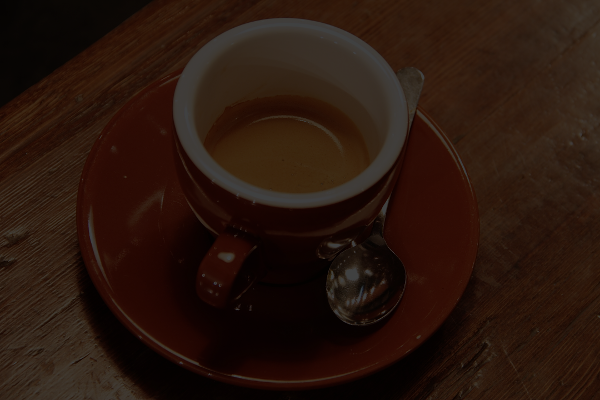
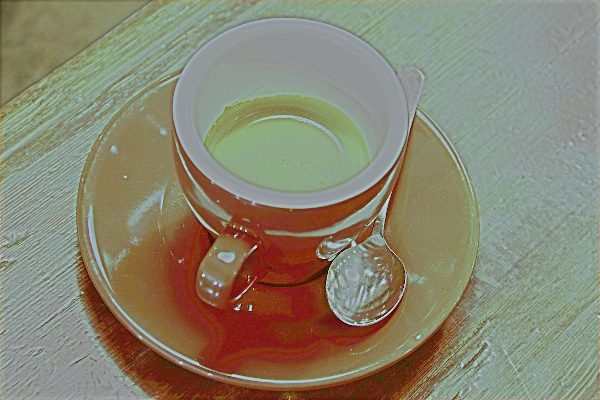
為了看看這些損失函數如何運作,下面的程式碼在 CPU 上訓練一個迷你的 Zero-DCE 風格網路約半分鐘。它用四張 skimage 影像的隨機裁切訓練,每塊都在線性光中以隨機倍率變暗;測試則用訓練時從沒看過的咖啡杯影像。全程不使用任何真值。(損失權重與論文不同,因為各項的正規化方式不同:曝光誤差用平方而非絕對值,梯度用平均而非加總。)
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
from skimage import data, img_as_float
from skimage.transform import resize

torch.manual_seed(0); rng = np.random.default_rng(0)
darken = lambda x, k: (k * x ** 2.2) ** (1 / 2.2)          # less light, in linear units
train = [resize(img_as_float(f()), (256, 256), anti_aliasing=True)
         for f in (data.astronaut, data.chelsea, data.rocket, data.immunohistochemistry)]

def batch(n=4, size=64):                                  # random crops, random darkness
    xs = []
    for _ in range(n):
        img = train[rng.integers(len(train))]
        i, j = rng.integers(0, 256 - size, 2)
        xs.append(darken(img[i:i + size, j:j + size], rng.uniform(0.02, 0.3)))
    return torch.tensor(np.stack(xs), dtype=torch.float32).permute(0, 3, 1, 2)

class TinyDCE(nn.Module):
    def __init__(self, n_iter=8, w=16):
        super().__init__()
        self.n_iter = n_iter
        self.body = nn.Sequential(
            nn.Conv2d(3, w, 3, padding=1), nn.ReLU(), nn.Conv2d(w, w, 3, padding=1), nn.ReLU(),
            nn.Conv2d(w, w, 3, padding=1), nn.ReLU(), nn.Conv2d(w, 3 * n_iter, 3, padding=1), nn.Tanh())
    def forward(self, x):
        alphas = self.body(x).chunk(self.n_iter, dim=1)    # 8 maps of shape B x 3 x H x W
        y = x
        for a in alphas:
            y = y + a * y * (1 - y)                         # the LE curve
        return y, torch.cat(alphas, 1)

def L_exp(y, E=0.6, p=16):   # mean brightness of 16x16 patches should be near E
    return (F.avg_pool2d(y.mean(1, keepdim=True), p) - E).pow(2).mean()
def L_col(y):                # gray-world: channel means should agree
    r, g, b = y.mean((2, 3)).unbind(1)
    return ((r - g) ** 2 + (r - b) ** 2 + (g - b) ** 2).mean()
def L_tv(a):                 # curve parameters should vary smoothly in space
    return (a[..., 1:, :] - a[..., :-1, :]).pow(2).mean() + (a[..., :, 1:] - a[..., :, :-1]).pow(2).mean()
def L_spa(y, x, p=4):        # keep the contrast between neighbouring 4x4 regions
    Y, X = (F.avg_pool2d(t.mean(1, keepdim=True), p) for t in (y, x))
    return sum(((torch.diff(Y, dim=d) - torch.diff(X, dim=d)) ** 2).mean() for d in (2, 3))

net = TinyDCE()
opt = torch.optim.Adam(net.parameters(), lr=1e-3)
for step in range(600):                                   # ~20-40 s on a laptop CPU
    x = batch()
    y, a = net(x)
    loss = L_spa(y, x) + 10 * L_exp(y) + 5 * L_col(y) + 200 * L_tv(a)
    opt.zero_grad(); loss.backward(); opt.step()

test = darken(img_as_float(data.coffee()), 0.05)          # an image never used in training
with torch.no_grad():
    out, _ = net(torch.tensor(test, dtype=torch.float32).permute(2, 0, 1)[None])
print(f"mean brightness: {test.mean():.3f} -> {out.mean():.3f}")   # about 0.10 -> 0.50
拖動滑桿,比較暗的輸入與小玩具的輸出:
 暗的輸入零參考小玩具
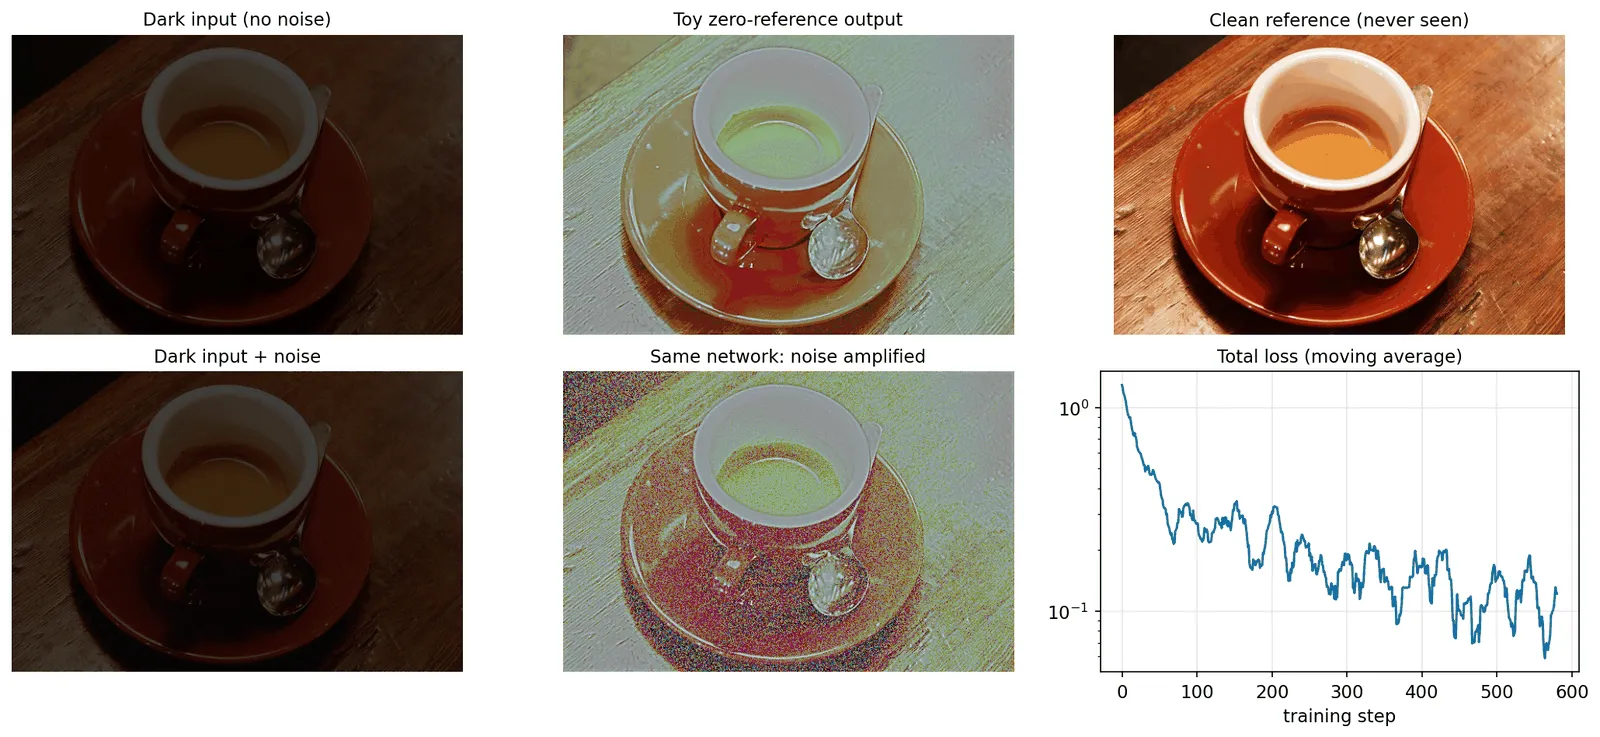
這個小玩具在一張圖裡同時展示了零參考想法的優點與極限。沒有任何一張參考影像,網路就學到了合理的調亮方式,而且能遷移到沒看過的照片。但每一個損失都是一種先驗,而先驗可能是錯的:場景本來就偏紅或偏褐時,灰色世界假設就失效;固定的曝光目標 會把刻意保留的暗區拉平;而損失中沒有任何一項要求去噪。真正的零參考方法用多得多的影像訓練,有些還加入了明確的雜訊處理,但這些失敗模式在已發表的結果中同樣看得到。
正規化流與擴散模型
LLFlow [37](2022)觀察到:同一張暗影像有許多種可接受的明亮版本,而逐像素損失會把它們平均成一個模糊的折衷。它學習一個條件式正規化流(normalizing flow):一個可逆網路,在以暗輸入特徵為條件下,把正常光影像對應到高斯分布。這些特徵由呼應傳統方法的先驗引導:輸入的直方圖等化版本、色彩圖(接近 Retinex 的反射率),以及雜訊圖。
2023 年起,擴散模型(diffusion model)大量進入 LLIE。它們以暗影像為條件,從隨機雜訊逐步去噪來生成輸出,因此能合成回歸式網路會模糊掉的合理細節:
- Diff-Retinex [38](2023)先用 Retinex Transformer 分解影像,再用條件式擴散模型生成復原後的反射率與照度。
- GSAD [39](2023)加入全域結構感知的正則化,以影像結構引導擴散軌跡上以曲率為基礎的約束,並對困難區域加入不確定性引導項。
- LightenDiffusion [40](2024)在潛在空間中做 Retinex 分解,並以非配對資料訓練。
- Reti-Diff [41](2025)以潛在擴散模型產生精簡的 Retinex 先驗,再用它引導一個復原 Transformer,降低在全解析度上跑擴散的成本。
代價是運算量與保真度:多步去噪讓推論變慢,生成的細節可能看起來對,卻不一定真實。Adhikarla 等人的綜述 [6] 把這個子領域分成六類:內在分解、頻譜與潛在空間、加速、引導式、多模態,以及自主式。
Raw 域的低光
以上方法都作用在處理過的 sRGB 影像上,而相機的處理流程(去馬賽克、白平衡、去噪、色調曲線、壓縮)早已丟掉部分資訊。Learning to See in the Dark [44](2018)改把 raw 感測器資料送進 U-Net,用它取代整條處理流程。它的 SID 資料集有 5,094 張短曝光 raw 影像,對應 424 張不同的長曝光參考影像,來自 Sony α7S II(Bayer 感測器)與 Fujifilm X-T2(X-Trans 感測器),曝光比為 ×100、×250 與 ×300。Raw 資料保留光子數與數值之間的線性關係,位元數也更多,因此在 sRGB 中毫無希望的極暗場景也能被救回來。代價是模型綁定在單一感測器上。
All-in-one 復原
低光增強也是通用復原模型中的一項任務。InstructIR [43](2024)接受自然語言指令(「把這張照片調亮」、「去除雜訊」)並據此復原影像,在一個網路中涵蓋去噪、去模糊、去霧與低光增強。
面向下游任務的低光處理
如果目標是偵測而非好看的照片,常見的基準做法是「先增強、再偵測」(請見 DL 03・物件偵測)。但為人眼調校的增強,不一定是偵測器需要的。MAET [45](2021)以物理方式模擬低光退化,並訓練偵測器同時預測退化參數,讓特徵能感知退化。FeatEnHancer [46](2023)則在網路內部增強階層式特徵,直接用下游任務的損失訓練,而不是增強像素。
評估
白話版。 分數有兩類。全參考指標把輸出和一張真值照片比較;無參考指標只看輸出本身。第三種做法則是問:增強後的影像有沒有幫助下游任務?每一種回答的問題都不同,而且每一種都可能被鑽漏洞。
全參考指標
給定參考影像 與輸出 (數值在 ),PSNR 為
其中 是數值的個數。它是純粹的像素誤差。SSIM [47] 比較局部的亮度、對比與結構統計量,與人眼感知的相關性較高。LPIPS [48] 衡量兩張影像深度特徵之間的距離,越低越好,對 PSNR 忽略的紋理與模糊很敏感。
無參考指標
非配對的測試集(LIME、MEF、NPE、DICM、VV)沒有參考影像。NIQE [49] 對原始高品質影像的自然場景統計量擬合一個多變量高斯分布,再回報測試影像統計量與它的距離,不需要用人類評分訓練;BRISQUE [50] 使用類似的特徵,搭配以人類主觀評分訓練的迴歸器。兩者都是越低越好。它們是為一般失真而設計,不是為曝光,因此可能偏好過度銳化或有雜訊的影像,應該搭配視覺比較或使用者研究。
GT-mean 陷阱
白話版。 在成對基準上,整體亮度的一點點差異就會大幅改變 PSNR。有些論文在評分前,會把每張輸出重新縮放,讓它的平均亮度與真值一致。但實際使用時,你永遠拿不到這個資訊。
精確版。 「GT-mean」評估把輸出乘上 ,再對 計算指標, 為影像平均。由於 LLIE 的「正確」亮度本來就有歧義,這樣做可以大幅提高 PSNR。Retinexformer 的作者在程式碼中提供了這個模式,以便與 LLFlow、KinD 及近期擴散模型等方法比較,但明確表示不建議使用,因為它用真值來修正輸出 [26]。Liao 等人 [51](2025)研究輸出與參考之間的亮度不匹配,提出用於訓練的 GT-mean 損失函數,並同時回報標準與 GT-mean 指標。讀表格時:先確認使用哪一種設定,絕不混用兩者,並優先選擇在標準協定下表現好的方法。
以任務為導向的評估
由於 LLIE 常是前處理步驟,另一種檢驗方式是在增強後的影像上跑偵測或分割模型(例如在 ExDark [57] 上)並回報準確率。Liu 與 Fan 2025 年的綜述 [5] 發現兩者脫節:監督式方法常產生感知品質高的影像,對視覺任務的提升卻有限;零樣本(zero-shot)方法雖然畫質分數較低,在各種任務上的提升反而更一致。Liu 等人的基準 [4] 也評估了低光下的人臉偵測。完整的評估應該回報保真度、無參考品質、任務表現與執行時間。
基準資料集
白話版。 資料集的差別在於:有沒有成對、暗是真實的還是合成的、是 raw 還是 sRGB,以及有沒有偵測用的標註。
| 資料集 | 類型 | 內容與用途 |
|---|---|---|
| LOL (v1) [21] | 成對、真實、sRGB | 改變曝光拍攝的 500 組低光/正常光影像(485 組訓練/15 組測試),400×600。最常用的 LLIE 基準;測試集很小。 |
| LOL-v2 [52] | 成對,真實+合成子集 | 較大的 Real 子集(實拍成對)與合成成對資料的 Synthetic 子集。兩個子集要分開回報。 |
| LSRW [53] | 成對、真實 | 5,650 組,來自 Nikon D7500(3,170 組)與 Huawei P40 Pro(2,480 組);5,600 組訓練、50 組測試。測試跨裝置泛化。 |
| SDSD [54] | 成對影片 | 以機電系統對齊、拍攝兩次的動態室內與室外場景;常拆成影格做影像測試。 |
| SID [44] | 成對、raw | 5,094 張短曝光 raw 影像,搭配 424 張長曝光參考(Sony 與 Fuji)。極低光、raw 到 sRGB。 |
| MIT-Adobe FiveK [55] | 成對、修圖 | 5,000 張 raw 照片,每張由五位專家修圖。用於色調與色彩增強(照片修圖)。 |
| SICE [56] | 多重曝光序列 | 每個場景從曝光不足到過曝的多張拍攝與一張參考;用來訓練曝光校正(例如 Zero-DCE)。 |
| VE-LOL [4] | 成對+偵測 | VE-LOL-L 用於增強,VE-LOL-H 附有人臉標註,用於高階任務評估。 |
| ExDark [57] | 非配對、有標註 | 7,363 張低光影像、12 個物件類別、10 種光照條件。以任務為導向的評估(偵測)。 |
| LIME [17]、MEF [58]、NPE [18]、DICM [59]、VV [60] | 非配對測試集 | 小型的真實低光或光照不均照片集,用於視覺比較與無參考指標。 |
挑戰賽:NTIRE 2024 與 2025
CVPR 的 NTIRE workshop 連續兩年舉辦 LLIE 挑戰賽。NTIRE 2024 挑戰賽 [61] 涵蓋超高解析度(4K 以上)、不均勻照明、逆光、極暗與夜景等情境,共有 428 人註冊、22 隊有效提交。NTIRE 2025 挑戰賽 [62] 有 762 人註冊、28 隊有效提交。這些報告整理了勝出隊伍的設計,是「在固定且公平的協定下什麼方法有效」的一個好切面。
現代觀點
這個領域在不到十年內從手工先驗走到學習模型,但原文 [1] 提出的核心問題依然相同:如何描述光、如何處理雜訊,以及如何判斷輸出好不好。下面幾篇綜述是最好的入門點。
Li 等人,TPAMI 2022 [2]。 引用最多的深度 LLIE 綜述。它依學習策略(監督式、強化學習、非監督式、零樣本與半監督式學習)、網路結構、是否使用 Retinex 模型、資料格式(sRGB 或 raw)、損失函數,以及訓練與測試資料來整理方法。它也提出了 LLIV-Phone:一個由多款手機相機在各種光照下拍攝的影像與影片資料集,以及一個比較方法的線上平台。主要結論是泛化落差(許多方法在手機資料上表現不佳),以及指標分數與視覺品質經常不一致。
Zheng 等人,“Low-Light Image and Video Enhancement: A Comprehensive Survey and Beyond” [3]。 以類似的分類回顧傳統與深度方法,並在資料上更進一步:提出 SICE_Grad 與 SICE_Mix(在單張影像中混合曝光不足與過曝),以及 Night Wenzhou(空拍與街景的夜間影片集),用來測試現有基準沒涵蓋的情況。原文的概觀圖也出自這篇。
Liu 等人,IJCV 2021 [4]。 “Benchmarking low-light image enhancement and beyond” 與其說是綜述,不如說是基準:VE-LOL 資料集提供成對資料與人臉標註,以全參考、無參考與語意指標進行比較,並提出一個增強加偵測的聯合模型。它讓以任務為導向的評估成為主流。
Liu 與 Fan,Neurocomputing 2025 [5]。 這篇綜述追問哪種增強真正幫得上下游視覺任務,並發現前述畫質指標與任務表現之間的脫節,其中零樣本方法帶來最一致的任務提升。
Adhikarla 等人,2025 [6]。 一篇關於擴散模型 LLIE 的綜述,提出六類分類法並做效能分析。它的訊息是:擴散模型帶來真實感與彈性,但推論成本很高,因此加速、引導與潛在空間設計是目前的熱門方向。
NTIRE 報告 [61], [62]。 它們不是綜述,但呈現了頂尖隊伍在共同協定、高解析度與困難光照下的實際做法。
目前的最先進技術(2023–2026)。 主要有三個方向。第一,Retinex 引導的骨幹網路:保留「光與反射率」結構的 Transformer(Retinexformer [26])與狀態空間模型(RetinexMamba [42])。第二,生成模型:擴散模型(Diff-Retinex [38]、GSAD [39]、LightenDiffusion [40]、Reti-Diff [41])與 flow(LLFlow [37])。第三,更好的表示法與評估協定:學習出來的色彩空間(HVI-CIDNet [27])、考慮亮度不匹配的訓練與評估(GT-Mean loss [51])、語言引導與 all-in-one 復原(CLIP-LIT [36]、InstructIR [43]),以及任務感知的增強(MAET [45]、FeatEnHancer [46])。
未解決的問題。
- 真實雜訊。 多數 sRGB 方法使用的訓練資料,其雜訊與經過相機處理流程後的真實感測器雜訊不相符。更好的雜訊模型 [7]、raw 域訓練 [44],或增強與去噪的聯合處理仍是核心課題。
- 影片一致性。 逐影格增強會閃爍。成對的影片資料(SDSD [54])稀少,時間一致性依然困難,對生成模型尤其如此。
- 評估。 亮度目標本身是病態的、GT-mean 協定、無參考指標對曝光不可靠,以及感知指標與任務指標的落差,都讓比較結果很脆弱。
- 邊緣裝置上的效率。 手機與車輛需要即時、低功耗的模型。曲線方法(Zero-DCE++ [34]、SCI [35])與輕量的先驗式網路 [28] 證明了極小的模型也能運作,而擴散模型對這類用途仍然太慢。
- 泛化。 在某個資料集或相機上訓練的模型,換到另一個常常失效([2] 所報告的泛化落差);混合過曝與曝光不足、逆光,以及有色人工光源仍然困難。
重點整理
- LLIE 是色調強化加上復原:完美的亮度校正之後,雜訊、色偏與量化誤差依然存在(圖 1)。
- 亮度可以在獨立通道(、、、)中增強,但這個選擇會牽動飽和度。BT.601 亮度為 ; 是同一個亮度在 8 位元有限範圍下的寫法。
- Retinex 把影像表示為反射率乘上照度,;SSR、MSR、LIME 以平滑先驗估計 ,而反轉影像去霧的做法本質上建立在同一個假設上。
- 深度方法最好依訓練訊號分類:監督式、展開式、非配對(EnlightenGAN)、零參考(Zero-DCE、SCI、CLIP-LIT)與生成式(LLFlow、擴散模型)。Retinex 分解橫跨其中各類。
- Zero-DCE 的 LE 曲線 保留範圍與順序;它的無參考損失是先驗(曝光、灰色世界、平滑、對比),遇到真實雜訊與色彩鮮豔的場景時可能失效。
- 同時回報全參考、無參考與任務導向的結果,絕不混用 GT-mean 與標準數字,並記住 PSNR 較高不代表偵測更好。
練習
- 單調曲線。 證明 在 上單調不減,若且唯若 。 時會出什麼問題?
提示
導數為 ,對 是線性的,所以在 上的最小值出現在端點: 時為 , 時為 。兩者都 恰好等價於 。 時, 處的斜率為 ,接近白色的像素會隨輸入變亮而變暗,明暗順序反轉,在亮部造成假影。
- 迭代曲線的增益。 對很小的輸入 ,證明以固定 迭代八次大約會把 乘上 。用這個結果解釋為什麼零參考曲線方法會放大暗部雜訊,並提出一個能減輕問題的損失函數或架構修改。
提示
很小時 ,所以每一步都是 。 時就是 ,標準差為 的雜訊變成 。可能的修正:加入去噪分支或考慮雜訊的損失、在估計訊噪比低的地方限制 (類似 SNR-aware 的精神),或懲罰輸出中、平滑後的輸入所沒有的高頻能量。
- 兩個亮度公式。 一個 8 位元像素為 。計算它的 BT.601 全範圍亮度與有限範圍亮度,並說明兩者編碼的是同一個量。
提示
全範圍:。有限範圍:。換算回去:。唯一的差別是比例 與偏移量 16。
- 沒有真值的 Retinex 損失。 在 Retinex-Net 中,為什麼需要 ?描述一個能讓 的自我重建項與 都變成零、卻毫無用處的分解,並說明 如何排除它。
提示
令 (完全平滑)且 。每張影像都能被完美重建,平滑損失也為零,但根本沒有做任何分解。由於 ,這會讓 ,所以 很大。要求兩者反射率相等,就迫使兩張影像之間的亮度差異被放進照度裡。
- 手算 GT-mean。 你的模型輸出平均為 0.40,真值平均為 0.50,除了這個整體倍率之外輸出完美無缺。GT-mean 的縮放因子是多少?如果影像是常數,縮放前後的 PSNR 各是多少?為什麼縮放後的數字無法公平地與正常評估的方法比較?
提示
。縮放前:MSE ,PSNR dB。縮放後輸出等於參考,誤差為 0,PSNR 趨於無窮大。實際使用時方法永遠拿不到真值的平均,所以 GT-mean 數字獎勵的是正確的結構,卻忽略了任務中最難的部分:決定亮度。
- 更換色彩先驗。 在 PyTorch 小玩具中,把灰色世界損失換成保留輸入色度的損失,例如 。重新訓練,並把咖啡杯的結果與圖 7 比較。兩種先驗各在什麼情況下較好?
提示
分母要加上一個小 epsilon。保留輸入色度能讓紅褐色的杯子維持紅色,但也會保留光源的色偏(例如鈉燈)。灰色世界能去除色偏,卻會讓真正色彩鮮豔的場景褪色。實際的方法常結合較弱的色彩先驗,與從資料學到的色彩校正。
參考文獻
- Shyandram,〈簡介Deep Learning Low-Light Image Enhancement (LLIE)〉,部落格文章,2024;2026 年更新。連結
- C. Li, C. Guo, L. Han, J. Jiang, M.-M. Cheng, J. Gu and C. C. Loy, “Low-light image and video enhancement using deep learning: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 12, pp. 9396–9416, 2022. arXiv
- S. Zheng, Y. Ma, J. Pan, C. Lu and G. Gupta, “Low-light image and video enhancement: A comprehensive survey and beyond,” arXiv:2212.10772, 2022. arXiv
- J. Liu, D. Xu, W. Yang, M. Fan and H. Huang, “Benchmarking low-light image enhancement and beyond,” International Journal of Computer Vision, vol. 129, no. 4, pp. 1153–1184, 2021. doi project
- F. Liu and L. Fan, “A review of advancements in low-light image enhancement using deep learning,” Neurocomputing, vol. 652, art. 131052, 2025. arXiv
- E. Adhikarla, Y. Liu and B. D. Davison, “Diffusion models for low-light image enhancement: A multi-perspective taxonomy and performance analysis,” arXiv:2510.05976, 2025. arXiv
- A. Foi, M. Trimeche, V. Katkovnik and K. Egiazarian, “Practical Poissonian-Gaussian noise modeling and fitting for single-image raw-data,” IEEE Transactions on Image Processing, vol. 17, no. 10, pp. 1737–1754, 2008. doi
- ITU-R, “Recommendation BT.601-7: Studio encoding parameters of digital television for standard 4:3 and wide-screen 16:9 aspect ratios,” 2011. ITU
- S. M. Pizer, E. P. Amburn, J. D. Austin, et al., “Adaptive histogram equalization and its variations,” Computer Vision, Graphics, and Image Processing, vol. 39, no. 3, pp. 355–368, 1987. doi
- K. Zuiderveld, “Contrast limited adaptive histogram equalization,” in Graphics Gems IV, Academic Press, 1994, pp. 474–485. doi
- E. H. Land, “The retinex theory of color vision,” Scientific American, vol. 237, no. 6, pp. 108–128, 1977. doi
- D. J. Jobson, Z. Rahman and G. A. Woodell, “Properties and performance of a center/surround retinex,” IEEE Transactions on Image Processing, vol. 6, pp. 451–462, 1997. doi
- D. J. Jobson, Z. Rahman and G. A. Woodell, “A multiscale retinex for bridging the gap between color images and the human observation of scenes,” IEEE Transactions on Image Processing, vol. 6, no. 7, pp. 965–976, 1997. doi
- K. He, J. Sun and X. Tang, “Single image haze removal using dark channel prior,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 33, no. 12, pp. 2341–2353, 2011. doi
- X. Dong, Y. Pang and J. Wen, “Fast efficient algorithm for enhancement of low lighting video,” ACM SIGGRAPH 2010 Posters, 2010. SIGGRAPH history doi
- X. Dong, G. Wang, Y. Pang, W. Li, J. Wen, W. Meng and Y. Lu, “Fast efficient algorithm for enhancement of low lighting video,” in Proc. IEEE International Conference on Multimedia and Expo (ICME), 2011. doi
- X. Guo, Y. Li and H. Ling, “LIME: Low-light image enhancement via illumination map estimation,” IEEE Transactions on Image Processing, vol. 26, no. 2, pp. 982–993, 2017. doi
- S. Wang, J. Zheng, H.-M. Hu and B. Li, “Naturalness preserved enhancement algorithm for non-uniform illumination images,” IEEE Transactions on Image Processing, vol. 22, no. 9, pp. 3538–3548, 2013. doi
- K. G. Lore, A. Akintayo and S. Sarkar, “LLNet: A deep autoencoder approach to natural low-light image enhancement,” Pattern Recognition, vol. 61, pp. 650–662, 2017. doi
- L. Tao, C. Zhu, J. Song, T. Lu, H. Jia and X. Xie, “Low-light image enhancement using CNN and bright channel prior,” in Proc. IEEE International Conference on Image Processing (ICIP), 2017, pp. 3215–3219. doi
- C. Wei, W. Wang, W. Yang and J. Liu, “Deep retinex decomposition for low-light enhancement,” in Proc. British Machine Vision Conference (BMVC), 2018. arXiv project
- Y. Zhang, J. Zhang and X. Guo, “Kindling the darkness: A practical low-light image enhancer,” in Proc. ACM International Conference on Multimedia (ACM MM), 2019, pp. 1632–1640. doi
- Y. Zhang, X. Guo, J. Ma, W. Liu and J. Zhang, “Beyond brightening low-light images,” International Journal of Computer Vision, vol. 129, no. 4, pp. 1013–1037, 2021. doi
- S. W. Zamir, A. Arora, S. Khan, et al., “Learning enriched features for real image restoration and enhancement,” in Proc. European Conference on Computer Vision (ECCV), 2020, pp. 492–511. arXiv
- X. Xu, R. Wang, C.-W. Fu and J. Jia, “SNR-aware low-light image enhancement,” in Proc. IEEE/CVF CVPR, 2022, pp. 17693–17703. doi
- Y. Cai, H. Bian, J. Lin, H. Wang, R. Timofte and Y. Zhang, “Retinexformer: One-stage Retinex-based transformer for low-light image enhancement,” in Proc. IEEE/CVF ICCV, 2023. arXiv code
- Q. Yan, Y. Feng, C. Zhang, et al., “HVI: A new color space for low-light image enhancement,” in Proc. IEEE/CVF CVPR, 2025. arXiv
- S.-E. Weng, S.-G. Miaou and R. Christanto, “A lightweight low-light image enhancement network via channel prior and gamma correction,” International Journal of Pattern Recognition and Artificial Intelligence, vol. 39, no. 12, art. 2554013, 2025. doi code
- S.-E. Weng, C.-Y. Hsiao, L.-W. Lu, et al., “Rethinking theoretical illumination for efficient low-light image enhancement” (CPGA-Net+), arXiv:2409.05274, 2024. arXiv
- R. Liu, L. Ma, J. Zhang, X. Fan and Z. Luo, “Retinex-inspired unrolling with cooperative prior architecture search for low-light image enhancement,” in Proc. IEEE/CVF CVPR, 2021, pp. 10556–10565. arXiv
- W. Wu, J. Weng, P. Zhang, X. Wang, W. Yang and J. Jiang, “URetinex-Net: Retinex-based deep unfolding network for low-light image enhancement,” in Proc. IEEE/CVF CVPR, 2022, pp. 5891–5900. doi
- Y. Jiang, X. Gong, D. Liu, et al., “EnlightenGAN: Deep light enhancement without paired supervision,” IEEE Transactions on Image Processing, vol. 30, pp. 2340–2349, 2021. arXiv
- C. Guo, C. Li, J. Guo, et al., “Zero-reference deep curve estimation for low-light image enhancement,” in Proc. IEEE/CVF CVPR, 2020, pp. 1777–1786. arXiv
- C. Li, C. Guo and C. C. Loy, “Learning to enhance low-light image via zero-reference deep curve estimation,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 8, 2022. arXiv
- L. Ma, T. Ma, R. Liu, X. Fan and Z. Luo, “Toward fast, flexible, and robust low-light image enhancement,” in Proc. IEEE/CVF CVPR, 2022, pp. 5627–5636. arXiv
- Z. Liang, C. Li, S. Zhou, R. Feng and C. C. Loy, “Iterative prompt learning for unsupervised backlit image enhancement,” in Proc. IEEE/CVF ICCV, 2023. arXiv
- Y. Wang, R. Wan, W. Yang, H. Li, L.-P. Chau and A. C. Kot, “Low-light image enhancement with normalizing flow,” in Proc. AAAI Conference on Artificial Intelligence, vol. 36, no. 3, pp. 2604–2612, 2022. arXiv
- X. Yi, H. Xu, H. Zhang, L. Tang and J. Ma, “Diff-Retinex: Rethinking low-light image enhancement with a generative diffusion model,” in Proc. IEEE/CVF ICCV, 2023. arXiv
- J. Hou, Z. Zhu, J. Hou, H. Liu, H. Zeng and H. Yuan, “Global structure-aware diffusion process for low-light image enhancement,” in Advances in Neural Information Processing Systems (NeurIPS), 2023. arXiv
- H. Jiang, A. Luo, X. Liu, S. Han and S. Liu, “LightenDiffusion: Unsupervised low-light image enhancement with latent-Retinex diffusion models,” in Proc. European Conference on Computer Vision (ECCV), 2024. arXiv
- C. He, C. Fang, Y. Zhang, et al., “Reti-Diff: Illumination degradation image restoration with Retinex-based latent diffusion model,” in Proc. International Conference on Learning Representations (ICLR), 2025. proceedings
- J. Bai, Y. Yin, Q. He, Y. Li and X. Zhang, “RetinexMamba: Retinex-based Mamba for low-light image enhancement,” arXiv:2405.03349, 2024. arXiv
- M. V. Conde, G. Geigle and R. Timofte, “InstructIR: High-quality image restoration following human instructions,” in Proc. European Conference on Computer Vision (ECCV), 2024. arXiv
- C. Chen, Q. Chen, J. Xu and V. Koltun, “Learning to see in the dark,” in Proc. IEEE/CVF CVPR, 2018, pp. 3291–3300. arXiv
- Z. Cui, G.-J. Qi, L. Gu, S. You, Z. Zhang and T. Harada, “Multitask AET with orthogonal tangent regularity for dark object detection,” in Proc. IEEE/CVF ICCV, 2021. arXiv
- K. A. Hashmi, G. Kallempudi, D. Stricker and M. Z. Afzal, “FeatEnHancer: Enhancing hierarchical features for object detection and beyond under low-light vision,” in Proc. IEEE/CVF ICCV, 2023. arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image quality assessment: From error visibility to structural similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The unreasonable effectiveness of deep features as a perceptual metric,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- A. Mittal, R. Soundararajan and A. C. Bovik, “Making a ‘completely blind’ image quality analyzer,” IEEE Signal Processing Letters, vol. 20, no. 3, pp. 209–212, 2013. doi
- A. Mittal, A. K. Moorthy and A. C. Bovik, “No-reference image quality assessment in the spatial domain,” IEEE Transactions on Image Processing, vol. 21, no. 12, pp. 4695–4708, 2012. doi
- J. Liao, S. Hao, R. Hong and M. Wang, “GT-Mean loss: A simple yet effective solution for brightness mismatch in low-light image enhancement,” in Proc. IEEE/CVF ICCV, 2025. arXiv
- W. Yang, W. Wang, H. Huang, S. Wang and J. Liu, “Sparse gradient regularized deep Retinex network for robust low-light image enhancement,” IEEE Transactions on Image Processing, vol. 30, pp. 2072–2086, 2021. doi
- J. Hai, Z. Xuan, R. Yang, et al., “R2RNet: Low-light image enhancement via Real-low to Real-normal Network,” Journal of Visual Communication and Image Representation, vol. 90, art. 103712, 2023. arXiv
- R. Wang, X. Xu, C.-W. Fu, et al., “Seeing dynamic scene in the dark: A high-quality video dataset with mechatronic alignment,” in Proc. IEEE/CVF ICCV, 2021, pp. 9680–9689. doi code
- V. Bychkovsky, S. Paris, E. Chan and F. Durand, “Learning photographic global tonal adjustment with a database of input/output image pairs,” in Proc. IEEE CVPR, 2011, pp. 97–104. dataset
- J. Cai, S. Gu and L. Zhang, “Learning a deep single image contrast enhancer from multi-exposure images,” IEEE Transactions on Image Processing, vol. 27, no. 4, pp. 2049–2062, 2018. doi
- Y. P. Loh and C. S. Chan, “Getting to know low-light images with the Exclusively Dark dataset,” Computer Vision and Image Understanding, vol. 178, pp. 30–42, 2019. arXiv
- K. Ma, K. Zeng and Z. Wang, “Perceptual quality assessment for multi-exposure image fusion,” IEEE Transactions on Image Processing, vol. 24, no. 11, pp. 3345–3356, 2015. doi
- C. Lee, C. Lee and C.-S. Kim, “Contrast enhancement based on layered difference representation of 2D histograms,” IEEE Transactions on Image Processing, vol. 22, no. 12, pp. 5372–5384, 2013. doi
- V. Vonikakis, “Datasets” (source of the VV test images), personal web page. link
- X. Liu, Z. Wu, A. Li, et al., “NTIRE 2024 challenge on low light image enhancement: Methods and results,” in Proc. IEEE/CVF CVPR Workshops, 2024. arXiv
- X. Liu, Z. Wu, F.-A. Vasluianu, et al., “NTIRE 2025 challenge on low light image enhancement: Methods and results,” in Proc. IEEE/CVF CVPR Workshops, 2025. arXiv