簡介Deep Learning Low-Light Image Enhancement (LLIE)
2026 年 10 月更新: 原文寫於 2024 年 6 月。此後 LLIE 主要往 Diffusion 生成式方法、Transformer / Mamba 骨幹的 Retinex 架構,以及包含低光任務的 all-in-one 復原模型發展,NTIRE 2024、2025 也連續舉辦 LLIE 挑戰賽。本次只補充標示清楚的段落(新方法、資料集、挑戰賽與幾則更正),原文不變,文末附延伸閱讀。
簡單介紹LLIE
2024/6/1 原理及文章大綱
2024/6/5 補一些例子和連結
預備知識、任務屬性
目的
把圖片從Dark to Bright(Normal Exposure),強化圖片「前景」內的細節。有別於Image 2 Image translation,並不是轉換圖片的屬性,而是把被Dark破壞的圖片細節及色調還原。因此,可以將此任務簡單的分為兩個難點:色調強化、細節還原。
在深度學習LLIE,由於細節還原本身就是深度學習網路的標的本身,因此在設計上不見得會針對此點再深入探討,而將重點放在其圖片及學習性質上,也就是色調強化(圖片的某些特性)、細節還原(學習機制),而不會有特別的細節還原。
Outline
- Non-DL LLIE & LLIE characteristic
- DL LLIE
- Evaluation
- Benchmark Datasets
- Reference
1. Non-DL LLIE & LLIE characteristic
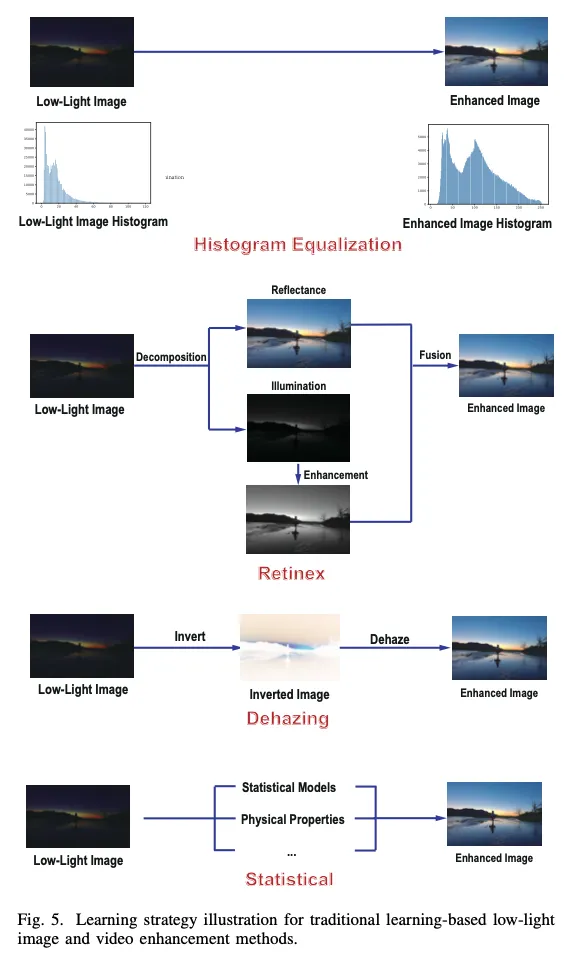
From Low-Light Image and Video Enhancement: A Comprehensive Survey and Beyond
基本上可以分為兩大流派:Histogram Equalization 和 Retinex (以理論為基礎,其中也可包含Dehazing),並配合Statistical方法延伸
1–1. 低光度影像在色彩空間上的特性
在影像處理中,有不少特型可以直接連結到低光度等曝光不足的圖片,特別是「色彩空間」
有許多color space representation都特別把「曝光」這項特性納入考量,又可稱作 “Illumination”, “Brightness”, “Lightness” and “Lumination”. 例如:HSV, HSI, YUV (YCbCr), LAB
首先,假設原始取得的影像為RGB三通道影像
HSV中Value代表三通道最大值(又稱亮通道,與除霧中暗通道對比)
V = max(R, G, B)HSI中Intensity則是三通道的平均
I = mean(R, G, B)YUV中Y則代表Luminance
Y = 0.257 * R + 0.504 * G + 0.098 * B更正: 原文提到 YUV 中 Y 為
0.257R + 0.504G + 0.098B,更精確的說法是:這是 BT.601 8-bit 有限範圍的 YCbCr 係數,完整式子還要加上偏移量 16;全範圍(如 JPEG)則是Y = 0.299R + 0.587G + 0.114B(Wikipedia: YCbCr)。不影響「單獨增強亮度」的論點。
換而言之,既然能拆解,那對此分量單獨增強便是一種解決方式
1–2. Histogram Equalization
在數位影像處理中,最基本和最先學習的影像處理法直方圖等化。而對彩色影像,通常會轉換至特定色彩空間以直方圖增強特定分量後再還原至原始空間(E.g. RGB to LAB (L represents Luminance) to RGB)
E.g. CLAHE
1–3. Retinex
Retinex源自Land的論文,描述接收到的視覺可以用以下公式簡略概述:
I = L R
# I 是接收到的訊息
# L 是 Luminance
# R 是 Reflectance, 反射分量,代表物體本身
更正: 原文提到 L 是 Luminance,更精確的說法是:Retinex 模型中的 L 是照度(Illumination),Luminance 通常指色彩空間裡的亮度通道(如上一節的 Y);模型為逐像素相乘,常寫成 。
以文字敘述,就是「接收到的影像是由亮度的分量和物體本身的反射決定」,反射分量被假設為恆久不變並不受環境影響;而亮度分量則代表著環境本身,亦即空間的變化(亮度)。
雖然是一個比較簡易的模型,但也足夠對任務進行假設。那麼在影像增強上,任務就變成想盡辦法「取得R」
(SSR 取原始圖片和設計出的L取log相減, 由於是對彩色影像,L 通常簡化以模糊後的影像取代;MSR則是取三個預設的尺度計算後融合)
E.g. SSR, MSR, MSRCR, MSRCP
1–4. Other Theorem and Retinex
當然,並不是只有Retinex的理論可以描述接收影像的過程,其中最常使用的就是大氣散射模型 (Atmospheric Scattering Model, ATSM)。
I = t J + (1 - t) AATSM被廣泛用於除霧的影像復原(當然理論上適用於所有影像復原任務),但除霧的ATSM卻不能直接應用在LLIE,因為圖片特性仍具壹定的相異性。
故此,Dong’14發現反轉後的低光度影像可以適用於大氣散射模型的假設。因此將改寫,順利以此解決低光度問題
更新(2026): Dong 等人「反轉低光影像後套用去霧演算法」的做法,在 SIGGRAPH 2010 已有發表,同團隊 2011 年的相關論文見 arXiv。
I from ATSM = (1 - I from Retinex)
J from ATSM = (1 - R from Retinex)
以另一個角度而言(結果論),普遍除霧任務假設暗通道可代表無霧區域,而低光度受到「暗」的影響,暗通道會涵蓋大量的被破壞區域,注重的則會是亮通道(或稱作被影響相對比較少的區域)
另外,在LIME中對兩者公式進行深入探討,可以發現兩者實質上是相同的假設,但Retinex較為簡化
最具盛名的方法就是LIME,結合最佳化及Retinex理論進行影像增強
https://ieeexplore.ieee.org/document/7782813
2. DL LLIE
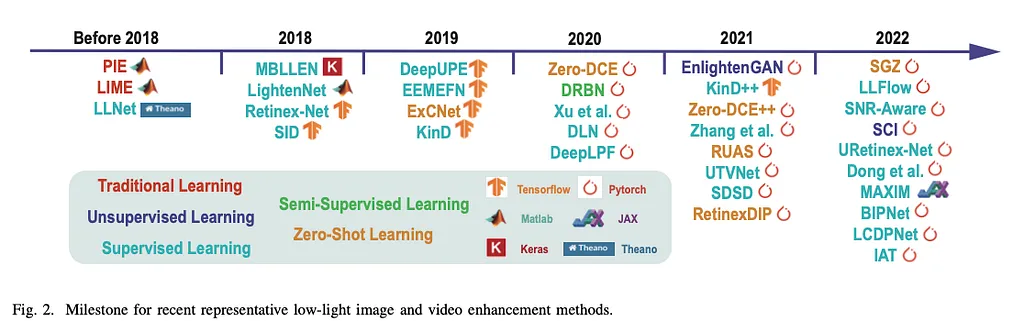
Low-Light Image and Video Enhancement: A Comprehensive Survey and Beyond
深度學習本身就是一種相當複雜的最佳化過程,更因其Black Box特性,更簡化設計上的假設和增強的做法。
普遍上可以用簡單的分類法分為兩類,以理論為基礎(通常是Retinex)和非以理論假設(強學習能力的模型)。當然,更多的發展基本上都是兩者交織,不完全可以用二元的方式進行分類。
2–1. 基於理論假設的方法
RetinexNet (2018)的假設有別於「取得R」,而是假設「輸入及輸出都有個別的R&L」,換而言之,代表其增強過程可以被敘述為:分解出R&L, 強化L to L hat, 融合R & L hat。這種做法也是現今主流之一,例如KinD (2019), Retinexformer、URetinex-Net等。(大家取名時Retinex大多都會出現在名字)
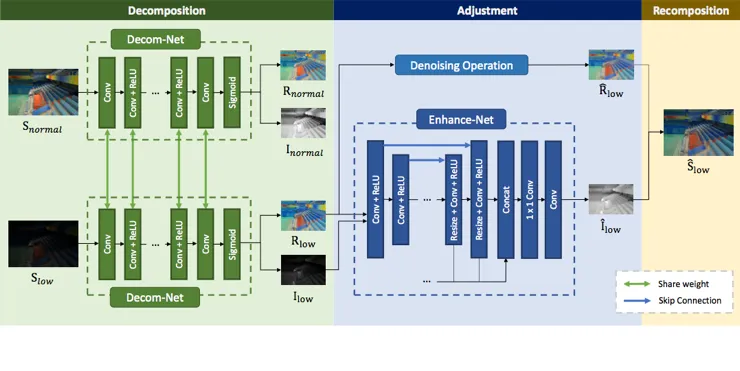
RetinexNet
BMVC2018 Deep Retinex Decomposition
前面也有提及色調強化、細節還原兩項任務的困難點。在早期的深度學習方法下,亦有被考慮至其設計(雖然兩者本來就都是最佳化的標的)。下圖方法先處理去噪再針對對比度調整。對比度調整的部分採取ATSM的增強法進行。
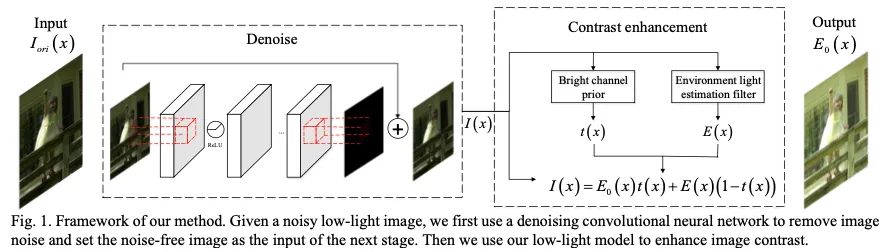
DOI: 10.1109/ICIP .2017.8296876
另外,我的研究成果是使用大氣散射模型的假設(目前比較少見使用ATSM非單純Retinex)為基礎建構,並配合全域局部的影像處理方法影像增強。另外,也觀察到深度學習下不同功能性模組學習到的特徵(相似於比較深度學習剛導入時對各層的探討),可以觀察到深度學習在某種程度仍是受自然的特性引導的現象,而非完全的不可理解黑箱。
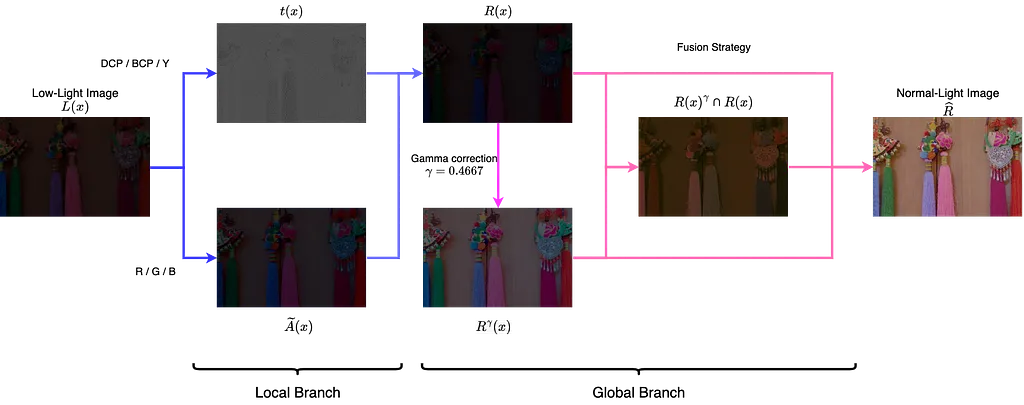
- GitHub - Shyandram/CPGA-Net-Pytorch
- GitHub - Shyandram/CPGA-Net_Plus: This is the implementation of CPGA-Net+ based on Pytorch.
Retinex × Transformer / Mamba(2026 補充)
上文提到的 Retinexformer(ICCV 2023)後來成為常見基準,以單階段訓練取代多階段流程。
2024 年起 Mamba(State Space Model)也被引入,例如 RetinexMamba: Retinex-based Mamba for Low-light Image Enhancement(2024)。「Retinex 分解+新骨幹」仍是很穩定的設計模式。
2–2.非基於理論假設的方法
現今的model則隨著深度和學習機制的深入研究而有相當多樣的方法。
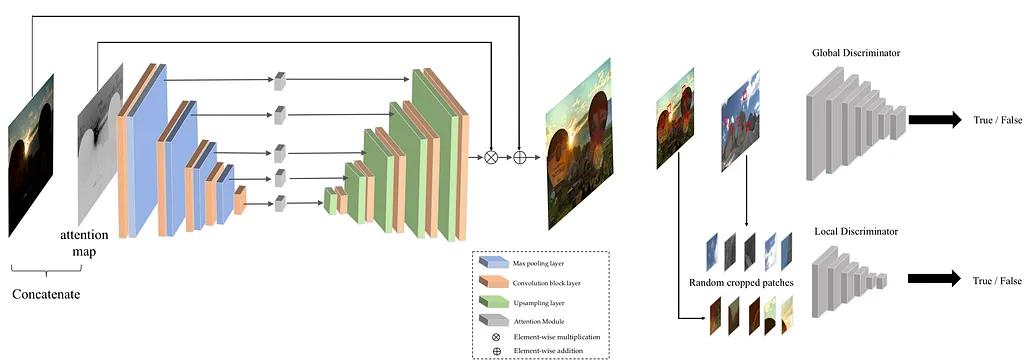
EnlightenGAN (2021),以GAN (生成對抗網路)…
LLFlow (2022)以normalizing flow為基礎,以反向的方式學習照明場景的多樣性質,並將其映射至高斯分佈中。其概念也有以理論的先驗特徵引導學習,Encoder中以直方圖等化、Color map (Retinex中的R)、Noise map (前面所提細節還原處理的雜訊)
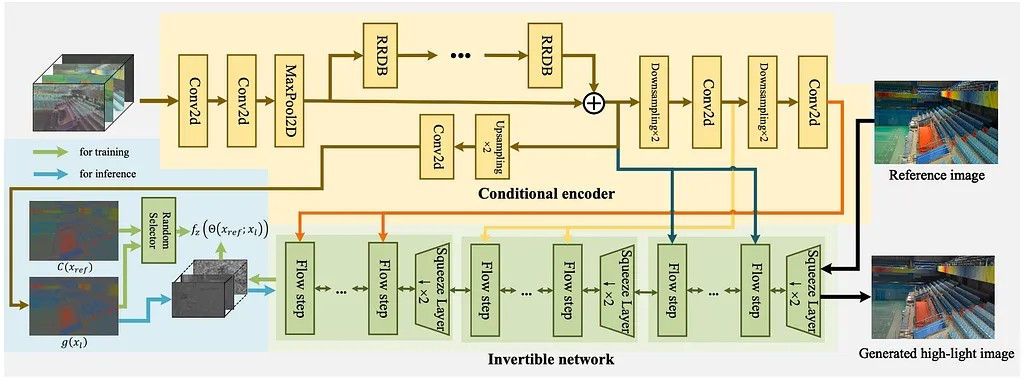
LLFlow
MIRNet(2020)以尺度、解析度和連接機制組合,將空間的特征以不同的截取方式組合,達到優異的效果。
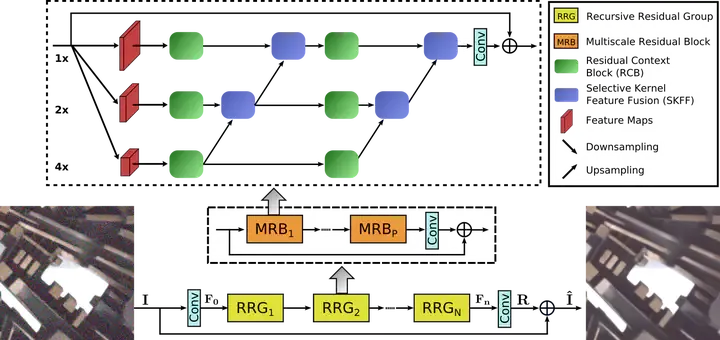
MIRNet
(後續待補充)
Diffusion、色彩空間與 All-in-One(2026 補充)
Diffusion。 接續 LLFlow「學習正常光分佈」的思路,2023 年後 Diffusion 大量進入 LLIE:Diff-Retinex: Rethinking Low-light Image Enhancement with A Generative Diffusion Model(ICCV 2023)先做 Retinex 分解再以條件式 Diffusion 補回細節;Global Structure-Aware Diffusion Process for Low-Light Image Enhancement(NeurIPS 2023)加入以影像結構為依據的曲率正則化。代價是多步推論較慢。
色彩空間。 呼應第 1–1 節,HVI: A New Color Space for Low-light Image Enhancement(HVI-CIDNet,CVPR 2025;arXiv 初版題為 You Only Need One Color Space)設計可訓練的 HVI 色彩空間與雙分支網路,減少色偏與亮度假影。
All-in-One。 低光增強也成為通用復原模型的任務之一,例如 InstructIR: High-Quality Image Restoration Following Human Instructions(ECCV 2024)以文字指令處理去噪、去霧與(低光)增強等任務。
2–3. Unsupervised LLIE(待補充)
Zero-DCE (2020)
利用迭代多次Light-Enhancement Curve的方式,預測不同階段的參數Alpha,以校正的方式做影像增強。
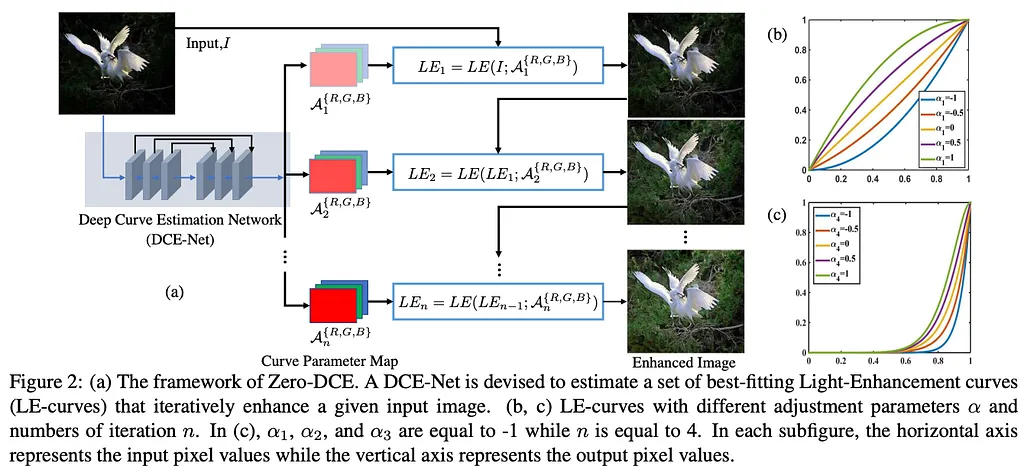
GitHub - Li-Chongyi/Zero-DCE: Zero-DCE code and model
SCI (2022)
亦使用迭代的方式,以F作為亮度預測及Self-Calibrate加強使訓練時各階段收斂到相同狀態。實際使用僅需一次F的計算。
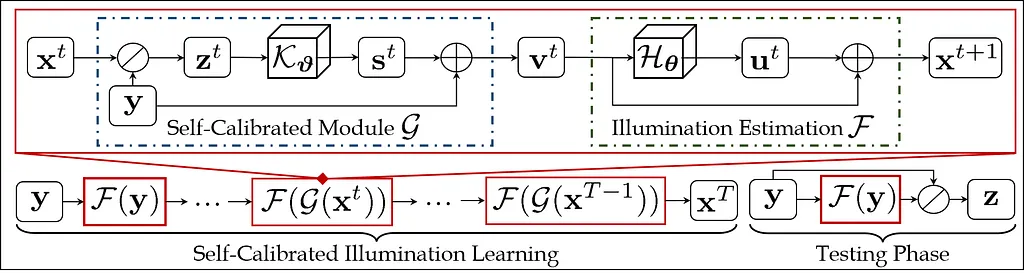
Zero-DCE 之後(2026 補充)
- Learning to Enhance Low-Light Image via Zero-Reference Deep Curve Estimation(Zero-DCE++,TPAMI 2021):Zero-DCE 的期刊延伸版。
- Iterative Prompt Learning for Unsupervised Backlit Image Enhancement(CLIP-LIT,ICCV 2023):以 CLIP 與迭代 prompt learning 做無監督的逆光影像增強。
3. Evaluation
3–1. Image quality assessment
PSNR, SSIM, LPIPS
NIQE BRISQUE
3–2. High-level task
Object Detection, Instance Segmentation
更新(2026): 除了「先增強再偵測」,也有直接增強特徵的做法,如 FeatEnHancer(ICCV 2023)。2025 年的 A review of advancements in low-light image enhancement using deep learning 指出畫質指標較高的監督式方法不一定最利於下游任務,zero-shot 方法反而提升較一致。
4. Benchmark Dataset
4–1. Low-Level Vision Task (without paired data)
- LIME/MEF/VV/DICM…
BMVC2018 Deep Retinex Decomposition
4–2. Low-Level Vision Task (with paired data)
- LOL dataset (v1)
BMVC2018 Deep Retinex Decomposition
- LOL dataset (v2)
GitHub - flyywh/CVPR-2020-Semi-Low-Light
- VE-LOL
Benchmarking Low-Light Image Enhancement and Beyond
- MIT-Adobe 5K
- SICE
以另一個任務MEF (Multi-exposure image fusion)中underexposure作為數據的驗證庫。
- SID
更新(2026): 上方連結是 SNR-Aware 的實作;SID 本身出自 Learning to See in the Dark(CVPR 2018),為 RAW 短曝光/長曝光配對。
其他常見的真實成對資料集(2026 補充)
- LSRW:R2RNet: Low-light Image Enhancement via Real-low to Real-normal Network(J. Vis. Commun. Image Represent., 2022)提出的大規模真實場景成對資料集。
- SDSD:Seeing Dynamic Scene in the Dark: High-Quality Video Dataset with Mechatronic Alignment(ICCV 2021),時空對齊的低光/正常光影片配對(indoor/outdoor),也常拆成影格評估。
4–3. High-level Vision Task
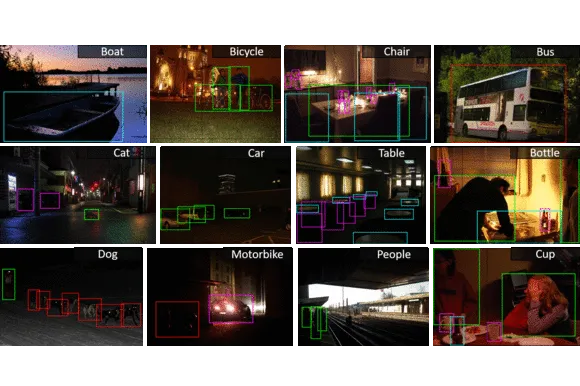
- ExDark
高階任務(物件偵測)的驗證
- Dark Face
DARK FACE: Face Detection in Low Light Condition
4–4. 挑戰賽(2026 補充)
CVPR NTIRE workshop 在 2024、2025 年都舉辦了 LLIE 挑戰賽,2024 年題目涵蓋超高解析度、不均勻照明、背光、極暗與夜景等情境:
- NTIRE 2024 Challenge on Low Light Image Enhancement: Methods and Results:428 人註冊、22 隊有效提交。
- NTIRE 2025 Challenge on Low Light Image Enhancement: Methods and Results:762 人註冊、28 隊有效提交。
Reference
待補充完善
Low-Light Image and Video Enhancement: A Comprehensive Survey and Beyond
Low-Light Image and Video Enhancement: A Comprehensive Survey and Beyond
Low-Light Image and Video Enhancement Using Deep Learning: A Survey (Github有簡中版可供參考)
Low-Light Image and Video Enhancement Using Deep Learning: A Survey
自己的文獻探討和經驗
延伸閱讀(2024–2026)
- Survey:Diffusion Models for Low-Light Image Enhancement: A Multi-Perspective Taxonomy and Performance Analysis(2025)
- Survey:A review of advancements in low-light image enhancement using deep learning(2025)
- 挑戰賽:NTIRE 2024、NTIRE 2025
- 方法:Retinexformer、RetinexMamba、Diff-Retinex、GSAD、HVI-CIDNet、Zero-DCE++、CLIP-LIT、FeatEnHancer、InstructIR
- 資料集:LSRW、SDSD、SID
原文發表於 medium.com