ML 02・類神經網路:從感知器到深度網路
先備知識: ML 01・機器學習入門
你將學到
- 感知器(perceptron)是什麼、它的學習規則如何運作,以及它和邏輯迴歸(logistic regression)到底差在哪裡。
- 把層疊起來如何得到多層感知器(multilayer perceptron, MLP)、通用近似定理(universal approximation theorem)保證了什麼、沒保證什麼,以及「深」究竟是什麼意思。
- 目前常用的激活函數(sigmoid、tanh、softmax、ReLU、Leaky ReLU、GELU、SiLU/Swish、SwiGLU)與正規化層(BatchNorm、LayerNorm、RMSNorm),連同公式與導數。
- 如何讓輸出層搭配正確的損失函數,以及反向傳播(backpropagation)如何算出每一個梯度:我們會為兩層網路親手推導,並用 NumPy 做數值檢查。
- 實務上怎麼訓練:初始化、SGD、momentum、Adam 與 AdamW、學習率排程、batch size、梯度裁剪(gradient clipping),以及怎麼讀損失曲線。
- 如何診斷欠擬合(underfitting)與過擬合(overfitting)、對付過擬合的正則化工具,以及殘差連接(residual connection)如何一路通往 Transformer。
先看全貌
類神經網路是一個帶有許多可調旋鈕(也就是參數)的函數。它接收輸入,例如影像的像素或平面上一個點的兩個座標,然後產生輸出,例如類別標籤。所謂訓練,就是每次把旋鈕轉動一點點,讓模型在已知範例上的輸出越來越接近正確答案。本篇的所有內容都在回答三個問題之一:這個函數長什麼樣子(架構)、怎麼衡量「更接近」(損失函數),以及怎麼把旋鈕轉好(最佳化)。
為什麼重要:今天在影像、語音與語言領域的幾乎所有系統,都是由本篇介紹的零件組成的。卷積網路、Transformer 和擴散模型(diffusion model)用的是同一套材料:線性層、非線性激活函數、正規化、殘差連接、損失函數、反向傳播,以及自適應最佳化器。把這些弄清楚之後,深度學習系列談的就只是如何為影像排列這些零件。
感知器
白話版。 感知器是最簡單的人工神經元。它把每個輸入乘上一個權重,加總後再加上偏差(bias),總和為正就回答「是」,否則回答「否」。它只在答錯時才微調權重,藉此學習。
模型
Rosenblatt 在 1958 年提出感知器,作為大腦如何儲存與辨識圖樣的模型 [4]。對輸入向量 ,它計算
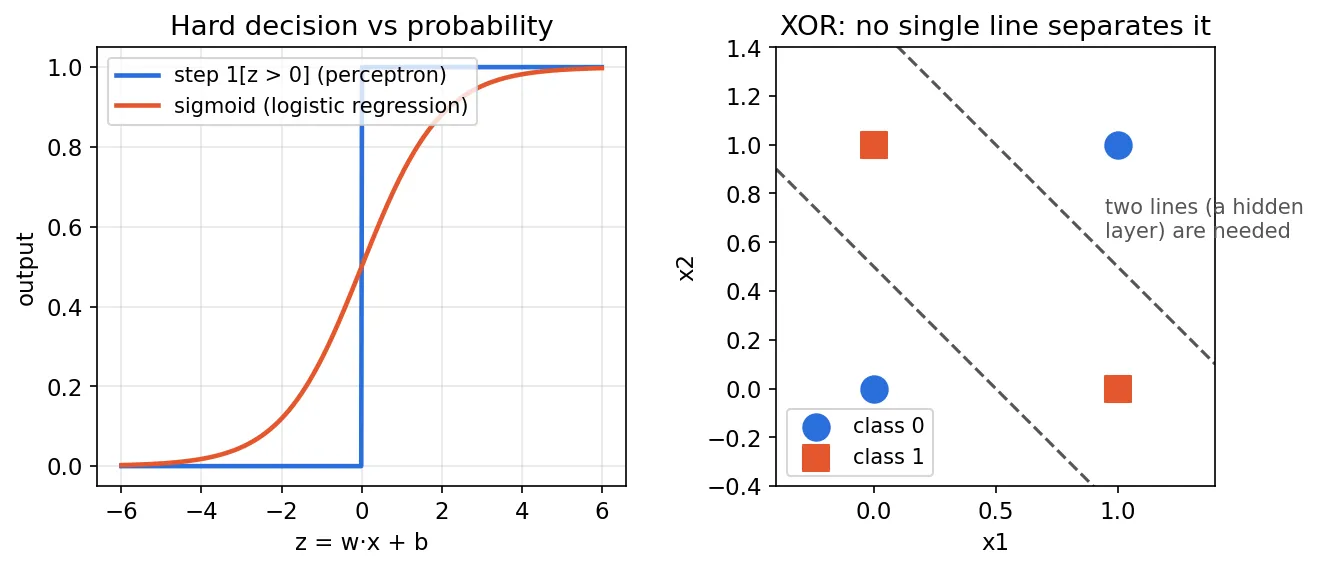
其中 是權重向量, 是偏差, 是激活前的值(pre-activation,即加權和), 是指示函數(條件成立時為 1,否則為 0), 是預測類別。這個指示函數就是階梯函數(step function)。從幾何上看, 是一個超平面(在二維中是一條直線),感知器依照點落在超平面的哪一側來分類。
感知器學習規則
把訓練範例 一個一個拿來看。每看一個,就算出 並更新
其中 是學習率(步長), 是真實標籤。預測正確時 ,什麼都不變。如果感知器答 0 但正確答案是 1,權重會往 的方向移動,下次遇到這個輸入時 就會變大;反方向的錯誤則讓權重遠離它。當兩個類別可以被一個超平面分開(資料線性可分)時,這個規則在有限次更新後就不會再犯錯;如果不可分,它永遠不會停下來。
import numpy as np

def perceptron_train(X, y, epochs=20, eta=1.0):
    """X: (N, d),y 為 0 或 1。回傳 w, b。"""
    w, b = np.zeros(X.shape[1]), 0.0
    for _ in range(epochs):
        mistakes = 0
        for x_i, y_i in zip(X, y):
            y_hat = float(w @ x_i + b > 0)       # 階梯函數
            if y_hat != y_i:                     # 只在答錯時更新
                w += eta * (y_i - y_hat) * x_i
                b += eta * (y_i - y_hat)
                mistakes += 1
        if mistakes == 0:
            break
    return w, b

# AND 線性可分;XOR 不是
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
for name, y in [("AND", [0, 0, 0, 1]), ("XOR", [0, 1, 1, 0])]:
    w, b = perceptron_train(X, np.array(y, float))
    print(name, (X @ w + b > 0).astype(int))
# AND [0 0 0 1]
# XOR [1 1 0 0]   <- 錯了:沒有任何一條直線能做到
感知器與邏輯迴歸的差別
這兩個模型很容易混淆,因為第一步完全相同,都是 。但它們是不同的方法:
| 感知器 | 邏輯迴歸 | |
|---|---|---|
| 輸出函數 | 階梯: | sigmoid: |
| 輸出意義 | 0/1 的硬決策 | 機率 |
| 訓練方式 | 感知器規則,只在答錯時更新 | 以梯度下降最小化交叉熵(最大概似) |
| 資料不可分時 | 永不收斂 | 收斂到定義明確的最佳解 |
邏輯迴歸對單一範例的損失梯度是 ,所以梯度下降的一步是 。這看起來幾乎和感知器規則一模一樣,但 是介於 0 與 1 之間的機率,因此每一個範例都有貢獻,而且非常有把握又答對的範例貢獻很小。正是這種平滑性,讓邏輯迴歸可以用梯度下降訓練,也讓它能被疊成更大的可微分網路。相對地,階梯函數幾乎處處導數為零,梯度根本無法通過它。
多層感知器(MLP)
白話版。 一個神經元只能畫一條直線。把很多神經元並排就有很多條直線,再把它們的輸出送進下一層組合起來,組合的結果可以彎曲,網路就能切出彎曲的區域。
把層疊起來
只有一個隱藏層的 MLP 計算
其中 是輸入, 與 是第一層的權重與偏差, 是寬度(隱藏單元數), 是逐元素作用的非線性激活函數(activation function), 是隱藏表示, 與 把它映射到 個輸出, 則是依任務選擇的輸出函數(見後文)。每個隱藏單元都是一個「類似邏輯迴歸」的神經元;「多層感知器」這個名字是歷史沿用,現代 MLP 用的是平滑的激活函數,不是階梯函數。
非線性 是關鍵。少了它, 又只是一個線性映射:再多層的線性層都會塌縮成一層,網路依然只能畫一個超平面。以 XOR 為例,兩個隱藏單元可以各畫出圖 1 中的一條虛線,輸出單元再回答「是否落在兩條線之間」。
通用近似
Cybenko 在 1989 年證明:只要隱藏層夠寬,一個由 sigmoid 型單元組成的隱藏層,就能在有界的方塊(單位超立方體)上以任意精度逼近任何連續函數 [5]。後續研究把結果推廣到其他激活函數,包括 ReLU。這個定理令人安心,但要仔細讀:
- 它講的是存在性。它只說合適的權重存在,完全沒說梯度下降找不找得到。
- 它沒說「夠寬」到底要多寬。對某些函數,所需的寬度會隨輸入維度極快地成長。
- 它沒談泛化:把訓練點擬合得很好,不代表能準確預測新的點。
所以這個定理說明了 MLP 在原理上夠有彈性,而本篇其餘部分談的,正是它留下來的那些實務問題。
深度神經網路:深度與寬度
白話版。 「深」只是代表依序疊了很多層。並沒有一個官方的層數門檻,超過就算深。
深度神經網路(deep neural network, DNN)是具有多個隱藏層的 MLP 或其他層狀網路:,,且 。「深」沒有公認的門檻。常見的非正式說法是隱藏層超過一層就算深,但各教材計算總層數或隱藏層數的方式不同,所以「三層」在不同書裡指的東西也不一樣。重要的是概念而不是數字:深度網路是把很多簡單步驟組合(composition)起來得到答案。
增加模型能力有兩種方式:寬度(每層更多單元)與深度(更多層)。兩者並不等價。加寬是多放幾塊只組合一次的零件;加深則讓網路重複利用前面各層的特徵,建構出更抽象的特徵。LeCun、Bengio 與 Hinton 的回顧論文 [2] 正是以此解釋深度學習的成功:每一層都把前一層的表示轉換成稍微抽象一點的表示,疊很多這樣的層,網路就能直接從原始資料學到非常複雜的函數,而且特徵是學出來的,不是人工設計的。
從歷史來看,1990 年代以淺層方法為主流。支持向量機(SVM)是當時的主要工具,它是一種核方法(kernel method),並不是很寬的類神經網路;那時深度網路很難訓練。從 2000 年代中期開始,更多的資料、GPU 與更好的訓練技巧讓深度變得可行,深度網路開始在一個又一個基準測試中勝出 [2]。不過深度並不是全部:單純疊更多普通的層,最後反而會讓訓練變差,這個問題要靠殘差連接才得以解決(見最後一個主要章節)。
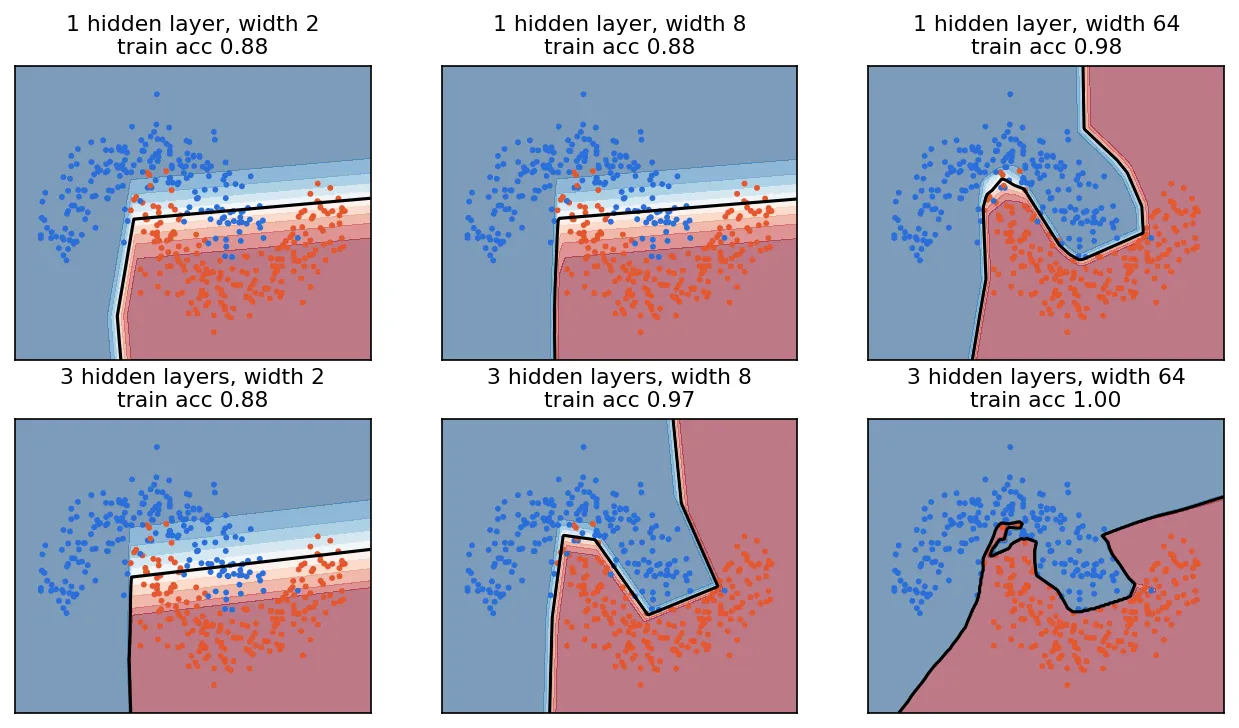
圖 2 以 scikit-learn 的雙月形(two moons)資料集展示寬度與深度的作用。一層只有 2 或 8 個隱藏單元時,邊界只由少數幾段直線組成,無法沿著月牙走。更寬或更深的網路能把邊界彎曲到貼合資料;最寬又最深的那個甚至繞著個別的雜訊點打轉,這是過擬合的第一個徵兆。
激活函數
白話版。 激活函數是每次加權和之後加上的「彎曲」。沒有它,整個網路就只是直線模型。不同的彎曲方式在平滑度、速度,以及梯度能否順利通過很多層之間取捨。
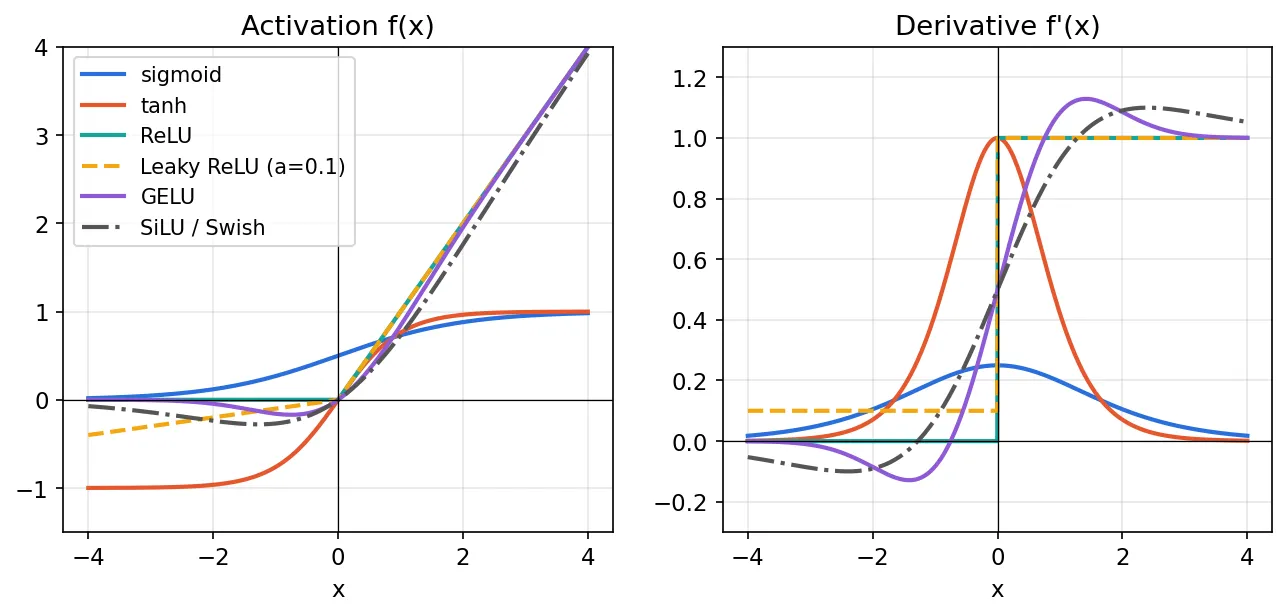
圖 3 畫出常見的選擇與它們的導數。導數和函數本身一樣重要,因為反向傳播會一層一層地把導數乘起來(見訓練章節)。
Sigmoid 與 tanh
Sigmoid 把任何實數映射到 ;tanh 映射到 ,並以零為中心。兩者都會飽和(saturate): 很大時曲線很平,導數幾乎為零,梯度幾乎過不去。Sigmoid 的導數最大只有 (在 )。這兩件事讓深層 sigmoid 網路很難訓練,Glorot 與 Bengio 對此有詳細分析 [17]。今天 sigmoid 主要用在二元分類器的輸出與門控機制(例如下面的 SwiGLU),tanh 則出現在某些遞迴網路中。
Softmax
Softmax 把 個實數分數組成的向量 (稱為 logits)轉成機率分布:
其中 時 為 1,否則為 0。每個 都是正數,而且總和為 1。和本節其他函數不同,softmax 作用在整個向量上,而不是逐元素作用,所以幾乎只用在多類別分類器的輸出層(以及 attention 內部),不當作隱藏層的激活函數。寫程式時,先減去 再取指數;結果不變,但可以避免溢位。
ReLU 與 Leaky ReLU
整流線性單元(rectified linear unit, ReLU)讓正的輸入原封不動通過,其餘歸零。它對所有正輸入的導數恰好是 1,所以梯度通過活躍單元時不會縮小,而且計算成本極低。ReLU 是讓深層監督式網路不必靠非監督式預訓練也能訓練起來的改變之一 [2]。它的弱點是死亡 ReLU(dying ReLU):如果某個單元對所有範例的輸入都是負的,它的梯度就是零,從此不再學習。Leaky ReLU 在負側保留一個小斜率 (例如 0.01),讓一些梯度永遠能流過。Dubey、Singh 與 Chaudhuri 的激活函數綜述 [7] 把這些以及後來的許多變體歸為 ReLU 家族。
GELU 與 SiLU/Swish
這些是 ReLU 的平滑版本,會讓小的負值通過:
其中 是標準常態分布的累積分布函數(CDF), 是它的密度函數 [8]。GELU 不像 ReLU 依正負號硬切,而是依輸入的大小來加權: 是標準常態隨機變數小於 的機率。常用的快速近似是 [8]。GELU 是許多 Transformer 模型的預設激活函數。
sigmoid 加權線性單元(SiLU)由 Elfwing、Uchibe 與 Doya 為強化學習提出 [9]。Ramachandran、Zoph 與 Le 以自動搜尋找到同樣的形狀, 可固定或可學習,並稱之為 Swish [10]; 時 Swish 就是 SiLU。GELU 和 SiLU 長得非常像(圖 3)。兩者都不是單調函數:對中等大小的負輸入,它們會稍微低於零。
SwiGLU:帶門控的前饋區塊
門控線性單元(gated linear unit, GLU)把兩個線性投影逐元素相乘,其中一個先通過一個像閘門一樣的非線性函數。Shazeer 在 Transformer 的前饋(feed-forward)區塊中測試了幾種變體 [11]。SwiGLU 版本以論文的列向量寫法、且省略偏差,寫成
其中 是大小為 的列向量, 與 是 矩陣, 是 矩陣, 是逐元素相乘。在 Shazeer 的實驗中,包括 SwiGLU 與 GEGLU 在內的 GLU 變體,表現都優於該區塊的 ReLU 與 GELU 版本。由於 SwiGLU 有三個權重矩陣而不是兩個, 要縮小為原本的 ,參數量才會相同 [11]。例如 LLaMA 就以 SwiGLU 取代 ReLU,隱藏維度用 [12];SwiGLU 已成為大型語言模型的常見預設。
| 激活函數 | 值域 | 平滑 | 目前的典型用途 |
|---|---|---|---|
| sigmoid | 是 | 二元/多標籤輸出、門控 | |
| tanh | 是 | 某些遞迴網路 | |
| softmax | 機率向量 | 是 | 多類別輸出、attention 權重 |
| ReLU / Leaky ReLU | / | 否(0 處有折角) | CNN、MLP,安全的預設 |
| GELU、SiLU | 約 、 | 是 | Transformer、現代 CNN |
| SwiGLU | 是 | Transformer 的前饋區塊 |
正規化層
白話版。 訓練進行中,網路內部流動的數值可能飄到很大或很小的尺度,讓學習變得不穩定。正規化層(normalization)在每一步把它們重新縮放到標準大小,再讓網路自己選擇偏好的最終尺度。
三種常見的正規化層共用同一個模板。對一組數值 ,
其中 與 是平均與變異數, 是為了數值安全的小常數, 是可學習的縮放與平移(如果有幫助,網路可以藉此還原正規化)。三者的差別在於哪些數值被放在同一組(圖 4)。
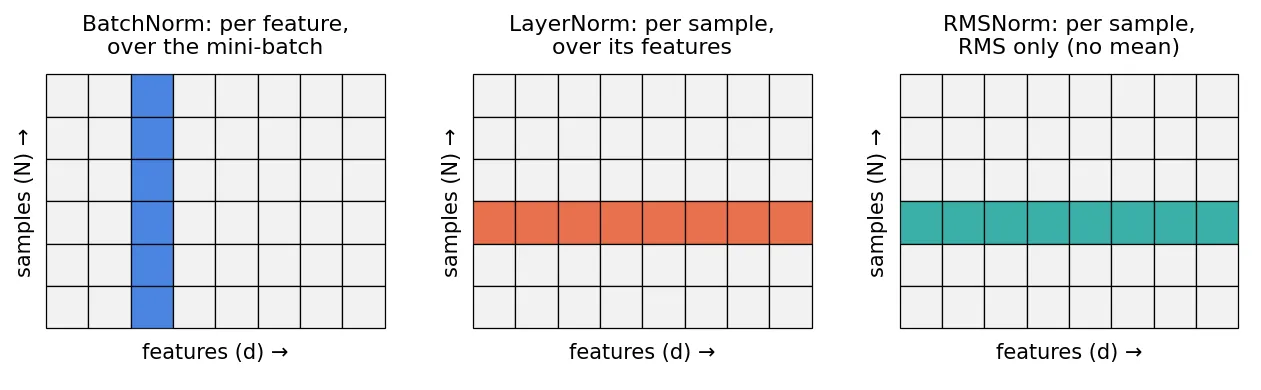
- BatchNorm(Ioffe 與 Szegedy [13])對每個特徵(在 CNN 中是每個通道)跨 mini-batch 計算 。它能加快訓練,成為 CNN 的標準配置。由於統計量取決於 batch,它在訓練與推論時的行為不同:推論時改用訓練期間累積的移動平均。batch 很小時統計量變得很吵,效果也會變差。
- LayerNorm(Ba、Kiros 與 Hinton [14])對單一樣本的所有特徵計算 。它與 batch 無關,訓練和測試時行為一致,也很自然地適用於序列。它是 Transformer 的標準正規化方式。
- RMSNorm(Zhang 與 Sennrich [15])省略減去平均的步驟,只除以均方根:。作者假設 LayerNorm 的重新置中(re-centering)是可有可無的,並報告品質相當而執行時間更短 [15]。LLaMA 採用 RMSNorm,並把它放在每個 Transformer 子層的輸入端(pre-normalization),而不是輸出端 [12]。
import torch

x = torch.randn(4, 8) * 5 + 3                       # 4 個樣本、8 個特徵
ln = torch.nn.LayerNorm(8, elementwise_affine=False)
bn = torch.nn.BatchNorm1d(8, affine=False)
rms = x / torch.sqrt(x.pow(2).mean(dim=1, keepdim=True) + 1e-6)

print(ln(x).mean(dim=1))     # 每個樣本(列)約為 0
print(bn(x).mean(dim=0))     # 每個特徵(欄)約為 0(訓練模式)
print(rms.pow(2).mean(dim=1))  # 每個樣本約為 1:RMS 為 1,但平均沒有被移除
Huang 等人 [16] 的綜述整理了這個家族,並把任何正規化方法拆成三個選擇:哪些數值放在一起(正規化區域)、做什麼運算(標準化、置中、縮放或白化),以及之後如何還原表示(可學習的仿射步驟)。BatchNorm、LayerNorm 與 RMSNorm 主要差在前兩項。
設計輸出層與選擇損失函數
白話版。 最後一層必須說答案的語言:數量就輸出任意實數,是非題就輸出機率,「 選一」就輸出機率分布。每種輸出都有一個天生搭配的損失函數,下表就是該用的組合。
| 任務 | 輸出層 | 輸出範圍 | 損失函數 |
|---|---|---|---|
| 迴歸 | 線性(不加激活函數) | 均方誤差(MSE,L2)或平均絕對誤差(MAE,L1) | |
| 二元分類 | 1 個單元 + sigmoid | 二元交叉熵(binary cross-entropy) | |
| 多標籤(多個是非題) | 個單元,各接 sigmoid | 每個標籤各算二元交叉熵 | |
| 多類別( 選一) | 個單元 + softmax | 機率向量 | 交叉熵(cross-entropy) |
常見的錯誤是在迴歸輸出接 sigmoid。sigmoid 的值域是開區間 ,它的工作是為二元或多標籤分類輸出機率。迴歸的輸出層通常是線性的,才能輸出任何實數。只有當目標值本身已知落在 0 到 1 之間(例如正規化後的像素強度或比例)時,迴歸輸出接 sigmoid 才合理。
對單一範例,損失函數為
其中 是目標,,, 是 one-hot 標籤, 是正確類別。(MSE 的 只是為了方便;PyTorch 的 MSELoss 取平均且不含這個因子。)MAE 即 ,比 MSE 更不受離群值影響。每一組搭配都是最大概似估計:MSE 對應目標上的高斯雜訊,二元交叉熵對應 Bernoulli 標籤,交叉熵對應類別(categorical)標籤 [3]。
這些搭配還有一個漂亮的實務理由。三種情況下,損失對輸出層激活前的值的梯度都只是
這裡的 分別指線性輸出、 或 。會飽和的 sigmoid 或 softmax 導數被抵消掉了,所以即使模型非常有把握地答錯,梯度仍然很大。(練習 3 請你為 softmax 驗證這件事。)這也是為什麼框架會把最後的激活函數併進損失函數:PyTorch 的 nn.CrossEntropyLoss 與 nn.BCEWithLogitsLoss 接收的是 logits,所以模型本身在訓練時不能以 softmax 或 sigmoid 結尾。
訓練(一):前向傳遞與反向傳播
白話版。 前向傳遞(forward pass)從輸入到輸出逐層算出預測與損失。反向傳播再從損失往回走到輸入,用連鎖律(chain rule)算出每個權重對誤差的貢獻。它會重複利用中間結果,所以算出所有梯度的成本大約只等於多做一次前向傳遞。
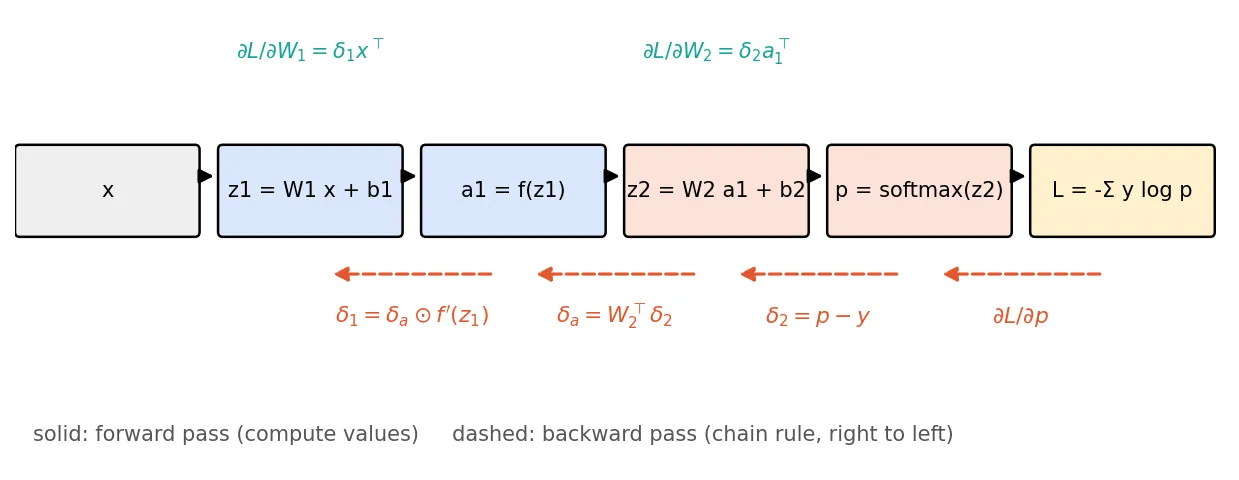
Rumelhart、Hinton 與 Williams 讓反向傳播成為訓練多層網路的普及方法 [6]。它其實就是微積分的連鎖律,只是安排得讓任何計算都不重複。圖 5 畫出我們要微分的網路的計算圖。
兩層 MLP 的推導
取一個範例 ,, 是 one-hot 標籤。前向傳遞為
其中 、, 是逐元素的激活函數。定義某一層的誤差訊號為損失對該層激活前的值的梯度:。
步驟 1:輸出層。 由上一節可知,softmax 搭配交叉熵給出
步驟 2:輸出層權重。 因為 ,所以 ,於是
一個權重的梯度等於(它輸出端的誤差)乘以(它輸入端的激活值)。形狀和 相同,這是很好用的檢查。
步驟 3:往回穿過線性層。 每個隱藏激活值 都影響所有輸出,所以它的梯度要對所有輸出加總:,寫成矩陣形式為
步驟 4:往回穿過激活函數。 因為 逐元素作用,它的 Jacobian 是對角矩陣,連鎖律就變成逐元素相乘:
步驟 5:第一層權重。 和步驟 2 完全一樣,
更深的網路只是重複步驟 3 到 5:,以及 。對 個範例組成的 mini-batch,損失取平均,所以每個梯度也是各範例梯度的平均。
用 NumPy 從零實作,並做梯度檢查
下面的程式把範例存成列(X 的形狀是 ),這是程式中常見的慣例。於是 X @ W1(W1 形狀為 )扮演數學式中 的角色,上面每個公式在程式裡都以轉置的形式出現:例如 dW2 = A1.T @ dZ2 就是把 沿 batch 疊起來。梯度檢查把一個解析導數和中央差分 比較;如果兩者在很多位數上都一致,反向傳遞就是對的。只要親手寫梯度,就一定要做這個檢查。
import numpy as np
from sklearn.datasets import make_moons

rng = np.random.default_rng(0)
X, y = make_moons(n_samples=200, noise=0.2, random_state=0)
N, d, h, K = X.shape[0], 2, 16, 2
Y = np.eye(K)[y]                                   # one-hot 目標,(N, K)

# He 式初始化(標準差 = sqrt(2 / fan_in))
W1 = rng.normal(0, np.sqrt(2 / d), (d, h)); b1 = np.zeros(h)
W2 = rng.normal(0, np.sqrt(2 / h), (h, K)); b2 = np.zeros(K)

def forward(X, W1, b1, W2, b2):
    Z1 = X @ W1 + b1                               # (N, h)
    A1 = np.maximum(Z1, 0)                         # ReLU
    Z2 = A1 @ W2 + b2                              # (N, K) logits
    Z2 = Z2 - Z2.max(axis=1, keepdims=True)        # 數值穩定
    P = np.exp(Z2) / np.exp(Z2).sum(axis=1, keepdims=True)
    loss = -np.mean(np.sum(Y * np.log(P + 1e-12), axis=1))
    return Z1, A1, P, loss

def backward(X, Z1, A1, P, W2):
    dZ2 = (P - Y) / N                              # 輸出層的 delta
    dW2 = A1.T @ dZ2;  db2 = dZ2.sum(axis=0)
    dA1 = dZ2 @ W2.T
    dZ1 = dA1 * (Z1 > 0)                           # ReLU'(z) = 1[z > 0]
    dW1 = X.T @ dZ1;   db1 = dZ1.sum(axis=0)
    return dW1, db1, dW2, db2

# 對 W1 的一個元素做梯度檢查(中央差分)
Z1, A1, P, loss = forward(X, W1, b1, W2, b2)
dW1, db1, dW2, db2 = backward(X, Z1, A1, P, W2)
eps = 1e-6; E = np.zeros_like(W1); E[0, 3] = eps
num = (forward(X, W1 + E, b1, W2, b2)[3] - forward(X, W1 - E, b1, W2, b2)[3]) / (2 * eps)
print(f"analytic {dW1[0, 3]:.8f}  numeric {num:.8f}")

# 單純的梯度下降
lr = 0.5
for step in range(2000):
    Z1, A1, P, loss = forward(X, W1, b1, W2, b2)
    dW1, db1, dW2, db2 = backward(X, Z1, A1, P, W2)
    W1 -= lr * dW1; b1 -= lr * db1; W2 -= lr * dW2; b2 -= lr * db2
acc = (P.argmax(axis=1) == y).mean()
print(f"final loss {loss:.3f}, train accuracy {acc:.3f}")
# analytic -0.01941581  numeric -0.01941581
# final loss 0.063, train accuracy 0.970
實務上你永遠不必自己寫反向傳遞:PyTorch 等框架會記錄前向計算,在你呼叫 loss.backward() 時自動執行完全相同的程序。但親手寫過一次,仍是理解這個呼叫在做什麼、以及為什麼計算圖中某處導數為零時它會失靈的最好方法。
訓練(二):讓最佳化真正可行
白話版。 只知道梯度還不夠。你還需要一個合理的起點(初始化)、把梯度變成步伐的規則(最佳化器)、隨時間改變的步長(排程)、每一步看多少範例的選擇(batch size),以及防止偶發超大步伐的保護(裁剪)。
梯度消失與梯度爆炸
把遞迴式 沿 層展開,第一層的梯度會包含 個權重矩陣與 個激活函數導數的連乘。如果典型的因子小於 1,連乘會隨深度指數縮小,前面的層幾乎學不到東西:這就是梯度消失(vanishing gradient)。用 sigmoid 時每個 最多 ,十層就可能把訊號縮小到 。如果典型因子大於 1,例如初始權重太大,連乘會指數成長,更新變得巨大,損失變成 inf 或 NaN:這就是梯度爆炸(exploding gradient)。
下面介紹的補救方法,從不同方向處理這個連乘:
- 在大範圍內導數為 1 的激活函數(ReLU 與它的平滑親戚);
- 讓訊號大小逐層保持不變的初始化;
- 重新標準化激活值的正規化層;
- 殘差連接,給梯度一條因子為 1 的通道(最後一個主要章節);
- 梯度裁剪,對付爆炸的標準緊急煞車。
有時也會列出其他做法,例如微調(fine-tuning)預訓練模型或改用較小的網路;它們讓整體訓練變得比較容易,但並不直接解決梯度問題。
權重初始化
如果所有權重一開始都相同,每個隱藏單元算的東西都一樣、拿到的梯度也一樣,它們就永遠一模一樣。所以權重要隨機初始化。尺度很重要:我們希望激活值(前向)與梯度(反向)的變異數在層與層之間大致維持不變。對有 個輸入、 個輸出的線性層:
- Xavier(Glorot)初始化 [17] 為 tanh 等對稱激活函數平衡前向與反向條件:,例如在 上均勻分布。
- He(Kaiming)初始化 [18] 考慮到 ReLU 會把約一半的輸入歸零,使每層的變異數減半,因此把尺度加倍:,例如 。
偏差通常從零開始。He 等人證明這種初始化能讓非常深的 ReLU 網路從零開始訓練 [18]。上面的 NumPy 範例就是用它。
最佳化器
下面每個最佳化器都是隨機梯度下降(stochastic gradient descent, SGD)的變體:在一個小的隨機 mini-batch 上估計梯度,往反方向走一步,然後重複。記 為第 步的 mini-batch 梯度, 為所有參數, 為學習率。
SGD。 。簡單、不需額外記憶體,但在狹長的山谷中會來回鋸齒狀前進,在平坦方向上又走得很慢。
SGD with momentum。 維持一個移動的速度:,, 約為 0.9。就像一顆沉重的球滾下山坡,它把鋸齒平均掉,並在方向一致時累積速度。
Adam(Kingma 與 Ba [19])為每個參數維持兩個移動平均,分別是梯度與梯度平方:
其中平方、開根號與除法都是逐元素運算,、 是衰減率, 是小常數。第一個平均就是 momentum。除以第二個平均的平方根,讓每個參數有自己的步長,這是 Adam 所借鏡的 RMSprop 的概念 [19]:梯度一直很大的參數走小步,很少被更新的參數走大步。偏差修正(bias correction) 是因為兩個平均都從零開始,若不修正,在最初幾步會太小。
AdamW(Loshchilov 與 Hutter [20])。權重衰減(weight decay)在每一步把權重往零縮。對單純的 SGD,這等同於在損失中加入 L2 懲罰 。對 Adam 則不然:L2 項會進入 ,再被 除掉,於是梯度大的權重反而被正則化得比較少。AdamW 把衰減和自適應步伐解耦:
作者證明這能改善 Adam 的泛化能力 [20],AdamW 現在是訓練 Transformer 與大型語言模型最常用的最佳化器。在 PyTorch 中,torch.optim.Adam(..., weight_decay=λ) 是耦合的 L2 版本,torch.optim.AdamW 才是解耦版本。
較新的最佳化器(簡述)。 有兩個近年的選項值得認識。Lion 是透過自動化的程式搜尋找到的 [21]:它只保留一個 momentum 緩衝區(所以比 Adam 省記憶體),並以內插後 momentum 的正負號(sign)更新每個參數,因此所有更新的大小都相同;它需要比 AdamW 更小的學習率。Muon [22] 作用在隱藏層的二維權重矩陣上:它取 momentum 更新,用幾次 Newton–Schulz 迭代把它近似正交化;嵌入層、輸出層、偏差以及其他純量或向量參數仍以 AdamW 訓練。Liu 等人報告,在加入權重衰減與逐參數更新尺度調整之後,Muon 在他們的運算最適(compute-optimal)大型語言模型訓練實驗中,達到約 AdamW 兩倍的運算效率 [23]。這些都還是活躍的研究主題;AdamW 仍是安全的預設。
學習率排程
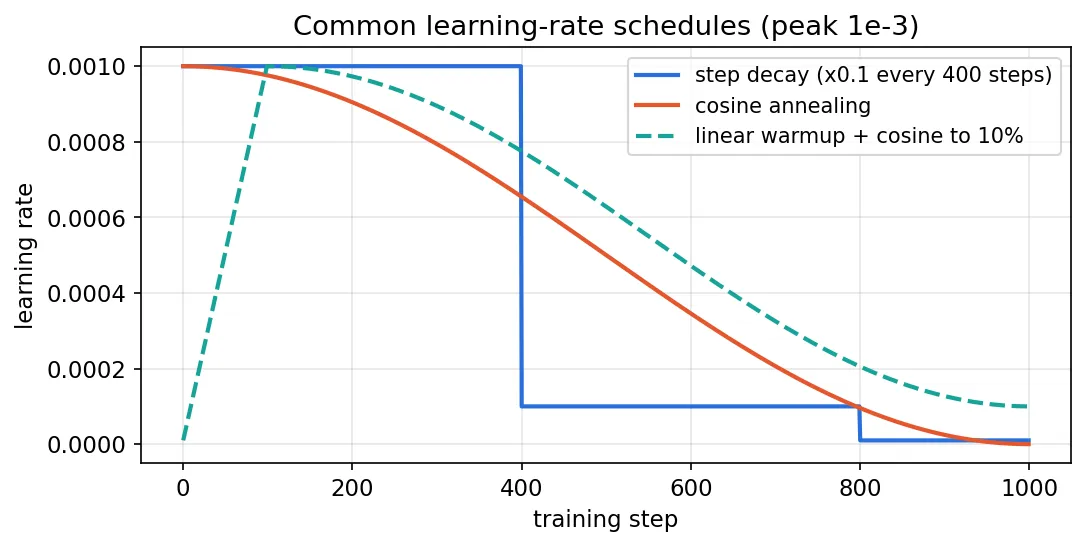
學習率通常是最重要的超參數。訓練初期合適的學習率,到後期常常太大,因為模型那時需要小而謹慎的步伐,所以學習率會隨時間改變(圖 6)。
- 階梯衰減(step decay):在固定的 epoch 把學習率乘上 0.1 之類的因子。以 SGD 訓練 CNN 的傳統做法。
- 餘弦退火(cosine annealing):,在 步內從 平滑降到 ;SGDR [24] 把它和週期性的熱重啟(warm restart)結合。
- 暖身(warmup):在最初幾百或幾千步內,把學習率從接近零線性升高。訓練初期 Adam 的二階動差估計很吵,權重也離任何好區域都很遠,直接用全尺寸的步伐可能造成不穩定。
以一個已發表的大型模型為具體例子:LLaMA 使用 AdamW(、)、權重衰減 0.1、梯度裁剪 1.0、2,000 步暖身,以及結束於峰值 10% 的餘弦排程 [12]。
Mini-batch、iteration 與 epoch
Mini-batch(常簡稱 batch)是用來做一次梯度估計的 個隨機範例。一次 iteration(迭代)是一次參數更新,使用一個 mini-batch。一個 epoch 是把整個訓練集完整走過一遍,對 個範例需要 次 iteration。例如 、 時,每個 epoch 有 391 次 iteration。
Batch size 同時影響速度與結果,而且並非越大越好:
- 小 batch 的梯度估計很吵(mini-batch 平均的變異數大約以 下降),所以損失曲線跳動,每個 epoch 要走很多步,硬體利用率也差。
- 大 batch 的梯度穩定,在 GPU 上平行效率高,但每個 epoch 的更新次數較少,而且在其他設定不變時往往泛化較差。Keskar 等人發現,大 batch 訓練傾向收斂到尖銳極小值(sharp minima),也就是解附近損失急遽上升的地方;小 batch 訓練則因為梯度雜訊,傾向找到泛化較好的平坦極小值(flat minima)[25]。
實務上,選一個能舒服放進記憶體、而且仍然訓練得好的最大 batch;改變 時要重新調整學習率,兩者交互作用很強。
梯度裁剪
即使網路設計得很好,偶爾某個 batch 也會產生巨大的梯度。梯度範數裁剪(gradient-norm clipping)在梯度範數超過門檻 時把整個梯度縮小:
其中 是把所有參數梯度串接起來後的範數。它保留方向、限制步伐大小,是對付梯度爆炸的標準防線,在遞迴網路與 Transformer 中尤其常用 [3]。門檻 1.0 是常見的選擇。
在 PyTorch 中組合起來
下面的程式以 mini-batch、AdamW、餘弦排程與梯度裁剪,在 make_moons 上訓練一個小型 MLP。在 CPU 上幾秒鐘就跑完。
import torch, torch.nn as nn
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
X, y = make_moons(n_samples=1000, noise=0.25, random_state=0)
Xtr, Xva, ytr, yva = train_test_split(X, y, test_size=0.3, random_state=0)
Xtr, Xva = torch.tensor(Xtr, dtype=torch.float32), torch.tensor(Xva, dtype=torch.float32)
ytr, yva = torch.tensor(ytr), torch.tensor(yva)

model = nn.Sequential(
    nn.Linear(2, 64), nn.ReLU(),
    nn.Linear(64, 64), nn.ReLU(),
    nn.Linear(64, 2),               # 輸出 logits:這裡不加 softmax
)
loss_fn = nn.CrossEntropyLoss()     # 內部會做 log-softmax
opt = torch.optim.AdamW(model.parameters(), lr=1e-2, weight_decay=1e-2)
sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=200)

for epoch in range(200):
    model.train()
    perm = torch.randperm(len(Xtr))
    for i in range(0, len(Xtr), 64):                # 每個 mini-batch 64 筆
        idx = perm[i:i + 64]
        loss = loss_fn(model(Xtr[idx]), ytr[idx])
        opt.zero_grad()
        loss.backward()                              # 反向傳播
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        opt.step()
    sched.step()

model.eval()
with torch.no_grad():
    acc = (model(Xva).argmax(dim=1) == yva).float().mean().item()
print(f"validation accuracy: {acc:.3f}")   # 約 0.94
注意 model.train() 與 model.eval():它們讓 dropout、BatchNorm 等層在訓練行為與推論行為之間切換。測試時忘了 eval() 是經典的 bug。
泛化:欠擬合、過擬合與正則化
白話版。 目標不是在訓練資料上表現好,而是在模型從沒看過的資料上表現好。模型有兩種相反的失敗方式:太弱,連訓練資料都學不會(欠擬合);或者把訓練資料連同雜訊一起背下來,遇到新資料就失敗(過擬合)。
模型能力與兩種失敗模式
模型的能力(capacity)粗略地說就是它能擬合多複雜的函數;它隨參數量、深度、寬度與訓練時間增加。能力提高時,訓練誤差持續下降,驗證誤差則先降後升,因為模型開始擬合雜訊。兩者之間的差距稱為泛化差距(generalization gap)[3]。
- 欠擬合:訓練誤差本身就很高。模型或訓練程序抓不到資料的規律。
- 過擬合:訓練誤差很低,但驗證或測試誤差高得多。
處理欠擬合,依序是:
- 先檢查程式與資料。 bug、輸入與標籤沒對齊、前處理錯誤,或損失套在錯誤的張量上,看起來都像欠擬合。
- 提高模型能力:更寬或更深的模型,或更好的架構。
- 改善最佳化:訓練更久、調整學習率與排程、換最佳化器、檢查初始化與正規化。
把模型變小永遠不能解決欠擬合,那只會讓能力更低。在準確率已經足夠之後,為了速度或記憶體選擇較小的模型是合理的,但那是效率上的考量,不是解方。
處理過擬合:用更多或更多樣的資料、加入正則化(見下文)、降低能力,以及提早停止。也值得確認訓練集和驗證集真的來自同一個分布;兩者不一致時看起來也像過擬合,但需要的是修正資料,而不是正則化。
讀懂損失曲線
把訓練損失與驗證損失都對 iteration 或 epoch 作圖。下面四種情況涵蓋大部分狀況:
- A. 兩條曲線一開始就是平的。 如果損失很高,模型根本沒在學:懷疑 bug、學習率太小或太大,或模型與資料不匹配。如果損失已經很低,可能是任務非常簡單,或每個記錄點之間隔了太多 iteration(一次記錄涵蓋的資料太多),把曲線的形狀藏起來了;請更頻繁地記錄。
- B. 訓練損失持續下降,驗證損失轉而上升。 典型的過擬合。保留驗證損失最低時的參數(提早停止),並加入正則化。
- C. 兩條曲線都下降,並在彼此接近處持平。 可能模型已接近最佳,這在訓練與驗證資料非常相似時很常見;或兩者都還很高,那就是欠擬合:訓練更久或提高能力。
- D. 驗證損失高於訓練損失,但兩者都穩定下降。 正常、健康的情況。繼續訓練,並保留驗證損失最低的檢查點。
正則化工具
圖 7 刻意製造過擬合,並展示兩種解法。一個很寬的 MLP(兩個各 256 單元的隱藏層)只用 100 個有雜訊的雙月形資料點訓練。沒有正則化時,訓練損失降向零,驗證損失則很早就到達最低點,接著急遽上升。權重衰減與 dropout 都大幅減緩了這個上升。
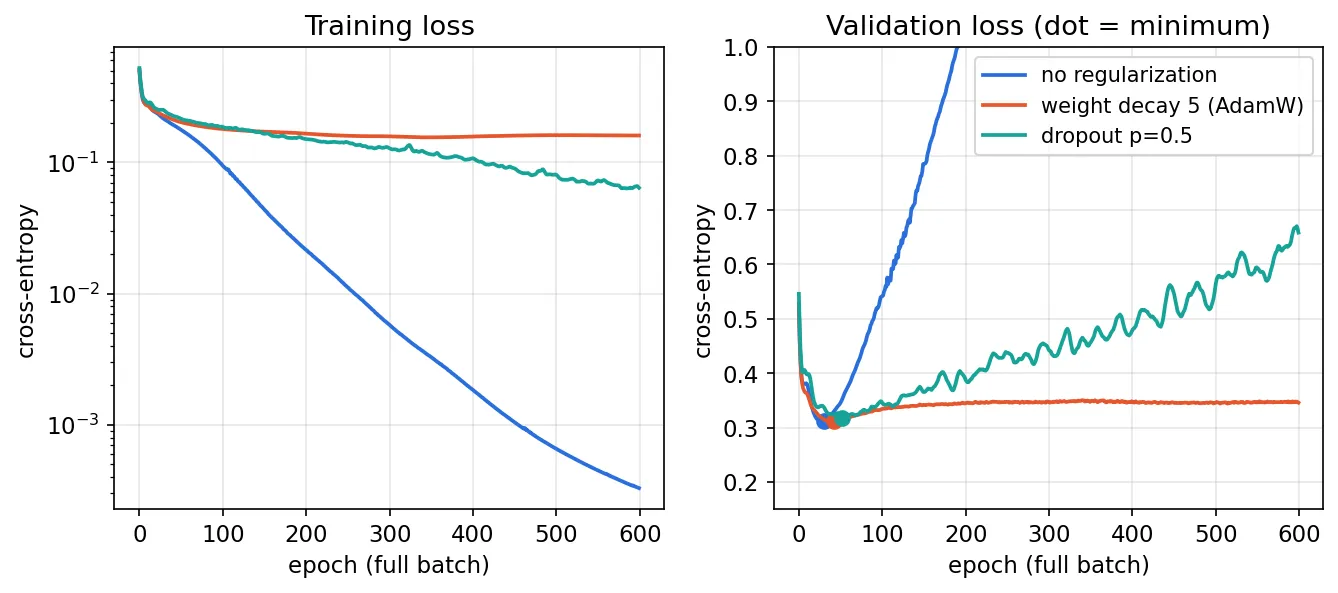
權重衰減(L2 正則化)。 在損失中加入 來懲罰大權重;使用 Adam 時則改用解耦的衰減(AdamW)。大權重讓網路能圍著個別資料點畫出尖銳、彎曲的邊界;讓權重保持小,就偏好較平滑的函數。在圖 7 中, 的解耦衰減讓驗證損失在最低點之後幾乎持平。
Dropout(Srivastava 等人 [27])。訓練時,每個隱藏單元以機率 被設為零,每個範例、每一步都獨立抽樣,存活的單元再乘上 ,讓激活值的期望不變(「inverted dropout」)。測試時使用所有單元,不做縮放。於是每一步訓練的都是一個不同的「變瘦」子網路;單元無法依賴特定的夥伴,必須學出本身就有用的特徵,而測試時的完整網路就像許多瘦網路的平均 [27]。這也是 model.eval() 很重要的原因。
資料擴增(data augmentation)。用不改變標籤的轉換產生新的訓練範例:對影像做翻轉、裁切、小角度旋轉、色彩抖動與加雜訊。它常常是影像領域最有效的單一正則化方法,因為它直接教模型該有的不變性。但它必須符合任務:水平翻轉對貓沒問題,對辨識文字就不行。
提早停止(early stopping)。訓練時監看驗證損失,保留它最低那個 epoch 的參數;如果連續若干個 epoch(「patience」)都沒有改善就停止。它不花成本、不必修改模型,並藉由限制參數能離初始值多遠而發揮正則化作用 [3]。
更多資料與更好的策略。 原始筆記列出的其他手段值得再強調:更多訓練資料是對付過擬合最可靠的方法;更強的架構(更深,或結構更好以利收斂)在模型欠擬合時有幫助;更好的訓練策略(最佳化器、學習率排程、batch size)則兩者都有幫助。
殘差連接與通往 Transformer 之路
白話版。 疊很多層時,每一層不但要改進訊號,還得把它完整傳下去,這其實很難。殘差連接給每個區塊一條快速道路:區塊只需要學一個加在輸入上的修正量。
He 等人觀察到,在已經很深的網路上再加普通的層,連訓練誤差都會變差;這是最佳化的問題,不是過擬合 [28]。他們的殘差區塊計算
其中 是區塊的輸入, 是一小疊層(在 ResNet 中是卷積加上 BatchNorm 與 ReLU)。如果一個區塊最好的做法是什麼都不做,它只需要把 推向零,這很容易。反向傳遞說明了為什麼它好訓練:
其中 是單位矩陣。單位項讓梯度直接穿過每一個區塊,所以許多區塊的連乘不再必然縮到零。靠著殘差連接,He 等人在 ImageNet 上訓練了多達 152 層的網路,並贏得 ILSVRC 2015 的多個項目 [28]。
Transformer(Vaswani 等人 [29])結合了本篇的每一個概念。每個區塊有兩個子層:多頭自注意力(multi-head self-attention,用 softmax 在不同位置之間混合資訊)與逐位置的 MLP,每個子層都包在殘差連接與 LayerNorm 裡。原始論文是在相加之後才正規化;許多近期模型(包括 LLaMA)改為正規化子層的輸入(pre-normalization),並使用 RMSNorm 與 SwiGLU [12]:
自 2017 年起,這個設計從機器翻譯擴展到語言模型、影像、語音等領域,也是今日大型語言模型的基礎。它的訓練方法同樣來自本篇:AdamW、暖身加餘弦衰減、梯度裁剪與權重衰減 [12]。深度學習系列會從這裡接著談用於影像的卷積網路與 Transformer,第一個任務是影像分類。
現代觀點
上述的基本工具已經穩定好幾年了;研究持續探討它們為什麼有效,以及每個零件更好的版本。以下幾篇回顧從不同角度提供了很好的導覽。
全貌:LeCun、Bengio 與 Hinton [2](Nature,2015)。 這篇短回顧至今仍是「深度學習是什麼」最清楚的說明:以多層進行表示學習(representation learning),每一層把前一層的表示轉成更抽象的表示,特徵以反向傳播從資料中學得,而不是人工設計。它介紹了以 SGD 進行的監督式學習、ReLU 的角色、處理影像的卷積網路、處理序列的遞迴網路,以及分散式表示(distributed representation),最後預測非監督式學習,以及表示學習與推理的結合,在未來會更加重要。若要以教科書的方式學習本篇的每個主題(包括損失函數的最大概似觀點、正則化與最佳化),Goodfellow、Bengio 與 Courville 的書 [3] 仍是標準參考。
最佳化:Sun [26]。 Sun 的綜述問的是「類神經網路何時、為什麼能被成功訓練?」,並把答案分成三部分:梯度的問題(爆炸、消失)以及透過謹慎的初始化與正規化來解決;實用的演算法(SGD、Adam 等自適應方法,以及分散式訓練)與它們的收斂理論;以及損失地形(loss landscape)的整體圖像,包括不好的局部極小值、模式連通性(mode connectivity)、樂透彩券假說(lottery ticket hypothesis)與無限寬度極限。它是從上述實務走向理論的好橋樑。
正規化:Huang 等人 [16](IEEE TPAMI,2023)。 這篇綜述從最佳化的角度給出正規化方法的統一觀點,並提出一套分類法,把任何方法拆成正規化區域、正規化運算與表示還原三部分。它涵蓋從 BatchNorm 開始的發展史、正規化為何能加速訓練並幫助泛化的分析,以及在不同領域的應用。讀它可以把 BatchNorm、LayerNorm、分組式與以權重為主的正規化,看成同一個設計空間中的不同點。
激活函數:Dubey、Singh 與 Chaudhuri [7](Neurocomputing,2022)。 這篇綜述把激活函數分為 logistic sigmoid/tanh 類、ReLU 類、ELU 類與可學習類,依值域、單調性與平滑性等性質加以描述,並在不同網路架構與資料類型上評測其中 18 種。它的實務訊息是:沒有哪一種激活函數處處最好,選擇會和架構與資料互相影響。
現況(2023–2026)。 從已發表的模型訓練配方可以看到幾個趨同的方向:
- 架構。 採用 pre-normalization 與殘差連接的 Transformer 區塊,是語言領域的主流架構,在影像領域也越來越普遍;RMSNorm 與 SwiGLU(如 LLaMA [12])是大型語言模型的常見預設。
- 最佳化。 AdamW [20] 搭配線性暖身、餘弦(或類似的)衰減與梯度裁剪是標準配方。不只做逐座標縮放的最佳化器是活躍的研究方向:Lion [21] 使用正負號更新、較省記憶體;Muon [22] 把矩陣更新正交化,並有在大規模下提升運算效率的報告 [23]。這些增益在不同任務與規模下有多穩健,仍在研究中,因此 AdamW 依然是安全的選擇。
- 泛化。 尖銳與平坦極小值的觀點 [25] 是有用的直覺,而不是完整的理論;高度過度參數化(over-parameterized)的網路為什麼還能泛化得這麼好,至今仍是開放問題,Sun 的綜述 [26] 整理了主要的研究方向。
開放問題。 深度網路可靠的泛化理論;同時選擇學習率、batch size 與排程的原則性規則,特別是在放大模型規模時;正規化、殘差連接與自適應最佳化器之間究竟如何交互作用;以及不靠目前配方中那些大量小技巧,也能在極大規模下穩定訓練。
重點整理
- 感知器是線性分數接上階梯函數,以「答錯才更新」的規則訓練;邏輯迴歸則用 sigmoid 機率與交叉熵。結構相似但方法不同,而且只有平滑的那一個能被疊起來並以梯度訓練。
- 具有非線性激活函數的隱藏層,才讓網路不只是線性模型。一個夠寬的隱藏層在原理上能逼近任何連續函數,但那只是存在性結果;深度讓有用的函數更容易被表示與學習。「深」沒有固定的層數定義。
- ReLU 家族(ReLU、Leaky ReLU、GELU、SiLU)讓梯度保持暢通;sigmoid 與 softmax 主要放在輸出層;SwiGLU 是 Transformer 前饋層的現代選擇。BatchNorm 沿 batch 正規化,LayerNorm 與 RMSNorm 沿單一樣本的特徵正規化。
- 輸出層要配合任務:迴歸用線性加 MSE,二元或多標籤用 sigmoid 加二元交叉熵,多類別用 softmax 加交叉熵。每種情況的輸出梯度都是預測減目標。
- 反向傳播是從損失往回套用連鎖律:,。親手寫的梯度要做數值檢查。
- 實務訓練:He 或 Xavier 初始化、AdamW 搭配暖身與衰減排程、梯度裁剪,以及和學習率一起選擇的 batch size,而不是「越大越好」。
- 欠擬合代表訓練誤差高,需要更多模型能力或更好的最佳化,絕不是更小的模型;過擬合則需要更多資料、資料擴增、權重衰減、dropout 與提早停止。
- 殘差連接讓非常深的網路可以訓練,而 Transformer 正是這些概念的集大成。
練習
- 手算感知器。 對 AND 資料執行感知器規則,、、,依 的順序拜訪各點。寫下每次更新後的 與 ,直到某個 epoch 完全沒有錯誤。接著用一句話解釋,為什麼同樣的程序用在 XOR 上永遠不會停。
提示
在嚴格判斷 下,第一個點 的 ,預測為 0,是正確的。第一個錯誤發生在 ,得到 、。繼續做下去:在標籤為 0 的點上犯錯就減去 和 1,在標籤為 1 的點上犯錯就加上它們。以這個順序,五個 epoch 內共更新十次,第六個 epoch 完全正確,此時 、,也就是直線 。換一個拜訪順序會得到另一條同樣有效的直線。對 XOR 而言,沒有任何 能把四個點全部分對,所以永遠有某個點是錯的,也就永遠會更新。
- sigmoid 的梯度消失得多快? 證明 。接著考慮一條由 20 個 sigmoid 層組成、所有權重都等於 1 的鏈。梯度在往回傳的路上,最多會被乘上多大的因子?對活躍單元的 ReLU 重做一次推理。
提示
在 上是開口向下的拋物線,在 有最大值 。二十個最多 的因子相乘,最多是 。對活躍的 ReLU 單元,,所以激活函數完全不會造成縮小;只有權重會,這就是初始化重要的原因。
- 「預測減目標」梯度。 利用 ,證明當 為 one-hot 時, 滿足 。再對 sigmoid 搭配二元交叉熵證明同樣的結果。
提示
,因為 。對 sigmoid,,且 ;相乘並化簡即得 。
- 擴充梯度檢查。 在 NumPy 範例中,把
W2、b1、b2的每個元素(而不只是W1的一個元素)都和有限差分比較,並回報最大相對誤差 。然後故意放一個 bug,例如拿掉* (Z1 > 0)這個因子,看看誤差會變多大。
提示
用 np.ndindex(param.shape) 跑過每個元素,把它擾動 並重新計算損失。正確的實作相對誤差約在 或更小(少數緊鄰 ReLU 折角的元素可能較大)。拿掉 ReLU 導數後,W1 與 b1 會出現量級為 1 的誤差,而 W2 與 b2 仍然正確,因為 bug 只在隱藏層以下的反向路徑上。
- Iteration、epoch 與 batch size。 某資料集有 60,000 張訓練影像。(a) 與 時,一個 epoch 各有多少次 iteration?(b) 兩者都訓練 20 個 epoch,各做了多少次參數更新?(c) 根據 batch size 的討論,舉出兩個理由說明在相同學習率下, 的執行可能得到較差的驗證準確率,並提出一個可能有幫助的調整。
提示
(a) 與 。(b) 37,500 次對 1,180 次更新。(c) 同樣的 epoch 數下更新次數少很多;梯度雜訊也較少,而尖銳極小值的研究把這和較差的泛化連在一起。常見的調整是針對新的 batch size 重新調學習率(通常調大,並加上暖身),以及訓練更多 epoch。
- 診斷曲線。 同事的網路訓練損失一開始下降很快,接著停在一個很高的值不動;驗證損失和它幾乎貼在一起。同事提議把隱藏單元數減半,「讓它收斂得快一點」。發生了什麼事?你會先檢查什麼?你會改提出什麼建議?
提示
兩條損失都很高而且彼此接近:這是欠擬合(數值偏高的情況 C),不是過擬合。先檢查 bug:標籤是否與輸入對齊、損失是否作用在 logits 上、資料是否已正規化、學習率是否合理。接著提高模型能力或改善最佳化(更寬或更深的模型、學習率排程、訓練更久)。把模型縮小會降低能力,只會讓欠擬合更嚴重。
參考文獻
- Shyandram, “機器學習及類神經網路筆記,” blog post, 2024; updated 2026. link
- Y. LeCun, Y. Bengio and G. Hinton, “Deep learning,” Nature, vol. 521, no. 7553, pp. 436–444, 2015. doi
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016. online book
- F. Rosenblatt, “The perceptron: A probabilistic model for information storage and organization in the brain,” Psychological Review, vol. 65, pp. 386–408, 1958. doi
- G. Cybenko, “Approximation by superpositions of a sigmoidal function,” Mathematics of Control, Signals and Systems, vol. 2, pp. 303–314, 1989. doi
- D. E. Rumelhart, G. E. Hinton and R. J. Williams, “Learning representations by back-propagating errors,” Nature, vol. 323, pp. 533–536, 1986. doi
- S. R. Dubey, S. K. Singh and B. B. Chaudhuri, “Activation functions in deep learning: A comprehensive survey and benchmark,” Neurocomputing, vol. 503, pp. 92–108, 2022. arXiv
- D. Hendrycks and K. Gimpel, “Gaussian error linear units (GELUs),” arXiv:1606.08415, 2016. arXiv
- S. Elfwing, E. Uchibe and K. Doya, “Sigmoid-weighted linear units for neural network function approximation in reinforcement learning,” Neural Networks, vol. 107, pp. 3–11, 2018. arXiv
- P. Ramachandran, B. Zoph and Q. V. Le, “Searching for activation functions,” arXiv:1710.05941, 2017. arXiv
- N. Shazeer, “GLU variants improve Transformer,” arXiv:2002.05202, 2020. arXiv
- H. Touvron, T. Lavril, G. Izacard et al., “LLaMA: Open and efficient foundation language models,” arXiv:2302.13971, 2023. arXiv
- S. Ioffe and C. Szegedy, “Batch normalization: Accelerating deep network training by reducing internal covariate shift,” in Proc. International Conference on Machine Learning (ICML), PMLR 37, pp. 448–456, 2015. PMLR
- J. L. Ba, J. R. Kiros and G. E. Hinton, “Layer normalization,” arXiv:1607.06450, 2016. arXiv
- B. Zhang and R. Sennrich, “Root mean square layer normalization,” in Advances in Neural Information Processing Systems (NeurIPS), 2019. arXiv
- L. Huang, J. Qin, Y. Zhou, F. Zhu, L. Liu and L. Shao, “Normalization techniques in training DNNs: Methodology, analysis and application,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, no. 8, pp. 10173–10196, 2023. arXiv
- X. Glorot and Y. Bengio, “Understanding the difficulty of training deep feedforward neural networks,” in Proc. International Conference on Artificial Intelligence and Statistics (AISTATS), PMLR 9, pp. 249–256, 2010. PMLR
- K. He, X. Zhang, S. Ren and J. Sun, “Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification,” in Proc. IEEE International Conference on Computer Vision (ICCV), pp. 1026–1034, 2015. arXiv
- D. P. Kingma and J. Ba, “Adam: A method for stochastic optimization,” in Proc. International Conference on Learning Representations (ICLR), 2015. arXiv
- I. Loshchilov and F. Hutter, “Decoupled weight decay regularization,” in Proc. International Conference on Learning Representations (ICLR), 2019. arXiv
- X. Chen, C. Liang, D. Huang, E. Real, K. Wang, H. Pham, X. Dong, T. Luong, C.-J. Hsieh, Y. Lu and Q. V. Le, “Symbolic discovery of optimization algorithms,” in Advances in Neural Information Processing Systems (NeurIPS), 2023. arXiv
- K. Jordan, “Muon: An optimizer for hidden layers in neural networks,” blog post, December 2024. link
- J. Liu, J. Su, X. Yao et al., “Muon is scalable for LLM training,” arXiv:2502.16982, 2025. arXiv
- I. Loshchilov and F. Hutter, “SGDR: Stochastic gradient descent with warm restarts,” in Proc. International Conference on Learning Representations (ICLR), 2017. arXiv
- N. S. Keskar, D. Mudigere, J. Nocedal, M. Smelyanskiy and P. T. P. Tang, “On large-batch training for deep learning: Generalization gap and sharp minima,” in Proc. International Conference on Learning Representations (ICLR), 2017. arXiv
- R. Sun, “Optimization for deep learning: Theory and algorithms,” arXiv:1912.08957, 2019. arXiv
- N. Srivastava, G. Hinton, A. Krizhevsky, I. Sutskever and R. Salakhutdinov, “Dropout: A simple way to prevent neural networks from overfitting,” Journal of Machine Learning Research, vol. 15, pp. 1929–1958, 2014. JMLR
- K. He, X. Zhang, S. Ren and J. Sun, “Deep residual learning for image recognition,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), pp. 770–778, 2016. arXiv
- A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, Ł. Kaiser and I. Polosukhin, “Attention is all you need,” in Advances in Neural Information Processing Systems (NeurIPS), 2017. arXiv