ML 01・機器學習入門
先備知識: 影像就是陣列
你將學到
- 「從資料中學習」是什麼意思,以及它和手寫規則有什麼不同;全篇以手寫數字的小影像當作貫穿的例子。
- 主要的學習範式:監督式學習(迴歸與分類)、非監督式學習(分群、降維、異常偵測)、自監督式學習,以及強化學習,包括「基於人類回饋的強化學習」(RLHF)如何調校聊天模型。
- 一個學習問題的基本詞彙:模型 、參數、特徵、目標值、預測值、訓練/驗證/測試集,以及成本函數。
- 以均方誤差為成本的線性迴歸,以及用來最小化成本的梯度下降:更新規則、學習率、收斂,以及批次、小批次與隨機梯度下降的差別。
- 為什麼要做特徵縮放;邏輯迴歸如何用 sigmoid 函數與交叉熵損失把一條直線變成分類器;如何用驗證資料發現過擬合,並用 L2 正則化修正。
- 如何用準確率、精確率、召回率與 MSE 誠實地回報結果。
先看全貌
大多數程式都像食譜:有人把問題想清楚,再把每一個步驟寫下來。機器學習把這件事反過來。我們寫一個有彈性、裡面有很多可調整數字的程式,給它看大量「正確完成任務」的例子,再讓一個演算法去調整這些數字,直到程式把任務做好。範例取代了食譜。
為什麼重要:幾乎所有現代電腦視覺系統,從手機的臉部解鎖到醫學影像分析,都是學習出來的模型,而不是手寫的程式。本篇的幾個概念:帶有參數的模型、衡量誤差的成本、讓成本下降的梯度下降,以及用另外的資料檢查結果,正是今天訓練最大型神經網路所用的同一套想法,只是模型的規模不同。把這幾個概念弄清楚之後,本系列接下來的內容(ML 02 與各篇深度學習教學)主要就是在談「用哪一種模型」與「用哪一種成本」。
什麼是機器學習?
白話版。 機器學習系統藉由觀察資料來把任務做得更好,而不是由程式設計師寫下每一個決定。
用學習取代寫程式
這個想法由來已久。1959 年,Arthur Samuel 描述了一個學會下西洋跳棋(checkers)、而且下得比他本人還好的程式:它下了很多盤棋,並據此調整自己評估棋局的方式 [2]。他的重點是:一台能從經驗中學習的電腦,可以省去這項任務原本需要的大量細部手寫程式。那句著名的一行定義,把機器學習說成「讓電腦不需明確寫程式就能學習的研究領域」,其實是後人對這個想法的轉述,通常被歸於 Samuel,但並不是他論文裡的原句。
教科書中常見一個更具操作性的定義,包含三個部分:一個任務(例如辨識數字)、一個效能指標(辨識正確的比例),以及經驗(一批有標註的數字影像)。如果程式在這個任務上的效能隨著經驗增加而提升,我們就說它在學習 [3]、[7]。
影像的例子:規則與學習
我們貫穿全篇的例子是 scikit-learn 的 digits 資料集 [5]、[6]:1,797 張手寫數字的灰階影像,每張只有 個像素,數值從 0 到 16。就像〈Images as Arrays〉介紹的,每張影像只是一個小小的數字陣列,攤平之後就是 64 個數字組成的向量。
假設我們只需要分辨 0 和 1。程式設計師可能會寫一條規則:「1 很細、0 很寬,所以數一數有幾欄有墨跡;不超過五欄就是 1。」這條規則容易理解,對大多數直立的 1 也是對的。但人們寫 1 的方式各不相同,有的傾斜、有的帶襯線或底座,而傾斜的 1 佔的欄數和 0 一樣多(圖 1)。這條規則大約只對了 79%。想修好它就得加更多規則(「除非它是斜的⋯⋯」),而每條新規則又會帶來新的例外。
機器學習的做法則不寫任何針對數字的規則。它挑一個有彈性的函數家族(這裡是邏輯迴歸,本篇後面會從頭實作),再讓演算法從範例中選出其中的 65 個數字。在沒看過的影像上,它把 0 和 1 完全分對;而且一模一樣的程式碼,不加任何新規則就能處理全部十個數字:
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

digits = load_digits()                       # 1,797 images, 8x8 pixels, values 0..16
X, y = digits.data, digits.target            # X: (1797, 64) flattened pixels; y: 0..9

# Hand-written rule for "0 versus 1": a 1 is thin, a 0 is wide.
keep = (y == 0) | (y == 1)
imgs, labels = digits.images[keep], y[keep]
width = (imgs.max(axis=1) > 4).sum(axis=1)   # how many columns contain ink
rule = np.where(width <= 5, 1, 0)
print("hand rule, 0 vs 1:", round((rule == labels).mean(), 3))           # 0.789

# Learned rule for the same task, judged on images it never saw.
X01 = imgs.reshape(len(imgs), -1)
Xa, Xb, ya, yb = train_test_split(X01, labels, test_size=0.3, random_state=0)
print("learned, 0 vs 1:", LogisticRegression(max_iter=1000).fit(Xa, ya).score(Xb, yb))   # 1.0

# The same recipe scales to all ten digits with no new rules.
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=0)
print("learned, 10 digits:",
      round(LogisticRegression(max_iter=5000).fit(X_tr, y_tr).score(X_te, y_te), 3))  # 0.953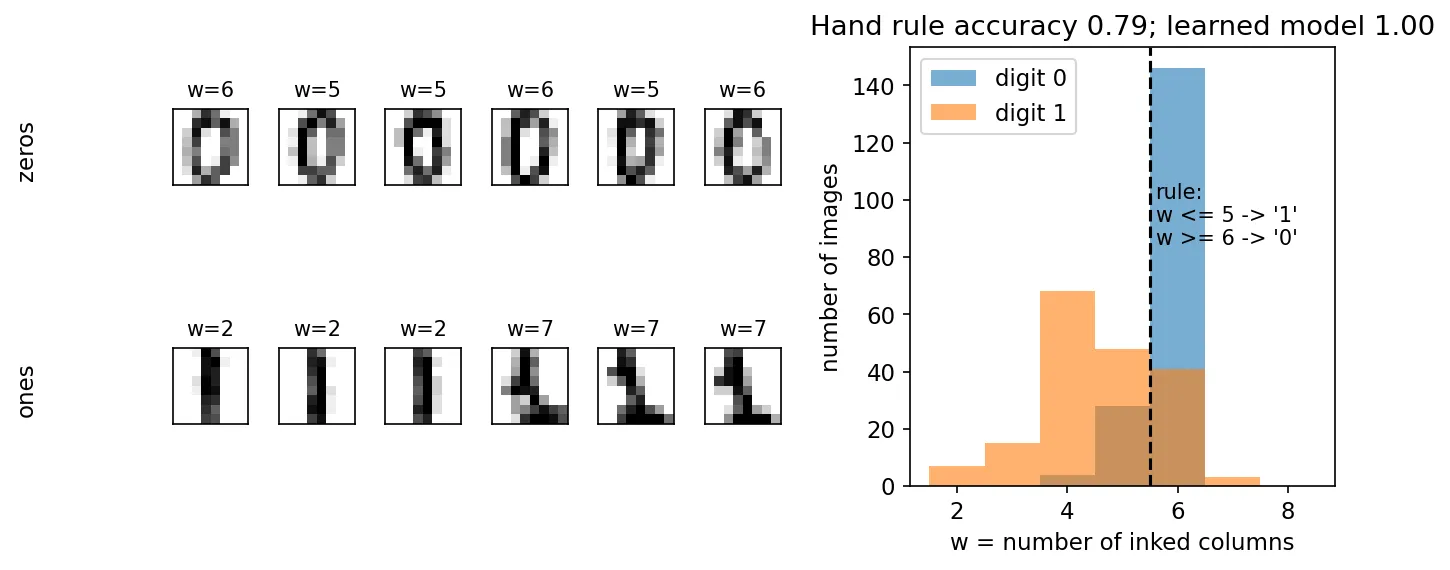
這個小實驗包含了支持機器學習的全部理由:當規則難以用文字說清楚、範例卻很容易取得時,就從範例中學出規則。它也顯示了代價:學到的模型是一串 65 個數字,比「數欄數」難讀得多。
學習範式
白話版。 各種學習問題的主要差別在於學習者得到什麼樣的回饋:每個範例都有正確答案、完全沒有答案、可以從資料本身製造答案,或是只偶爾得到一個「做得好不好」的分數。
| 範式 | 資料長什麼樣子 | 學到什麼 | 典型例子 |
|---|---|---|---|
| 監督式 | 成對的 :輸入與「正確答案」 | 從 到 的函數 | 數字影像 → 數字標籤 |
| 非監督式 | 只有輸入 | 結構:群組、方向、離群值 | 把相似的數字分在一起 |
| 自監督式 | 只有輸入 ,但把 的一部分藏起來當作目標 | 通用的表示(representation) | 預測被遮住的字詞或影像區塊 |
| 強化學習 | 代理人的動作,以及動作換來的獎勵 | 策略:在每種情況下該採取哪個動作 | 玩遊戲、調校聊天模型 |
我原本的筆記列了第一、第二和第四種;自監督式學習後來已成為預訓練大型模型的主要方式,所以這裡讓它單獨佔一列 [9]、[10]。
監督式學習
在監督式學習(supervised learning)中,學習者會拿到正確答案。資料是一組範例 ,其中 是輸入, 是期望的輸出(稱為標籤或目標值), 是範例數。目標是找到一個函數 ,使 接近 ,而且對資料中沒有的新輸入也一樣。最後這一點稱為泛化(generalization),它才是真正的目標;把範例背起來很容易。
非監督式學習
在非監督式學習(unsupervised learning)中沒有答案,只有輸入 。目標是從資料中找出有意思的東西:相似範例組成的群組、精簡的描述,或是格格不入的範例。由於沒有唯一「正確」的輸出,這類方法很適合用來探索資料,但也比較難評估。
自監督式學習
自監督式學習(self-supervised learning)使用沒有標註的資料,但把一部分藏起來、要模型預測被藏的部分,藉此把問題變成監督式問題。在文字上,遮住一個字詞,從句子的其餘部分預測它。在影像上,遮住大部分的區塊再把它們重建出來:遮罩自編碼器(masked autoencoder)會遮住一張影像 75% 的區塊,訓練網路把它們補回來 [12]。LeCun 與 Misra 認為,自監督式學習讓模型能從原始觀察中累積廣泛的背景知識,因為標籤是免費得到的 [9]。
重點不在「填空」本身,而在於:一個很會填空的模型,必定已經學到很多關於資料結構的知識。這個學到的內部表示可以再用很少的標籤,調整去做許多其他任務。這正是基礎模型(foundation model)背後的做法:在大規模、廣泛的資料上訓練(通常是自監督式),再調整去做各式各樣的下游任務 [10]。GPT-3 只是被訓練來在大量文字上預測下一個字,卻能憑提示中給的幾個例子完成許多語言任務,不需要再訓練 [11]。
強化學習
在強化學習(reinforcement learning, RL)中,一個代理人(agent)與環境互動。每一步它觀察一個狀態、選一個動作,然後得到一個獎勵(一個數字)和新的狀態。沒有人告訴它正確的動作;它必須自己發現哪些動作能在長期累積較高的總獎勵,而獎勵常常在造成它的動作之後很久才出現。學到的是一個策略(policy),也就是在每個狀態下選擇動作的規則 [8]。Samuel 的跳棋程式就是這種情境的早期例子 [2]。
今天,強化學習最為人所知的用途是調校大型語言模型。在 Ouyang 等人描述的基於人類回饋的強化學習(reinforcement learning from human feedback, RLHF)[13] 中,先用人寫的示範答案對預訓練語言模型做微調(監督式學習)。接著由人對模型針對同一個提示所產生的幾個答案排序,再訓練一個獨立的獎勵模型來預測這些排序。最後用強化學習最佳化語言模型,讓它產生獎勵模型評分高的答案。作者回報,標註人員偏好他們 13 億參數的調校模型,勝過 1,750 億參數的 GPT-3 [13]。更近期,DeepSeek-R1 用大規模強化學習,搭配可自動檢查的獎勵(例如數學答案是否正確),來提升逐步推理的能力 [14]。
注意 RLHF 串起了三種範式:自監督式預訓練、監督式微調,以及強化學習。真實的系統會自由混用各種範式;上面那張表是一張地圖,而不是一道道牆。
監督式學習:迴歸與分類
白話版。 監督式學習主要有兩種。迴歸預測一個數字;分類預測一個類別。
迴歸
在迴歸(regression)中,目標值 是一個實數,所以可能的輸出有無限多個。例如:預測股價、用之前的考試成績預測學生的期末成績,或從臉部影像預測一個人的年齡。最後一個例子說明:輸入可以是一張影像,輸出仍然只是一個數字。
分類
在分類(classification)中,目標值是一小組固定類別中的某一個。例如:垃圾郵件或非垃圾郵件(兩類,二元分類)、臉型的類別,或是腫瘤類型,如良性、惡性第 1 型、惡性第 2 型(多類別分類)。類別是名稱,不是數量:「第 2 類」並不是「第 1 類」的兩倍。分類器通常會對每個類別輸出一個機率,再挑最可能的那一個。
from sklearn.datasets import make_regression, make_classification
from sklearn.linear_model import LinearRegression, LogisticRegression

# Regression: the target is a real number.
X_r, y_r = make_regression(n_samples=100, n_features=1, noise=10.0, random_state=0)
reg = LinearRegression().fit(X_r, y_r)
print(reg.predict(X_r[:3]).round(1), y_r[:3].round(1))   # numbers vs numbers

# Classification: the target is one of a few labels.
X_c, y_c = make_classification(n_samples=100, n_features=2, n_redundant=0,
                               n_clusters_per_class=1, random_state=0)
clf = LogisticRegression().fit(X_c, y_c)
print(clf.predict(X_c[:5]), y_c[:5])                     # labels vs labels
print(clf.predict_proba(X_c[:2]).round(3))               # class probabilities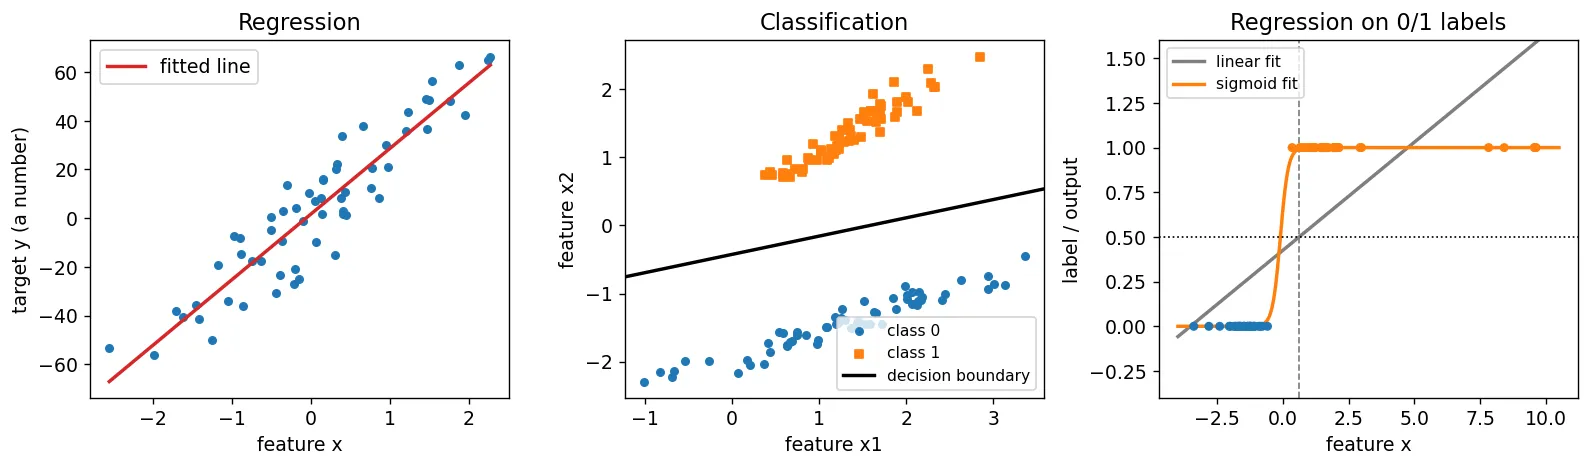
為什麼不用迴歸來做分類?
把類別編成 0 和 1、擬合一條迴歸直線、大於 0.5 就判為 1,這個做法很誘人。在簡單的資料上它也許可行,但通常表現很差,原因有兩個,都能在圖 2(右)看到。第一,直線會輸出 或 這類數值,它們不是機率。第二,平方誤差會懲罰那些已經分對、只是離邊界很遠的點,所以少數極端但容易的範例會把直線拉過去,讓它跨過 0.5 的位置移到錯誤的地方。本篇後面的邏輯迴歸同時解決了這兩個問題。
非監督式學習
白話版。 即使沒有答案,我們仍然可以問:哪些範例屬於同一群?怎樣用更少的數字描述每個範例?哪些範例很奇怪?
分群
分群(clustering)把相似的範例歸在一起。經典的演算法是 k-means [15]。先決定群數 ,從 個中心點出發,然後重複兩個步驟直到不再變化:把每個範例指派給最近的中心,再把每個中心移到被指派給它的範例的平均位置。每一步都只會讓範例到其中心的總平方距離
變小或不變,其中 是第 群的中心, 是範例 被指派到的群。所以演算法一定會停下來,但可能停在不好的局部解,這也是為什麼要從好幾個隨機起點各跑一次。Jain 回顧五十年分群研究的文章 [15] 強調,一般而言沒有「最好」的分群演算法:「正確」的群組取決於「相似」對這份資料代表什麼意思。
一個常見的混淆:k 近鄰法(k-nearest neighbors, KNN)不是分群方法。KNN 對一個新範例分類的方式,是讓 個最相似的有標籤訓練範例投票,所以它是監督式方法 [5]。k-means 的 k 是群數;KNN 的 k 是鄰居數。
降維
降維(dimensionality reduction)用更少的數字描述每個範例,同時盡量保留有用的資訊。主成分分析(principal component analysis, PCA)找出資料變化最大的幾個方向,再把資料投影到其中前幾個方向上;新的座標彼此不相關,並依序盡可能捕捉最多的變異 [16]。兩個 PCA 座標就能把 64 個像素的數字影像變成平面上的點,讓我們看得到(圖 3 中)。
異常偵測
異常偵測(anomaly detection)找出與其他資料模式不符的範例:詐騙交易、瑕疵零件、損壞的影像。Chandola、Banerjee 與 Kumar 的綜述 [17] 依照各技術對「正常長什麼樣子」所做的假設,把眾多技術加以分類。一個簡單的版本使用 PCA:在資料上擬合幾個主成分,用它們重建每個範例,再標出重建誤差大的範例,因為主成分只描述了常見的部分。
import numpy as np
from sklearn.datasets import load_digits
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA

X, y = load_digits(return_X_y=True)             # y is used only to check, never to fit

# Clustering: ten groups, found without looking at y.
km = KMeans(n_clusters=10, n_init=10, random_state=0).fit(X)
purity = sum(np.bincount(y[km.labels_ == k]).max() for k in range(10)) / len(y)
print("cluster purity:", round(purity, 3))      # 0.792: most clusters are one digit

# Dimensionality reduction: 64 numbers per image -> 2 numbers.
Z = PCA(n_components=2).fit_transform(X)        # shape (1797, 2)

# Anomaly detection: images that a 20-component PCA rebuilds badly are unusual.
pca20 = PCA(n_components=20).fit(X)
err = ((X - pca20.inverse_transform(pca20.transform(X))) ** 2).sum(axis=1)
print("most unusual images:", np.argsort(err)[-5:])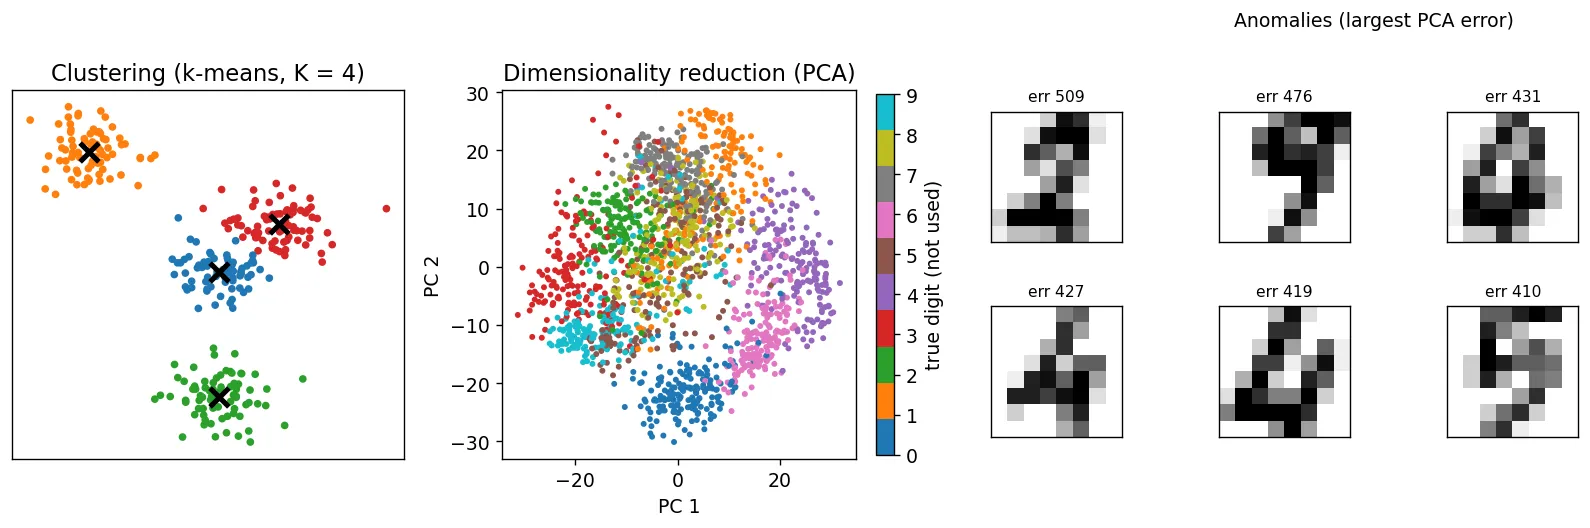
程式中的純度(purity)檢查只在分群之後才用到標籤,用來看找出的群組是否和數字吻合。大約 79% 的影像落在以它自己的數字為主的群裡,即使 k-means 從沒看過任何標籤。
學習問題的詞彙
白話版。 在談數學之前,我們需要替各部分取名字:什麼進去、什麼出來、正確答案是什麼、模型是什麼,以及怎麼衡量它的錯誤。
輸入、輸出與目標值
- 特徵(features,輸入):描述一個範例的數字。對數字影像來說是 64 個像素值;對一棟房子來說是坪數和房間數。有 個特徵時寫成 , 是第 個特徵。
- 目標值(target):正確的輸出,也叫標籤或真值(ground truth)。只有監督式學習有目標值。
- 預測值(prediction)(讀作 y-hat):模型對某個輸入的輸出。帽子代表「估計的」。
- 訓練範例 :成對的 。括號中的上標是索引,不是次方。 是範例 的第 個特徵。
模型與參數
模型是把特徵對應到預測值的函數。我們寫成 ,表示它取決於稱為參數的可調整數字,這裡是 (權重,weights)與 (偏差,bias):
選擇 的形式(直線、曲線、神經網路)是設計上的決定;選擇 和 的數值則是學習要做的事。由我們手動設定的數字,例如學習率或多項式的次數,稱為超參數(hyperparameters),以和學習出來的參數區分。
成本函數
損失(loss) 衡量一個預測錯了多少。成本函數(cost function) 把損失對整個訓練集取平均,因此它是一個數字,說明在某組參數下整個模型錯了多少。模型是 ;成本是 。把兩者分清楚可以避免很多混淆: 吃一個輸入、吐出預測值; 吃一組參數、吐出誤差。
於是訓練的目標就很明確:找出讓 盡可能小的參數,使所有訓練範例的 都接近 。
訓練集、驗證集與測試集
資料會切成三份,各有不同的工作:
- 訓練集用來擬合參數;
- 驗證集在開發過程中用來比較模型、選擇超參數;
- 測試集只在最後使用一次,用來估計最終模型在新資料上的表現。
測試集絕不能影響任何決定,否則估計值會過於樂觀。我們會在過擬合那一節回來說明為什麼要這樣切。
線性迴歸
白話版。 在資料中畫一條直線。這條線有兩個旋鈕:斜率和高度。學習就是轉動旋鈕,直到直線盡可能貼近所有的點。
模型
只有一個特徵時,線性迴歸(linear regression)模型是
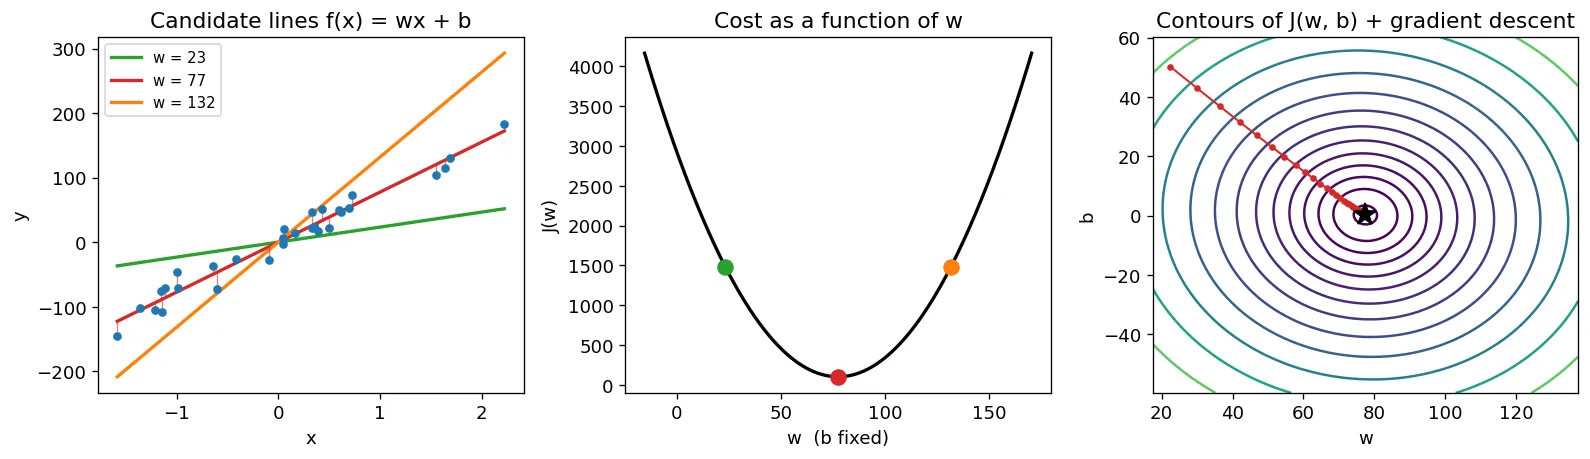
其中 是特徵, 是斜率( 增加 1 時預測值改變多少), 是截距( 時的預測值)。改變 會讓直線傾斜;改變 會讓直線上下移動(圖 4 左)。
有 個特徵時,同一個模型是加權總和:
其中 為每個特徵各存一個權重。常見的技巧是加上一個常數特徵 ,偏差就變成另一個權重 ,模型縮寫成 。無論哪種寫法,「線性」指的都是對參數是線性的;之後我們會餵給它平方或三次方的特徵,它仍然是線性迴歸。
成本函數:均方誤差
對每個範例,誤差(殘差)是 。取平方讓誤差變成正數,並讓大誤差比小誤差受到更重的懲罰。對 個訓練範例取平均,就得到均方誤差(mean squared error, MSE)成本:
其中 是訓練範例數, 是第 個範例。多出來的 只是為了方便:微分平方項時出現的 2 會和它抵消,而且它不會改變最小值的位置。
把成本想像成參數上的一片地形。如果固定 、只改變 , 是一條拋物線:太平或太陡的直線誤差都很大,介於中間的某個斜率最好(圖 4 中)。同時考慮 和 時, 是一個碗,我們把它畫成由橢圓組成的等高線圖(圖 4 右)。最好的直線就在碗底。
為什麼這個碗只有一個底
對線性迴歸來說,MSE 成本是 的凸函數(convex):曲面上任兩點之間的直線段都位於曲面上方或曲面上。凸函數沒有其他的局部最小值;每個最小值都是全域最小值。這是一個特別友善的情況。對許多其他模型,包括 ML 02 的神經網路,成本地形有許多山谷,最佳化方法可能停在不是最低的那一個。原本的筆記正是在講這一點:一般而言,我們能期待的最好結果是找到一個夠好、接近全域最小值的局部最小值。
對線性迴歸,我們甚至可以用公式直接解出碗底(正規方程式,np.polyfit 就是這麼做的)。我們仍然使用梯度下降,因為在沒有公式可用時,它依然有效。
梯度下降
白話版。 你在濃霧中站在成本地形的某處。感覺一下地面往哪邊傾斜,往下坡走一小步,再重複。等地面平了,你就到底了。
更新規則
導數 告訴我們 稍微增加時 會怎麼變:正值表示「往右是上坡」,負值表示「往左是上坡」。它的正負號給出方向,大小說明坡有多陡。梯度下降(gradient descent)讓每個參數逆著它的導數走一小步:
其中 是學習率(步長), 表示「以右邊取代」。兩個導數都要在目前的 計算完之後才更新任何一個參數,這叫做同步更新。所有偏導數組成的向量就是梯度 ,它指向上升最快的方向,所以這個更新是朝下降最快的方向移動 [3]。
對線性迴歸的 MSE 成本,連鎖律給出
用文字讀: 的梯度是「平均誤差乘以特徵」; 的梯度是「平均誤差」。如果預測值平均而言太高, 就往下調。如果預測值主要在 很大的地方太高, 就往下調。有 個特徵時, 用 取代 。
從頭實作
import numpy as np
from sklearn.datasets import make_regression

X, y = make_regression(n_samples=100, n_features=1, noise=10.0, random_state=0)
x = X[:, 0]                                   # one feature, shape (m,)
m = len(x)

def cost(w, b):
    return ((w * x + b - y) ** 2).sum() / (2 * m)

w, b, alpha = 0.0, 0.0, 0.1
for step in range(200):
    err = w * x + b - y                       # f_wb(x_i) - y_i for every i
    dj_dw = (err * x).sum() / m
    dj_db = err.sum() / m
    w, b = w - alpha * dj_dw, b - alpha * dj_db   # simultaneous update
    if step % 50 == 0:
        print(f"step {step:3d}  J = {cost(w, b):8.2f}")

print("gradient descent:", round(w, 3), round(b, 3))   # 42.619 -0.814
print("closed form     :", np.polyfit(x, y, 1).round(3))  # [42.619 -0.814]
成本在 50 步內從大約 800 降到 57,之後就不再變化。梯度下降和精確公式的結果在小數點後三位都一致。剩下的成本不是零,因為資料中含有任何直線都無法解釋的雜訊。
收斂:導數為零的地方
「重複直到收斂」需要一個定義。在最小值處地形是平的,所以那裡的導數為零,更新 不會改變 。要注意變成零的是導數,不是成本:最小值處的成本只是能達到的最小數值,在上面的例子中是 57。實務上,當兩次迭代之間成本下降得比一個小容許值還少、梯度的大小低於某個門檻,或是用完固定的步數時,就停止。
一個有用的推論:越接近最小值,導數越小,所以即使 固定,步伐 也會自動變小。梯度下降在接近谷底時會自然放慢。
選擇學習率
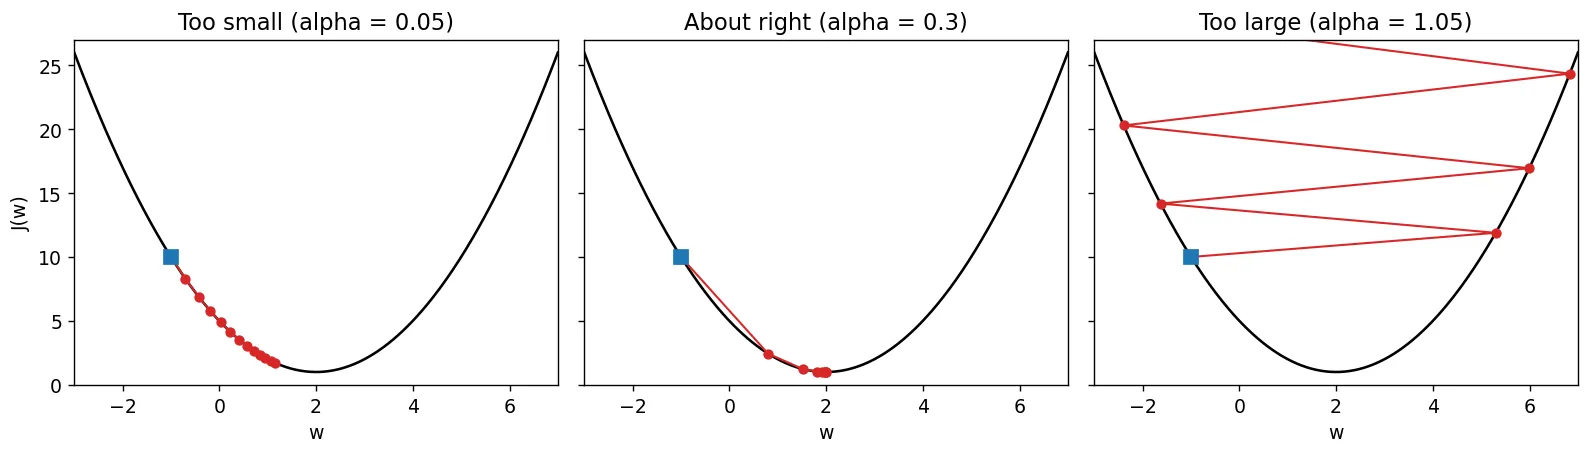
學習率是梯度下降最重要的超參數(圖 5):
- **太小:**每一步都很小。演算法確實在下坡,但可能需要非常多步。
- **剛好:**成本快速下降並穩定下來。
- **太大:**一步跨過谷底跳到山谷另一側,甚至可能比起點還高。參數來回彈跳,可能永遠停不下來(越過頭,overshoot),甚至一路飛向無限大(發散,divergence)。
標準的診斷工具是學習曲線:把 對迭代次數作圖。學習率合適時, 每一步都會下降。如果 曾經上升,就是 太大(或梯度的程式有錯)。實用的做法是以大約 3 倍的間隔嘗試數值,例如 0.001、0.003、0.01、0.03、0.1、0.3,然後挑曲線仍平穩下降的最大那一個。
許多最佳化方法會在訓練過程中調整步長:用一個排程(schedule)隨時間降低 ,或像 Adam 那樣,用每個參數過去梯度的移動統計量來縮放它的步伐 [19]。這讓「接近最小值時步伐變小」成為明確的設計,而不只是副作用。
批次、小批次與隨機梯度下降
梯度公式要對全部 個範例加總。100 個範例沒問題,一億個就是麻煩了。關鍵的洞見是:梯度是一個平均值,也就是對資料的期望值,而平均值可以從樣本估計。[3] 對此有清楚的說明,Bottou、Curtis 與 Nocedal [18] 則做了深入的分析。
- 批次梯度下降(batch gradient descent)每次更新都使用整個訓練集。每一步都精確,但也昂貴。
- 小批次梯度下降(mini-batch gradient descent)先打亂資料,每次更新只用一個隨機的小子集(小批次),大小為 個範例,通常是 32 到幾百。每一步是對完整梯度帶雜訊但不偏的估計,成本只有 。
- 隨機梯度下降(stochastic gradient descent, SGD)在嚴格意義上每次更新只用一個範例()。實務上「SGD」也常指小批次的版本。
完整走過訓練資料一遍稱為一個 epoch。注意程式中的命名:深度學習函式庫中的 batch_size 參數指的是小批次的大小,而不是批次梯度下降的「整個資料集」。
小批次梯度的雜訊不只可以容忍,往往還有幫助:在相同的 epoch 數內,小批次下降比批次下降多做了非常多次更新。Bottou 等人認為,這正是隨機方法主導大規模學習的原因:它們用遠少於精確方法的計算量,就能達到有用的準確度 [18]。
import numpy as np
from sklearn.datasets import make_regression

X, y = make_regression(n_samples=10_000, n_features=5, noise=10.0, random_state=0)
m, n = X.shape
rng = np.random.default_rng(0)

def minibatch_gd(batch_size, alpha=0.05, epochs=5):
    w, b = np.zeros(n), 0.0
    for epoch in range(epochs):
        order = rng.permutation(m)                    # shuffle once per epoch
        for start in range(0, m, batch_size):
            idx = order[start:start + batch_size]
            err = X[idx] @ w + b - y[idx]
            w -= alpha * X[idx].T @ err / len(idx)    # gradient estimated on the batch
            b -= alpha * err.mean()
    return ((X @ w + b - y) ** 2).mean() / 2

for bs in [m, 64, 1]:                                 # batch, mini-batch, stochastic
    print(f"batch size {bs:5d}: J = {minibatch_gd(bs, alpha=0.05 if bs > 1 else 0.005):.2f}")
# batch size 10000: J = 6127.00   (only 5 updates in 5 epochs)
# batch size    64: J = 49.93     (785 updates)
# batch size     1: J = 50.64     (50,000 noisy updates)
同樣走過資料五遍,批次下降只走了五步,離谷底還很遠;小批次下降則基本上已經收斂(這份資料的雜訊程度讓可達到的最佳 大約是 50)。單一範例的 SGD 也能到達,但因為梯度雜訊較大,需要較小的學習率,而且無法有效利用向量化運算。
特徵縮放
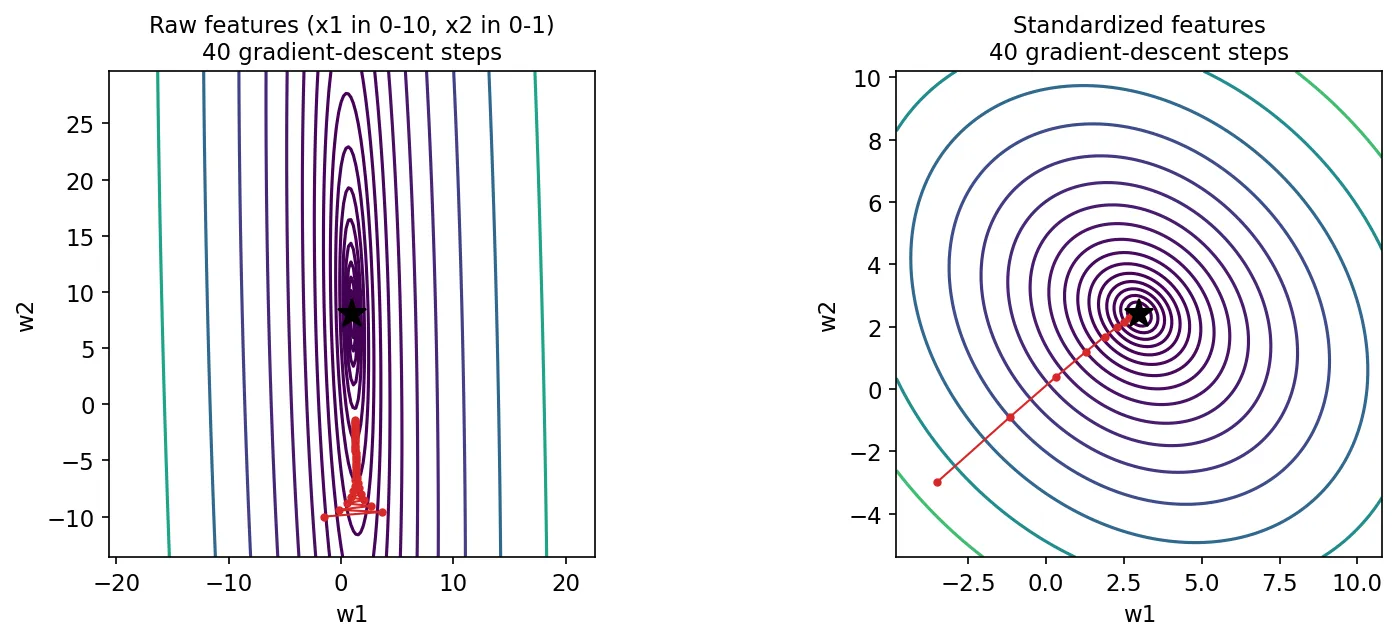
白話版。 如果一個特徵以千為單位、另一個以小數為單位,成本地形會變成又長又窄的山谷,梯度下降會左右來回鋸齒狀前進。把所有特徵放到相近的尺度,山谷就會變成圓圓的碗,很容易走到底。
為什麼尺度很重要
假設特徵 (例如以平方英尺計的房屋面積)的範圍是好幾千,特徵 (房間數)的範圍是 1 到 5。 稍微改變一點,預測值就變很多; 做同樣的改變卻幾乎沒影響。所以 沿著 方向非常陡,沿著 方向非常平:等高線是細長的橢圓。學習率若小到不會在陡的方向發散,在平的方向上就幾乎沒有進展(圖 6 左)。
標準化與最小–最大縮放
最常見的解法是標準化(standardization,z 分數正規化):
其中 與 是特徵 在訓練集上計算的平均值與標準差。縮放後每個特徵的平均為 0、標準差為 1。另一個做法是最小–最大縮放(min–max scaling),,把訓練集的範圍對應到 ,這也是像素強度的常用選擇(8 位元影像除以 255)。兩者在 scikit-learn 中分別是 StandardScaler 與 MinMaxScaler [5]。
兩條規則可以避免隱微的錯誤。只在訓練集上計算 ,再把同一組數字套用到驗證、測試和未來的資料。並且記得縮放會改變學到的權重的意義:權重現在代表特徵每增加一個標準差時預測值改變多少。
import numpy as np
from sklearn.datasets import make_regression

X, y = make_regression(n_samples=200, n_features=2, noise=5.0, random_state=1)
X = X * np.array([1000.0, 1.0])               # feature 1 now has a ~1000x wider range

def gd(X, y, alpha, steps=500):
    m, n = X.shape
    w, b = np.zeros(n), 0.0
    for _ in range(steps):
        err = X @ w + b - y
        w -= alpha * X.T @ err / m
        b -= alpha * err.mean()
    return ((X @ w + b - y) ** 2).mean() / 2

print("raw,    alpha=1e-7:", round(gd(X, y, 1e-7), 2))    # 158.01; alpha=3e-6 diverges
mu, sigma = X.mean(axis=0), X.std(axis=0)
Xs = (X - mu) / sigma                          # z-score standardization
print("scaled, alpha=0.1 :", round(gd(Xs, y, 0.1), 2))    # 13.47
在原始特徵上,任何大於約 的學習率都會發散;用安全的學習率跑 500 步,成本仍卡在 158 左右(跑 5,000 步也還是 158 左右),因為第二個權重幾乎不動。標準化之後, 輕鬆到達最小值(大約 13,也就是雜訊的程度)。
用於分類的邏輯迴歸
白話版。 保留線性迴歸的加權總和,但把輸出壓進 0 到 1 之間,讓它可以被解讀成機率。然後選擇權重,讓真實類別的機率越高越好。
Sigmoid 函數
Sigmoid(logistic)函數是
其中 是任意實數。它把 對應到 0、 對應到 1、 恰好對應到 ,中間是一條 S 形曲線(圖 7 左)。它還有對稱性 ,以及方便的導數 。
模型與決策邊界
邏輯迴歸(logistic regression)把線性模型送進 sigmoid:
並把輸出解讀為標籤為 1 的估計機率,。名字雖然叫「迴歸」,它其實是分類方法。做決定時,只要這個機率至少 0.5 就預測為 1。由於 恰好在 時成立,規則就是
滿足 的集合就是決策邊界(decision boundary)。有兩個特徵時它是一條直線;一般而言它是一個平的超平面,而 與它垂直。離邊界很遠的點,機率接近 0 或 1;靠近邊界的點,機率接近 0.5。若想得到彎曲的邊界,就餵給模型非線性的特徵,例如 或 ;模型對參數仍然是線性的。
成本:交叉熵(對數損失)
為什麼不沿用平方誤差?和 sigmoid 結合之後,平方誤差成本對 不是凸的:它會出現平坦的高原和多個山谷。所以邏輯迴歸改用對數損失(log loss),也稱為二元交叉熵(binary cross-entropy):
其中 是預測機率, 是真實標籤。每個範例只會用到兩項中的一項。若 ,損失是 : 時為零, 時無限增大。若 ,損失是 ,正好是鏡像(圖 7 中)。信心滿滿卻答錯會受到很重的懲罰;信心滿滿且答對則幾乎沒有成本。
成本是整個訓練集上的平均:
這個選擇並不隨意。如果把每個標籤看成一次擲硬幣,出現 1 的機率是 ,那麼 正好是訓練標籤的負對數概似(negative log-likelihood)除以 。最小化它就是最大概似估計(maximum likelihood estimation)[3]。而且搭配 sigmoid 時,這個成本是凸的,所以梯度下降又能找到唯一的全域最小值。
再一次梯度下降
利用 ,對數損失的導數會化簡得非常漂亮:
它和線性迴歸的梯度形式完全相同:平均誤差乘以特徵。唯一的差別在 的內部。這不是巧合;只要輸出函數和它相配的概似函數成對使用,整個模型家族都有這個性質,這也是梯度下降程式碼這麼容易重複使用的原因之一。
import numpy as np
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=200, n_features=2, n_redundant=0,
                           n_clusters_per_class=1, class_sep=1.5, random_state=3)

def sigmoid(z):
    return 1.0 / (1.0 + np.exp(-z))

def log_loss(p, y, eps=1e-12):
    p = np.clip(p, eps, 1 - eps)              # avoid log(0)
    return -(y * np.log(p) + (1 - y) * np.log(1 - p)).mean()

w, b, alpha = np.zeros(2), 0.0, 0.5
for step in range(1000):
    p = sigmoid(X @ w + b)                    # predicted P(y = 1 | x)
    w -= alpha * X.T @ (p - y) / len(y)       # same form as linear regression
    b -= alpha * (p - y).mean()

p = sigmoid(X @ w + b)
print("log loss:", round(log_loss(p, y), 3))  # 0.06
print("accuracy:", ((p >= 0.5) == y).mean())  # 0.99
print("boundary: %.2f*x1 + %.2f*x2 + %.2f = 0" % (w[0], w[1], b))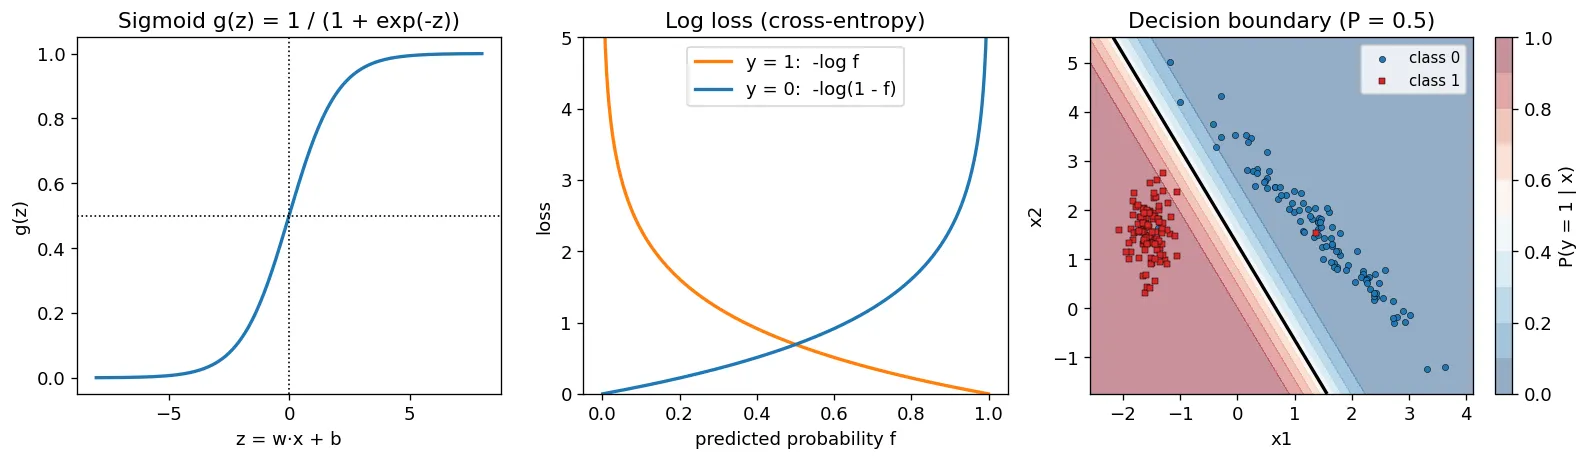
超過兩個類別
當類別數 時,標準的推廣方式是讓每個類別有自己的權重向量和分數 ,再用 softmax 函數把分數轉成總和為 1 的機率:。成本同樣是真實類別的負對數機率的平均(類別交叉熵)[3]。本篇開頭 scikit-learn 的 LogisticRegression 處理十個數字時做的就是這件事,而它也正是 ML 02 中大多數分類網路的輸出層。
過擬合、欠擬合與正則化
白話版。 太簡單的模型抓不到模式(欠擬合,underfitting)。太有彈性的模型會把訓練範例連同雜訊一起背下來,遇到新範例就失敗(過擬合,overfitting)。我們用模型沒訓練過的資料來分辨兩者,並用懲罰大權重的方式馴服過於有彈性的模型。
親眼看它發生
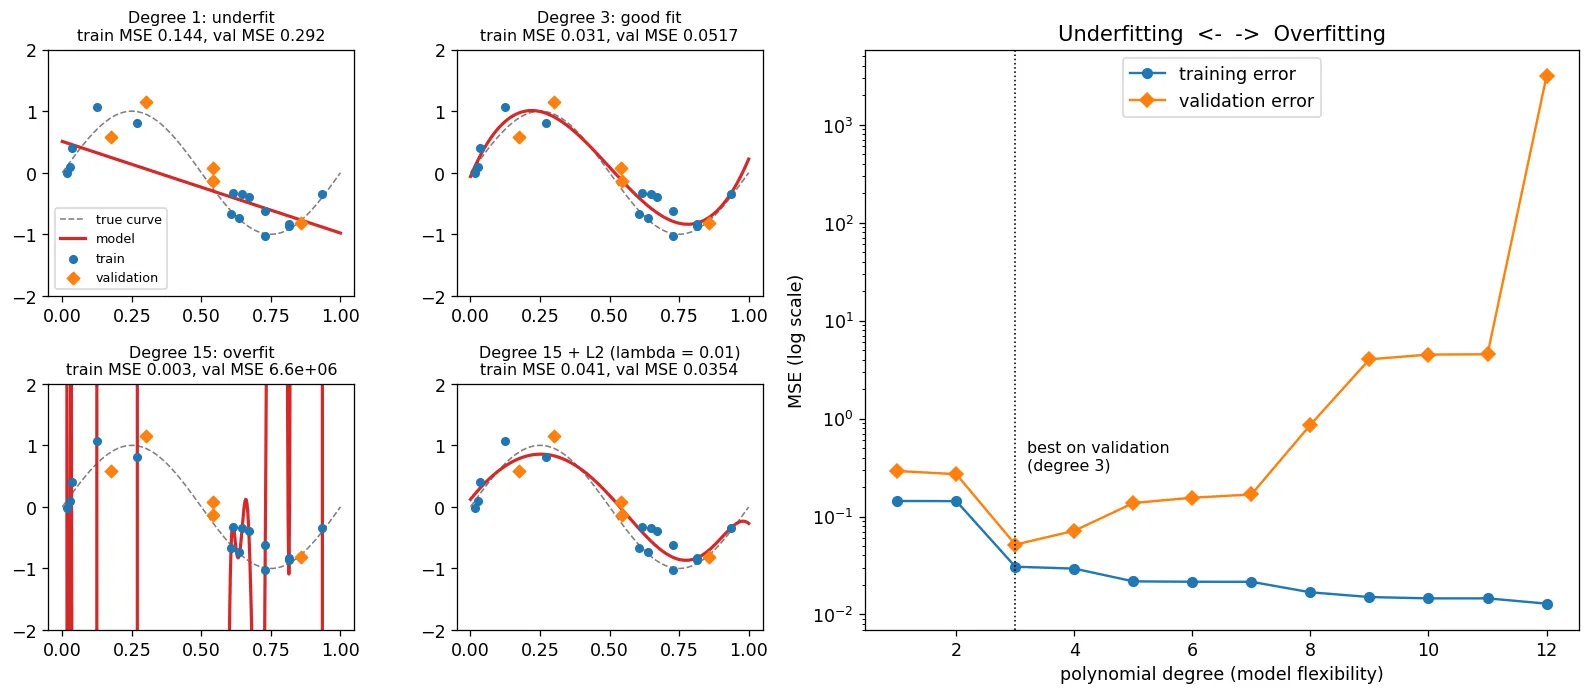
取 25 個帶雜訊的平滑曲線樣本,擬合不同次數的多項式,也就是在特徵 上做線性迴歸(圖 8):
- 1 次(欠擬合,高偏差)。直線跟不上曲線。不論在訓練集還是新資料上,誤差都很大。
- **3 次(擬合良好)。**曲線跟著趨勢走,忽略雜訊。兩邊的誤差都很小。
- **15 次(過擬合,高變異)。**曲線幾乎精確地穿過每個訓練點,所以訓練誤差接近零。但在點與點之間和點的範圍之外,它劇烈擺盪,新資料上的誤差暴增。
光看訓練誤差無法分辨好模型和過擬合的模型;它甚至偏好過擬合的那個。只有模型沒看過的資料才能揭露差別。這就是我們保留驗證集的原因。
使用驗證集與測試集
流程是:
- 在訓練集上擬合每個候選模型(每種次數、每種正則化強度)。
- 在驗證集上比較候選模型,保留最好的那個。
- 在測試集上回報所選模型的誤差,只做一次。
為什麼要三份而不是兩份?因為在驗證集上從眾多候選中挑出最好的,本身就是一種擬合:勝出者有一部分只是剛好在那些特定範例上運氣好。沒動過的測試集才能給出不偏的最終估計。資料很少時,可以用交叉驗證(cross-validation)取代單一的驗證集:把訓練資料切成 份,訓練 次,每次用不同的一份做驗證,再取平均。
要留意的模式:如果訓練誤差和驗證誤差都很高,模型欠擬合(換更有彈性的模型或更好的特徵)。如果訓練誤差很低、驗證誤差卻高得多,模型過擬合(取得更多資料、簡化模型,或加上正則化)。
L2 正則化
正則化(regularization)保留有彈性的模型,但不鼓勵極端的參數值。15 次多項式那條狂野的曲線,需要非常大、又彼此精細抵消的權重。L2 正則化在成本上加入權重平方大小的懲罰:
其中 是原本的成本(MSE 或對數損失), 是正則化強度(一個超參數),加總的範圍是所有權重,但慣例上不包括偏差 。 時回到原本的模型; 越大,權重越被拉向零,擬合出的函數越平滑; 太大則會欠擬合。對線性迴歸來說,這就是脊迴歸(ridge regression),由 Hoerl 與 Kennard 提出,用來在特徵高度相關時穩定最小平方估計 [20]。
從梯度下降的更新可以看出懲罰項做了什麼:
在每次一般的更新之前,每個權重都先乘上一個略小於 1 的數。這就是為什麼 L2 正則化在神經網路訓練中也被稱為權重衰減(weight decay)[3]。
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.metrics import mean_squared_error

rng = np.random.default_rng(0)
x = rng.uniform(0, 1, 25)
y = np.sin(2 * np.pi * x) + rng.normal(0, 0.25, 25)      # true curve + noise
X = x[:, None]

# 60% train, 20% validation, 20% test
X_tmp, X_te, y_tmp, y_te = train_test_split(X, y, test_size=0.2, random_state=0)
X_tr, X_va, y_tr, y_va = train_test_split(X_tmp, y_tmp, test_size=0.25, random_state=0)

def fit(degree, lam=0.0):
    reg = Ridge(alpha=lam) if lam > 0 else LinearRegression()   # sklearn calls lambda "alpha"
    model = make_pipeline(PolynomialFeatures(degree), StandardScaler(), reg)
    return model.fit(X_tr, y_tr)

for degree, lam in [(1, 0), (3, 0), (15, 0), (15, 1e-2)]:
    model = fit(degree, lam)
    tr = mean_squared_error(y_tr, model.predict(X_tr))
    va = mean_squared_error(y_va, model.predict(X_va))
    print(f"degree {degree:2d}, lambda {lam:g}: train MSE {tr:.3f}, val MSE {va:.3g}")

best = fit(15, 1e-2)                                    # chosen on validation only
print("test MSE:", round(mean_squared_error(y_te, best.predict(X_te)), 3))
輸出說明了一切:1 次的訓練/驗證 MSE 是 0.144/0.292(欠擬合),3 次是 0.031/0.052(良好),沒有正則化的 15 次訓練 MSE 只有 0.003,驗證 MSE 卻高達數百萬,因為有些驗證點落在訓練點之間很寬的空隙中(例如 到 之間),多項式在那裡劇烈擺盪。對同一個 15 次模型加上溫和的 L2 懲罰(),得到 0.041/0.035,測試 MSE 為 0.075。
評估模型
白話版。 單一個數字永遠說不完整個故事。選一個符合「犯錯代價」的指標,而且一定要和簡單的基準比較。
迴歸指標
迴歸最常用的指標是 MSE,,這裡不再有只是為了訓練方便的 。它的平方根 RMSE 和 的單位相同,比較好解讀(「平均大約差 3 分」)。平均絕對誤差(mean absolute error),,對少數大誤差比較不敏感 [5]。
分類指標
分類中,準確率(accuracy)是預測正確的比例。它容易理解,也容易騙人。在 digits 資料中,大約 10% 的影像是 9。一個永遠回答「不是 9」的「模型」有 90% 的準確率,卻完全沒用。
混淆矩陣(confusion matrix)計算二元問題的四種結果,「陽性」代表我們在意的那一類:
| 預測為陽性 | 預測為陰性 | |
|---|---|---|
| 實際為陽性 | 真陽性(TP) | 偽陰性(FN) |
| 實際為陰性 | 偽陽性(FP) | 真陰性(TN) |
由此得到
精確率(precision)回答「模型說是陽性時,有多常是對的?」召回率(recall)回答「所有真正的陽性中,模型找到了多少?」兩者互相拉扯:把邏輯迴歸的 0.5 決策門檻調低,會找到更多陽性(召回率較高),但也會發出更多假警報(精確率較低)。哪個比較重要取決於每種錯誤的代價:癌症篩檢不該漏掉腫瘤(高召回率),垃圾郵件過濾器則不該把真正的郵件藏起來(高精確率)。F1 分數是精確率與召回率的調和平均,把兩者合成一個數字 [5]。
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix, accuracy_score, precision_score, recall_score

X, y = load_digits(return_X_y=True)
y = (y == 9).astype(int)                  # "is it a 9?": only about 10% positives
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0)

lazy = np.zeros_like(y_te)                # always answers "not a 9"
model = LogisticRegression(max_iter=5000).fit(X_tr, y_tr)
pred = model.predict(X_te)

print("lazy accuracy :", round(accuracy_score(y_te, lazy), 3), " recall:", recall_score(y_te, lazy))
print("model accuracy:", round(accuracy_score(y_te, pred), 3),
      " precision:", round(precision_score(y_te, pred), 3),
      " recall:", round(recall_score(y_te, pred), 3))
print(confusion_matrix(y_te, pred))       # rows: true 0/1, columns: predicted 0/1
# lazy accuracy : 0.9   recall: 0.0
# model accuracy: 0.974  precision: 0.87  recall: 0.87
偷懶的基準有 90% 的準確率,召回率卻是零。真正的模型準確率 97.4%,聽起來只好一點點,但 0.87 的召回率顯示它確實找到了大部分的 9。一定要回報基準;類別不平衡時,一定要看準確率以外的指標。同樣的指標會在 DIP 的圖樣分類一章再次出現,並更仔細地處理門檻與多類別的問題。
現代觀點
本篇的機制(帶參數的模型、成本、以梯度為基礎的最佳化,以及保留資料的評估)幾十年來沒有改變,下面談到的每個系統也都還在使用它們。改變的是特徵從哪裡來、標籤從哪裡來,以及模型有多大。以下幾篇回顧文章把這些轉變描繪得很好。
機器學習這個領域。 Jordan 與 Mitchell 發表在《Science》的回顧 [7] 以一個問題來界定機器學習:如何打造能透過經驗自動進步的電腦;並把它定位在電腦科學與統計學的交會處、人工智慧與資料科學的核心。他們把機器學習在科學、醫療、製造、教育與金融等領域的快速擴散,歸因於三件事同時到來:新的學習演算法與理論、可取得資料量的爆炸性成長,以及便宜的運算。這個框架是對抗炒作的好解藥:方法的好壞,取決於它得到的資料與經驗。
從特徵工程到表示學習。 很長一段時間,傳統模型的成敗主要取決於人工設計的特徵,也就是由專家來做圖 1 中「數有墨跡的欄數」這一步:邊緣直方圖、紋理描述子、關鍵點描述子(見 DIP 12)。Bengio、Courville 與 Vincent [21] 認為這種依賴是一個弱點,因為正確的表示決定了任務的難易,並主張直接從資料學習表示本身。他們的回顧涵蓋了做到這件事的工具(機率模型、自編碼器、流形學習與深度網路),以及讓表示變好的通用先驗,例如把資料背後各自獨立的解釋因子分離開來。用本篇的語言來說,深度網路仍然是「特徵加上邏輯迴歸」,只是特徵由前面的層產生,而這些層的權重也是用同樣的梯度下降學出來的。這就是 ML 02 的主題。
自監督式學習。 學習表示需要資料,而標籤是昂貴的部分。Jing 與 Tian 關於自監督式視覺特徵學習的綜述 [22] 把不需要標籤的「前置任務」(pretext task)分成四類:以生成為基礎(例如重建影像或為影像上色)、以上下文為基礎(利用空間或時間結構,例如影像區塊的排列)、以免費語意標籤為基礎(使用自動得到的標籤,例如來自繪圖引擎或傳統方法),以及跨模態(判斷兩個訊號,例如影片與聲音,是否屬於同一事件)。它也確立了至今仍是標準的評估流程:用表示遷移到分類、偵測、分割等下游任務的表現來評判它。Gui 等人較新的綜述 [23] 則把這個領域重新整理為:以上下文為基礎的方法、對比學習(利用負例、自蒸餾或特徵去相關)、以遮罩影像建模為主的生成式方法,以及結合對比與生成目標的混合方法,反映出遮罩自編碼器 [12] 之後轉向遮罩預測的趨勢。對實務工作者,Balestriero 等人的《A Cookbook of Self-Supervised Learning》[24] 把現代方法分成深度度量學習家族、自蒸餾家族、典型相關分析家族與遮罩影像建模,並坦白指出結果有多依賴資料擴增與訓練時使用的小型「投影器」(projector)網路等細節。
基礎模型。 Bommasani 等人的報告 [10] 為由此產生的範式命名:在大規模、廣泛的資料上訓練(通常是自監督式),再調整去做許多下游任務的模型。報告強調了兩個後果。湧現(emergence):像是憑提示中的幾個例子就能遵循指示 [11] 這類能力,是隨著規模出現的,而不是被設計出來的。同質化(homogenization):許多應用如今都由同樣少數幾個基礎模型調整而來,這帶來巨大的槓桿效果,但也代表基礎模型的缺陷會被建立在它之上的一切所繼承。報告也強調,我們對這些模型如何運作、何時會失敗的理解仍非常有限。
基於人類回饋的強化學習。 強化學習已經從遊戲走到語言模型訓練的最後階段 [13]、[14]。Casper 等人 [25] 整理了可能出錯的地方。他們依照 RLHF 的三個步驟(收集人類回饋、擬合獎勵模型、最佳化策略),逐一列出每一步的問題:人的回饋帶有雜訊、前後不一致,而且可能被操弄;獎勵模型只是「人們真正想要的東西」的不完美替代;而針對這個替代品用力最佳化的策略,可能會鑽它的漏洞。他們區分了在 RLHF 框架內用更好的方法就能解決的問題,以及需要換一種方法才能克服的根本限制,並主張提高透明度、把 RLHF 與其他安全措施結合,而不是只依賴它。
大規模最佳化。 Bottou、Curtis 與 Nocedal [18] 解釋了為什麼成為機器學習主力的,是樸素的隨機梯度法,而不是傳統數值分析中更精巧的最佳化方法:資料充足時,便宜而帶雜訊的一步勝過昂貴而精確的一步。Adam [19] 等自適應方法則在其上加入每個參數各自的步長。本節提到的每個模型,無論多大,都是用本篇小批次迴圈的後代訓練出來的。
未解問題。 儘管規模驚人,這篇入門教學中的幾個問題仍然是最困難的。泛化:非常大的模型幾乎完美地擬合訓練資料,卻仍能泛化,這和圖 8 中簡單的過擬合圖像不符,其原因尚未完全被理解。評估:當模型用了相當大比例的公開網路資料來訓練,就很難保證測試集沒有出現在訓練資料中,因此誠實評估的基礎,乾淨的訓練/測試分離,變得難以驗證。目標:成本函數是模型唯一會最佳化的東西,而 RLHF 顯示出要寫出一個真正反映人們需求的成本有多難。還有資料:模型能學到什麼,受限於它看到的資料與標籤,以及其中所有的缺口與偏差。
針對電腦視覺,傳統路線(人工特徵加上簡單分類器)在 DIP 的圖樣分類一章中有完整發展;學習的路線則延續到 ML 02 與〈Deep Learning for Image Processing〉。
重點整理
- 機器學習用一個參數由範例擬合而來的彈性模型,取代手寫規則;當規則難以說清楚、範例卻容易取得時,它最能發揮。
- 各範式的差別在於回饋:監督式(有正確答案;數字用迴歸、類別用分類)、非監督式(沒有答案;分群、降維、異常偵測)、自監督式(答案由資料本身製造),以及強化學習(動作換來獎勵)。KNN 是監督式;k-means 是分群。
- 把模型 和成本 分開:模型把輸入對應到預測值;成本把參數對應到誤差。訓練就是最小化 。
- 梯度下降重複 。在最小值處,導數為零。學習率必須小到不會越過頭,又大到能有進展;小批次讓每一步都很便宜。
- 做梯度下降前先縮放特徵,而且只用訓練集的統計量。
- 邏輯迴歸對線性分數套上 sigmoid,並最小化交叉熵;它的決策邊界是 ,梯度形式和線性迴歸相同。
- 用模型沒訓練過的資料評判它:用驗證集做選擇、在測試集上只回報一次、模型過擬合時加上(L2)正則化,類別不平衡時要看準確率以外的指標。
練習
- 手算導數。 對單一特徵的 MSE 成本 ,推導 與 。接著對三個點 ,從 出發,以 計算一步梯度下降。
提示
對每個平方項用連鎖律得到 ,2 和 抵消,就得到梯度下降一節中的公式。在 時誤差是 。所以 ,。一步之後 ,。
- 找出發散的門檻。 對 (沒有偏差),證明一步梯度下降會把到最佳值 的距離乘上 ,其中 。 在什麼範圍內梯度下降會收斂?用特徵縮放一節中的
gd函數檢查你的答案。
提示
因為 是曲率為 、最小值在 的拋物線,。所以 。當 ,也就是 時收斂; 時一步就落在最小值上。有多個特徵時, 換成 的最大特徵值,這就是為什麼一個尺度巨大的特徵會逼得 必須非常小。
- 用迴歸做分類。 用
make_classification(n_features=1, n_informative=1, n_redundant=0, n_clusters_per_class=1)產生一維資料,再加上五個 非常大的第 1 類範例。分別擬合LinearRegression(以 0.5 為門檻)與LogisticRegression。比較加入額外點前後兩者的準確率,並解釋差異。
提示
額外的點很容易分類,但平方誤差仍然希望直線經過它們附近。直線的斜率下降,跨過 0.5 的位置往第 1 類移動,一些靠近邊界的普通第 1 類點因此被分錯。分類正確且離得很遠的點,對數損失已經接近 0,所以邏輯迴歸幾乎不受影響。
- 縮放 digits。 用本篇從頭實作的邏輯迴歸,在 digits 資料上訓練「是 9 或不是 9」,一次用原始像素(0 到 16),一次用除以 16 的像素。使用相同的步數,找出各自可用的最大學習率。縮放改變的是最終準確率、速度,還是兩者都有?
提示
這裡所有像素的單位相同,所以效果比圖 6 溫和,但原始輸入大了 16 倍,梯度的大小和地形的曲率也隨之放大。原始像素的安全學習率大約小 倍。學習率都調好時,兩者能達到相近的準確率;縮放過的版本只是比較容易調。
- 選擇 lambda。 用多項式的例子,固定 15 次,嘗試 。以對數橫軸畫出訓練與驗證 MSE 對 的變化。哪一端欠擬合、哪一端過擬合?你會選哪個 ?為什麼不能用測試集來做這個選擇?
提示
很小的 等於沒有正則化(過擬合:訓練誤差低、驗證誤差高)。很大的 把曲線壓成接近常數(欠擬合:兩種誤差都高)。選驗證誤差最低的 。如果測試集參與了選擇,它就不再是新資料上效能的不偏估計。
- 哪一種範式? 把每個問題歸類為監督式(迴歸或分類)、非監督式、自監督式或強化學習,並說出目標值或獎勵:(a) 用附有實際結果的使用紀錄,估計手機剩餘的電池時間;(b) 把一百萬張沒有標籤的商品照片分組以便瀏覽;(c) 藉由預測每張照片缺少的四分之一來預訓練影像模型;(d) 教機械手臂堆積木,只有在積木堆穩時才給分數;(e) 在沒有任何故障標註的情況下,標出工廠感測器資料流中的異常讀數。
提示
(a) 監督式迴歸;目標值是剩餘時數。(b) 非監督式分群。(c) 自監督式;目標值是被藏起來的像素,由資料本身產生。(d) 強化學習;獎勵是積木是否堆穩,要到最後才給。(e) 非監督式異常偵測。
參考文獻
- Shyandram, “Introduction to Machine Learning,” blog post, 2024; updated 2026. link
- A. L. Samuel, “Some studies in machine learning using the game of checkers,” IBM Journal of Research and Development, vol. 3, no. 3, pp. 210–229, 1959. doi
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016. book site
- A. Ng, E. Shyu, A. Bagul and G. Ladwig, “Machine Learning Specialization,” DeepLearning.AI and Stanford Online, Coursera. course page
- F. Pedregosa, G. Varoquaux, A. Gramfort, V. Michel, B. Thirion et al., “Scikit-learn: Machine learning in Python,” Journal of Machine Learning Research, vol. 12, pp. 2825–2830, 2011. link
- E. Alpaydin and C. Kaynak, “Optical Recognition of Handwritten Digits,” UCI Machine Learning Repository, 1998. doi
- M. I. Jordan and T. M. Mitchell, “Machine learning: Trends, perspectives, and prospects,” Science, vol. 349, no. 6245, pp. 255–260, 2015. doi
- R. S. Sutton and A. G. Barto, Reinforcement Learning: An Introduction, 2nd ed., MIT Press, 2018. book page
- Y. LeCun and I. Misra, “Self-supervised learning: The dark matter of intelligence,” Meta AI blog, 2021. link
- R. Bommasani, D. A. Hudson, E. Adeli et al., “On the opportunities and risks of foundation models,” arXiv:2108.07258, 2021. arXiv
- T. Brown, B. Mann, N. Ryder, M. Subbiah, J. D. Kaplan et al., “Language models are few-shot learners,” in Advances in Neural Information Processing Systems (NeurIPS), vol. 33, 2020. link
- K. He, X. Chen, S. Xie, Y. Li, P. Dollár and R. Girshick, “Masked autoencoders are scalable vision learners,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), pp. 15979–15988, 2022. arXiv
- L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright et al., “Training language models to follow instructions with human feedback,” in Advances in Neural Information Processing Systems (NeurIPS), vol. 35, 2022. link
- DeepSeek-AI, “DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning,” Nature, vol. 645, pp. 633–638, 2025. arXiv
- A. K. Jain, “Data clustering: 50 years beyond K-means,” Pattern Recognition Letters, vol. 31, no. 8, pp. 651–666, 2010. doi
- I. T. Jolliffe and J. Cadima, “Principal component analysis: A review and recent developments,” Philosophical Transactions of the Royal Society A, vol. 374, no. 2065, 20150202, 2016. doi
- V. Chandola, A. Banerjee and V. Kumar, “Anomaly detection: A survey,” ACM Computing Surveys, vol. 41, no. 3, 2009. doi
- L. Bottou, F. E. Curtis and J. Nocedal, “Optimization methods for large-scale machine learning,” SIAM Review, vol. 60, no. 2, pp. 223–311, 2018. doi
- D. P. Kingma and J. Ba, “Adam: A method for stochastic optimization,” in Proc. International Conference on Learning Representations (ICLR), 2015. arXiv
- A. E. Hoerl and R. W. Kennard, “Ridge regression: Biased estimation for nonorthogonal problems,” Technometrics, vol. 12, no. 1, pp. 55–67, 1970. doi
- Y. Bengio, A. Courville and P. Vincent, “Representation learning: A review and new perspectives,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, no. 8, pp. 1798–1828, 2013. doi
- L. Jing and Y. Tian, “Self-supervised visual feature learning with deep neural networks: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 43, no. 11, pp. 4037–4058, 2021. doi
- J. Gui, T. Chen, J. Zhang, Q. Cao, Z. Sun, H. Luo and D. Tao, “A survey on self-supervised learning: Algorithms, applications, and future trends,” arXiv:2301.05712, 2023. arXiv
- R. Balestriero, M. Ibrahim, V. Sobal, A. Morcos, S. Shekhar et al., “A cookbook of self-supervised learning,” arXiv:2304.12210, 2023. arXiv
- S. Casper, X. Davies, C. Shi et al., “Open problems and fundamental limitations of reinforcement learning from human feedback,” Transactions on Machine Learning Research, 2023. TMLR · arXiv