IT 08・網路、資訊不等式與學習
先備知識:IT 07・統計證據、最大熵與成長
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
資訊理論
你將學到
- 描述分散式來源與多重存取通道的速率區域。
- 解釋廣播、中繼與一般網路為何需要不同論證。
- 使用 log-sum、Pinsker、熵功率與條件資訊不等式。
- 區分表示資訊與訓練樣本資訊。
- 執行小型分散式同位檢查解碼器,明確回報有限誤差。
- 把完整書籍章節地圖連到現代學習,不過度宣稱極限。
先看全貌
一個發送者與接收者會給單一容量,多個來源或接收者則給相容速率區域。提高某速率可能降低另一個;資訊也可能只有合在一起才有用,各分量單看卻沒有用。
最後一章依 Cover 與 Thomas 第 15 章網路與第 17 章不等式 [1]。其他十五章已由前面內容與 IT 01 閱讀地圖涵蓋。最後以有限合成實驗連結來源相依、編碼、解碼與任務資訊。
課程使用已出版第二版,並以當代綜述與明確標示的 2026 年擬議章補充。
分散式來源編碼:相關性節省速率
兩編碼器可以各自描述相關觀測,讓聯合解碼器利用關係,不必每個都獨立發送全部位元。
獨立點對 依固定有限聯合法則。第一編碼器只看 ,第二只看 ,共同解碼器重建兩區塊。Slepian–Wolf 漸近近乎無損區域為
是每對來源樣本由各編碼器發送的位元,熵使用指定聯合來源。邊界不等式描述閉包;編碼以適當速率餘裕操作,使區塊誤差趨零 [1]。
個別界假設另一來源可以在解碼時幫忙;總和界計全部聯合不確定性。沒有假設編碼器看見另一方目前區塊;允許此觀測會定義不同問題。
公平 、、獨立 Bernoulli 雜訊機率 下,兩邊際熵都一,聯合熵 。忽略相依的分別編碼,漸近需每對兩位元;聯合解碼可利用較小聯合不確定性。
一個角點把 以完整邊際速率傳送,並把 壓到接近 。解碼器已有重建 作旁資訊,啟發後面的同位檢查症候實驗。
隨機分箱提供存在論證:把來源區塊放入箱,再用另一已解碼來源,找發送箱中可能匹配區塊。箱索引比完整來源索引短,相關性解開歧義。
這不保證每個有限點對精確重建。罕見或模糊區塊可能失敗。真正有限無損程序,若要求每個允許實現都恢復,需額外逃脫機制或其他處理。
隨機分箱為什麼有三個速率限制?
各編碼器把每個來源區塊隨機指派到箱,傳送箱索引。解碼器在兩個指定箱中尋找聯合典型點對。競爭點對可能有三種錯誤:只有 X 錯、只有 Y 錯,或兩者都錯。
| 競爭點對 | 典型候選數尺度 | 每候選碰撞機率 |
|---|---|---|
| X 錯、Y 正確 | ||
| X 正確、Y 錯 | ||
| 兩者都錯 |
是配對區塊長度, 是傳送箱索引速率,熵指數依固定聯合來源。尺度省略小典型性容許誤差與有限前置因子。獨立箱指派給碰撞因子,聯合典型性則限制需要考慮的候選數。
候選數乘碰撞機率,再用聯集界限。適當餘裕下,三項全部趨零的條件,正是兩個別速率超過條件熵、總和超過聯合熵。真正點對未通過典型性測試的機率也趨零。平均所有指派後,便證明某固定共享分箱規則具有小區塊錯誤 [1]。
證明解釋相關性的好處與限制。解碼旁資訊把 X 候選數從完整來源目錄降成條件目錄,卻不消除區分剩餘候選的需求。總和限制則處理兩個別界限無法單獨排除的同時歧義。
公平位元、翻轉機率 0.1 時,條件熵約 0.468996,聯合熵每對 1.468996 位元。角點約 、,對稱點的各編碼器速率是 0.734498。各給 0.5 雖通過個別界限,卻違反總和界限。這些是極限邊界值,實際漸近構造會保留餘裕,不保證短區塊恰在邊界可行。
多重存取:獨立訊息共享輸出
兩發送者都可對同一接收器通訊。接收器觀測不只限制每人速率,也限制資訊總和。
有限無記憶通道 、獨立訊息與固定乘積輸入法則的區域包括
是發送者輸入, 是共享輸出, 是每次共同通道使用位元。對乘積輸入法則取聯集與分時,得到一般雙使用者多重存取容量區域 [1]。
個別界的條件化表示知道另一輸入時,接收器如何區分該使用者訊息;總和界處理聯合解碼。各自最大化個別式,不會取消共享總和限制。
分時引入共同預定變數 ,給定 時輸入為乘積。各界也條件於 ,把操作點凸化。共享排程不代表發送者取得任意依訊息的合作能力。
獨立實數高斯訊號、功率 、加性雜訊變異數 下,
一次使用含兩個同時實數輸入,訊號有獨立訊息與標準平均功率限制。二分之一保留實數慣例。
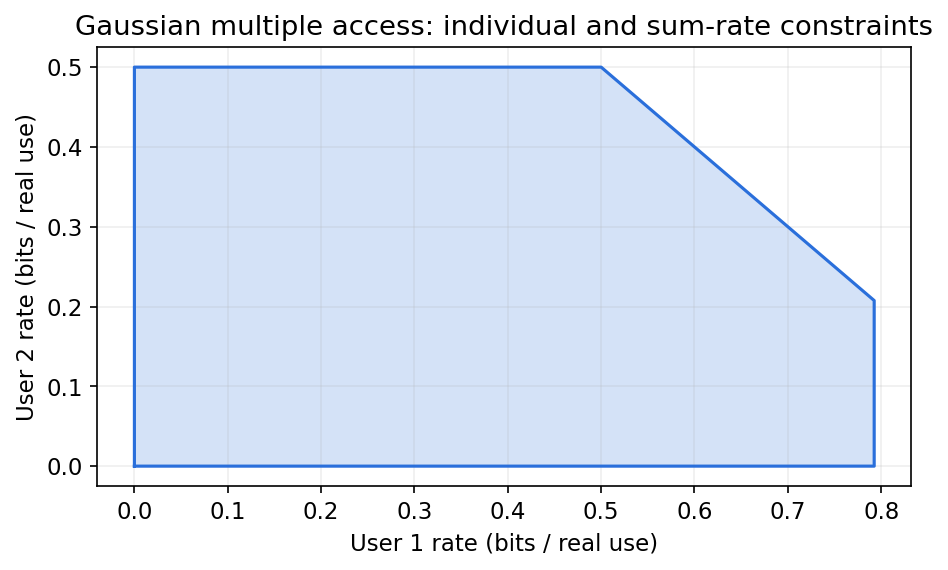
逐次解碼可達角點:先把另一訊息當雜訊,解一個訊息,再移除已解碼貢獻。順序改變誰取得較有利的條件速率。聯合解碼與分時描述更廣區域。
手算兩種高斯解碼順序
圖中功率 、,雜訊變異數 。使用者一的個別界限約每次 0.792481 位元,使用者二為 0.5,共享總和界限一。點 通過兩個別界,卻違反總和; 則通過三者。
先解使用者一時,暫時把使用者二的獨立高斯訊號當成變異數一的額外雜訊,因此第一人的速率限制為 。成功解碼並相減後,第二人只剩原雜訊,可達 0.5,得到角點 。
先解第二人時,其初始速率為 。移除後,第一人可達 ,得到角點 。兩角點總和都是一,但解碼順序改變分配。
相減論證假設第一訊息解碼正確。第一個錯誤決策可能傳播至第二個,因此有限接收器必須評估聯合訊息錯誤,也評估個別錯誤。漸近角點可指引設計,不應掩蓋此實作問題。
廣播與中繼改變資訊模式
一發送者、兩接收者,不是兩發送者、一接收者的反向問題。先聽再傳的中繼,又是另一種模式。
物理退化廣播通道的 ,讓接收器一在指定統計意義較強。疊加建構使用 的輔助變數 :
是較弱接收器私人訊息速率, 是較強接收器私人訊息速率, 是兩者可解的層。對適當 取聯集,給退化通道容量區域 [1]。
Markov 順序是假設接收觀測的關係,不只是依樣本準確度排序。一般廣播通道不一定退化,不能繼承此精確區域。
無記憶中繼的來源輸入 、中繼輸入 、中繼觀測 、目的端觀測 ,有 cut-set 上界
第一切割把來源與中繼加目的端分開;第二把來源加中繼與目的端分開。上界輸入聯合法則允許統計合作,作為外部鬆弛。
Cut-set 界不會自動可達。中繼可以解訊息、描述觀測或採其他因果策略,各有條件。許多一般網路容量仍未解。
重點是先畫實際資訊模式,再用公式:獨立訊息、相關來源、旁觀測、因果中繼與接收需求,都是不同假設。單一點對點容量不能概括全部。
聯合用途可能不見於邊際資訊
兩個各自沒有資訊的特徵,可能一起決定目標。一次只排名一特徵,可能把兩者都丟掉。
令 是獨立公平位元,。則
是二元互斥或目標。任一邊際輸入仍讓目標公平,知道兩者就精確決定;給定另一輸入,第一輸入顯示完整相關性。
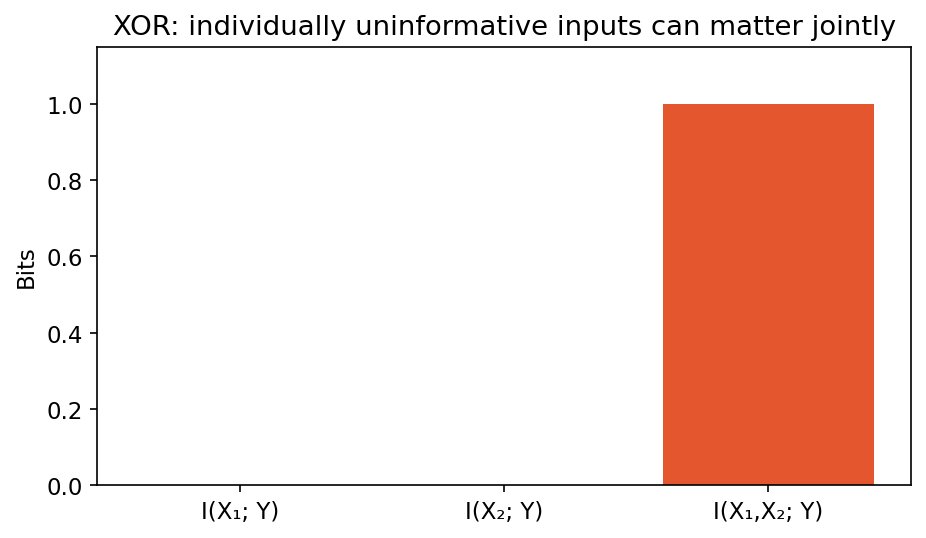
「協同」可非正式描述只在合併後出現的資訊,但一般量化冗餘與協同分解,需要額外定義。三個互資訊值本身,不會定義任意變數的通用分解。
這對多模態學習重要。單看弱的模態可能在上下文有用;兩個強邊際特徵也可能大量重疊。應分析聯合法則與接收任務,不把邊際相關等同唯一貢獻。
計算函數是另一個分散式問題
假設各編碼器觀察獨立公平區塊 ,解碼器只需逐座標互斥或。輸出每對有一位元熵,很容易以為每對總共一位元就夠。
這忽略誰看輸入。額外把第二原始區塊給解碼器:若能從兩傳送索引求互斥或,就能恢復第一區塊。因輸入獨立,第二編碼器索引沒有提供額外第一區塊資訊。
因此,本例第一編碼器要使誤差趨零,就必須傳約每座標一位元;對稱地,第二也一樣。所需函數熵雖一,分散式總需求仍可能兩位元。
若中央編碼器看到兩輸入,就可直接用每對一位元傳互斥或。目標不變,觀測模式不同。這具體說明任務導向速率宣稱應附網路圖。
本例也區分兩種「聯合資訊」。接收者需要聯合計算,發送者卻沒有聯合觀測。不能只因某中央特徵算好後足夠,就假設學習系統已取得它。
實際應用可能有相關輸入、互動、共同隨機性或其他旁資訊,都會改變問題。未推導相應限制前,不能套用獨立非互動例子的速率結論。
較強不等式延伸工具
資訊不等式常比較合併結果、改變分布或加入獨立雜訊後還剩什麼。單位與假設決定意義。
非負 、正 的 log-sum 不等式為
索引元素, 是總和,零項用標準連續慣例。全零 時兩側零。此式支援散度凸性與聚合資料處理形式 [1]。
在分割每格內使用,可證合併結果不增加相對熵。精細量測能區分的分布差異,粗摘要可能已看不到。
有限機率向量 的 Pinsker 不等式為
總變差限制事件機率差,散度使用自然對數。若以位元回報,根號內散度要乘 。小散度可控制事件機率差,大散度則可能讓界無用。
離散熵也具次模性:
是變數索引集合, 是相應變數群,空群熵零。差是非重疊部分給定交集的條件互資訊,因此非負。
這是子集熵關係,不表示每個任務相關函數都次模。XOR 提醒我們,另一特徵加入後,特徵資訊可以增加。
熵功率與高斯雜訊
微分熵能轉成類似變異數的量。獨立連續訊號相加後,熵功率不小於原本總和。
維向量有有限自然單位微分熵時,定義熵功率
是維度, 使用自然對數。純量高斯熵功率等於變異數;等向高斯向量則等於共同座標變異數。
相同維度獨立向量的熵功率不等式為
須滿足相應密度與有限性假設。標準非退化設定下,獨立高斯向量且共變異數成比例時等號成立 [1]。
de Bruijn 恆等式連結雜訊平滑與 Fisher 資訊:
是獨立標準高斯向量, 是每座標雜訊變異數, 是位置 Fisher 資訊。需要平滑性與可積分性。
此 Fisher 是與位置估計相關的密度梯度量,不是前章任意參數 Fisher。明確定義可避免混淆同名物件。
加雜訊可以增加觀測熵,卻減少原始資訊,沒有矛盾:熵功率描述輸出散布,資料處理描述保留關係。現代含雜訊表示模型應區分兩者。
表示資訊與樣本資訊
特徵可保留目標,限制原始細節;訓練模型也可揭露對特定樣本依賴多少。這是不同資訊問題。
的資訊瓶頸目標為
是觀測, 是選定相關目標, 是可能隨機的表示, 平衡壓縮與目標資訊。Goldfeld 與 Polyanskiy 的出版教學文 [2] 發展理論與學習連結。
目標選擇相對任務的統計表示,不證明每個神經網路自動符合相同最佳化,也不證明表示保留所有未來目標。
瓶頸如何移除干擾、保留標籤?
有限例子讓表示目標具體。令標籤 與干擾位元 是獨立公平位元,觀測 包含兩者。比較完整表示 、只含標籤的 ,以及常數表示。
| 表示 | 目標 | ||
|---|---|---|---|
| 兩個位元 | 2 | 1 | |
| 只含標籤 | 1 | 1 | |
| 常數 | 0 | 0 | 0 |
資訊單位都是位元,相關權重 無單位。只含標籤的表示保留此標籤全部需求,比完整表示少花一位元。 時常數勝出, 時保留標籤勝出; 時標籤與常數平手。
結論不限於這三個例子。資訊鏈式法則給出
, 是獨立干擾位元, 是任意由 產生的表示。條件項非負,因此 時全域下界零,由常數達到。 時,利用 得下界 ,由 達到。保留任務的最佳解來自鏈式法則與明確來源,不是「壓縮一定改善學習」的非正式主張。
若未來目標改成 ,舊的純標籤表示對此新公平目標互資訊零,完整觀測卻能決定它。不可逆任務壓縮即使對原相關準則最佳,也會限制未來任務轉移。
符號也區分本節兩種資訊問題:此處討論單一觀測與表示,後面的學習界限則討論模型 與全部訓練樣本 。減少 中干擾資訊,不直接證明 較小,也不直接建立數值泛化保證。
學習時,令 是獨立訓練樣本, 是學得模型。母體與經驗損失為
是母體法則,新 與訓練獨立, 是所選損失。相關資訊可為 ,而非特徵資訊 。
每個固定模型損失在 下都是 次高斯時,標準期望界形式為
期望平均樣本與學習器隨機性, 是共同集中參數,資訊使用自然對數。 有界損失可用 [3]。
這是期望界,不自動成為某訓練網路的高機率憑證。確定性連續學習器可能有無窮樣本資訊,使界無用。條件資訊與其他精細框架處理不同隨機化、抽樣慣例 [3]。
程式:精確有限學習界
完整例子只依多數標籤學常數二元分類器。輸出是確定性位元,所以 ,全部期望都可對二項計數加總。
程式碼 · Python · 18 行
import numpy as np
from scipy.stats import binom

p = 0.65
for n in [5, 20, 100]:
    counts = np.arange(n+1)
    mass = binom.pmf(counts, n, p)
    prediction = counts >= n/2
    training_loss = np.where(prediction, (n-counts)/n, counts/n)
    population_loss = np.where(prediction, 1-p, p)
    gap = mass @ (population_loss-training_loss)
    probability_one = mass[prediction].sum()
    probabilities = np.array([probability_one, 1-probability_one])
    positive = probabilities > 0
    information_nats = -np.sum(probabilities[positive]*np.log(probabilities[positive]))
    bound = np.sqrt(information_nats/(2*n))
    assert abs(gap) <= bound + 1e-12
    print("Length / expected gap / information bound:", n, gap, bound)
計算納入模型與樣本的選擇相依。把所選分類器當成與訓練標籤獨立,會抹掉正在分析的泛化間隙。
專題:同位檢查分箱與旁資訊解碼
編碼器替二元區塊發送短同位檢查標籤。解碼器結合標籤與相關區塊,選最可能原始資料。
二元區塊 、具有 個獨立列的公開二元矩陣 ,傳送症候
為 乘 , 含 個同位檢查位元,乘法用二元體加法與乘法。每個症候辨認一箱候選區塊。
解碼器取得 ,獨立翻轉機率低於二分之一,再從症候相容候選選與 Hamming 距離最小者。指定法則下,這是最大條件概似。
編碼器從不看 ,矩陣與區塊長度共享,解碼器取得 作旁資訊。負載速率為 ,不含傳送或重建旁資訊程序。
因此,實驗對應來源編碼角點,不是免費壓縮兩觀測。若第二區塊也須傳送,其長度應計入總速率。共享旁資訊是有來源的假設,不是不明解碼優勢。
程式:窮舉有限解碼與整區塊誤差
完整 CPU 例子採十位元區塊,讓窮舉可行。它在二元體檢查矩陣秩,不使用實數數值秩。
程式碼 · Python · 45 行
import numpy as np

rng = np.random.default_rng(43)
n, trials, flip = 10, 3000, 0.1
patterns = ((np.arange(2**n)[:, None] >> np.arange(n)) & 1).astype(np.uint8)
source_indices = rng.integers(2**n, size=trials)
source = patterns[source_indices]
side = source ^ rng.binomial(1, flip, size=source.shape).astype(np.uint8)

def binary_rank(matrix):
    work = matrix.copy()
    rank = 0
    for column in range(work.shape[1]):
        pivots = np.flatnonzero(work[rank:, column])
        if len(pivots) == 0:
            continue
        pivot = rank + pivots[0]
        work[[rank, pivot]] = work[[pivot, rank]]
        for row in range(work.shape[0]):
            if row != rank and work[row, column]:
                work[row] ^= work[rank]
        rank += 1
        if rank == work.shape[0]:
            break
    return rank

for parity_bits in [4, 6, 8]:
    while True:
        H = rng.integers(2, size=(parity_bits, n), dtype=np.uint8)
        if binary_rank(H) == parity_bits:
            break
    weights = 2**np.arange(parity_bits)
    syndromes = ((patterns @ H.T) % 2) @ weights
    bins = [np.flatnonzero(syndromes == s) for s in range(2**parity_bits)]
    assert all(len(group) == 2**(n-parity_bits) for group in bins)
    decoded = np.empty(trials, dtype=int)
    for t, (index, observation) in enumerate(zip(source_indices, side)):
        candidates = bins[syndromes[index]]
        distances = np.count_nonzero(patterns[candidates] != observation, axis=1)
        decoded[t] = candidates[np.argmin(distances)]
    block_error = np.mean(decoded != source_indices)
    print("Parity bits / payload rate / full-block error:",
          parity_bits, parity_bits/n, block_error)
conditional_entropy = -flip*np.log2(flip)-(1-flip)*np.log2(1-flip)
print("Asymptotic side-information reference:", conditional_entropy)
這是有限示範,不是達容量建構。不同隨機矩陣有不同誤差;增加同位位元,不保證每個獨立抽樣矩陣都單調改善。參考熵是長區塊極限,不是十位元精確預測。
平手依候選順序確定處理。雜訊可能把旁區塊移得更近錯誤但症候相容的來源。要求每次含雜訊試驗都往返完全一致,是錯誤測試:程序刻意回報有限訊息誤差。
真正無損檔案程序應提供逃脫或互動修正,明確計傳送成本。此處學習目標是看旁資訊如何縮小箱,以及有限歧義如何保留。
現代觀點
Hellström 等人的 2025 年出版專論 [3],透過期望、機率與條件資訊表示,整理資訊論與 PAC-Bayesian 泛化。分類幫助區分平均選擇相依界,與單一部署預測器保證。
Nguyen 等人的 2025 年語意通訊綜述 [4],區分接收者意圖建模、生成解碼與學得聯合編碼。網路觀點把接收者知識與任務目標放中心,應納入數學資訊模式。
El Gamal 的 2026 年擬議章 [5],把教科書討論延伸至統計學習,草稿狀態保持明確。現代推論與生成模型可以用相同散度工具,卻另有計算與評估問題。
開放問題包括一般多使用者區域、短區塊分散式碼、真實相依與通道偏移、罕見內容任務準則,以及高維學習系統有用資訊界。新架構不會只因產生合理樣本就解決它們。
全課程推論是:解讀資訊宣稱前,先問五件事:涉及哪些隨機變數;誰觀察各變數;假設哪些來源與通道法則;需要什麼重建或決策;以及如何量測速率、誤差與資源成本。
資訊檢核可以把問題變成簡短實驗紀錄:
| 選擇 | 應記錄內容 |
|---|---|
| 來源 | 母體、分組與相依假設 |
| 觀測 | 各編碼器、接收器分別可用的變數 |
| 描述 | 字母集合、實際位元流、共享參數與旁資料流 |
| 通道 | 條件法則、記憶、功率與使用慣例 |
| 目標 | 精確訊息、有損重建或指定任務 |
| 評估 | 固定測試集、誤差定義、速率與執行時間 |
即使沒有緊的定理,紀錄仍有用。它避免數字在訓練、分析與部署間悄悄變義,也讓負面結果提供資訊:不佳速率可能來自機率模型、重建限制或有限解碼器,而非同一底層極限。
課程後的閱讀與專題路徑
可以三次重讀完整書籍。先用熵、編碼、通道與失真例子鞏固第 1–5、7–10 章;再把第 6、11–14 章連到預測、證據、最大熵、通用碼與描述複雜度;最後讀第 15–17 章,把網路假設與不等式放在每個定理旁。
小專題可選明確聯合法則,或獨立收集資料集,配一個接收者目標。實作基準編碼器與解碼器,回報實際速率與決策誤差,再一次只改一元件。機率模型、量化器與通道碼回答不同實驗問題。
自迴歸視覺章 連結逐步機率分解與現代模型;表示章 發展任務特徵;語言模型章 連結條件預測與 token 序列。
資訊定義具體時,連結最強。Tokenization 改變字母與單位,學得潛在變數改變觀測,生成重建改變失真問題。比較數值資訊前,應先說明選擇。
重點整理
- 網路產生相容速率區域,不是通用純量速率。
- 分散式解碼利用相關性,不賦予未觀察輸入。
- 多重存取個別速率仍受共享總和限制。
- 廣播與中繼公式依特定資訊模式。
- 聯合任務資訊可能不見於個別特徵資訊。
- 進階不等式需要明確單位、支撐與獨立假設。
- 表示資訊與樣本相依泛化是不同物件。
- 有限解碼、實際速率與誠實誤差,完成理論圖像。
練習
- 公平 、、翻轉機率 0.2 下,求 Slepian–Wolf 角點與聯合熵,說明各編碼器觀察什麼。
提示
條件熵用 。
- 求圖參數的兩個高斯多重存取角點,驗證總和限制並說明逐次解碼順序。
提示
一人達個別最大值,另一填總和界。
- 說明一般廣播通道為何不能繼承物理退化區域,指出缺少的條件關係。
提示
檢查 。
- 對 、 驗證 Pinsker 界,一致使用自然與二進位散度。
提示
以 把位元轉 nats。
- 把同位碼區塊長度改 12,比較數種同位位元數,保留窮舉成本,回報區塊誤差而不只位元誤差。
提示
候選表有 列。
- XOR 目標下,比較只保留 與保留點對,再說明確定性連續表示的原輸入資訊為何可無窮,而離散任務資訊仍有界。
提示
區分目標熵與精確連續關係。
參考文獻
- T. M. Cover and J. A. Thomas, Elements of Information Theory, 2nd ed., Wiley, 2006, Chapters 15 and 17. 出版社書頁與目錄。
- Z. Goldfeld and Y. Polyanskiy, “The Information Bottleneck Problem and Its Applications in Machine Learning,” IEEE Journal on Selected Areas in Information Theory, 1(1), 2020, DOI: 10.1109/JSAIT.2020.2991561. 機構最終手稿紀錄。
- F. Hellström, G. Durisi, B. Guedj and M. Raginsky, “Generalization Bounds: Perspectives from Information Theory and PAC-Bayes,” Foundations and Trends in Machine Learning, 18(1), 1–223, 2025. 出版社資訊,作者版本。
- L. X. Nguyen, A. D. Raha, P. S. Aung, D. Niyato, Z. Han and C. S. Hong, “A Contemporary Survey on Semantic Communications: Theory of Mind, Generative AI, and Deep Joint Source-Channel Coding,” IEEE Communications Surveys & Tutorials, 2025. 出版資訊與作者版本。
- A. El Gamal, “Information Theory and Statistical Learning,” proposed textbook chapter, arXiv preprint, 2026. 草稿與出版狀態。
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑這是「資訊理論」單元的最後一篇。 回到學習地圖 →