IT 06・率失真與有損表示
先備知識:IT 05・微分熵與高斯通道
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
資訊理論
你將學到
- 稱重建可接受之前,先指定失真函數。
- 區分操作速率與資訊論測試通道。
- 推導 Bernoulli/Hamming 與高斯/平方誤差率失真函數。
- 解釋覆蓋可達性與逆定理的資訊計算。
- 以交替更新計算有限字母率失真點。
- 把實際量化與學習目標連到誠實的速率、品質量測。
先看全貌
無損編碼要求精確原始資料;有損編碼要求有用替代品。後者必須先給「有用」數學意義:哪些差異重要、成本多大,以及限制指平均誤差,還是罕見的大失敗。
本章依 Cover 與 Thomas 第 10 章 [1],以及 Stanford 的率失真講義 [2,3]。核心結果對假想重建法則最小化互資訊。最佳化定義極限,本身不建立有限檔案格式,也不保證神經解碼器行為。
這直接連到視覺:像素重建、機器可讀特徵與合理生成影像,保留不同性質。比較速率、失真以前,應明確說明目標與資源慣例。
先選失真,再選編碼器
誤差量指定接收器容忍哪些來源差異。沒有任何通用失真分數能涵蓋所有任務。
令 為來源符號, 為可能屬於不同字母集合的重建。非負失真函數為 。長度 區塊的失真為
索引符號, 是區塊長度, 是每符號平均失真。常見限制是 ; 是允許平均值,期望依指定來源與編碼。
Hamming 失真在符號正確時零,其他時一。實數振幅的平方誤差為 。前者計不符次數,後者更重視大數值偏差,回答不同問題。
平方誤差依賴單位。來源與重建乘以 ,失真乘以 。率失真曲線應寫明來源正規化、維度平均與失真單位。
一般加性模型替每符號計成本再平均。結構化任務可能需要區塊準則,例如保留關係、罕見特徵或決策。仍可研究,但不會自動等同單字母問題。
平均失真不會限制每個重建的最壞誤差。小平均可能伴隨罕見大誤差。需要尾端機率、最大誤差或各群組保證時,應另列條件,不要從平均值推讀。
重建字母集合也是定義的一部分。限制為小碼本、整數像素或特定模型族,會縮小可行集合,無限制理論最佳值可能無法達到。反過來,允許輸出任務標籤而非影像,會改變字母集合與失真問題。公平比較應先說明選擇,再展示速率,讓讀者判斷系統是否保留同一物件。
操作與資訊論率失真
實際編碼發送有限描述之一;測試通道描述來源與重建可能的統計關係。定理連結它們的漸近極限。
區塊編碼器把 映到 個索引之一,解碼器把索引映到 。固定速率為
是可發送描述數, 是每來源符號位元。操作函數 是指定失真下,漸近可達速率的下確界。
獨立無記憶來源與適當加性失真設定下,率失真定理給
來源法則 固定, 遍歷正規化重建法則。最小值符號適用最佳解存在的設定;更一般連續情況可能需要下確界與正則條件 [1,2]。
此重建法則常稱測試通道(test channel)。與通訊容量不同,它不最佳化來源輸入。容量在給定物理通道下最大化傳輸資訊,率失真在重建限制下最小化所需資訊。
隨機測試通道是描述所需聯合分布的數學物件。操作定理以區塊碼逼近資訊速率。逐符號獨立抽取含雜訊重建,本身不會說明接收器需要多少位元才能重現抽樣。
基本形狀與零速率重建
容許更多誤差,不會需要更多位元。某個失真以上,接收器可以固定輸出同一重建,完全不需訊息。
定義
是最佳常數重建的平均失真, 不依觀察來源選擇。 時,零速率可行。
標準設定下 非負、非遞增且凸。非遞增是因更大的失真容許值包含先前所有可行編碼。
凸性有分時解釋。長區塊的 比例使用第一種碼,其餘用第二種:
是比例, 是各失真,右側是平均速率。預定區塊邊界可以避免逐符號發送選擇。
零失真時,有限來源若只有完全相同才零成本,就回到一般熵極限。若數種不同來源值都同樣正確,零失真可能需要少於來源熵。真正連續高斯來源的平方誤差零失真速率則發散。
這些條件很重要。沒有指定失真零集合或字母集合,就說「零失真等於熵」,可能抹掉任務表示能壓縮的原因。
Hamming 誤差下的二元來源
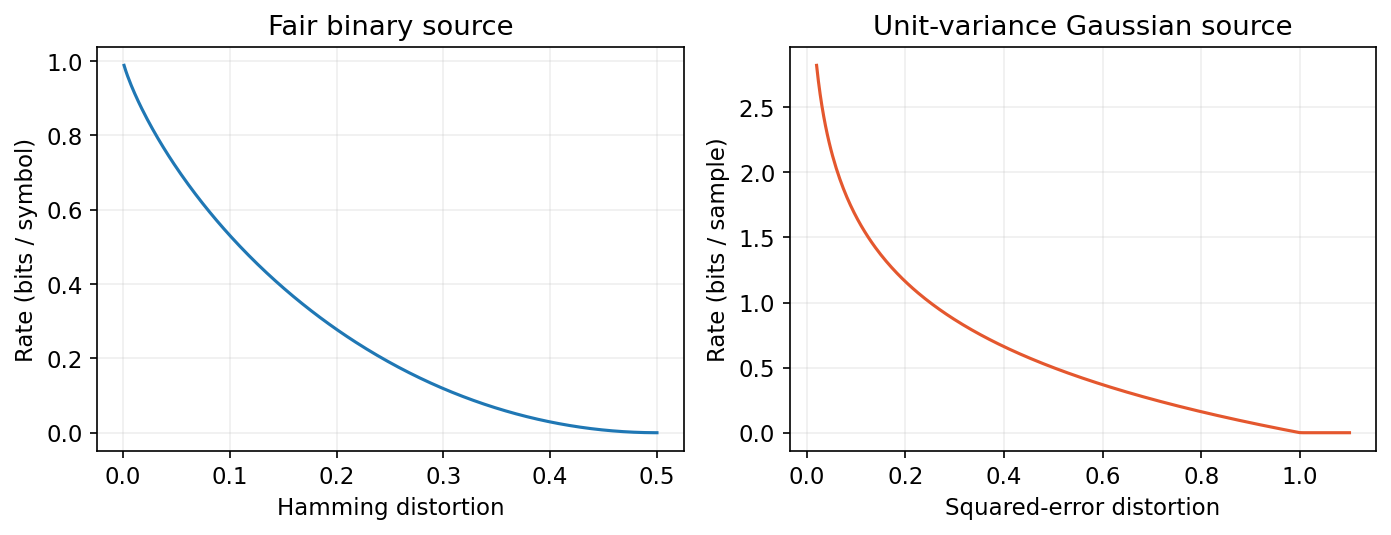
公平二元來源要每符號一位元才能精確保留。容許受控的不符比例,會降低必要速率。
對 、 與 Hamming 失真,
是一的機率, 是不符機率, 是二元熵。零速率重建永遠為零,因此錯誤占來源符號比例 。
為求下界,令 是不符指示, 表二元互斥或。則
為一的機率至多 ,二元熵在此範圍遞增。條件化不能增加離散熵。
等號以反向建構達到:選 與獨立 ,再令 。重建機率滿足
避開公平來源的奇異端點;端點由連續性或直接常數重建處理。建構符合指定來源法則,並讓不符與重建獨立。
公平來源在 前為 。有偏來源若直接以前向機率 翻轉 ,一般不會達到相同最佳值。獨立條件的方向是推導一部分。
建立最佳二元聯合表
把機率逐項寫出,反向建構就更清楚。取來源機率 、允許不符 。若 ,重建與不符獨立,則
是要求的來源一機率, 是重建一機率, 是獨立反向翻轉機率。解得 。重建機率乘獨立誤差機率,得到:
| 聯合機率 | 來源邊際 | ||
|---|---|---|---|
| 0.7875 | 0.0125 | 0.8 | |
| 0.0875 | 0.1125 | 0.2 | |
| 重建邊際 | 0.875 | 0.125 | 1.0 |
非對角項總和為 0.1,恰好符合失真限制。每個重建欄除以總和後,來源與重建不同的機率都是 0.1。因此 ,必要資訊為每來源符號 位元。
等價的前向條件通道不對稱。給定 ,輸出一的機率是 ;給定 ,輸出零的機率是 。罕見一的錯誤大、常見零的錯誤小,合計達到指定平均誤差,並符合最佳後驗不確定性。
相較之下,以 0.1 機率獨立前向翻轉來源,平均失真相同,但重建一的機率為 0.26。資訊變成 位元,大於最佳值。「百分之十雜訊」不足以定義最佳測試通道;方向與獨立關係也重要。
程式碼 · Python · 20 行
import numpy as np

def entropy(p):
    p = np.asarray(p, dtype=float)
    positive = p > 0
    return -np.sum(p[positive] * np.log2(p[positive]))

source_one, D = 0.2, 0.1
q = (source_one-D)/(1-2*D)
joint = np.array([[(1-q)*(1-D), q*D],
                  [(1-q)*D, q*(1-D)]])
px, pr = joint.sum(axis=1), joint.sum(axis=0)
information = entropy(px)+entropy(pr)-entropy(joint)
assert np.allclose(px, [0.8, 0.2])
assert np.isclose(joint[0, 1]+joint[1, 0], D)
assert np.allclose([joint[1, 0]/pr[0], joint[0, 1]/pr[1]], D)
exact = entropy(px)-entropy([D, 1-D])
assert np.isclose(information, exact)
print("Backward joint table:", joint)
print("Optimal information:", information)
計算驗證的是統計最佳值,仍需要長區塊碼,才能把該資訊速率轉成傳送的重建索引。
平方誤差下的高斯來源
較分散的高斯來源,需要更多位元才能有相同絕對精度。要求更小誤差,速率以對數增加。
對 與 ,
是來源變異數, 是相同平方單位的均方誤差。 時,零重建不用位元。 時,速率無界增加 [1,3]。
令 是重建誤差。相容有限微分熵下,
互資訊良好定義時,條件化降低微分熵;高斯最大熵以二階動差限制誤差熵。此式是非零速率範圍的下界。
資訊論最小值的可達建構使用獨立 與 ,並令 。再次是反向測試通道:誤差與重建獨立,不是與來源獨立。
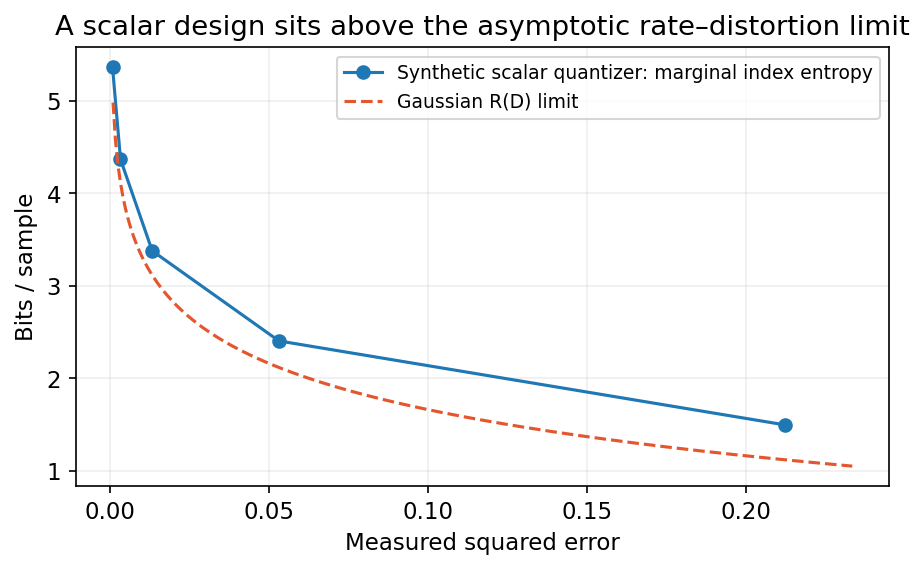
等價失真速率關係為 ,描述漸近最佳區塊編碼。簡單純量量化器在其速率下,一般位於極限上方。
程式:測試高斯反向建構
完整合成實驗驗證來源變異數、誤差變異數與資訊公式。它沒有序列化區塊碼,只測最佳化聯合分布。
程式碼 · Python · 16 行
import numpy as np

rng = np.random.default_rng(38)
variance, distortion = 1.0, 0.2
reconstruction = rng.normal(0, np.sqrt(variance-distortion), size=100000)
error = rng.normal(0, np.sqrt(distortion), size=100000)
source = reconstruction + error
rho = np.corrcoef(source, reconstruction)[0, 1]
information = -0.5 * np.log2(1-rho**2)
exact = 0.5 * np.log2(variance/distortion)
print("Source variance / error MSE:", source.var(), np.mean(error**2))
print("Error-reconstruction correlation:", np.corrcoef(error, reconstruction)[0, 1])
print("Gaussian-model information / exact rate:", information, exact)
assert abs(source.var()-variance) < 0.02
assert abs(np.mean(error**2)-distortion) < 0.01
assert abs(information-exact) < 0.02
獨立性在取樣時就建立;有限相關只是檢查。任意非高斯變數的經驗相關很小,不能單獨證明獨立。
為何覆蓋不同於通道打包
有損來源碼需要足夠重建代表,在允許誤差內覆蓋可能來源區塊。通道碼則分隔傳輸代表,抵抗雜訊。
固定可行來源重建聯合分布,從重建邊際抽許多碼字。對典型來源區塊,隨機重建符合聯合關係的機率,指數尺度為 。
代表數超過約 並帶小速率餘裕,就很可能找到匹配。編碼器選索引,解碼器回傳共享重建;聯合典型性把所選點對連到目標失真。
這是覆蓋論證。精確證明需要典型性定義與來源、失真假設;指數尺度解釋速率,不是有限碼表現公式。
逆定理使用傳輸索引 :
遍歷 個描述,,,來源無記憶。第一資訊界使用重建由索引決定;逐符號步驟用來源獨立與資訊論定義;最後用凸性。
編碼傳達的來源資訊,不能超過索引所含資訊。這說明解碼器再精細的先驗,也不能以零來源速率恢復任意遺失細節;它可以依指定失真選有用或可能的重建。
計算有限測試通道
離散字母下,交替更新重建邊際與來源條件重建法則。懲罰參數會沿率失真前緣移動。
最小化自然單位目標 ,。給目前重建邊際 ,
是固定來源法則, 是測試通道, 索引重建, 以自然單位衡量失真懲罰。位元速率將自然單位資訊除以 。
教科書 [1] 討論 Blahut–Arimoto 交替計算。正初始邊際涵蓋全部候選重建符號。解出後應計算實際失真與互資訊,不要把 本身稱為失真。
指數測試通道更新從哪裡來?
交替規則來自受限制最小化,不是因為某公式看起來像機率。暫時固定正的重建邊際 ,對來源狀態 最小化列貢獻
是給定來源 的重建 條件機率, 是固定參照邊際, 是失真, 是自然單位懲罰。正來源權重 乘此列,但不改變最小化的條件分布。
加入列正規化乘子 ,對 微分,駐點方程為 。取指數使 正比於 ,列正規化再提供更新式分母。
接著固定 ,其誘導邊際 在正規化 中最小化交叉熵部分。指定有限字母設定下,交替兩步降低懲罰目標。幾何也很清楚: 大時各列集中於低失真重建,邊際因子則偏向母體常使用的重建。
公平二元來源與 Hamming 失真下,對稱性保持 均勻,非對角機率因此是 ,速率為 。程式檢查的正是此解析關係。它直接解釋懲罰,而不把懲罰值當成實際失真。
程式:對照精確二元曲線
實作檢查重建邊際收斂,以獨立解析公式驗證點。容許誤差是數值更新容許值,不是前章容量上下界間隙。
程式碼 · Python · 37 行
import numpy as np
from scipy.special import logsumexp

def entropy(p):
    p = np.asarray(p)
    return -np.sum(p[p > 0] * np.log2(p[p > 0]))
def rd_point(p, distortion_matrix, beta):
    p = np.asarray(p, dtype=float)
    d = np.asarray(distortion_matrix, dtype=float)
    q = np.full(d.shape[1], 1/d.shape[1])
    for _ in range(50000):
        scores = np.log(q)[None, :] - beta*d
        V = np.exp(scores-logsumexp(scores, axis=1, keepdims=True))
        updated = p @ V
        if np.max(abs(updated-q)) < 1e-13:
            q = updated
            break
        q = updated
    else:
        raise RuntimeError("Rate-distortion updates did not converge")
    joint = p[:, None]*V
    positive = joint > 0
    ratio = np.divide(V, q[None, :], out=np.ones_like(V), where=positive)
    rate = np.sum(joint[positive]*np.log2(ratio[positive]))
    distortion = np.sum(joint*d)
    return rate, distortion, V

d = np.array([[0, 1], [1, 0]])
for beta in [0.0, 1.0, 2.0, 4.0]:
    rate, D, V = rd_point([0.5, 0.5], d, beta)
    exact = 1-entropy([D, 1-D])
    assert abs(rate-exact) < 1e-10
    print("Penalty / D / rate / exact:", beta, D, rate, exact)
rate, D, V = rd_point([0.8, 0.2], d, 4.0)
exact = entropy([0.8, 0.2])-entropy([D, 1-D])
assert D < 0.2 and abs(rate-exact) < 1e-9
print("Biased-source D / rate / exact:", D, rate, exact)
任意失真矩陣的小邊際更新差,是有用收斂檢查,但不是嚴格全域數值憑證。應看目標改變、支撐與獨立特殊例子。很大懲罰可能造成機率下溢,需要更仔細實作。
純量量化是具體可達設計
把來源取整至有限解析度格點,再無損描述格點索引。取整造成失真,機率編碼降低索引速率。
步距 下使用
是離散索引, 是格點重建, 是平方誤差失真。熵編碼索引的速率由索引分布決定,再加實際編碼成本。
密度夠平滑、步距夠小時,常用近似 ,把量化誤差視為格內近似均勻。粗步距、裁切附近或結構化集中數值,不一定符合。
程式碼 · Python · 14 行
import numpy as np

rng = np.random.default_rng(26)
source = rng.normal(size=20000)
for step in [0.1, 0.2, 0.4, 0.8, 1.6]:
    index = np.rint(source/step).astype(int)
    reconstruction = step*index
    _, counts = np.unique(index, return_counts=True)
    p = counts/counts.sum()
    rate_estimate = -np.sum(p*np.log2(p))
    mse = np.mean((source-reconstruction)**2)
    gaussian_limit = max(0, 0.5*np.log2(1/mse))
    print("Step / index entropy / MSE / reference rate:",
          step, rate_estimate, mse, gaussian_limit)
經驗分布來自同一批量化樣本,所以是描述統計。比較學得熵模型時,應另用訓練觀測擬合,在固定保留資料評分,並以明確慣例傳輸或共享參數。
索引熵不是實際壓縮檔大小。編碼器還須指定索引支撐、超界處理、重建步距、訊息長度與熵編碼終止。有限經驗估計可能在理論關係附近波動,不會推翻母體定理。
平行高斯來源使用反向注水
有限描述預算應更仔細保留高變異來源方向。低變異方向的整體變動若已在誤差容許值內,就可以捨棄。
對變異數 的獨立高斯座標,總平方誤差預算為 :
索引座標, 是各自均方誤差, 是完整來源向量的位元。正速率範圍中,微分目標使最佳作用中失真相等:
是反向水位,在預算小於總來源變異數時選擇。變異數低於水位的座標重建為均值,付出全部變異數但不付速率。
與通道注水的相似很有啟發,但角色不同。通道配置在雜訊地板上花訊號功率,最大化運送資訊;來源配置允許誤差到來源變異數,最小化所需描述資訊。
相關高斯向量的正交共變異數特徵基底,會產生獨立座標且保留總平方誤差,配置因此作用於特徵值。非線性任務失真或非高斯分布,不一定能簡化成相同計算。
這也說明低維重建的好處與限制。捨棄低變異座標,對總平方誤差便宜,但該座標仍可能決定特定標籤。任務相關與變異數是不同準則。
反向注水配置例
取三個獨立高斯座標,變異數為 4、1、0.25,每向量允許總平方誤差一。若每座標都給三分之一誤差,第三座標的預算會浪費:直接重建為零,已經只有 0.25 誤差。
其餘兩座標的最佳共同誤差水位滿足 ,得到 。失真為 0.375、0.375、0.25,總和一。必要速率為
是每個三座標來源向量的位元數。前兩座標需要正描述速率,第三重建為均值,速率零。此失真預算是每向量總和,不是每座標平均;將預算除以三,才是同一操作點的另一種慣例。
共同誤差水位來自對作用中座標速率微分:每增加一單位失真,速率降低的幅度為 。讓邊際節省相等,就讓作用中 相等。當 到達來源變異數,已經沒有速率可省,該座標離開作用集合。
小變異座標仍可能編碼重要標籤。反向注水對此高斯平方誤差問題最佳,但標籤保留需要另一失真。這個例子把最佳化條件與接收者目標直接連起來。
比較操作點時,不要改變問題
公平率失真比較固定來源資料、品質準則與資源假設。否則看似更好的曲線,可能只是在解更容易問題。
經驗操作點是完整程序下的量測速率與失真。應說明速率為固定長度、平均變長、理想負對數機率,還是實際序列化位元。
本章理論曲線使用無記憶母體來源與漸近長碼。有限實驗有抽樣不確定性、有限區塊、受限模型族與實作成本。把全部叫同一間隙,會掩蓋原因。
不同編碼設定應使用同一保留觀測。量化器、機率模型與學得轉換使用訓練資料擬合;驗證資料選懲罰或操作點;最後測試集估計已選程序表現。
母體異質時,應回報有意義群組的失真。常見例子平均可能掩蓋某子群很差的重建。這不推翻平均失真定理,而是指出該平均未充分表達應用。
也應說明解碼隨機性。相同索引下,確定性與隨機生成解碼器可能有不同誤差分布。重建同一測試輸入多次可以揭露變動;看到原圖後才挑最佳隨機重建,加入真實接收器可能沒有的選擇步驟。
最後,共享旁資訊須可比。帶任務資料庫、預訓練先驗或傳送調適資訊的解碼器,與沒有這些資訊的程序不同。共享資源有用,但可用性與成本慣例應伴隨前緣宣稱。
表示、任務與學得速率懲罰
表示可以捨棄無關細節,保留任務。只有指定任務並在目標母體評估,這才有幫助。
學得編碼器可能產生量化潛在變數 ,具有熵模型 ,解碼器回傳 。常見訓練目標為
第一項是位元單位理想編碼成本代理, 平衡指定失真,期望使用訓練分布。此目標不會自動等於母體率失真函數。
潛在字母集合、熵模型失配、有限編碼器、旁資料流與模型成本,影響實際速率。架構限制可達重建;最佳化可能找到局部或模型受限取捨,而非資訊論最小值。
若接收器需要標籤 ,適當準則可評估從 推得決策,而非重建全部 。這是不同來源失真問題。保留某標籤的特徵,可能捨棄後續不相關任務需要的資訊。
感知準則可能獎勵合理紋理,即使紋理與來源不同;忠實重建準則可能懲罰同一改變。沒有通用正確目標,文字、圖形與評估都要保留區別。
多種失真可以一起回報,不需合成沒有解釋的單一分數。例如分開數值忠實度、明確任務誤差與分布真實性準則。
現代觀點
Yang、Mandt 與 Theis 的 2023 年專論 [4],區分無損熵編碼、有損轉換設計、量化、感知目標與任務導向編碼。分類能定位系統哪些部分改變速率、哪些改變失真、哪些改變評估目標。
Huang 與 Wu 的 2024 年綜述 [5],明確對照學得影像壓縮的人類與機器使用者。共同結論是:表示的用途依賴接收者;一個重建分數不能證明保留所有下游分析。
Hofer 與 Böhme 的 2024 年預印本 [6],建立神經影像錯誤壓縮分類,鼓勵檢查哪些內容改變,而不假設平均數值誤差已完整描述重建行為。此處依已核對狀態引用為預印本。
由率失真理論,我們推論應評估前緣,而非單一有利操作點:固定測試母體上的量測位元流大小,對明確失真。來源正規化、模型共享假設與解碼資源預算應一致。
開放問題包括不可逆壓縮後的任務轉移、罕見細節失真量、分布偏移,以及生成先驗的公平資源計算。更長區塊或更精細解碼器可以改善特定取捨,卻可能增加延遲或依賴更強共享假設。
下一章把資訊延伸到編碼以外:散度描述統計證據,最大熵在限制下選分布,對數成長則連結預測與決策。
重點整理
- 失真定義有損重建可以改變什麼。
- 率失真固定來源,最佳化重建法則。
- 標準前緣非遞增且凸。
- 二元與高斯最佳解使用仔細定義的反向測試通道。
- 覆蓋與資訊計算連結測試通道和區塊碼。
- 交替更新需要明確對數與懲罰單位。
- 量化索引熵不同於實際序列化速率。
- 學習或感知目標,須依指定接收者與失真評估。
練習
- 對機率 0.2 的 Bernoulli 來源,求零速率失真,以及失真 0、0.05、0.1 的速率。
提示
非零速率範圍用 。
- 建立 、 的反向二元聯合分布,比較直接以前向機率 0.1 翻轉來源。
提示
讓不符與重建獨立。
- 變異數 4 的高斯來源,求平方誤差 1、0.25 所需速率,並解釋改變座標單位後的結果。
提示
速率依賴變異數失真比。
- 把有限測試通道程式延伸至三符號與非對稱失真矩陣,分開回報懲罰、實際速率與實際失真。
提示
檢查每列正規化,重建聯合分布。
- 在純量量化加入裁切,分別比較中央與尾端誤差,不只回報平均。
提示
分開追蹤飽和例子。
- 替小二元影像設計兩種失真:精確像素保留,以及保留是否存在任何前景像素。說明零失真速率為何不同。
提示
任務辨認影像等價類。
參考文獻
- T. M. Cover and J. A. Thomas, Elements of Information Theory, 2nd ed., Wiley, 2006, Chapter 10. 出版社書頁與目錄。
- T. Weissman, “Lossy Compression & Rate Distortion Theory,” Stanford EE276 Lecture 13 notes, 2024. 第一手講義。
- T. Weissman, “Lossy Compression & Rate Distortion Theory Continued,” Stanford EE276 Lecture 14 notes, 2024. 第一手講義。
- Y. Yang, S. Mandt and L. Theis, “An Introduction to Neural Data Compression,” Foundations and Trends in Computer Graphics and Vision, 15(2), 113–200, 2023. 出版專論與作者版本。
- C.-H. Huang and J.-L. Wu, “Unveiling the Future of Human and Machine Coding: A Survey of End-to-End Learned Image Compression,” Entropy, 26(5), 357, 2024. 出版綜述。
- N. Hofer and R. Böhme, “A Taxonomy of Miscompressions: Preparing Image Forensics for Neural Compression,” arXiv preprint, 2024. 第一手預印本。
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 IT 07・統計證據、最大熵與成長 · 14 分鐘