IT 07・統計證據、最大熵與成長
先備知識:IT 06・率失真與有損表示
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 把概似比解讀為證據,而非後驗機率。
- 以經驗型態解釋散度控制的罕見事件速率。
- 區分假說檢定誤差取捨與參數估計。
- 推導 Fisher 資訊與正則不偏估計下界。
- 從明確限制建立最大熵分布。
- 把對數最佳配置、通用混合連到編碼悔損。
先看全貌
資訊量不只用於儲存與通訊。它們也量化觀測如何區分競爭解釋、分布對參數變化多敏感,以及不良預測決策在重複試驗中多昂貴。
書籍對照為 Cover 與 Thomas 第 11 章統計、第 12 章最大熵、第 6 章賭局與編碼,以及第 16 章投資組合理論 [1]。Stanford 型態方法講義 [2] 提供易讀的有限字母推導。
本章使用完全指定機率與報酬的數學決策遊戲,目的在揭露資訊恆等式,不從歷史資料推論實際回報。每節都區分來源法則、選定模型、觀測樣本與決策準則。
概似比比較解釋
某模型給樣本較大機率時,樣本便較支持該模型。重複獨立觀測會相加對數證據。
對支撐相容、完全指定的分布 ,定義
是長度 觀測樣本,最後等式假設各模型內的觀測獨立。 可自然或底數二,但須一致。正值在概似比較中偏向 。
下,期望二進位對數比為 ; 下為 。方向不同,是因期望使用不同法則。
概似比不是後驗機率。計算後驗勝算,需要乘先驗勝算;選擇行動,需要納入錯誤決策損失。零閾值適合某些對稱先驗與損失,不適合所有檢定。
簡單假說下,Neyman–Pearson 概似比原則描述指定偽警報限制的最強力檢定 [1]。「簡單」是分布固定,不是帶未知擬合參數的模型族。
若用同一樣本估計參數,就是另一套程序。模型選擇、干擾參數與閾值校準,都可能改變有限誤差。把擬合分類器分數當證據前,先用完全指定小模型理解。
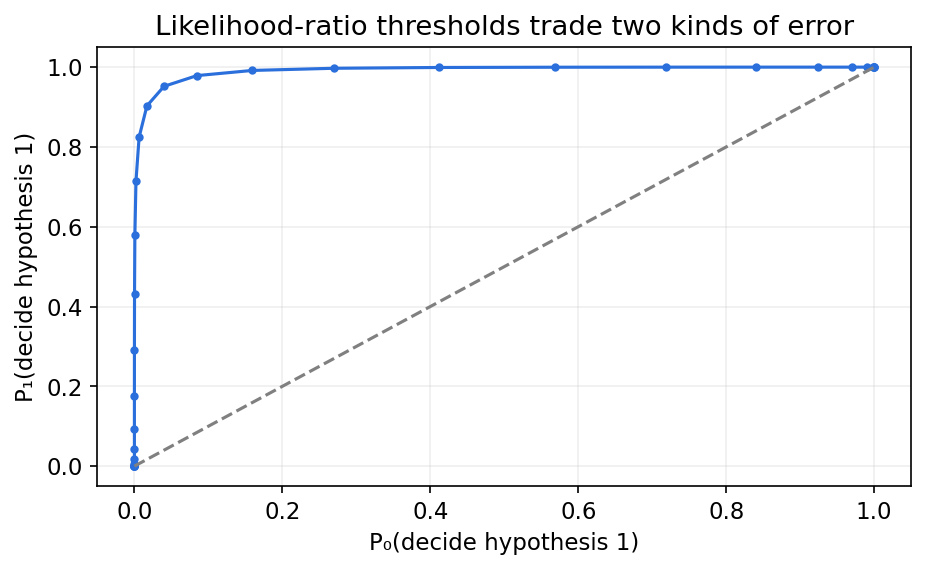
檢定誤差形成取捨
更難宣布對立假說,可以減少偽警報,卻可能漏掉更多真對立情況。報告不應省略任一誤差。
設虛無分布 、對立分布 。拒絕區域 給
是第一型或偽警報機率, 是第二型或漏判對立機率, 是宣布對立的集合。
Bernoulli 機率 時,對立相對虛無的對數概似比,是一的計數遞增函數。因此,計數閾值實作概似比檢定。
離散計數可能讓確定性閾值無法精確達到任意偽警報目標。邊界隨機化可以數學上達到中間操作點;部署規則應說明是否隨機化。
程式:精確誤差與 Monte Carlo 檢查
完整例子選擇首個符合 5% 偽警報限制的計數閾值,計算漏判機率,再分別驗證兩個法則。
程式碼 · Python · 17 行
import numpy as np
from scipy.stats import binom

n, p0, p1 = 30, 0.3, 0.6
thresholds = np.arange(n+2)
false_alarm = binom.sf(thresholds-1, n, p0)
detection = binom.sf(thresholds-1, n, p1)
threshold = thresholds[np.flatnonzero(false_alarm <= 0.05)[0]]
alpha = binom.sf(threshold-1, n, p0)
beta = binom.cdf(threshold-1, n, p1)
rng = np.random.default_rng(40)
observed_alpha = np.mean(rng.binomial(n, p0, 100000) >= threshold)
observed_beta = np.mean(rng.binomial(n, p1, 100000) < threshold)
print("Threshold / alpha / beta:", threshold, alpha, beta)
print("Simulation alpha / beta:", observed_alpha, observed_beta)
assert abs(observed_alpha-alpha) < 0.005
assert abs(observed_beta-beta) < 0.005
閾值使用已知分布,不在測試集搜尋。學習應用應在驗證資料調閾值,再以獨立測試觀測估計誤差。資料群組與時間相依可能改變獨立性假設。
評估集中對立比例,影響正確宣布頻率,卻不改變固定檢定與法則的兩種條件誤差。即使偽警報機率小,對立極罕見時,仍可能有很多錯誤宣布。解讀時需結合條件誤差與目標先驗盛行率。這是條件機率直接結果,不是概似比原則失敗。應說明回報量以虛無、對立,還是檢定輸出為條件。
計算例:證據不等於信心
例子的虛無機率 0.3、對立機率 0.6,長度 30 區塊含 個一時,對立相對虛無的對數概似比為
是觀測計數, 使用自然對數,兩個分數比較競爭法則下的一與零機率。18 個一時,,概似比約 317.748375,證據明顯偏向對立。
若對立的先驗機率為 0.01,先驗勝算為 。後驗勝算約 ,對應後驗機率約 0.762447。概似比不是 99.7% 信心值,先驗會改變後驗解讀。
更實際的區別,是閾值檢定的全部陽性宣布。程式選閾值 14,偽警報約 0.040053,漏判約 0.048112。如果只有 1% 案例來自對立,陽性真正屬對立的機率為
是對立先驗盛行率, 是偽警報機率, 是漏判機率。符號 表示案例由對立產生的事件。即使兩種條件誤差都低於 5%,此母體多數陽性仍是偽警報。
結論來自計算兩族群預期產生的陽性數,沒有改變概似比最佳性或量測條件誤差。決策報告應說明條件事件,讓讀者區分個別樣本後驗與所有陽性的平均組成。
程式碼 · Python · 14 行
import numpy as np
from scipy.stats import binom

n, p0, p1, prior = 30, 0.3, 0.6, 0.01
count = 18
log_ratio = count*np.log(p1/p0)+(n-count)*np.log((1-p1)/(1-p0))
posterior = 1/(1+((1-prior)/prior)*np.exp(-log_ratio))
threshold = 14
alpha = binom.sf(threshold-1, n, p0)
beta = binom.cdf(threshold-1, n, p1)
positive_precision = prior*(1-beta)/(prior*(1-beta)+(1-prior)*alpha)
assert alpha <= 0.05 and binom.sf(threshold-2, n, p0) > 0.05
print("Likelihood ratio / sample posterior:", np.exp(log_ratio), posterior)
print("Probability alternative given positive:", positive_precision)
經驗型態揭露散度為何控制罕見事件
許多字串具有同一直方圖。數量以熵指數成長,單一來源機率以交叉熵指數縮小,差就是散度。
大小 的有限字母中,長度 序列的型態 是經驗符號分布。型態類 包含所有相同計數序列。獨立來源法則 下,
具有型態 , 是經驗熵,散度以位元計。將相同對數機率按計數分組,即得公式。
類別大小的保守多項式界為
是序列數, 是區塊長度與字母大小。乘單一序列機率得到
是型態類總機率。有限長度多項式因子重要,但會從正規化對數指數中消失 [1,2]。
方向值得強調:第一引數是異常經驗型態,第二是實際生成來源。這不同於在固定真來源下平均的編碼失配計算。
經驗分布集合的主要指數行為,由允許型態中最小散度控制。Sanov 定理在有限字母與集合正則條件下,形式化此大偏差陳述 [1]。
程式:精確二元型態機率與指數
獨立例子比較二項機率與指數界,使用對數避免下溢,並檢查有限多項式間隙。
程式碼 · Python · 15 行
import numpy as np
from scipy.stats import binom

q, target = 0.3, 0.6
for n in [30, 100, 300, 1000]:
    count = int(round(n*target))
    empirical = count/n
    divergence = (empirical*np.log2(empirical/q) +
                  (1-empirical)*np.log2((1-empirical)/(1-q)))
    negative_log_probability = -binom.logpmf(count, n, q)/np.log(2)
    exponent = n*divergence
    assert exponent <= negative_log_probability + 1e-10
    assert negative_log_probability <= exponent + 2*np.log2(n+1) + 1e-10
    print("Length / observed normalized exponent / divergence:",
          n, negative_log_probability/n, divergence)
罕見精確型態,不同於單邊尾端或典型鄰域。尾端指數來自對事件全部計數最佳化,不是直接代入最極端計數。
從單一型態到型態集合
由經驗分布集合 定義的事件,至多有 種型態。加總上界得到
是 中長度 可實現型態, 是候選型態,下確界選 下最不意外的型態。空事件機率零,另行處理。
罕見事件最可能部分,常在最接近來源的邊界,而非最戲劇化極端。二元來源機率 0.3,要求頻率至少 0.6 的尾端,主要由接近 0.6 而非一控制。
有限型態格點重要:所需邊界可能在可達分數間。精確二項總和處理離散性;漸近散度圖像解釋趨勢,同時保留取整與多項式因子。
這可幫助解讀表面分布偏移。異常直方圖可作為反對來源法則的證據,卻不能辨認原因。相依、選擇偏差、量測改變與不同來源,都可能改變頻率。
非對稱與對稱假說指數
不同方式分配兩種檢定誤差,會導向不同資訊極限。散度只是其中一種,不是所有分類問題的答案。
假設虛無 、對立 下觀測獨立,第一型誤差保留在固定非平凡容許值內。最佳第二型指數趨近
是對立下誤接受虛無的機率, 使用自然對數。這是適當來源與支撐條件下的經典 Stein 漸近設定 [1]。
方向依接受區域:典型虛無觀測必須仍被接受,對立看起來像虛無的機率,具有 到 散度指數。交換假說會反轉散度,也可能改變指數。
固定非零先驗與對稱 Bayesian 誤差目標下,指數改為 Chernoff 資訊:
在兩法則間內插, 遍歷有限字母。雖然加總項看似非對稱,整個量是對稱的。
指數描述大獨立樣本,不是短樣本精確誤差。前面的二項實驗直接計算有限情況。前置因子與決策邊界重要時,把漸近指數當精確機率可能不準。
複合假說、相依、改變中的母體與不等損失,都需要各自分析。資訊極限可解釋哪些來源差異有助區分,仍留下實際校準與抽樣設計問題。
推論中的充分性與資料處理
某摘要對參數充分,表示它在指定模型族中保留樣本的全部參數證據。
對模型族 ,若給定統計量 的樣本條件法則不依賴 ,就稱充分。分解準則為
是參數, 是統計量, 是依參數的因子, 是與參數無關因子,須有相應模型族與支配假設 [1]。
獨立 Bernoulli 試驗的一計數,對未知機率充分;順序在此族不含額外參數證據。Markov 族則可能需要順序,單一一計數一般不再充分。
隨機參數 有指定先驗時,充分性給出 所需條件關係。任意摘要只有資料處理上界。
「在模型族中」很重要。某假設模型的充分統計量,可能丟棄模型錯誤證據。平均值能估位置,卻隱藏多峰、相依或離群模式。
這連到學得表示:保留某目標資訊,不同於保留原資料全部診斷性質。充分性宣稱應伴隨任務與來源族。
Fisher 資訊衡量局部參數敏感度
Fisher 資訊衡量參數微移時,對數機率改變多強。它是模型局部性質,不同於隨機變數互資訊。
對純量參數 與正則密度或質量函數 ,定義分數與資訊:
是分數(score), 是每觀測 Fisher 資訊,期望在參數化模型下。正則條件下,分數期望零。
個獨立觀測的資訊相加成 。正則不偏估計器 的 Cramér–Rao 不等式為
變異數描述固定參數的重複樣本。此界需要可微性、微分與積分交換,以及適當支撐、不偏假設 [1]。
Bernoulli 機率 的 。樣本均值不偏,變異數 ,達到該界。
資訊會隨參數座標改變。把機率重參數化為對數勝算,會以參數導數平方縮放資訊。統計族不變,只是參數誤差單位改變。
支撐依參數的非正則模型或有偏估計器,需要不同界。經驗變異數小,若均值偏離參數,也不能單獨證明準確。
選讀:支撐隨參數移動時(見「補充資料」頁)。以均勻來源指出失效的正則性恆等式。
推導 Bernoulli 資訊與變異數界
單一 Bernoulli 觀測 的對數概似為 。微分得到
是一的機率, 是分數。其兩種值為 、,按機率 、 平均平方,得到 。
為何倒數限制估計變異數?令 是依 個獨立觀測建立的正則不偏估計器, 是分數總和。在正則假設下,對不偏性 微分:
是觀測樣本的固定函數, 是總分數,且 。右側是估計器與分數的共變異數。共變異數平方不超過兩個變異數乘積;再利用 ,就得到變異數界。
、 時,每觀測資訊約 4.761905,變異數下界 0.0021。樣本均值達到下界,因為中心化估計誤差與總分數成正比。獨立樣本數增加四倍,變異數除以四,標準差除以二。分數變異數能相加是因獨立;反覆測量同一相關試驗,不足以支持此縮放。
Fisher 資訊是局部散度曲率
適當二次可微正則條件下,鄰近參數分布滿足
是小參數位移, 是自然對數分數資訊, 的餘項除以 趨零。底數二散度的首項要除以 。
一階導數消失,因分數期望零;正則模型的二階導數給 Fisher 資訊。這連結局部估計敏感度與檢定、編碼使用的全域散度。
它是局部近似。大參數移動可能涉及不同曲率、支撐改變或多峰。把一個 Fisher 值當整個族的精確距離,會丟棄差異。
最大熵讓限制明確
若只知道少數期望,就從符合期望的分布選最大熵。答案依指定限制與允許支撐。
有限字母的特徵 要求 。帶正規化的最大熵給指數族形式
是符合動差限制的乘子, 正規化質量函數。正號只是乘子符號慣例;存在性與內部支撐條件重要。
微分 給受限制特徵期望。只知道均值、沒有支撐,不會決定熵最佳值。有界區間固定支撐無其他限制,給均勻密度;實數固定均值與變異數給高斯;非負支撐固定均值給指數密度 [1]。
最大熵是透明建模原則,不是來源真的屬於此族的證據。未量測相依與高階動差仍可能存在。應記錄限制、擬合乘子,再用獨立資料測預測。
指數形式也解釋與散度的關係。候選分布若符合最大熵模型的特徵期望,平均模型對數機率只依賴共享動差。同一對數底數下,候選到模型的相對熵,等於模型熵減候選熵。
這再次是限制把交叉熵項變成固定量。前章高斯最大熵證明就是連續動差例子。共同代數說明最大熵、指數族與資訊投影為何反覆一起出現。
推導與解讀最大熵分布
最佳化先使用自然對數,只會縮放熵與乘子。把正規化與特徵限制加到熵目標:
是候選機率, 是正規化乘子, 是特徵乘子, 是特徵 , 是要求期望。內部最佳點對各機率微分,得到 ;取指數再正規化,就得到前述指數形式。
狀態 0、1、2、平均 0.7 只有一個特徵 ,相對權重為 。均勻分布平均一,較低目標平均因此需要負乘子。程式找到 ,機率約 0.494780、0.310440、0.194780。
模型在符合平均的同時,將機率散布於全部允許狀態。點質量或兩狀態混合也可能符合某些動差,但此處熵較低。可行邊界上,部分機率可能為零,有限內部乘子不一定足夠。支撐、動差與存在條件是數學問題的一部分,不是選好喜歡密度後才補上的選擇。
程式:解有限最大熵模型並驗證 Fisher 變異數
完整例子求指定均值的三狀態分布,再比較 Bernoulli 估計器變異數與精確不偏界。
程式碼 · Python · 19 行
import numpy as np
from scipy.optimize import brentq
from scipy.special import softmax

states = np.array([0.0, 1.0, 2.0])
target_mean = 0.7
probability = lambda lam: softmax(lam*states)
lam = brentq(lambda value: probability(value) @ states-target_mean, -20, 20)
p = probability(lam)
assert abs(p @ states-target_mean) < 1e-12
print("Maximum-entropy multiplier / probabilities:", lam, p)

rng = np.random.default_rng(41)
theta, n = 0.3, 100
estimates = rng.binomial(n, theta, size=100000)/n
fisher = 1/(theta*(1-theta))
bound = 1/(n*fisher)
print("Empirical estimator variance / exact bound:", estimates.var(), bound)
assert abs(estimates.var()-bound) < 0.0001
最大熵計算精確使用列出的支撐;允許其他狀態會改變最佳化。變異數計算檢查合成正則例子,不是所有估計器的通用下界。
對數成長把失配轉成決策成本
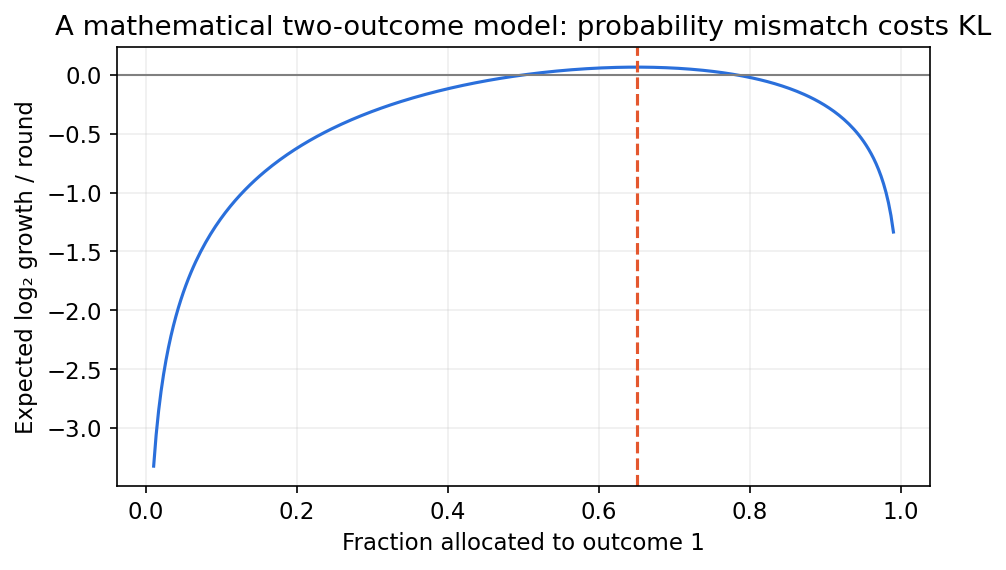
重複乘法遊戲中,策略錯誤會累積。指定公平報酬模型下,最大期望對數成長使最佳配置符合結果機率。
結果 以機率 發生。配置比例 到其條件報酬,。公平參考法則 在結果 發生時付乘數 。期望二進位對數成長為
是結果法則, 是配置, 是報酬倒數機率向量, 是每次試驗對數乘數。恆等式使用正規化法則與指定條件報酬遊戲 [1]。
最佳解在來源支撐為 。失配策略精確損失 的期望對數成長。兩結果皆乘數二時, 公平,最佳值為 。
這是預測與成長的 Kelly 連結,不表示每個投資組合都有公平條件報酬,或機率已知。加入現金、交易成本、槓桿限制或不同報酬,會改變最佳化。
每次結果前可觀察旁資訊 時,條件最佳化配置。相對固定最佳配置的改善為
是結果, 是旁資訊,參考報酬法則 不變。在此特定對數成長遊戲,互資訊有操作價值。
通用混合連結投資組合與編碼
不只選一個固定配置,而是混合許多固定策略的財富。過去結果決定各策略之後貢獻多少。
正報酬向量 與固定單純形配置 的累積財富為
索引試驗, 非負且總和一, 含各分量相對報酬, 是固定配置的先驗測度。混合有等價逐步配置,依過去財富加權策略。
Cover 與 Thomas 第 16 章在指定條件下,發展通用投資組合與長期比較最佳固定配置的想法 [1]。基準是事後固定配置,不是無限制、知道未來的交易者。
雙結果公平條件遊戲中,機率參數均勻先驗,給與 beta 混合相同的預測機制。 次後,一的逐步機率為 。這是整數計數先驗,不同於無損編碼的半計數預測器。
程式:混合成長與最佳固定配置
完整例子以對數計財富,用 beta 積分求均勻混合。比較已知來源策略、回顧最佳固定策略與因果混合。
程式碼 · Python · 23 行
import numpy as np
from scipy.special import betaln

rng = np.random.default_rng(42)
p, n = 0.65, 2000
outcomes = rng.binomial(1, p, size=n)
ones, zeros = int(outcomes.sum()), n-int(outcomes.sum())
fitted = ones/n
oracle_log_wealth = n*np.log(2)+ones*np.log(p)+zeros*np.log(1-p)
best_log_wealth = n*np.log(2)+ones*np.log(fitted)+zeros*np.log(1-fitted)
mixture_log_wealth = n*np.log(2)+betaln(ones+1, zeros+1)
sequential_log_wealth, previous_ones = 0.0, 0
for t, outcome in enumerate(outcomes):
    q = (previous_ones+1)/(t+2)
    sequential_log_wealth += np.log(2*(q if outcome else 1-q))
    previous_ones += int(outcome)
assert abs(sequential_log_wealth-mixture_log_wealth) < 1e-9
assert mixture_log_wealth <= best_log_wealth
print("Source / best fixed / mixture growth bits per trial:",
      oracle_log_wealth/n/np.log(2), best_log_wealth/n/np.log(2),
      mixture_log_wealth/n/np.log(2))
print("Mixture regret to best fixed, bits:",
      (best_log_wealth-mixture_log_wealth)/np.log(2))
這是受控合成報酬實驗。最佳固定參數用整段序列,作為基準;混合則因果更新。對數財富減最佳基準,與負對數機率悔損有相同代數,但方向相反。
現代觀點
Hellström、Durisi、Guedj 與 Raginsky 的 2025 年出版專論 [3],統一資訊論與 PAC-Bayesian 泛化界。分類區分期望、機率與條件互資訊表示,清楚指出統計保證需要指定隨機物件與評估準則。
El Gamal 的 2026 年擬議學習章 [4],以教科書式說明連結散度恆等式與統計學習。它是草稿補充;本章把現代觀點搭配已出版第二版,不把擬議章當成完成新版。
我們推論,同一量只有指定模型後,才能具有不同操作意義。散度可以是編碼懲罰、異常型態指數、證據速率或對數成長損失。方向、對數底數與極限設定可能各異。
學習推論的開放問題包括大參數空間可靠資訊估計、相依或偏移資料保證,以及能對實際模型選擇程序提供資訊的界。資訊項無窮或難估時,形式不等式可能變得無用。
實際工作應搭配獨立有限實驗:精確小機率驗證實作、保留資料概似評估擬合、決策誤差評估用途。單一熵數值不能代替三者。
最後一章結合多來源、多接收者、較強不等式,並以小型分散式資訊專題連到現代學習。
重點整理
- 概似證據、後驗勝算與決策閾值不同。
- 檢定同時回報偽警報與漏判機率。
- 型態機率有散度指數,須明確引數方向。
- 假說指數依所選誤差設定。
- 充分性相對於模型族與目標參數。
- Fisher 資訊給局部正則估計極限。
- 最大熵依賴支撐與指定限制。
- 對數成長失配、通用混合悔損共享編碼恆等式。
練習
- 反轉二項例子的虛無與對立,找 5% 偽警報限制閾值,比較漏判誤差。
提示
拒絕區域變低計數。
- 按經驗計數分組符號,推導型態機率恆等式,說明散度引數順序。
提示
計數乘來源對數機率。
- 比較 Bernoulli 機率 0.3、0.6 的雙向 Stein 散度,說明非對稱結果不違反對稱 Chernoff 指數。
提示
先固定接受區域,再選散度。
- 將 Bernoulli 機率重參數化為對數勝算,推導 Fisher 資訊並解釋誤差單位。
提示
乘機率導數平方。
- 求狀態 0、1、2、3、均值 1.2 的最大熵分布,再加入二階動差限制,描述額外乘子。
提示
第二特徵是狀態平方。
- 公平條件遊戲中,來源機率 0.65,求配置 0.5、0.65、0.8 的期望成長,驗證散度損失,並說明哪種策略知道未來。
提示
沒有策略知道未來;事後基準只在觀察後擬合常數。
參考文獻
-
T. M. Cover and J. A. Thomas, Elements of Information Theory, 2nd ed., Wiley, 2006, Chapters 6, 11–12 and 16. 出版社書頁與目錄。
-
T. Weissman, “Method of Types,” Stanford EE276 Lecture 15 notes, 2024. 第一手講義。
-
F. Hellström, G. Durisi, B. Guedj and M. Raginsky, “Generalization Bounds: Perspectives from Information Theory and PAC-Bayes,” Foundations and Trends in Machine Learning, 18(1), 1–223, 2025. 出版社資訊,作者版本。
-
A. El Gamal, “Information Theory and Statistical Learning,” proposed textbook chapter, arXiv preprint, 2026. 草稿與出版狀態。
-
MIT OpenCourseWare, “Lecture 6: Efficient Estimators, Rao-Cramer Bound,” 14.381 Statistical Method in Economics, Fall 2018, pp. 3–6。第一手講義.
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 IT 08・網路、資訊不等式與學習 · 15 分鐘