IT 03・無損編碼與通用壓縮
先備知識:IT 02・典型序列、AEP 與熵率
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
資訊理論
你將學到
- 區分單射、唯一可解碼與前綴自由描述。
- 利用 Kraft–McMillan 不等式推導熵下界。
- 建立 Huffman 編碼並測試精確重建。
- 解釋算術編碼區間,實作短訊息的精確算術往返。
- 連結自適應機率預測、通用編碼與模型額外成本。
- 區分可計算壓縮與理想的演算法複雜度。
先看全貌
壓縮用較短、接收者能解讀的表示取代訊息。關鍵是能解讀。若串接後的字串產生歧義,只替每個符號分配短字串還不夠。有用的編碼器必須指定訊息如何開始與結束、機率如何取得,以及接收端如何完全反轉表示。
閱讀對照是 Cover 與 Thomas 的第 5 章無損編碼、第 13 章通用來源編碼,以及第 14 章 Kolmogorov 複雜度 [1]。Stanford 的變長編碼與 Huffman 原始講義 [2,3] 提供易讀推導。本章使用原創例子,不重製書中表格或練習。
前章描述幾乎無損的典型集目錄;這裡要求精確重建每個允許訊息。成本包括未預期符號的逸出表示,以及辨識模型所需的資訊。後續率失真理論會明確放寬重建要求,不能將它混入無損主張。
無損編碼必須保留什麼
壓縮表示必須識別原始訊息,包括邊界。兩個不同訊息不能變成相同的傳送物件。
編碼器 與解碼器 滿足
對每個允許的來源訊息 成立。其中 是表示, 是重建規則;這要求 在允許訊息集合上為單射。
逐符號編碼以串接各符號碼字表示來源字串。唯一可解碼的編碼讓不同來源序列的串接結果都不同。前綴自由編碼則沒有任何碼字以另一個完整碼字開頭;走到碼樹葉節點時,就能立即解碼。
前綴自由必然唯一可解碼,反向卻不一定成立。孤立符號的單射映射,甚至不保證串接後唯一可解碼。例如三個符號分別使用 0、1、01,第三個符號便無法與第一個接第二個區分。
提供分隔符可以修補歧義,但分隔符也占傳輸空間。提供訊息長度有助於判定終止,長度本身卻不會修補符號剖析歧義。解碼器使用的任何側資訊都屬於通訊協定,必須明確計入。
若來源只有一個已知符號且外部提供長度,空碼字可能成立;它不適用於下方一般多符號碼樹。例子為每個符號至少分配一位元,並假設兩端共享字母集、樹與訊息邊界。
Kraft–McMillan:碼樹的機率預算
很短的碼字占用二元碼樹的大部分空間。短碼字太多,就沒有空間放剩餘符號。
對碼長為整數 的二元唯一可解碼編碼,
其中 是來源符號索引, 是符號 的碼字位元數, 是 Kraft 總和。反之,滿足不等式的有限非負整數碼長配置,都能實現為前綴碼,單符號情況依通常慣例處理 [1,3]。
在前綴樹中,長度 的葉節點,在任何足夠深的層級占全部碼樹的 。前綴自由使占用後代互不重疊,因此比例總和不能超過一。延伸到唯一可解碼情況,需要跨串接碼字的計數論證,不能直接把樹圖套在非前綴碼上。
不等式測試碼長是否存在,不給出唯一碼樹、位元串流格式,也不保證實際來源下的效率。許多合法碼樹的期望長度仍不必要地偏大。
熵下界
可逆二元描述的平均長度不能短於來源不確定性。看似更好的速率,通常表示成本或假設改變了。
設 是來源機率,並定義碼長誘導的正規化機率 ,則
其中 是隨機來源符號, 表示期望, 是熵, 是以位元表示的相對熵, 是 Kraft 總和。兩個額外項都非負,因為散度非負且 。
等式把低效率拆成分布不匹配與未使用的碼樹容量。完整樹滿足 ;但 與整數碼長誘導的二元冪機率不匹配,仍會造成額外成本。機率符合適當完整二元樹時,才可能達到相等。
選擇 滿足 Kraft 不等式,並給出
上取整符號表示向上取整數。嚴格上界適用於正機率的有限符號及通常非退化慣例。額外位元是每個編碼單位的成本;把長度 的來源區塊當單位,每符號取整成本就降至小於 。
區塊編碼並非免費:區塊字母集可能指數成長,儲存表格昂貴,延遲也增加。算術編碼不用替每個可能長訊息指定獨立固定樹葉。
Huffman 編碼:合併最不可能的選項
不斷把兩個最不可能的符號合併成暫時符號。逆轉這些合併就得到二元樹,常見符號的路徑比較短。
Huffman 編碼將
在指定有限來源分布的二元前綴碼中最小化。其中 是期望長度, 是符號機率, 是葉深度。最佳性只針對這個模型與逐符號編碼類別,不涵蓋所有區塊或上下文相依編碼器 [1,3]。
最佳碼樹可以讓兩個最低機率符號位於最深的兄弟葉節點。把較小機率交換到較長路徑,不會增加期望長度。合併這兩個節點後,最佳化轉成較小字母集;遞迴求解就得到貪婪演算法。
相同機率可能產生多棵同樣最佳的樹。若兩端獨立重建樹,確定性的平手規則很重要。實作用遞增計數器,讓堆積比較沒有歧義,也不用比較異質的樹物件。
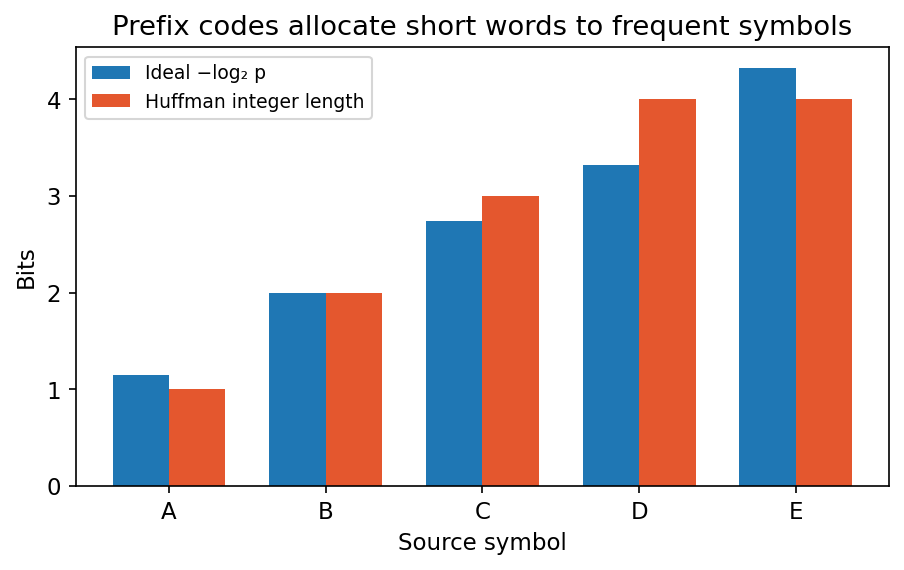
貪婪合併為什麼保留最佳性?
交換論證可以直接計算成本。若 ,但符號 比 深,交換葉標籤後的期望長度變化為
是兩機率, 是原深度, 是交換後減交換前的成本。高機率符號放得比低機率深,從來不會有好處。
最佳二元樹可選最深葉為兄弟節點,否則多餘單分支能縮短。交換論證允許把兩個最低機率放到此兄弟葉,不增加成本。將它們替換為機率 的暫時符號,深度比原葉少一,因此
兩個 是合併前後期望長度。增加項固定,不依其餘縮小樹如何安排。因此最佳縮小樹給最佳原樹,假如原樹還有更好解,也會導出更好的縮小樹。反覆使用此論證,才是貪婪演算法的理由,不只是觀察輸出看起來合理 [1,3]。
手算五符號碼樹
機率為 0.45、0.25、0.15、0.10、0.05 時,合併順序容易手算。先合併 0.05 與 0.10,得到 0.15;再把暫時權重與原本的 0.15 合併為 0.30。接著合併 0.25 與 0.30 為 0.55,最後合併 0.45 與 0.55,得到一。
符號碼長等於葉節點到根之間經過的合併次數,結果是 1、2、3、4、4。以下是一個合法配置:
| 符號 | 機率 | 碼字 | 長度 |
|---|---|---|---|
| A | 0.45 | 0 | 1 |
| B | 0.25 | 10 | 2 |
| C | 0.15 | 110 | 3 |
| D | 0.10 | 1110 | 4 |
| E | 0.05 | 1111 | 4 |
這組碼字前綴自由:讀到 0 就確定是 A,讀到 111 則還需要一位元才能區分 D 與 E。交換左右子樹會改變碼字,但保留長度與期望成本。
Kraft 總和為 。期望長度為 位元。來源熵約 1.977235 位元,因此逐符號碼每符號付出約 0.022765 位元的取整失配。五個符號也可使用定長三位元碼,但相較此期望長度,每符號多花一位元。
A 的一位元描述比理想驚訝量 短,其他符號會補償。定理限制機率加權平均,不要求每個碼字都至少等於自己的驚訝量。下方程式可能為平手節點選不同位元標記,但會得到同樣碼長與兩位元期望。
程式:建樹、編碼、解碼與長度計算
完整例子使用與圖相同的合成機率,檢查每對碼字的前綴自由性,並重建獨立取樣訊息。列印的負載長度排除傳送樹與長度標頭;這些排除明確說明。
程式碼 · Python · 42 行
import heapq
import itertools
import numpy as np

symbols = list("ABCDE")
p = np.array([0.45, 0.25, 0.15, 0.10, 0.05])
counter = itertools.count()
heap = [(float(w), next(counter), s) for s, w in zip(symbols, p)]
heapq.heapify(heap)
while len(heap) > 1:
    wa, _, a = heapq.heappop(heap)
    wb, _, b = heapq.heappop(heap)
    heapq.heappush(heap, (wa + wb, next(counter), (a, b)))
tree = heap[0][2]
code = {}
def visit(node, prefix=""):
    if isinstance(node, str):
        code[node] = prefix or "0"
    else:
        visit(node[0], prefix + "0")
        visit(node[1], prefix + "1")
visit(tree)
assert all(not b.startswith(a) for i, a in enumerate(code.values())
           for j, b in enumerate(code.values()) if i != j)

rng = np.random.default_rng(34)
message = "".join(rng.choice(symbols, size=2000, p=p))
payload = "".join(code[s] for s in message)
inverse = {v: k for k, v in code.items()}
decoded, prefix = [], ""
for bit in payload:
    prefix += bit
    if prefix in inverse:
        decoded.append(inverse[prefix])
        prefix = ""
assert not prefix and "".join(decoded) == message
entropy = -np.sum(p * np.log2(p))
expected = sum(w * len(code[s]) for s, w in zip(symbols, p))
assert entropy <= expected < entropy + 1
print("Code:", code)
print("Entropy / expected length:", entropy, expected)
print("Payload bits per symbol:", len(payload) / len(message))
熵界限討論來源下的期望長度,不是每個有限訊息。特定樣本可比期望速率更短或更長。小訊息的樹傳送成本可能占大部分;跨許多訊息共享穩定字母模型,可以攤提成本。
若由訊息本身估計機率,接收端不能直接使用該估計,除非它被傳送,或可由已解碼符號重現。先擬合直方圖、只報告負載,便隱藏真正的模型成本。
算術編碼:用區間識別整個訊息
從單位區間開始,每個符號挑選與機率成比例的子區間。反覆選擇後,剩下的小區間唯一描述整個訊息。
設 是符號 之前的累積模型機率, 是條件機率,區間界限更新為
其中 是處理 個符號後的區間, 是目前符號, 在兩端使用相同已解碼歷史,初始區間是 。第二行使用舊下界,不是剛更新的下界。
最後寬度為
其中 是訊息長度, 是模型聯合機率。夠短的二元描述若能指定區間內的點或包含於其中的二元冪區間,就能識別訊息。理想區間方法只為整個區塊付出有界的終止成本,而不逐符號取整。
實際實作使用有限整數暫存器、重新正規化與明確終止。實數不是可傳送物件,無限精度也不是產品編碼器。下方短例子刻意用精確有理數示範區間不變量,不宣稱建立完整檔案格式。
看懂前三次區間更新
使用例子中有順序的模型:A 機率 ,B 為 ,C 為 ,累積起點分別是 0、、。前綴 ABA 的更新為:
| 已讀符號 | 下界 | 上界 | 寬度 |
|---|---|---|---|
| 無 | 0 | 1 | 1 |
A | 0 | ||
AB | |||
ABA |
讀 A 後,可用區間寬 。B 選擇該區間內從二分之一到六分之五的部分,所以下界為 ,上界為 。接著 A 選寬度 區間的下半部。最後寬度為 ,恰好等於 ABA 的模型機率。
解碼時,把標記在目前區間的位置正規化,依相同累積分割選 A、B 或 C,再更新區間並重複。模型與訊息長度讓程序可逆,小區間則解釋理想描述成本。精確有理數標記用來教機制,有限整數實作才決定實際輸出哪些位元。
程式:短訊息的精確區間往返
編碼器輸出有理數標記;解碼器另取得共享模型與訊息長度。分子與分母在此是概念側資訊,其序列化大小不宣稱等於最佳算術碼長。
程式碼 · Python · 34 行
from fractions import Fraction

model = {"A": Fraction(1, 2), "B": Fraction(1, 3), "C": Fraction(1, 6)}
message = "ABACAB"
cumulative = {}
running = Fraction(0)
for symbol, probability in model.items():
    cumulative[symbol] = running
    running += probability
assert running == 1
low, high = Fraction(0), Fraction(1)
joint = Fraction(1)
for symbol in message:
    width = high - low
    old_low = low
    low = old_low + width * cumulative[symbol]
    high = old_low + width * (cumulative[symbol] + model[symbol])
    joint *= model[symbol]
assert high - low == joint
tag = (low + high) / 2

low_d, high_d = Fraction(0), Fraction(1)
decoded = []
for _ in range(len(message)):
    position = (tag - low_d) / (high_d - low_d)
    symbol = next(s for s in model
                  if cumulative[s] <= position < cumulative[s] + model[s])
    width, old_low = high_d - low_d, low_d
    low_d = old_low + width * cumulative[symbol]
    high_d = old_low + width * (cumulative[symbol] + model[symbol])
    decoded.append(symbol)
assert "".join(decoded) == message
print("Final interval:", low, high, "width:", high - low)
print("Exact decoded message:", "".join(decoded))
真實符號的模型機率若為零,區間會消失。編碼器需要正機率逸出路徑,或涵蓋所有合法輸入的字母模型。只在編碼端截斷機率不夠,解碼端也必須使用相同正規化與整數量化。
模型成本是交叉熵,不只是熵
再好的位元封裝,也救不了差的機率模型。模型未預期的符號仍需長描述。
對實際區塊分布 與編碼模型 ,
其中 依真實來源取平均, 是真實區塊熵,散度比較完整區塊分布。有限編碼器與框定成本還會增加位元。
使用先前符號的模型可以接近熵率,而不只是邊際熵。對持續的 Markov 序列使用獨立模型,就丟掉可預測的重複;更豐富上下文模型也可能過度擬合、需要過多記憶體,或對未見歷史分配脆弱機率。
評估應保留獨立紀錄或資料取得群組,報告實際序列化大小,包括標頭、模型選擇旗標與必要側串流。若預訓練權重永久共享,說明慣例;若每個訊息調適權重,計入更新成本。
有意義的比較,是共同假設下的完整編碼器與解碼器協定。某方法的理想對數機率與另一方法的實際位元組數可供診斷,但不是直接的編碼器比較。
訊息框定與不合法串流
完整實驗也指定訊息邊界如何處理。前綴樹告訴解碼器符號在哪裡結束,卻不一定告訴它整個串流何時結束。長度標頭、訊息結束符號或容器邊界,提供另外這項資訊。
填補到位元組邊界的位元,可能看起來像合法碼字。因此接收端需要有意義的位元數或原始符號數。樹例子的負載是教學用 Python 位元字串,不是省空間的位元組容器。
解碼器應拒絕最後不完整碼字與不可能轉移,不能默默回傳較短結果。完整性機制可能偵測損壞,但偵測檔案損壞與壓縮未損壞檔案是不同要求。若該機制屬於選用協定,傳送大小也必須計入。
這些細節對小訊息與公平比較最重要。漸近敘述可讓固定標頭的每符號成本忽略不計,實際短檔案仍必須支付每個標頭位元。
通用編碼邊解碼邊學習
不知道來源機率時,兩端可依已傳送符號更新相同預測器。更新不用透露未來符號。
序列模型分解為
其中 是先前已解碼歷史, 是正規化條件分布。編碼器觀察目前符號;解碼器從區間知道該符號後,再執行相同狀態更新。
對未知的獨立 Bernoulli 來源,Krichevsky–Trofimov 預測器使用
其中 計算先前的一, 是先前觀測數。分母為先前計數加一。半計數平滑使任何下一符號都具有正機率,包括第一次觀測 [1]。
這是使用 beta 半計數先驗的 Bernoulli 混合後驗預測分布。適當漸近編碼意義下,它對指定 Bernoulli 家族具有通用性,但不會自動對任意相依來源通用。
定義相對於知道真實來源的參照模型之序列遺憾:
其中 是選定參照來源, 是自適應模型。固定來源下的期望遺憾是區塊散度,非負;單一樣本的實現遺憾卻可為負,因為混合模型可能為該樣本分配比參照來源更高的機率。
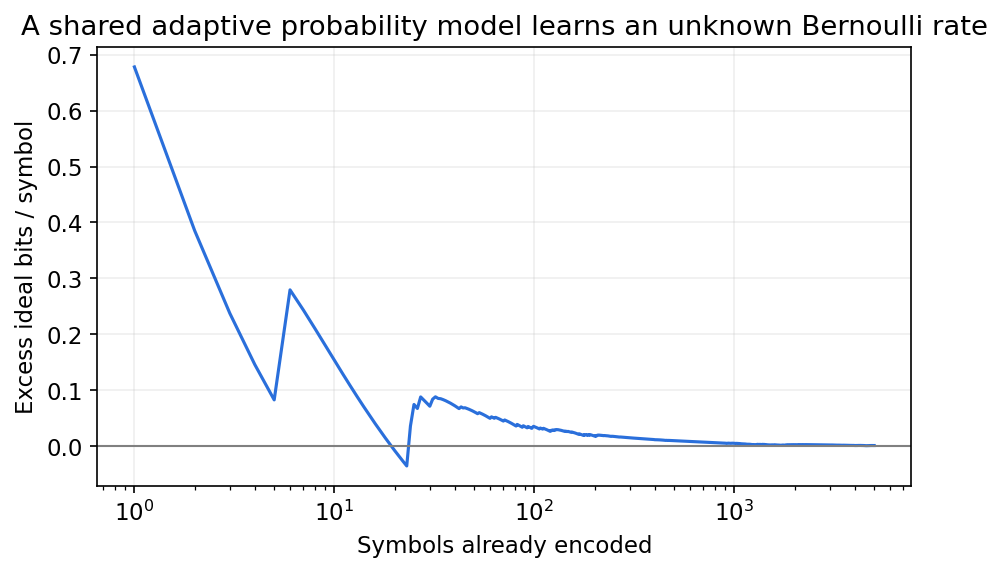
程式:調適與突然變動的來源
完整實驗測量理想序列長度,比較固定公平位元模型、匹配真實來源的參照模型,以及半計數調適。第二條序列在中途改變生成機率,顯示平穩計數模型的限制。
程式碼 · Python · 22 行
import numpy as np

rng = np.random.default_rng(23)
def adaptive_length(bits):
    ones, loss = 0, 0.0
    for t, bit in enumerate(bits):
        q = (ones + 0.5) / (t + 1)
        loss -= np.log2(q if bit else 1 - q)
        ones += int(bit)
    return loss

for n in [100, 1000, 5000]:
    bits = rng.binomial(1, 0.2, size=n)
    oracle = -np.sum(bits * np.log2(0.2) + (1 - bits) * np.log2(0.8))
    print("Length:", n, "oracle:", oracle / n,
          "adaptive:", adaptive_length(bits) / n, "fair model:", 1.0)
bits = np.r_[rng.binomial(1, 0.1, size=2500),
             rng.binomial(1, 0.9, size=2500)]
one_model = adaptive_length(bits)
two_models = adaptive_length(bits[:2500]) + adaptive_length(bits[2500:])
print("Changed source, whole / reset ideal rate:", one_model / 5000, two_models / 5000)
assert two_models < one_model
重設比較免費提供變動點。真實編碼器必須識別該位置,或使用兩端共享的預定重設時程。計入重設好處卻省略通知成本,會高估可達節省。
另有兩種不同基準:相對於固定真實機率的遺憾,以及相對於觀察序列事後最佳擬合參數的遺憾。兩者不能互換。即使來源模型正確,有限樣本也可能偏好不同於生成機率的參數。
看因果預測器逐符號學習
尚無觀測時,半計數模型替兩種位元各給 機率。若已解碼前綴是 001,下一個一的機率為 ,零的機率為 。兩端從相同前綴得到同一狀態,因此不需要傳直方圖。
模型一開始不知道來源偏差,必須支付學習成本。固定 Bernoulli 來源的計數增加時,初期成本被更多符號攤提。但交替字串的總計數公平,卻可由前一符號完全預測;純計數模型漏掉此關係,持續預測接近二分之一。Bernoulli 家族內的通用性指學未知偏差,不是學會所有序列結構。
字典、相依性與通用來源類別
字典編碼器學習重複片語,而不只符號頻率。長重複模式可以用先前片語的參照表示。
Lempel–Ziv 家族使用持續成長的已觀察字串集合建立描述 [1]。漸近通用性結果指定來源類別,例如平穩遍歷有限字母程序,也指定精確演算法;並不表示任何字典實作都在每個有限檔案上勝過每個機率模型。
字典項目、片語邊界與參照索引必須能由解碼器重現。字典增長時,索引需要更多位元。剖析出的片語個數不是壓縮長度,還需要整數編碼規則與終止格式。
不同來源結構適合不同機制。單符號預測器捕捉偏差,上下文預測器捕捉短相依性,片語字典利用重複子字串,學習模型則可利用訓練族群共享的結構。若宣稱無損,仍都需要可逆符號傳送。
通用性相對於基準與極限設定。未知平穩參數是一種問題,變動字母集或任意對抗來源則是另一種。記憶體限制、延遲、短訊息與重設規則可能主導漸近好處。
引用通用速率結果前,應問四件事:涵蓋什麼來源類別、使用何種參照長度、收斂是期望還是實現路徑,以及是否包含模型、字典與框定成本。
Kolmogorov 複雜度:描述的理想極限
想像能印出某字串並停止的最短電腦程式。有結構字串可用短程式,大多數長字串卻不行。
相對於固定通用描述機器 ,定義
其中 是有限字串, 是讓機器 輸出 並終止的程式, 是程式位元長度。某些版本使用前綴自由程式;機器與慣例必須說明 [1]。
不同適當通用機器之間,複雜度只差與機器相關的加法常數。但對短字串,這不表示實際數值與機器無關。更重要的是,一般情況下精確最短程式函數不可計算,不能從定義得到總能找出最佳壓縮的演算法。
把解碼器與框定計入後,無損壓縮器給出演算法描述複雜度的上界;輸出長度不是精確 Kolmogorov 複雜度。某壓縮器不能縮短字串,也不證明字串具演算法隨機性。
計數論證說明,沒有單射壓縮器能縮短每個固定長度輸入:長度 的字串,比所有短於 的二元描述更多。在誠實邊界慣例下,讓一些輸入更短的任何方法,必須使其他輸入維持原長或變長。
這不妨礙在有結構來源分布上取得優秀壓縮。壓縮利用非均勻機率或重複結構,沒有移除所有可能輸入的計數限制。
現代觀點
Yang、Mandt 與 Theis 的 2023 年已出版專論 [4],區分無損機率編碼與有損表徵設計。其無損分類包括自迴歸、潛在變數與可逆模型,並強調模型分解與熵編碼器的相容性。我們用這個分類,追問機率如何到達可執行解碼器。
現代自迴歸網路可取代簡單計數預測器,同時保留鏈式協定。下一符號機率必須能由已解碼上下文取得。潛在變數模型需指定傳送潛在資訊的協定;低變分訓練目標不會自動等於最後位元串流長度。
El Gamal 的 2026 年擬議學習章節 [5],以散度連結壓縮與統計學習。它仍是草稿。古典不匹配恆等式依然有用:更好的預測機率可以降低理想編碼成本,計算與同步則決定節省是否實際可用。
開放問題包括有效調適分布轉移、降低逐步解碼成本、公平比較完整格式,以及讓小訊息負擔得起模型更新。較大預測器可以節省負載,同時增加共享記憶體或計算需求。
具體評估應分開記錄三項:保留資料的負對數機率、包含必要側資訊的實際檔案大小,以及共同硬體假設下的編解碼時間。只有第二項能建立實際壓縮率,只有完整往返斷言能建立精確重建。
下一章轉換角色:來源編碼移除可預測冗餘,通道編碼加入精心設計的冗餘以抵抗雜訊。兩者都使用機率,但解決不同重建問題。
重點整理
- 無損性是具有明確邊界的精確編碼器與解碼器恆等式。
- Kraft–McMillan 限制碼長,熵限制其期望值下界。
- Huffman 對指定二元逐符號前綴問題最佳。
- 算術區間把取整成本攤到整個訊息。
- 模型不匹配先增加散度,再加有限實作額外成本。
- 自適應編碼需要同步因果更新與正機率支撐。
- 通用表現依賴指定來源類別與基準。
- 可計算壓縮長度是理想演算法描述的上界。
練習
- 在碼字 0、1、01 下,找兩個產生相同串流的不同符號序列。說明其他配置中,提供符號數為何仍可能有歧義。
提示
從第三符號與前兩符號開始。
- 驗證碼長 1、2、3、4、4 的 Kraft 總和,建立實現這些長度的前綴樹,並以例子分布比較期望長度。
提示
加總二的冪,配置互不為祖先的葉節點。
- 將 Huffman 機率改成五符號均勻來源,說明平手為何改變樹而不改變最佳期望長度。
提示
保持確定性平手規則。
- 將精確算術例子改成上下文相依的二元預測器,讓解碼器依已解碼符號更新,驗證最後區間寬度。
提示
使用精確半計數分數與相同歷史。
- 比較半計數調適在常數、交替、獨立偏差二元字串上的結果,指出單一計數模型漏掉哪些來源結構。
提示
頻率沒有編碼順序。
- 學習預測器每符號節省 0.1 理想位元,但需傳送 8,000 位元調適資訊。忽略其他變化,求抵銷額外成本所需訊息長度。
提示
總額外成本除以每符號節省。
參考文獻
- T. M. Cover and J. A. Thomas, Elements of Information Theory, 2nd ed., Wiley, 2006, Chapters 5, 13–14. 出版社書籍與目錄.
- T. Weissman, “Variable Length Lossless Compression,” Stanford EE276 Lecture 4 notes, 2024. 原始課程講義.
- T. Weissman, “Kraft-McMillan Inequality and Huffman Coding,” Stanford EE276 Lecture 5 notes, 2024. 原始課程講義.
- Y. Yang, S. Mandt and L. Theis, “An Introduction to Neural Data Compression,” Foundations and Trends in Computer Graphics and Vision, 15(2), 113–200, 2023. 已出版專論作者版本.
- A. El Gamal, “Information Theory and Statistical Learning,” proposed textbook chapter, arXiv preprint, 2026. 草稿與出版狀態.
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 IT 04・通道容量與可靠通訊 · 15 分鐘