IT 02・典型序列、AEP 與熵率
先備知識:IT 01・熵、相對熵與互資訊
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
資訊理論
你將學到
- 推導獨立有限字母來源的漸近均分性質。
- 分別限制典型集的機率與大小,不混淆兩者。
- 說明最可能的單一序列為何不一定具有代表性。
- 推導平穩有限狀態 Markov 來源的熵率。
- 用具體反例區分平穩性、獨立性與遍歷性。
- 連結條件典型性、聯合典型性與壓縮及通訊證明。
先看全貌
單次取樣充滿不確定性,長序列的整體行為卻常相當穩定。具有偏差的二元來源,其下一個位元仍無法完全預測,但長區塊的平均描述長度往往接近固定值。典型性把這項觀察寫成精確敘述。
本章依循 Cover 與 Thomas 的第 3–4 章 [1]。Stanford 的 AEP 原始講義 [2] 提供精簡的獨立來源證明。我們會推導結果、說明有限區塊的限制,再延伸至相依來源。後續章節會把存在性論證轉成實際編碼器與解碼器。
典型性永遠相對於指定的來源分布。它不代表外觀普通、語意正確,或對每個族群都有代表性。樣本可能在錯誤的模型下具有高機率,卻仍不符合應用需求。
區塊機率與平均驚訝量
不只問一個符號有多令人意外,而是計算整個區塊的驚訝量,再除以長度。對獨立符號,這就是各符號驚訝量的平均。
設 在有限字母集 上,依機率質量函數 獨立同分布。定義區塊 :
其中 是區塊長度, 是特定序列, 是位置, 是以每符號位元數表示的隨機平均驚訝量。等式利用獨立性;其期望為單一來源符號的熵 。
有限字母設定使正機率結果上的驚訝量可積分。字母集中可以包含不可能的符號,但實際取樣區塊不會出現它們。因此大數法則給出
箭頭表示依機率收斂:對任何固定正容許誤差, 與熵的差超過該誤差的機率會趨近零。這就是漸近均分性質(asymptotic equipartition property,AEP)[1,2]。
「均分」是近似且漸近的。它不表示每個區塊都具有相同機率,也不表示所有符號最後都會等頻出現。它表示多數機率質量集中於機率具有近似相同指數尺度的區塊。
對符號一機率為 的 Bernoulli 來源,含有 個一的區塊滿足
其中 是觀察到的個數, 是經驗比例。當比例接近 ,平均驚訝量接近二元熵 。一的個數通常不會接近區塊長度的一半。
典型集:分清機率與計數
多數可能觀察到的結果能放進合理區塊的目錄。目錄內每個區塊的機率可能很低,但加總後涵蓋幾乎全部來源機率。
對容許誤差 ,定義
其中 是弱典型集,大括號內的 表示絕對值, 是以每符號位元數表示的容許誤差。其元素滿足
這限制單一典型區塊的機率。AEP 另外指出 趨近一。
當 足夠大,假設典型集機率至少為 ,其中 是指定的機率容許誤差,則
其中 表示典型序列的個數,而非其機率。上界來自每個典型區塊至少具有 的機率,且總機率不能超過一。下界來自集合至少涵蓋 的機率,而各區塊機率至多為 。
把 與 分開,可以看清角色:前者限制描述長度的偏差,後者限制被排除的機率質量。教科書可能在選擇足夠大的區塊後,用同一個小參數表示兩者;有限長度計算仍必須區分。
總共有 種可能序列。若 ,典型目錄的指數尺度就小得多。這是壓縮背後的計數事實:若允許很小的錯誤機率,就不必讓每個可想像的區塊都有短描述。
最可能的區塊不一定典型
單一機率最高的字串可能沒有代表性。許多單獨機率稍低的字串,加起來反而占大多數機率。
對 的獨立二元來源,全零區塊是單一機率最高的區塊。其平均驚訝量為
其中 是零的機率。這個值與 不同。對較窄的容許誤差,全零字串一直在典型集外,即使沒有任何單一字串比它更可能。
它的總機率 趨近零;反之,約五分之一符號為一的區塊有非常多個,加總機率趨近一。機率質量與單一結果排名是不同的對象。
生成模型也有類似區別:最大機率序列不一定像模型的代表性樣本。典型性提供數學例子,卻不保證某個取樣演算法會產生有用語言或影像。
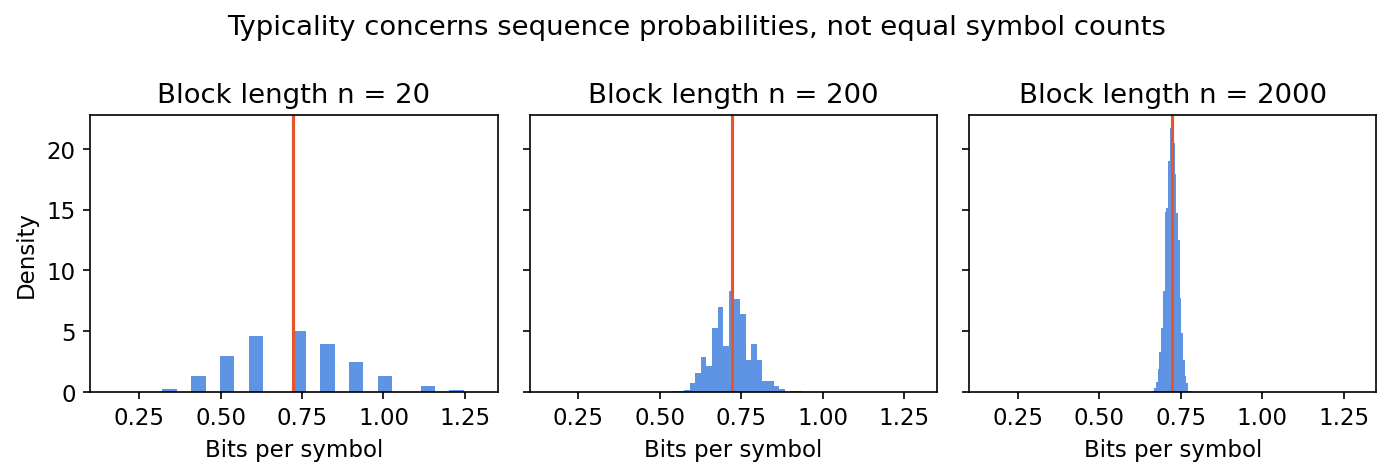
程式:精確典型機率與有限個數
第一個完整例子利用二項計數分布,將典型集機率加總至浮點運算精度。另用小區塊枚舉檢查基數界限。
程式碼 · Python · 25 行
import itertools
import numpy as np
from scipy.stats import binom

p, epsilon = 0.2, 0.1
entropy = -p * np.log2(p) - (1 - p) * np.log2(1 - p)
for n in [20, 200, 2000]:
    k = np.arange(n + 1)
    per_symbol = -(k / n) * np.log2(p) - (1 - k / n) * np.log2(1 - p)
    typical = np.abs(per_symbol - entropy) <= epsilon
    probability = binom.pmf(k, n, p)[typical].sum()
    print("Length:", n, "typical probability:", probability)

n, epsilon = 10, 0.15
count, mass = 0, 0.0
for block in itertools.product([0, 1], repeat=n):
    k = sum(block)
    probability = p**k * (1 - p)**(n - k)
    surprise = -np.log2(probability) / n
    if abs(surprise - entropy) <= epsilon:
        count += 1
        mass += probability
assert count <= 2**(n * (entropy + epsilon))
assert count >= mass * 2**(n * (entropy - epsilon))
print("Small-block typical count / mass:", count, mass)
小區塊的典型機率不一定接近一。「漸近」描述固定容許誤差下,區塊長度持續增加的行為,不代表任何長度都能套用長區塊結論。
計算例:先數字串,再加總機率
使用上方小區塊枚舉的 、、。有 個一的區塊,其每符號平均驚訝量為 位元,來源熵則為 0.721928。只有 符合容許誤差;我們先決定成員,再進行計數。
這些字串有 個。每個機率為 ,所以典型集機率是 。相較之下,單一全零字串機率為 。它比每個典型字串更可能,但比 45 個字串合計的機率低。
這分別回答三個問題:成員資格由驚訝量容許誤差決定,基數計算接受字串數,機率質量加總其機率。45 個字串的目錄需要六個定長索引位元,因為五位元只能區分 32 種選項。但該目錄只涵蓋這個短區塊來源約 30.2% 的機率。因此,即使碼率是每符號0.6 位元,僅靠長度十目錄仍不是好的幾乎無損編碼。
熵界限沒有失效。固定此容許誤差時,高機率結論需要更長區塊。基數取整與排除機率,是極限論證不會從短實驗中消除的成本。
若改用公平位元模型評分,同一批區塊全部恰好每符號一位元。該模型無法用驚訝量區分全零與兩個一的字串。真正來源未變,改變的是評分模型。計算典型集時,必須指定由哪個分布提供機率。
經驗頻率與組合計數直覺
區塊的符號頻率定義一群具有相同來源機率的字串。計算這一群的大小,就能說明單獨不太可能的字串為何能共同占大多數機率。
對恰好有 個一的二元區塊,排列數與該計數的總機率為
其中 計算字串個數, 是隨機的一的個數, 是二項係數, 是來源產生一的機率。同一計數的每種排列機率相同,但排列數差異非常大。
兩個極端分別只有一個全零與一個全一字串;中間則有大量排列。對偏差來源,每種排列的機率與排列數朝不同方向變化,乘積在接近來源期望計數處達到高值。
這也說明經驗頻率典型性與驚訝量典型性的差別。公平二元來源的每個長度 字串機率都是 ,平均驚訝量恰好一位元。因此任何正容許誤差下,所有可能字串都是弱典型,包括全零。
觀察到全零字串的機率仍趨近零。以頻率定義的典型集可要求一的比例接近一半,從而排除全零。它的機率也趨近一,但成員條件更嚴格。
兩種定義都沒有錯;它們用於不同證明。機率尺度敘述可能只需要弱典型性;需要匹配經驗條件分布的構造,可能必須控制頻率。務必確認證明實際使用哪個定義,尤其從邊際來源編碼轉向聯合輸入輸出關係時。
來源編碼論證與限制
將典型區塊編號,傳送其目錄索引。區塊夠長時,平均每符號使用接近熵的位元數,只在少量被排除的結果上失敗。
典型集至多有 個成員,因此索引大致需要不超過 位元,再加取整與區塊框定的成本。解碼器用相同目錄重建所選區塊。
這是幾乎無損的定長構造,並未正確編碼所有區塊。可以保留一個額外符號表示失敗,但旗標不能重建非典型區塊。要真正無損,就必須提供足以完整還原它的逸出表示。
簡單的反向論證可說明,遠低於熵的速率為何無法涵蓋多數機率。假設編碼最多正確表示 個區塊,將它們與典型集取交集。每個典型區塊機率至多為 ,可接受機率質量至多為
其中 是以每來源符號位元數表示的定長編碼速率。若 ,典型集內可接受的機率趨近零。被排除的非典型機率也趨近零,因此編碼無法以高機率重建來源。
論證假設編碼器與解碼器只有有限個不同訊息。這是計數證明,不是有效率的實作;枚舉巨大目錄通常不實際。下一章研究前綴編碼、機率編碼與自適應模型,把理論速率轉成可計算程序。
加上逸出分支,讓目錄真正無損
有時失敗的目錄,可以變成還原每個允許有限區塊的碼。先傳一位元分支旗標;區塊典型時傳定長目錄索引,否則傳逐符號固定寬度的未壓縮表示。
令 ,非空典型集的索引寬度為 。期望長度滿足
是區塊總位元長度, 是原始符號固定寬度, 是典型索引寬度, 是典型機率, 沿用前述定義。等式計入旗標與兩分支;不等式利用典型集基數與向上取整。
解碼器先讀旗標,便知道該讀哪個固定分支長度。典型分支回傳共享目錄項目,逸出分支還原原始符號,沒有區塊被默默省略。小有限區塊的典型集若為空,先只用原始分支,直到有可用目錄。
固定 下,AEP 給 ,使逸出分支的每符號貢獻消失。旗標與取整成本也隨 增長而消失,期望速率因此漸近不超過 。先建立足夠長區塊,再選較小容許誤差,便能任意接近熵。
構造揭露定長幾乎無損與變長完全無損的差別。逸出分支在罕見區塊可能很長,後者結論因此針對期望長度,不是每個區塊都有短上界。兩端還須共享目錄與來源模型。這是速率可達證明,明確枚舉通常太昂貴,不是實用壓縮演算法。
有限區塊集中速度取決於來源
長區塊很有用,但需要多長,取決於來源與容許誤差。稀有符號可能造成很大的驚訝量波動。
對驚訝量變異數有限的獨立符號,
其中 是來源驚訝量變異數, 表示變異數。結果來自獨立變異數相加再除以 。一般變異數界限給出
其中 是前述驚訝量容許誤差。界限可能寬鬆,但明確顯示依賴關係。很小的機率可能提高驚訝量變異數;要求更窄誤差也會增加所需長度。
跨區塊的經驗標準差有用,卻不是通用的有限區塊編碼保證。相依性改變變異數計算;小規模模擬可能漏掉稀有事件;模型不匹配會改變集中位置。
若來源 由模型 評分,在可積分條件下,獨立區塊平均驚訝量收斂至 ,而不是 。兩者的差是相對熵。對模型典型與對真實來源典型,是分開的問題。
熵率考慮相依性
鄰近符號常能幫忙互相預測。因此,長序列每符號需要的資訊,可以小於單一邊際符號的熵。
對隨機程序 ,若極限存在,定義熵率為
其中 是每符號平均新增的不確定性, 是區塊長度。定義討論區塊熵,不是擬合模型在某一條已實現序列上的損失。
鏈式法則給出
其中 是先前歷史, 時為空。相依性使條件項不同於邊際熵。
當所有時間指標共同平移後,每個有限維聯合分布都不改變,程序稱為平穩。這比平均值或共變異數固定更強。有限字母的平穩來源,其給定更長過去的條件熵不增加,而且以零為下界,故極限存在;區塊平均熵有相同極限。
兩種極限相等,是因為對收斂的條件熵序列取平均。平穩性允許將固定長度歷史移到共同時間點,而增加過去資訊會降低條件熵。
獨立同分布是特例:每個條件熵都等於 。相依的平穩來源可以在每個時間擁有相同邊際分布,但每一步需要的新資訊少得多。
Markov 來源的明確計算
一階 Markov 模型只需目前狀態即可預測下一個狀態。長期不確定性是各轉移列不確定性的加權平均。
設有限 Markov 來源的轉移矩陣為 :
其中 是來源狀態索引, 是時間, 是轉移機率, 是平穩狀態分布。 每列總和為一; 非負且總和為一。
若程序以 初始化,平穩性與 Markov 性質給出
內部總和是轉移列 的熵,外部總和按平穩占有率加權。有限區塊熵為
其中 是初始狀態熵。鏈式法則貢獻一個初始項與 個相同轉移項。
對翻轉機率為 的對稱二元來源,平穩分布均勻。邊際熵為一位元,熵率則是 。當 ,下一符號多半重複目前符號,因而減少新增不確定性。
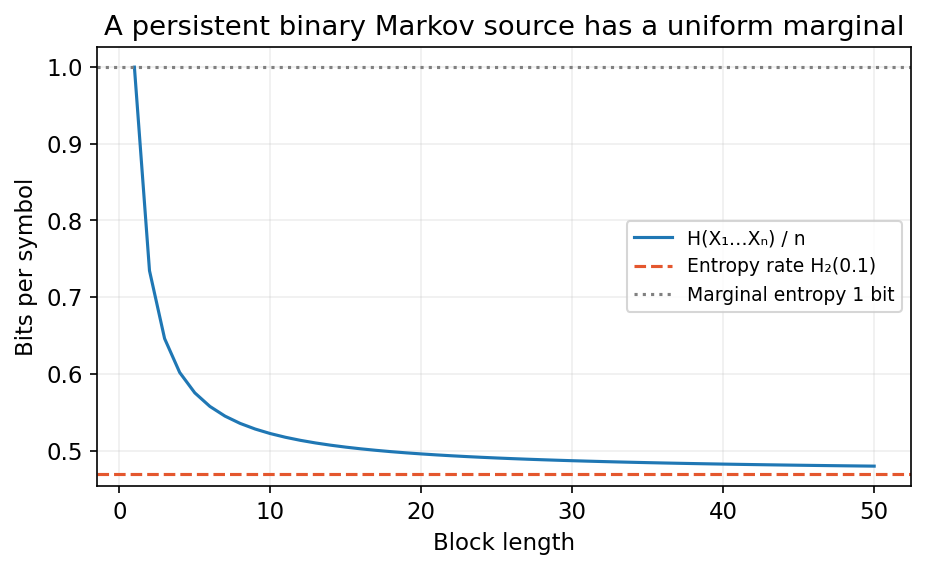
程式:邊際不變,預測性不同
獨立的翻轉事件產生平穩二元 Markov 區塊,再將觀察到的平均驚訝量與精確區塊熵公式比較。
程式碼 · Python · 18 行
import numpy as np

rng = np.random.default_rng(32)
a = 0.1
rate = -a * np.log2(a) - (1 - a) * np.log2(1 - a)
for n in [64, 256, 1024]:
    initial = rng.integers(2, size=1000)
    flips = rng.binomial(1, a, size=(1000, n - 1))
    states = np.column_stack([
        initial, initial[:, None] ^ np.bitwise_xor.accumulate(flips, axis=1)])
    surprise = 1 + (-flips * np.log2(a) - (1 - flips) * np.log2(1 - a)).sum(axis=1)
    expectation = (1 + (n - 1) * rate) / n
    print("Length:", n, "one-frequency:", states.mean(),
          "mean surprise rate:", surprise.mean() / n,
          "exact entropy per symbol:", expectation)
    assert abs(states.mean() - 0.5) < 0.08
    assert abs(surprise.mean() / n - expectation) < 0.02
print("Entropy rate:", rate, "marginal entropy:", 1.0)
初始狀態均勻取樣,因此來源平穩。每個區塊固定從零開始會改變有限區塊分布;適當轉移假設下漸近速率仍可能相同,但精確的初始熵項會改變。
邊際公平,為什麼仍容易預測?
翻轉機率 的對稱 Markov 例子,第一位元有一位元不確定性,後續每個位元貢獻 位元。長度十的區塊熵為 位元,即每符號 0.522096 位元;十個獨立公平位元則有十位元區塊熵。
可以用初始位元加九個翻轉指示表示整段序列。這個映射可逆:從第一位元開始,依序與翻轉指示做互斥或,就恢復下一狀態。它揭露相依性,沒有捨棄來源資訊。在此特定模型下,指示是有偏的獨立位元,因此比十個邊際公平狀態更容易編碼。
長期速率趨近 0.468996,因為初始化的一位元成本被越來越長的區塊攤提。可預測性來自轉移關係,即使每個時間位置的邊際都公平。影像直方圖也無法揭露利用鄰近像素預測所能獲得的全部節省。
隱藏狀態與觀測對象
轉移模型可能描述內部狀態,接收端卻只看得到帶雜訊的測量。觀測序列因此有自己的預測問題。
設 是有限隱藏 Markov 狀態, 是發射觀測,模型可將區塊分解為
其中 是狀態序列, 是觀測序列,各因子描述轉移與發射。對隱藏序列加總後得到觀測概似 。
的熵率通常不只是按平穩分布平均的發射列熵。過去觀測能幫助推論隱藏狀態,剩餘狀態不確定性也影響預測。相關項是 ,而不只是 。
對視覺而言,物件動態模型與相機測量模型描述不同的隨機程序。更多感測雜訊可能提高觀測熵,同時降低關於場景的有用資訊。速率計算必須說明究竟描述哪個程序。
共同典型值需要遍歷性
平穩表示分布不隨時間漂移,卻不保證一條長序列會探索混合族群的全部部分。
在適當的有限字母平穩遍歷假設下,長區塊正規化驚訝量收斂至共同的熵率值。遍歷性排除某個持續存在的隱藏選擇,把程序分成行為不同的平穩成分。
考慮只選一次成分 :一半機率永遠產生零,一半機率產生獨立公平位元。每個成分平穩,混合也平穩。
條件區塊熵為 。恆等式
使用成分標籤 、區塊 與互資訊 。因為 ,區塊平均熵趨近半位元。
然而,確定成分產生的已實現序列,其正規化驚訝量趨近零;公平成分的序列通常趨近一。多數實現不會共享接近一半的單一值。僅有熵率極限,並不足以套用遍歷 AEP 結論。
程式:平穩但非遍歷的反例
這個完整例子從一的個數解析計算混合區塊機率,避免先計算極小公平區塊機率,再取對數。
程式碼 · Python · 14 行
import numpy as np

rng = np.random.default_rng(33)
for n in [128, 1024]:
    component = rng.integers(2, size=2000)
    counts = rng.binomial(n, 0.5, size=2000) * component
    # A nonzero sequence can only come from the fair component:
    # its probability is 0.5 * 2**(-n), so surprise is n + 1.
    all_zero_surprise = -np.log2(0.5 + 0.5 * np.exp2(-float(n)))
    per_symbol = np.where(counts == 0, all_zero_surprise, n + 1) / n
    print("Length:", n, "deterministic mean:", per_symbol[component == 0].mean(),
          "fair mean:", per_symbol[component == 1].mean(),
          "fraction within 0.1 of 0.5:", np.mean(abs(per_symbol - 0.5) <= 0.1))
    assert np.mean(abs(per_symbol - 0.5) <= 0.1) == 0
例子描述持續的異質性,而不是時間漂移。資料集包含不同來源類型時,可能需要條件模型或明確混合,不能假設一段長紀錄代表整個族群。
聯合與條件典型性
兩條各自普通的序列,配在一起可能非常異常。通訊證明需要輸入與輸出的關係,不能只看各自的直方圖。
從聯合機率質量函數 獨立取樣配對 ,考慮聯合與條件平均驚訝量:
其中箭頭表示在指定獨立配對模型下依機率收斂。 是配對區塊,每對內部允許相依。
聯合典型配對依照來源的聯合關係檢查,只有邊際典型性並不足夠。若 是 的帶雜訊副本,兩條無關的公平位元序列可以各自有典型邊際計數,卻具有不符模型的差異頻率。
區塊資訊密度為
其中 衡量聯合配對相對於獨立配對模型的證據。在獨立配對取樣及可積分條件下,其正規化平均趨近 。
這連結通道解碼:接收端尋找與收到區塊具有通道預期關係的碼字。它也連結配對與表徵學習,正配對必須仔細定義。從錯誤族群抽取負配對,會改變參照分布。
有限字母的強典型性另外限制各符號或配對的經驗頻率,並尊重不可能事件;弱典型性限制平均對數機率。若證明假設使用特定定義,不能在未說明下把兩者互換。
現代觀點
平均驚訝量與有意義輸出的區別,對現代機率模型尤其重要。長上下文與學習式預測器能描述固定 Markov 階數以外的相依性,損失仍是在指定觀測與詞元化模型下評分。
El Gamal 於 2026 年提出的學習章節 [3],以散度連結預測與生成模型。它是草稿補充教材,不是已出版的第三版。從來源編碼觀點推論,序列概似應連同預測目標、單位與條件上下文一起報告。
Huang 與 Wu 的 2024 年綜述 [4] 依人類重建與機器分析的區別,整理學習式影像壓縮。這個分類凸顯壓縮表示是否有用,取決於接收者。熵率給出來源描述的限制,卻不單獨指定任務可接受的失真。
許多應用仍面對三個問題:實際區塊長度下,漸近行為多快才有用;擬合來源模型跨族群是否仍有效;以及取樣、詞元化、前處理造成的相依性,如何影響估計速率。
有限評估應比較獨立區塊或取得資料的群組,並保留非典型案例。只報告平均驚訝量,可能掩蓋速率高得多的稀有來源成分。在一個模型下測量概似,不能證明所有來源成分共享同一典型集。
下一章會實際搭起橋梁:編碼器必須定義機率模型、更新規則、終止慣例,以及未預期符號的處理。速率定理引導選擇,完整編碼再解碼的測試則檢查實作是否還原原始資料。
重點整理
- AEP 在指定來源假設下,讓正規化區塊驚訝量集中。
- 典型集機率與基數是不同量,具有不同界限。
- 單一機率最大的區塊,不一定占大多數總機率。
- 典型目錄說明幾乎無損編碼限制,不是有效率的實作。
- 熵率衡量利用相依性後,每一步新增的不確定性。
- 平穩性不保證遍歷性,也不保證共同的已實現驚訝量。
- 聯合典型性檢查邊際典型性可能漏掉的關係。
- 漸近主張必須伴隨有限區塊、模型不匹配與異質性的討論。
練習
- 對 的 Bernoulli 來源,計算全零區塊的驚訝量率與來源熵,選一個能在所有長度排除全零的容許誤差。
提示
比較 與 。
- 以容許誤差 、、 重跑精確典型機率計算,說明較窄容許誤差為何可能需要更長區塊。
提示
平均驚訝量視窗縮窄。
- 用不同的 與 推導典型集基數上下界,指出每一步使用哪個單一區塊機率界限。
提示
以區塊數乘最大或最小允許機率,限制總和。
- 二元 Markov 鏈轉移矩陣為 。求平穩分布、邊際熵與熵率。
提示
解 ,再加權轉移列熵。
- 將非遍歷混合例子的成分機率改為四分之一確定來源、四分之三公平來源,求區塊熵率極限與各實現的驚訝量率極限。
提示
持續存在的成分仍阻止共同實現值。
- 構造兩條邊際典型公平位元序列,使它們在 10% 翻轉通道下不是聯合典型。說明個別符號計數為何無法發現不匹配。
提示
使用差異過多或過少的配對。
參考文獻
- T. M. Cover and J. A. Thomas, Elements of Information Theory, 2nd ed., Wiley, 2006, Chapters 3–4. 出版社書籍與目錄.
- T. Weissman, “Asymptotic Equipartition Property,” Stanford EE276 Lecture 3 notes, 2024. 原始課程講義.
- A. El Gamal, “Information Theory and Statistical Learning,” proposed textbook chapter, arXiv preprint, 2026. 草稿與出版狀態.
- C.-H. Huang and J.-L. Wu, “Unveiling the Future of Human and Machine Coding: A Survey of End-to-End Learned Image Compression,” Entropy, 26(5), 357, 2024. 已出版綜述.
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 IT 03・無損編碼與通用壓縮 · 15 分鐘