OPT 05・近似、統計估計與實驗設計
先備知識:OPT 04・對偶性、KKT 條件與證明憑證、ML 01B・機率與資訊理論
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 依重要的誤差選擇殘差範數,而非只沿用習慣。
- 區分參數正則化、穩健殘差損失與不確定量測模型。
- 使用線性不等式,讓擬合函數保持單調或凸。
- 辨認凸的概似與機率估計表示法。
- 設計隨機化偵測器,理解以動差建立的風險上界。
- 使用資訊矩陣與明確準則,配置量測資源。
先看全貌
最佳化模型可以替觀測擬合曲線、估計分布,或決定接下來收集哪些觀測。它們有共同模式:選擇表示方式、說明如何衡量不一致,再指定允許哪些選擇。
Boyd 與 Vandenberghe 的第 6–7 章 [1] 連結近似與統計估計。適合一起閱讀:同一個平方殘差,可以是幾何近似誤差、雜訊模型下的概似,或受限制設計目標的一部分。即使數值公式相同,解釋仍帶有不同假設。
成功求解器回答的是你寫下的最佳化問題。它不會證明量測假設正確、曲線能預測新資料,或感測器配置可以實際執行。本章把這些問題與數學一起保留。
例子使用合成觀測與小型量測模型,展示各部分如何運作,不在程式裡隱藏下載、預訓練系統或特定應用假設。
殘差範數表達優先順序
白話說。 殘差是預測與觀測的差。選擇哪種範數,會決定哪些誤差模式特別昂貴。
線性模型為
是固定設計矩陣, 是觀測, 是參數, 是殘差向量。所選範數作用於殘差,不是直接作用於參數。
歐幾里得範數或其平方,透過平方貢獻強調大殘差。絕對值範數加總殘差大小。最大值範數則最小化最大的絕對殘差,適合要求每個量測誤差都不超過一致容許值的場合 [1,第 6.1 節]。
是第 個殘差座標。當 對 仿射,三者都是凸目標。把非負歐幾里得範數平方不會改變最小化解,但會改變目標值、導數,以及與其他懲罰項的取捨。
絕對值殘差可以引入 、,再最小化 。一致容許值則引入一個純量 ,要求 。若額外限制只有仿射式,兩者都是 LP 表示法。
最佳常數的三種意思
只擬合一個數字,就能看出殘差目標的差別。取合成觀測 ,對三者都預測同一個純量 。對應設計矩陣是一欄全為一的向量。
對平方損失,微分 得到 ,所以 。對絕對損失,離開資料點時,斜率等於低於 的觀測數減去高於 的觀測數。斜率在中位數由負轉正,因此 最小化總和。對最大絕對損失,平衡兩端誤差:,因此 。
其中 是擬合常數、 是固定觀測。在各自最佳解處,平方殘差和為 、絕對殘差和為 、最大殘差為 。它們是不同單位的不同量,直接比較數值大小沒有意義。真正要比較的是回傳預測:平均擬合選三、中位數擬合選一、均勻誤差擬合選四。觀測八大幅拉動平均數,卻不會使中位數超過中間觀測 [1]。
實際任務須先問哪種誤差模式昂貴。儀器的統一容許誤差適合最大誤差;指定高斯量測模型可導向平方誤差;受污染的反應值可促使選用影響力有界的殘差損失。這些選擇都不能只由求解器方便與否決定。
單位與加權誤差
不同單位的量測,沒有指定縮放慣例就不能合理相加。一像素殘差與一秒殘差,不會自動具有可比性。
加權最小平方目標可以寫為
是固定半正定權重矩陣。若 是已知正定雜訊共變異數的反矩陣,目標就有統計意義。若權重代表優先順序,則應明確說明那個意義。
非對角元素可以描述相關量測誤差。把完整共變異數換成對角權重,是模型近似,不只是實作細節。以矩陣因子白化殘差,再擬合時,應保留原本指定的二次形式。
大殘差不會自動代表離群值。它可能揭露錯誤模型、縮放不良的特徵、真正罕見的現象或損壞觀測。在降低某些誤差的影響以前,先看資料生成過程。
最小範數解與正則化
白話說。 符合觀測可能仍留下許多參數選擇。參數範數能從中選解,或在擬合與複雜度間取捨。
最小範數問題為
是參數向量, 固定。這不同於殘差範數問題:此處要求精確一致,目標則選擇小的參數向量 [1,第 6.2 節]。
等式不一致時,問題不可行。把它換成軟殘差項會改變問題。在欠定且一致的系統中,歐幾里得最小範數解可由適當偽逆表示,但仍須關心數值秩與奇異值。
正則化近似則平衡兩個目標:
是凸懲罰, 是非負權重。二分之一讓導數較簡潔。改變這個因子卻保持 不動,會改變取捨。
取 ,就是 ridge 或二次正則化模型 [1,第 6.3 節]。正 使 Hessian 正定。取 ,非光滑幾何會鼓勵部分座標精確為零。
截距通常另行處理,因為懲罰它與懲罰特徵效果的意義不同。特徵單位也會改變參數範數。標準化矩陣欄,或採明確縮放的懲罰,可以讓這項選擇可見。
逐方向推導二次收縮
二次正則化減少量測薄弱方向造成的不穩定。對前面定義的 ridge 目標,令梯度為零得到
其中 是最佳解、 是固定設計與觀測、 是單位矩陣、 是懲罰權重。令 為奇異值分解, 包含正交奇異向量, 包含奇異值 。在方向 上,係數為
其中 是配對奇異向量。沒有正則化時,非零奇異值會把觀測係數除以 ;很小的值可能放大量測誤差。加入正則化後,分母不會低於 。在這個所有座標都受懲罰的模型中,零空間方向的係數為零。
對 與 ,未正則化解為 。取 後,解變為 。量測薄弱的第二方向被收縮得更多。這同時解釋數值穩定性與引入的偏差:正則化沒有學到第二個真實係數很小,而是在觀測對該方向限制較弱時,施加一種偏好 [1,第 6.3 節]。
限制與懲罰相關,但不同
在 下最小化 ,會直接指定可接受的複雜度預算。在適當條件下,它的拉格朗日乘子可以連到懲罰表示。
這不表示特定數值 事先就對應明顯的 。非唯一解與未作用的限制,可能讓對應更複雜。應選擇最能表達真正需求的表示法。
正則化可能改善條件數,但數值優勢與預測改善是不同的事。條件數良好卻有偏差的模型,仍可能預測很差。若目標是預測,應用有效評估切分選擇調整參數,並把擬合目標與最後評估指標分開。
穩健損失與穩健量測模型
白話說。 「穩健」可能指減少異常大殘差的影響,也可能指防範量測運算子的變動。兩者是不同模型。
一個凸殘差損失是 Huber 函數:
是純量殘差, 是轉換尺度。導數在零附近等於 ,外部大小則飽和於 。對仿射殘差加總此損失,就得到凸問題 [1,第 6.1 節]。
轉換尺度具有殘差的單位。把所有觀測乘上一個尺度、卻不改 ,會改變哪些點減少影響。此損失不能抵抗所有污染;設計矩陣中的高槓桿誤差需要另外處理。
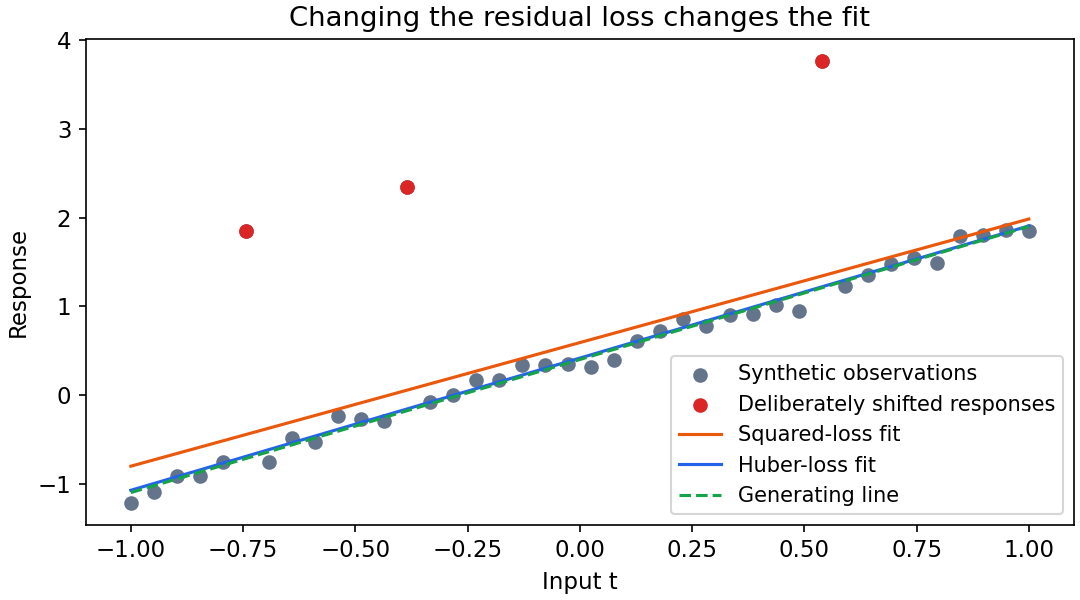
程式:用兩種損失擬合直線
資料與偏移在本機生成。平滑最佳化呼叫遵循 SciPy 官方介面 [2]。我們比較解,並驗證穩健目標的梯度,而不宣稱某估計器永遠較好。
程式碼 · Python · 23 行
import numpy as np
from scipy.optimize import minimize

rng = np.random.default_rng(15)
t = np.linspace(-1, 1, 40)
A = np.column_stack([np.ones_like(t), t])
b = 0.4 + 1.5*t + rng.normal(0, 0.08, len(t))
b[[5, 12, 30]] += 2.5
least_squares = np.linalg.lstsq(A, b, rcond=None)[0]
delta = 0.2

def huber_objective(x):
    r = A @ x - b
    loss = np.where(abs(r) <= delta, 0.5*r*r,
                    delta*abs(r) - 0.5*delta**2)
    return loss.sum(), A.T @ np.clip(r, -delta, delta)

fit = minimize(huber_objective, least_squares, jac=True,
               method="BFGS", options={"gtol": 1e-9})
assert np.linalg.norm(huber_objective(fit.x)[1]) < 1e-6
print("squared-loss coefficients:", np.round(least_squares, 4))
print("Huber-loss coefficients:", np.round(fit.x, 4))
print("robust objective:", round(fit.fun, 6))
不確定運算子
假設矩陣本身會在指定集合 中變動,最壞情況近似模型是
是決策, 是固定目標, 是允許的量測矩陣。每個固定矩陣範數目標對 為凸,所以逐點上確界仍凸 [1,第 6.4 節]。
凸性不保證容易計算上確界。有限不確定集合可以產生有限個上圖限制。結構化橢球不確定性可能允許錐重寫。模糊描述的「小擾動」,不足以選擇正確對應模型。
期望平方誤差是另一個模型。若 且 ,
是平均運算子, 是隨機變動, 是半正定二階動差矩陣。零均值假設使交叉項消失。此處正則化來自指定的不確定模型,而非任意複雜度偏好。
最壞情況與期望保護回答不同問題。不確定集合不是機率分布;共變異數模型也不保證控制每個可能實現。
具有形狀限制的函數擬合
白話說。 我們可以要求擬合函數遞增或凸,同時讓係數最佳化保持凸。
對固定基底函數 ,
是輸入, 是已知基底, 是待擬合係數。在固定樣本輸入評估時,預測對 仿射,即使基底對 非線性。
這個區別很重要:對最佳化變數的凸性,不等於對函數輸入的凸性。多項式迴歸可以是凸係數擬合問題,擬合出的多項式卻既不遞增,也不凸。
在有序節點 ,令 為擬合值。單調性可要求 。分段線性內插函數的凸性要求
是變數,節點間距是固定正數。這些斜率順序不等式對擬合值為線性。與取樣任意彈性函數導數不同,它們會保證這個特定內插函數在整段節點區間的形狀。
程式:以 LP 做單調絕對誤差擬合
我們擬合五個有序量測,輔助變數表示絕對殘差上界。SciPy 的 LP 邊界全部明確指定 [3],包括符號不受限的擬合值。
程式碼 · Python · 22 行
import numpy as np
from scipy.optimize import linprog

observed = np.array([0., 2., 1., 3., 4.])
n = len(observed)
I = np.eye(n)
order = np.zeros((n-1, n))
for i in range(n-1):
    order[i, i], order[i, i+1] = 1, -1
G = np.vstack([np.hstack([I, -I]),
               np.hstack([-I, -I]),
               np.hstack([order, np.zeros((n-1, n))])])
h = np.r_[observed, -observed, np.zeros(n-1)]
fit = linprog(np.r_[np.zeros(n), np.ones(n)], A_ub=G, b_ub=h,
              bounds=[(None, None)]*n + [(0, None)]*n,
              method="highs")
assert fit.success
z = fit.x[:n]
assert np.all(np.diff(z) >= -1e-9)
assert np.isclose(abs(z-observed).sum(), fit.fun)
print("monotone fitted values:", z)
print("total absolute residual:", fit.fun)
絕對誤差解可能不唯一。程式驗證性質與目標,不要求某個特定平台值。加入嚴格凸的次要目標可以選定一解,但那會是另一個指定問題。
觀測區間外的限制需要小心。分段線性內插提供明確區間內函數;外插則是額外規則。形狀限制可以增加合理性,但若真實過程違反它們,也會引入偏差。
概似與凸參數化
白話說。 概似模型可以產生凸目標,但是否為凸,取決於所選參數化與定義域。
對自然參數為 的分布,獨立觀測 的模型為
是充分統計量向量, 是對數配分函數, 是與參數無關的基底項。指數族模型的 在自然定義域上為凸。
忽略與 無關的項,負對數概似為
是觀測數。此式對自然參數為凸。任意非線性參數轉換,不一定保留凸性 [1,第 7.1 節]。
對成功機率 的 Bernoulli 觀測, 次有 次成功,負對數概似為 。若兩種結果都有出現,內部最佳點為 。
若所有觀測都成功或都失敗,開放定義域的最佳值可能只在邊界逼近。允許邊界分布或加入先驗,會改變存在性問題。程式若裁切機率,應把裁切記錄成定義域選擇。
最大後驗估計會加入負對數先驗。若負對數先驗在所選座標為凸,整體凸性就保留。「Bayesian」本身不保證凸最佳化,點估計也不代表完整後驗不確定性。
選讀:Logistic 分離與有限估計(見「補充資料」頁)。用實例區分係數發散與目標向下無界。
非參數機率
對離散結果,在單純形上估計機率向量 :
是結果 的機率。給定計數 ,負對數概似為 ,正計數搭配零機率時,要採適當延伸值慣例。
已知動差形成仿射限制,例如固定結果特徵 與已知平均值 的 。最大化熵,等價於最小化 ,可在這些限制下選擇分布 [1,第 7.2 節]。
動差限制應來自與資料相同的母體、使用相同單位。不一致的經驗限制可能使單純形模型不可行。放軟限制,是決定接受多少不確定性的模型選擇,不是修補代數上的麻煩。
以線性規劃設計偵測器
白話說。 看見離散證據後的決策,可以直接最佳化。允許隨機決策,會讓可行集合凸化。
假設 是假說 下觀測 的已知機率。令 表示看見 後決定假說 的機率。
是 為真時決定 的機率。 是決策變數,條件機率 固定。 的每個元素對 都是線性的。
加權錯誤成本、正確偵測下界與錯誤決策上界,都能寫成線性目標和限制 [1,第 7.3 節]。假說先驗可以加權整體期望錯誤,但不應悄悄拿它代替條件錯誤保證。
二元假說的適當最佳偵測器表示法,會產生概似比閾值規則。邊界觀測可能需要隨機化,才能符合精確錯誤預算。確定性規則是受限子集;強制使用它們會引入離散選擇。
最佳偵測器的有效性,取決於條件分布。分布偏移、估計概似與校準不確定性,都應納入判斷。指定機率表下的數值最佳性,不會驗證機率表本身。
偵測器算例:隨機化為什麼有用
偽陽性預算可能落在兩個確定性規則之間。假設觀測為 或 。假設 下的機率為 , 下為 。這是合成條件機率表,不是量測頻率。
令 為各觀測後判定 的機率。在偽陽性預算 下最大化真陽性機率,形成 LP:
其中目標為 下的偵測機率,第一限制為 下的錯誤機率。在 花一單位錯誤預算,可得四單位偵測機率;在 花同樣預算,只得四分之一單位。因此把預算給 :、,真陽性機率為 。
在 做確定性判定會消耗 ,超過預算。在這個離散觀測集合中,任何非平凡的確定性規則都違反預算,因此唯一可行確定性規則是永遠選 ,完全不偵測。隨機化填入確定性規則之間的凸空間,達到需要的操作點 [1,第 7.3 節]。這是在已知觀測後隨機決策,不是把未知機率當成決策變數。
動差與指數風險上界
白話說。 有時我們知道動差,卻不知道整個分布。明確列出假設後,上界可以保守控制尾端事件。
對均值 、有限變異數 的純量隨機變數 ,Chebyshev 不等式為
是偏離閾值。這個上界只使用前兩階動差,可能很鬆。大於一的上界可以換成一;它不是估計的事件機率 [1,第 7.4 節]。
對閾值 ,指數或 Chernoff 上界使用
是正輔助參數,使用處的期望必須有限。最佳化其對數,得到 。
對數動差生成函數在定義域上對 為凸。但這不會自動使所有設計與風險的聯合問題,對全部變數為凸。應檢查隨機變數如何依賴決策,以及保留哪些分布假設。
尾端上界可以支援保守設計限制,卻不能代替檢查動差估計是否可靠。厚尾、相依性與有限樣本不確定性,可能讓假定的動差生成函數不適合。
選擇下一批量測
白話說。 估計品質不只取決於怎麼擬合,也取決於量測什麼。凸實驗設計先配置連續量測資源,再處理離散取整。
對候選量測向量 、獨立單位變異數雜訊與正規化權重 ,定義
是每單位正規化量測資源的資訊矩陣。矩陣正定、量測模型正確且計入總資源時,相應線性估計器的共變異數會與其反矩陣成比例。
D-optimal 設計最小化 ,針對不確定性體積。A-optimal 設計最小化 ,針對總座標變異數。E-optimal 設計最大化 的最小特徵值,針對最弱量測方向 [1,第 7.5 節]。
它們是不同的純量摘要。單位與座標轉換對它們解釋的影響可能不同。小的總變異數仍可能藏著量測不良的方向;小不確定體積,也不保證每個座標的界。
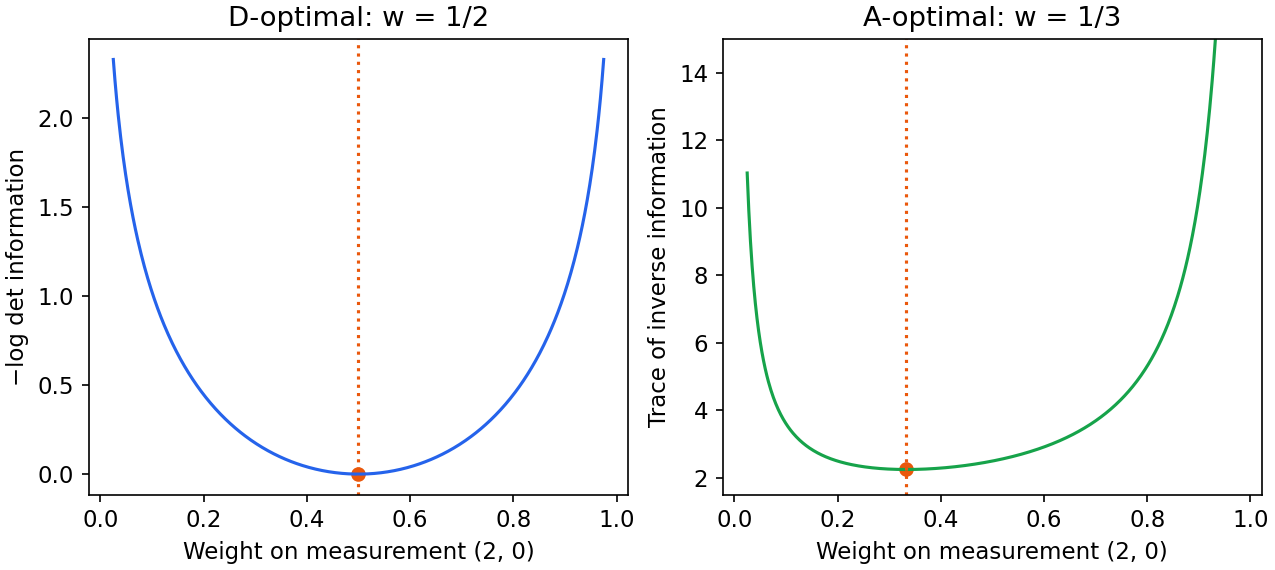
程式:兩種設計準則與精確檢查
候選向量為 與 ,第一個權重 ,第二個 。資訊矩陣為對角矩陣 。任一方向未量測時,兩種準則都發散。
程式碼 · Python · 15 行
import numpy as np
from scipy.optimize import minimize_scalar

def d_loss(w):
    return -np.log(4*w) - np.log(1-w)

def a_loss(w):
    return 1/(4*w) + 1/(1-w)

d = minimize_scalar(d_loss, bounds=(1e-6, 1-1e-6), method="bounded")
a = minimize_scalar(a_loss, bounds=(1e-6, 1-1e-6), method="bounded")
assert np.isclose(d.x, 0.5, atol=1e-5)
assert np.isclose(a.x, 1/3, atol=1e-5)
print("D-optimal first weight:", round(d.x, 6))
print("A-optimal first weight:", round(a.x, 6))
實驗總數固定時,實際次數是整數。連續權重是鬆弛,或隨機取樣策略。取整可能破壞預算,或讓某方向完全未量測;轉成排程後應重新檢查矩陣。
若候選向量無法張成參數空間,任何權重都不能使資訊矩陣正定。加入先驗矩陣可以正則化設計,但意義變成先驗加量測資訊。
推導兩種設計準則為什麼配置不同
兩方向實驗在執行數值程式前就可解出。候選向量為 與 ,權重為 ,資訊矩陣為 。令 ,確保兩方向都有量測。
D-optimal 目標與導數為
其中 是負對數行列式準則。駐點條件給出 。強度因子四只讓目標改變一個常數,不影響這個體積準則的配置。
對 A-optimal 設計,
其中 是反資訊矩陣跡準則。分母為正,因此駐點方程化為 ,得到 。兩個純量目標的二階導數都為正,而且在端點發散,因此這些駐點為唯一全域最小解 [1,第 7.5 節]。
解讀是:第一種量測本來就更強,因此最小化總變異數時,會把更多資源送往較弱的第二方向。最小化不確定性體積則平衡方向資訊的乘積,因此給相同資源。若量測成本或雜訊變異數不同,須先在資訊矩陣與預算中納入改變,再重新推導。沒有哪種配置永遠最好;每種都回答自己選定的不確定性問題。
擬合與設計的檢核
先從必須準確的應用量開始,決定它是預測、參數分量、最壞殘差或分布機率。選擇數值損失以前,先寫出表示法與單位。
對每個限制,問它是物理必要、統計估計,還是為計算方便引入。這些角色代表不同的不可行性處理方式。物理限制可能要求修正設計,經驗動差可能需要不確定性,冗餘代數可能需要移除。
擬合後驗證定義域、形狀限制與求解器殘差,再以適當獨立程序評估泛化或不確定性。訓練目標最佳解與可靠未來預測,是不同宣稱。
設計時檢查資訊譜、預算、雜訊假設與排程轉換。連同鬆弛目標一起回報最後可執行排程,讓最重要的近似保持可見。
不確定性橢球真正說明什麼
資訊矩陣的反矩陣,只有在相應量測與估計器假設下才能解讀為共變異數。若要轉成具有指定涵蓋機率的區域,還需要分布論證與正確閾值。只由矩陣畫出橢圓,不會建立信賴水準。
對正定共變異數 ,橢球可以寫成 。 是中心, 是閾值。矩陣指定形狀,閾值指定大小;涵蓋率還取決於估計誤差的實際分布。
先驗共變異數、抽樣共變異數與數值 Hessian 反矩陣,不一定具有相同解釋。特定模型下可能一致,但交換使用前應檢查模型。估計器的最佳化容許誤差與抽樣不確定性,也具有不同單位與來源。
重複量測時,獨立等變異數假設可支持簡單的資訊相加。相關重複可能提供比次數所暗示更少的新資訊。忽略相關性的設計,可能把資源自信地配置到冗餘量測。
這也影響停止精度。求解精度遠低於輸入係數的不確定性,可能實際幫助有限;看似微小的硬物理限制違反,卻仍可能不可接受。應依應用尺度設定最佳化容許誤差,而非只看浮點數能提供幾位數。
最後,不確定性視覺化應說明畫的是解析模型、估計共變異數,或重複合成實驗。本章圖形展示示意擬合與目標曲線,沒有呈現經驗校準的涵蓋區域,也沒有宣稱特定信賴機率。
現代觀點
白話說。 現今研究把結構化凸估計、大規模一階計算與學得的凸元件結合。凸性保證只屬於明確寫出的變數與定義域。
Pokutta 的 2024 年綜述 [4] 以凸可行集合的線性最小化、收斂保證與實用變體,組織 Frank–Wolfe 方法。單純形限制的實驗設計,是這個觀點的自然場合:極端點搜尋可以避免完整投影。但目標仍須滿足要求的平滑性與正定定義域控制。
Schaller、Bemporad 與 Boyd 的 2025 年手稿 [5] 討論學習參數化凸函數,再用於後續最佳化。它以有紀律的曲率規則連結擬合:對合法固定參數,學得元件可以保持對決策變數的凸性。訓練元件是另一個問題,本身未必凸。
兩來源涵蓋互補問題:如何在結構化可行集合中移動,以及如何建立能放入集合內使用的函數。它們都不會代替不確定性建模、保留資料評估或設計的物理可行性。
目前挑戰包括模型失配下的可靠不確定性、資源限制下有資訊的量測、樣本區間外仍合適的形狀限制,以及觀測逐步到來時的可擴充更新。應區分可證明凸的估計器與完整驗證的統計流程。
重點整理
- 殘差範數、參數範數與評估指標回答不同問題。
- 正則化權重依賴目標正規化與特徵單位。
- 穩健殘差損失與不確定運算子模型防範不同誤差。
- 固定非線性基底仍能產生凸係數擬合。
- 概似凸性依賴參數化與定義域。
- 離散證據的隨機偵測器可以寫成 LP。
- 實驗設計準則不同,連續權重也需要執行方案。
練習
- 將最大絕對殘差擬合寫成 LP,包含符號不受限的參數。
提示
使用一個非負殘差上界。
- 把觀測與預測乘以十。求 Huber 轉換尺度與二次正則化權重應如何改變,才能保留指定等價目標。
提示
寫出縮放後目標;答案取決於參數與懲罰單位是否也縮放。
- 在五節點單調擬合例子加入凸性限制,使用不相等的正節點間距。
提示
排序相鄰斜率。
- 推導 Bernoulli 最大概似估計,並解釋開放定義域的邊界情況。
提示
令概似導數為零,再看端點。
- 建立具有明確偽陽性預算的雙假說隨機化偵測器 LP。
提示
使用每個觀測的決策機率,把條件錯誤寫成線性式。
- 推導程式中兩方向 D-optimal 與 A-optimal 權重,再說明小量測預算取整後為何需要重新檢查。
提示
對純量準則微分;檢查每個取整方向是否有量測。
參考文獻
-
Stephen Boyd and Lieven Vandenberghe, Convex Optimization, Cambridge University Press, 2004. 閱讀:第 6 章第 6.1–6.5 節;第 7 章第 7.1–7.5 節。 官方書頁,免費 PDF。
-
SciPy developers, “scipy.optimize.minimize” and “scipy.optimize.minimize_scalar,” SciPy API documentation, accessed 2026. 多變數介面,純量介面。
-
SciPy developers, “scipy.optimize.linprog,” SciPy API documentation, accessed 2026. 官方文件。
-
Sebastian Pokutta, “The Frank-Wolfe Algorithm: A Short Introduction,” Jahresbericht der Deutschen Mathematiker-Vereinigung, 126, 2024. 開放綜述。
-
Michael Schaller, Alberto Bemporad and Stephen Boyd, “Learning Parametric Convex Functions,” manuscript, 2025. 官方手稿頁。
-
SAS Institute, “Existence of Maximum Likelihood Estimates,” SAS/STAT 12.1 User’s Guide, 查閱日期:2026-11-05。官方文件.
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 OPT 06・梯度下降、牛頓步驟與數值可靠性 · 16 分鐘