OPT 03・線性、二次、錐與幾何規劃
先備知識:OPT 02・凸函數、組合規則與共軛
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 辨認線性、二次與凸二次限制問題。
- 精確改寫絕對值、最大值與範數限制。
- 以正確矩陣順序表達二階錐與半正定限制。
- 對正變數取對數,把幾何規劃轉成凸問題。
- 區分精確改寫、凸鬆弛與近似。
- 選求解器前,說明尺度、可行檢查與多目標權衡。
先看全貌
模型可能凸,寫法卻把凸性藏起來。絕對殘差和看似非平滑,加入輔助變數就成為線性規劃;範數界變成錐限制;正變數設計可在對數座標下凸。
Boyd 與 Vandenberghe 第 4 章 [1] 整理這些問題家族,提供可重用模式,也幫助選擇利用結構的數值方法。類型由方程式與定義域決定,不由應用名稱決定。
本章用合成小問題展示精確數學關係與數值檢查,不是 benchmark。程式使用既有數值函式庫,不新增建模系統依賴。
凸標準形式
白話版。 目標、不等式與等式必須一起符合條件,只看目標凸不夠。
是決策向量; 在共同有效定義域凸; 是固定等式係數與目標。凸下水平集合與仿射集合相交,得到凸可行集合。
凹函數可放另一側: 凹時, 等價於凸不等式 。非線性凸函數等號通常不凸; 是球面, 才是凸球。
把等式拆成兩個不等式也不能修好,因為其中一側翻轉曲率。若物理問題真的要求球面,改成球就是鬆弛,可能改變答案。
精確改寫與改變問題
精確改寫在消去輔助變數或反轉一對一變換後,保留原決策與目標。鬆弛擴大允許集合,近似則修改函數或限制。
最小化 且 精確,因為目標偏好最小允許 。但把相同不等式放進別的模型,若目標不偏好較小 ,未必達到等號。
增加變數時應證明兩方向:原可行點可延伸成新可行點,新點也映回原可行決策,且目標關係正確。
線性規劃
白話版。 線性規劃的成本與規則都是直線,可行多面體具有角、面與可能延伸至無限的方向。
是固定成本向量, 定義不等式, 定義等式。座標界可另列或加入 。
線性目標同時凸與凹,解未必唯一;若平行某可行面,整個面都可能最佳。
非負標準形式為 。加入非負 slack 將不等式轉成等式,自由純量可拆成兩個非負純量差。
這些改寫精確,但會增大問題與改變 conditioning。求解器若直接支援界與不等式,就不必為了形式手動展開。
絕對殘差變成線性限制
是固定設計矩陣, 是係數, 是量測。每個殘差加入 :
限制殘差幅度, 是全一向量。可行 不小於絕對殘差,目標加總使界緊。成對不等式已推得非負,也可明列。
Minimax 只加一個純量 ,限制 並最小化 ,控制最大絕對殘差,與總和代表不同偏好。
程式碼:小型配置 LP
SciPy 介面見 [2]。先檢查狀態,再獨立檢查可行性。
程式碼 · Python · 14 行
import numpy as np
from scipy.optimize import linprog

c = np.array([-3.0, -2.0])
G = np.array([[1.0, 1.0], [2.0, 1.0]])
h = np.array([4.0, 5.0])
result = linprog(c, A_ub=G, b_ub=h, bounds=[(0, None), (0, None)])
assert result.success, result.message
x = result.x
assert np.all(G @ x <= h + 1e-8)
assert np.all(x >= -1e-8)
assert np.allclose(x, [1, 3], atol=1e-7)
print("allocation:", x, "objective:", c @ x)
print("slacks:", h - G @ x)
負成本把最大化正收益轉為最小化。容量限制使非負選擇有界;移除關鍵界可能無界,是建模結果而非求解器缺陷。
二次規劃與凸 QCQP
白話版。 二次規劃把直線成本換成碗狀成本,規則仍線性。向上彎的二次限制也能加入。
凸 QP 目標為
對稱半正定, 是線性係數, 是不影響最佳解的常數,限制為仿射。
最小平方展開後 。二次正則化加正對角曲率。設計矩陣 rank 不足時,未正則化解未必唯一。
凸 QCQP 允許
是限制曲率, 是線性係數, 是偏移。任意二次限制不保證凸;不定二次限制即使搭配強凸目標,也可能非凸。
數值結構很重要
無限制正定 QP 解 。受限最佳點可能在邊界,不能通常先解無限制再裁切。
一般二次函數耦合座標,調一個座標會改變其他座標最佳值。只有特定幾何,如普通二範數的盒投影,逐座標裁切才正確。
大小與稀疏性影響計算。明算 可能破壞稀疏性與放大病態,實作可保留殘差算子。演算法章會討論分解與矩陣向量乘法。
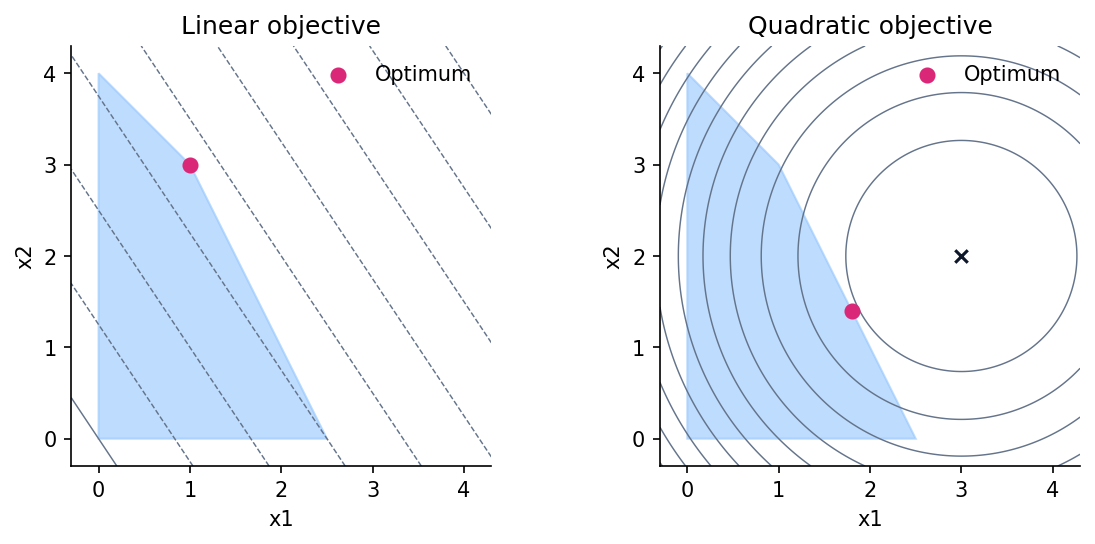
反例算解:為什麼 QP 不能直接裁切
耦合曲率讓一個座標改變時,另一個座標的最佳值也跟著移動。考慮凸二次函數
其中 是變數、 是無限制目標、 是正定曲率矩陣。直接裁切 得到 ,目標值為一。但固定 後,不受限制的第二座標之駐點條件給出 ,因此 。
候選點 的目標值為 ,梯度為 ,由 的乘子 平衡。可行性、乘子符號、駐點條件與互補鬆弛因此透過 OPT 04 的條件驗證最佳解。座標裁切忽略了 的非對角元素;歐氏盒投影之所以可裁切,是因為其二次函數可按座標分離。
二階錐規劃
白話版。 二階錐以範數小於純量表示弧形限制,形成標準幾何形式。
定義範數中的向量, 定義仿射純量界, 是決策。右側自動必須非負。
不能直接平方後漏掉右側正負條件,否則可能新增右側負值的點。錐表示正確保留正負。
常見 rotated second-order cone 要求 。係數二是慣例,需配合介面。令 ,即可表達平方殘差不超過 。
不同縮放數學等價,數值行為卻可能不同。
Robust 線性限制
係數不確定時,令 。要求所有允許 都滿足 ,等價於
是名義係數, 映射球狀不確定性, 是固定界。範數來自單位球上 的最大值。
此為指定不確定集合的精確 robust counterpart,不保護集合以外所有實際擾動。集合較大可能保守,集合不合理可能漏掉重要變異。
盒狀不確定性導向一範數項,橢球導向轉換後二範數,連到上一章的 support function [1]。
推導穩健對應式,而不是猜測懲罰
穩健範數項是容許擾動的精確最壞結果。展開不確定線性限制:
其中 是決策、 是名目係數、 是不確定性映射、 是容許擾動。最後的等號來自內積範數上界;分母非零時, 可取等號。分母為零時,所有擾動的貢獻都為零。
對合成限制 ,其中 ,精確穩健規則為 。在 ,左側最壞值為 ,因此穩健可行。最大化擾動與 成比例。這裡沒有憑空選調整權重;新增項直接來自所指定的不確定性幾何 [1]。
半正定規劃
白話版。 SDP 限制完整矩陣在每個向量方向都非負,不能只檢查元素。
是固定對稱矩陣, 是決策純量, 必須半正定。搭配線性目標與仿射等式得到 SDP。
若矩陣全對角,退化為線性不等式;一般矩陣則編碼元素之間的關係。
是 off-diagonal correlation,此矩陣半正定若且唯若 。負元素可允許,過大正元素反而不定。
Schur complement 揭露結構
正定 下:
是對稱正定區塊, 是向量, 是純量。右側是 Schur complement。奇異 還需要 range 條件或廣義論證。
區塊對決策仿射時,可把部分反矩陣式轉成矩陣限制。凸性依賴仿射結構,不是只要寫成區塊矩陣就成立。
用配方證明 Schur 條件
區塊矩陣半正定,代表其二次型對每個向量都非負。對 、向量 與純量 ,
其中 是正定區塊、 是相容向量、 是純量區塊、 是任意測試座標。若 ,兩項都非負。反過來,選 、,第一項消失,強制該純量不等式成立。如此證明等價性的兩個方向 [1]。
它也是建模方式。固定 且 為仿射向量時,上界 可化成對 仿射的矩陣不等式。若 是矩陣決策變數,在正定定義域上,同樣的區塊表示仍可對其元素仿射。因此原反矩陣式雖把結構藏起來,非線性項仍可能具有凸上圖集合。
假設 才能配方並使用反矩陣。 奇異時不能默默沿用同一公式;向量的值域條件會成為等價性的一部分。
程式碼:矩陣順序不是逐元素順序
此例檢查已知特徵值,並驗證 Schur 邊界。
程式碼 · Python · 13 行
import numpy as np

for r in [-0.8, 0.8, 1.2]:
    X = np.array([[1., r], [r, 1.]])
    eigenvalues = np.linalg.eigvalsh(X)
    print("r:", r, "eigenvalues:", eigenvalues)
    assert (eigenvalues.min() >= -1e-12) == (abs(r) <= 1)
P = np.array([[2., .3], [.3, 1.]])
q = np.array([.4, -.2])
t = q @ np.linalg.solve(P, q)
block = np.block([[P, q[:, None]], [q[None, :], np.array([[t]])]])
assert np.linalg.eigvalsh(block).min() >= -1e-12
print("Schur boundary t:", t)
這是 spectral 檢查,不是完整 SDP 求解器。小型直接計算說明模型,不暗示通用非線性 optimizer 提供專用錐方法的全部證書。
幾何規劃
白話版。 正變數模型在原座標可能非凸,取對數使乘法變加法後,卻可能凸。
Geometric programming 的 monomial:
正, 可為任意實數,不同於基礎代數中的非負整數指數慣例。
Posynomial 是 monomial 加總:
是項數, 正, 是指數,不能有負係數。
GP 最小化 posynomial,限制 posynomial 不超過一、monomial 等於一,且變數正 [1,第 4.5 節]。任意加總、正負或等式不屬於此類。
推導對數轉換
令 ,則 。Monomial 的對數仿射,posynomial 的對數:
是第 項指數向量,右側為仿射式的 log-sum-exp,因此凸。
對數嚴格遞增,所以原目標與 log 目標有相同最佳選擇;回轉變數即可。Posynomial 不等式轉為凸不等式,monomial 等式轉為仿射等式。
目標數值已改變,報告應用成本時要轉回。這是正定義域的一對一變換;刪負項或把非 monomial 等式改不等式,則可能改變問題。
程式碼:對數座標的正配置
最小化 ,且 。對稱性與凸目標給 ,以下數值驗證。
程式碼 · Python · 17 行
import numpy as np
from scipy.optimize import minimize
from scipy.special import logsumexp

objective = lambda z: logsumexp(-z)
constraint = {"type": "ineq",
              "fun": lambda z: np.log(4.) - logsumexp(z)}
result = minimize(objective, np.log([1., 1.]),
                  constraints=[constraint], method="SLSQP",
                  options={"ftol": 1e-12, "maxiter": 100})
assert result.success, result.message
x = np.exp(result.x)
assert x.sum() <= 4 + 1e-7
assert np.allclose(x, [2., 2.], atol=1e-5)
print("positive variables:", x)
print("original objective:", np.sum(1 / x))
print("transformed objective:", result.fun)
介面見 [3]。這個小例與解析解比較,不宣稱通用方法在所有尺度可替代專用 GP 求解器。
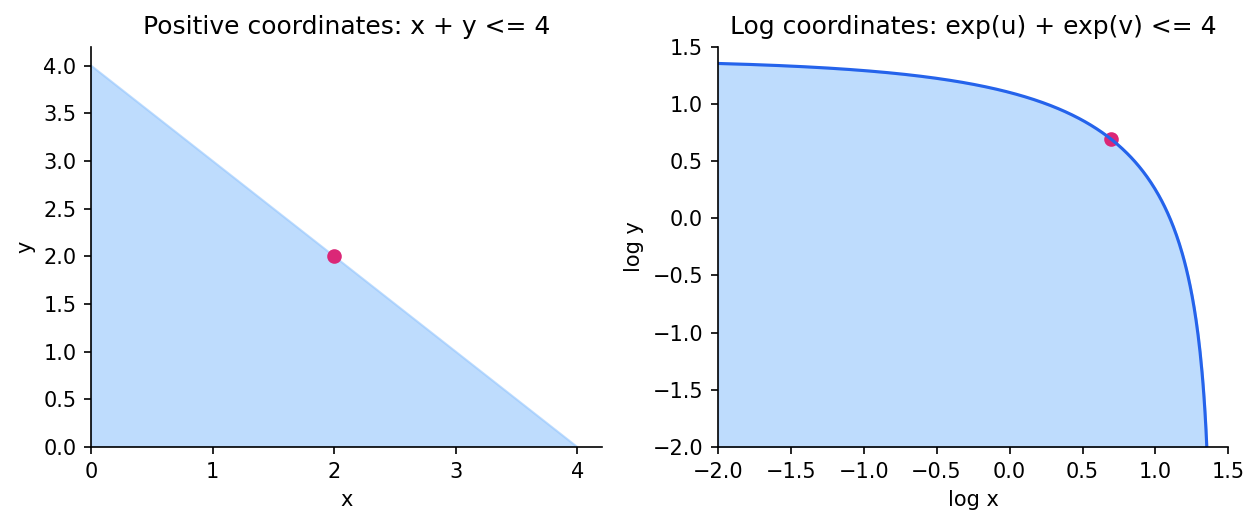
設計算例:非對稱的正配置
即使不能靠對稱性找到答案,對數轉換仍保留最佳解。在 、 下最小化 。兩項都隨其變數增大而下降,因此最佳解會用完預算。
令 。微分剩下的純量目標,得到
其中 是正配置量,星號表示最佳解。在 上二階導數為正,所以駐點是唯一最小解,原成本為 。
換成對數變數 、,目標變為 ,限制變為 ,兩者都是 log-sum-exp。轉換後解為 ,轉換成本為 。若把 回報成原成本,就混淆兩套座標。這個例子提供整個轉換的解析檢查 [1,第 4.5 節]。
以可行性求解擬凸問題
白話版。 有些目標非凸,但「此分數能否達到」是凸可行問題。反覆詢問門檻,可找到最佳分數。
若 對每個固定門檻 都能用凸限制描述,可維持最佳分數上下界,檢查中間門檻:可行就降低上界,不可行就提高下界。
每個子問題的門檻是固定資料。若把它也當自由變數,可能產生非凸乘積;各子問題凸,不代表門檻與決策共同凸。
例如正分母下的仿射比值 ,固定 時限制變成 ,對 仿射。分母嚴格正是必要條件。
接近最佳門檻時,可行區域可能很窄。近似求解失敗不等於不可行證書,需適當可行程序,報告門檻區間與容忍值。[1] 的擬凸討論擴展非凸目標,但保證仍精確限於凸子問題與外層二分。
求解前的建模稽核
逐條把原需求轉成變數,檢查定義域、正負號、單位,並追蹤輔助變數消去方式。
範數的輔助上界若不在目標中,可能保持鬆;若只要求限制,仍可正確,但不可直接當成實際範數。應自行計算真正範數。
Lifted 矩陣半正定凸,但要求等於向量外積會引入 rank 限制。刪除此限制是鬆弛,矩陣可能提供下界卻沒有對應原向量。
也要檢查邊界。GP 變數不能任意設零,log-determinant 矩陣不能在有限目標下奇異。允許這些點的改寫,需要明確延伸論證。
這些是數學驗證。求解器可能正確最佳化錯誤鬆弛或錯誤正負的模型;與小型解析案例比較,能檢查從文字到陣列再到解釋的整條流程。
多目標與 Pareto 權衡
白話版。 兩目標衝突時,最佳化不會替你決定偏好;它提供指定偏好下的答案與權衡。
中, 是目標數。若沒有其他可行點能改善一項而不傷害其他項,則為 Pareto 最佳。
編碼偏好與單位;達到的最佳解是 Pareto 最佳。零權重可忽略某項,只提供較弱效率敘述。
也可最小化一項,限制其他項不超過指定值。例如在固定記憶體預算下最小化重建誤差,比虛構 bytes 到誤差的通用換算更自然。
Scalarization 仍需符合凸規則。變動權重得到的是此模型的權衡曲線,不涵蓋被排除的離散選擇或上游系統行為。
建模與數值檢查
白話版。 文字公式與實際陣列必須描述相同決策,微小錯誤可能悄悄改變限制。
檢查變數預設界。有的介面預設非負,有的自由;忽略預設可把原本自由迴歸係數變成非負。
檢查不等式方向。數學 與介面 可能同時出現,必須刻意翻譯。
檢查形狀與對稱。非對稱陣列不符合對稱半正定記號;broadcasting 可能把純量限制變成不同向量限制。
縮放需保留與原變數的關係,解與殘差都應轉回原單位檢查。轉換形式與原形式都驗證。
狀態與證書也分開。小例有解析答案時,通用求解器成功提供數值支持;正式凸模型還應依類型檢查原始可行、對偶可行與 gap。
求解器轉換後,寫出的模型仍應可以審閱。應在同一份回報保留變數單位、定義域限制、轉換與所有鬆弛。若回傳轉換解,先映回原座標,再檢查物理限制與應用目標。
對數座標、輔助上圖變數與提升矩陣模型尤其需要這樣做。沒有映射的轉換可行點可能被誤解;若定義限制未準確滿足,輔助目標也可能與原表示式不同。
現代觀點
白話版。 標準類型仍適用現代研究,新實作常利用結構改善成本,而非改變數學類型。
Disciplined convex programming [4] 透過曲率與單調性規則,將高層描述精確轉成標準形式。先讓凸性論證明確,再選求解器。
PDLP [5] 於 2025 公開、2026 修訂,以實用一階原始—對偶方法處理大型 LP,加入 preconditioning、restart 與可行修整。結論針對測試問題與精度,並非所有 LP 的通用冠軍。
Schaller、Bemporad 與 Boyd [6] 擬合符合 disciplined programming 的參數化凸函數,讓學習式目標或限制進入凸建模流程,但須維持有效參數與決策變數凸性。
開放問題包括減少不必要展開、利用錐稀疏性、尺度下可靠證明不可行,以及 active-set 變化附近的微分。凸類型是分析基礎,完整系統仍需資料、容忍值與工程驗證。
重點整理
- 凸標準形式需要凸目標與不等式、仿射等式。
- 輔助變數的精確性應證明兩方向。
- LP、QP、SOCP 與 SDP 編碼不同幾何。
- 矩陣順序不同於逐座標順序。
- GP 要求正變數與受限 monomial/posynomial。
- 多目標需要明確偏好或界限。
- 狀態、原變數可行性與最佳證書應分別檢查。
練習
- 將 minimax 絕對殘差擬合改為 LP,證明等價。
提示
一個純量界限制所有正負殘差。
- 範數右側可能負時,為何平方會新增點?
提示
範數非負。
- 推導二乘二、對角一的半正定矩陣中 範圍。
提示
特徵值 。
- 把 且 轉為 log 座標,再回復原目標。
提示
代入指數並對正式取 log。
- 提出凸函數的非凸等號水平集合。
提示
正水平的平方範數。
- 比較誤差—成本加權和,與固定成本限制下最小誤差的含意。
提示
一個是交換率,另一個是硬承諾。
參考文獻
- Stephen Boyd and Lieven Vandenberghe, Convex Optimization, Cambridge University Press, 2004。閱讀:第 4 章,特別 4.3–4.7;第 6.1 節範數擬合。官方書籍、免費 PDF。
- SciPy developers, “linprog,” SciPy API documentation, accessed 2026。已驗證介面。
- SciPy developers, “minimize,” SciPy API documentation, accessed 2026。最佳化介面。
- Michael Grant, Stephen Boyd and Yinyu Ye, “Disciplined Convex Programming,” in Global Optimization: From Theory to Implementation, Springer, 2006。作者出版頁。
- David Applegate, Mateo Díaz, Oliver Hinder, Haihao Lu, Miles Lubin, Brendan O’Donoghue and Warren Schudy, “PDLP: A Practical First-Order Method for Large-Scale Linear Programming,” arXiv preprint, 2025,2026 修訂。論文記錄。
- Michael Schaller, Alberto Bemporad and Stephen Boyd, “Learning Parametric Convex Functions,” manuscript, June 2025。已驗證稿件。
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 OPT 04・對偶性、KKT 條件與證明憑證 · 16 分鐘