OPT 06・梯度下降、牛頓步驟與數值可靠性
先備知識:OPT 05・近似、統計估計與實驗設計
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
最佳化
你將學到
- 區分搜尋方向與沿方向選擇的步長。
- 在 Lipschitz 梯度假設下推導安全梯度步驟。
- 實作具有定義域與迭代保護的 Armijo 回溯。
- 解釋條件數、依範數而異的最陡下降,以及牛頓曲率。
- 解讀牛頓減量與快速局部收斂背後的假設。
- 以 CPU 例子驗證導數、線性求解與停止證據。
先看全貌
凸性告訴我們哪些答案為全域最佳;演算法則告訴我們,如何利用可計算資訊逐步靠近答案。兩者互補:凸問題仍可能尺度不良、昂貴或數值敏感。
Boyd 與 Vandenberghe 的第 9 章 [1] 發展無限制下降方法、梯度下降、最陡下降、牛頓方法、自協調性與實作。本章依這個順序前進,同時保留每步成本與停止判準的意義。
例子求解確定性的凸目標。不能把保證悄悄轉移到神經網路的非凸訓練目標、含雜訊導數或非光滑懲罰。實用想法可能能轉移,但證明假設需要重新檢查。
我們先用有精確解的二次函數,再從頭實作平滑正則化邏輯斯目標。兩者使用本機生成資料,在 CPU 執行,除 NumPy 外不需要求解器套件。
一個方向與一段距離
白話說。 下降迭代先選往哪裡指,再選走多遠。太早把兩者混在一起,會隱藏步驟為何安全。
迭代寫成
是目前決策向量, 是搜尋方向, 是步長。對可微目標 ,嚴格下降方向滿足 。
此內積是零步長處的方向導數。可微性表示,在目前點周圍的開放定義域,足夠小的正步長會降低目標,並保留定義域。大步長仍可能提高目標或離開定義域。
方向可能依賴梯度、Hessian、度量或其他結構;線搜尋評估候選距離。只計算接受的迭代,會隱藏許多拒絕的目標評估。
若可微凸函數在開凸定義域的梯度為零,支撐平面不等式就能證明全域最小化解。有約束時,零無限制梯度通常不是正確最佳性條件;下一章會用受限制系統。
精確與非精確線搜尋
精確線搜尋會在允許的正距離上最小化 。這個輔助一維問題可能昂貴,也可能不必要。
非精確搜尋接受足夠下降,不精確求解線問題。它也應保留目標定義域。對數項的引數無效時,候選點只是未通過定義域檢查,不是提供了目標證據。
浮點數又帶來另一個區別:數學上下降的步驟,在機器精度下可能與目前值無法區分。不斷縮小到比較偶然通過,不是穩健停止規則。
梯度下降與假設
白話說。 梯度下降往梯度反方向走。曲率上界告訴我們,固定步長必須多小。
更新為
是步長。假設相關區域的梯度具有 Lipschitz 常數 :
是連接線段留在該區域的點。 衡量梯度改變多快,不是正則化係數,也不是損失值。
平滑性不等式為
是嘗試的位移。代入 得到
因此,假設與定義域要求成立時, 步長會下降。對二次可微目標,Hessian 最大特徵值上界可以建立此 [1,第 9.3 節]。
只有凸性與平滑性時,標準固定步長分析通常給次線性目標收斂。強凸性加入正的曲率下界,讓線性幾何收斂成為可能。這些字描述數學速率,不保證每個實作都很快。
從單步下降到收斂速率
下降證明目標改善;收斂速率量化達到指定誤差需要多少工作。設 上的可微凸函數具有 -Lipschitz 梯度,而且最小解 存在。使用 。梯度支撐下界給出
其中 是目前點、 是下一迭代點、 是任意最小解。展開更新後的平方距離:
所有符號保留上述定義。把第一個不等式與前面的平滑下降界結合,得到
對前 次更新加總,中間距離逐項抵消。因為目標值下降,最後誤差不大於這 個誤差的平均:
其中 是起點、 是 次更新後的點。這就是 目標速率的具體意思:依此界把保證誤差減半,通常要把迭代次數加倍。它是這些假設下的最壞情況保證,不是所有實測軌跡都如此 [1]。
強凸性與停止上界
若 是 強凸,支撐模型加入 。最小化此下模型得到
是全域最小值, 是有效強凸常數。小梯度因此給出單位明確的目標間隙上界。
沒有驗證正 時,同一公式不是憑證。很平坦的目標可能同時有小梯度與很大的解距離;小參數更新也可能只是步長過小。
不要只因數次印出的目標值看似相同就停止。應檢查適當殘差、模型尺度、進度趨勢,以及迭代或時間限制。
條件數改變路徑
白話說。 拉長的碗有陡方向與平方向。對陡方向安全的步長,可能讓平方向進展非常慢。
正定二次函數為
對稱正定, 固定。Hessian 就是 ,最小和最大特徵值給 與 。
比例 描述歐幾里得曲率條件數。比例很大時,單一純量步長要照顧非常不同的方向尺度。因此,座標單位會大幅改變梯度下降行為。
標準化變數或選適當度量可以改善路徑,但限制、係數與停止範數都要一致轉換。不能用未轉換的參數距離閾值,公平評估縮放後演算法。
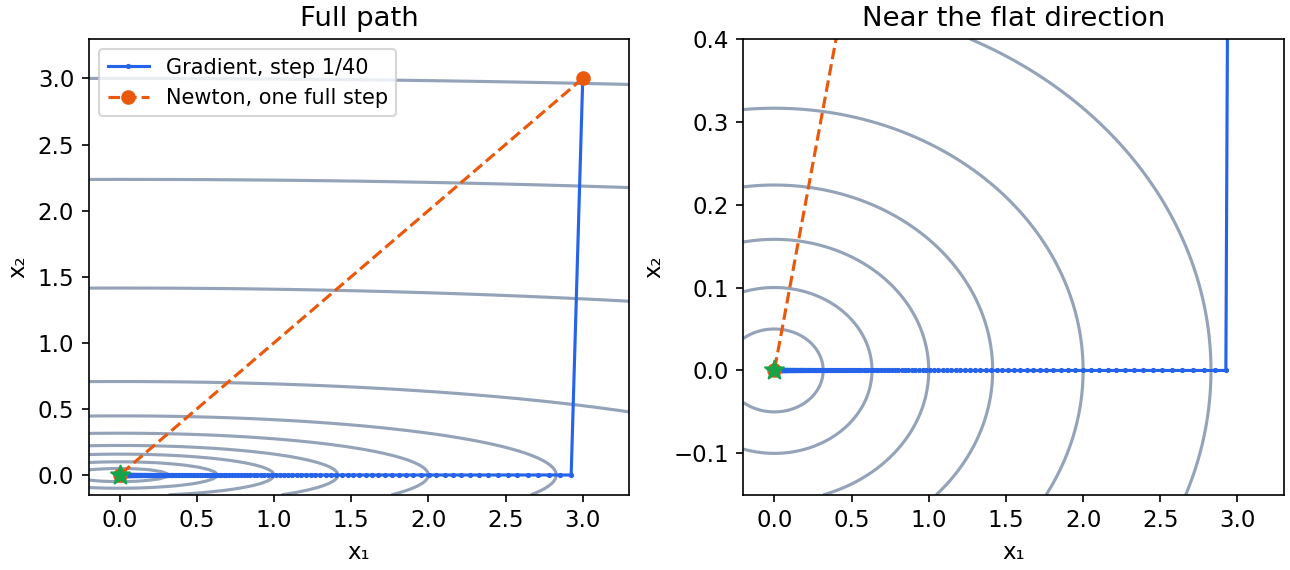
程式:比較固定梯度步與牛頓步
目標在零最小。我們比較目標下降,並驗證牛頓線性系統,不使用明確反矩陣。
程式碼 · Python · 16 行
import numpy as np

Q = np.diag([1., 40.])
x = np.array([3., 3.])
start = x.copy()
values = [0.5*x @ Q @ x]
for _ in range(200):
    x = x - (Q @ x)/40
    values.append(0.5*x @ Q @ x)
direction = np.linalg.solve(Q, -(Q @ start))
newton = start + direction
assert np.all(np.diff(values) <= 1e-12)
assert np.allclose(Q @ direction + Q @ start, 0)
assert np.linalg.norm(newton) < 1e-12
print("gradient objective after 200 steps:", round(values[-1], 8))
print("Newton objective after one step:", 0.5*newton @ Q @ newton)
一步牛頓解,是精確正定二次函數與準確線性求解的特殊結果。一般平滑函數移動時曲率會變,完整一步可能失敗。
逐特徵向量讀懂二次路徑
二次函數能精確呈現步長影響。對曲率為 的正定二次函數,令 為誤差。梯度下降給出 。在 的特徵值為 的特徵向量方向上,誤差係數乘以 。
其中 是固定步長、 是單位矩陣、 是方向曲率。所有係數收縮的充分必要條件為 ,其中 是最大特徵值。若 ,即使目標凸,最陡方向的誤差量值仍會增大。
對本章的 與 ,陡座標在一次更新後消失,平坦座標則每次乘以 。從 開始, 次更新後第一座標誤差為 。緩慢路徑是方向曲率的結果,而非隨機數值失敗。
對最小特徵值為 的二次函數,取 可平衡極端收縮因子的量值,其最壞值為 。相較保守步長,這能改善上界,但需要已知頻譜端點,不能取代任意非二次函數的線搜尋 [1]。
Armijo 回溯
白話說。 從候選距離開始,縮小到相對局部斜率有足夠下降。
足夠下降條件為
是下降方向, 是測試距離, 是固定下降比例。回溯反覆把 乘上 ,直到定義域與下降測試通過 [1,第 9.2 節]。
牛頓方法常選 ,讓標準局部分析下,正則最佳點附近能接受完整步。這是考慮假設的選擇,不是通用最佳參數。
實作需要最多試驗次數、最小有意義步長、有限值檢查,以及清楚失敗回報。否則無效方向或錯誤梯度,可能導致無限縮小迴圈。
拒絕步驟告訴我們什麼
拒絕可能表示初始距離太大、遠離解時曲率模型不準、跨越定義域或導數錯誤。單次拒絕本身不能分辨原因。
先檢查方向導數。若非負,一般下降回溯就沒有原本的正當性。可能需要修改方向,也可能候選點已滿足最佳性測試。
最佳點附近反覆拒絕,可能來自浮點抵消。要求低於可表示精度的改善以前,應比較目標與導數尺度。停止時應說明符合哪個數值條件。
最陡下降依賴範數
白話說。 「最陡」需要定義一單位移動。不同範數會選出不同方向。
正規化最陡方向求解
是方向, 是選定移動範數, 是目前點。歐幾里得範數下,非零梯度給方向 。
對正定度量矩陣 ,定義 。相應未正規化下降方向是
決定方向成本。方向導數為 ,梯度非零時嚴格為負。
選擇 類似預條件化:納入已知尺度或曲率,不一定建立真正 Hessian。好處取決於度量系統求解多便宜,以及它多能代表問題。
採座標型移動範數時,最陡方向可能選單一座標,或以不同方式分配移動。書中 [1,第 9.4 節] 說明,最陡下降是一族方法,不是單一與座標無關的程序。
牛頓的局部二次模型
白話說。 牛頓以二次函數近似目標,再求該近似的最小化解。
目前點的模型為
是位移, 是梯度, 是 Hessian。若 正定,模型唯一最小化位移滿足
這就是牛頓方向。以線性求解或分解計算,不要建立反矩陣。正定性保證 時有下降方向。
凸性只給半正定 Hessian,仍可能奇異。因此,完整牛頓步不會自動有定義。正則化 Hessian、受限子空間或其他方向可能合適,但每項都會改變指定數值程序。
牛頓減量
定義
是牛頓減量(Newton decrement),假設 正定。二次模型預測,最佳步驟會下降 。
對精確二次函數,預測等於目標間隙。對一般函數,它是局部模型量;嚴格間隙解釋需要額外假設。不要把預測下降標成無條件全域誤差憑證。
導數與求解精確時,在可逆仿射座標轉換下,方向與減量會一致轉換。這是牛頓與歐幾里得梯度下降不同的一個原因,但浮點條件數與實作仍重要。
局部收斂有條件
在適當平滑性、最小化點附近非奇異正定 Hessian,以及合適線搜尋下,牛頓最終會接受完整步,並可二次收斂 [1,第 9.5 節]。
二次收斂表示,在足夠小鄰域中,誤差約以先前誤差平方縮小。它不表示任何初始點的前幾步都如此。
梯度、Hessian 與線性求解誤差可能限制速率。遠離解時,保護措施可能必要;接近解時,要求低於導數準確度的殘差,可能浪費計算或引發誤導的失敗。
牛頓法為什麼尊重座標轉換
牛頓法利用曲率調整方向,所以改變變數單位不會改變其理想的實際步驟。令 ,其中 可逆、 為固定位移,定義 。在對應點,鏈鎖律給出
其中 是 座標下的梯度與正定 Hessian,波浪號表示 座標下的對應導數。轉換後的牛頓方程為
其中 是新座標的位移。線性解唯一,因此 ,等於原牛頓位移。預測下降量也不變:。
普通梯度下降的轉換步驟映回後,卻是 ,通常不同於 。這連起座標縮放與最陡下降中的度量。牛頓不變性假設精確導數與求解;條件數不良的座標轉換仍可能傷害浮點實作 [1,第 9.5 節]。
自協調性與受控曲率
白話說。 某些凸函數透過本身局部曲率,控制曲率改變速度,提供分析牛頓步的特殊途徑。
標準一維自協調函數滿足
是純量輸入,撇號表示導數,二階導數非負。多維時,沿定義域中的直線套用此條件 [1,第 9.6 節]。
上的對數障礙 滿足這個純量關係,連結無限制牛頓分析與下一章內點方法。
自協調性比一般平滑凸性更具體。它允許局部範數控制變動,不必只靠單一全域歐幾里得 Hessian-Lipschitz 常數。理論包含精確的減量區域與複雜度陳述;它們需要正確正規化與障礙假設。
包含對數的函數,不會自動成為每種限制表示的有效障礙。定義域、邊界行為與縮放都要符合問題。即使兩者都有對數,也應區分平滑概似項與限制障礙。
穩定的凸邏輯斯求解器
白話說。 完整實作應穩定評估目標、驗證導數,並以最佳性量停止。
對固定列 與二元結果 ,使用
是參數向量, 是觀測數, 是正則化係數。本例正則化每個座標。固定設計邏輯斯概似,遵循 [1,第 7 章] 的凸估計推理。
令 ,導數為
堆疊量測列, 是觀測向量, 是單位矩陣。正 提供有效全域強凸常數 。
使用穩定 softplus 評估,不要先算可能溢位的指數再取對數。下列合成分數大小受控,允許直接 sigmoid;對任意極端分數,也應使用數值穩定的 sigmoid 實作。
推導邏輯斯曲率界限
知道曲率常數,能讓穩定目標更容易最佳化。對單一分數 , 的導數為 ,二階導數為 。因此扣除線性項 後,梯度為 ,Hessian 為 。
其中 是固定特徵向量、 是參數向量、 是觀測標籤、 是 sigmoid 機率。對觀測取平均,再加二次懲罰,即得上面列出的導數。因為 ,
其中 是正則化平均邏輯斯目標、 是特徵矩陣、 是觀測數、 是懲罰權重, 是最大奇異值。下界來自所有座標的正則化;上界可對任意方向 檢查 得出。
因此 與 是合法全域常數,能對這個特定模型提供安全梯度步長與目標間隙停止界。若截距不受懲罰,就無法直接推出每個座標都有同樣正下界。數學公式、懲罰實作與停止測試必須一致 [1]。
程式:具有導數與停止檢查的牛頓方法
這是最佳化示範,不是分類基準。求解前先檢查方向導數,最後驗證梯度、下降序列與強凸間隙上界。
程式碼 · Python · 54 行
import numpy as np

rng = np.random.default_rng(16)
A = rng.normal(size=(160, 5))
truth = np.array([0.8, -0.5, 0.3, 0., 0.4])
prob = 1/(1+np.exp(-(A @ truth)))
y = (rng.random(len(A)) < prob).astype(float)
rho = 0.1

def evaluate(w):
    z = A @ w
    p = 1/(1+np.exp(-z))
    value = np.mean(np.logaddexp(0, z)-y*z) + rho*(w @ w)/2
    gradient = A.T @ (p-y)/len(y) + rho*w
    Hessian = (A.T * (p*(1-p))) @ A/len(y) + rho*np.eye(A.shape[1])
    return value, gradient, Hessian

w = np.zeros(A.shape[1])
direction = rng.normal(size=len(w))
eps = 1e-5
finite_difference = (evaluate(w+eps*direction)[0] -
                     evaluate(w-eps*direction)[0])/(2*eps)
assert np.isclose(finite_difference, evaluate(w)[1] @ direction,
                  atol=1e-8)
history = []
for iteration in range(30):
    value, g, H = evaluate(w)
    history.append(value)
    if np.linalg.norm(g) < 1e-9:
        break
    step_direction = np.linalg.solve(H, -g)
    slope = g @ step_direction
    assert slope < 0
    step = 1.0
    for trial in range(50):
        candidate = w + step*step_direction
        candidate_value = evaluate(candidate)[0]
        if np.isfinite(candidate_value) and candidate_value <= value+0.1*step*slope:
            w = candidate
            break
        step *= 0.5
    else:
        raise RuntimeError("backtracking did not accept a step")
else:
    raise RuntimeError("iteration limit reached")

value, g, H = evaluate(w)
assert np.linalg.norm(g) < 1e-9
assert np.all(np.diff(history) <= 1e-12)
assert np.linalg.eigvalsh(H).min() >= rho-1e-12
print("accepted Newton steps:", len(history)-1)
print("objective:", round(value, 8))
print("gradient norm:", np.linalg.norm(g))
print("objective-gap upper bound:", (g @ g)/(2*rho))
導數檢查只測一個方向與一個點,不能證明全部導數正確。修改模型時,應在代表性非零點加入檢查。Hessian 對稱性、特徵值預期與線性求解殘差,提供其他獨立證據。
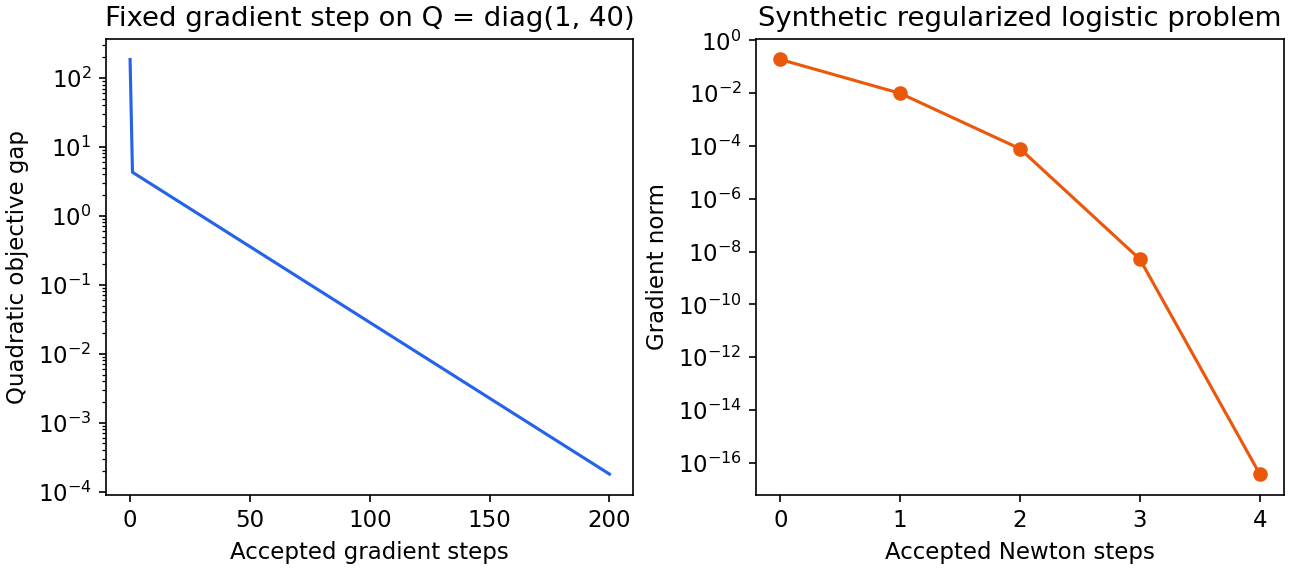
實作與停止回報
白話說。 求解器結果應描述為何停止、驗證什麼,以及做了多少計算。
稠密牛頓儲存的矩陣大小,隨變數數量平方增加,分解可能主導成本。梯度方法常只需矩陣向量乘法,因此很多便宜迭代對大問題有吸引力。
稀疏矩陣、低秩項與區塊結構,可能大幅改變比較。利用結構前,要先確認轉換系統等價,且分解填入量可接受 [1,第 9.7 節與附錄 C]。
Hessian 向量乘積可以支援迭代線性求解,不需儲存完整 Hessian。內層求解也有自身殘差與容許誤差。粗略解出的牛頓系統,不一定重現精確牛頓方向與收斂率。
應回報目標值、適當梯度或駐點殘差、定義域檢查、迭代次數,以及指定停止條件。若時間重要,要計入導數評估與線搜尋嘗試,而不只看接受步數。
縮放目標會改變梯度大小。固定絕對梯度容許誤差,不能在任意損失正規化間直接比較。相對判準需要明確尺度,在零附近也應有意義。
迭代限制是資源停止,不是最佳性憑證;線搜尋失敗是演算法診斷,不是不存在解的證明。應保留最後候選點與殘差證據,讓結果可以評估。
精確二次線搜尋揭露取捨
對前述正定二次函數與非零下降方向 ,線上目標為純量二次函數。對距離微分得到
是目前梯度, 是正定曲率, 是最小化線距離。此公式只對這個特定二次函數給精確線搜尋,不適用於所有平滑目標。
對負梯度方向,分子變成 ,分母為 。距離納入該方向的曲率,可能比保守固定步快,卻不會修正背後拉長的幾何。
連續方向仍可能鋸齒移動。沿一條線精確最小化,不表示線直接指向全域最小值。這清楚區分方向與距離:更好的距離選擇,不能完全取代更好的方向幾何。
牛頓方向使用完整二次曲率系統,在精確算術下以距離一達到最小值。度量近似可能降低系統成本,卻給較不準路線。公平比較須計入度量如何建立與重用,不只看可見路徑長度。
矩陣分解若能對許多右側重用,初始成本就可攤提;若每次迭代矩陣都變,優勢可能縮小。小教材目標評估很便宜,但內含模擬的應用可能很昂貴。宣稱速度前,應說明真正計算原語。
導數檢查需要尺度
中央有限差分把兩個鄰近目標值的差,除以兩倍擾動。縮小擾動,一開始會減少理想截斷誤差,最後卻放大浮點抵消。
應試幾種擾動大小,同時比較相對與絕對差。合理縮放方向、避開定義域邊界,並檢查結果是否在有用區間穩定。一次極小步比較失敗,可能表示數值解析度,而非導數錯誤。
對 Hessian,可比較梯度差與 Hessian 向量乘積。這比只看目標差,測到實作不同層次。目標二次連續可微且預期 Hessian 對稱時,也應檢查對稱性。
自動微分可以減少手動代數,卻仍是對實作表示式微分,而不是對意圖中的模型。錯誤廣播、加總位置不對或意外正則化截距,都可能產生錯誤目標的完全一致導數。
應把檢查與表示法一起記錄。目的是連結符號與陣列,不只是取得通過標記。確認實作符合模型後,數值容許誤差與演算法假設才有意義。
可重現比較也需要起點、目標正規化、停止規則與數值精度。任一項改變,都可能改變表面收斂。合成實驗應保留參數與隨機種子,讓之後的圖能從相同指定問題重新生成。
即使演算法確定性,平台小差異仍可能影響最後幾位數或邊界線搜尋比較。應以有理由的容許誤差驗證性質,不要求完全相同的小數軌跡。本章檢查下降、線性系統一致性與梯度證據,因為它們直接連到表示法。
現代觀點
白話說。 現代凸演算法在曲率資訊、投影、近端運算與通訊成本間取捨。適合的選擇取決於結構與要求精度。
Dvurechensky、Shtern 與 Staudigl 的一階綜述 [2] 提供廣泛基礎,包括非歐幾里得近端方法、加速與免投影方法。它發表於 2021 年,是背景地圖,不是 2026 年新結果。
Condat 等人的 2023 年 SIAM Review 綜述 [3],以原問題與對偶乘積空間和選擇的度量,統一高維非光滑凸問題的近端分裂。它說明加入絕對值懲罰,為何會改變合適計算原語:不能直接讓一般平滑牛頓公式穿過轉折點微分。
Pokutta 的 2024 年 Frank–Wolfe 綜述 [4] 專注受限制集合的線性最小化,以及收斂與憑證結構。它透過詢問能否避開投影或昂貴系統求解,補充梯度與牛頓比較。
這些綜述共同提供實用分類:平滑與非光滑目標、便宜與昂貴可行集合運算、歐幾里得與結構化幾何,以及局部曲率與便宜一階步驟。近期變體不會消除模型差異。
目前議題包括有可靠憑證的自適應方法、大線性系統的精度限制、分散式通訊,以及對求解器輸出微分。應讓演算法符合模型、硬體與要求誤差,並在可比精度下比較總工作量。
重點整理
- 下降方向與步長是兩種不同選擇。
- 固定梯度步需要有效曲率與定義域論證。
- 不良條件數會拖慢純量步長梯度方法。
- 回溯需要保護措施與正確導數符號。
- 牛頓使用線性求解,局部收斂有條件。
- 減量是模型量,除非已建立間隙假設。
- 可靠回報包含停止證據與拒絕工作成本。
練習
- 推導 步長的平滑下降不等式。
提示
把負縮放梯度代入二次上模型。
- 把二次特徵值 40 換成 400,預測並測試固定步長梯度進度如何改變。
提示
平方向收縮取決於特徵值比例。
- 在 上替 實作回溯,每次評估目標前先檢查定義域。
提示
立即拒絕非正候選點。
- 在非零參數向量,以三個隨機方向驗證邏輯斯梯度。
提示
使用幾種有限差分尺度,比較中央差分與內積。
- 說明奇異半正定 Hessian 為何不一定定義唯一牛頓方向。
提示
檢查線性系統零空間與一致性。
- 把邏輯斯目標乘上一百,求如何改變停止量與容許誤差,保留原本要求的目標準確度。
提示
一起轉換梯度、強凸常數與要求間隙。
參考文獻
- Stephen Boyd and Lieven Vandenberghe, Convex Optimization, Cambridge University Press, 2004. 閱讀:第 9 章第 9.1–9.7 節;線性系統背景看附錄 C;邏輯斯概似連結看第 7 章。 官方書頁,免費 PDF。
- Pavel Dvurechensky, Shimrit Shtern and Mathias Staudigl, “First-Order Methods for Convex Optimization,” EURO Journal on Computational Optimization, 9, 100015, 2021. 已核對開放手稿,出版文章。
- Laurent Condat, Daichi Kitahara, Andrés Contreras and Akira Hirabayashi, “Proximal Splitting Algorithms for Convex Optimization: A Tour of Recent Advances, with New Twists,” SIAM Review, 65(2), 375–435, 2023. 出版綜述,開放手稿。
- Sebastian Pokutta, “The Frank-Wolfe Algorithm: A Short Introduction,” Jahresbericht der Deutschen Mathematiker-Vereinigung, 126, 2024. 開放綜述。
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 OPT 07・等式限制與內點法 · 18 分鐘