OPT 08・幾何應用、分裂法與現代方法
先備知識:OPT 07・等式限制與內點法
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
最佳化
你將學到
- 用凸幾何建立距離、中心、分離與配置模型。
- 區分凸應用模型與離散或非凸問題的鬆弛。
- 推導非平滑項與限制的近端更新。
- 實作合成訊號去雜訊的分裂法及單純形上的條件梯度法。
- 依昂貴運算選擇方法,查核相應收斂證據。
- 建立可重現的最佳化專題,連接現代綜述與方法。
先看全貌
問題結構同時告訴你如何建模、如何求解時,凸最佳化就有實際價值。幾何模型可能讓投影簡單;訊號模型可能把平滑資料項與非平滑先驗分開;分散式模型可能讓局部求解便宜,但通訊昂貴。合適的演算法運用這些結構。
幾何閱讀搭配 Boyd 與 Vandenberghe 第 8 章,並連接第 4、6 章的建模與近似 [1]。演算法延伸搭配 Parikh 與 Boyd 的近端綜述 [2]、Boyd 等人的 ADMM 綜述 [3]、Condat 等人的分裂綜述 [4],以及 Pokutta 的條件梯度導論 [5]。本章把這些運算連成完整的建模、求解與驗證流程,作為單元收尾。
全部實驗使用合成資料、在本機 CPU 執行,目的是讓目標、假設、殘差與失敗模式可查核。數值目標降低,只有在可行集合、資料尺度與評估規則都確認後才有意義。
1. 距離、投影與分離
距離問題問兩個點或集合能在各自限制下靠多近。投影找最近的容許點。這些幾何運算是應用與最佳化演算法的共同積木。
對非空閉凸集合 ,定義:
其中 是固定查詢點, 是最佳化變數, 是歐氏範數, 是投影。目標對 嚴格凸,因此最小解唯一;閉性確保能達到最小值,非空則確保有可行點。
盒狀集合投影逐座標裁切到區間;仿射集合投影解受限二次問題;半正定矩陣錐投影涉及對稱矩陣的譜分解。它們都是凸投影,成本卻很不同。「投影梯度」只有在理解投影成本後才是有用的演算法描述。
投影滿足 ,對每個 成立,其中 。從投影指向查詢點的位移,背離所有可行方向。它提供最適性檢查,且當查詢點位於集合外時產生分離超平面。
兩個凸集合的距離可寫成最小化 ,限制為 、,其中 是第二個集合。範數對變數配對凸。但任意無界集合的有限下確界不一定能達到;解讀迭代點是否收斂至最近配對前,先查核存在性。緊緻集合較容易處理。
以分離進行分類也有幾何解釋。線性分數 定義超平面, 是法向量、 是偏移。資料與標籤固定時,間隔限制可以凸;若表示與分類器全部參數共同學習,則可能成為另一個非凸問題。圖形識別單元說明其統計脈絡。
2. 中心、橢球與配置
「中心」有不同意思。最小化到觀測點最大距離的中心,不同於可行區域內最大球的中心;不等式表示的解析中心又是另一個物件。稱一個點為中心前,先說清楚幾何。
對 描述的多面體,最大內接歐氏球的中心 與半徑 由下式求得:
其中 與 是固定資料, 與 是變數。長度至多 的位移在法向量方向上的最壞貢獻為 。法向量固定,因此每條限制對 都仿射。
此中心以歐氏單位平衡與邊界的距離。把不等式乘正數會同時縮放法向量範數與右側,不改變幾何條件。零法向量須另行檢查,其限制不是永遠成立就是不可能;不可直接除以其範數。
橢球允許各方向不同半徑。寫成 ,其中 是對稱正定形狀矩陣, 是中心, 是單位球的輔助座標。包含於半空間的條件變成 ;最大化 對應最大體積,差一個加法常數 [1]。 定義域不可省略。
置中與包圍的限制不同。內接橢球須位於區域內,包圍橢球則須包含指定點;便利的凸參數化也不同。形狀矩陣看似合理,若不小心引入反矩陣與變數乘積,仍可能得到非凸模型。每項變換都要追溯定義域與凸性規則。
配置問題常最小化可移動點與固定錨點的距離總和。連接與限制固定時,歐氏範數給凸目標;選擇哪些連接存在則引入離散變數。矩形的相對次序先選定後,平面配置子問題可能凸;未知不重疊次序包含析取。原實體問題與凸子問題須分開標示。
中心算例:矩形不一定只有一個答案
最大內切球的中心未必唯一。取矩形 、。球的限制化為 與 ,並要求 。
其中 是中心、 是半徑。短邊要求 。最大半徑為一時,所有滿足 的中心 都最佳。問題凸,最佳解卻不唯一。對稱中心 只是有效答案之一,不是模型唯一指定的答案。
對內切橢球,對稱正定 把單位球映成所需形狀。其體積等於單位球體積乘以 ,因為線性映射以行列式縮放體積。因此最大化 保留體積最大解。半空間包含規則來自在 上最大化 ,得到 。這連起 OPT 03 的支撐函數計算與 OPT 02 的矩陣曲率 [1,第 8 章]。
凸形式是在包含限制下最小化 。半空間法向量固定,因此範數項對 凸。讓 奇異會離開有限對數行列式定義域,並使橢球體積塌縮。
3. 鬆弛需要明確的模型解讀
鬆弛(relaxation)擴大可行集合,讓困難問題較容易處理。它能提供有用界限,或產生稍後需取整的候選點。只有應用允許混合、共享或時間分配時,分數解才可執行。
假設二元配置變數 必須在 。改成 ,且其他部分凸時,是離散要求的凸鬆弛。最小化問題擴大可行集合只能降低最適值,因此鬆弛值是原最適值的下界,但不表示鬆弛點是有效的離散決策。
取整後要再次評估原目標與限制。逐座標取整可能違反總預算、連接要求或等式。修復後的可行解提供上界,鬆弛最適值提供下界;兩者差距只有在對應同一原目標,且下方數值是精確鬆弛最適值、有憑證的對偶界或經誤差修正的界時,才有意義。近似的鬆弛原始目標值通常是鬆弛最適值的上界,本身不一定是原離散最適值的下界。
視覺與學習的凸替代模型也一樣。範數懲罰可以鼓勵稀疏,不代表精確解出一般的非零項數最小化問題。凸資料項可能刻意近似物理量測過程。說明模型是統計估計器、計算鬆弛或精確改寫,三種目的支持不同主張。
參數選擇也不在數值憑證內。把正則化問題解得很準,不證明其正則化強度能預測新資料。以正確驗證規則選強度,再於保留資料測試一次。數值最佳化誤差、模型選擇誤差與泛化誤差分開處理。
4. 近端運算處理非平滑結構
非平滑項不必用陡峭平滑函數近似。近端運算(proximal operation)在該項與留在候選點附近之間取捨。許多懲罰與限制有簡單閉式解,適合一階方法 [2]。
對適當、閉、凸函數 ,步幅尺度 ,定義:
其中 是候選點, 是子問題變數, 可取正無窮以表示限制, 控制二次接近項的尺度。在所述條件下,子問題有唯一最小解。
閉凸集合的指示函數之近端運算就是投影。對 、,則是逐座標軟閾值:,其中 是座標索引。它能產生精確零;絕對值懲罰在零點不可微,不能直接用普通梯度下降。
最小化 、且 可微凸時,近端梯度更新為:
其中 是迭代索引, 是平滑梯度, 依方法假設選擇。梯度若為 -Lipschitz,保守固定選擇是 。 限制梯度變化,不是目標值大小。
受限最小平方法變成先梯度再投影;稀疏最小平方法變成先梯度再軟閾值。較複雜的組合,如非平滑函數作用在線性差分算子上,直接近端映射可能昂貴。分裂法引入輔助變數,把便宜運算分開。
有用的殘差是縮放更新 ,其中 稱近端梯度映射。映射為零時滿足凸組合問題的一階最適條件。其大小是收斂診斷,仍須搭配尺度、可行性及能取得時的目標界限解讀。
在轉角推導軟閾值
近端映射精確處理非平滑轉角。對單一座標,在 、 下最小化 。最適條件為
其中 是候選座標、 是輸出、 是絕對值的次微分集合。當 ,次梯度為一,所以 ,只在 時有效。當 ,次梯度為負一,得到 ,只在 時有效。在零點,次微分為 ,因此零恰好在 時最佳 [2]。
三種情況合起來就是閾值公式。對合成向量 與閾值 ,輸出為 。非零輸入能變成精確零,因為零點具有整個區間的支撐斜率。
近端梯度更新來自最小化平滑項的局部上界模型:把 換成 ,保留精確的 。配方後,模型中心變成 。因此平滑成本走梯度步,非平滑成本則做精確小型求解。當 ,平滑性不等式使模型成為上界,解釋了保守步長條件。
5. 把訊號模型拆成簡單子問題
分段常數訊號可以在符合觀測與懲罰相鄰差異之間取捨估計。二次資料項避免修正太大,絕對差懲罰鼓勵許多鄰近值相同。這個凸估計器適合控制去雜訊實驗,其行為與均勻平滑不同。
令 是含雜訊觀測, 計算相鄰差分,求解:
其中 是估計訊號, 是正則化強度。這是近端與分裂文獻的一維總變異正則化 [2–4],描述局部變化,不宣稱所有真實訊號都分段常數。
引入 ,使用交替方向乘子法(alternating direction method of multipliers,ADMM)[3]。縮放形式為:
其中 是懲罰參數, 是單位矩陣, 是縮放對偶變數,shrink 是上述逐座標軟閾值。反矩陣記號只描述數學解,實作使用分解與線性求解。分裂等式在收斂時成立,不必每個中間迭代點都成立。
程式碼 · Python · 28 行
import numpy as np
from scipy.linalg import cho_factor, cho_solve

rng = np.random.default_rng(8)
n = 48
clean = np.r_[np.zeros(16), np.ones(16), np.full(16, 0.3)]
y = clean + rng.normal(0, 0.16, n)
D = np.diff(np.eye(n), axis=0)
lam, rho = 0.4, 4.0
factor = cho_factor(np.eye(n) + rho*D.T @ D)
x, z, u = y.copy(), np.zeros(n-1), np.zeros(n-1)
for k in range(2000):
    x = cho_solve(factor, y + rho*D.T @ (z-u))
    z_old = z.copy()
    v = D @ x + u
    z = np.sign(v) * np.maximum(np.abs(v)-lam/rho, 0)
    u += D @ x-z
    primal = np.linalg.norm(D @ x-z)
    dual = rho*np.linalg.norm(D.T @ (z-z_old))
    if max(primal, dual) < 1e-7:
        break
objective = lambda a: 0.5*np.sum((a-y)**2) + lam*np.abs(D @ a).sum()
print("Iterations and residuals:", k+1, primal, dual)
print("Objectives, raw and estimated:", objective(y), objective(x))
print("Synthetic MSE, raw and estimated:", np.mean((y-clean)**2), np.mean((x-clean)**2))
assert max(primal, dual) < 1e-7
assert objective(x) <= objective(y) + 1e-8
assert np.mean((x-clean)**2) < np.mean((y-clean)**2)
最後一項斷言只查核這個合成例子,不是正則化一定改善重建的定理。太強的正則化可能壓平真邊緣或移除窄峰。目標在模型內選取折衷;乾淨訊號誤差則需要真值,實際部署不一定有。
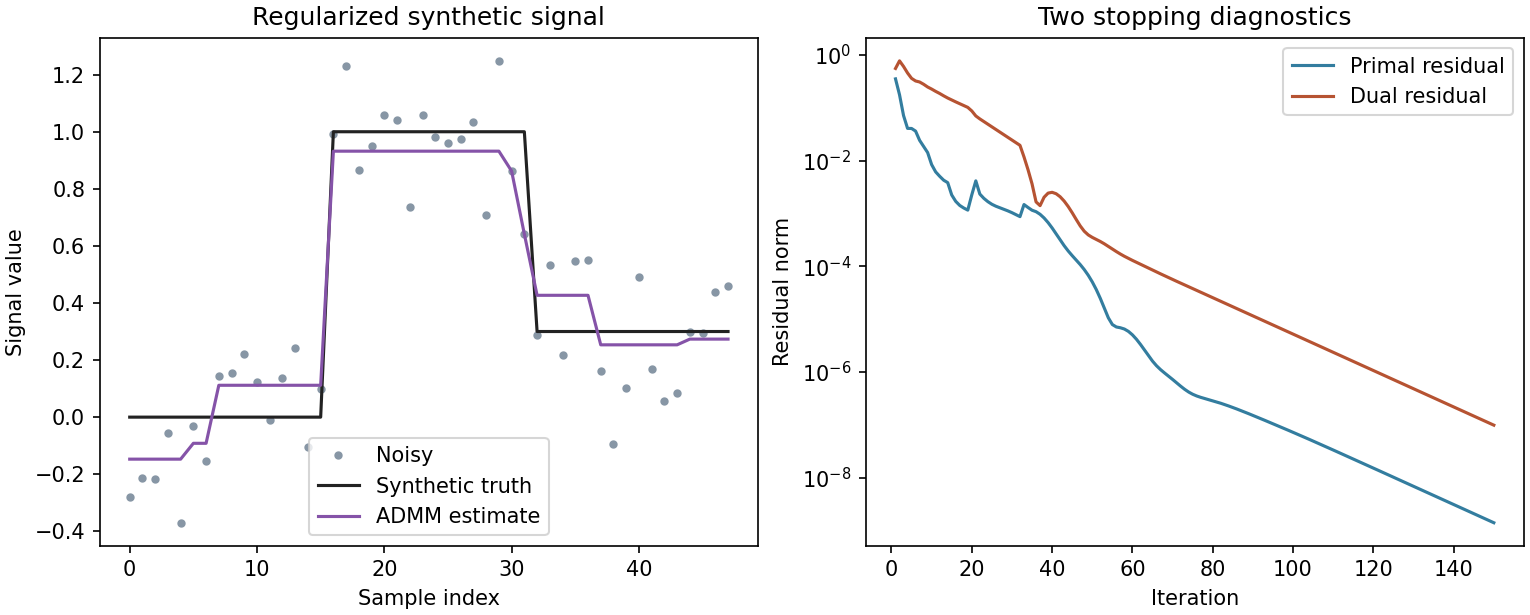
與 固定,所以分解能重用。改正則化強度只改閾值;改 會改線性系統,須重新分解。若改 且保留同一未縮放乘子, 也須一致重縮放,否則更新偷偷改了對偶狀態。
影像中,相鄰差分改成水平與垂直算子,懲罰也有不同合併方式。邊界條件與像素尺度影響估計器。本章一維結果不能當影像復原基準。量測模型請看影像處理,學習式復原比較請看視覺深度學習。
推導拆分更新與殘差
ADMM 方程來自保留明確的差分變數,而不是直接計算困難的組合近端映射。以 建立縮放增廣目標:
其中 是訊號、 是觀測、 是差分矩陣、 是拆分差分、 是縮放乘子、 是懲罰參數。最後一項在原問題子步驟中固定。對 微分得到 。對 最小化就是以 為中心、閾值為 的軟閾值問題。乘子更新接著累積拆分等式誤差 [3]。
為什麼監測兩個殘差?原問題殘差 檢查耦合;對偶殘差 檢查循序更新在駐點條件中留下的不一致。其中 是迭代索引;改變正負號慣例不影響殘差範數。
資料項讓這個特定目標對 強凸,因此即使相鄰差分在非平滑轉角為零,去雜訊訊號仍唯一。殘差說明拆分演算法是否到達該解,卻不量測與未知乾淨訊號的吻合程度。合成實驗因為知道生成訊號,才能同時檢查兩者。
6. 條件梯度使用線性 oracle
投影可能昂貴,但在集合上最小化線性函數可能簡單。條件梯度法以線性最佳化 oracle 和凸組合更新取代投影;可行初始化後,迭代點保持可行 [5]。
對緊緻凸集合 上的可微凸函數 ,求解:
其中 是目前可行點, 是線性 oracle 解, 是步幅權重。新點依凸性可行。Frank–Wolfe 演算法 [5] 就是搭配適當步幅與收斂假設的基本條件梯度構造。
有用的憑證是:
其中 是在 的線性 oracle 解。oracle 精確且目標可微凸時,支撐超平面不等式給 ,其中 是 內最小解。間隙因此限制目前可行點的目標誤差。近似 oracle 需要額外誤差容許量。
在機率單純形 ,線性 oracle 選梯度最小的座標,回傳單純形頂點。混合模型若能便宜選出新成分,此法就有用。每次加入頂點可能形成稀疏迭代表示,但表示與精度折衷仍須檢查。
程式碼 · Python · 28 行
import numpy as np

target = np.array([-0.1, 0.6, 0.5])
def project_simplex(v):
    sorted_v = np.sort(v)[::-1]
    threshold = (np.cumsum(sorted_v)-1)/np.arange(1, len(v)+1)
    active = np.flatnonzero(sorted_v > threshold)[-1]
    return np.maximum(v-threshold[active], 0)
optimum = project_simplex(target)
x = np.full(3, 1/3)
for k in range(1000):
    grad = x-target
    vertex = np.eye(3)[int(np.argmin(grad))]
    gap = float(grad @ (x-vertex))
    error = 0.5*np.sum((x-target)**2)-0.5*np.sum((optimum-target)**2)
    assert error <= gap + 1e-12
    if gap < 1e-4:
        break
    gamma = 2/(k+2)
    x = (1-gamma)*x + gamma*vertex
# Recompute certificate at the returned iterate.
grad = x-target
vertex = np.eye(3)[int(np.argmin(grad))]
gap = float(grad @ (x-vertex))
print("Simplex iterate:", x)
print("Frank–Wolfe gap:", gap)
assert np.all(x >= 0) and np.isclose(x.sum(), 1)
assert gap < 0.01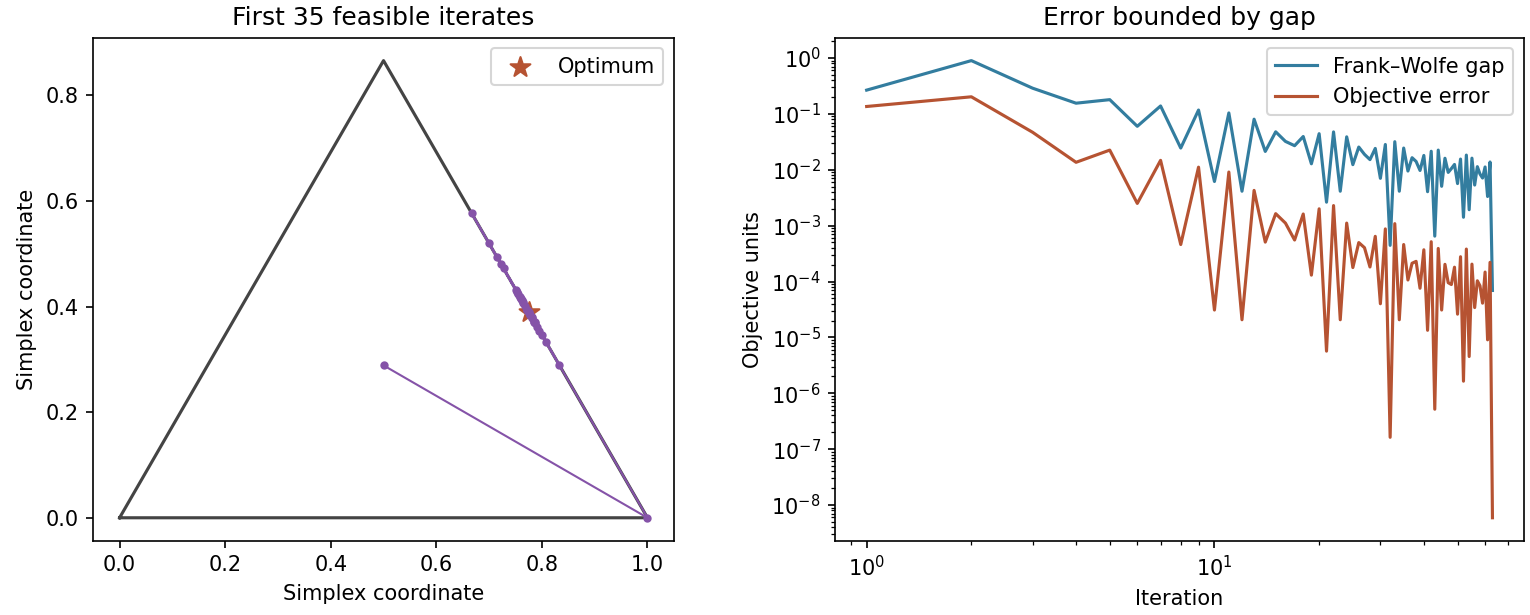
範例的參考投影只用於計算精確二次最小解,方便比較;條件梯度本身從不呼叫投影。如此可測間隙界限,而不只看曲線下降便推斷收斂。最後更新後重新計算間隙,讓它描述真正回傳的點。
緊緻可行集合與平滑目標支持通常的收斂分析。無界 oracle 或非平滑目標改變問題。變體能處理額外結構,但不可未檢查假設便沿用基本保證。綜述 [5] 說明選擇與幾何動機。
證明 oracle 間隙,並包含非精確 oracle
條件梯度間隙是最佳線性化可行方向允許的改善。凸性給出 。因為精確 oracle 在 上最小化該線性分數,
其中 是目前可行點、 是最佳解、 是精確線性 oracle 的解。第一個不等式使用目標凸性,第二個使用 oracle 與 的比較。這兩個要素把可計算方向量變成全域誤差上界 [5]。
若可行的近似 oracle 回傳 ,滿足 ,其中已知 ,有效上界就是計算出的間隙加上 。其中 是 oracle 的線性目標誤差容許量。因為 ,即使間隙須修正,更新仍保持可行。
對單純形梯度 ,精確 oracle 選第二頂點,分數為 。選第一頂點的分數為 ,需要容許量 。在 ,精確間隙為 ,近似 oracle 間隙卻為 。加上三後恢復 。此處未修正負間隙代表 oracle 不佳,不代表目標誤差低於零。
7. 依結構、精度與資訊選擇方法
沒有全面最好的更新方程。建模決策決定可取得的資訊及便宜運算。比較名稱或迭代次數前,先比較真正運算成本。
中型平滑問題若能利用曲率,牛頓或內點法可透過較少昂貴步驟取得精確解。巨大稀疏模型可能受分解記憶體限制,一階法便宜的矩陣向量運算更合適。簡單非平滑懲罰可用便宜精確的近端運算;複雜集合若線性 oracle 簡單,條件梯度可避免昂貴投影。
分散式最佳化再加入通訊成本。局部目標可分離,共識限制卻連接變數。ADMM 能暴露局部子問題,但收斂時間須包括通訊輪次與局部求解。數學上分散式不代表實作平行;本章去雜訊範例完全循序執行。
原始/對偶混合梯度法(primal–dual hybrid gradient)以原始與對偶更新處理鞍點表示 [4],步幅依算子範數與分裂項結構決定。PDLP [6] 等實際線性規劃系統在此結構外加入前處理與自適應技巧。短小理論遞迴與正式求解器是不同描述層次。
要求精度可能反轉比較。快速產生有用近似解的方法,可能要很久才達到極小憑證間隙;另一法前置成本大,但高精度收斂有效。畫出達到幾種指定誤差所需時間,並與間隙一起回報原單位可行性,讓折衷可查核。
記憶體與重複求解也重要。參數掃描在方法支援時能重用資料結構、分解或前一解;稀疏樣式改變可能阻止重用。首次量測納入前處理與設定,暖啟動重複求解另行回報。不要偷偷拿一法暖執行與另一法冷執行比較。
共識:局部求解與共享平均
分散式 ADMM 明確呈現通訊機制。假設 個參與者共享向量決策,但各有局部凸成本 。引入局部副本 與共享變數 ,在所有 下求解 。
縮放形式的一次共識迭代為
其中 是參與者 的縮放乘子、 是懲罰參數、 是迭代索引。第一列為獨立局部求解;第二列對 最小化二次共識項之和,其導數使 等於平均;第三列累積不一致 [3]。
對純量成本 ,局部解為 ,其中 是局部目標。兩參與者的目標若為零與四,必須在全域最佳值二達成共識。各自最適的零與四違反共識;平均與乘子更新協調折衷。
因此通訊屬於演算法本身:共享更新需要各個局部量,局部求解則需要最新共享值。平行實作除了局部算術,也須量測訊息成本與同步。若增加共享限制, 子問題也會改變,常從簡單平均變成受限近端運算。
8. 完整凸最佳化專題
專題須讓模型與證據可重現。選合成訊號估計、幾何配置或資源模型,求解前先寫變數、單位、凸性論證、定義域與可行集合解讀。說明鬆弛及如何把結果轉成可執行決策。
建立一個有解析答案或獨立憑證的小實例,用來檢查符號、形狀、尺度與停止規則。接著一次改一項:雜訊、正則化、條件數、稀疏性、大小或容許誤差。同一實例比較演算法時固定資料種子。
在真正回傳點記錄目標與殘差。分裂法追蹤耦合與對偶殘差;條件梯度報目前間隙與 oracle 精度;障礙法區分外層目標與計算憑證;鬆弛則分開下界與可行取整上界。
數值收斂之外也評估應用。去雜訊器可能準確最小化一個會移除真事件的懲罰;配置求解器可能遵守全部已建模規則,卻漏了門口需求;資源最佳化可能對不確定需求敏感。這些是模型驗證發現,不應模糊數學憑證的意義。
學習流程在選正則化或學前處理前先切分資料。驗證集重複求解、選規則,再回報保留資料結果。ML/DL 評估章說明更廣的學習規則。數值收斂與預測評估回答不同問題,結果表應分不同欄。
現代觀點
閱讀地圖把整理演算法的綜述與改變實務建模/求解的新工作結合。以下來源查核至 2026 年 10 月 4 日,未出版手稿明確標示。
Parikh 與 Boyd [2] 以小凸子問題整理近端法;Boyd 等人 [3] 以可分離性、耦合與分散式統計應用整理 ADMM。本章綜合重點是:分裂後哪些子問題變簡單,新增哪些殘差需要控制。分裂能減少總工作才有價值,不是因目標有數項就值得做。
Condat 等人 [4] 透過原始/對偶乘積空間與單調包含統一近端分裂,重訪參數範圍與變體。不同遞迴可依算子與度量連接。用它查明真實假設,尤其平滑二次項可能允許與一般平滑函數不同的選擇。統一觀點避免把任意參數組合當成有保證的方法。
Pokutta 的 2024 年導論 [5] 以線性 oracle 與可行組合整理條件梯度,幫助比較投影法與 oracle 法,也解釋可行集合幾何如何影響行為。先估 oracle 與表示成本,再使用有效間隙。便宜 oracle 仍可能需很多迭代才達應用精度。
Shorinwa 等人的 2024 年多機器人綜述 [7] 區分分散式一階、循序凸規劃與 ADMM 方法,把通訊、協調及實體限制放在數學更新旁。部分機器人模型非凸,或透過一連串凸子問題求解;凸子問題收斂不證明原軌跡或協調問題全域最適。
Applegate 等人的 PDLP 手稿 [6] 於 2025 年發布、2026 年修訂,提供大型一階線性規劃的新實務證據。Schaller、Bemporad 與 Boyd 的 2025 年手稿 [8] 則配適相容於規範式程式設計的參數化凸函數。前者關於求解流程,後者關於對決策變數保持凸性的學習函數;兩者都是手稿,也都不會使任意神經網路訓練凸化。
| 問題 | 有用家族或閱讀 | 應蒐集的證據 |
|---|---|---|
| 限制投影便宜嗎? | 投影/近端法 [2] | 投影成本與最適性殘差 |
| 各項能拆成簡單運算嗎? | ADMM、原始/對偶分裂 [3,4] | 局部求解成本與耦合殘差 |
| 線性最小化比投影容易嗎? | 條件梯度 [5] | oracle 成本、可行點與間隙 |
| 通訊是否主導成本? | 分散式分類 [7] | 輪次、訊息、局部工作與實體可行性 |
| 線性模型太大而無法分解嗎? | 實務一階線性規劃 [6] | 記憶體、準確度與原單位殘差 |
| 學習函數能保留決策變數凸性嗎? | 參數化凸建模 [8] | 結構限制與保留資料上的模型適切性 |
綜合而言,建模與計算越來越透過可重用結構元件交會:凸子問題、便宜近端映射、學習式凸函數及配合硬體的求解運算。價值仍依明確模型、有效假設與端到端量測。求解器基準不證明泛化,預測基準也不證明可行性。
未解問題包含自動結構辨識、不良尺度下的穩健憑證、通訊效率、活躍限制改變時的可微性,以及學習預測與精確限制的可靠整合。有用研究問題隔離一項議題並保留獨立可查核結果,例如:「同一憑證誤差下,暖啟動是否降低總求解時間?」
本單元已提供完整路徑:凸集合與函數、問題建立、對偶性、估計、數值方法、受限求解器與結構式應用。接著可選一組教科書練習,圍繞假設建立小型原創實驗。核心習慣是寫清楚最佳化什麼、為何凸、演算法計算什麼,以及接受結果的證據。
重點整理
- 幾何建模包含投影、分離、中心、橢球與結構式配置。
- 未知離散選擇與析取可能使原應用非凸。
- 鬆弛下界與可行可執行解扮演不同角色。
- 近端運算直接處理簡單非平滑懲罰與限制。
- ADMM 把耦合拆成易處理運算,須查核原始及對偶殘差。
- 條件梯度透過線性 oracle 保持可行性,並在所述假設下提供間隙。
- 比較原單位準確度、設定、記憶體、重複求解與應用結果。
練習
- 幾何中心。推導軸對齊矩形的最大內接球,說明一邊較長時中心為何可能不唯一。
提示
較短邊限制半徑;中心可沿長邊移動而仍保留足夠邊界距離。
- 平面配置。先選定兩矩形哪個在左,寫凸不重疊限制,解釋次序未知時有何改變。
提示
固定次序給仿射分離不等式;未知次序須二選一,是析取而非單一凸半空間。
- 正則化掃描。以五種強度執行去雜訊,比較目標、合成重建誤差與近乎零的相鄰差分數。
提示
不同強度的目標是不同函數,不能用原始值公平比較收斂。分開模型品質與求解精度。
- 懲罰更新。在實驗中途改 ADMM 懲罰,保持分解與縮放對偶變數一致,再與固定懲罰比較殘差。
提示
未縮放乘子是懲罰乘縮放對偶變數。改懲罰時保持此乘積。
- 非精確 oracle。故意使用次最適單純形頂點,找出 oracle 目標誤差如何改憑證界限,以及迭代是否仍可行。
提示
頂點的凸組合保持可行;非精確 oracle 的間隙須加上其線性目標誤差上界。
- 專題報告。在一個合成凸應用比較兩種合適演算法,納入模型、凸性證明、停止政策、原單位殘差、時間、記憶體及一個模型失敗。
提示
資料與驗收誤差相同;設定成本與重複求解分開。未解決的數值執行須如實回報,不能算成功求解。
參考文獻
- S. Boyd and L. Vandenberghe, Convex Optimization, Cambridge University Press, 2004, Chapter 8, with Chapters 4 and 6 for modeling and approximation. Book
- N. Parikh and S. Boyd, “Proximal Algorithms,” Foundations and Trends in Optimization, 2014. Survey
- S. Boyd, N. Parikh, E. Chu, B. Peleato and J. Eckstein, “Distributed Optimization and Statistical Learning via the Alternating Direction Method of Multipliers,” Foundations and Trends in Machine Learning, 2011. Review
- L. Condat, D. Kitahara, A. Contreras and A. Hirabayashi, “Proximal Splitting Algorithms for Convex Optimization: A Tour of Recent Advances, with New Twists,” SIAM Review, 2023. Author manuscript
- S. Pokutta, “The Frank-Wolfe Algorithm: A Short Introduction,” Jahresbericht der Deutschen Mathematiker-Vereinigung, 2024. Survey
- D. Applegate, M. Díaz, O. Hinder, H. Lu, M. Lubin, B. O’Donoghue and W. Schudy, “PDLP: A Practical First-Order Method for Large-Scale Linear Programming,” arXiv preprint, 2025, revised 2026. Paper
- O. Shorinwa, T. Halsted, J. Yu and M. Schwager, “Distributed Optimization Methods for Multi-Robot Systems: Part 2—A Survey,” IEEE Robotics & Automation Magazine, 2024. Survey
- M. Schaller, A. Bemporad and S. Boyd, “Learning Parametric Convex Functions,” manuscript, June 2025. Author page
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑這是「最佳化」單元的最後一篇。 回到學習地圖 →