現代觀點論文導讀
選讀・IP 13・影像圖樣分類 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
這些選讀連接統計分類、學習表示、預訓練遷移與評估可靠度,協助分辨整條流程中改變了什麼。
本章的「現代觀點」建立在以下回顧與研究之上。
深度學習之前的統計圖樣辨識
Jain、Duin 與 Mao 的回顧 [2] 至今仍是傳統領域最清楚的地圖:表示、特徵擷取與選擇、貝氏與最近鄰規則、線性與非線性分類器、分類器結合,以及錯誤率估計。它的主要結論是:特徵表示與評估流程比分類器的選擇更重要。這個結論經得起時間考驗。深度學習並沒有推翻它,而是把「表示」這一部分自動化了。
CNN 時代
Rawat 與 Wang [11] 回顧了用於影像分類的 CNN,從 1980 年代末的起源一路到 2017 年,依架構、正則化、最佳化與實務技巧整理了三百多篇論文。他們描繪的脈絡始於 LeCun 等人以梯度訓練、用於文件辨識的網路 [6];AlexNet [7] 使用 GPU、ReLU、dropout 與資料擴增,在 2012 年贏得 ImageNet 大規模視覺辨識競賽 [10],讓這條路線加速;VGG [8] 顯示以小型 核堆出的深度有幫助;ResNet [9] 透過恆等捷徑連接學習殘差函數,讓非常深的網路變得可以訓練。這些架構都仍看得出圖 13.6 的影子:卷積、非線性、池化、線性分類器,以反向傳播訓練。
視覺中的 Transformer
Vision Transformer(ViT)[12] 把影像切成 的小塊,把每塊當成一個 token,以自注意力(self-attention)而非卷積處理這個序列。只要預訓練資料足夠,它能追平甚至超越 CNN。Khan 等人的綜述 [13] 涵蓋了用於分類、偵測、分割等任務的眾多視覺 Transformer 變體,並討論它們對大規模預訓練的依賴。隨後 ConvNeXt [14] 顯示:一個純 CNN,只要借用 Transformer 的設計選擇一步步現代化,又能再度與之匹敵。實務上的教訓是:架構家族的差異,不如訓練資料、規模與訓練配方來得重要。
基礎模型特徵與零樣本分類
2021–2023 年的兩項發展改變了「訓練分類器」的意義。CLIP [15] 同時訓練一個影像編碼器與一個文字編碼器,讓相符的影像–說明文字對擁有相近的嵌入向量。於是不需要任何標註影像,就能建出新的分類器:把 a photo of a {class} 這類提示文字嵌入,再把每張影像指派給文字嵌入最相似的類別。這就是一個最小距離分類器,只是原型來自語言。DINOv2 [16] 在一個大型、經過篩選的影像集上以自監督方式學習通用視覺特徵,完全不用標籤;它凍結的特徵只要在上面接一個線性層或最近鄰規則,就能做出很強的分類。兩者都把最昂貴的部分,也就是特徵擷取器,只訓練一次;上面的分類器往往正是本章前半的簡單規則之一。
資料擴增與正則化
Shorten 與 Khoshgoftaar 的綜述 [18] 把擴增方法分成基本影像操作(幾何與色彩轉換、核濾波、影像混合、隨機抹除)與學習式方法(對抗式訓練、以 GAN 合成、神經風格轉換、以後設學習搜尋擴增策略)。它的結論和圖 13.9 一致:在標註資料有限時,擴增是降低過擬合最便宜也最有效的方法之一。
評估陷阱與資料集偏差
Torralba 與 Efros [19] 問了一個簡單的問題:分類器能不能分辨一張影像來自哪個資料集?答案是可以,而且遠高於隨機猜測,顯示每個基準資料集都有自己的「指紋」;在一個資料集上訓練的模型,換到另一個資料集時也泛化得很差。Liu 與 He [20] 用現代網路,以及非常大、非常多樣的網路規模資料集重做了這個實驗:現代網路仍能在未見過的影像上高準確率地辨認出來源資料集,而且靠的是可泛化的特徵而不是死背。資料集偏差並沒有因為規模變大而消失。由此有兩個實務結論:在某個基準上的準確率,描述的是那個基準,而不是真實的視覺世界;只要可能,就用與訓練資料獨立蒐集的資料來測試。
如何判讀這些論文的證據
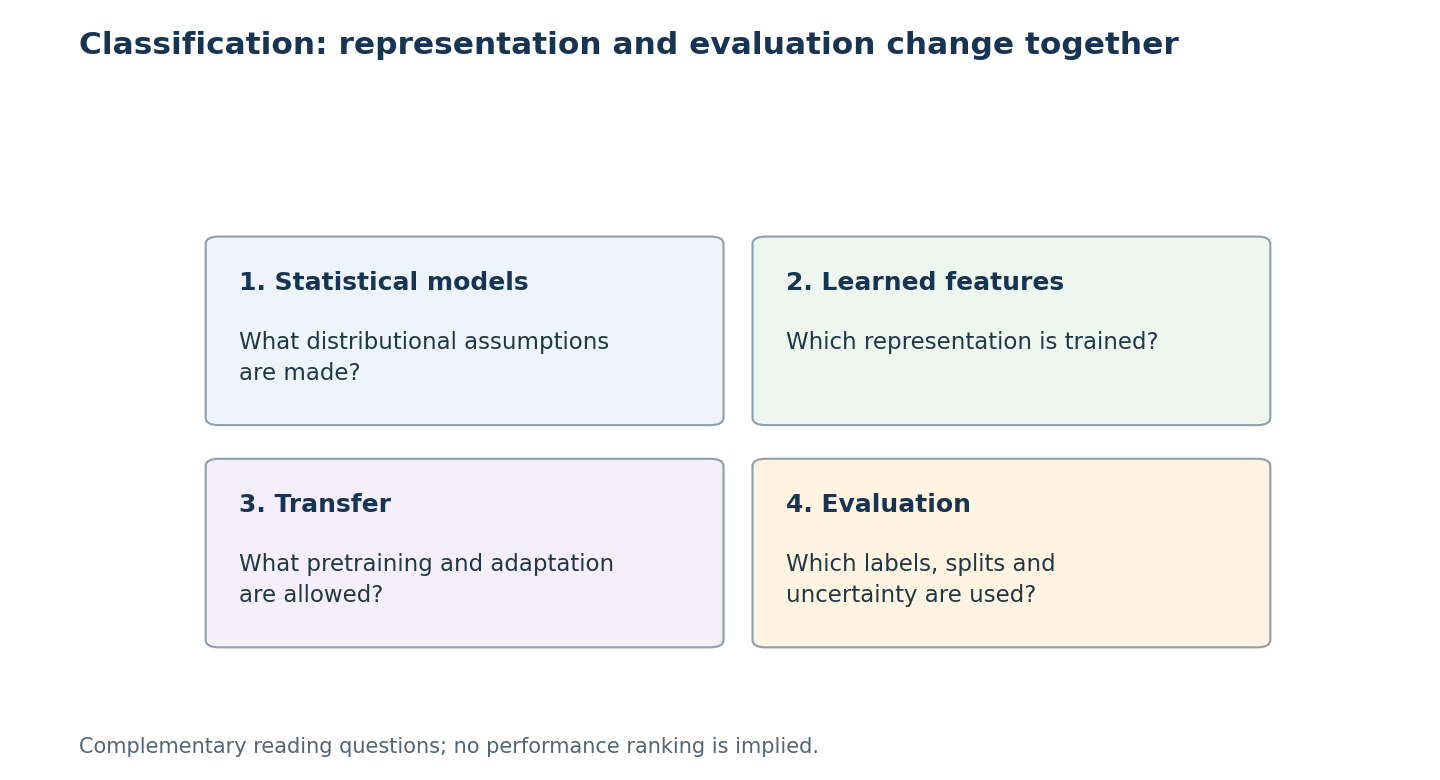
歷史變化不只是換最後分類器。深度模型同時改變表示、預訓練資料與最佳化,基礎特徵又改變標籤、文字如何定義決策。與最小距離或統計分類器比較前,先確認是否共用特徵,否則測到的是整條流程變化。
本導讀的評估研究也檢查證據可靠度:新測試集檢查偏移,修訂標籤檢查歧義、錯誤,重複訓練檢查變異,各自不能涵蓋所有泛化。比較須記錄預訓練重疊、調適資料、選模規則與標籤慣例;架構年表不能證明哪個元件造成準確率進步。
參考文獻
- R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed., Pearson, 2018, Ch. 13. publisher page
- A. K. Jain, R. P. W. Duin, and J. Mao, “Statistical Pattern Recognition: A Review,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 22, no. 1, pp. 4–37, 2000. doi:10.1109/34.824819
- D. G. Lowe, “Distinctive Image Features from Scale-Invariant Keypoints,” International Journal of Computer Vision, vol. 60, 2004. doi:10.1023/B:VISI.0000029664.99615.94
- F. Rosenblatt, “The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain,” Psychological Review, vol. 65, 1958. doi:10.1037/h0042519
- D. E. Rumelhart, G. E. Hinton, and R. J. Williams, “Learning Representations by Back-Propagating Errors,” Nature, vol. 323, 1986. doi:10.1038/323533a0
- Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-Based Learning Applied to Document Recognition,” Proceedings of the IEEE, vol. 86, 1998. doi:10.1109/5.726791
- A. Krizhevsky, I. Sutskever, and G. E. Hinton, “ImageNet Classification with Deep Convolutional Neural Networks,” Advances in Neural Information Processing Systems 25 (NIPS), 2012. paper
- K. Simonyan and A. Zisserman, “Very Deep Convolutional Networks for Large-Scale Image Recognition,” arXiv:1409.1556, 2014. arXiv
- K. He, X. Zhang, S. Ren, and J. Sun, “Deep Residual Learning for Image Recognition,” arXiv:1512.03385, 2015. arXiv
- O. Russakovsky, J. Deng, H. Su, J. Krause, S. Satheesh, et al., “ImageNet Large Scale Visual Recognition Challenge,” arXiv:1409.0575, 2014. arXiv
- W. Rawat and Z. Wang, “Deep Convolutional Neural Networks for Image Classification: A Comprehensive Review,” Neural Computation, vol. 29, no. 9, 2017. doi:10.1162/neco_a_00990
- A. Dosovitskiy, L. Beyer, A. Kolesnikov, et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” ICLR, 2021. arXiv
- S. Khan, M. Naseer, M. Hayat, S. W. Zamir, F. S. Khan, and M. Shah, “Transformers in Vision: A Survey,” ACM Computing Surveys, 2022. arXiv
- Z. Liu, H. Mao, C.-Y. Wu, C. Feichtenhofer, T. Darrell, and S. Xie, “A ConvNet for the 2020s,” CVPR, 2022. arXiv
- A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, et al., “Learning Transferable Visual Models From Natural Language Supervision,” arXiv:2103.00020, 2021. arXiv
- M. Oquab, T. Darcet, T. Moutakanni, et al., “DINOv2: Learning Robust Visual Features without Supervision,” arXiv:2304.07193, 2023. arXiv
- N. Srivastava, G. Hinton, A. Krizhevsky, I. Sutskever, and R. Salakhutdinov, “Dropout: A Simple Way to Prevent Neural Networks from Overfitting,” Journal of Machine Learning Research, vol. 15, pp. 1929–1958, 2014. JMLR
- C. Shorten and T. M. Khoshgoftaar, “A Survey on Image Data Augmentation for Deep Learning,” Journal of Big Data, vol. 6, 2019. doi:10.1186/s40537-019-0197-0
- A. Torralba and A. A. Efros, “Unbiased Look at Dataset Bias,” CVPR, 2011. paper page
- Z. Liu and K. He, “A Decade’s Battle on Dataset Bias: Are We There Yet?,” ICLR, 2025. arXiv