模型怎麼選:看懂評測、授權與證據
如何解讀關於模型的證據,並為我的任務選出一個模型?
模型只是一個可運作系統的元件。排行榜能幫你縮小候選名單,但你的工具、指令、資料與驗收條件,才決定候選模型是否有用。這份指南教你如何解讀證據:評測分數究竟量測什麼、為什麼可能誤導、能信任到什麼程度,以及你選的模型讓你可以做什麼。
正文的寫法盡量不隨模型更新而過時。目前的模型名稱、版本連結、評測入口,以及值得閱讀的組織與人物清單,都在現行選項。如果你是為 agent 挑模型,建議先讀選擇 agent 工具。
重點
- 你選的從來不是「一個模型」,而是一個具體的產物:API 背後固定版本的託管模型,或是搭配特定執行環境與精度的某個權重檔。
- 「開放」要分別檢查程式碼、權重、託管服務與訓練資料。模型可以是開放權重,卻不是開源。
- 評測分數是任務集、harness、評分器與彙整規則的輸出。任何一項改變,數字就會改變。
- 公開測試集會洩漏到訓練資料中。優先採用新題、有時間戳記或私有任務的證據。
- 小規模評估雜訊很大:30 題解對 21 題,與大約 52% 到 83% 之間的任何真實成功率都相容。
- 「k 次嘗試中解出一次」(pass@k)與「k 次嘗試全部解出」(pass^k)回答相反的問題;無人值守的 agent 需要的是後者。
- 最終決定時,你自己的小型固定評估集勝過任何排行榜。
你實際選的是什麼
排行榜上的模型名稱只是家族標籤。你的系統實際呼叫的東西更具體:
- 託管版本。 供應商透過識別碼提供模型。有些識別碼是別名,會隨時間指向較新的快照;有些是固定快照,在退役之前行為不應改變。請記錄 API 回報的識別碼,而不只是你請求的那個,並留意供應商的退役日期。
- 可下載的權重檔。 儲存庫版本、檔案格式、精度或量化、對話樣板,以及服務用的執行環境,共同決定行為。4 位元轉換版與原始 16 位元釋出版是不同的實驗。
- 系統設定。 推理強度設定、工具定義、重試政策與 token 預算,對結果的影響不亞於模型的選擇。一項評測若只用某一種 agent 骨架回報模型成績,就很難說明同一個模型換成別的骨架會如何。
「開放」是每一層各自的性質
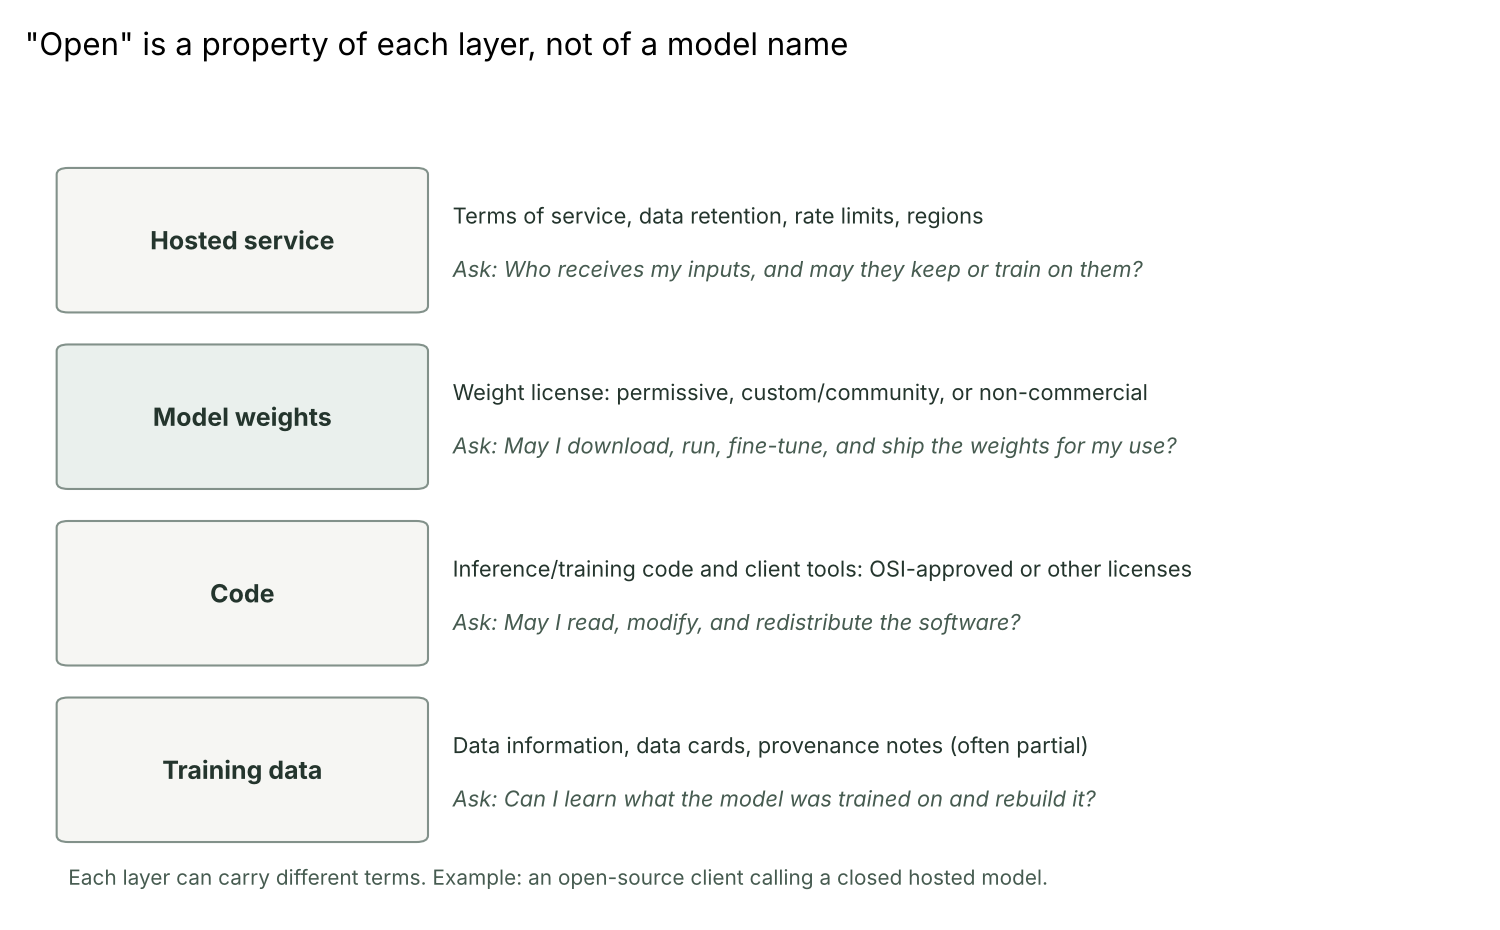
白話版。「開放模型」這個說法含糊不清。要問的是:到底什麼是開放的、可以用在什麼用途。
精確版。 四層各有各的條款:
- 程式碼。 推論與訓練程式碼,以及用戶端工具,都是軟體。開放原始碼定義(Open Source Definition)規定了開源授權的準則,例如可自由再散布、可取得原始碼、允許衍生作品,以及不得歧視特定領域的使用。Apache-2.0 與 MIT 是常見的例子。[1]
- 權重。 模型參數依各自的授權散布,可能是標準的寬鬆授權、附帶條件的自訂「社群」授權(例如限制用途或超大規模部署),或是非商業授權。同一個家族可以混用:某個大小採寬鬆授權,另一個則是非商業。[2]
- 託管服務。 當你呼叫 API 時,供應商的條款決定資料保留、輸入的使用方式、速率限制與區域,與任何權重授權無關。
- 訓練資料。 往往只有部分文件說明。開放原始碼促進會(Open Source Initiative)的 Open Source AI Definition 1.0 除了程式碼與參數之外,還要求提供足夠詳細的資料資訊,讓具備技能的人能建立出實質相當的系統;大多數「開放權重」的釋出都達不到這個標準。[3]
因此開放權重(你可以在某種授權下下載並執行參數)不等於 OSI 定義下的開源。請閱讀附在確切權重檔上的授權檔,以及說明預期用途與限制的模型卡。[2, 4]
評測如何產生一個數字
白話版。 評測就像一場考試:一組題目、作答規則、批改答案的方式,以及加總分數的方式。這些選擇每一項都會影響分數。
精確版。 每個回報的分數,都是五個組成部分的輸出:
| 組成部分 | 是什麼 | 什麼會改變數字 |
|---|---|---|
| 任務集 | 題目,連同版本或日期區間 | 不同切分、較新的釋出、被移除或修正的題目 |
| Harness | 模型如何被提示、拿到哪些工具與骨架、可以走幾步 | Agent 框架、工具呼叫模式、步數與 token 上限 |
| 取樣 | 溫度、推理強度、嘗試次數 | 更多次嘗試或更多思考,會提高成功率,也提高成本 |
| 評分器 | 單元測試、完全比對、人工投票,或擔任評審的模型 | 比對寬鬆或嚴格;評審偏好較長或特定風格的回答 |
| 彙整 | 各任務平均、pass@k、Elo 式評分、加權指數 | 各類別的權重;平手與失敗如何計算 |
評測的種類也不同:
| 種類 | 如何評分 | 範例(見現行選項) | 它無法證明什麼 |
|---|---|---|---|
| 靜態、以測試為基礎 | 隱藏測試通過或失敗 | SWE-bench:修補必須通過儲存庫測試 [5] | 測試以外的程式碼品質;在你的儲存庫中的表現 |
| 即時、限定時間區間 | 某個日期之後才公開的題目 | LiveCodeBench 蒐集附有發布日期的新競賽題 [6] | 不同日期區間的結果無法比較 |
| Agent 環境 | 互動環境的最終狀態 | 終端機與工具使用套件 | 脫離骨架、屬於模型本身的能力 |
| 成對偏好 | 人從兩個輸出中選較好的 | Arena 式排行榜 | 事實正確性;在你的工作流程中是否成功 |
| 彙整指數 | 許多評估的加權組合 | 商業與學術指數,例如 HELM | 永久有效的排名:組成與權重會改變 |
引用數字之前,先寫下測試套件與版本、harness 及其版本、模型識別碼、取樣設定與嘗試次數。只要其中任何一項不同,兩個數字就不能直接比較。
資料污染:考題外洩的時候
白話版。 如果模型在訓練時看過考題,高分量測的可能是記憶,而不是能力。
精確版。 大型模型以網路規模的資料訓練,公開評測的題目或其近似改寫,可能混進這些資料。這種影響是可以量測的。研究者針對一個流行的公開小學數學題集,寫了一組風格與難度都相符的新題;部分模型家族在新題集上的分數低了最多 8 個百分點,而且差距與各模型重現公開題集題目的可能性相關;不過許多前沿模型幾乎沒有過擬合的跡象。[7] LiveCodeBench 的做法是為每道題標上時間戳記,並只用在模型訓練截止日之後公開的題目來評估。[6] 本站 ML 10 中關於污染的小節說明了背後的概念。
實務上的結論:
- 優先採用限定時間區間、定期更新或私有任務的結果。
- 如果一個模型在舊的公開評測上遠強於測同一項技能的新評測,要保持懷疑。
- 把自己的評估集保密,不要貼到可能用輸入來訓練的託管工具中。
一個數字能信任到什麼程度
白話版。 只有幾十題的分數只是粗略的估計。兩個模型在小題集上差幾分,可能根本沒有差別。
精確版。 若系統在 個獨立任務中解出 個,觀察到的比率是 。它的取樣不確定性只隨 的平方根縮小。Wilson 分數區間(Wilson score interval)即使在 很小時,也是表現良好的 的近似 95% 區間:[39]
其中 是觀察到的成功率, 是任務數, 對應 95% 的涵蓋率。評估方法論的論文也針對語言模型評測提出同樣的看法,並給出在相同題目上比較兩個模型的公式。[8]
重複嘗試。 Agent 具有隨機性,所以每個任務要跑好幾次。有兩種彙整方式,回答相反的問題。某個任務嘗試 次,其中 次通過:
其中 pass@ 估計 次嘗試中至少一次通過的機率(最初為程式碼生成提出 [9]),pass 估計 次嘗試全部通過的機率(最初為衡量 agent 可靠性而提出 [10])。兩者都對各任務取平均。
程式碼 · Python · 27 行
from math import comb, sqrt


def pass_at_k(n, c, k):
    """Unbiased estimate of P(at least one of k attempts passes), from n attempts with c passes."""
    return 1.0 if n - c < k else 1 - comb(n - c, k) / comb(n, k)


def pass_hat_k(n, c, k):
    """Estimate of P(all k attempts pass), from the same n attempts."""
    return comb(c, k) / comb(n, k)


def wilson(successes, trials, z=1.96):
    """Approximate 95% interval for a success rate (Wilson score interval)."""
    p = successes / trials
    centre = (p + z * z / (2 * trials)) / (1 + z * z / trials)
    half = z * sqrt(p * (1 - p) / trials + z * z / (4 * trials * trials)) / (1 + z * z / trials)
    return centre - half, centre + half


n, c = 10, 7  # one task, ten attempts, seven passed
for k in (1, 3, 5):
    print(f"k={k}: pass@k={pass_at_k(n, c, k):.3f}  pass^k={pass_hat_k(n, c, k):.3f}")
for solved, total in ((21, 30), (210, 300)):
    lo, hi = wilson(solved, total)
    print(f"{solved}/{total} tasks: {solved / total:.0%} solved, 95% interval {lo:.0%} to {hi:.0%}")
程式碼 · 5 行
k=1: pass@k=0.700  pass^k=0.700
k=3: pass@k=0.992  pass^k=0.292
k=5: pass@k=1.000  pass^k=0.083
21/30 tasks: 70% solved, 95% interval 52% to 83%
210/300 tasks: 70% solved, 95% interval 65% to 75%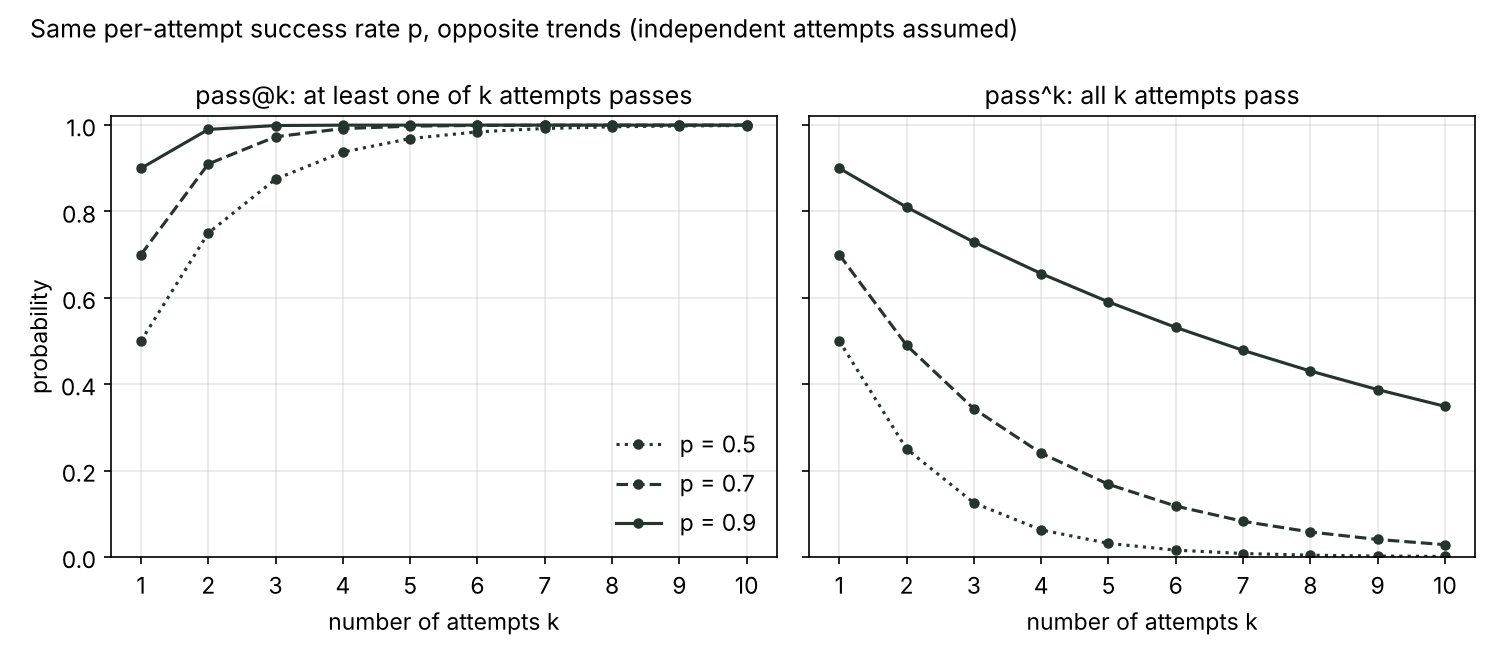
當由人從多份草稿中挑出最好的一份時,用 pass@;當系統必須每次都在無人值守下運作時,用 pass(或直接用單次執行的成功率與其區間)。
有助於維運系統的指標
任務成功率是通過驗收測試的嘗試比例,而驗收測試要在讀到任何輸出之前就寫好。要包含各種限制,例如保留無關檔案,或回傳可用的引文。
每個驗收成果的成本是全部花費(包含失敗的嘗試與重試)除以通過驗收的輸出數。人工審查時間另外回報,或用明確的規則計入。若沒有任何輸出通過,就如實報告,而不是給出無限大或誤導性的成本。
延遲需要先界定範圍:首個 token 的時間說明輸出何時開始;端到端時間說明可驗收的成果何時就緒。請回報多次執行下的典型值與慢尾端的值,而不是最佳的展示。
可靠度是單次執行的成功率及其區間,或如上所述的 pass。
自己執行模型:記憶體估算
參數量並不是記憶體預算。在 GPU 上有兩項占大宗:權重,大約是參數量乘以每個參數的位元組數;以及鍵值(KV)快取,它為每個進行中序列的每個 token 儲存注意力的鍵與值:
其中 是層數, 是鍵值頭的數量, 是每個頭的維度, 是每個序列的 token 數, 是同時處理的序列數, 是每個儲存值的位元組數,係數 2 則分別計入鍵與值。KV 快取的記憶體隨情境長度與併發量增長,這也是服務系統要仔細管理它的原因。[11] 以一個假想的 80 億參數模型(32 層、8 個 KV 頭、頭維度 128)為例:
程式碼 · Python · 18 行
GiB = 2**30
# Assumed architecture of a hypothetical 8-billion-parameter decoder.
params, layers, kv_heads, head_dim = 8e9, 32, 8, 128


def weights_gib(bits):
    return params * bits / 8 / GiB


def kv_cache_gib(tokens, sequences, bits=16):
    # 2 tensors (keys and values) per layer, per KV head, per token.
    return 2 * layers * kv_heads * head_dim * tokens * sequences * bits / 8 / GiB


for bits in (16, 4):
    print(f"weights at {bits:>2}-bit: {weights_gib(bits):5.1f} GiB")
for tokens, seqs in ((8_000, 1), (32_000, 1), (32_000, 8)):
    print(f"KV cache, {tokens:,} tokens x {seqs} sequence(s): {kv_cache_gib(tokens, seqs):5.1f} GiB")
程式碼 · 5 行
weights at 16-bit:  14.9 GiB
weights at  4-bit:   3.7 GiB
KV cache, 8,000 tokens x 1 sequence(s):   1.0 GiB
KV cache, 32,000 tokens x 1 sequence(s):   3.9 GiB
KV cache, 32,000 tokens x 8 sequence(s): 31.2 GiB把權重量化會縮小第一項;長情境與大量同時使用者會讓第二項增長,甚至超過權重。執行環境的額外開銷與激活值(activation)還會再增加用量。請在你的硬體上,以預定的情境長度與併發量實際量測;能載入的模型,仍可能慢到無法互動使用。ML 11 說明了量化本身。
建立你自己的評估
- 蒐集 20–50 個真實任務,並附上已知的檢查方式:一般工作、模糊的要求、缺少的相依項、工具故障,以及幾個困難案例。
- 先寫驗收測試。 優先採用可執行的檢查;需要評分規準時,保持簡短,並以人工判斷校準任何由模型擔任的評審。
- 固定流程: 提示、工具、預算、重試政策、嘗試次數,以及確切的模型識別碼。
- 執行後,要讀失敗案例,而不只看分數。失敗類別會告訴你該改什麼。
- 回報不確定性。 若兩個候選的區間大幅重疊,就依成本、延遲、資料條款或維運適配度來決定,而不要硬宣布贏家。
- 每次更換模型或提示後,重跑同一組題目。 把用來調整的案例與用來評判的案例分開。
先透過你理解的工具使用一個託管模型。當本地執行、客製化、資料所在位置或服務經濟性帶來具體理由時,再試開放權重的替代方案,並在工作負載改變時重新檢視這個決定。視覺類的工作,請接著讀影像生成模型選擇或影片生成模型選擇。
現行選項,查核日期 2026 年 11 月 6 日
這些清單是指出值得調查的產物。它們不求完整,不是排名,也不是重現的評測結果。供應商經常更名、新增與退役模型;依賴某一列之前,請先打開目錄確認。
託管模型家族與版本頁面
| 供應商 | 官方目錄中的現行模型 | 要檢查什麼 |
|---|---|---|
| OpenAI | GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra、GPT-6 Luna [12] | 推理強度、工具支援、延遲與整項任務成本 |
| Anthropic | Claude Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 5.5 [13] | 模型 ID 是固定快照;推理強度設定;各平台專屬的 ID |
Gemini 4 Argon(gemini-4-argon,穩定版)、Gemini 3.8 Flash、3.6 Flash、3.5 Flash-Lite [14] | 穩定、新版或預覽狀態;會被改導向的已棄用 ID | |
| Meta | muse-spark-1.3 與 muse-wonder-1.0(預覽) [15] | API 模型與 Muse 應用程式、Muse Code agent 的差別;Standard 與 Contributor 資料使用模式 |
| xAI | Grok 4.7(grok-4.7)與模型目錄 [16] | 需要即時資訊時,另外啟用搜尋並編列預算 |
本次修訂新增:Google 的目錄將 gemini-4-argon 列為穩定的旗艦推理模型。[14]
Meta 的名稱需要確認存取方式。 Muse 是面向消費者的 agent,Muse Code 是終端機程式開發 agent。Muse Wonder Full 只在符合條件的訂閱下,於 Muse Code 中提供,不透過 Model API;Muse Spark Open 與 Muse Glimmer 是開放權重的釋出,沒有 Model API 的 ID。[15, 17, 18, 19]
可下載的權重檔
| 家族 | 權重檔或下載頁面 | 要檢查什麼 |
|---|---|---|
| OpenAI gpt-oss | 官方儲存庫(Apache-2.0)[20] | 釋出的權重檔、推理格式、服務執行環境 |
| Meta Muse | Muse-Spark-Open-816B-A42B、Muse-Glimmer-30B [18, 19] | 自行託管或由供應商託管;不是 Meta Model API 的名稱 |
| Qwen | Qwen3.8-27B、Qwen3.8-Flash-Next、Qwen3.8-2.4T-A95B [21] | 這些模型卡列出不同的授權;同一個家族名稱不代表條款相同 |
| DeepSeek | DeepSeek-V4.1-Flash-1017 [22] | 帶日期的權重版本、精度、工具解析器、推論設定 |
| Google Gemma | gemma-4-31B-it [23] | 指令微調版本及其條款 |
| Mistral AI | Mistral-Small-4-119B-2603 [24] | 該版本專屬的部署與工具使用說明 |
| Moonshot AI | Kimi-K2.5 [25] | 預期搭配的 agent harness 與思考設定 |
| Z.ai | GLM-5 [26] | 官方的對話樣板與服務說明 |
評測入口
| 資源 | 它問的問題 | 引用任何結果時要一併記錄 |
|---|---|---|
| SWE-bench 排行榜與 Verified 資料集 [5, 27] | 生成的修補能否通過儲存庫的測試? | 資料集切分、agent 骨架及其版本 |
| Terminal-Bench(網站回報版本 4.0)與任務目錄 [28, 29] | Agent 能否完成可執行的終端機任務? | 評測版本、agent、預算 |
| LiveCodeBench [6] | 模型能否解出所選時間區間的競賽題? | 日期區間與取樣設定 |
| Berkeley Function-Calling Leaderboard V4 [30] | 模型能否依該套件的規則選擇並組成工具呼叫? | 原生與提示式函式呼叫 |
| Arena [31, 32] | 抽樣投票者偏好哪個回答?Agent Mode 採用不同的設計。 | 排行榜類別與日期 |
| HELM [33] | 模型在許多情境與指標上的表現如何? | 情境集與釋出版本 |
| Artificial Analysis 與方法 [34] | 模型在指定的品質、速度與價格量測上如何比較? | 指數與方法版本、推理強度設定 |
值得追蹤的組織與人物。 這個領域是由團隊建立的;以下是通往不同工作脈絡的入口,不是功勞的排名。Dario Amodei 與 Daniela Amodei(Anthropic 領導團隊)[35];Demis Hassabis(Google DeepMind)[36];Andrej Karpathy,以神經網路與語言模型實作的實用講解聞名 [37];Fei-Fei Li,專長視覺辨識、ImageNet 與空間智慧(Stanford HAI)[38]。除了訪談,也請閱讀他們的技術著作與實際的產物;知名度不能替不相關的產品主張背書。
延伸閱讀
- Jimenez et al.,SWE-bench:如何從真實任務建立以執行結果評分的評測。[5]
- Jain et al.,LiveCodeBench:以限定時間區間的評估防禦資料污染。[6]
- Zhang et al.,A Careful Examination of LLM Performance on Grade School Arithmetic:用全新的對照測試集量測過擬合。[7]
- Miller,Adding Error Bars to Evals:回報與比較評估結果的統計方法。[8]
- Yao et al.,τ-bench:以 pass^k 衡量可靠度的 agent 評估。[10]
- Open Source Initiative,Open Source AI Definition 1.0:一個 AI 系統要「開放」需要滿足什麼。[3]
參考文獻
第一手文件、論文與模型卡,除另有註明外,查核日期為 2026 年 11 月 6 日:
- Open Source Initiative, “The Open Source Definition.” Definition.
- Black Forest Labs, “How does FLUX licensing work?” (an example of different licenses within one model family). License overview.
- Open Source Initiative, “The Open Source AI Definition 1.0.” Definition.
- Hugging Face, “Model Cards,” Hub documentation. Documentation.
- Carlos E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?,” ICLR, 2024. Paper, evaluation harness.
- Naman Jain et al., “LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code,” arXiv:2403.07974, 2024. Paper, project, leaderboard.
- Hugh Zhang et al., “A Careful Examination of Large Language Model Performance on Grade School Arithmetic,” NeurIPS Datasets and Benchmarks Track, 2024. Paper.
- Evan Miller, “Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations,” arXiv:2411.00640, 2024. Paper.
- Mark Chen et al., “Evaluating Large Language Models Trained on Code,” arXiv:2107.03374, 2021. Paper.
- Shunyu Yao, Noah Shinn, Pedram Razavi and Karthik Narasimhan, “τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains,” arXiv:2406.12045, 2024. Paper.
- Woosuk Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” SOSP, 2023. DOI, preprint.
- OpenAI, “Models.” Model catalog.
- Anthropic, “Models overview.” Model IDs and platform comparison.
- Google, “Gemini API models.” Model catalog, Gemini 4 Argon.
- Meta, “Models,” Meta Model API. Model identifiers and access.
- xAI, “Grok 4.7 Developer Guide” and “Models.” Grok 4.7, catalog.
- Meta, “Introducing Muse: The World’s First Personal AI Agent Built for Everyone,” 2026. Announcement.
- Meta, “Muse Spark Open: Get the model.” Released checkpoints.
- Meta, “Muse Glimmer: Get the model.” Released weight variants.
- OpenAI, “gpt-oss.” Repository and license.
- Qwen team, “Qwen3.8.” Official release collection.
- DeepSeek-AI, “DeepSeek-V4.1-Flash-1017.” Model card.
- Google, “gemma-4-31B-it.” Model card.
- Mistral AI, “Mistral-Small-4-119B-2603.” Model card.
- Moonshot AI, “Kimi-K2.5.” Model card.
- Z.ai, “GLM-5.” Model card.
- SWE-bench maintainers, “Official Leaderboards” and “SWE-bench Verified.” Results, dataset card.
- Terminal-Bench maintainers, benchmark and leaderboard. Official site.
- Harbor, “Dataset registry.” Versioned benchmark tasks.
- Berkeley Function-Calling Leaderboard maintainers, “BFCL V4.” Leaderboard.
- Arena, “Frequently asked questions.” Methodology.
- Arena, “How to use Agent Mode.” Evaluation design.
- Stanford CRFM, “Holistic Evaluation of Language Models (HELM).” Framework.
- Artificial Analysis, “AI Model & API Providers Analysis” and “Methodology.” Comparisons, methodology.
- Anthropic, “Leadership.” Official biographies.
- Google DeepMind, “About.” Organization.
- Andrej Karpathy, personal website. Teaching and projects.
- Stanford HAI, “Fei-Fei Li.” Profile.
- Edwin B. Wilson, “Probable Inference, the Law of Succession, and Statistical Inference,” Journal of the American Statistical Association, 22(158), 209–212, 1927. DOI.