Agent 實務(一):agent 如何運作,以及任務需要多少自主性
Agent 是什麼?它的底層如何運作?我的任務需要多少自主性?
聊天助手可以告訴你如何修正失效連結。Agent 則可以查看儲存庫、找出正確目標、修改連結、執行檢查,再交出可供審閱的變更。真正有用的差別,在於回饋循環:系統會觀察發生了什麼,再決定下一步。
這個三篇系列沿著這個循環,從第一次使用一路走到日常維運。如果你用過聊天機器人,卻還沒開發過 agent,可以從這篇開始。 只需要對檔案與指令有基本認識。
| 閱讀順序 | 它回答的問題 |
|---|---|
| 一 · Agent 如何運作 | Agent 是什麼?如何運作?我的任務需要多少自主性? |
| 二 · Skills 與 harness | 如何封裝一套工作程序,並建立能驗證完成與否的循環? |
| 三 · 維運 agent harness | 如何日常運行 agent:工作階段、權限、記憶、排程與復原? |
正文描述的機制不依賴特定廠商。具名的產品、協定版本與近期研究方向,集中在現行選項,並標明查核日期。
重點
- Agent 是放在循環裡的模型:模型提出行動,程式執行,觀察結果再影響下一個提案。
- 模型自己從不執行工具。它只送出結構化請求,由你的 harness 決定這個請求能不能執行。
- 每次請求都會重新送出指令、工具定義、對話與工具結果。情境視窗是一筆預算,而耗盡它的通常是工具結果。
- 多數 agent 失敗其實是系統失敗:缺少證據、工具含糊、輸出沒有上限、完成宣告沒有檢查。
- 選擇能通過任務驗收檢查的最小系統。固定的工作流程常常勝過自由運行的 agent。
- 在挑選任何工具之前,先寫好任務約定(目標、輸入、允許的行動、驗收測試、停止條件)。
先說清楚想完成什麼
以每週論文摘要為例。有用的成果是一份本地文件,包含每篇選定論文的簡短說明、原始來源連結,以及明確列出的不確定之處。「研究所有 agent 技術」沒有界定搜尋範圍,也沒有完成標準。「根據這些來源整理摘要,寄出前先停下」才是一個可以完成的任務。
寫程式也是同樣的原則。說明可以觀察的行為、允許修改的檔案、驗證指令,以及預期交付的產物。以下是可以自行調整的原創任務範本:
程式碼 · 7 行
Goal: prepare a short digest of the three supplied papers.
Inputs: the supplied PDFs and their official publication pages.
Output: a local draft with a claim, evidence, limitation, and source for each.
Allowed actions: read these sources and write inside the draft directory.
Acceptance: every factual claim has a source; unknowns remain explicit.
Stop: after the draft and source checks; do not send or publish it.
If blocked: preserve completed work and name the missing evidence.
這是一份任務約定,不是神奇提示詞。提示詞的文字無法強制執行權限;檔案系統與寄送的限制,必須由應用程式在工具中強制執行。第一次嘗試時,選擇產物小、容易檢查的工作,然後審閱產物與檢查結果,而不是看最後一句訊息有多自信。
一個 agent 由哪些部分組成
模型提出行動。工具讓它讀取或改變環境。情境(context)提供目前任務與證據。Harness 是外圍的執行系統,管理循環、執行工具、保存狀態、強制限制並處理錯誤。Skill 則封裝可重用的工作知識,讓執行系統在相關時載入。這些角色可以存在於同一個程式裡,但除錯時仍值得分開理解。[4, 5, 6]
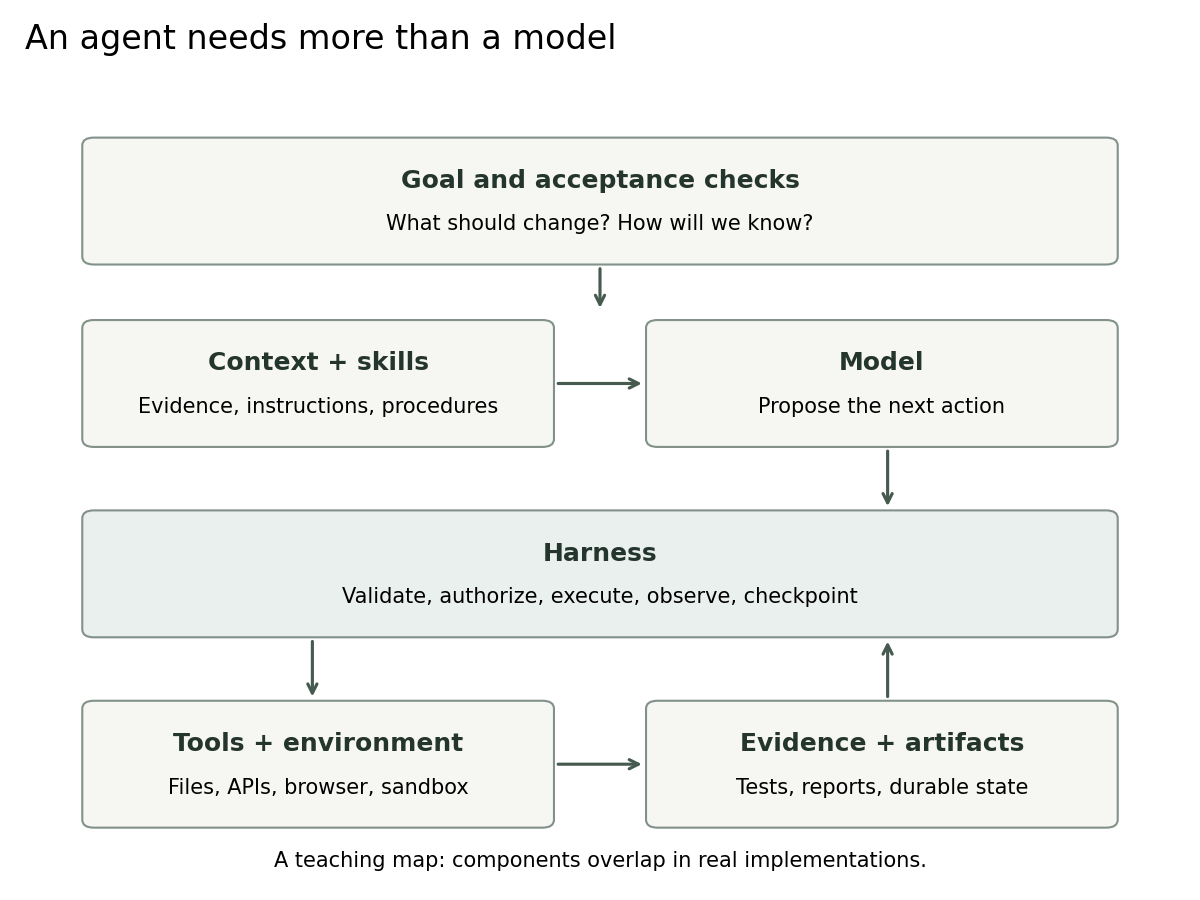
假設摘要引用了錯誤論文,先找錯誤從哪裡進來。情境裡沒有正確來源?搜尋找到同名文章?工具截掉了關鍵段落?檢查器只確認網址存在?每個原因需要不同的修正,一直重寫系統提示詞,可能完全碰不到真正的問題。
工具呼叫實際上如何運作
白話版。 模型不能點擊、讀檔或呼叫 API。它只會寫出一份結構化請求,說明想用哪個工具、帶什麼參數。你的程式讀取請求,決定是否執行,執行後在下一次請求中把結果送回去。
精確版。 主要的模型 API 都實作同一種往返流程,只是欄位名稱不同。[12, 13]
- 應用程式送出的請求,包含對話內容與一份工具定義(tool definitions)清單。每個定義有名稱、自然語言說明,以及描述參數的 JSON Schema。
- 模型回傳的內容可能是文字,也可能(或同時)是一個或多個工具呼叫(tool calls):工具名稱、參數,以及每次呼叫的識別碼。回應會標示為「因為要使用工具而停止」。
- 應用程式驗證參數、檢查授權,然後執行呼叫。
- 應用程式送出第二次請求:重複先前的訊息、納入模型的工具呼叫,並附上帶有相同識別碼的工具結果(tool result)。
- 模型讀取結果後,若不是直接回答,就會再要求下一次呼叫。Agent 循環會重複步驟 2–5,直到模型停止,或 harness 讓它停止。
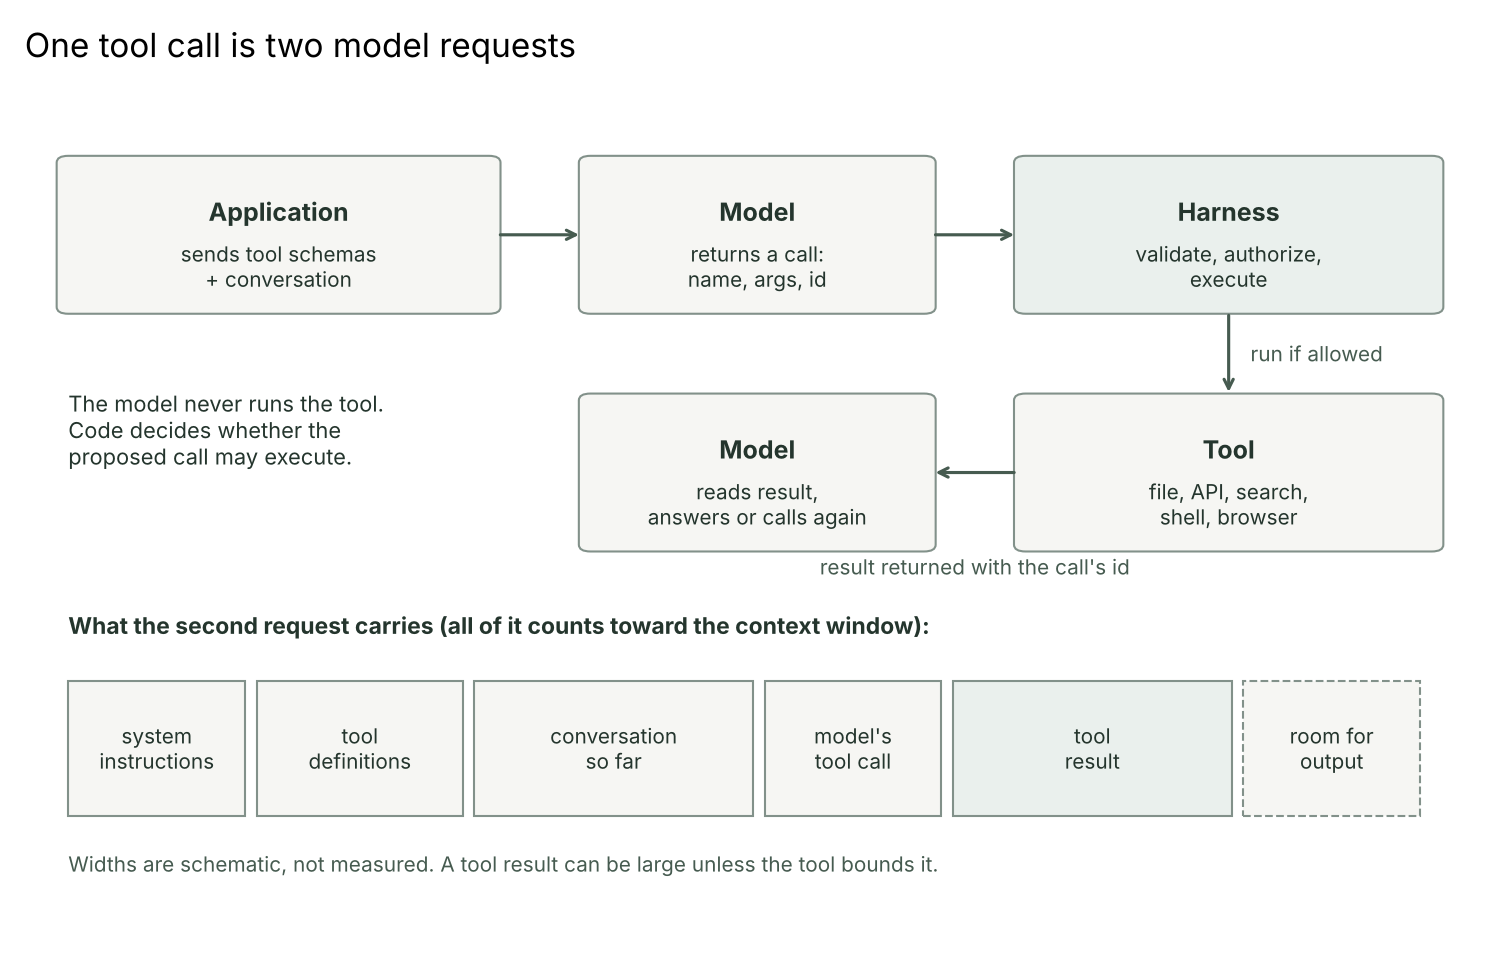
這個機制直接帶來四個結論:
- 是否執行由你決定。 因為模型只是提出請求,授權、沙箱與參數檢查都屬於程式的責任。供應商也可能在自己的伺服器上執行部分工具(例如網路搜尋);那是另一類,有各自的控制方式。[12]
- Schema 能減少參數錯誤,但不能消除。 兩家供應商都提供嚴格模式,限制參數必須符合宣告的 schema。符合 schema 的參數仍可能是錯的值:格式正確,但日期是錯的那一天。[12, 13]
- 識別碼把呼叫與結果配成對。 當模型在同一輪發出多個呼叫,識別碼讓它知道哪個結果屬於哪個呼叫。Harness 若遺失或弄亂順序,歷史紀錄就會損壞。[12, 13]
- 工具說明就是提示詞。 模型依工具的名稱與說明來選擇工具。功能重疊的工具、含糊的參數名稱(用
user而非user_id)與看不懂的錯誤訊息,都會造成錯誤呼叫。清楚的命名空間、少數高價值的工具、有上限的輸出,以及會告訴你如何修正輸入的錯誤訊息,都能帶來可衡量的改善。[16]
情境視窗是一筆預算
白話版。 模型在兩次請求之間沒有記憶。它需要知道的一切,都必須放在目前這次請求裡,而這次請求有大小上限。
精確版。 情境視窗(context window)是模型在一次請求中能處理的 token 數量,包含它生成的輸出。系統提示詞、每則訊息、每個工具定義與每個工具結果都會計入,兩家供應商也都把工具定義當作輸入 token 計費。[12, 13, 14] Agent 的每個新步驟,都會重新送出累積的歷史,所以視窗是一步一步被填滿的。更大的視窗並不是解藥:情境變長時,回想能力可能下降,位於長輸入中間的資訊,也可能比開頭或結尾的資訊更不容易被可靠利用。[14, 15]
用一個小計算就能看出工具輸出為什麼占大宗。下面的程式使用假設的大小(200,000 token 的視窗、保留 16,000 token 給輸出、9,000 token 的固定指令與工具定義、每步 400 token 的模型文字),計算在下一次請求溢出之前,能容納多少個使用工具的步驟:
程式碼 · Python · 19 行
WINDOW = 200_000          # assumed context window, in tokens
RESERVED_OUTPUT = 16_000  # room kept free for the model's reply
FIXED = 3_000 + 6_000     # system instructions + tool definitions, sent every call


def calls_before_full(result_tokens, per_call_overhead=400, cap=None):
    """Count model calls until the next request would not fit."""
    used, calls = FIXED, 0
    while True:
        result = result_tokens if cap is None else min(result_tokens, cap)
        nxt = used + per_call_overhead + result
        if nxt + RESERVED_OUTPUT > WINDOW:
            return calls
        used, calls = nxt, calls + 1


for size in (500, 5_000, 20_000):
    print(f"{size:>6,}-token results: {calls_before_full(size):>3} calls uncapped,"
          f" {calls_before_full(size, cap=2_000):>3} calls capped at 2,000")
程式碼 · 3 行
   500-token results: 194 calls uncapped, 194 calls capped at 2,000
 5,000-token results:  32 calls uncapped,  72 calls capped at 2,000
20,000-token results:   8 calls uncapped,  72 calls capped at 2,000
這些數字是假設,但形狀是普遍的:沒有上限、會回傳長檔案或整頁搜尋結果的工具,只要幾個步驟就能耗盡很大的視窗。以下是可以使用的手段,大致依「該多早採用」排序:
- 替每個工具結果設上限。 分頁、篩選,並用明確標記截斷,完整輸出則存在磁碟上,並附上回到它的路徑。[5, 16]
- 按需檢索。 先搜尋,再開啟相關段落,而不是事先貼上整份文件。
- 按需載入工具與程序。 工具搜尋與 skills 讓很少用到的定義不必出現在每次請求裡。[6, 11]
- 壓縮(compaction)。 摘要較舊的輪次,保留近期輪次的原文。壓縮可能丟掉讓結果成立的但書,所以要讓原始內容仍可取回。[5, 14]
- 把狀態外部化。 把進度、決策與未解問題寫進檔案,讓之後的步驟或工作階段可以讀取。[7]
這個領域如何走到今天
下面的年份對應具代表性的論文與工程報告,不代表每個概念都在當年首次被發明。
2022–2023:把語言接到行動。 ReAct 交錯安排推理步驟與行動,讓觀察可以改變下一個決定;它的實驗說明了為什麼在任務進行中取得資訊,可能勝過只靠第一個提示就作答。[1] Toolformer 研究如何透過自監督訓練,讓模型學會何時呼叫 API,這和把工具定義交給已訓練好的模型,是不同層次。[2] Reflexion 在多次嘗試之間保留文字回饋,不更新權重;回饋有用,但它不是獨立的正確性測試。[3]
2024:工作流程成為設計選擇。 Anthropic 的 Building effective agents 區分了預先定義的工作流程,以及由模型選擇下一步的系統,並把路由、平行工作與評估迴圈整理成依任務選用的模式。[4]
2025:情境與可重用程序。 任務變長之後,核心問題變成哪些資訊能跨步驟保留:選擇性檢索、壓縮、按需載入的 skills,以及跨工作階段的交接產物。[5–7]
2026:環境成為一等公民。 工程報告強調容易閱讀的儲存庫、可由機器檢查的限制、分開的規劃/生成/評估角色,以及把工作階段歷史與執行環境解耦。這些是案例研究,不是基準測試上的保證。[8–10]
四個時期共通的持久教訓是:讓工作可以被檢查。下一步或下一個工作階段,應該能找到目標、目前的檔案、尚未排除的失敗,以及已完成檢查的證據。
選擇足以處理問題的最小系統
| 情境 | 建議起點 | 關鍵檢查 |
|---|---|---|
| 解釋或改寫已提供的文字 | 單次模型呼叫 | 回答是否符合評分規準? |
| 步驟與輸入格式固定 | 固定流程搭配驗證 | 中間資料結構與最終產物是否通過? |
| 失敗後需要調查並改變策略 | 有界限的單一 agent 工具循環 | 能否從代表性的失敗中恢復? |
| 多項獨立調查需要整合 | 有輸出約定的平行工作者 | 整合後的改善是否值得付出成本? |
| 工作跨越重啟或外部事件 | 持久化工作階段、排程或事件驅動的執行 | 能否續作而不重複產生副作用? |
這是設計建議,不是效能排名。工作彼此獨立時,平行處理才有幫助;兩個 agent 同時修改同一份檔案,會把時間花在處理彼此的變更。獨立審閱者可以找出遺漏,但兩個模型也可能共享同一個錯誤假設,所以優先採用可執行或以原始來源為準的檢查。[4, 9] Agent 工作流程會詳細討論這些模式。
Agent 會在哪裡失敗
| 失敗類型 | 看起來像什麼 | 常見的根本原因 | 第一步修正 |
|---|---|---|---|
| 選錯工具或參數 | 搜尋錯的系統;修改錯的檔案 | 工具說明重疊;參數含糊 | 減少工具並加上命名空間;在說明中加入範例 [16] |
| 捏造參數 | 填入使用者從未提供的必填欄位 | 缺少輸入;提示詞鼓勵硬要完成 | 提供「向使用者詢問」的路徑;驗證時拒絕預設值 [12] |
| 情境溢出或衰退 | 忘記早先的限制;出現截斷錯誤 | 工具結果沒有上限;歷史過長 | 限制結果大小、壓縮、外部筆記 [5, 14] |
| 循環卻沒有進展 | 重複同一個失敗的指令 | 沒有預算;偵測不到重複失敗 | 步數與成本預算;相同失敗重複出現就停止 |
| 被注入的指令 | 照著網頁或檔案裡的命令去做 | 把不受信任的內容當成指令 | 最小權限、標示不受信任的內容、風險行動需核准 [24] |
| 虛假的完成 | 測試失敗或毫無改動,卻說「完成」 | 從對話紀錄判斷完成 | 檢查環境;以證據作為完成的門檻(見第二篇) |
間接提示詞注入(indirect prompt injection)值得另外說明:當 agent 讀取外部內容,這些內容可能含有寫成指令口吻的文字。過濾有幫助,但不是保證,所以穩健的控制是結構性的:限制 agent 持有的工具與憑證、持續標示不受信任的內容,並在新的、有風險的邊界上要求核准。[23, 24]
介面位於不同層次
| 名稱 | 主要處理什麼 | 它本身不會直接提供什麼 |
|---|---|---|
| Agent Skills | 可攜的任務指令與附屬檔案 | 新憑證或執行成功保證 |
| MCP(Model Context Protocol) | 讓應用程式連接伺服器提供的工具、資源與提示 | 任務計畫或完整的 agent 執行系統 |
| ACP(Agent Client Protocol) | 編輯器/用戶端與 coding agent 之間的通訊 | 適用所有行動的通用權限政策 |
| A2A(Agent2Agent) | Agent 系統之間的通訊與任務協作 | 共享私有狀態或自動建立互信 |
這些描述依據各自的原始規格。它們是互補的介面,不是同一種產品的競爭名稱,是否相容取決於兩端支援的版本與能力。MCP 規格本身就說明,協定層級無法強制執行同意與工具安全,必須由主機應用程式負責。[6, 20–22] 要把單一個 agent 用好,並不需要先導入其中任何一種。
第一個值得做的實驗
選一件你已經知道如何檢查的工作。先跑簡單基準,再改變系統的一個部分:加入相關 skill、替工具輸出設上限、改善錯誤訊息,或補上缺少的來源。比較產物與所需的人工修正量,並保存失敗案例。
以論文摘要來說,可以測試名稱模糊的論文、缺失的 PDF,以及與先前摘要互相矛盾的來源。有用的行為是消除歧義或回報缺口;如果證據不存在,把表格每一格都填滿也不算成功。
當你能說出預期產物、允許的行動、完成檢查與停止條件,就可以進入下一篇。繼續閱讀 skills 與 harness;如果已經在運行 harness,則可以看維運 agent harness。
現行選項,查核日期 2026 年 11 月 6 日
這一節收集會隨版本更新而改變的細節。上面的正文並不依賴它們。
協定版本。 MCP 規格目前的版本日期為 2026-07-28;它定義伺服器如何透過 JSON-RPC 2.0 提供工具、資源與提示,並有長時間任務等選用擴充。[20] Agent Skills 規格是持續更新的文件,其中的 allowed-tools 欄位被標示為實驗性。[6] ACP 與 A2A 發布的是持續更新的文件;請確認兩端實作的版本。[21, 22]
情境上限。 舉一個具體例子,Anthropic 目前的模型文件列出其現行模型的情境視窗為 1M token,把工具定義與結果計入視窗,並提供伺服器端壓縮。其他供應商另有各自的上限與行為。[14]
值得追蹤的方向。 以下是近期的研究或工程提案,並非已確立的實務:
- 程式化工具呼叫(programmatic tool calling)把篩選、迴圈與彙整交給模型寫出的程式,讓模型只收到真正重要的結果。執行環境仍需要控制。[11, 19]
- Recursive Language Models(RLMs)把長輸入當作可從外部檢查、並透過程式化的遞迴呼叫拆解的環境,而不是把它貼進一個更大的視窗。[18]
- 反思式提示詞最佳化,例如 GEPA,根據執行軌跡的回饋演進提示詞;其比較結果依任務而定。用來調整的案例,應與用來判斷成效的案例分開。[17]
- 長時間執行的 harness 設計分開規劃、生成與評估,並把工作階段歷史與執行沙箱解耦。[9, 10]
延伸閱讀
- Anthropic, Building effective agents:對工作流程與 agent 模式最清楚的分類。[4]
- Anthropic 與 OpenAI 的工具使用指南(tool use、function calling):往返流程中請求與回應的確切格式。[12, 13]
- Effective context engineering for AI agents:選擇、壓縮與外部化情境。[5]
- Liu et al., Lost in the Middle:為什麼更多情境不等於更好的情境。[15]
- Yao et al., ReAct:讓「觀察—行動」循環變得具體的論文。[1]
- OWASP, LLM01:2025 Prompt Injection:每個使用工具的 agent 都必須圍繞它來設計的威脅。[24]
參考文獻
- Shunyu Yao et al., “ReAct: Synergizing Reasoning and Acting in Language Models,” ICLR, 2023;初稿 2022。 論文.
- Timo Schick et al., “Toolformer: Language Models Can Teach Themselves to Use Tools,” NeurIPS, 2023。 論文.
- Noah Shinn et al., “Reflexion: Language Agents with Verbal Reinforcement Learning,” NeurIPS, 2023。 論文.
- Anthropic, “Building effective agents,” 工程文章,2024-12-19。 文章.
- Prithvi Rajasekaran et al., “Effective context engineering for AI agents,” Anthropic,2025-09-29。 文章.
- Agent Skills contributors, “Specification,” 持續更新規格,查閱日期 2026-11-06。 規格.
- Anthropic, “Effective harnesses for long-running agents,” 工程文章,2025-11-26。 文章.
- Ryan Lopopolo, “Harness engineering: leveraging Codex in an agent-first world,” OpenAI,2026-02-11。 文章.
- Prithvi Rajasekaran, “Harness design for long-running application development,” Anthropic,2026-03-24。 文章.
- Anthropic, “Scaling Managed Agents: Decoupling the brain from the hands,” 2026-04-08。 文章.
- Anthropic, “Introducing advanced tool use on the Claude Developer Platform,” 2025-11-24。 文章.
- Anthropic, “Tool use with Claude,” Claude Platform 文件,查閱日期 2026-11-06。 文件.
- OpenAI, “Function calling,” OpenAI API 文件,查閱日期 2026-11-06。 文件.
- Anthropic, “Context windows,” Claude Platform 文件,查閱日期 2026-11-06。 文件.
- Nelson F. Liu et al., “Lost in the Middle: How Language Models Use Long Contexts,” Transactions of the Association for Computational Linguistics, 2024。 論文.
- Ken Aizawa, “Writing effective tools for AI agents,” Anthropic,2025-09-11。 文章.
- Lakshya A. Agrawal et al., “GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning,” ICLR, 2026。 論文.
- Alex L. Zhang, Tim Kraska and Omar Khattab, “Recursive Language Models,” arXiv:2512.24601,2025,2026 年 5 月修訂。 論文.
- Anthropic, “Code execution with MCP: Building more efficient agents,” 2025-11-04。 文章.
- Model Context Protocol contributors, “Specification” (version 2026-07-28) and “Architecture overview,” 查閱日期 2026-11-06。 規格、架構.
- Agent Client Protocol contributors, “Introduction,” 持續更新文件,查閱日期 2026-11-06。 文件.
- A2A contributors, “What is A2A?,” 持續更新文件,查閱日期 2026-11-06。 文件.
- Kai Greshake et al., “Not What You’ve Signed Up For: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection,” Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security, 2023。 DOI、預印本.
- OWASP Gen AI Security Project, “LLM01:2025 Prompt Injection,” OWASP Top 10 for LLM Applications 2025。 條目.